C语言
C语言学习
1章 概述
注意点:
- 一个函数的函数体可以没有变量定义和执行部分,函数可以是空函数。
- 一个C程序至少包含一个主函数,即main函数。
- 一个函数由两部分组成,分别是函数的说明部分和函数体。
- C语言通过输入和输出函数 来进行输入输出。
- 主函数后的圆括号内可为空,但这个圆括号不能省略。
2章 数据类型、运算符、表达式
注意点:
- C语言中,数据基本类型有整型,浮点型,字符型;
- 能表示整型常量的进制有八、十、十六进制(二进制不行);
- ASCII码表:数值0——48;字母A——65;字母a——97;
- 所有变量,遵循先定义后使用的原则;
- 强制类型转换——将一个表达式转换成指定的类型;
基本类型
整型
| 类型 | 存储需求 | 取值范围 |
|---|---|---|
| int | 4字节 | -2 147 483 648 ~ 2 147 483 647(过20亿) |
| short | 2字节 | -32 768 ~ 32 767 |
| long | 8字节 | -9 223 372 036 854 775 808 ~ 9 223 372 036 854 775 807(过九百亿亿) |
| byte | 1字节 | -128 ~ 127 |
长整型数值带一个后缀L或l,十六进制数值带前缀0x,八进制带前缀0,(但容易混淆,如010对应十进制的8,所以不建议用),二进制数前缀带0b。
浮点型
| 类型 | 存储需求 | 取值范围 |
|---|---|---|
| float | 4字节 | 大约+-3.402 823 47E + 38F(有效位数为6~7位) |
| double | 8字节 | 大约+-1.797 693 134 862 315 70E + 308(有效位数为15位) |
float类型带后缀F/f,没有后缀的浮点数值默认为double类型,double类型后缀也可以带D
对于表示溢出和出错情况的三个特殊浮点数值:
1.正无穷大:Double.POSITIVE_INFINITY
2.负无穷大:Double.NEGATIVE_INFINITY
3.NaN(不是一个数字):Double.NaN
检测一个特定值是否等于Double.NaN:
整数被0除会产生异常,浮点数被0除会得到无穷大或NaN结果。
浮点数值采用二进制系统表示,无法精确表示分数1/10,就像十进制无法精确表示分数1/3一样,所以,(2.0 - 1.1)将打印出 0.899999999,而不是0.9。(舍入误差)
char类型
占2字节,char类型的字面量要用单引号括起来,char类型的值可以表示为16进制值,其范围为:\u0000 ~ \uFFFF
Unicode转义序列会在解析代码前得到处理,如:”\u0022+\u0022”,不是由引号包围加号的字符串,\0022表示引号,会在解析前转换为”,这会得到”“+”“,也就是一个空串。
更隐秘的,对注释中的\u也一样:// \u000A is a newline 中\u000A会替换为一个换行符,
类似的:// look inside c:\users中会出现一个语法错误,即\u后没有跟着4个十六进制数。
枚举类型
枚举类型也是算术类型,被用来定义在程序中只能赋予其一定的整数值的变量。
1 | enum 枚举名 {枚举元素1,枚举元素2,……}; |
比如:
1 |
|
注意:
第一个枚举成员的默认值为整型的 0,后续枚举成员的值在前一个成员上加 1。在这个实例中把第一个枚举成员的值定义为 1,第二个就为 2,以此类推。
可以在定义枚举类型时改变枚举元素的值:
1
enum season {spring, summer=3, autumn, winter};
没有指定值的枚举元素,其值为前一元素加 1。也就说 spring 的值为 0,summer 的值为 3,autumn 的值为 4,winter 的值为 5
关于枚举的遍历:
在C 中,枚举类型是被当做 int 或者 unsigned int 类型来处理的,所以按照 C 规范是没有办法遍历枚举类型的。不过有特殊情况,即在枚举类型中的值是连续时 可以遍历,否则不能;
void类型
void 类型指定没有可用的值。它通常用于以下三种情况下:
| 序号 | 类型与描述 |
|---|---|
| 1 | 函数返回为空 :C 中有各种函数都不返回值,或者您可以说它们返回空。不返回值的函数的返回类型为空。例如 void exit (int status); |
| 2 | 函数参数为空: C 中有各种函数不接受任何参数。不带参数的函数可以接受一个 void。例如 int rand(void); |
| 3 | 指针指向 void :类型为 void * 的指针代表对象的地址,而不是类型。例如,内存分配函数 void *malloc( size_t size ); 返回指向 void 的指针,可以转换为任何数据类型。 |
运算符
逻辑运算符
假设变量 A 的值为 1,变量 B 的值为 0,则:
| 运算符 | 描述 | 实例 |
|---|---|---|
| && | 称为逻辑与运算符。如果两个操作数都非零,则条件为真。 | (A && B) 为假。 |
| || | 称为逻辑或运算符。如果两个操作数中有任意一个非零,则条件为真。 | (A || B) 为真。 |
| ! | 称为逻辑非运算符。用来逆转操作数的逻辑状态。如果条件为真则逻辑非运算符将使其为假。 | !(A && B) 为真。 |
位运算符
位运算符作用于位,并逐位执行操作。&、 | 和 ^ 的真值表如下所示:
| p | q | p & q | p | q | p ^ q |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 1 | 1 |
假设如果 A = 60,且 B = 13,现在以二进制格式表示,它们如下所示:
A = 0011 1100
B = 0000 1101
-—————-
A&B = 0000 1100
A|B = 0011 1101
A^B = 0011 0001
~A = 1100 0011
赋值运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| = | 简单的赋值运算符,把右边操作数的值赋给左边操作数 | C = A + B 将把 A + B 的值赋给 C |
| += | 加且赋值运算符,把右边操作数加上左边操作数的结果赋值给左边操作数 | C += A 相当于 C = C + A |
| -= | 减且赋值运算符,把左边操作数减去右边操作数的结果赋值给左边操作数 | C -= A 相当于 C = C - A |
| *= | 乘且赋值运算符,把右边操作数乘以左边操作数的结果赋值给左边操作数 | C *= A 相当于 C = C * A |
| /= | 除且赋值运算符,把左边操作数除以右边操作数的结果赋值给左边操作数 | C /= A 相当于 C = C / A |
| %= | 求模且赋值运算符,求两个操作数的模赋值给左边操作数 | C %= A 相当于 C = C % A |
| <<= | 左移且赋值运算符 | C <<= 2 等同于 C = C << 2 |
| >>= | 右移且赋值运算符 | C >>= 2 等同于 C = C >> 2 |
| &= | 按位与且赋值运算符 | C &= 2 等同于 C = C & 2 |
| ^= | 按位异或且赋值运算符 | C ^= 2 等同于 C = C ^ 2 |
| |= | 按位或且赋值运算符 | C |= 2 等同于 C = C | 2 |
杂项运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| sizeof() | 返回变量的大小。 | sizeof(a) 将返回 4,其中 a 是整数。 |
| & | 返回变量的地址。 | &a; 将给出变量的实际地址。 |
| * | 指向一个变量。 | *a; 将指向一个变量。 |
| ? : | 条件表达式(三元运算符) | 如果条件为真 ? 则值为 X : 否则值为 Y |
3章 顺序结构
printf函数包括“格式控制”和“输出列表”,其中“格式控制”包括:格式说明、普通字符;。
scanf函数包括“格式控制”和“地址列表”。
#define宏都是直接替换的,不会计算后再替换。
1
2
3
4
5
6
7
8
9
int main(){
int ar;
ar=S(3+5);
printf("\n%d",ar);
}
//输出结果为29
//s(3+5) = p*3+5*3+5 = 9+15+5 =29真 等价于 非0的数
数组中的元素具有相同的类型(数据类型,储存类型)
实型常量–指数形式:e/E之前必须有数字,且e/E后面必须为整数;如不能有e4,12e2.5
\a:警告,蜂鸣声 \b:退格,后退一个字符 \f:换页 \n:换行 \r:回车,当前位置移到本行开头 \t:水平制表符,当前位置移到下一个tab位置 \v:垂直制表符,当前位置移到下一个垂直对齐点 \加数字:数字为八进制,表示为数字对于的ASCII字符 \x加数字:数字为十六进制,表示为数字对于的ASCII字符执行结果为:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
## 4章 选择结构
1. switch括号内的表达式应为整数类型,即可以是int类型、char类型、枚举类型;
2. 运算符优先级:
!(逻辑非) > 算数运算 > 关系运算 > &&(逻辑与) > ||(逻辑或) > 赋值运算
3. else与它前面最近的一个未配对的if 配对
## 5章 循环结构
1. ```c
int k = 0;
while(k++ <= 2){
printf("%d ",k);
}1
1 2 3
for( 表达式1;表达式2;表达式3) 中表达式2不成立后,依旧会执行完表达式3.
6章.数组
- 全局或静态数组:未初始化的部分默认为0;
局部数组:如果有部分初始化,则剩下未初始化的部分为0;如完全没有初始化,则所有值均不确定。 - “类型 数组名 [常量表达式]” 中常量表达式 可以包括 常量和符号常量。
- 二维数组中元素排列顺序为 : 按行存放,即在内存中先存放第一行的元素,再存放第二行的元素。
输出“魔方阵”。
所谓魔方阵是指这样的方阵,它的每一行、每一列和对角线之和均相等。例如,三阶魔方阵为
8 1 6
3 5 7
4 9 2
要求输出1~pow(n,2)的自然数构成的魔方阵。
解:魔方阵中各数的排列规律如下:
(1)将1放在第1行中间一列。
(2)从2开始直到n×n止各数依次按下列规则存放:每一个数存放的行比前一个数的
行数减1,列数加1(例如上面的三阶魔方阵,5在4的上一行后一列)。
(3)如果上一数的行数为1,则下一个数的行数为n(指最下一行)。例如,1在第1行,
则2应放在最下一行,列数同样加1。
(4)当上一个数的列数为n时,下一个数的列数应为1,行数减1。例如,2在第3行最
后一列,则3应放在第2行第1列。
(5)如果按上面规则确定的位置上已有数,或上一个数是第1行第n列时,则把下一个
数放在上一个数的下面。例如,按上面的规定,4应该放在第1行第2列,但该位置已被1
占据,所以4就放在3的下面。由于6是第1行第3列(即最后一列),故7放在6下面。
按此方法可以得到任何阶的魔方阵。注:魔方阵的阶数应为奇数。
7章.函数
变量作为实参向形参的数据传递方式是:单向值传递
函数的定义不可以嵌套,但调用可以嵌套
形参可以是常量,变量或表达式;
实参与对应的形参各占用独立的存储单元;
函数定义的一般形式如下:
1 | return_type function_name( parameter list ) |
在 C 语言中,函数由一个函数头和一个函数主体组成。下面列出一个函数的所有组成部分:
- 返回类型:一个函数可以返回一个值。return_type 是函数返回的值的数据类型。有些函数执行所需的操作而不返回值,在这种情况下,return_type 是关键字 void。
- 函数名称:这是函数的实际名称。函数名和参数列表一起构成了函数签名。
- 参数:参数就像是占位符。当函数被调用时,您向参数传递一个值,这个值被称为实际参数。参数列表包括函数参数的类型、顺序、数量。参数是可选的,也就是说,函数可能不包含参数。
- 函数主体:函数主体包含一组定义函数执行任务的语句。
调用函数:
当程序调用函数时,程序控制权会转移给被调用的函数。被调用的函数执行已定义的任务,当函数的返回语句被执行时,或到达函数的结束括号时,会把程序控制权交还给主程序。
调用函数时,传递所需参数,如果函数返回一个值,则可以存储返回值。
牛顿迭代法
用牛顿迭代法求根。方程为ax3+b2+cx+d=0,系数a,b,c,d的值依次为1,2,
3,4,由主函数输入。求x在1附近的一个实根。求出根后由主函数输出。
牛顿迭代公式:x = x0 - f(x0) / f ‘(x0)
1 |
|
8章.指针运用
- ```
int a[5];1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
则数组a中首元素的地址可表示为:a
2. C中,指针变量能够赋<u>地址值</u>或<u>NULL</u><u>值</u>(或'\0',或0,或空值);
3. 指针 p++ 指 p = p + 1,因为++有赋值操作,p的值(存放的地址)会改变;
指针 p + 1 指访问下一个地址;p本身不变。
4. * int * p[3];
//首先从P 处开始,先与[]结合,因为其优先级比 * 高,所以P 是一个数组,然后再与 * 结合,说明数组里的元素是指针类型,然后再与int 结合,说明指针所指向的内容的类型是整型的,所以**P 是一个由返回整型数据的指针所组成的数组**
* int ( *p)[3];
//首先从P 处开始,先与*结合,说明P 是一个指针然后再与[]结合(与"()"这步可以忽略,只是为了改变优先级),说明指针所指向的内容是一个数组,然后再与int 结合,说明数组里的元素是整型的.所以**P 是一个指向由整型数据组成的数组的指针**
* int * * p;
//首先从P 开始,先与* 结合,说是P 是一个指针,然后再与*结合,说明指针所指向的元素是指针,然后再与int 结合,说明该指针所指向的元素是整型数据.
* int p(**int**);
//从P 处起,先与()结合,说明P 是一个函数,然后进入()里分析,说明该函数有一个整型变量的参数,然后再与外面的int 结合,说明函数的返回值是一个整型数据
* Int ( *p)(**int**);
//从P 处开始,先与指针结合,说明P 是一个指针,然后与()结合,说明指针指向的是一个函数,然后再与()里的int 结合,说明函数有一个int 型的参数,再与最外层的int 结合,说明函数的返回类型是整型,所以**P 是一个指向有一个整型参数且返回类型为整型的函数的指针**
* int * (* p(**int**))[3];
从P 开始,先与()结合,说明P 是一个函数,然后进入()里面,与int 结合,说明函数有一个整型变量参数,然后再与外面的 * 结合,说明函数返回的是一个指针,,然后到最外面一层,先与[]结合,说明返回的指针指向的是一个数组,然后再与*结合,说明数组里的元素是指针,然后再与int 结合,说明指针指向的内容是整型数据.所以**P 是一个参数为一个整数据且返回一个指向由整型指针变量组成的数组的指针变量的函数.**
# 一些题解
#### 求素数
令变量 i 从**2**开始,看是否能被N%后等于0,i 一直到**sqrt(N)**即可。
#### 将ASCII码转为字符:
```c
char c1;
c1 = 33; //对应字符ASCII码的十进制数,不需加引号;
printf("%c",c1);
//32以前的字符无法正常输出;
将字符转为对应ASCII码
1 | char c; |
一元二次方程
求 的根:
1 |
|
求两数的最大公约数:
1 | int main(){ |
1 | int fun(int m,int n){ |
1 | //递归 |
求两数最小公倍数
1 | int fun(int n1,int n2){ |
汉诺塔问题
有三根柱子,有若干圆盘从下面开始按大到小顺序摆在第一根柱子上,将这些圆盘原封不动移到另一根(第三根)柱子上。
并且规定,在小圆盘上不能放大圆盘,在三根柱子之间一次只能移动一个圆盘。
总体思想
1.将 n-1个盘子先放到B座位上
2.将A座上地剩下的一个盘移动到C盘上
3.将n-1个盘从B座移动到C座上
或者
在1盘的基础上操作2盘,在2盘的基础上操作3盘………在n-1盘的基础上操作n盘
(1)
1 | void move(char x, char y); |
(2)(上下两段代码一样)
1 | void move(char x,int i,char y) |
3个字符串排序
输入3个字符串,按由小到大的顺序输出
1 | void swap(char *a, char *b){ |
C一些用法
int *p[3]; //定义了一个指针数组p,该数组含有三个元素; //每个元素都是基类型为int的指针1
2
3
4
5
6
2. ```c
char *s="\ta\017bc";
//则指针变量s指向的字符串所占的字节数是?
//6个,(包括结束符)
//\t a \017 b c \0同类型的两个指针之间可以减运算,但不能加运算;
- 两个相同指针变量相减可以获得在其之间相隔的同类型元素个数(可在某类型的数组中应用);
(j = 3, j++) //表达式的值为3,j为4;1
2
3
4
5
5. ```c
#define S(a,b) t=a;a=b;b=t
//宏就是符号定义,宏扩展时只是字符串替换,
//虽然变量t没定义,但此宏定义是正确的如果函数值的类型和return语句中表达式的值不一致,则以函数类型为准
内外函数的两种理解.
(1)库函数是C语言的内部函数或自带函数,外部函数即程序员自定函数.
(2)凡加写了extern 的函数是外部函数;一个函数声明为static或声明在另外一个函数内部,那么这个函数就是内部函数,它的声明在其他文件中不可见。
- 位运算符的操作数必须为整数类型;
(位运算符优先级比算数运算符低)
| & | (按位与)都为1,则得到1;有一个0,则得到0 |
|---|---|
| | | (按位或)有一个1,则得到1;都为0,则得到0 |
| ^ | (按位异或)两着值不同,则得到1;值相同,则为0 |
| ~ | (取反)~x:取反(得到x的补码) |
9.
1 | int x = 0177; |
double a = 513.789215; printf(“a = %8.2f, a = %14.8f, a = %14.8lf\n”, a, a, a); //输出结果:a = 513.79,a = 513.78921500,a = 513.78921500 //小数部分不够则补01
2
3
4
5
11. ```c
int a = 0;
a += (a = 8);
//运算后a = 16```c
int a[4],*p = a;
*p++;
*(–p);
//上述两者都是指针p地址值的改变1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
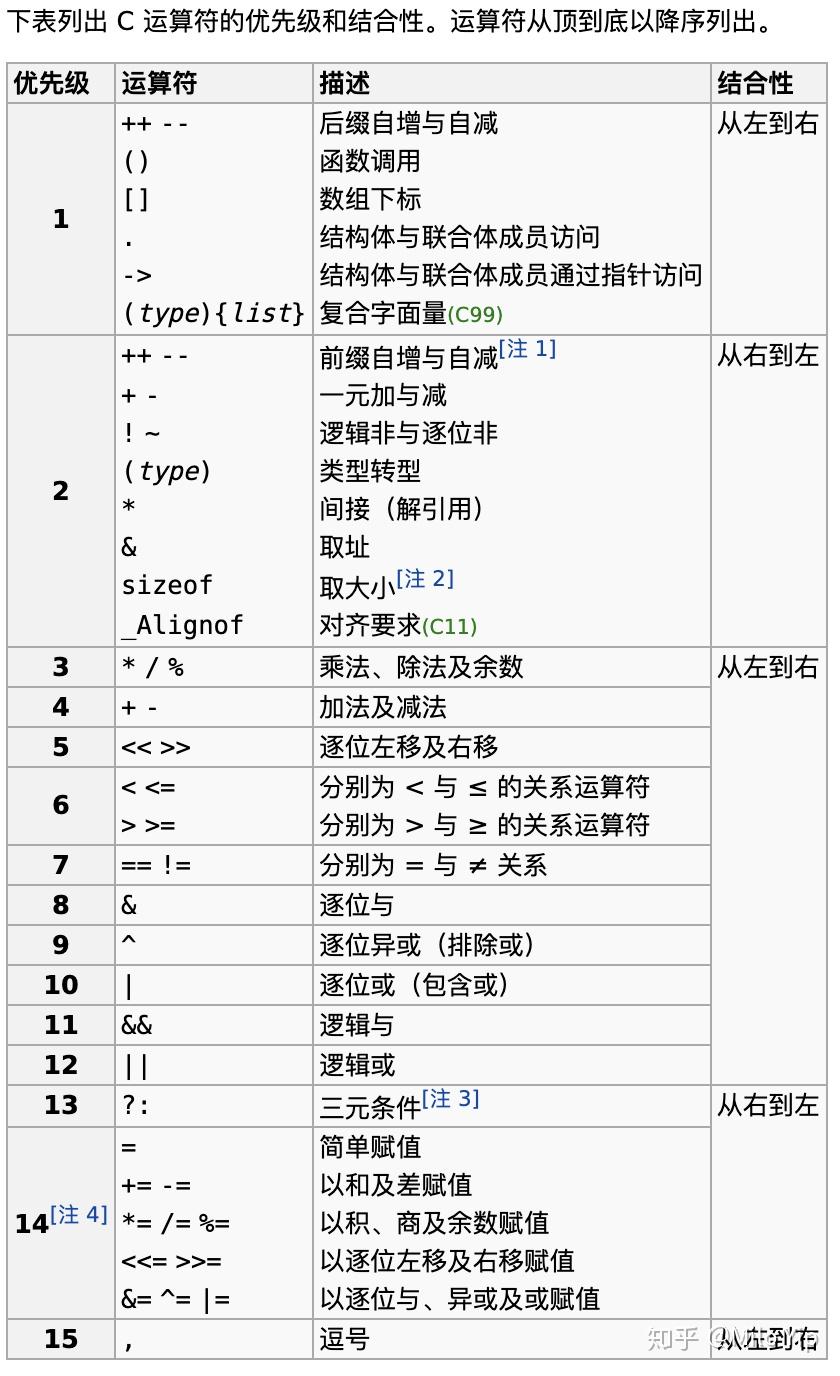
#### C运算符的优先级
#### 四舍五入
例:对小数点后四舍五入:
```c
//a是x四舍五入后的结果
a = (int)(x+0.5)>(int)x?(int)x+1:(int)x;
获取字符串长度
1 |
|
1 | 5 |
1.为类型起别名
为常用的数据类型起一个别名,这样就实现简单的多态,如需要将int类型改为char时,只需修改定义的别名中的类型即可。
2.求数中的一个数字
要求一个数中的个位数字,可使用求模运算,如,149 % 10 = 9;
3.迭代自增用++i
一般情况下,迭代自增请使用++ i (以减少不必要开销);
1 | for (语句1; 语句2; 语句3) |
语句 1 在循环(代码块)开始前执行;
语句 2 定义运行循环(代码块)的条件;
语句 3 在循环(代码块)已被执行之后执行。
- 循环里的 ++i 和 i++的结果是一样的,都要等代码块执行完毕才能执行,但是性能是不同的。在大量数据的时候++i的性能要比i++的性能好原因。
4.uthash
开源文件<uthash.h> : uthash 是C的比较优秀的开源代码,它实现了常见的hash操作函数,例如查找、插入、删除等待。该套开源代码采用宏的方式实现hash函数的相关功能,支持C语言的任意数据结构为key值,甚至可以采用多个值作为key,
5.qsort
头文件<stdlib.h> 包含有 qsort 函数(即快速排序),用法:
对int类型:
1 |
|
对char类型:(同上)
对double类型:
1 | int cmp( const void *a , const void *b ) |
对结构体类型以及字符串类型:
1 | typedef struct node{ |
qsort ( ) 包含:
- arr : 指向要排序的数组的第一个元素的指针;
- n : 对应数组中元素的个数;
- sizeof ( int ) : 数组中每个的元素的大小,以字节为单位;
- cmp:用来比较两个元素的函数
6.布尔类型
C语言中没有布尔类型,要使用true和false,需要导入头文件<stdbool.h>,或使用宏定义或枚举类来设置:
1 | //使用宏定义布尔类型 |
1 | //也可以用过枚举来定义 |
7.字符串操作
C中的有关字符串操作的函数:
- 需要头文件<string.h>
| 序号 | 函数 & 目的 |
|---|---|
| 1 | strcpy(s1, s2); 复制字符串 s2 到字符串 s1。 |
| 2 | strcat(s1, s2); 连接字符串 s2 到字符串 s1 的末尾。 |
| 3 | strlen(s1); 返回字符串 s1 的长度。 |
| 4 | strcmp(s1, s2); 如果 s1 和 s2 是相同的,则返回 0;如果 s1<s2 则返回小于 0;如果 s1>s2 则返回大于 0。 |
| 5 | strchr(s1, ch); 返回一个指针,指向字符串 s1 中字符 ch 的第一次出现的位置。 |
| 6 | strstr(s1, s2); 返回一个指针,指向字符串 s1 中字符串 s2 的第一次出现的位置。 |
8.动态分配
- malloc用法,如:
1 | int *p = (int*)malloc(sizeof(int)*20); |
- calloc用法,如:
1 | int *p = (int*)calloc(20,sizeof(int)); |
malloc申请后空间的值是随机的,并没有进行初始化,而calloc却在申请后,对空间逐一进行初始化,并设置值为0; 关于效率问题,calloc函数由于给每一个空间都要初始化值,那必然效率较malloc要低,并且现实世界,很多情况的空间申请是不需要初始值的,这也就是为什么许多初学者更多的接触malloc函数的原因。
- realloc用于对动态内存进行扩容(即已申请的动态空间不够用,需进行空间扩容操作),如:
1 | int *p = (int*)malloc(sizeof(int)*20); |
(逗号前的p是指向原来空间的指针,逗号后是需要扩容的大小)
9.&&和switch注意
(…)&&(…) 如果前面的语句为0,则后面的语句不执行
switch中的case后不带break的话,会一直往后执行,直到遇到break;default写在中间,也会一直往后执行语句,直到遇到break或switch结束。
10.斐波那契数通项公式:
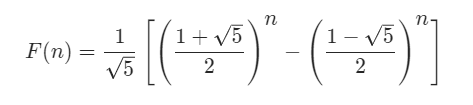
1 | int fib(int n) { |
11.math.h
1 |
|
12.负数补码,二/十/八进制转化
补码来表示和存储。反码多应用于系统环境设置。
1、补码:在计算机系统中,数值一律用补码来表示和存储。原因在于,使用补码,可以将符号位和数值域统一处理;同时,加法和减法也可以统一处理。此外,补码与原码相互转换,其运算过程是相同的,不需要额外的硬件电路。
2、反码:反码是数值存储的一种,但是由于补码更能有效表现数字在计算机中的形式,所以多数计算机一般都不采用反码表示数。
比如(7)+(-7)=0
7 -> 0000 0111(7的补码)
-7 -> 1111 1001(-7的补码)
所以相加为1 0000 0000(超出的最高位默认去掉)
比如(2)+(-3)=(-1)
2 -> 0000 0010 (2的补码)
-3 -> 1111 1101 (-3的补码)
相加为 1111 1111(-1的补码)
1.负数的补码是在原码的基础上除符号位外其余位取反后+1
例如:-8的原码为 1000 1000,通过原码求出它的反码,负数的反码就是 除符号为以外,其余的全部求反,-8 的反码为 1111 0111,其反码码 +1,就是它的补码, -8 的补码为 1111 1000
或者:
2.先求出负数的绝对值的二进制,然后从右到左遍历,遇到第一个1时,将其左侧全部取反,右侧和它本身不变。
例如01100100 -> 10011100
十进制转二进制,如果十进制数是负数则取其反码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18void function(int x) {
int arr[15], flag = 0;
if (x < 0) flag = 1, x = -x; //这里使用了上述第二种取补码方式
for (int i = 0; i <= 7; ++i) {
arr[i] = x % 2; //这里数组存储二进制数的1和0的顺序与其本身相反
x /= 2;
}
if (flag) // 负数
for (int i = 0; i <= 7; ++i)
if (arr[i] == 1 && i < 7) {
for (int j = i + 1; j <= 7; ++j)
arr[j] = 1 - arr[j];
break;
}
for(int i = 7; i >= 0; --i){
printf("%d",arr[i]);
}
}1
2
3
4
5
6
7
8
9
10
11
12
13long long convertDecimalToBinary(int n){
long long binaryNumber = 0;
int remainder, i = 1, step = 1;
while (n!=0){
remainder = n%2;
printf("Step %d: %d/2, 余数 = %d, 商 = %d\n", step++, n, remainder, n/2);
n /= 2;
binaryNumber += remainder*i;
i *= 10;
}
return binaryNumber;
}二进制转十进制
1
2
3
4
5
6
7
8
9
10
11//输入的n由1和0构成,以表示二进制数
int convertBinaryToDecimal(long long n){
int decimalNumber = 0, i = 0, remainder;
while (n!=0){
remainder = n%10;
n /= 10;
decimalNumber += remainder*pow(2,i);
++i;
}
return decimalNumber;
}
输入常见问题
scanf
1、scanf的返回值
scanf通常返回的是成功赋值(从标准输入设备赋值到参数列表所指定的内存区域)的数据项数,如果出错或是遇到end of file,则返回EOF,比如:
scanf(“%d%d”, &x, &y);
scanf函数仅在每一个数据域均有数据,并按回车后结束
如果x和y都被成功读入,那么scanf的返回值就是2;
如果只有x被成功读入,返回值为1;
如果x和y都未被成功读入,返回值为0;
如果遇到错误或遇到end of file,返回值为EOF
2、scanf的处理机制
scanf以删除的方式从缓冲区读入数据(来自标准输入设备的数据存储在缓冲区),也就是说,scanf从缓冲区读入一个数据项,该数据项在缓冲区中就被清除掉了。而如果scanf需要读取一个数据项,发现缓冲区当前是空的,那么程序就会在scanf代码处阻塞,等待用户输入,scanf函数接收到相应的数据项之后,在缓冲区中将这一数据项清除,scanf函数返回,程序继续执行。
3、scanf对不同类型输入的处理方式
首先,要明确一个概念:空白字符(white space)。一般,程序中所指的空白字符是指空格(space),回车(enter)和指标符(table)。
3.1 整数%d
对于整型数据的输入,也就是说”%d”类型的输入,scanf默认的分割符是所有的空白字符(空格,回车和指标符都行)。也就是说如果一个scanf函数中出现scanf(“%d%d”,&a,&b),那么用任何一个空白字符来分隔两个整数a,b的值,变量a,b都可以接收到正确的输入。另外,要注意的是,scanf对于数字输入,会忽略输入数据项前面的空白字符。
3.2 字符串%s
scanf对于字符串输入的处理和对整数类似,会忽略前导的空白字符,而且默认的分隔符是所有的空白字符。但是,要注意的是,由于C语言中,没有string类型,都是用char型数组来表示。因此,scanf会为每一个输入的字符串最后加一个‘\0’。
因此,在读取字符串时,只要遇到一个空格,scanf() 就会停止读取,所以 “this is test” 对 scanf() 来说是三个字符串。
3.3 字符%c
scanf在处理对字符数据的输入时,既不会忽略前导空白字符,默认也没有任何分隔字符。所有的字符,包括空白字符都会被当成输入字符。对此可以使用 getchar(char类型变量) ,来只读取一个字符。
1 2 4 8 16 32 64 128 256