位运算 X & -X X & -X ,即 X & (~X+1) 得到 二进制数的LowBit (其二进制最低位/最右侧的1,其余位均为0):
-X的值,是在X的基础上进行按位取反之后再加1得到的,
当X为偶数时,~X为奇数,奇数加上1会发生进位,最低位的连续的1都会变为0,所以X和 ~X的低位都为0,高位都相反,只有得到进位的那个位置都为1,即X的最右边的1相等,所以,当一个偶数与它的负值相与时, 结果是能整除这个偶数的最大的2的幂, 即: m = n & -n , 则 n % m = 0, 且 m = 2^k^
当X为奇数时 ,因为奇数取反后为偶数,偶数加1并不会影响进位,所以此时 X & -X 结果一定为1 (奇数最低位的1就在二进制数的末尾)
X = X & (X - 1) 该运算可以将 xxx 的二进制表示的最后一个 1 变成 0。
重复n次该运算,X最终变为0, n即为X二进制表示中的1的个数。
当 X & (X−1) = 0 时,意味着X的二进制表示只有一个1,且在最高位,即X是2的整数次幂
X & 1 即判断X二进制表示最低位是1还是0, 可表示 X 除以 2 的余数。
数学 素数 素数:除了1和它本身以外不再有其他因数。
遍历筛选:
1
2
3
4
5
6
7
8
9
10
11
static boolean is (int n) { if (n==1 ) return false ; int len = Math.sqrt(n); for (int i=2 ; i <= len; i++){ if (n % i == 0 ){ return false ; } } return true ; }
素数筛选法:
[labuladong算法题解:高效寻找素数](如何高效寻找素数 :: labuladong的算法小抄 )
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public static int countPrimes (int n) { boolean [] isPrime = new boolean [n + 1 ]; Arrays.fill(isPrime, true ); int len = Math.sqrt(n); for (int i = 2 ; i <= len; i++) { if (isPrime[i]) { for (int j = i * i; j <= n; j += i) { isPrime[j] = false ; } } } int count = 0 ; for (int i = 2 ; i <= n; i++) { if (isPrime[i]) { count++; } } return count; }
判断闰年 1 2 3 4 5 int m[13 ]={0 ,31 ,28 ,31 ,30 ,31 ,30 ,31 ,31 ,30 ,31 ,30 ,31 };if (year%400 ==0 || year%4 ==0 && year%100 !=0 ){ m[2 ] = 29 ; }
最大公约数 1 2 3 static int gcd (int a,int b) { return b = = 0 ? a : gcd(b, a % b); }
最小公倍数 1 2 3 4 5 6 7 8 static int gcd (int a,int b) { return b = = 0 ? a : gcd(b, a % b); } static int lcm (int a,int b) { return a * b / gcd(a, b); }
快速幂 求 a的n次方。 由于指数计算会很快出现数值过大的情况,所以一般题目都是取模求后几位。
快速幂: 每一步都把指数分成两半,相应的底数做平方运算。如 3^10^ = 9^5^ 。对于奇数指数值,可以抽出一次底数,如 9^5^ = 9^4^ * 9^1^。
1 2 3 4 5 6 7 8 9 10 11 12 13 static long mpow (long a, long n, long mod) { if (n == 0 || a == 1 ) return 1 ; long ans = 1 ; while (n != 0 ) { if (n % 2 == 1 ) ans = a * ans % mod; a = a * a % mod; n >>= 1 ; } return ans; }
阶乘逆元求组合数 C(n,m): 从n个数中取m个数,有多少种取法。 而逆元是指倒数,用inv表示逆元。
公式:C(n,m) = n! / m!(n-m)! = n! * inv[m!] * inv[(n-m)!]
且 inv[(n-1)!] = inv[n] * n
。。。。。
欧拉函数 。。。。
**双指针 ** Two Pointer s
141: 判断链表中是否有环: (快慢指针)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 typedef struct listNode { int data; struct listNode *next ; }LinkList; bool hasCycle (struct listNode *head) { if (head == NULL || head->next == NULL ){ return false ; } struct listNode *slow = struct listNode *fast = while (slow != fast){ if (fast == NULL || fast->next == NULL ){ return false ; } slow = slow->next; fast = fast->next->next; } return true ; }
344:反转字符串 编写一个函数,其作用是将输入的字符串反转过来。输入字符串以字符数组 char[] 的形式给出。
不要给另外的数组分配额外的空间,你必须原地修改输入数组、使用 O(1) 的额外空间解决这一问题。
你可以假设数组中的所有字符都是 ASCII 码表中的可打印字符。
1 2 3 4 5 6 7 8 9 10 11 void swap (char *a, char *b) { char t = *a; *a = *b; *b = t; } void reverseString (char *s, int sSize) { for (int left = 0 , right = sSize - 1 ; left < right; ++left, --right) { swap(s + left, s + right); } }
881:救生艇 第 i 个人的体重为 people[i],每艘船可以承载的最大重量为 limit。
每艘船最多可同时载两人,但条件是这些人的重量之和最多为 limit。
返回载到每一个人所需的最小船数。(保证每个人都能被船载)。
示例 1:
1 2 3 输入:people = [1,2], limit = 3 输出:1 解释:1 艘船载 (1, 2)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 int cmp (const void *a,const void *b) { return *(int *)a - *(int *)b; } int numRescueBoats (int * people, int peopleSize, int limit) { if (peopleSize == 1 ) return 1 ; qsort(people,peopleSize,sizeof (int ),cmp); int left = 0 ,right = peopleSize - 1 ; int count = 0 ; for (; left < right; right--){ if (people[left] + people[right] <= limit){ left++; } count++; } if (left == right){ right--; count++; } return count; }
**二分查找法 ** Binary Search
二分査找也称折半査找,其优点是查找速度快,缺点是要求所要査找的数据必须是有序序列。
该算法的基本思想是将所要査找的序列的中间位置的数据与所要査找的元素进行比较,如果相等,则表示査找成功,否则将以该位置为基准将所要査找的序列分为左右两部分 。接下来根据所要査找序列的升降序规律及中间元素与所查找元素的大小关系,对其采用同样的方法进行査找,直至能够确定所要查找的元素是否存在。
使用二分法的条件:有序,无重复元素
二分法的边界条件 二分法的区间一般分为两种,
左闭右闭,即 [left, right]
定义了target 在 [left, right] 区间,所以有:
用 while (left <= right) ,因为left == right是有意义的
当 if (nums[middle] > target) ,right = middle - 1,因为当前这个nums[middle]一定不是target,所以左区间的结束下标就是middle - 1。
左闭右开,即 [left, right)
用 while (left < right) ,因为left == right是无意义的
当 if (nums[middle] > target) ,right = middle,因为当前这个nums[middle]不是target,去左区间寻找,而区间又是左闭右开区间,所以right更新为middle,即:下一个查询区间不会去比较nums[middle]
704:二分查找 给定一个 n 个元素有序的(升序)整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 target,如果目标值存在返回下标,否则返回 -1。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 int search (int * nums, int numsSize, int target) { int left = 0 ,right = numsSize - 1 ,mid; while (left <= right){ mid = left + (right - left)/2 ; if (nums[mid] == target){ return mid; } else if (nums[mid] > target) right = mid - 1 ; else if (nums[mid] < target) left = mid + 1 ; } return -1 ; }
35:搜索插入的位置 给定一个排序数组和一个目标值,在数组中找到目标值,并返回其索引。如果目标值不存在于数组中,返回它将会被按顺序插入的位置。
你可以假设数组中无重复元素。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 int searchInsert (int * nums, int numsSize, int target) { int left = 0 , right = numsSize - 1 , mid; while (left <= right) { mid = left + (right - left) / 2 ; if (nums[mid] == target) { return mid; } else if (target < nums[mid]) { right = mid - 1 ; } else if (target > nums[mid]) { left = mid + 1 ; } } return left; }
162:寻找峰值 峰值元素是指其值大于左右相邻值的元素。
给你一个输入数组 nums,找到峰值元素并返回其索引。数组可能包含多个峰值,在这种情况下,返回 任何一个峰值 所在位置即可。
你可以假设 nums[-1] = nums[n] = -∞ 。
解:(巧用二分法)
我们可以将 nums 数组中的任何给定序列视为交替的升序和降序序列。
在简单的二分查找中,我们处理的是一个有序数列,并通过在每一步减少搜索空间来找到所需要的数字。在本例中,我们对二分查找进行一点修改。首先从数组 nums 中找到中间的元素 mid。若该元素恰好位于降序序列或者一个局部下降坡度中(通过将 nums[i]与右侧比较判断),则说明峰值会在本元素的左边。于是,我们将搜索空间缩小为 mid 的左边(包括其本身),并在左侧子数组上重复上述过程。
若该元素恰好位于升序序列或者一个局部上升坡度中(通过将 nums[i] 与右侧比较判断),则说明峰值会在本元素的右边。于是,我们将搜索空间缩小为 mid 的右边,并在右侧子数组上重复上述过程。
就这样,我们不断地缩小搜索空间,直到搜索空间中只有一个元素,该元素即为峰值元素。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 int findPeakElement (int * nums, int numsSize) { int Left = 0 ; int Right = numsSize - 1 ; int Mid = 0 ; while (Left < Right) { iMid = (Left + Right) / 2 ; if (nums[Mid] > nums[Mid + 1 ]){ Right = Mid; } else { Left = Mid + 1 ; } } return Left; }
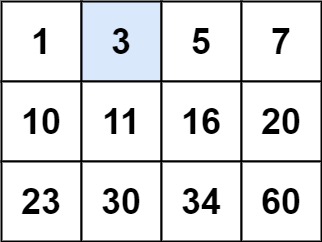
74:搜索二维矩阵 在 m * n 矩阵中,搜索是否存在一个目标值。
该矩阵有如下特点:
每行中的整数从左到右按升序排列;
每行的第一个整数大于前一行的最后一个整数;
示例:
1 2 输入:matrix = [[1,3,5,7],[10,11,16,20],[23,30,34,60]], target = 3 输出:true
两次二分查找:
我们可以对矩阵的第一列的元素二分查找,找到最后一个不大于目标值的元素,然后在该元素所在行中二分查找目标值是否存在。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 int binarySearchFirstColumn (int ** matrix, int matrixSize, int target) { int low = -1 , high = matrixSize - 1 ; while (low < high) { int mid = (high - low + 1 ) / 2 + low; if (matrix[mid][0 ] <= target) { low = mid; } else { high = mid - 1 ; } } return low; } bool binarySearchRow (int * row, int rowSize, int target) { int low = 0 , high = rowSize - 1 ; while (low <= high) { int mid = (high - low) / 2 + low; if (row[mid] == target) { return true ; } else if (row[mid] > target) { high = mid - 1 ; } else { low = mid + 1 ; } } return false ; } bool searchMatrix (int ** matrix, int matrixSize, int * matrixColSize, int target) { int rowIndex = binarySearchFirstColumn(matrix, matrixSize, target); if (rowIndex < 0 ) { return false ; } return binarySearchRow(matrix[rowIndex], matrixColSize[rowIndex], target); }
一次二分查找:
若将矩阵每一行拼接在上一行的末尾,则会得到一个升序数组,我们可以在该数组上二分找到目标元素。
代码实现时,可以二分升序数组的下标,将其映射到原矩阵的行和列上。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 bool searchMatrix (int ** matrix, int matrixSize, int * matrixColSize, int target) { int m = matrixSize, n = matrixColSize[0 ]; int left = 0 , right = m * n - 1 ,mid; while (left <= right){ mid = left + (right - left) / 2 ; int a = matrix[mid / n][mid % n]; if (a == target) return true ; else if (a > target){ right = mid - 1 ; } else if (a < target){ left = mid + 1 ; } } return false ; }
**滑动窗口 ** Sliding Window
209:长度最小的子数组 给定一个含有 n 个正整数的数组和一个正整数 target 。
找出该数组中满足其和 ≥ target 的长度最小的 连续子数组 [numsl, numsl+1, …, numsr-1, numsr] ,并返回其长度。如果不存在符合条件的子数组,返回 0 。
示例 1:
1 2 3 输入:target = 7, nums = [2,3,1,2,4,3] 输出:2 解释:子数组 [4,3] 是该条件下的长度最小的子数组。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 int minSubArrayLen (int target, int * nums, int numsSize) { int left = 0 , right = 0 ,minSize = 0 , sum = 0 ,ans = INT_MAX; if (numsSize == 0 ) return 0 ; for (;right < numsSize; right++){ sum += nums[right]; while (sum >= target){ minSize = right - left + 1 ; ans = minSize < ans ? minSize : ans; sum -= nums[left]; left++; } } return ans == INT_MAX ? 0 :ans; }
1456:定长子串中元音的最大数目 给你字符串 s 和整数 k 。
请返回字符串 s 中长度为 k 的单个子字符串中可能包含的最大元音字母数。
英文中的 元音字母 为(a, e, i, o, u)。
示例:
1 2 3 输入:s = "abciiidef", k = 3 输出:3 解释:子字符串 "iii" 包含 3 个元音字母。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 int maxVowels (char *s, int k) { int left = 0 , right = 0 , sum = 0 , ans = 0 ; while (s[right] != '\0' ) { if (s[right] == 'a' || s[right] == 'e' || s[right] == 'i' || s[right] == 'o' || s[right] == 'u' ) { sum++; ans = sum > ans ? sum : ans; } right++; if (right - left + 1 > k) { if (s[left] == 'a' || s[left] == 'e' || s[left] == 'i' || s[left] == 'o' || s[left] == 'u' ) { sum--; } left++; } } return ans; }
**递归 ** Recursion
344:反转字符串 编写一个函数,其作用是将输入的字符串反转过来。输入字符串以字符数组 char[] 的形式给出。
不要给另外的数组分配额外的空间,你必须原地修改输入数组、使用 O(1) 的额外空间解决这一问题。
你可以假设数组中的所有字符都是 ASCII 码表中的可打印字符。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 void swap (char *a, char *b) { char t = *a; *a = *b; *b = t; } void recursion (char *s,int left,int right) { if (left >= right) return ; recursion(s,left + 1 ,right - 1 ); swap(&s[left],&s[right]); } void reverseString (char *s, int sSize) { if (sSize == 0 ) return ; recursion(s,0 ,sSize - 1 ); }
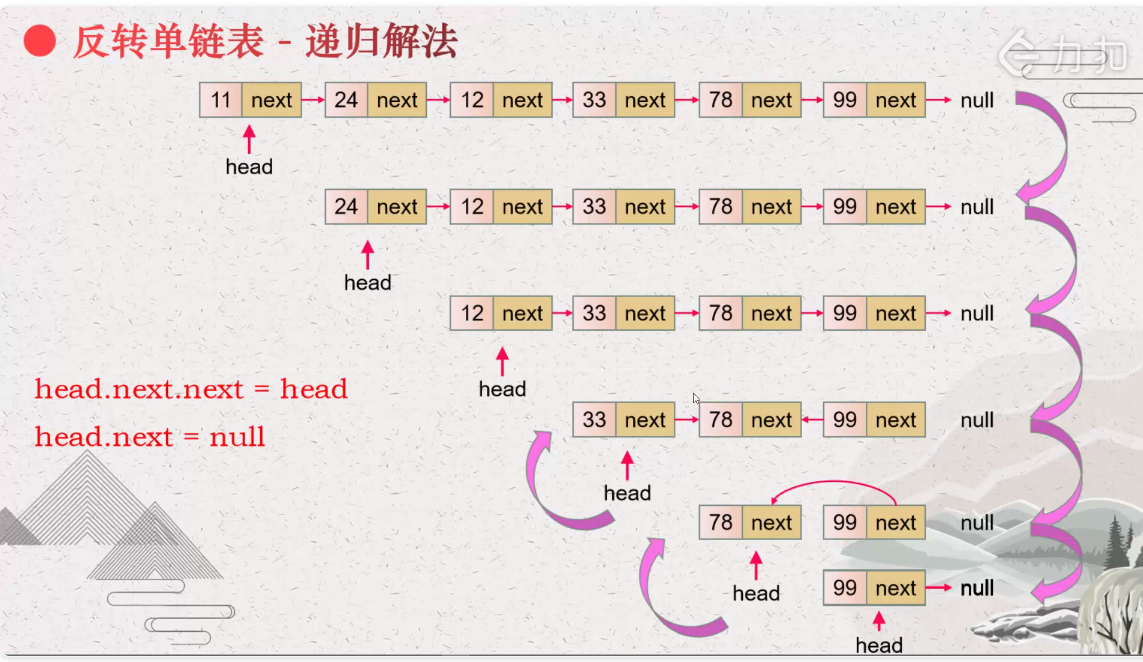
206:反转一个单链表。 示例:
1 2 输入: 1->2->3->4->5->NULL 输出: 5->4->3->2->1->NULL
1 2 3 4 5 6 7 8 9 struct ListNode* reverseList (struct ListNode* head) { if (head == NULL || head->next == NULL ) { return head; } struct ListNode * newHead = head->next->next = head; head->next = NULL ; return newHead; }
687:最长同值路径 给定一个二叉树,找到最长的路径,这个路径中的每个节点具有相同值。 这条路径可以经过也可以不经过根节点。
注意:两个节点之间的路径长度由它们之间的边数表示。
示例 1:
输入:
5
/ \
4 5
/ \ \
1 1 5
输出:
输入:
1
/ \
4 5
/ \ \
4 4 5
输出:
代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution { int ans = 0 ; public int longestUnivaluePath (TreeNode root) { dfs(root); return ans; } public int dfs (TreeNode node) { if (node == null ) return 0 ; int left = dfs(node.left); int right = dfs(node.right); int arrowLeft = 0 , arrowRight = 0 ; if (node.left != null && node.left.val == node.val) arrowLeft += left + 1 ; if (node.left != null && node.left.val == node.val) arrowRight += right + 1 ; ans = Math.max(ans, arrowLeft + arrowRight); return Math.max(arrowLeft, arrowRight); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 #define MAX(a, b) ((a) > (b) ? (a) : (b)) int Dfs (struct TreeNode *root, int *maxDep, int value) { if (root == NULL ) { return 0 ; } int leftDep = Dfs(root->left, maxDep, root->val); int rightDep = Dfs(root->right, maxDep, root->val); *maxDep = MAX(*maxDep, leftDep + rightDep); if (root->val == value) { return MAX(leftDep, rightDep) + 1 ; } else { return 0 ; } } int longestUnivaluePath (struct TreeNode *root) { if (root == NULL ) { return 0 ; } int maxDep = 0 ; Dfs(root, &maxDep, root->val); return maxDep; }
**分治法 ** Divide & Conquer
分治法所能解决的问题一般具有以下几个特征:
该问题的规模缩小到一定的程度就可以容易地解决
该问题可以分解为若干个规模较小的相同问题,即该问题具有最优子结构性质。(前提)
利用该问题分解出的子问题的解可以合并为该问题的解;(分治的关键,如果不具备,可以考虑贪心算法和动态规划)
该问题所分解出的各个子问题是相互独立的,即子问题之间不包含公共的子子问题。(关系分治的效率,如果要反复求解公共子问题,用动态规划较好)
分治法在每一层递归上都有三个步骤:
step1 分解 :将原问题分解为若干个规模较小,相互独立,与原问题形式相同的子问题;
step2 解决 :若子问题规模较小而容易被解决则直接解,否则递归地解各个子问题
step3 合并 :将各个子问题的解合并为原问题的解。
分治法的复杂性分析
一个分治法将规模为n 的问题分成k个规模为n/m 的子问题去解。设分解阀值n0=1,且adhoc解规模为1的问题耗费1个单位时间。再设将原问题分解为k个子问题以及用merge将k个子问题的解**合并为原问题的解需用f(n)**个单位时间。用T(n)表示该分治法解规模为|P|=n的问题所需的计算时间,则有:
T(n)= k T(n/m)+f(n)
169.多数元素 给定一个大小为 n 的数组,找到其中的多数元素。多数元素是指在数组中出现次数 大于 ⌊ n/2 ⌋ 的元素。
你可以假设数组是非空的,并且给定的数组总是存在多数元素。
思路:
如果数 a 是数组 nums 的众数,如果我们将 nums 分成两部分,那么 a 必定是至少一部分的众数。
这样以来,我们就可以使用分治法解决这个问题:将数组分成左右两部分,分别求出左半部分的众数 a1 以及右半部分的众数 a2,随后在 a1 和 a2 中选出正确的众数。
算法:
我们使用分治算法递归求解,直到所有的子问题都是长度为 1 的数组。长度为 1 的子数组中唯一的数显然是众数,直接返回即可。如果回溯后某区间的长度大于 1,我们必须将左右子区间的值合并。如果它们的众数相同,那么显然这一段区间的众数是它们相同的值。否则,我们需要比较两个众数在整个区间内出现的次数来决定该区间的众数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution { private int countInRange (int [] nums, int num, int lo, int hi) { int count = 0 ; for (int i = lo; i <= hi; i++) if (nums[i] == num) count++; return count; } private int majorityElementRec (int [] nums, int lo, int hi) { if (lo == hi) { return nums[lo]; } int mid = (hi - lo) / 2 + lo; int left = majorityElementRec(nums, lo, mid); int right = majorityElementRec(nums, mid + 1 , hi); if (left == right) { return left; } int leftCount = countInRange(nums, left, lo, hi); int rightCount = countInRange(nums, right, lo, hi); return leftCount > rightCount ? left : right; } public int majorityElement (int [] nums) { return majorityElementRec(nums, 0 , nums.length - 1 ); } }
53.最大子序和 给定一个整数数组 nums ,找到一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。
1 2 3 4 5 6 7 8 9 10 11 class Solution { public int maxSubArray (int [] nums) { int pre = 0 , maxAns = nums[0 ]; for (int x : nums) { pre = Math.max(pre + x, x); maxAns = Math.max(maxAns, pre); } return maxAns; } }
**回溯法 ** Backtracking
常见问题:
排列问题,讲究顺序,因此已经选过的元素还有可能再次被选中放置在不同的位置上,构成不同的排列;
组合问题与子集问题,因为不计算元素顺序,一个元素选还是没有选过很重要,因此需要设置搜索起点,搜索起点之前的元素不再考虑,这样才能做到不重不漏;
切割问题:如 给一字符串返回符合条件的子串
棋盘问题:如 N皇后,解数独
编码之前先根据具体的用例画出树形图,图和代码是一 一对应的关系,先画图再编码是不错的方式;
22.括号生成 数字 n 代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。
有效括号组合需满足:左括号必须以正确的顺序闭合。
1 2 输入:n = 3 输出:["((()))","(()())","(())()","()(())","()()()"]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution { List<String> res = new ArrayList <>(); public List<String> generateParenthesis (int n) { if (n <= 0 ){ return res; } getParenthesis("" ,n,n); return res; } private void getParenthesis (String str,int left, int right) { if (left == 0 && right == 0 ){ res.add(str); return ; } if (left == right){ getParenthesis(str+"(" ,left-1 ,right); }else if (left < right){ if (left > 0 ){ getParenthesis(str+"(" ,left-1 ,right); } getParenthesis(str+")" ,left,right-1 ); } } } }
77.组合 给定两个整数 n 和 k,返回范围 [1, n] 中所有可能的 k 个数的组合。
你可以按 任何顺序 返回答案。
1 2 3 输入:n = 4 , k = 2 输出: [[2 ,4 ],[3 ,4 ],[2 ,3 ],[1 ,2 ],[1 ,3 ],[1 ,4 ],]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution { List<List<Integer>> res = new ArrayList <>(); public void backtrack (Deque<Integer> a, int n, int n1, int k, int k1) { if (k1 == k) { res.add(new ArrayList <>(a)); return ; } for (; n1 <= n; n1++) { a.add(n1); backtrack(a, n, n1 + 1 , k, k1 + 1 ); a.removeLast(); } } public List<List<Integer>> combine (int n, int k) { Deque<Integer> stack = new ArrayDeque <>(); backtrack(stack, n, 1 , k, 0 ); return res; } }
78.子集 给你一个整数数组 nums ,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。
解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。
1 2 输入:nums = [1,2,3] 输出:[[],[1],[2],[1,2],[3],[1,3],[2,3],[1,2,3]]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class Solution { List<List<Integer>> res = new ArrayList <>(); public void backtrack (Deque<Integer> a, int [] nums, int n, int m) { if (m > n) { return ; } for (; m <= n; m++) { a.add(nums[m]); res.add(new ArrayList <>(a)); backtrack(a, nums, n, m + 1 ); a.removeLast(); } } public List<List<Integer>> subsets (int [] nums) { Deque<Integer> a = new ArrayDeque <>(); int n = nums.length - 1 ; res.add(new ArrayList <>(a)); backtrack(a, nums, n, 0 ); return res; } }
46.全排列 给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。
1 2 输入:nums = [1,2,3] 输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Solution { List<List<Integer>> res = new ArrayList <>(); public void backtrack (Deque<Integer> a, int [] nums, int [] ind, int n) { if (a.size() == n) { res.add(new ArrayList <>(a)); return ; } for (int i = 0 ; i < n; i++) { if (ind[i] == 1 ) continue ; a.add(nums[i]); ind[i] = 1 ; backtrack(a, nums, ind, n); ind[i] = 0 ; a.removeLast(); } } public List<List<Integer>> permute (int [] nums) { if (nums == null ) return res; Deque<Integer> a = new ArrayDeque <>(); int n = nums.length; int [] ind = new int [n]; backtrack(a, nums, ind, n); return res; } }
深度优先搜索 DFS深度优先搜索属于图算法的一种,英文缩写为DFS即Depth First Search。其过程简要来说是对每一个可能的分支路径深入到不能再深入为止,再返回至最近的分支进行搜索,而且每个节点只能访问一次。
常用栈 或 递归 实现
200.岛屿数量 给你一个由 ‘1’(陆地)和 ‘0’(水)组成的的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例:
1 2 3 4 5 6 7 输入:grid = [ ["1","1","0","0","0"], ["1","1","0","0","0"], ["0","0","1","0","0"], ["0","0","0","1","1"] ] 输出:3
代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution { public void dfs (char [][] grid, int i, int j, int width, int length) { if (grid[i][j] == '0' ) return ; grid[i][j] = '0' ; if (j > 0 ) dfs(grid, i, j - 1 , width, length); if (j < length - 1 ) dfs(grid, i, j + 1 , width, length); if (i > 0 ) dfs(grid, i - 1 , j, width, length); if (i < width - 1 ) dfs(grid, i + 1 , j, width, length); } public int numIslands (char [][] grid) { if (grid == null || grid.length == 0 ) { return 0 ; } int ans = 0 ; int length = grid[0 ].length, width = grid.length; for (int i = 0 ; i < width; i++) for (int j = 0 ; j < length; j++) { if (grid[i][j] == '1' ) { ans += 1 ; dfs(grid, i, j, width, length); } } return ans; } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 void searchLand_DFS (char **grid, int rowSize, int colSize,int row, int col) { grid[row][col] = '0' ; if ((col + 1 < colSize) && (grid[row][col + 1 ] == '1' )){ searchLand_DFS(grid,rowSize,colSize,row,col + 1 ); } if ((row + 1 < rowSize) && (grid[row + 1 ][col] == '1' )){ searchLand_DFS(grid, rowSize, colSize, row + 1 , col); } if ((row - 1 >= 0 ) && (grid[row - 1 ][col] == '1' )){ searchLand_DFS(grid, rowSize, colSize, row - 1 , col); } if ((col - 1 >= 0 ) && (grid[row][col - 1 ] == '1' )){ searchLand_DFS(grid, rowSize,colSize, row, col - 1 ); } } int numIslands (char ** grid, int gridSize, int * gridColSize) { int result = 0 ; for (int i = 0 ; i < gridSize; i++){ for (int j = 0 ;j <gridColSize[0 ]; j++){ if (grid[i][j] == '1' ){ searchLand_DFS(grid,gridSize, gridColSize[0 ],i,j); result += 1 ; } } } return result; }
938.二叉搜索树的范围和 给定二叉搜索树的根结点 root,返回值位于范围 [low, high]
1 2 输入:root = [10,5,15,3,7,null,18], low = 7, high = 15 输出:32
代码:(这里利用了递归实现深度优先搜索,下面两种代码一样)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 int rangeSumBST (struct TreeNode *root, int low, int high) { if (root == NULL ) return 0 ; if (root->val > high){ return rangeSumBST(root->left,low,high); } if (root->val < low ){ return rangeSumBST(root->right,low,high); } return root->val + rangeSumBST(root->left,low,high) + rangeSumBST(root->right,low,high); }
1 2 3 4 5 6 7 8 int rangeSumBST (struct TreeNode* root, int L, int R) { if (root == NULL ) return 0 ; int sum = rangeSumBST(root ->left,L,R) + rangeSumBST (root -> right,L,R); if (root ->val <= R && root ->val >= L) sum += root ->val; return sum; }
547.省份数量 有 n 个城市,其中一些彼此相连,另一些没有相连。如果城市 a 与城市 b 直接相连,且城市 b 与城市 c 直接相连,那么城市 a 与城市 c 间接相连。
省份 是一组直接或间接相连的城市,组内不含其他没有相连的城市。
给你一个 n x n 的矩阵 isConnected ,其中 isConnected[i] [j] = 1 表示第 i 个城市和第 j 个城市直接相连,而 isConnected[i] [j] = 0 表示二者不直接相连。
返回矩阵中 省份 的数量。
1 2 3 输入: isConnected = [[1,1,0],[1,1,0],[0,0,1]] 输出:2
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution { public int findCircleNum (int [][] isConnected) { int n = isConnected.length; boolean [] visited = new boolean [n]; int ans = 0 ; for (int i = 0 ; i < n; i++){ if (!visited[i]){ dfs(isConnected, visited, n, i); ans++; } } return ans; } public void dfs (int [][] isConnected, boolean [] visited, int n, int i) { for (int j = 0 ; j < n; j++){ if (isConnected[i][j] == 1 && !visited[j]){ visited[j] = true ; dfs(isConnected, visited, n, j); } } } }
方格分割 有一个6x6的方格,沿着格子的边线剪开成两部分。要求这两部分的形状完全相同。如:
注意:旋转对称的属于同一种分割法。
题解:
我们从中心点开始搜索,每次可以走四个方向。搜索的过程要将中心对称点顺便标记
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 int dx[4 ] = {1 , 0 , -1 , 0 }, dy[4 ] = {0 , 1 , 0 , -1 };int ans = 0 ;int map [7 ][7 ] = {0 };void DFS (int x, int y) { if (x == 0 || y == 0 || x == 6 || y == 6 ){ ans++; return ; } for (int i = 0 ; i < 4 ; ++i){ int xx = x + dx[i]; int yy = y + dy[i]; if (map [xx][yy] == 0 ){ map [xx][yy] = 1 ; map [6 - xx][6 - yy] = 1 ; DFS(xx,yy); map [xx][yy] = 0 ; map [6 - xx][6 - yy] = 0 ; } } } int main () { map [3 ][3 ] = 1 ; DFS(3 , 3 ); printf ("%d" ,ans/4 ); return 0 ; }
广度优先搜索 BFS107.二叉树的层序遍历 给定一个二叉树,返回其节点值自底向上的层序遍历。 (即按从叶子节点所在层到根节点所在的层,逐层从左向右遍历)
1 2 3 4 5 6 7 例:给定二叉树 [3,9,20,null,null,15,7], 返回结果: [ [15,7], [9,20], [3] ]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 class Solution { public class TreeNode { int val; TreeNode left; TreeNode right; TreeNode() { } TreeNode(int val) { this .val = val; } TreeNode(int val, TreeNode left, TreeNode right) { this .val = val; this .left = left; this .right = right; } } public List<List<Integer>> levelOrder (TreeNode root) { Deque<TreeNode> queue = new ArrayDeque <>(); List<List<Integer>> ret = new ArrayList <>(); if (root == null ) { return ret; } queue.add(root); while (!queue.isEmpty()) { int n = queue.size(); List<Integer> tempNums = new ArrayList <>(); for (int i = 0 ; i < n; i++) { TreeNode temp = queue.poll(); tempNums.add(temp.val); if (temp.left != null ) { queue.add(temp.left); } if (temp.right != null ) { queue.add(temp.right); } } ret.add(tempNums); } Collections.reverse(ret); return ret; } }
200.岛屿数量 给你一个由 ‘1’(陆地)和 ‘0’(水)组成的的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例:
1 2 3 4 5 6 7 输入:grid = [ ["1","1","0","0","0"], ["1","1","0","0","0"], ["0","0","1","0","0"], ["0","0","0","1","1"] ] 输出:3
代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution { public int numIslands (char [][] grid) { int count = 0 ; for (int i = 0 ; i < grid.length; i++) { for (int j = 0 ; j < grid[0 ].length; j++) { if (grid[i][j] == '1' ){ bfs(grid, i, j); count++; } } } return count; } private void bfs (char [][] grid, int i, int j) { Queue<int []> list = new LinkedList <>(); list.add(new int [] { i, j }); while (!list.isEmpty()){ int [] cur = list.remove(); i = cur[0 ]; j = cur[1 ]; if (0 <= i && i < grid.length && 0 <= j && j < grid[0 ].length && grid[i][j] == '1' ) { grid[i][j] = '0' ; list.add(new int [] { i + 1 , j }); list.add(new int [] { i - 1 , j }); list.add(new int [] { i, j + 1 }); list.add(new int [] { i, j - 1 }); } } } }
547.省份数量 有 n 个城市,其中一些彼此相连,另一些没有相连。如果城市 a 与城市 b 直接相连,且城市 b 与城市 c 直接相连,那么城市 a 与城市 c 间接相连。
省份 是一组直接或间接相连的城市,组内不含其他没有相连的城市。
给你一个 n x n 的矩阵 isConnected ,其中 isConnected[i][j] = 1 表示第 i 个城市和第 j 个城市直接相连,而 isConnected[i][j] = 0 表示二者不直接相连。
返回矩阵中 省份 的数量。
1 2 3 输入: isConnected = [[1,1,0],[1,1,0],[0,0,1]] 输出:2
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 import java.util.ArrayDeque;import java.util.Deque;public class Solution { public int findCircleNum (int [][] isConnected) { int n = isConnected.length; int ans = 0 ; int [] visits = new int [n]; Deque<Integer> q = new ArrayDeque <>(); for (int i = 0 ; i < n; i++) { if (visits[i] == 0 ) { q.add(i); while (!q.isEmpty()) { int j = q.poll(); visits[j] = 1 ; for (int k = 0 ; k < n; k++) { if (isConnected[j][k] == 1 && visits[k] == 0 ) q.add(k); } } } ans++; } return ans; } }
**并查集 ** Union Find
并查集主要解决集合问题, 问两个节点是否属于一个集合中。
并查集算法有比较固定的套路模板:
首先有一个并查集,存放各元素放在的集合(元素的根节点),然后使用union,find两个步骤将所有元素分为若干集合。
union:将两个元素合并为一个根节点(加入到同一个集合)。
find:找到某个元素的根节点。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class UnionFind { int [] parent; public UnionFind (int n) { parent = new int [n]; for (int i = 0 ; i < n; ++i) { parent[i] = i; } } public void union ( int index1, int index2) { parent[find(index1)] = find(index2); } public int find (int index) { if (parent[index] != index) { parent[index] = find(parent[index]); } return parent[index]; } }
200.岛屿数量 给你一个由 ‘1’(陆地)和 ‘0’(水)组成的的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例:
1 2 3 4 5 6 7 输入:grid = [ ["1","1","0","0","0"], ["1","1","0","0","0"], ["0","0","1","0","0"], ["0","0","0","1","1"] ] 输出:3
代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 public class Solution { public int numIslands (char [][] grid) { int rows = grid.length; if (rows == 0 ) { return 0 ; } int cols = grid[0 ].length; if (cols == 0 ) { return 0 ; } int [][] directions = new int [][]{{0 , 1 }, {1 , 0 }}; int size = rows * cols; UnionFind unionFind = new UnionFind (size + 1 ); for (int i = 0 ; i < rows; i++) { for (int j = 0 ; j < cols; j++) { if (grid[i][j] == '1' ) { for (int [] direction : directions) { int newX = i + direction[0 ]; int newY = j + direction[1 ]; if (inArea(newX, newY, rows, cols) && grid[newX][newY] == '1' ) { unionFind.union(getIndex(i, j, cols), getIndex(newX, newY, cols)); } } } else { unionFind.union(getIndex(i, j, cols), size); } } } return unionFind.getCount() - 1 ; } private class UnionFind { private int [] parent; private int count; public UnionFind (int n) { count = n; parent = new int [n]; for (int i = 0 ; i < n; i++) { parent[i] = i; } } public int find (int x) { while (x != parent[x]) { parent[x] = parent[parent[x]]; x = parent[x]; } return x; } public void union (int x, int y) { int rootX = find(x); int rootY = find(y); if (rootX == rootY) { return ; } parent[rootX] = rootY; count--; } public int getCount () { return count; } } private boolean inArea (int x, int y, int rows, int cols) { return x >= 0 && x < rows && y >= 0 && y < cols; } private int getIndex (int x, int y, int cols) { return x * cols + y; } }
547.省份数量 有 n 个城市,其中一些彼此相连,另一些没有相连。如果城市 a 与城市 b 直接相连,且城市 b 与城市 c 直接相连,那么城市 a 与城市 c 间接相连。
省份 是一组直接或间接相连的城市,组内不含其他没有相连的城市。
给你一个 n x n 的矩阵 isConnected ,其中 isConnected[i][j] = 1 表示第 i 个城市和第 j 个城市直接相连,而 isConnected[i][j] = 0 表示二者不直接相连。
返回矩阵中 省份 的数量。
1 2 3 输入: isConnected = [[1,1,0],[1,1,0],[0,0,1]] 输出:2
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Solution { public int findCircleNum (int [][] isConnected) { int n = isConnected.length; int [] parent = new int [n]; for (int i = 0 ; i < n; i++){ parent[i] = i; } for (int i = 0 ; i < n; i++) { for (int j = i + 1 ; j < n; j++) if (isConnected[i][j] == 1 ) union(parent, i, j); } int ans = 0 ; for (int i = 0 ; i < n; i++){ if (parent[i] == i) ans++; } return ans; } public void union (int [] parent, int i, int j) { parent[find(parent, i)] = find(parent, j); } public int find (int [] parent, int index) { if (parent[index] != index) parent[index] = find(parent, parent[index]); return parent[index]; } }
721.账户合并 给定一个列表 accounts,每个元素 accounts[i] 是一个字符串列表,其中第一个元素 accounts[i][0] 是 名称 (name),其余元素是 emails 表示该账户的邮箱地址。
现在,我们想合并这些账户。如果两个账户都有一些共同的邮箱地址,则两个账户必定属于同一个人。请注意,即使两个账户具有相同的名称,它们也可能属于不同的人,因为人们可能具有相同的名称。一个人最初可以拥有任意数量的账户,但其所有账户都具有相同的名称。
合并账户后,按以下格式返回账户:每个账户的第一个元素是名称,其余元素是 按字符 ASCII 顺序排列 的邮箱地址。账户本身可以以 任意顺序 返回。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 示例: 输入:accounts = [ ["John" , "johnsmith@mail.com" , "john00@mail.com" ], ["John" , "johnnybravo@mail.com" ], ["John" , "johnsmith@mail.com" , "john_newyork@mail.com" ], ["Mary" , "mary@mail.com" ] ] 输出:[ ["John" , 'john00@mail.com' , 'john_newyork@mail.com' , 'johnsmith@mail.com' ], ["John" , "johnnybravo@mail.com" ], ["Mary" , "mary@mail.com" ] ] 解释: 第一个和第三个 John 是同一个人,因为他们有共同的邮箱地址 "johnsmith@mail.com" 。 第二个 John 和 Mary 是不同的人,因为他们的邮箱地址没有被其他帐户使用。 (可以以任何顺序返回这些列表)
根据题意可知:
存在相同邮箱的账号一定属于同一个人
名称相同的账户不一定属于同一个人
思路: 使用邮箱是否相同来判断是否为同一人。
这样建立并查集就比较简单了:
先初始化每个账户为1个连通分量
遍历每个账户下的邮箱,判断该邮箱是否在其他账户下出现
如果未出现,继续
如果账户A、B下出现了相同的邮箱email,那么将账户A和账户B两个连通分量进行合并
最后遍历并查集中每个连通分量,将所有连通分量内部账户的邮箱全部合并(相同的去重,不同的合并)
结束
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 class Solution { public List<List<String>> accountsMerge (List<List<String>> accounts) { Map<String, Integer> emailToId = new HashMap <>(); int n = accounts.size(); UnionFind myUnion = new UnionFind (n); for (int i = 0 ; i < n; i++){ int num = accounts.get(i).size(); for (int j = 1 ; j < num; j++){ String curEmail = accounts.get(i).get(j); if (!emailToId.containsKey(curEmail)){ emailToId.put(curEmail, i); }else { myUnion.union(i, emailToId.get(curEmail)); } } } Map<Integer, List<String>> idToEmails = new HashMap <>(); for (Map.Entry<String, Integer> entry : emailToId.entrySet()){ int id = myUnion.find(entry.getValue()); List<String> emails = idToEmails.getOrDefault(id, new ArrayList <>()); emails.add(entry.getKey()); idToEmails.put(id,emails); } List<List<String>> res = new ArrayList <>(); for (Map.Entry<Integer, List<String>> entry : idToEmails.entrySet()){ List<String> emails = entry.getValue(); Collections.sort(emails); List<String> tmp = new ArrayList <>(); tmp.add(accounts.get(entry.getKey()).get(0 )); tmp.addAll(emails); res.add(tmp); } return res; } } class UnionFind { int [] parent; public UnionFind (int n) { parent = new int [n]; for (int i = 0 ; i < n; i++) { parent[i] = i; } } public void union (int index1, int index2) { parent[find(index2)] = find(index1); } public int find (int index) { if (parent[index] != index) { parent[index] = find(parent[index]); } return parent[index]; } }
贪心算法 Greedy
55.跳跃游戏 给定一个非负整数数组 nums ,你最初位于数组的 第一个下标 。
数组中的每个元素代表你在该位置可以跳跃的最大长度 。
判断你是否能够到达最后一个下标。
1 2 3 4 5 6 7 8 示例: 输入:nums = [2,3,1,1,4] 输出:true 解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。 输入:nums = [3,2,1,0,4] 输出:false 解释:无论怎样,总会到达下标为 3 的位置。但该下标的最大跳跃长度是 0 , 所以永远不可能到达最后一个下标。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution { public boolean canJump (int [] nums) { int n = nums.length; int far = 0 ; for (int i = 0 ; i < n; i++) { if (i <= far) { far = Math.max(far, nums[i] + i); if (far >= n - 1 ) { return true ; } } } return false ; } }
**记忆化搜索 ** Menory Search
**动态规划 ** Dynamic Programming
动态规划 :先将问题分解为子问题,并且对于这些分解的子问题自身是最优的才能在这个基础上得出我们要解决的问题的最优方案.与贪心算法不同之处 在于,贪心算法是从局部最优来解决问题,而动态规划则是从全局最优来解决问题,当对情况及条件加以限制时,贪心算法会因目光短浅而得到错误答案。记忆化搜索 =搜索的形式+动态规划的思想
联系
dp和ms 原理都是相同的,只是实现方法不同
1、DP是从下向上,而记忆化搜索是从上向下的
2、DP是从下向上,为了求到最终结果需要把过程中所有的值都保存下来,以便下一步可能会使用,而因为记忆化搜索是从上向下的,所以求解过程求的都是需要的;也就是说不需要的值并没有求
3、记忆化搜索使用递归实现的;
如果一个dp[i] [j]的值已经求过,使用DP直接调用即可;而使用记忆化搜索则要进入递归
如果一个dp[i] [j]的值还未求过,使用DP直接求得,而使用记忆化搜索则要进入递归中去求,而这个递归很有可能是多重的
这样一来DP在时间上几乎总是优于记忆化搜索的
322.零钱兑换 给定不同面额的硬币 coins 和一个总金额 amount。编写一个函数来计算可以凑成总金额所需的最少的硬币个数。如果没有任何一种硬币组合能组成总金额,返回 -1。
你可以认为每种硬币的数量是无限的。
示例 1:
1 2 3 输入:coins = [1, 2, 5], amount = 11 输出:3 解释:11 = 5 + 5 + 1
解答:
我们采用自下而上的方式进行思考。定义 F(i) 为组成金额 i 所需最少的硬币数量,假设在计算 F(i)之前,我们已经计算出 F(0) - F(i-1) 的答案。 则 F(i) 对应的转移方程应为
F(i) = min [ F ( i - cj ) ] + 1
{ cj 表示第 j 枚硬币的面值,即我们枚举最后一枚硬币时,需要从 i - cj 这个金额状态 F ( i - cj ) 转移过来,也就是求出 F( i - cj ) 所需的硬币数量,再加1 }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 int coinChange (int *coins, int coinsSize, int amount) { int dp[amount + 1 ]; dp[0 ] = 0 ; for (int i = 1 ; i < amount + 1 ; i++) { dp[i] = amount + 1 ; for (int j = 0 ; j < coinsSize; j++) { if (i >= coins[j]) { dp[i] = (dp[i - coins[j]] + 1 ) < dp[i] ? (dp[i - coins[j]] + 1 ) : dp[i]; } } } return dp[amount] < amount + 1 ? dp[amount] : -1 ; }
121.买卖股票的最佳时机 给定一个数组 prices ,它的第 i 个元素 prices[i] 表示一支给定股票第 i 天的价格。
你只能选择 某一天 买入这只股票,并选择在 未来的某一个不同的日子 卖出该股票。设计一个算法来计算你所能获取的最大利润。
返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回 0 。
1 2 3 4 输入:[7,1,5,3,6,4] 输出:5 解释:在第 2 天(股票价格 = 1)的时候买入,在第 5 天(股票价格 = 6)的时候卖出,最大利润 = 6-1 = 5 。 注意利润不能是 7-1 = 6, 因为卖出价格需要大于买入价格;同时,你不能在买入前卖出股票。
假如计划在第 i 天卖出股票,那么最大利润的差值一定是在[0, i-1] 之间选最低点买入;所以遍历数组,依次求每个卖出时机的的最大差值,再从中取最大值。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 int maxProfit (int * prices, int pricesSize) { int minprice=0xFFFFFF ; int maxret =0 ; for (int i =0 ;i<pricesSize;i++){ if (prices[i] < minprice){ minprice = prices[i]; }else { maxret = (prices[i]-minprice)>maxret ? prices[i]-minprice:maxret; } } return maxret; }
70.爬楼梯 假设你正在爬楼梯。需要 n 阶你才能到达楼顶。
每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢?
注意: 给定 n 是一个正整数。
1 2 3 4 5 输入: 2 输出: 2 解释: 有两种方法可以爬到楼顶。 1. 1 阶 + 1 阶 2. 2 阶
解题思路与斐波那契一致;
1 2 3 4 5 6 7 8 9 10 int climbStairs (int n) { int a = 0 , b = 0 ,c = 1 ; for (int i = 1 ; i <= n; ++i){ a = b; b = c; c = a + b; } return c; }
62.不同路径 一个机器人位于一个 m x n 网格的左上角 。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角。
问总共有多少条不同的路径?
动态规划转移方程:
f(i, j) = f(i-1, j) + f(i, j-1)
注:网格的边界,它们的值均为 1。
1 2 3 4 5 6 7 8 9 10 11 12 13 int uniquePaths (int m, int n) { int nums[m][n]; for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (i == 0 || j == 0 ) { nums[i][j] = 1 ; } else nums[i][j] = nums[i - 1 ][j] + nums[i][j - 1 ]; } } return nums[m - 1 ][n - 1 ]; }
221.最大正方形 在一个由 '0' 和 '1' 组成的二维矩阵内,找到只包含 '1' 的最大正方形,并返回其面积。
1 2 3 4 5 6 输入:matrix = [ ["1","0","1","0","0"], ["1","0","1","1","1"], ["1","1","1","1","1"], ["1","0","0","1","0"]] 输出:4
用dp ( i , j ) 表示以 ( i, j ) 为右下角,且只包含 1 的正方形的边长最大值。
如果该位置的值是 0,则dp( i , j )=0,因为当前位置不可能在由 1 组成的正方形中;
如果该位置的值是 1,则 dp( i , j ) 的值由其上方、左方和左上方的三个相邻位置的dp( i , j ) 值决定。具体而言,当前位置的元素值等于三个相邻位置的元素中的最小值加 1,状态转移方程如下:
dp(i, j)=min( dp(i−1, j), dp(i−1, j−1), dp(i, j−1) )+1
1 2 3 4 5 6 7 8 9 10 11 12 13 #define MIN(a,b,c) ((a)<(b)?( (a)<(c)?(a):(c) ):( (b)<(c)?(b):(c) )) int maximalSquare (char ** matrix, int matrixSize, int * matrixColSize) { if (matrixSize == 0 ) return 0 ; int j,k,ms = matrix[0 ][0 ]; for (j=0 ;j<matrixSize;j++){ for (k=0 ;k<matrixColSize[j];k++){ if (matrix[j][k]=='1' && j>0 && k>0 ) matrix[j][k] = MIN(matrix[j-1 ][k],matrix[j][k-1 ],matrix[j-1 ][k-1 ]) + 1 ; if (matrix[j][k] > ms) ms = matrix[j][k]; } } return (ms-'0' )*(ms-'0' ); }
279.完全平方数 给定正整数 n ,找到若干个完全平方数(比如 1, 4, 9, 16, ...)使得它们的和等于 n 。你需要让组成和的完全平方数的个数最少。
给你一个整数 n ,返回和为 n 的完全平方数的 最少数量 。
(完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9 和 16 都是完全平方数,而 3 和 11 不是。)
1 2 3 输入:n = 12 输出:3 解释:12 = 4 + 4 + 4
这是完全背包问题的简单变形:
背包大小即传入的参数n
物品的重量是平方数的值sqr
物品的价值是1,因为我们要求的是数字个数
题目转换为,能用 [1,n] 里的共m个平方数(物品)刚好装满空间为n的背包的所有方法中,产生价值最少的装法。
1 2 3 4 5 记 dp[0. .capa + 1 ] 是备忘录数组 for i = 1 to n for j = weight[i] to capa dp[j] = max( dp[j] , dp[j - weight[i]] + val[i] ) 输出 dp[capa]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 int min (int a,int b) { return a < b ? a : b; } int numSquares (int n) { int *dp = (int *)malloc (sizeof (int )*(n + 1 )); dp[0 ] = 0 ; for (int i = 1 ; i <= n; ++i){ dp[i] = INT_MAX - 1 ; } for (int i = 1 ;i <= n; ++i){ for (int j = 1 ; j*j <= i; ++j){ dp[i] = min(dp[i],dp[i - j*j] + 1 ); } } return dp[n]; }
矩阵 (十一届蓝桥 B组)
把 1 ∼ 2020 放在 2 × 10¹⁰ 的矩阵里。
要求同一行中右边的比左边大,同一列中下边的比上边的大。一共有多少种方案?
答案很大,你只需要给出方案数除以 2020 的余数即可。
题解:(动态规划)
用DP[i] [j]表示第一层有i个数,第二层有j个数有多少种方案
题目要求同一行中右边比左边大, 同一列中下边比上边的大,所以 j <= i
1.当 j < i 时, DP[i] [j]可以用此时少一个数的方案来表示,少一个数可以是DP[i - 1] [j],也可以是DP[i] [j - 1],所以:
DP[i] [j] = DP[i - 1] [j] + DP[i] [j - 1]
2.当 j = i时, 因为要求,所以
DP[i] [j] = DP[i] [j - 1]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #include <stdio.h> int DP[1011 ][1011 ];int main () { int i, j; DP[1 ][0 ] = 1 ; for (i = 1 ; i <= 1010 ; i++) DP[i][0 ] = 1 ; for (i = 1 ; i <= 1010 ; i++) { for (j = 1 ; j <= i; j++) { if (i == j) DP[i][j] = DP[i][j - 1 ]; else DP[i][j] = (DP[i - 1 ][j] + DP[i][j - 1 ]) % 2020 ; } } printf ("%d" , DP[1010 ][1010 ]); return 0 ; }
1 2 3 4 5 6 7 8 9 int main () { f[0 ][0 ] = 1 ; for (int i = 0 ; i <= 1010 ; i ++) for (int j = 0 ; j <= i; j ++){ if (i - 1 >= j) f[i][j] += f[i - 1 ][j] % 2020 ; if (j - 1 >= 0 ) f[i][j] += f[i][j - 1 ] % 2020 ; }
背包问题 背包问题可以描述为:给定一组物品,每种物品都有自己的重量 和价值 ,在限定的总重量 内,如何选择才能使得物品的总价值 最高。
而背包问题还存在需要恰好装满 背包和不需要恰好装满 两种情况
01背包问题(每种物品只有一件,放或者不放)
完全背包问题(每件物品有无限件可用)
多重背包问题(每件物品有n[i]件可用)
01背包问题 题目:
有N件物品和一个容量为V的背包。第i件物品的费用是weight[i],价值是value[i]。求将哪些物品装入背包可使价值总和最大。
”01”的意思是:每种物品仅有一件,放为“1”,不放为“0”。
f [i] [V]=max{ f [i-1] [V] ,f [i-1] [V-weight[i] ]+value[i] }
公式中,即将前 i 件物品放入容量为 V 的背包中:
不放第 i 件:前 i - 1 件物品放入容量为V的背包中,价值为f [i - 1] [V] ;
放第 i 件:前 i - 1 件物品放入剩余容量为 V - weight[i] 的背包中,价值为f [i-1] [V-weight[i] ]+value[i]
1 2 3 4 5 6 7 for (int i = 1 ; i <= N; i++) for (int j = 1 ; j <= V; j++) { if (weight[i] <= j) { f[i][j] = max(f[i - 1 ][j], f[i - 1 ][j - weight[i]] + value[i]); } else f[i][j] = f[i - 1 ][j]; }
还可以将二维数组转化为一维数组,减少空间复杂度:
1 2 3 for (int i = 1 ; i <= N; ++i) for (int j = V; j >= weight[i]; --j) f[j] = max(f[j], f[j - weight[i]] + value[i]);
具体代码:
(在输出的时候,只能输出最后的价值,不能知道选择的物品是哪个。为此,在这里我们定义一个数组x[i],对于每一个物品,如果被选择置为“1”,否则为“0”。)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 #include <stdio.h> #define V 100 int f[10 ][V];int weight[10 ]; int value[10 ]; #define max(x,y) (x)>(y)?(x):(y) int main () { int N,M; freopen("1.txt" ,"r" ,stdin ); scanf ("%d%d" ,&N,&M); for (int i=1 ;i<=N; i++) { scanf ("%d%d" ,&weight[i],&value[i]); } for (int i=1 ; i<=N; i++) for (int j=1 ; j<=M; j++) { if (weight[i]<=j) { f[i][j]=max(f[i-1 ][j],f[i-1 ][j-weight[i]]+value[i]); } else f[i][j]=f[i-1 ][j]; } printf ("%d\n" ,f[N][M]); int j = M; int x[V]; for (int i=N; i>0 ; --i) { if (f[i][j] > f[i-1 ][j]) { x[i-1 ] = 1 ; j = j - weight[i-1 ]; } } for (int i=0 ; i<N; ++i) printf ("%d " , x[i]); }
完全背包问题 题目:
有N件物品和一个容量为V的背包。第i件物品的费用是weight[i],价值是value[i]。每件物品可以无限选用,求将哪些物品装入背包可使价值总和最大。
完全背包问题不设定物品取用上限
对于算法的优化我们可以这样想:一个(即一种) 物品”而这种方式同时也保证了每件物品只选一次。一个(即一种) 物品”时就是单纯的考虑“加选出一个(可能为同一种) 物品”,这样我们就需要考虑选入的物品是已经选入的情况。相比来说,反而简化了代码。
同样,我们假定f [i] [v]为将前i件物品前恰好放入一个容量为V的背包中可获得的最大价值
*f [i] [V]=max{ f [i-1] [V] , f [i-1] [ V-k weight[i] ] + k value[i] } *
( 0<=k*weight[i]<=v,其中0<=k<=V/weight[i+1] )
1 2 3 4 for (int i = 1 ; i <= N; ++i) for (int j = 0 ; j <= M; ++j) for (int k = 0 ; k * weight[i] <= j; ++k) f[i][j] = max(f[i][j], f[i - 1 ][j - k * weight[i]] + k * value[i]);
一维数组:
1 2 3 for (int i = 1 ; i <= N; ++i) for (int j = weight[i]; j <= V; ++j) f[j] = max(f[j], f[j - weight[i]] + value[i]);
具体代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #include <stdio.h> #define V 1500 int f[10 ][V];int weight[10 ]; int value[10 ]; #define max(x,y) (x)>(y)?(x):(y) int main () { int N,M; freopen("1.txt" ,"r" ,stdin ); scanf ("%d%d" ,&N,&M); for (int i=1 ;i<=N; i++) { scanf ("%d%d" ,&weight[i],&value[i]); } for (int i = 1 ; i <= N; ++i) for (int j = 0 ; j <= M; ++j) for (int k = 0 ; k * weight[i] <= j; ++k) f[i][j] = max(f[i][j], f[i - 1 ][j - k * weight[i]] + k * value[i]); printf ("%d" ,f[N][M]); }
多重背包问题 题目:
有N件物品和一个容量为V的背包。第i件物品最多有n[i]个,每个的费用是weight[i],价值是value[i]。每件物品最多可以选用相应的最大个数,求将哪些物品装入背包可使价值总和最大。
1 2 3 4 for (int i = 1 ; i <= N; ++i) for (int j = 0 ; j <= V; ++j) for (int k = 0 ; k <= num[i] && k * weight[i] <= j; ++k) f[i][j] = max(f[i-1 ][j], f[i - 1 ][j - k * weight[i]] + k * value[i]);
一维:
1 2 3 4 for (int i = 1 ; i <= N; ++i) for (int j = V; j >= 0 ; --j) for (int k = 1 ; k <= num[i] && k * weight[i] <= j; ++k) f[j] = max(f[j], f[j - k * weight[i]] + k * value[i]);
具体代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #include <stdio.h> #define V 1500 int f[10 ][V];int weight[10 ]; int value[10 ]; int num[10 ];#define max(x,y) (x)>(y)?(x):(y) int main () { int N,M,cur; freopen("2.txt" ,"r" ,stdin ); scanf ("%d%d" ,&N,&M); for (int i=1 ;i<=N; i++) { scanf ("%d%d%d" ,&weight[i],&value[i],&num[i]); } for (int i = 1 ; i <= N; ++i) for (int j = 0 ; j <= V; ++j) for (int k = 0 ; k <= num[i] && k * weight[i] <= j; ++k) f[i][j] = max(f[i-1 ][j], f[i - 1 ][j - k * weight[i]] + k * value[i]); printf ("%d\n" ,f[N][M]); }
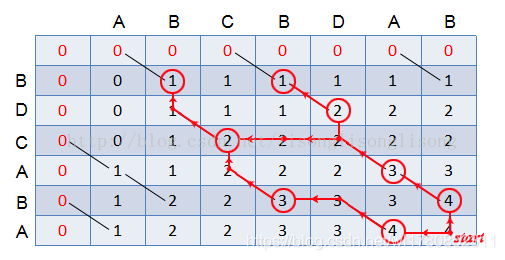
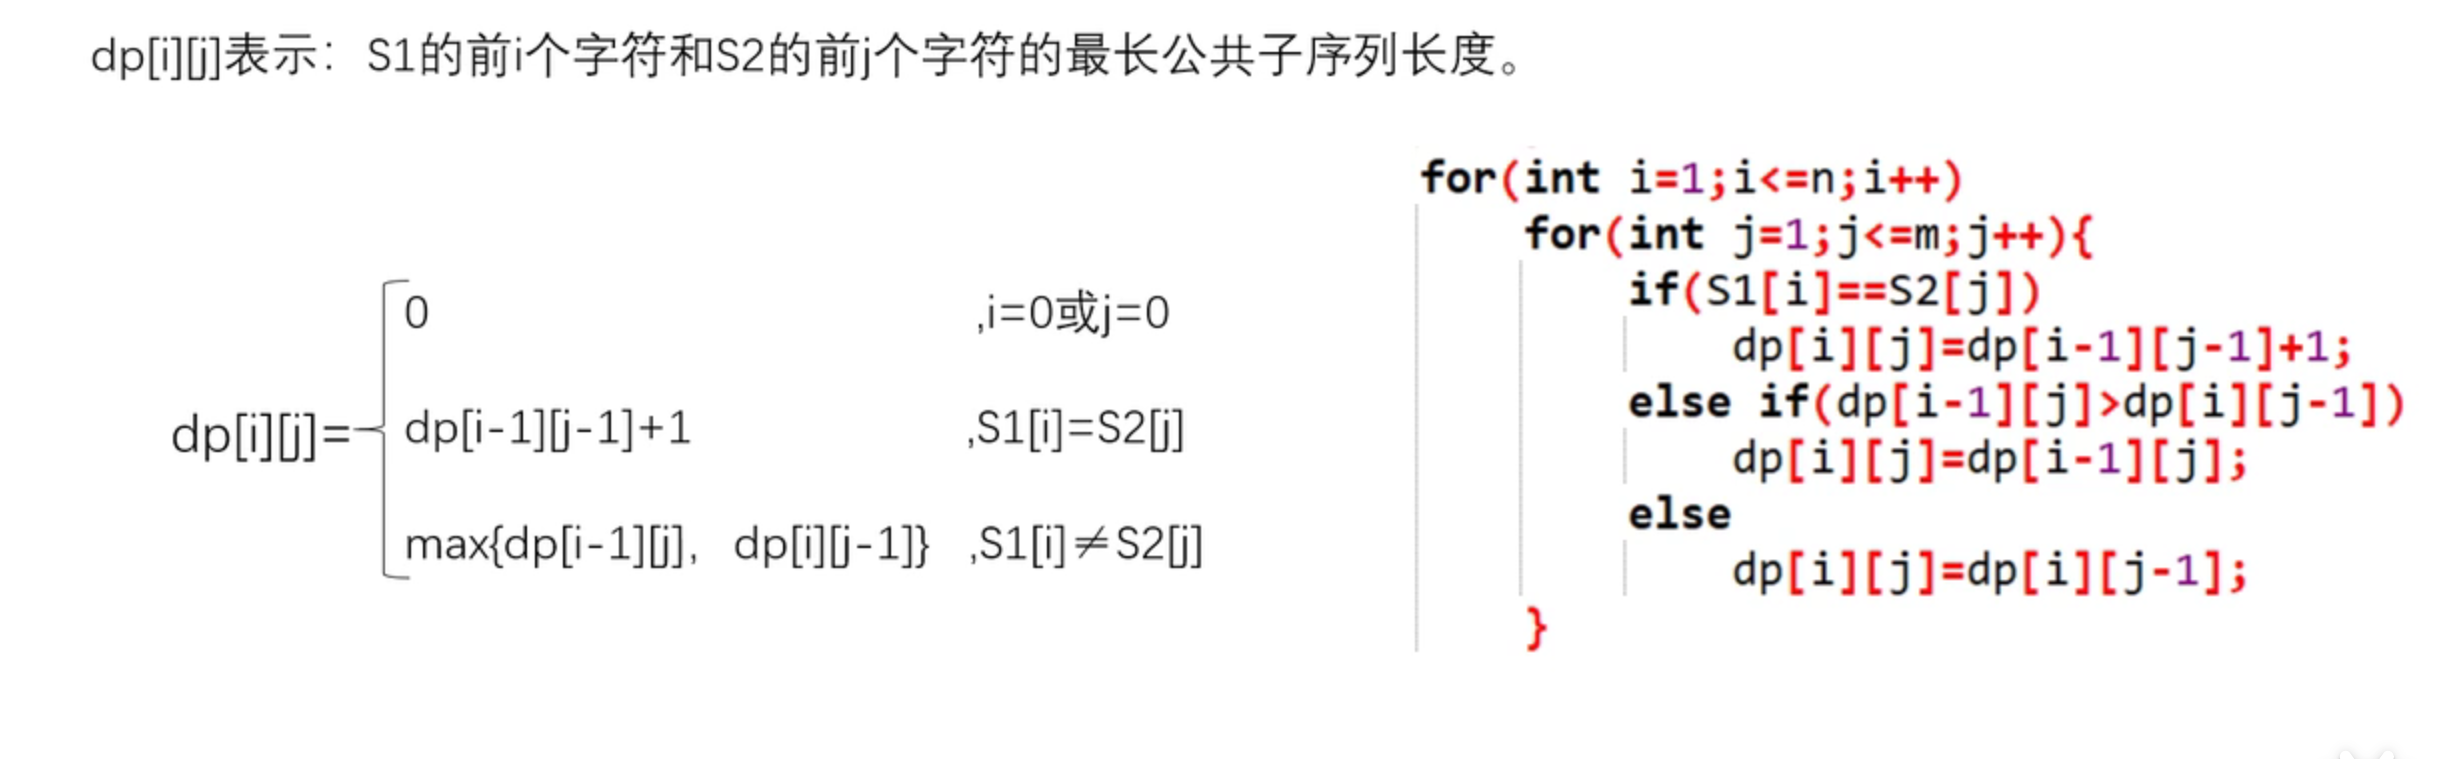
最长公共子序列 LCS :longest common sequence
子序列与子串不同,子序列:将给定序列中零个或多个元素去掉之后得到的结果;子串:给定串中任意个连续的字符组成的子序列称为该串的子串
此问题有最优子结构性质:
设序列S1={x1,x2,……xn}和S2= {y1,y2,……ym}的最长公共子序列为S={z1,z2,……zk},则:
1)若xn=ym,那么zk=xn=ym 且S[k-1]是S1[n-1]和S2[m-1]的最长公共子序列
2)若xn != ym且zk != xn,则S[k]是S1[n-1]和S2[m]的最长公共子序列
2)若xn != ym且zk!=ym,则S[k]是S1[n]和S2[m-1]的最长公共子序列
可见:两个序列的最长公共子序列包含了这两个序列的前缀的最长公共子序列。因此,最长公共子序列具有最优子结构性质,可以用动态规划求解。
递推公式:
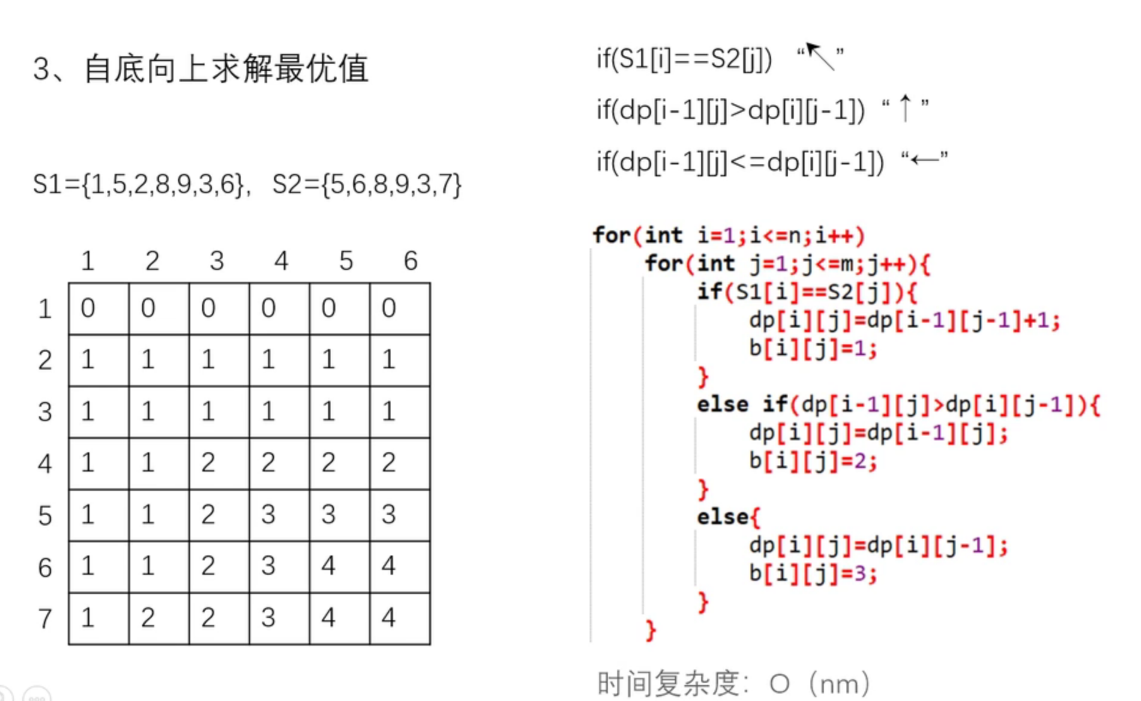
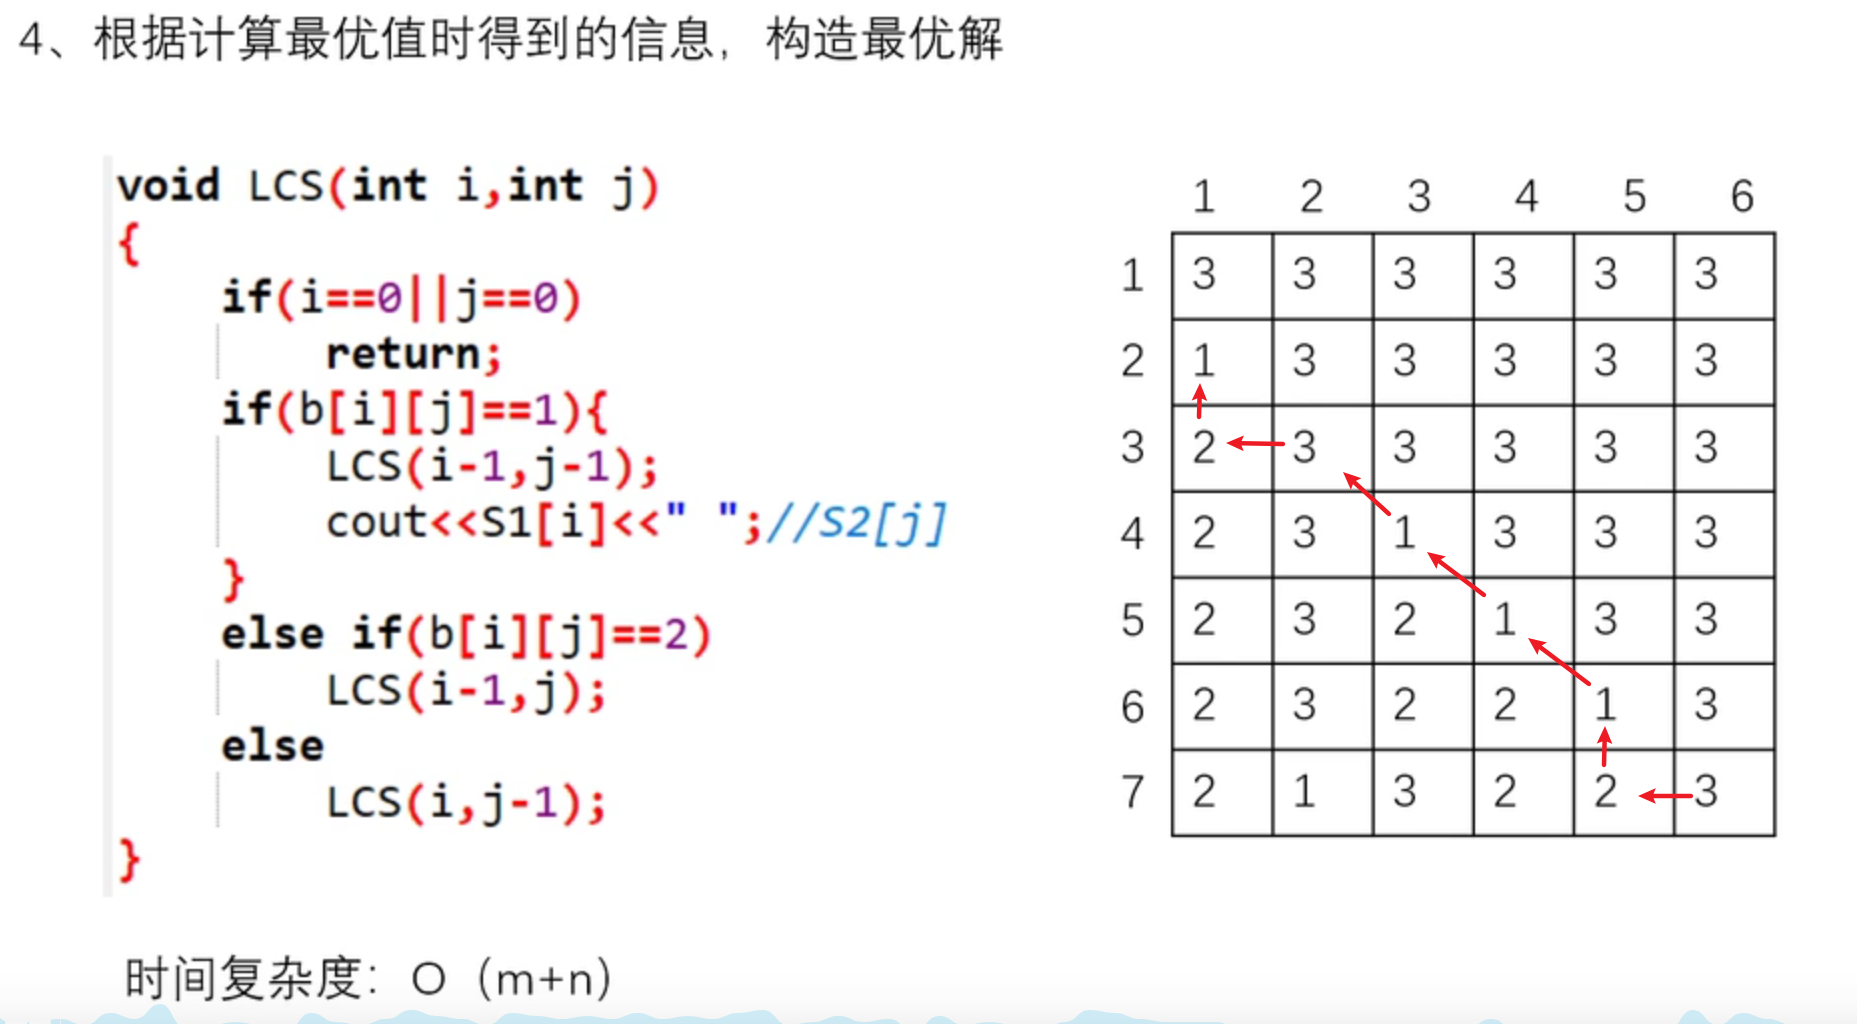
为了求出LCS中具体的字符,再用一个表格b[i] [j] 表示dp[i] [j]与周边表格的关系(也可以使用dp[i] [j]来推,不必再建一个表格)。
即 S1[i] 和 S2[j] 值相等时dp[i] [j] 的值与右上的dp[i-1] [j-1]有关 ,用1表示 ,以此类推;
前缀和 前缀和是一个数组的某项下标之前(包括此项元素)的所有数组元素的和。
一维数组的前缀和 : sum[i] = sum[i-1] + a[i]
1 2 3 4 5 for (int i=0 ;i<n;i++){ if (i==0 ) y[i]=x[i]; else y[i]=y[i-1 ]+x[i]; }
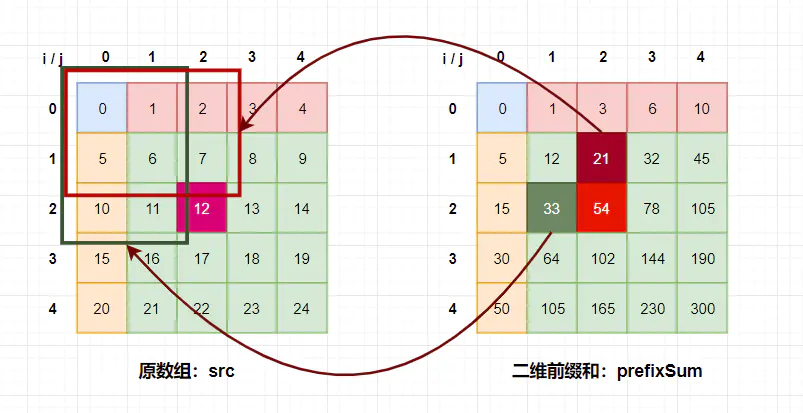
二维数组前缀和:
二维前缀和实际上就是一个矩阵内值的和,而矩阵又可以由两个行数或列数少一的子矩阵组合后,删去重合部分再加上右下角的值来构成,也就是以下式子:
1 2 3 4 5 6 7 8 for (int y=0 ;y<n;y++) for (int x=0 ;x<m;x++) { if (x==0 &&y==0 ) b[y][x]=a[y][x]; else if (x==0 ) b[y][x]=b[y-1 ][x]+a[y][x]; else if (y==0 ) b[y][x]=b[y][x-1 ]+a[y][x]; else b[y][x]=b[y-1 ][x]+b[y][x-1 ]-b[y-1 ][x-1 ]+a[y][x]; }
前缀树 Trie Trie 是一颗非典型的多叉树模型,
多叉:即每个结点的分支数量可能为多个。
非典型:因为它和一般的多叉树不一样,尤其在结点的数据结构设计上,
比如一般的多叉树的结点是这样的:
1 2 3 4 struct TreeNode { VALUETYPE value; TreeNode* children[NUM]; };
而 Trie 的结点是这样的(假设只包含’a’~’z’中的字符):
1 2 3 4 struct TrieNode { bool isEnd; TrieNode* next[26 ]; };
TrieNode结点中并没有直接保存字符值的数据成员,而是用 字母映射表 next ,TrieNode* next[26]中保存了对当前结点而言下一个可能出现的所有字符的链接,因此我们可以通过一个父结点来预知它所有子结点的值:
1 2 3 4 5 6 7 8 for (int i = 0 ; i < 26 ; i++) { char ch = 'a' + i; if (parentNode->next[i] == NULL ) { 说明父结点的后一个字母不可为 ch } else { 说明父结点的后一个字母可以是 ch } }
Trie代码示例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 class Trie { private Trie[] children; private boolean isEnd; public Trie () { children = new Trie [26 ]; isEnd = false ; } public void insert (String word) { Trie node = this ; for (int i = 0 ; i < word.length(); i++){ char ch = word.charAt(i); int index = ch - 'a' ; if (node.children[index] == null ){ node.children[index] = new Trie (); } node = node.children[index]; } node.isEnd = true ; } public boolean search (String word) { Trie node = searchPrefix(word); return node != null && node.isEnd; } public boolean startsWith (String prefix) { return searchPrefix(prefix) != null ; } private Trie searchPrefix (String prefix) { Trie node = this ; for (int i = 0 ; i < prefix.length(); i++){ char ch = prefix.charAt(i); int index = ch - 'a' ; if (node.children[index] == null ){ return null ; } node = node.children[index]; } return node; } }
720.词典中最长的单词 给出一个字符串数组words组成的一本英语词典。从中找出最长的一个单词,该单词是由words词典中其他单词逐步添加一个字母组成。若其中有多个可行的答案,则返回答案中字典序最小的单词。
若无答案,则返回空字符串。
示例 1:
1 2 3 4 5 输入: words = ["w","wo","wor","worl", "world"] 输出:"world" 解释: 单词"world"可由"w", "wo", "wor", 和 "worl"添加一个字母组成。
示例 2:
1 2 3 4 5 输入: words = ["a", "banana", "app", "appl", "ap", "apply", "apple"] 输出:"apple" 解释: "apply"和"apple"都能由词典中的单词组成。但是"apple"的字典序小于"apply"。
思路:
将所有单词插入 trie,然后从 trie 进行深度优先搜索,每找到一个单词表示该单词的全部前缀均存在,我们选取长度最长的单词。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 class Trie { Trie[] children; boolean isEnd; String word; public Trie () { children = new Trie [26 ]; isEnd = false ; } } class Solution { Trie root = new Trie (); private int maxLength = 0 ; private String res = "" ; public String longestWord (String[] words) { for (String word : words) { insert(word); } getMaxLengthWord(root, 0 ); return res; } public void insert (String word) { int n = word.length(); Trie node = this .root; for (int i=0 ;i<n;i++) { char c = word.charAt(i); if (node.children[c - 'a' ] == null ) { node.children[c - 'a' ] = new Trie (); } node = node.children[c - 'a' ]; } node.isEnd = true ; node.word = word; } public void getMaxLengthWord (Trie node, int deep) { if (deep > 0 && !node.isEnd) return ; if (deep > maxLength) { res = node.word; maxLength = deep; } for (int i=0 ;i<26 ;i++) { if (node.children[i] != null ) { getMaxLengthWord(node.children[i], deep + 1 ); } } } }
题目顺序 leetcode
数组Arrary:485,283,27
链表Linked List: 203,206
队列Queue:933,225(用队列实现栈 ),622,64
栈Atack:20,496,232(用栈实现队列)
哈希表Hash Table:217,389,496
集合Set:217,705(设计哈希集合)
堆Heap:215,692
树/图:各种算法
双指针算法Two Pointers:141,344,881
二分查找法Binary Search(模板):704,35,162,74
滑动窗口Sliding Window:209,1456
递归算法Recursion(开始练习时用笔画):509,206,344,687
分治算法Divide & Conquer:169,53
回溯算法Backtracking:22,78,77,46(全部非常经典)
深度优先搜索DFS:200,547,721
宽度优先搜索BFS:102,107,200
并查集Union Find(模板):200,547,721
贪心算法Greedy:322 ,1217,55
记忆化搜索Memoization:509,322
动态规划 Bynamic Bogramming:509,62,121,70,279,221拓扑排序Topologic Sort:207,210
前缀Trie:208(模板),720 ,692
tips 判断闰年:
1 2 3 4 int m[13 ]={0 ,31 ,28 ,31 ,30 ,31 ,30 ,31 ,31 ,30 ,31 ,30 ,31 };if (year%400 ==0 ||year%4 ==0 &&year%100 !=0 ){ }
反转数组:
Collections.reverse(ret);