汇编语言
一、访问寄存器和内存
前提:此汇编语言学习以 Intel 8086 CPU作为示例。
1 寄存器和数据存储
寄存器是CPU内部的信息存储单元。
一个n位寄存器能存储一个n位的数据,通用寄存器常用X表示;
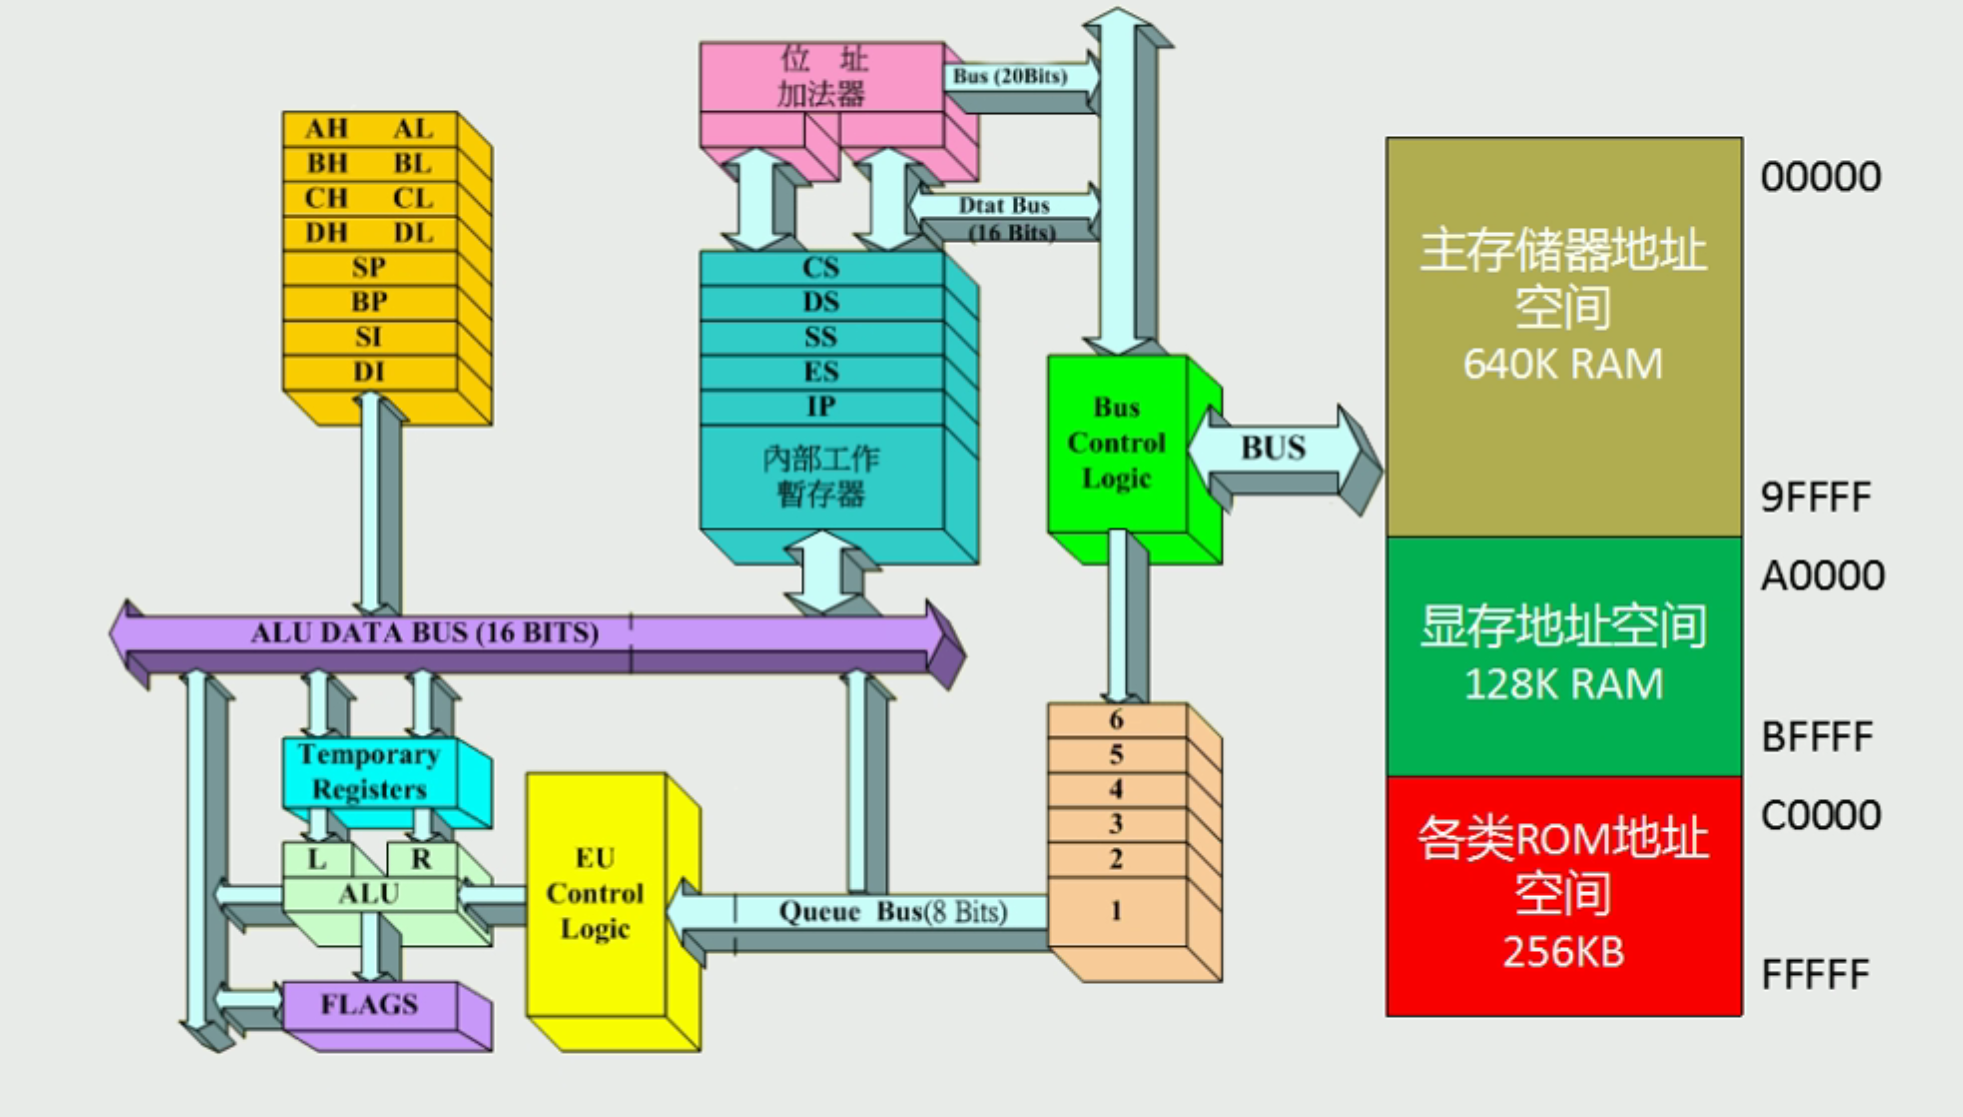
有时为了向下兼容,会把寄存器分为高低位,如AX 分为 AH, AL; AH表示AX的高位,AL表示AX的低位
(当AL中的数值大于AL所能表示的范围,AL会丢弃溢出位,而不会将溢出位加到AH上)
8086CPU有14个寄存器
通用寄存器:AX,BX,CX,DX(累加,基地址,计数,数据)
变址寄存器:SI,DI (源,目标)
指针寄存器:SP,BP(栈顶,基)
指令指针寄存器:IP
段寄存器:CS,SS,DS,ES(代码,数据,栈,附加)
标志寄存器:PSW
2 mov和add指令
示例:
mov ax 18 - 将18放入寄存器AX中
add ax 8 - 将寄存器AX中的值加上8
mov ax bx - 将BX中的值放入寄存器AX中
add ax bx - 将AX,BX中的值相加,结果放入AX中
3 确定物理地址的方法
物理地址:唯一表示每个内存单元在存储体中的地址。
CPU访问内存单元时要给出内存单元的地址,而所有的内存单元构成的存储空间是一个一维的线性空间。
问题:8086有20位地址总线,可传送20位地址,寻址能力有1M;但8086是16位结构的CPU,其所能处理的地址只有16位,即寻址能力只有64KB,这就与20位地址总线的1M寻址能力产生矛盾,如何解决?
解决方法:使用 地址加法器 可以将两个16位地址(段地址和偏移地址 )合成为一个20位的物理地址。
物理地址 = 段地址 * 16 + 偏移地址
(乘16 是将段地址左移4位,同一个物理地址可以用不同的段地址和偏移地址表示)
然后 地址加法器 会通过内部总线将这20位物理地址送到 输入输出控制电路,再传到地址总线。
4 内存的分段表示法
内存中并没有分段,段的划分是由CPU进行的。
对8086来看:
- 段地址 * 16 必然是16的倍数,所以一个段的起始地址也一定是16的倍数;
- 偏移地址为16位,16位地址的寻址能力为64k,所以一个段的长度为64k;
段地址很重要,有专门的寄存器存放段地址:
CS:代码段寄存器
DS:数据段寄存器
SS:栈段寄存器
ES:附加段寄存器
5 Debug的使用
-R:查看寄存器内容;
-R 寄存器名 :内容:改变CPU寄存器的内容;
-D:查看预设地址内存处的128个字节的内容;
-D 段地址 : 偏移地址 :列出内存中指定地址处的内容;
-D 段地址 : 偏移地址 地址范围 :列出内存中指定地址范围内的内容
**-E 段地址 : 偏移地址 数据1 数据2 …….**: 改变指定地址内存中的内容
-E 段地址 : 偏移地址 :逐个询问式修改内容,使用空格表示接收,回车表示结束
-U 段地址 : 偏移地址:查看数据,可以将内存中的机器指令翻译成汇编指令显示出来
-A 段地址 : 偏移地址 :以汇编指令的格式在内存中写入机器指令
-T :逐条执行机器指令,从 CS : IP处开始
-P :类似于T命令,逐条执行指令,显示结果,但遇到子程序,中断等时,会直接执行,然后显示结果。
-G:从地址开始处运行命令,直到遇到断点或程序正常结束。
。。。
6 CS、IP与代码段
CS:代码段寄存器; IP:指令指针寄存器
CS : IP — CPU将内存中CS : IP 指向的内容当作指令执行。
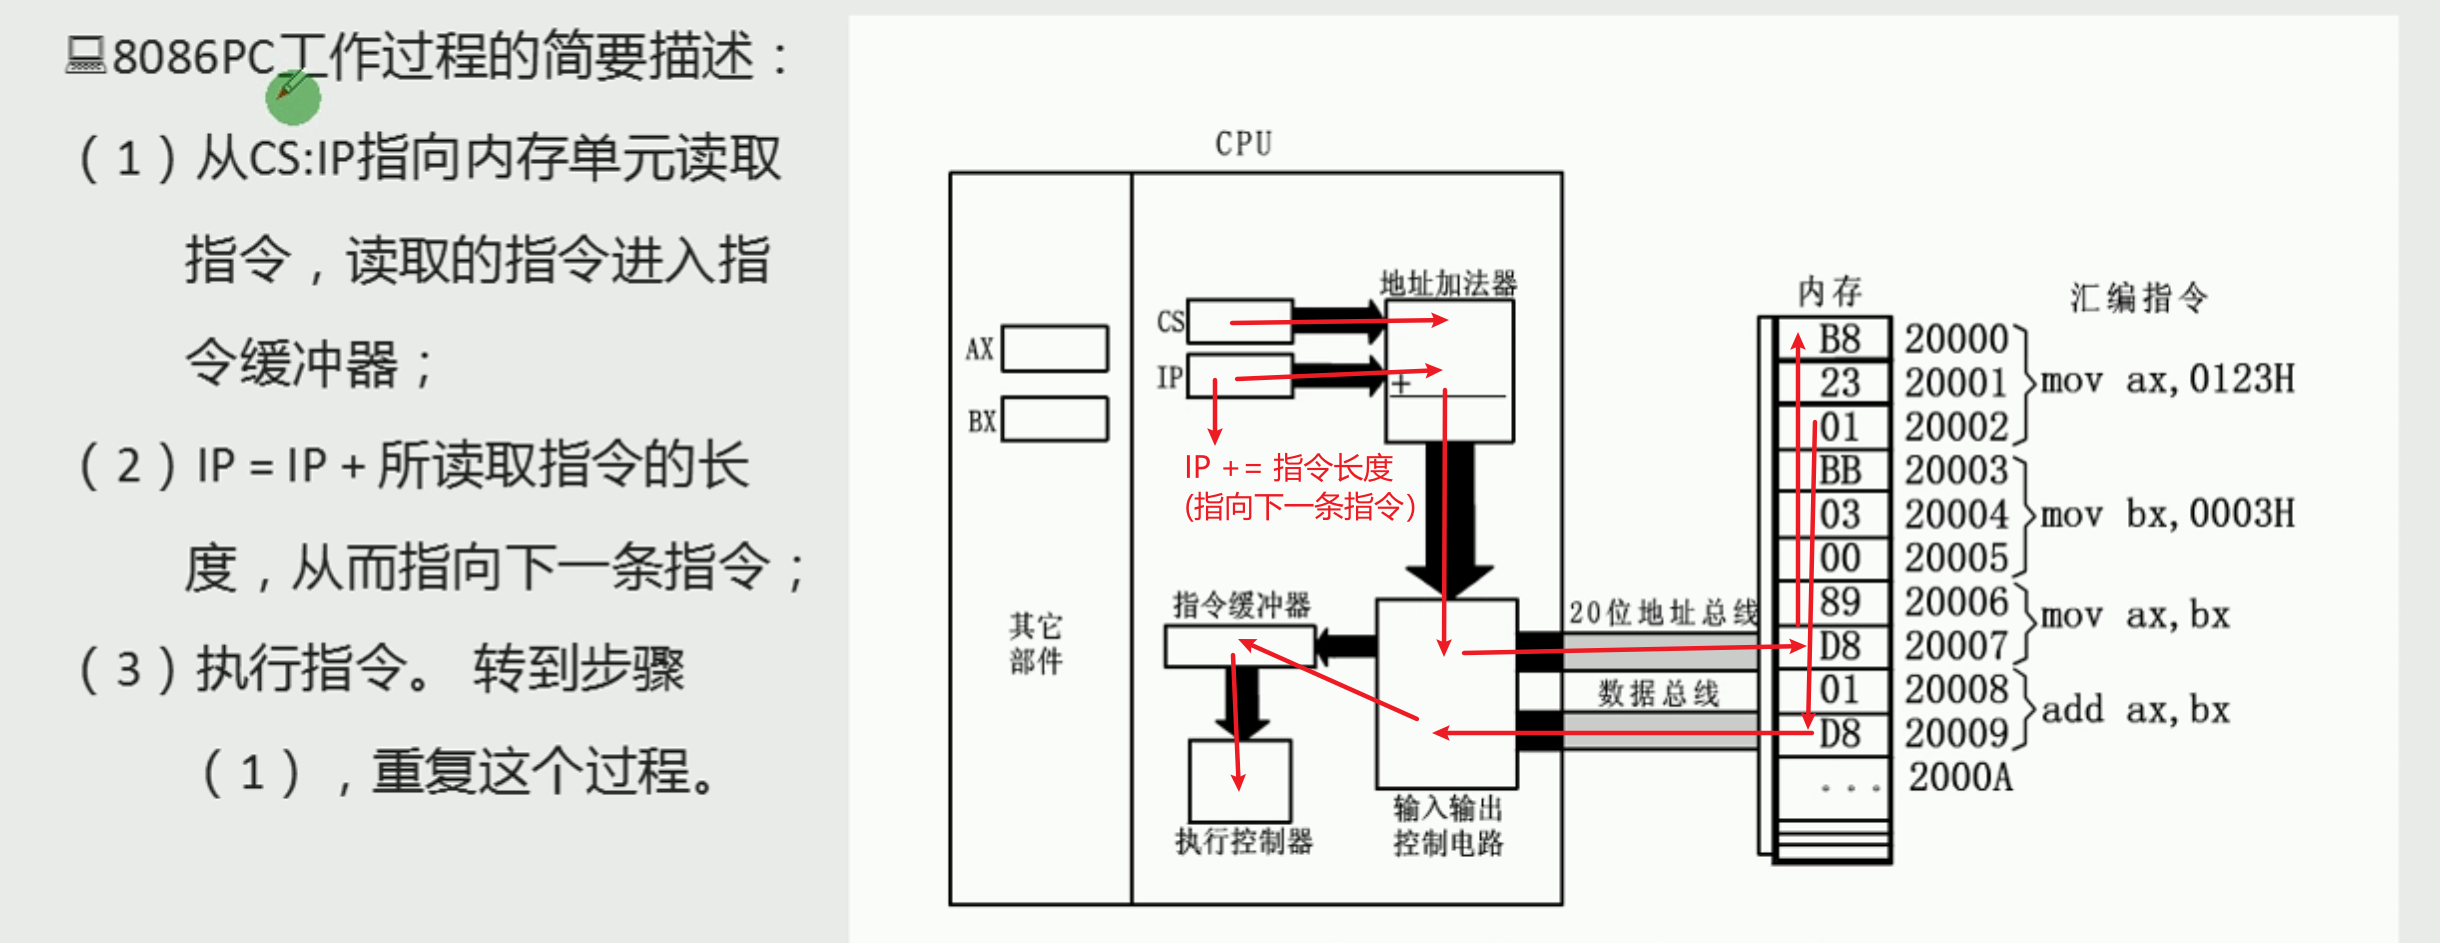
内存中的数据, 应该用作一般数据,还是指令?
答:CPU会将CS:IP指向的内存单元中的内容看作指令(CPU根据指令周期的不同阶段,可以知道取出的是指令还是数据)
7 jmp指令
CS:IP的内容不能通过mov修改,可以在Debug中用R命令修改(调试手段),而程序手段是可以用jmp指令进行跳转:
同时修改CS : IP 的内容: jmp 段地址 : 偏移地址(根据给出的段地址修改CS,偏移地址修改IP)
仅修改IP的内容: jmp 某一合法寄存器,如 jmp ax,jmp bx
8 内存中字的存储
(对8086CPU,16位作为一个字 )
字单元:由两个地址连续的内存单元组成,存放一个字型数据(16位)。
在一个字单元中,低地址单元 存放 低位字节,高地址单元 存放 高位字节。
9 用DS和[address] 实现字的传送
CPU要读取一个内存单元的时候,必须先知道这个内存单元的地址:
解决:DS 和 [address] 配合,DS寄存器存放要访问的数据的段地址,偏移地址用[…]形式直接给出。
注:8086CPU不支持将数据直接送入段寄存器(硬件设计的问题),所以需要先将数据放入通用寄存器,再放入段寄存器:
mov bx 1000H
mov ds bx
字的传送:
8086CPU可以一次性传送一个字(16位的数据),例:
1 | mov bx 1000H |
10 DS与数据段
对于8086 PC机,可以根据需要将一组内存单元定义为一个段。将一组长度为N (N<64K)、地址连续、起始地址为16的倍数的内存单元当作专门 存储数据的内存空间,从而定义了一个数据段。
DS : [address] —— 用DS存放数据段的段地址,用相关指令访问数据段中的具体单元,单元地址由[address]指出
1 | #累加数据段中的前 3个单元的数据 |
11 栈及栈操作的实现
栈:只能在一端进行插入或删除操作的数据结构
栈的操作规则:LIFO(Last In First Out,后进先出)
CPU提供的栈机制:可以将一段内存当作栈来使用,支持用栈的方式访问内存空间。(对于栈溢出的问题,8086CPU不会检查是否越界,需要程序员自己预防栈溢出)
在8086CPU中,有两个与栈相关的寄存器:
- 栈段寄存器SS : 存放栈顶的段地址
- 栈顶指针寄存器SP: 存放栈顶的偏移地址
- 任意时刻,SS:SP指向栈顶元素
PUSH(入栈)和POP(出栈)指令:
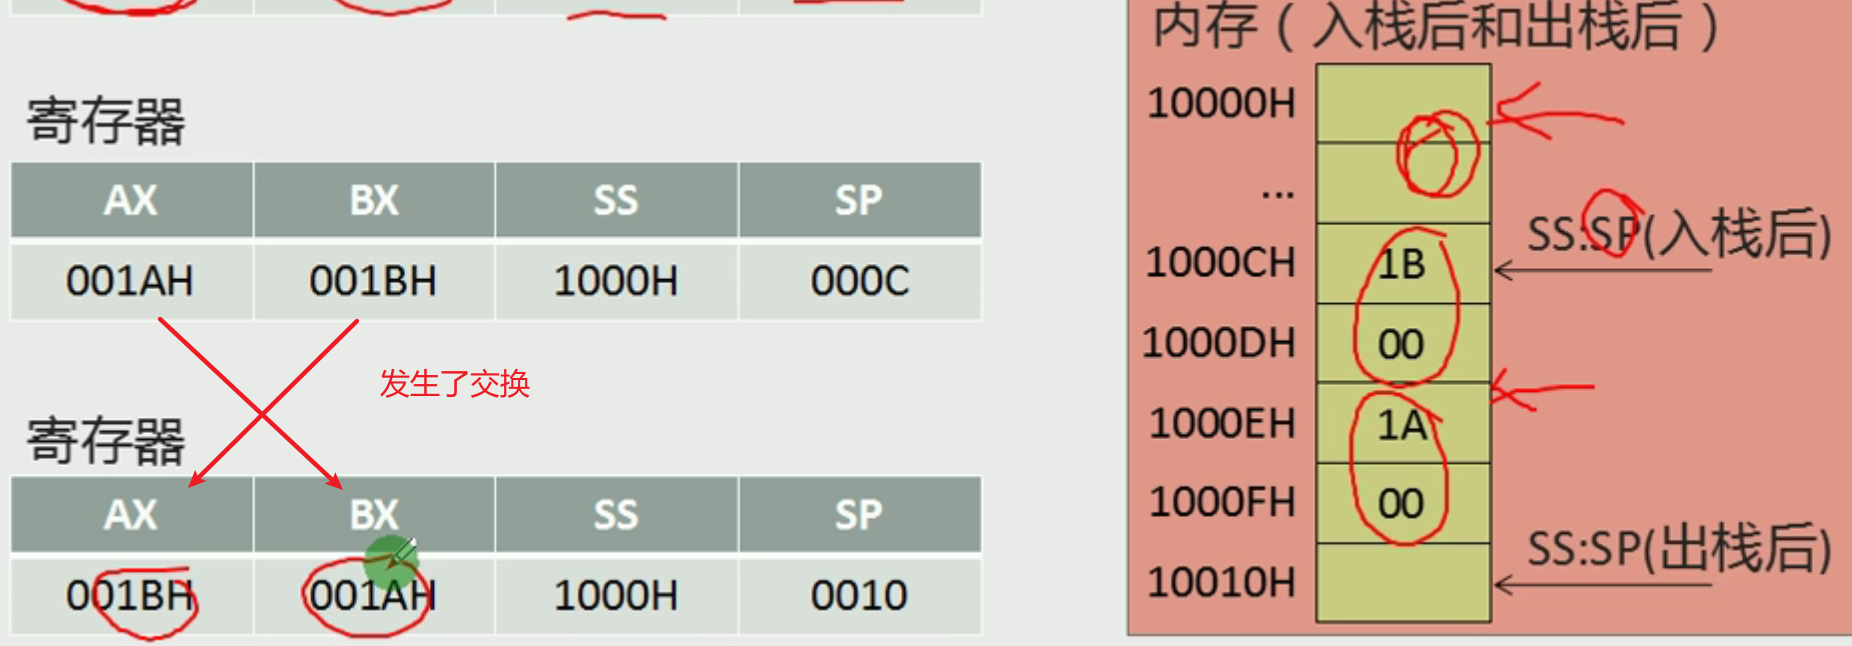
push ax:将ax中的数据送入栈中(以字为单位对栈进行操作)
- (1)SP=SP-2;
(2)将ax中的内容送入SS : SP指向的内存单元处,SS : SP此时指向新栈顶。
pop ax:从栈顶取出数据 放到ax(以字为单位对栈进行操作)
- (1)将 SS : SP指向的内存单元处的数据送入ax中;
(2)SP=SP+2,SS:SP指向当前栈顶下面的单元,以当前栈顶下面的单元为新的栈顶。
1 | mov ax,1000H |
二、汇编语言程序
1 汇编语言写的源程序
汇编程序:包含汇编指令和伪指令的文本
伪指令:没有对应的机器码,最终是不会被CPU所执行;伪指令是由编译器来执行的,编译器根据伪指令来执行相关的编译工作。
汇编指令:对应有机器码的指令,可以被编译为机器指令,最终被CPU执行。
过程:汇编程序——编译器编译——机器码——计算机运行
1 | assume cs:codesg #伪指令 |
程序中的三种伪指令
段定义
一个汇编程序是由多个段组成的,这些段被用来存放代码,数据或当作栈空间来使用。
1
2
3
4#定义程序中的段:每个段都需要有段名
段名 segment #段的开始
...
段名 ends #段的结束end (不是ends)
汇编程序的结束标记。若程序结尾处不加end,编译器在编译程序时,不知道程序在何处结束。
assume (假设)
让某一个 段寄存器 和程序中的某一个 用segment…ends定义的段 相关联
1
2#使CS寄存器与codesg关联,将定义的codesg当作程序的代码段使用
assume cs:codesg
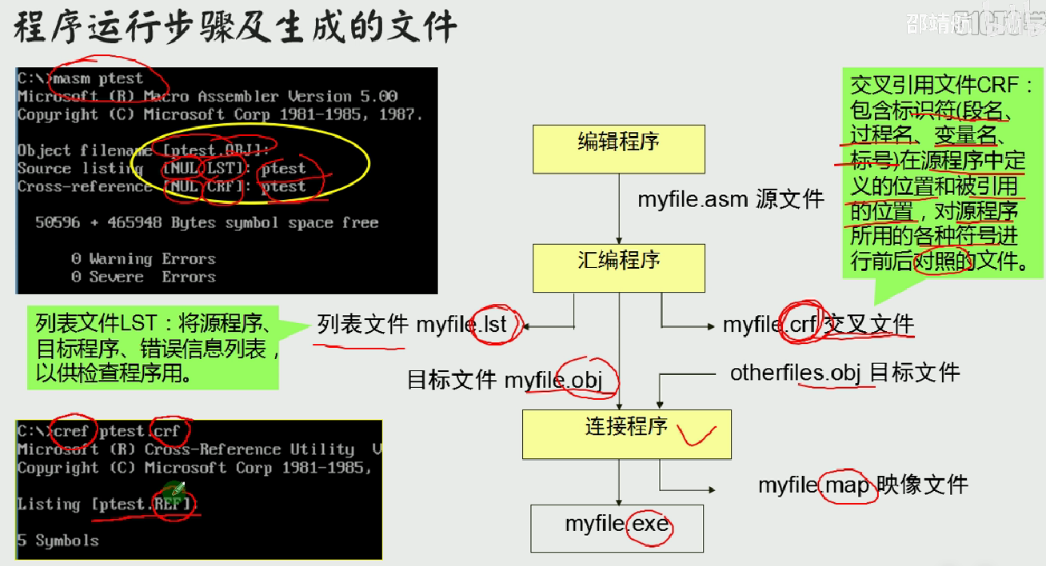
2 由源程序到程序运行
源文件 ( .asm) ——编译——> 目标文件( .obj ) ——连接——> 可执行文件( .exe )
编译
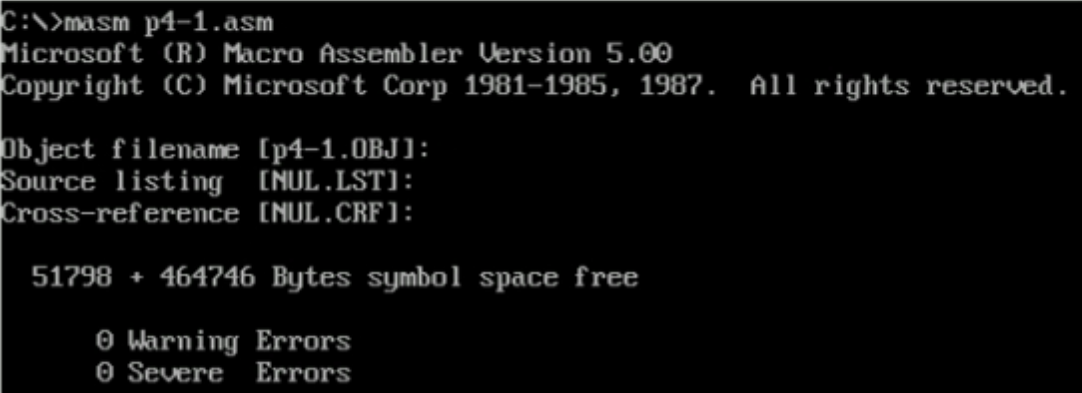
编译命令:masm + 汇编文件名
编译过程产生的文件:
目标文件(*.OBJ)**是对一个源程序进行编译后得到的最终结果;
列表文件(*.LST)是编译过程中产生的中间结果;
交叉引用文件(*.CRF)同样是编译过程产生的中间结果;
连接
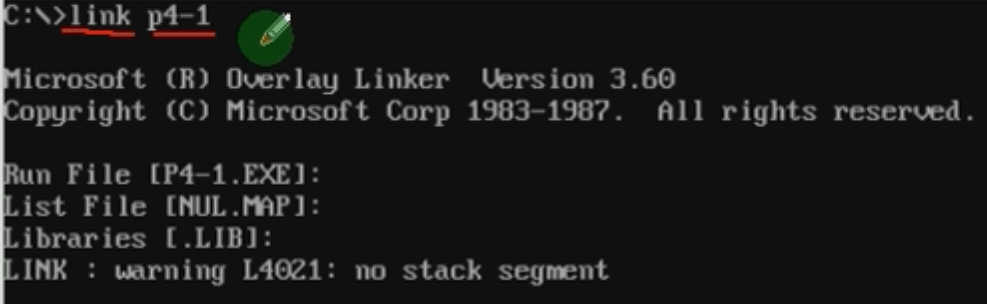
连接命令:link + 文件名
连接过程产生的文件:
- **可执行文件(EXE)**是我们对一个程序进行连接要得到的最终结果。
- 映像文件(MAP)是连接程序将目标文件连接为可执行文件过程中产生的中间结果。
- 库文件( .LIB) 里包含了ー些可以调用的子程序,如果我们的程序中调用了某一个库文件中的子程序,就需要在连接的时候,将这个库文件和我们的目标文件连接到一起,生成可执行文件。
- 如果出现no stack segment,是一个“没有栈段”的警告错误,可以不理会这个错误。
3 用Debug跟踪程序执行

4 […] 和 (…)
[…] ——表示一个内存单元(汇编语法规定)
| 指令 | 段地址 | 偏移地址 | 操作单位 |
|---|---|---|---|
| mov ax,[0] | 在DS中 | 在[0]中 | 字 |
| mov al,[0] | 在DS中 | 在[0]中 | 字节 |
| mov ax,[bx] | 在DS中 | 在[bx]中 | 字 |
| mov al,[bx] | 在DS中 | 在[bx]中 | 字节 |
(…) ——表示一个内存单元或寄存器中的内容(为学习交流方便做出的约定)
| 描述对象 | 描述方法 | 描述对象 | 描述方法 |
|---|---|---|---|
| ax中的内容为0010H | (ax)=0010H | 2000: 1000处的内容为0010H | (21000H)=0010H【20位地址描述只能用于寄存器和物理地址】 |
| mov ax,[2] | (ax)=((ds)*16+2) | mov [2], ax | ((ds)*16+2)=(ax) |
| add as,2 | (ax)=(ax)+2 | add ax, bx | (ax)=(ax)+(bx) |
| push ax | (sp)=sp-2; ((ss)*16+sp)=(ax) | pop ax | (ax)=((ss)*16+(sp)); (sp)=(sp)+2 |
再约定:符号idata表示常量
例:mov ax,[idata] ——代表mov ax, [1]、 mov ax, [1] 等等
5 Loop指令
Loop指令实现计数型循环,格式:loop 标号
CPU执行loop指令时要进行的操作:
- (cx)=(cx) - 1;
- 判断cx中的值,不为0则转至标号处执行程序,为0则向下执行
注:要先定义一个标号,即指定循环开始的地方;cx中要提前存放循环次数,因为(cx) 影响loop指令的执行结果;
1 | assume cs:code |
6 Loop指令使用例子
计算ffff:0000字节单元中的数乘以3,结果存储到dx中。(取出的是字节,而结果要作为字放进dx中)
1 | #先将内存中数据取出,连加上次,即乘以3 |
计算ffff:0 ~ ffff:b 单元中的数据的和,结果存放在dx中
1 | assume cs:code |
7 段前缀的使用
在程序中,如果使用 mov al,[0] 意思应该是将DS:0存储单元的值传给al,但实际编译后,会变成mov al,0,即把常量0放到al里。为了避免这种情况,可以在 […] 前加上段前缀
1 | mov al [0] #同mov al, 0 |
例题:
将内存 ffff:0 ~ ffff:b 中的数据拷贝到 0:200 ~ 0:20b 单元中中
1 | assume cs:code |
8 在代码段中使用数据
一般的,在程序中直接写地址是很危险的,因为可能会把数据写入到不该写的地方。
对策:可以在程序的段中存放数据,运行时有操作系统分配空间;(段的类别:数据段,代码段,栈段)
程序的一般框架:
当代码段前部 放的是数据而不是执行代码,应该用标号 表明代码开始的地方,不然编译器会把数据部分也当作执行代码来编译,从而造成错误。
1 | assume cs:code |
例题:编程计算以下8个数据的和,结果存在ax寄存器中
0123h,0456h,0789h,0abch,odefh,0fedh,0cbah,0987h
1 | assume cs:code |
9 在代码段中使用栈
例题:将给定的数据逆序存放(使用栈,数据依次入栈,再依次出栈的数据就是逆序的了)
1 | assume cs:code |
10 将数据、代码、栈放入不同段
为了不让程序显得混乱,可以将数据,栈,代码放在不同的段
1 | #将代码,数据,栈放入不同段 |
三、内存寻址方式
1 处理字符问题
用 ‘ ’ 表明字符,
小写字母的ASCII码值比大写字母的ASCII码值大20H;所以:大写+20H == 小写,小写-20H == 大写
问:大小写转换问题,将第一个字符串的小写字母转换为大写字母,将第二个字符串的大写字母转换为小写字母
(因为同一个字母大小写的ASCII码的区别只有高位第三位数不同,因此可以不用分支判断,而直接用 位运算 来变换大小写:转大写:将字母和11011111做与运算,转小写:将字母与00100000做或运算)
1 | assume cs:codesg,ds:datasg |
2 [bx + idata] 方式寻址
[bx + idata] 表示一个内存单元,它的偏移地址为 (bx) + idata(是bx中的数值加上idata)
mov ax, [bx + 200] 的含义:将一个内存单元的内容送入ax,这个内存单元的段地址在ds中,偏移地址为bx的值加上200,*数学化描述:(ax)=( (ds)16 + (bx) + 200 )
对上面的大小写转换问题,如果两个字符串长度相等,可以用[bx + idata] 进行代码简化:
1 | assume cs:codesg,ds:datasg |
1 | //上面的程序就相当于C语言等高级语言的数组机制,实际上,[bx+idata]的方式为高级语言实现数组提供了便利机制 |
3 SI 和DI 寄存器
SI:source index ,源变址寄存器
DI:destination index ,目标变址寄存器
( SI和DI 是和BX功能相近的寄存器,区别:SI和DI不能分成两个8位寄存器来使用)
1 | #下面三组指令实现的功能相同 |
4 [bx + si] 和[bx + di] 方式寻址
5 [ bx + si + idata ] 和[ bx + di + idata ] 方式寻址
6 不同的寻址方式的灵活应用
| 形式 | 名称 | 特点 | 意义 | 示例 |
|---|---|---|---|---|
| [idata] | 直接寻址 | 一个常量表示地址 | 直接定位一个内存单元 | mov ax,[200] |
| [bx] | 寄存器间接寻址 | 一个变量表示地址 | 间接定位一个内存单元 | mov bx, 0 mov ax,[bx] |
| [bx+idata] | 寄存器相对寻址 | 一个常量和变量表示地址 | 可在一个起始地址的基础上用变量间接定位一个内存单元 | mov bx, 4 mov ax,[bx+200] |
| [bx+si] | 基址变址寻址 | 两个变量表示地址 | mov ax,[bx+si] | |
| [bx+si+idata] | 相对基址变址寻址 | 两个变量和一个常量表示地址 | mov ax,[bx+si+200] |
7 不同寻址方式演示
8 用于内存寻址的寄存器
只有bx,bp,si,di可以用在 […] 内对内存单元寻址,一般将bx,bp作为基址,si,di作为变址;
bx以外的通用寄存器和段寄存器不可以用在[…]中
bx、bp区别:bx默认在ds段上,bp默认在ss段上
9 数据在哪里?有多长?
数据位置的表达:
- 立即数:直接包含在机器指令中的数据idata
- 寄存器:指令要处理的数据在寄存器中
- 内存:指令要处理的数据放在内存中,内存地址由段地址和偏移地址组合确定。
处理的数据有多长:
- 字word操作:利用整个寄存器,如ax
- 字节byte操作:寄存器拆开用,如al,ah
- 没有寄存器参与的内存单元访问指令中,用word ptr或byte ptr显性地指明所要访问的内存单元的长度:如:mov word ptr ds:[0],1 指明了是字操作,而mov byte ptr ds:[0],1指明了是字节操作
10 寻址方式的综合应用
11 用div指令实现除法
div是除法指令,使用div作除法时:
被除数:默认放在AX或 DX和AX中
除数:8位或16位,在寄存器或内存单元中
被除数 AX DX和AX 除数 8位内存/寄存器 16位内存/寄存器 商 AL AX 余数 AH DX
div指令格式:div 寄存器/内存单元
切记:提前在默认寄存器中设置好被除数,且默认寄存器不作其他用途。
示例:
| 指令 | 被除数 | 除数 | 商 | 余数 |
|---|---|---|---|---|
| div bl | (ax) | (bl) | (al) | (ah) |
| div byte ptr ds:[0] | (ax) | ((ds)*16+0) | (al) | (ah) |
| div bx | (dx)*10000H+(ax) | (bx) | (ax) | (dx) |
| div word ptr es:[0] | (dx)*10000H+(ax) | ((ds)*16+0) | (ax) | (dx) |
例子:利用除法指令计算 1000001/100
分析:1000001D=186A1H,需要进行16位的除法,所以用ax和dx联合存放186A1H,用bx存放除数 100D=64H。
1 | data segment |
12 用dup(复制)设置内存空间
duplication(复制)
功能:dup和db,dw,dd等数据定义伪指令配合,用于进行数据的重复
如:
| 指令 | 功能 | 相当于 |
|---|---|---|
| bd 3 dup (0) | 定义3个字节,值都为0 | db 0,0,0 |
| bd 3 dup (‘abc’,’ABC’) | 定义了18个字节,有’abcABC’重复3次 | db ‘abcABCabcABCabcABC’ |
定义一个容量为200个字节的栈段:
1 | stack segment |
四、流程转移与子程序
1 ”转移“概述
一般情况下指令是顺序地逐条执行的,而在实际中,常需要改变程序的执行流程。
转移指令:
- 可以控制CPU执行内存中某处代码的指令
- 可以修改IP,或同时修改CS和IP的指令
转移指令的分类:
- 按转移行为
- 段内转移:只修改IP,如jmp ax
- 段间转移:同时修改CS和IP,如jmp 1000:0
- 根据指令对IP修改的范围不同:
- 段内短转移:IP修改范围为-128~127
- 段内近转移:IP修改范围为-32768~32767
- 按转移指令
- 无条件转移指令,如jmp
- 条件转移指令,如jcxz
- 循环指令,如loop
- 过程调用
- 中断
2 操作符offset
用offset可以取得标号的偏移地址
格式:offset 标号
1 | assume cs:codeseg |
例:使程序在运行时将s处的一条指令复制到s0处
1 | assume sc:codeseg |
3 jmp指令
功能:无条件转移,可以只修改IP,也可以同时修改CS和IP
使用jmp要给出两种信息:
- 转移的目的地址;
- 转移的距离:
- 段间转移(远转移):jmp far ptr 标号
- 段内短转移:jmp short 标号;IP的修改范围为-128~127,8位的位移
- 段内近转移:jmp near ptr 标号;IP的修改范围为-32768~32767,16位的位移
两种段内转移
短转移:jmp short 标号
功能:(IP)=(ip)+8位位移
原理:
- 8位位移=标号处的地址 — jmp指令后的第一个字节的地址;
- short指明此处的位移为8位位移;
- 8位位移的范围为-128~127,用补码表示;
- 8位位移由编译器在编译时算出。
近转移:jmp near ptr 标号
功能:(IP)=(ip)+16位位移(相对于当前IP的转移位移)
原理:
- 16位位移=标号处的地址 — jmp指令后的第一个字节的地址;
- near ptr指明此处的位移为16位位移;
- 16位位移的范围为-32768~32767,用补码表示;
- 16位位移由编译器在编译时算出。
远转移:jmp far ptr 标号;
- far ptr指明了跳转到的目的地址,即包含了标号的段地址CS和偏移地址IP
转移地址放在寄存器中的jmp指令
格式:jmp 16位寄存器
功能:IP = (16位寄存器) 如:jmp bx
转移地址在内存中的jmp地址
段内转移
jmp word ptr 内存单元地址
功能:从内存单元地址处开始存放的一个字,作为转移的目的的偏移地址
```assembly
mov ax,0123H
mov ds:[0],ax
jmp word ptr ds:[0] #执行后,(IP)=0123H1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
段间转移
* **jmp dword ptr 内存单元地址**
* 功能:从内存单元地址开始处的**两个字**,**高地址的字**作为转移的目的**段地址**,**低地址**处是转移的目的**偏移地址**
* ```assembly
mov ax,0123H
mov ds:[0],ax
mov word ptr ds:[2],0
jmp dword ptr ds:[0] #执行后,(CS)=0,(IP)=0123H,CS:IP指向0000:0123
mov ax,0123H
mov bx,ax
mov word ptr [bx+2],0
jmp dword ptr [bx] #执行后,(CS)=0,(IP)=0123H,CS:IP指向0000:0123
| jmp指令格式 | 示例 |
|---|---|
| jmp 标号 | —段间转移(远转移):jmp far ptr 标号 —段内短转移:jmp short 标号(8位的位移) —段内近转移:jmp near ptr 标号;16位的位移 |
| jmp 寄存器 | —jmp bx;16位的位移 |
| jmp 内存单元(表示跳转到的地址) | —段内转移:jmp word ptr 内存单元地址;jmp word ptr [bx] —段间转移:jmp dword ptr 内存单元地址;jmp dword ptr [bx] |
在源程序中,不能使用 jmp 2000:0100 的转移指令进行跳转,这是在Debug中使用的汇编指令,而编译器并不认识,会报错。
4 其他转移指令
所有的有条件转移都是短转移,对IP的修改范围都为-128~127。
位移:是指”相对“转移,好处是:无论s处的指令的实际地址是多少,loop等指令转移的相对位移都是不变的。这样,方便了程序段在内存中的浮动装配。
jcxz指令
格式:jcxz 标号(条件转移)
功能:如果**(cx)=0,则转移到标号处执行**;当(cx) != 0时,什么也不做(程序向下执行)
loop指令
格式:loop 标号(条件转移)
功能:(cx) = (cx) - 1; 当**(cx) != 0时,则转移到标号处执行**,当(cx) = 0时,程序向下执行(cx的值先减1,再判断)
5 call指令和ret指令
模块化程序设计:调用子程序——call指令;返回——ret指令
实质:流程转移指令,都修改IP,或同时修改CS:IP
1 | mov ax,0 |
call指令
格式:
- call 标号(段内转移),
- call far ptr 标号(段间转移),
- call 16位寄存器(转移地址放在寄存器中,段内转移),
- call word ptr 内存单元地址(单字,段内转移);call dword ptr 内存单元地址(双字,段间转移)
CPU执行call指令,进行两步操作:
将当前的IP或CS和IP压入栈中;转移到标号处执行指令。
ret,retf指令
- ret指令:
- 功能:用栈中的数据,修改IP的内容,从而实现近转移;
- 相当pop IP
- retf指令( f 意思是far):
- 用栈中的数据,修改CS和IP的内容,从而实现远转移
- 相当于 pop IP, pop CS
6 mul指令
mul指令用于做乘法运算
格式:mul 寄存器 或者 mul 内存单元
| 8位乘法 | 16位乘法 | |
|---|---|---|
| 被除数(默认) | AL | AX |
| 乘法 | 8位寄存器或内存字节单元 | 16位寄存器或内存字节单元 |
| 结果 | AX | DX(高位),AX(低位) |
1 | mov al,100 #被除数先放到默认寄存器al中 |
7 汇编语言的模块化程序设计
模块之间的参数和结果的传递:1. 用寄存器传递参数;2. 用内存单元进行参数传递;3. 用栈传递参数
用寄存器来存储参数和结果:最常用,但寄存器有限,所以参数不能太多;
用内存单元批量传递数据:将批量数据放在内存中,然后将它们所在内存空间的首地址放在寄存器中,传递给所需的子程序;对于具有批量数据的返回结果,也可以用同样的方法。
用栈传递参数:由调用者将需要传递给子程序的参数压入栈中,子程序从栈中取得参数。
8 寄存器冲突问题
在调用的子程序中,如果用到了调用者已经在用的寄存器,可能会会使运行结果错误甚至程序崩溃。
为了不影响调用者在使用的寄存器的值,同时为了避免在编写程序时需时刻注意寄存器的使用这种麻烦情况,因此,制定了子程序的标准框架:
- 子程序开始时,将子程序会使用到的寄存器入栈
- 子程序内容
- 子程序使用的寄存器出栈(恢复寄存器中的数据)
- 返回(ret,retf)
1 | capital: |
9 标志寄存器
结构:
- flag寄存器是按 位 起作用的,也就是说,它的每一位都有专门的含义,记录特定的信息。
- 8086CPU的16位flag寄存器没有使用1,3,5,12,13,14,15,这些位不具有任何含义
作用:
- 用来存储相关指令的某些执行结果(溢出,进位,是否为0…)
- 用来为CPU执行相关指令提供行为依据(如传送数据的方向…)
- 用来控制CPU的相关工作方式
flag寄存器的值:
| 15 | 14 | 13 | 12 | 11 | 10 | 9 | 8 | 7 | 6 | 5 | 4 | 3 | 2 | 1 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| OF | DF | IF | TF | SF | ZF | AF | PF | CF |
| 标志 | 值为1 | 值为0 | 意义 |
|---|---|---|---|
| OF (Overflow) | OV | NV | 溢出 |
| DF (Direction) | DN | UP | 方向 |
| SF (Sign) | NG | PL | 符号 |
| ZF (Zero) | ZR | NZ | 零值 |
| PF (parity) | PE | PO | 奇偶 |
| CF (Carry) | CY | NC | 进位 |
直接访问标志寄存器的方法:
- pushf:将标志寄存器的值压栈。
- popf:从栈中弹出数据,送入标志寄存器中。
指令影响:
- 在8086CPU的指令集中,有的指令的执行是影响标志寄存器的,如:add,sub,mul,div,inc,or,and等,大都是运算指令,逻辑指令
- 有的指令的执行对标志寄存器没有影响,如:mov,push,pop等,大都是传送指令。
ZF—零标志(Zero Flag)
ZF=1,表示 逻辑真;ZF=0,表示逻辑假
PF—奇偶标志(Parity Flag)
PF记录指令执行后,结果的所有二进制位中1的个数;
1的个数为偶数,PF = 1
1的个数为奇数,PF = 0
SF—符号标志(Sign Flag)
结果为负:SF = 1
结果为非负:SF = 0
(将数据当作有符号数来运算时,通过SF可知结果的正负;将数据当作无符号数来运算时,SF的值则没有意义,虽然相关的指令会影响它的值)
CF—进位标志(Carry Flag)
在进行无符号数的运算时,CF记录了运算结果的 最高有效位 向更高位(这个更高位是假象的)的进位值。
有进位或借位,CF = 1
无进位或借位,CF = 0
OF—溢出标志(Overflow Flag)
在进行有符号数运算时,如果结果超过了机器所能表示的范围,称为溢出。
有溢出,OF = 1
无溢出,OF = 0
10 带进位的加减法
adc—带进位加法指令,利用了CF位上记录的进位值。
格式:adc 操作对象1,操作对象2
功能:操作对象1 = 操作对象1 + 操作对象2 + CF值
例:adc ax, bx 实现的功能:(ax) = (ax) + (bx) + CF
应用:大数相加(先将低16位相加,然后将高16位和进位值相加)
sbb—带借位减法指令
格式:sbb 操作对象1,操作对象2
功能:操作对象1 = 操作对象1 - 操作对象2 - CF值
例:sbb ax, bx 实现的功能:(ax) = (ax) - (bx) - CF
11 cmp和条件转移指令
cmp指令是比较指令,功能相当于减法指令,只是不保存结果;cmp指令执行后,会对标志寄存器产生影响,可以根据标志寄存器来比较结果,而不影响原值。
格式: cmp 操作对象1,操作对象2
功能:计算 操作对象1 - 操作对象2
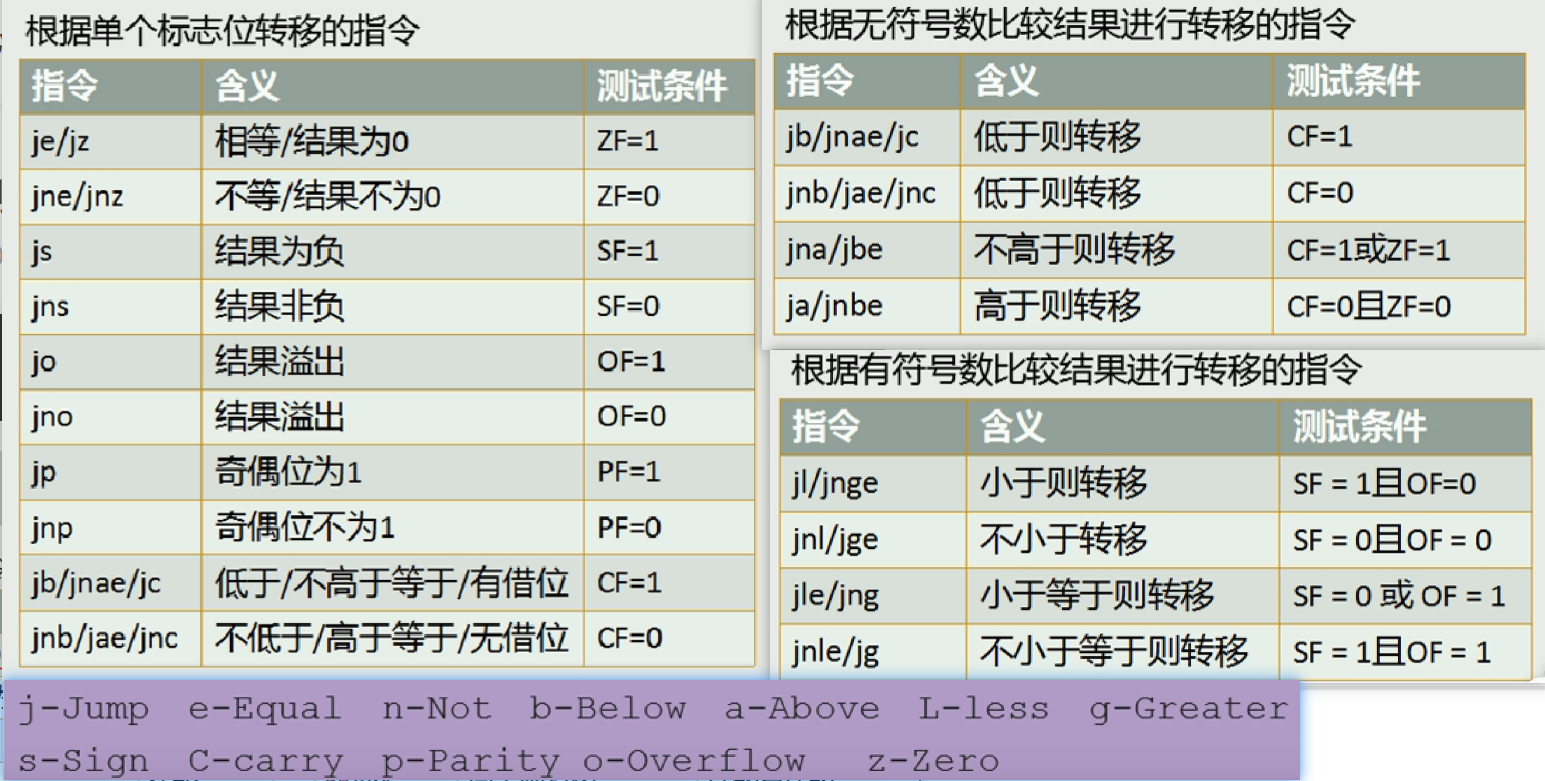
无符号数比较以及标志位取值
| 比较关系 | (ax)-(bx)特点 | 标志寄存器 |
|---|---|---|
| 等于 | (ax)-(bx) = 0 | ZF=1 |
| 不等于 | (ax)-(bx) != 0 | ZF=0 |
| 小于 | (ax)-(bx) 产生借位 | CF=1 |
| 大于等于 | (ax)-(bx) 不必借位 | CF=0 |
| 大于 | (ax)-(bx) 即不借位,结果右不为0 | CF=0且ZF=0 |
| 小于等于 | (ax)-(bx) 借位 或者 结果为0 | CF=1或ZF=1 |
有符号数比较以及标志位取值(仅凭结果正负(SF)无法得出结论,需要配合是否溢出(OF)得到结论)
| 比较关系 | (ax)-(bx)特点 | 标志寄存器 |
|---|---|---|
| 等于 | (ax)-(bx) = 0 | ZF=1 |
| 不等于 | (ax)-(bx) != 0 | ZF=0 |
| 小于 | (ax)-(bx) 为负,且不溢出 | SF=1且OF=0 |
| 大于等于 | (ax)-(bx) 为负,且溢出 | SF=1且OF=1 |
| 大于 | (ax)-(bx) 为非负,且无溢出 | SF=0且OF=0 |
| 小于等于 | (ax)-(bx) 为非负,或有溢出 | SF=0或OF=1 |
条件转移指令
12 DF标志和串传送指令,rep指令
DF—方向标志位(Direction Flag)
功能:在串处理指令中,控制每次操作后 si,di的增减
DF = 0,每次操作后 si,di 递增;
DF = 1,每次操作后 si,di 递减;
对DF位进行设置:
cld 指令:将标志寄存器的DF位设为0 (clear)
std 指令:将标志寄存器的DF位设为1 (setup)
串传送指令:
movsb:以字节为单位传送
( (es) * 16 + (di) ) = ( (ds) * 16 + (si) ),复制字节
如果DF = 0,则 (si) = (si) + 1,(di) = (di) + 1
如果DF = 1,则 (si) = (si) - 1,(di) = (di) - 1
movsw:以字为单位传送
( (es) * 16 + (di) ) = ( (ds) * 16 + (si) )
如果DF = 0,则 (si) = (si) + 2,(di) = (di) + 2
如果DF = 1,则 (si) = (si) - 2,(di) = (di) - 2
rep指令:
功能:根据cx的值,重复执行后面的指令
用法:
1
2
3
4rep movsb
#上下两段代码是等价的
s:movsb
loop s
五、中断及外部设备操作
直接定址表
1 移位指令
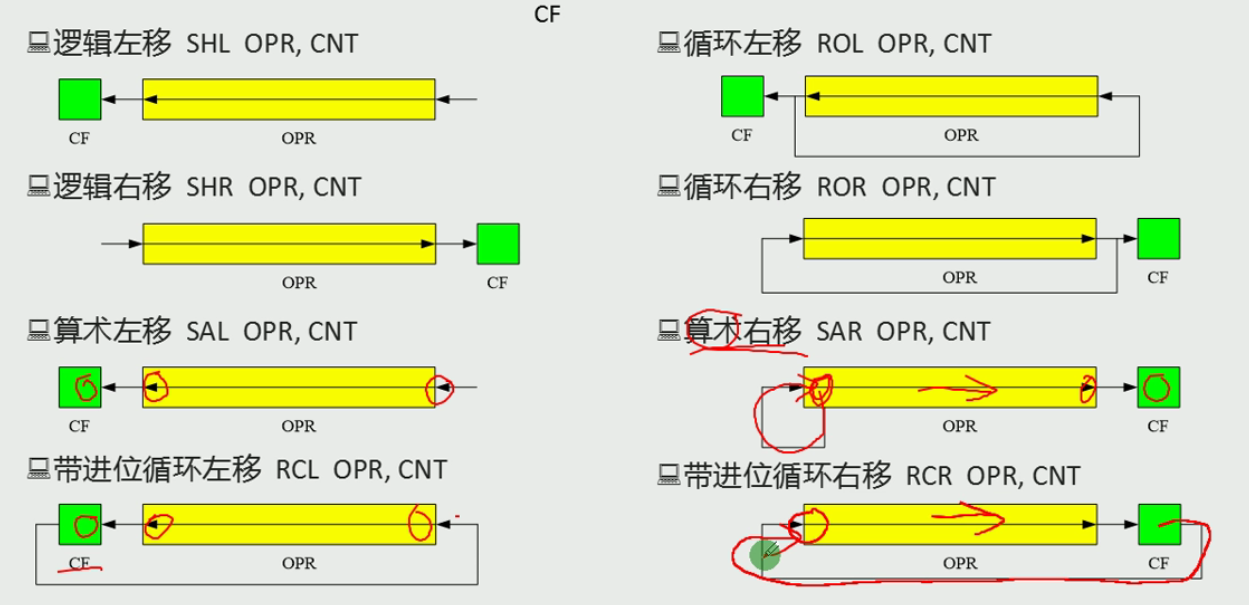
其中OPR为操作数,CNT为位移位数
1 | #注意点:移位位数大于1时,必须使用cl |
常用法:将x逻辑左移一位,相当于x=x*2;右移一位,相当于x=x/2
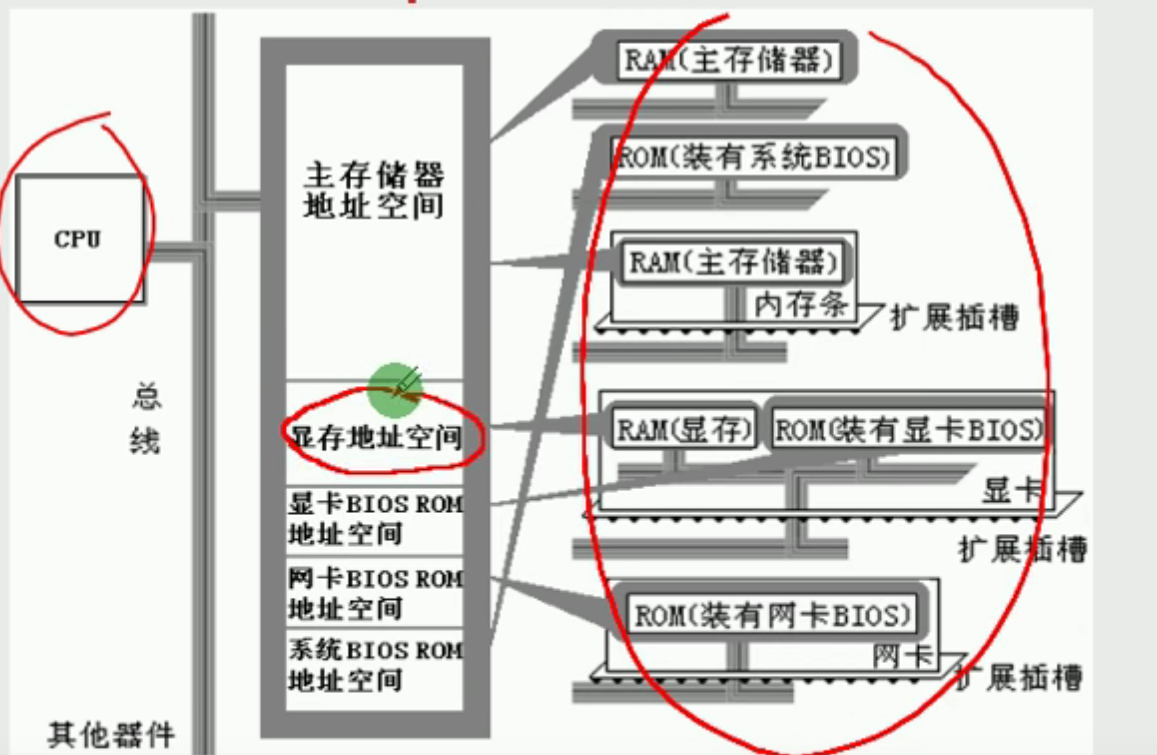
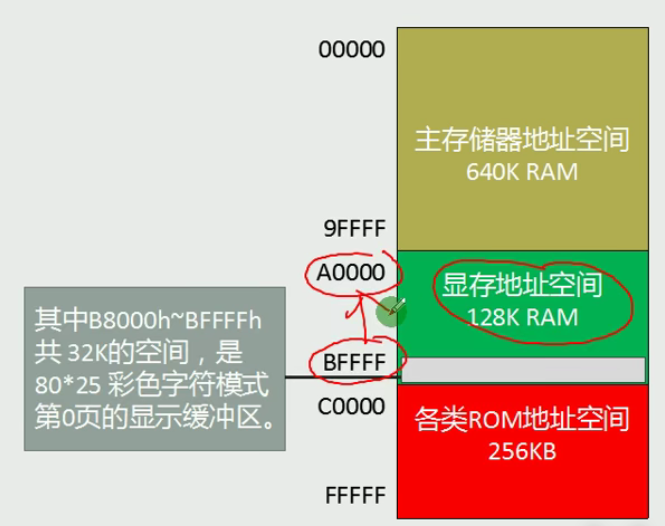
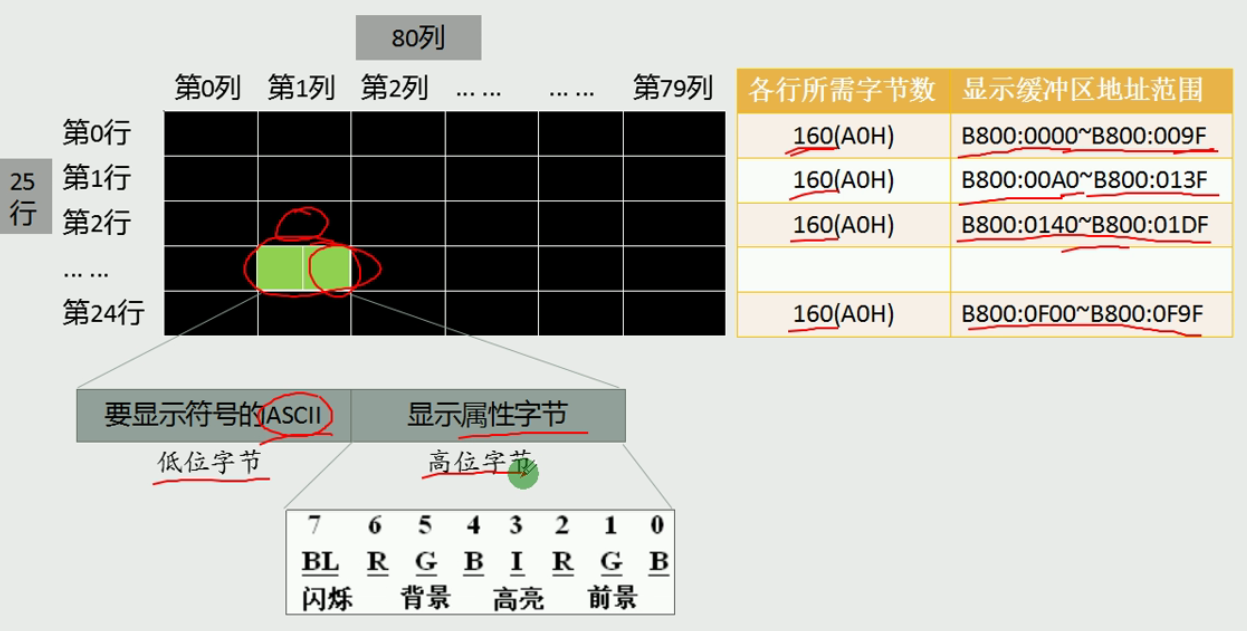
2 操作显存数据
显存数据,即屏幕上显示的内容。
3 描述内存单元的标号
地址标号:仅仅表示地址,标号后要加冒号
数据标号:标记了存储数据的单元的地址和长度。
注意:地址标号只能在代码段中使用,数据标号在代码段,数据段等都可以使用。
1 | assume cs:code |
4 数据的直接定址表
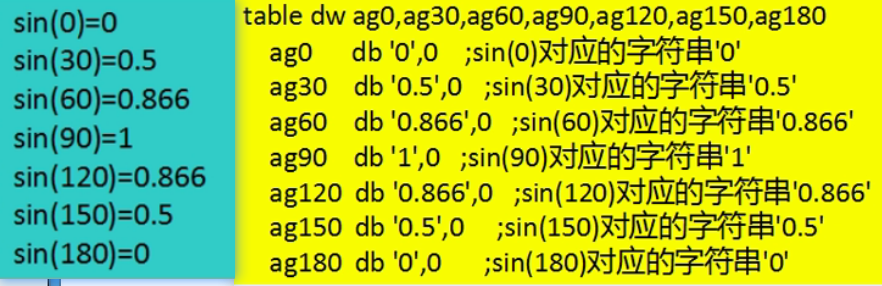
利用表,在两个数据集合之间建立一种映射关系,用查表的方法根据给出的数据得到另一集合中的对应数据。
例:计算sin(x)的值(x为有限个度数值),而计算过程需要多个乘除运算,代价颇高,所以可以考虑使用映射表。
5 代码的直接定址表
通过查表的方式,通过依据数据,直接计算出所要找的元素的位置。
如:要实现一个子程序,它提供四种功能,利用定址表的方案:将4个功能写成4个子程序,将这些功能子程序的入口地址存到一个表中,其对应关系:功能号*2=对应的功能子程序在地址表中的偏移。这样就方便许多,不用很多分支选择
内中断
1 中断及其处理
中断:CPU不再接着(刚执行完的指令)向下执行,而是转去处理中断信息。
内中断:由CPU内部发生的事件而引起的中断
外中断:由外部设备发生的事件而引起的中断
内中断:
- 除法错误:0(中断码)
- 单步执行:1
- 执行into指令:4
- 执行int n指令:立即数n为中断类型码
CPU接到中断信息后,会立即执行中断处理程序;
中断处理程序在哪里?中断信息和处理程序的入口地址之间有联系,CPU根据中断信息可查找中断向量表,找到要执行的处理程序。
中断向量表:中断类型码 与 中断处理程序地址入口 的映射表
中断过程
中断过程由CPU的硬件自动完成,由中断类型码找到中断向量,并用它设置CS和IP
8086CPU的中断过程:
- 从中断信息中取得中断类型码;
- 标志寄存器的值入栈:中断过程要改变标志寄存器的值,所以需要先行保护;
- 设置标志寄存器的第8位TF 和第9位IF的值为 0;
- CS的内容入栈,IP的内容入栈(先行保护)
- 从中断向量表读取处理程序的入口地址,设置IP和CS
2 编制中断处理程序
- CPU随时可能检测到中断信息,所以中断处理程序必须常驻内存中。
- 中断处理程序的入口地址,即中断向量,必须存储在对应的 中断向量表中(入口地址为IP和CS应该修改的值)。
如果是自己编制的中断处理程序,应该放在内存的确定位置,且不破坏系统(向操作系统申请获得存放 程序的内存空间);
3 单步中断
从Debug中断的t命令,即让CPU能执行一条指令就停下来:
- Debug利用了CPU提供的单步中断功能;
- 使用t命令,Debug将TF标志设为1,使CPU工作在单步中断方式下。
两个和中断相关的寄存器标志位:
- TF—陷阱标志(Trap flag):用于调试时的单步方式操作。
- 当TF=1时,每条指令执行完后产生陷阱,由系统控制计算机;
- 当TF=0时,CPU正常工作,不产生陷阱。
- IF—中断标志(Interrupt flag):
- 当IF=1时,允许CPU响应可屏蔽中断请求;
- 当IF=0时,关闭中断。
- 设置IP的指令:sti,置IF=1;cli,置IF=0。
单步中断过程:
CPU在执行完一条指令后,如果检测到标志寄存器的TF位为1,则产生单步中断(中断类型码为1):
取得中断类型码1;
标志寄存器入栈,TF和IF设置为0;
为什么TF要设置为0?
因为中断处理程序也由一条条指令组成。如果在执行中断处理程序之前,TF=1,则CPU在执行完中断处理程序的第一条指令后,又要产生单步中断,转去执行单步中断的中断处理程序的第一条指令….这样会陷入一个死循环,CPU一直在执行单步中断处理程序的第一条指令。所以,在进入中断处理程序前,设置TF为0。
CS,IP入栈;
设置CS,IP的值,使CPU执行中断处理程序;
中断不响应的情况:
一般来说,CPU在执行完当前指令后,如果检测到中断信息,就响应中断,当有些情况下,CPU不会响应中断:
例:在执行完向ss寄存器传送数据的指令后,即使发生中断,CPU也不会响应。
原因:因为ss:sp是联合指向栈顶,而对它们的设置应该连续完成,依次保证对栈的正确操作。
2
3
4
5
mov ax,1000
mov ss,ax
.... #不要在设置ss和sp的指令中将插入其他操作
mov sp,10
4 由int指令引发的中断
格式:int n (n为中断类型码)
功能:引发特定中断过程。int指令的功能和call指令相似,都是调用一段程序,一般来说,系统将一些具有一定功能的子程序,以中断处理程序的方式提供给应用程序调用。
应用:因为int指令可以调用子程序(中断处理程序/中断例程),所以可以自定义中断例程,由int调用,实现特定功能。
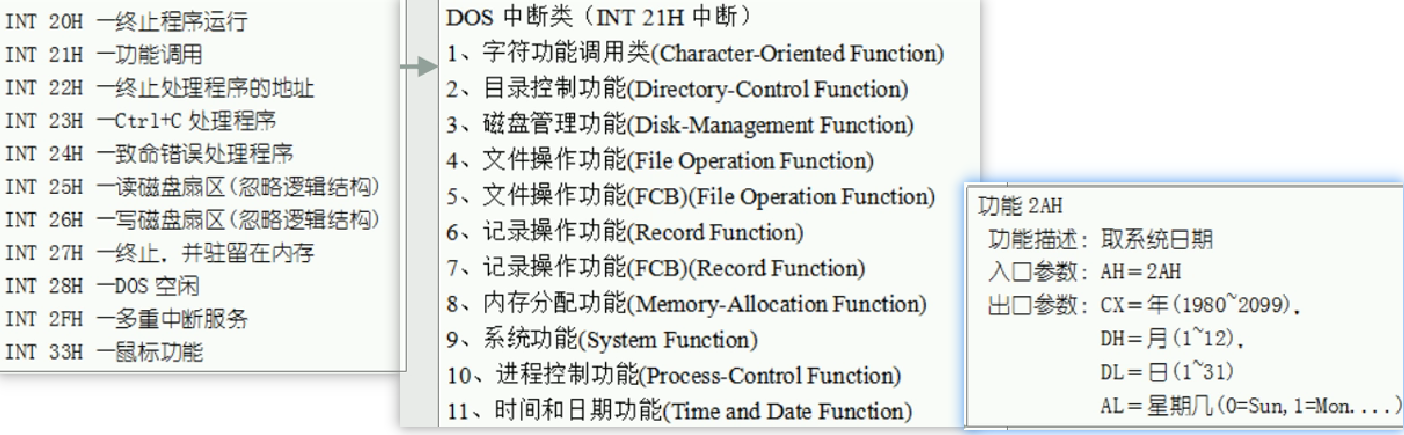
5 BIOS和DOS中断处理
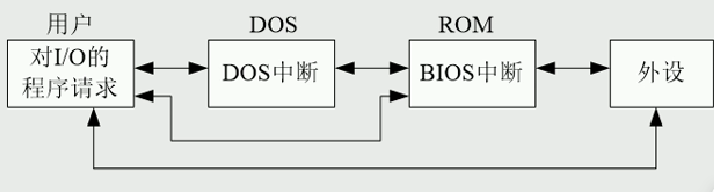
BIOS和DOS在所提供的中断例程中包含了许多编程时可以用到的功能子程序。
BIOS——基本输入输出系统,存放在系统板的ROM中。
BIOS功能:
- 硬件系统的检测和初始化程序;
- 外部中断和内部中断的中断例程;
- 用于对硬件设备进行I/O操作的中断例程;
- 其他和硬件系统相关的中断例程。
意义:使用BIOS功能调用,程序员就不用了解硬件操作细节,直接使用指令设置参数,并使用BIOS的中断例程,即可完成工作。更方便编程,写处简洁,可读性号,易于移植的程序。
具体的BIOS和DOS中断例程可以查看手册。
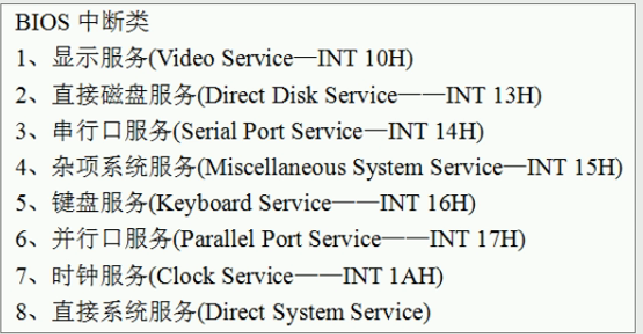
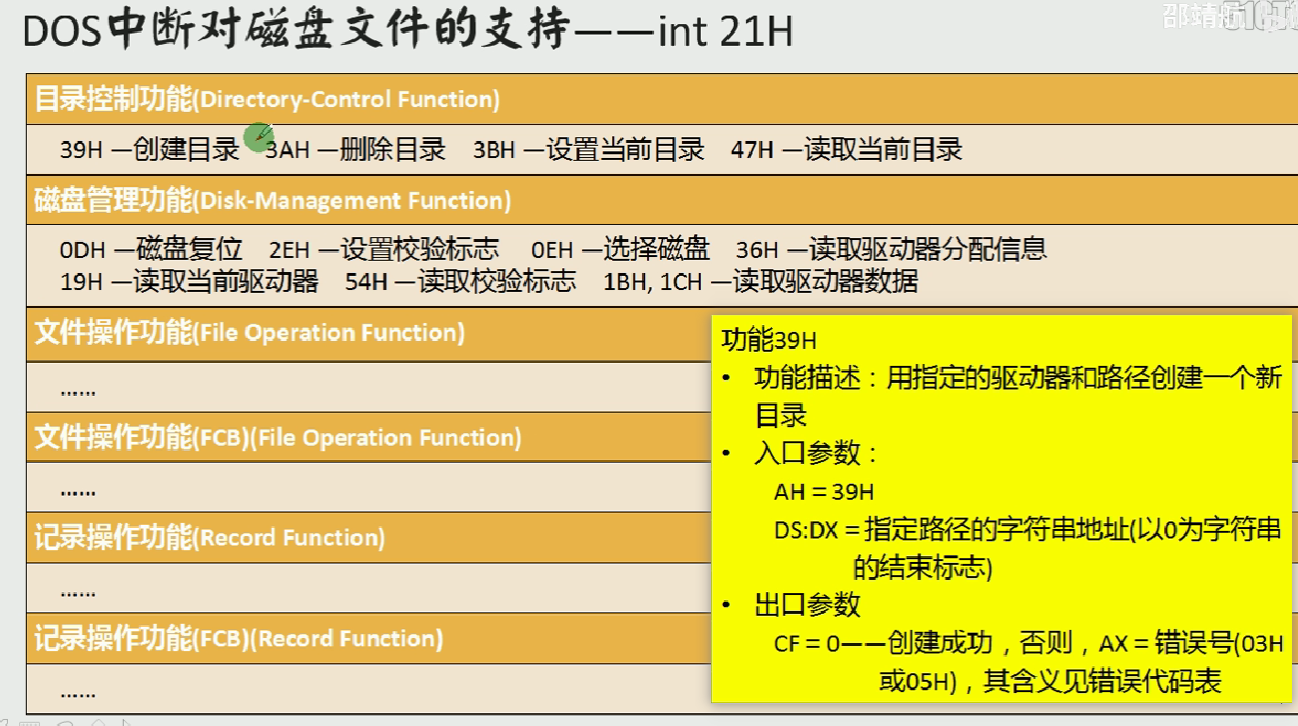
DOS中断
端口及外设控制
1 端口的读写
CPU可以直接读写3个地方的数据:CPU内寄存器,内存单元,端口。(端口指各种接口卡,网卡,显卡,主板的接口芯片等等)
端口的地址:各种芯片工作时,芯片上的一些寄存器由CPU读写,即CPU将这些寄存器当作端口并统一编址。
指令格式:in:CPU从端口读取数据;out:CPU往端口写入数据
端口的读写:
例 :in al,60h 从60h号端口读入一个字节
执行时相关的操作:
- CPU通过地址线将地址信息60h发出;
- CPU通过控制线发出端口读命令,选中端口所在的芯片,并通知要从中读取数据;
- 端口所在的芯片将60H对应端口中的数据通过数据总线送入CPU
端口读写规定:
- 对0~255以内的端口进行读写,端口号用立即数给出
- 对256~65535的端口进行读写,端口号放在dx中
- 在in和out指令中,只能使用ax或al来存放从端口中读入的数或要发送到端口中的数据:访问8位端口上时用al,访问16位端口时用ax。
2 操作CMOS RAM芯片
CMOS RAM芯片:包含一个实时时钟和一个128个存储单元的RAM存储器。
- 128个字节的RAM存储器包含:内部实时钟,系统配置信息,相关的程序(用于开机时配置系统信息)
- CMOS RAM芯片靠电池供电,关机后其内部的实时钟仍可正常工作,RAM中的信息不丢失。
- 芯片内部有两个端口,端口地址为70h和71h,CPU通过这两个读写CMOS RAM。
- 70h地址端口:存放要访问的CMOS RAM单元的地址;
- 71h数据端口:存放从选定的单元中读取的数据,或要写入到其中的数据。
读取CMOS RAM:将要读取的单元地址送入70h地址端口,再从71h数据端口读出指定单元的内容。
3 外设连接与中断
CPU在执行指令过程中,可以检测到端口(外设)发送过来的中断信息,引发中断过程,处理外设的输入。
外中断:由外部设备发生的事件引起的中断。
可屏蔽中断:
- 可屏蔽中断是CPU可以不响应的外中断。
- CPU是否响应可屏蔽中断,要看标志寄存器的IF位:IF=1时,执行完当前指令后引发中断过程;IF=0时,不响应中断。
- 几乎所有由外设引发的外中断,都是可屏蔽中断。
不可屏蔽中断:
- 不可屏蔽中断是CPU必须响应的外中断。
- 8086CPU不可屏蔽中断的中断类型码固定为2。
- 不可屏蔽中断在 系统中有必须畜栏里的经济情况发生时 用来通知CPU的中断信息,如:突然掉电时,进行保护性工作。
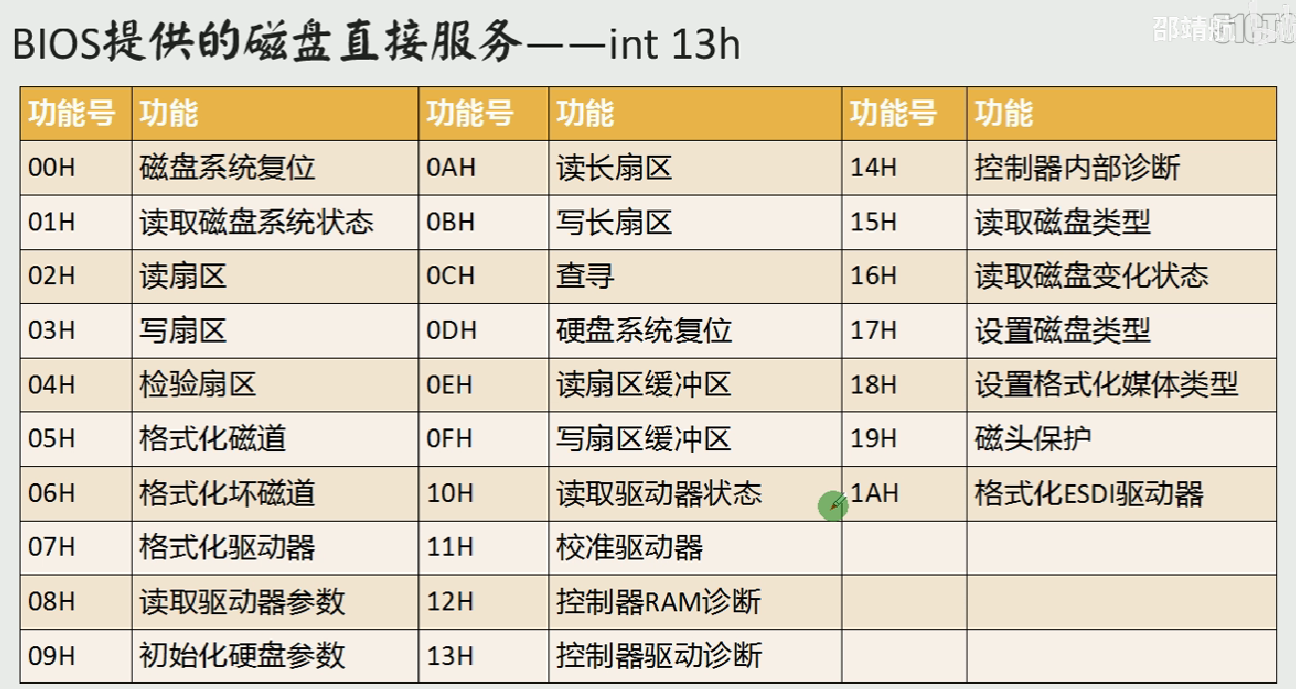
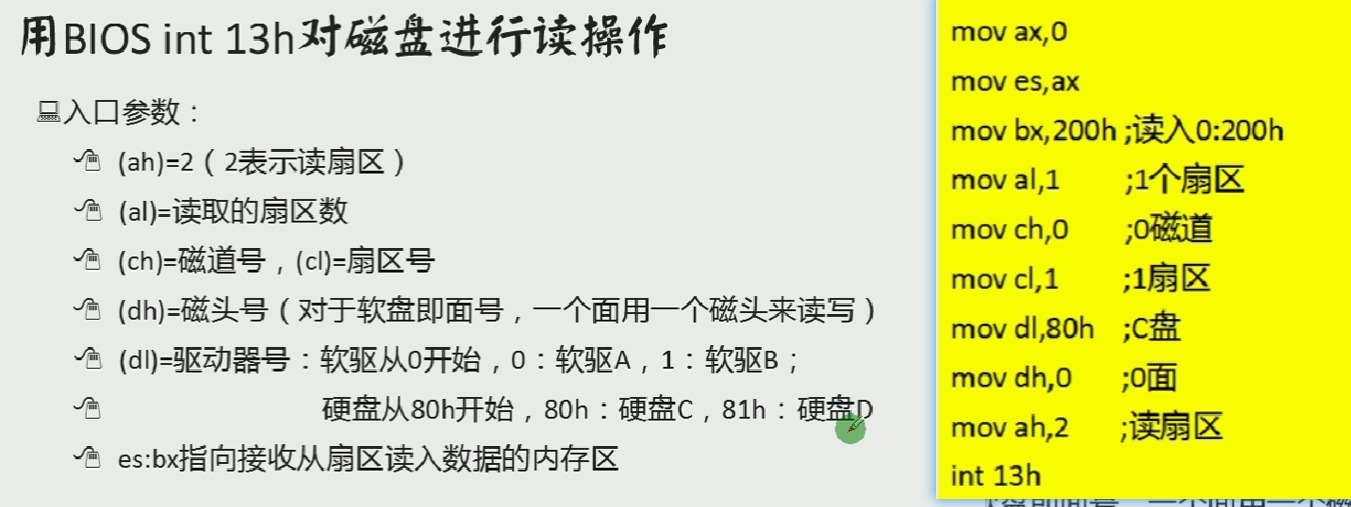
9 磁盘读写
六、高级汇编语言技术
8086拓展
子程序的可读性更好的写法:
1 | #相当于高级语言中对子程序的包装:{ } |
程序的多文件组织:
可以将程序放到不同地方,再进行连接编译,调用者需要声明调用了其他程序,被调用程序需要声明为共有的;
1 | #调用者 |
8086总结
一些名词缩写
reg:寄存器
src:标号
opr:操作数
flags:标志寄存器
汇编指令
数据传送指令
通用数据传送指令:mov,push,pop,xchg
xchg是交换指令:xchg 操作数1 操作数2 ——将两个操作数作交换
注:不影响标志位,不允许使用段寄存器
累加器专用传送指令:in,out,xlat
in,out是用于端口读写的指令
xlat是换码指令:xlat 或者 xlat 操作数
执行的操作是: (al) <— ( (bx) + (al) )
用法:bx放一个数据段的首地址,al放偏移量,根据基地址和偏移地址,取出对应位置的数据,放到al里。一开始 al 放偏移量,最后 al 放数据。
注:不影响标志位,只用于字节表格(长度不超过256),执行指令前需要先把首地址放进bx中,位移量放进al中
地址传送指令:lea,lds,les
lea:有效地址送寄存器指令
lea 寄存器 标号 ,将标号的偏移地址放入寄存器中
lds:指针送寄存器和DS指令
lds 寄存器 标号 ,将代表标号处的4字节地址取出,低2字节放入寄存器,高2字节放入DS中
les:指针送寄存器和ES指令(与lds类似)
标志寄存器传送指令:lahf,sahf,pushf,popf
lahf:标志送ah指令(l 指load,ah是ah寄存器,f是标志寄存器),效果:将 标志寄存器的低字节送入ah中。
sahf:ah送标志寄存器指令(s指 send),效果:将ah的内容送入标志寄存器的低字节。
类型转换指令:cbw,cwd
c指change,转换的意思,b指byte,w指word(单字),d是双字
cbw:将一个字节数据转换为字数据—— al —> ax
cwd:将一个字数据转换为双字数据—— ax —> (dx,ax)
注:是无操作数指令,隐含对al或ax进行符号拓展,执行指令前先把数据放入al或ax中,不影响条件标志位
算术指令
加法指令:add,adc,inc
adc:带进位加法; inc:加1操作
减法指令:sub,sbb,dec,neg,cmp
sbb:带借位减法; dec:减1操作;
neg:取负的; cmp:比较大小(用的是减法操作)
乘法指令:mul,imul
带 i 表示有符号的
除法指令:div,idiv
十进制调整指令:daa,das,aaa,aas,aam,aad
BCD码:用二进制编码的十进制数
压缩的BCD码:用4位二进制数表示1位十进制数
如: (59)
10= ( 0101 1001)BCD非压缩的BCD码:用8位二进制数表示1位十进制数
如:(59)
10= ( 0000 0101 0000 1001)BCD
当BCD码进行算术运算时,可能会出现错位,借位等问题,所以需要进行调整。
- 压缩的BCD码调整指令:
- DAA:加法的十进制调整指令
- DAS:减法的十进制调整指令
- 非压缩的BCD码调整指令:
- AAA:加法的ASCII码调整指令
- AAS:减法的ASCII码调整指令
- AAM:乘法的ASCII码调整指令
- AAD:除法的ASCII码调整指令
逻辑指令
逻辑运算指令:and,or,not,xor,test
xor——异或;
test——测试,做 与运算,但不保存结果,只影响标志位;
移位指令:shl,shr,sal,sar,rol,ror,rcl,rcr
shl——逻辑左移
shr——逻辑右移
sal——算术左移
sar——算术右移
rol——循环左移
ror——循环右移
rcl——带进位循环左移
rcr——带进位循环右移
串处理指令
- 设置方向标志指令:cld,std
- 串处理指令:movsb/movsw,stosb/stosw,lodsb/lodsw,cmpsb/cmpsw,scasb/scasw
控制转移指令
- 无条件转移指令:jmp
- 条件转移指令:jz,je,js,jo,jp,jb,jl,jbe,jle,jcxz
- 循环指令:loop,loopz,loopnz
- 子程序调用和返回指令:call,ret
- 中断与中断返回指令:int,into,iret
处理机控制与杂项操作指令
- 标志处理指令:clc,stc,cmc,cld,std,cli,sti
- 其他:
- nop(无操作,占位1字节)
- hlt(暂停机,等待一次外中断,之后继续执行程序)
- wait(等待,等待外中断,之后仍继续等待)
- esc(换码)
- lock(封锁,维持总线的锁存信号,直到其他的指令执行完)
伪操作
汇编指令是指:与机器指令一一对应,在程序运行期间由计算机执行。
伪操作是指:在汇编程序对源程序汇编期间,由汇编程序处理的操作/指令(只在汇编期间其作用,伪指令不会产生机器码),可以完成如数据定义,分配存储区,指示程序结束等功能。
处理器选择伪操作,段定义伪操作,程序开始和结束伪操作,数据定义及存储器分配伪操作,表达式赋值伪操作,地址计数器与对准伪操作,基数控制伪操作
(具体的暂略)
操作符
操作符:用于操作数中,通过操作符,将常数,寄存器,标号,变量等,组合成表达式,实现求值的目的(还是将汇编期间进行的)。
算术操作符:+,-,*,/,mod
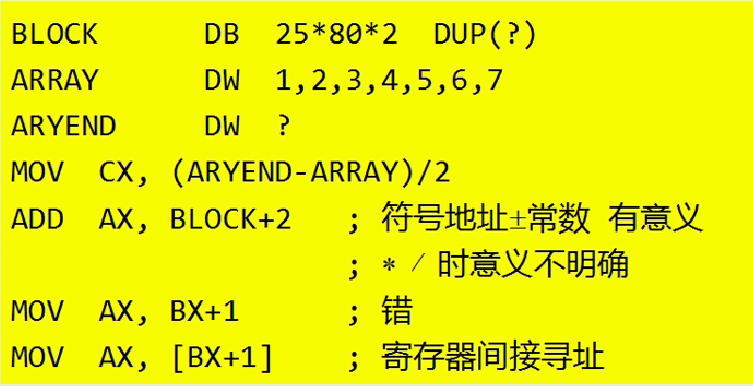
逻辑和移位操作符:and,or,xor,not,shl,shr
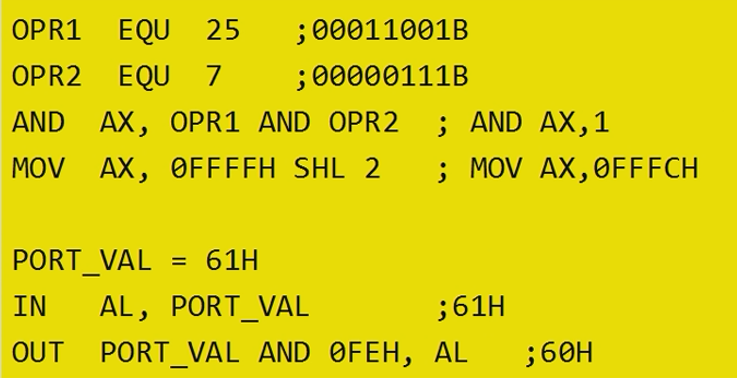
关系操作符:eq,nf,lt,le,gt,ge
数值回送操作符:offset,seg,type,length,size
属性操作符:ptr,段操作符,short,this,high,low,highword,lowword
宏汇编
汇编过程:有两次汇编
- 第一次汇编:确定地址,翻译成各条机器码,字符标号原样写出;
- 第二次汇编:标号代真,将字符标号用计算出的地址值或偏移量代换。
32位汇编
实用技术