计算机网络2.0
TCP/IP网络模型
应用层
用户直接接触到的就是应⽤层(Application Layer),当两个不同设备的应⽤需要通信的时候,应用就把应用数据传给下⼀层,也就是传输层。
所以,应用层只需要专注于为用户提供应用功能,不用去关心数据是如何传输的。
应⽤层是⼯作在操作系统中的⽤户态,传输层及以下则⼯作在内核态。
传输层
传输层(Transport Layer)是为应用层提供网络支持的。
传输层有两个重要协议:TCP和UDP
TCP —— 传输层控制协议(Transmission Control Protocol)
大部分应用使用的正是 TCP 传输层协议,比如 HTTP 应用层协议。TCP 相比 UDP 多了很多特性,比如流量控制、超时重传、拥塞控制等,这些都是为了保证 数据包能可靠地传输给对方。
UDP —— 用户数据报协议(User Datagram Protocol)
UDP 就相对很简单,简单到只负责发送数据包,不保证数据包是否能抵达对方,但它实时性相对更好,传输效率 也高。
MSS —— TCP最大报文段长度
当传输层的数据包大小超过 MSS(TCP 最大报文段长度) ,就要将数据包分块,这样即使中途有⼀个分块丢失或损坏了,只需要重新这⼀个分块,而不用重新发送整个数据包。在 TCP 协议中,我们把每个分块称为⼀个 TCP段(TCP Segment)。
端口:
⼀台设备上可能会有很多应用在接收或者传输数 据,因此需要用一个编号将应用区分开来,这个编号就是端口。
传输层的报文中会携带端口号,因此接收方可以识别出该报文是发送给哪个应用。
公认的默认端口:
0 ~ 1023 是系统端口号,即已经公认定义或为将要公认定义的软件保留的,1024-49151用户端口号 ,49152-65535 是动态端口号 或称私有端口,不能被正式注册占用。
端口 服务 描述 20 /TCP,UDP FTP [Default Data] 文件传输协议 - 默认数据端口 21 /TCP,UDP FTP [Control] 文件传输协议 - 控制端口 22 /TCP,UDP SSH SSH(Secure Shell) - 远程登录协议,用于安全登录文件传输(SCP,SFTP)及端口重新定向 23 /TCP,UDP Telnet Telnet终端仿真协议 - 未加密文本通信 25 /TCP,UDP SMTP SMTP(简单邮件传输协议) - 用于邮件服务器间的电子邮件传递 43 /TCP WHOIS WHOIS协议(who is ,查询域名的相关信息) 53 /TCP,UDP DNS DNS(域名服务系统) 67 /UDP BOOTPs BOOTP服务;同时用于动态主机设置协议 (BootStrap协议,引导程序协议,是DHCP的前身) 68 /UDP BOOTPc BOOTP客户端;同时用于动态主机设定协议 69 /UDP TFTP 小型文件传输协议(小型文件传输协议) 80 /TCP Http 超文本传输协议(超文本传输协议)- 用于传输网页 110 /TCP POP3 邮局协议,“邮局协议”,第3版 - 用于接收电子邮件 113 /TCP Windows验证服务 Ident - 旧的服务器身份识别系统,仍然被IRC服务器用来认证它的用户 123 /UDP NTP NTP(Network Time Protocol) - 用于网络时间同步 137 /TCP,UDP NetBIOS Name Service NetBIOS(网上基本输入输出系统), NetBIOS 名称服务 138 /TCP,UDP NetBIOS Datagram Service NetBIOS NetBIOS 数据报文服务 139 /TCP,UDP NetBIOS Session Service NetBIOS NetBIOS 会话服务 143 /TCP,UDP IMAP 因特网信息访问协议(Internet Message Access Protocol) - 用于检索 电子邮件 161 /TCP,UDP SNMP 简单网络管理协议 179 /TCP Bgp 边界网关协议 (Border Gateway Protocol) 194 /TCP IRC 互联网中继聊天(Internet Relay Chat) 220 /TCP,UDP IMAP3 因特网信息访问协议,交互邮件访问协议第3版 389 /TCP,UDP LDAP 轻型目录访问协议(Lightweight Directory Access Protocol) 443 /TCP Https 超文本传输安全协议 - 超文本传输协议 over TLS/SSL(加密传输) 546 /TCP,UDP DHCPv6 client DHCPv6客户端(动态主机配置协议,Dynamic Host Configuration Protocol) 547 /TCP,UDP DHCPv6 server DHCPv6服务器 631 /TCP,UDP CUPS 通用Unix打印系统 636 /TCP,UDP LDAPS LDAP over SSL(加密传输,也被称为LDAPS) 991 /TCP,UDP NAS NAS (Netnews Admin System, 网络新闻管理系统 ) 1080 /tcp SOCKS SOCKS代理 1194 /udp OpenVPN OpenVPN 1433 /tcp,udp SQL Server Microsoft SQL 数据库系统 1434 /tcp,udp SQL Server monitor Microsoft SQL 活动监视器 1521 /tcp Oracle Oracle数据库 default listener, in future releases official port 2483 3306 /tcp,udp MySQL MySQL数据库系统 3389 /tcp RDP 远程桌面协议(RDP) 5432 /tcp PostgreSQL PostgreSQL database system
网络层
网络层负责 实际的数据传输功能;
⼀个设备的数据要传输给另⼀个设备,就需要在各种各样的路径和节点进行选择,而传输层的设计理念是简单、高效、专注,所以这些功能交由网络层实现。
主要协议: IP
IP 协议会将传输层的报文作为数据部分,再加上 IP 包头组装 成 IP 报文,如果 IP 报文大小超过 MTU(最大传输但与,以太网中⼀般为 1500 字节)就会再次进行分片,得到⼀个即将发送到网络的 IP 报文。
IP地址分为两种意义 :
- 网络号:负责标识该 IP 地址是属于哪个子网的
- 主机号:负责标识同⼀子网下的不同主机
路由:通过算法决定下一步走哪一条路径。
IP 协议的寻址作用是告诉我们去往下⼀个目的地该朝哪个⽅向走,路由则是根据「下⼀个目的地」选择路径。寻址更像在导航,路由更像在操作⽅向盘。
数据链路层
数据链路层 标识网络中的设备,为网络层提供链路级别传输的服务。
每⼀台设备的网卡都会有⼀个 MAC 地址,它就是用来唯⼀标识设备的。路由器计算出了下⼀个目的地 IP 地址,再通过 ARP 协议找到该目的地的 MAC 地址,这样就知道这个 IP 地址是哪个设备的了。
物理层
当数据准备要从设备发送到网络时,需要把数据包转换成电信号,让其可以在物理介质中传输,这⼀层就是物理层 (Physical Layer),它主要是为数据链路层提供⼆进制传输的服务。
HTTP
基础概述
HTTP,是超文本传输协议,HyperText Transfer Protocol
状态码
HTTP五大类状态码:
| 状态码 | 含义 |
|---|---|
| 1** | 提示信息,表示目前是协议处理的中间状态,还需要后续操作 |
| 2** | 成功,报文已经收到并正确处理 |
| 3** | 重定向,资源位置发生变动,需要客户端重新发送请求 |
| 4** | 客户端错误,请求报文有误,服务器无法处理 |
| 5** | 服务器错误,服务器在处理请求时内部发生错误 |
1xx —— 属于提示信息,是协议处理中的⼀种中间状态,实际⽤到的⽐较少。
2xx —— 类状态码表示服务器成功处理了客户端的请求,也是我们最愿意看到的状态。
- 「200 OK」:是最常见的成功状态码,表示⼀切正常。如果是非 HEAD 请求,服务器返回的响应头都会有 body 数据。
- 「204 No Content」:也是常见的成功状态码,与 200 OK 基本相同,但响应头没有 body 数据。
- 「206 Partial Content」:是应用于 HTTP 分块下载或断点续传,表示响应返回的 body 数据并不是资源的全部,而是其中的⼀部分,也是服务器处理成功的状态。
3xx —— 表示客户端请求的资源发送了变动,需要客户端用新的 URL 重新发送请求获取资源,也就是重定向。
「301 Moved Permanently」表示永久重定向,说明请求的资源已经不存在了,需改⽤新的 URL 再次访问。
「302 Found」表示临时重定向,说明请求的资源还在,但暂时需要⽤另⼀个 URL 来访问。
301 和 302 都会在响应头里使用字段 Location ,指明后续要跳转的 URL,浏览器会自动重定向新的 URL。
「304 Not Modified」不具有跳转的含义,表示资源未修改,重定向已存在的缓冲文件,也称缓重定向,用于缓 控制。
4xx —— 表示客户端发送的报文有误,服务器无法处理,也就是错误码的含义。
- 「400 Bad Request」表示客户端请求的报文有错误,但只是个笼统的错误。
- 「403 Forbidden」表示服务器禁止访问资源,并不是客户端的请求出错。
- 「404 Not Found」表示请求的资源在服务器上不存在或未找到,所以无法提供给客户端。
5xx —— 表示客户端请求报文正确,但是服务器处理时内部发⽣了错误,属于服务器端的错误码。
- 「500 Internal Server Error」与 400 类型一样,是个笼统通用的错误码,服务器发生了什么错误,我们并不知道。
- 「501 Not Implemented」表示客户端请求的功能还不⽀持,类似“即将开业,敬请期待”的意思。
- 「502 Bad Gateway」通常是服务器作为网关或代理时返回的错误码,表示服务器自身工作正常,访问后端服务器 发生了错误。
- 「503 Service Unavailable」表示服务器当前很忙,暂时⽆法响应服务器,类似“网络服务正忙,请稍后再试”的意思。
常见字段
Host 字段 —— 客户端发送请求时,用来指定服务器的域名。
例: Host: www. baidu.com ,有了Host字段,就可以将请求发往「同⼀台」服务器上的不同网站。
Content-Length 字段 —— 服务器本次回应返回的数据长度。
Connection 字段 —— 用于客户端要求服务器使用TCP 持久连接,以便其他请求复用。
Connection:Keep-Alive
HTTP/1.1 版本的默认连接都是持久连接,但为了兼容⽼版本的 HTTP,需要指定 Connection ⾸部字段的值为 Keep-Alive.
⼀个可以复用的 TCP 连接会持续到 客户端或服务器主动关闭连接。
Content-Type —— 用于服务器回应时,告诉客户端,本次数据是什么格式。
Accept —— 客户端声明自己可以接收哪些数据格式
客户端 Accept: */* (表示能接收所有数据格式
服务器 Content-Type: text/html; charset=utf-8
Content-Encoding —— 说明数据的压缩方法,即服务器返回的数据用了什么压缩格式
Accept-Encoding —— 客户端能接受的压缩方式。
GET与POST
GET —— 请求从服务器获取资源;
POST —— 向 url 指定的资源提交数据,数据就放在报文的 body 里;
安全:在 HTTP 协议⾥,所谓的「安全」是指请求⽅法不会「破坏」服务器上的资源。
幂等:是指多次执⾏相同的操作,结果都是「相同」的。
对此 ——
- GET方法是安全且幂等的,因为它是「只读」操作,无论操作多少次,服务器上的数据都是安全 的,且每次的结果都是相同的;
- POST 因为是「新增或提交数据」的操作,会修改服务器上的资源,所以是不安全的,且多次提交数据就会创建多 个资源,所以不是幂等的。
特性
优点:简单、灵活和易于扩展、应用广泛和跨平台。
简单: HTTP 基本的报文格式就是 header + body ,头部信息也是 key-value 简单文本的形式,易于理解。
灵活和易于扩展::HTTP协议里的各类请求方法、URI/URL、状态码、头字段等每个组成要求都没有被固定死,都允许自定义和扩充。
同时HTTP是工作再应用层的,它的下层可以随意变化,比如:HTTPS就是在HTTP和TCP之间增加了SSL/TLS安全传输层,HTTP3还把TCP换成了基于UDP的QUIC。
缺点:无状态,明文传输,不安全
无状态
好处在于服务器不会去记忆 HTTP 的状态,所以不需要额外的资源来记录状态信息,这能减轻服务器的 负担,能够把更多的 CPU 和内存用来对外提供服务。
坏处是在完成有关联性的操作时会非常麻烦,需要每次都询问身份信息。
最简单的解决方式:使用 Cookie 技术
明文传输
好处在于方便阅读,通过浏览器控制台或抓包都可以直接查看,便于调试。
坏处是 信息裸奔了,很容易被窃取信息。
不安全
- 窃听风险:通信使用明文;
- 冒充风险:不验证通信方的身份,可能遭遇伪装;
- 篡改风险:无法证明报文的完整性,可能数据遭到篡改
解决:可以用HTTPS,也就是引入 SSL/TLS 层
HTTP/1.1性能
长连接
HTTP/1.0每次发起请求,都要新建一次TCP连接,而且是串行请求,做了无所谓的TCP建立连接和断开。
HTTP/1.1提出了 长连接,也就是持久连接,只要任意一端没有明确提出断开连接,则会保持TCP连接状态。
长连接使得 管道网络传输 成为可能,即在同⼀个 TCP 连接里面,客户端可以发起多个请求,只要第一个请求发出去了,不必等其回来,就可以发第二个请求出去,可以减少整体的响应时间。
但是服务器还是得按顺序处理请求,可能发生 队头阻塞。
队头阻塞
「请求 - 应答」的模式会发送队头阻塞,影响性能;
因为当顺序发送的请求序列中的⼀个请求因为某种原因被阻塞时,在后⾯排队的所有请求也⼀同被阻塞了,会招致客户端⼀直请求不到数据。
HTTPS
概述
HTTPS 在 HTTP 与 TCP 层之间加入了 SSL/TLS 协议,可以很好的解决了上述的风险:
信息加密:交互信息无法被窃取;
使用混合加密的方式实现信息的机密性。
混合加密: 对称加密 + 非对称加密
- 在通信建立前采用非对称加密的方式交换「会话秘钥」,后续就不再使用非对称加密。
- 在通信过程中全部使用对称加密的「会话秘钥」的方式加密明文数据。
之所以使用混合加密是因为:
- 对称加密 只使用⼀个密钥,运算速度快,密钥必须保密,无法做到安全的密钥交换。
- 非对称加密 使用两个密钥:公钥和私钥,公钥可以任意分发而私钥保密,解决了密钥交换问题但速度慢。
校验机制:无法篡改通信内容,篡改了就不能正常显示;
使用 摘要算法 来实现完整性,它能够为数据生成独一无二的「指纹」,指纹用于校验数据的完整性,解决 了篡改的风险。
客户端在发送明文之前会通过摘要算法算出明文的「指纹」,发送的时候把「指纹 + 明文」⼀同加密成密文后,发送给服务器,服务器解密后,用相同的摘要算法算出发送过来的明文,通过比较客户端携带的「指纹」和当前算出 的「指纹」做⽐较,若「指纹」相同,说明数据是完整的。
身份证书:证明网站合法性;
将服务器公钥放入到数字证书中,解决了冒充的风险。
公钥的可信度:将公钥放在CA(数字证书认证机构)颁发的数字证书中,只要证书可信,公钥就可信;
- 服务器把自己的公钥注册到CA;
- CA用自己的私钥将服务器的公钥 数字签名,并颁发数字证书;
- 客户端拿到服务器的数字证书后,使用CA的公钥确认服务器的数字证书的真实性;
- 从数字证书获取服务器的公钥后,使用公钥对报文加密后发送;
- 服务器使用是要对报文解密;
HTTPS建立连接
SSL/TLS 协议基本流程:
- 客户端向服务器索要并验证服务器的公钥。
- 双方协商生产「会话秘钥」。
- 双方采用「会话秘钥」进行加密通信。
前两步是SSL/TLS的建立过程,即握手阶段,设计四次通信:
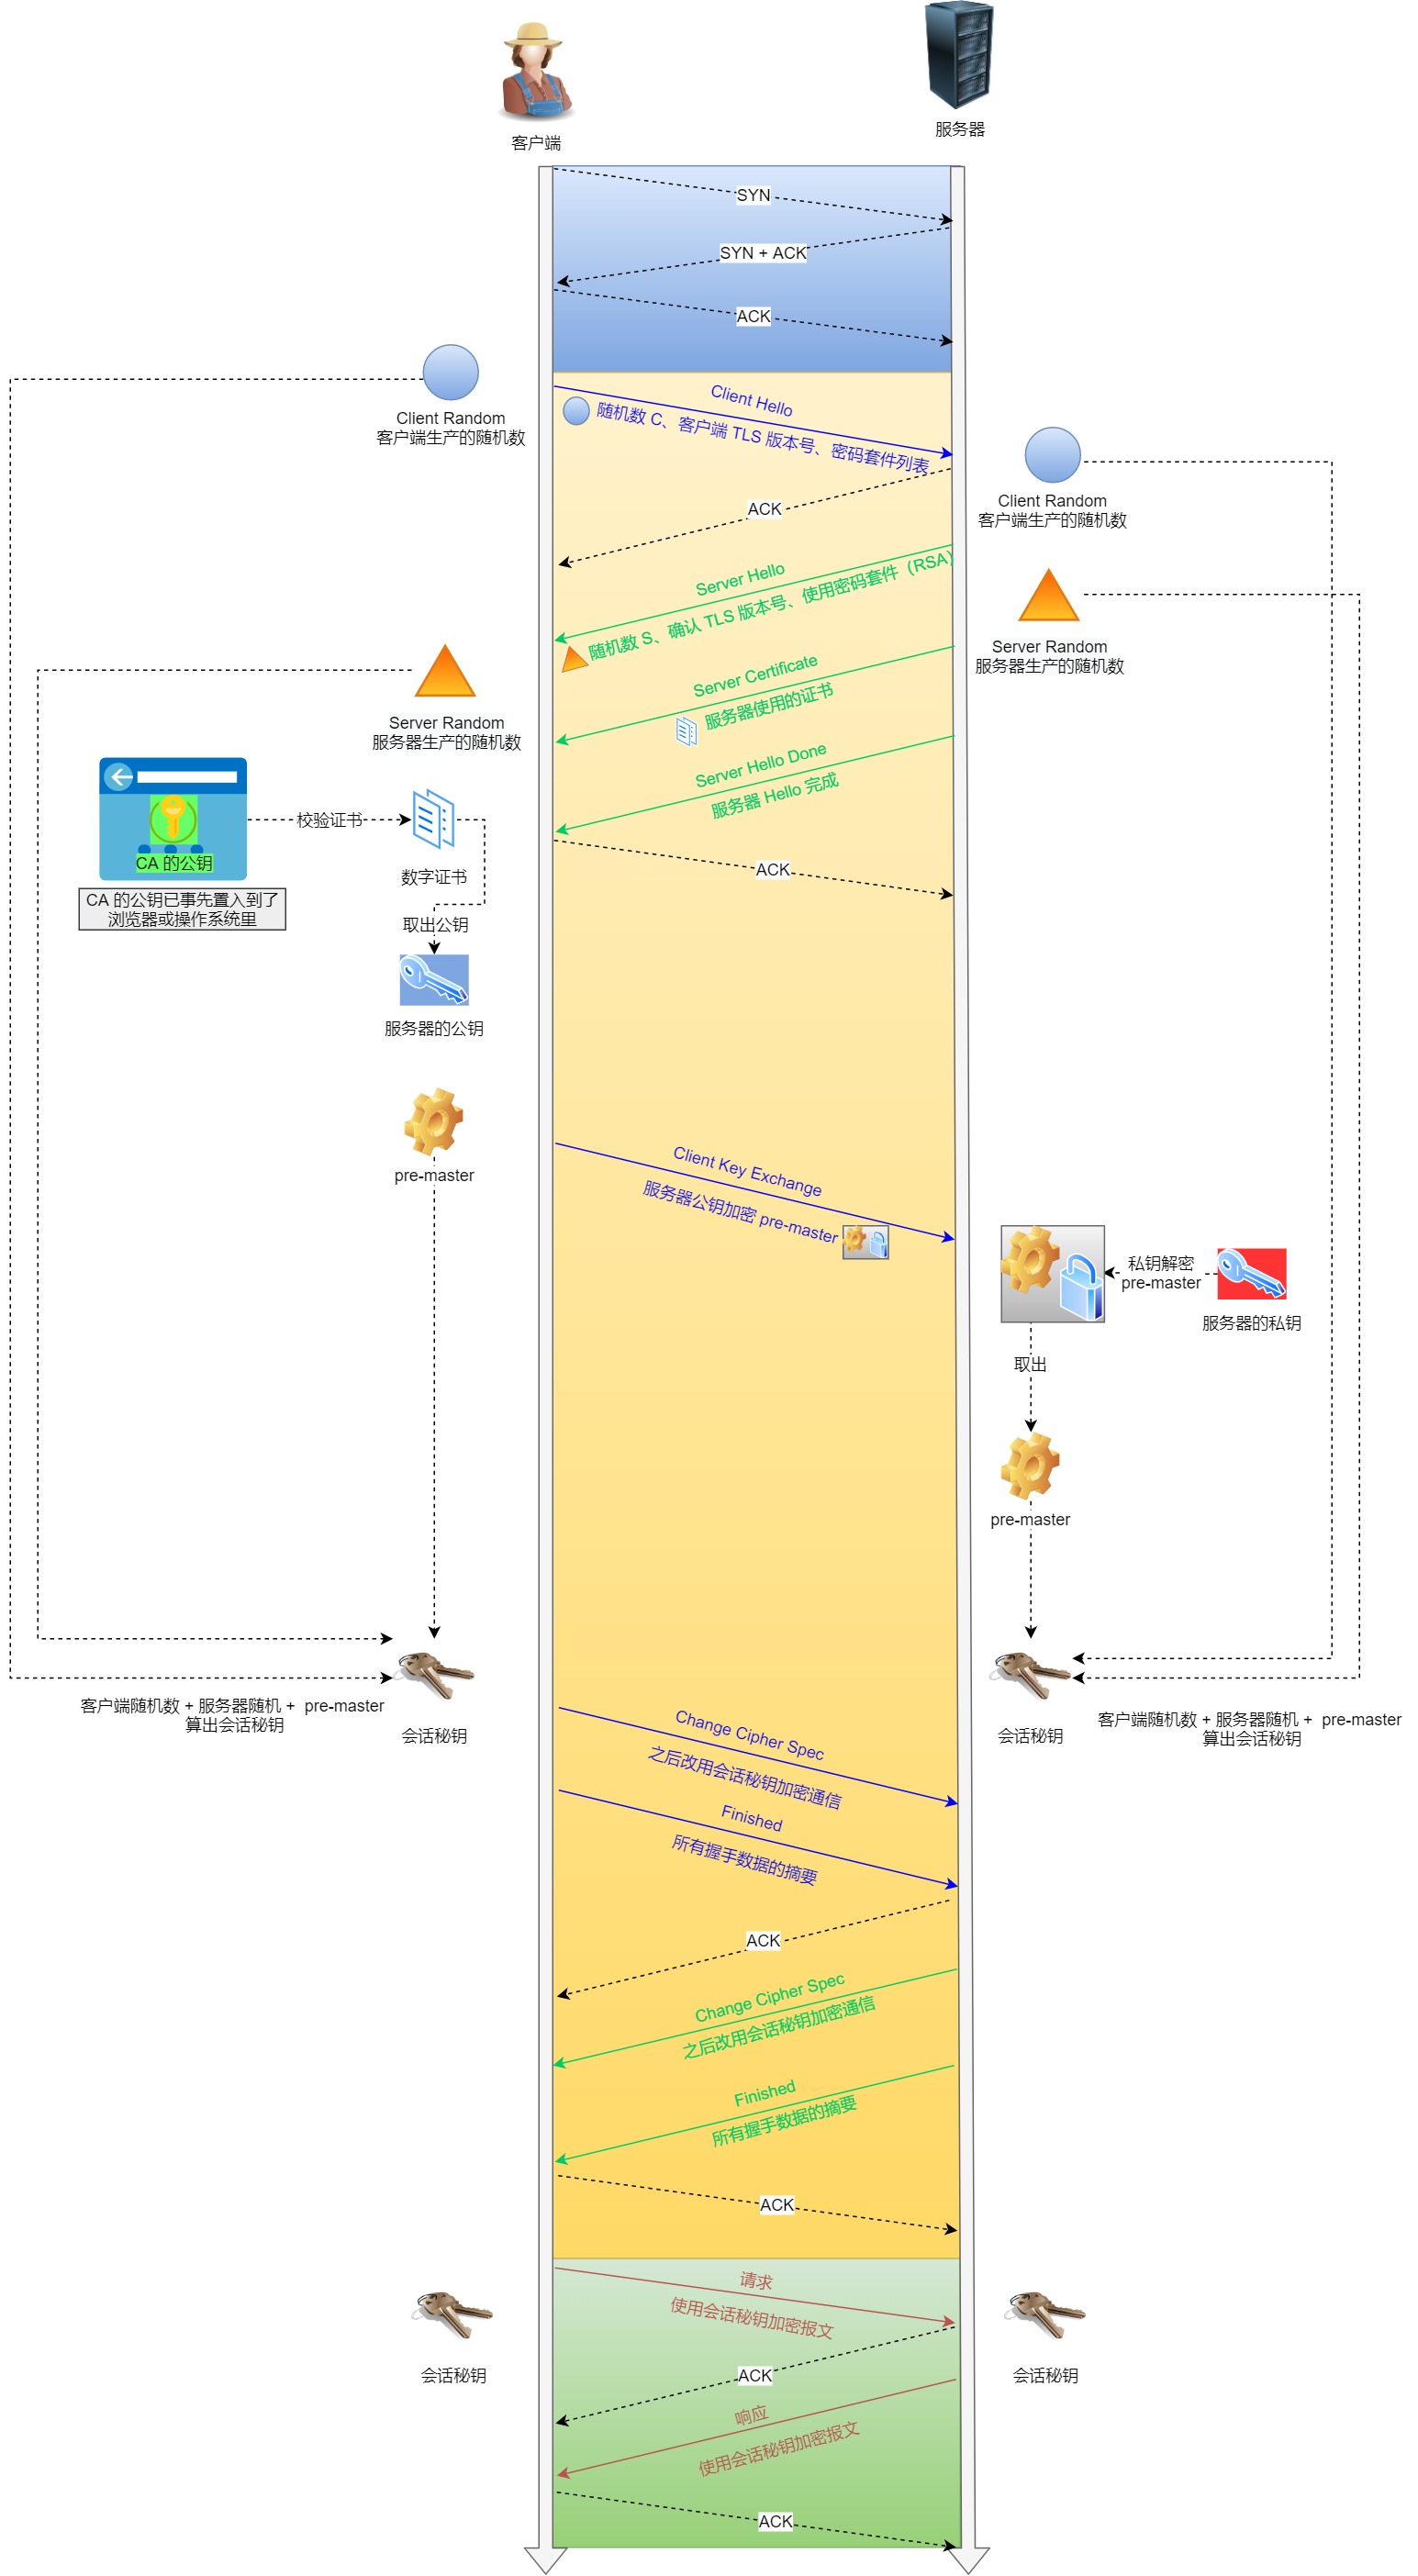
流程:
1. ClientHello
首先,由客户端向服务器发起加密通信请求,也就是 ClientHello 请求。
在这一步,客户端主要向服务器发送以下信息:
(1)客户端支持的 SSL/TLS 协议版本,如 TLS 1.2 版本。
(2)客户端生产的随机数(Client Random),后面用于生成「会话秘钥」条件之一。
(3)客户端支持的密码套件列表,如 RSA 加密算法。
2. SeverHello
服务器收到客户端请求后,向客户端发出响应,也就是 SeverHello。服务器回应的内容有如下内容:
(1)确认 SSL/ TLS 协议版本,如果浏览器不支持,则关闭加密通信。
(2)服务器生产的随机数(Server Random),也是后面用于生产「会话秘钥」条件之一。
(3)确认密码套件列表,如 RSA 加密算法。
(4)服务器的数字证书。
3.客户端回应
客户端收到服务器的回应之后,首先通过浏览器或者操作系统中的 CA 公钥,确认服务器的数字证书的真实性。
如果证书没有问题,客户端会从数字证书中取出服务器的公钥,然后使用它加密报文,向服务器发送如下信息:
(1)一个随机数(pre-master key)。该随机数会被服务器公钥加密。
(2)加密通信算法改变通知,表示随后的信息都将用「会话秘钥」加密通信。
(3)客户端握手结束通知,表示客户端的握手阶段已经结束。这一项同时把之前所有内容的发生的数据做个摘要,用来供服务端校验。
上面第一项的随机数是整个握手阶段的第三个随机数,会发给服务端,所以这个随机数客户端和服务端都是一样的。
服务器和客户端有了这三个随机数(Client Random、Server Random、pre-master key),接着就用双方协商的加密算法,各自生成本次通信的「会话秘钥」。
4. 服务器的最后回应
服务器收到客户端的第三个随机数(pre-master key)之后,通过协商的加密算法,计算出本次通信的「会话秘钥」。
然后,向客户端发送最后的信息:
(1)加密通信算法改变通知,表示随后的信息都将用「会话秘钥」加密通信。
(2)服务器握手结束通知,表示服务器的握手阶段已经结束。这一项同时把之前所有内容的发生的数据做个摘要,用来供客户端校验。
至此,整个 SSL/TLS 的握手阶段全部结束。接下来,客户端与服务器进入加密通信,就完全是使用普通的 HTTP 协议,只不过用「会话秘钥」加密内容。
关于SSL和TLS:
SSL 叫 安全套接层,Secure Sockets Layer ,由网景公司设计,因为应用广泛,成为互联网上的事实标准。
IETF 就把 SSL 标准化。标准化之后的名称改为 TLS(Transport Layer Security),叫 传输层安全协议。
因此,SSL 和 TLS 可以视作同一东西的不同阶段。
SSL1.2 需要4次握手,2个RTT时延;而SSL/TLS1.3 只需3次握手,1个RTT时延。
HTTP/1.1~2~3的演变
HTTP/1.1
HTTP/1.1 相比 HTTP/1.0 性能上的改进:
- 使用 TCP 长连接的方式改善了 HTTP/1.0 短连接造成的性能开销。
- 支持管道(pipeline)网络传输,只要第一个请求发出去了,不必等其回来,就可以发第二个请求出去,可以减少整体的响应时间。
但 HTTP/1.1 还是有性能瓶颈:
- 请求 / 响应头部(Header)未经压缩就发送,首部信息越多延迟越大。只能压缩
Body的部分; - 发送冗长的首部。每次互相发送相同的首部造成的浪费较多;
- 服务器是按请求的顺序响应的,如果服务器响应慢,会招致客户端一直请求不到数据,也就是队头阻塞;
- 没有请求优先级控制;
- 请求只能从客户端开始,服务器只能被动响应。
HTTP/2
HTTP/2 协议是基于 HTTPS 的,所以 HTTP/2 的安全性也是有保障的。
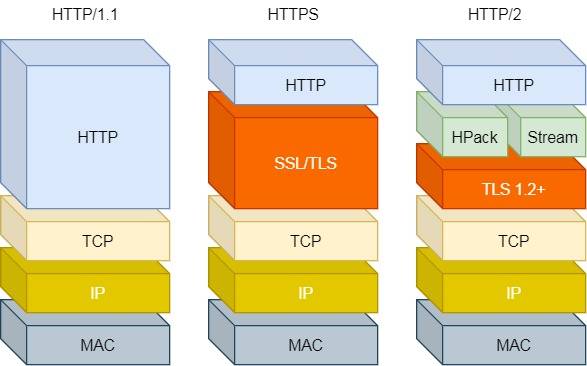
1. 头部压缩
HTTP/2 会压缩头(Header)如果你同时发出多个请求,他们的头是一样的或是相似的,那么,协议会帮你消除重复的部分。
这就是所谓的 HPACK 算法:在客户端和服务器同时维护一张头信息表,所有字段都会存入这个表,生成一个索引号,以后就不发送同样字段了,只发送索引号,这样就提高速度了。
2. 二进制格式
HTTP/2 不再像 HTTP/1.1 里的纯文本形式的报文,而是全面采用了二进制格式,头信息和数据体都是二进制,并且统称为帧(frame):头信息帧(Headers Frame)和数据帧(Data Frame)。
在收到报文后,无需再将明文的报文转成二进制,而是直接解析二进制报文,这增加了数据传输的效率。
3. 数据流
HTTP/2 的数据包不是按顺序发送的,同一个连接里面连续的数据包,可能属于不同的回应。因此,必须要对数据包做标记,指出它属于哪个回应。
在 HTTP/2 中每个请求或相应的所有数据包,称为一个数据流(Stream)。每个数据流都标记着一个独一无二的编号(Stream ID),不同 Stream 的帧是可以乱序发送的(因此可以并发不同的 Stream ),因为每个帧的头部会携带 Stream ID 信息,所以接收端可以通过 Stream ID 有序组装成 HTTP 消息
客户端和服务器双方都可以建立 Stream, Stream ID 也是有区别的,客户端建立的 Stream 必须是奇数号,而服务器建立的 Stream 必须是偶数号。
客户端还可以指定数据流的优先级。优先级高的请求,服务器就先响应该请求。
4. 多路复用
HTTP/2 是可以在一个连接中并发多个请求或回应,而不用按照顺序一一对应。
移除了 HTTP/1.1 中的串行请求,不需要排队等待,也就不会再出现「队头阻塞」问题,降低了延迟,大幅度提高了连接的利用率。
举例来说,在一个 TCP 连接里,服务器收到了客户端 A 和 B 的两个请求,如果发现 A 处理过程非常耗时,于是就回应 A 请求已经处理好的部分,接着回应 B 请求,完成后,再回应 A 请求剩下的部分。
5. 服务器推送
HTTP/2 还在一定程度上改善了传统的「请求 - 应答」工作模式,服务不再是被动地响应,也可以主动向客户端发送消息。
比如,客户端通过 HTTP/1.1 请求从服务器那获取到了 HTML 文件,而 HTML 可能还需要依赖 CSS 来渲染页面,这时客户端还要再发起获取 CSS 文件的请求,需要两次消息往返,而在 HTTP/2 中,客户端在访问 HTML 时,服务器可以直接主动推送 CSS 文件,减少了消息传递的次数。
HTTP/2缺陷:
在TCP层仍存在队头阻塞问题:
TCP 是字节流协议,TCP 层必须保证收到的字节数据是完整且连续的,这样内核才会将缓冲区里的数据返回给 HTTP 应用,那么当「前 1 个字节数据」没有到达时,后收到的字节数据只能存放在内核缓冲区里,只有等到这 1 个字节数据到达时,HTTP/2 应用层才能从内核中拿到数据,这就是 HTTP/2 队头阻塞问题。
HTTP/3
HTTP/1.1 中的管道( pipeline)虽然解决了请求的队头阻塞,但是没有解决响应的队头阻塞,
HTTP/2 虽然通过多个请求复用一个 TCP 连接解决了 HTTP 的队头阻塞 ,但是一旦发生丢包,就会阻塞住所有的 HTTP 请求,这属于 TCP 层队头阻塞。
对此,HTTP/3 把 HTTP 下层的 TCP 协议改成了 UDP!
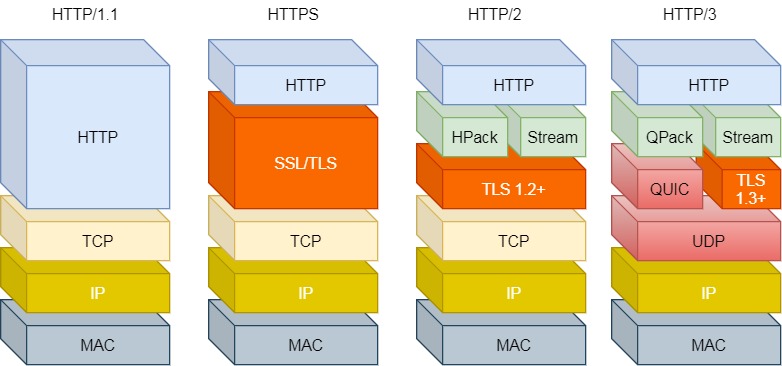
并且,基于 UDP 的 QUIC 协议 可以实现类似 TCP 的可靠性传输。
QUIC有以下特点:
无队头阻塞
QUIC 协议也有类似 HTTP/2 Stream 与多路复用的概念,也是可以在同一条连接上并发传输多个 Stream,Stream 可以认为就是一条 HTTP 请求。
QUIC 有自己的一套机制可以保证传输的可靠性的。当某个流发生丢包时,只会阻塞这个流,其他流不会受到影响,因此不存在队头阻塞问题。(Stream之间没有依赖,都是独立的)
更快的连接建立
对于 HTTP/1 和 HTTP/2 协议,TCP 和 TLS 是分层的,分别属于内核实现的传输层、openssl 库实现的表示层,因此它们难以合并在一起,需要分批次来握手,先 TCP 握手,再 TLS 握手。
HTTP/3 在传输数据前虽然需要 QUIC 协议握手,这个握手过程只需要 1 RTT,握手的目的是为确认双方的「连接 ID」,连接迁移就是基于连接 ID 实现的。
但是 HTTP/3 的 QUIC 协议并不是与 TLS 分层,而是QUIC 内部包含了 TLS,它在自己的帧会携带 TLS 里的“记录”,再加上 QUIC 使用的是 TLS/1.3,因此仅需 1 个 RTT 就可以「同时」完成建立连接与密钥协商,如图:
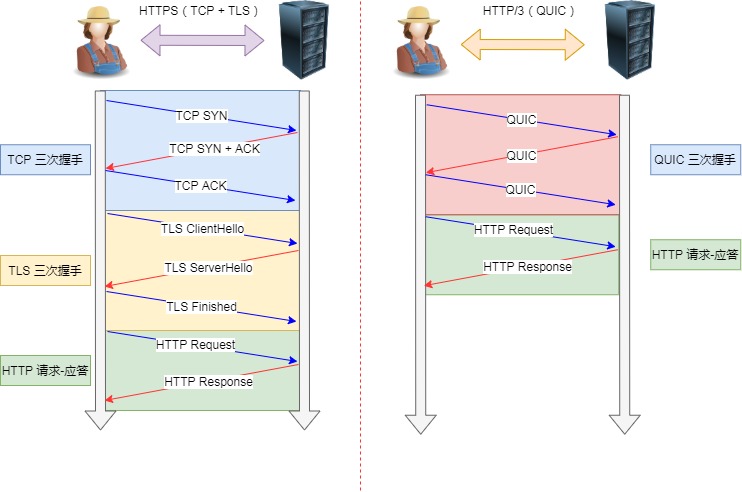
在第二次连接的时候,应用数据包还可以和 QUIC 握手信息(连接信息 + TLS 信息)一起发送,达到 0-RTT 的效果。
连接迁移
基于 TCP 传输协议的 HTTP 协议,由于是通过四元组(源 IP、源端口、目的 IP、目的端口)确定一条 TCP 连接,那么当移动设备的网络从 4G 切换到 WIFI 时,意味着 IP 地址变化了,那么就必须要断开连接,然后重新建立连接。而建立连接的过程包含 TCP 三次握手和 TLS 四次握手的时延,以及 TCP 慢启动的减速过程,给用户的感觉就是网络突然卡顿了一下,因此连接的迁移成本是很高的。
而 QUIC 协议没有用四元组的方式来“绑定”连接,而是通过连接 ID来标记通信的两个端点,客户端和服务器可以各自选择一组 ID 来标记自己,因此即使移动设备的网络变化后,导致 IP 地址变化了,只要仍保有上下文信息(比如连接 ID、TLS 密钥等),就可以“无缝”地复用原连接,消除重连的成本,没有丝毫卡顿感,达到了连接迁移的功能。
所以, QUIC 是一个在 UDP 之上的伪 TCP + TLS + HTTP/2 的多路复用的协议。
不过,QUIC 是新协议,对于很多网络设备,根本不知道什么是 QUIC,只会当做 UDP,这样会出现新的问题,因为有的网络设备是会丢掉 UDP 包的,而 QUIC 是基于UDP 实现的,那么如果网络设备无法识别这个是 QUIC 包,那么就会当作 UDP包,然后被丢弃。
所以,HTTP/3 现在普及的进度非常的缓慢。
HTTP/1.1如何优化
思路:
尽量避免发送 HTTP 请求;
—— 缓存:将请求的url作为key,响应作为value; 并估算一个过期时间,过期后发请求,会带上上一次请求的摘要,服务器比对后,如果一样,仅返回不含包体的
304 Not Modified响应,不一样就带上最新的资源。在需要发送 HTTP 请求时,考虑如何减少请求次数;
—— 减少重定向请求次数: 将重定向工作交给代理服务器。
—— 合并请求: 比如将多个小图片放在一起发送,将css、js一起打包发送,但缺点是:如果其中一个资源发送变化,客户端必须重新下载整个大资源文件。
—— 延迟发送请求:一般页面中有很多url,没必要全部获取,只获取当前用户所看到的页面资源。
减少服务器的 HTTP 响应的数据大小;
—— 无损压缩: 如Brotli,gzip等算法
—— 有损压缩:WebP格式(图片压缩)
HTTPS TLS握手解析
HTTPS 是应用层协议,需要先完成 TCP 连接建立,然后走 TLS 握手过程后,才能建立通信安全的连接。
事实上,不同的密钥交换算法,TLS 的握手过程可能会有一些区别。
通常经过「四个消息」就可以完成 TLS 握手,也就是需要 2个 RTT 的时延,然后就可以在安全的通信环境里发送 HTTP 报文,实现 HTTPS 协议。
- 客户端:ClientHello
- 服务端:ServerHello,Certificate,ServerHelloDone
- 客户端:ClientKeyExchange,ChangeCipherSpec,Finished
- 服务端:ChangeCiipherSpec,Finished
早先的密钥交换算法是RSA算法,但不支持前向保密(一旦服务端的私钥泄漏了,过去被第三方截获的所有 TLS 通讯密文都会被破解)。现在大多数网站使用的正是 ECDHE 密钥协商算法,
RSA算法
RSA算法中,TLS 证书部署服务端时,证书文件中包含一对公私钥,其中公钥会在 TLS 握手阶段传递给客户端,私钥则一直留在服务端,需要确保私钥不被窃取。
TLS第一次握手
客户端发出一个「Client Hello」,消息里面有客户端使用的 TLS 版本号、支持的密码套件列表,以及生成的随机数(Client Random),这个随机数会被服务端保留,它是生成对称加密密钥的材料之一。
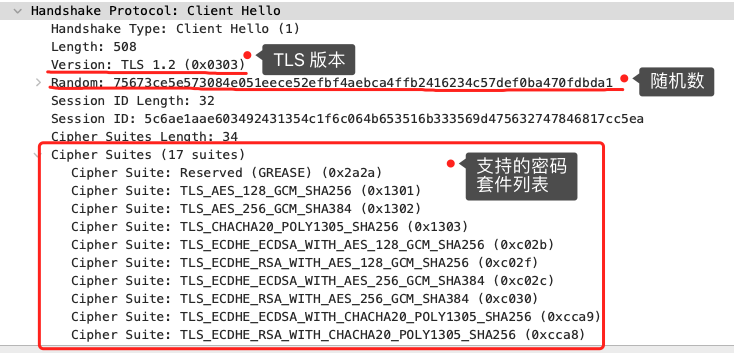
TLS第二次握手
当服务端收到客户端的「Client Hello」消息后,会确认 TLS 版本号是否支持,和从密码套件列表中选择一个密码套件,以及生成随机数(Server Random)。
接着,返回「Server Hello」消息,消息里面有服务器确认的 TLS 版本号,也给出了随机数(Server Random),然后从客户端的密码套件列表选择了一个合适的密码套件。
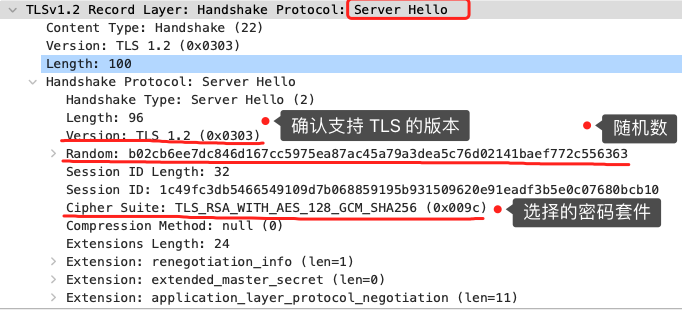
上图选择的密码套件: “Cipher Suite: TLS_RSA_WITH_AES_128_GCM_SHA256” ,其基本的形式是「密钥交换算法 + 签名算法 + 对称加密算法 + 摘要算法」。
其中 “TLS”后 “WITH” 前 一般有两个单词,为密钥交换算法 和 约定证书的验证算法。图中只有RSA,说明这个算法用的都是RSA;
握手后的通信使用 AES 对称算法,密钥长度 128 位,分组模式是 GCM;
摘要算法 SHA256 用于消息认证和产生随机数;
此时,两个 HELLO 就确认了TLS 版本和使用的密码套件,并且各自发了一个随机数给对方,这是生成 「会话密钥」的条件。
然后,服务端为了证明自己的身份,会发送「Server Certificate」给客户端,这个消息里含有数字证书。
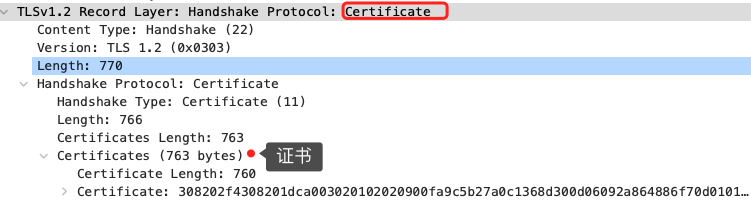
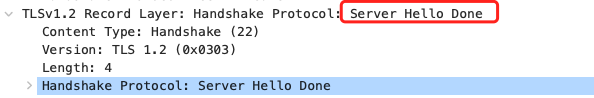
随后,服务端发送「Server Hello Done」消息,目的是告诉客户端,我已经把该给你的东西都给你了,本次打招呼完毕。
TLS第三次握手
客户端验证完证书后,认为可信则继续往下走。
接着,客户端就会生成一个新的随机数 (pre-master),用服务器的 RSA 公钥加密该随机数,通过「Change Cipher Key Exchange」消息传给服务端。
服务端会用RSA私钥解密,得到 pre-master。
此时,双方都有了三个随机数:Client Random、Server Random、pre-master,根据这三个随机数,就可以生成 会话密钥(Master Secret),它是对称密钥,用于对后续的 HTTP 请求/响应的数据加解密。
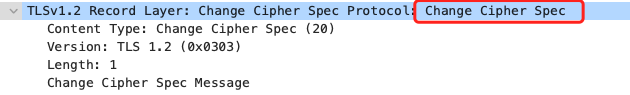
客户端生成会话密钥后,发送一个「Change Cipher Spec」,告诉服务端开始使用加密方式发送消息。
然后再发一个「Encrypted Handshake Message(Finishd)」消息,把之前所有发送的数据做个摘要,再用会话密钥(master secret)加密一下,让服务器做个验证,验证加密通信是否可用和之前握手信息是否有被中途篡改过。
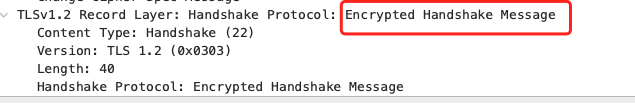
可以发现,在「Change Cipher Spec」之前传输的 TLS 握手数据都是明文,之后都是对称密钥加密的密文。
TLS第四次握手
服务器也是同样的操作,发「Change Cipher Spec」和「Encrypted Handshake Message」消息,如果双方都验证加密和解密没问题,那么握手正式完成。
之后就可以用 会话密钥加解密 HTTP 请求和响应了。
ECDHE算法
ECDHE 密钥协商算法是 DH 算法演进过来,DH算法的核心数学思想是 离散对数。
离散对数
离散对数是在对数运算的基础上加了「模运算」,也就说取余数,即 % 或 mod 。
式子: a^i^ % p = b , 底数a和模板p是公共参数,是公开的,b是真数,i 是对数。
一般 对数 作为密钥,知道了对数,能算出真数,但只知道 真数,且模板p是很大的质数时,极难算出 对数。
DH算法
DH算法的密钥交换过程:
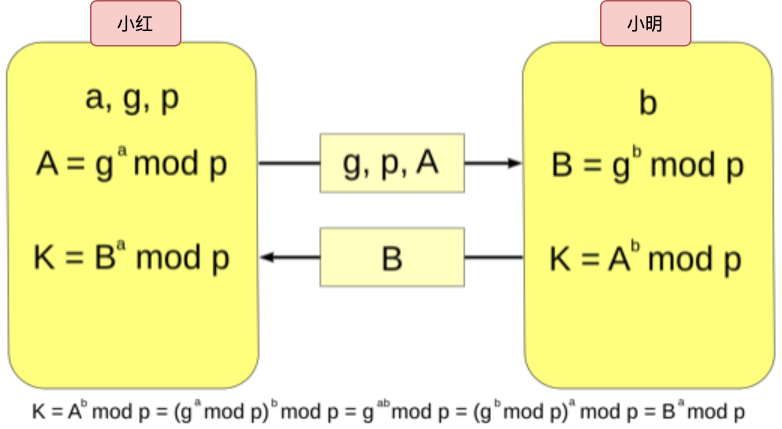
首先双方会先确定模板和底数,两个数是公开的,设模板为P,底数为G;
然后各自生成一个随机整数为私钥,假设双方的密钥为a和b。
于是有:
公钥A = G ^a^ % P
公钥B = G ^b^ % P
之后将公钥发给对方, 双方都可以算出一个相同的对称加密密钥k, k = B ^a^ % P = A ^b^ % p。
DH算法的实现:
DHE算法,E 是指 ephemeral(临时性的),即双方的私钥在每次密钥交换通信时,都是随机生成的、临时的。
DH算法的另一个实现是 static DH,即有一方的私钥是静态的,一般是服务器方固定私钥,但这样通过大量密钥协商过程的数据 可能可以暴力破解出服务器的私钥。
所以 static DH 算法不具备前向安全性,并不被采用。
ECDHE算法
现在广泛应用的密钥交换算法 —— ECDHE算法。
ECDHE算法在 DHE算法的基础上,利用了ECC椭圆曲线特性,可以用更少的计算量计算出公钥,以及最终的会话密钥。
小红和小明使用 ECDHE 密钥交换算法的过程:
- 双方事先确定好使用哪种椭圆曲线,和曲线上的基点 G,这两个参数都是公开的;
- 双方各自随机生成一个随机数作为私钥d,并与基点 G相乘得到公钥Q(Q = dG),此时小红的公私钥为 Q1 和 d1,小明的公私钥为 Q2 和 d2;
- 双方交换各自的公钥,最后小红计算点(x1,y1) = d1Q2,小明计算点(x2,y2) = d2Q1,由于椭圆曲线上是可以满足乘法交换和结合律,所以 d1Q2 = d1d2G = d2d1G = d2Q1 ,因此双方的 x 坐标是一样的,所以它是共享密钥,也就是会话密钥。
这个过程中,双方的私钥都是随机、临时生成的,都是不公开的,即使根据公开的信息(椭圆曲线、公钥、基点 G)也是很难计算出椭圆曲线上的离散对数(私钥)。
客户端验证证书
在TLS第二次握手中,客户端拿到服务端的数字证书后,要校验该数字证书的有效性。
数字证书 通常包含:
- 公钥;
- 持有者信息;
- 证书认证机构(CA)的信息;
- CA 对这份文件的数字签名及使用的算法;
- 证书有效期;
- 还有一些其他额外信息;
为了让服务端的公钥被大家信任,服务端的证书都是由 CA (Certificate Authority,证书认证机构)签名的,CA 就是网络世界里的公安局、公证中心,具有极高的可信度,所以由它来给各个公钥签名。
签名的作用:可以避免中间人在获取证书时对证书内容的篡改。
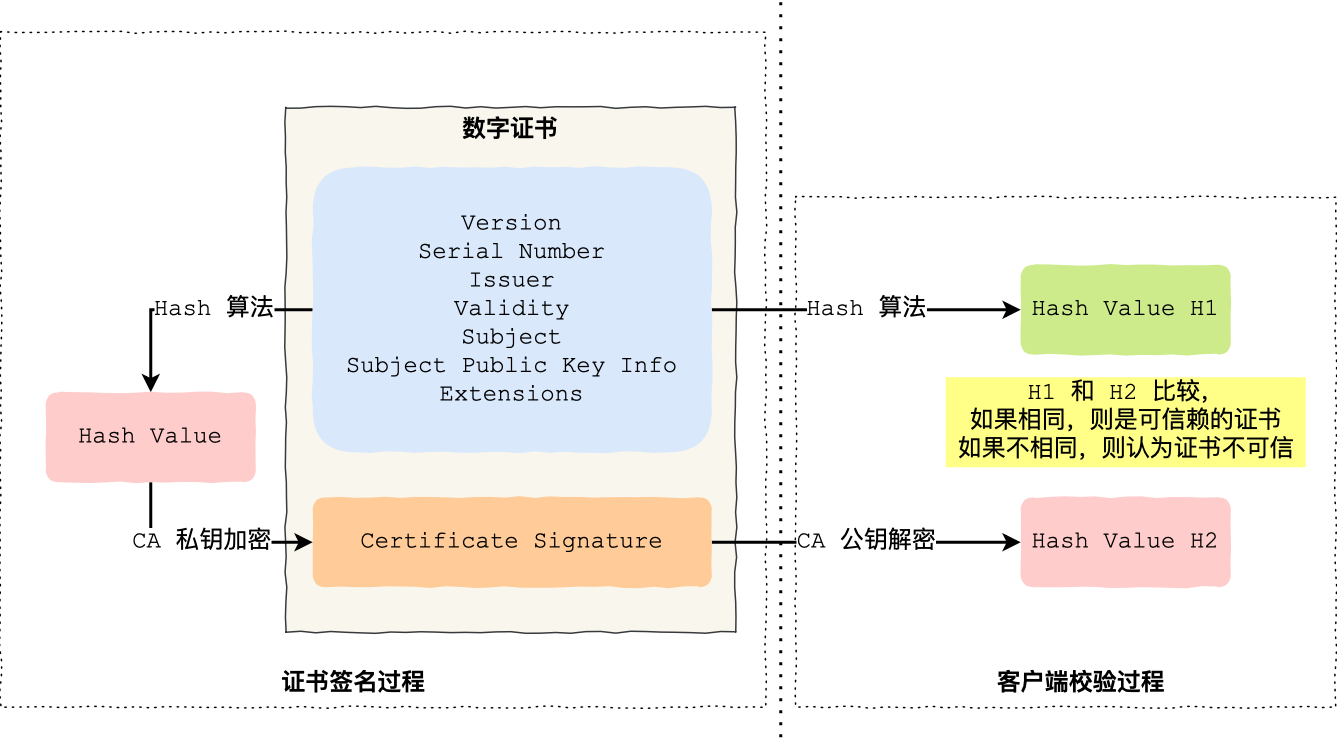
数字证书签发和验证
CA 签发证书的过程:
- 首先 CA 会把持有者的公钥、用途、颁发者、有效时间等信息打成一个包,然后对这些信息进行 Hash 计算,得到一个 Hash 值;
- 然后 CA 会使用自己的私钥将该 Hash 值加密,生成 Certificate Signature,也就是 CA 对证书做了签名;
- 最后将 Certificate Signature 添加在文件证书上,形成数字证书;
客户端校验服务端的数字证书的过程:
- 首先客户端会使用同样的 Hash 算法获取该证书的 Hash 值 H1;
- 通常浏览器和操作系统中集成了 CA 的公钥信息,浏览器收到证书后可以使用 CA 的公钥解密 Certificate Signature 内容,得到一个 Hash 值 H2 ;
- 最后比较 H1 和 H2,如果值相同,则为可信赖的证书,否则则认为证书不可信。
证书链:
一般申请的证书由中间证书签发,而不是由根证书签发。 客户端发现签发者不是根证书时,会逐步向上验证,确保中间证书是可信的。
之所以要弄证书链,是为了确保根证书的绝对安全性,将根证书隔离地越严格越好,不然根证书如果失守了,那么整个信任链都会有问题。f