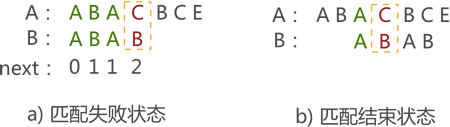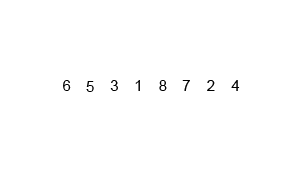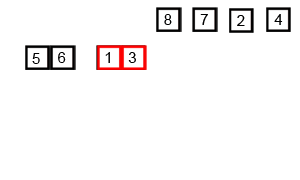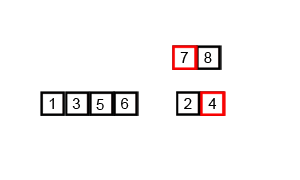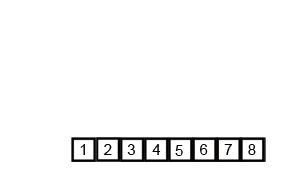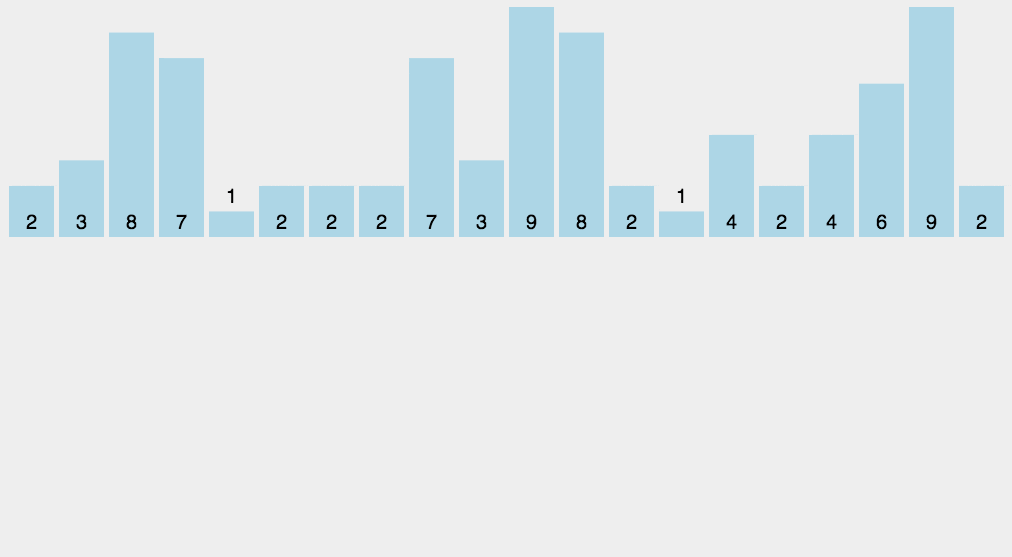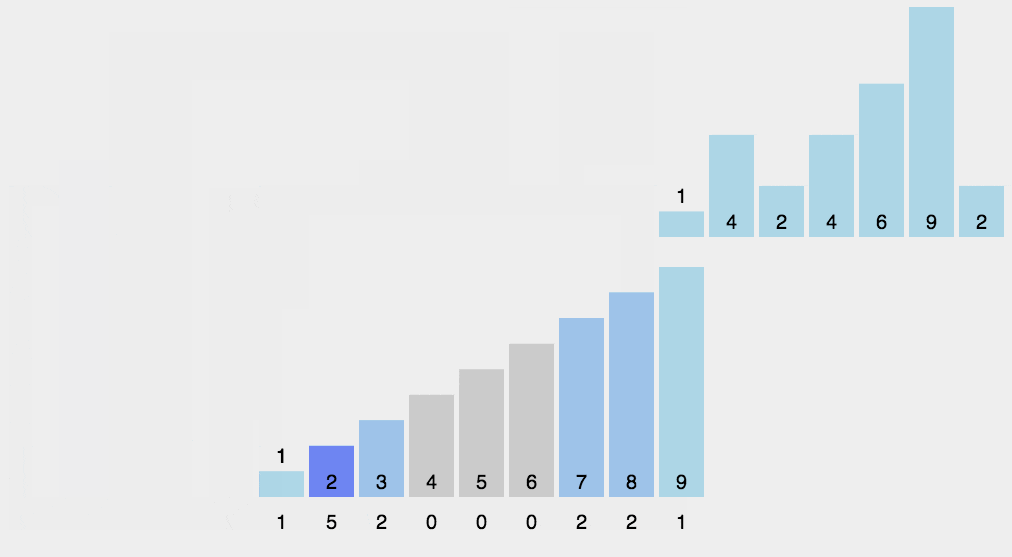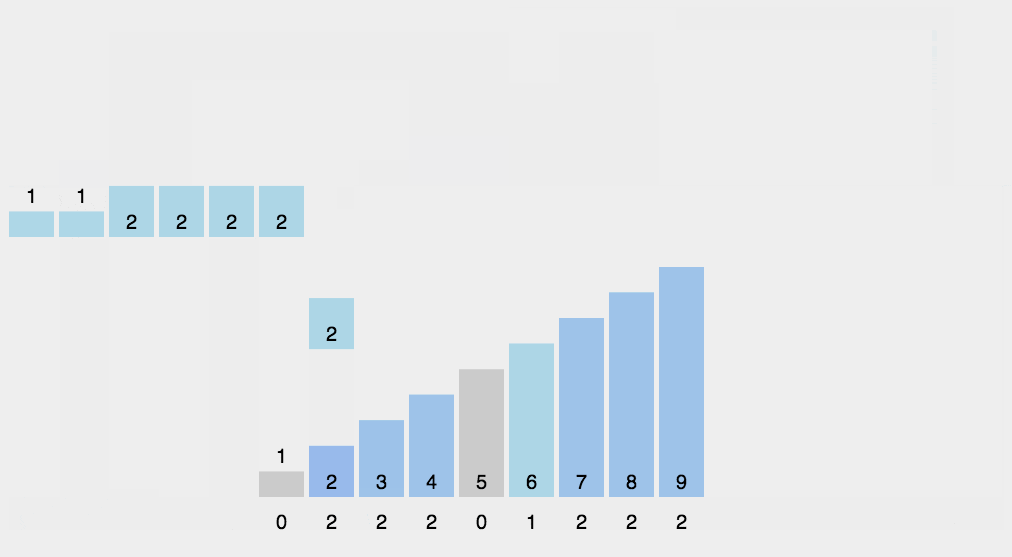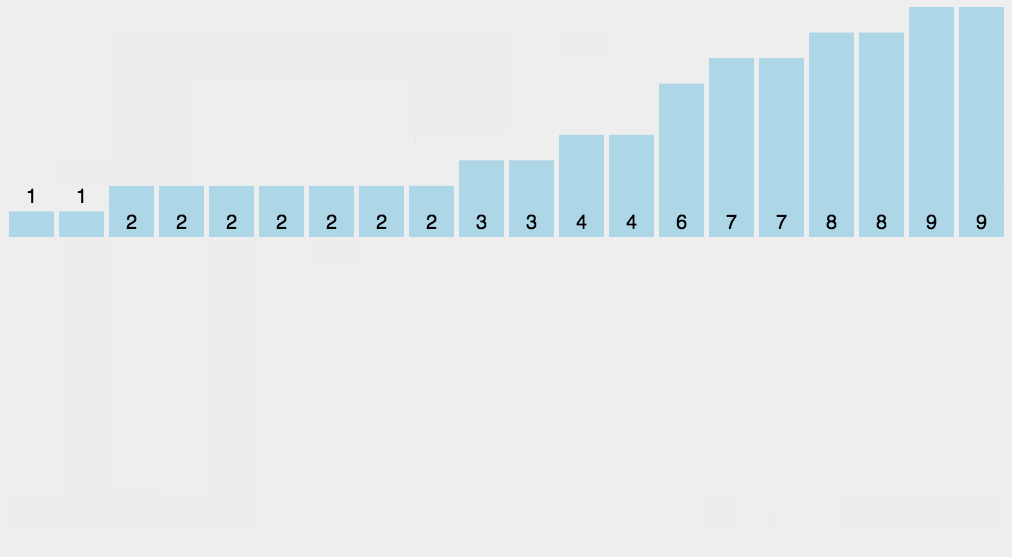欠缺 数组:广义表
树:层次遍历算法,线索二叉树,二叉搜索(排序)树BST,自平衡二叉树AVL(左旋右旋),B树(多路平衡查找树),B+树,——红黑树
并查集:
图:
数组 Arrarry C
使用数组中的第 i + 1 个元素:1.数组名[i] ; 或者使用指针*p = &数组: *(p +i)
C 语言不允许返回一个完整的数组作为函数的参数。
想要从函数返回一个数组,需先声明一个返回指针的函数:
C 不支持在函数外返回局部变量的地址,除非定义局部变量为 static 变量。
示例(生成随机数,并用数组返回):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 int * getRandom ( ) { static int r[10 ]; int i; srand( (unsigned )time( NULL ) ); for ( i = 0 ; i < 10 ; ++i){ r[i] = rand(); printf ( "r[%d] = %d\n" , i, r[i]); } return r; } int main () { int *p; int i; p = getRandom(); for ( i = 0 ; i < 10 ; i++ ) { printf ( "*(p + %d) : %d\n" , i, *(p + i)); } return 0 ; }
java
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 import java.util.ArrayList;import java.util.Arrays;public class Test { public static void main (String[] args) { int [] a = {1 , 2 , 3 }; System.out.println("a: " + Arrays.toString(a)); int [] b = new int []{1 , 2 , 3 }; System.out.println("b: " + Arrays.toString(b)); int [] c = new int [3 ]; for (int i = 0 ; i < a.length; i++) { c[i] = i + 1 ; } System.out.println("c: " + Arrays.toString(c)); ArrayList<Integer> arr = new ArrayList <>(); for (int i = 0 ; i < 3 ; i++) { arr.add(i + 1 ); } System.out.println("arr: " + arr.toString()); arr.add(99 ); arr.add(3 , 88 ); int c1 = c[1 ]; int arr1 = arr.get(1 ); c[1 ] = 11 ; arr.set(1 , 11 ); arr.remove(1 ); arr.remove(Integer.valueOf(4 )); for (int i = 0 ; i < arr.size(); i++) { if (arr.get(i) == 3 ) { arr.remove(i--); } } int cSize = c.length; int arrSize = arr.size(); for (int i = 0 ; i < c.length; i++) { int current = c[i]; System.out.println("c at index " + i + ": " + current); } for (int i = 0 ; i < arr.size(); i++) { int current = arr.get(i); System.out.println("c at index " + i + ": " + current); } for (int i = 0 ; i < c.length; i++) { if (c[i] == 99 ) { System.out.println("we found 99 at int c!" ); } } boolean is99 = arr.contains(99 ); Arrays.sort(c); Collections.sort(arr); Collections.sort(arr, Collections.reverseOrder()); }
数组的时间复杂度 访问(Access):O(1)
搜索(Search):O(N)
插入(Insert):O(N)
删除(Delete):O(N)
链表 Linked List C
创建链表:
创建结构变量指针,使用前要先分配内存空间
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 #include <stdio.h> #include <stdlib.h> typedef struct listNode { int data; struct listNode *next ; }LinkList; LinkList *CreatList (int n) { LinkList *head = (LinkList*)malloc (sizeof (LinkList)); LinkList *temp = head; for (int i = 1 ; i < n; ++i){ LinkList *a = (LinkList*)malloc (sizeof (LinkList)); scanf ("%d" , &a->data); a->next = NULL ; temp->next = a; temp = a; } return head; } LinkList changeList (LinkList *list , int n) { LinkList *temp = list ; int i = 0 ; while (i < n && temp != NULL ){ temp = temp->next; i++; } if (temp != NULL ){ printf ("请输入要修改的值:" ); scanf ("%d" , &temp->data); } else printf ("结点不存在" ); } LinkList *insert (LinkList *list , int n) { LinkList *temp = list ; for (int i = 1 ; i < n; ++i){ if (temp ==NULL ){ printf ("插入位置无效\n" ); return list ; } temp = temp->next; } LinkList *in = (LinkList*)malloc (sizeof (LinkList)); scanf ("%d" ,&in->data); in->next = temp->next; temp->next = in; return list ; } LinkList *delete (LinkList *list , int n) { LinkList *temp = list ; for (int i = 0 ; i < n; ++i) { temp = temp->next; } LinkList *del = temp->next; temp->next = temp->next->next; free (del); return list ; } void display (LinkList *list ) { LinkList *temp = list ; while (temp->next){ temp = temp->next; printf ("%d" ,temp->data); } }
头插法和尾插法: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 #include <stdio.h> #include <stdlib.h> struct list { int data; struct list *next ; }; int i;void output (struct list *head) ;void creat (struct list *head, int n) { struct list *p , *q ; head->next=NULL ; p=head; for (i=0 ; i<n; i++){ q=(struct list *)malloc ( sizeof (struct list ) ); scanf ("%d" , &q->data); q->next = p->next; p->next=q; p=q; } } void creat_1 (struct list *head, int n) { struct list *p ; head->next=NULL ; for (i=0 ; i<n; i++){ p=(struct list *)malloc ( sizeof (struct list ) ); scanf ("%d" , &p->data); p->next=head->next; head->next=p; } } void output (struct list *head) { struct list *p = while (p){ printf ("%d " , p->data); p=p->next; } puts ("\n\n" ); } void main () { struct list *head ; head=(struct list *)malloc ( sizeof (struct list ) ); creat(head, 5 ); output(head); creat_1(head, 5 ); output(head); }
java
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 import java.util.LinkedList;public class Test { public static void main (String[] args) { LinkedList<Integer> list = new LinkedList <>(); list.add(1 ); list.add(2 , 99 ); int element = list.get(2 ); int index = list.indexOf(99 ); list.set(2 ,88 ); list.remove(2 ); int length = list.size(); } }
203.移除链表元素 给你一个链表的头节点 head 和一个整数 val ,请你删除链表中所有满足 Node.val == val 的节点,并返回 新的头节点 。
1 2 输入:head = [1,2,6,3,4,5,6], val = 6 输出:[1,2,3,4,5]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 public ListNode removeElements (ListNode head, int val) { ListNode pre = new ListNode (0 ); pre.next = head; ListNode temp = pre; while (temp.next != null ) { if (temp.next.val == val){ temp.next = temp.next.next; } else temp = temp.next; } return pre.next; } } public ListNode removeElements (ListNode head, int val) { if (head == null ) { return head; } head.next = removeElements(head.next, val); return head.val == val ? head.next : head; } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution { public ListNode removeElements (ListNode head, int val) { ListNode sentinel = new ListNode (0 ); sentinel.next = head; ListNode prev = ans, curr = head; while (curr != null ){ if (curr.val == val){ prev.next = curr.next; }else { prev = curr; } curr = curr.next; } return sentinel.next; } }
206.反转链表 给你单链表的头节点 head ,请你反转链表,并返回反转后的链表。
1 2 输入:head = [1,2,3,4,5] 输出:[5,4,3,2,1]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 public ListNode reverseList (ListNode head) { ListNode prev = null ; ListNode curr = head; while (curr != null ) { ListNode next = curr.next; curr.next = prev; prev = curr; curr = next; } return prev; } public ListNode reverseList (ListNode head) { if (head == null || head.next == null ) return head; ListNode temp = reverseList(head.next); head.next.next = head; head.next = null ; return head; }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution { public ListNode reverseList (ListNode head) { ListNode prev = null , curr = head; while (curr != null ){ ListNode temp = curr.next; curr.next = prev; prev = curr; curr = temp; } return prev; } }
链表的时间复杂度 访问(Access):O(N)
搜索(Search):O(N)
插入(Insert):O(1)
删除(Delete):O(1)
队列 Queue C
判断队列是否为空:
设置一个标志变量;
当队列满时,保留一个元素空间;设队列最大尺寸为QueueSize,则队列满的条件是:(rear+1)%QueueSize == front 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 #include <stdio.h> #include <stdlib.h> typedef int QuDataType;typedef struct QListNode { struct QListNode *_next ; QuDataType _data; }QueueNode; typedef struct Queue { QueueNode *_front; QueueNode *_rear; }Queue; void QueueInit (Queue *q) ;void QueuePush (Queue *q,QuDataType data) ;void QueuePop (Queue *q) ;QuDataType QueueFront (Queue* q) ; QuDataType QueueBack (Queue* q) ; int QueueSize (Queue* q) ;int QueueEmpty (Queue* q) ;void QueueDestroy (Queue* q) ;QueueNode * BuyQueueNode (QuDataType x) { QueueNode * cur = (QueueNode *)malloc (sizeof (QueueNode)); cur->_data = x; cur->_next = NULL ; return cur; } void QueueInit (Queue* q) { q->_front = NULL ; q->_rear = NULL ; } void QueuePush (Queue* q, QuDataType x) { QueueNode * cur = BuyQueueNode(x); if (q->_front == NULL ){ q->_front = q->_rear = cur; } else { q->_rear->_next = cur; q->_rear = cur; } } void QueuePop (Queue* q) { if (q->_front == NULL ){ return ; } QueueNode* tmp = q->_front->_next; free (q->_front); q->_front = tmp; } QuDataType QueueFront (Queue* q) { return q->_front->_data; } QuDataType QueueBack (Queue* q) { return q->_rear->_data; } int QueueEmpty (Queue* q) { return q->_front == NULL ; } int QueueSize (Queue* q) { QueueNode * cur; int count = 0 ; for (cur = q->_front; cur; cur = cur->_next) { count++; } return count; } void QueueDestory (Queue* q) { if (q->_front == NULL ){ return ; } while (q->_front){ QueuePop(q); } } int main () { Queue q; QueueInit(&q); QueuePush(&q, 1 ); QueuePush(&q, 2 ); QueuePush(&q, 3 ); QueuePush(&q, 4 ); printf ("%d\n" , QueueFront(&q)); QueuePop(&q); printf ("%d\n" , QueueFront(&q)); printf ("%d\n" , QueueBack(&q)); return 0 ; }
java
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 import java.util.queue;import java.util.LinkedList;public class Test { public static void main (String[] args) { Queue<Integer> queue = new LinkedList <>(); queue.add(1 ); queue.add(2 ); int temp1 = queue.peek(); System.out.println(temp1); int temp2 = queue.poll(); System.out.println(temp2); System.out.println(queue.toString()); System.out.println(queue.isEmpty()); System.out.println(queue.size()); while (!queue.isEmpty()){ int temp = queue.poll(); System.out.print(temp); } } }
933.最近的请求次数 写一个 RecentCounter 类来计算特定时间范围内最近的请求。
请你实现 RecentCounter 类:
RecentCounter() 初始化计数器,请求数为 0 。
1 2 3 4 5 输入: ["RecentCounter", "ping", "ping", "ping", "ping"] [[], [1], [100], [3001], [3002]] 输出: [null, 1, 2, 3, 3]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class RecentCounter { Queue<Integer> q; public void RecentCounter () { q = new LinkedList (); } public int ping (int t) { q.add(t); while (q.peek() < t - 3000 ){ q.poll(); } return q.size(); } }
225.用队列实现栈 利用两个队列 来实现栈的基本操作:进栈,显示栈顶元素,删除栈顶元素,判空f
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 class MyStack { Queue<Integer> queue1; Queue<Integer> queue2; public MyStack () { queue1 = new LinkedList <Integer>(); queue2 = new LinkedList <Integer>(); } public void push (int x) { queue2.add(x); while (!queue1.isEmpty()){ queue2.add(queue1.poll()); } Queue<Integer> temp = queue1; queue1 = queue2; queue2 = temp; } public int pop () { return queue1.poll(); } public int top () { return queue1.peek(); } public boolean empty () { return queue1.isEmpty(); } }
622.设计循环队列 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 class MyCircularQueue { int [] queue; int index; int rear; int count; int capacity; public MyCircularQueue (int k) { capacity = k; queue = new int [k + 1 ]; index = 0 ; rear = 0 ; count = 0 ; } public boolean enQueue (int value) { if (count == capacity) return false ; queue[rear] = value; rear = (rear + 1 ) % capacity; count++; return true ; } public boolean deQueue () { if (count == 0 ) return false ; else { index = (index + 1 ) % capacity; count--; return true ; } } public int Front () { if (count == 0 ) return -1 ; else { return queue[index]; } } public int Rear () { if (count == 0 ) return -1 ; else { return queue[(rear + capacity - 1 ) % capacity]; } } public boolean isEmpty () { return count = = 0 ; } public boolean isFull () { return count = = capacity; } }
Deque(双端队列) Deque(java.util.Deque)接口代表着双向队列,意思就是可以从队列的两端增加或者删除元素,
deque 是“double ended queue(双端队列)”的缩写,通常读为“deck”。
Deque的实现 :
1 2 java.util.LinkedList java.util.ArrayDeque
LinkedList类是非常标准的Deque和Queue的实现,它在内部使用链接列表来建模queue或deque。
ArrayDeque类内部存储元素是数组,如果元素数超过数组中的空间,则分配一个新的数组,并移动所有元素,换句话说,ArrayDeque根据需要增长,即使它将元素存储在数组中。
创建Deque
1 Deque deque = new LinkedList();
创建 ArrayDeque实例:
1 Deque deque = new ArrayDeque();
Deque泛型
1 Deque<MyObject> deque = new LinkedList<MyObject>();
这个Deque中只能添加 MyObject的实例对象,并且访问时不需要强制类型转换:
1 2 3 4 5 MyObject myObject = deque.remove(); for(MyObject anObject : deque){ //do someting to anObject... }
Deque中添加元素
add()
方法具体说明:
add() 尾部 添加元素:
1 2 3 Deque<String> deque = new ArrayDeque<>(); deque.add("element 1");
如果元素不能插入到Deque,那么add(),方法将抛异常,而 offer()方法不一样,如果不能添加元素offer()方法将返回false。add()方法实际是继承Queue接口。
offer()
1 2 3 Deque<String> deque = new ArrayDeque<>(); deque.offer("element 1");
push() 头部 添加元素,如果Deque中的元素满了,则会抛异常,这和addFirst()方法比较相似:
1 2 3 Deque<String> deque = new LinkedList<>(); deque.push("element 0");
获取元素:
peek()
1 2 3 4 5 6 Deque<String> deque = new ArrayDeque<>(); deque.add("first element"); deque.add("last element"); String firstElement = deque.peek();
执行完代码后firstElement将指向Deque的第一个元素: “first element”。
getFirst()
1 2 3 4 5 6 7 Deque<String> deque = new ArrayDeque<>(); deque.add("first element"); deque.add("last element"); String firstElement = deque.getFirst();
执行完代码后firstElement的值是: “first element”。
移除Deque中的元素
remove()
1 2 3 4 5 Deque<String> deque = new LinkedList<>(); deque.add("element 0"); String removedElement = deque.remove();
如果Deque 是空则抛异常,这一点和poll()返回null不一样。
poll()
1 2 3 4 5 6 7 Deque<String> deque = new LinkedList<>(); deque.add("element 0"); deque.add("element 1"); deque.add("element 2"); String removedElement = deque.poll();
pop()
1 2 3 4 5 Deque<String> deque = new LinkedList<>(); deque.push("element 0"); String removedElement = deque.pop();
检查Deque是否包含某个元素
1 2 3 4 5 6 Deque<String> deque = new ArrayDeque<>(); deque.add("first element"); boolean containsElement1 = deque.contains("first element"); boolean containsElement2 = deque.contains("second element");
执行完代码后containsElement1的值是true ,containsElement2值是false。
Deque的大小
1 2 3 4 5 6 Deque<String> deque = new ArrayDeque<>(); deque.add("first element"); deque.add("second element"); int size = deque.size();
执行完代码后size大小是2,因为Deque中包含两个元素。
迭代Deque中的元素
使用Iterator.
通过迭代器迭代Deque
1 2 3 4 5 6 7 8 9 10 Deque<String> deque = new LinkedList<>(); deque.add("element 0"); deque.add("element 1"); deque.add("element 2"); Iterator<String> iterator = deque.iterator(); while(iterator.hasNext(){ String element = iterator.next(); }
通过For-Each循环迭代Deque
1 2 3 4 5 6 7 8 9 Deque<String> deque = new LinkedList<>(); deque.add("element 0"); deque.add("element 1"); deque.add("element 2"); for(String element : deque) { System.out.println(element); }
队列的时间复杂度 访问(Access):O(N)
搜索(Search):O(N)
插入(Insert):O(1)
删除(Delete):O(1)
栈 Stack java:
(Java堆栈Stack已经过时,推荐使用Deque替代Stack。)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 import java.util.Deque;import java.util.LinkedList;public class Test { public static void main (String[] args) { Deque<Integer> stack = new LinkedList <>(); stack.push(1 ); stack.push(3 ); stack.peek(); int temp = stack.pop(); stack.size(); stack.isEmpty(); while (!stack.isEmpty()){ int num = stack.pop(); System.out.println(num); } } }
单调栈 单调栈中存放的数据应该是有序的,所以单调栈也分为单调递增栈 和单调递减栈
单调递增栈:单调递增栈就是从栈底到栈顶数据是从大到小
单调递减栈:单调递减栈就是从栈底到栈顶数据是从小到大
假设:
现在有一组数10,3,7,4,12。从左到右依次入栈,则如果栈为空或入栈元素值小于栈顶元素值,则入栈;否则,如果入栈则会破坏栈的单调性,则需要把比入栈元素小的元素全部出栈。单调递减的栈反之。
10入栈时,栈为空,直接入栈,栈内元素为10。
3入栈时,栈顶元素10比3大,则入栈,栈内元素为10,3。
7入栈时,栈顶元素3比7小,则栈顶元素出栈,此时栈顶元素为10,比7大,则7入栈,栈内元素为10,7。
4入栈时,栈顶元素7比4大,则入栈,栈内元素为10,7,4。
12入栈时,栈顶元素4比12小,4出栈,此时栈顶元素为7,仍比12小,栈顶元素7继续出栈,此时栈顶元素为10,仍比12小,10出栈,此时栈为空,12入栈,栈内元素为12。
伪代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 int stack () for (遍历这个数组) { if (栈空 || 栈顶元素大于等于当前比较元素) { 入栈; } else { while (栈不为空 && 栈顶元素小于当前元素) { 栈顶元素出栈; 更新结果; } 当前数据入栈; } }
20.有效的括号 给定一个只包括 ‘(‘,’)’,’{‘,’}’,’[‘,’]’ 的字符串 s ,判断字符串是否有效。
有效字符串需满足:
左括号必须用相同类型的右括号闭合。
示例 2:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 import java.util.Deque;import java.util.HashMap;import java.util.LinkedList;class Solution { public boolean isValid (String s) { int n = s.length(); if (n % 2 == 1 ) { return false ; } HashMap<Character, Character> hash = new HashMap <Character, Character>(); hash.put(')' , '(' ); hash.put(']' , '[' ); hash.put('}' , '{' ); Deque<Character> stack = new LinkedList <Character>(); for (int i = 0 ; i < n; i++) { char c = s.charAt(i); if (hash.containsKey(c)) { if (stack.isEmpty() || stack.peek() != hash.get(c)) { return false ; } stack.pop(); } else stack.push(c); } return stack.isEmpty(); } }
496.下一个更大元素1 给定两个没有重复元素 的数组 nums1 和 nums2 ,其中nums1 是 nums2 的子集。
请你找出 nums1 中每个元素在 nums2 中的下一个比其大的值。
nums1 中数字 x 的下一个更大元素是指 x 在 nums2 中对应位置的右边的第一个比 x 大的元素。如果不存在,对应位置输出 -1 。
示例 :
1 2 3 4 5 6 输入: nums1 = [4,1,2], nums2 = [1,3,4,2]. 输出: [-1,3,-1] 解释: 对于 num1 中的数字 4 ,你无法在第二个数组中找到下一个更大的数字,因此输出 -1 。 对于 num1 中的数字 1 ,第二个数组中数字1右边的下一个较大数字是 3 。 对于 num1 中的数字 2 ,第二个数组中没有下一个更大的数字,因此输出 -1 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution { public int [] nextGreaterElement(int [] nums1, int [] nums2) { int n = nums1.length, m = nums2.length; HashMap<Integer, Integer> map = new HashMap <>(); Deque<Integer> stack = new LinkedList <>(); for (int i = 0 ; i < m; i++){ while (!stack.isEmpty() && nums2[i] > stack.peek()){ map.put(stack.pop(),nums2[i]); } map.put(nums2[i],-1 ); stack.push(nums2[i]); } for (int i = 0 ; i < n; i++){ nums1[i] = map.get(nums1[i]); } return nums1; } }
232.用栈实现队列 只使用两个栈,实现一个先入先出的队列(push,pop,peek,empty)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 import java.util.Deque;import java.util.LinkedList;class MyQueue { Deque<Integer> stack1; Deque<Integer> stack2; public MyQueue () { stack1 = new LinkedList <>(); stack2 = new LinkedList <>(); } public void push (int x) { while (!stack1.isEmpty()){ stack2.push(stack1.pop()); } stack2.push(x); while (!stack2.isEmpty()){ stack1.push(stack2.pop()); } } public int pop () { return stack1.pop(); } public int peek () { return stack1.peek(); } public boolean empty () { return stack1.isEmpty(); } }
栈的时间复杂度 访问(Access):O(1)
搜索(Search):O(N)
插入(Insert):O(1)
删除(Delete):O(1)
字符串 String 字符串输入:
数组
1 2 char arr[6 ] = "array" ;char arr[] = "array" ;
指针
1 2 char *p = "pointer" ;printf ("%s %c %c" ,p,*p,*(p + 2 ));
数组/指针
1 2 3 4 5 6 7 char arr1[6 ];scang("%s\n" ,arr1); gets(arr1); char *arr2 = (char *)malloc ( 100 *sizeof (char ) ); scanf ("%s\n" ,arr2);gets(arr2);
(scanf只能输入一个单词,当遇到空格时会认为字符串结束;gets函数只知道数组的开始,并不知道数组的大小,如果输入过长容易溢出,并可能擦掉程序中的其他数据)
使用while完成多组测试,而不是在输入完一组数据后退出控制台
1 2 3 4 5 char arr1[100 ],arr2[2 ];int a; while ((a = scanf ("%s%s" ,arr1,arr2)) != EOF){ pritnf("scanf返回l %d,s1是%s,s2是%s" ,a,arr1,arr2); }
KMP模式匹配 KMP算法实现过程接近人为模式匹配
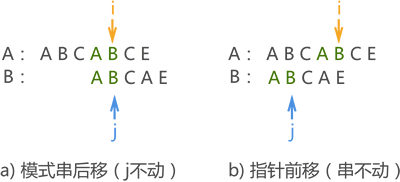
匹配失败后,模式串移动的距离和主串无关,只与模式串本身有关,模式串后移等价于指针j前移。
因此,我们可以给每个模式串配备一个数组(例如 next[]),用于存储模式串中每个字符对应指针 j 重定向的位置(也就是存储模式串的数组下标),比如 j=3,则该字符匹配失败后指针 j 指向模式串中第 3 个字符。
模式串中各字符对应 next 值 的计算方式是,取该字符前面的字符串(不包含自己),其前缀字符串和后缀字符串相同字符的最大个数再 +1 就是该字符对应的 next 值。
(模式串中第一个字符对应的值为 0,第二个字符对应 1 ,这是固定不变的。)
Next函数 一般的Next函数:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 void Next (char *T,int *next) { next[1 ]=0 ; next[2 ]=1 ; int i=2 ; int j=1 ; while (i<strlen (T)) { if (j==0 ||T[i-1 ]==T[j-1 ]) { i++; j++; next[i]=j; }else { j=next[j]; } } }
但这样可能会有多余的操作,如:
当匹配失败时,Next 函数会由图 10b) 开始继续进行模式匹配,但是从图中可以看到,这样做是没有必要的。
如此,问题在当 T[i-1]==T[j-1] 成立时,没有继续对 i++ 和 j++ 后的 T[i-1] 和 T[j-1] 的值做判断。
因此改进后的Next函数:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 void Next (char *T,int *next) { next[1 ]=0 ; next[2 ]=1 ; int i=2 ; int j=1 ; while (i<strlen (T)) { if (j==0 ||T[i-1 ]==T[j-1 ]) { i++; j++; if (T[i-1 ]!=T[j-1 ]) { next[i]=j; }else { next[i]=next[j]; } }else { j=next[j]; } } }
KMP实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 void Next (char [] T, int [] next) { next[1 ] = 0 ; int i = 1 ; int j = 0 ; while (i < T.length) { if (j == 0 || T[i - 1 ] == T[j - 1 ]) { i++; j++; if (T[i - 1 ] != T[j - 1 ]) { next[i] = j; } else { next[i] = next[j]; } } else { j = next[j]; } } } int KMP (char [] S, char [] T) { int [] next = new int [T.length + 1 ]; Next(T, next); int i = 1 ; int j = 1 ; while (i <= S.length && j <= T.length) { if (j == 0 || S[i - 1 ] == T[j - 1 ]) { i++; j++; } else { j = next[j]; } } if (j > T.length) { return i - T.length - 1 ; } return -1 ; }
散列表(Hash)
哈希表 (hashtable),又叫散列表,是根据关键码(key)来进行访问的数据结构,通过哈希函数把key转成哈希值来定位数据存储的位置。通常是键-值对(即key-value)的结构,即用key算出的哈希值来定位存储位置,在该位置上存储内容为value。
哈希集合 (hashset),也是一种通过哈希值来定位存储位置的数据结构,只是它不是键-值对结构,而是储存key本身,相当于只有哈希表(hashtable)的key部分,即用key算出的哈希值来定位存储位置,在该位置上存储内容为key本身。
哈希映射 (hashmap)是和哈希表(hashtable)相似的数据结构,也是键-值对存储,只是哈希映射是线程安全的,而哈希表是非线程安全的。所谓线程安全,就是多线程同时操作数据的时候,能确保在同一时刻只能有一个线程能访问同一个数据(也就是会给数据操作加锁);如果不能确保这个,就是非线程安全。
哈希表 可能存在特殊情况,就是通过不同的 Key,可能访问到同一个地址,这种现象叫作碰撞(Collision)。而通过某个 Key 一定会得到唯一的 Value 地址。
目前,这个哈希函数比较常用的实现方法比较多,通常需要考虑几个因素:关键字的长度、哈希表的大小、关键字的分布情况、记录的查找频率,等等。
下面简单介绍几种哈希函数 。
直接寻址法:取关键字或关键字的某个线性函数值为散列地址。
数字分析法:通过对数据的分析,发现数据中冲突较少的部分,并构造散列地址。例如同学们的学号,通常同一届学生的学号,其中前面的部分差别不太大,所以用后面的部分来构造散列地址。
平方取中法:当无法确定关键字里哪几位的分布相对比较均匀时,可以先求出关键字的平方值,然后按需要取平方值的中间几位作为散列地址。这是因为:计算平方之后的中间几位和关键字中的每一位都相关,所以不同的关键字会以较高的概率产生不同的散列地址。
取随机数法:使用一个随机函数,取关键字的随机值作为散列地址,这种方式通常用于关键字长度不同的场合。
除留取余法 :取关键字被某个不大于散列表的表长 n 的数 m 除后所得的余数 p 为散列地址。这种方式也可以在用过其他方法后再使用。该函数对 m 的选择很重要,一般取素数 或者直接用 n。
对散列表函数产生冲突的解决办法 :
有时不同的 Key 通过哈希函数可能会得到相同的地址,这在我们操作时可能会对数据造成覆盖、丢失。之所以产生冲突是由于哈希函数有时对不同的 Key 计算之后获得了相同的地址。
冲突的处理方式也有很多,下面介绍几种。
开放地址法 (也叫线性探测 ):实际上就是当需要存储值时,对Key哈希之后,发现这个地址已经有值了,这时该怎么办?不能放在这个地址,不然之前的映射会被覆盖。这时对计算出来的地址进行一个探测再哈希,比如往后移动一个地址,如果没人占用,就用这个地址。如果超过最大长度,则可以对总长度取余。这里移动的地址是产生冲突时的增列序量。(如 f(key) = { f(key + d) } % m)再哈希法 :在产生冲突之后,使用关键字的其他部分继续计算地址,如果还是有冲突,则继续使用其他部分再计算地址。这种方式的缺点是时间增加了。链地址法 :链地址法其实就是对Key通过哈希之后落在同一个地址上的值,做一个链表。其实在很多高级语言的实现当中,也是使用这种方式处理冲突的,我们会在后面着重学习这种方式。建立一个公共溢出区 :这种方式是建立一个公共溢出区,当地址存在冲突时,把新的地址放在公共溢出区里。
散列表实现 java
C:
实现简单的哈希表 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 #include <stdio.h> #include <stdlib.h> #define SUCCESS 1 #define UNSUCCESS 0 #define HASHSIZE 12 #define NULLKEY -32768 typedef int Status;typedef struct { int *elem; int count; } HashTable; int m = 0 ; Status InterHashTable (HashTable *H) { int i; m = HASHSIZE; H->count = m; H->elem = (int *) malloc (m * sizeof (int )); for (i = 0 ; i < m; i++) { H->elem[i] = NULLKEY; } return 1 ; } int Hash (int key) { return key % m; } void IntertHash (HashTable *H, int key) { int addr = Hash(key); while (H->elem[addr] != NULLKEY) addr = (addr + 1 ) % m; H->elem[addr] = key; } Status SearchHash (HashTable H, int key, int *addr) { *addr = Hash(key); while (H.elem[*addr] != key) { *addr = (*addr + 1 ) % m; if (H.elem[*addr] == NULLKEY || *addr == Hash(key)) { return UNSUCCESS; } } return SUCCESS; } int main () { int a[12 ] = {12 , 67 , 56 , 16 , 25 , 37 , 22 , 29 , 15 , 47 , 48 , 34 }; HashTable H; int i; InterHashTable(&H); for (i = 0 ; i < m; i++) IntertHash(&H, a[i]); printf ("插入之后的哈希表为:" ); for (i = 0 ; i < m; i++) printf ("%d," , H.elem[i]); int addr, j; j = SearchHash(H, a[5 ], &addr); printf ("搜索到a[5]的地址是:%d" , j); }
实现哈希集合 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 #include <stdbool.h> #include <stdio.h> #include <stdlib.h> struct List { int val; struct List *next ; }; void listPush (struct List *head, int x) { struct List *tmp =malloc (sizeof (struct List)); tmp->val = x; tmp->next = head->next; head->next = tmp; } void listDelete (struct List *head, int x) { for (struct List *it = head; it->next; it = it->next) { if (it->next->val == x) { struct List *tmp = it->next = tmp->next; free (tmp); break ; }}} bool listContains (struct List *head, int x) { for (struct List *it = head; it->next; it = it->next) { if (it->next->val == x) return true ; } return false ; } void listFree (struct List *head) { while (head->next) { struct List *tmp = head->next = tmp->next; free (tmp); } } const int base = 769 ;int hash (int key) { return key % base; } typedef struct { struct List *data ; } MyHashSet; MyHashSet *myHashSetCreate () { MyHashSet *ret = malloc (sizeof (MyHashSet)); ret->data = malloc (sizeof (struct List) * base); for (int i = 0 ; i < base; i++) { ret->data[i].val = 0 ; ret->data[i].next = NULL ; } return ret; } void myHashSetAdd (MyHashSet *obj, int key) { int h = hash(key); if (!listContains(&(obj->data[h]), key)) { listPush(&(obj->data[h]), key); } } void myHashSetRemove (MyHashSet *obj, int key) { int h = hash(key); listDelete(&(obj->data[h]), key); } bool myHashSetContains (MyHashSet *obj, int key) { int h = hash(key); return listContains(&(obj->data[h]), key); } void myHashSetFree (MyHashSet *obj) { for (int i = 0 ; i < base; i++) { listFree(&(obj->data[i])); } free (obj->data); }
实现哈希映射 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 struct List { int key; int val; struct List * next ; }; void listPush (struct List* head, int key, int val) { struct List * tmp =malloc (sizeof (struct List)); tmp->key = key; tmp->val = val; tmp->next = head->next; head->next = tmp; } void listDelete (struct List* head, int key) { for (struct List* it = head; it->next; it = it->next) { if (it->next->key == key) { struct List * tmp = it->next = tmp->next; free (tmp); break ; } } } struct List* listFind (struct List* head, int key) { for (struct List* it = head; it->next; it = it->next) { if (it->next->key == key) { return it->next; } } return NULL ; } void listFree (struct List* head) { while (head->next) { struct List * tmp = head->next = tmp->next; free (tmp); } } const int base = 769 ;int hash (int key) { return key % base; } typedef struct { struct List * data ; } MyHashMap; MyHashMap* myHashMapCreate () { MyHashMap* ret = malloc (sizeof (MyHashMap)); ret->data = malloc (sizeof (struct List) * base); for (int i = 0 ; i < base; i++) { ret->data[i].key = 0 ; ret->data[i].val = 0 ; ret->data[i].next = NULL ; } return ret; } void myHashMapPut (MyHashMap* obj, int key, int value) { int h = hash(key); struct List * rec = if (rec == NULL ) { listPush(&(obj->data[h]), key, value); } else { rec->val = value; } } int myHashMapGet (MyHashMap* obj, int key) { int h = hash(key); struct List * rec = if (rec == NULL ) { return -1 ; } else { return rec->val; } } void myHashMapRemove (MyHashMap* obj, int key) { int h = hash(key); listDelete(&(obj->data[h]), key); } void myHashMapFree (MyHashMap* obj) { for (int i = 0 ; i < base; i++) { listFree(&(obj->data[i])); } free (obj->data); }
java:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 import java.util.HashMap;class Test { public static void main (String[] args) { String[] hashTable = new String [4 ]; HashMap<Integer, String> map = new HashMap <>(); hashTable[1 ] = "hello" ; map.put(1 , "hello" ); hashTable[1 ] = "world" ; map.put(1 , "world" ); hashTable[1 ] = "" ; map.remove(1 ); String temp = hashTable[1 ]; map.get(3 ); map.containsKey(3 ); map.size(); map.isEmpty(); } }
散列表的特点 散列表有两种用法:一种是 Key 的值与 Value 的值一样,一般我们称这种情况的结构为 Set(集合);而如果 Key 和 Value 所对应的内容不一样时,那么我们称这种情况为 Map,也就是人们俗称的键值对集合。
根据散列表的存储结构,我们可以得出散列表的以下特点。
访问速度很快
由于散列表有散列函数,可以将指定的 Key 都映射到一个地址上,所以在访问一个 Key(键)对应的 Value(值)时,根本不需要一个一个地进行查找,可以直接跳到那个地址。所以我们在对散列表进行添加、删除、修改、查找等任何操作时,速度都很快。
需要额外的空间
首先,散列表实际上是存不满的,如果一个散列表刚好能够存满,那么肯定是个巧合。而且当散列表中元素的使用率越来越高时,性能会下降,所以一般会选择扩容来解决这个问题。另外,如果有冲突的话,则也是需要额外的空间去存储的,比如链地址法,不但需要额外的空间,甚至需要使用其他数据结构。
这个特点有个很常用的词可以表达,叫作“空间换时间”,在大多数时候,对于算法的实现,为了能够有更好的性能,往往会考虑牺牲些空间,让算法能够更快些。
3) 无序
散列表还有一个非常明显的特点,那就是无序。为了能够更快地访问元素,散列表是根据散列函数直接找到存储地址的,这样我们的访问速度就能够更快,但是对于有序访问却没有办法应对。
4) 可能会产生碰撞
没有完美的散列函数,无论如何总会产生冲突,这时就需要采用冲突解决方案,这也使散列表更加复杂。通常在不同的高级语言的实现中,对于冲突的解决方案不一定一样。
散列表的适用场景 根据散列表的特点可以想到,散列表比较适合无序、需要快速访问的情况。
缓存
通常我们开发程序时,对一些常用的信息会做缓存,用的就是散列表,比如我们要缓存用户的信息,一般用户的信息都会有唯一标识的字段,比如 ID。这时做缓存,可以把 ID 作为 Key,而 Value 用来存储用户的详细信息,这里的 Value 通常是一个对象(高级语言中的术语,前面提到过),包含用户的一些关键字段,比如名字、年龄等。
在我们每次需要获取一个用户的信息时,就不用与数据库这类的本地磁盘存储交互了(其实在大多数时候,数据库可能与我们的服务不在一台机器上,还会有相应的网络性能损耗),可以直接从内存中得到结果。这样不仅能够快速获取数据,也能够减轻数据库的压力。
有时我们要查询一些数据,这些数据与其他数据是有关联的,如果我们进行数据库的关联查询,那么效率会非常低,这时可以分为两部分进行查询:将被关联的部分放入散列表中,只需要遍历一遍;对于另一部分数据,则通过程序手动关联,速度会很快,并且由于我们是通过散列表的 Key、Value 的对应关系对应数据的,所以性能也会比较好。
快速查找
这里说的查找,不是排序,而是在集合中找出是否存在指定的元素。
这样的场景很多,比如我们要在指定的用户列表中查找是否存在指定的用户,这时就可以使用散列表了。在这个场景下使用的散列表其实是在上面提到的 Set 类型,实际上不需要 Value 这个值。
还有一个场景,我们一般对网站的操作会有个IP地址黑名单,我们认为某些 IP 有大量的非法操作,于是封锁了这些 IP 对我们网站的访问。这个 IP 是如何存储的呢?就是用的散列表。当一个访问行为发送过来时,我们会获取其 IP,判断其是否存在于黑名单中,如果存在,则禁止其访问。这种情况也是使用的 Set。
当然,对于上面说的两个例子,用列表也是可以实现的,但是访问速度会受到很大的影响,尤其是列表越来越长时,查找速度会很慢,而散列表则不会。
217.存在重复元素 给定一个整数数组,判断是否存在重复元素。
如果存在一值在数组中出现至少两次,函数返回 true 。如果数组中每个元素都不相同,则返回 false 。
1 2 3 4 5 6 7 8 9 10 11 public boolean containsDuplicate (int [] nums) { HashMap<Integer, Integer> hash = new HashMap <>(); int n = nums.length; for (int i : nums) { if (hash.containsKey(i)) { return true ; } else hash.put(i, 1 ); } return false ; }
389.找不同 给定两个字符串 s 和 t
字符串 t 由字符串 s 随机重排,然后在随机位置添加一个字母。
请找出在 t
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution { public char findTheDifference (String s, String t) { int [] cnt = new int [26 ]; int n = s.length(), m = t.length(); for (int i = 0 ; i < n; i++){ cnt[s.charAt(i) - 'a' ]++; } for (int i = 0 ; i < m; i++){ char c = t.charAt(i); cnt[c - 'a' ]--; if (cnt[c - 'a' ] < 0 ) return c; } return ' ' ; } }
哈希表的时间复杂度 访问(Access):
搜索(Search):O(1)
插入(Insert):O(1)
删除(Delete):O(1)
集合 Set
检查元素是否存在
检查元素是否重复(原数据长度与集合长度是否相同)
java(哈希集合HashSet)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 import java.util.HashSet;public class Test { public static void main (String[] args) { HashSet<Integer> set = new HashSet <>(); set.add(10 ); set.add(2 ); set.add(2 ); System.out.println(set.add(2 )); set.contains(2 ); System.out.println(set.contains(2 )); set.remove(2 ); System.out.println(set.toString()); set.size(); } }
217.存在重复元素 给定一个整数数组,判断是否存在重复元素。
如果存在一值在数组中出现至少两次,函数返回 true 。如果数组中每个元素都不相同,则返回 false 。
1 2 3 4 5 6 7 8 9 class Solution { public boolean containsDuplicate (int [] nums) { Set<Integer> set = new HashSet <>(); for (int x : nums){ if (!set.add(x)) return true ; } return false ; }
树 Tree
结点的度:结点的子树个数;
树的度:树中所有结点中最大的度;
叶结点:度为0的结点;
兄弟结点:具有同一父结点的各个结点;
路径和路径结点:从结点N到结点Nk的路径,其路径结点为路径中结点个数 - 1,即路径中所包含的边的个数;
祖先结点:从某一结点,到根结点的所有节点,都是这个结点的祖先节点;
子孙结点:某一结点的子树中的所有节点,都是这个结点的子孙;
层次:规定根结点 在0/1层,其他结点的层数是其父结点的层数+1;
深度:从上往下数,等于层;高度:从下往上数
二叉树: 普通二叉树 :每个结点最多两个子结点
满二叉树 :除了叶结点,每个结点都有两个子结点,并且所有叶结点都在同一层上;
满二叉树的深度为k,则该树一共有 2^k^ - 1 个节点。
完全二叉树 :从树的根结点出发,从上到下,从左到右,依次填满结点形成的二叉树
(满二叉树一定是完全二叉树,完全二叉树不一定是满二叉树)
二叉树的遍历:
前 序遍历根节点 ->左子树->右子树
中 序遍历左子树->根节点 ->右子树
后 序遍历左子树->右子树->根子树
层次遍历
从上到下,从左到右
(层次遍历需要用到 队列 )
二叉树实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 #include <stdio.h> #include <stdlib.h> typedef struct node { int data; struct node *left ; struct node *right ; } Node; typedef struct { Node *root; } Tree; void insert (Tree *tree, int value) { Node *node = (Node *) malloc (sizeof (Node)); node->data = value; node->left = NULL ; node->right = NULL ; if (tree->root == NULL ) tree->root = node; else { Node *temp = tree->root; while (temp != NULL ) { if (value < temp->data){ if (temp->left == NULL ) { temp->left = node; return ; } else { temp = temp->left; } } else { if (temp->right == NULL ) { temp->right = node; return ; } else { temp = temp->right; } } } } return ; } void inorder (Node *node) { if (node != NULL ){ inorder(node->left); printf ("%d" ,node->data); inorder(node->right); } } void inorder (Node *node) { if (node == NULL ){ return ; } printf ("%d" ,node->data); inorder(node->left); inorder(node->right); } void inorder (Node *node) { if (node == NULL ){ return ; } inorder(node->left); inorder(node->right); printf ("%d" ,node->data); } void Deleteer (Node *node, int value) { Node *L,*LL; Node *p=node; Node *parent=node; int child=0 ; if (!node) return ; while (p) { if (p->data == value) { if (!p->left && !p->right) { if (p == node) free (p); else if (child==0 ) { parent->left=NULL ; free (p); } else { parent->right=NULL ; free (p); } } else if (!p->left) { if (child==0 ) parent->left=p->right; else parent->right=p->right; free (p); } else if (!p->right) { if (child==0 ) parent->left=p->left; else parent->right=p->left; free (p); } else { LL=p; L=p->right; if (L->left) { LL=L; L=L->left; p->data=L->data; LL->left=L->left; for (; L->left; L=L->left); L->left=p->left; p->left=NULL ; } else { p->data=L->data; LL->right=L->right; } } p=NULL ; } else if (value < p->data) { child=0 ; parent=p; p=p->left; } else { child=1 ; parent=p; p=p->right; } } } int main () { Tree tree; tree.root = NULL ; int n; scanf ("%d" , &n); for (int i = 0 ; i < n; i++) { int temp; scanf ("%d" , &temp); insert(&tree, temp); } inorder(tree.root); Deleteer(tree.root,5 ); return 0 ; }
线索二叉树 二叉搜索树BST 二又排序树、二叉查找树(BST, Binary Search Tree)
左子树上所有结点的关键字均小于根结点的关键字
右子树上所有结点的关键字均大于根结点的关键字
左子树和右子树又各是一棵二叉排序树。
左子树结点值 < 根结点值 < 右子树结点值;
进行中序遍历,可以得到一个递增的有序序列。
查找: 时间复杂度 O(h),若排序树很平衡,则h接近log2n,若非常不平衡,则h会接近n。
插入: 时间复杂度 O(h)
若原二叉排序树为空,则直接插入结点;否则,若关键字k小于 根结点值,则插入到左子树,若关键字k大于根结点值,则插入到右子树。
删除:
先搜索找到目标结点:
①若被删除结点z是叶结点,则直接删除,不会破坏二又排序树的性质。
②若结点z只有一棵左子树或右子树,则让z的子树成为z父结点的子树,替代z的位置。
③若结点z有左、右两棵子树,则令z的直接后继(或直接前驱)替代z,然后从二叉排序树中删去这个直接后继(或直接前驱),这样就转换成了第一或第二种情况。
自平衡二叉树AVL 平衡二叉树( Balanced Binary Tree),简称平衡树(AVL树)ー一树上任一结点的左子树和右子树的高度之差不超过1 。
结点的平衡因子 = 左子树高 - 右子树高。
平衡二叉树结点的平衡因子的值只可能是-1、0或1。否则就不是平衡二叉树了。
查找:时间复杂度不超过O(h) 、O(log2n)
插入 :
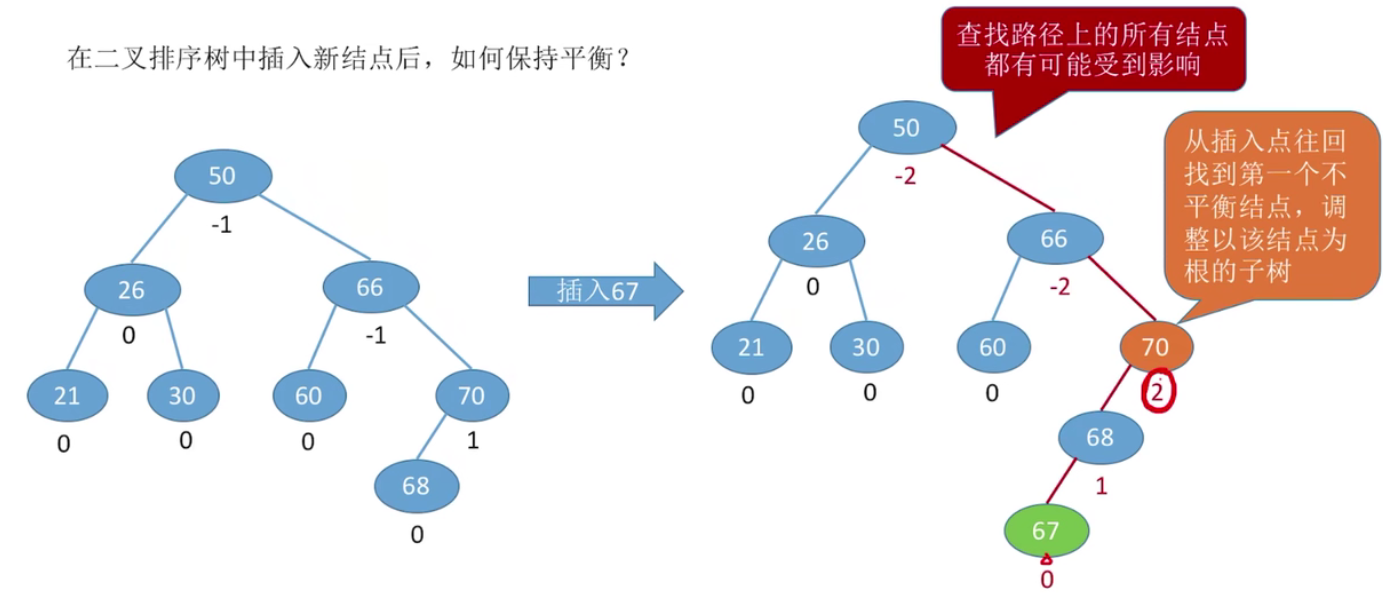
调整 最小不平衡子树A(从插入点找到的第一个不平衡点为根的子树):
LL :在A的左孩子的左子树中插入导致不平衡;右上旋 ;
RR :在A的右孩子的右子树中插入导致不平衡;
调整:A的右孩子结点左上旋 ;
LR :在A的左孩子的右子树中插入导致不平衡;先左上旋再右上旋 ;
RL :在A的右孩子的左子树中插入导致不平衡;先右上旋后左上旋 ;
哈夫曼树 结点的带权路径长度:
树的每一个结点,都可以拥有自己的“权重”(Weight),权重在不同的算法当中可以起到不同的作用。结点的带权路径长度,是指树的根结点到该结点的路径长度,和该结点权重的乘积。
树的带权路径长度
在一棵树中,所有叶子结点的带权路径长度之和,被称为树的带权路径长度,也被简称为WPL。
而哈夫曼树(Huffman Tree)是在叶子结点和权重确定的情况下,带权路径长度最小的二叉树,也被称为最优二叉树。
一颗有n个叶子结点的的哈夫曼树共有2n-1个结点
原则上,我们应该让权重小的叶子结点远离树根,权重大的叶子结点靠近树根。
思路:
借助辅助队列,将权值最小的两个叶子节点挑出来,并根据这两个结点生成一个新的父结点,父节点的权值是这两个结点权值之和;从队列中移除已选择的节点,把新的父结点加入队列;
重复这一步骤,直到所有结点组成一颗完整二叉树
(如果是构造k叉哈夫曼树 ,且节点数无法严格构成k叉树,则需要补充几个权值为0的 “假节点” )
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 #include <cstdio> #include <cstring> using namespace std;typedef struct { int weight; int parent, lc, rc; } HTNode, *HuffmanTree; void Select (HuffmanTree &HT, int n, int &s1, int &s2) int minum; for (int i = 1 ; i <= n; i++){ if (HT[i].parent == 0 ) { minum = i; break ; } } for (int i = 1 ; i <= n; i++) { if (HT[i].parent == 0 ) if (HT[i].weight < HT[minum].weight) minum = i; } s1 = minum; for (int i = 1 ; i <= n; i++) { if (HT[i].parent == 0 && i != s1) { minum = i; break ; } } for (int i = 1 ; i <= n; i++) { if (HT[i].parent == 0 && i != s1) if (HT[i].weight < HT[minum].weight) minum = i; } s2 = minum; } void CreatHuff (HuffmanTree &HT, int *w, int n) int m, s1, s2; m = n * 2 - 1 ; HT = new HTNode[m + 1 ]; for (int i = 1 ; i <= n; i++){ HT[i].weight = w[i]; HT[i].parent = 0 ; HT[i].lc = 0 ; HT[i].rc = 0 ; } for (int i = n + 1 ; i <= m; i++) { HT[i].weight = 0 ; HT[i].parent = 0 ; HT[i].lc = 0 ; HT[i].rc = 0 ; } printf ("\nthe HuffmanTree is: \n" ); for (int i = n + 1 ; i <= m; i++) { Select (HT, i - 1 , s1, s2); HT[s1].parent = i; HT[s2].parent = i; HT[i].lc = s1; HT[i].rc = s2; HT[i].weight = HT[s1].weight + HT[s2].weight; printf ("%d (%d, %d)\n" , HT[i].weight, HT[s1].weight, HT[s2].weight); } printf ("\n" ); } int main () HuffmanTree HT; int *w, n, wei; printf ("input the number of node\n" ); scanf ("%d" , &n); w = new int [n + 1 ]; printf ("\ninput the %dth node of value\n" , n); for (int i = 1 ; i <= n; i++) { scanf ("%d" , &wei); w[i] = wei; } CreatHuff (HT, w, n); return 0 ; }
哈夫曼编码 哈夫曼编码:对一棵具有n个叶子的哈夫曼树,若对树中的每个左分支赋0,右分支赋1,则从根到每个叶子的路径上,各分支的赋值分别构成一个二进制串,该二进制串就称为哈夫曼编码。
哈夫曼编码的基本思想是:为出现次数较多的字符编以较短的编码,在压缩原理中有重要作用。
B树 B树,又称多路平衡查找树 。
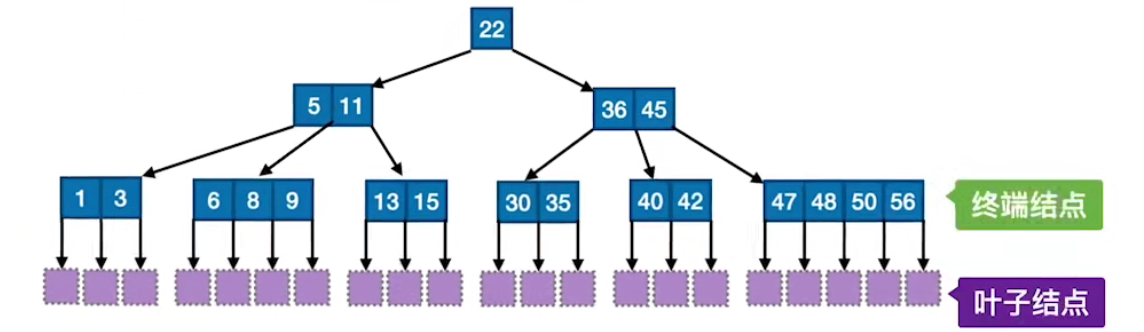
B树中所有结点的孩子个数的最大值称为B树的阶,通常用m表示。一棵m阶B树或为空树,或为满足如下特性的m叉树 :
树中每个结点至多有m棵子树 ,即至多含有m-1个关键字
若根结点不是终端结点,则至少有两棵子树 。
除根结点外的所有非叶结点至少有 m/2 棵子树 ,即至少含有 (m/2) -1 个关键字。
所有的叶结点都出现在同一层次上,并且不帯信息 (可以视为外部结点或类似于折半查找判定树的查找失败结点,实际上这些结点不存在,指向这些结点的指针为空)。
m阶B树的核心特性
根节点的子树数∈[2,m], 关键字数∈[1, m-1]
对任一结点,其所有子树高度都相同
关键字的值:子树0 < 关键字1 < 子树1 <关键字2 < 子树2 <. (类比二叉査找树左<中<右)
注:算B树高度时,不用包括叶子节点/失败节点;
n个关键字的B树必有n+1个叶子节点。(相当于在n个关键字中插入木板,两边也插,则插了n+1个木板)
B树的插入
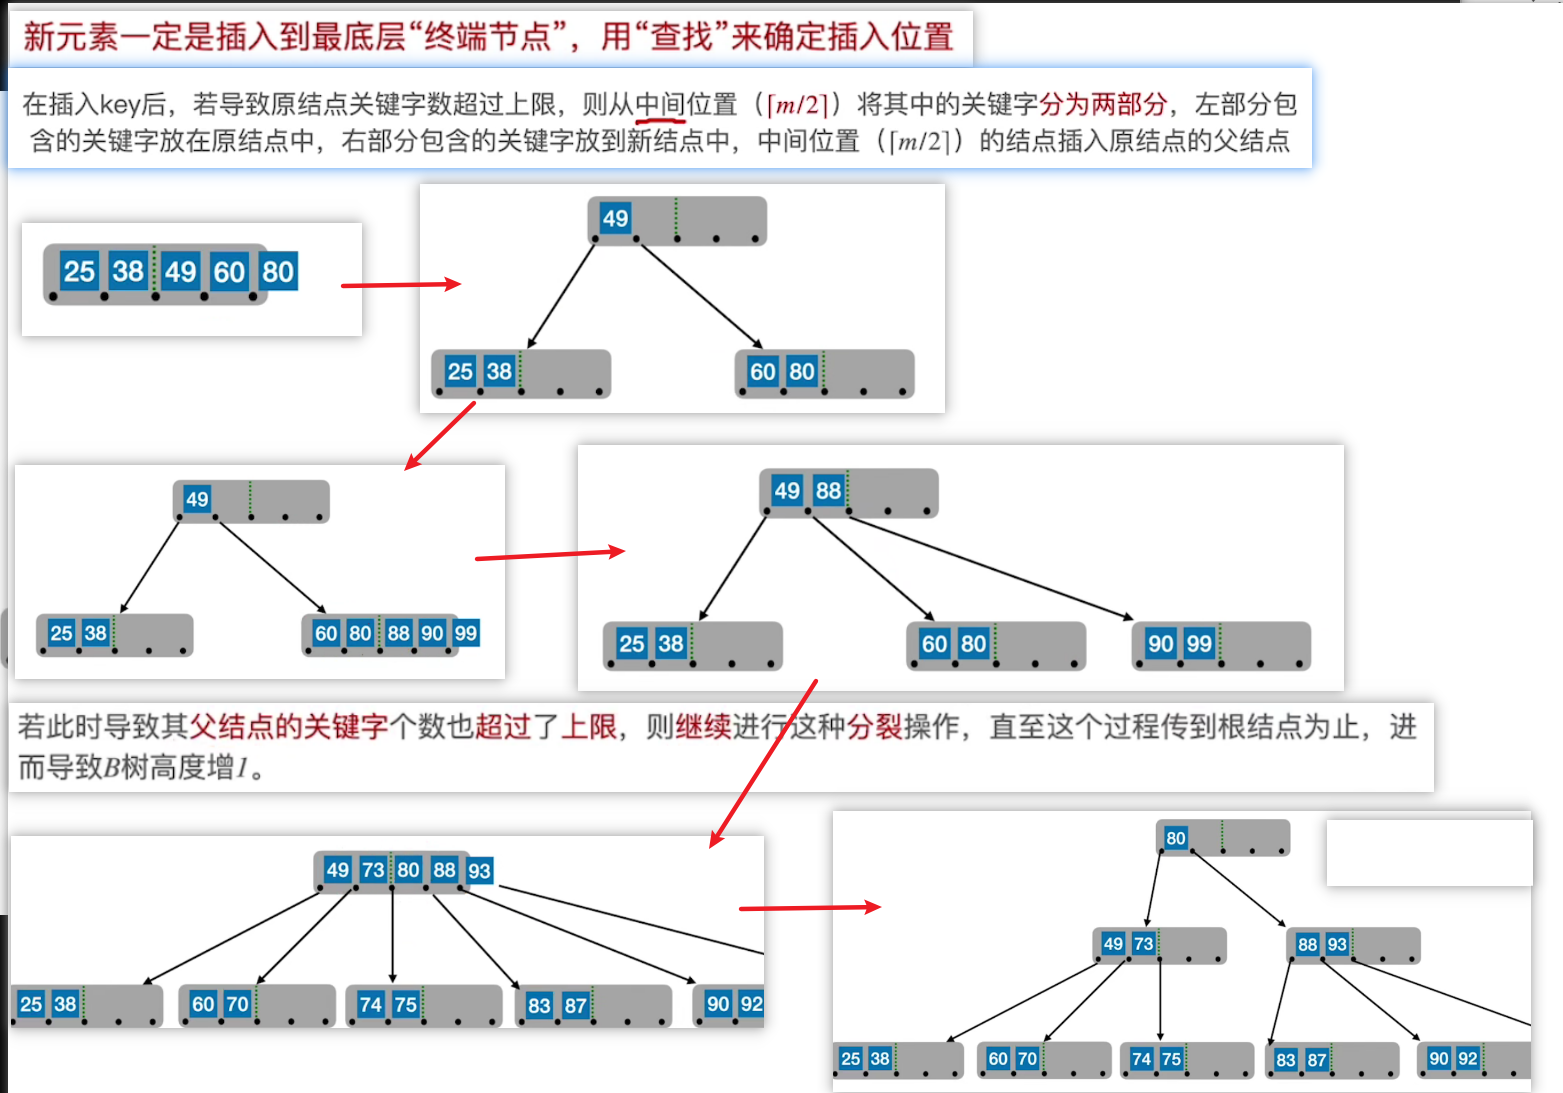
新元素一定是插入到最底层“终端节点” ,用“查找”来确定插入位置。
在插入key后,若导致原结点关键字数超过上限,则从中间位置( [m/2] )将其中的关键字分为两部分,左部分包含的关键字放在原结点中,右部分包含的关键字放到新结点中,中间位置( [m/2] )的结点插入原结点的父结点。
若此时导致其父结点的关键字个数也超过了上限,则继续进行这种分裂操作,直至这个过程传到根结点为止,进而导致B树高度增。
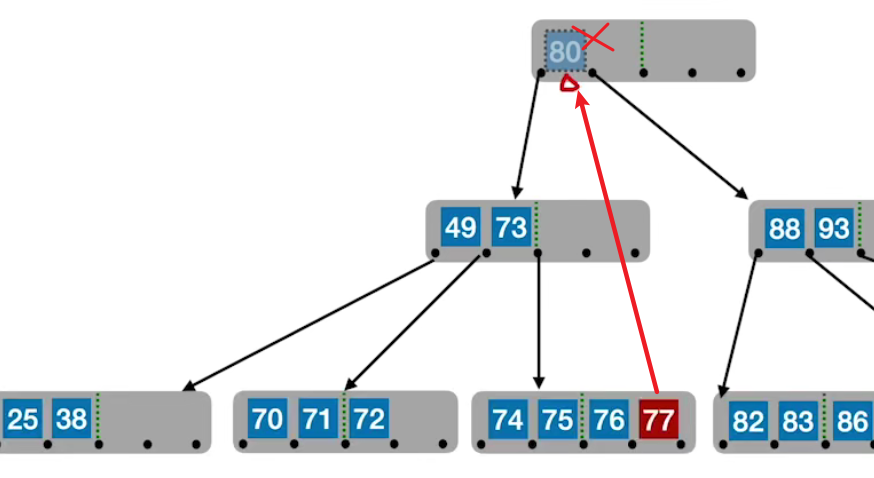
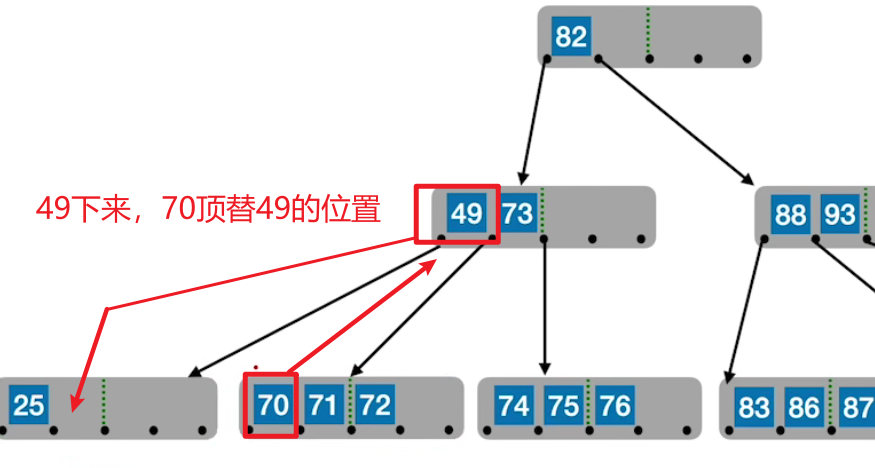
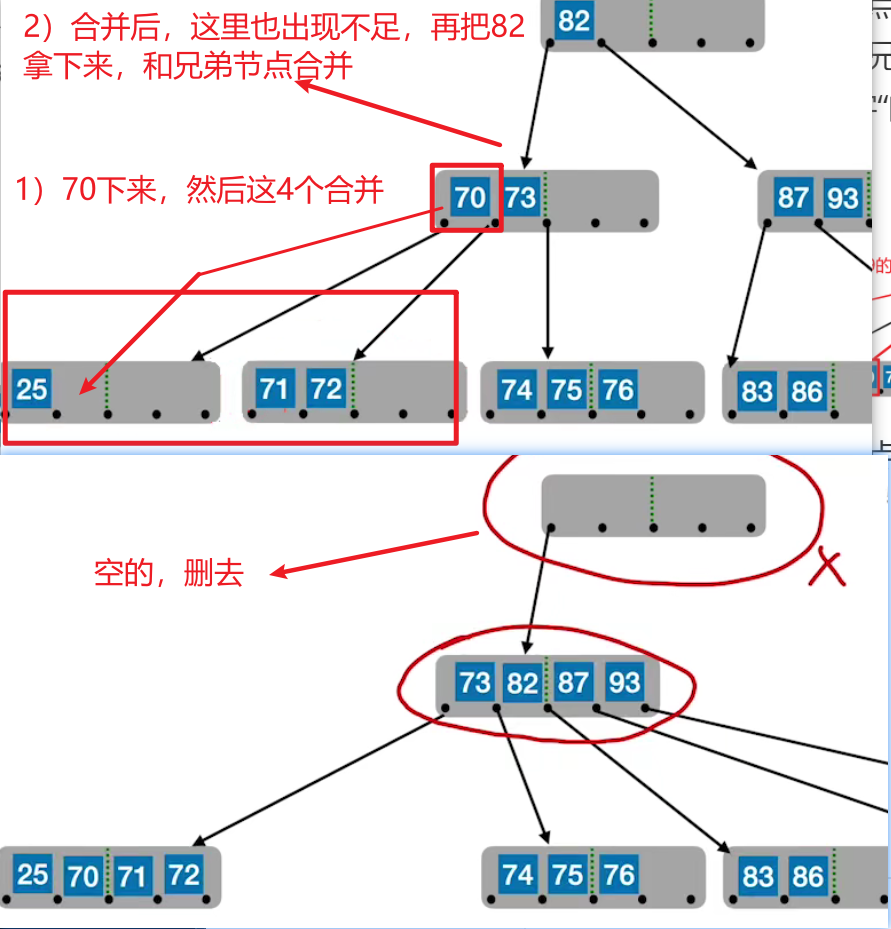
B树的删除
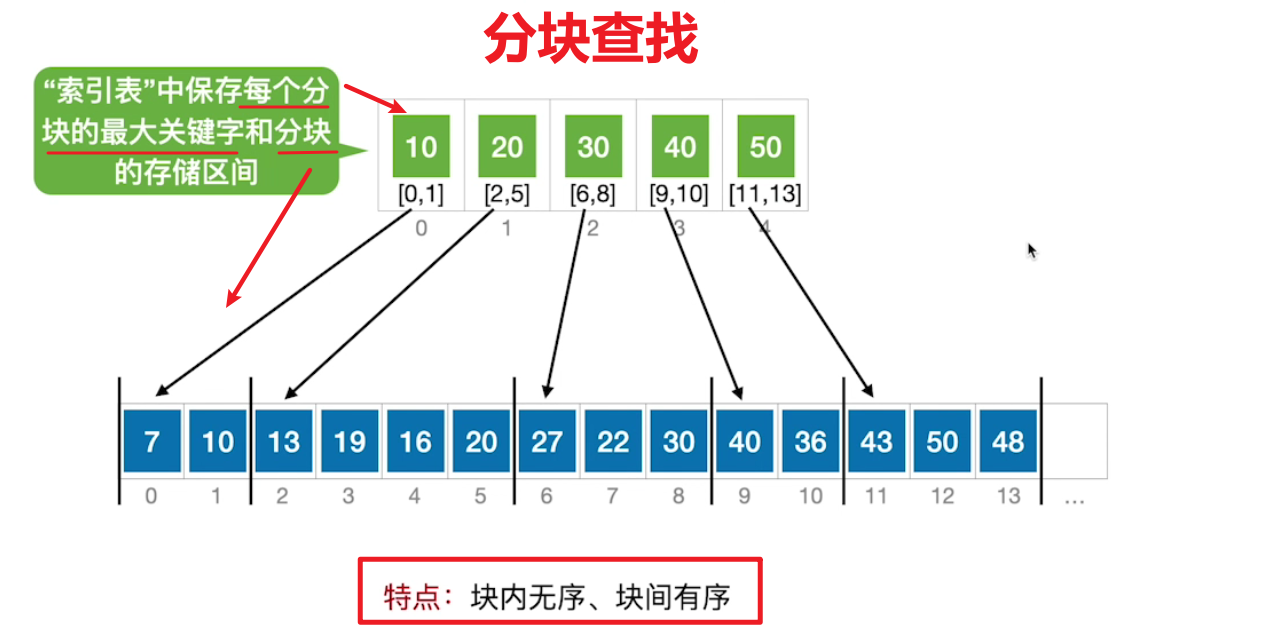
B+树 B+树 可以类比分块查找。
分块查找:
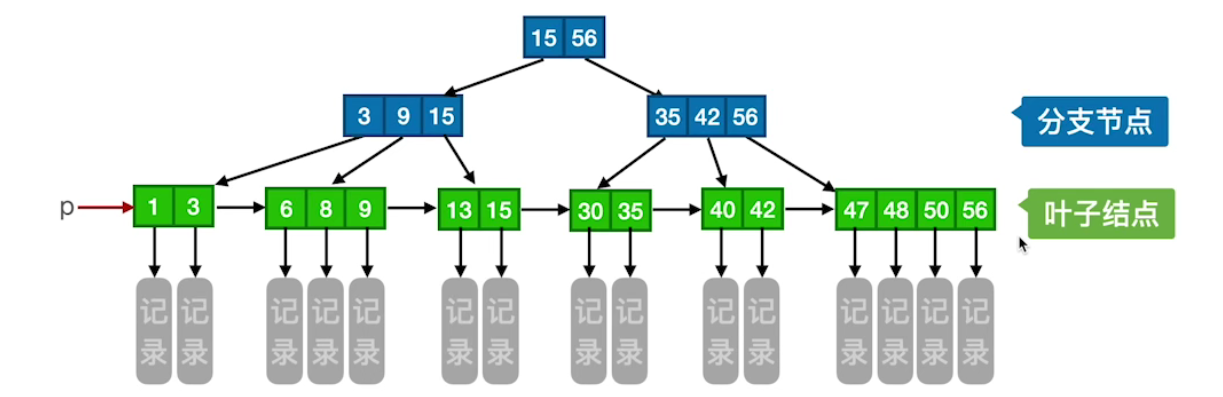
B+树:
一棵m阶的B+树 需满足下列条件:
每个分支结点最多有m棵子树(孩子结点)。
非叶根结点至少有两棵子树,其他每个分支结点至少有 m/2 棵子树。
结点的子树个数与关键字个数相等 。(区别于B树,因为B+树的关键字和子树是一一对应的)所有叶结点包含全部关键字及指向相应记录的指针 ,叶结点中将关键字按大小顺序排列,并且相邻叶结点按大小顺序相互链接起来 。(支持顺序查找)
所有分支结点 中仅包含它的各个子结点中关键字的最大值 及指向其子结点的指针。
B+的查找:
无论查找成功与否,最终一定要走到最下面一层节点。 因为只有叶子节点存放了所需记录。
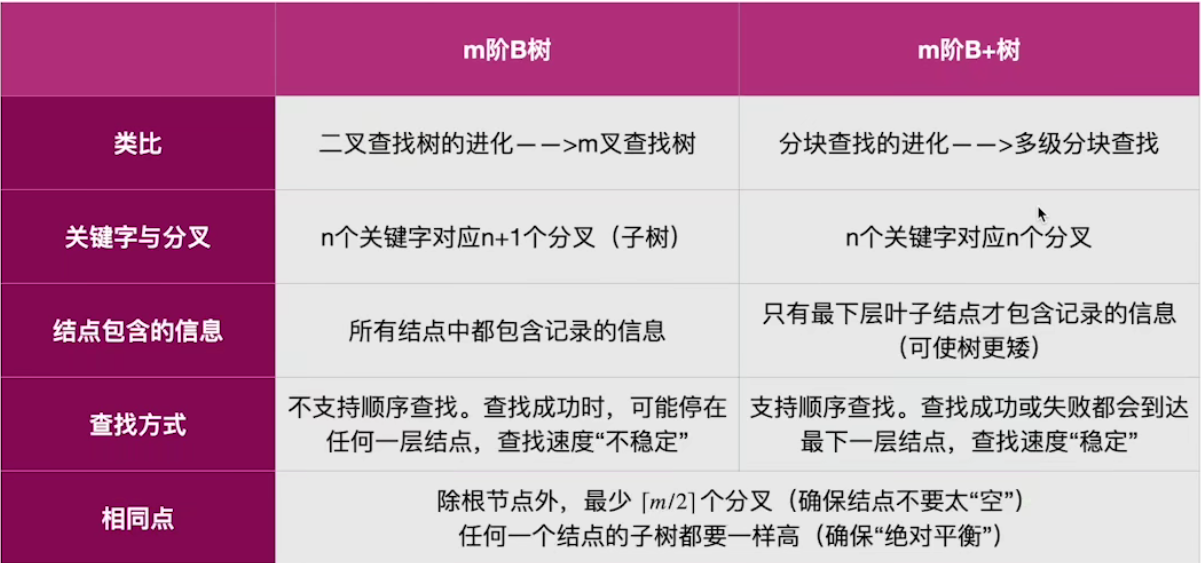
B树和B+树的对比:
红黑树 概念性质 红黑树的概念模型是2-3-4树 ,以二叉树为基础 ,在二叉树属性中加入颜色属性 来表示2-3-4树中不同的节点。
红黑树的五大定义 :
节点颜色只能为红或黑; 根节点是黑色; 每个叶子节点是黑色的(这里的叶子节点其实是空节点) 不能出现连续的红色节点; 从任意节点到它的每个子节点的所有路径都包含相同的黑色节点;
这5条定义确保了红黑树的关键特性:
从根到叶子节点的最长路径,不会超过最短路径的两倍 ;这棵树基本是平衡 的;
虽然不是绝对平衡,但可以保证最坏情况下,红黑树依然是高效的 ;
为什么能做到最长路径不超过最短路径的两倍?
性质4规定了路径上不能有两个相连的红节点,因此,最长路径一定是红色节点和黑节点交替而成;
性质2和3规定了根节点和叶子节点都是黑色,所以最短路径的黑节点一定多于红节点(可能全部为黑);
性质5规定每条路径黑节点的数目相同;
因此,没有路径的长能多于其他任何路径两倍。
红黑树的三种变换:变色,左旋转,右旋转
红黑树插入的新节点为红色 的:
因为插入红节点,不会违反红黑树的规则,虽然可能会红红相连,不过可以通过变色和旋转来调整;而插入黑色节点,必然会导致一条路径上多一个黑节点(难以调整)。
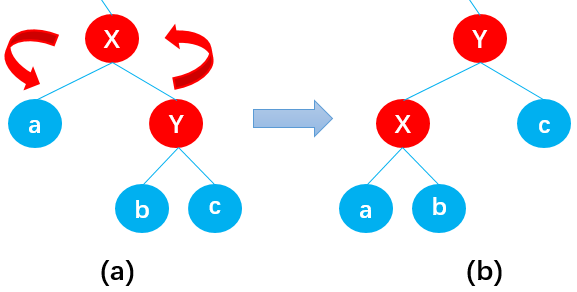
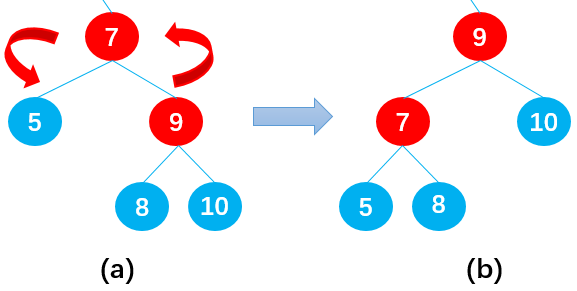
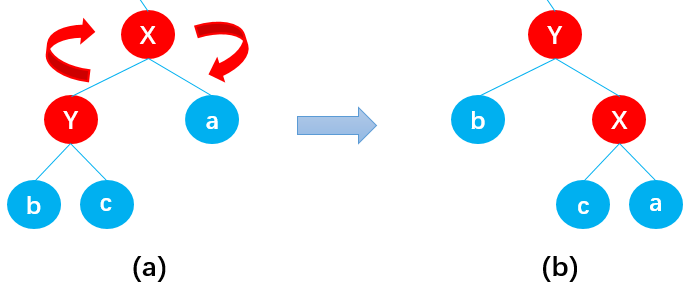
左旋转 :以当前节点X为根,逆时针旋转二叉树,使得父节点原来的位置被右子节点替代,左子节点的位置被父节点替代 。同时,节点Y的左子树 b 向左平移 成为了节点X的右子树
旋转之后仍然是二叉搜索树:
右旋转 :以节点X为根,顺时针 旋转二叉搜索树,使得父节点原来的位置被自己的左子节点替代,右子节点的位置被父节点替代;
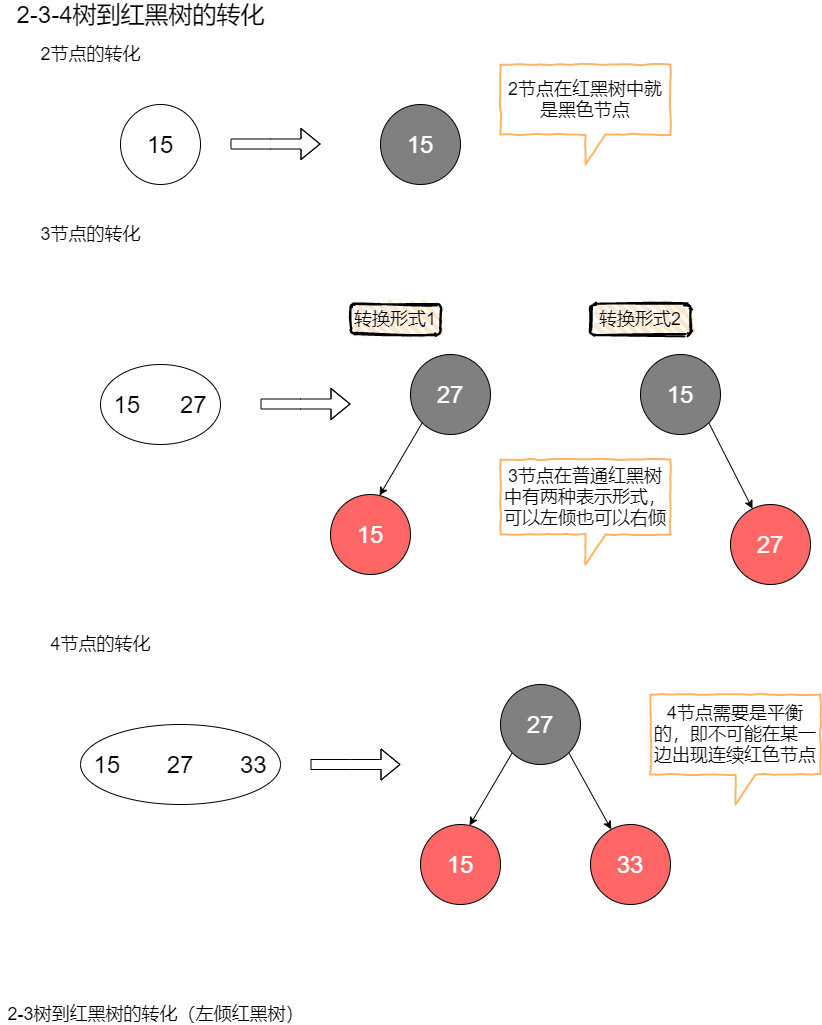
2-3树 到 红黑树 2-3-4树中的2节点对应红黑树中的黑色节点,而非2节点以红节点+黑节点的方式表示,黑色父节点+一个红色子节点表示3节点,黑色父节点+左右两个红色子节点表示4节点;
2-3-4树 :是一颗阶数为4的B树,它可能会存在2节点,3节点,4节点(2节点就是普通的二叉树节点;3节点:由2个属性X和Y,3个子节点,分别是小于X的,大于X小于Y的,大于Y的;4节点跟3节点类似)
下面是以较为简单的 2-3树和左倾红黑树 为例,理解两者的转化关系
2-3树不用考虑2-3-4树中复杂的4节点分裂;
左倾红黑树规定了红色节点只能在左子树,这个限制减少了原本红黑树的调平难度,更容易理解;
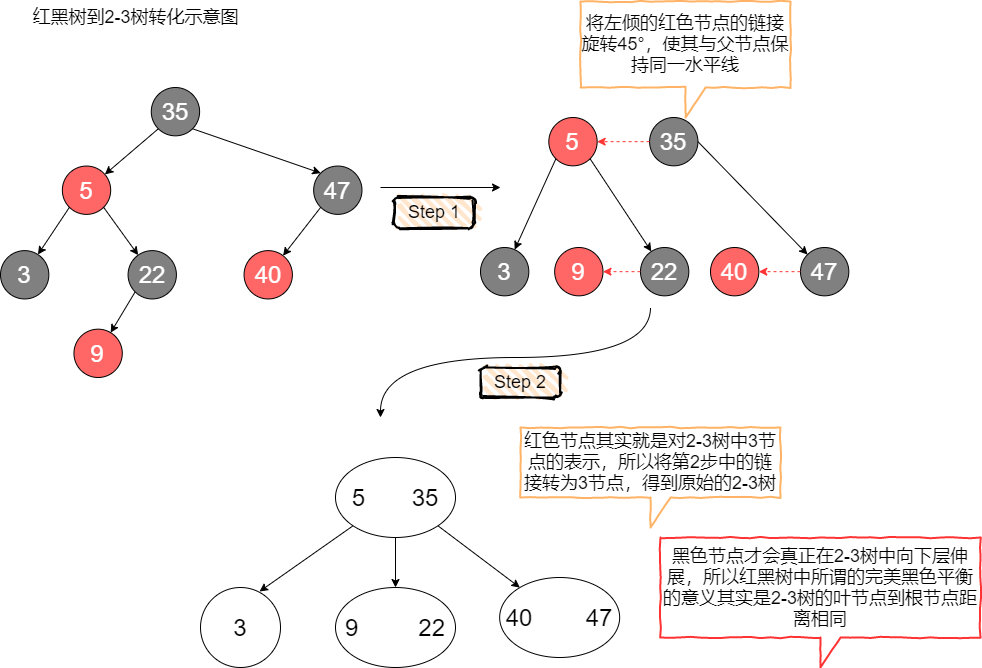
2-3树 和 左倾红黑树 :把左倾红黑树中的红色节点顺时针方向旋转45° 使其与黑父平行,然后再将它们看作一个整体,可以近似得到一颗2-3树。
从2-3树来看,红黑树的红节点和黑节点是绑定的,因为在2-3树中它们本来就在同一层,所有只有黑节点在2-3树中体现树的高度
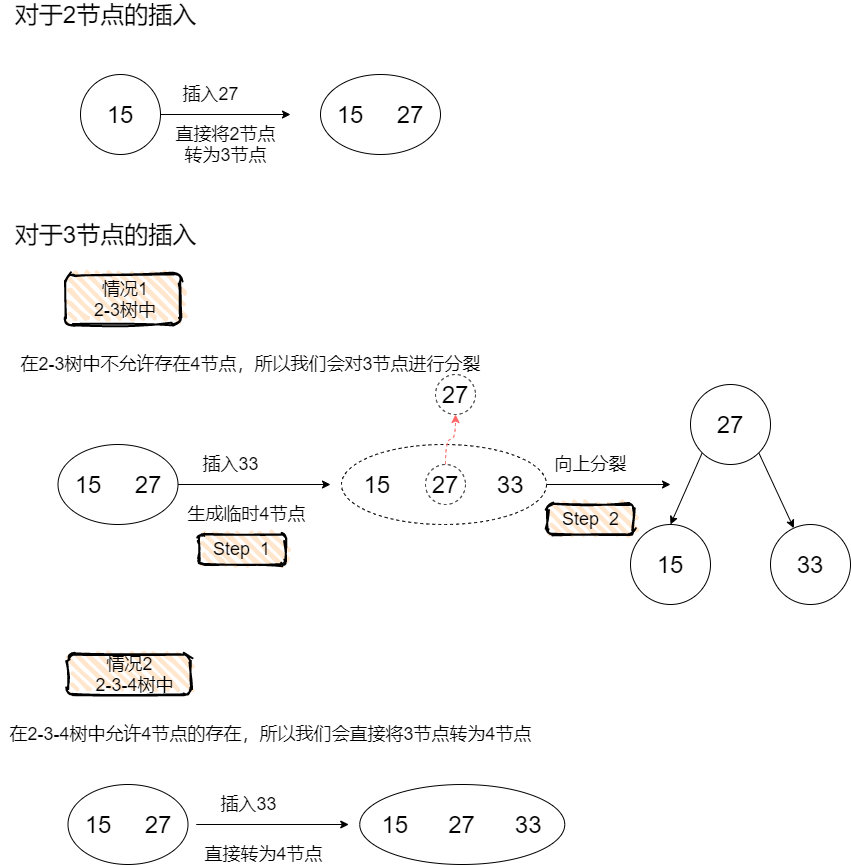
对于2-3树的插入:
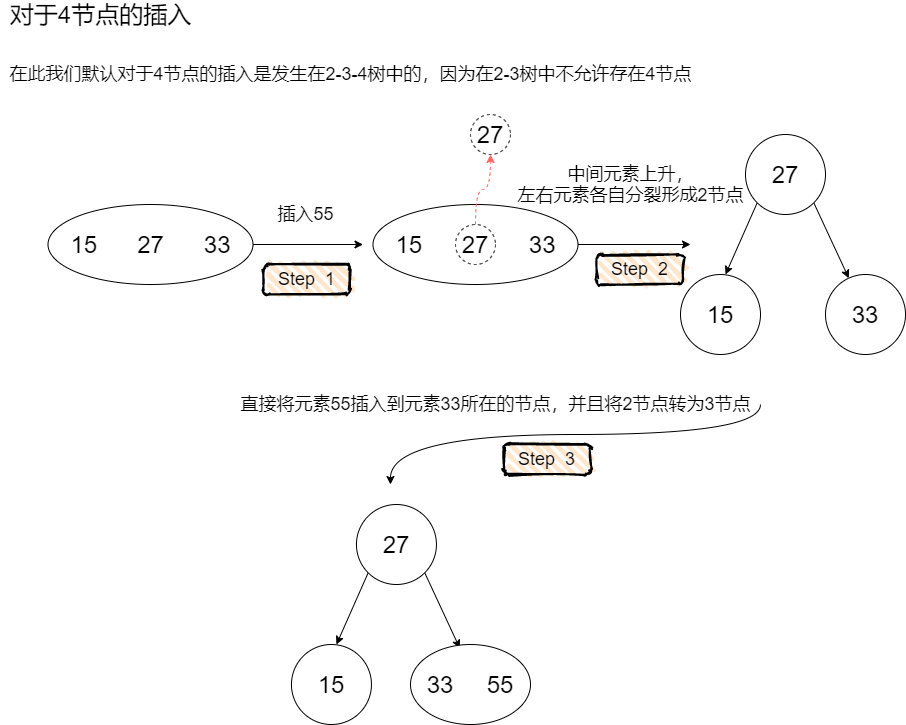
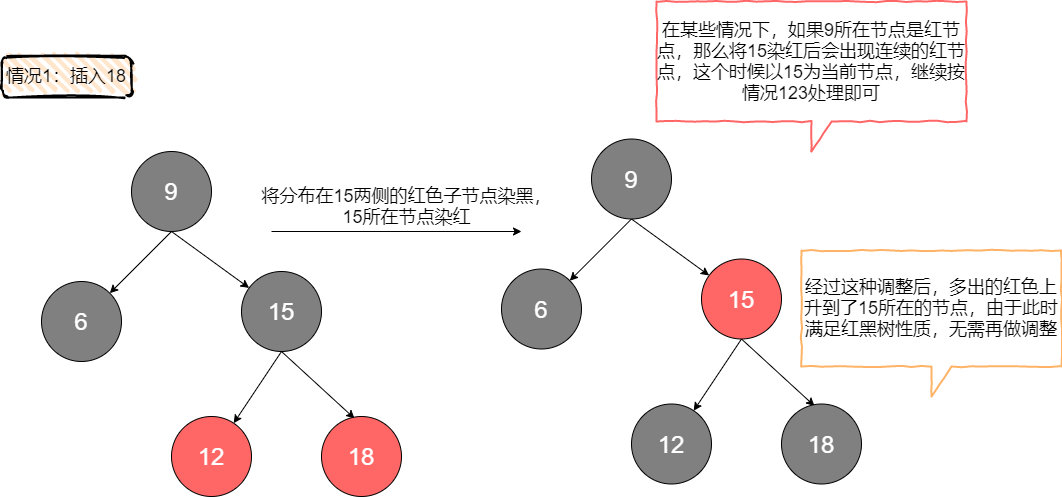
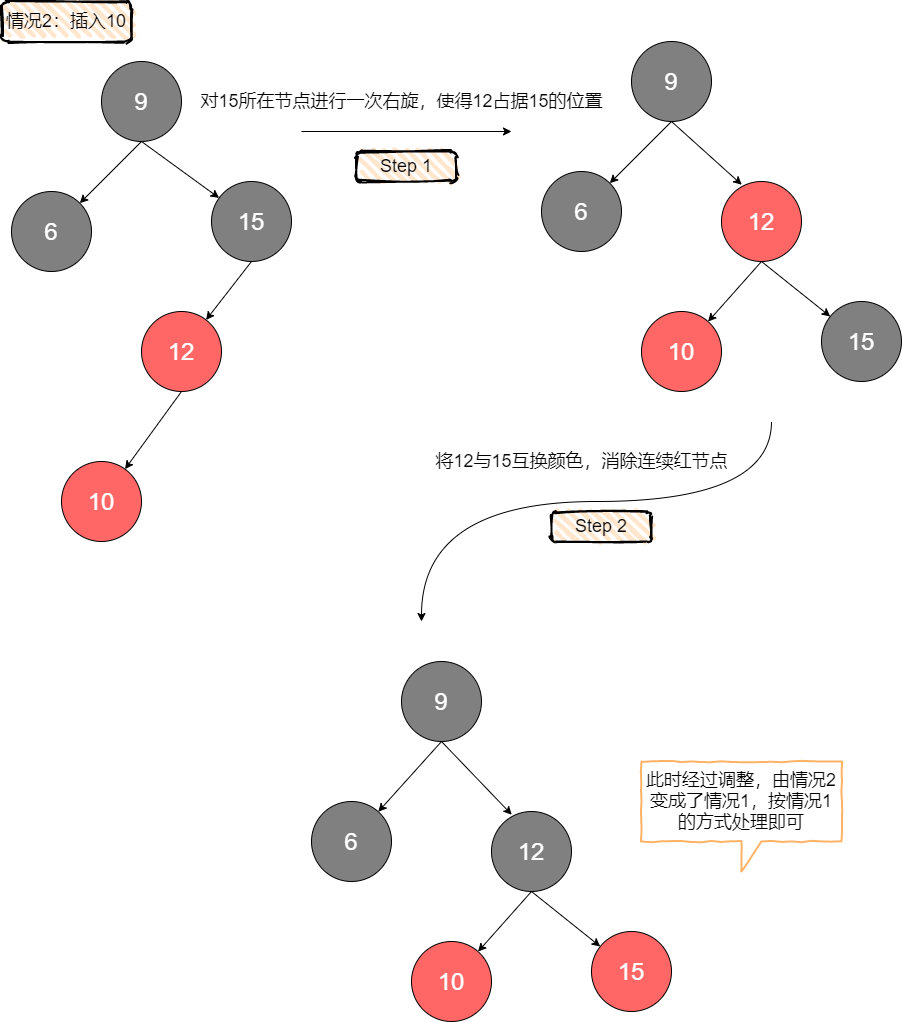
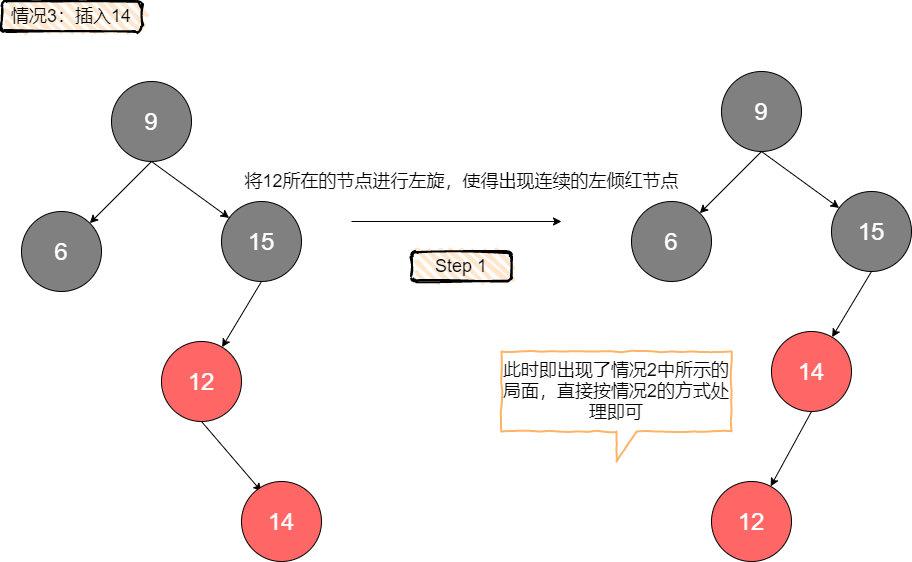
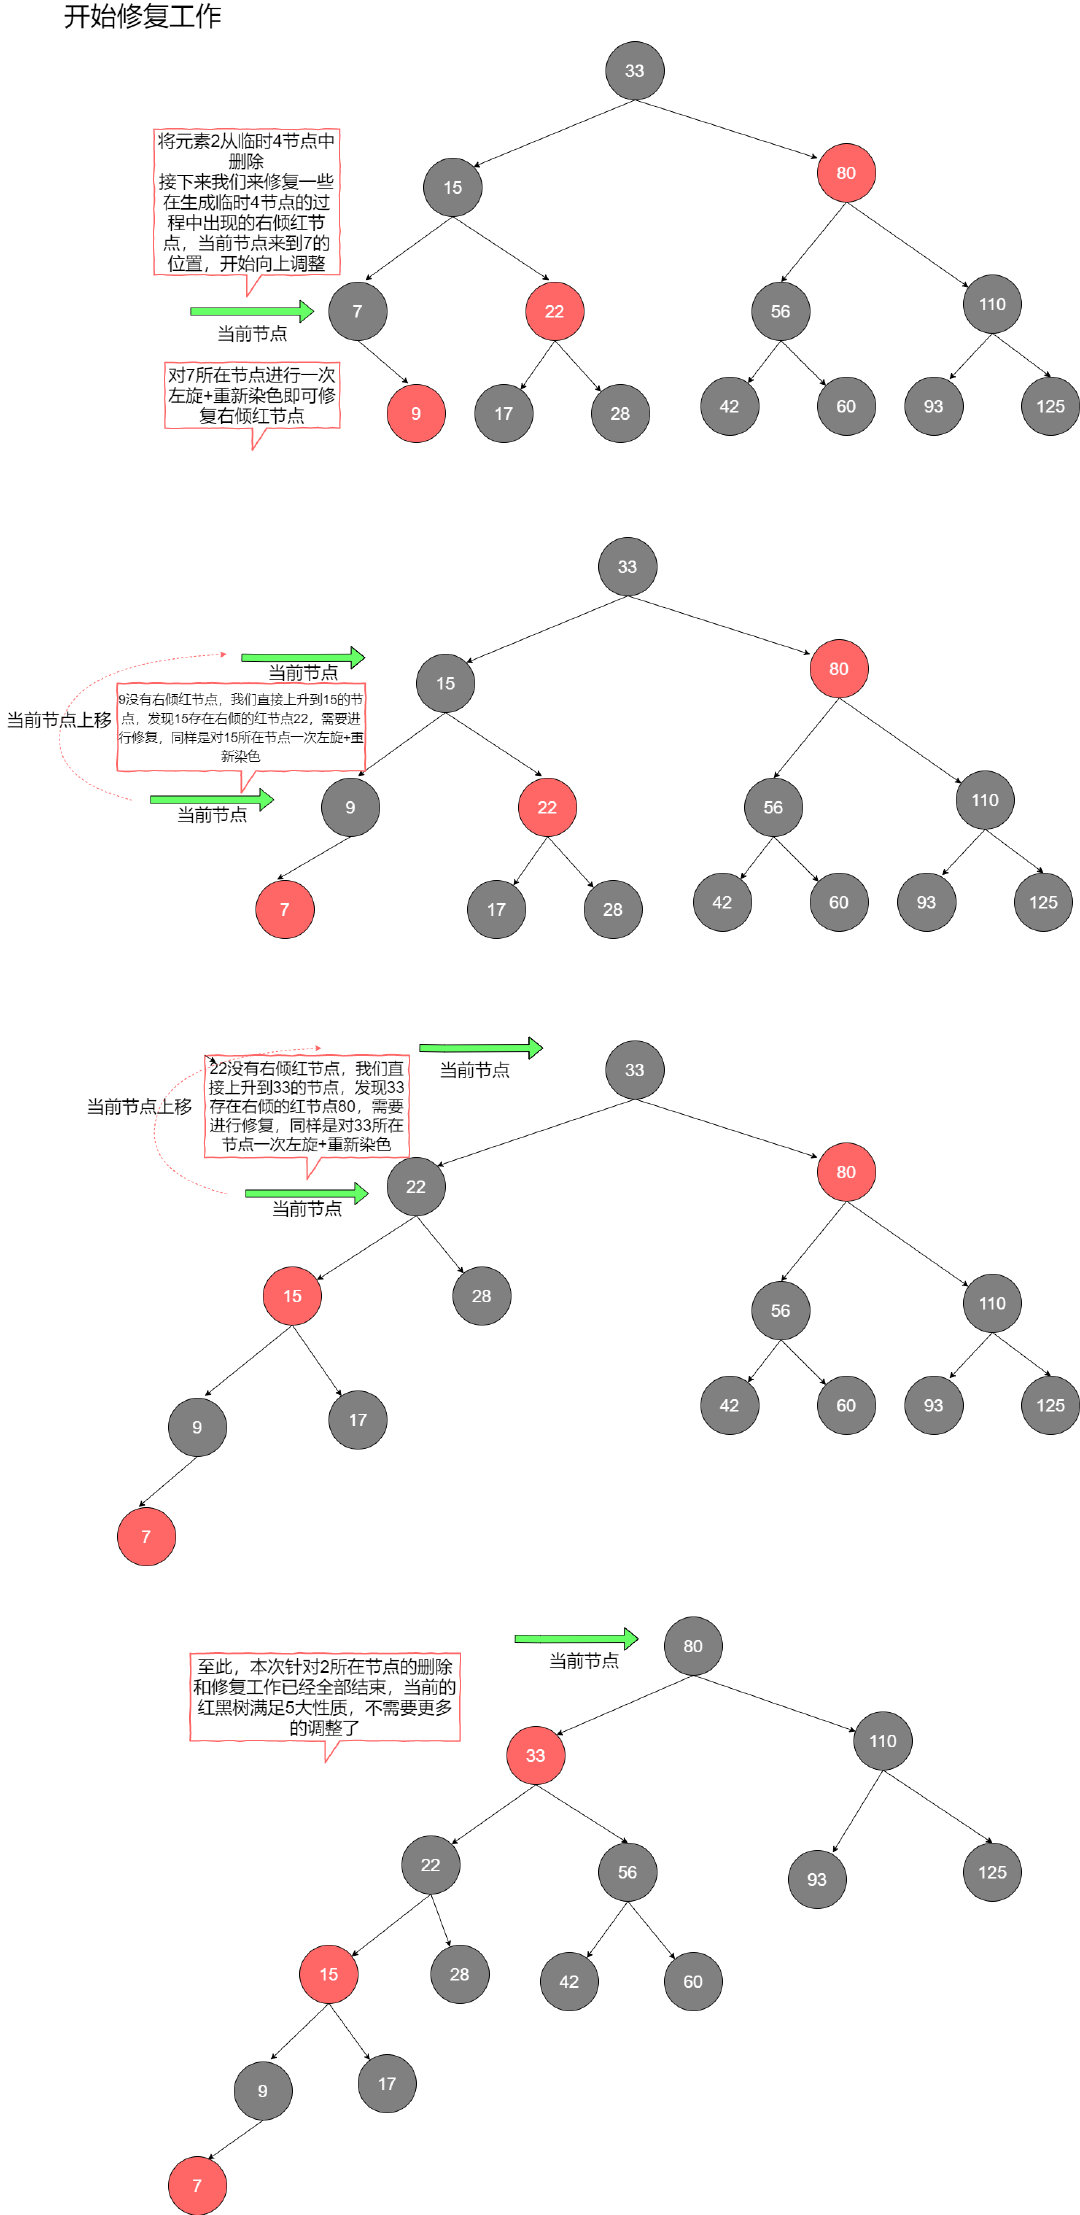
我们的插入操作需要遵循一个原则 :先将这个元素尝试性地放在已经存在的节点中 (即插入一个红色节点),如果要存放的节点是2节点,那么插入后会变成3节点,如果要存放的节点是3节点,那么插入后会变成4节点(临时 )。然后,我们对可能生成的临时4节点进行分裂处理,使得临时4节点消失。
如图:
在2-3树中如果待插入节点是个2节点,而2节点对应着红黑树中的黑色父节点;所以向2节点插入元素,即在黑色父节点下面增加一个红色儿子,
3节点插入元素,即已经有一个黑色父节点和一个红色子节点,则再给黑色父节点一个红色子节点
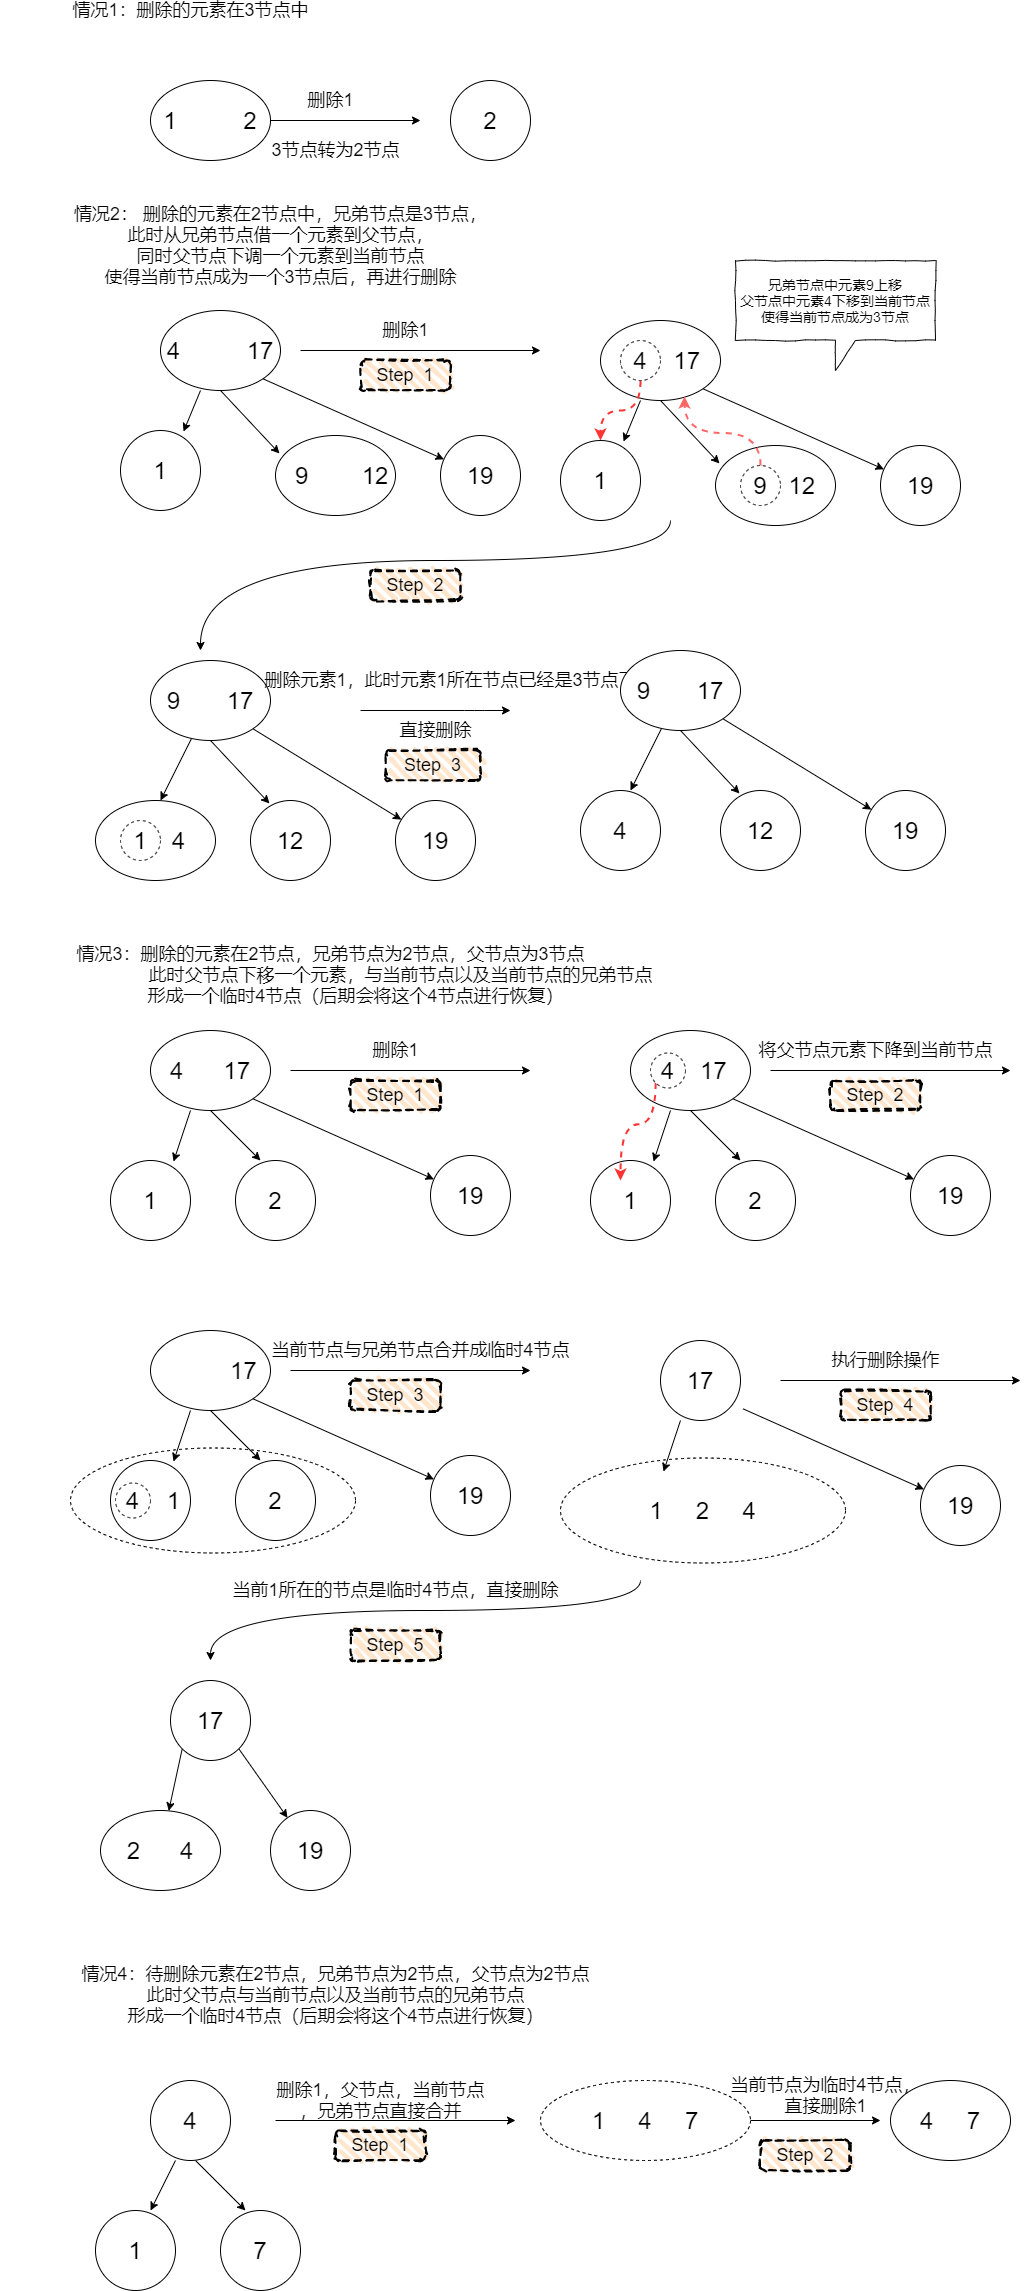
对于2-3树的删除:
2-3树的删除我们主要要考虑待删除元素在2节点这种情况,因为如果待删除元素在3节点,那么可以直接将这个元素删除,而不会破坏2-3树的任何性质(删除这个元素不会引起高度的变化)。
当待删除元素在2节点的时候,由于删除这个元素会导致2节点失去自己唯一的元素 ,引发2节点自身的删除,会使得树中某条路径的高度发生变化 ,树变得不平衡 。
对此有两种方案:
先删除这个2节点,再对树进行平衡调整;
想办法让被删除元素不可能出现在2节点中;
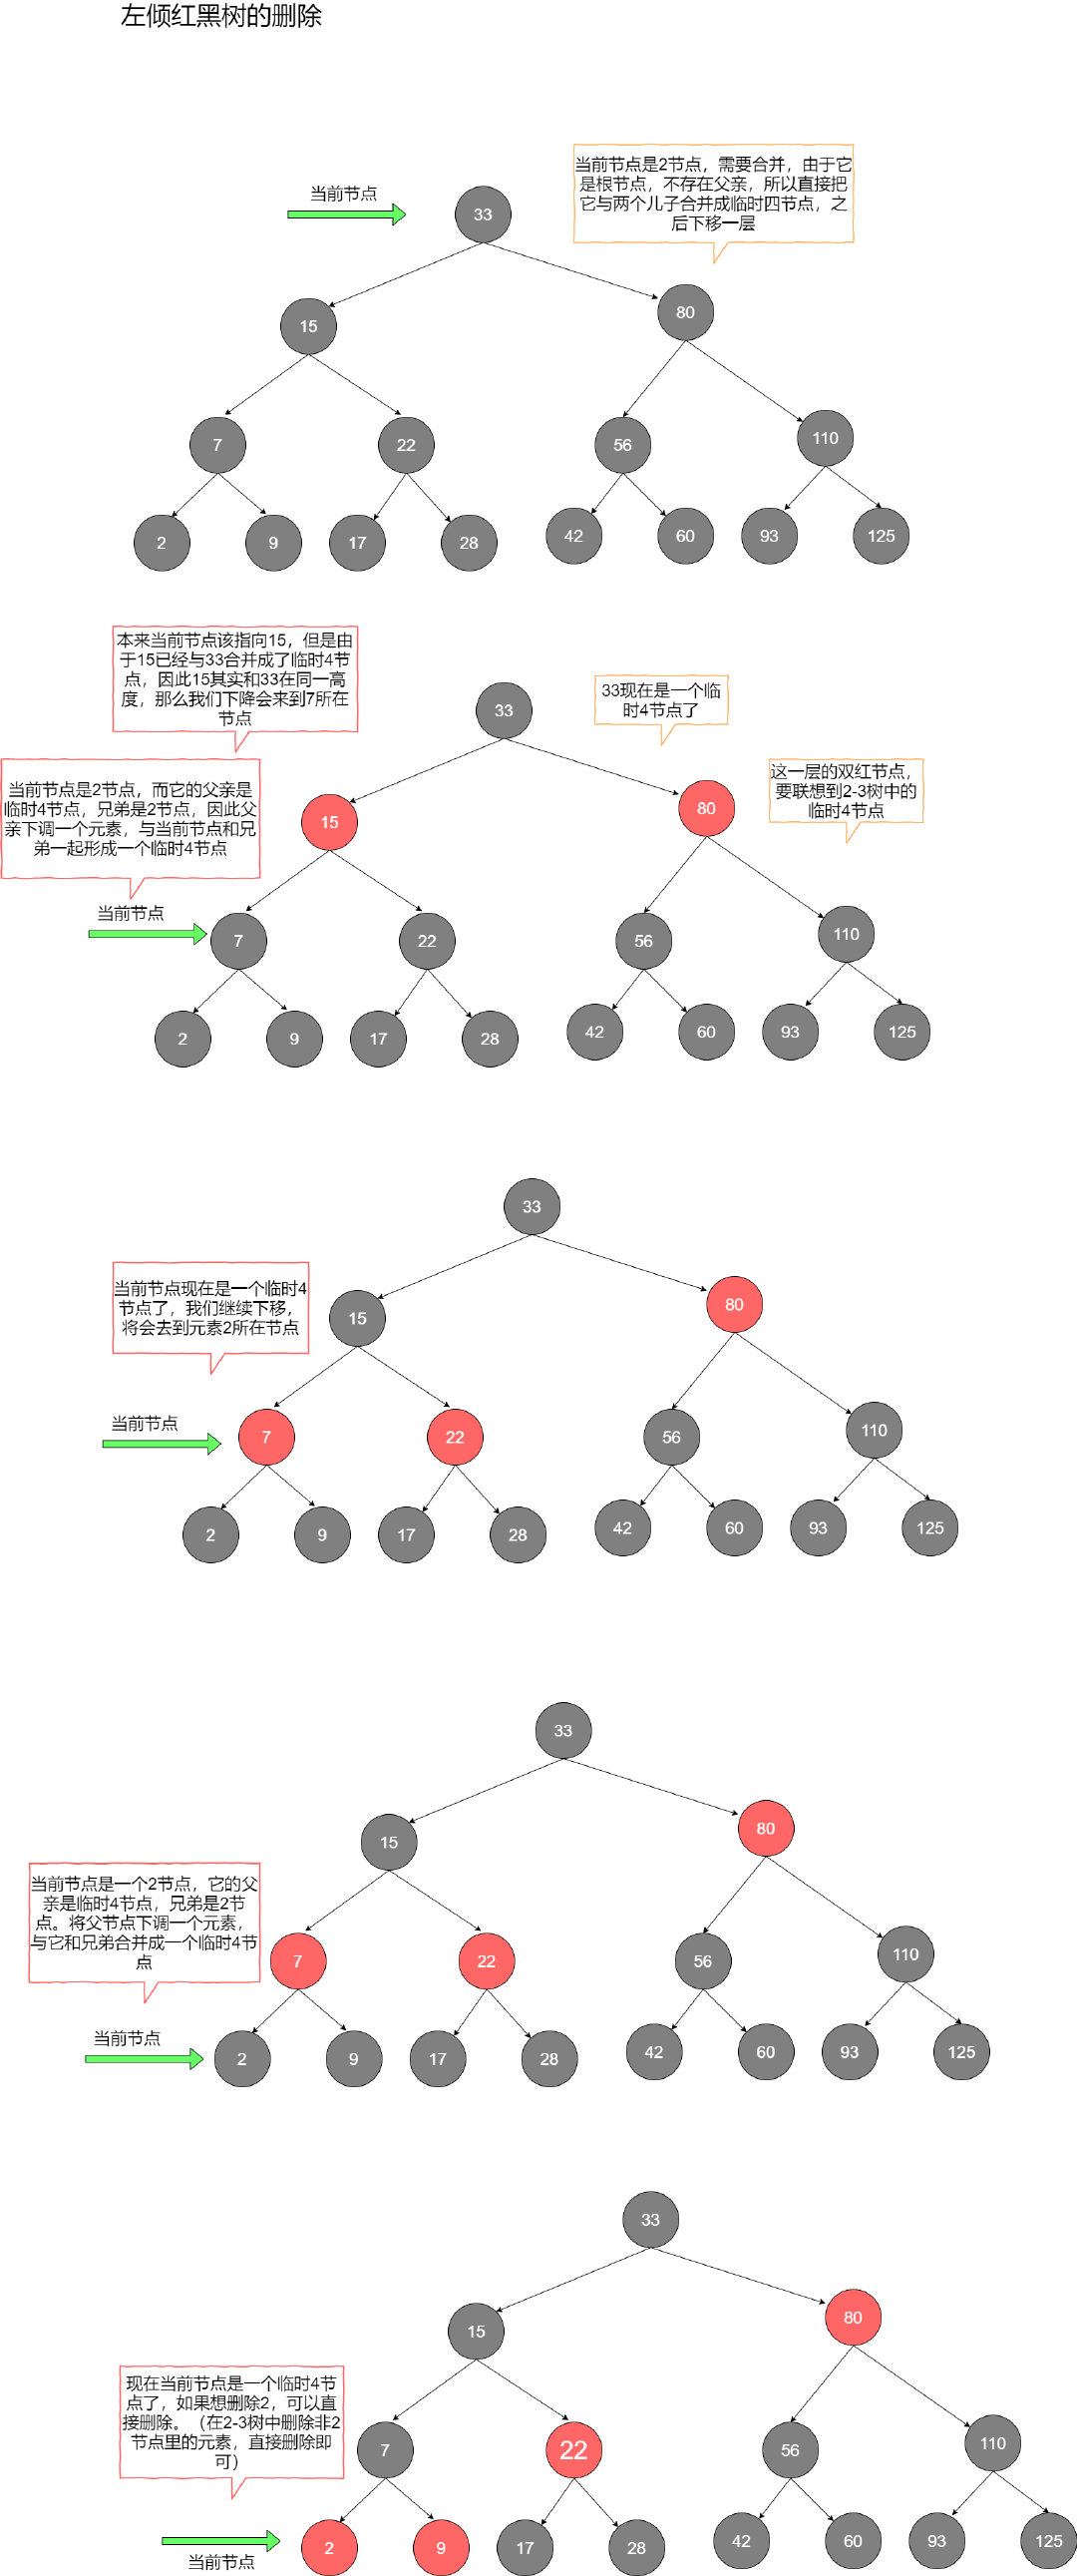
这里看第二种方案,我们在搜索到这个节点的路径中,不断地判断当前节点是否为2节点,如果是,就从它的兄弟节点或者它的父节点借一个元素,使得当前节点由2节点成为一个3节点或者一个临时4节点。
这种操作会产生一种结果:除非当前节点是根节点,否则当前节点的父节点一定是一个非2节点(因为搜索的路径是自上而下,父节点已经进行过了这种操作,所以不可能是2节点),那么我们可以保证到达叶子节点的时候,也能顺利的从父节点或者兄弟节点处借到元素,使得自己成为非2节点。从而能够直接删除某个元素
红黑树的插入和删除 插入和删除操作的父子节点上下浮动和删除里借元素的做法,就是红黑树的调整(变色,旋转);
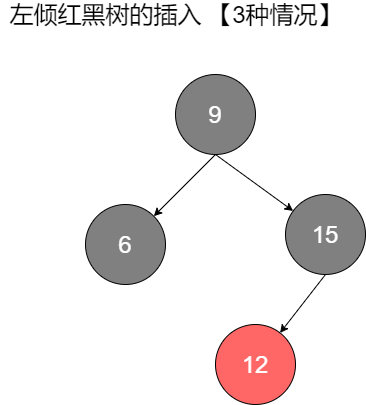
看左倾红黑树的 插入和删除(图示):
删除之后需要一些调整(左倾红黑树不允许出现右倾)
堆 Heap 性质:
结构性:用数组表示 的完全二叉树 。
有序性:任意结点的关键字(权值)是其子树所有结点的最小值/最大值
应用:
优先队列:是一种特殊的“队列”,从队列中取出元素的顺序是依照元素的关键字(权值/数值)大小,而不是元素进入队列的先后顺序。
堆排序
最小堆操作与实现: 对于任意最多有MaxSize个元素的最小堆H ∈ MinHeap 元素,item ∈
ElementType主要操作有:
MinHeap Create(int Maxsize): 创建一个空的最小堆。
void Destroy(MinHeap):释放堆的空间。
Boolean IsFull(MinHeap H): 判断最小堆是否已满。
Boolean IsEmpty(MinHeap H): 判断最小堆是否为空。
void Insert(MinHeap H,ElementType item): 将元素item插入最小堆H。
ElementType DeleteMin(MinHeap H): 返回最小堆H中最小元素(高优先级)。
MinHeap BuildMinHeap(ElementType *Element,int Size,int MaxSize):创建一个非空的最小堆
数组下标为0 的位置放一个比所有堆中元素都要小的元素(可以是ElementType的最小值),称为“哨兵 ”。从下标为1的位置开始存放堆中元素。因为是完全二叉树,所以父亲节点与其左右子节点下标满足一些关系。
由子节点找父节点:父节点下标=子节点下标 / 2 由父节点找左子节点:左子节点下标=父节点下标 * 2 由父节点找右子节点:右子节点下标=父节点下标 * 2 + 1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 #include <stdio.h> #include <stdlib.h> #include <stdbool.h> #define ElementType int typedef struct HeapStruct { ElementType *Elenment; int Size; int MaxSize; } HeapStruct, *MinHeap; MinHeap Create (int MaxSize) { MinHeap H = (MinHeap) malloc (sizeof (struct HeapStruct)); H->Elenment = (ElementType *) malloc (sizeof (ElementType) * (MaxSize + 1 )); H->Size = 0 ; H->MaxSize = MaxSize; H->Elenment[0 ] = -2020 ; return H; } void Destroy (MinHeap H) { free (H->Elenment); free (H); } bool IsFull (MinHeap H) { return (H->Size == H->MaxSize); } bool IsEmpty (MinHeap H) { return (H->Size == 0 ); } void Inset (MinHeap H, ElementType item) { int i = 0 ; if (IsFull(H)) { printf ("Heap is full\n" ); return ; } H->Size++; for (i = H->Size; H->Elenment[i / 2 ] > item; i = i / 2 ) { H->Elenment[i] = H->Elenment[i / 2 ]; } H->Elenment[i] = item; } ElementType Delete (MinHeap H) { int parent = 0 ,child = 0 ; ElementType item, temp; if (IsEmpty(H)){ printf ("Heap is Empty\n" ); return H->Elenment[0 ]; } item = H->Elenment[1 ]; temp = H->Elenment[H->Size]; H->Size--; for (parent = 1 ; parent * 2 <= H->Size; parent = child){ child = parent*2 ; if (child != H->Size && (H->Elenment[child] > H->Elenment[child +1 ])){ child ++; } if (temp > H->Elenment[child]){ H->Elenment[parent] = H->Elenment[child]; } else { break ; } } H->Elenment[parent] = temp; return item; } MinHeap BuildMinHeap (ElementType *Element,int Size,int MaxSize) { MinHeap H = NULL ; int i = 0 , parent = 0 , child = 0 ; ElementType Temp; H = Create(MaxSize); if (Size > H->MaxSize){ printf ("堆储存空间不足\n" ); return NULL ; } for (i = 0 ; i <Size; i++){ H->Elenment[i + 1 ] = Element[i]; } H->Size = Size; for (parent = H->Size/2 ; parent >= 1 ; parent--){ Temp = H->Elenment[parent]; for (; parent * 2 <= H->Size; parent = child){ child = parent * 2 ; if (child != H->Size && (H->Elenment[child] > H->Elenment[child + 1 ])){ child ++; } if (Temp > H->Elenment[child]){ H->Elenment[parent] = H->Elenment[child]; } else break ; } H->Elenment[parent] = Temp; } return H; }
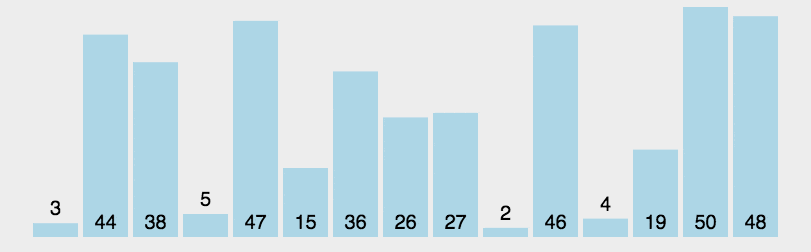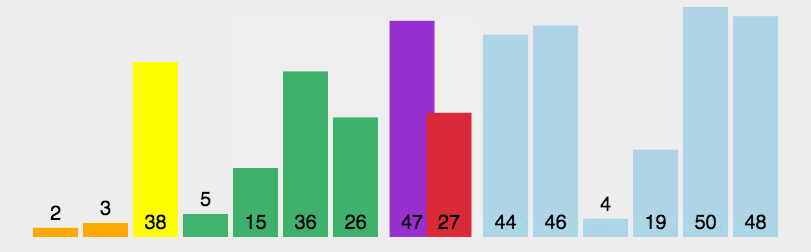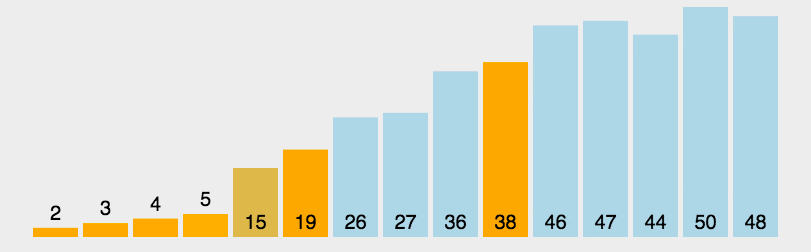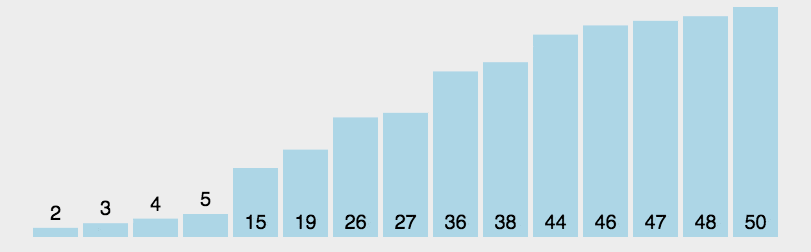
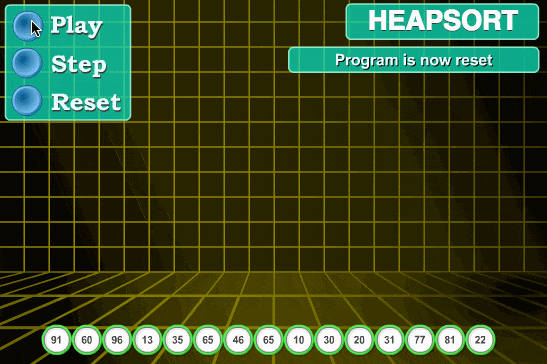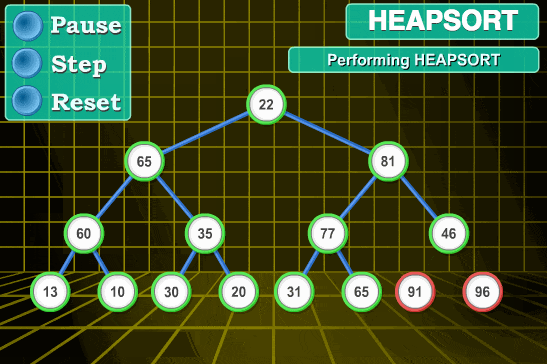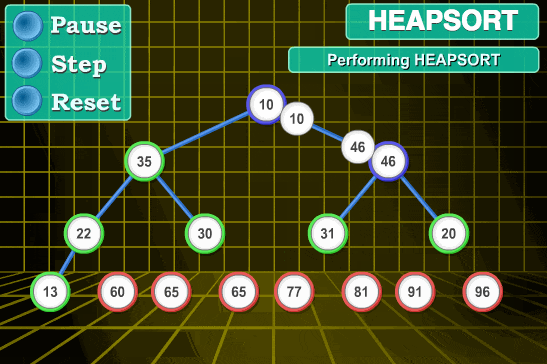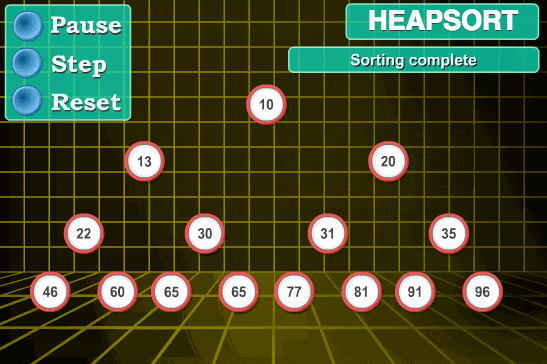
堆排序 Heapsort是利用堆所设计的一种排序算法。堆积是一个近似完全二叉树的结构,并同时满足堆积的性质,即子结点的键值总小于(或大于)它的父结点。它有两种方法来排序:
大顶堆:每个结点的值都大于或等于其他子结点的值,在堆排序中可用于升序排序。(因为其中每一次排序都会先将堆顶的元素交换到后面)
小顶堆:每个结点的值都小于或等于其他子结点的值,在堆排序中可用于降序排序。
堆排序的平均时间复杂度是O(nlogn)
堆排序操作与实现
创建一个堆;
把堆首与堆尾互换;
把堆的尺寸缩小1,并调用heapify(堆化)将堆重新调整好;
重复步骤2、3,直到堆的尺寸为1。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 #include <stdio.h> #include <stdlib.h> void swap (int *a,int *b) { int temp = *b; *b = *a; *a = temp; } void max_heapify (int arr[],int start, int end) { int parent = start; int child = parent * 2 + 1 ; while (child <= end){ if (child + 1 <= end && arr[child] < arr[child + 1 ]) child ++; if (arr[parent] > arr[child]) return ; else { swap(&arr[parent],&arr[child]); parent = child; child = parent *2 + 1 ; } } } void heap_dort (int arr[],int len) { int i; for (i = len / 2 -1 ; i >= 0 ; --i) max_heapify(arr, i ,len - 1 ); for (i = len - 1 ; i > 0 ; --i){ swap(&arr[0 ],&arr[i]); max_heapify(arr, 0 , i - 1 ); } } int main () { int arr[] = { 3 , 5 , 3 , 0 , 8 , 6 , 1 , 5 , 8 , 6 , 2 , 4 , 9 , 4 }; int len = (int ) sizeof (arr) / sizeof (*arr); heap_sort(arr, len); int i; for (i = 0 ; i < len; i++) printf ("%d " , arr[i]); printf ("\n" ); return 0 ; }
215.数组中的第k个最大元素 给定整数数组 nums 和整数 k,请返回数组中第 k 个最大的元素。
示例 :
1 2 输入: [3,2,1,5,6,4] 和 k = 2 输出: 5
(可以自行构造最大堆或最小堆,加深对堆的认识)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution { public int findKthLargest (int [] nums, int k) { PriorityQueue<Integer> maxheap = new PriorityQueue <>(Collections.reverseOrder()); int n = nums.length; for (int num : nums) { maxheap.add(num); } for (int i = 0 ; i < k - 1 ; i++){ maxheap.poll(); } return maxheap.peek(); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 class Solution { public : int findKthLargest (vector<int >& nums, int k) { for (int i = 0 ; i < k; i++) { swim(nums, i); } for (int i = k; i < nums.size(); i++) { if (nums[i] > nums[0 ]) { swap(nums[0 ], nums[i]); sink(nums, 0 , k - 1 ); } } return nums[0 ]; } private : bool priorityThan (int v1, int v2) { return v1 < v2; } void swim (vector<int >& heap, int i) { while (i > 0 && priorityThan(heap[i], heap[(i - 1 ) / 2 ])) { swap(heap[i], heap[(i - 1 ) / 2 ]); i = (i - 1 ) / 2 ; } } void sink (vector<int >& heap, int i, int N) { while (2 * i + 1 <= N) { int j = 2 * i + 1 ; if (j + 1 <= N && priorityThan(heap[j + 1 ], heap[j])) { j++; } if (priorityThan(heap[i], heap[j])) { break ; } swap(heap[i], heap[j]); i = j; } } }
692.前k个高频单词 给一非空的单词列表,返回前 k 个出现次数最多的单词。
返回的答案应该按单词出现频率由高到低排序。如果不同的单词有相同出现频率,按字母顺序排序。
示例 :
1 2 3 4 输入: ["the", "day", "is", "sunny", "the", "the", "the", "sunny", "is", "is"], k = 4 输出: ["the", "is", "sunny", "day"] 解析: "the", "is", "sunny" 和 "day" 是出现次数最多的四个单词, 出现次数依次为 4, 3, 2 和 1 次。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 import java.util.*;class Solution { public List<String> topKFrequent (String[] words, int k) { Map<String, Integer> cnt = new HashMap <String, Integer>(); for (String word : words) { cnt.put(word, cnt.getOrDefault(word, 0 ) + 1 ); } PriorityQueue<Map.Entry<String, Integer>> pq = new PriorityQueue <Map.Entry<String, Integer>>(new Comparator <Map.Entry<String, Integer>>() { public int compare (Map.Entry<String, Integer> entry1, Map.Entry<String, Integer> entry2) { return entry1.getValue() == entry2.getValue() ? entry2.getKey().compareTo(entry1.getKey()) : entry1.getValue() - entry2.getValue(); } }); for (Map.Entry<String, Integer> entry : cnt.entrySet()) { pq.offer(entry); if (pq.size() > k) { pq.poll(); } } List<String> ret = new ArrayList <String>(); while (!pq.isEmpty()) { ret.add(pq.poll().getKey()); } Collections.reverse(ret); return ret; } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 import java.util.*;class Solution { public List<String> topKFrequent (String[] words, int k) { HashMap<String, Integer> hash = new HashMap <>(); for (String s : words) { hash.put(s, hash.getOrDefault(s, 0 ) + 1 ); } List<String> rec = new ArrayList <String>(); for (Map.Entry<String, Integer> entry : hash.entrySet()) { rec.add(entry.getKey()); } Collections.sort(rec, new Comparator <String>() { public int compare (String word1, String word2) { return hash.get(word1).equals(hash.get(word2)) ? word1.compareTo(word2) : hash.get(word2) - hash.get(word1); } }); return rec.subList(0 , k); } }
图 要素 G( V , E ):图由顶点集合V(G)和边集合E(G)构成;
端点:
无向图:一条边(i,j) ,它的顶点 i 和 j 叫端点 ,它们互为邻接点 ;
有向图:一条边< i , j > ,它的顶点 i 为 起始端点 (起点),j 为终止端点 (终点),它们互为邻接点;
度 :
以某点为端点的 边的数量 叫该顶点的度
入度:进入该点的边数;
出度:从该点出发的边数
完全图:
完全无向图:n( n - 1 ) / 2 条边
完全有向图:n( n - 1) 条边
当一个图接近完全图时,称为稠密图 ,反之,则为稀疏图 ;
路径:
路径长度:一条路径上经过的边的数目;
简单路径:除开始点和结束点可以相同,其它顶点均不同;
环/回路:一条路径上开始点和结束点为同一顶点;
连通: 指从 i 到 j 有路径,则 i 和 j 连通;
连通图:无向图中任意两点连通;
强连通图:有向图中任意两点连通;
连通分量:指无向图G中的极大连通子图;
强连通分量:指有向图G中的极大连通子图;
(强连通图的连通分量只有一个,非连通图有多个连通分量)(强连通图也一样)
权: 边上附加的一个数值,可以表示从一个顶点到另一个顶点的距离或代价;
1 2 3 4 5 6 7 8 9 问: 设有一个图G=(V,E),取V的子集V',E的子集E'。那么,(V',E)一定是G的子图吗? 答: 如果对顶点的子集和边的子集不加限定的话,(V',E')不一定构成一个图。 假如边集对应的顶点包含在所取的顶点集中,则(V',E')构成G的子图 如果所取的顶点集不能包含s取的边集所对应的所有顶点,则(V',E')不构成G的子图。
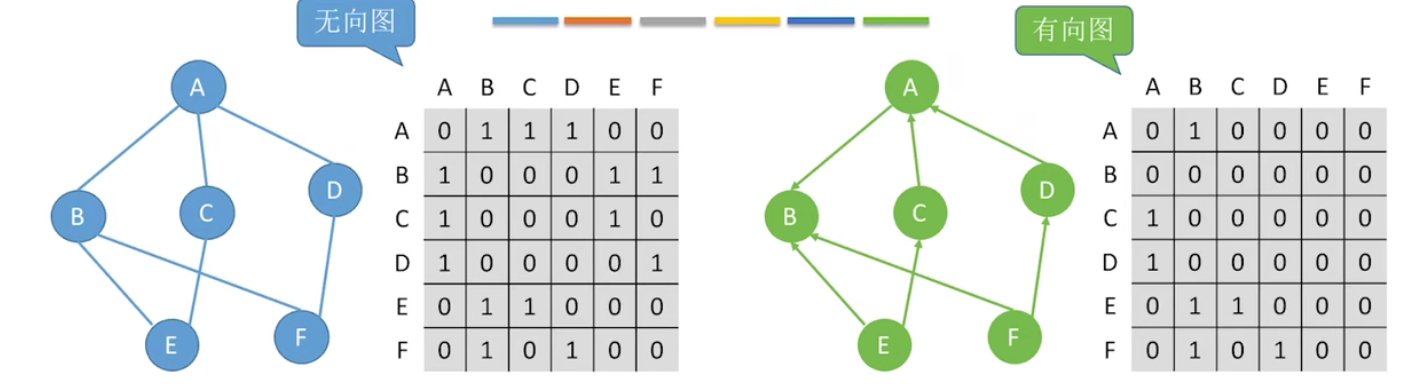
邻接矩阵 存储类型:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 #define MAXV <最大顶点个数> typedef struct{ int no; InfoType info; }VertexType; typedef struct{ int edges[MAXV][MAXV]; int n, e; VertexType vexs[MAXV]; }
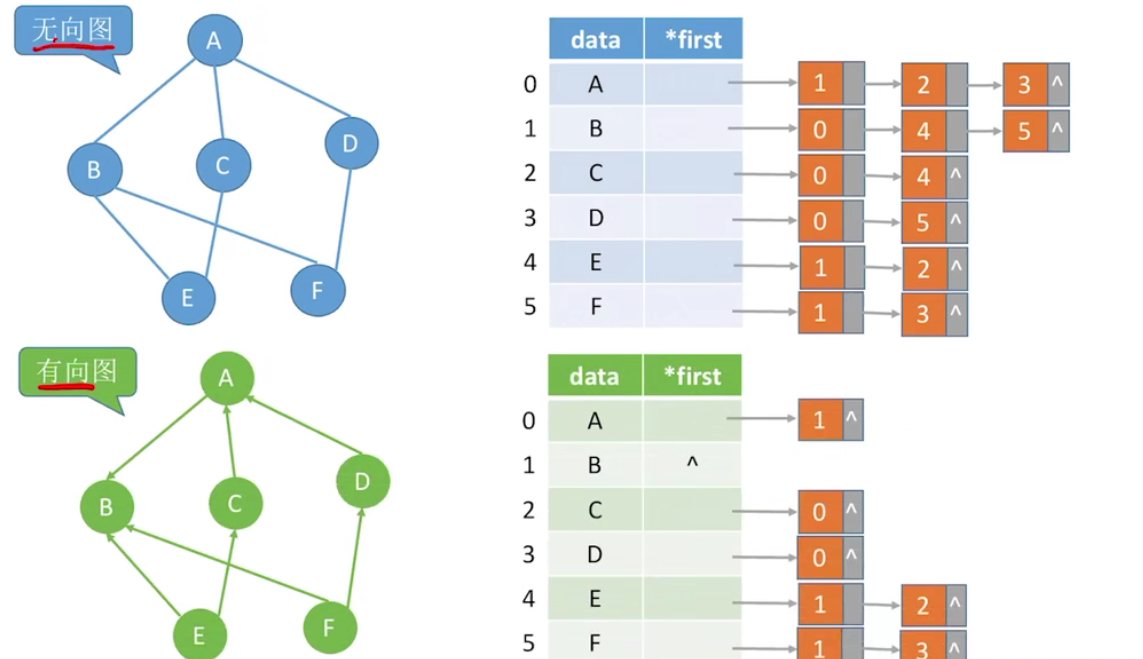
邻接表 存储类型:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 typedef struct ANode{ int adjvex; struct ANode *next; InfoType info; }ArcNode; typedef struct Vnode{ vertex data; ArcNode *firstArc; }VNode; typedef struct{ VNode adjList[MAXV]; int n, e; }AdjGraph;
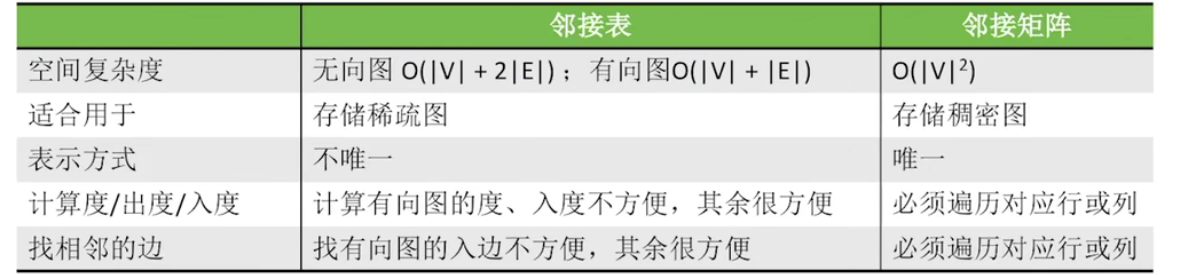
邻接矩阵 和 邻接表 对比:
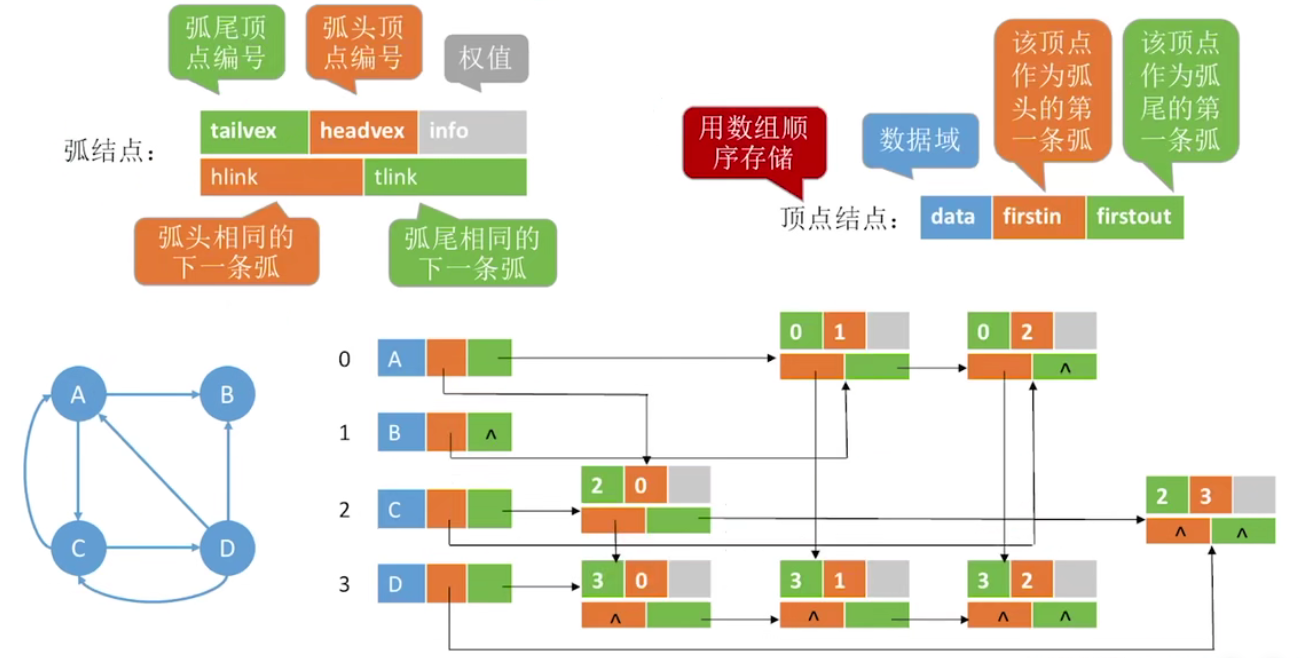
十字链表(有向图)
找顶点出边: 顺着绿色线找
找顶点入边:顺着橙色线找
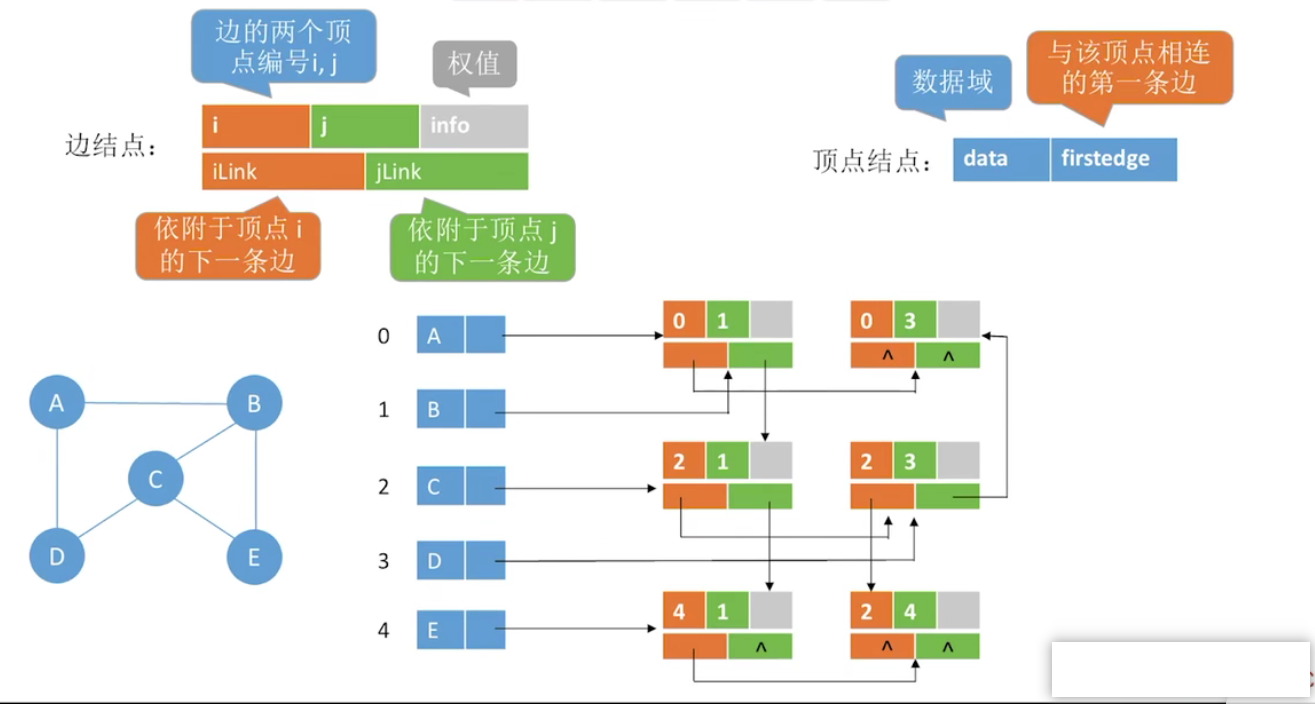
邻接多重表(无向图)
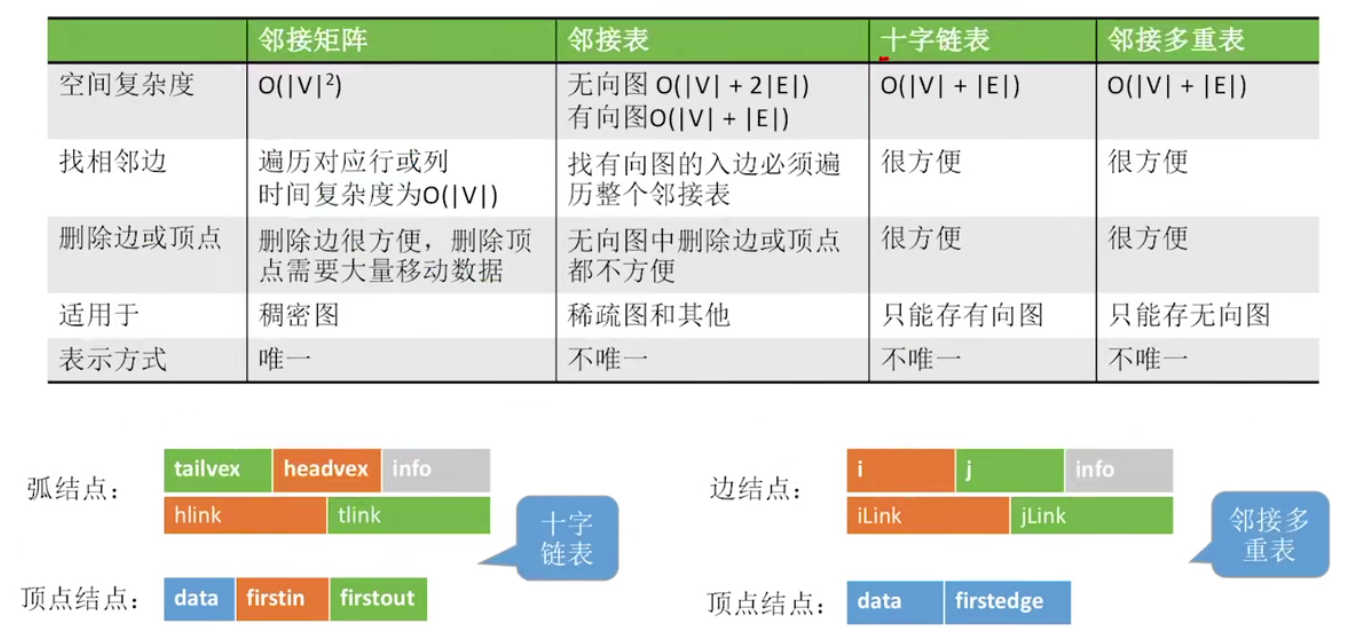
四种存储方式 对比
一些基本操作 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 void createAdj (AdjGraph *G, int a[MAXV][MAXV], int n, int e) { int i, j; ArcNode *p; G = (AdjGraph *) malloc(sizeof(AdjGraph)); for (i = 0 ; i < n; ++i) { G->adjList[i].firstArc = NULL; } for (i = 0 ; i < n; ++i) { for (j = n - 1 ; j >= 0 ; --j) { if (a[i][j] != 0 && a[i][j] != INF) { p = (ArcNode *) malloc(sizeof(ArcNode)); p->adjvex = j; p->weight = a[i][j]; p->next = G->adjList[i].firstArc; G->adjList[i].firstArc = p; } } } G->n = n; G->e = n; } void displayAdj (AdjGraph *G) { int i; ArcNode *p; for (i = 0 ; i < G->n; ++i) { p = G->adjList[i].firstArc; printf("%d:" , i); while (p != NULL) { printf("%d[%d]->" , p->adjvex, p->weight); p = p->next; } printf("^\n" ); } } void destory (AdjGraph *G) { int i; ArcNode *pre, *p; for (i = 0 ; i < G->n; ++i) { pre = G->adjList[i].firstArc; if (pre != NULL) { p = pre->next; while (p != NULL) { free(pre); pre = p; p = p->next; } free(pre); } } free(G); } void MatToList (MatGraph g, AdjGraph *G) { int i, j; ArcNode *p; G = (AdjGraph *) malloc(sizeof(AdjGraph)); for (i = 0 ; i < g.n; ++i) { G->adjList[i].firstArc = NULL; } for (i = 0 ; i < g.n; i++) { for (j = 0 ; j >= 0 ; ++j) { if (g.edges[i][j] != 0 && g.edges[i][j] != INF) { p = (ArcNode *) malloc(sizeof(ArcNode)); p->adjvex = j; p->weight = g.edges[i][j]; p->next = G->adjList[i].firstArc; G->adjList[i].firstArc = p; } } } G->n = g.n; G->e = g.e; } void ListToMat (AdjGraph *G, MatGraph g) { int i; ArcNode *p; for (i = 0 ; i < G->n; i++) { p = G->adjList[i].firstArc; while (p != NULL) { g.edges[i][p->adjvex] = p->weight; p = p->next; } g.n = G->n; g.e = G->e; } } int visited[MAXV] = {0 };void DFS (AdjGraph *G, int v) { ArcNode *p; int w; for (int i = 0 ; i < MAXV; i++) { visited[i] = 0 ; } visited[v] = 1 ; printf("%d " , v); p = G->adjList[v].firstArc; while (p != NULL) { w = p->adjvex; if (visited[w] == 0 ) DFS(G, w); p = p->next; } } void BFS (AdjGraph *G, int v) { int w, i; ArcNode *p; SqQueue *qu; IntiQueue(qu); int visit[MAXV]; for (i = 0 ; i < G->n; i++) { visit[i] = 0 ; } printf("%2d" , v); visit[v] = 1 ; EnQueue(qu, v); while (!QueueEmpty(qu)){ DeQuenu(qu, w); p = G->adjList[w].firstArc; while (p != NULL) { if (visit[p->adjvex] == 0 ){ printf("%2d" , p->adjvex); visit[p->adjvex] = 1 ; EnQueue(qu, p->adjvex); } p = p->next; } } printf("\n" ); }
生成树 一个连通图的生成树 是一个极小连通子图 ,它含有图中全部n个顶点 和构成一棵树的(n - 1 )条边。
遍历方法得到生成树:深度优先生成树,广度~~树
(所以一个连通图的生成树不一定唯一)
最小生成树
对 带权连通图G (权 均为大于0的实数),其权值之和最小的生成树 即 图的最小生成树。
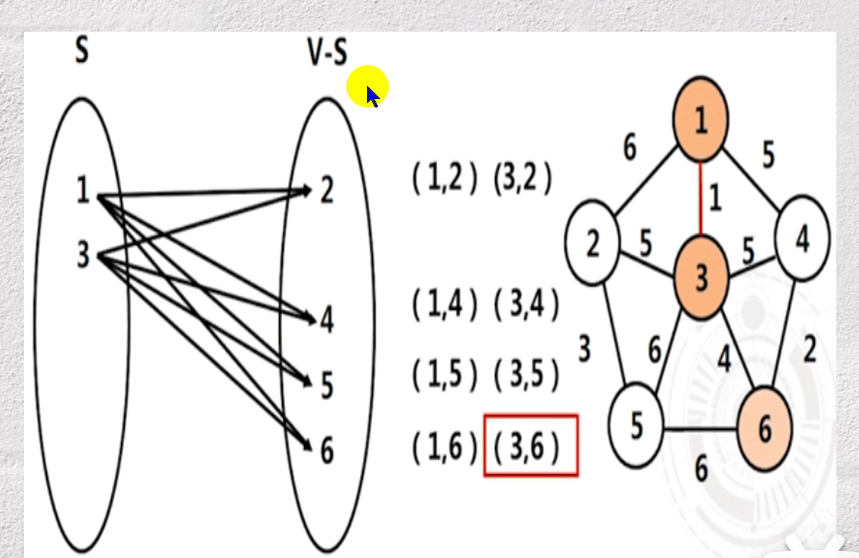
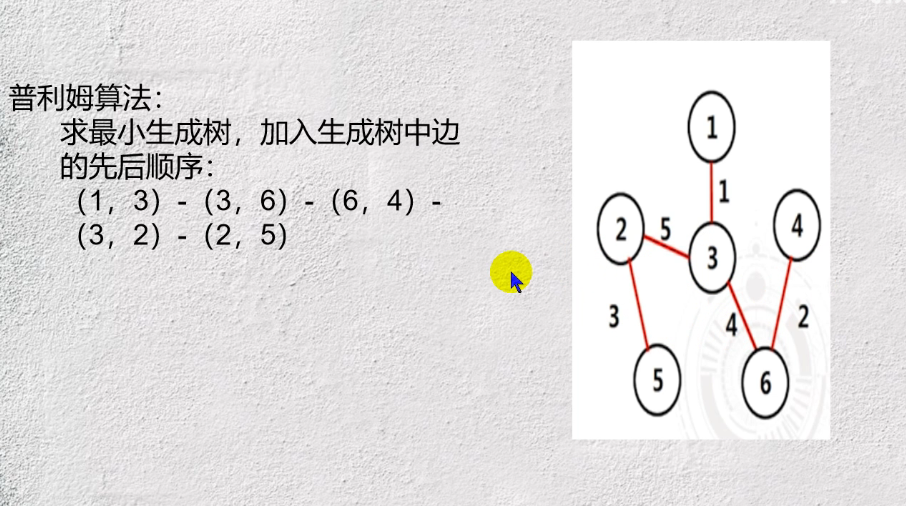
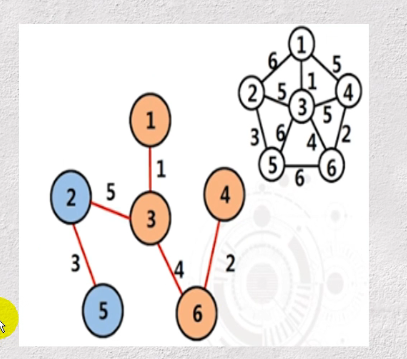
普里姆(prim)算法 (从顶点 考虑)
选择初始点 把图中的顶点分成两个不同的顶点集S(生成树的顶点集),V-S
在横跨两个不同顶点集的边中选择一条权值最小的边加入到生成树中
将该边的另一个顶点加入到顶点集S中,并从V-S中删除
重复步骤2,3,知道V-S为空集
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 void prim (MatGraph g, int v) { int lowcost[MAXV]; int min; int closest[MAXV], i, j, k; for (i = 0 ; i < g.n; ++i) { lowcost[i] = g.edges[v][i]; closest[i] = v; } for (i = 1 ; i < g.n; i++) { min = INF; for (j = 0 ; j < g.n; j++) if (lowcost[j] != 0 && lowcost[j] < min) { min = lowcost[j]; k = j; } printf ("边(%d, %d)权为:%d\n" , closest[k], k, min); lowcost[k] = 0 ; for (j = 0 ; j < g.n; j++) if (lowcost[j] != 0 && g.edges[k][j] < lowcost[j]){ lowcost[j] = g.edges[k][j]; closest[j] = k; } } }
克鲁斯卡尔(kruskal)算法 (从边 考虑)
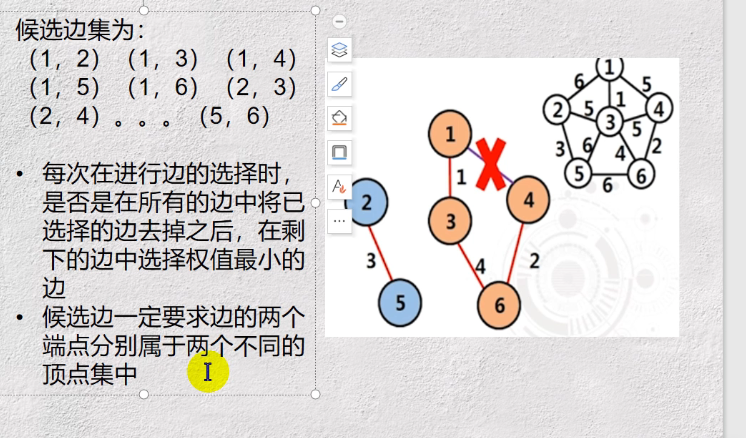
把图中的顶点看成n个不同的顶点集,每个顶点集都只含1个顶点
每次都在横跨不同顶点集的边 中选择一条权值最小的边加入到最小生成树中
直到图中所有的顶点都在同一个顶点集为止
思路:连通图的边按照权值从小到大进行排列;依次检查它的每条边对应的两个端点是否分别属于两个不同的顶点集,是,则加入生成树中。
最短路径
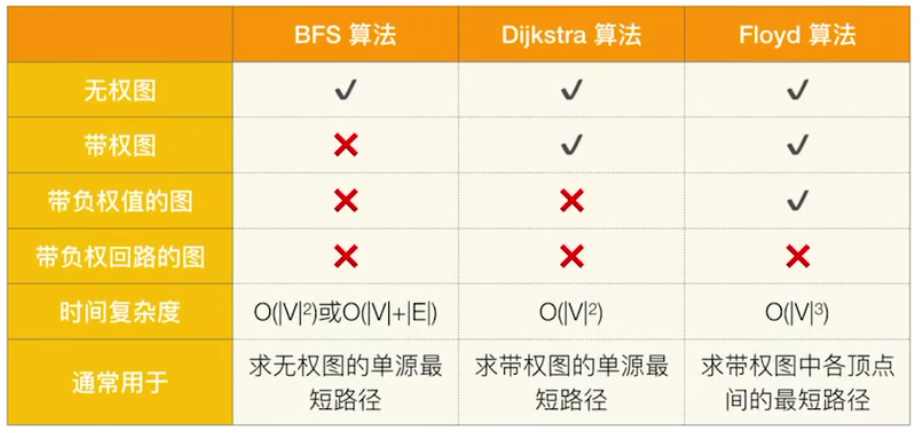
狄克斯特拉(Dijkstra)算法 只适用 有向无环图,图中存在负权重、环 时,无法使用狄克斯特拉算法
过程如下:
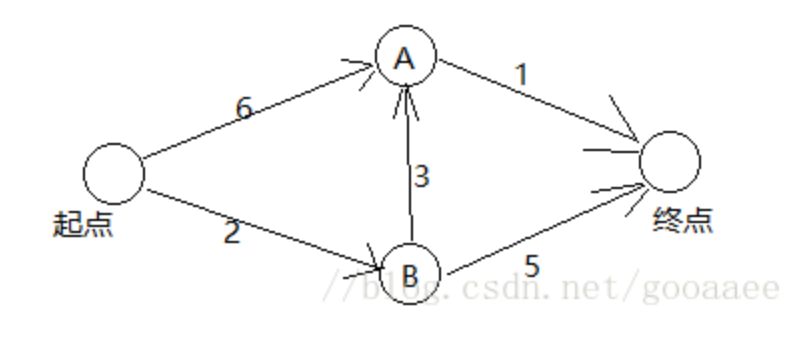
从起点开始,起点到其所有邻居的距离2和6是初始值,其他不相邻的节点的距离为无穷大,
然后从{2,6,无穷大}中找到最小值2,2对应的节点是B,然后从B开始遍历B的所有邻居{A,终点},计算起点->B->A的距离为2+3=5,比之前的距离6要小,所以更新A的记录为5,继续计算起点->B->终点的距离为2+5=7,比之前的距离无穷大要小,所以更新终点的记录为7,至此B的所有相邻节点遍历完毕,故划去B,
之后继续从{2,5,7}中寻找最小值,由于2对应的B节点已经被划去,所以只要从{5,7}中找最小值,最小值为5,5对应于节点A,然后从A开始遍历A的所有邻居{终点},计算起点->A->终点的距离6,比之前的距离7要小,故更新终点的记录为6,至此A的所有邻居遍历完毕,故划去A,
最后只剩下终点这个节点,由于终点没有邻居,故图中的所有邻居遍历完毕。至此得出从起点到终点的最短距离是6。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 void Dijkstra (MatGraph g, int v) { int dist[MAXV], path[MAXV]; int s[MAXV]; int mindis, u; for (int i = 0 ; i < g.n; i++) { dist[i] = g.edges[v][i]; s[i] = 0 ; if (g.edges[v][i] < INF) path[i] = v; else path[i] = -1 ; } s[v] = 1 ; for (int i = 0 ; i < g.n; i++) { mindis = INF; for (int j = 0 ; j < g.n; j++) if (s[j] == 0 && dist[j] < mindis) { u = j; mindis = dist[j]; } s[u] = 1 ; for (int j = 0 ; j < g.n; j++) if (s[j] == 0 ) if (g.edges[u][j] < INF && dist[u] + g.edges[u][j] < dist[j]) { dist[j] = dist[u] + g.edges[u][j]; path[j] = u; } } Dispath(dist, path, s, g.n, v); }
弗洛伊德(Floyd)算法 基本思想:
矩阵D记录顶点间的最小路径
矩阵P记录顶点间最小路径中的中转点
它通过3重循环,k为中转点,v为起点,w为终点,循环比较D[v] [w] 和 D[v] [k] + D[k] [w] 最小值,如果D[v] [k] + D[k] [w] 为更小值,则把D[v] [k] + D[k] [w] 覆盖保存在D[v] [w]中。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 int pathmatirx[MAXV][MAXV];int shortPath[MAXV][MAXV];void short_path_floyd (MatGraph G, int P[MAXV][MAXV], int D[MAXV][MAXV]) { int v, w, k; for (v = 0 ; v < G.n; v++) { for (w = 0 ; w < G.n; w++) { D[v][w] = G.edges[v][w]; P[v][w] = w; } } for (k = 0 ; k < G.n; k++) { for (v = 0 ; v < G.n; v++) { for (w = 0 ; w < G.n; w++) { if (D[v][w] > (D[v][k] + D[k][w])) { D[v][w] = D[v][k] + D[k][w]; P[v][w] = P[v][k]; } } } } printf ("\n初始化的D矩阵\n" ); for (v = 0 ; v < G.n; v++) { for (w = 0 ; w < G.n; w++) { printf ("%d " , D[v][w]); } printf ("\n" ); } printf ("\n初始化的P矩阵\n" ); for (v = 0 ; v < G.n; v++) { for (w = 0 ; w < G.n; w++) { printf ("%d" , P[v][w]); } printf ("\n" ); } v = 0 ; w = 3 ; printf ("\n%d -> %d 的最小路径为:%d\n" , v, w, D[v][w]); k = P[v][w]; printf ("path: %d" , v); while (k != w) { printf ("-> %d" , k); k = P[k][w]; } printf ("-> %d\n" , w); }
拓扑排序 AOV网(Activity On Vertex NetWork):用顶点表示活动的网。每个AOV网都有一个或多个拓扑排序序列。
AOV网有且仅有一个入度为0的开始点,出度为0的结束点。
拓扑排序:在有向无环图中,找出做事的先后顺序。
规则 :
图中每个顶点只出现一次。
A在B前面,则不存在B在A前面的路径。(不能成环!!!!)
顶点的顺序是保证所有指向它的下个节点在被指节点前面 !(例如A—>B—>C那么A一定在B前面,B一定在C前面)。所以,这个核心规则下只要满足即可,所以拓扑排序序列不一定唯一 !
使用拓扑排序时,一般是稀疏图,所以用邻接表,
代码思想为:
新建node类,包含节点数值和它的指向;
一个数组包含node(这里默认编号较集中)。初始化,添加每个节点指向的时候同时被指的节点入度+1!(A—>C)那么C的入度+1;入度为0的点 加入一个栈(队列)。
当栈(队列)不空的时候,抛出其中任意一个node (栈就是尾,队就是头,顺序无所谓,上面分析了只要同时入度为零可以随便选择顺序)。将node输出,并且node指向的所有元素入度减一 。如果某个点的入度被减为0,那么就将它加入栈 (队列)。
重复上述操作,直到栈为空。
210.课程表 现在你总共有 numCourses 门课需要选,记为 0 到 numCourses - 1。给你一个数组 prerequisites ,其中 prerequisites[i] = [ai, bi] ,表示在选修课程 ai 前 必须 先选修 bi 。
1 例如,想要学习课程 0 ,你需要先完成课程 1 ,我们用一个匹配来表示:[0 ,1 ]。
返回你为了学完所有课程所安排的学习顺序。可能会有多个正确的顺序,你只要返回 任意一种 就可以了。如果不可能完成所有课程,返回 一个空数组。
题解:
本题是一道经典的「拓扑排序」问题。
求出该图的拓扑排序,就可以得到一种符合要求的课程学习顺序。
方法一,深度优先搜索
对于一个节点 u,如果它的所有相邻节点都已经搜索完成,那么在搜索回溯到 u 的时候,u本身也会变成一个已经搜索完成的节点。这里的「相邻节点」指的是从 u 出发通过一条有向边可以到达的所有节点。
对于图中的任意一个节点,它在搜索的过程中有三种状态,即:
通过上述的三种状态,我们就可以给出使用深度优先搜索得到拓扑排序的算法流程,在每一轮的搜索搜索开始时,我们任取一个「未搜索」的节点开始进行深度优先搜索。
我们将当前搜索的节点 u 标记为「搜索中」,遍历该节点的每一个相邻节点 v:
如果 v 为「未搜索」,那么我们开始搜索 v,待搜索完成回溯到 u;
如果 v 为「搜索中」,那么我们就找到了图中的一个环,因此是不存在拓扑排序的;
如果 v 为「已完成」,那么说明 v 已经在栈中了,而 u 还不在栈中,因此 u 无论何时入栈都不会影响到 (u, v)(u,v) 之前的拓扑关系,所以不用进行任何操作。
当 u 的所有相邻节点都为「已完成」时,我们将 u 放入栈中,并将其标记为「已完成」。
在整个深度优先搜索的过程结束后,如果我们没有找到图中的环,那么栈中存储这所有的 n 个节点,从栈顶到栈底的顺序即为一种拓扑排序。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 class Solution { List<List<Integer>> edges; int [] visited; int [] result; boolean valid = true ; int index; public int [] findOrder(int numCourses, int [][] prerequisites) { edges = new ArrayList <List<Integer>>(); for (int i = 0 ; i < numCourses; ++i) { edges.add(new ArrayList <Integer>()); } visited = new int [numCourses]; result = new int [numCourses]; index = numCourses - 1 ; for (int [] info : prerequisites) { edges.get(info[1 ]).add(info[0 ]); } for (int i = 0 ; i < numCourses && valid; ++i) { if (visited[i] == 0 ) { dfs(i); } } if (!valid) { return new int [0 ]; } return result; } public void dfs (int u) { visited[u] = 1 ; for (int v: edges.get(u)) { if (visited[v] == 0 ) { dfs(v); if (!valid) { return ; } } else if (visited[v] == 1 ) { valid = false ; return ; } } visited[u] = 2 ; result[index--] = u; } }
复杂度分析
时间复杂度: **O(n+m)**,其中 n 为课程数,m 为先修课程的要求数。这其实就是对图进行深度优先搜索的时间复杂度。
空间复杂度: **O(n+m)**。题目中是以列表形式给出的先修课程关系,为了对图进行深度优先搜索,我们需要存储成邻接表的形式,空间复杂度为 O(n+m)。在深度优先搜索的过程中,我们需要最多 O(n) 的栈空间(递归)进行深度优先搜索,并且还需要若干个 O(n)的空间存储节点状态、最终答案等。
方法二:广度优先搜索
我们使用一个队列来进行广度优先搜索。开始时,所有入度为 0 的节点都被放入队列中,它们就是可以作为拓扑排序最前面的节点,并且它们之间的相对顺序是无关紧要的。
在广度优先搜索的每一步中,我们取出队首的节点 u:
我们将 u 放入答案中;
我们移除 u 的所有出边,也就是将 u 的所有相邻节点的入度减少 1。如果某个相邻节点 v 的入度变为 0,那么我们就将 v 放入队列中。
在广度优先搜索的过程结束后。如果答案中包含了这 n 个节点,那么我们就找到了一种拓扑排序,否则说明图中存在环,也就不存在拓扑排序了。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 class Solution { List<List<Integer>> edges; int [] indeg; int [] result; int index; public int [] findOrder(int numCourses, int [][] prerequisites) { edges = new ArrayList <List<Integer>>(); for (int i = 0 ; i < numCourses; ++i) { edges.add(new ArrayList <Integer>()); } indeg = new int [numCourses]; result = new int [numCourses]; index = 0 ; for (int [] info : prerequisites) { edges.get(info[1 ]).add(info[0 ]); ++indeg[info[0 ]]; } Queue<Integer> queue = new LinkedList <Integer>(); for (int i = 0 ; i < numCourses; ++i) { if (indeg[i] == 0 ) { queue.offer(i); } } while (!queue.isEmpty()) { int u = queue.poll(); result[index++] = u; for (int v: edges.get(u)) { --indeg[v]; if (indeg[v] == 0 ) { queue.offer(v); } } } if (index != numCourses) { return new int [0 ]; } return result; } }
内排序
希尔排序 也称为缩小增量(递减增量)算法,是插入排序的改进 。
希尔排序需要一个增量序列(增量会递减),一般用len/2,如:len为11,则增量分别为5,2,1,进行三次循环。
每次循环排序只排 间隔 为增量值的数,
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 public class ShellSort { public void shellSort (int [] nums) { int len = nums.length; for (int i = len / 2 ; i > 0 ; i /= 2 ) { for (int j = i; j < len; j++) { int k; int temp = nums[j]; for (k = j; k >= i && temp < nums[k - i]; k -= i) { nums[k] = nums[k - i]; } nums[k] = temp; } } } public static void main (String[] args) { int [] nums = new int []{7 , 6 , 9 , 3 , 1 , 5 , 2 , 4 }; new ShellSort ().shellSort(nums); System.out.println(Arrays.toString(nums)); } }
归并排序 将数据不断分半,直到只剩下一个元素,然后从以分半的两段数据,逐个选出最小的元素移入临时数组的末尾。(归并排序需要用到临时数组)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 void merge (int arr[], int tempArr[],int left, int mid, int right) { int l_pos = left; int r_pos = mid + 1 ; int pos = left; while (l_pos <= mid &&r_pos <= right){ if (arr[l_pos] < arr[r_pos]) tempArr[pos++] = arr[l_pos++]; else tempArr[pos++] = arr[r_pos++]; } while (l_pos <= mid){ tempArr[pos++] = arr[l_pos++]; } while (r_pos <= right){ tempArr[pos++] = arr[r_pos++]; } while (left <= right){ arr[left] = tempArr[left]; left++; } } void msort (int arr[], int tempArr, int left, int right) { if (left < right){ int mid = (left + right) / 2 ; msort(arr,tempArr, left, mid); msort(arr, tempArr, mid + 1 , right); merge(arr, tempArr, left, mid , right); } } void merge_sort (int arr[], int n) { int *tempArr = (int *)malloc (n * sizeof (int )); if (tempArr){ msort(arr, tempArr, 0 , n - 1 ); free (tempArr); } else { printf ("error: failed to allocate memory" ); } }
快速排序 在区间中挑选一个元素作基准,将小于基准的元素放在基准之前,大于基准的元素放在基准之后,再分别对小数区与大数区进行同样操作。直到各个分区只有一个数时为止。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 void quicksort (int *s, int start, int end) { if (start < end) { int i = start, j = end, x = s[start]; while (i < j) { while (i < j && s[j] >= x) { j--; } if (i < j) { s[i++] = s[j]; } while (i < j && s[i] < x) { i++; } if (i < j) { s[j--] = s[i]; } } s[i] = x; quicksort(s, start, i - 1 ); quicksort(s, i + 1 , end); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 void quick_sort_recursive (int arr[], int start, int end) { if (start >= end) return ; int mid = arr[end]; int i = start, j = end - 1 ; while (i < j) { while (arr[i] < mid && i < j) i++; while (arr[j] >= mid && i < j) j--; swap(&arr[i], &arr[j]); } if (arr[i] >= arr[end]) swap(&arr[i], &arr[end]); else i++; if (i) quick_sort_recursive(arr, start, i - 1 ); quick_sort_recursive(arr, i + 1 , end); } void quick_sort (int arr[], int len) { quick_sort_recursive(arr, 0 , len - 1 ); }
堆排序 (堆积是一个近似完全二叉树的结构,并同时满足堆积的性质)
堆排序可以说是一种利用堆的概念来排序的选择排序。分为两种方法:
算法步骤:
创建一个堆
把堆首(最大值)和堆尾互换;
把堆的尺寸减少1,并调用上浮/下沉操作,把新的最大值调整到堆首;
重复步骤2,3,直到堆的尺寸为1;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 class HeapSort { public int [] sort(int [] arr){ int len = arr.length; buildMaxHeap(arr, len); for (int i = len - 1 ; i > 0 ; i--) { swap(arr, 0 , i); len--; heapify(arr, 0 , len); } return arr; } private void buildMaxHeap (int [] arr, int len) { for (int i = (int ) Math.floor(len / 2 ); i >= 0 ; i--) { heapify(arr, i, len); } } private void heapify (int [] arr, int i, int len) { int left = 2 * i + 1 ; int right = 2 * i + 2 ; int largest = i; if (left < len && arr[left] > arr[largest]) { largest = left; } if (right < len && arr[right] > arr[largest]) { largest = right; } if (largest != i) { swap(arr, i, largest); heapify(arr, largest, len); } } private void swap (int [] arr, int i, int j) { int temp = arr[i]; arr[i] = arr[j]; arr[j] = temp; } }
计数排序 计数排序的核心在于将输入的数据值转化为键存储在额外开辟的数组空间中。
作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数。
当输入的元素是 n 个 0 到 k 之间的整数时,它的运行时间是 Θ(n + k)。
由于用来计数的数组C的长度取决于待排序数组中数据的范围 (等于待排序数组的最大值与最小值的差加上1),这使得计数排序对于数据范围很大的数组,需要大量时间和内存。例如:计数排序是用来排序0到100之间的数字的最好的算法,但是它不适合按字母顺序排序人名。但是,计数排序可以用在基数排序中的算法来排序数据范围很大的数组。
算法的步骤如下:
找出待排序的数组中最大和最小的元素
统计数组中每个值为i的元素出现的次数,存入数组C的第i项
反向填充目标数组:将每个元素 i 放在新数组的第C(i)项,每放一个元素就将C(i)减去1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class CountingSort { public int [] sort(int [] arr){ int maxValue = getMaxValue(arr); return countingSort(arr, maxValue); } private int [] countingSort(int [] arr, int maxValue) { int bucketLen = maxValue + 1 ; int [] bucket = new int [bucketLen]; for (int value : arr) { bucket[value]++; } int sortedIndex = 0 ; for (int j = 0 ; j < bucketLen; j++) { while (bucket[j] > 0 ) { arr[sortedIndex++] = j; bucket[j]--; } } return arr; } private int getMaxValue (int [] arr) { int maxValue = arr[0 ]; for (int value : arr) { if (maxValue < value) { maxValue = value; } } return maxValue; } }
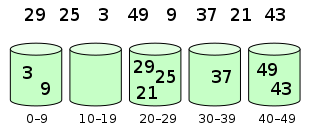
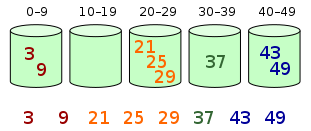
桶排序 排序是计数排序的升级版。它利用了函数的映射关系,高效与否的关键就在于这个映射函数的确定。为了使桶排序更加高效,我们需要做到这两点:
在额外空间充足的情况下,尽量增大桶的数量
使用的映射函数能够将输入的 N 个数据均匀的分配到 K 个桶中
同时,对于桶中元素的排序,选择何种比较排序算法对于性能的影响至关重要。
最快的情况:当输入的数据可以均匀的分配到每一个桶中。
最慢的情况:当输入的数据被分配到了同一个桶中。
示例:
元素分布在桶中:
然后,元素在每个桶中排序:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 public class BucketSort { public int [] sort(int [] arr) { return bucketSort(arr, 5 ); } private int [] bucketSort(int [] arr, int bucketSize){ if (arr.length == 0 ) { return arr; } int minValue = arr[0 ]; int maxValue = arr[0 ]; for (int value : arr) { if (value < minValue) { minValue = value; } else if (value > maxValue) { maxValue = value; } } int bucketCount = (int ) Math.floor((maxValue - minValue) / bucketSize) + 1 ; int [][] buckets = new int [bucketCount][0 ]; for (int i = 0 ; i < arr.length; i++) { int index = (int ) Math.floor((arr[i] - minValue) / bucketSize); buckets[index] = arrAppend(buckets[index], arr[i]); } int arrIndex = 0 ; for (int [] bucket : buckets) { if (bucket.length <= 0 ) { continue ; } bucket = XxxSort.sort(bucket); for (int value : bucket) { arr[arrIndex++] = value; } } return arr; } private int [] arrAppend(int [] arr, int value) { arr = Arrays.copyOf(arr, arr.length + 1 ); arr[arr.length - 1 ] = value; return arr; } }
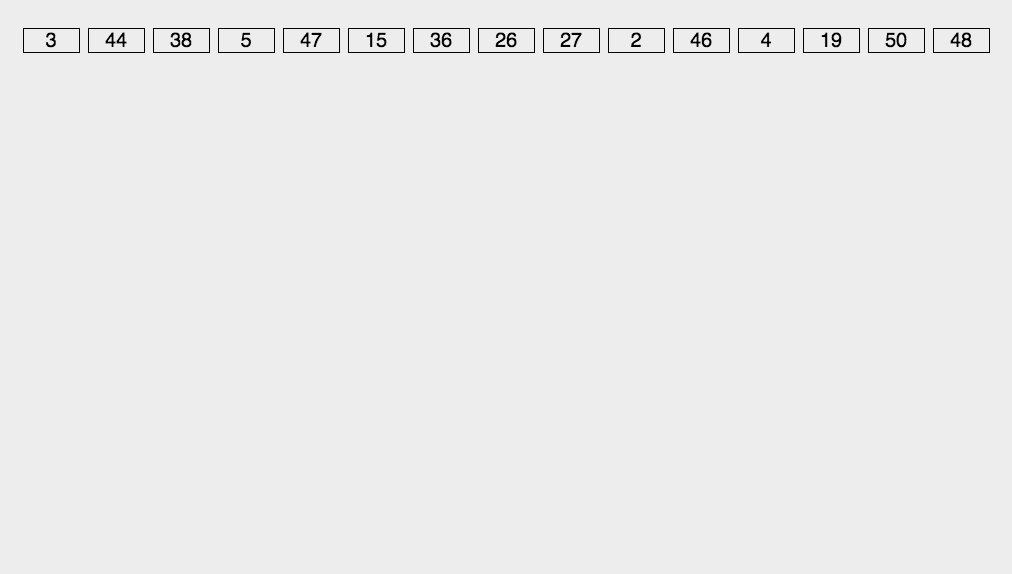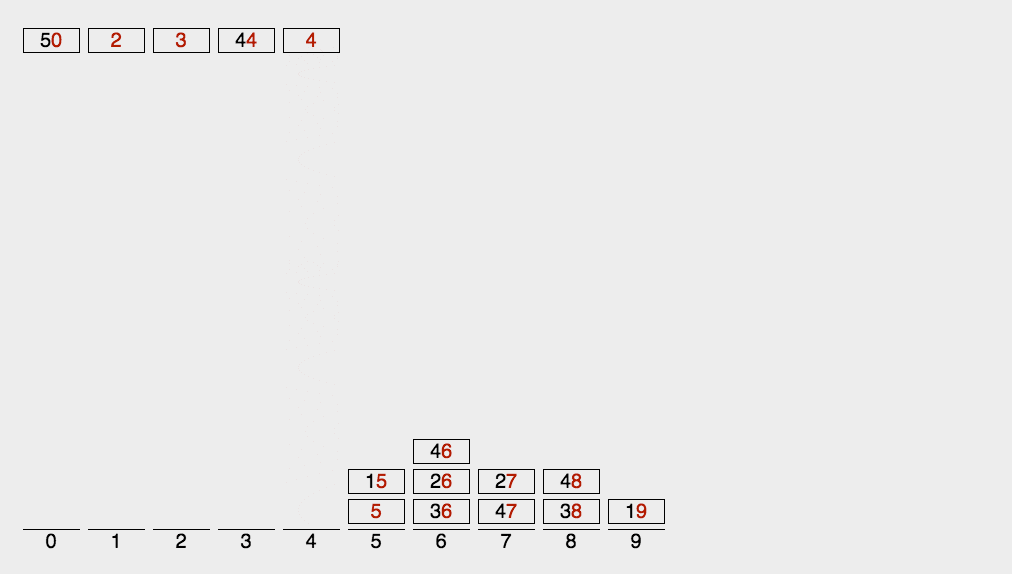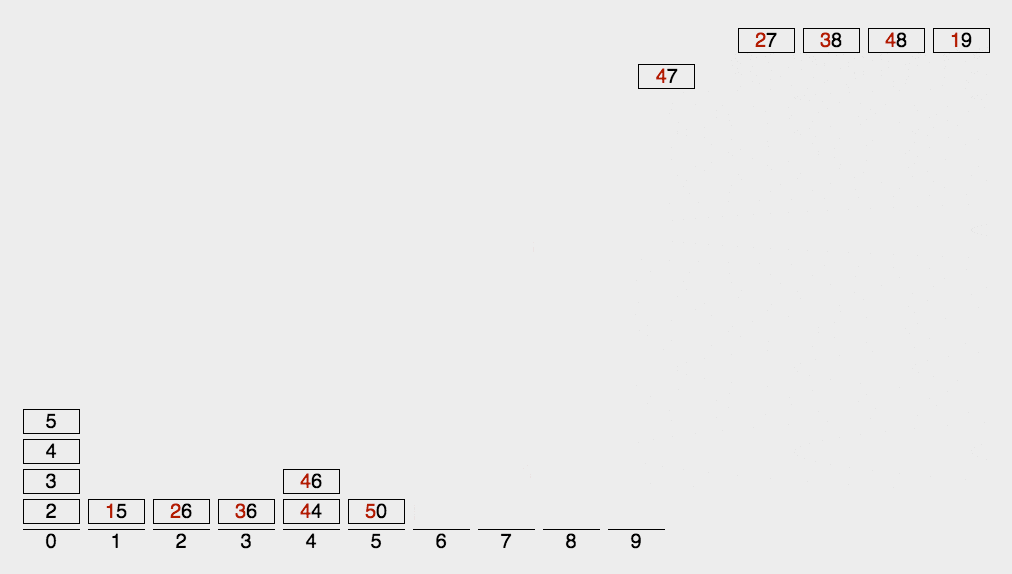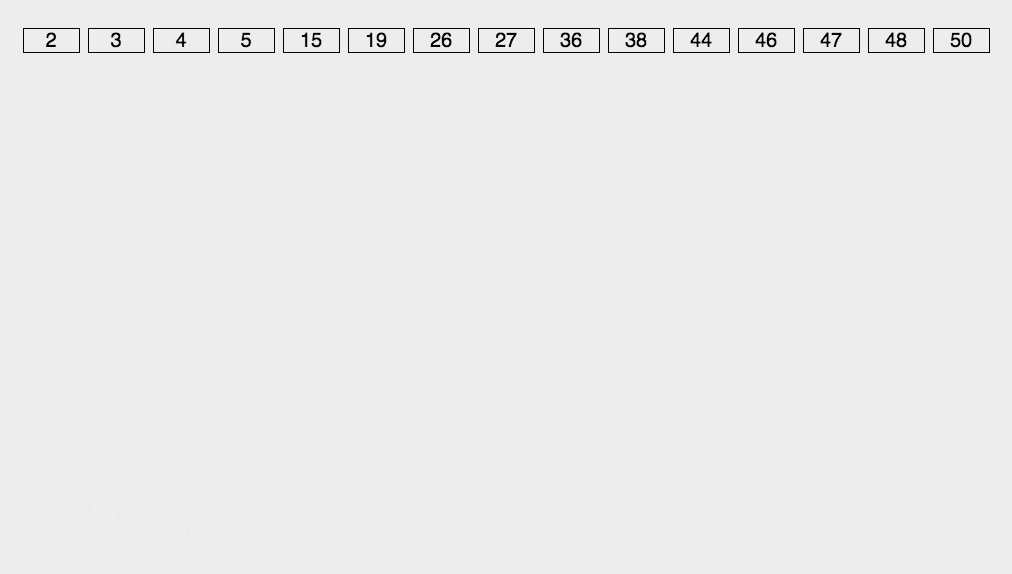
基数排序 基数排序是一种非比较型整数排序算法,其原理是将整数按位数切割成不同的数字,然后按每个位数分别比较 。由于整数也可以表达字符串(比如名字或日期)和特定格式的浮点数,所以基数排序也不是只能使用于整数。
下面三种排序算法都利用了桶的概念,但对桶的使用方法上有明显差异:
基数排序:根据键值的每位数字来分配桶;
计数排序:每个桶只存储单一键值;
桶排序:每个桶存储一定范围的数值;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 class RadixSort { public int [] sort(int [] arr) { int maxDigit = getMaxDigit(arr); return radixSort(arr, maxDigit); } private int getMaxDigit (int [] arr) { int maxValue = getMaxValue(arr); return getNumLenght(maxValue); } private int getMaxValue (int [] arr) { int maxValue = arr[0 ]; for (int value : arr) { if (maxValue < value) { maxValue = value; } } return maxValue; } protected int getNumLenght (long num) { if (num == 0 ) { return 1 ; } int lenght = 0 ; for (long temp = num; temp != 0 ; temp /= 10 ) { lenght++; } return lenght; } private int [] radixSort(int [] arr, int maxDigit) { int mod = 10 ; int dev = 1 ; for (int i = 0 ; i < maxDigit; i++, dev *= 10 , mod *= 10 ) { int [][] counter = new int [mod * 2 ][0 ]; for (int j = 0 ; j < arr.length; j++) { int bucket = (arr[j] % mod) / dev; if (arr[j] > 0 ) bucket += 10 ; else bucket = -bucket; counter[bucket] = arrayAppend(counter[bucket], arr[j]); } int pos = 0 ; for (int [] bucket : counter) { for (int value : bucket) { arr[pos++] = value; } } } return arr; } private int [] arrayAppend(int [] arr, int value) { arr = Arrays.copyOf(arr, arr.length + 1 ); arr[arr.length - 1 ] = value; return arr; } }
外排序 对磁盘中的数据进行排序。
归并排序 最少只需要在内存中开辟2个输入缓冲区和一个输出缓冲区,每次将磁盘的数据块 输入到输入缓冲区,然后按 归并排序的规则,从2个输入缓冲区 每次跳出最小的数 放到输出缓冲区,当有输入缓冲区为空了,应该立刻将和它排好序的下一个数据块放到输入缓冲区中。当输出缓冲区满时,写出外存。
减少时间开销:进行K路归并排序 ,需要在内存中分配k个输入缓冲区和一个输出缓冲区。
因为读写磁盘时间开销大,所以多几路可以提高效率,但也不能太多,因为需要在内存中开多个缓冲区,且每次比较都要比较这k个缓冲区的最小值
时间开销:读写外存时间+内部排序时间+内部归并时间
优化:
增加归并路数k
代价1:需要增加相应的输入缓冲区
代价2:每次从k个归并段总选一个最小值需要(k-1)次比较。——可用败者树减少关键字比较次数
减少初始归并段数量r
若有N个记录,内存工作区可放L个记录,则初始归并段数量 r = N / L ——可用 置换-选择排序 减少初始归并段
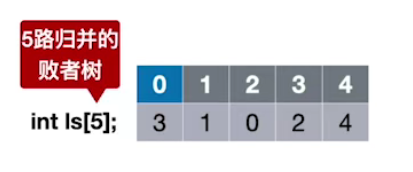
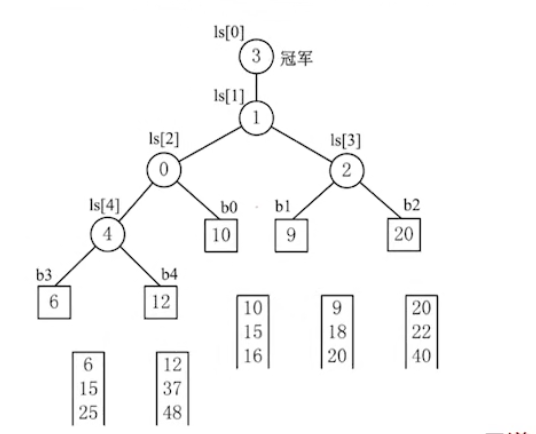
败者树 败者树解决的问题:使用多路平衡归并可減少归并趟数,但是用老土方法从k个归并段选出一个最小/最大元素需要对比关键字k-1次,构造败者树可以使关键字对比次数减少到 log2k。
败者树可视为一棵完全二叉树(多了一个在根节点之上的头节点 )。k个叶结点 分别对应k个归并段 中当前参加比较的元素,非叶子结点 用来记忆左右子树中的“失败者” ,而让胜者往上继续进行比较,一直到根结点。
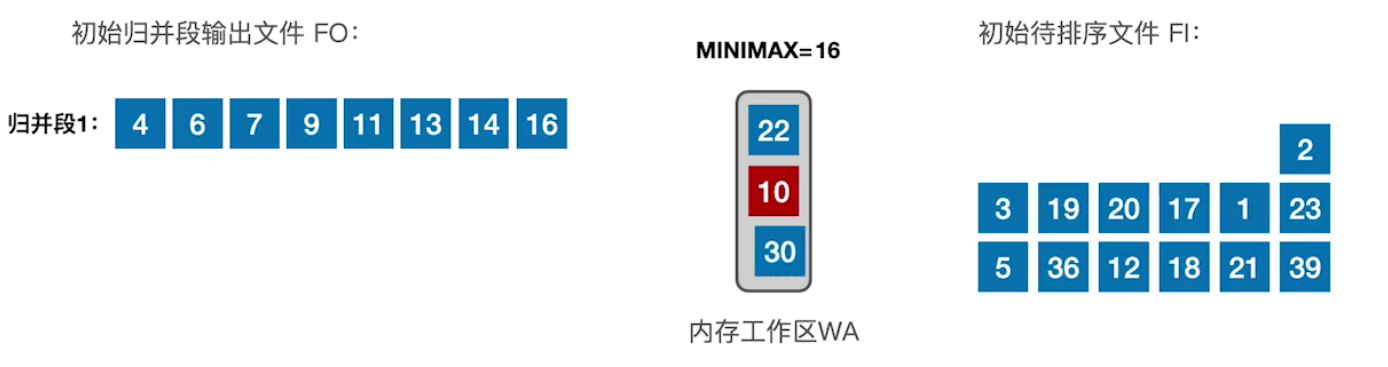
置换-选择排序 设初始待排文件为FI,初始归并段输出文件为FO,内存工作区为WA,FO和WA的初始状态为空,WA可容纳w个记录。置換-选择算法的步骤如下:
从FI输入w个记录到工作区WA
从WA中选出其中关键字取最小值的记录,记为 MIINIMAX记录。(MIINIMAX指不断选出的最小指中的最大值)
将 MINIMAX记录输出到FO中去。
若FI不空,则从FI输入下一个记录到WA中。
从WA中所有关键字比 MIINIMAX记录的关键字大的记录中选出最小关键字记录,作为新的MINIMAX记录。
重复(3)~(5),直至在WA中选不出新的 MINIMAX记录为止,由此得到一个初始归并段,输出一个归并段的结束标志到FO中去。
重复(2)~(6),直至WA为空。由此得到全部初始归并段。
r
试题 选择题
设指针变量p指向单链表中结点A,若删除单链表中结点A,则需要修改指针的操作序列为( )。
答案:A
先用指针变量q指向结点A的后继结点B,然后将结点B的值复制到结点A中,最后删除结点B。
设有n个待排序的记录关键字,则在堆排序中需要( )个辅助记录单元。
答案:1个。
堆排序只需一个辅助空间,用来记录当前操作的二叉树上的根节点的数字,来与其左右孩子节点比较。
设某二叉树中度数为0的结点数为N0,度数为1的结点数为Nl,度数为2的结点数为N2,则下列等式成立的( )。
答案:N0 = N2 + 1
设有序顺序表中有n个数据元素,则利用二分查找法查找数据元素X的最多比较次数不超过( )。
答案:log2n + 1
1、数据的最小单位是( A )。
设一棵m叉树中度数为0的结点数为N0,度数为1的结点数为N1,……,度数为m的结点数为Nm,则N0 =( B )。1+N2+2N3+3N4+……+(m-1)Nm
设在一棵度数为3的树中,度数为3的结点数有2个,度数为2的结点数有1个,度数为1的结点数有2个,那么度数为0的结点数有( )个。
解:6个
除了根节点外,其他节点均为孩子节点,而孩子节点等于总的分支数,即 孩子节点 = 1 * n1 + 2 * n2+3 * n3 = 10;
所以总节点数 = 10 + 1 = 11(1是指根节点),度数为0的节点数 = 11 - n1 - n2 - n3 = 6;
设顺序表的长度为n,则顺序查找的平均比较次数为()。
解:(n+1)/ 2
若第一个为查找元素,则查找次数为1,。。。。。所以 平均查找次数为 (1+2+3 + ….+ n) / n= (1+n) / 2;
填空题
通常从四个方面评价算法的质量:正确性、易读性、强壮性、高效性 。
数据结构从逻辑上划分为三种基本类型:线性结构,树型结构,图型结构。
用链表存储二叉树,则有n个节点的二叉树共有 2n 个指针域,其中 n-1 个存放了地址,剩下的是空指针(n+1个)。
AOV网是一种 有向无回路 的图。
对于具有n个顶点和e条边的有向图和无向图,其对应的邻接表中,所含边节点分别有 e 和 2e 个。
在一个具有n个顶点的无向完全图中,包含有 n(n-1)/2 条边,有n个顶点的有向完全图中,包含有 n(n-1) 条边。
设某二叉树中度数为0的节点数为 N,度数为1的节点数为 M,可得该二叉树中度数为2的节点数为 N - 1 ,。
数据的物理结构主要包括 顺序存储结构 和 链式存储结构。
设满二叉树的深度为k, 则该树的节点数为 2^k^ - 1; 若用二叉链表作为二叉树的存储结构,设该树有 n 个节点,则一共有 n + 1个空指针域。
一个序列,经过栈的作用可以得到 C^n^2n/ (n+1) 中不同的输出序列。(卡特兰数)
如:序列有3个数,则有5中不同的输出序列。
设哈夫曼树有n个节点,则该树有 0 个度数为1的节点。
设有n个结点的完全二叉树,如果按照从自上到下、从左到右从1开始顺序编号,则第 i 个结点的双亲结点编号为 i / 2 ; 右孩子结点的编号为 2i + 1。
设一组初始记录关键字为(72,73,71,23,94,16,5),则以记录关键字72为基准的一趟快速排序结果为
答案:(5,16,71,23,72,94,73)
两个指针,从左开始,和从右开始,先从右开始选第一个遇到的小于基准的数,和基准数换位;换 从左开始,遇到的第一个大于基准的数,和基准换位;再从右继续……循环,直至小于基准的在左边,大于基准的在右边。
在二叉排序树中插入一个结点的时间复杂度为 O(n),如果该排序树即不平衡,需要遍历n个节点,如果该树很平衡,则只需log2n。
设初始记录关键字序列为(K1,K2,…,Kn),则用筛选法思想建堆必须从第 n/2
设哈夫曼树中共有99个结点,则该树中有50 个叶子结点;若采用二叉链表作为存储结构,则该树中有_100 _个空指针。
设有一个顺序循环队列中有M个存储单元,则该循环队列中最多能够存储______m-1个队列元素;当前实际存储_____(R - F + M) % M_个队列元素(设头指针F指向当前队头元素的前一个位置,尾指针指向当前队尾元素的位置)。
设顺序线性表中有n个数据元素,则第i个位置上插入一个数据元素需要移动表中 n-i+1 n-i 个元素。
根据二叉树的先序和中序 遍历、或中序和后序 遍历,可以唯一确定二叉树的形状。
筛选法建初始堆必须从第 n / 2 个元素开始进行筛选。
快速排序在序列基本有序时为 O(n^2^),在序列基本无序时为 O(nlog2n)。
设一棵m叉树的结点数为n,用多重链表表示其存储结构,则该树中有 n(m-1)+1 个空指针域。