Mysql
MySQL
SQL分类:
DDL:数据定义语言
Data Definition Language,负责数据结构定义与库对象定义的语言,由CREATE、ALTER与DROP三个语法所组成。
DML:数据操作语言
Data Manipulation Language,负责对数据库对象运行数据访问工作的指令集,以 INSERT、UPDATE、DELETE三种指令为核心,分别代表插入、更新与删除。
DQL:数据查询语言
Data Query Language,负责进行数据查询而不会对数据本身进行修改的语句,这是最基本的SQL语句。保留字SELECT是DQL(也是所有SQL)用得最多的动词,其他DQL常用的保留字有FROM,WHERE,GROUP BY,HAVING和ORDER BY。
DCL:数据控制语言
Data Control Language,是一种可对数据访问权进行控制的指令,它可以控制特定用户账户对数据表、查看表、预存程序、用户自定义函数等数据库对象的控制权。由 GRANT 和 REVOKE 两个指令组成。DCL以控制 的访问权限为主,GRANT为授权语句,对应的REVOKE是撤销授权语句。
连接MySQL的指令:
1 | mysql -h 127.0.0.1 -P 3306 -u root -p密码 |
-p密码不要有空格;
-h 后没有写ip地址,默认就是主机
-P 后没有写端口,默认就是3306
1 | mysql -u 用户名 -p密码 //直接进默认的MySQL? |
启动mysql服务
1 | net start mysql |
进入mysql
2
输入密码 zzc
快捷键:
注释:shift + ctrl + c ; 注销注释:shift + ctrl + r
注:
MySQL在==Linux下==数据库名、表名、列名、别名大小写规则是这样的:
- ==数据库名、表名、表的别名、变量名是严格区分大小写的==;
- 关键字、函数名称在 SQL 中不区分大小写;
- 列名(或字段名)与列的别名(或字段别名)在所有的情况下均是忽略大小写的;
MySQL在Windows的环境下全部不区分大小写
utf8mb4 能使用1~ 4个字节表示字符,utf8是utf8mb3的别名,能使用1 ~ 3个字节表示字符;
MySQL中有4个级别的字符集和计较规则:
- 服务器级别
- 数据库级别
- 表级别
- 列级别
执行如下SQL语句:
会得到一些信息:
character_set_server:服务器级别的字符集
character_set_database:当前数据库的字符集
character_set_client:服务器解码请求时使用的字符集
character_set_connection:服务器处理请求时会把请求字符串从character_set_client转为character_set_connection
character_set_results:服务器向客户端返回数据时使用的字符集
数据库操作
创建与删除
1 | #删除数据库指令 |
注:DATABASE不能改名,一些可视化工具可以改名,是新建一个库,把所有表复制过去,再删旧库完成。
查看数据库
1 | #查看当前数据库服务器中的所有数据库 |
修改数据库
1 | ALTER DATABASE 数据库名 CHARACTER SET 字符集 |
使用反引号
1 | #在创建数据库,表时,为了规避关键字,可以使用反引号解决,删除的时候也要带反引号 |
备份与恢复
1 | #备份数据库(注意:在DOS执行; 这个备份的文件就是对应的sql语句): |
数据库CRUD
create,read,update,delete
表
表操作
DUAL表是一个虚拟的表,很特殊,是建立数据库的时候随数据字典创建而建立的,它是单行单列的一个表,一般称为“哑表、虚表等”,列名DUMMY,类型VARCHAR2(1),值为’X’,
创建表
creat table 表名
1 | CREATE TABLE [IF NOT EXISTS] 表名 |
1 | #示例: |
创建表——方式2,基于现有的表创建
2
3
4
5
6
#例子:
CREATE TABLE myemp
AS
SELECT employee_id,name,salary FROM employees;mysql8新特性:计算列
—— 列名 generated always 公式 virtual
可以在create table 和 alter teble中使用
2
3
4
5
a INT,
b INT,
c INT GENERATED ALWAYS AS (a + b) VIRTUAL -- 字段c为计算列
);
删除表
drop table 表名
drop是删除整个表,包括表的结构,约束,索引等。并释放掉所占的空间。
1 | DROP TABLE 表名 |
删除表的数据 : delete from 表名
delete不会减少表或索引占用的空间。
1 | DELETE FROM t7 |
TRUNCATE TABLE: truncate table语句删除表中所有的数据,重置表的自增值,会保留表结构及其约束,索引等。并使表和索引占用的空间恢复到初始大小。
添加数据
**insert into 表名 (可选列名) values (数据),(数据) **
1 | CREATE TABLE `t6`( --创建表 |
注:如果是将查询结果插入表中,则不必写values:
2
#子查询中的列表应与INSERT句中的列名对应
查询数据
select , desc
1 | #select 查询;* 表示所有字段,可改为具体的多个列名; FROM 从哪个表;WHERE 从哪个字段(按条件查询); |
where子语句中常用的
比较运算符: > < <= >= = <> 或 != (不等于,两种写法) **between…and…**(显示在某一区间的值) in(set)(显示在int列表中的值,如:in(10,20,30)) like ‘赵%’ not like ‘赵%’ (模糊查询:%匹配0到多个字符,_ 单个下划线匹配单个字符) is null(判断是否为空)
exists 指定一个子查询,检测 行 的存在。该子查询实际上并不返回任何数据,而是返回值True或False。xx all ( … ): all前的xx数据要大于括号内的所有数据,相当于 xx > max ( … )
xx any ( … ): all前的xx数据只要大于括号内的任一数据,相当于 xx > min ( … )
逻辑运算符:and(多个条件同时成立) or(多个条件任一成立) not(条件需不成立)
exists 练习
有 学生表student(学号,姓名) ,课程表course(课程号,课程名),成绩表sc(学号,课程号,成绩)
(1)查询选修了所有课程的学生姓名
2
3
4
5
# 所以,将每个学生选修的课程一一列出与课程表所有课程进行比较!首先找出课程表中,每个学生没有选修的课;然后再挑出没有选修课为空集的学生返回即可。
SELECT s.姓名 FROM student s WHERE NOT EXISTS
(SELECT * FROM course c WHERE NOT EXISTS
(SELECT * FROM sc WHERE sc.学号 = s.学号 AND sc.课程号 = c.课程号));(2)使用嵌套查询,查询选修了学生S2所有课程的学生姓名
2
3
4
5
# 所以,将每个学生选修的课程一一列出与学生S2选修课程进行比较!首先找出S2课程表中,每个学生没有选修的课;然后再挑出没有选修课为空集的学生返回即可。
SELECT s.SNAME FROM student s WHERE NOT EXISTS
(SELECT * FROM sc x WHERE x.SNO = "S2" AND NOT EXISTS
(SELECT * FROM sc y WHERE y.SNO = s.SNO AND x.CNO = y.CNO));
注意:列的别名不能在where中使用。
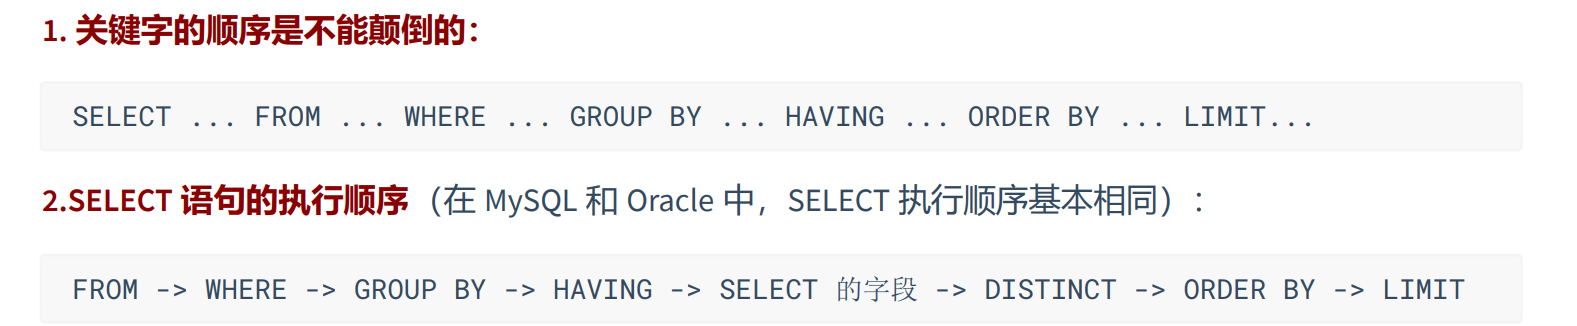
因为select语句的执行顺序:
1.from语句
2.where语句(结合条件)
3.start with语句
4.connect by语句
6.group byi语句
7.having语句
8.model语句
9.select语句
10.union、ninus、intersect等集合演算演算
11.order by语句12.limit语句(limit n, offset x; 指从结果的第x行开始,取n行作为展示结果)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
方式1:
SELECT ...,....,...
FROM ...,...,....
WHERE 多表的连接条件
AND 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...
#方式2:
SELECT ...,....,...
FROM ...
JOIN ... ON 多表的连接条件
JOIN ... ON ...
WHERE 不包含组函数的过滤条件
AND/OR 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...
#其中:
#(1)from:从哪些表中筛选
#(2)on:关联多表查询时,去除笛卡尔积
#(3)where:从表中筛选的条件
#(4)group by:分组依据
#(5)having:在统计结果中再次筛选
#(6)order by:排序
#(7)limit:分页
分页查询
1 | #select ... limit start, rows |
select语句中如果包含了group by,having,order by,limit:则书写顺序为group by,having,order by,limit
1 | SELECT column1, column2... FROM table |
多表查询
多表查询是基于两个或以上的表的查询,查询所规定的条件不能少于表的个数-1,否则会出现笛卡尔集
1 | SELECT ename,sal,dname,emp.deptno |
表连接的约束条件可以有三种方式:WHERE, ON, USING
自连接
自连接是指在同一张表的连接查询:将同一张表看作两张表
1 | # 给同一张表起不同别名,以达到自连接的目的 |
外连接
使用多表查询时,会根据关联条件显示匹配记录,而那些没有匹配到的记录则不会显示,如果在多表查询中至少需要显示表的全部内容,就要用到外连接。
1 | SELECT ... FROM 表1 |
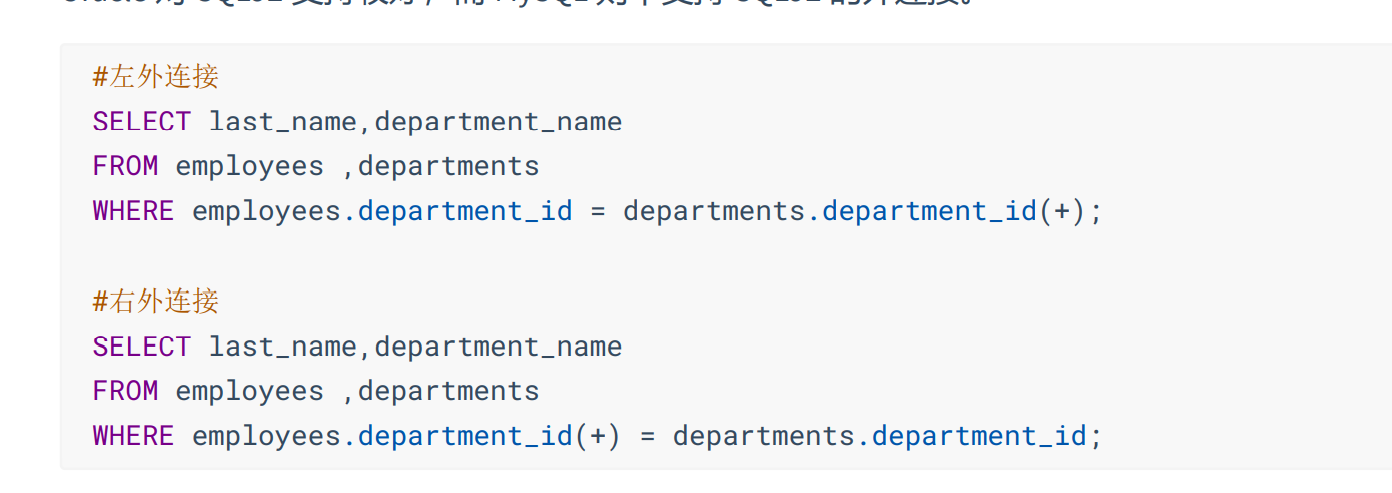
左外连接:让左侧的表完全显示,即左表为主表;
右外连接:让右侧的表完全显示;即右表为主表;
1 | #左外连接 |
或者使用符号 (+)
满外连接 FULL JOIN
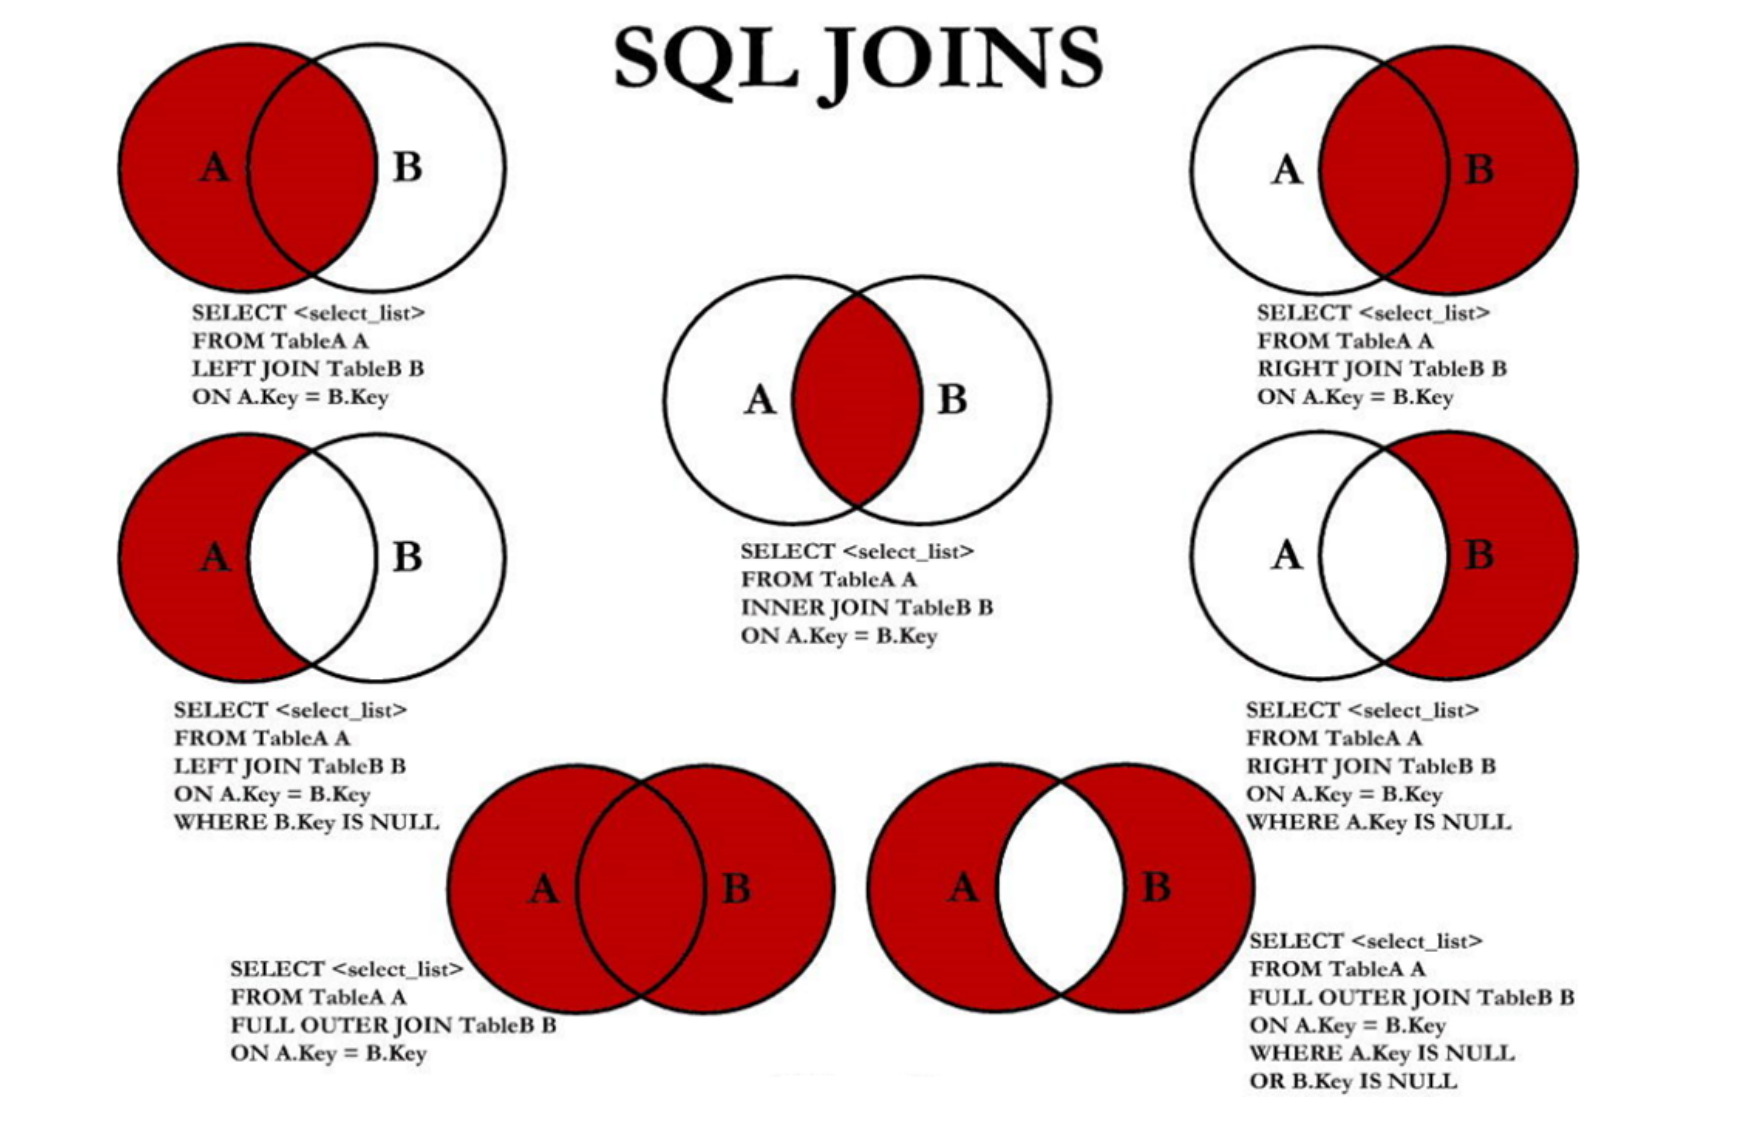
满外连接的结果 = 左右表匹配的数据 + 左表没有匹配到的数据 + 右表没有匹配到的数据。
各种关系的实现:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
SELECT employee_id,last_name,department_name
FROM employees e JOIN departments d
ON e.`department_id` = d.`department_id`;
#左上图:左外连接
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`;
#右上图:右外连接
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`;
#左中图:A - A∩B
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL
#右中图:B-A∩B
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE e.`department_id` IS NULL
#左下图:满外连接
# 左中图 + 右上图 A∪B
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL
UNION ALL #没有去重操作,效率高
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`;
#右下图
#左中图 + 右中图 A ∪B- A∩B 或者 (A - A∩B) ∪ (B - A∩B)
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL
UNION ALL
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE e.`department_id` IS NULL
自然连接
natural join 用来表示自然连接。我们可以把 自然连接理解为 SQL92 中的等值连接。它会帮你自动查询两张连接表中 所有相同的字段 ,然后进行 等值连接 。
1 | #在SQL92中 |
USING
SQL99还支持使用 USING 指定数据表里的 同名字段 进行等值连接。但是只能配合JOIN一起使用。
2
3
4
5
6
7
FROM employees e JOIN departments d
USING (department_id);
#等值于
SELECT employee_id,last_name,department_name
FROM employees e ,departments d
WHERE e.department_id = d.department_id;
子查询
子查询是指嵌入其他sql语句中的select语句,也叫嵌套查询
单行子查询:只返回一行数据的子查询语句
1 | # 单行子查询:只返回一行数据的子查询语句 |
还可以把子查询当作一张临时表:
1 | select goods_id, ecs_goods.cat_id, goods_name, shop_price |
空值问题:
如果子查询的表中有NULL值,则使用NOT IN筛选子表时会出现问题:
2
3
4
5
6
7
8
FROM employees
WHERE employee_id NOT IN (
SELECT manager_id
FROM employees
-- WHERE manager_id is not NULL
);
# 结果应该是排除子表筛出来的元素,但因为子表的结果集有NULL值,所以最后结果是什么都没筛出来。
合并查询
操作符 union,union all 可以取得两个结果集的并集;
其中 union all 不会去重, union 会去重
1 | SELECT `name`, id FROM table01 WHERE id > 2500 |
表复制
表的复制
1 | #将表1的数据复制添加到表2,如果两表相同,则相当于自我复制 |
修改列属性
alter table 表名 add 内容 after 在哪之后/ modify 列名 属性更改/ drop 列名 / character 字符集 / change 旧名 新名 属性更改 ; rename 表名
1 | #添加列 |
1 | # 删除表 (不能回滚) |
更新数据
update 表名 set 修改内容 where 位置
1 | UPDATE t7 |
如果需要回滚数据,需要保证在DML前进行设置:set autocommit = false;
删除数据
delete from 表名 where …
1 | DELETE FROM departments |
约束
约束用于确保数据库的数据满足特定的商业规则;为保证数据完整性,一般从以下四个方面考虑限制:
实体完整性(Entity Integrity)
例如:同一个表中,不能存在两条完全相同无法区分的记录
域完整性(Domain Integrity)
例如:年龄范围0-120,性别范围“男/女”
引用完整性(Referential Integrity)
例如:员工所在部门,在部门表中要能找到这个部门
用户自定义完整性(User-defined Integrity)
例如:用户名唯一、密码不能为空等,本部门经理的工资不得高于本部门职工的平均工资的5倍。
mysq的约束包括:
- not null,非空约束,规定某字段不能为空
- unique,唯一约束,规定某字段在表中唯一
- primary key, 主键约束(非空且唯一)
- foreign key,外键约束
- check,检查约束
- default,默认值约束
查看某个表已有的约束:
2
3
4
WHERE table_name = "表名";
# information_schema 系统库
# table_constraints 专门存储各表的约束
注:MySQL不支持check约束,可以用,但没效果。
primary key (主键)
用于唯一的标识表行的数据,当定义主键约束后,该列不能重复;
- primary key约束列的数据不能重复,且不能为null
- 一张表最多只能有一个主键,但可以是复合主键:比如有列:name和id,可以将两者用一个主键约束,单个name或id可以重复,但name+id的组合不能有重复;
- 主键的指定方式有两种:
- 在列定义 后指定:列定义 primary key
- 在表定义最后写 :primary key (列名)
- 主键名总是PRIMAR,对主键定义约束名没用;
- 使用desc 表名,可以看到primary key的情况;
- 开发中,每个表往往会设计一个主键,且建议不要修改主键字段的值,否则有破坏数据完整性的危险;
1 | #字段后 定义主键 |
删除主键约束:
删除主键时,不需指定主键名,因为一个表只有一个主键;删除主键约束后,非空约束会存在。
1 | alter table 表名称 drop primary key; |
自增列 auto_increment
一个表最多只能有一个自增列;
自增列约束的必须是键列(主键列、唯一键列,即 primary key 或 unique );
自增列约束的列的数据类型必须是整数类型;
默认从1开始,也可用:alter table 表名auto_increment = 新的开始值;
如果自增列指定了 0 和 null,会在当前基础上继续自增,如果指定了具体值,直接赋值为具体值。
1 | # 设置自增列 |
not null (非空)
在列上定义了not null,那么当插入数据时,必须为列提供数据
1 | 字段名 字段类型 NOT NULL |
1 | # 建表时 |
1 | # 删除非空约束 |
unique (唯一)
当定义了唯一约束后,该列的数据不能重复。
1 | 字段名 字段类型 UNIQUE |
- 没有指定not null时,unique字段允许有多个null;
- 如果一个列, 约束了 unique not null ,则使用效果类似主键 primary key;
- MySQL会给唯一约束的列上默认创建一个唯一索引。
1 | # 建表时 |
1 | # 复合唯一约束 |
删除唯一约束:
删除时需要指定唯一索引名(唯一索引名 和 唯一约束名一样,如果是复合约束且没有指定约束名,则默认为组合里的第一列的名)
1 | ALTER TABLE 表名 DROP INDEX 唯一索引名 |
foreign key (外键)
用于定义主表和从表之间的关系:’
外键约束主要定义在从表上,主表则必须具有主键约束或unique约束,当定义外键约束后,要求 外键列的数据必须在主表的主键列存在 或为null;
1 | #foreign key(...) references 主表(...) |
- 表的类型需要是innodb,这样的表才支持外键;一个表可以有多个 外键;
- 外键列的类型要和主键列的类型一致(长度可以不同);
- 一旦建立主外键关系,主键列数据就不能随意删除,需要先删除依赖该记录的数据,即对应外键列的所有同一数据,才能删除主键的这一数据。
- 当创建外键约束时,系统会默认在所在的列上建立对应的普通索引,索引名是外键的约束名(根据外键查询效率很高);删除外键约束后,必须手动删除对应的索引。
约束等级:
- Cascade方式 :在父表上update/delete记录时,同步update/delete子表的匹配记录
- Set null方式 :在父表上update/delete记录时,将子表上匹配记录的列设为null,但是要注意子 表的外键列不能为not null
- No action方式 :如果子表中有匹配的记录,则不允许对父表对应候选键进行update/delete操作
- Restrict方式 :同no action, 都是立即检查外键约束
- Set default方式(在可视化工具SQLyog中可能显示空白):父表有变更时,子表将外键列设置成一个默认的值,但Innodb不能识别。
对于外键约束,最好是采用: on update cascade on delete restrict 的方式。
2
3
4
5
6
7
8
9
10
did int primary key, #部门编号
dname varchar(50) #部门名称
);
create table emp(
eid int primary key, #员工编号
ename varchar(5), #员工姓名
deptid int, #员工所在的部门
foreign key (deptid) references dept(did) on update cascade on delete restrict #把修改操作设置为级联修改等级,把删除操作设置为restrict等级
);
删除外键约束:
查看约束名——删除外键约束——查看索引名——删除外键索引
1 | # 第一步先查看约束名和删除外键约束 |
外键约束是用于保证数据的参照完整性的,因此主表与从表的存储引擎需要一致。
建不建外键约束和查询有没有关系。
在 MySQL 里,外键约束是有成本的,需要消耗系统资源。对于大并发的 SQL 操作,有可能会不适 合。比如大型网站的中央数据库,可能会因为外键约束的系统开销而变得非常慢 。
所以,MySQL 允许不使用系统自带的外键约束,在应用层面完成检查数据一致性的逻辑。
阿里开发规范:不得使用外键与级联,一切外键概念必须在应用层解决。
级联更新:主键更新,外键跟着更新;
外键与级联更新 适用于单机低并发 ,不适合 分布式 、 高并发集群 ;级联更新是强阻塞,存在数据库更新风暴的风险;外键影响数据库的插入速度 。
check
用于强制数据必须满足的条件
(oracle和sql server支持check,mysql8.0才支持check)
1 | 列名 类型 CHECK(check条件) |
1 | CREATE TABLE temp( |
default
1 | # 默认值一般不加在唯一键和主键列上 |
建表时,通常会加 not null default ‘’ 或 default 0,因为:
- null是特殊的值,比较时只能用专门的 is null 和 is not null 来比较。碰到运算符,通 常返回null。
- 效率不高,影响提高索引效果。
索引
索引可以极大加快查询的速度;
- 使用索引会为该列形成一个索引的数据结构,如索引二叉树;
- 代价:额外占用磁盘空间;对dml语句(update, delete, insert) 的效率有影响,因为数据变动时需要重新维护索引结构
- 一般使用中,查询操作比增删改操作要多很多,因此索引很有必要
更新一个包含索引的表需要比更新一个没有索引的表更多的时间,这是由于索引本身也需要更新。因此,理想的做法是仅仅在常常被搜索的列(以及表)上面创建索引。
索引的类型:
- 主键索引:主键就是一个索引
- 唯一索引(unique)
- 普通索引(index)
- 全文索引:不适用mysql自带的fulltext,而是使用全文搜索Solr和ElasticSearch(ES)
1 | #建表后 创建索引 |
1 | #建表时 |
索引使用:
频繁的作为查询条件的字段应创建索引;
唯一性太差的字段不适合单独创建索引,即使频繁查询;更新很频繁的字段也不适合创建索引(因为维护索引结构需要额外开销);不会或极少作为查询条件出现的字段也不用创建索引
事务
事务用于保证数据的一致性,事务期间的操作要么全部成,要么全部失败。
当执行事务操作时(dml语句),mysql会在表上加锁,防止其他用户修改表;
mysql的事务机制需要设置innodb的存储引擎才能使用
事务ACID特性:
- 原子性(Atomicity):原子性是指事务是一个不可分割的工作单位,事务中的操作要么都发生,要么都不发生;
- 一致性(Consistency):事务必须使数据库从一个一致性状态变换到另一个一致性状态
- 隔离性(Isolation):事务的隔离性使多个用户并发访问数据库时,数据库未每个用户开启的事务不能被其他事务的操作所干扰,多个并发事务之间要相互隔离;
- 持久性(Durability):持久性是指一个事务一旦被提交,它对数据库中数据的改变是永久性的,即使数据库发生故障也不应该对其有影响
事务操作
start transaction :开启一个事务 (或者:set autocommit = off ,即关闭自动提交)
savepoint 保存点名:设置保存点
rollback to 保存点名:回退到某个保存点,回退后,会删除此保存点 以及 在其之后设置的保存点
rollback :回退全部事务,即回到事务开始的时候
commit:提交事务,所有操作生效,不能再回退(确认事务的变化—结束事务—删除保存点—释放锁—数据生效)
DDL和DML的说明:
- DDL的操作一旦执行,就不可回滚;
- DML的操作默认情况也不可回滚;想要回滚,需要在操作前设置:SET autocommit = FALSE;
事务隔离级别
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 加锁读 |
|---|---|---|---|---|
| 读未提交(Read uncommitted) | Y | Y | Y | 不加锁 |
| 读已提交(Read committed) | N | Y | Y | 不加锁 |
| 可重复读(Repeatable read) | N | N | Y | 不加锁 |
| 可串行化(Serializable) | N | N | N | 加锁 |
脏读:当一个事务读取另一个事务还未提交的改变时,产生脏读
不可重复读:由于其他事务所提交的修改或删除操作,致使在同一事务中的同一查询返回不同结果,即发生不可重复读
幻读:由于其他事务所提交的插入操作,致使在同一事务中的同一查询返回不同结果,即发生幻读
事务隔离级别操作:
设置当前会话隔离级别:
set session transaction isolation level repeattable read;
设置系统当前隔离级别:
set global transaction isolation level repeattable read;
查看当前会话隔离级别:
select @@tx_isolation;查看系统当前隔离级别:
select @@global.tx_isolation;mysql默认的事务隔离级别是repeatable read,一般都用,无需修改;
全局修改:直接修改my.ini配置文件,在末尾加上:
#可选参数有:READ-UNCOMMITTED, READ-COMMITTED, REPEATABLE-READ, SERIALIZABLE[mysqld]transaction-isolation = REPEATABLE-READ
表类型/存储引擎
mysql的表类型由存储引擎(Storage Engines)决定,
MySQL数据表主要支持六种类型:CSV,Memory,ARCHIVE,MRG_MYISAM,MYISAM,InnoDB;
其中InnoDB为事务安全型,其他五种为非事务安全型;
MYISAM:不支持事务,不支持外键,但访问速度快
InnoDB:支持事务安全,但读写的处理效率相比MYISAM差一些,且会占用更多的磁盘空间以保留数据和索引;
MEMORY:使用存在内存中的内容来创建表,每个MEMORY表实际对应一个磁盘文件。MEMORY类型的表访问非常快,因为它的数据放在内存中,且默认使用hash索引;但如果MySQL服务关闭,表中的数据就会丢失,而表的结构还在
修改存储引擎:
alter table 表名 engine = 存储引擎
视图
视图是一个虚拟表,其内容由查询定义,同真实的表一样,视图包括列,其数据来自对应的基表(可以是多个基表)。通过视图可以修改基表的数据,基表的改变也会影响视图的数据。(视图中可以再使用视图,数据仍来自基表)
操作:
1 | #创建: |
视图的好处:
- 安全:可以只让用户查询到需要的字段,一些保密的字段不能查看。
- 性能:视图存储的是查询语句,本身并不占用数据存储资源,减少了数据冗余。
- 灵活:可以在旧表上建立一张视图,然后映射到新表上,达到升级数据表的目的。
视图的不足:
如果实际数据表的结构变更了,我们就需要及时对相关的视图进行相应的维护。特别是嵌套的视图(就是在视图的基础上创建视图),维护会变得比较复杂, 可读性不好 ,容易变成系统的潜在隐患。
实际项目中,如果视图过多,会导致数据库维护成本的问题。
1 | #查看视图 |
1 | # 更新视图,跟更新表一样 |
1 | # 修改视图 |
视图作为虚拟表,主要用于 方便查询,不建议更新视图数据。
对视图数据的更改,都是通过对实际数据表的更新来完成。
一些不可更新的视图:
要使视图可更新,视图中的行和底层基本表中的行之间必须存在 一对一 的关系。
另外当视图定义出现如下情况时,视图不支持更新操作:
- 在定义视图的时候指定了“ALGORITHM = TEMPTABLE”,视图将不支持INSERT和DELETE操作;
- 视图中不包含基表中所有被定义为非空又未指定默认值的列,视图将不支持INSERT操作;
- 在定义视图的SELECT语句中使用了 JOIN联合查询 ,视图将不支持INSERT和DELETE操作;
- 在定义视图的SELECT语句后的字段列表中使用了 数学表达式 或 子查询 ,视图将不支持INSERT,也不支持UPDATE使用了数学表达式、子查询的字段值;
- 在定义视图的SELECT语句后的字段列表中使用 DISTINCT 、 聚合函数 、 GROUP BY 、 HAVING 、 UNION 等,视图将不支持INSERT、UPDATE、DELETE;
- 在定义视图的SELECT语句中包含了子查询,而子查询中引用了FROM后面的表,视图将不支持 INSERT、UPDATE、DELETE;
- 视图定义基于一个 不可更新视图 ;
- 常量视图。
用户管理
mysql的用户,都存储在系统数据库mysql中的user表中;
user表的重要字段说明:
- host:允许登录的“位置”/IP,可以指定ip地址登录;其中localhost表示该用户只允许本机登录;
- user:用户名;
- authentication_string:密码,用mysql的password()函数加密过的密码字段
操作:
1 | #创建用户,并指定密码: |
用户权限
1 | # 给用户权限: |
授予权限时,如果 [库.对象名] 写 *.*, 则代表数据库的所有对象,可以在mysql.user中查到; 写 具体库名.* ,则代表某数据库下所有表,可以在mysql.db中查到; 如果写 具体库名.具体表名, 可以在 mysql.tables_priv 中查到。
函数
mysql的条件判断返回的是1和0,true为1,false为0
不同DBMS采用的函数有所不同,因此使用了SQL函数的代码,往往可移植性较差。
统计函数
count, sum, avg, max, min
1 | #count(*)会返回满足条件的记录的个数,count(列名)同样返回满足条件的列的个数,但会排除为null的情况 |
where 不能使用统计函数。
对于统计符合要求的行数,可使用count和sum,如:
2
3
4
5
select count(if(state="true",1,NULL))...
select sum(if(state="true",1,0))...
# 应该条件返回的是1和0,所以sum中可以不用if,效果一样,如下:
select sum(state="true")...
分组
group by .. having …. (having可对分组后结果进行过滤)
1 | SELECT 列, 列(可以是函数), 分组的列名 FROM 表名 |
对比where和having:
| 优点 | 缺点 | |
|---|---|---|
| WHERE | 先筛选数据再关联,执行效率高 | 不能使用分组中的计算函数进行筛选 |
| HAVING | 可以使用分组中的计算函数 | 在最后的结果集中进行筛选,执行效率较低 |
窗口函数
over(partition by xxx order by xxx [限定数据范围] ),对数据分为多个窗口后还需要在前面加其他功能函数
限定数据范围的用法:
1
2
3
4
5
6
7
8
9
10
11
12
13当前行 - current row
之前的行 - preceding
之后的行 - following
无界限 - unbounded
表示从前面的起点 - unbounded preceding
表示到后面的终点 - unbounded following
取当前行和前五行:
ROWS between 5 preceding and current row --共6行
取当前行和后五行:
ROWS between current row and 5 following --共6行
取前五行和后五行:
ROWS between 5 preceding and 5 folowing --共11行1
2
3
4
5# 假设日期visited_on递进,每天都有对应的收入amount
# 以下为计算7天收入的每日平均收入(当前天+前6天)
SELECT visited_on,
SUM(amount) OVER (ORDER BY visited_on ROWS 6 PRECEDING ) AS sum_amount
FROM t
例如:根据 a,b 划分窗口,根据 c, d 在窗口内进行排序,并找出每个窗口内最大的e的值
1 | select a, b, c, d, MAX(e) over(partition by a,b order by c, d) from t; |
窗口函数可以和一些函数一起使用,例如:
统计函数:sum(),avg(),count(),max(),min()
排序函数:row_number(),dense_rank(),rank(),这些排序在每个窗口/分组中都是以序号1开始排的
- ROW_NUMBER() OVER():直接表示第几行了,并不会出现并列的情况
- DENSE_RANK() OVER():并列连续(连续指的是:如有相同的6行数据,序号为1,那下一个相同的值的序号就是2)
- RANK() OVER():并列不连续(不连续指的是:如有相同的6行数据,序号为1,那下一个相同的值的序号就是7)
偏移函数:lag(),lead()
- lag(列名,n,default):n表示取向前第几行,defualt表示没有向前第n行时返回的默认值
- lead(列名,n,default):n表示向后第几行
1
2
3
4
5
6
7
8
9# 查询连续三行的num值相同的列
SELECT DISTINCT Num as ConsecutiveNums
FROM(
SELECT Id,Num,
Lead(Num, 1)OVER() as num_1, #选择指定行的向前一行的内容
Lead(Num, 2)OVER() as num_2 #选择指定行的向前两行的内容
FROM Logs
) as c
WHERE c.Num = c.num_1 AND c.num_1 = c.num_2
字符串函数
1 | #charset(str) 返回字串的字符集 |
数学函数
1 | -- abs(num) 绝对值 |
数据格式化函数 cast,convert 中用到的类型有:
| 类型 | 解释 |
|---|---|
| DECIMAL(4,2) | 浮点型:DECIMAL(总共位数,浮点位数) |
| SIGNED | 整数型 |
| DATETIME | 日期时间型 |
| DATE | 日期型 |
| TIME | 时间型 |
| CHAR() | 字符型 |
日期函数
1 | -- CURRENT_DATE ( ) 当前日期 |
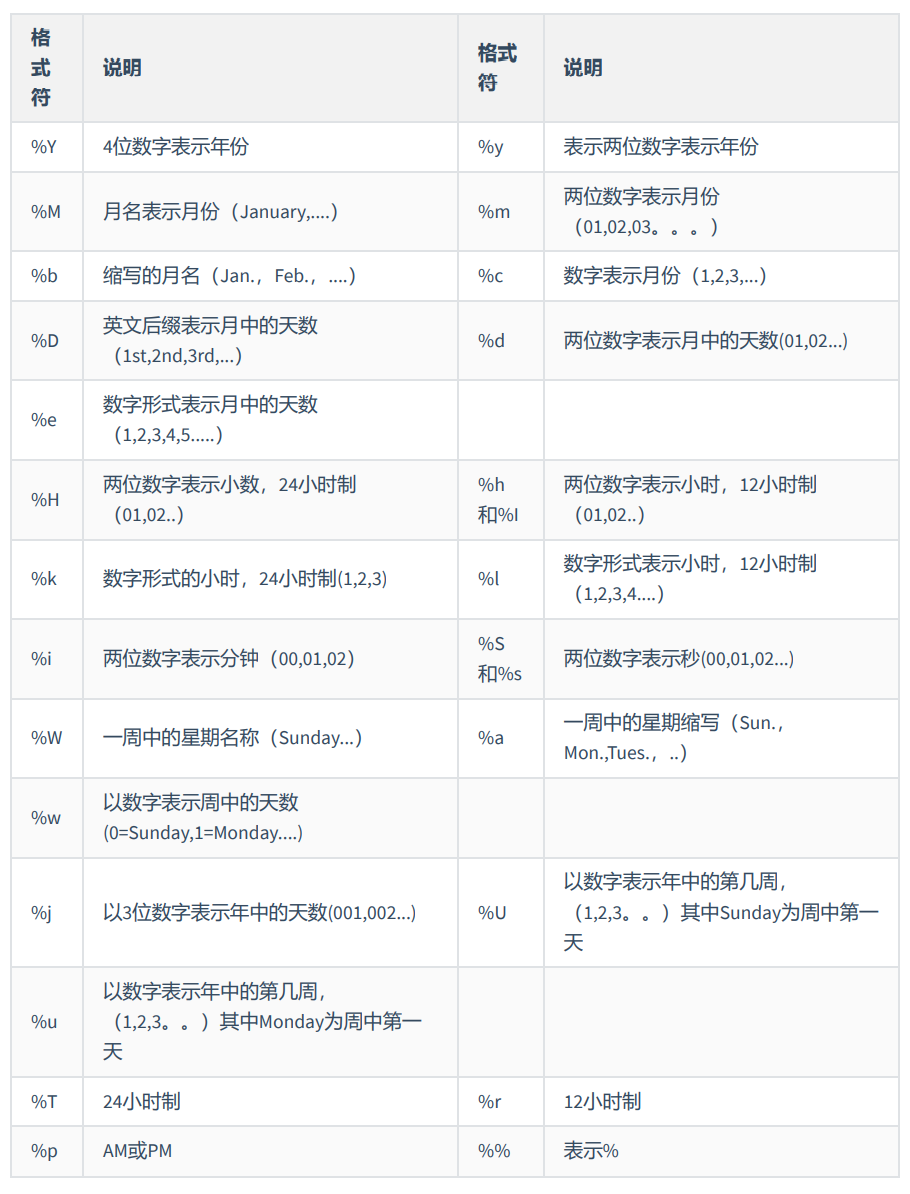
常用格式符:
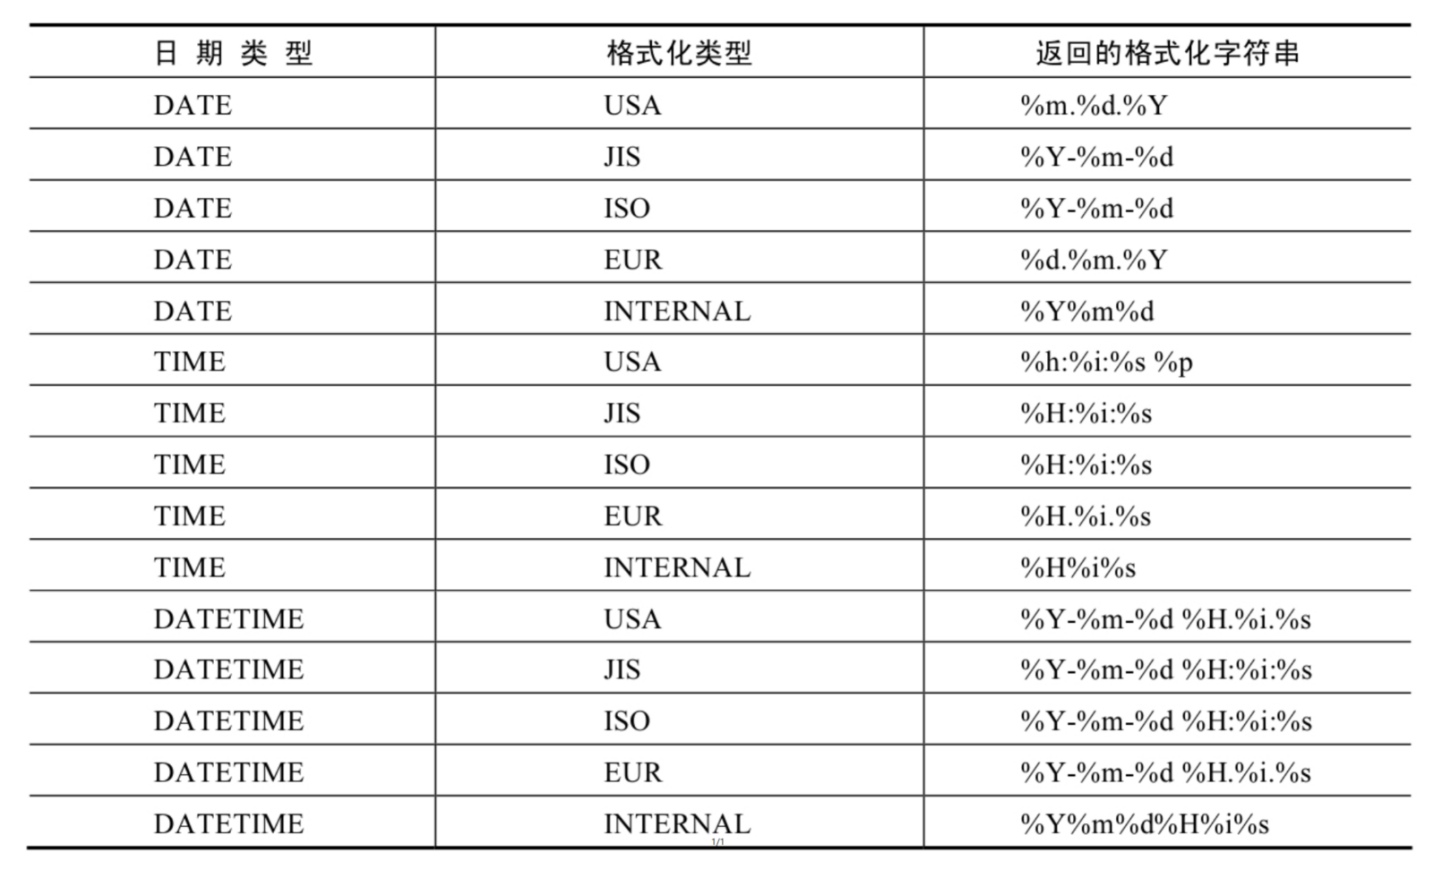
常用取值:
例子:
1 | -- 创建测试表 信息表 |
加密函数
1 | #user() 查询用户,可以查看登录到mysql的有哪些用户,以及登录的IP |
流程函数
1 | # IF(expr1,expr2,expr3) 如果 expr1 为 True ,则返回 expr2 否则返回 expr3 |
其他函数
1 | FORMAT(value,n) -- 返回对数字value进行格式化后的结果数据。n表示 四舍五入 后保留到小数点后n位 |
正则表达式: regexp ‘表达式’,如:
1 | SELECT |
注意:
- 多数正则表达式实现使用单个反斜杠转义特殊字符,一遍能使用这些字符本身,但是MySQL要求两个反斜杠(MySQL自己解释一个,正则表达式库解释另一个)。
- ^ 符号的双重用途: ^在集合中(用 [ ] 定义)时用它来否定该集合,否则用来指定串的开始处。
- mysql的正则表达式不区分大小写,想要区分大小写,可以使用 BINARY 关键字:WHHERE name REGEXP BINARY ‘^Xx .000’。
| 模式 | 描述 |
|---|---|
| ^ | 匹配输入字符串的开始位置。如果设置了 RegExp 对象的 Multiline 属性,^ 也匹配 ‘\n’ 或 ‘\r’ 之后的位置。 |
| $ | 匹配输入字符串的结束位置。如果设置了RegExp 对象的 Multiline 属性,$ 也匹配 ‘\n’ 或 ‘\r’ 之前的位置。 |
| . | 匹配除 “\n” 之外的任何单个字符。要匹配包括 ‘\n’ 在内的任何字符,请使用像 ‘[.\n]’ 的模式。 |
| […] | 字符集合。匹配所包含的任意一个字符。例如, ‘[abc]’ 可以匹配 “plain” 中的 ‘a’。 |
| [^…] | 负值字符集合。匹配未包含的任意字符。例如, ‘[^abc]’ 可以匹配 “plain” 中的’p’。 |
| p1|p2|p3 | 匹配 p1 或 p2 或 p3。例如,’z|food’ 能匹配 “z” 或 “food”。’(z|f)ood’ 则匹配 “zood” 或 “food”。 |
| * | 匹配前面的子表达式零次或多次。例如,zo* 能匹配 “z” 以及 “zoo”。* 等价于{0,}。 |
| + | 匹配前面的子表达式一次或多次。例如,’zo+’ 能匹配 “zo” 以及 “zoo”,但不能匹配 “z”。+ 等价于 {1,}。 |
| {n} | n 是一个非负整数。匹配确定的 n 次。例如,’o{2}’ 不能匹配 “Bob” 中的 ‘o’,但是能匹配 “food” 中的两个 o。 |
| {n,m} | m 和 n 均为非负整数,其中n <= m。最少匹配 n 次且最多匹配 m 次。 |
存储过程和存储函数
存储过程
存储过程 就是将一组经过预先编译的SQL语句封装。
执行流程:存储过程预先存储在mysql服务器上,用户需要的时候,只需要向服务器发出调用存储过程的命令,就像调用一个封装的方法一样,之后服务器就可以把预先存储好的这一系列SQL语句全部执行。
好处:
- 简化操作,提高sql语言的重用性;
- 减少失误;
- 减少网络传输量,用户只需使用存储过程的名字即可;
- 减少sql语句暴露在网络上的风险,也提高数据查询的安全性;
不足:
可移植性差:
存储过程程不能跨数据库移植,比如在 MySQL、Oracle 和 SQL Server 里编写的存储过程,在换成其他数据库时都需要重新编写。
调试困难:
只有少数 DBMS 支持存储过程的调试。对于复杂的存储过程来说,开发和维护都不容 易。
版本管理困难:
比如数据表索引发生变化了,可能会导致存储过程失效。在开发软件的时候往往需要进行版本管理,但是存储过程本身没有版本控制,版本迭代更新的时候很麻烦。
不适合高并发:
高并发的场景需要减少数据库的压力,有时数据库会采用分库分表的方式,而且对可扩展性要求很高,在这种情况下,存储过程会变得难以维护,增加数据库的压力,显然就 不适用了。
分类:
存储过程的参数有:IN,OUT,INOUT
- 没有参数(无参数无返回)
- 仅带IN(有参数无返回)
- 仅带OUT(无参数有返回)
- 带IN,OUT(有参数有返回)
- 带INOUT(有参数有返回)
注:IN、OUT、INOUT 都可以在一个存储过程中带多个。
1 | # 创建 |
因为mysql默认的语句结束符号为分号 ‘;‘,为了避免与存储过程的sql语句冲突,需要使用delimiter改变存储过程的结束符;
如果使用的Navicat工具,那么在编写存储过程时,Navicat会自动设置 DELIMITER ,不需要自己再额外设置了。
1 | DELIMITER // |
IN:当前函数为输入参数;存储过程只是读取这个参数的值。没有定义参数种类时,默认为IN;
OUT:当前参数为输出参数;执行完毕后,执行调用的客户端可以读取这个这个参数返回的值。
INOUT:当前参数即可为输入参数,也可为输出参数;
characteristics:表示创建存储过程时指定的对存储过程的约束条件,取值如下:
2
3
4
5
| [not] deterministic
| {contains sql | no sql | reads sql data | modifies sql data}
| sql security { definer | invoker }
| comment 'string'LANGUAGE SQL :说明存储过程执行体是由SQL语句组成的,当前系统支持的语言为SQL。
[NOT] DETERMINISTIC :指明存储过程执行的结果是否确定。DETERMINISTIC表示结果是确定 的。每次执行存储过程时,相同的输入会得到相同的输出。NOT DETERMINISTIC表示结果是不确定的,相同的输入可能得到不同的输出。如果没有指定任意一个值,默认为NOT DETERMINISTIC。
{ CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA } :指明子程序使 用SQL语句的限制。
- CONTAINS SQL表示当前存储过程的子程序包含SQL语句,但是并不包含读写数据的SQL语句;
- NO SQL表示当前存储过程的子程序中不包含任何SQL语句;
- READS SQL DATA表示当前存储过程的子程序中包含读数据的SQL语句;
- MODIFIES SQL DATA表示当前存储过程的子程序中包含写数据的SQL语句。
- 默认情况下,系统会指定为CONTAINS SQL。
SQL SECURITY { DEFINER | INVOKER } :执行当前存储过程的权限,即指明哪些用户能够执 行当前存储过程。
- DEFINER 表示只有当前存储过程的创建者或者定义者才能执行当前存储过程;
- INVOKER 表示拥有当前存储过程的访问权限的用户能够执行当前存储过程。
- 如果没有设置相关的值,则MySQL默认指定值为DEFINER。
COMMENT ‘string’ :注释信息,可以用来描述存储过程。
存储函数
mysql允许自定义函数,调用方式与调用mysql的系统函数一样。
语法格式:
1 | create function 函数名(参数名 参数类型, ...) |
调用:与调用mysql内部函数是一样的
1 | SELECT 函数名(实参列表) |
例子:
创建存储函数count_by_id(),参数传入dept_id,该函数查询dept_id部门的员工人数,并返回,数据类型 为整型。
1 | DELIMITER // |
| 关键字 | 调用语法 | 返回值 | 应用场景 | |
|---|---|---|---|---|
| 存储过程 | procedure | call 存储过程() | 0个或多个 | 一般用于更新 |
| 存储函数 | function | select 函数() | 只能一个 | 一般用于查询结果为一个值并返回时 |
查看存储过程和存储函数的
创建信息:
1 | show create {procedure | function} 存储过程名或函数名 |
状态信息:
1 | # 返回子程序的特征,如数据库,名字,类型,创建者,创建、修改日期 |
存储信息:
MySQL中存储过程和函数的信息放在 infornation_schema 数据库下的 Routines 表中。
1 | SELECT * FROM information_schema.Routines |
修改:
1 | ALTER {PROCEDURE | FUNCTION} 存储过程或函数的名 [characteristic] |
characteristic指定存储过程或函数的特性,其取值信息与创建存储过程、函数时的取值信息略有不同。
2
3
| SQL SECURITY { DEFINER | INVOKER }
| COMMENT 'string'CONTAINS SQL ,表示子程序包含SQL语句,但不包含读或写数据的语句。
NO SQL ,表示子程序中不包含SQL语句。
READS SQL DATA ,表示子程序中包含读数据的语句。
MODIFIES SQL DATA ,表示子程序中包含写数据的语句。
SQL SECURITY { DEFINER | INVOKER } ,指明谁有权限来执行。
- DEFINER ,表示只有定义者自己才能够执行。
- INVOKER ,表示调用者可以执行。
COMMENT ‘string’ ,表示注释信息。
删除:
1 | DROP {PROCEDURE | FUNCTION} [IF EXISTS] 存储过程或函数的名 |
IF EXISTS:如果程序或函数不存储,它可以防止发生错误,产生一个用SHOW WARNINGS查看的警告。
数据类型
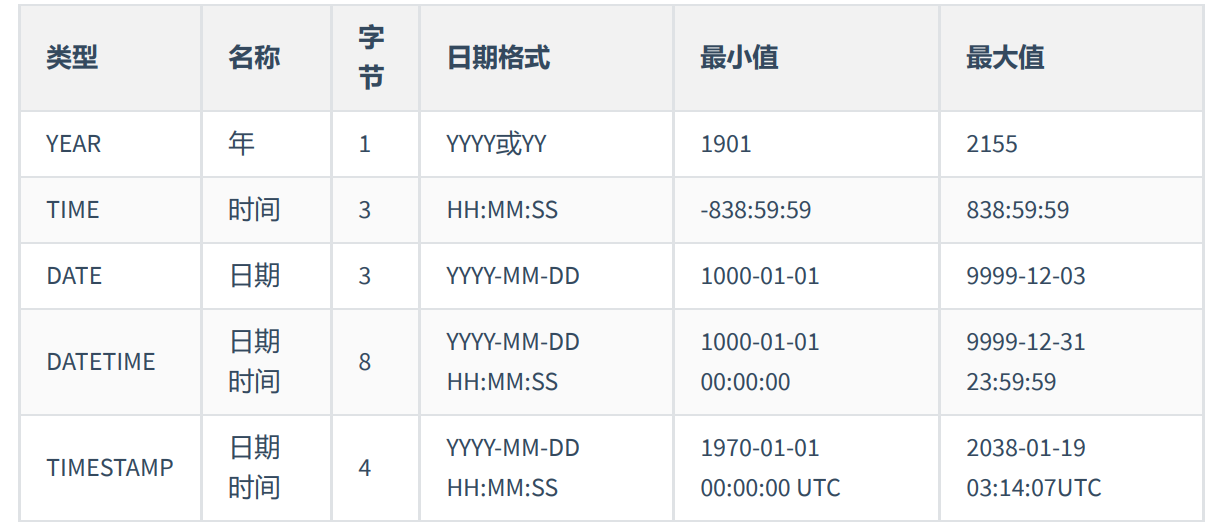
MySQL常用列类型(数据类型)
- 数值类型
- 整型:tinyint(1个字节)smallint(2个字节)mediumint(3个字节)int(4个字节)bigint(8个字节)decimal[M, 0](数值长度为M)
- 小数类型:float(单精度4字节)double(双精度8字节)**decimal[M,D]**(数值长度M,小数部分长度D;M最大65,D最大30;M被省略则默认为10,D被省略则默认为0)
- 文本类型(字符串类型)
- char (0~255字符,固定长)
- varchar (0
65535 即 最大放02^16 - 1字节,可变长,实际占用空间看存放多少数据,varchar本身需要占用1~3个字节来记录存放内容的长度)- 查询速度:char > varchar
- varchar 存放大小的单位写的仍是字符,但存放上下限是按字节算的
- text (0~ 2^16 - 1)
- longtext (0~2^32 - 1)
- 二进制数据类型
- blob (0~2^16 - 1)
- longblob (0~2^32 - 1)
- 日期类型
- date (日期 年月日 3字节)
- time (时间 时分秒 3字节)
- datetime (年月日 时分秒 YYYY-MM-DD HH:mm:ss 8字节)
- timestamp (时间戳,会自动更新 4字节)
- 自动更新时间戳为当前时间:login_time(列名) TIMESTAMP(数据类型:时间戳) NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
- year (年 1字节)
常用的类型介绍:
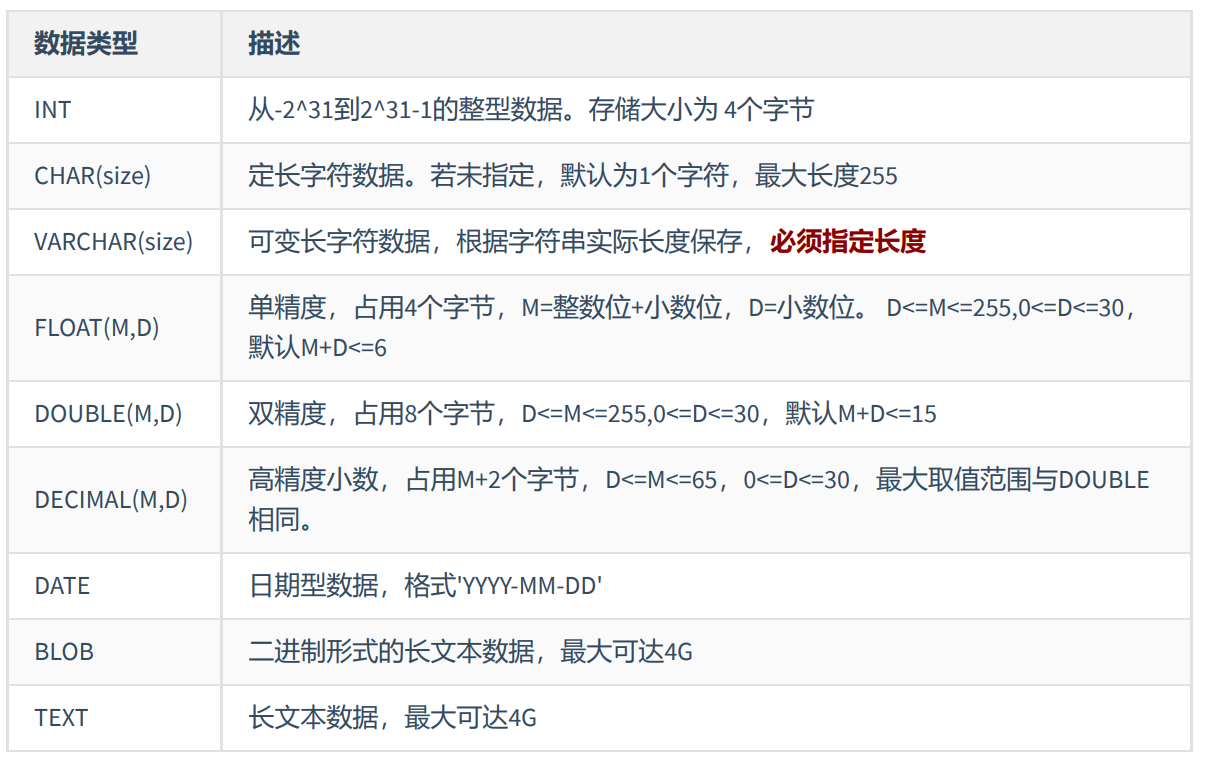
MySQL在执行建表语句时,将id字段的类型默认设置为int(11),这里的11是指int类型的显示宽度,默认的显示宽度为11。
使用建议:
任何字段如果为非负数,应该加unsigned
整数:int
小数:decimal,如果存储的数据范围超过,建议将数据拆成整数和小数并分开存储。
日期时间:datetime
字符串:
- 如果存储的字符串长度几乎相等,使用char定长字符串类型;
- varchar不预先分配存储空间,长度不要超过5000,如果超过,应该定义为text,并独立出来一张表,用主键来对应,避免影响其他字段索引效率。
变量
系统变量
变量由系统定义,属于服务器层面。启动MySQL服务,生成MySQL服务实例期间, MySQL将为MySQL服务器内存中的系统变量赋值,这些系统变量定义了当前MySQL服务实例的属性、特征。
系统变量的值大都是 编译MySQL时参数的默认值,或配置文件(如 .ini)中的参数值。
global 全局系统变量,也简称全局变量
session 会话系统变量,也可称 local变量,
如果没有加global关键字,则默认为会话级别。
静态变量属于特殊的全局系统变量。
每个客户机功连接MySQL服务器后,都会产生与之对应的会话。
会话期间,MySQL服务实例 会在MySQL服务器内存中生成与该会话对应的会话系统变量,这些会话系统变量的初始值是全局系统变量值的复制。
- 全局系统变量针对于所有会话(连接)有效,但不能 跨重启 (即重启服务);
- 修改会话变量仅影响当前的会话/连接, 不会影响其他会话的同一会话系统变量的值。
- 修改全局系统变量的值会导致 同一会话系统的其他会话 的全局系统变量改变。
查看系统变量:
1 | # 查看所有全局变量 |
修改系统变量的值:
方法1:修改MySQL配置文件,继而修改MySQL系统变量的值(需要重启MySQL服务)
方法2:使用 set命令 重新设置系统变量的值
1 | #为某个系统变量赋值 |
MySQL8.0新特性:全局变量的持久化
使用 set global 语句设置的变量值只会 临时生效,数据库重启后又变成默认值。
而使用 set persist 命令,会将该命令的配置保存到数据目录下的musql-auto.cnf文件中,下次数据库重启时会读取该文件,用其中的配置来覆盖默认的配置文件。
1 | -- 例:设服务器最大连接数为1000 |
用户变量
mysql中的用户变量以 一个 @ 开头,分为 会话用户变量和局部变量。
- 会话用户变量:作用域和会话变量一样,只对 当前连接 会话有效。
- 局部变量:只在 BEGIN 和 END 语句块中有效。局部变量只能在 存储过程和函数 中使用。
| 作用域 | 定义位置 | 语法 | |
|---|---|---|---|
| 会话用户变量 | 当前会话 | 会话的任何地方 | 加@符号,不用指定类型 |
| 局部变量 | 定义它的begin end中 | begin end的第一句话 | 一般不加@,需指定类型 |
1 | # 会话用户变量的定义 |
1 | # 局部变量 的定义 declare只能放在begin...end中的第一句 |
处理错误
定义条件:事先定义程序执行过程中可能遇到的问题;
处理程序:定义了在遇到问题时应当采取的处理方式,并且保证存储过程或函数在遇到警告或错误时能继续执行。——增强了处理问题的能力,避免程序异常停止运行。
定义条件和处理程序在存储过程、存储函数中都是支持的。
在存储过程中未定义条件和处理程序,且当存储过程中执行的SQL语句报错时,MySQL数据库会抛出错误,并退出当前SQL逻辑, 不再向下继续执行。
定义条件
定义条件就是给MySQL中的错误码 命名,它将一个错误名字和指定的错误条件关联起来。这个名字随后被用在定义处理程序的 declare handler 语句中。
语法格式:
1 | declare 错误名称 condition for 错误码(或错误条件) |
错误码的说明:
MySQL_error_code 和 sqlstate_value 都可以表示MySQL的错误。
- MySQL_error_code是数值类型错误代码。
- sqlstate_value是长度为5的字符串类型错误代码。
例如:
在ERROR 1418 (HY000)中,1418是MySQL_error_code,’HY000’是sqlstate_value。
在ERROR 1142(42000)中,1142是MySQL_error_code,’42000’是sqlstate_value。
1 | # 例: 给违反非空约束的错误类型“ERROR 1048(23000)”定义 |
定义处理程序
为SQL执行过程中发生的某种类型的错误定义特殊的处理程序。
语法格式:
1 | DECLARE 处理方式 HANDLER FOR 错误类型 处理语句 |
处理方式有三种:continue,exit,undo
- CONTINUE:遇到错误不处理,继续执行;
- EXIT:遇到错误马上退出;
- UNDO:遇到错误后撤回之前的操作,MySQL中暂时不支持。
错误类型:
- SQLSTATE ‘字符串错误码’ :表示长度为5的sqlstate_value类型的错误代码;
- MySQL_error_code :匹配数值类型错误代码;
- 错误名称 :表示DECLARE … CONDITION定义的错误条件名称。
- SQLWARNING :匹配所有以01开头的SQLSTATE错误代码;
- NOT FOUND :匹配所有以02开头的SQLSTATE错误代码;
- SQLEXCEPTION :匹配所有没有被SQLWARNING或NOT FOUND捕获的SQLSTATE错误代码;
处理语句:可以是“set 变量 = 值”这样简单的语句,也可以是使用“begin….end”的复合语句。
1 | # 定义处理程序的几种方式举例: |
示例:
创建一个名称为“InsertDataWithCondition”的存储过程:在存储过程中,定义处理程序,捕获sqlstate_value值,当遇到sqlstate_value值为23000(重复条目错误)时,执行EXIT操 作,并且将@proc_value的值设置为-1。
1 | DELIMITER // |
流程控制与游标
流程控制:控制存储过程中sql语句的执行顺序。分别有三大类:顺序结构,分支结构,循环结构。
流程控制语句(只能用于存储程序):
- 条件判断语句:if 和 case语句
- 循环语句:loop,while,repeat语句
- 跳转语句:iterate 和 leave语句
分支结构—— IF
1 | # if |
分支结构——CASE
1 | # case |
循环结构——LOOP
LOOP内的语句一直重复执行直到循环被退出(使用LEAVE子句)。
1 | [loop_label:] LOOP |
示例:
涨工资—— 声明存储过程 “update_salary_loop()”,声明OUT参数num,输出循环次数。存储过程中实现循环给大家涨薪,薪资涨为 原来的1.1倍。直到全公司的平均薪资达到12000结束。并统计循环次数。
1 | DELIMITER // |
循环结构——WHILE
WHILE语句创建一个带条件判断的循环过程。WHILE在执行语句执行时,先对指定的表达式进行判断,如 果为真,就执行循环内的语句,否则退出循环。
1 | [while_label:] WHILE 循环条件 DO |
循环结构——REPEAT
REPEAT语句创建一个带条件判断的循环过程。与WHILE循环不同的是,REPEAT 循环首先会执行一次循环,然后在 UNTIL 中进行表达式的判断,如果满足条件就退出 。
1 | [repeat_label:] REPEAT |
三种循环的对比:
都可以省略名称,但如果循环中添加了循环控制语句(LEAVE或ITERATE)则必须添加名称。
LOOP:一般用于实现简单的”死”循环
WHILE:先判断后执行
REPEAT:先执行后判断,无条件至少执行一次
跳转语句——LEAVE
LEAVE语句:可以用在循环语句内,或者以 BEGIN 和 END 包裹起来的程序体内,表示跳出循环或者跳出 程序体的操作。(类似于编程语言的break)
1 | LEAVE 标记名 |
跳转语句——ITERATE
iterate语句只能用在循环语句(LOOP、REPEAT和WHILE语句)内,表示重新开始循环,将执行顺序转到语句段开头处。(类似于编程语言的continue)
1 | ITERATE label |
游标
游标提供一种灵活的操作方式,能够对结果集中的每一条记录 进行定位,并对指向的记录中的数据进行操作的数据结构。
在SQL中,游标是一种临时的数据库对象,可以指向存储在数据库表中的数据行指针。即充当了指针的作用。
游标让 面向集合的SQL语言有了面向过程开发的能力。
一些性能问题:
游标可以在存储程序中使用,效率高,程序也更加简洁,比在应用层实现相同的功能要好。
但在使用游标的过程中,会对数据行进行 加锁 ,这样在业务并发量大的时候,不仅会影响业务之间的效率,还会消耗系统资源 ,造成内存不足,这是因为游标是在内存中进 行的处理。
所以要在用完后及时关闭,这样才能提高系统整体效率。
使用步骤:
游标必须在 声明处理程序之前 被声明,且 变量和条件必须在声明游标/处理程序之前 被声明。
第一步:声明游标
1
2
3
4
5# 适用于MySQL,SQL Server,DB2 和 MariaDB
DECLARE 游标名 CURSOR FOR 查询语句/结果集
# 适用于Oricle,PostgreSQL
DECLARE 有标明 CURSOR IS 查询语句/结果集第二步:打开游标
1
OPEN 游标名
打开游标时, SELECT 语句的查询结果集就会送到游标工作区,为后面游标的 逐条读取 结果集中的记录做准备。
第三步:使用游标(从游标中取得数据)
1
FETCH 游标名 INTO 变量名[,变量名...]
将游标读取到的行数据 保存到变量名中,然后指针指向下一行。
查询结果集的字段数,必须与into后的变量数一致。
第四步:关闭游标
1
CLOSE 游标名
游标会占用系统资源,不关闭的话,会保持到存储过程结束。
示例:
创建存储过程“get_count_by_limit_total_salary()”,声明IN参数 limit_total_salary,DOUBLE类型;声明OUT参数total_count,INT类型。函数的功能可以实现累加薪资最高的几个员工的薪资值,直到薪资总和 达到limit_total_salary参数的值,返回累加的人数给total_count。
1 | DELIMITER // |
触发器
触发器是由事件 来触发某个操作,这些事件包括 INSERT 、 UPDATE 、 DELETE 事件。
如果定义了触发程序,当数据库执行这些语句时候,就相当于事件发生 了,就会 自动 激发触发器执行相应的操作。
当对数据表中的数据执行插入、更新和删除操作,需要自动执行一些数据库逻辑时,可以使用触发器来 实现。
优点:
- 可以确保数据的完整性;—— 比如一张表的修改会影响其他表的数据,则使用触发器就可以同步多个表了。
- 可以记录操作日志;—— 利用触发器,可以具体记录什么时间发生了什么。
- 操作数据前对数据进行合法性检查;
缺点:
- 可读性差;—— 因为 触发器存储在数据库中,且由事件驱动,这意味着触发器可以不受应用层的控制。使得触发器发生错误时可能难以发现。
- 相关数据的变更,可能导致触发器出错;—— 特别是表结构的变更,都可能导致触发器的出错。
创建:
1 | CREATE TRIGGER 触发器名称 |
示例:
定义触发器“salary_check_trigger”,基于员表“employees”的INSERT事件,在INSERT之前检查 将要添加的新员工薪资是否大于他领导的薪资,如果大于领导薪资,则报sqlstate_value为’HY000’的错 误,从而使得添加失败。
1 | DELIMITER // |
在触发器的执行语句块中,可以使用 NEW. 指代被监听的表发生添加或修改的那条记录;
要自定义错误,则使用以下格式:
查看:
1 | -- 语句结尾不加;加\G,数据显示较清晰直观,但SQLyog不识别 |
删除:
触发器也是数据库对象,所以也用DROP语句:
1 | DROP TRIGGER IF EXISTS 触发器名称; |
JDBC
JDBC是java提供的一套用于数据库操作的接口API,不同的数据库厂商会针对这套接口,提供不同实现。
JDBC 为访问不同的数据库提供了统一的接口,为使用者屏蔽了细节问题(JDBC统一和规范了应用程序和数据库的连接,执行SQL语句,并得到返回结果等操作);
使用JDBC可以连接任何提供了JDBC驱动程序的数据库系。
JDBC程序编写步骤
- 注册驱动 – 加载Driver类
- 获取连接 – 得到Connection
- 执行增删改查 – 发送SQL给mysql执行
- 释放资源 – 关闭相关连接
1 | public static void main(String[] args) throws SQLException { |
获取数据库连接
获取数据库连接的5种方法,常用方法4,5:
1 | //方式 1 |
1 | //方式 2 |
1 | //方式 3 使用 DriverManager 替代 driver 进行统一管理 |
1 | //方式 4: 使用 Class.forName 自动完成注册驱动,简化代码 |
1 | //方式 5 , 在方式 4 的基础上改进,增加配置文件,让连接 mysql 更加灵活 |
JDBC API
DriverManger
驱动管理类
getConnection(url, user, pwd) : 获取到连接
Connection 接口
createStatement() :创建Statement对象
Statement
Statement对象用于执行静态SQL语句并返回其生成的结果的对象;
但使用Statement存在SQL注入的风险:SQL注入是利用利用某些系统没有对用户输入数据进行充分检查,而在输入数据中注入非法的SQL语句,恶意攻击数据库;
1 | SELECT * FROM admin |
推荐使用PreparedStatement取代Statement,可以防止SQL注入;
方法:
executeUpdate(sql) :执行dml语句,返回影响的行数;
**executeQuery(sql)**:执行查询,返回ResultSet对象;
**execute(sql)**:执行任意的sql,返回布尔值;
Statement使用:
1 | public void Statement01() throws Exception { |
PreparedStatement
PreparedStatement 执行的SQL语句中的参数用问号(?)来表示;
调用 PreparedStatement 对象的 setXxx() 方法来设置这些参数, .setXxx() 方法有两个参数,第一个参数是SQL语句中的参数的索引(从1开始,第几个问号),第二个参数是设置的 SQL语句中的参数的值;
方法:
executeUpdate(sql) :执行dml语句,返回影响的行数;
**executeQuery(sql)**:执行查询,返回ResultSet对象;
**execute(sql)**:执行任意的sql,返回布尔值;
**setXxx(占位符索引,占位符的值)**:将指定位置的参数设置为给定值(解决了SQL注入)
**setObject(占位符索引,占位符的值)**:将指定位置的参数设置为给定的对象
PreparedStatement使用:
1 | public void preparedStatement() throws Exception { |
ResultSet
ResultSet是结果集,表示数据库结果集的数据表,通常通过执行查询数据库的语句生成;
ResultSet对象保持一个光标指向当前的数据行,最初,光标位于第一行之前,next方法将光标移到下一行,且在ResultSet对象中没有更多行时返回false,因此可以在while循环中用来遍历结果集
方法:
**next()**:向下移动一行,如果没有下一行,返回false;
**previous()**:向上移动一行,如果没有上一行,返回false;
getXxx( 列的索引 / 列名) :返回对应列的值,接收类型是Xxx
getObject(列的索引/ 列名) :返回索引对应的值,接收类型为Object
ResultSet使用:
1 | public void ResultSet01() throws Exception { |
JDBCUtils(封装)
在jdbc操作中,获取连接和释放资源 是经常使用到的,可以将其封装到 JDBC连接的工具类JDBCUtils中。
JDBCUtils 实现示例 以及 使用 :
1 | //JDBCUtils实现实例: |
使用Druid实现JDBCUtils
1 | //用Druid实现JDBCUtils |
事务
JDBC程序中当一个Connection对象创建时,默认是自动提交事务的(语句执行成功,就会向数据库自动提交,而不能回滚)。
JDBC 使用事务:
- 使用Connection的setAutoCommit (false) 可以取消自动提交事务;
- 在所有sql语句成功执行后,调用Connection的commit() 方法提交事务;
- 当其中某个操作失败或出现异常,调用Connection的rollback() 方法回滚事务;
在异常捕获中,可以将 setAutoCommit (false) 方法和 commit() 方法放在try语句块中,将 rollback() 方法放在catch中,当出现异常时,就可以进行回滚
批处理
当需要成批插入或者更新记录时,可以采用Java的批量更新机制,这一机制允许多条语句一次性提交给数据库批量处理。
JDBC连接MySQL时,如果要使用批处理功能,要在url中加参数: rewriteBatchedStatements=true
批处理往往和PreparedStatement搭配使用,可以减少编译次数,运行次数,提高效率;
方法:
addBatch() :添加需要批量处理的SQL语句或参数;
executeBatch() :执行批量处理语句;
clearBatch() :清空批处理包的语句;
1 | public void batch() throws Exception { |
数据库连接池
传统的 JDBC数据库使用DriverManager来获取连接的弊端:
- 每次向数据库建立连接都要将Connection加载到内存中,再验证IP地址,用户名和密码(0.05~1s)。
- 频繁的进行数据库连接操作将占用很多的系统资源,容易造成服务器崩溃。
- 每一次数据库连接,使用完后都得断开,如果程序出现异常而未能关闭,将导致数据库内存泄漏。
- 不能控制连接的方式,不能控制创建的连接数量,如果连接过多,会导致内存泄漏,MySQL崩溃。
因此有了数据库连接池技术(connection pool)。
JDBC的数据库连接池使用javax.sql.DataSource来表示, DataSource只是一个接口,该接口通常由第三方提供实现;
- C3P0 数据库连接池:速度相对较慢,稳定性不错;
- DBCP 数据库连接池:速度较C3P0快,但不稳定;
- Proxool 数据库连接池:有监控连接池状态的功能,稳定性较C3P0差一些;
- BoneCp 数据库连接池:速度快;
- **Druid(德鲁伊)**是阿里提供的数据库连接池,集DBCP,C3P0,Proxool有点于一身的数据库连接池;
C3P0
1 | //方式 1: 相关参数,在程序中指定 user, url , password 等 |
Druid
1 | public void testDruid() throws Exception { |
DBUtils
DBUtils是对JDBC的封装,使用dbutils可以极大简化jdbc的编码的工作量。
DBUtils类:
- QueryRunner类:该类封装了SQL的执行,是线程安全的。可以实现 增,删,改,查,批处理;
- ResultSetHandler接口:该接口用于处理java.sql.ResultSet,将数据按要求转换为另一种形式;
- ArrayHandler:把结果集中的第一行转成对象数组;
- ArrayListHandler:把结果集中的每一行数据都转成一个数组,再存放到List中;
- BeanHandler:把结果集中的第一行数据封装到一个对应的 JavaBean实例中;
- BeanListHandler:把结果集中的每一行数据封装到一个对应的 JavaBean实例中,存放到List里;
- ColumnListHandler:将结果集中某一列的数据存放到List中;
- KeyedHandler(name):将结果集中的每一行数据都封装到Map里,再把这些map再存到一个map里,其key为指定的key;
- MapHandler:将结果集中的第一行数据封装到一个Map里,key是列名,value就是对应的值;
- MapListHandler:将结果集中的每一行数据都封装到一个Map里,再存放到list
DBUtils和Druid搭配使用例子:
1 | class DBUtils_USE { |
DAO
DAO:data access object 数据访问对象
这样的通用类,称为BasicDao,是专门和数据库交互的,即完成对数据库(表)的crud操作;
编写DAO的例子:
1 | class BasicDAO<T> { //泛型指定具体类型 |
架构 TODO
MySQL的数据目录
MySQL数据库文件的存放路径:/var/lib/mysql/
相关命令目录:/usr/bin 和 /usr/sbin。
配置文件目录:/usr/share/mysql-8.0(命令及配置文件),/etc/mysql(如my.cnf)
数据库和文件系统的关系:
MySQL有4个自带的系统数据库:mysql,information_schema,performance_schema,sys
mysql
MySQL 系统自带的核心数据库,它存储了MySQL的用户账户和权限信息,一些存储过程、事件的定义信息,一些运行过程中产生的日志信息,一些帮助信息以及时区信息等。
information_schema
保存mysql服务器维护其他所有数据库的信息,比如有哪些表,哪些触发器等等,是一些描述性信息,称之为元数据。
information_schema还提供了一些以innodb_sys开头的表,用于表示内部系统表。
performance_schema
保存MySQL服务器运行过程中的一些状态信息,可以用来 监控 MySQL 服务的各类性能指标 。包括统计最近执行了哪些语句,在执行过程的每个阶段都 花费了多长时间,内存的使用情况等信息。
sys
这个数据库主要是通过 视图 的形式把 information_schema 和 performance_schema 结合起来,帮助系统管理员和开发人员监控 MySQL 的技术性能。
表在文件系统中的表示:
InnoDB存储引擎模式:
表结构:
为了保存表结构, InnoDB 在 数据目录 下对应的数据库子目录下创建了一个专门用于
描述表结构的文件,文件名是这样:表名.frm表的数据和索引:
系统表空间(5.6.6版本以前)
默认情况下,InnoDB会在数据目录下创建一个名为 ibdata1 、大小为 12M 的文件,这个文件就是对应 的 系统表空间 在文件系统上的表示。它是一个自扩展文件。
独立表空间(5.6.6版本以后)
InnoDB 为每一个表建立一个独立表空间 ,表现为:在该表所属数据库对应的子目录下创建一个表示该独立表空间的文件,文件名和表名相同,为:表名.ibd
MyISAM存储引擎模式:
表结构:
(同InnoDB一样)
表数据和索引:
在MyISAM中的索引全部都是 二级索引 ,该存储引擎的 数据和索引是分开存放 的。所以在文件系统中也是 使用不同的文件来存储数据文件和索引文件,同时表数据都存放在对应的数据库子目录下。
MyISAM存储引擎 会在 表所在数据库对应的 atguigu 目录下 创建这三个文件:
1
2
3表名.frm 存储表结构
表名.MYD 存储数据 (MYData)
表名.MYI 存储索引 (MYIndex)
用户与权限管理
逻辑架构
存储引擎
索引调优 TODO
索引的数据结构
InnoDB数据存储结构
索引的创建与设计原则
性能分析工具的使用
索引优化与查询优化
数据库的设计规范
数据库其他调优策略
事务 TODO
基础知识
MySQL事务日志
锁
多版本并发控制(MVCC)
日志与备份 TODO
mysql优化—作业
performance_schema 通过监视Server的事件来实现监视其内部执行情况,“事件”就是在Server内部活动中所做的任何事情以及对应的时间消耗,利用这些信息来判断Server中的相关资源被消耗在哪里。
performance_schema配置:
performance_schema服务器性能:
资源
- 磁盘文件
- 表I/O
- 表锁
- 资源消耗和等待
事件
- SQL执行:解析,操作,排序
- 函数调用
- 操作系统的等待
检测
- 检测点
- 收集事件
- 内存中存储
- select语句查询
记录表
语句事件记录表
- event_statements_current —— 当前语句事件表
- events_statements_history —— 历史语句事件表
- events_statements_history_long —— 长语句历史事件表
- events_stages_sumary_* —— 聚合后的摘要表(可以根据account,host,thread,user,global进行细分)
等待事件记录表
- events_wait_current —— 当前等待事件,每个线程只保留一条记录,工作结束后不再记录。(主要字段有:THREAD_ID, EVENT_ID, EVENT_NAME, SOURCE 表示该代码在哪个源文件及其行号, TIMER_WAIT 表示总的事件开销)
- events_wait_history —— 历史等待事件,记录每个线程已经执行完成的事件(10条,超过覆盖)。(主要字段有:THREAD_ID,EVENT_ID,EVENT_NAME,TIMER_WAIT)
- events_wait_history_long —— 记录所有线程的事件信息(10000条,超过覆盖)
- event_wait_summary_by_*
阶段事件记录表
- events_stage_current
- events_stage_history
- events_stage_history_long
- events_stage_summary_by_*
事务事件记录表
- events_transaction_current
- events_transaction_history
- events_transaction_history_long
- events_transaction_summary_by_*
监视文件系统层调用的表
file_instances —— 列出了文件I/O操作及其关联文件名。
isntance表记录了哪些类型的对象会被检测。这些对象在被Server使用时,在该表中将会长生一条记录事件。
file_summary_by_event_name
file_summary_by_instance —— 根据文件对象实例的汇总摘要
监视内存使用的表
- memory_summary_by_*_by_event_name —— (*处要按account,host,thread,user,global进行细分,如memory_summary_by_account_by_event_name )
动态对performance_schema配置的配置表(只支持修改和查询,不支持增删)
- setup_actors —— 表用于配置是否为新的前台Server线程(与客户端连接相关联的线程)启用监视和历史事件日志记录。
- setup_consumers —— 包含consumers可配置列表项,对该表的修改会立即影响监控
- setup_instruments —— 表示哪些事件支持被收集。
- setup_objects —— 控制performance_schema是否监控特定对象
- setup_timers —— 记录了当前使用的事件计时器信息
