java
一些用法
2. HashMap和Hashtable
相同点:
hashmap和Hashtable都实现了map、Cloneable(可克隆)、Serializable(可序列化)这三个接口
不同点:
底层数据结构不同:jdk1.7底层都是数组+链表,但jdk1.8 HashMap加入了红黑树
Hashtable 是不允许键或值为 null 的,HashMap 的键值则都可以为 null。
添加key-value的hash值算法不同:HashMap添加元素时,是使用自定义的哈希算法,而HashTable是直接采用key的hashCode()
实现方式不同:Hashtable 继承的是 Dictionary类,而 HashMap 继承的是 AbstractMap 类。初始化容量不同:HashMap 的初始容量为:16,Hashtable 初始容量为:11,两者的负载因子默认都是:0.75。
- 扩容机制不同:当已用容量 > 总容量 * 负载因子时,HashMap 扩容规则为当前容量翻倍,Hashtable 扩容规则为当前容量翻倍 +1。
支持的遍历种类不同:HashMap只支持Iterator遍历,而HashTable支持Iterator和Enumeration两种方式遍历。
迭代器不同:HashMap的迭代器(Iterator)是fail-fast迭代器,而Hashtable的enumerator迭代器不是fail-fast的。所以当有其它线程改变了HashMap的结构(增加或者移除元素),将会抛出ConcurrentModificationException,但迭代器本身的remove()方法移除元素则不会抛出ConcurrentModificationException异常。但这并不是一个一定发生的行为,要看JVM。而Hashtable 则不会。
部分API不同:HashMap不支持contains(Object value)方法,没有重写toString()方法,而HashTable支持contains(Object value)方法,而且重写了toString()方法
同步性不同: Hashtable是同步(synchronized)的,适用于多线程环境,
而hashmap不是同步的,适用于单线程环境。多个线程可以共享一个Hashtable;而如果没有正确的同步的话,多个线程是不能共享HashMap的。
由于Hashtable是线程安全的也是synchronized,所以在单线程环境下它比HashMap要慢。如果你不需要同步,只需要单一线程,那么使用HashMap性能要好过Hashtable。sdfla
3.Arrays.asList
List 是一种很有用的数据结构,如果需要将一个数组转换为 List 以便进行更丰富的操作的话,可以这么实现:
1 | String[] myArray = { "Apple", "Banana", "Orange" }; |
( new 一个 java.util.ArrayList ,然后再把 asList 方法的返回值作为构造器的参数传入,最后得到的 myList 是动态扩容的了。)
注意:
- 不要将 原生数据类型的数组 作为参数
1 | int[] myArray = { 1, 2, 3 }; |
上述代码,遍历mylist的话,会得到一个带有hashCode 的对象。
(当传入一个原生数据类型数组时,asList 的真正得到的参数就不是数组中的元素,而是数组对象本身)
如果需要将一个整型数组转换为 List,那么就将数组的类型声明为 Integer 而不是 int。例:
1 | Integer[] myArray = { 1, 2, 3 }; |
asList返回一个由指定数组生成的固定大小的List;
如果不new一个ArrayList,那么得到的list不能修改其大小,且Arrays的内部类ArrayList没有重写add等方法,用add会抛出异常
1 | String[] myArray = { "Apple", "Banana", "Orange" }; |
4.可变参数
java允许将同一个类中的多个同名,同功能但参数个数不同的方法,封装成一个方法,即通过可变参数实现。
1 | //int... 表示接受的是可变参数,类型是int, 即可接受多个int;可变参数的实参可以为0到任意多个; |
5.字符
1.字符分割
使用了 split(string) 方法通过指定分隔符将字符串分割为数组:
1 | public class Test { |
1 | Hello |
使用 StringTokennizer 设置不同分隔符来分隔字符串,默认的分隔符是:空格、制表符(\t)、换行符(\n)、回车符(\r)。0
1 | public class Test { |
2.字符大小写
toUpperCase() 方法将字符串从小写转为大写
tolowerCase() 方法将字符串从大写转为小写
1 | String str = "string runoob"; |
3.测试两个字符串区域是否相等
regionMatches() 方法测试两个字符串区域是否相等:
1 | String str1 = "Welcome to Microsoft"; |
1 | str1.regionMatches(11, str2, 12, 9) 表示将 str1 字符串从第11个字符"M"开始和 str2 字符串的第12个字符"M"开始逐个比较,共比较 9 对字符,由于字符串区分大小写,所以结果为false。 |
6.数组
获取最大
通过 Collections 类的 Collections.max() 和 Collections.min() 方法来查找数组中的最大和最小值:
1 | Integer[] numbers = { 8, 2, 7, 1, 4, 9, 5}; |
数组合并
使用List类的Arrays.toString方法和list.Addall(list.Addall(array1.aslist(array2))方法将两个数组合并
1 | String a[] = { "A", "E", "I" }; |
数组填充
通过 Java Util 类的 Arrays.fill(arrayname,value) 方法和Arrays.fill(arrayname ,starting index ,ending index ,value) 方法向数组中填充元素
1 | int array[] = new int[6]; |
数组扩容
1 | String[] names = new String[] { "A", "B", "C" }; |
数组差集,交集
用removeAll () 方法来计算两个数组的差集:
1 | ArrayList objArray = new ArrayList(); |
用 retainAll () 方法来计算两个数组的交集:
1 | ArrayList objArray = new ArrayList(); |
7.时间处理
当前时间及格式化
用simpleDateFormat类的format(date):
1 | //创建一个Date对象,获取当前时间 |
1 | 今天是 2019 年 10 月 15 日 星期一 09 点 26 分 23 秒 |
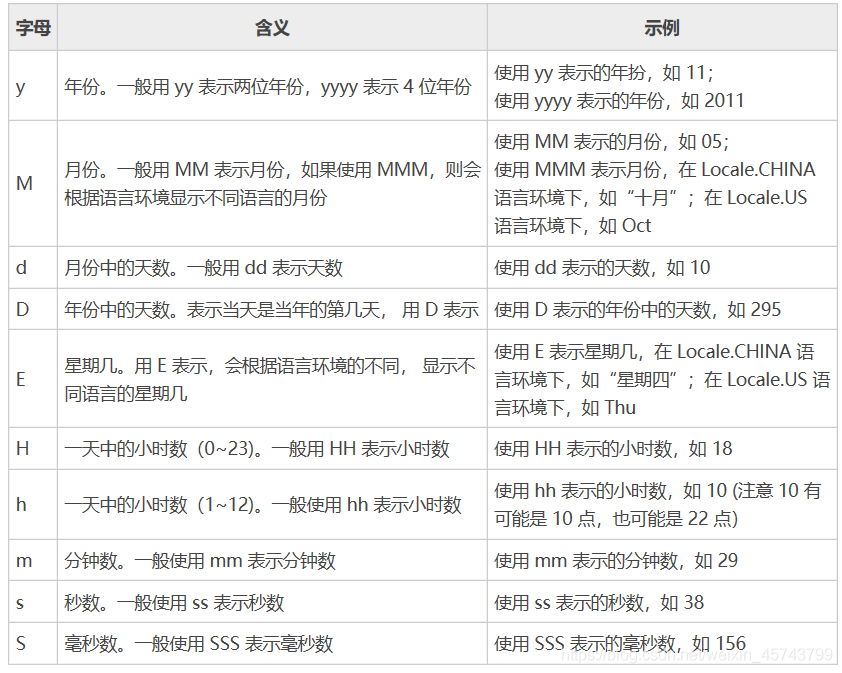
SimpDateFormat自定义格式中常用字母及含义
获取年份月份等
用Calendar类:
1 | Calendar cal = Calendar.getInstance(); |
8.方法
instanceof关键字
测试它左边的对象是否是它右边的类的实例,返回 boolean 的数据类型。
1 | Object o = new ArrayList(); |
1 | 对象是 java.util.ArrayList 类的实例 |
标签(Label)
1 | OUTER: //定标签义,可以是任意标识符(一般放在迭代语句之前) |
Varargs可变参数
在一个形参的”类型”与”参数名”之间加上三个连续的”.”,就可以让它和不确定个实参相匹配。
本质上和字符串一样
1 | static int sumvarargs(int... intArrays){ |
Java练习
网上练习
JDK:java开发核心组件;JRE:java运行环境;JVM:java虚拟机
JDK,JRE,JVM的关系:
JDK = JRE + Java的开发工具(javac.exe,java.exe,javadoc.exe)
JRE = JVM + Java核心类库
javac(java语言编译器)用于编译java源文件。
JDK工具中javadoc用于生成java文档,格式为HTML。
JVM运行于操作系统之上,依赖于操作系统;能够直接运行java字节码文件。
Java HotSpot是一种热编译技术,在运行Java代码时会被使用,只对程序的部分字节码进行优化。
环境变量PATH中包含多个路径时,路径之间用;(分号)分开。
CLASSPATH中的“ . ” 表示当前目录。
JVM执行一个Java类时,大致流程为:
装载类—>校验类—>执行类中的代码
如果类的成员的访问权限设置为默认,则该成员被同一包中的类访问;
类具有封装性,但可以通过类的公共接口访问类中的数据;
super指的是当前对象的父类对象的内存地址;
尝试对null对象进行操作时,会产生NullPointerException类型的异常;
覆盖(重写)只能发生在父类与子类之间;
重载可以发生在同一个类中;
this和super不能用在main()方法中;
每一个Unicode码占用16个比特位;
封装:对外隐藏内部实现细节,增强程序的安全性;
自定义异常必须继承Exception,可以继承自Error;
使用JDBC(Java Data Base Connectivity)连接数据库的顺序:
导入驱动包 ——加载驱动——建立数据库的连接——发送并处理SQL语句——关闭连接
java分了5片内存:寄存器,本地方法区,方法区,栈,堆。
栈:存储的都是局部变量 ( 函数中定义的变量,函数上的参数,语句中的变量 );栈的存取速度要比堆快,次于CPU寄存器。 只要数据运算完成所在的区域结束,该数据就会被释放。
堆:用于存储数组和对象,也就是实体。
1:每一个实体都有内存首地址值。
2:堆内存中的变量都有默认初始化值。因为数据类型不同,值也不一样。
3:垃圾回收的主要地方。
作业练习
一、java入门
java诞生:1995年5月;java特点:简单性,面向对象,安全性,跨平台性,支持多线程,分部性;
path环境变量的作用:使用jdk命令 / 在任何目录下都可以使用javac和java命令;
java程序运行需要经过编译和运行两个步骤:编译器执行 .java文件,编译生成 .class的字节码文件,而Java虚拟机运行 .class文件;
java命令用于运行编译后的 .class文件,不需要文件后缀名;
JDK中可执行程序都放在bin目录下:Java编译器javac.exe 和 Java运行工具 java.exe;
一个java程序不一定要有main方法,需要独立运行的程序才要有main方法。
二、java编程基础
- 在Java中,浮点型数会被默认为double类型,所以给float赋值浮点型数据时,应该加F/f,如 float = 1F;
- 文档注释 格式: /** */
三、面向对象
- public,static不能修饰局部变量;
- 构造方法不能被继承;
- 面向对象的三大特征:封装,继承,多态;
- this关键字的作用:(简答题)
- this调用本类中的属性,即成员变量;
- this调用本类的其他方法;
- this调用本类的其他构造方法,调用时要放在构造方法的首行;
- 成员变量和局部变量的区别:
- 定义位置的区别:成员变量定义与方法之外,类之内;局部变量定义在方法之内;
- 生命周期:成员变量随着对象的创建而产生,随着对象的消失而消失;局部变量随着方法内的创建语句而产生,在代码运行至自己的作用域外即消失;
- 存储位置的区别:成员变量存储在堆中,局部变量存储在栈中;
- 初始值不同:成员变量有默认的初始值;局部变量没有,需要初始化才能使用;
- 构造方法和普通成员方法的不同:
- 构造方法与类名相同;
- 构造方法前没有返回类型的声明;
- 构造方法因为没有返回类型,所以不能返回任何值,但可以使用return来返回;
- 面向对象的三特征:
- 封装:将对象的属性和行为封装起来,不需要让外界知道具体的实现细节;
- 继承:描述类与类之间的关系,通过继承,可以在无需重新编写原有类的情况下,对原有类进行功能拓展;
- 多态:允许程序中出现重名现象,使同种类的多个对象,在接收到同一个消息时能产生不同反应和效果;(前提是有一个父类,多个子类)
- 局部内部类只可以被final修饰,且只能访问被final修饰的局部变量;
- super和this不能同时存在与同一个构造方法中;
IDEA使用
新建
src(source源文件)—package(包)—-class(类)
模板
IDEA 中代码模板位置:setting - Editor - Live Templates / postfix Completion
常用模板:
psvm :
1
2
3public static void main(String[] args){
}sout
快捷键
删除当前行:ctrl + y
复制当前行:ctrl + d
补全代码:alt + /
添加取消注释:ctrl + /
生成方法:alt + insert
生成环绕方式:ctrl + alt + t (即 if … else ,do…while,try…catch 之类的)
查看类的的层级关系:ctrl + H
定位方法:ctrl + B
自动分配变量名:alt + 回车 / ctrl + alt + v / 在后面加 .var
显示所有快捷键:ctrl + j
显示类或接口的继承:ctrl + h; 显示类图:ctrl + alt + u
显示类或接口的所有方法: alt + 7 或点击右下角的“结构”
从接口方法跳转到具体的实现方法: ctrl + alt + b
显示当前类/接口的所有方法名:ctrl + f12
封装一段代码:选取一段代码,按 ctrl+alt+m 即可封装为方法
跳转到子类: ctrl + alt + b
使用单元测试工具 JUnit 来运行调试 单个方法:
1 | //在方法上加上@Test,按Alt+Enter,点”将JUnit5加入到类路径中",之后方法右边会右绿色小箭头可以使用,之后在这个类中要使用JUnit5,只要加上@Test即可 |
| 分类 | 功能点 | Eclipse快捷键 | IDEA快捷键 |
|---|---|---|---|
| 搜索 | 搜索文本 | Ctrl + F | Ctrl + FCtrl + R 查找替换 Alt + P/A 逐个/全部替换 Alt + F3 查找当前选中词 |
| 继续搜索 | Ctrl + K 向前 Ctrl + Shift + K 向后 | F3 Shift + F3 | |
| 搜索方法 | Ctrl + O | Ctrl + F12 | |
| 搜索类 | Ctrl + Shift + T | Ctrl + N | |
| 搜索文件 | Ctrl + Shift + T | Ctrl + Shift + N 这两个都支持简单的正则表达式,还支持直接按大写字母的缩略, 例如:查找JsonTranscoder,只需要输入JT | |
| 搜索所有引用处 | Ctrl + Alt + H | Alt + F7 | |
| 搜索所有文本出现的位置 | Ctrl + H | Ctrl + Shift + F | |
| 编辑 | 自动代码补全 | Alt + / | Ctrl + J |
| 自动代码生成 | Alt + Insert | ||
| 快速修复错误 | Ctrl + 1 | Alt + Enter | |
| 删除当前行 | Ctrl + D | Ctrl + X | |
| 复制到下一行 | Ctrl + D | ||
| 注释/取消注释 | Ctrl + / | Ctrl + / | |
| 选中当前字 | Ctrl + W | ||
| 补全当前行 | Ctrl + Shift + Enter神器,补全当前行,最常用的场景时补全当前行后的;号,并将光标定位到下一行 | ||
| 调出最近复制的N份内容 | Ctrl + Shift + V | ||
| 查看最近编辑的文件 | Ctrl + E | ||
| 对比最近修改 | Alt + Shift + C | ||
| 格式化代码 | Ctrl + Shift + F | Ctrl + Alt + L | |
| 整理import | Ctrl + Shift + O | Ctrl + Alt + O | |
| 跳转 | 显示方法层次 | Ctrl + Shift + H | |
| 显示类、方法说明 | F2 | Ctrl + Q | |
| 跳到方法定义处 | Ctrl + B | ||
| 跳到方法实现处 | Ctrl + Alt + B | ||
| 跳到上/下一方法 | Alt + Up/Down | ||
| 上/下一查看处 | Alt + <-Alt + -> | Ctrl + Alt + Up/Down | |
| 跳到指定行 | Ctrl + L | Ctrl + G | |
| 重构 | 改名 | Alt + Shift + R | Shift + F6 |
| 其他常用 | Ctrl + F6 修改方法签名 Ctrl + Shift + F6 修改参数的类型 Ctrl + Shift + V引入局部变量 Ctrl + Shift + P 引入参数 Ctrl + Shift + F 引入类变量 Ctrl + Shift + M 引入方法 Ctrl + Shift + C 引入常量 | ||
| 运行 | 启动调试 | Alt + Shift + F9 | |
| 启动运行 | Alt + Shift + F10 | ||
| 单步进入 | F5 | F7 | |
| 单步跳过 | F6 | F8 | |
| 跳过 | F8 | F9 | |
| 执行选中语句 | Alt + F8 | ||
| 窗口 | 调出界面 | Ctrl + Alt + S调出Settings界面 Ctrl + Alt + Shift + S调出项目Setting界面 | |
| 关闭界面 | Ctrl + F4 或 ESC | ||
| 打开窗口 | Alt + 窗口编号(例如项目窗口编号是1) | ||
| 最大化窗口 | Ctrl + M | Ctrl + Shift + F12 | |
| 隐藏窗口 | Shift + ESC | ||
| 关闭当前文件 | Ctrl + F4 | ||
| 垂直分屏 | Ctrl + | (自定义的) | ||
| 调整窗口位置 | Ctrl + M 将当前光标处显示到屏幕中央 | ||
| 切换窗口 | Ctrl + Tab |
基础内容
编写 Java 程序时,应注意以下几点:
- 大小写敏感:Java 是大小写敏感的,这就意味着标识符 Hello 与 hello 是不同的。
- 类名:对于所有的类来说,类名的首字母应该大写。如果类名由若干单词组成,那么每个单词的首字母应该大写,例如 MyFirstJavaClass 。
- 方法名:所有的方法名都应该以小写字母开头。如果方法名含有若干单词,则后面的每个单词首字母大写。
- 源文件名:源文件名必须和类名相同。当保存文件的时候,你应该使用类名作为文件名保存(切记 Java 是大小写敏感的),文件名的后缀为 .java。(如果文件名和类名不相同则会导致编译错误)。
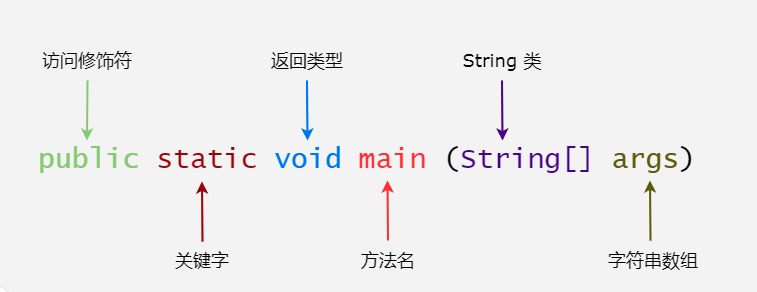
- 主方法入口:所有的 Java 程序由 public static void main(String[] args) 方法开始执行。
标识符
Java 所有的组成部分都需要名字。类名、变量名以及方法名都被称为标识符。
关于 Java 标识符,有以下几点需要注意:
- 所有的标识符都应该以字母(A-Z 或者 a-z),美元符($)、或者下划线(_)开始
- 首字符之后可以是字母(A-Z 或者 a-z),美元符($)、下划线(_)或数字的任何字符组合
- 关键字不能用作标识符
- 标识符是大小写敏感的
- 合法标识符举例:age、$salary、_value、__1_value
- 非法标识符举例:123abc、-salary
修饰符
Java可以使用修饰符来修饰类中 方法和属性。主要有两类修饰符:
- 访问控制修饰符 : default, public , protected, private
- 非访问控制修饰符 : final, abstract, static, synchronized
访问控制修饰符
public : 对所有类可见(对外公开)。使用对象:类、接口、变量、方法
protected : 对所有子类 和 同一包内的类 可见。使用对象:变量、方法。 注意:不能修饰类(外部类)
default (即默认,什么也不写): 在同一包内可见。使用对象:类、接口、变量、方法。
private : 仅在类本身内可见。使用对象:变量、方法。 注意:不能修饰类(外部类)
可以通过以下表来说明访问权限:
| 修饰符 | 当前类 | 同一包内 | 子孙类(不同包) | 其他包 |
|---|---|---|---|---|
public |
Y | Y | Y | Y |
protected |
Y | Y | Y | N |
default |
Y | Y | N | N |
private |
Y | N | N | N |
非访问控制修饰符
static
类变量,也叫静态变量,是该类的所有对象共享的变量,任何一个该类的对象去访问/修改它,取到/修改的都是相同的值。
1 | 访问修饰符 static 数据类型 变量名; |
jdk8以前,静态变量放在静态域(方法区),jdk8以后放在堆中,当这个类加载的时候会在堆生成这个类的class对象,静态变量就放在class实例的尾部。
访问方式:类名.类变量名 或者 对象名.类变量名
(类变量在类加载时就初始化了,而不管new几次对象,类只会加载一次,类变量的生命周期与类相同)
类方法,也叫静态方法
1 | 访问修饰符 static 数据返回类型 方法名(){} |
访问方式:类名.类方法名 或者 对象名.类方法名
当方法中不涉及任何和对象相关的成员(包括this,super),则可以设计成静态方法,提高开发效率;如:工具类中的方法utils:Math类、Collections集合
final
这个关键字是一个修饰符,可以修饰类,方法,变量。
被final修饰的类是一个最终类,不可以被继承。
被final修饰的方法是一个最终方法,不可以被重写。
被final修饰的变量是一个常量,只能赋值一次。
其实这样的原因的就是给一些固定的数据起个阅读性较强的名称。
加了final,程序更为严谨。常量名称定义时,有规范,所有字母都大写,如果由多个单词组成,中间用 _ 连接。
注意点:
- final修饰的属性在定义时,必须赋初值,且不能再修改,可以在如下位置赋值:
- 定义时;
- 在构造器中
- 在代码块中
- 如果final修饰的属性是静态的,则只能在定义时和在静态代码块中赋值,不能在构造器中赋值;
- final类不能继承,但可以实例化对象;
- 如果类不是final类,但含有final方法,则该方法虽不能重写,但能被继承
- final类中,没有必要再将用final修饰方法;
- final不能修饰构造器;
- final和static搭配使用,不会导致类加载;
- 包装类(Integer,Double,Float,Boolean等都是final),String也是final类;
关键字
这些保留字不能用于常量、变量、和任何标识符的名称。
| 类别 | 关键字 | 说明 |
|---|---|---|
| 访问控制 | private | 私有的 |
| protected | 受保护的 | |
| public | 公共的 | |
| default | 默认 | |
| 类、方法和变量修饰符 | abstract | 声明抽象 |
| class | 类 | |
| extends | 扩充,继承 | |
| final | 最终值,不可改变的 | |
| implements | 实现(接口) | |
| interface | 接口 | |
| native | 本地,原生方法(非 Java 实现) | |
| new | 新,创建 | |
| static | 静态 | |
| strictfp | 严格,精准 | |
| synchronized | 线程,同步 | |
| transient | 短暂 | |
| volatile | 易失 | |
| 程序控制语句 | break | 跳出循环 |
| case | 定义一个值以供 switch 选择 | |
| continue | 继续 | |
| default | 默认 | |
| do | 运行 | |
| else | 否则 | |
| for | 循环 | |
| if | 如果 | |
| instanceof | 实例 | |
| return | 返回 | |
| switch | 根据值选择执行 | |
| while | 循环 | |
| 错误处理 | assert | 断言表达式是否为真 |
| catch | 捕捉异常 | |
| finally | 有没有异常都执行 | |
| throw | 抛出一个异常对象 | |
| throws | 声明一个异常可能被抛出 | |
| try | 捕获异常 | |
| 包相关 | import | 引入 |
| package | 包 | |
| 基本类型 | boolean | 布尔型 |
| byte | 字节型 | |
| char | 字符型 | |
| double | 双精度浮点 | |
| float | 单精度浮点 | |
| int | 整型 | |
| long | 长整型 | |
| short | 短整型 | |
| 变量引用 | super | 父类,超类 |
| this | 本类 | |
| void | 无返回值 | |
| 保留关键字 | goto | 是关键字,但不能使用 |
| const | 是关键字,但不能使用 | |
| null | 空 |
包
作用:
- 区分相同名字的类
- 当类很多时,可以很好的管理类(Java API文档)
- 控制访问范围
包的基本语法:
1 | package 包名 |
包本质上,就是创建不同的文件夹/目录来保存类文件
包的命名规则:
只能包含数字、字母、下划线、小圆点,不能数字开头,不能用关键字或保留字
命名规范: 小写字母 + 小圆点
一般是 com.公司名.项目名.业务模块名
常用的包:
1 | java.lang.* //lang包是基本包,默认导入 |
引入包: 使用 import 关键字
1 | import javautil.Scanner; |
注意事项:
- package的作用是声明当前类所在的包,需要放在类的最上面,一个类中最多只能声明一句package;
注解@
注解(Annotation),也叫元数据(Metadata),用于修饰包,类,方法,属性,构造器,局部变量等数据信息;
和注释一样,注解不影响程序逻辑,但注解可以被编译或运行,相当于嵌入在代码中的补充信息;
在JavaSE中,注解的使用目的比较简单,例如标记过时的功能,忽略警告等;而在JavaEE中,注解有更大的作用,如:配置应用程序的任何切面,代替javaEE旧版中所遗留的繁冗代码和XML配置等;
使用:
三个基本的Annotaton:
@Override:限定某个方法,是重写父方法的,该注解只能用于方法;
@Override 表示指定重写父类的方法(从编译层面验证),如果父类没有fly方法,则会报错;
@Override 只能用来修饰方法
查看@Override注解源码@Target(ElementType. METHOD),说明只能修饰方法;
@Target是修饰注解的注解,称为元注解
@Deprecated:用于表示某个程序元素(类/方法等)已过时;
- @Target(vlaue = {CONSTRUCTOR, FIELD, LOCAL_VARIABLE, METHOD, PACKAGE, PARAMETER, TYPE})
- @Deprecated的作用:新旧版本的兼容和过度
@SuppressWarnings:抑制编译器警告;
1
;
可以指定的警告类型有 (可以查看黄色警告光标,看是什么类型的警告)
all,抑制所有警告
boxing,抑制与封装/拆装作业相关的警告
cast,抑制与强制转型作业相关的警告
dep-ann,抑制与淘汰注释相关的警告
deprecation,抑制与淘汰的相关警告
fallthrough,抑制与 switch 陈述式中遗漏 break 相关的警告
finally,抑制与未传回 finally 区块相关的警告
hiding,抑制与隐藏变数的区域变数相关的警告
incomplete-switch,抑制与 switch 陈述式(enum case)中遗漏项目相关的警告
javadoc,抑制与 javadoc 相关的警告
nls,抑制与非 nls 字串文字相关的警告
null,抑制与空值分析相关的警告
rawtypes,抑制与使用 raw 类型相关的警告
resource,抑制与使用 Closeable 类型的资源相关的警告
restriction,抑制与使用不建议或禁止参照相关的警告
serial,抑制与可序列化的类别遗漏 serialVersionUID 栏位相关的警告
static-access,抑制与静态存取不正确相关的警告
static-method,抑制与可能宣告为 static 的方法相关的警告
super,抑制与置换方法相关但不含 super 呼叫的警告
synthetic-access,抑制与内部类别的存取未最佳化相关的警告
sync-override,抑制因为置换同步方法而遗漏同步化的警告
unchecked,抑制与未检查的作业相关的警告
unqualified-field-access,抑制与栏位存取不合格相关的警告
unused,抑制与未用的程式码及停用的程式码相关的警告
补充说明:查看源码时,有个:@interface,表明是一个注解类,跟interface是不一样的
四种元注解:
- Retention :指定注解的作用范围,三种 SOURCE,CLASS,RUNTIME
- Target : 指定注解可以在哪些地方使用
- Documented :指定该注解是否会在 javadoc 体现
- Inherited :子类会继承父类注
数据类型
基本类型和引用类型
| 基本类型 | 引用类型(包装类) |
|---|---|
| boolean | Boolean |
| byte | Byte |
| short | Short |
| int | Integer |
| long | Long |
| float | Float |
| double | Double |
| char | Character |
此外,BigInteger、BigDecimal 用于高精度的运算,BigInteger 支持任意精度的整数,也是引用类型,但它们没有相对应的基本类型。
包装类与其他的转换
包装类与基本类型的相互转换
jdk5后可以自动装箱和拆箱,自动装箱底层调用的是valueOf 方法,比如:Integer.valueOf();
手动装箱:
1 | //int -> integer |
手动拆箱:
1 | //Integer -> int |
包装类与String类型的相互转换
1 | //包装类 —> String |
包装类型
Integer和Character常用方法:
1 | Integer.MIN_VALUE //返回最小值 |
关于Integer的数据存放位置:
1 | Integer i = new Integer(1); |
基本类型
整型
| 类型 | 存储需求 | 取值范围 |
|---|---|---|
| int | 4字节 | -2 147 483 648 ~ 2 147 483 647(过20亿) |
| short | 2字节 | -32 768 ~ 32 767 |
| long | 8字节 | -9 223 372 036 854 775 808 ~ 9 223 372 036 854 775 807(过九百亿亿) |
| byte | 1字节 | -128 ~ 127 |
长整型数值带一个后缀L或l,十六进制数值带前缀0x,八进制带前缀0,(但容易混淆,如010对应十进制的8,所以不建议用),二进制数前缀带0b。
Java没有无符号形式的int,long,short,byte类型。
(可以将有符号整数解释为无符号数,但需要非常仔细)
浮点型
| 类型 | 存储需求 | 取值范围 |
|---|---|---|
| float | 4字节 | 大约+-3.402 823 47E + 38F(有效位数为6~7位) |
| double | 8字节 | 大约+-1.797 693 134 862 315 70E + 308(有效位数为15位) |
float类型带后缀F/f,没有后缀的浮点数值默认为double类型,double类型后缀也可以带D
对于表示溢出和出错情况的三个特殊浮点数值:
1.正无穷大:Double.POSITIVE_INFINITY
2.负无穷大:Double.NEGATIVE_INFINITY
3.NaN(不是一个数字):Double.NaN
- 检测一个特定值是否等于Double.NaN:
1
if(Double.isNaN(x)) //检查x是否是一个数
- 整数被0除会产生异常,浮点数被0除会得到无穷大或NaN结果。
浮点数值采用二进制系统表示,无法精确表示分数1/10,就像十进制无法精确表示分数1/3一样,所以,命令System.out.plantln(2.0 - 1.1)将打印出 0.899999999,而不是0.9。(舍入误差)
char类型
占2字节,char类型的字面量要用单引号括起来,char类型的值可以表示为16进制值,其范围为:\u0000 ~ \uFFFF
Unicode转义序列会在解析代码前得到处理,如:”\u0022+\u0022”,不是由引号包围加号的字符串,\0022表示引号,会在解析前转换为”,这会得到”“+”“,也就是一个空串。
更隐秘的,对注释中的\u也一样:// \u000A is a newline 中\u000A会替换为一个换行符,
类似的:// look inside c:\users中会出现一个语法错误,即\u后没有跟着4个十六进制数。
java中,char类型描述了UTF-16编码中的一个代码单元,但辅助字符编码为一对连续的代码单元(即不止一个代码单元),所以建议不要在程序中使用char类型,除非确实要处理UTF-16代码单元。最好将字符串作为抽象数据类型处理。
变量与常量
1 | //声明与初始化 |
常量
利用关键字final指示常量
1 | final double ABC = 2.54; |
类常量:使某个常量在一个类的多个方法中使用,用关键字static final设置类常量
1 | public calss Constant{ |
枚举类型
枚举类型的变量只能存储这个类型声明中给定的某个枚举值,或特殊值null(表示这个变量没有设置任何值)
关系运算boolean
&&和||运算符按照短路方式求值,如果第一个操作数已能确定表达式的值,第二个操作数就不会进行计算。
&和|不采用短路方式求值,即两个操作数都会进行计算。
&:对应位都为1则结果为1,否则为0;
|:对应位都为0则结果为0,否则为1;
^:对应位值相同则为0,否则为1;
~:按位取反每一位;
位模式左移:>>
右移:<<
运算符>>>会用0填充高位,不存在<<<
子串
String类的substring方法:从字符串中提取出一个子串:
1 | String a = "hello"; |
java可以用+号连接两个字符串
1 | String a = "abc"; |
静态join方法:将多个字符串放在一起,用界定符分开:
1 | String all = String.join("/","S","M","L","XL"); |
repeat方法:将字符串复制n次:
1 | String a = "java".repeat(3); |
java没有提供修改字符串的方法,因此要通过其他操作来完成:
1 | String a = "hello"; |
(尽管通过这种方式修改字符串效率不高,但不可变字符串有其他的优点:编译器可以让字符串共享,即原始字符串与复制字符串共享相同的字符(地址))。
检测字符串是否相等:equals方法——s.equals(t)——其中s和t可以是字符串变量,也可以是字符串字面量
1 | "Hello".equals(a); |
localDate类的程序:(显示当前月的日历)
1 | import java.time.*; |
1 | Mon Tue Wed Thu Fri Sat Sun |
main方法
1 | public static void main(String[] args){} |
- main方法时虚拟机调用
- jvm需要调用类的main()方法,所以该方法的访问权限必须是public
- jvm在执行main()方法时不必创建对象,所以main()为static
- main()接受String类型的参数数组,该数组中保存执行java命令时传递给所运行的类的参数
在main()方法中,可以直接调用main方法所在类的静态方法和静态变量,但不能访问非静态的方法和变量,必须创建该类的一个实例对象后,才能这个对象去访问;
面向对象
类(Class)和对象(object)
类:类是一个模板,它描述一类对象的行为和状态
(类包含:属性,方法,构造器,代码块,内部类)
一个类可以包含以下类型变量:
- 局部变量:在方法、构造方法或者语句块中定义的变量被称为局部变量。变量声明和初始化都是在方法中,方法结束后,变量就会自动销毁。
- 成员变量(非静态变量):成员变量是定义在类中,方法体之外的变量。这种变量在创建对象的时候实例化。成员变量可以被类中方法、构造方法和特定类的语句块访问。
- 类变量(静态变量):类变量也声明在类中,方法体之外,但必须声明为 static 类型。
类什么时候会被加载?
- 创建对象实例时;
- 创建子类对象实例,父类也会被加载;
- 使用类的静态成员
代码块:又称初始化块,类似于方法,将语句封装在方法体中,用{}包起来
1 | [修饰符]{ |
静态代码块,作用就是对类初始化,随着类的加载而执行,且只会执行一次,如果是普通代码块,每创建一个对象都会执行一次(如果只是使用类的静态成员,普通代码不会执行);
对象:对象是类的一个示例,有状态和行为。软件对象的状态就是属性,行为通过方法体现
创建对象
对象是根据类创建的。在Java中,使用关键字 new 来创建一个新的对象。创建对象需要以下三步:
- 声明:声明一个对象,包括对象名称和对象类型。
- 实例化:使用关键字 new 来创建一个对象。
- 初始化:使用 new 创建对象时,会调用构造方法初始化对象。
1 | public class Puppy{ |
调用顺序:
- 调用静态代码块和静态属性初始化(有多个则顺序调用);
- 调用普通代码块和普通属性的初始化;
- 调用构造方法;
源文件声明规则
在本节的最后部分,我们将学习源文件的声明规则。当在一个源文件中定义多个类,并且还有import语句和package语句时,要特别注意这些规则。
- 一个源文件中只能有一个 public 类
- 一个源文件可以有多个非 public 类
- 源文件的名称应该和 public 类的类名保持一致。例如:源文件中 public 类的类名是 Employee,那么源文件应该命名为Employee.java。
- 如果一个类定义在某个包中,那么 package 语句应该在源文件的首行。
- 如果源文件包含 import 语句,那么应该放在 package 语句和类定义之间。如果没有 package 语句,那么 import 语句应该在源文件中最前面。
- import 语句和 package 语句对源文件中定义的所有类都有效。在同一源文件中,不能给不同的类不同的包声明。
1.继承
好处:
1:提高了代码的复用性。
2:提高了代码的拓展性和维护性,让类与类之间产生了关系,提供了另一个特征多态的前提。
一般类只能单继承;内部类实现多继承;接口可以多继承;
子类继承了所有的属性和方法,非私有的属性和方法可以在子类直接访问,但是私有的属性和方法要通过父类提供的公共方法去访问;
子类必须调用父类的构造器,完成父类的初始化;
- 对与成员变量:
1 | 关键字: |
注意:子父类中通常是不会出现同名成员变量的,因为父类中只要定义了,子类就不用在定义,直接继承过来用。(当有属性/方法重名时,只能用super访问父类的重名属性/方法;super的访问不限于直接父类,如果爷爷类也有与本类重名的属性/方法,也能用super去访问;即多个基类中都有重名的成员,super的访问遵循就近原则)
- 成员函数:
当子父类可以出现一样的方法,即可以覆盖(重写)函数(当一个类的功能需要修改时,可以通过覆盖来实现)
- 构造函数
子类的构造函数运行时,一定会先运行父类的构造函数;
原因:子类的构造函数中的第一行,都有一条隐身的语句super(),而这个super()是在调用父类中空参数的构造函数;
因为子类继承父类,会继承父类中的数据,所以必须要看到父类对自己数据进行初始化的过程
子类在进行对象初始化时,先调用父类的构造函数,这就是子类的实例化过程。
注意:子类中所有的构造函数都会默认访问父类中的空参数的构造函数,因为每一个子类构造内第一行都有默认的语句super();
如果父类中没有空参数的构造函数,那么子类的构造函数内,必须通过super语句指定要访问的父类中的构造函数。
如果子类构造函数中用this来指定调用子类自己的构造函数,那么被调用的构造函数也一样会访问父类中的构造函数。
在方法覆盖(重写)时,注意:
子类覆盖父类时,必须要保证,子类方法的权限必须大于等于父类方法权限可以实现继承。否则,编译失败。
覆盖时,要么都静态,要么都不静态。 (静态只能覆盖静态,或者被静态覆盖)
子类中重写父类的方法,必须与父类的那个方法:名称,返回类型,参数一样;
而对于重载:只要同一类中,且方法名一致,参数列表不一样即可,对返回类型,修饰符无要求;
继承的一个弊端:打破了封装性。对于一些类,或者类中功能,是需要被继承,或者复写的。
此时可以用到final;
1 | final特点: |
其实这样的原因的就是给一些固定的数据起个阅读性较强的名称。
加了final,程序更为严谨。常量名称定义时,有规范,所有字母都大写,如果由多个单词组成,中间用 _ 连接。
创建子类对象时的调用顺序:
- 父类的静态代码块和静态属性
- 子类的静态代码块和静态属性
- 父类的普通代码块和普通属性初始化;
- 父类的构造方法;
- 子类的普通代码块和普通属性初始化;
- 子类的构造方法;
2.封装
在面向对象程式设计方法中,封装(Encapsulation)是指一种将抽象性函式接口的实现 细节部分 包装、隐藏起来的方法。
也就是说:将数据和对数据的操作封装起来,程序的其他部分只有通过被允许的操作才能对数据进行修改。
封装可以被认为是一个保护屏障,防止该类的代码和数据被外部类定义的代码随机访问。
要访问该类的代码和数据,必须通过严格的接口控制。
封装最主要的功能在于我们能修改自己的实现代码,而不用修改那些调用我们代码的程序片段。
适当的封装可以让程式码更容易理解与维护,也加强了程式码的安全性。
封装的优点:
良好的封装能够减少耦合。
类内部的结构可以自由修改。
可以对成员变量进行更精确的控制。
隐藏信息,实现细节。
实现Java封装的步骤:
修改属性的可见性来限制对属性的访问(一般限制为private),例如:
1
2
3
4publish class person(){
private string name;
private int age;
}这段代码中,将 name 和 age 属性设置为私有的,只能本类才能访问,其他类都访问不了,如此就对信息进行了隐藏。
访问权限控制:public > protected > 包 > private
对每个值属性提供对外的公共方法访问,也就是创建一对赋取值方法,用于对私有属性的访问,例如:
1
2
3
4
5
6
7
8
9
10
11
12public class Person{
private String name;
private int age;
public int getAge(){
return age;
}
public void setAge(int age){
this.age = age;
}
}
static关键字:可对数据进行静态修饰
被静态修饰的成员,可以直接被类名所调用。也就是说,静态的成员多了一种调用方式。类名.静态方式。
静态随着类的加载而加载,而且优先于对象存在。
静态方法只能访问静态成员,不可以访问非静态成员。
静态方法中不能使用this,super关键字。
因为this代表对象,而静态在时,有可能没有对象,所以this无法使用。
成员变量和静态变量的区别:
1,成员变量所属于对象,所以也称为实例变量。
静态变量所属于类,所以也称为类变量。
2,成员变量存在于堆内存中。
静态变量存在于方法区中。
3,成员变量随着对象创建而存在,随着对象被回收而消失。
静态变量随着类的加载而存在,随着类的消失而消失。
4,成员变量只能被对象所调用。
静态变量可以被对象调用,也可以被类名调用。
所以,成员变量可以称为对象的特有数据,静态变量称为对象的共享数据。
3.多态
实现多态的三个必要条件:继承,重写(重载也是),向上转型;
向上转型:子类对象被父类引用;
向下转型:向下转型是子类对象被父类引用之后,再把父类引用强转成子类;
1 | //父类 |
向下转型的意义:当多个子类继承同一个父类或接口时,可以写一个公用的方法,方法传入的形参为父类或接口,这样每个子类实参就可以传入这个父类形参中,进而实现公用性。
1 | publish class Test2{ |
使用例子:
多态参数:可以在方法实参中使用父类,然后调用方法时传入子类,即向上转型
多态数组:数组的定义类型为父类,里面保存的实际元素类型为子类类型
如果要调用数组中子类特有的方法,可以使用类型判断+向下转型:
1
2
3
4
5
6Fu[] f = new Fu[n];
if(f[i] instancef Zi){
Zi z = (Zi)f[i];
z.方法();
//两句直接写成:((Zi)f[i]).方法();
}
多态 体现在:父类引用变量可以指向子类对象
多态的定义格式:
父类类型 变量名 = new 子类类型();
多态成员特点:
- 多态成员变量:编译类型 运行类型 都看左边
- 多态成员方法:编类型看左边,运行类型看右边
java的动态绑定机制
- 当调用对象方法时,该方法会和对象的内存地址/运行类型绑定;
- 当调用对象属性时,没有动态绑定机制,哪里声明,那里使用
1 | Fu f = new Zi(); |
instanceof关键字:用于判断对象是否属于某种数据类型(返回值为布尔类型)
1 | Fu f1=new Zi(); |
多态的转型:
向上转型:多态本身就是向上转型过的过程
- 使用格式:父类类型 变量名=new 子类类型();
适用场景:当不需要面对子类类型时,通过提高扩展性,或者使用父类的功能就能完成相应的操作。
向下转型:一个已经向上转型的子类对象可以使用强制类型转换的格式,将父类引用类型转为子类引用各类型
- 使用格式:子类类型 变量名=(子类类型) 父类类型的变量;
适用场景:当要使用子类特有功能时。
内部类
一个类的内部又完整嵌套了另一个结构,被嵌套的类被称为内部类(inner class),嵌套其他类的类称为外部类(outer class)。
内部类最大的特点是可以直接访问外部类的所有成员,包括私有属性。
按定义的位置:
- 定义在局部位置(方法/代码块):
- 局部内部类
- 匿名内部类
- 定义在成员位置:
- 成员内部类(不加static)/ 普通内部类
- 静态内部类(加static)
成员内部类
在类里面作为一个字段直接定义即可:
1 | public class A{ |
在这里 B 类为 A 类的普通内部类,在这种定义方式下,普通内部类对象依赖外部类对象而存在,即在创建一个普通内部类对象时首先需要创建其外部类对,如:
1 | public class Outer{ |
静态内部类
一个类的静态成员独立于这个类的任何一个对象存在,只要在具有访问权限的地方,我们就可以通过 类名.静态成员名 的形式来访问这个静态成员,同样的,静态内部类也是作为一个外部类的静态成员而存在,创建一个类的静态内部类对象不需要依赖其外部类对象。
与静态成员一样,静态内部类 无法访问外部类的非静态成员。
1 | public class Outer{ |
匿名内部类
匿名内部类没有名字,定义在外部类的局部位置(方法/代码块)
某个类实现接口/抽象类,但只使用一次,可以使用匿名内部类(简化开发)
语法:
1 | new 类或接口(参数列表){ |
基于接口的匿名内部类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16interface IA{ //接口
}
class Outer{
public void method(){ //方法
//anonymity的编译类型是IA,运行类型是匿名内部类
//匿名内部类其实在底层会分配一个名字,不会显示出来
//jdk底层在创建匿名内部类anomymity$1,立刻就创建了其实例,并把地址返回给anomymity;
IA anonymity = new IA(){
}
//查看一下运行类型,即在原名字后加$1: anomymity$1
system.out.println(anomymity.getclass());
//匿名内部类anomymity$1使用一次就回收掉,但anonymity是一个对象,仍可以反复调用
}
}基于类的匿名内部类
1
2
3A a = new A(){ //A可以为普通类或抽象类
}匿名内部类可以直接当作实参直接传递,简洁高效
1
2
3
4
5
6
7
8
9
10public static void main(String[] args) {
//当做实参直接传递,简洁高效
f1(new IL() {
public void show() {
System.out.println("这是一副名画~~...");
}
});
//传统方法
f1(new Picture());
}
局部内部类
定义在外部类的局部位置,有名字。
不能添加访问修饰符,但可以使用final修饰(跟局部变量一样)
作用域:仅在定义它的方法或代码块中
访问方式:
- 局部内部类访问外部类的成员:直接访问
- 外部类访问局部内部类的成员:在它的作用域中创建对象,再访问;
外部其他类不能访问局部内部类(地位相当于是一个局部变量)
如果外部类和局部内部类的成员同名,默认遵循就近原则,如果想访问外部类成员,可以用:外部类名. this. 成员名 ,去访问
抽象类
在面向对象的概念中,所有的对象都是通过类来描绘的,但是反过来,并不是所有的类都是用来描绘对象的,
如果一个类中没有包含足够的信息来描绘一个具体的对象,这样的类就是抽象类。
抽象类除了不能实例化对象之外,类的其它功能依然存在,成员变量、成员方法和构造方法的访问方式和普通类一样。
由于抽象类不能实例化对象,所以抽象类必须被继承,才能被使用。
父类包含了子类集合的常见的方法,但是由于父类本身是抽象的,所以不能使用这些方法。
在Java中抽象类表示的是一种继承关系,一个类只能继承一个抽象类,而一个类却可以实现多个接口。
使用abstract class来定义抽象类。
抽象方法:如果你想设计这样一个类,该类包含一个特别的成员方法,该方法的具体实现由它的子类确定,那么你可以在父类中声明该方法为抽象方法。
Abstract 关键字同样可以用来声明抽象方法,抽象方法只包含一个方法名,而没有方法体。
抽象方法没有定义,方法名后面直接跟一个分号,而不是花括号。
1 | public abstract class Employee |
声明抽象方法会造成以下两个结果:
- 如果一个类包含抽象方法,那么该类必须是抽象类。
- 任何子类必须重写父类的抽象方法,或者声明自身为抽象类。
继承抽象方法的子类必须重写该方法。否则,该子类也必须声明为抽象类。最终,必须有子类实现该抽象方法,否则,从最初的父类到最终的子类都不能用来实例化对象。
抽象类总结规定
- 抽象类不能被实例化(初学者很容易犯的错),如果被实例化,就会报错,编译无法通过。只有抽象类的非抽象子类可以创建对象。
- 抽象类中不一定包含抽象方法,但是有抽象方法的类必定是抽象类。
- 抽象类中的抽象方法只是声明,不包含方法体,就是不给出方法的具体实现也就是方法的具体功能。
- 构造方法,类方法(用 static 修饰的方法)不能声明为抽象方法。
- 抽象类的子类必须给出抽象类中的抽象方法的具体实现,除非该子类也是抽象类。
- 抽象关键字abstract 和 final, private, static不共存
设计模式:
解决的问题:当功能内部一部分实现时确定,一部分实现是不确定的。这时可以把不确定的部分暴露出去,让子类去实现。
1 | abstract class GetTime{ |
接口
接口(Interface),在JAVA中是一个抽象类型,是抽象方法的集合,
接口通常以interface来声明。一个类通过继承接口,从而继承接口中的抽象方法。
接口并不是类,编写接口的方式和类很相似,但是它们属于不同的概念。类描述对象的属性和方法。接口则包含类要实现的方法。
除非实现接口的类是抽象类,否则该类要定义接口中的所有方法。
接口无法被实例化,但是可以被实现。一个实现接口的类,必须实现接口内所描述的所有方法,否则就必须声明为抽象类。另外,在 Java 中,接口类型可用来声明一个变量,他们可以成为一个空指针,或是被绑定在一个以此接口实现的对象。
接口声明:
1 | [可见度] interface 接口名称 [extends 其他的接口名] { |
接口实现:
1 | ...implements 接口名称[, 其他接口名称, 其他接口名称..., ...]{ |
接口与类相似点:
- 一个接口可以有多个方法。
- 接口文件保存在 .java 结尾的文件中,文件名使用接口名。
- 接口的字节码文件保存在 .class 结尾的文件中。
- 接口相应的字节码文件必须在与包名称相匹配的目录结构中。
接口与类的区别:
- 接口不能用于实例化对象。
- 接口没有构造方法。
- 接口中所有的方法必须是抽象方法。
- 接口不能包含成员变量,除了 static 和 final 变量。
- 接口不是被类继承了,而是要被类实现。
- 接口支持多继承。
接口特性:
接口中每一个方法也是隐式抽象的,接口中的方法会被隐式的指定为 public abstract(只能是 public abstract,其他修饰符都会报错)。
接口中可以含有变量,但是接口中的变量会被隐式的指定为 public static final 变量(并且只能是 public,用 private 修饰会报编译错误)。
使用static可以 在继承多接口时,如果存在多个同名变量,可以使用接口名.变量名来区分;
使用final,让接口中的变量不可更改,否则,每个实现接口的类都可以改变这个变量的值,就违背了OCP原则;
接口中的方法是不能在接口中实现的,只能由实现接口的类来实现接口中的方法。
接口的修饰符只能是public和默认。
抽象类和接口的区别:
抽象类中的方法可以有方法体,就是能实现方法的具体功能,但是接口中的方法不行。
抽象类中的成员变量可以是各种类型的,而接口中的成员变量只能是 public static final 类型的。
接口中不能含有静态代码块以及静态方法(用 static 修饰的方法),而抽象类是可以有静态代码块和静态方法。
一个类只能继承一个抽象类,而一个类却可以实现多个接口。
注:
JDK 1.8 以后,接口里可以有静态方法和方法体了。
JDK 1.8 以后,接口允许包含具体实现的方法,该方法称为”默认方法”,默认方法使用 default 关键字修饰。
JDK 1.9 以后,允许将方法定义为 private,使得某些复用的代码不会把方法暴露出去。
实现接口和继承类的区别
当子类继承了父类,就自动拥有父类的功能,是 is-a的关系
如果子类需要扩展功能,可以通过实现接口的方式扩展,是like - a 的关系,可以理解 ” 实现接口“ 是对java单继承机制的补充;
继承的价值只要是:解决代码的复用性和可维护性。
接口的价值主要是:设计好各种规范(方法),让其它子类去实现,更加灵活。且接口在一定程度上实现代码解耦(即:接口规范性+动态绑定机制)。
接口与多态
接口也能利用动态参数 和 多态数组
接口存在多态传递现象
在重写接口中声明的方法时,需要注意以下规则:
- 类在实现接口的方法时,不能抛出强制性异常,只能在接口中,或者继承接口的抽象类中抛出该强制性异常。
- 类在重写方法时要保持一致的方法名,并且应该保持相同或者相兼容的返回值类型。
- 如果实现接口的类是抽象类,那么就没必要实现该接口的方法。
在实现接口的时候,也要注意一些规则:
- 一个类可以同时实现多个接口。
- 一个类只能继承一个类,但是能实现多个接口。
- 一个接口能继承另一个接口,这和类之间的继承比较相似。
标记接口:
最常用的继承接口是没有包含任何方法的接口。
标记接口是没有任何方法和属性的接口。它仅仅表明它的类属于一个特定的类型,供其他代码来测试允许做一些事情。
标记接口作用:简单形象的说就是给某个对象打个标(盖个戳),使对象拥有某个或某些特权。
没有任何方法的接口被称为标记接口。标记接口主要用于以下两种目的:
建立一个公共的父接口:
正如EventListener接口,这是由几十个其他接口扩展的Java API,你可以使用一个标记接口来建立一组接口的父接口。例如:当一个接口继承了EventListener接口,Java虚拟机(JVM)就知道该接口将要被用于一个事件的代理方案。
向一个类添加数据类型:
这种情况是标记接口最初的目的,实现标记接口的类不需要定义任何接口方法(因为标记接口根本就没有方法),但是该类通过多态性变成一个接口类型。
枚举
枚举的两种实现:
- 自定义枚举类;
- 使用enum关键字实现枚举;
枚举是一个特殊的类,一般表示一组常量,
1 | enum ...{ |
- 使用enum,要求将定义常量对象写在最前面;
- 直接使用: 常量名(实参列表); 如果使用无参构造器,则实参列表和小括号都可以省略;
- 如果有多个常量/对象,使用逗号间隔即可;
1 | enum Season{ |
values(), ordinal() 和 valueOf() 方法:
enum 定义的枚举类默认继承了 java.lang.Enum 类,并实现了 java.lang.Seriablizable 和 java.lang.Comparable 两个接口。
(所以使用enum关键字后,就不能再继承其他类了,因为enum隐式继承了Enum类)
values(), ordinal() 和 valueOf() 方法位于 java.lang.Enum 类中:
- values() 返回枚举类中所有的值。
- ordinal()方法可以找到每个枚举常量的索引,就像数组索引一样。
- valueOf()方法返回指定字符串值的枚举常量。
1 | enum Color |
枚举类成员:
枚举跟普通类一样可以用自己的变量、方法和构造函数,构造函数只能使用 private 访问修饰符,让外部无法调用。
枚举既可以包含具体方法,也可以包含抽象方法。 如果枚举类具有抽象方法,则枚举类的每个实例都必须实现它。
自定义枚举类
- 将构造器私有化,防止外部直接new;
- 去掉set方法,防止属性被修改;
- 在枚举类内部,直接创建固定的对象;
- 对外暴露对象:对枚举对象/属性使用public + final + static共同修饰,实现底层优化;
- 枚举对象名通常全部大写(这是常量的命名规范);
1 | class Season{ |
包
包是Java语言提供的一种区别类名字命名空间的机制,它是类的一种文件组织和管理方式、是一组功能相似或相关的类或接口的集合。
Java package提供了访问权限和命名的管理机制。
一、包的作用
- 把功能相似或相关的类或接口组织在同一个包中,方便类的查找和使用。
- 如同文件夹一样,包也采用了树形目录的存储方式。同一个包中的类名字是不同的,不同的包中的类的名字是可以相同的,当同时调用两个不同包中相同类名的类时,应该加上包名加以区别。因此,包可以避免名字冲突。
- 包也限定了访问权限,拥有包访问权限的类才能访问某个包中的类。
二、包的定义
在一个.java文件中可以一个public类和多个非public类,如果要将这些类组织在一个包当中,则在.java文件中除注释以外的第一行使用关键字package即可实现。
当需要调用此包中的类时,就可以使用关键字import进行导入。在定义包的时候,应该注意几点:
- 为了尽量使包名保持唯一性,包名通常采用小写、按倒写互联网址的形式进行定义。
- 在进行命名包时,应该避免使用与系统发生冲突的名字。
异常
异常:程序执行中发生的不正常情况
异常分为两大类:
- Error(错误):JVM无法解决的严重问题,如:JVM系统内部错误,资源耗尽等严重情况
- Exception:其他因编程错误或外在因素导致的一般性问题,可以使用针对性代码进行处理;Exception分为两大类:运行时异常(程序运行时发生的异常),编程时异常(编程时,编译器检查出的异常,编译器要求必须处理)
常见的运行时异常:
**NullPointerException 空指针异常 **
如:当应用程序试图在需要对象的地方使用 null 时,会抛出该异常;
**ArithmeticException 数学运算异常 **
如:当出现异常的运算条件时,抛出此异常,比如整数除以零时;
ArrayIndexOutOfBoundsException 数组下标越界异常
用非法索引访问数组时抛出的异常,比如索引为负或大于等于数组大小,则该索引为非法索引;
ClassCastException 类型转换异常
当试图将对象强制转换为不是实例的子类时,抛出该异常;
1
2
3
4
5
6
7
8
9
10public class ClassCastException_ {
public static void main(String[] args) {
A b = new B(); //向上转型
B b2 = (B)b;//向下转型,这里是 OK
C c2 = (C)b;//这里抛出 ClassCastException
}
}
class A {}
class B extends A {}
class C extends A {}NumberFormatException 数字格式不正确异常
当程序试图将字符串转换成一种数值类型,但该字符串不能转换为适当格式时,抛出该异常(使用此异常可以确保输入满足条件的数字)
常见的编译异常:
- SQLException :操作数据库时,查询表可能发生异常
- IOException :操作文件时,发生的异常
- FileNotFoundException :当操作一个不存在的文件时,发生异常
- ClassNotFoundException:加载类,而该类不存在时,异常
- EOFException:操作文件时,到文件末尾,发生异常
- IllegalArguementException:参数异常
异常处理机制
try - catch - finally
程序员在代码中捕获发生的异常,自行处理
1
2
3
4
5
6
7
8
9
10
11try{
可能有异常的代码
}catch(Exception e){
//当异常发生时,系统将异常封装成Exception对象e,传递给catch
//得到异常对象后,程序员自己处理
//如果没有发生异常,catch代码块不执行
//可以有多个catch语句,捕获不同的异常,要求子类异常写在前,父类异常在后(只会匹配一个catch)
}finally{
//不管try代码块有没有异常发生,始终要执行finally
//通常将释放资源的代码放在finally
}- 就算在catch中ruturn了,但因为finally必须执行,所以catch的return中的语句会执行,但不会立即返回(return);
- 如果catch中 ruturn i ;但finally中又用到了 变量 i ,底层会保存临时变量temp = i ,执行完finally后,catch返回temp(finally有return的话则在finally中return);
throws
将发生的异常抛出,交给调用者(方法)处理,最高级的处理者是JVM(JVM会直接打印异常信息,退出)
1
2
3public void method() throws XXException{
}- 子类重写父类的方法时,对抛出异常的规定:子类重写的方法,所抛出的异常类型要和父类的一致或其异常类型的子类型;
自定义异常
自定义异常 需要继承 Excption或RuntimeException;如果继承Exception属于编译异常, 继承RuntimeException属于运行异常。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16public class CustomException {
public static void main(String[] args) /*throws AgeException*/ {
int age = 180;
//要求范围在 18 – 120 之间,否则抛出一个自定义异常
if(!(age >= 18 && age <= 120)) {
//这里我们可以通过构造器,设置信息
throw new AgeException("年龄需要在 18~120 之间");
}
System.out.println("你的年龄范围正确.");
}
}
class AgeException extends RuntimeException {
public AgeException(String message) { //构造器
super(message);
}
}
throw和throws的区别
| 意义 | 位置 | 后面跟的是 | |
|---|---|---|---|
| throws | 异常处理的一种方式 | 方法声明处 | 异常类型 |
| throw | 手动生成异常对象的关键字 | 方法体中 | 异常对象 |
集合
集合主要有 单列集合 和 双列集合:
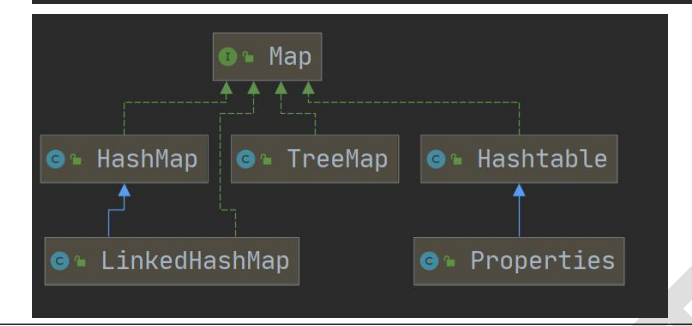
Collection接口有两个重要的子接口List,Set,它们实行的都是单列集合;
Map接口的实现子类,是双列集合,从存放K - V;

如何选择集合实现类:判断存储的类型:单列/双列
一组对象(单列):Collection接口
允许重复:List
- 增删多:LinkedList(底层是双向链表)
- 查改多:ArrayList(底层是可变数组)
不允许重复:Set
无序:HashSet(底层HashMap)
排序:TreeSet
1
2
3
4
5
6
7//使用默认构造器是自然顺序的,重写Compatator能实现q排序)
TreeMap treeMap = new TreeMap(new Comparator() {
public int compare(Object o1, Object o2) {
return ((String) o2).compareTo((String) o1);
}
});
//要往TreeMap中加入自定义的类型对象,需要该类型的对象实现comparable接口,否则会抛出类型转换异常插入和取出顺序一致:LinkedHashSet(维护数组和双向链表)
一组键值对(双列):Map
键无序:HashMap(底层:维护了一个哈希表:数组+链表+红黑树)
键排序:TreeMap
键插入和取出顺序一致:LinkedHashMap
读取文件:Properties
Collection接口
Collection接口的常用方法:add,remove,contains,size,isEmpty,clear,addAll,containsAll,removeAll(All都是指多个元素)
遍历方式:
- 使用 Iterator 迭代器(快捷模板:while->itit)
1 | Collection col = new ArrayList(); |
在调用iterator.next()之前必须先用iterator.hasNext()进行检测,不然,如果下一条记录无效,且直接调用next方法会抛出NoSuchElementException异常
当退出while循环后,iterator迭代器指向最后的元素,如果要再次遍历,需重置迭代器:ite = col.iterator();
iterator迭代器的remove方法是迭代过程中唯一能 线性安全地 删除集合元素的方法,因为iterator在遍历过程中,会锁定集合中的元素。
不能直接使用集合的remove方法:因为集合中会有变量modCount记录修改次数,当调用remove方法时,modCount ++,而迭代开始时,会先把modCount 记录下来,在调用iterator.next时会检查修改次数是否一致,如果不一致,则会报错ConcurrentModificationException;
注:由于hasnext是检查当前已经迭代的数量是否等于集合大小,如果删除倒数第二个数据,集合size–,就会使size == 已经迭代的个数,所以会漏掉最后一项数据,即最后一遍循环不执行,iterator.next不执行,也就不会报错。
使用for循环增强
增强for就是简化版的iterator,本质一样,只能用于遍历集合或数组。
1
2
3
4
5
6for(元素类型 元素名 : 集合名/数组名){
访问元素
}
for(Object object : col){
System.out.println(object);
}
List接口
- 元素有序(添加和取出的顺序一致),有索引
- 元素可重复
List接口常用方法:add,add(index,Object),get,indexOf,lastIndexOf,remove,set,subList(fromIndex,toIndex)(注意fromIndex <= subList < toIndex)
ArrayList和Vector基本等同,区别在线程是否安全
ArrayList类:效率较高,但线程不安全
创建 ArrayList 对象时,如果使用的是无参构造器,则初始 elementData 容量为0,第一次添加,则扩容elementData 为10,后面再次扩容,则扩容为原来的1.5倍 + 1;如果使用指定大小的构造器,则初始elementData 为指定大小,再次扩容,则为原来的1.5倍 + 1。
Vector类:线程安全,效率比ArrayList低
Vector类的操作方法带有synchronized。
1 | public synchronized E get(int index){ |
Vector扩容:无参构造,默认10;扩容为原来的2倍
LinkList类:底层实现了双向链表和双端队列的特点,线程不安全,没有实现同步;
- LinkList维护了两个属性:first指向首节点,last指向尾节点,
- 每个节点(Node对象)又维护了三个属性:prev指向前一个,next指向下一个,item存放数值;
Set接口
- 无序(添加和取出的顺序不一致,但存放位置是固定的),没有索引
- 不允许重复元素,所以最多包含一个null
Set常用方法,因为也是Collection的子接口,所以常用方法和Collection接口一样
遍历方式:迭代器,增强for(但不能使用索引方式来获取)
HashSet类
HashSet实现了Set接口,实际上是HashMap
1 | //HashSet的构造器 |
LinkedHashSet类
LinkedHashSet是HashSet的子类,底层是LinkedHashMap,底层中维护了一个hash表和双向链表;
LinkedHashMap类
LinkedHashMap中有头节点head和尾节点tail(指向第一个添加的节点和最后添加的节点),还创建了Entry类来存放节点,它继承自HashMap.Node类,每个节点有before和after属性。
- LinkedHashMap根据元素的hashCode值来决定元素的存储位置,同时使用链表维护元素的次序,使得元素看起来是以插入顺序保存的。
1 | tail.next = newElenment |
Map接口
Map中用于保存具有映射关系的数据:Key - Value
key不允许重复,只能有一个key为null;value允许重复,可以有多个null;
遍历方式:
containsKey:查找键是否存在
keySet:获取所有的键
1 | Set ks = map.keySet(); |
entrySet:获取所有的关系k - v
1 | Set entrySet = map.entrySet(); |
values:获取所有的值
1 | Collection val = map.values(); |
HashMap类
如果添加相同的key,则会覆盖原来的key - value,相当于修改了value;
底层没有实现同步,线程不安全;
HashMap底层:数组+链表+红黑树(不保证映射顺序)
- 先获取元素的哈希值(hashcode方法);
- 对哈希值进行运算,得出一个索引值即为要存放在哈希表中的位置;(用(length-1)&hash得到数组下标)
- 如果该位置上没有其他元素,则直接存放,如果有,则需要进行equals判断,如果相等,则不添加,如果不等,则以链表的方式添加;
1 | //计算hash值的算法,“扰动函数” |
扩容机制:
- 第一次添加时,table数组扩容到16,临界值(threshold)是16 * 加载因子(loadFactor = 0.75)= 12;
- 如果table数组使用到临界值12,就会扩容到16*2 = 32,新的临界值为32 * 0.75 = 24;
- 在Java8中,如果一条链表的元素个数到达TREEIFY_THRESHOLD(默认是8),且table大小>=MIN_TREEIFY_CAPACITY(默认是64),就会进行树化(红黑树);(table是HashMap的一个数组,类型是Node[])
- 如果链表的元素个数达到8以上,但table不足64,会将元素加入链表后,对table进行一次扩容。
Hashtable类
存放的元素的键值对:K - V ,键和值都不能为null,否则会抛出NullPointerException;
是线程安全的(效率比HashMap低)
(使用方法和HashMap基本一样)
Properties类
Properties类继承自Hashtable类并实行了Map接口;键和值同样不能为null,否则会抛出NullPointerException;
特点:可以用于从xxx.properties文件中,加载数据到Properties类对象,并进行读取和修改(工作中,xxx.properties文件通常为配置文件)
一道练习:
1 | HashSet set = new HashSet(); |
queue接口
PriorityQueue类:
PriorityQueue(优先队列) 采用的是堆排序,实际上是一个堆(不指定Comparator时默认为最小堆);
队列既可以根据元素的自然顺序来排序,也可以根据 Comparator来设置排序规则。
队列的头是按指定排序方式的最小元素。如果多个元素都是最小值,则头是其中一个元素。
新建对象的时候可以指定一个初始容量,其容量会自动增加。
该队列是用数组实现,但是数组大小可以动态增加,容量无限。
队列的实现不是同步的。不是线程安全的。如果多个线程中的任意线程从结构上修改了列表, 则这些线程不应同时访问 PriorityQueue实例。保证线程安全可以使用PriorityBlockingQueue 类。
不允许使用 null 元素。
插入移除方法:
- offer()、poll()、remove() 、add() 方法,时间复杂度为O(log(n)) ;
- remove(Object) 和 contains(Object), 时间复杂度为O(n);
检索方法:peek、element 和 size,时间复杂度为常量。
方法iterator()中提供的迭代器并不保证以有序的方式遍历优先级队列中的元素。因为PriorityQueue对元素采用的是堆排序,堆排序只能保证根是最大(最小),整个堆并不是有序的。如果需要按顺序遍历,可用Arrays.sort(pq.toArray())。
1 | // 默认是最小堆实现 |
泛型
泛型又称参数化类型。
java中的泛型只在编译阶段有效,在编译之后程序会采取去泛型化的措施。在编译过程中,正确检验泛型结果后,会将泛型的相关信息擦出,并且在对象进入和离开方法的边界处添加类型检查和类型转换的方法。也就是说,泛型信息不会进入到运行时阶段。
1 | //泛型声明 |
1 | //实例化,在类名后面指定类型参数的值 |
T,E …只能是引用类型,不能是基本数据类型
在给泛型指定具体类型后,可以传入该类型的子类类型
要注意,在静态方法中使用泛型,必须将静态方法定义成泛型方法。因为静态方法访问在类上定义的泛型,不能引用不确定的数据类型。
如果在创建对象时,没有指定类型,默认为Object
泛型接口的类型,在继承接口或实现接口时确定
java中不能创建一个确切的泛型类型的数组;
1
2
3
4List<String>[] ls = new ArrayList<String>[10]; //这样是不允许的
List<?>[] ls = new ArrayList<?>[10];//这样可以
List<String>[] ls = new ArrayList[10];//这样也可以解释:由于JVM泛型的擦除机制,在运行时JVM不知道泛型信息,可以将一个确切数据类型的数据加入,但在取出数据时却还要做一次类型转换,所以有可能出现ClassCastException。如果可以进行泛型数组的声明,则这种情况不会在编译期进行警告和错误,只有到运行时才出错,所有对泛型数据的声明进行限制可以防止运行时的错误发生;
而使用通配符,最后取出数据要做显式的类型转换,所以没问题;
泛型上下边界
在使用泛型的时候,我们还可以为传入的泛型类型实参进行上下边界的限制,如:类型实参只准传入某种类型的父类或某种类型的子类。
泛型通配符 <?> :支持任意泛型类型
< ? extends A > :支持A类以及A类的子类,规定了泛型的上限
< ? super A> :支持A类以及A类的父类,不限于直接父类,规定了泛型的下限
IO流
File类
创建文件的三种方式:
1 | //方法一:new File(String pathname) |
获取文件的相关信息:
getName(),length(),
getAbsolutePath():获取绝对路径
getParent():获取父目录
exist():文件是否存在
isFile():是不是文件
isDirectory():是不是目录
目录的操作和文件删除:
mkdir:创建一级目录
mkdirs:创建多级目录
delete:删除空目录或空文件
IO流分类
I/O 是Input / Output 的缩写,用于处理数据传输,如:读写文件、网络通讯等;
输入input:读取外部数据(磁盘、光盘等存储设备的数据)到程序(内存)中;
输出output:将程序(内存)中的数据输出到磁盘等存储设备中;
分类:
- 按操作的数据单位不同:字节流文件(二进制文件),字符流文件(文本文件);
- 按数据流的流向不同:输入流,输出流;
- 按流的角色的不同:节点流,处理流(包装流);
| 字节流 | 字符流 | |
|---|---|---|
| 输入流 | InputStream | Reader |
| 输出流 | OutputStream | Writer |
由上面四个类派生出来的子类名称 都是以其父类名作为子类名后缀
体系图:
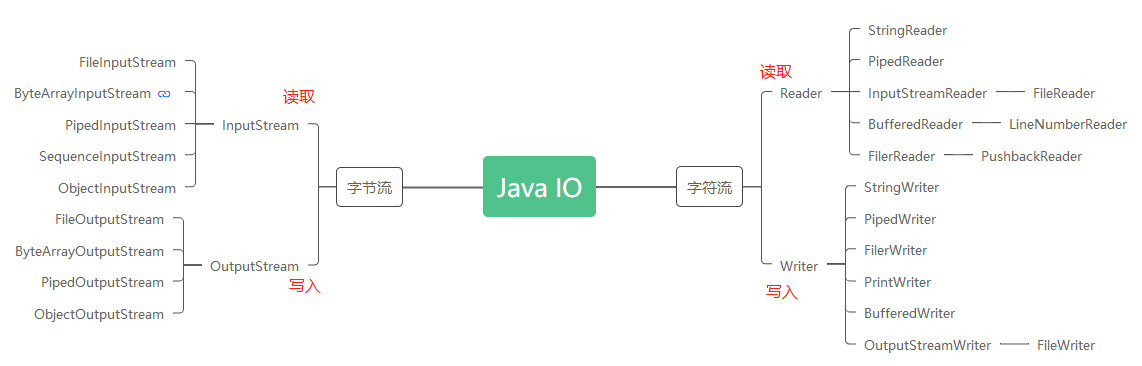
FileInputStream
1 | //一次接受一个字节的数据 |
FileOutputStream
1 | public void writeFile(){ |
FileReader 和 FileWriter
FileReader —> InputStreamReader —>Reader
FileReader —> InputStreamReader —>Reader
使用方法跟上面的差不多
注意:对于字符流,记得操作完后要关闭文件流,或使用flush(),否则更新内容不会保存
节点流和处理流
节点流 :从一个特定的数据源读写数据,如FileReader,FileWriter;
处理流(包装流):是连接在已存在的流(节点流/处理流)之上,提供了更方便,更强大的读写功能,如BufferedReader,BufferedWriter。
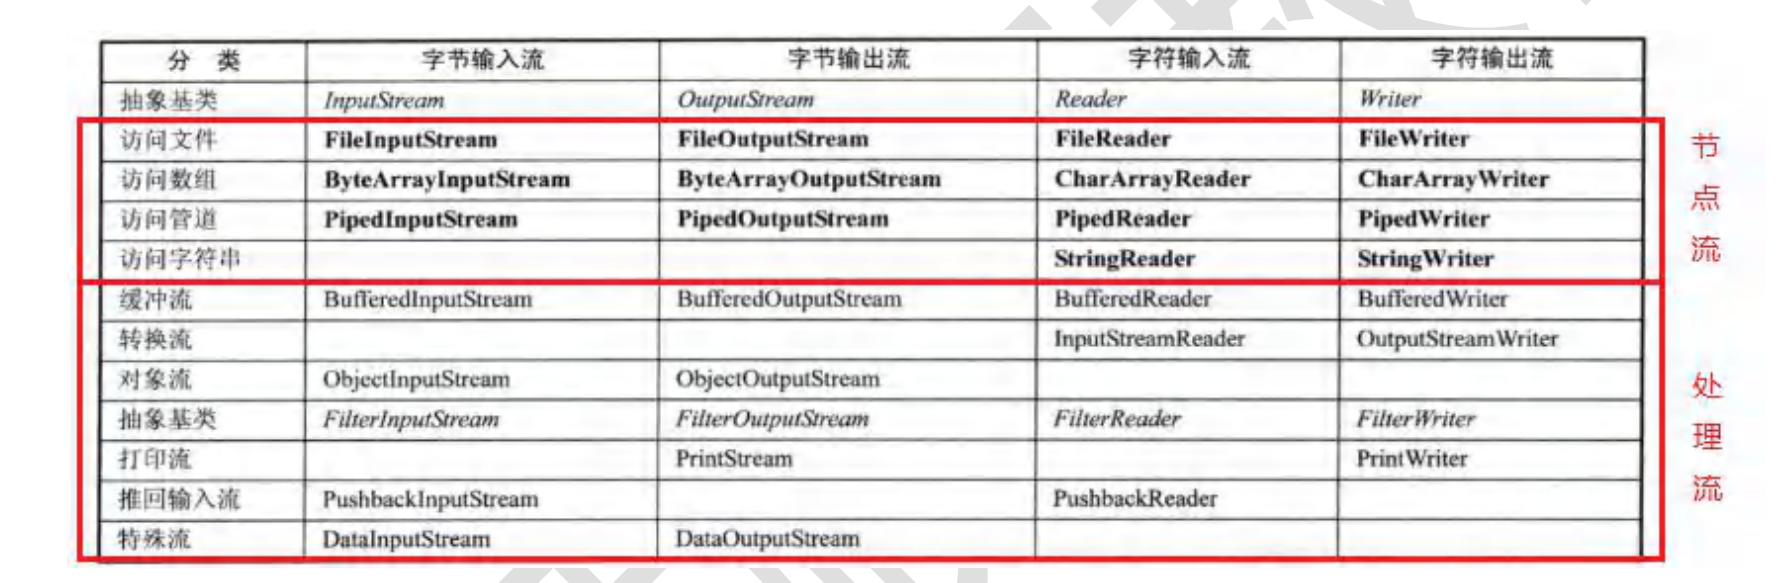
节点流是底层流,直接跟数据源相接。
处理流包装节点流,既可以消除不同节点流的实现差异,也可以提供更方便的方法;处理流使用了修饰器设计模式,不会直接与数据源相连。
处理流对性能的提高:主要以增加缓冲的方式来提高输入输出的效率;
(BufferedReader,BufferedWriter是字符流,不要去操作二进制文件(声音、视频、pdf等),可能造成文件损坏)
1 | //BufferedReader |
1 | //BufferedWriter |
BufferedInputStream 和 BufferedOutputStream
(是字节流,创建时,内部会创建一个缓冲区数组)
1 | //使用BufferedInputStream 和 BufferedOutputStream将一个二进制文件的内容拷贝到另一个文件 |
对象流
ObjectOutputStream :提供 序列化功能 ObjectInputStream :提供 反序列化
序列化:在保存数据时,保存数据的值和数据类型
反序列化:恢复数据时,恢复数据的值和数据类型
想要让对象支持序列化机制,其类应该是可序列化的,必须实现两个接口之一:Serializable(是一个标记接口,没有方法)或 Externalizable(有方法需要实现,所以一般实现Serializable接口)
注意:
- 读写顺序要一致;
- 要求对象实现Serializable
- 为了提高版本的兼容性,序列化的类中建议添加SerialVersionUID
- 序列化对象时,默认将里面所有属性都进行序列化,除了static或transient修饰的成员
- 序列化对象时,要求其属性的类型也实现序列化接口
- 序列化具备可继承性,即实现了序列化的类,它的子类默认也实现了序列化
标准输入输出流
| 类型 | 默认设备 | |
|---|---|---|
| System.in 标准输入 | InputStream | 键盘 |
| System.out 标准输出 | PrintStream | 显示器 |
转换流
InputStreamReader和OutputStreamWriter
可以将字节流转换成字符流,同时可以指定编码格式(如:utf-8,gbk等)
1 | String filePath = "e:\\a.txt"; |
打印流
打印流只有输出流,没有输入流
PrintStream 和 PrintWriter
1 | PrintStream out = System.out; |
properties类
专门用于读写配置文件的集合类
配置文件的格式:键=值
(不用空格,值不需要引号,默认类型时String)
常用方法:
load:加载配置文件的键值对到Properties对象;
list:将数据显示到指定设备;
getProperty(key):根据键 取 值
setProperty(key,value):设置键值对
store:键Properties对象中的键值对存储到配置文件(在idea中,保存信息到配置文件,如果含有中文,会存储为unicode码)
1 | Properties p = new Properties(); |
多线程
进程和线程
进程:一个独立的正在执行的程序;
多进程:在操作系统中,同时运行多个程序;
- 多进程好处:可以充分利用CPU,提高CPU使用率;
线程:一个进程的最基本的执行单位,执行路径;
多线程:在同一个进程(应用程序)中同时执行多个线程
- 多线程好处:提高进程的执行使用率,提高CPU的使用率
并发:同一时刻,多个任务交替执行;
并行:同一时刻,多个任务同时执行,多核cpu可以实现并行;
注意:
- 在同一个时间点,一个CPU中只能有一个线程在执行;
- 多线程会降低效率,但可以提高CPU使用率;
- 一个进程如果有多条执行路径,则称为多线程程序;
- Java虚拟机的启动至少开启两条进程:主线程和垃圾回收线程;
- 一个线程可以理解为进程的子任务;
线程实现方式
继承Thread类,重写run方法;
实现Runnable接口,重写run方法;
(Thread类实现了Runnable接口,Runnable接口里面只有一个方法run() )
- 调用start方法,才是真正开启了一个子线程,调用run方法不会开启新的线程(所处的线程还是执行调用的那个线程)
- start() 方法调用了start0()方法, start0()方法是本地方法,由JVM调用,底层是C/C++实现, start0()真正实现多线程的效果。
- start() 方法调用start() 方法后,该线程不一定会立即执行,只是将线程变成了可运行的状态。具体什么时候执行,取决于CPU,由CPU统一调度。
实现Callable接口,重写call方法,和Runnable相似,但能通过Thread+FutureTask配合,拿到异步执行任务的结果。(FutureTask实现了Runnable和Future,本质也是Runnable)
利用线程池Executors 来创建线程;(不建议)
方法一:继承Thread类
当一个类继承了Thread类,该类就可以当作线程使用,并在run方法里写上自己的业务代码。
1 | class Thread01 extends Thread{ |
方法二:实现Runnable接口
可能一个类已经继承了某个父类,再继承Thread类来创建线程显然不可能。此时可以通过实现Runnable接口来创建进程。
1 | class AA implements Runnable{ |
方法三:实现Callable接口
实现Callable接口,实现call()方法,得使用Thread+FutureTask配合,这种方式支持拿到异步执行任务的结果
Future接口是异步调用的应用,主要提供的功能有:取消任务,判断任务是否被取消,判断任务是否已经完成,获取任务执行结果。
FutureTask不光实现了Future接口,还实现了Runnable接口,因此可以作为任务直接被线程执行。
1 | class A implements Callable<Integer> { |
1 | // lamba简写 |
方法四:利用线程池来创建线程(不建议使用Executors,而是直接用ThreadPoolExcutor)
1 | class test { |
继承Thread 和 实现Runnable 的区别
从本质上来讲是没有区别的;
不过实现Runnable接口的方式更加适合多个线程共享一个资源的情况,并且避免了单继承的限制(建议使用Runnable)
线程终止
- 当线程完成任务后,会自动退出;
- 可以通过使用变量来控制run方法退出的方式来停止线程,即通知方式
线程常用方法
start:使该线程开始执行(JVM底层调用该线程的start0方法);
run:调用该线程对象的run方法;
setName : 设置线程名称,赋值给name;
getName : 返回该线程的名称;
getId:获取线程的长整型id;
getPriority:获取线程的优先级;
setPriority:设置优先级,从1~10
getState:获取线程状态,即 NEW, RUNNABLE, BLOCKED, WAITING,
TIMED_WAITING, TERMINATED
isAlive:判断线程是否存活
interrupt:中断线程(不是终止线程,一般用于中断线程的休眠状态);
- 如果被打断线程正在 sleep,wait,join 会导致被打断的线程抛出InterruptedException,并清除 打断标记 ;
- 如果打断的正在运行的线程,则会设置 打断标记 ;
- park 的线程被打断,也会设置 打断标记
join:线程的插队。插队的线程一旦插队成功,则肯定先执行完插入的线程所有的任务;或者理解为,需要等待该线程的结果返回,也就是说原本两个线程是异步的,现在变成同步的了,另一个线程需要等待 插队的线程返回才能继续运行;
sleep:(static)让当前正在执行的线程在指定的毫秒数内休眠 ——Running 进入 Timed Waiting 状态。(建议用TimeUnit的sleep 代替 Thread的sleep来获得更好的可读性)
yield:(static)线程的礼让。让出CPU,让其他线程先执行,但礼让的时间不确定,也不一定能礼让成功 —— Running 进入 Runnable 就绪状态;
currentThread:(static)获取当前正在执行的线程;
isInterrupted:判断当前线程是否被打断,不会清除打断标记;
interrupted:(static)判断当前线程是否被打断,会清除打断标记;
守护线程
用户线程和守护线程:
- 用户线程:也叫工作线程
- 守护线程:一般是为工作线程服务的,当所有的用户线程结束,守护线程自动结束。(常见的守护线程:垃圾回收机制)
使用setDaemon方法将普通线程设为守护线程
1 | Runnable r1 = new MyRunnable(); |
守护线程的优先级非常低;
TimerTask
守护线程经常要做一些周期性的操作,如:每5分钟执行某操作,每天12点执行某操作等;此时可以用到Java的计时器的工具类:Timer和TimerTask
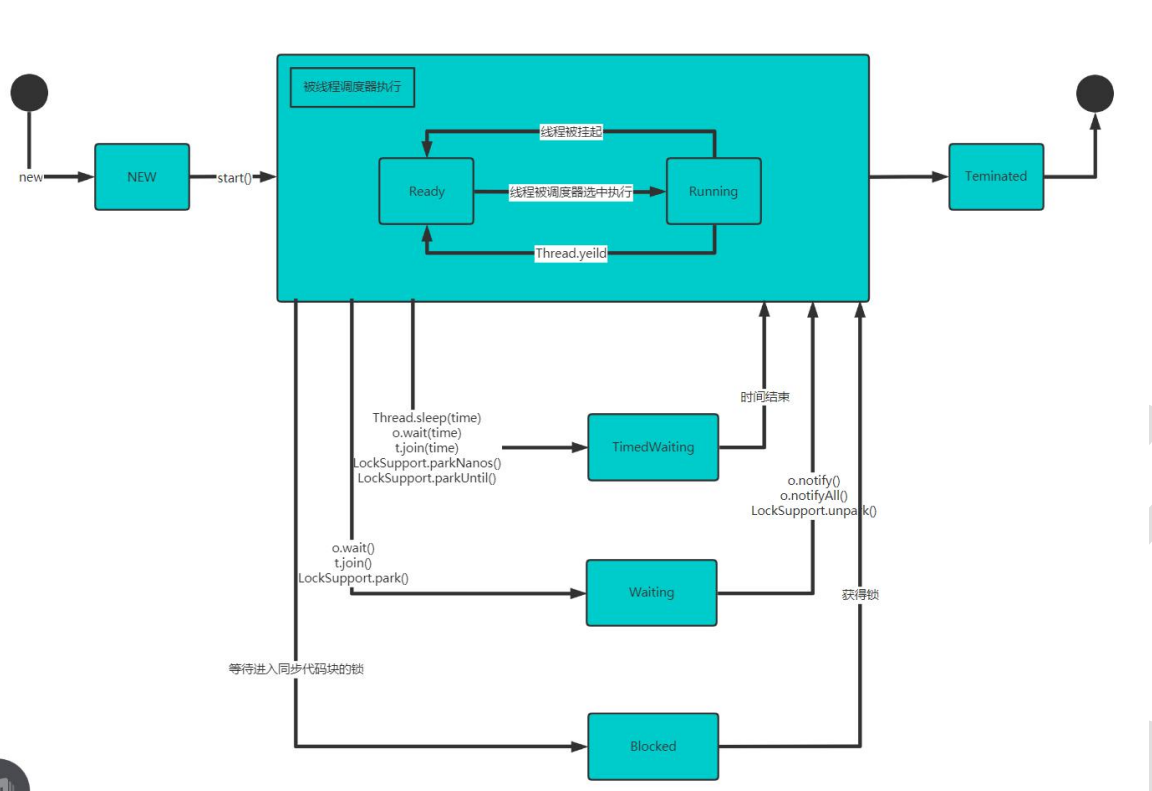
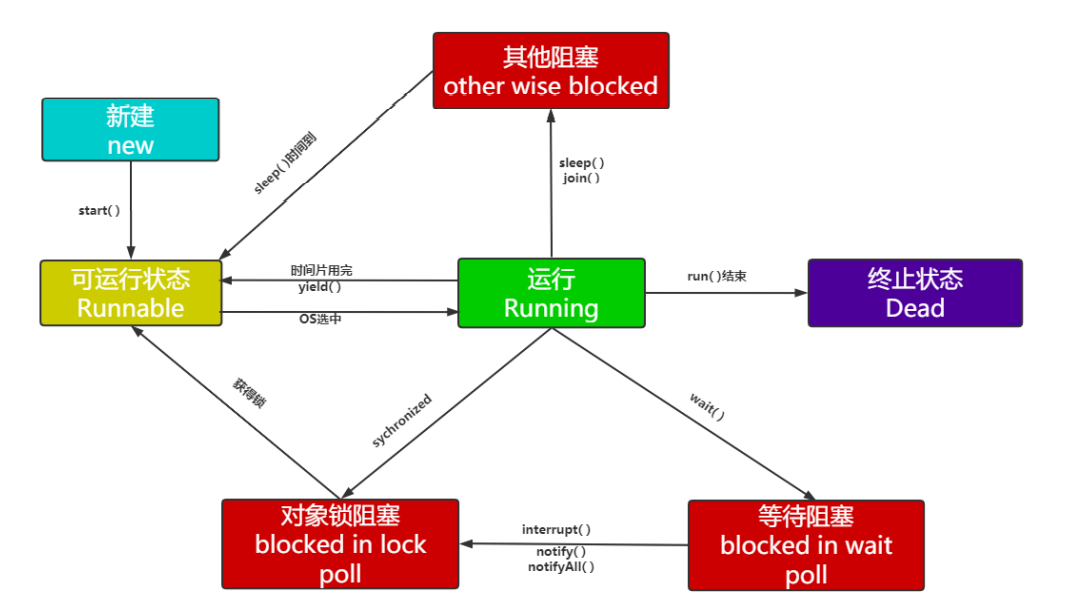
线程生命周期
JDK中用Thread.State枚举了线程的六种状态:
- NEW:(new)尚未启动的线程 处于此状态
- RUNNABLE:(runnable)在java虚拟机中执行的线程 处于此状态
- BLOCKED:(blocked)被阻塞等待监视器锁定的线程 处于此状态
- WAITING:正在等待另一个线程执行特定动作的线程 处于此状态
- TIMED_WAITING:正在等待另一个线程执行动作达到指定等待时间的线程 处于此状态
- TERMINATED:已退出的线程 处于此状态
线程状态转换图:
同步机制
在多线程编程中,为了防止部分数据被多个线程同时访问,所有就使用同步访问计数,保证数据在任何 同一时刻,最多被一个线程访问,以保证数据的完整性
实现同步的方法:Synchronized / Lock
Synchronized
同步代码块
1
2
3synchronized(对象){ //需要对象的锁,才能操作同步代码
被同步的代码;
}同步方法
1
2
3public synchronized void method(){
被同步的代码;
}1
2
3
4//静态同步方法的锁是加在当前类本身
public synchronized static vodi method(){
}
同步方法如果没有使用static修饰,默认锁对象是this,如果方法由static修饰,默认锁对象:当前类.class
Lock
Lock 是一种比 Synchroized更加灵活的一种加锁方式,使用的时候必须显示的加锁 :lock.lock ,然后 在释放锁的时候我们也需要显示的 lock.unlock 调用
1 | public void run(){ |
锁
互斥锁:
保证共享数据操作的完整性;每个对象都对应于一个可称为“互斥锁”的标记,这个标记用于保证在任一时刻,都只能有一个线程访问该对象;
关键字synchronized来与对象的互斥锁联系。当某个对象用synchronized修饰时,表明该对象在任一时刻只能由一个线程访问;
死锁:
多个线程都占用了对方的锁资源,但不肯让出资源,导致了死锁(必须要避免死锁发生)
释放锁:
- 当前线程的同步方法,同步代码块执行结束;
- 当前线程在同步方法,同步代码块中遇到break,return;
- 当前线程在同步方法,同步代码块中出现了未处理的Error或Exception,导致异常结束;
- 当前线程在同步方法,同步代码块中执行了线程对象的wait()方法,当前线程暂停,并释放锁;
注意:下面操作不会释放锁
- 线程执行同步方法,同步代码块时,程序调用了Thread.sleep(),Thread.yied()方法暂停当前线程的执行,不会释放锁;
- 线程执行同步代码块时,其他线程调用了该线程的suspend() 方法将该线程挂起,该线程不会释放锁;(尽量避免使用suspend() 和resume() 来控制程序,方法不再推荐使用)
网络编程
java.net包中包含的类和接口,提供了低层次的通信细节,因此我们专注于网络程序开发,而不用考虑通信的细节。
java.net包中提供了两种常见的网络协议的支持:TCP和UDP;
而对于IP地址,java中的InetAddress类表示互联网协议(IP)地址;
InetAddress类
无构造方法
常用方法:
**type[] getAddress( )**:返回此InetAddress对象的原始IP地址
**static Inetaddress getByName(String host)**:在给定主机名的情况下确定主机的IP地址
**String getHostAddress( )**:返回IP地址字符串(以文本表现形式)
**String getHostName( )**:获取此IP地址的主机名
**static InetAddress getLocalHost( )**:返回本地主机
127.0.0.1:本地主机,主要用于测试。
别名:Localhost
1 | //示例: |
InetSocketAddress类
InetSocketAddress类实现了IP套接字地址(IP地址+端口号)
注意:
- 编写的程序要占用端口号的话 只占用1024以上的端口号,1024以下的端口号不要去占用,因为系统有可能会随时征用。端口号本身又分为TCP端口和UDP端口,TCP的8888端口和UDP的8888端口是完全不同的两个端口。TCP端口和UDP端口都有65536个。(端口的表示是一个16位的二进制整数,2个字节,对应十进制的0~65535)(ssh 22, ftp 21, smtp, 25, http 80, tomcat 2020, mysql 3306, oracle 1521, sqlserver 1433)
DOS命令查看端口:
- 查看所有端口:netstat -ano
- 查看指定端口:netstat -ano|findstr “端口号”
- 查看指定端口的进程:tasklist|findstr “端口号”
InetSocketAddress类:
构造方法:
InetSocketAddress ( InetAddress addr, int port) :根据IP地址和端口号创建套接字地址。
**InetSocketAddress ( int port)**:创建套接字地址,其中IP地址为通配符地址,端口号为指定值。
**InetSocketAddress ( String hostname, int port)**:根据主机名和端口号创建套接字地址。
常用方法:
**InetAddress getAddress( )**:获取InetAddress(IP对象)
String getHostName( ):获取主机名
**int getPort( )**:获取端口号
TCP网络编程:
TCP通信能实现两台计算机之间的数据交互,通信的两端,要严格区分为客户端(Client)与服务端(Server)。
两端通信时步骤:
- 服务端程序,需要事先启动,等待客户端的连接。
- 客户端主动连接服务器端,连接成功才能实现通信。服务端不可以主动连接客户端。
java提供了两个类用于实现TCP通信程序:
- 客户端:用 java.net.Socket类实现。创建Socket对象,向服务端发出连接请求,服务端响应请求,两者建立连接开始通信。
- 服务端:用 java.netServerSocket类实现。创建ServerSocket对象,相当于开启一个服务,等待客户端的连接。
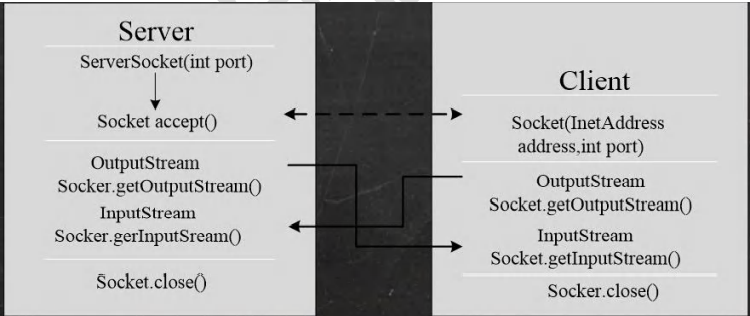
Socket类
Socket类实现客户端套接字,套接字指的是两台设备间通讯的端点。
构造方法:
**public Socket ( String host, int port)**:创建套接字对象并将其连接到指定主机上的指定端口号。如果指定的host是null,则相当于指定地址为回送地址。
回送地址(127.0.0.1)是本机回送地址(Loopback Address),主要用于网络让江测试以及本地机进程间通讯,无论什么程序,一旦使用回送地址发送数据,会立即返回,不进行任何网络传输。
1 | //示例: |
常用方法:
**public InputStream getInputStream( )**:返回此套接字的输入流
- 如果此Scoket具有相关联的通道,则生成的InputStream 的所有操作也关联该通道。
- 关闭生成的InputStream也将关闭相关的Socket。
**public OutputStream getOutputStream( )**:返回此套接字的输出流
- 如果此Socket具有相关联的通道,则生成的OutputStream 的所有操作也关联该通道。
- 关闭生成的OutputStream也将关闭相关的Socket。
**public void closs( )**:关闭此套接字
- 一旦一个socket被关闭,它不可再使用。
- 关闭此socket也将关闭相关的InputStream和OutputStream 。
public void shutdownOutput( ) : 禁用此套接字的输出流。
- 任何先前写出的数据将被发送,随后终止输出流。
ServerSocket类
ServerSocket类实现了服务器套接字,该对象等待通过网络的请求。
构造方法:
**public ServerSocket( int port)**:创建ServerSocket对象,并将其绑定到一个指定的端口号上,参数port就是端口号。
1 | ServerSocket server = new ServerSocket(6666); |
常用方法:
**public Socket accept( )**:侦听并接受连接,返回一个新的Socket对象,用于和客户端实现通信。该方法会一直柱塞直到建立连接。
注意:
- 服务器是没有IO流的,服务器可以获取到请求的客户端对象socket;
- 使用每个客户端socket中提供的IO流和客户端进行交互;
- 服务器使用客户端的字节输入流读取客户端发送的数据;
- 服务器使用客户端的字节输出流给客户端回写数据;
示例:客户端向客户端发送消息,服务端向客户端回写消息
客户端:
1 | public class TCPClient { |
服务端
1 | public class TCPServer { |
UDP网络编程
java.net包提供了两个类DatagramSocket类和DatagramPacket类
DatagramSocket类:表示用于发送和接收数据报的套接字DatagramPacket类:表示数据报的数据包。
DatagramSocket类
构造方法:
**protected DatagramSocket()**:构造数据报套接字并将其绑定到本地主机上的任何可用端口。
**protected DatagramSocket(int port)**:构造数据报套接字并将其绑定到本地主机上的指定端口。
**protected DatagramSocket(int port, InetAddress laddr)**:创建一个数据报套接字,绑定到指定的本地地址。
DatagramPacket类
构造方法:
DatagramPacket( byte[] buf, int offset, int length) :构造一个DatagramPacket对象用于接受指定长度的数据报 包到缓冲区。
**DatagramPacket( byte[] buf, int offset, int length, InetAddress address, int port)**:构造用于发送指定长度的数据报包 到指定主机的指定端口号上。
常用方法:
byte[] getData() :返回数据报包中的数据。
**InetAddress getAddress()**:返回该数据报发送或接收数据报的计算机的IP地址。
**int getLength()**:返回要发送的数据的长度或接收到的数据的长度。
1 | public class UDPSender { |
接受方:
1 | public class UDPReceiver { |
注意:
如果是TCP中先启动客户端会报错;而UDP中先启动发送方不会报错,但会正常退出;
案例:在线咨询功能,学生和老师一对一交流(多线程)
发送方:
1 | public class UDPSender implements Runnable { |
接受方
1 | public class UDPReceiver implements Runnable { |
学生线程:
1 | class Student { |
老师线程:
1 | public class Teacher { |
URL类
位于java.net包下
构造方法:
**URL(String spec)**:根据 String 表示形式创建 URL 对象。
URL(String protocol, String host, int port, String file) :根据指定协议名、主机名、端口号和文件名创建 URL 对象。
**URL(String protocol, String host, String file)**: 根据指定的协议名、主机名和文件名创建 URL。
常用方法:
**String getProtocol()**:获取此 URL的协议名称。
String getHost() :获取此 URL 的主机名。
int getPort() :获取此 URL 的端口号。
String getPath() :获取此 URL 的文件路径。
**String getFile()**:获取此 URL 的文件名。
**String getQuery()**:获取此 URL的查询部分。
URLConnection openConnection() :返回一个URLConnection实例,表示与URL引用的远程对象的URL
- URLConnection类中又有一个方法:
InputStream getInputStream() :返回从此打开的连接读取的输入流。
演示案例:URL下载网络资源
1 | public class Test { |
a
| x | f1(x) | f2(x) | f3(x) | f4(x) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 1 | 11 | 0 | 2 | 20 |
| 2 | 12 | 5 | 10 | 21 |
| 3 | 13 | 10 | 30 | 22 |
| 4 | 14 | 30 | 32 | 23 |
| 5 | 15 | 20 | 40 | 24 |
| x | F1(x) | F2(x) | F3(x) | F4(x) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 1 | 11 | 11 | 11 | 20 |
| 2 | 12 | 12 | 13 | 31 |
| 3 | 13 | 16 | 30 | 33 |
| 4 | 14 | 21 | 41 | 50 |
| 5 | 15 | 26 | 43 | 61 |
1 | for(int i = 2; i <= n; i++){//n为项目 |
反射
java程序有三个阶段:
- 代码阶段/编译阶段
- Class类阶段(加载阶段):当new一个对象时(类实例化),会在堆里加载一个Class类,里面存放类的成员变量,构造器,成员方法(通过类加载器ClassLoader从.class字节码文件中加载数据,体现了反射);会在方法区生成该类的字节码二进制数据/元数据;
- 运行阶段
反射机制
- 反射机制允许程序在运行期借助Reflection API 取得任何类的内部信息(比如成员变量,构造器,成员方法等),并能操作对象的属性及方法,反射在设计模式和框架底层都会用到;
- 加载完类之后,在堆中就产生了一个Class类型的对象(一个类只有一个Class对象),这个对象包含了类的完整结构信息,反射可以通过这个对象得到类的结构。
- 功能:
- 在运行时判断任意一个对象所属的类;
- 在运行时构造任意一个类的对象;
- 在运行时得到任意一个类所具有的成员变量和方法;
- 在运行时调用任意一个对象的成员变量和方法;
- 生成动态代理;
反射的主要类
java.lang.Class:代表一个类,Class对象表示某个类加载在堆中的对象;
java.lang.reflect.Method:代表类的方法,Method对象表示某个类的方法;
java.lang.reflect.field:代表类的成员变量,Field对象表示某个类的成员变量;
java.lang.reflect.Constructor:代表类的构造方法,Constructor对象表示构造器;
反射优点:可以动态的创建和使用对象(也是框架底层核心),使用灵活。
反射缺点:使用反射基本是解释执行,对执行速度有影响;
反射调用优化:Method和Field,Constructor对象都有setAccessible方法; 使用setAccessible(true)可以访问安全检查的开关;
使用反射:
1 | public class reflect { |
Class类
- Class类也继承Object类;
- Class类对象不是new出来的,而是系统创建的;
- 对于每个类的Class类对象,在内存中只有一份,因为类只加载一次;
- 每个类的实例 都知道自己是由哪个Class实例生成的;
- 通过Class对象可以完整地得到一个类的完整结构;
- Class对象存放在堆中;
- 类的 字节码二进制数据/元数据 是放在方法区的(包括类的方法代码,变量名,方法名,访问权限,返回值等);
Class类的常用方法:
**static Class forName (String name)**:返回指定类名name的Class对象;
Object newInstance( ) :调用缺省构造函数,返回该Class对象的一个实例;
getName( ) :返回此Class对象所表示的实体(类,接口,数组类,基本类型等)名称;
**Class[] getInterfaces( )**:获取当前Class对象的接口;
**ClassLoader getClassLoader( )**:返回该类的类加载器;
Class getSuperclass( ) :返回此Class所表示的试题的超类的Class;
Constructor[] getConstructors( ) :返回一个包含某些Constructor对象的数组;
**Field[] getDeclaredFields( )**:返回Field对象的一个数组;
Method getMethod( ) :返回一个Method对象,此对象的形参类型为paramType;
1 | public static void main(String[] args) throws ClassNotFoundException, IllegalAccessException, InstantiationException, NoSuchFieldException { |
获取Class对象
前提:已知一个类的全类名,且该类在类路径下,可通过Class类的静态方法 forName( ) 获取,如:**Class cls = Class.forName(“java.lang.Cat”)**;
应用场景:多用于配置文件,读取类全路径,加载类;
前提:若已知具体的类,通过类的class获取,该方式最为安全可靠,程序性能最高;如:Class cls = Cat.class;
应用场景:多用于参数传递,比如通过反射得到对应构造器对象;
前提:已知某个类的实例,调用该实例的getClass() 方法获取Class对象,如:Class cls = 对象.getClass(); //运行类型
应用场景:通过创建好的对象,获取Class对象;
先得到类加载器,再通过类加载器得到Class对象:
ClassLoader cl=对象.getClass().getClassLoader();
Class cls = cl.loadClass(“类的全类名”);
基本数据(int, char, boolean, float, double, byte, long, short)得到Class类对象:
Class cls = 基本数据类型.class
基本数据类型对应的包装类,可以通过 .TYPE得到Class对象:Class cls = 包装类.type
类加载
静态加载:编译时加载相关的类,如果没有则报错,依赖性强;
动态加载:运行时加载需要的类,如果运行时不用该类,即使不存在该类,也不报错,降低了依赖性;
类加载时机:
- 当创建对象时(new)//静态加载
- 当子类被加载时,父类也加载 //静态加载
- 调用类中的静态成员时 //静态加载
- 通过反射 //动态加载
类加载的三个阶段:
Java源码 —(javac编译)—> 字节码文件 —(java运行)—> 加载 –> 连接(验证,准备,解析)–> 初始化
加载阶段:将类的字节码从不同的数据源(可能是Class文件,jar包,网络)转化为二进制字节流加载到内存,并为之创建一个java.lang.Class对象,此过程由类加载器完成;
连接阶段:将类的二进制数据合并到JRE中;
验证:
目的:是为了确保Class文件的字节流中包含的信息符合当前虚拟机的要求,且不会危害虚拟机自身的安全。
包括:文件格式验证(是否以魔数oxcafebabe开头),元数据验证,字节码验证,符号引用验证;
可以考虑使用 -Xverify : none参数来关闭大部分的类验证措施,缩短虚拟机 类加载的时间;
准备:
JVM会在该阶段对静态变量分配内存并默认初始化,这些变量所使用的内存都将在方法区中进行分配;
1
2
3public int n1 = 10; //n1 是实例属性, 不是静态变量,因此在准备阶段,是不会分配内存
public static int n2 = 20; //n2 是静态变量,分配内存 n2 是默认初始化 0 ,而不是 20
public static final int n3 = 30;//n3 是 static final 是常量, 他和静态变量不一样, 因为一旦赋值就不变 n3 = 30解析:
到这里,才真正开始执行类中定义的Java程序代码,此阶段是执行 < clinit > ( ) 方法的过程;
< clinit > ( ) 方法 是由编译器按语句在源文件中出现的顺序,依次自动收集类中的所有静态变量的赋值动作和静态代码块中的语句,并进行合并;
虚拟机会保证一个类的< clinit > ( ) 方法在多线程环境中被正确地加锁、同步;
1
2
3
4
5
6protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException{
//因为有同步机制,能保证某个类在内存中, 只有一份 Class 对象
synchronized (getClassLoadingLock(name)) {
//....
}
}
初始化阶段:JVM负责对类进行初始化,这里主要是指静态成员;
反射获取类结构信息
java.lang.Class类
- getName:获取全类名
- getSimpleName:获取简单类名
- getFields:获取所有public修饰的属性,包括本类以及父类的
- getDeclaredFields:获取本类中所有属性
- getMethods:获取所有public修饰的方法,包括本类以及父类的
- getDeclaredMethods:获取本类中所有方法
- getConstructors:获取本类中所有public修饰的构造器
- getDeclaredConstructors:获取本类中所有构造器
- getPackage:以Package形式返回 包信息
- getSuperClass:以Class形式返回父类信息
- getInterfaces:以Class[] 形式返回接口信息
- getAnnotations:以Annotation[] 形式返回注解信息
java.lang.reflect.Field类
getModifiers:以int形式返回修饰符
(默认修饰符为0;public为1;private为2;protected为4;static为8;final为16)
getType:以Class形式返回 类型
getName:返回属性名
java.lang.reflect.Method类
getModifiers:以int形式返回修饰符
(默认修饰符为0;public为1;private为2;protected为4;static为8;final为16)
getReturnType:以Class形式获取 返回类型
getParameterTypes:以Class[] 返回参数类型数组
java.lang.reflect.Constructor类
- getModifiers:以int形式返回修饰符
- getName:返回构造器名(全名)
- getParameterTypes:以Class[] 形式返回参数类型数组
1 | public class reflect { |
反射创建对象
方式一:调用类中的public修饰的无参构造器
方式二:调用类中的指定构造器
方式三:Class类相关方法:newInstance,getConstructor,getDecalaredConstructor
方式四:Constructor类相关方式:setAccessible,newInstance
1 | public class reflect2 { |
反射访问类中成员
访问属性:
根据属性名获取Field对象
1
Field f = class对象.getDeclaredField(属性名);
爆破:f.setAccessible (true); //f是Field
访问:
f.set(o值); //o表示对象
syso(f.get(o));//o表示对象
(如果是静态属性,则set和get中的参数o可以写成null)
1 | public class reflect3 { |
访问方法:
根据方法名和参数列表获取Method方法对象:Method m = class.getDeclaredMethod(方法名,XX.class);//得到本类的所有方法
获取对象:Object o = class.newInstance();
爆破:m.setAccessible(true);
访问:Object.returnValue = m.invoke(o,实参列表); //o就是对象
(如果是静态方法,则invoke的参数o,可以写成null)
1 | public class reflect4 { |
正则表达式
(String能使用正则表达式,如
string.replaceAll(“aaa”, “AAA”);
string.matches(“1(38|39)\d{8}”);(返回true或false)
String[] split = string.split(“#|-|~|\\d+”);
(stirng都是指一个字符串)
)
正则表达式
1 | String content; //目标串 |
正则表达式中的()表示分组,第一个()表示第一组..
底层:
根据指定的表达式规则,定位到满足规则的子字符串;
找到后,将子字符串的开始索引值和结束索引值+1记录到 int[] groups;
同时记录oldLast的值为子字符串的结束索引值+1,即下一次执行find时,就从oldLast开始;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15//源码
public String group(int group) {
if (first < 0)
throw new IllegalStateException("No match found");
if (group < 0 || group > groupCount())
throw new IndexOutOfBoundsException("No group " + group);
if ((groups[group * 2] == -1) || (groups[group * 2 + 1] == -1))
return null;
return getSubSequence(groups[group * 2], groups[group * 2 + 1]).toString();
}
//group(0)表示匹配到的子字符串
//group(1)表示匹配到的子字符串的第一组子串
//group(2)表示匹配的子字符串的第二组子串
//...但是分组的数不能越界,否则报错
System.out.println("第 1 组()匹配到的值=" + matcher.group(1));
语法
限定符
| 符号 | 含义 | 示例 | 解释 |
|---|---|---|---|
| * | 指定字符字符重复0到多次 | (abc)* | 仅包含任意个abc字符串 |
| + | 指定字符重复1到多次 | (abc)+ | 仅包含至少一个abc字符串 |
| ? | 指定字符重复0或1次 | abc? | ab或abc |
| {n} | 只能输入n个字符 | [abcd]{3} | 由abcd中字母组成的任意长度为3的字符串 |
| {n,} | 指定至少n个匹配 | [abcd]{3,} | 由abcd中字母组成的任意长度不小于3的字符串 |
| {n,m} | 指定至少n个到m个之间的匹配 | [abcd]{3,5} | 由abcd中字母组成的任意长度不小于3,不大于5的字符串 |
选择匹配符
有选择性的匹配字符:|
|:匹配之前或之后的表达式
如:ab|cd :匹配ab或cd
分组组合和方向应用符
在表达式分组中:
(表达式):非命名捕获,编号为0的第一个捕获是整个表达式模式匹配的文本,其他捕获则根据括号顺序从1开始编号;
**(?< name>表达式)**:命名捕获,将匹配到的子字符串捕获到一个组名或编号name中。name不能包含任何标点符号,不能以数字开头,可以使用单引号代替<>
(?:表达式):
非捕获匹配(即匹配但不存储),例:“industr(?:y|ies)”效果与”industry|intdustries“相同,但更经济;
(?=表达式):
是非捕获匹配 ,例:“Windows(?=95|98|NT)”匹配“Windows 95”中的“Windows”,但不匹配“Windows 3.1”中的“Windows”;
(?!表达式):
非捕获匹配,例:“Windows(?!95|98|NT)”匹配“Windows 3.1”中的“Windows”,但不匹配“Windows 98”中的“Windows”;
特殊字符
对于已经有特殊的含义的字符,想要匹配这些字符,就需要加上转义符号:**\\**(java中使用两个\,其他语言使用一个\);
需要用到转义符号的字符有: . * + ( ) $ / \ ? [ ] ^ { }
字符匹配符
| 符号 | 含义 | 示例 | 解释 |
|---|---|---|---|
| [ ] | 可接收的字符列表 | [efgh] | efgh中任意一个字符 |
| [^ ] | 不可接收的字符列表 | [^abc] | 除了a,b,c之外的任意一个字符,包括特殊符号 |
| - | 连字符 | A-Z | 任意单个大写字符 |
| . | 匹配除\n外的任何字符 | a..b | 以a开头,b结尾,中间任意2个字符 |
| \\d | 匹配单个数字字符,相当于[0-9] | \\d{3}(\\d)? | 包含3个或4个数字的字符串 |
| \\D | 匹配单个非数字字符,相当于[ ^ 0-9 ] | \\D(\\d)* | 以单个非数字字符开头,后接任意个数字 |
| \\w | 匹配单个数字,大小写字母,相当于[0-9a-zA-Z] | \\w{4} | 长度为4的数字字母字符串 |
| \\W | 匹配单个非数字,大小写字母,相当于[ ^ 0-9a-zA-Z] | \\W+\\d{2} | 以至少一个非数字字母字符开头,2个数字结尾 |
| \\s | 匹配任何空白字符(空格,制表符) |
定位符
| 符号 | 含义 | 示例 | 解释 |
|---|---|---|---|
| ^ | 指定起始字符 | ^[0-9]+[a-z]* | 至少一个数字开头,后接任意小写字母 |
| $ | 指定结束字符 | ^[0-9] [a-z]+$ | 以一个数字开头,后接至少一个小写字母结尾 |
| \\b | 匹配目标字符串的边界 | can\\b | 边界指空格或结束位置,如:cancan ccan |
| \\B | 匹配目标字符串的非边界 | can\\B | 如:cancan can |
常用类
Pattern类,Matcher类,PatternSyntaxException
Pattern对象是一个正则表达式对象,Pattern类没有公共构造方法,要创建对象,应调用其公共静态方法,它接收一个正则表达式作为参数,返回一个Pattern对象。
1 | Pattern compile = Pattern.compile(regStr,Pattern.CASE_INSENSITIVE); |
Matcher对象是对输入字符串进行解释和匹配的引擎。与Pattern类一样,Matcher也没有公共构造方法,需要调用Pattern对象的matcher方法或获得一个Matcher对象;
PatternSyntaxException是一个非强制性异常类,它表示一个正则表达式模式中的语法错误;
反向引用
分组:
正则表达式中的 一个括号的部分可以看成是一个分组/子表达式;
捕获:
分组匹配到的内容,会保存到以数字编号或显示命名的组里,方便后面引用;
反向引用:
圆括号(分组)的内容被捕获后,可以在这个括号后被使用;这种引用可以在内部使用,也可以在外部使用;
内部:\\分组号
外部:**$分组号**
如:要匹配两个连续的相同数字: (\\d)\\1
要匹配五个连续的相同数字:(\\d)\\1{4}
要匹配个位与千位相同,十位与百位相同的数(5225,1551):(\\d)(\\d)\\2\\1
程序案例:结巴去重
把 类似 : “我….我要….学学学学….编程 java!”
通过正则表达式 修改成 “我要学编程 java” ;(即没有连续重复的字符)
1 | String content = "我....我要....学学学学....编程 java!"; |
简化:
1 | //3. 使用一条语句 去掉重复的字 我我要学学学学编程 java! |
元字符-详细说明
| 字符 | 说明 |
|---|---|
| \ | 将下一字符标记为特殊字符、文本、反向引用或八进制转义符。例如,”n”匹配字符”n”。”\n”匹配换行符。序列”\\“匹配”\“,”\(“匹配”(“。 |
| ^ | 匹配输入字符串开始的位置。如果设置了 RegExp 对象的 Multiline 属性,^ 还会与”\n”或”\r”之后的位置匹配。 |
| $ | 匹配输入字符串结尾的位置。如果设置了 RegExp 对象的 Multiline 属性,$ 还会与”\n”或”\r”之前的位置匹配。 |
| ***** | 零次或多次匹配前面的字符或子表达式。例如,zo* 匹配”z”和”zoo”。* 等效于 {0,}。 |
| + | 一次或多次匹配前面的字符或子表达式。例如,”zo+”与”zo”和”zoo”匹配,但与”z”不匹配。+ 等效于 {1,}。 |
| ? | 零次或一次匹配前面的字符或子表达式。例如,”do(es)?”匹配”do”或”does”中的”do”。? 等效于 {0,1}。 |
| {*n*} | *n* 是非负整数。正好匹配 *n* 次。例如,”o{2}”与”Bob”中的”o”不匹配,但与”food”中的两个”o”匹配。 |
| {*n*,} | *n* 是非负整数。至少匹配 *n* 次。例如,”o{2,}”不匹配”Bob”中的”o”,而匹配”foooood”中的所有 o。”o{1,}”等效于”o+”。”o{0,}”等效于”o*“。 |
| {*n*,*m*} | *m* 和 *n* 是非负整数,其中 *n* <= *m*。匹配至少 *n* 次,至多 *m* 次。例如,”o{1,3}”匹配”fooooood”中的头三个 o。’o{0,1}’ 等效于 ‘o?’。注意:您不能将空格插入逗号和数字之间。 |
| ? | 当此字符紧随任何其他限定符(*、+、?、{*n*}、{*n*,}、{*n*,*m*})之后时,匹配模式是”非贪心的”。”非贪心的”模式匹配搜索到的、尽可能短的字符串,而默认的”贪心的”模式匹配搜索到的、尽可能长的字符串。例如,在字符串”oooo”中,”o+?”只匹配单个”o”,而”o+”匹配所有”o”。 |
| . | 匹配除”\r\n”之外的任何单个字符。若要匹配包括”\r\n”在内的任意字符,请使用诸如”[\s\S]”之类的模式。 |
| (*pattern*) | 匹配 *pattern* 并捕获该匹配的子表达式。可以使用 $0…$9 属性从结果”匹配”集合中检索捕获的匹配。若要匹配括号字符 ( ),请使用”(“或者”)“。 |
| (?:*pattern*) | 匹配 *pattern* 但不捕获该匹配的子表达式,即它是一个非捕获匹配,不存储供以后使用的匹配。这对于用”or”字符 (|) 组合模式部件的情况很有用。例如,’industr(?:y|ies) 是比 ‘industry|industries’ 更经济的表达式。 |
| (?=*pattern*) | 执行正向预测先行搜索的子表达式,该表达式匹配处于匹配 *pattern* 的字符串的起始点的字符串。它是一个非捕获匹配,即不能捕获供以后使用的匹配。例如,’Windows (?=95|98|NT|2000)’ 匹配”Windows 2000”中的”Windows”,但不匹配”Windows 3.1”中的”Windows”。预测先行不占用字符,即发生匹配后,下一匹配的搜索紧随上一匹配之后,而不是在组成预测先行的字符后。 |
| (?!*pattern*) | 执行反向预测先行搜索的子表达式,该表达式匹配不处于匹配 *pattern* 的字符串的起始点的搜索字符串。它是一个非捕获匹配,即不能捕获供以后使用的匹配。例如,’Windows (?!95|98|NT|2000)’ 匹配”Windows 3.1”中的 “Windows”,但不匹配”Windows 2000”中的”Windows”。预测先行不占用字符,即发生匹配后,下一匹配的搜索紧随上一匹配之后,而不是在组成预测先行的字符后。 |
| x*|*y** | 匹配 *x* 或 *y*。例如,’z|food’ 匹配”z”或”food”。’(z|f)ood’ 匹配”zood”或”food”。 |
| [*xyz*] | 字符集。匹配包含的任一字符。例如,”[abc]”匹配”plain”中的”a”。 |
| [^*xyz*] | 反向字符集。匹配未包含的任何字符。例如,”[^abc]”匹配”plain”中”p”,”l”,”i”,”n”。 |
| [*a-z*] | 字符范围。匹配指定范围内的任何字符。例如,”[a-z]”匹配”a”到”z”范围内的任何小写字母。 |
| [^*a-z*] | 反向范围字符。匹配不在指定的范围内的任何字符。例如,”[^a-z]”匹配任何不在”a”到”z”范围内的任何字符。 |
| \b | 匹配一个字边界,即字与空格间的位置。例如,”er\b”匹配”never”中的”er”,但不匹配”verb”中的”er”。 |
| \B | 非字边界匹配。”er\B”匹配”verb”中的”er”,但不匹配”never”中的”er”。 |
| \c*x* | 匹配 *x* 指示的控制字符。例如,\cM 匹配 Control-M 或回车符。*x* 的值必须在 A-Z 或 a-z 之间。如果不是这样,则假定 c 就是”c”字符本身。 |
| \d | 数字字符匹配。等效于 [0-9]。 |
| \D | 非数字字符匹配。等效于 [^0-9]。 |
| \f | 换页符匹配。等效于 \x0c 和 \cL。 |
| \n | 换行符匹配。等效于 \x0a 和 \cJ。 |
| \r | 匹配一个回车符。等效于 \x0d 和 \cM。 |
| \s | 匹配任何空白字符,包括空格、制表符、换页符等。与 [ \f\n\r\t\v] 等效。 |
| \S | 匹配任何非空白字符。与 [^ \f\n\r\t\v] 等效。 |
| \t | 制表符匹配。与 \x09 和 \cI 等效。 |
| \v | 垂直制表符匹配。与 \x0b 和 \cK 等效。 |
| \w | 匹配任何字类字符,包括下划线。与”[A-Za-z0-9_]”等效。 |
| \W | 与任何非单词字符匹配。与”[^A-Za-z0-9_]”等效。 |
| \x*n* | 匹配 *n*,此处的 *n* 是一个十六进制转义码。十六进制转义码必须正好是两位数长。例如,”\x41”匹配”A”。”\x041”与”\x04”&”1”等效。允许在正则表达式中使用 ASCII 代码。 |
| *num* | 匹配 *num*,此处的 *num* 是一个正整数。到捕获匹配的反向引用。例如,”(.)\1”匹配两个连续的相同字符。 |
| *n* | 标识一个八进制转义码或反向引用。如果 *n* 前面至少有 *n* 个捕获子表达式,那么 *n* 是反向引用。否则,如果 *n* 是八进制数 (0-7),那么 *n* 是八进制转义码。 |
| *nm* | 标识一个八进制转义码或反向引用。如果 *nm* 前面至少有 *nm* 个捕获子表达式,那么 *nm* 是反向引用。如果 *nm* 前面至少有 *n* 个捕获,则 *n* 是反向引用,后面跟有字符 *m*。如果两种前面的情况都不存在,则 *nm* 匹配八进制值 *nm*,其中 *n* 和 *m* 是八进制数字 (0-7)。 |
| \nml | 当 *n* 是八进制数 (0-3),*m* 和 *l* 是八进制数 (0-7) 时,匹配八进制转义码 *nml*。 |
| \u*n* | 匹配 *n*,其中 *n* 是以四位十六进制数表示的 Unicode 字符。例如,\u00A9 匹配版权符号 (©)。 |
函数式编程
Lambda表达式
Lambda表达式是JDK8中的一个语法糖。可以对某些匿名内部类的写法进行简化。(是函数式编程思想的一个重要体现)
核心原则: 可推导可省略
基本格式:
1 | (参数列表)->{代码} |
省略规则:
- 参数类型可以省略;
- 方法体只有一句代码时,大括号return和唯一一句代码的分号可以涉略;
- 方法只有一个参数时小括号可以省略;
例1:接口只有一个方法需要重写,且以匿名内部类的形式出现
1 | //正常写法 |
Stream流
java8的Stream使用的是函数式编程模式,可以被用来对集合或数据进行链状流式的操作。(跟IO流是两码事)
现有一个需求:
将list集合中姓张的元素过滤到一个新的集合中
然后将过滤出来的姓张的元素中,再过滤出来长度为3的元素,存储到一个新的集合中
1.用常规方法解决需求
1 | // 已知的知识来解决需求 |
2.用Stream流操作集合,获取流,过滤操作,打印输出
1 | list1.stream() |
流式思想 类似于 工厂车间的“流水线”
获取流:根据集合来获取:
根据Collection获取流:
Collection接口中有一个stream()方法,可以获取流
1 | default Stream<E> stream() |
1.根据List获取流
2.根据Set获取流
3.根据Map获取流
3.1根据Map集合的键来获取流
3.2根据Map集合的值获取流
3.3根据Map集合的键值对对象获取流
4.根据数组获取流
代码演示:
1.根据List集合获取流
1 | // 创建List集合 |
2.根据Set集合获取流
1 | // 创建List集合 |
3.根据Map集合获取流
1 | // 创建Map集合 |
4.根据数组获取流
1 | // 根据数组获取流 |
Stream流的常用方法:
终结方法:返回值类型不再是Stream接口本身类型的方法,例如:forEach方法和count方法
非终结方法/延迟方法:返回值类型仍然是Stream接口自身类型的方法,除了终结方法都是延迟方法。例如:filter,limit,skip,map,conat
| 方法名称 | 方法作用 | 方法种类 | 是否支持链式调用 |
|---|---|---|---|
| count | 统计个数 | 终结方法 | 否 |
| forEach | 逐一处理 | 终结方法 | 否 |
| filter | 过滤 | 函数拼接 | 是 |
| limit | 取用前几个 | 函数拼接 | 是 |
| skip | 跳过前几个 | 函数拼接 | 是 |
| map | 映射 | 函数拼接 | 是 |
| concat | 组合 | 函数拼接 | 是 |
方法演示:
- count方法:
long count (); 统计流中的元素,返回long类型数据
1 | List<String> list = new ArrayList<>(); |
- filter方法:
Stream<T> filter(Predicate<? super ?> predicate); 过滤出满足条件的元素
参数Predicate:函数式接口,抽象方法:boolean test (T t)
Predicate接口:是一个判断接口
1 | // 获取stream流 |
- forEach方法
void forEach(Consumer<? super T> action):逐一处理流中的元素
参数 Consumer<? super T> action:函数式接口,只有一个抽象方法:void accept(T t);
注意:
1.此方法并不保证元素的逐一消费动作在流中是有序进行的(元素可能丢失)
2.Consumer是一个消费接口(可以获取流中的元素进行遍历操作,输出出去),可以使用Lambda表达式
1 | List<String> list = new ArrayList<>(); |
- limit方法
Stream<T> limit(long maxSize); 取用前几个元素
注意:
参数是一个long 类型,如果流的长度大于参数,则进行截取;否则不进行操作
1 | // 获取流的长度 |
- map方法
<r> Stream <R> map(Function<? super T,? exception R> mapper;
参数Function<T,R>:函数式接口,抽象方法:R apply(T t);
Function<T,R>:其实就是一个类型转换接口(T和R的类型可以一致,也可以不一致)
1 | // 获取Stream流 |
- skip方法
Stream<T> skip(long n); 跳过前几个元素
注意:
如果流的当前长度大于n,则跳过前n个,否则将会得到一个长度为0的空流
1 | // 获取stream流 |
- concat方法
public static <T> Stream<T> concat(Stream<? extends T> a, Stream<? extends T> b)
–> 合并两个流
1 | Stream<String> stream1 = Stream.of("11","22","33","44","55"); |
收集Stream流:
Stream流中提供了一个方法,可以把流中的数据收集到单例集合中
<R, A> R collect(Collector<? super T, A, R> collector); 把流中的数据到单收集列集合中
返回值类型是R。R指定为什么类型,就是手机到什么类型的集合
参数Collector<? super T, A, R>中的R类型,决定把流中的元素收集到哪个集合中
参数Collector如何得到 ?,可以使用 java.util.stream.Collectors工具类中的静态方法:
- public static <T> Collector<T, ?, List<T>> toList():转换为List集合
- public static <T> Collector<T, ?, Set<T>> toSet() :转换为Set集合
1 | List<String> list2 = new ArrayList<>(); |
设计模式
单例设计模式
采用一定的方法保证在整个软件系统中,对某个类,只能存在一个对象实例,且该类只提供一个取得其对象实例的方法。
步骤:
- 构造器私有化,防止直接new;
- 在类的内部创建对象;
- 向外暴露一个静态的公共方法
饿汉式和懒汉式区别:
- 创建时机不同,饿汉式是在类加载就创建了对象实例,而懒汉式是使用时才创建;
- 饿汉式不存在线程安全问题,懒汉式存在线程安全问题;
- 饿汉式存在资源浪费问题,如果使用时一个对象实例都没使用,饿汉式创建的对象就浪费了;
饿汉式:
1 | class Instance{ |
懒汉式:
1 | class Instance{ |
模板设计模式
API
Object类
**equals(object o)**:指示其他对象是否与此对象相等
finalize()
当垃圾收集确定不再有对该对象的引用时,垃圾收集器在对象上调用该对象。
**getclass()**:返回此 Object的运行时类。
**hashcode()**:返回对象的哈希码值
**toString()**:返回对象的字符串表示形式
**clone()**:创建并返回此对象的一个副本
notify()
notifyAll()
wait()
==与equals的对比:
==是一个比较运算符
- == 判断基本类型时,判断值是否相等
- == 判断引用类型时,判断地址是否相等,即是不是同一个对象
equals是Objects类中的方法,只能判断引用类型,默认判断地址是否相等,不过其子类往往重写该方法,用于判断内容是否相等,如Integer, String
1 | //Object中的equals方法 |
hashcode方法
- 提高具有哈希结构的容器的效率;
- 两个引用,如果指向同一个对象,则哈希值肯定是一样的;
- 两个引用,如果指向不同的对象,则哈希值不一样;
- 哈希值主要根据地址号 计算得来的,不能完全将哈希值等价与地址
重写hahscode:
toString方法
Object的toString方法默认返回:全类名 + @ + 哈希值的十六进制;子类往往重写toString方法,用于返回对象的属性信息;
1 | //Object的toString方法 |
finalize方法
当对象被回收时,系统自动调用该对象的finalize方法。子类可以重写该方法,做一些释放资源的操作
什么时候被回收:当某个对象没有任何引用时,则jvm就认为该对象是一个垃圾对象,就会使用垃圾回收机制来销毁对象,在销毁该对象前,会先调用finalize方法;
垃圾回收机制的调用,是由系统来决定 ( 即有自己的 GC 算法 ) ,也可以通过 System.gc() 主动触发垃圾回收机制
(实际开发中,几乎不会用到finalize)
Collections类
reverse(List):反转List中元素的顺序;
shuffle(List):对List中元素进行随机排序;
swap(List, int ,int):交换List中两个元素的位置
Object max(Collection):返回给定集合中最大元素
Object max(Collection,Comparator):根据Comparator指定的顺序,返回最大元素;
min跟max一样
int frequency(Collection, Object):返回指定集合中指定元素的出现次数
void copy(List dest,List src):将src复制到dest中
boolean replaceAll(List list,Object oldVal,Object newVal):使用新值,替换掉List中所有旧值
sort():
Map, Set, List等集合中,都提供了一个排序方法:**sort()**,不过要保证集合中的对象是可比较的;
让对象是 可比较的, 可以让对象实现 Comparable< T>接口,然后重写里面的**compareTo()**方法,
compareTo(Object o):
1 | public int compareTo(Student o) { |
| 返回值 | 含义 |
|---|---|
| 负整数 | 当前对象的值 < 比较对象的值 , 位置排在前 |
| 零 | 当前对象的值 = 比较对象的值 , 位置不变 |
| 正整数 | 当前对象的值 > 比较对象的值 , 位置排在后 |
比较器的使用:
(例题可看 笔记(数据结构 ) —堆 692.前k个高频词)
想要排序集合中的其他元素,可以使用Comparator :
- Collertions.sort ( list , Comparator< T> ) ;
- list.sort ( Comparator< T>) ;
1 | //自定义排序1 |
1 | //自定义排序2 |
Scanner类
1 | import java.util.Scanner; |
当通过new Scanner(System.in)创建一个Scanner,控制台会一直等待输入,直到敲回车键结束,把所输入的内容传给Scanner,作为扫描对象。
如果要获取输入的内容,则只需要调用Scanner的nextLine()方法即可。
1 | Scanner s = new Scanner(System.in); |
Scanner类主要提供了两个方法来扫描输入:
1)**hasNextXx()**:是否还有下一个输入项,其中Xxx可以是Int、Long等代表基本数据类型的字符串。如果只是判断是否包含下一个字符串,则直接使用hasNext()。
2)**nextXxx()**:获取下一个输入项。Xxx的含义同上。
默认情况下,Scanner使用空白(包括空格、Tab空白和回车)作为多个输入项的分隔符。
1 | public class Test{ |
String类
1 | public final class String |
String 类是被 final 修饰的,即 String 类不能被继承。
其中有一个很重要的数组,char 数组,用来保存字符串的,既然是用 final 关键字来修饰的,那就代表 String 是不可变的(不能指向新地址,但char[]里面的单个字符可改)
在源代码中,substring,replace 最后都是通过 new String(xxx) 来产生了一个新的 String 对象,最原始的字符串并没有改变。
(String实现了serializable接口,说明可以串行化(可以在网络上传输),实现了comparable接口,说明String对象可以比较;)
而StringBuilder中的字符可变
比如使用append方法,返回的依然是 StringBuffer 对象本身,说明他确实是值改变了
1 | public StringBuilder append(String str) { |
该方法实际调用的是 StringBuilder 的父方法。该父方法,会先检测容量够不够,不够的话会进行扩容,然后调用 String 的 getChars 方法。注意,最后返回的依旧是 StringBuffer 对象
关于字符串相加:
使用“+”对两个字符串相加的过程:
String 对象的操作符“+”其实被赋予了特殊的含义,该操作符是 Java 中仅有的两个重载过的操作符。
String 对象在进行“+”操作的时候,其实是调用了StringBuilder 对象的 append() 方法来加以构造
1 | String a1 = "helloworld"; //a1指向常量区 |
看 String a,“hello” + “world” 在 String 编译期间进行优化,优化结果为 “helloworld”,而该值在常量池中已经存有一份,因此 a 也指向了该常量池中的字符串,因此 a1 和 a 相等;
在对 b 和 c 进行相加的过程中:1. xia你创建StringBuilder sb = StringBuilder();2. 执行sb.append(“hello”); 再执行一次sb.append(“world”); 3. String d = sb.toString();
很明显 d 对象指向的是堆中的 String 对象,而 a1 则指向的是常量池中的字符串,两者引用明显不同,
小结:String s = “ab” + “cd”:常量相加,看的是池;String s = a + b : 变量相加,是在堆中
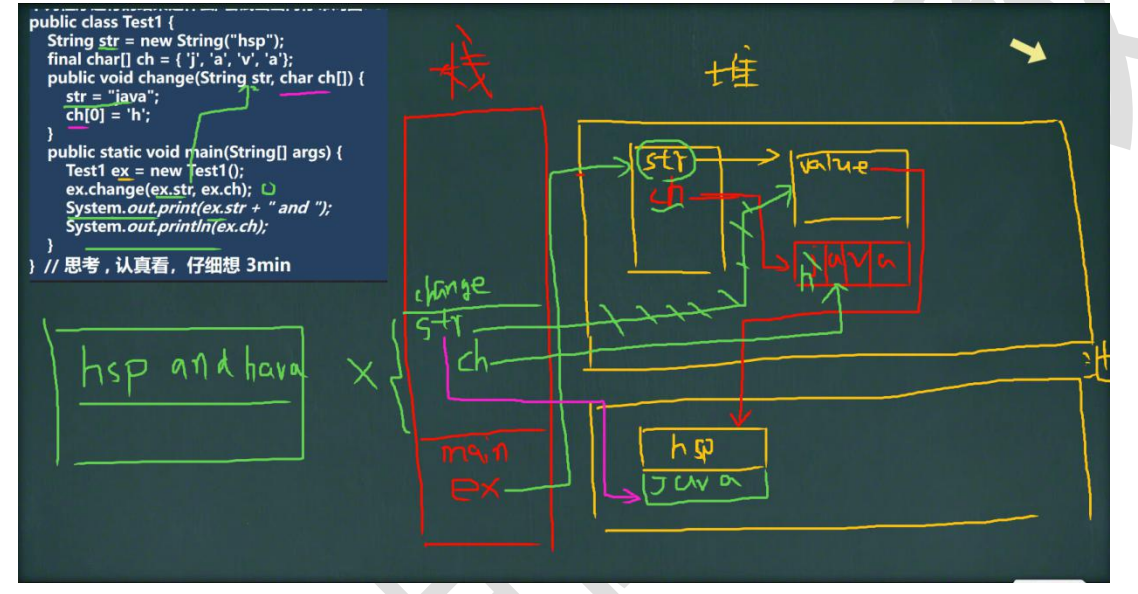
创建的两种方式:
1 | String s = "ssss"; |
构造器 参数列表有多种:(String s), (char[] a ), (char[] a, int startIndex, int count), (byte[] b) ….
int **indexOf(int ch) : ** lastIndexOf(int ch) :
返回指定字符第一次(最后一次)出现处的索引
int **indexOf(String str) ** / lastIndexOf(String str)
返回指定 子字符串 第一次出现处的索引
char cahrAt(int index) :
返回index’位置上的字符
concat( String s) : 拼接字符串
boolean endsWith(String suffix) :
判断此字符串是否以指定的字符串结尾
boolean startsWith(String prefix) :
判断此字符串是否以指定的字符串开始
int length() : 返回此字符串的长度
boolean equals (Object anObject) :
将此字符串与指定的字符串比较
equaIsIgnoreCase :忽略大小写的判断内容相等
boolean isEmpty() :
此字符串长度为0时返回true
boolean contains(CharSequence cs) :
判断是否包含指定的字符序列
String toLowerCase() :
将String中的所有字符都转换为小写(使用默认语言环境的规则)
String toUpperCase() :
将String中的所有字符都转换为大写
static String valueOf(int i) :
返回int参数的字符串表示形式
char[] toCharArray() :
将此字符串转换为一个字符数组
String replace(CharSequence oldstr, CharSequence newstr) :
返回新的字符串,用newstr替换所有的oldstr
String[] split(String regex) :
根据参数regex(regex是一个正则表达式,用于限定分隔规则)将此字符串分割为若干个字符串
String substring(itn beginIndex) :
返回一个新字符串,从指定的beginIndex开始,直至末尾
String substring(itn beginIndex, int endIndex) :
返回一个新字符串,从指定的beginIndex到endIndex - 1
String trim() :
返回一个新字符串,它去除了原字符串 首尾的空格
format(String s, …):格式化字符串,%s 字符串,%c 字符 …
1 | String info = String.format(s, ....); |
Strng方法练习:
1 | public class Main { |
StringBuffer类
StringBuffer代表可变的字符序列,可以对字符串内容进行增删;是一个final类,不能被继承;
很多方法与String相同,StringBuffer是一个容器;
StringBuffer中的char[] value没有加final,所以可以增删字符,且放在堆中
String与StringBuffer的转换
1 | //String -> StringBuffer |
StringBuffer方法
append( String s) :末尾增添字符串
delete( int start, int end) :删,将start到end的内容删掉,不包括end
replace( int start, int end, String s) :改,将start到end的内容换掉,不包括end
insert(int index, String s) :插,在索引n处插入字符串,索引n后的内容自动后移
1 | String s = null; |
StringBulider类
StringBulider提供一个与 StringBuffer兼容的API,但不保证同步(不是线程安全)。该类被设计作为StringBuffer的一个简易替换,用在字符串缓冲区被单个线程使用的时候。
StringBuilder类的方法和StringBuffer类的一样
String,StringBuffer,StringBuilder的比较
- String:不可变字符序列,效率低,但复用率高
- StringBuffer:可变序列,效率较高,线程安全
- StringBuilder:可变序列,效率最高,线程不安全
所以,如果字符串存在大量修改操作:在单线程时用StringBuilder,在多线程时用StringBuffer;如果字符串很少修改,且被多个对象引用,使用String。
Arrays类
数组转List
1 | Integer arr[] = new Integer[]{3, 10, 4, 0, 2}; |
1 | //上面的转换,拆开: |
Arrays.fill() ;填充数组
1 | Arrays.fill(arr,4);//给所有值赋值4 |
Arrays.sort(); //数组排序
1 | Arrays.sort(intArray); |
Arrays.sort(T[] a, Comparator<? super T> c) //自定义数组排序
1 | Arrays.sort(a, new Comparator<Integer>() { |
Arrays.toString(); //将数组中的内容全部打印出来
1 | System.out.print(arr);//直接将数组打印输出 |
Arrays.equals(); //比较数组元素是否相等
1 | int[] arr1 = {1,2,3}; |
Arrays.binarySearch(); //二分查找法找指定元素的索引值(下标)
1 | Arrays.binarySearch(arr, 30) |
Arrays.copeOf() 和Arrays.copeOfRange(); //截取数组
1 | int[] arr1 = Arrays.copyOf(arr, 3); |
对数组元素采用指定的方法计算
1 | array = new int[]{3, 10, 4, 0, 2}; |
自定义排序规则
Arrays.sort方法和Collections.sort方法都提供了一个可以接收Comparator实例作为第二个参数的版本。
像Comparator、Runable等这=一些接口有一个特点就是只有一个抽象方法(其他的都是static或者default的方法),比如继承Comparator接口只需要重写compare方法,继承Runnable接口只需要重写run方法,这种类型的接口被称为函数式接口,可以被lambda表达式所代替。
1 | String[] names = {"tom", "alice", "fred"}; |
或者更简单些:
1 | String[] names = {"tom", "alice", "fred"}; |
ArrayList类
add()
将元素插入指定位置的动态数组中。
1 | arraylist.add(int index,E element) |
insert(itn index, object value)
将元素插入到索引处(不过其有一定的限制性,必须在数组长度以内插入数组)
addAll()
将给定集合中的所有元素添加到 arraylist 中。
1 | arraylist.addAll(int index, Collection c) |
clear()
用于删除动态数组中的所有元素。
1 | arraylist.clear() |
clone()
用于拷贝一份动态数组,属于浅拷贝。
1 | arraylist.clone() |
1 | //例:sites为已设置好的数组,使用clone将其拷贝给clonesites; |
拓展:
浅拷贝只复制指向某个对象的指针,而不复制对象本身,新旧对象还是共享同一块内存, 所以如果其中一个对象改变了这个地址,就会影响到另一个对象。
浅拷贝对应的就是深拷贝,深拷贝是将一个对象从内存中完整的拷贝一份出来,从堆内存中开辟一个新的区域存放新对象,且修改新对象不会影响原对象。
contains()
判断元素是否在动态数组中。
存在于动态数组中,则返回 true。
不存在于动态数组中,则返回 false。
1 | arraylist.contains(Object obj) |
set()
1 | arraylist.set(int index,E element) ; |
get()
通过索引值获取动态数组中的元素。
1 | arraylist.get(int index) |
indexOf()
remove()
1 | arraylist.remove(int index) ; |
size()
返回此集合中的元素数。遍历集合时,可以控制索引范围,防止越界。
isEmpty()
subList()
sort()
toArray()
toString()
ensureCapacity()
lastIndexOf()
retainAll()
containAll()
trimToSize()
removeRange()
replaceAll()
removeIf()
forEach()
LinkedList类
add(E e) 将指定元素添加到此列表的结尾。
add(int index, E element) 在此列表中指定的位置插入指定的元素。
get(int index) 返回此列表中指定位置处的元素。
getFirst() 返回此列表的第一个元素。
getLast() 返回此列表的最后一个元素。
remove(int index) 移除此列表中指定位置处的元素。
remove() 获取并移除此列表的头(第一个元素)。
remove(Object o) 从此列表中移除首次出现的指定元素(如果存在)。
size() 返回此列表的元素数。
push(E e):与addFirst一样,实际上它就是addFirst;
pop() : removeFirst一样,实际上它就是removeFirst;
E poll():查询并移除第一个元素;
peek() : 获取第一个元素,但是不移除;
offer(E e):在链表尾部插入一个元素;
isEmpty : 判空
contains(Object o) :是否包含
Hashset类
HashMap类
HashMap的每次增删查改都是O(1),但这个常数操作比较大,是没数组的查询快的。
put(key, value) :将键/值 映射 存放到Map集合中(如果key重复,则会覆盖原先的value值)
get(key) :返回指定键 所映射的值,没有该key对应的值则返回null
getOrDefault ( key, defaultvalue) : 当集合中有这个key时,就返回key对应的value,没有这个key的话,返回默认值;
size( ) :返回Map集合中的 key-value的组数
clear( ):清空Map集合
isEmpty( ):判空,集合中为空则返回true
remove(key):删除集合中键为key的数据,并返回对应的value值
getOrDefault( key, defaultValue) : 返回key对应的value值,如果没有该key值,就返回默认值defaultValue
values():返回Map集合中所有value组成的以Collection数据类型格式数据(一般用于遍历HashMap集合中value值)
1 | HashMap<String, Integer> map = new HashMap<String, Integer>(); |
keyset():返回Map集合中所有key组成的Set集合
1 | //将key作为元素转存入一个set集合。 |
entrySet(): 将Map集合每个key-value转换为一个Entry对象,并返回由所有的Entry对象组成的Set集合
1 | //将每一组key-value变为一个entry对象存入set集合 |
Hashtable类
Hashtable定义了四个构造方法。第一个是默认构造方法:
1 | Hashtable() |
第二个构造函数创建指定大小的哈希表:
1 | Hashtable(int size) |
第三个构造方法创建了一个指定大小的哈希表,并且通过fillRatio指定填充比例。
填充比例必须介于0.0和1.0之间,它决定了哈希表在重新调整大小之前的充满程度:
1 | Hashtable(int size,float fillRatio) |
第四个构造方法创建了一个以M中元素为初始化元素的哈希表。
哈希表的容量被设置为M的两倍。
1 | Hashtable(Map m) |
Hashtable中除了从Map接口中定义的方法外,还定义了以下方法:
| 序号 | 方法描述 |
|---|---|
| 1 | void clear( ) 将此哈希表清空,使其不包含任何键。 |
| 2 | Object clone( ) 创建此哈希表的浅表副本。 |
| 3 | boolean contains(Object value) 测试此映射表中是否存在与指定值关联的键。 |
| 4 | boolean containsKey(Object key) 测试指定对象是否为此哈希表中的键。 |
| 5 | boolean containsValue(Object value) 如果此 Hashtable 将一个或多个键映射到此值,则返回 true。 |
| 6 | Enumeration elements( ) 返回此哈希表中的值的枚举。 |
| 7 | Object get(Object key) 返回指定键所映射到的值,如果此映射不包含此键的映射,则返回 null. 更确切地讲,如果此映射包含满足 (key.equals(k)) 的从键 k 到值 v 的映射,则此方法返回 v;否则,返回 null。 |
| 8 | boolean isEmpty( ) 测试此哈希表是否没有键映射到值。 |
| 9 | Enumeration keys( ) 返回此哈希表中的键的枚举。 |
| 10 | Object put(Object key, Object value) 将指定 key 映射到此哈希表中的指定 value。 |
| 11 | void rehash( ) 增加此哈希表的容量并在内部对其进行重组,以便更有效地容纳和访问其元素。 |
| 12 | Object remove(Object key) 从哈希表中移除该键及其相应的值。 |
| 13 | int size( ) 返回此哈希表中的键的数量。 |
| 14 | String toString( ) 返回此 Hashtable 对象的字符串表示形式,其形式为 ASCII 字符 “, “ (逗号加空格)分隔开的、括在括号中的一组条目。 |
TreeMap类
TreeMap中的值有序排列,每次增删改查的时间复杂度都是O(logN);
创建时传入Comparator可自定义排序规则。
1 | //使用默认构造器是自然顺序的,重写Compatator能实现q排序) |
基本的put, get, remove, containskey都一样;
- fristKey() 返回排序后的第一个
- lastKey() 返回排序后的最后一个
- floorKey(key1) 返回小于等于key1的最近的key
- ceilingKey(key1) 返回大于等于key1的最近的key
Deque类
Deque(java.util.Deque)接口代表着双向队列,意思就是可以从队列的两端增加或者删除元素,
- deque 是“double ended queue(双端队列)”的缩写,通常读为“deck”。
Deque的实现:
既然Deque是个接口所以初始化时就要用到其具体的实现,在 Collections API中有下面两种实现:
1 | java.util.LinkedList |
LinkedList类是非常标准的Deque和Queue的实现,它在内部使用链接列表来建模queue或deque。
ArrayDeque类内部存储元素是数组,如果元素数超过数组中的空间,则分配一个新的数组,并移动所有元素,换句话说,ArrayDeque根据需要增长,即使它将元素存储在数组中。
创建Deque
在使用Deque之前首先要创建 Deque接口实现的实例,下面是创建 LinkedList实例:
1 | Deque deque = new LinkedList(); |
创建 ArrayDeque实例:
1 | Deque deque = new ArrayDeque(); |
Deque泛型
默认 Deque放入的Object对象,但是也可以用泛型:
1 | Deque<MyObject> deque = new LinkedList<MyObject>(); |
这个Deque中只能添加 MyObject的实例对象,并且访问时不需要强制类型转换:
1 | MyObject myObject = deque.remove(); |
Deque中添加元素
前面讲到可以在Deque 的两端增加元素,Deque 中有下面几种添加元素的方法:
add()
addLast()
addFirst()
offer()
offerFirst()
offerLast()
方法具体说明:
add()
可以使用add()方法在Deque 的尾部添加元素:
1 | Deque<String> deque = new ArrayDeque<>(); |
如果元素不能插入到Deque,那么add(),方法将抛异常,而 offer()方法不一样,如果不能添加元素offer()方法将返回false。add()方法实际是继承Queue接口。
offer()
offer()方法可以在Deque的尾部添加元素,如果元素没满则添加成功返回true,否则返回false。这是和 add()抛异常方法不同的地方,下面是使用offer()方法:
1 | Deque<String> deque = new ArrayDeque<>(); |
push()
push()方法是在Deque的头部添加元素,如果Deque中的元素满了,则会抛异常,这和addFirst()方法比较相似:
1 | Deque<String> deque = new LinkedList<>(); |
获取元素:
peek()
peekFirst()
peekLast()
getFirst()
getLast()
peek()
peek()返回Deque中的第一个元素并且不删除,如果Deque是空则返回null:
1 | Deque<String> deque = new ArrayDeque<>(); |
执行完代码后firstElement将指向Deque的第一个元素: “first element”。
getFirst()
getFirst()方法获取Deque的第一个元素并且不删除,如果Deque是空则抛异常:
1 | Deque<String> deque = new ArrayDeque<>(); |
执行完代码后firstElement的值是: “first element”。
移除Deque中的元素
以下几种方法可以移除Deque 中的元素:
remove()
removeFirst()
removeLast()
poll()
pollFirst()
pollLast()
remove()
remove()方法移除Deque中的第一个元素并返回:
1 | Deque<String> deque = new LinkedList<>(); |
如果Deque 是空则抛异常。
poll()
poll()方法移除Deque中的第一个元素,如果Deque为空则poll()返回null:
1 | Deque<String> deque = new LinkedList<>(); |
pop()
pop()方法移除Deque的第一个元素,如果Deque是空则抛异常:
1 | Deque<String> deque = new LinkedList<>(); |
检查Deque是否包含某个元素
可以用contains()方法检查Deque中是否包含某个元素,如果包含返回true否则返回false:
1 | Deque<String> deque = new ArrayDeque<>(); |
执行完代码后containsElement1的值是true ,containsElement2值是false。
Deque的大小
Deque的size()方法可以返回Deque中存储的元素个数:
1 | Deque<String> deque = new ArrayDeque<>(); |
执行完代码后size大小是2,因为Deque中包含两个元素。
迭代Deque中的元素
可以通过两种方法迭代Deque中的元素:
使用Iterator.
使用for-each循环.
具体使用哪一种迭代取决Deque的实现。
通过迭代器迭代Deque
第一种方法是获取Deque的Iterator,下面是代码:
1 | Deque<String> deque = new LinkedList<>(); |
通过For-Each循环迭代Deque
第二种方法是通过for-each循环迭代Deque:
1 | Deque<String> deque = new LinkedList<>(); |
Properties 类
Properties 继承于 Hashtable。表示一个持久的属性集.属性列表中每个键及其对应值都是一个字符串。
这个类的优势是可以从流中加载属性集,或者把属性集报错到流中。
除了从 Hashtable 中所定义的方法,Properties 还定义了以下方法:
| 序号 | 方法描述 |
|---|---|
| 1 | String getProperty(String key) 用指定的键在此属性列表中搜索属性。 |
| 2 | String getProperty(String key, String defaultProperty) 用指定的键在属性列表中搜索属性。 |
| 3 | void list(PrintStream streamOut) 将属性列表输出到指定的输出流。 |
| 4 | void list(PrintWriter streamOut) 将属性列表输出到指定的输出流。 |
| 5 | void load(InputStream streamIn) throws IOException 从输入流中读取属性列表(键和元素对)。 |
| 6 | Enumeration propertyNames( ) 按简单的面向行的格式从输入字符流中读取属性列表(键和元素对)。 |
| 7 | Object setProperty(String key, String value) 调用 Hashtable 的方法 put。 |
| 8 | void store(OutputStream streamOut, String description) 以适合使用 load(InputStream)方法加载到 Properties 表中的格式,将此 Properties 表中的属性列表(键和元素对)写入输出流。 |
Iterator类
Iterator(迭代器)不是一个集合,它是一种用于访问集合的方法
1 | import java.util.ArrayList; |
Number类
xxxValue()
以xxx类型返回指定的数值
1 | xxxValue() |
1 | public class Test{ |
1 | 结果:5.0 |
compareTo()
用于两个相同数据类型的比较;
两个不同类型的数据不能用此方法来比较。
- 如果指定的数与参数相等返回0。
- 如果指定的数小于参数返回 -1。
- 如果指定的数大于参数返回 1。
1 | public int compareTo(referenceName) |
1 | public class Test{ |
1 | 结果:1 |
equals()
判断 Number 对象与方法的参数是否相等(类型和数值)
- 如果Number 对象不为 Null,且与方法的参数类型与数值都相等返回 True,否则返回 False。
1 | public boolean equals(Object x) //x为任何对象 |
1 | public class Test { |
1 | false |
valueOf()
返回给定参数的原生 Number 对象值,
参数可以是原生数据类型,如String等。
如果方法有两个参数, 返回用第二个参数指定基数表示的第一个参数的对象值。
1 | public class Test { |
1 | 9 |
toString()
返回以一个字符串表示的 Number 对象值。
如果方法有两个参数, 返回用第二个参数指定基数表示的第一个参数的字符串表示形式。
1 | public class Test { |
1 | 5 |
parseInt()
将字符串参数作为有符号的十进制整数进行解析。
如果方法有两个参数, 使用第二个参数指定的基数,将字符串参数解析为有符号的整数。
1 | public class Test{ |
1 | 9 |
Math数学类
在源文件顶部加上:
1 | import static java.lang.Math.*; |
Math类
abs()
返回参数的绝对值
1 | public class Test{ |
1 | 8 |
sqrt()
返回参数的算术平方根。
1 | public class Test{ |
1 | sqrt(11.635) 为 3.411 |
round()
返回一个最接近的int ,long型值,”四舍五入“,算法为**Math.floor(x+0.5)**;
1 | public class Test{ |
1 | 101 |
min()和max()
1 | public class Test{ |
1 | 12 |
random()
返回一个随机数,随机数范围为 0.0 <= x < 1.0。
1 | public class Test{ |
1 | 0.5444085967267008 |
pow()
返回第一个参数的第二个参数次方。
1 | public class Test{ |
1 | pow(11.635, 2.760) 为 874.008 |
exp()
返回自然数底数e的参数次方
1 | public class Test{ |
1 | e 的值为 2.7183 |
log()
返回参数的自然数底数的对数值。
1 | public class Test{ |
1 | e 的值为 2.7183 |
rint()
返回最接近参数的整数值
1 | public class Test{ |
1 | 101.0 |
floor()/ceil()
floor():对一个数进行下舍入,返回给定参数最大的整数,该整数小于或等给定的参数。
ceil():对一个数进行上舍入,返回值大于或等于给定的参数,类型为双精度浮点型。
1 | public class Test{ |
Enumeration
枚举
| 1 | boolean hasMoreElements( ) | 测试此枚举是否包含更多的元素。 |
|---|---|---|
| 2 | Object nextElement( ) | 如果此枚举对象至少还有一个可提供的元素,则返回此枚举的下一个元素。 |
Vector类
Vector 类实现了一个动态数组。和 ArrayList 很相似,但是两者是不同的:
- Vector 是同步访问的。
- Vector 包含了许多传统的方法,这些方法不属于集合框架。
Vector 主要用在事先不知道数组的大小,或者只是需要一个可以改变大小的数组的情况。
Vector 类支持 4 种构造方法。
第一种构造方法创建一个默认的向量,默认大小为 10:
1 | Vector() |
第二种构造方法创建指定大小的向量。
1 | Vector(int size) |
第三种构造方法创建指定大小的向量,并且增量用 incr 指定。增量表示向量每次增加的元素数目。
1 | Vector(int size,int incr) |
第四种构造方法创建一个包含集合 c 元素的向量:
1 | Vector(Collection c) |
Vector还拥有以下方法:
| 序号 | 方法描述 |
|---|---|
| 1 | void add(int index, Object element) 在此向量的指定位置插入指定的元素。 |
| 2 | boolean add(Object o) 将指定元素添加到此向量的末尾。 |
| 3 | boolean addAll(Collection c) 将指定 Collection 中的所有元素添加到此向量的末尾,按照指定 collection 的迭代器所返回的顺序添加这些元素。 |
| 4 | boolean addAll(int index, Collection c) 在指定位置将指定 Collection 中的所有元素插入到此向量中。 |
| 5 | void addElement(Object obj) 将指定的组件添加到此向量的末尾,将其大小增加 1。 |
| 6 | int capacity() 返回此向量的当前容量。 |
| 7 | void clear() 从此向量中移除所有元素。 |
| 8 | Object clone() 返回向量的一个副本。 |
| 9 | boolean contains(Object elem) 如果此向量包含指定的元素,则返回 true。 |
| 10 | boolean containsAll(Collection c) 如果此向量包含指定 Collection 中的所有元素,则返回 true。 |
| 11 | void copyInto(Object[] anArray) 将此向量的组件复制到指定的数组中。 |
| 12 | Object elementAt(int index) 返回指定索引处的组件。 |
| 13 | Enumeration elements() 返回此向量的组件的枚举。 |
| 14 | void ensureCapacity(int minCapacity) 增加此向量的容量(如有必要),以确保其至少能够保存最小容量参数指定的组件数。 |
| 15 | boolean equals(Object o) 比较指定对象与此向量的相等性。 |
| 16 | Object firstElement() 返回此向量的第一个组件(位于索引 0) 处的项)。 |
| 17 | Object get(int index) 返回向量中指定位置的元素。 |
| 18 | int hashCode() 返回此向量的哈希码值。 |
| 19 | int indexOf(Object elem) 返回此向量中第一次出现的指定元素的索引,如果此向量不包含该元素,则返回 -1。 |
| 20 | int indexOf(Object elem, int index) 返回此向量中第一次出现的指定元素的索引,从 index 处正向搜索,如果未找到该元素,则返回 -1。 |
| 21 | void insertElementAt(Object obj, int index) 将指定对象作为此向量中的组件插入到指定的 index 处。 |
| 22 | boolean isEmpty() 测试此向量是否不包含组件。 |
| 23 | Object lastElement() 返回此向量的最后一个组件。 |
| 24 | int lastIndexOf(Object elem) 返回此向量中最后一次出现的指定元素的索引;如果此向量不包含该元素,则返回 -1。 |
| 25 | int lastIndexOf(Object elem, int index) 返回此向量中最后一次出现的指定元素的索引,从 index 处逆向搜索,如果未找到该元素,则返回 -1。 |
| 26 | Object remove(int index) 移除此向量中指定位置的元素。 |
| 27 | boolean remove(Object o) 移除此向量中指定元素的第一个匹配项,如果向量不包含该元素,则元素保持不变。 |
| 28 | boolean removeAll(Collection c) 从此向量中移除包含在指定 Collection 中的所有元素。 |
| 29 | void removeAllElements() 从此向量中移除全部组件,并将其大小设置为零。 |
| 30 | boolean removeElement(Object obj) 从此向量中移除变量的第一个(索引最小的)匹配项。 |
| 31 | void removeElementAt(int index) 删除指定索引处的组件。 |
| 32 | protected void removeRange(int fromIndex, int toIndex) 从此 List 中移除其索引位于 fromIndex(包括)与 toIndex(不包括)之间的所有元素。 |
| 33 | boolean retainAll(Collection c) 在此向量中仅保留包含在指定 Collection 中的元素。 |
| 34 | Object set(int index, Object element) 用指定的元素替换此向量中指定位置处的元素。 |
| 35 | void setElementAt(Object obj, int index) 将此向量指定 index 处的组件设置为指定的对象。 |
| 36 | void setSize(int newSize) 设置此向量的大小。 |
| 37 | int size() 返回此向量中的组件数。 |
| 38 | List subList(int fromIndex, int toIndex) 返回此 List 的部分视图,元素范围为从 fromIndex(包括)到 toIndex(不包括)。 |
| 39 | Object[] toArray() 返回一个数组,包含此向量中以恰当顺序存放的所有元素。 |
| 40 | Object[] toArray(Object[] a) 返回一个数组,包含此向量中以恰当顺序存放的所有元素;返回数组的运行时类型为指定数组的类型。 |
| 41 | String toString() 返回此向量的字符串表示形式,其中包含每个元素的 String 表示形式。 |
| 42 | void trimToSize() 对此向量的容量进行微调,使其等于向量的当前大小。 |
例子:
1 | import java.util.*; |
以上实例编译运行结果如下:
1 | Initial size: 0 |
Bitset类
Bitset类创建一种特殊类型的数组来保存位值。BitSet中数组大小会随需要增加。这和位向量(vector of bits)比较类似。
BitSet定义了两个构造方法。
第一个构造方法创建一个默认的对象:
1 | BitSet() |
第二个方法允许用户指定初始大小。所有位初始化为0。
1 | BitSet(int size) |
BitSet中实现了Cloneable接口中定义的方法如下表所列:
| 序号 | 方法描述 |
|---|---|
| 1 | void and(BitSet set) 对此目标位 set 和参数位 set 执行逻辑与操作。 |
| 2 | void andNot(BitSet set) 清除此 BitSet 中所有的位,其相应的位在指定的 BitSet 中已设置。 |
| 3 | int cardinality( ) 返回此 BitSet 中设置为 true 的位数。 |
| 4 | void clear( ) 将此 BitSet 中的所有位设置为 false。 |
| 5 | void clear(int index) 将索引指定处的位设置为 false。 |
| 6 | void clear(int startIndex, int endIndex) 将指定的 startIndex(包括)到指定的 toIndex(不包括)范围内的位设置为 false。 |
| 7 | Object clone( ) 复制此 BitSet,生成一个与之相等的新 BitSet。 |
| 8 | boolean equals(Object bitSet) 将此对象与指定的对象进行比较。 |
| 9 | void flip(int index) 将指定索引处的位设置为其当前值的补码。 |
| 10 | void flip(int startIndex, int endIndex) 将指定的 fromIndex(包括)到指定的 toIndex(不包括)范围内的每个位设置为其当前值的补码。 |
| 11 | boolean get(int index) 返回指定索引处的位值。 |
| 12 | BitSet get(int startIndex, int endIndex) 返回一个新的 BitSet,它由此 BitSet 中从 fromIndex(包括)到 toIndex(不包括)范围内的位组成。 |
| 13 | int hashCode( ) 返回此位 set 的哈希码值。 |
| 14 | boolean intersects(BitSet bitSet) 如果指定的 BitSet 中有设置为 true 的位,并且在此 BitSet 中也将其设置为 true,则返回 true。 |
| 15 | boolean isEmpty( ) 如果此 BitSet 中没有包含任何设置为 true 的位,则返回 true。 |
| 16 | int length( ) 返回此 BitSet 的”逻辑大小”:BitSet 中最高设置位的索引加 1。 |
| 17 | int nextClearBit(int startIndex) 返回第一个设置为 false 的位的索引,这发生在指定的起始索引或之后的索引上。 |
| 18 | int nextSetBit(int startIndex) 返回第一个设置为 true 的位的索引,这发生在指定的起始索引或之后的索引上。 |
| 19 | void or(BitSet bitSet) 对此位 set 和位 set 参数执行逻辑或操作。 |
| 20 | void set(int index) 将指定索引处的位设置为 true。 |
| 21 | void set(int index, boolean v) 将指定索引处的位设置为指定的值。 |
| 22 | void set(int startIndex, int endIndex) 将指定的 fromIndex(包括)到指定的 toIndex(不包括)范围内的位设置为 true。 |
| 23 | void set(int startIndex, int endIndex, boolean v) 将指定的 fromIndex(包括)到指定的 toIndex(不包括)范围内的位设置为指定的值。 |
| 24 | int size( ) 返回此 BitSet 表示位值时实际使用空间的位数。 |
| 25 | String toString( ) 返回此位 set 的字符串表示形式。 |
| 26 | void xor(BitSet bitSet) 对此位 set 和位 set 参数执行逻辑异或操作。 |
Map接口
Map 接口中键和值一一映射. 可以通过键来获取值。
- 给定一个键和一个值,你可以将该值存储在一个 Map 对象。之后,你可以通过键来访问对应的值。
- 当访问的值不存在的时候,方法就会抛出一个 NoSuchElementException 异常。
- 当对象的类型和 Map 里元素类型不兼容的时候,就会抛出一个 ClassCastException 异常。
- 当在不允许使用 Null 对象的 Map 中使用 Null 对象,会抛出一个 NullPointerException 异常。
- 当尝试修改一个只读的 Map 时,会抛出一个 UnsupportedOperationException 异常。
| 序号 | 方法描述 |
|---|---|
| 1 | void clear( ) 从此映射中移除所有映射关系(可选操作)。 |
| 2 | boolean containsKey(Object k) 如果此映射包含指定键的映射关系,则返回 true。 |
| 3 | boolean containsValue(Object v) 如果此映射将一个或多个键映射到指定值,则返回 true。 |
| 4 | Set entrySet( ) 返回此映射中包含的映射关系的 Set 视图。 |
| 5 | boolean equals(Object obj) 比较指定的对象与此映射是否相等。 |
| 6 | Object get(Object k) 返回指定键所映射的值;如果此映射不包含该键的映射关系,则返回 null。 |
| 7 | int hashCode( ) 返回此映射的哈希码值。 |
| 8 | boolean isEmpty( ) 如果此映射未包含键-值映射关系,则返回 true。 |
| 9 | Set keySet( ) 返回此映射中包含的键的 Set 视图。 |
| 10 | Object put(Object k, Object v) 将指定的值与此映射中的指定键关联(可选操作)。 |
| 11 | void putAll(Map m) 从指定映射中将所有映射关系复制到此映射中(可选操作)。 |
| 12 | Object remove(Object k) 如果存在一个键的映射关系,则将其从此映射中移除(可选操作)。 |
| 13 | int size( ) 返回此映射中的键-值映射关系数。 |
| 14 | Collection values( ) 返回此映射中包含的值的 Collection 视图。 |
system类
exit 退出当前程序
1 | System.exit(0); //表示程序退出,0表示一个正常的状态 |
arraycopy :复制数组元素,比较适合底层调用,一般使用Arrays.copyOf 完成复制数组
1 | System.arraycopy(src, srcPos, dest, destPos, length); |
currentTimeMillens : 返回当前时间距离1970-1-1的毫秒数
1 | System.currentTimeMillens(); |
gc:运行垃圾回收机制
1 | System.gc(); |
大数类型
BigInteger类:适合保存比较大的整型
BigDecimal类:适合保存进度更高的浮点型(小数)
方法(算术):
add 加
subtract 减
multiply 乘
divide 除
1 | BigInteger bigInteger = new BigInteger("23788888899999999999999999999"); |
日期类
第三代日期类(jdk8加入)
LocalDate(日期/年月日)
LocalTime(时间/时分秒)
LocalDateTime(时间/年月日时分秒)
1 | LocalDateTime ldt = LocalDateTime.now(); |
使用DateTimeFormatter对象来进行格式化(ofPattern方法)
1 | DateTimeFormatter dtf = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss"); |
日期类还有plus增加时间的某个部分,minus查看一年前和一年后的日期 …等等(具体看API文档)


