SpringCloud微服务
练习需启动的软件:
nacos:到nacos的bin目录下,输入: startup.cmd -m standalone(单机启动)
到sentinel的jar包目录下,输入:java -jar sentinel-dashboard-1.8.1.jar 运行sentinel
技术路线
- 微服务技术
- 1 微服务治理 —— 注册发现、远程调用、配置管理、网关路由
- 6 微服务保护 —— 流量控制、系统保护、熔断降级、服务授权
- 7 分布式事务 —— 分布式事务、TCC模型、AT模型、Seata
- 异步通信技术
- 3 异步通信 —— MQ消息模型、SpringAMQP、消息堆积问题、数据持久化
- 10 可靠消息服务 —— 消息可靠性、镜像集群、延迟队列、消息幂等性
- 缓存技术
- 4 分布式缓存 —— Redis数据结构、SpringDataRedis、缓存穿透/雪崩…
- 8 多级缓存 —— OpenResty、多级缓存、缓存数据同步、Nginx本地缓存
- 9 Redis集群 —— 数据持久、Redis主从复制、Lua脚本、Redis集群
- 搜索技术
- 5 分布式搜索 —— DSL语句、RestAPI、ES集群状态…
- DevOps
- 2 Docker技术
| SpringCloud | SpringCloudAlibaba | |
|---|---|---|
| 注册中心 | Eureka,Consul | Nacos,Eureka |
| 服务远程调用 | Feign(http协议) | Dubbo,Feign |
| 配置中心 | SpringCloudConfig | SpringCloudConfig,Nacos |
| 服务网关 | SpringCloudGateway,Zuul | SpringCloudGateway,Zuul |
| 服务监控和保护 | Hystrix | Sentinel |
微服务技术
微服务治理
单体结构 —— 将业务的所有功能集中在一个项目中开发,打成一个包部署。
优点: 架构简单,部署成本低;
缺点:耦合度高(维护困难,升级困难)。
适合小型项目。例如:学生管理系统
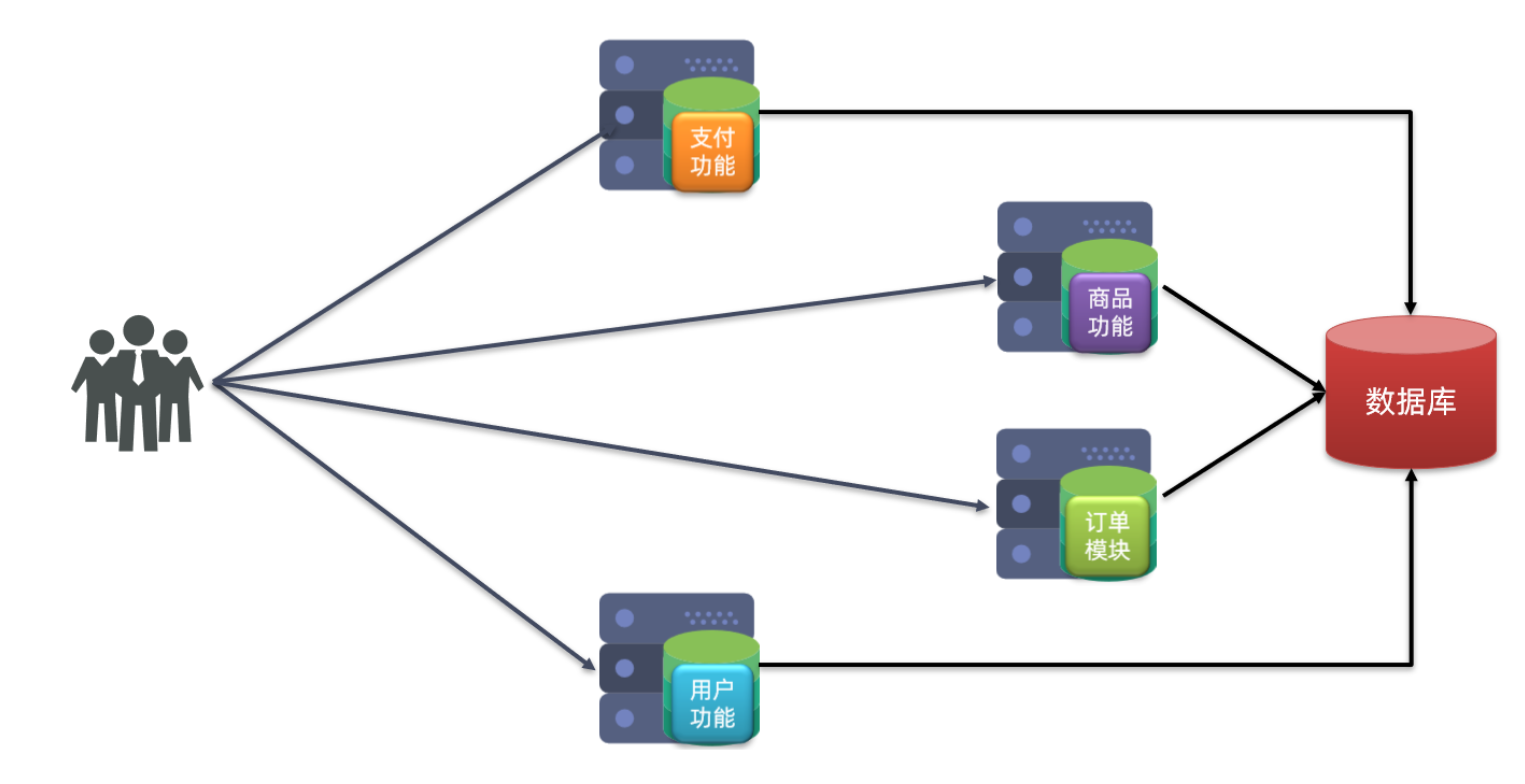
分布式架构 —— 根据业务功能对系统做拆分,每个业务功能模块作为独立项目开发,称为一个服务。
优点:降低服务耦合,有利于服务升级和拓展;
缺点:服务调用关系复杂。
适合大型互联网项目,例如:京东、淘宝
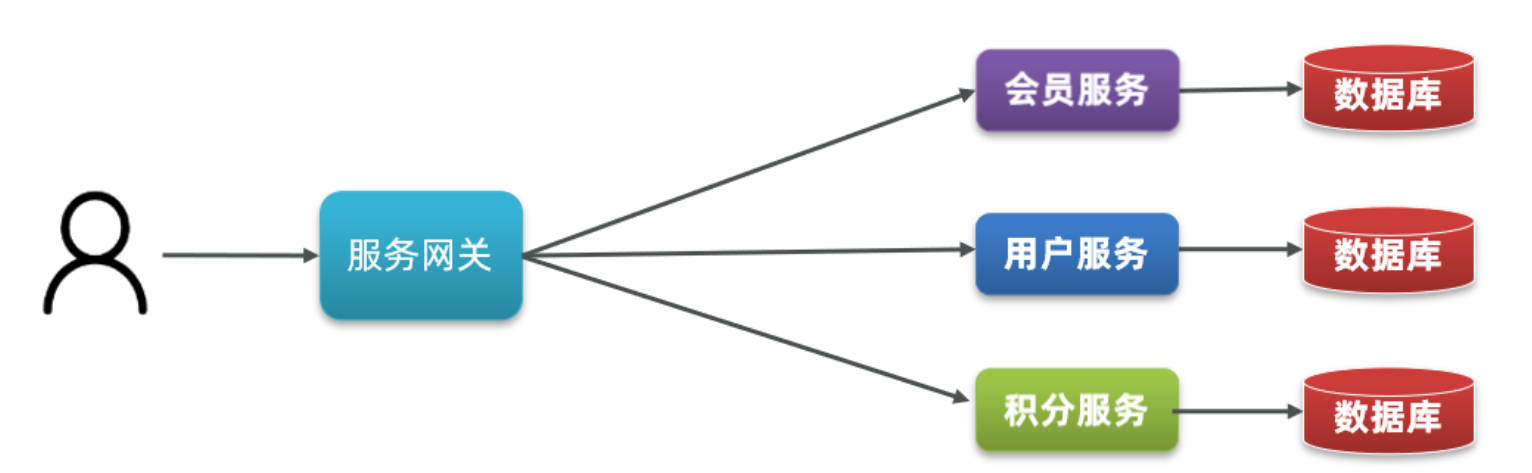
对于分布式架构,人们制定一套行之有效的标准来约束,其中微服务就是一种经过良好架构设计的分布式架构方案 。
优点:拆分粒度更小、服务更独立、耦合度更低
缺点:架构非常复杂,运维、监控、部署难度提高
微服务的架构特征:
- 单一职责:微服务拆分粒度更小,每一个服务都对应唯一的业务能力,做到单一职责
- 自治:团队独立、技术独立、数据独立,独立部署和交付
- 面向服务:服务提供统一标准的接口,与语言和技术无关
- 隔离性强:服务调用做好隔离、容错、降级,避免出现级联问题
SpringCloud —— 是目前国内使用最广泛的微服务框架。
SpringCloud集成了各种微服务功能组件,并基于SpringBoot实现了这些组件的自动装配,从而提供了良好的开箱即用体验。
常见组件有:
- 服务注册发现: Eureka,Nacos,Consul
- 服务远程调用:OpenFeign,Dubbo
- 服务链路监控:Zipkin,Sleuth
- 统一配置管理:SpringCloudConfig,Nacos
- 统一网关路由:SpringCloudGateway,Zuul
- 流量控制,降级,保护:Hystix,Sentinel
SpringCloud底层是依赖于SpringBoot的,并且有版本的兼容关系。
如:版本是 Hoxton.SR10,对应的SpringBoot版本是2.3.x 。
服务拆分和远程调用
微服务拆分时的几个原则:
- 不同微服务,不要重复开发相同业务(如订单业务就不要去查用户和商品信息);
- 微服务的数据库各自独立,不要访问其它微服务的数据库;
- 微服务可以将自己的业务暴露为接口,供其它微服务调用;
例子:
loud-demo:父工程,管理依赖
- order-service:订单微服务,负责订单相关业务
- user-service:用户微服务,负责用户相关业务
要求:
- 订单微服务和用户微服务都必须有各自的数据库,相互独立
- 订单服务和用户服务都对外暴露Restful的接口
- 订单服务如果需要查询用户信息,只能调用用户服务的Restful接口,不能查询用户数据库
远程调用:
在一个模块服务中,调用其他模块服务的方法,即为远程调用。 有两个角色:
- 服务提供者: 提供接口给其他微服务。
- 服务消费者:调用其他微服务的接口。
一个服务既可以是提供者也可以是消费者,取决于它的业务需求。
如果要在java中发送HTTP请求,Spring提供了一个工具类 RestTemplate,专门用于访问RESTful服务。
1 | // 在配置类中注册RestTemplate实例 |
1 |
|
注册中心
Eureka
注册中心流程:
- 提供者向注册中心注册服务信息。(双方有心跳机制,当提供者下线时可以及时更新注册信息)
- 消费者向注册中心拉去服务信息。
- 消费者根据信息进行远程调用。
使用:
新建注册中心模块,并配置以下:
1 | <dependency> |
1 | server: |
1 | // 编写启动类,需要添加@EnableEurekaServer注解,开启eureka的注册中心功能 |
启动服务,然后访问 http://127.0.0.1:10086 ,可以看到注册中心的页面。
服务提供者和服务消费者:
1 | <dependency> |
1 | spring: |
对于提供者,可以复制service的启动配置,改一下启动端口,就有了两个service实例。(在服务界面点击启动类,复制配置,修改名字和VM选项:-Dserver.port=端口号)
对于消费者,需要拉取服务和负载均衡,只需给RestTemplate这个Bean添加一个@LoadBalanced注解, 修改访问的url路径,用服务名代替ip和端口。 然后,spring会自动从注册中心,根据userservice这个服务名称,获取实例列表,而后完成负载均衡。
1 |
|
1 |
|
Nacos
Nacos是阿里巴巴的产品,相比Eureka,功能更丰富。
Nacos有namespace的概念,和group的区别:
namespace:用于区分环境、比如:开发环境、测试环境、生产环境。(不同namespace之间服务不可见)
group:用于区分项目,比如:cheng-plus项目、cheng2.0项目。
启动:
进入bin目录:
startup.cmd -m standalone 单机启动,可以从启动信息中的地址进入nacos管理界面。
使用:
依赖:
父工程pom文件的<dependencyManagement>中引入SpringCloudAlibaba依赖。
1
2
3
4
5
6
7<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-alibaba-dependencies</artifactId>
<version>2.2.6.RELEASE</version>
<type>pom</type>
<scope>import</scope>
</dependency>子工程user-service和order-service中引入nacos-discovery依赖(注释掉eureka的依赖):
1
2
3
4
5
6
7
8
9
10<!-- nacos服务注册 -->
<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
<!-- nacos配置 -->
<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
</dependency>配置:
子工程配置文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21spring:
application:
name: content-service # 服务名
cloud:
nacos:
server-addr: 192.168.205.1:8848 # nacos地址
discovery: # 服务注册
namespace: dev # 命名空间
group: olp-project # 分组
config: # 读取nacos上的配置文件(服务名-环境名.后缀)
namespace: dev
group: olp-project
file-extension: yaml # 配置文件的后缀
refresh-enabled: true
# 可以导入其他指定的配置文件
extension-configs:
- data-id: xxx-${spring.profiles.active}.yaml
group: olp-project
refresh: true
profiles:
active: develop # 环境名启动微服务,再登录nacos管理页面,就可以看到微服务信息了。
Nacos有两种实例:
- 临时实例:如果实例宕机超过一定时间,会从服务列表剔除,默认的类型。
- 非临时实例:如果实例宕机,不会从服务列表剔除,也可以叫永久实例。
1 | spring: |
集群
nacos可以配置集群,一般在同一机房或地区的服务器划分为一个集群,访问当前集群的服务器自然会快些,所以应该优先访问同一集群的服务器,再考虑其他集群的服务器。
例如: 一个服务可以有多个实例,即多个服务器可以提供这个服务,这些服务器会分布在不同的集群,当需要访问这个服务时,优先访问在同一集群的服务器。
使用:服务提供者 配置文件添加集群配置即可。
1 | spring: |
服务消费者 配置同集群优先的负载均衡策略:
1 | spring: |
环境隔离:
可以将服务放在不同的namespace(命名空间)中,不同namespace的服务互相不可见。
在nacos的控制台界面,创建好命名空间后,将命名空间ID设置到服务的配置文件中:
1 | spring: |
与Eureka的区别
Nacos与eureka的共同点
- 都支持服务注册和服务拉取
- 都支持服务提供者心跳方式做健康检测
Nacos与Eureka的区别
- Nacos支持服务端主动检测提供者状态:临时实例采用心跳模式,非临时实例采用主动检测模式
- 临时实例心跳不正常会被剔除,非临时实例则不会被剔除
- Nacos支持服务列表变更的消息推送模式,服务列表更新更及时
- Nacos集群默认采用AP方式,当集群中存在非临时实例时,采用CP模式;Eureka采用AP方式
配置管理
Nacos可以将配置集中管理,并在变更时通知微服务,实现微服务的热更新。(需要热更新的配置才需要交给nacos管理,其他基本不变的配置仍然放在微服务本地)
优先级:nacos的当前服务名的配置 > nacos的配置(拓展配置 > 共享配置) > 本地配置(application.yaml)
使用:
在nacos管理界面的-配置管理-配置列表中进行配置。文件id应该为 [服务名]-[profile环境名].[后缀名],如userserver-dev.yaml
如果不包含[profile],如userserver.yaml,则可以被多个环境共享。
想让本地最优先,可以在nacos配置文件 中配置如下即可实现:
1
2
3
4
5#配置本地优先
spring:
cloud:
config:
override-none: true本地拉取nacos的配置。(spring的bootstrap.yaml文件,会在application.yml之前被读取,所以可以bootstrap.yaml中放入nacos地址,先一步读取配置信息)
先引入nacos-config依赖(服务提供者)
1
2
3
4
5<!--nacos配置管理依赖-->
<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
</dependency>添加一个bootstrap.yaml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29spring:
application:
name: content-service # 服务名
cloud:
nacos:
server-addr: 192.168.205.1:8848 # nacos地址
discovery: # 服务注册
namespace: dev # 命名空间
group: olp-project # 分组
config: # 读取nacos上的配置文件(服务名-环境名.后缀)
namespace: dev
group: olp-project
file-extension: yaml # 配置文件的后缀
refresh-enabled: true
# 可以导入其他指定的配置文件
extension-configs:
- data-id: xxx-${spring.profiles.active}.yaml
group: olp-project
refresh: true
# 引用公用配置文件
shared-configs:
- data-id: swagger-${spring.profiles.active}.yaml
group: olp-common
refresh: true
- data-id: logging-${spring.profiles.active}.yaml
group: olp-common
refresh: true
profiles:
active: develop # 环境名这里会根据spring.cloud.nacos.server-addr获取nacos地址,再根据
${spring.application.name}-${spring.profiles.active}.${spring.cloud.nacos.config.file-extension}作为文件id,来读取配置。读取nacos配置
跟正常读取yaml配置一样。但对于要热更新的配置,有两种方式:
在@Value注入的变量所在类上添加注解@RefreshScope(在类上添加,不是字段)
1
2
3
4
5
6
7
public class UserController {
private String dateformat;
}使用@ConfigurationProperties注解代替@Value。
先新建一个类用于读取配置属性,再用这个类替代@Value处的变量。
1
2
3
4
5
6
public class PatternProperties {
private String dateformat;
}1
2
3
4
5
6public class Test {
private PatternProperties patternProperties;
...
}
负载均衡
Ribbon
@LoadBalanced 能提供负载均衡,是因为SpringCloud底层利用了Ribbon组件,来实现负载均衡。
Ribbon底层是采用了一个拦截器,拦截了RestTemplate发出的请求,对地址做了修改。
基本流程如下:
- 拦截RestTemplate请求http://userservice/user/1
- RibbonLoadBalancerClient 会从请求url中获取服务名称,也就是user-service
- DynamicServerListLoadBalancer根据user-service到eureka拉取服务列表
- eureka返回列表,localhost:8081、localhost:8082
- IRule利用内置负载均衡规则,从列表中选择一个,例如localhost:8081
- RibbonLoadBalancerClient修改请求地址,用localhost:8081替代userservice,得到http://localhost:8081/user/1,发起真实请求。
负载均衡策略:
IRule接口定义了负载均衡规格,以下是IRule的实现类:
| 内置负载均衡规则类 | 规则描述 |
|---|---|
| RoundRobinRule | 简单轮询服务列表来选择服务器。它是Ribbon默认的负载均衡规则。 |
| AvailabilityFilteringRule | 对以下两种服务器进行忽略: (1)在默认情况下,这台服务器如果3次连接失败,这台服务器就会被设置为“短路”状态。短路状态将持续30秒,如果再次连接失败,短路的持续时间就会几何级地增加。 (2)并发数过高的服务器。如果一个服务器的并发连接数过高,配置了AvailabilityFilteringRule规则的客户端也会将其忽略。并发连接数的上限,可以由客户端的<clientName>.<clientConfigNameSpace>.ActiveConnectionsLimit属性进行配置。 |
| WeightedResponseTimeRule | 为每一个服务器赋予一个权重值。服务器响应时间越长,这个服务器的权重就越小。这个规则会随机选择服务器,这个权重值会影响服务器的选择。 |
| ZoneAvoidanceRule | 以区域可用的服务器为基础进行服务器的选择。使用Zone对服务器进行分类,这个Zone可以理解为一个机房、一个机架等。而后再对Zone内的多个服务做轮询。 |
| BestAvailableRule | 忽略那些短路的服务器,并选择并发数较低的服务器。 |
| RandomRule | 随机选择一个可用的服务器。 |
| RetryRule | 重试机制的选择逻辑 |
默认的实现就是ZoneAvoidanceRule,是一种轮询方案。(一般不用修改)
修改负载均衡策略,有两种方式:
在配置类中返回Bean。
1
2
3
4
public IRule randomRule(){
return new RandomRule();
}在yml配置文件中,添加负载均衡规则的配置:
1
2
3userservice: # 给某个微服务配置负载均衡规则,这里是userservice服务
ribbon:
NFLoadBalancerRuleClassName: com.netflix.loadbalancer.RandomRule # 负载均衡规则
Ribbon默认是懒加载,即第一次访问时才创建LoadBalanceClient,请求时间会很长。
而饥饿加载则会在项目启动时创建,降低第一次访问的耗时,通过下面配置开启饥饿加载:
1 | ribbon: |
远程调用-TODO
Feign
最佳实践
因为Feign的客户端和服务提供者的controller的代码很相似,如下:
1 | // Feign客户端 |
1 |
|
有两种方式来优化:
通过继承方式来共享代码,但会使服务提供方和消费方紧耦合,且参数列表的注解也不继承,需要重新声明。 故不推荐。
抽取方式,把Feign的Client抽取为独立模块,并把有关的pojo,默认的Feign配置都放到这里,再提供出去。
使用:
新建模块,命名为feign-api,并引入依赖:
1
2
3
4<dependency>
<groupId>org.springframework.cloud</groupId>
<artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>转移pojo,编写feign客户端和配置类
1
2
3
4
5
6
public interface UserClient {
User findById( Long id);
}在服务提供方使用feign-api, 先引入feign-api依赖:
1
2
3
4
5<dependency>
<groupId>cn.itcast.demo</groupId>
<artifactId>feign-api</artifactId>
<version>1.0</version>
</dependency>如果扫描不到feign客户端:UserClient接口,可能是包名不同,可以在启动类指定,有两种:
一是直接指定包:
1
二是指定要加载的Client接口
1
服务消费方修改调用方法,改为feign:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class OrderService {
private OrderMapper orderMapper;
private UserClient userClient;
public Order queryOrderById(Long orderId) {
// 1.查询订单
Order order = orderMapper.findById(orderId);
// 2.用Feign远程调用
User user = userClient.findById(order.getUserId());
// 3.封装user到Order
order.setUser(user);
// 4.返回
return order;
}
}
修改配置
Feign可以支持很多的自定义配置,如下表所示:
| 类型 | 作用 | 说明 |
|---|---|---|
| feign.Logger.Level | 修改日志级别 | 包含四种不同的级别:NONE、BASIC、HEADERS、FULL |
| feign.codec.Decoder | 响应结果的解析器 | http远程调用的结果做解析,例如解析json字符串为java对象 |
| feign.codec.Encoder | 请求参数编码 | 将请求参数编码,便于通过http请求发送 |
| feign. Contract | 支持的注解格式 | 默认是SpringMVC的注解 |
| feign. Retryer | 失败重试机制 | 请求失败的重试机制,默认是没有,不过会使用Ribbon的重试 |
一般Feign的配置保持默认即可,如果需要修改的话,可以修改配置文件或创建自定义的Bean进行覆盖:
1 | feign: |
Feign使用优化:
Feign底层发起http请求,依赖于其它的框架。其底层客户端实现包括:
URLConnection:默认实现,不支持连接池
Apache HttpClient :支持连接池
OKHttp:支持连接池
因此提高Feign的性能主要手段就是使用连接池代替默认的URLConnection。
使用:
在服务方引入依赖:
1
2
3
4
5<!--httpClient的依赖 -->
<dependency>
<groupId>io.github.openfeign</groupId>
<artifactId>feign-httpclient</artifactId>
</dependency>配置连接池:
1
2
3
4
5
6
7
8
9feign:
client:
config:
default: # default全局的配置
loggerLevel: BASIC # 日志级别,BASIC就是基本的请求和响应信息
httpclient:
enabled: true # 开启feign对HttpClient的支持
max-connections: 200 # 最大的连接数
max-connections-per-route: 50 # 每个路径的最大连接数
Dubbo-TODO
分布式任务调度-TODO
XXL-JOB
介绍
XXL-JOB是一个轻量级的,分布式任务调度平台。主要有调度中心、执行器、任务:
调度中心:
负责管理调度信息,按照调度配置发出调度请求,自身不承担业务代码。
- 主要职责为:管理执行器、管理任务、监控运维、日志管理等
任务执行器:
负责接收调度请求并执行任务逻辑。
- 只要职责是注册服务、执行任务(接收到任务后会放入线程池中的任务队列)、执行结果上报、日志服务等
任务:
负责执行具体的业务。
调用中心和任务执行器的工作流程:
任务执行器根据配置的调度中心的地址,自动注册到调度中心;
达到任务触发条件,调度中心下发任务;
执行器基于线程池执行任务,并把执行结果放入内存队列中、把执行日志写入日志文件中;
执行器消费内存队列中的执行结果,主动上报给调度中心;
当用户在调度中心查看任务日志,调度中心请求任务执行器,任务执行器读取任务日志文件并返回日志详情;
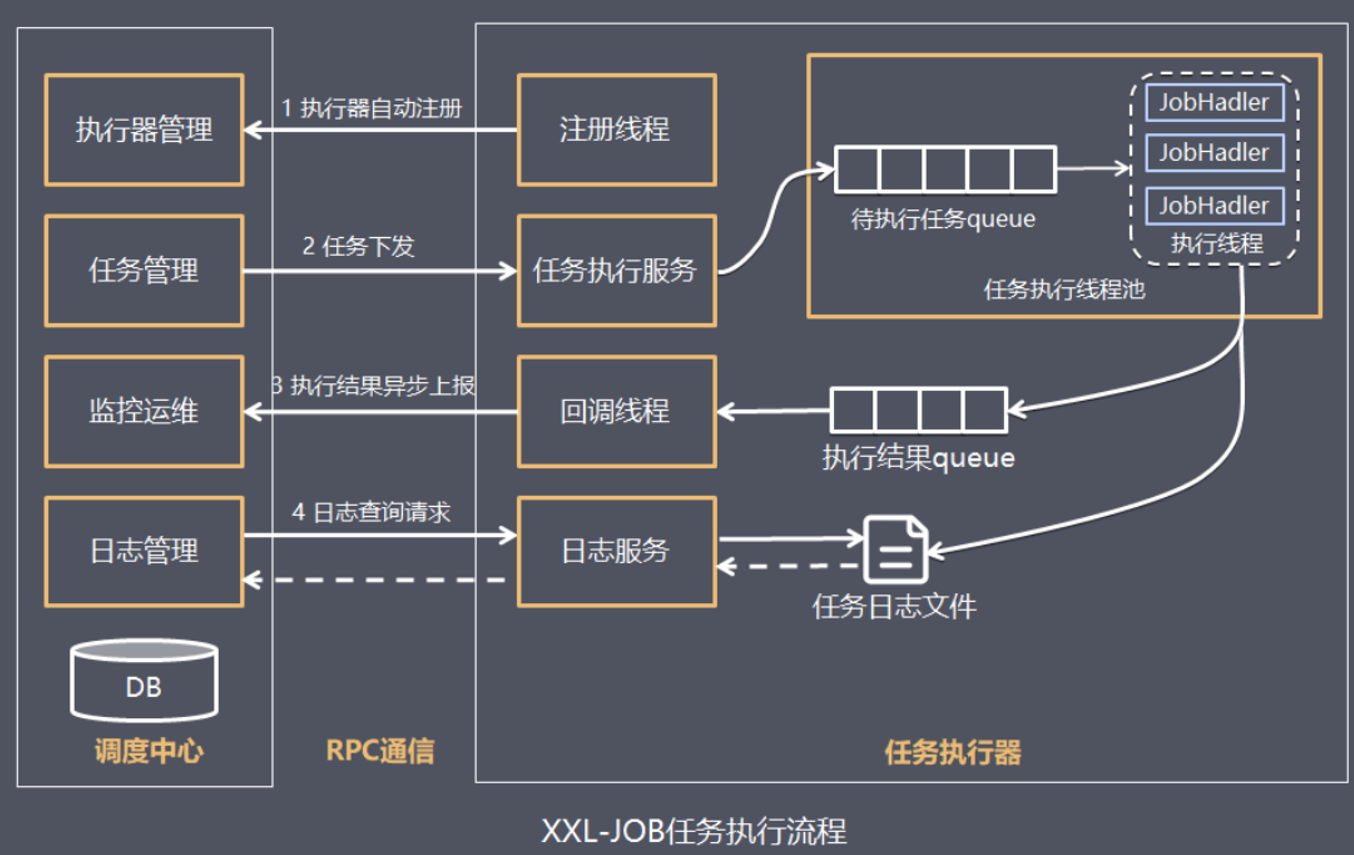
调度中心的一些选项和参数:
- 执行器:AppName用于标识执行器
- 任务:
- 调度类型:有固定速度(按固定间隔执行),Cron模式(使用Cron表达式,能执行更多的调度策略)
- 运行模式:有BEAN和GLUE,bean模式是在项目工程中编写执行器的任务代码,GLUE是将任务代码编写在调度中心。
- JobHandler即任务方法名,填写任务方法上边@XxlJob注解中的名称。
- 路由策略:当执行器集群部署时,调度中心向哪个执行器下发任务。其中除了“分片广播”,其余的都是只选择一个执行器执行。(分片广播任务中可以获取分片参数:当前分片序号,总分片数)
- 阻塞处理策略:指调度过于密集执行器来不及处理时的处理策略;
使用
需要先配置xxl-job的数据库,从官网下载xxl-job后,会发现这是一个springboot工作,在doc文件中有一个sql文件,即是需要的数据库脚本。
该工程有三个模块:xxl-job-admin:调度中心; xxl-job-core:公共依赖; xxl-job-executor-samples:执行器Sample示例(选择合适的版本执行器,可直接使用)
默认账户密码是:admin/123456
xxl-job可以使用idea启动该工程,也可以在交给docker管理,步骤如下:
拉取镜像:docker pull xuxueli/xxl-job-admin:2.3.1
执行sql脚本
创建xxl-job-admin容器:
1
2
3
4
5
6
7
8docker create --name xxl-job-admin -p 8088:8080 \
-e PARAMS="\
--spring.datasource.url=jdbc:mysql://【数据库IP】:3306/xxl_job?Unicode=true&characterEncoding=UTF-8 \
--spring.datasource.username=【数据库账号】 \
--spring.datasource.password=【数据库密码】" \
-v /usr/local/xxl-job/admin/logs:/data/applogs \
--privileged=true \
xuxueli/xxl-job-admin:2.3.1启动容器:docker start xxl-job-admin
访问 http://192.168.205.140:8088/xxl-job-admin/,登录任务调度中心。
- 在“执行器管理”中新建执行器: 注册方式选“自动注册”即可,机器地址可不填。(一个服务对应一个执行器)
- 在“任务管理”中新建任务
在需要进行任务调度模块添加依赖:
1
2
3
4<dependency>
<groupId>com.xuxueli</groupId>
<artifactId>xxl-job-core</artifactId>
</dependency>配置文件:
1
2
3
4
5
6
7
8
9
10
11
12xxl:
job:
admin:
addresses: http://192.168.205.140:8088/xxl-job-admin
executor:
appname: media-process-service
address:
ip:
port: 9999
logpath: /data/applogs/xxl-job/jobhandler
logretentiondays: 30
accessToken: default_token- 其中 appname 就是执行器的 AppName,要保持一致。
- port 是执行器启动的端口,如果本地启动多个执行器注意端口不能重复。(上述8088是调度中心的端口,9999是该执行器的端口)
配置XxlJobConfig类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
public class XxlJobConfig {
private Logger logger = LoggerFactory.getLogger(XxlJobConfig.class);
private String adminAddresses;
private String accessToken;
private String appname;
private String address;
private String ip;
private int port;
private String logPath;
private int logRetentionDays;
public XxlJobSpringExecutor xxlJobExecutor() {
logger.info(">>>>>>>>>>> xxl-job config init.");
XxlJobSpringExecutor xxlJobSpringExecutor = new XxlJobSpringExecutor();
xxlJobSpringExecutor.setAdminAddresses(adminAddresses);
xxlJobSpringExecutor.setAppname(appname);
xxlJobSpringExecutor.setAddress(address);
xxlJobSpringExecutor.setIp(ip);
xxlJobSpringExecutor.setPort(port);
xxlJobSpringExecutor.setAccessToken(accessToken);
xxlJobSpringExecutor.setLogPath(logPath);
xxlJobSpringExecutor.setLogRetentionDays(logRetentionDays);
return xxlJobSpringExecutor;
}
/**
* 针对多网卡、容器内部署等情况,可借助 "spring-cloud-commons" 提供的 "InetUtils" 组件灵活定制注册IP;
*
* 1、引入依赖:
* <dependency>
* <groupId>org.springframework.cloud</groupId>
* <artifactId>spring-cloud-commons</artifactId>
* <version>${version}</version>
* </dependency>
*
* 2、配置文件,或者容器启动变量
* spring.cloud.inetutils.preferred-networks: 'xxx.xxx.xxx.'
*
* 3、获取IP
* String ip_ = inetUtils.findFirstNonLoopbackHostInfo().getIpAddress();
*/
}此时可以启动服务,会看到调度中心的执行器管理处出现对应的 OnLine在线地址。
如果同一服务要启动多个实例,记得执行器的端口要设置不同,如实例2 在VM options添加:
1
-Dserver.port=63051 -Dxxl.job.executor.port=9998
任务对应的方法: 类标明为Bean, 方法上添加 @XxlJob(“xxx”), 里面的字符串是 新建任务填的“JobHandler”
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
public class SampleJob {
/**
* 1、单个任务
*/
public void testJob() throws Exception {
log.info("开始执行.....");
}
/**
* 2、分片广播任务
*/
public void shardingJobHandler() throws Exception {
// 可以获取分片参数
int shardIndex = XxlJobHelper.getShardIndex();
int shardTotal = XxlJobHelper.getShardTotal();
log.info("分片参数:当前分片序号 = {}, 总分片数 = {}", shardIndex, shardTotal);
log.info("开始执行第"+shardIndex+"批任务");
}
}
例子:
启动xxl-job,添加任务执行配置,项目中添加依赖、配置文件、配置类;
编写抽象任务类:
将从数据库查询任务列表,新建线程池等抽象出来,具体的执行为抽象方法,等待实现。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
public abstract class MessageProcessAbstract {
MqMessageService mqMessageService;
/**
* @param mqMessage 执行任务内容
* @return boolean true:处理成功,false处理失败
* @description 任务处理
*/
public abstract boolean execute(MqMessage mqMessage);
/**
* @param shardIndex 分片序号
* @param shardTotal 分片总数
* @param messageType 消息类型
* @param count 一次取出任务总数
* @param timeout 预估任务执行时间,到此时间如果任务还没有结束则强制结束 单位秒
* @return void
* @description 扫描消息表多线程执行任务
*/
public void process(int shardIndex, int shardTotal, String messageType, int count, long timeout) {
try {
//扫描消息表获取任务清单
List<MqMessage> messageList = mqMessageService.getMessageList(shardIndex, shardTotal, messageType, count);
//任务个数
int size = messageList.size();
log.debug("取出待处理消息" + size + "条");
if (size <= 0) {
return;
}
//创建线程池
ExecutorService threadPool = Executors.newFixedThreadPool(size);
//计数器
CountDownLatch countDownLatch = new CountDownLatch(size);
messageList.forEach(message -> {
threadPool.execute(() -> {
log.debug("开始任务:{}", message);
//处理任务
try {
boolean result = execute(message);
if (result) {
log.debug("任务执行成功:{})", message);
//更新任务状态,删除消息表记录,添加到历史表
int completed = mqMessageService.completed(message.getId());
if (completed > 0) {
log.debug("任务执行成功:{}", message);
} else {
log.debug("任务执行失败:{}", message);
}
}
} catch (Exception e) {
e.printStackTrace();
log.debug("任务出现异常:{},任务:{}", e.getMessage(), message);
} finally {
//计数
countDownLatch.countDown();
}
log.debug("结束任务:{}", message);
});
});
//等待,给一个充裕的超时时间,防止无限等待,到达超时时间还没有处理完成则结束任务
countDownLatch.await(timeout, TimeUnit.SECONDS);
System.out.println("结束....");
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}实现任务类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
public class CoursePublishTask extends MessageProcessAbstract {
//任务调度入口
public void coursePublishJobHandler() throws Exception {
// 分片参数
int shardIndex = XxlJobHelper.getShardIndex();//执行器的序号,从0开始
int shardTotal = XxlJobHelper.getShardTotal();//执行器总数
//调用抽象类的方法执行任务
process(shardIndex, shardTotal, "course_publish", 30, 60);
}
// 任务的执行内容: 执行课程发布任务的逻辑,如果此方法抛出异常说明任务执行失败
public boolean execute(MqMessage mqMessage) {
//从mqMessage拿到课程id
Long courseId = Long.parseLong(mqMessage.getBusinessKey1());
//课程静态化上传到minio
generateCourseHtml(mqMessage, courseId);
//向elasticsearch写索引数据
saveCourseIndex(mqMessage, courseId);
//向redis写缓存
....
//返回true表示任务完成
return true;
}
}
Quartz-TODO
服务网关
Gateway
Gateway网关是所有微服务的统一入口。其功能有:
- 路由和负载均衡:一切请求都必须先经过gateway,但网关不处理业务,而是根据某种规则,把请求转发到某个微服务,这个过程叫做路由。当然路由的目标服务有多个时,还需要做负载均衡。
- 权限控制:网关作为微服务入口,需要校验用户是是否有请求资格,如果没有则进行拦截。
- 限流:当请求流量过高时,在网关中按照下流的微服务能够接受的速度来放行请求,避免服务压力过大。
Zuul是基于Servlet的实现,属于阻塞式编程。而SpringCloudGateway则是基于Spring5中提供的WebFlux,属于响应式编程的实现,具备更好的性能。
使用:
新建maven服务,并引入依赖:
1
2
3
4
5
6
7
8
9
10<!--网关-->
<dependency>
<groupId>org.springframework.cloud</groupId>
<artifactId>spring-cloud-starter-gateway</artifactId>
</dependency>
<!--nacos服务发现依赖-->
<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>新建启动类
编写基础配置和路由规则:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15server:
port: 10010 # 网关端口
spring:
application:
name: gateway # 服务名称
cloud:
nacos:
server-addr: localhost:8848 # nacos地址
gateway:
routes: # 网关路由配置
- id: user-service # 路由id,自定义,只要唯一即可
# uri: http://127.0.0.1:8081 # 路由的目标地址 http就是固定地址
uri: lb://userservice # 路由的目标地址 lb就是负载均衡,后面跟服务名称
predicates: # 路由断言,也就是判断请求是否符合路由规则的条件
- Path=/user/** # 这个是按照路径匹配,只要以/user/开头就符合要求服务列表需要从注册中心nacos拉取。
这个配置的意思是:将
/user/**开头的请求,代理到lb://userservice,lb是负载均衡,根据服务名拉取服务列表,实现负载均衡。
断言工厂
在配置文件写在predicates下的断言规则,会被Predicate Factory读取并转变为路由判断的条件,Feign有十多个这样的断言工厂:
个:
| 名称 | 说明 | 示例 |
|---|---|---|
| After | 是某个时间点后的请求 | - After=2037-01-20T17:42:47.789-07:00[America/Denver] |
| Before | 是某个时间点之前的请求 | - Before=2031-04-13T15:14:47.433+08:00[Asia/Shanghai] |
| Between | 是某两个时间点之前的请求 | - Between=2037-01-20T17:42:47.789-07:00[America/Denver], 2037-01-21T17:42:47.789-07:00[America/Denver] |
| Cookie | 请求必须包含某些cookie | - Cookie=chocolate, ch.p |
| Header | 请求必须包含某些header | - Header=X-Request-Id, \d+ |
| Host | 请求必须是访问某个host(域名) | - Host=.somehost.org,.anotherhost.org |
| Method | 请求方式必须是指定方式 | - Method=GET,POST |
| Path | 请求路径必须符合指定规则 | - Path=/red/{segment},/blue/** |
| Query | 请求参数必须包含指定参数 | - Query=name, Jack或者- Query=name |
| RemoteAddr | 请求者的ip必须是指定范围 | - RemoteAddr=192.168.1.1/24 |
| Weight | 权重处理 |
过滤器工厂
GatewayFilter是网关中提供的一种过滤器,可以对进入网关的请求和微服务返回的响应做处理(流程:路由——过滤器——各个微服务)。
Spring提供了31种不同的路由过滤器工厂,如AddRequestHeader,RemoveRequestHeader等。
使用: 在Gateway服务的配置文件添加路由过滤即可(注意这里的过滤器是写在user-service服务下的,只对其有效)
1
2
3
4
5
6
7
8
9
10spring:
cloud:
gateway:
routes:
- id: user-service
uri: lb://userservice
predicates:
- Path=/user/**
filters: # 过滤器
- AddRequestHeader=Truth, Itcast is freaking awesome! # 添加请求头要对所有路由生效,要写在default-filters下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17spring:
application:
name: gateway # 服务名称
cloud:
nacos:
server-addr: localhost:8848 # nacos地址
gateway:
routes: # 网关路由配置
- id: user-service # 路由id,自定义,只要唯一即可
# uri: http://127.0.0.1:8081 # 路由的目标地址 http就是固定地址
uri: lb://userservice # 路由的目标地址 lb就是负载均衡,后面跟服务名称
predicates: # 路由断言,也就是判断请求是否符合路由规则的条件
- Path=/user/** # 这个是按照路径匹配,只要以/user/开头就符合要求
filters: # 过滤器
- AddRequestHeader=Truth, Itcast is freaking awesome! # 添加请求头
default-filters: # 默认过滤项
- AddRequestHeader=Truth, ZZC is freaking awesome!
全局过滤器
下载配置文件的过滤器的作用是固定的,如果想要实现自己的业务逻辑,就需要实现全局过滤器接口GlobalFilter,而全局过滤器的作用与GatewayFilter是一样的:
1 | public interface GlobalFilter { |
自定义全局过滤器例子:
需求: 拦截请求,判断请求的参数是否满足以下条件
- 参数中是否有authorization;
- authorization参数值是否为admin;
实现:在gateway中定义一个过滤器
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32package cn.itcast.gateway.filters;
import org.springframework.cloud.gateway.filter.GatewayFilterChain;
import org.springframework.cloud.gateway.filter.GlobalFilter;
import org.springframework.core.annotation.Order;
import org.springframework.http.HttpStatus;
import org.springframework.stereotype.Component;
import org.springframework.util.MultiValueMap;
import org.springframework.web.server.ServerWebExchange;
import reactor.core.publisher.Mono;
public class AuthorizeFilter implements GlobalFilter {
public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
// 1.获取请求参数
MultiValueMap<String, String> params = exchange.getRequest().getQueryParams();
// 2.获取authorization参数
String auth = params.getFirst("authorization");
// 3.校验
if ("admin".equals(auth)) {
// 放行
return chain.filter(exchange);
}
// 4.拦截
// 4.1.禁止访问,设置状态码
exchange.getResponse().setStatusCode(HttpStatus.FORBIDDEN);
// 4.2.结束处理
return exchange.getResponse().setComplete();
}
}
关于过滤器的执行顺序:
- 三种过滤器(DefaultFilter,路由过滤器,GlobalFilter)会合并到一个过滤器链/集合中,根据order值排序后,执行每个过滤器。
- 关于order值:
- 每一个过滤器都必须指定一个int类型的order值,order值越小,优先级越高,执行顺序越靠前。
- GlobalFilterd 的order值要手动指定,通过实现Ordered接口或添加@Order注解来指定值。
- 路由过滤器和defaultFilter的order由Spring指定,默认是按照声明顺序从1递增。
- 当过滤器的order值一样时,会按照 defaultFilter > 路由过滤器 > GlobalFilter的顺序执行。
解决跨域问题
在gateway服务的application.yml文件中,添加下面的配置:
1 | spring: |
微服务保护
Sentinel
雪崩问题
在微服务中,服务间调用关系错综复杂,一个微服务往往依赖于多个其它微服务。 如果某个服务提供者发生故障,对应的服务消费者A就会被阻塞,且这个线程如果迟迟不被释放,会造成很多线程处于阻塞状态,使服务器资源紧张,影响其他服务。 且依赖A的其他服务也会变的不可用,形成级联失败,从而发生雪崩。
简单讲: 微服务之间相互调用,因为调用链中的一个服务故障,引起整个链路都无法访问的情况。
雪崩问题解决方法:
- 超时处理: 设定超时时间,请求超过一定时间没有响应就返回错误信息,不会无休止等待。
- 舱壁模式/隔离: 类似船舱的设计,把故障控制在一定范围。可以限定每个业务能使用的线程数,避免耗尽服务器的资源。 这也叫线程隔离。
- 断路器: 由断路器统计业务执行的异常比例,如果超出阈值则会熔断该业务,拦截访问该业务的一切请求。
- 限流/流量控制: 限制业务访问的QPS,避免服务因流量的突增而故障。
限流是预防雪崩的措施。超时处理,线程隔离,降级熔断是补救措施,将故障影响缩小。
Sentinel
是阿里巴巴开源的一款微服务流量控制组件。有完备的实时监控,能应对多数大流量场景:秒杀、消息削峰填谷、集群流量控制、实时熔断下游不可用应用 等。
运行UI控制台: 运行sentinel-dashboard-1.8.1.jar包
1
java -jar sentinel-dashboard-1.8.1.jar
可以使用配置项目修改 服务端口、用户名、密码:
1
java -Dserver.port=8090 -jar sentinel-dashboard-1.8.1.jar
访问8080端口的页面即可。
微服务使用sentinel:
引入依赖:
1
2
3
4
5<!--sentinel-->
<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-sentinel</artifactId>
</dependency>服务消费者 配置文件:
1
2
3
4
5
6
7server:
port: 8088 #不要和sentinel用的端口冲了
spring:
cloud:
sentinel:
transport:
dashboard: localhost:8080 #sentinel地址
流量控制
当进入微服务时,首先会访问DispatcherServlet,然后进入Controller、Service、Mapper,这样的一个调用链就叫做簇点链路。簇点链路中被监控的每一个接口就是一个资源。
默认情况下sentinel会监控SpringMVC的每一个端点(Endpoint,也就是controller中的方法),因此SpringMVC的每一个端点(Endpoint)就是调用链路中的一个资源。
例如:Contoller类中的一个接收请求的方法,/order/{orderId}对应的方法,就是端点。
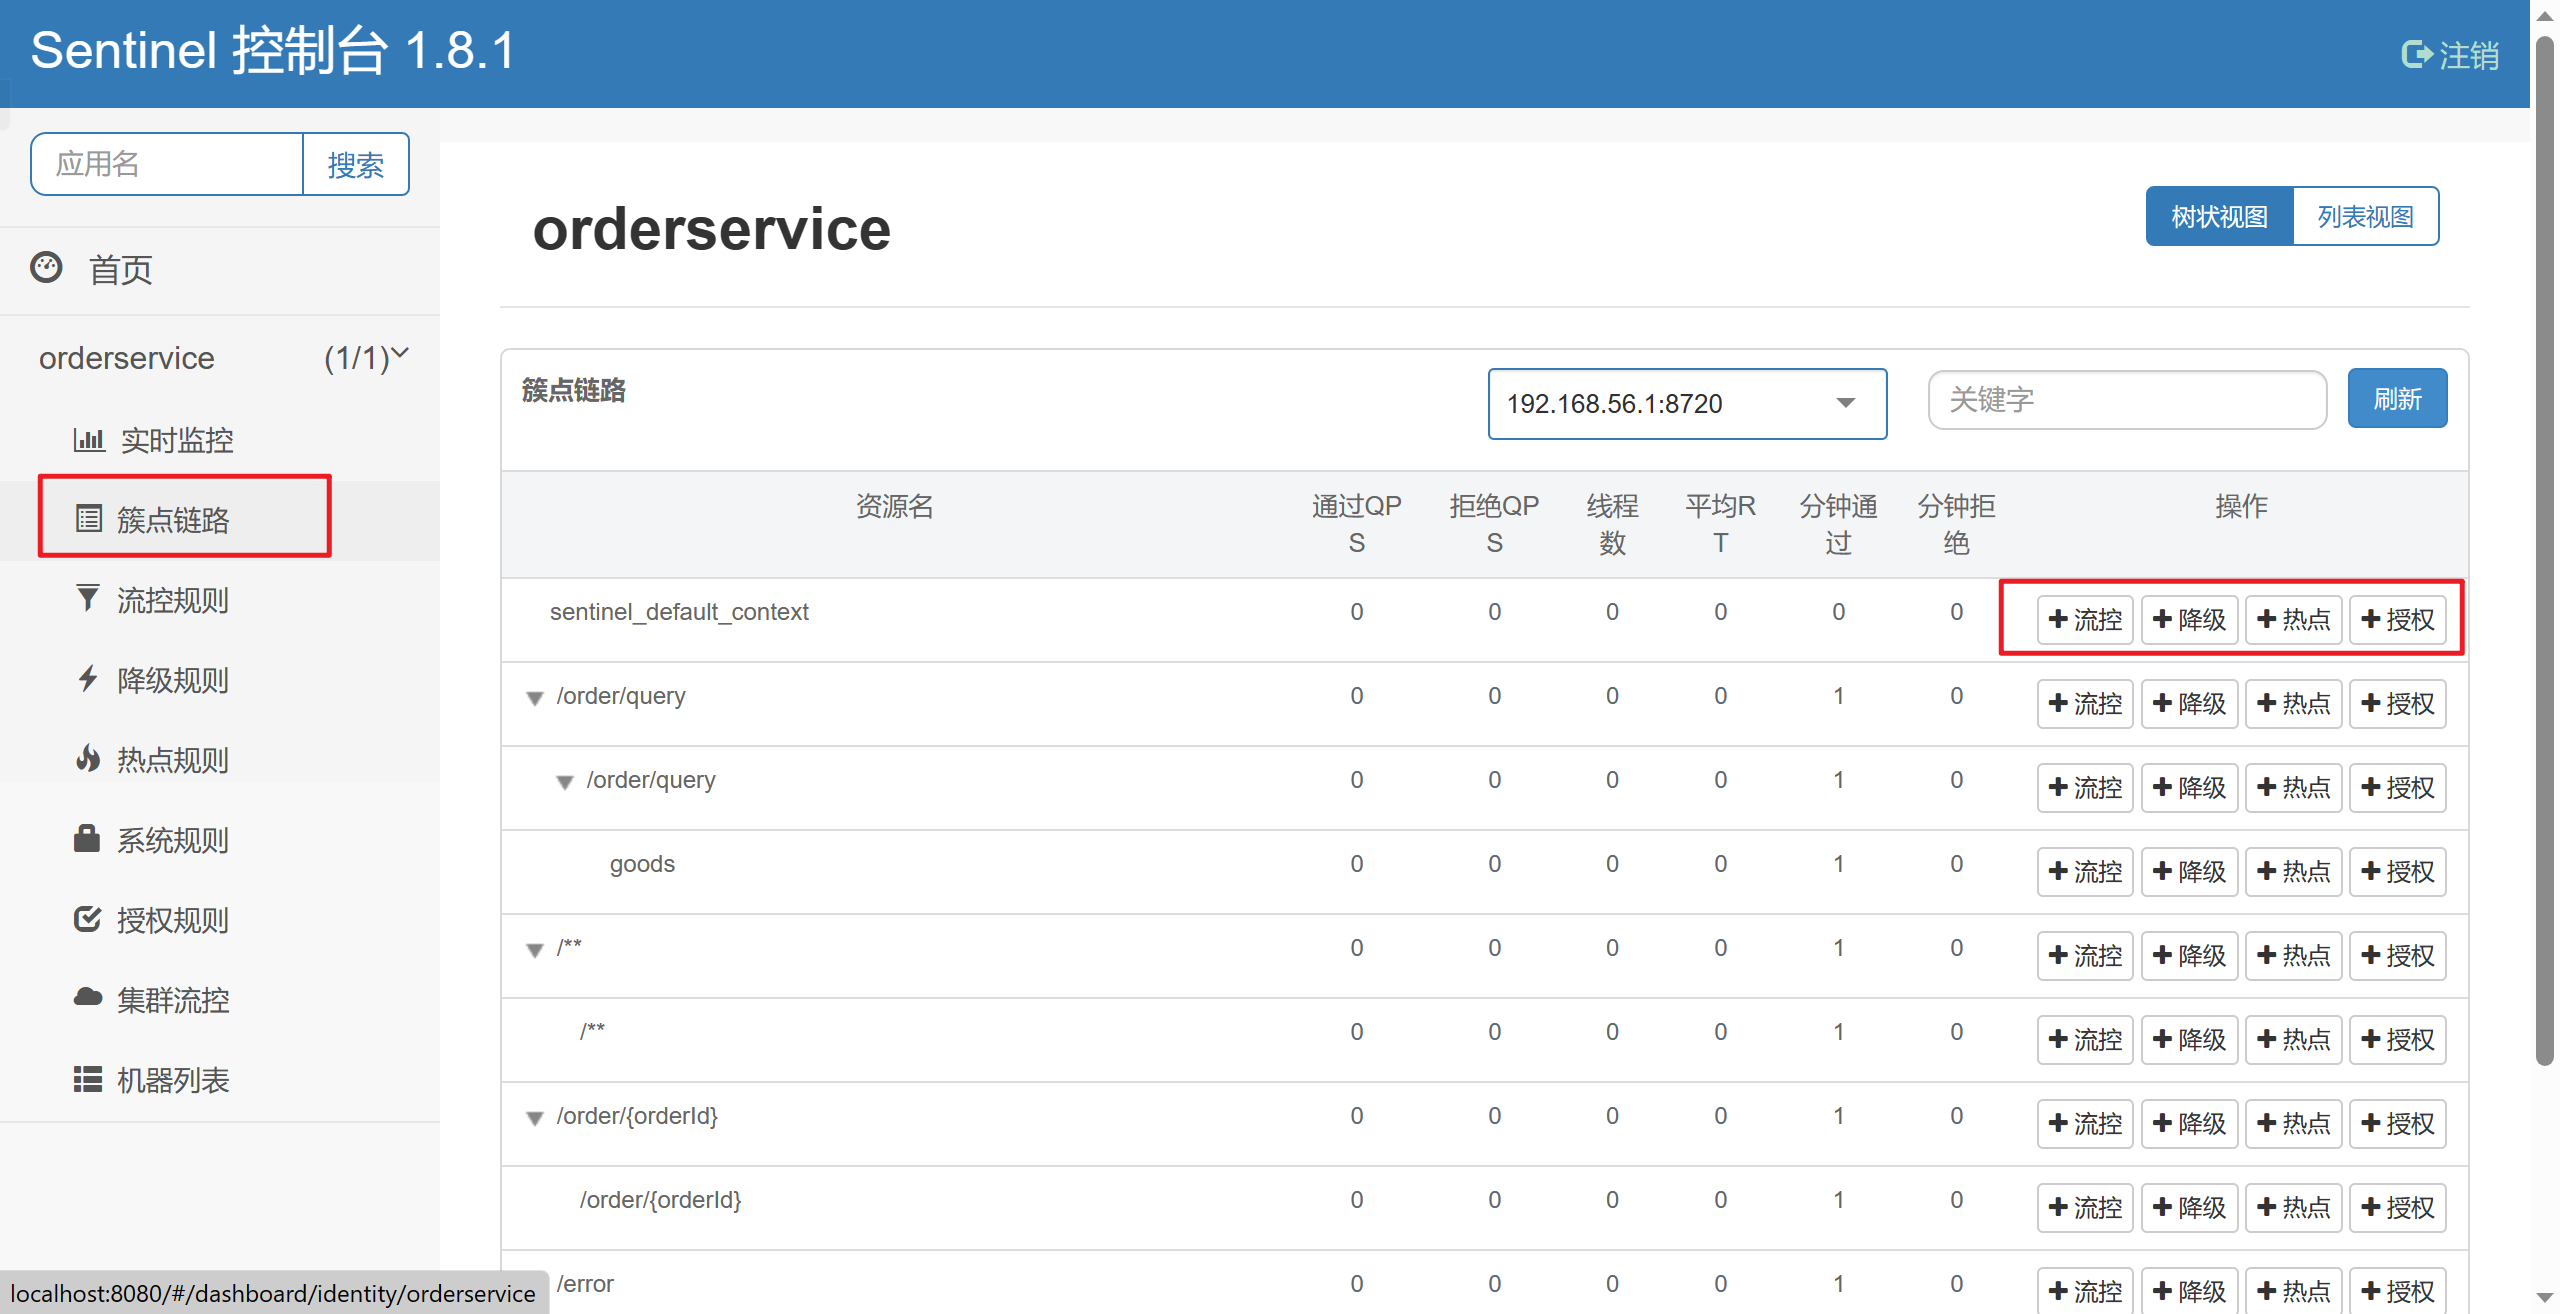
流控、熔断等都是针对簇点链路中的资源来设置的,可以点击对应资源后面的按钮来设置规则:
- 流控:流量控制
- 降级:降级熔断
- 热点:热点参数限流,是限流的一种
- 授权:请求的权限控制
流控模式
点击流控按钮的高级选项,可以选择三种流控模式:
直接:统计当前资源的请求,触发阈值时对当前资源直接限流,也是默认的模式
关联:统计与当前资源相关的另一个资源,触发阈值时,对当前资源限流
- 填写资源名和关联资源,如 /read 和 /write, 当关联资源/write 访问量触发阈值时,会对 /read进行限流。
- 场景例子: 比如用户支付时需要修改订单状态,同时用户要查询订单。查询和修改操作会争抢数据库锁,产生竞争。业务需求是优先支付和更新订单的业务,因此当修改订单业务触发阈值时,需要对查询订单业务限流。
链路:统计从指定链路访问到本资源的请求,触发阈值时,对指定链路限流
假如有两条请求链路:/test1 –> /common 和 /test2 –> /common。 如果只希望统计 /test1 –> /common的请求,可以资源名写 /common,入口资源写 /test1
例: 在service类中添加一个queryGoods方法,并加上 @SentinelResource(“goods”) 注明要监控,Controller中让两个方法调用 queryGoods,设置资源名为 goods, 入口资源选一个,如 /order/query
链路模式中,是对不同来源的两个链路做监控。但是sentinel默认会给进入SpringMVC的所有请求设置同一个root资源,会导致链路模式失效。
所以需要关闭这种对SpringMVC的资源聚合,修改order-service服务的application.yml文件:
1
2
3
4spring:
cloud:
sentinel:
web-context-unify: false # 关闭context整合
流控失败
流控的高级选项中,有一个流控效果选项:
快速失败:达到阈值后,新的请求会被立即拒绝并抛出FlowException异常。是默认的处理方式。
warm up:预热模式,对超出阈值的请求同样是拒绝并抛出异常。但这种模式阈值会动态变化,从一个较小值逐渐增加到最大阈值。(用于冷启动时)
排队等待:让所有的请求按照先后次序排队执行,两个请求的间隔不能小于指定时长
热点参数限流
这是针对某个请求中某个参数的限流, 会统计参数值相同的请求,判断是否超过QPS阈值。
- 配置中的参数索引是指请求路径上要统计的参数的下标,从0开始,即索引为0是指第一个参数。
- 新增热点规则后,可以配置高级选项,对一些特定的参数值进行不同的限流配置。
- 注:热点参数限流对默认的SpringMVC资源无效,需要利用@SentinelResource注解标记资源(用在Controller对应的方法上)
隔离和降级
当服务故障时,就需要将这些故障控制在一定范围,避免雪崩,就要靠线程隔离(舱壁模式)和熔断降级手段了。
- 线程隔离:调用者在调用服务提供者时,给每个调用的请求分配独立线程池,出现故障时,最多消耗这个线程池内资源,避免把调用者的所有资源耗尽。
- 熔断降级:是在调用方这边加入断路器,统计对服务提供者的调用,如果调用的失败比例过高,则熔断该业务,不允许访问该服务的提供者了。
可以看到,不管是线程隔离还是熔断降级,都是对客户端(调用方)的保护。需要在调用方 发起远程调用时做线程隔离、或者服务熔断。
如果微服务远程调用是基于Feign来完成的,需要将Feign与Sentinel整合,在Feign里面实现线程隔离和服务熔断。
Feign整合Sentinel
使用:
在服务调用方 orderService的配置文件,开启Feign的Sentinel功能:
1
2
3feign:
sentinel:
enabled: true # 开启feign对sentinel的支持在feign模块中编写失败降级逻辑,在业务失败后给予一个友好提示:
(在feign模块中,选择使用FallbackFactory,可以对远程调用的异常做处理)
新建一个类实现FallbackFactory
1
2
3
4
5
6
7
8
9
10
11
12
13
public class UserClientFallbackFactory implements FallbackFactory<UserClient> {
public UserClient create(Throwable throwable) {
return new UserClient() {
public User findById(Long id) {
log.error("查询用户异常", throwable);
return new User();
}
};
}
}在配置类中注册为bean:
1
2
3
4
public UserClientFallbackFactory userClientFallbackFactory(){
return new UserClientFallbackFactory();
}在feing模块中的UserClient接口中使用UserClientFallbackFactory:
1
2
3
4
5
6
public interface UserClient {
User findById( Long id);
}重启服务,访问一次订单查询业务,然后查看sentinel控制台,可以看到新的簇点链路。
线程隔离
两种方式:
- 线程池隔离:给每个服务调用业务分配一个线程池,利用线程池本身实现隔离效果
- 优点:支持主动超时,主持异步调用
- 缺点:线程的额外开销大
- 场景:低扇出
- 信号量隔离(默认模式):不创建线程池,而是计数器模式,记录业务使用的线程数量,达到信号量上限时,禁止新的请求。
- 优点:轻量级,无额外开销
- 缺点:不支持主动超时,不支持异步调用
- 场景:高频调用,高扇出
使用:在阈值类型中两者选一即可:QPS或线程数。
熔断降级
熔断:
当下游服务异常而断开与上游服务的交互,它就相当于保险丝,下游服务异常触发了熔断,从而保证上游服务不受影响。
降级:
当下游服务异常触发熔断后,上游服务就不再去调用异常的微服务而是执行了降级处理逻辑,这个降级处理逻辑可以是本地一个单独的方法。
使用断路器统计服务调用的异常比例、慢请求比例,如果超出阈值则会熔断该服务。即拦截访问该服务的一切请求;而当服务恢复时,断路器会放行访问该服务的请求。
断路器控制熔断和放行是通过状态机来完成的,状态机包括三个状态:
- closed:关闭状态,断路器放行所有请求,并开始统计异常比例、慢请求比例。超过阈值则切换到open状态
- open:打开状态,服务调用被熔断,访问被熔断服务的请求会被拒绝,快速失败,直接走降级逻辑。Open状态5秒后会进入half-open状态
- half-open:半开状态,放行一次请求,根据执行结果来判断接下来的操作。
- 请求成功:则切换到closed状态
- 请求失败:则切换到open状态
熔断策略有三种:
- 慢调用: 业务的响应时长(RT)大于指定时长的请求认定为慢调用请求。在指定时间内,如果请求数量超过设定的最小请求数,慢调用比例大于设定的阈值,则触发熔断。
- 异常比例、异常数:统计指定时间内的调用,如果调用次数超过指定请求数,并且出现异常的比例达到设定的比例阈值(或超过指定异常数),则触发熔断。
授权规则
配置授权规则,可以对请求方来源做判断和控制。有白名单和黑名单两种方式。
白名单:来源(origin)在白名单内的调用者允许访问
黑名单:来源(origin)在黑名单内的调用者不允许访问
配置的资源名就是受保护的资源,勾选白名单则允许名单中的来源访问,勾选黑名单则不允许名单中的来源访问。
例: 允许请求从gateway到order-service,不允许浏览器访问order-service
获取网关的来源名称 orgin: Sentinel是通过RequestOriginParser这个接口的parseOrigin来获取请求的来源的。
默认情况下,sentinel不管请求者从哪里来,从request对象中获取的origin返回值永远是default,也就是说一切请求的来源都被认为是一样的值default。 所以需要自定义:
在服务调用方orderService,实现这个接口:
1
2
3
4
5
6
7
8
9
10
11
12
13
public class HeaderOriginParser implements RequestOriginParser {
public String parseOrigin(HttpServletRequest request) {
// 1.获取请求头
String origin = request.getHeader("origin");
// 2.非空判断
if (StringUtils.isEmpty(origin)) {
origin = "blank";
}
return origin;
}
}让所有从gateway路由到微服务的请求都带上origin头,在gateway服务的配置文件添加过滤器,添加请求头origin,值为gateway:
1
2
3
4
5
6
7spring:
cloud:
gateway:
default-filters:
- AddRequestHeader=origin,gateway
routes:
# ...略设置授权规则,流控应用就写 origin头的值:gateway。 这样直接访问服务会被拦截,但通过网关访问则放行。
练习时的地址: 浏览器访问order服务 localhost:8088/order/103 会被拦截,通过gateway地址访问 localhost:10010/order/103?authorizetion=admin 则放行。
自定义异常
默认情况下,发生限流、降级、授权拦截时,都会抛出异常到调用方。为了让用户得知是因为什么而被拦截,可以自定义异常返回结果。
使用:在服务调用方orderService 实现BlockExceptionHandler接口:
1 |
|
这个接口的方法有三个参数:
- HttpServletRequest request:request对象
- HttpServletResponse response:response对象
- BlockException e:被sentinel拦截时抛出的异常
这里的BlockException包含多个不同的子类:
| 异常 | 说明 |
|---|---|
| FlowException | 限流异常 |
| ParamFlowException | 热点参数限流的异常 |
| DegradeException | 降级异常 |
| AuthorityException | 授权规则异常 |
| SystemBlockException | 系统规则异常 |
规则持久化
sentinel的所有规则都是内存存储,重启后所有规则都会丢失。在生产环境下,我们必须确保这些规则的持久化,避免丢失。
sentinel支持三种规则管理模式:
- 原始模式:Sentinel的默认模式,将规则保存在内存,重启服务会丢失。
- pull模式
- push模式
使用:
。。。。
分布式事务
- 本地事务,满足4个原则-ACID:原子性,一致性,隔离性,持久性。
- 分布式事务: 跨数据源、跨服务的多个业务,看作是一个业务,要做全成功,要么全失败。
分布式理论:CAP定理,提出分布系统有三个指标,这三个指标不可能全部做到。
- Consistency —— 一致性,指用户访问系统的任意节点,得到的数据是一致的。
- Availability —— 可用性,用户访问集群中的任意健康节点,必须能得到响应,而不是超时或拒绝。
- Partition tolerance —— 分区容错性,当集群出现分区时,整个系统也要继续对外提供服务。(分区:因网络故障或其他原因导致系统中的部分节点与其他节点时区联系,形成了独立分区)
因为分区无法避免,所以当部分节点无法进行数据同步时,如果要保证一致性,就要等待分区消失后进行数据同步,集群才对外提供服务,此时可用性不能保证。 如果要保证可用性,就继续提供服务,当分区会使数据不一致。
BASE理论: 是对CAP的一种解决思路,包含3个思想:
- Basically Available (基本可用):分布式系统在出现故障时,允许损失部分可用性,即保证核心可用。
- Soft State(软状态):在一定时间内,允许出现中间状态,比如临时的不一致状态。
- Eventually Consistent(最终一致性):虽然无法保证强一致性,但是在软状态结束后,最终达到数据一致。
解决思路:
AP模式(保证可用性):各子事务分别执行和提交,允许出现结果不一致,然后采用弥补措施恢复数据即可,实现最终一致。(如Redis,RocketMQ,Eureka,Nacos)
CP模式(保证一致性):各个子事务执行后互相等待,同时提交,同时回滚,达成强一致。但事务等待过程中,处于弱可用状态。(Zookeeper)
Seata
Seata 是一款开源的分布式事务解决方案,致力于在微服务架构下提供高性能和简单易用的分布式事务服务。
架构:Seata事务管理中有三个重要角色
TC (Transaction Coordinator) - 事务协调者:维护全局和分支事务的状态,协调全局事务提交或回滚。
TM (Transaction Manager) - 事务管理器:定义全局事务的范围、开始全局事务、提交或回滚全局事务。
RM (Resource Manager) - 资源管理器:管理分支事务处理的资源,与TC交谈以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚。
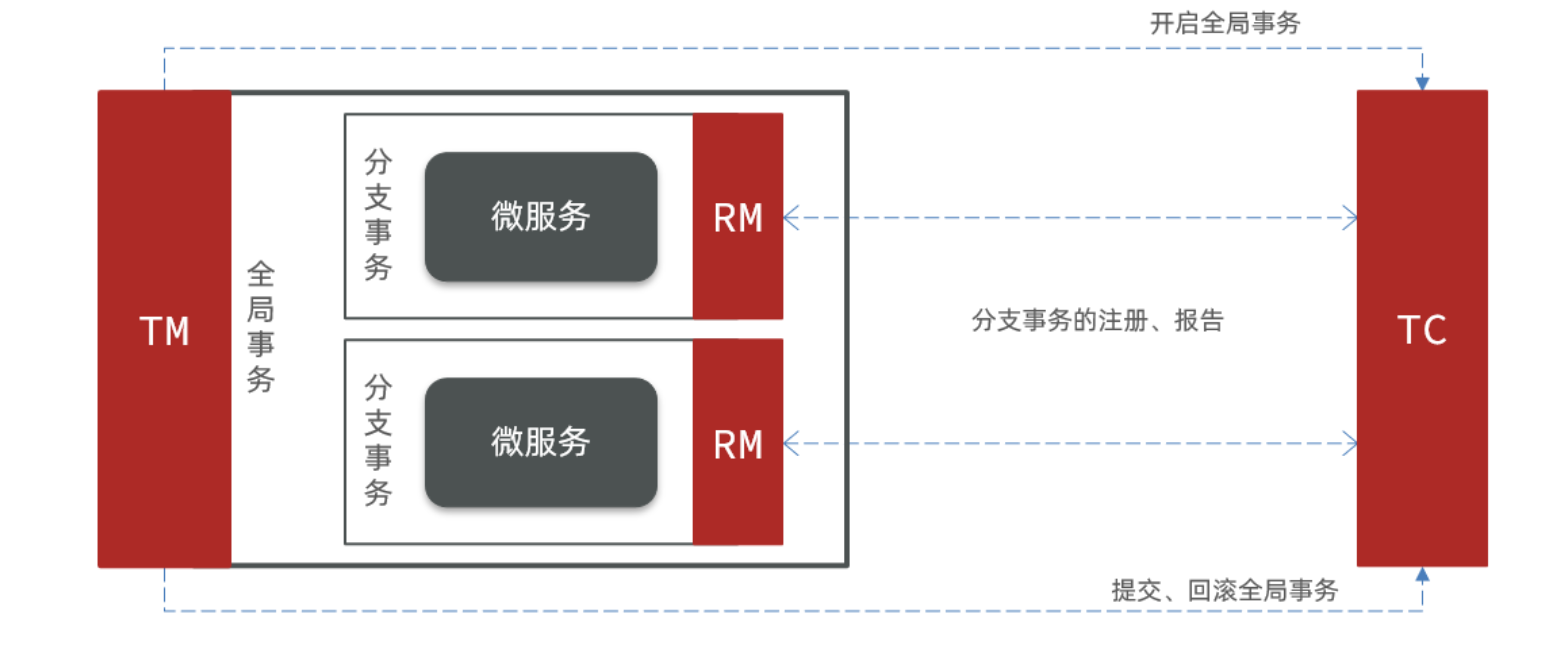
Seata基于上述架构提供了四种不同的分布式事务解决方案:
- XA模式:强一致性分阶段事务模式,牺牲了一定的可用性,无业务侵入
- TCC模式:最终一致的分阶段事务模式,有业务侵入
- AT模式:最终一致的分阶段事务模式,无业务侵入,也是Seata的默认模式
- SAGA模式:长事务模式,有业务侵入
使用
下载完seata后,进入conf目录,修改registry.conf:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29registry {
# tc服务的注册中心类,这里选择nacos,也可以是eureka、zookeeper等
type = "nacos"
nacos {
# seata tc 服务注册到 nacos的服务名称,可以自定义
application = "seata-tc-server"
serverAddr = "127.0.0.1:8848"
group = "DEFAULT_GROUP"
namespace = ""
cluster = "SH"
username = "nacos"
password = "nacos"
}
}
config {
# 读取tc服务端的配置文件的方式,这里是从nacos配置中心读取,这样如果tc是集群,可以共享配置
type = "nacos"
# 配置nacos地址等信息
nacos {
serverAddr = "127.0.0.1:8848"
namespace = ""
group = "SEATA_GROUP"
username = "nacos"
password = "nacos"
dataId = "seataServer.properties"
}
}在nacos添加配置:
为了让tc服务的集群可以共享配置,可以选择了nacos作为统一配置中心。因此服务端配置文件seataServer.properties文件需要在nacos中配好。
新建配置: Data ID:seataServer.properties,Group:DEFAULT_GROUP,具体内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34# 数据存储方式,db代表数据库
store.mode=db
store.db.datasource=druid
store.db.dbType=mysql
store.db.driverClassName=com.mysql.jdbc.Driver
store.db.url=jdbc:mysql://127.0.0.1:3306/seata?useUnicode=true&rewriteBatchedStatements=true
store.db.user=root
store.db.password=123
store.db.minConn=5
store.db.maxConn=30
store.db.globalTable=global_table
store.db.branchTable=branch_table
store.db.queryLimit=100
store.db.lockTable=lock_table
store.db.maxWait=5000
# 事务、日志等配置
server.recovery.committingRetryPeriod=1000
server.recovery.asynCommittingRetryPeriod=1000
server.recovery.rollbackingRetryPeriod=1000
server.recovery.timeoutRetryPeriod=1000
server.maxCommitRetryTimeout=-1
server.maxRollbackRetryTimeout=-1
server.rollbackRetryTimeoutUnlockEnable=false
server.undo.logSaveDays=7
server.undo.logDeletePeriod=86400000
# 客户端与服务端传输方式
transport.serialization=seata
transport.compressor=none
# 关闭metrics功能,提高性能
metrics.enabled=false
metrics.registryType=compact
metrics.exporterList=prometheus
metrics.exporterPrometheusPort=9898创建事务相关的表:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45SET NAMES utf8mb4;
SET FOREIGN_KEY_CHECKS = 0;
-- ----------------------------
-- 分支事务表
-- ----------------------------
DROP TABLE IF EXISTS `branch_table`;
CREATE TABLE `branch_table` (
`branch_id` bigint(20) NOT NULL,
`xid` varchar(128) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,
`transaction_id` bigint(20) NULL DEFAULT NULL,
`resource_group_id` varchar(32) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`resource_id` varchar(256) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`branch_type` varchar(8) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`status` tinyint(4) NULL DEFAULT NULL,
`client_id` varchar(64) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`application_data` varchar(2000) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`gmt_create` datetime(6) NULL DEFAULT NULL,
`gmt_modified` datetime(6) NULL DEFAULT NULL,
PRIMARY KEY (`branch_id`) USING BTREE,
INDEX `idx_xid`(`xid`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;
-- ----------------------------
-- 全局事务表
-- ----------------------------
DROP TABLE IF EXISTS `global_table`;
CREATE TABLE `global_table` (
`xid` varchar(128) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,
`transaction_id` bigint(20) NULL DEFAULT NULL,
`status` tinyint(4) NOT NULL,
`application_id` varchar(32) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`transaction_service_group` varchar(32) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`transaction_name` varchar(128) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`timeout` int(11) NULL DEFAULT NULL,
`begin_time` bigint(20) NULL DEFAULT NULL,
`application_data` varchar(2000) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`gmt_create` datetime NULL DEFAULT NULL,
`gmt_modified` datetime NULL DEFAULT NULL,
PRIMARY KEY (`xid`) USING BTREE,
INDEX `idx_gmt_modified_status`(`gmt_modified`, `status`) USING BTREE,
INDEX `idx_transaction_id`(`transaction_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;
SET FOREIGN_KEY_CHECKS = 1;启动:bin目录下的seata-server.bat,启动成功后,seata-server应该已经注册到nacos注册中心了。
微服务集成Seata
引入依赖:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17<dependency>
<groupId>com.alibaba.cloud</groupId>
<artifactId>spring-cloud-starter-alibaba-seata</artifactId>
<exclusions>
<!--版本较低,1.3.0,因此排除-->
<exclusion>
<artifactId>seata-spring-boot-starter</artifactId>
<groupId>io.seata</groupId>
</exclusion>
</exclusions>
</dependency>
<!--seata starter 采用1.4.2版本-->
<dependency>
<groupId>io.seata</groupId>
<artifactId>seata-spring-boot-starter</artifactId>
<version>${seata.version}</version>
</dependency>修改配置文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14seata:
registry: # TC服务注册中心的配置,微服务根据这些信息去注册中心获取tc服务地址
# 参考tc服务自己的registry.conf中的配置
type: nacos
nacos: # tc
server-addr: 127.0.0.1:8848
namespace: ""
group: DEFAULT_GROUP
application: seata-tc-server # tc服务在nacos中的服务名称
cluster: SH
tx-service-group: seata-demo # 事务组,根据这个获取tc服务的cluster名称
service:
vgroup-mapping: # 事务组与TC服务cluster的映射关系
seata-demo: SH微服务可以根据
- namespace:命名空间
- group:分组
- application:服务名
- cluster:集群名
这四个信息来确定TC服务集群,上述配置中,namespace为空,就是默认的public,所以TC服务是:public@DEFAULT_GROUP@seata-tc-server@SH
XA模式
XA 规范 是 X/Open 组织定义的分布式事务处理(DTP,Distributed Transaction Processing)标准,XA 规范 描述了全局的TM与局部的RM之间的接口,几乎所有主流的数据库都对 XA 规范 提供了支持。
- XA是规范,目前主流数据库都实现了这种规范,实现的原理都是基于两阶段提交。
正常情况:
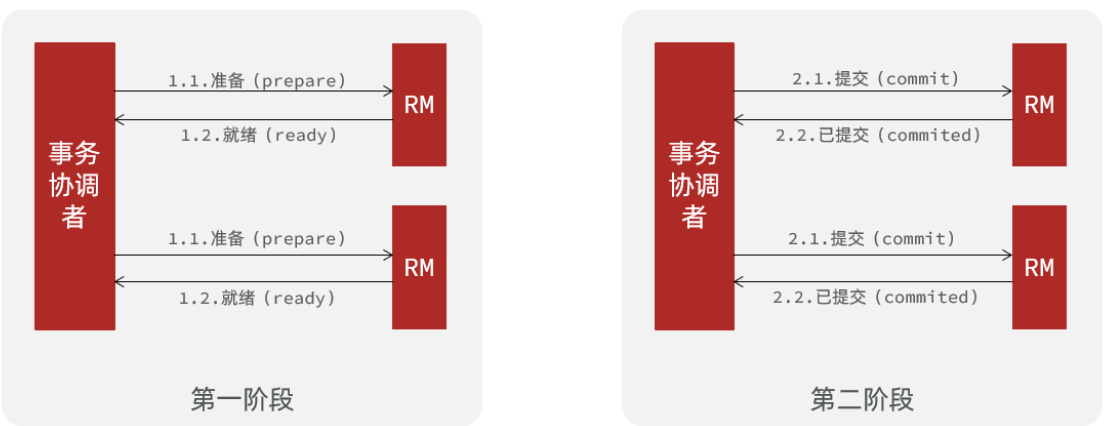
异常情况:
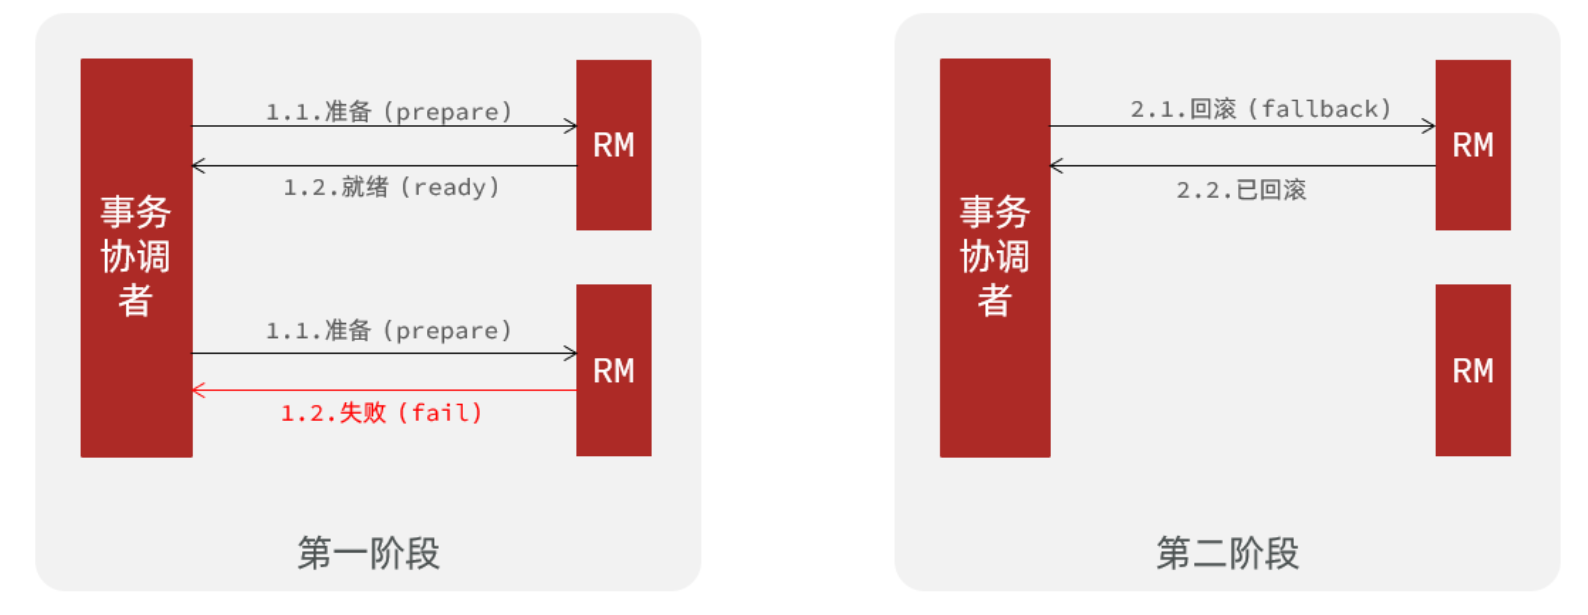
一阶段:
- 事务协调者通知每个事物参与者执行本地事务
- 本地事务执行完成后报告事务执行状态给事务协调者,此时事务不提交,继续持有数据库锁
二阶段:
- 事务协调者基于一阶段的报告来判断下一步操作
- 如果一阶段都成功,则通知所有事务参与者,提交事务
- 如果一阶段任意一个参与者失败,则通知所有事务参与者回滚事务
Seata对原始的XA模式做了简单的封装和改造,以适应自己的事务模型,基本架构如图:
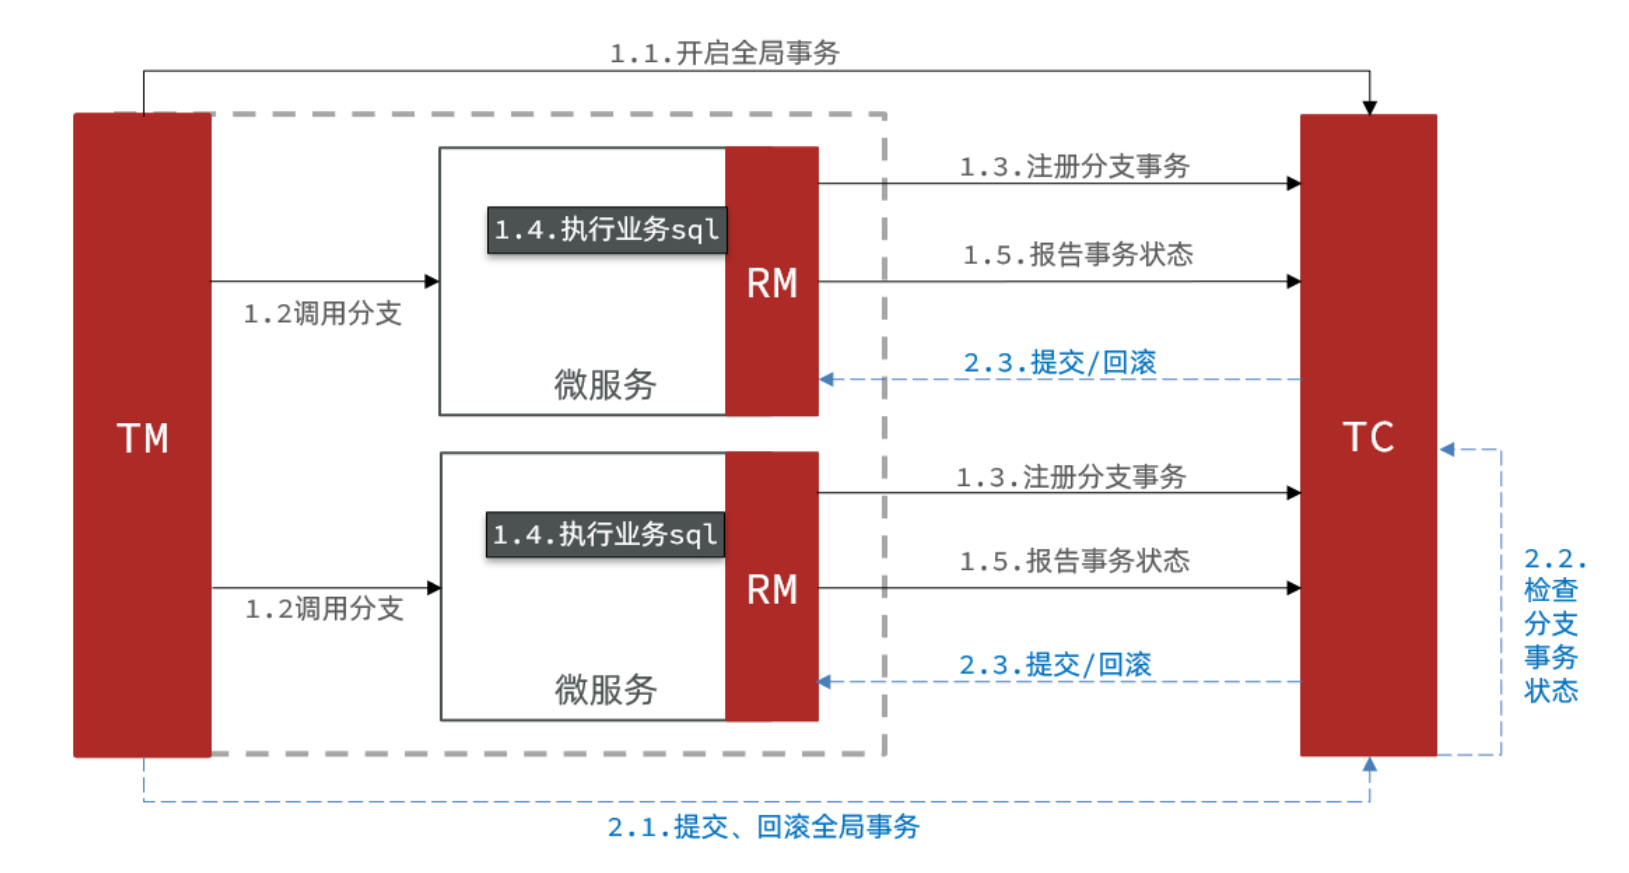
RM一阶段的工作:
① 注册分支事务到TC
② 执行分支业务sql但不提交
③ 报告执行状态到TC
TC二阶段的工作:
TC检测各分支事务执行状态
a.如果都成功,通知所有RM提交事务
b.如果有失败,通知所有RM回滚事务
RM二阶段的工作:
- 接收TC指令,提交或回滚事务
优点:
- 事务的强一致性,满足ACID原则。
- 常用数据库都支持,实现简单,并且没有代码侵入
缺点:
- 因为一阶段需要锁定数据库资源,等待二阶段结束才释放,性能较差
- 依赖关系型数据库实现事务
使用:
Seata的starter已经完成了XA模式的自动装配,实现简单,步骤如下:
修改application.yml文件(每个参与事务的微服务),开启XA模式:
1
2seata:
data-source-proxy-mode: XA给发起全局事务的入口方法添加@GlobalTransactional注解
启动服务并测试
AT模式
AT模式同样是分阶段提交的事务模型,不过缺弥补了XA模型中资源锁定周期过长的缺陷。
AT模式的基本流程图:
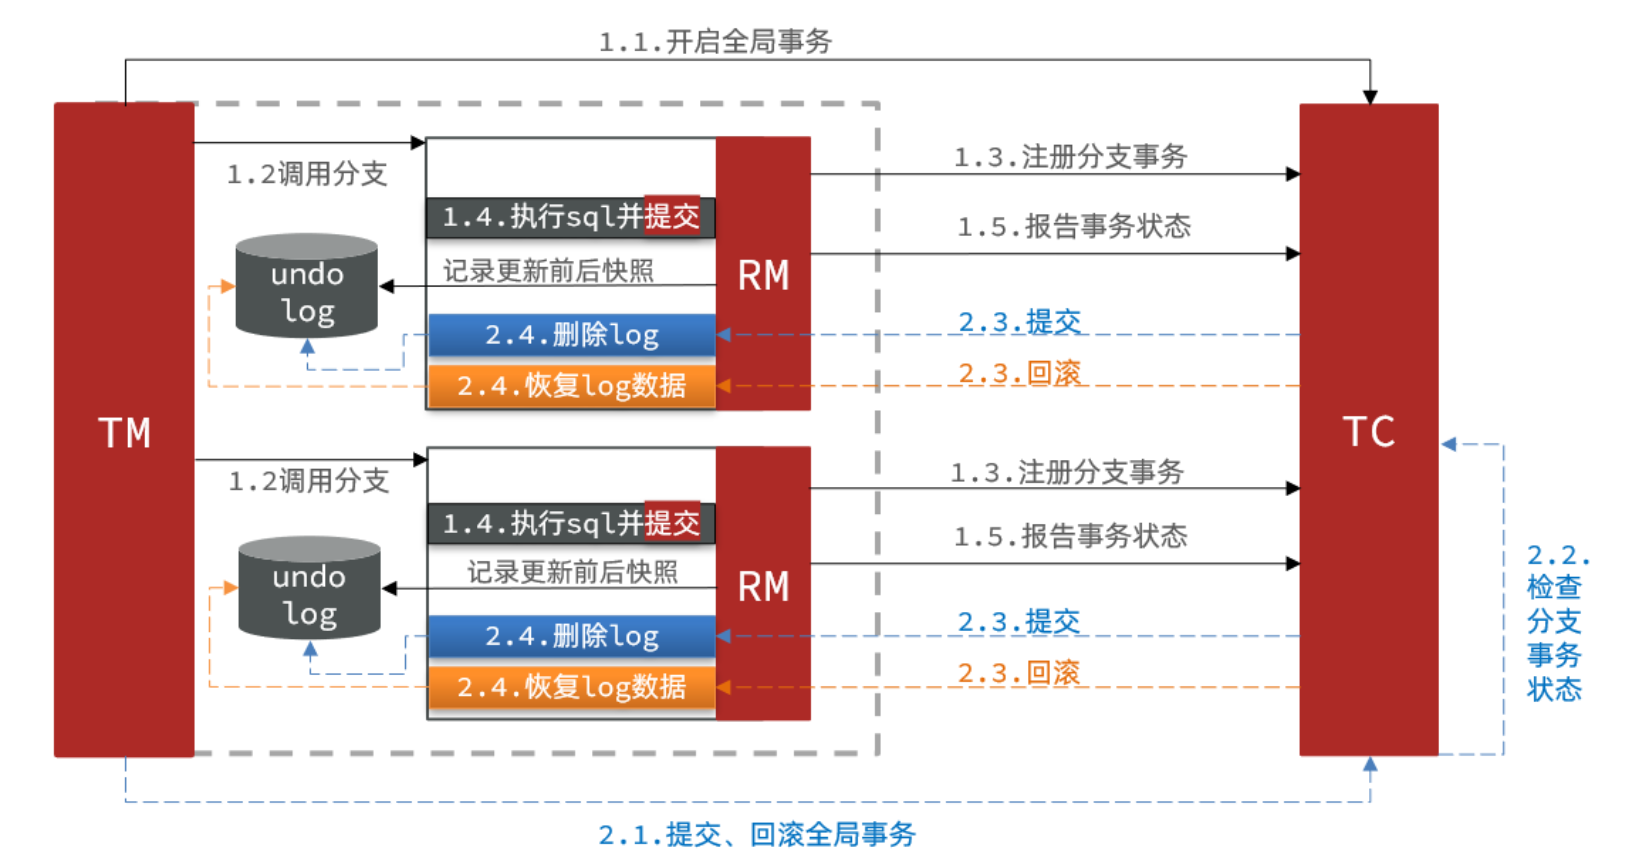
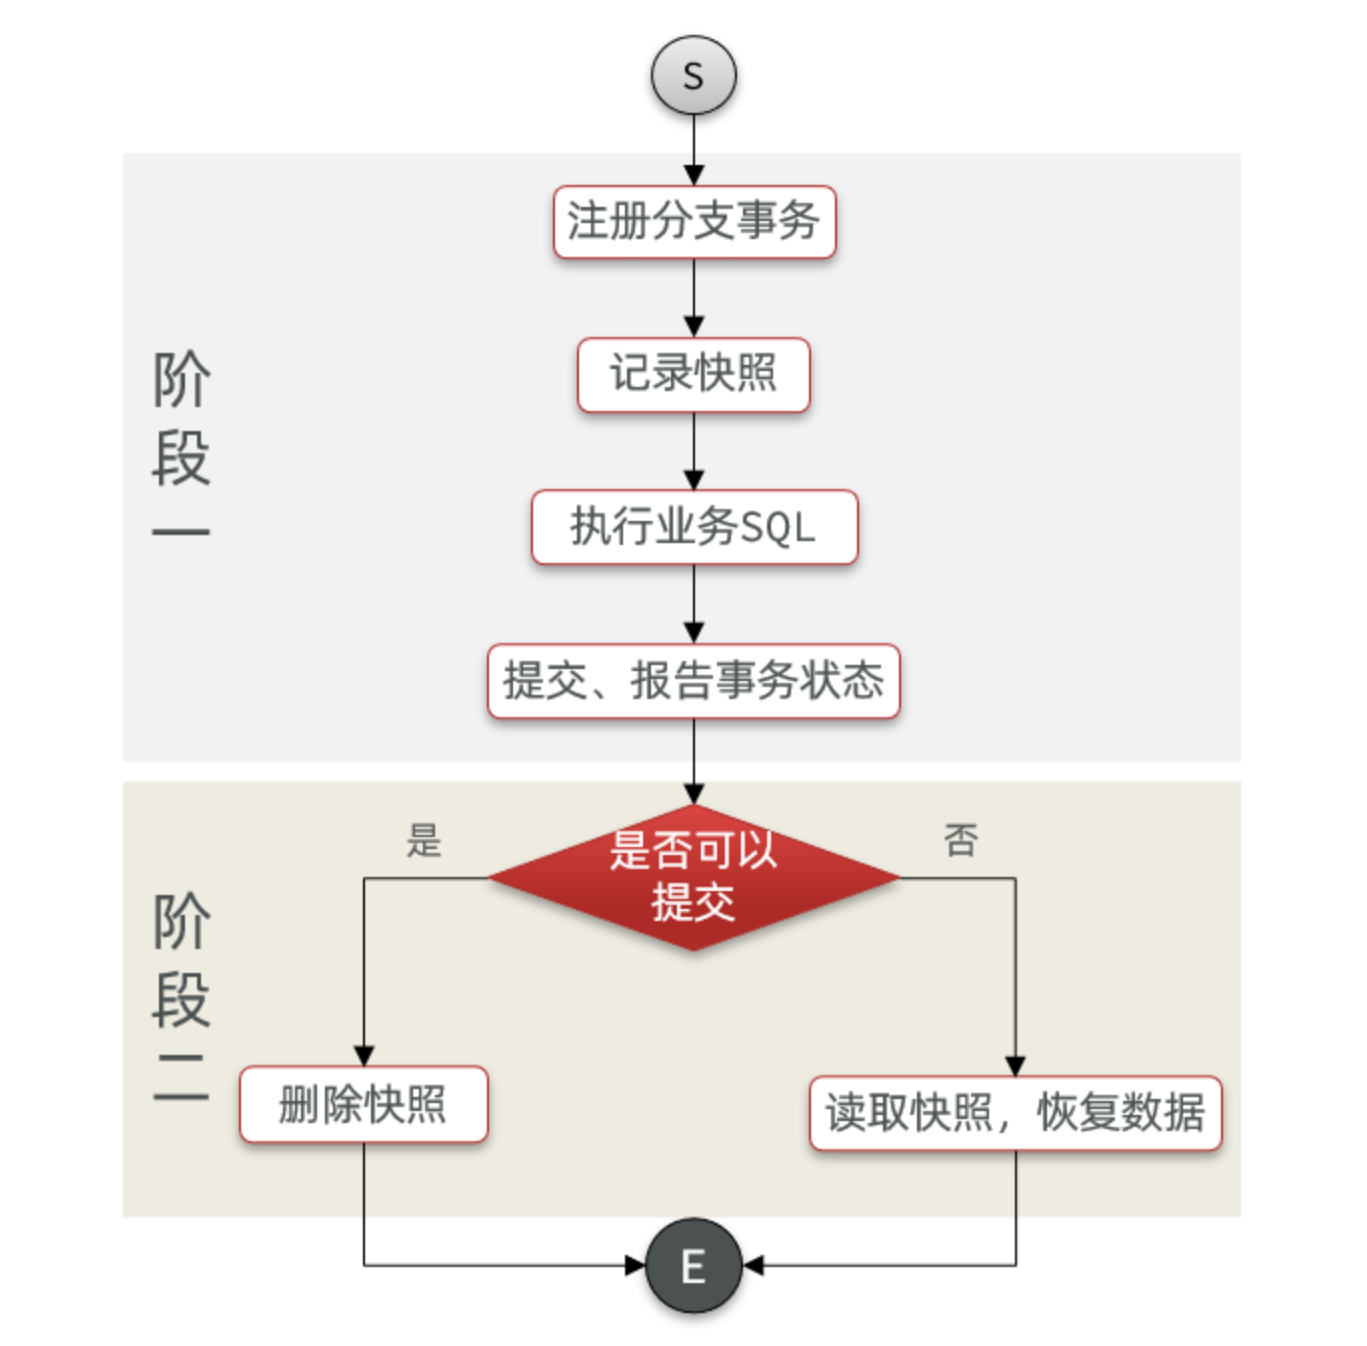
阶段一RM的工作:
- 注册分支事务
- 记录undo-log(数据快照)
- 执行业务sql并提交
- 报告事务状态
阶段二提交时RM的工作:
- 删除undo-log即可
阶段二回滚时RM的工作:
- 根据undo-log恢复数据到更新前
简述AT模式与XA模式最大的区别是什么?
- XA模式一阶段不提交事务,锁定资源;AT模式一阶段直接提交,不锁定资源。
- XA模式依赖数据库机制实现回滚;AT模式利用数据快照实现数据回滚。
- XA模式强一致;AT模式最终一致
在多线程并发访问AT模式的分布式事务时,有可能出现脏写问题,如图:
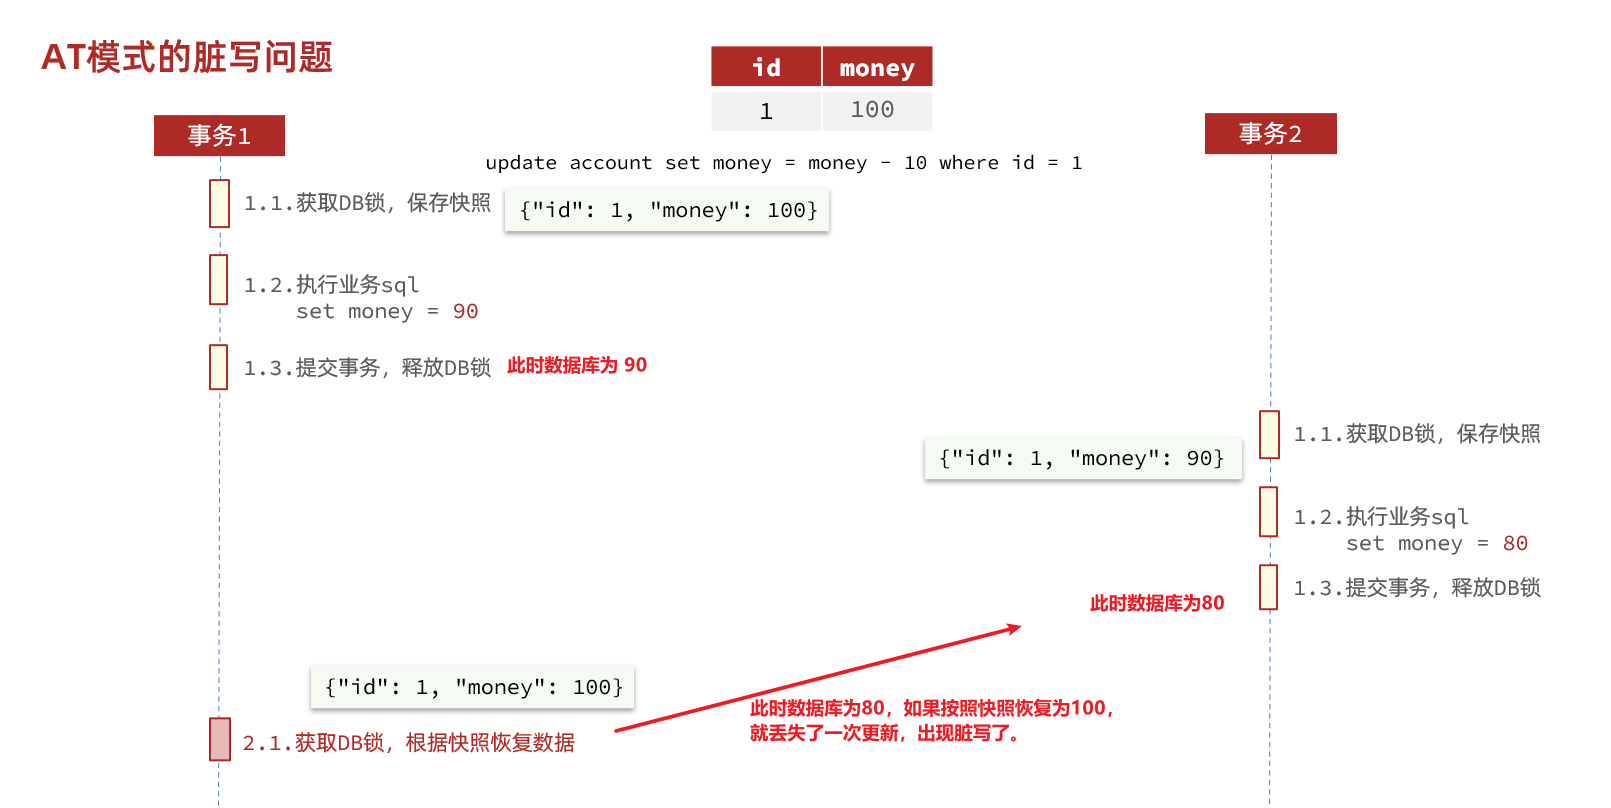
解决思路:引入了全局锁的概念。在释放DB锁之前,先拿到全局锁。避免同一时刻有另外一个事务来操作当前数据。
XA用的是mysql的锁,隔离级别默认是可重复读,加的是行锁,AT的全局锁是seata提供的,锁的只是该记录行的对应字段,其他事务可以读但不可写,其他字段不受影响,并且由TC管理,释放快且无阻塞问题。
- 如果是不受TC管理的事务想要同时和TC事务修改了同一行事务,是不受TC全局锁影响的,所以,AT模式会记录两份快照:before-image记录修改前的快照,用于回滚,after-image记录修改的快照,在二阶段时用于判断修改后的数据有没有被中途修改。
AT模式优点:
- 一阶段完成直接提交事务,释放数据库资源,性能比较好
- 利用全局锁实现读写隔离
- 没有代码侵入,框架自动完成回滚和提交
缺点:
- 两阶段之间属于软状态,属于最终一致
- 框架的快照功能会影响性能,但比XA模式要好很多
实现:
AT模式中的快照生成、回滚等动作都是由框架自动完成,没有任何代码侵入,因此实现也简单。
只不过,AT模式需要一个表来记录全局锁、另一张表来记录数据快照undo_log。
其中lock_table应该导入到TC服务关联的数据库,undo_log表导入到微服务关联的数据库:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42SET NAMES utf8mb4;
SET FOREIGN_KEY_CHECKS = 0;
-- ----------------------------
-- Table structure for undo_log
-- ----------------------------
DROP TABLE IF EXISTS `undo_log`;
CREATE TABLE `undo_log` (
`branch_id` bigint(20) NOT NULL COMMENT 'branch transaction id',
`xid` varchar(100) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT 'global transaction id',
`context` varchar(128) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL COMMENT 'undo_log context,such as serialization',
`rollback_info` longblob NOT NULL COMMENT 'rollback info',
`log_status` int(11) NOT NULL COMMENT '0:normal status,1:defense status',
`log_created` datetime(6) NOT NULL COMMENT 'create datetime',
`log_modified` datetime(6) NOT NULL COMMENT 'modify datetime',
UNIQUE INDEX `ux_undo_log`(`xid`, `branch_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci COMMENT = 'AT transaction mode undo table' ROW_FORMAT = Compact;
-- ----------------------------
-- Records of undo_log
-- ----------------------------
-- ----------------------------
-- Table structure for lock_table
-- ----------------------------
DROP TABLE IF EXISTS `lock_table`;
CREATE TABLE `lock_table` (
`row_key` varchar(128) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL,
`xid` varchar(96) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`transaction_id` bigint(20) NULL DEFAULT NULL,
`branch_id` bigint(20) NOT NULL,
`resource_id` varchar(256) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`table_name` varchar(32) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`pk` varchar(36) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
`gmt_create` datetime NULL DEFAULT NULL,
`gmt_modified` datetime NULL DEFAULT NULL,
PRIMARY KEY (`row_key`) USING BTREE,
INDEX `idx_branch_id`(`branch_id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Compact;
SET FOREIGN_KEY_CHECKS = 1;修改配置文件:
1
2seata:
data-source-proxy-mode: AT # 默认就是AT
TCC模式
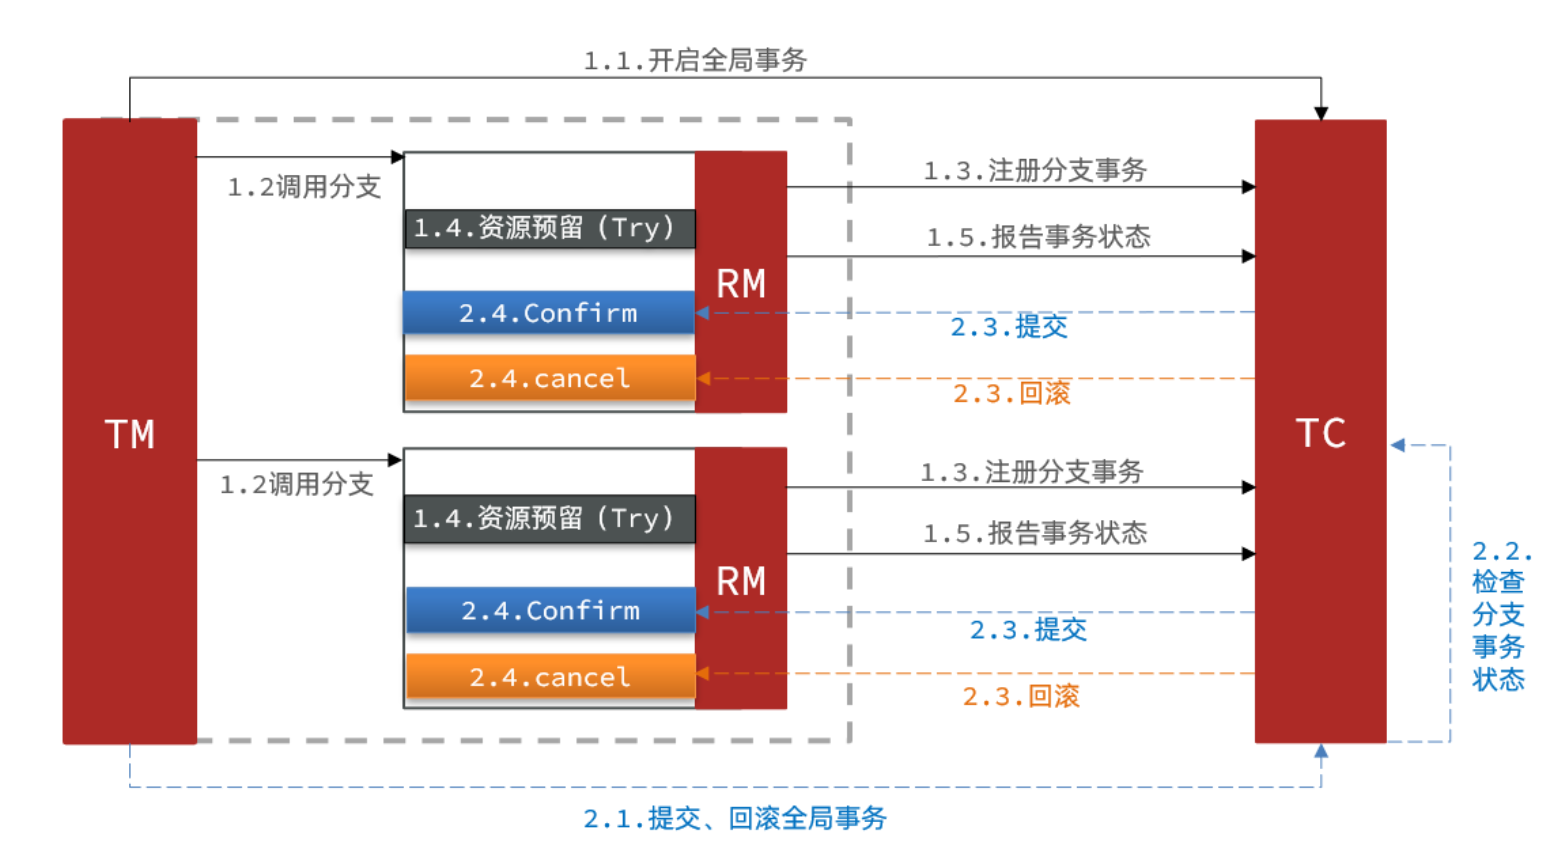
TCC模式与AT模式非常相似,每阶段都是独立事务,不同的是TCC通过人工编码来实现数据恢复。需要实现三个方法:
Try:资源的检测和预留;
Confirm:完成资源操作业务;要求 Try 成功 Confirm 一定要能成功。
Cancel:预留资源释放,可以理解为try的反向操作。
模型流程图:
TCC的优点:
- 一阶段完成直接提交事务,释放数据库资源,性能好
- 相比AT模型,无需生成快照,无需使用全局锁,性能最强
- 不依赖数据库事务,而是依赖补偿操作,可以用于非事务型数据库
TCC的缺点:
- 有代码侵入,需要人为编写try、Confirm和Cancel接口,太麻烦
- 软状态,事务是最终一致
- 需要考虑Confirm和Cancel的失败情况,做好幂等处理
问题:
空回滚:
当某分支事务的try阶段阻塞时,可能导致全局事务超时而触发二阶段的cancel操作。在未执行try操作时先执行了cancel操作,这时cancel不可以做回滚,而是应该执行一个空回滚。(空回滚就是什么都不做,直接返回cancel操作成功)
- 执行cancel操作时,应当判断try是否已经执行,如果尚未执行,则应该空回滚。
避免业务悬挂:
对于已经空回滚的业务,之前被阻塞的try操作恢复,继续执行try,就永远不可能confirm或cancel ,事务一直处于中间状态,这就是业务悬挂。
- 执行try操作时,应当判断cancel是否已经执行过了,如果已经执行,应当阻止空回滚后的try操作,避免悬挂
实现TCC模式:
加入一张表:
1
2
3
4
5
6
7CREATE TABLE `account_freeze_tbl` (
`xid` varchar(128) NOT NULL,
`user_id` varchar(255) DEFAULT NULL COMMENT '用户id',
`freeze_money` int(11) unsigned DEFAULT '0' COMMENT '冻结金额',
`state` int(1) DEFAULT NULL COMMENT '事务状态,0:try,1:confirm,2:cancel',
PRIMARY KEY (`xid`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8 ROW_FORMAT=COMPACT;业务逻辑:
- Try业务:
- 记录冻结金额和事务状态到account_freeze表
- 扣减account表可用金额
- Confirm业务
- 根据xid删除account_freeze表的冻结记录
- Cancel业务
- 修改account_freeze表,冻结金额为0,state为2
- 修改account表,恢复可用金额
- 如何判断是否空回滚?
- cancel业务中,根据xid查询account_freeze,如果为null则说明try还没做,需要空回滚
- 如何避免业务悬挂?
- try业务中,根据xid查询account_freeze ,如果已经存在则证明Cancel已经执行,拒绝执行try业务
- Try业务:
声明TCC接口:
1
2
3
4
5
6
7
8
9
10
11
public interface AccountTCCService {
void deduct( String userId,
int money);
boolean confirm(BusinessActionContext ctx);
boolean cancel(BusinessActionContext ctx);
}编写实现类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
public class AccountTCCServiceImpl implements AccountTCCService {
private AccountMapper accountMapper;
private AccountFreezeMapper freezeMapper;
public void deduct(String userId, int money) {
// 0.获取事务id
String xid = RootContext.getXID();
// 防止业务悬挂: 判断freeze中是否有冻结记录,如果有,一定是cancel执行过,要拒绝业务
if (freezeMapper.selectById(xid) != null){
return;
}
// 1.扣减可用余额
accountMapper.deduct(userId, money);
// 2.记录冻结金额,事务状态
AccountFreeze freeze = new AccountFreeze();
freeze.setUserId(userId);
freeze.setFreezeMoney(money);
freeze.setState(AccountFreeze.State.TRY);
freeze.setXid(xid);
freezeMapper.insert(freeze);
}
public boolean confirm(BusinessActionContext ctx) {
// 1.获取事务id
String xid = ctx.getXid();
// 2.根据id删除冻结记录
int count = freezeMapper.deleteById(xid);
return count == 1;
}
public boolean cancel(BusinessActionContext ctx) {
// 0.查询冻结记录
String xid = ctx.getXid();
AccountFreeze freeze = freezeMapper.selectById(xid);
// 1. 空回滚逻辑
if (freeze == null){
freeze = new AccountFreeze();
freeze.setUserId(userId);
freeze.setFreezeMoney(0);
freeze.setState(AccountFreeze.State.CANCEL);
freeze.setXid(xid);
freezeMapper.insert(freeze);
return true;
}
// 2. 幂等判断
if (freeze.getState() == AccountFreeze.State.CANCEL){
// 已经处理过一次cancel, 不需重复处理
return true;
}
// 1.恢复可用余额
accountMapper.refund(freeze.getUserId(), freeze.getFreezeMoney());
// 2.将冻结金额清零,状态改为CANCEL
freeze.setFreezeMoney(0);
freeze.setState(AccountFreeze.State.CANCEL);
int count = freezeMapper.updateById(freeze);
return count == 1;
}
}
SAGA模式
Saga 模式是 Seata 即将开源的长事务解决方案,将由蚂蚁金服主要贡献。
。。。
模式对比
从以下几个方面来对比四种实现:
- 一致性:能否保证事务的一致性?强一致还是最终一致?
- 隔离性:事务之间的隔离性如何?
- 代码侵入:是否需要对业务代码改造?
- 性能:有无性能损耗?
- 场景:常见的业务场景
| XA | AT | TCC | SAGA | |
|---|---|---|---|---|
| 一致性 | 强一致 | 弱一致 | 弱一致 | 最终一致 |
| 隔离性 | 完全隔离 | 基于全局锁隔离 | 基于资源预留隔离 | 无隔离 |
| 代码侵入 | 无 | 无 | 有,要编写三个接口 | 有,要编写状态机和补偿业务 |
| 性能 | 差 | 好 | 非常好 | 非常好 |
| 场景 | 对一致性、隔离性有高要求的业务 | 基于关系型数据库的大多数分布式事务场景都可以 | 对性能要求高,或有非关系型数据库参与的事务 | 业务流程长,业务流程多; 参与者包含遗留系统服务,无法提供TCC要求的三个接口时 |
高可用
搭建TC服务集群,只需启动多个TC服务,注册到nacos即可。
但集群并不能确保100%安全,如果集群所在机房故障,应该有异地容灾的功能。(大概就是在nacos配置事务组tx-service-group与TC集运的映射关系,当其中一个集群故障时,只需要将vgroup-mapping中的映射关系改成另一个集群的名字就行了。)
异步通信技术
消息队列的作用: 异步处理,系统解耦,流量削峰,(其中kafka主要用于大数据实时计算和日志采集)
| 特性 | ActiveMQ | RabbitMQ | RocketMQ | Kafka |
|---|---|---|---|---|
| 单机吞吐量 | 万级 | 万级 | 十万级 | 十万级 |
| 时效性 | ms 级 | 微秒级,延迟最低 | ms 级 | ms 级 |
| 可用性 | 高,基于主从架构实现高可用 | 同ActiveMQ | 非常高,分布式架构 | 非常高,分布式,一个数据多个副本,少数机器宕机,不会丢失数据,不会导致不可用 |
| 消息可靠性 | 有较低的概率丢失数据 | 基本不丢 | 经过参数优化配置,可以做到 0 丢失 | 经过参数优化配置,可以做到 0 丢失 |
| 功能支持 | MQ功能极为完善 | 基于erlang 开发,并发能力很强,性能极好,延时很低 | MQ功能较为完善,分布式拓展性好 | MQ功能简单,主要用于大数据的实时计算和日志采集 |
topic数量对吞吐量的影响:
- RocketMQ: topic 可以达到几百/几千的级别,吞吐量会有较小幅度的下降,这是 RocketMQ一大优势,在同等机器下,可以支撑大量的 topic
- Kafka:topic 从几十到几百个时候,吞吐量会大幅度下降,在同等机器下,Kafka尽量保证 topic 数量不要过多,如果要支撑大规模的topic,需要增加更多的机器资源
MQ选型推荐:
- 中小型公司,技术实力较为一般,技术挑战不是特别高,用 RabbitMQ 是不错的选择;(开源社区活跃度很高)
- 大型公司,基础架构研发实力较强,用 RocketMQ 是很好的选择。
- 如果是大数据领域的实时计算、日志采集等场景,用 Kafka 是业内标准的,
RabbitMQ
概述
微服务通信有同步(实时响应)和异步(不需要实时响应)两种方式:
- Feign调用就属于同步方式,虽然能时效性强,能立即得到结果,但存在以下问题:
- 耦合度高,每次加入新的需求都要修改原来的代码;
- 性能下降:调用者需要等待服务提供者响应;
- 资源浪费:调用链中的每个服务在等待响应过程中,不能释放请求占用的资源;
- 级联失效:如果服务提供者出现问题,所有调用方都会跟着出问题。
而异步通信,引入了一个中间人 Broker,事件/服务的发布者将事件发布到Broker,不用关心哪个接收方来订阅事件, 接收方也不关心是谁发布的事件。
好处:
吞吐量提升:无需等待订阅者处理完成,响应更快速
故障隔离:服务没有直接调用,不存在级联失败问题
调用间没有阻塞,不会造成无效的资源占用
耦合度极低,每个服务都可以灵活插拔,可替换
流量削峰:不管发布事件的流量波动多大,都由Broker接收,订阅者可以按照自己的速度去处理事件
缺点:
- 架构变复杂,业务没有明显的流程线,不好管理
- 需要依赖于Broker的可靠、安全、性能
MQ,即消息队列(MessageQueue),也就是上述事件驱动架构中的Broker。
RabbitMQ的5种消息模型:
- BasicQueue —— 基本消息队列
- WorkQueue —— 工作消息队列
- 发布订阅:
- Fanout Exchange —— 广播
- Direct Exchange —— 路由
- Topic Exchange —— 主题
使用:
SpringAMQP是基于RabbitMQ封装的一套模板。提供了三个功能:
- 自动声明队列、交换机及其绑定关系
- 基于注解的监听器模式,异步接收消息
- 封装了RabbitTemplate工具,用于发送消息
使用:
引入依赖:
1 | <!--AMQP依赖,包含RabbitMQ--> |
配置yaml文件(发布者和接收者都要配):
1 | spring: |
消息模型
BasicQueue
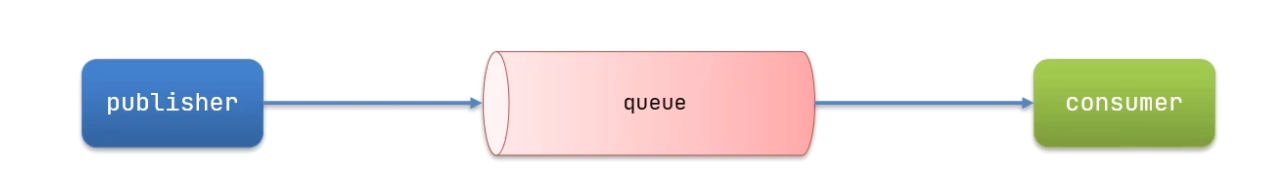
- publisher: 消息发布者,将消息发送到队列queue;
- queue:消息队列,负责接收并缓存消息;
- consumer:订阅队列,处理队列中消息;
发布者:
1 |
|
消费者:
1 |
|
启动consumer服务,然后在publisher服务中运行测试代码,发送MQ消息
WorkQueue
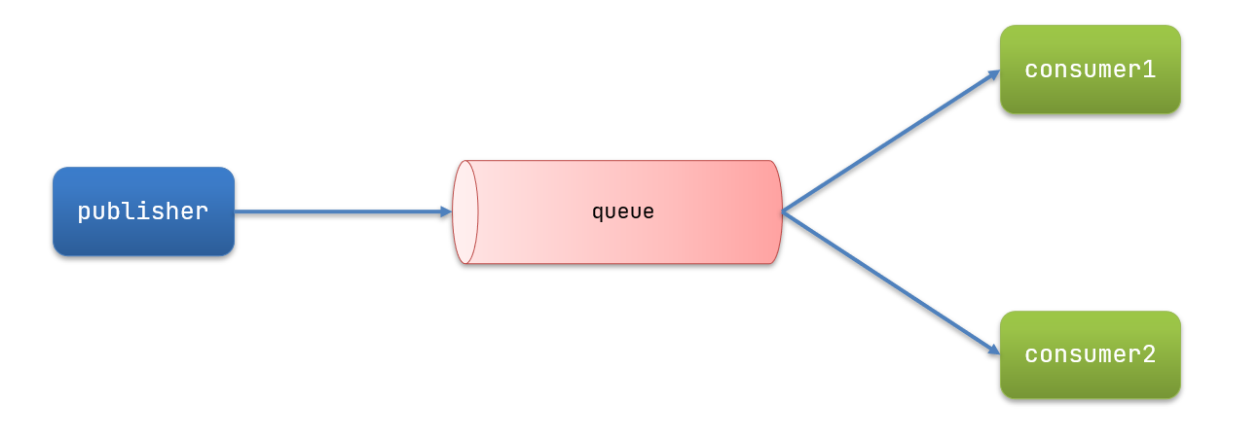
让多个消费者绑定一个队列,共同消费队列中的消息。
当消息处理比较耗时的时候,可能生产消息的速度会远远大于消息的消费速度。为了防止消息堆积越来越多,可以使用这个work模型,多个消费者共同处理消息处理,速度就能大大提高了。
- 同一条消息只会被一个消费者处理;
- 通过设置prefetch来控制消费者预取的消息数量;
发布者:模拟发送大量消息
1 |
|
消费者:
1 |
|
Fanout
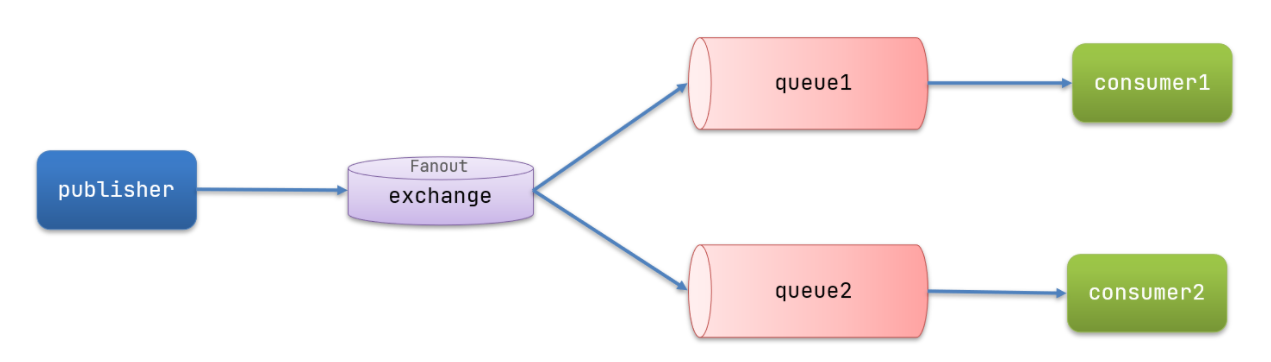
发布订阅模型:
- Publisher: 生产者,但消息不再发送到队列中,而是发给交换机Exchange。
- Exchange:交换机,一方面,接收生产者发送的消息。另一方面,知道如何处理消息,例如递交给某个特别队列、递交给所有队列、或是将消息丢弃。到底如何操作,取决于Exchange的类型。Exchange有以下3种类型:
- Fanout:广播,将消息交给所有绑定到交换机的队列
- Direct:定向,把消息交给符合指定routing key 的队列
- Topic:通配符,把消息交给符合routing pattern(路由模式) 的队列
- Consumer:消费者,与以前一样,订阅队列,没有变化
- Queue:消息队列也与以前一样,接收消息、缓存消息。
Exchange(交换机)只负责转发消息,不具备存储消息的能力,因此如果没有任何队列与Exchange绑定,或者没有符合路由规则的队列,那么消息会丢失!
Fanout,意思是扇出,在MQ中叫做广播更合适。 在广播模式下,可以有多个队列,每个队列都要绑定到Exchange,生产者发送的消息只能发送到交换机,交换机把消息发送给绑定过的所有队列。
代码:
声明队列和交换机:
1 |
|
消息发送:
1 |
|
接收消息:
1 |
|
Direct
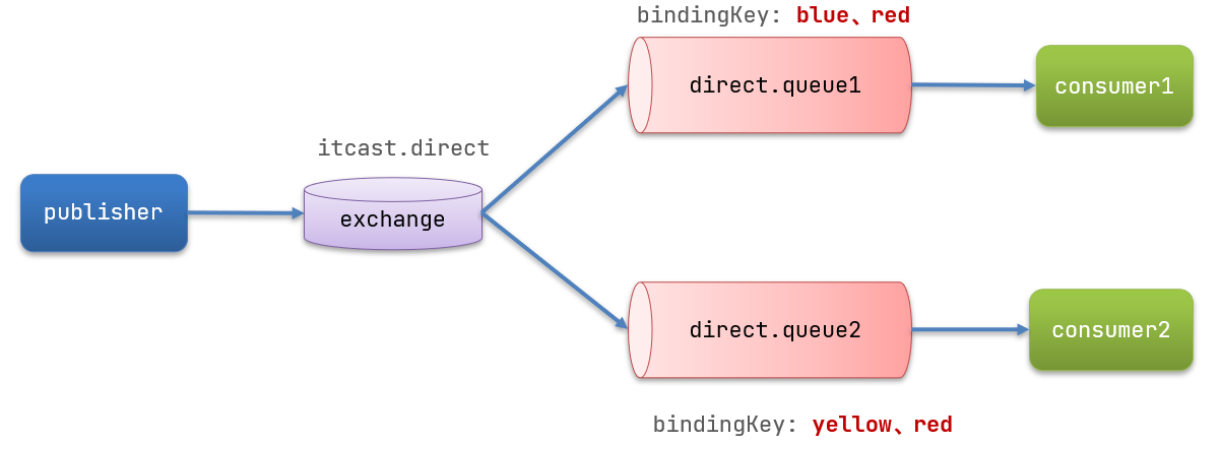
某些场景下,我们希望不同的消息被不同的队列消费。这时就要用到Direct类型的Exchange。
在Direct模式下,队列向绑定一个或多个RoutingKey,发送消息时,也要指定消息的RoutingKey,只有RoutingKey一致队列才接收消息。
代码:
声明队列和交换机(这里也可以用注解方法进行声明),接收消息:
1 |
|
发送消息:
1 |
|
Topic
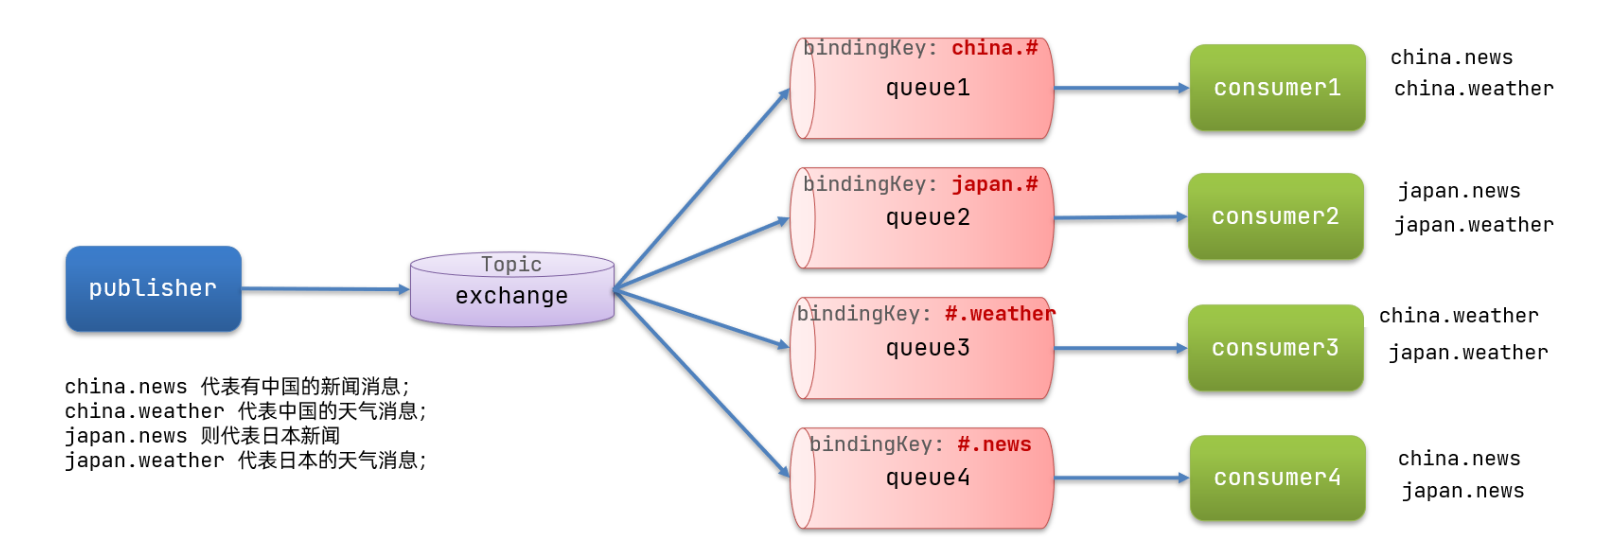
Topic可以根据RoutingKey把消息路由到不同的队列。只不过Topic可以让队列在绑定Routing key 的时候使用通配符!
Routingkey 一般都是有一个或多个单词组成,多个单词之间以”.”分割,例如: item.insert
通配符规则:
#:匹配一个或多个词*:匹配不多不少恰好1个词例如: item.# 能匹配 item.spu.insert 或者 item.spu; item.*:只能匹配item.spu
代码:
发送消息:
1 |
|
接收消息:
1 |
|
使用例子
配置文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20spring:
rabbitmq:
host: 192.168.101.65
port: 5672
username: guest
password: guest
virtual-host: /
publisher-confirm-type: correlated #correlated 异步回调,定义ConfirmCallback,MQ返回结果时会回调这个ConfirmCallback
publisher-returns: false #开启publish-return功能,同样是基于callback机制,需要定义ReturnCallback
template:
mandatory: false #定义消息路由失败时的策略。true,则调用ReturnCallback;false:则直接丢弃消息
listener:
simple:
acknowledge-mode: none #出现异常时返回unack,消息回滚到mq;没有异常,返回ack ,manual:手动控制,none:丢弃消息,不回滚到mq
retry:
enabled: true #开启消费者失败重试
initial-interval: 1000ms #初识的失败等待时长为1秒
multiplier: 1 #失败的等待时长倍数,下次等待时长 = multiplier * last-interval
max-attempts: 3 #最大重试次数
stateless: true #true无状态;false有状态。如果业务中包含事务,这里改为false声明mq配置(在service模块的config包中)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
public class PayNotifyConfig implements ApplicationContextAware {
//交换机
public static final String PAYNOTIFY_EXCHANGE_FANOUT = "paynotify_exchange_fanout";
//支付结果通知消息类型
public static final String MESSAGE_TYPE = "payresult_notify";
//支付通知队列
public static final String PAYNOTIFY_QUEUE = "paynotify_queue";
//声明交换机,且持久化
public FanoutExchange paynotify_exchange_fanout() {
// 三个参数:交换机名称、是否持久化、当没有queue与其绑定时是否自动删除
return new FanoutExchange(PAYNOTIFY_EXCHANGE_FANOUT, true, false);
}
//支付通知队列,且持久化
public Queue course_publish_queue() {
return QueueBuilder.durable(PAYNOTIFY_QUEUE).build();
}
//交换机和支付通知队列绑定
public Binding binding_course_publish_queue( Queue queue, FanoutExchange exchange) {
return BindingBuilder.bind(queue).to(exchange);
}
public void setApplicationContext(ApplicationContext applicationContext) throws BeansException {
// 获取RabbitTemplate
RabbitTemplate rabbitTemplate = applicationContext.getBean(RabbitTemplate.class);
//消息处理service
MqMessageService mqMessageService = applicationContext.getBean(MqMessageService.class);
// 设置ReturnCallback
rabbitTemplate.setReturnCallback((message, replyCode, replyText, exchange, routingKey) -> {
// 投递失败,记录日志
log.info("消息发送失败,应答码{},原因{},交换机{},路由键{},消息{}",
replyCode, replyText, exchange, routingKey, message.toString());
MqMessage mqMessage = JSON.parseObject(message.toString(), MqMessage.class);
//将消息再添加到消息表
mqMessageService.addMessage(mqMessage.getMessageType(), mqMessage.getBusinessKey1(), mqMessage.getBusinessKey2(), mqMessage.getBusinessKey3());
});
}
}启动服务,交换机和队列自动创建创建成功
在service中使用RabbitTemplate发送消息到交换机
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32// 发送消息到mq
public void notifyPayResult(MqMessage message) {
//消息内容
String jsonString = JSON.toJSONString(message);
//创建一个持久化消息
Message messageObj = MessageBuilder.withBody(jsonString.getBytes(StandardCharsets.UTF_8)).setDeliveryMode(MessageDeliveryMode.PERSISTENT).build();
//消息id
Long id = message.getId();
//全局消息id
CorrelationData correlationData = new CorrelationData(id.toString());
//使用correlationData指定回调方法
correlationData.getFuture().addCallback(result -> {
if (result.isAck()) {
//消息成功发送到了交换机
log.debug("发送消息成功:{}", jsonString);
//将消息从数据库表mq_message删除
mqMessageService.completed(id);
} else {
//消息发送失败
log.debug("发送消息失败:{}", jsonString);
}
}, ex -> {
//发生异常了
log.debug("发送消息异常:{}", jsonString);
});
//发送消息
rabbitTemplate.convertAndSend(PayNotifyConfig.PAYNOTIFY_EXCHANGE_FANOUT, "", messageObj, correlationData);
}接收并处理消息
1
2
3
4
public void receive(Message message) {
...
}
消息转换器
Spring会把要发送的消息序列化为字节发送给MQ,接收消息的时候,还会把字节反序列化为Java对象。
只不过,默认情况下Spring采用的序列化方式是JDK序列化。众所周知,JDK序列化存在数据体积大、有安全漏洞、可读性差等问题。
可以配置json转换器:
1 | <dependency> |
配置消息转换器,在配置类中添加一个Bean即可:
1 |
|
可靠消息服务
消息可靠性、镜像集群、延迟队列、消息幂等性
问题回答
RabbitMQ消息怎么传输?
由于 TCP 链接的创建和销毁开销较大,且并发数受系统资源限制,会造成性能瓶颈,所以 RabbitMQ 使用信道的方式来传输数据。信道(Channel)是生产者、消费者与 RabbitMQ 通信的渠道,信道是建立在 TCP 链接上的虚拟链接,且每条 TCP 链接上的信道数量没有限制。就是说 RabbitMQ 在一条 TCP 链接上建立成百上千个信道来达到多个线程处理,这个 TCP 被多个线程共享,每个信道在 RabbitMQ 都有唯一的 ID,保证了信道私有性,每个信道对应一个线程使用。
如何保证消息的可靠性?
- 生产者到RabbitMQ的过程丢失消息:事务机制和 Confirm 机制,注意:事务机制和 Confirm 机制是互斥的,两者不能共存,会导致 RabbitMQ 报错。
- RabbitMQ自身丢失消息:持久化、集群、普通模式、镜像模式。
- RabbitMQ到消费者的过程丢失消息:basicAck 机制、死信队列、消息补偿机制。
如何保证消息的顺序性?
- 拆分多个 queue(消息队列),每个 queue(消息队列) 一个 consumer(消费者),就是多一些 queue (消息队列)而已,确实是麻烦点;
- 或者就一个 queue (消息队列),但是只对应一个 consumer(消费者),然后这个 consumer(消费者)内部用内存队列做排队,然后分发给底层不同的 worker 来处理。
如何保证高可用?
RabbitMQ 是基于主从(非分布式)做高可用性的,RabbitMQ 有三种模式:单机模式、普通集群模式、镜像集群模式。
- 单机模式, 一般只在本地启动做练习,在生产中不会用单机模式。
- 普通集群模式,意思就是在多台机器上启动多个 RabbitMQ 实例,每个机器启动一个。你创建的 queue,只会放在一个 RabbitMQ 实例上,但是每个实例都同步 queue 的元数据(元数据可以认为是 queue 的一些配置信息,通过元数据,可以找到 queue 所在实例)。 在消费的时候,实际上如果连接到了另外一个实例,那么那个实例会从 queue 所在实例上拉取数据过来。这方案主要提高吞吐量,就是说让集群中多个节点来服务某个 queue 的读写操作。
- 镜像集群模式,这种模式,才是所谓的 RabbitMQ 的高可用模式。跟普通集群模式不一样的是,在镜像集群模式下,你创建的 queue,无论元数据还是 queue 里的消息都会存在于多个实例上,就是说,每个 RabbitMQ 节点都有这个 queue 的一个完整镜像,包含 queue 的全部数据的意思。然后每次你写消息到 queue 的时候,都会自动把消息同步到多个实例的 queue 上。
- RabbitMQ 有管理控制台,可以在后台新增一个镜像集群模式的策略,指定的时候是可以要求数据同步到所有节点的,也可以要求同步到指定数量的节点,再次创建 queue 的时候,应用这个策略,就会自动将数据同步到其他的节点上去了。 这样的好处在于,任何一个机器宕机了,其它机器(节点)还包含了这个 queue 的完整数据。坏处在于,性能开销太大,消息需要同步到所有机器上,导致网络带宽压力和消耗很重!
Kafka
- 简介
- 消息模型
- 消息概念
- kafka消息模型
- 生产者
- 消费者
- 序列化
概述
Apache Kafka是一个分布式流平台,由Scala和Java编写。一个分布式的流平台应该包含3点关键的能力:
- 发布和订阅数据流,类似于消息队列或者是企业消息传递系统
- 以容错的持久化方式存储数据流
- 处理数据流
应用场景:
- 建立实时数据管道,以可靠地在系统或应用程序之间获取数据
- 构建实时流应用程序,以转换或响应数据流
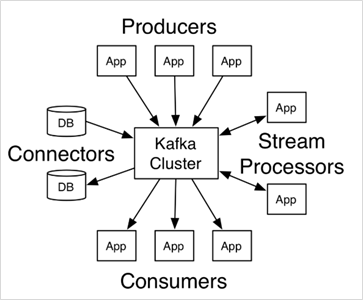
如上图:
Producers - 生产者:可以有很多的应用程序,将消息数据放入到Kafka集群中。
Consumers - 消费者:可以有很多的应用程序,将消息数据从Kafka集群中拉取出来。
Connectors - 连接器:Kafka的连接器用于数据库和Kafka之间传递数据。
Stream Processors - 流处理器:流处理器可以从Kafka中拉取数据,也可以将数据写入到Kafka中。
目录结构,软件的基本目录如下:
| 目录名称 | 说明 |
|---|---|
| bin | Kafka的所有执行脚本都在这里。例如:启动Kafka服务器、创建Topic、生产者、消费者程序等等 |
| config | Kafka的所有配置文件 |
| libs | 运行Kafka所需要的所有JAR包 |
| logs | Kafka的所有日志文件,如果Kafka出现一些问题,需要到该目录中去查看异常信息 |
| site-docs | Kafka的网站帮助文件 |
启动:
在解压缩后,进入软件目录,Kafka可以使用ZooKeeper或KRaft启动。
使用zookeeper启动kafka:
1
2
3# 先启动zookeeper, 再启动kafka
$ bin/zookeeper-server-start.sh config/zookeeper.properties &
$ bin/kafka-server-start.sh config/server.properties &使用KRaft启动kafka
1
2
3
4
5
6# 生成集群UUID
$ KAFKA_CLUSTER_ID="$(bin/kafka-storage.sh random-uuid)"
# 格式化日志目录
$ bin/kafka-storage.sh format -t $KAFKA_CLUSTER_ID -c config/kraft/server.properties
# 启动kafka
$ bin/kafka-server-start.sh config/kraft/server.properties
基本概念
broker:
一个Kafka的集群通常由多个broker组成,这样才能实现负载均衡、以及容错;
broker是无状态(Sateless)的,它们是通过ZooKeeper来维护集群状态;
一个Kafka的broker每秒可以处理数十万次读写,每个broker都可以处理TB级别的消息而不影响性能;
zookeeper:(Kafka逐步用自己实现的KRaft替换zookeeper)
- ZK用来管理和协调broker,并且存储了Kafka的元数据(例如:有多少topic、partition、consumer)
- ZK服务主要用于通知生产者和消费者Kafka集群中有新的broker加入、或者Kafka集群中出现故障的broker。
partitions 分区:在Kafka集群中,主题被分为多个分区。
replicas 副本: 将本服务器数据的副本分开放在其他服务器以做备份。
topic 主题:
- 主题是一个逻辑概念,用于生产者发布数据,消费者拉取数据
- Kafka中的主题必须要有标识符,而且是唯一的,Kafka中可以有任意数量的主题,没有数量上的限制
- 在主题中的消息是有结构的,一般一个主题包含某一类消息
- 一旦生产者发送消息到主题中,这些消息就不能被更新(更改)
offset 偏移量:
- offset记录下一条要发给消费者的消息的序号;
- 默认存放在zookeeper;
- 因为在分区中消息是有顺序地存放,所以每个分区都有一个递增的offset;
- offset在分区内才有意义,在分区之间无意义。
producer 生产者: 负责将数据推送给broker的topic。
consumer 消费者:消费者负责从broker的topic中拉取数据,并处理。
consumer group 消费者组:
- consumer group是kafka提供的可扩展且具有容错性的消费者机制
- 一个消费者组可以包含多个消费者
- 一个消费者组有一个唯一的ID(group Id)
- 组内的消费者一起消费主题的所有分区数据
基础操作
kafka中的消息都是保存在主题topic中的,先创建topic:
1
2
3
4# 创建名为test的主题
bin/kafka-topics.sh --create --topic test --bootstrap-server localhost:9092
# 查看目前Kafka中的主题
bin/kafka-topics.sh --list --bootstrap-server localhost:9092生产消息到对应的topic
1
bin/kafka-console-producer.sh --topic test --broker-list localhost:9092
可以持续输入,按ctrl-c随时停止
阅读消息:
1
bin/kafka-console-consumer.sh --topic test --from-beginning --bootstrap-server localhost:9092
可以持续阅读/消费,按ctrl-c随时停止
自带的基准测试:
生产测试
结果:
发送消息数量,吞吐量(吞吐速率),平均延迟,最大延迟
消费测试
结果:
- data.consumed.in.MB 共计消费的数据量
- MB.sec 每秒消费的数据量
- data.consumed.in.nMsg 共计消费的数量
- nMsg.sec 每秒的数量
2
2023-09-09 16:37:38:803, 2023-09-09 16:38:11:336, 4768.7235, 146.5811, 5000369, 153701.4416, 587, 31946, 149.2745, 156525.6683
Java API
官方API文档: http://kafka.apache.org/24/javadoc/index.html?org/apache/kafka/clients/consumer/KafkaConsumer.html
示例:将1-100写入kafka中
导入maven依赖
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24<!-- kafka客户端工具 -->
<dependency>
<groupId>org.apache.kafka</groupId>
<artifactId>kafka-clients</artifactId>
<version>2.4.1</version>
</dependency>
<!-- 工具类 -->
<dependency>
<groupId>org.apache.commons</groupId>
<artifactId>commons-io</artifactId>
<version>1.3.2</version>
</dependency>
<!-- SLF桥接LOG4J日志 -->
<dependency>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-log4j12</artifactId>
<version>1.7.6</version>
</dependency>
<!-- SLOG4J日志 -->
<dependency>
<groupId>log4j</groupId>
<artifactId>log4j</artifactId>
<version>1.2.16</version>
</dependency>生产者代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30public class KafkaProducerTest {
public static void main(String[] args) {
// 1. 创建用于连接Kafka的Properties配置
Properties props = new Properties();
props.put("bootstrap.servers", "192.168.205.129:9092");
props.put("acks", "all");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
// 2. 创建一个生产者对象KafkaProducer
KafkaProducer<String, String> producer = new KafkaProducer<String, String>(props);
// 3. 调用send发送1-100消息到指定Topic test
for(int i = 0; i < 100; ++i) {
try {
// 获取返回值Future,该对象封装了返回值
Future<RecordMetadata> future = producer.send(new ProducerRecord<String, String>("test", null, i + ""));
// 调用一个Future.get()方法等待响应
future.get();
} catch (InterruptedException e) {
e.printStackTrace();
} catch (ExecutionException e) {
e.printStackTrace();
}
}
// 5. 关闭生产者
producer.close();
}
}消费者代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42public class KafkaConsumerTest {
public static void main(String[] args) {
// 1.创建Kafka消费者配置
Properties props = new Properties();
props.setProperty("bootstrap.servers", "192.168.205.129:9092");
// 消费者组(可以使用消费者组将若干个消费者组织到一起),共同消费Kafka中topic的数据
// 每一个消费者需要指定一个消费者组,如果消费者的组名是一样的,表示这几个消费者是一个组中的
props.setProperty("group.id", "test");
// 自动提交offset
props.setProperty("enable.auto.commit", "true");
// 自动提交offset的时间间隔
props.setProperty("auto.commit.interval.ms", "1000");
// 拉取的key、value数据的
props.setProperty("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
props.setProperty("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
// 2.创建Kafka消费者
KafkaConsumer<String, String> kafkaConsumer = new KafkaConsumer<>(props);
// 3. 订阅要消费的主题
// 指定消费者从哪个topic中拉取数据
kafkaConsumer.subscribe(Arrays.asList("test"));
// 4.使用一个while循环,不断从Kafka的topic中拉取消息
while(true) {
// Kafka的消费者一次拉取一批的数据
ConsumerRecords<String, String> consumerRecords = kafkaConsumer.poll(Duration.ofSeconds(5));
// 5.将将记录(record)的offset、key、value都打印出来
for (ConsumerRecord<String, String> consumerRecord : consumerRecords) {
// 主题
String topic = consumerRecord.topic();
// offset:这条消息处于Kafka分区中的哪个位置
long offset = consumerRecord.offset();
// key\value
String key = consumerRecord.key();
String value = consumerRecord.value();
System.out.println("topic: " + topic + " offset:" + offset + " key:" + key + " value:" + value);
}
}
}
}
异步使用带有回调函数方法生产消息:(如果我们想获取生产者消息是否成功,或者成功生产消息到Kafka中后,执行一些其他动作。此时,可以很方便地使用带有回调函数来发送消息。)
1 | public class KafkaProducerTest { |
生产者的subscribe方法是自动订阅并主题中的数据,如果要手动消费某分区中的数据,可以assign方法指定分区,之后再用poll方法消费即可:
注:当手动管理消费分区时,即使GroupID是一样的,Kafka的组协调器都将不再起作用。 如果消费者失败,也将不再自动进行分区重新分配。
1 | String topic = "test"; |
原理及应用
工作流程
生产者:
- 从ZooKeeper获取对应分区leader的位置;(从”/brokers/topics/主题名/partitions/分区名/state”节点找)
- 发送消息给leader,leader写入本地log中;
- 其他follower拉取日志,写入本地log,并向leader发送ACK;
- leader接收到ISR中所有的ACK后,向生产者返回ACK;
消费者:
消息队列一般有两种消费模式,推模式和拉模式。
- 推模式:是由消息队列记录信息的消费状态,向消费者推送消息。(RabbitMQ)
- 拉模式:消息者自己记录消费状态,每个消费者互相独立地顺序拉取每个分区的消息。 消费者也可以按照任意的顺序消费消息。比如,消费者可以重置到旧的偏移量,重新处理之前已经消费过的消息;或者直接跳到最近的位置,从当前的时刻开始消费。(Kafka)
- 消费者从ZK获取要消费的分区对应的leader位置,以及offset;
- 消费者向leader请求拉取数据,leader从日志文件中读取数据并返回给消费者;
- 消费者向ZK提交offset;
存储形式
- 一个topic由多个分区组成
- 一个分区(paritition)由多个段(segmnet)组成
- 一个segment由多个文件组成(log,index,timeindex等)
kafka的数据存储位置在config/server.properties下的log.dirs参数指定,这些log
文件夹以 “主题名-分区ID” 命名,其中的文件作用如下:
| 文件名 | 说明 |
|---|---|
| 00000000000000000000.index | 索引文件,根据offset查找数据就是通过该索引文件来操作的 |
| 00000000000000000000.log | 日志数据文件 |
| 00000000000000000000.timeindex | 时间索引 |
| leader-epoch-checkpoint | 持久化每个partition leader对应的LEO (log end offset、日志文件中下一条待写入消息的offset) |
每个日志文件的文件名为起始偏移量,因为每个分区的起始偏移量是0,所以,分区的日志文件都以0000000000000000000.log开始;当该文件达到指定大小时,就会再新建一个log文件
查找: 根据offset找到存储数据的segment段,再进入segment读取消息(每个会维护对应的范围内存,方便进行二分查找)。
删除: 消息会定期清理,一次删除一个segment段;可以配置哪些文件可以删除。
幂等性
幂等性指的是:执行多次操作与执行一次操作的影响是一样的。
如果Kafka不具备幂等性的,就有可能会在partition中保存多条一模一样的消息。 为了实现生产者的幂等性,Kafka引入了 Producer ID(PID)和 Sequence Number的概念。
1 | props.put("enable.idempotence",true); |
- PID:每个Producer在初始化时,都会分配一个唯一的PID,这个PID对用户来说,是透明的。
- Sequence Number:针对每个生产者(对应PID)发送到指定主题分区的消息都对应一个从0开始递增的Sequence Number。
这样,每一条消息都能对应一个生产者发出的那条消息,收到重复pid和Sequence Number的消息就无需保存。
事务
Kafka事务指的是生产者生产消息以及消费者提交offset的操作可以在一个原子操作中,要么都成功,要么都失败。尤其是在生产者、消费者并存时,事务的保障尤其重要。(consumer-transform-producer模式)
在提供的API里,Producer接口中定义了以下5个事务相关方法:
- initTransactions(初始化事务):要使用Kafka事务,必须先进行初始化操作
- beginTransaction(开始事务):启动一个Kafka事务
- sendOffsetsToTransaction(提交偏移量):批量地将分区对应的offset发送到事务中,方便后续一块提交
- commitTransaction(提交事务):提交事务
- abortTransaction(放弃事务):取消事务
开启事务:(使用事务,就不要使用异步发送)
生产者
1
2// 开启事务必须要配置事务的ID
props.put("transactional.id", "dwd_user");消费者
1
2
3
4// 配置事务的隔离级别
props.put("isolation.level","read_committed");
// 关闭自动提交,一会我们需要手动来提交offset,通过事务来维护offset
props.setProperty("enable.auto.commit", "false");生产者
- 初始化事务
- 开启事务
- 需要使用producer来将消费者的offset提交到事务中
- 提交事务
- 如果出现异常回滚事务
1 | public class TransactionProgram { |
分区
生产者写入分区策略:
生产者写入消息到 topic,Kafka将依据不同的策略将数据分配到不同的分区中
轮询分区策略
- 默认的策略,也是使用最多的策略,可以最大限度保证所有消息平均分配到一个分区;
- 如果在生产消息时,key为null,则使用轮询算法均衡地分配分区;
随机分区策略(早期策略,也是为了均衡分配分区,现在基本不用)
按key分区分配策略
- 可能会出现数据倾斜问题;
- 可以做到局部有序存储,而轮询和随机策略会使生产到kafka的数据是乱序的;
自定义分区策略
实现步骤:
创建自定义分区器
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19public class KeyWithRandomPartitioner implements Partitioner {
private Random r;
public void configure(Map<String, ?> configs) {
r = new Random();
}
public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {
// cluster.partitionCountForTopic 表示获取指定topic的分区数量
return r.nextInt(1000) % cluster.partitionCountForTopic(topic);
}
public void close() {
}
}在生产者配置中配置
1
2
3
4props.put(
ProducerConfig.PARTITIONER_CLASS_CONFIG,
KeyWithRandomPartitioner.class.getName()
);
消费者组的Rebalance:
Kafka中的Rebalance称之为再均衡,是Kafka确保Consumer grou如何再分配所订阅topic的每个分区的机制。
Rebalance触发的时机有:
- 消费者组中consumer的个数发生变化。例如:有新的consumer加入到消费者组,或者是某个consumer停止了。
- 订阅的topic个数发生变化, 假设当前的消费者组订阅了三个主题,但有一个主题突然被删除了,此时也需要发生再均衡。
- 订阅的topic分区数发生变化。
缺陷:Rebalance过程中,所有参与的消费者都将停止工作,直到Rebalance完成。
消费者分区分配策略:
Range范围分配策略
默认策略,每个消费者消费的分区数量是均衡的。如topic有8个分区,有3个消费者订阅,则这3个消费者分别分配3,3,2个分区
RoundRobin轮询策略
将消费组内所有消费者以及消费者所订阅的所有topic的partition按照字典序排序(对topic和分区的hashcode进行排序),然后通过轮询方式逐个将分区以此分配给每个消费者。
Stricky粘性分配策略
作用:分区分配尽可能均匀; 在发生rebalance的时候,分区的分配尽可能与上一次分配保持相同(平时效果和RoundRobin轮询策略一样)
副本
kafka的一个tipic的一个分区,可以有多个副本,包括一个leader副本和多个follower副本,副本各自存放在不同的broker中。
- 只有leader副本对外提供服务,接收读写请求; follower副本只从leader异步拉取信息。(如果follower也提供服务,就需要解决同步问题,即一段时间内的数据不一致问题,为此会降低性能,没必要)
- 如果leader出现故障,其他follower会被重新选举为leader
kafka的副本统称为 AR(Assigned Replicas),其中可分为:
- ISR(In-sync Replicas):与leader一定时间内同步过的副本的集合,包括leader副本;
- OSR(Outof-sync Replicas):超过一定时间没有与leader同步的副本的集合,包括新加入的副本;
这个时间参数是replica.lag.time.max.ms,默认是10秒。 还有min.insync.replicas参数规定了最小的ISR数,默认是1(也就是只有leader,实际生产应该调高)。
在使用中跟副本关系最大的,是acks机制,acks决定了生产者如何在性能与数据可靠之间做取舍。配置acks的代码如下:
1 | Properties props = new Properties(); |
acks这个配置可以指定三个值,分别是0,1和-1。我们分别来说三者代表什么:
- acks为0:这意味着producer发送数据后,不会等待broker确认,直接发送下一条数据,性能最快
- acks为1:为1意味着producer发送数据后,需要等待leader副本确认接收后,才会发送下一条数据,性能中等
- acks为-1或all:这个代表的是all,意味着发送的消息写入所有的ISR集合中的副本(注意不是全部副本)后,才会发送下一条数据,性能最慢,但可靠性最强
顺序消费
1个Topic只对应一个 Partition。
(推荐)发送消息的时候指定 key/Partition。
Kafka 中发送 1 条消息的时候,可以指定 topic, partition, key,data(数据) 4 个参数。如果你发送消息的时候指定了 Partition 的话,所有消息都会被发送到指定的 Partition。并且,同一个 key 的消息可以保证只发送到同一个 partition,所以我们可以采用表/对象的 id 来作为 key 。
消息不丢失
broker数据不丢失:
生产者通过分区的leader写入数据后,所有在ISR中follower都会从leader中复制数据,这样,可以确保即使leader崩溃了,其他的follower的数据仍然是可用的。
生产者数据不丢失:
生产者可以通过ACK机制来确保数据已经成功写入。(使用回调函数查看消息是否发送成功)
消费者数据不丢失:
消费者消费数据的时候,只要每个消费者记录好offset值即可,就能保证数据不丢失。
消息不重复消费
kafka 出现消息重复消费的原因:
- 服务端侧已经消费的数据没有成功提交 offset(根本原因)。
- Kafka 侧 由于服务端处理业务时间长或者网络链接等等原因让 Kafka 认为服务假死,触发了分区 rebalance。
解决方案:
消费消息服务做幂等校验,比如 Redis 的 set、MySQL 的主键等天然的幂等功能。这种方法最有效。
将
enable.auto.commit参数设置为 false,即关闭自动提交,开发者在代码中手动提交 offset。那么这里会有个问题:什么时候提交 offset 合适?
- 处理完消息再提交:依旧有消息重复消费的风险,和自动提交一样
- 拉取到消息即提交:会有消息丢失的风险。允许消息延时的场景,一般会采用这种方式。然后,通过定时任务在业务不繁忙(比如凌晨)的时候做数据兜底。
数据积压
虽然Kafka消费者消费数据的速度是非常快的,但如果由于处理Kafka消息时,有一些外部IO、或者是产生网络拥堵,就会造成Kafka中的数据积压(或称为数据堆积)。
Kafka数据清理的操作可以再broker或topic配置:
| 配置项 | 配置值 | 说明 |
|---|---|---|
| log.cleaner.enable | true(默认) | 开启自动清理日志功能 |
| log.cleanup.policy | delete(默认) | 删除日志 |
| log.cleanup.policy | compaction | 压缩日志 |
| log.cleanup.policy | delete,compact | 同时支持删除、压缩 |
删除日志: 以segment为单位进行定期清理。
Kafka日志管理器中会有一个专门的日志删除任务来定期检测和删除不符合保留条件的日志分段文件,这个周期可以通过broker端参数log.retention.check.interval.ms来配置,默认值为300,000,即5分钟。当前日志分段的保留策略有3种:
- 基于时间的保留策略:大于指定留存时间的日志会被删除;
- 基于日志大小的保留策略:日志中超过指定大小的部分会被删除;
- 基于日志起始偏移量的保留策略:segment的起始偏移量小于指定值的会被删除;
压缩日志: 将相同的key对应的数据只保留一个版本。(在压缩后,offset不再连续,并生成新的segment文件)
搜索技术-TODO
ElasticSearch
DevOps
DevOps(Development和Operations的组合词)是一组过程、方法与系统的统称,用于促进开发(应用程序/软件工程)和 运维(QA)部门之间的沟通、协作与整合。
它重视“软件开发人员(Dev)”和“IT运维技术人员(Ops)”之间沟通合作。透过自动化“软件交付”和“架构变更”的流程,来更加地快捷、频繁和可靠地进行 构建、测试、软件发布。
CI/CD 是近年来企业有效实施DevOps的具体方案。CI/CD 包含了一个 CI 和两个 CD:
- CI全称 Continuous Integration,表示持续集成。
- 持续集成倡导团队成员需要频繁的集成他们的工作,将开发分支合并到主分支,每次集成都通过自动化构建(包括编译、构建、自动化测试)来验证,从而尽快地发现集成中的错误,让产品可以快速迭代,同时还能保持高质量。
- CD包含 Continuous Delivery和 Continuous Deployment,分别是持续交付和持续部署。
- 持续交付将集成后的代码部署到类生产环境(预发布),除了交付到类生产环境之外,还会执行一些集成测试、API测试。持续交付强调的是“交付”,交付给测试、产品验收,不管怎么更新,软件是随时随地可以交付的。
- 在持续交付的基础上由开发人员或运维人员自助式的定期向生产环境部署稳定的构建版本,持续部署的目标是代码在任何时刻都是可部署的,并可自动进入到生产环境。
三者具有前后依赖关系。
- CI全称 Continuous Integration,表示持续集成。
Docker
现代软件开发的一大目的就是隔离,应用程序在运行时相互独立互不干扰。主要的隔离方案有 虚拟机技术 和 容器技术:
虚拟机技术就是将应用程序部署在不同的虚拟机中从而实现隔离。
容器技术是 只隔离应用程序的运行时环境但容器之间可以共享同一个操作系统,这里的运行时环境指的是程序运行依赖的各种库以及配置。
容器更加的轻量级且占用的资源更少,与操作系统动辄几G的内存占用相比,容器技术只需数M空间,因此我们可以在同样规格的硬件上大量部署容器,这是虚拟机所不能比拟的,而且不同于操作系统数分钟的启动时间容器几乎瞬时启动,容器技术为打包服务栈提供了一种更加高效的方式
Docker是一个用Go语言实现的开源项目,可以让我们方便的创建和使用容器,docker将程序以及程序所有的依赖都打包到docker container,这样你的程序可以在任何环境都会有一致的表现。(屏蔽环境差异,快速部署)
Docker中的镜像和容器:
镜像(Image):Docker将应用程序及其所需的依赖、函数库、环境、配置等文件打包在一起,称为镜像。
容器(Container):镜像中的应用程序运行后形成的进程就是容器,只是Docker会给容器进程做隔离,对外不可见。
架构——Docker是一个CS架构的程序,由两部分组成:
服务端(server):Docker守护进程,负责处理Docker指令,管理镜像、容器等
客户端(client):通过命令或RestAPI向Docker服务端发送指令。可以在本地或远程向服务端发送指令。
数据卷: 是一个虚拟目录,指向宿主机文件系统中的某个目录。一旦完成数据卷挂载,对容器的一切操作都会作用在数据卷对应的宿主机目录了。—— 用于数据与容器的分离解耦,修改数据不用再进到docker内了。
如:创建一个数据卷html, 这样操作宿主机的/var/lib/docker/volumes/html目录,就等于操作容器内的/usr/share/nginx/html目录了
操纵命令
开启docker: systemctl start docker
镜像操作:
拉取镜像 —— docker pull 镜像名称:版本号
查看拉取到的镜像 —— docker images
保存镜像 —— docker save -o 要存放的文件名称 镜像名称
1
docker save -o nginx.tar nginx:latest
加载镜像 —— docker load -i 保存了镜像的文件名称
删除本地镜像 —— docker rmi 镜像名:版本号
容器操作:
创建并运行容器 —— docker run
1
docker run --name 容器名 -p 80:80 -d nginx:latest
查看运行中容器 —— docker ps
- -a 查看所有已创建的容器
暂停容器 —— docker pause 容器名
被暂停的容器恢复运行 —— docker unpause 容器名
停止容器 —— docker stop 容器名
启动容器 —— docker start 容器名
重启容器 —— docker restart 容器名
容器自启动 —— 使用run启动容器时加上–restart=always,或者使用update: docker update –restart=always 容器名称; restart=no则是取消自启
查看容器的启动命令:docker ps -a –no-trunc | grep 容器名
查看容器详细信息
删除容器 —— docker rm 容器名
进入容器执行容器的命令: docker exec -it 容器名 bash
- -i 指容器的标准输入始终打开,-t 分配一个终端
- bash是shell类型(bash是linux的默认类型),还可以用其他的,如sh,zsh
数据卷操作:
创建数据卷: docker volume create xxx
查看所有数据卷: docker volume ls
查看某个数据卷的详细信息:docker volume inspect xxx
删除指定数据卷:docker volume rm xxx
删除所有未使用的数据卷:docker volume prune
挂载数据卷:
可以在创建容器时,通过 -v 参数来挂载一个数据卷到某容器内目录: -v volume名称:容器内目录; -v 宿主机文件目录:容器内文件目录
1
2
3
4
5docker run \
--name mn \
-v html:/root/html \
-p 8080:80
nginx \
例子:给nginx挂载数据卷,nginx的html目录在/usr/share/nginx/html,要求将该目录挂载到html这个数据卷上,方便操作。
创建容器并挂载数据卷到容器内的HTML目录
1
docker run --name mn -v html:/usr/share/nginx/html -p 80:80 -d nginx
进入html数据卷所在位置,并修改HTML内容
1
2
3
4
5
6# 查看html数据卷的位置
docker volume inspect html
# 进入该目录
cd /var/lib/docker/volumes/html/_data
# 修改文件
vi index.html
docker-compose
Docker Compose可以基于Compose文件快速的部署分布式应用,而无需手动一个个创建和运行容器。
Compose文件: 通过指令定义集群中的每个容器如何运行。格式如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14version: "3.8"
services:
mysql:
image: mysql:5.7.25
environment:
MYSQL_ROOT_PASSWORD: 123
volumes:
- "/tmp/mysql/data:/var/lib/mysql"
- "/tmp/mysql/conf/hmy.cnf:/etc/mysql/conf.d/hmy.cnf"
web:
build: .
ports:
- "8090:8090"上面的Compose文件就描述一个项目,其中包含两个容器:
- mysql:一个基于
mysql:5.7.25镜像构建的容器,并且挂载了两个目录 - web:一个基于
docker build临时构建的镜像容器,映射端口时8090
- mysql:一个基于
部署微服务集群:
编写docker-compose文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24version: "3.2"
services:
nacos:
image: nacos/nacos-server
environment:
MODE: standalone
ports:
- "8848:8848"
mysql:
image: mysql:5.7.25
environment:
MYSQL_ROOT_PASSWORD: 123
volumes:
- "$PWD/mysql/data:/var/lib/mysql"
- "$PWD/mysql/conf:/etc/mysql/conf.d/"
userservice:
build: ./user-service
orderservice:
build: ./order-service
gateway:
build: ./gateway
ports:
- "10010:10010"可以看到,其中包含5个service服务:
nacos:作为注册中心和配置中心image: nacos/nacos-server: 基于nacos/nacos-server镜像构建environment:环境变量MODE: standalone:单点模式启动
ports:端口映射,这里暴露了8848端口
mysql:数据库image: mysql:5.7.25:镜像版本是mysql:5.7.25environment:环境变量MYSQL_ROOT_PASSWORD: 123:设置数据库root账户的密码为123
volumes:数据卷挂载,这里挂载了mysql的data、conf目录,其中有我提前准备好的数据
userservice、orderservice、gateway:都是基于Dockerfile临时构建的
修改自己的cloud-demo项目,将数据库、nacos地址都命名为docker-compose中的服务名
使用maven打包工具,将项目中的每个微服务都打包为app.jar
将打包好的app.jar拷贝到cloud-demo中的每一个对应的子目录中
将cloud-demo上传至虚拟机,利用 docker-compose up -d 来部署
手动部署项目
在父工程聚合各模块
1
2
3
4<modules>
<module>../xxxx</module>
<module>../xxx</module>
</modules>配置打包插件:在需要打可执行包的工程中配置spring-boot-maven-plugin插件否则报 “jar中没有主清单属性” 。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18<build>
<finalName>${project.artifactId}-${project.version}</finalName>
<plugins>
<plugin>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-maven-plugin</artifactId>
<version>${spring-boot.version}</version>
<executions>
<execution>
<goals>
<goal>repackage</goal>
</goals>
</execution>
</executions>
</plugin>
</plugins>
</build>配置了springboot打包插件即可在maven窗口显示打包选项:
- build-info:生成项目的构建信息文件 build-info.properties
- repackage:这个是默认 goal,在 mvn package 执行之后,这个命令再次打包生成可执行的 jar,同时将 mvn package 生成的 jar 重命名为 *.origin
- run:这个可以用来运行 Spring Boot 应用
- start:这个在 mvn integration-test 阶段,进行 Spring Boot 应用生命周期的管理
- stop:这个在 mvn integration-test 阶段,进行 Spring Boot 应用生命周期的管理
在父工程的启动配置中,设置指令 clean install -DskipTests -f pom.xml,以对所有工程进行打包。
打包完成可在本地通过java -jar 运行jar包观察是否可以正常运行。例如:进入对应服务的target目录,cmd运行:java -Dfile.encoding=utf-8 -jar xxx-0.0.1-SNAPSHOT.jar
将打成的jar包拷贝到Linux,生成镜像,并创建docker容器。
编写Dockerfile文件:
1
2
3
4
5
6
7FROM java:8u20
MAINTAINER docker_maven docker_maven@email.com
WORKDIR /ROOT
ADD xxx-0.0.1-SNAPSHOT.jar xxx.jar
CMD ["java", "-version"]
ENTRYPOINT ["java", "-Dfile.encoding=utf-8","-jar", "xuecheng-plus-checkcode.jar"]
EXPOSE 63075进入到jar包目录下,创建镜像:
1
docker build -t checkcode:1.0 .
创建并运行容器即可
1
docker run --name xuecheng-plus-checkcode -p 63075:63075 -idt checkcode:1.0
自动部署项目
示例:使用 jenkins 实现CI/CD流程
- 在pom.xml添加docker-maven-plugin插件实现将springboot工程创建镜像
1 | <dependency> |
在pom.xml的build部分添加plugins:
1 | <build> |
将代码使用Git托管
在jenkins创建任务,从Git拉取代码。
- 配置git仓库地址和密码
拉取代码后进行自动构建:测试、打包、部署。
首先将代码打成镜像包上传到docker私服。
自动创建容器、启动容器。
当有代码push到git实现自动构建。