RPC框架
RPC
简介
Remote Procedure Call, 远程过程调用
作用: 当调用的方法在其他服务器上时,就需要网络编程才能传递方法调用所需的参数,且方法调用的结果也要网络编程来接收。 所以,RPC就是用来方便的调用远程计算机上某个服务的方法, 像调用本地方法一样简单。
原理:
- 客户端(服务消费端):调用远程方法的一端;
- 客户端Stub(桩) :把调用的方法的信息和参数等传递给服务端。
- 网络传输: 实现方法如基本的Socket,封装优秀的Netty。
- 服务端Stub:根据传递过来的信息调用本地的方法, 得到结果后进行封装并发送至消费方。
- 服务提供端:执行请求的方法。
一般的,RPC框架不仅有服务发现的功能,还有负债均衡、容错等功能。简单的结构如下:
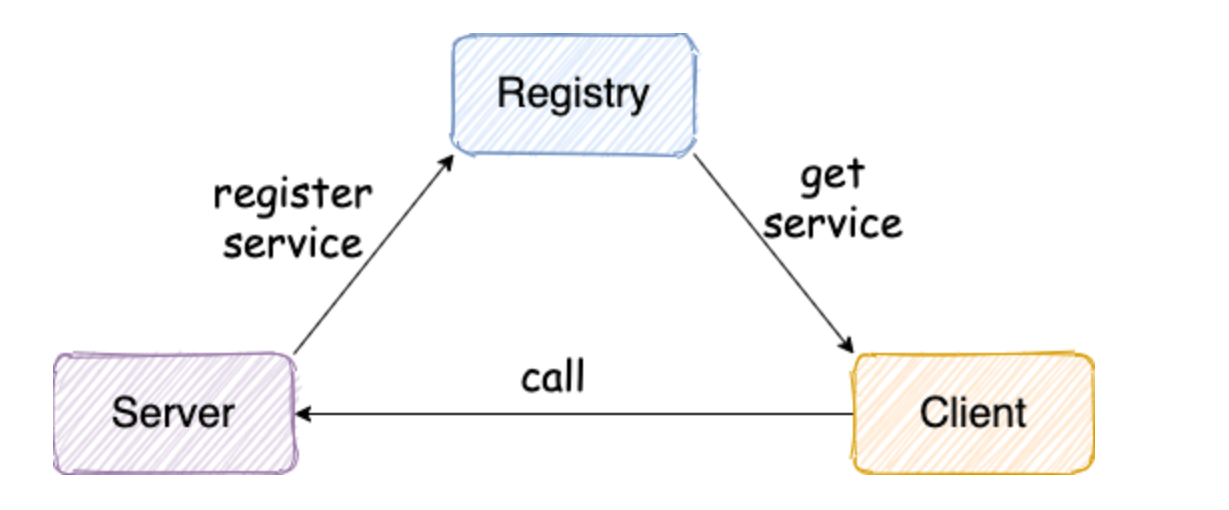
- 服务提供端Server向注册中心 注册服务;
- 服务消费端Client通过注册中心拿到相关信息,然后通过网络请求服务提供端Server;
完整的RPC框架结构:
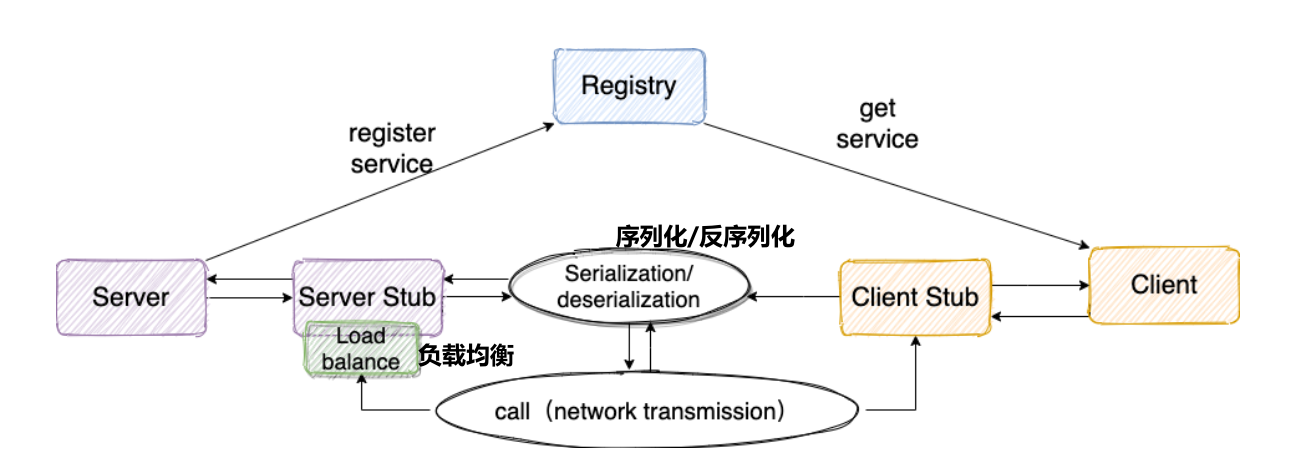
调用关系:
- 服务提供者在启动时,向注册中心注册自己提供的服务。
- 服务消费者在启动时,向注册中心订阅自己所需的服务。
- 注册中心返回服务提供者的地址列表给消费者,如果发生变更,注册中心将基于长连接推送变更数据给消费者。
- 服务消费者,从地址列表中基于负载均衡算法选一台提供者进行调用,如果失败则另选一台。
- (监控中心:服务消费者和提供者,在内存中累积调用次数和调用时间,定时非分钟发送一次统计数据到监控中心。)
实现所需
- 注册中心 —— 注册中心负责服务地址的注册与查找,相当于目录服务。
- 网络传输 —— 要调用远程方法,就需要发送网络请求来传递目标类和方法的信息及相关参数到服务提供端。
- 序列化/反序列化 —— 在网络传输数据、存储文件都要序列化。
- 动态代理 —— 屏蔽远程方法调用的细节。
- 负债均衡 —— 避免单个服务器压力过大。
- 传输协议 —— 协议是双方交流的基础。协议定义了需要输出哪些类型的数据,每种类型数据占的字节数。 RPC协议一般包含:魔数、序列化器编号、消息体长度…
更完善的还有监控模块(如Dubbo的监控模块)
实现细节
。。。
实现过程
。。。
Zookeeper
概述
Zoookeeper为分布式框架提供协调服务。从设计模式来看,Zk是基于观察者模式设计的框架,提供注册中心的功能: 服务注册,推送服务,服务下线通知等。 Zk相当于是 文件系统 + 通知机制。
分布式: 强调拆分多个子服务,其次才是多服务器
集群: 服务相同,就是多服务器。
特点:
- 组成: 一个领导者 Leader, 多个跟随者 Follower 组成的集群。
- 存活:集群只要有半数以上节点存活,Zk集群就能正常服务,所以Zk适合安装奇数台服务器。
- 全局数据一致:每个Server都保存一份相同的数据副本,Client不论连接到哪个Server,数据都一致。
- 更新请求顺序执行:来自同一个Client的更新请求按发送顺序依次执行。
- 数据更新原子性:一次数据更新要么成功,要么失败。
- 实时性:在一定时间范围内,Client能读到最新数据。(Zk因为只配置信息,数据量很小,所以同步速度非常快)
数据结构:
整体可以看作一棵树,每个节点称作Znode,能存储1MB数据,每个节点都能通过路径唯一标识,如:/ZNode1/ZNode2
因为zk主要用来协调服务,节点只存放服务信息等少量数据,不存放业务数据。
存储:
- 主要存储在内存中,有持久化机制,防止丢失数据。 更新数据时,会先写入硬盘中的编辑日志,等适当时候再同步数据到硬盘中。
节点类型:
- 持久节点:客户端与服务器断开连接后,创建的节点不删除。
- 短暂节点:断开连接后,创建的节点自动删除。
- 带顺序编号的节点: 创建的节点可以选择带或不带一个单调递增的顺序标识,该标识由父节点维护。 在分布式系统中,顺序标识可用于为所有同名节点进行全局排序。 如:创建带标识的节点,两个输入名是/nodeA,一个是/nodeB,实际名为 /nodeA0000000,/nodeA0000001,/nodeB0000002。
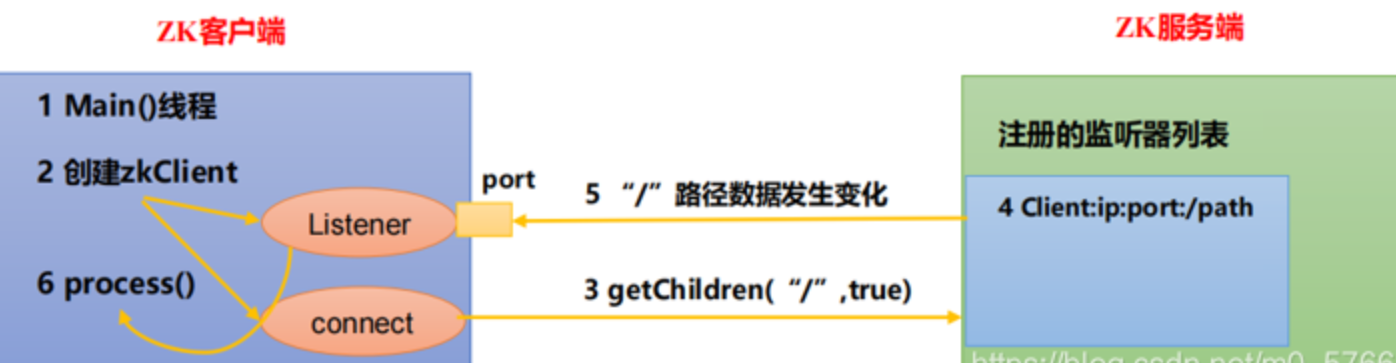
监听器原理:
- 在main线程中创建Zookeeper客户端,也就创建了两个线程:connect线程(网络连接通信),listener线程(负责监听)。
- 先通过connect线程将注册的监听事件发送给Zookeeper。
- 在Zookeepeer的 注册监听器列表 中将注册的监听事件加入其中。
- Zookeeper监听到变化时,就会将这个消息发给listener线程。
- listener线程内部会调用process()方法进行具体的处理。
应用场景:
- 统一命名服务: 一般一个服务会对应多个ip,这些ip地址会有一个统一的服务名。
- 数据发布/订阅: 通过 Watcher 机制 可以很方便地实现数据发布/订阅。把数据发布到 ZooKeeper 被监听的节点上,其他机器可通过监听 ZooKeeper 上节点的变化来实现配置的动态更新。
- 服务器节点动态上下线:
- 服务端启动时注册信息(创建临时节点);
- 客户端获取在线服务器列表,并注册监听;
- 某个服务器节点下线;
- 通知客户端有关服务器节点上下线事件。
- 软负载均衡
- 分布式锁:通过创建唯一节点来获取分布式锁,当获得锁的一方执行完相关代码或者是挂掉之后就释放锁。
ACL:AccessControlList,是一种权限控制策略。
- 对于znode操作的权限,有5种:
- CREATE:能创建子节点
- READ:能获取节点和子节点的数据
- WRITE:能设置/更新节点数据
- DELETE:能删除子节点
- ADMIN:能设置节点ACL权限
- 对于身份认证,有4种:
- world:默认,所有用户可无条件访问数据。
- auth: 允许已添加的用户访问。
- digest:用户名+密码认证
- ip白名单:只允许已配置/认证的ip进行访问。
集群配置
zoo.cfg配置参数
- tickTime=2000: 通信心跳时间间隔,单位毫秒;
- initLimit=10:LF初始通信时限,即Leader和Follower初始化连接时能容忍的最大心跳次数。
- syncLimit=5:LF同步通信时限,即Leader和Follower之间的通信时间超过 syncLimit * tickTime,就认为Follower已死,从服务器里列表中删除Follower。
- dataDir: 保存Zookeeper中的数据。
- clientPort=2181:客户端连接端口,一般不修改。
集群配置:
在各服务器上都安装zookeeper后,并修改zoo.cfg的dataDir路径,然后要在这个data目录下创建myid文件,里面写入server对应的编号。
myid文件,只写一个编号就行:
1
2
zoo.cfg添加配置信息: server.A=B:C:D
其中,A是myid文件中的编号,标识几号服务器;B是服务器地址;C是Follower与Leader交换信息的端口; D是重新选举Leader时用的端口。
1
2
3
server.2=hadoop102:2888:3888
server.3=hadoop102:2888:3888
server.4=hadoop102:2888:3888
选举机制
第一次启动时:
- 服务器启动时总是先投给自己一票,如果有其他服务器的话,再将票投给myid较大的服务器,如果当前的票数没超过服务器数量的一半的话,已启动的服务器进入LOOKING状态(观望状态)。
- 后续服务器启动,也是将票集中到myid大的服务器上,当票超过半数,票多的服务器当选为Leader,状态为LEADING,其他服务器状态为FOLLOWING。
- 剩下的服务器启动,当发现已启动服务器已选出leader,则将票投给leader,并更改状态为FOLLOWING。
非第一次启动,有服务器发起选举,有两种情况:
集群存在Leader: 只需与Leader简历连接,并同步状态。
集群中不存在Leader,即Leader挂掉,
(选举阶段)需要关注三个值: Epoch,ZXID,SID。
- Epoch最大的当选Leader;
- EPOCH一样,ZXID大的当选Leader;
- ZXID也一样,SID大的当选Leader。
(发现阶段)followers跟准leader通信,同步followers最近接收的事务提议。
(同步阶段)leader收集发现阶段的最新提议,同步集群中所有副本。同步之后才能称为真正的leader。
(广播阶段)zk正式对外提供服务。
Epoch: 经历过的选举次数,没有Leader时每投一次票这个数据+1。
ZXID:事务ID,用于标识服务器状态的总变更次序。 某一时刻,集群中的各服务器的ZXID值不一定一致。(高32位是Leader的Epoch值,低32位是单调递增的计数器,所以新Leader的ZXID比旧Leader时的ZXID要大,以区分新旧事务)
SID:服务器ID,和myid一致。
启停脚本:
由于多台服务器的启动和停止都要分别输入命令,比较麻烦,所以可以写一个脚本:
(在hadoop-mster的/root/script/下的zk.sh)
1 | !/bin/bash |
如果从机出现错误 Error: JAVA_HOME is not set and java could not be found in PATH. —— 解决: 在/root/.bashrc中加入java环境变量
2
3
4
export PATH=$JAVA_HOME/bin:$PATH
export PATH=$PATH:$JAVA_HOME/bin:$JRE_HOME/bin
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
客户端命令
help: 显示所有操作命令
ls 路径:使用 ls 查看当前ZNode的子节点(可监听)
-w :监听子节点变化(只监听一次变化)
-s :附加次级信息
次级信息有:
- cZxid:创建节点的事务zxid。(c是create)
- ctime:ZNode被创建的毫秒数,从1970年开始。
- mZxid:ZNode最后更新的事务id。(m是modified)
- mtime:ZNode最后修改的毫秒数,从1970年开始。
- pZxid:ZNode最后更新的子节点zxid。
- cversion:ZNode子节点变化号,即修改次数。
- dataversion:当前ZNode数据变化号。
- aclVersion:当前ZNode的ACL控制列表的变化号。
- ephemeralOwner:如果时临时节点,这个是该节点拥有者的session id;如果不是临时节点,则为0。
- dataLength:ZNode的数据长度。
- numChildren:ZNode的子节点数量。
create: 普通创建
-s :带顺序序列
-e :临时节点(重启或超时就消失)
1
create -s /zzcnode/aa "zzc zzc"
get 路径: 获得节点的值(可监听)
-w :监听节点内容变化(只监听一次变化)
-s :附加次级信息
1
get -s /zzcnode/aa
set: 设置节点的具体值
stat:查看节点状态
delete:删除节点
deleteall:递归删除节点
客户端API
在pom.xml中导入:
1 | <dependency> |
日志文件: 在resources目录下新建log4j.properties文件:
2
3
4
5
6
7
8
Log4j.appender.stdout=org.apache.Log4j.ConsoleAppender
Log4j.appender.stdout.Layout=org.apache.Log4j.PatternLayout
Log4j.appender.stdout.Layout.ConversionPattern=%d %p [%c]-%m%n
Log4j.appender.Logfile=org.apache.Log4j.FileAppender
Log4j.appender.Logfile.File=target/spring.Log
Log4j.appender.Logfile.Layout=org.apache.Log4j.PatternLayout
Log4j.appender.Logfile.Layout.ConversionPattern=%d %p [%c]-%m%n
建立客户端连接:
1 | private String connectString = "master:2181,slave1:2181,slave2:2181"; |
创建节点:
1 |
|
监控子节点:
1 |
|
判断节点是否存在:
1 |
|
使用案例
服务监听,动态上下线
要求: 服务器注册服务到节点/servers,客户端监听节点/servers,获取服务信息。
服务器端:
1 | public class distributeServer { |
客户端:
1 | public class distributeClient { |
分布式锁
要求:各客户端在 节点/locks下创建一个临时顺序节点,判断自己是不是当前节点下最小的节点,是,则获取到锁, 不是,则对前一个节点进行监听。(临时节点删除,相当于释放锁。 而监听前一个节点是为了防止惊群效应)
使用原生API
以下代码可能问题: 在获取前一个节点信息后,在启用监听前,这个中间时刻,前一个节点删除了,就会出现监听路径错误。
1 | public class distributeLocks { |
1 | public class LocksTest { |
使用Curator
原生的Java API开发存在的问题:
- 会话连接是异步的,需要自己去处理。比如使用CountDownLatch
- Watch需要重复注册,不然就不能生效
- 开发的复杂性比较高
- 不支持多节点删除和创建。需要自己去递归
Curator是一个专门解决分布式锁的框架,解决了原生Java API开发分布式遇到的问题。
一致性协议
CAP定理:
- consistency 数据一致性: 从不同服务器读到的数据是一致的。
- availability 系统可用性: 系统应该一致处于可用状态
- partition tolerance 分区容忍性: 在分区故障时继续运行。
一般CAP是不能同时满足的,而P是必要的,只能从A和C中选一个满足,Zookeeper实现的是CP, 因为选举leader和同步时系统不能对外提供服务,不满足A。
二阶段提交——2PC(phase commit)
- 协调者: 发送prepare请求。
- 参与者:YES/NO(先执行事务,暂不提交)
- 协调者:发送commit请求。
- 参与者:YES/NO(提交事务)
缺点:
- 单点故障:如果协调者挂了,系统就不可用了。
- 阻塞:参与者执行了事务,但暂不提交,会一直占着资源不放;一旦协调者此时挂了,这些资源就无法释放。
- 数据不一致:协调者只发了部分commit就挂了,这样参与者之间的数据就不一致了。
三阶段提交——3PC
CanCommit阶段:
- 协调者:发送CanCommit请求。
- 参与者:确认是否能执行,发送YES/NO。
PreCommit阶段:
- 协调者:收到全部的YES,则可以发送PreCommit预提交请求。
- 参与者:执行事务,并写Undo和Redo日志,事务执行完发送YES。
如果协调者在此过程收到任意一个NO,或在一定时间内没有收到全部的响应,则向所有参与者发送中断请求(abort)。
DoCommit阶段:
- 协调者:发送DoCommit请求。
- 参与者:提交事务,返回YES。
如果协调者在此过程收到任意一个NO,或在一定时间内没有收到全部的响应,则向所有参与者发送中断请求,参与者通过Undo回滚。
3PC加入了很多超时中断的处理,可以缓解阻塞问题。但一致性问题仍没解决。—— 解决:Paxos算法
Paxos算法
是一种基于消息传递且具有高度容错特性的一致性算法。 解决的问题是在分布式系统中如何就某个值达成一致。
Paxos中有三个角色:
- Proposer提案者:每个提案者在提出提案时都会首先获取到一个具有全局唯一性的、递增的提案编号N。
- Acceptor表决者:仅会接收编号大于本地保存的最大编号的提案,并保存该提案编号N,反馈之前的最大编号给提案者。
- Learner学习者。
过程:
- prepare阶段:
- Porposer提案者: 将编号N赋予提案,向所有 表决者 发出提案。
- Acceptor表决者:仅会接收编号大于本地保存的最大编号的提案,并保存该提案编号N,反馈之前的最大编号给提案者。
- accept阶段:
- Porposer提案者: 收到超过半数 表决者 同意后,提案者会给所有 表决者 发送真正的提案(内容和提案编号)。
- Acceptor表决者: 比对编号是否大于本地最大编号,是的话就接收该提案,执行,但不提交,反馈给提案者accept。如果不接受提案或事务出错,则返回NO。
- Porposer提案者:收到超过半数的accept,就向所有表决则发送提案的提交请求。(也让有些未批准提案内容的表决者无条件执行并提交)。 如果没有收到超过半数的accept,就会递增提案的编号,重新进入prepare阶段。
注意:
- paxos算法在一段时间内,只能允许一个提交提交,否则会出现死循环。
ZAB协议
ZAB,ZooKeeper Atomic Broadcast,原子广播。 ZAB协议是根据paxos算法定制的使用zookpeeer的算法。主要支持崩溃恢复 和 消息广播。
有三种角色:
- Leader: 集群中 唯一的写请求处理者,能发起投票。
- Follower:能够接收客户端的请求,如果是读请求则可以自己处理,如果是写请求则要转发给 Leader 。在选举过程中会参与投票,有选举权和被选举权 。
- Observer:是没有选举权和被选举权的Follower,不参与集群半数存活和半数答复的判断。
功能/模式:
崩溃恢复:
当整个服务框架在启动过程中,或是当 Leader 挂掉时,ZAB 协议就会进入恢复模式并选举产生新的 Leader 服务器。
当选举产生了新的 Leader 服务器,同时集群中已经有过半的机器与该 Leader 服务器完成了状态同步之后,ZAB 协议就会退出恢复模式。
关于新Leader当选后,没完成的提案的处理:
- 当旧leader发送了部分commit后挂了,此时收到commit的Follower的ZXID较大,所以新Leader会从这些收到commit的Follower中选出。没收到commit的Follower只要在新Leader选出后进行同步即可。
- 当旧leader自己同意提案后,却一个commit也没发出,那么这个提案就可以被废弃。
消息广播:
当集群中有过半follower完成了和leader的状态同步,则可以进入消息广播模式。当有服务器加入集群,会先和elader进行数据同步,同步完后进入消息广播模式。
在广播模式下,Leader为每个Follower准备一个队列Queue,采用先进先出的方式发送消息,以保证请求的发送顺序性,且协议通过TCP来通信,也保证消息的接收顺序。
此外,ZAB还定义了一个全局单调递增的事务id:ZXID(高32位是Leader的epoch年代,低32位是事务id),每个提案proposal在Leader中生成后需要根据ZXID进行排序,才能进行后续处理。
流程:
- Leader-followerQueue:发送写请求(提案)
- Follower:返回是否同意。
- Leader-followerQueue:发送Commit请求
netty
概述
Netty 是基于 NIO(同步非阻塞的I/O模型)的 client-server 框架,可以大大简化TCP和UDP套接字服务器等网络编程,性能和安全性也很不错。且支持多种协议,如FTP、SMTP、HTTP和各种基于文本的传统协议。
很多开源项目,如:Dubbo,RocketMQ,Elasticsearch,gRPC,等都是Netty,大部分微服务框架的网络通信部分也是基于Netty,如Spring CLoud Gateway。
BIO、NIO、AIO:
BIO(Blocking I/O):同步阻塞的I/O模式,数据的读取和写入必须阻塞在一个线程内,直至完成。 并发性能很差。
NIO(Non-blocking I/O或New I/O):
同步非阻塞的I/O模型,通过java.nio包,提供了Channel,Select,Buffer等抽象,其中Selector可以实现单线程管理多个Channel,当有Channel需要I/O操作时,它会将其交给一个独立的线程池(Reactor线程池)去处理。
NIO能够使用单线程(Selector)处理多个请求,从而避免了线程阻塞导致性能低下的问题。但是,NIO还是需要等待I/O操作完成,因此虽然减少了线程切换和上下文切换的开销,但是在I/O操作较多时,仍然会因为等待I/O操作完成而阻塞。
提供了与传统BIO模型中的Socket和ServerSocket相对应的SocketChannnel 和 ServerSocketChannel 两种套接字实现,两种通道都支持阻塞和非阻塞模式。
AIO(Asynchronous I/O):NIO的改进版,异步非阻塞的I/O模型。是基于事件和回调机制实现的,I/O操作是直接交给操作系统的,当后台处理完,系统会通知对应的线程。
BIO从发起read调用后,会一直阻塞,直到数据拷贝完成。(发起read调用后,内核过程:准备数据—数据就绪——拷贝数据)
NIO的操作仍是同步的,先发起select调用询问数据是否准备就绪(可以轮询,等告知准备好,用户线程才发起read调用(read调用的过程仍是阻塞的)
为什么不直接用NIO?
因为NIO的编程模型复杂且存在一些BUG,对编程功底要求较高。
且面对 断线重连,包丢失,粘包等问题处理过程更复杂。
netty优点:
- 统一的API,支持多种传输类型,阻塞和非阻塞的。
- 简单而强大的线程模型。
- 自带编解码器解决TCP粘包/拆包问题。
- 自带各种协议栈。
- 真正的无连接数据包套接字支持。
- 比直接使用 java核心API有更高的吞吐量、更低的延迟、更低的资源。
- 源消耗和更少的内存复制。
- 安全性不错,有完整的SSL/TLS以及StartTLS支持。
- 社区活跃
- 成熟稳定,经历了大型项目的使用和考验,而且很多开源项目都使用到了Ntty,比如我们经常接触的Dubbo、RocketMQ等等。
应用场景: 主要用于网络通信功能
- 作为RPC框架的网络通信工具。
- 实现一个HTTP服务器。(如Tomcat)
- 实现一个及时通讯系统。(如微信等聊天系统)
- 实现消息推送系统。
核心组件
ByteBuf
(字节容器)
网络通信是通过字节流传输的。而Bytebuf就是Netty提供的一个字节容器,内部是一个字节数组。传输数据时就是通过Bytebuf进行的。(可以看作时java.nio提供的ByteBuffer字节容器的封装)
Bootstrap、ServerBootstrap
Bootstrap是客户端的启动引导类,使用如下:
1 | NioEventLoopGroup eventLoopGroup = new NioEventLoopGroup(); |
ServerBootstrap 是服务端的启动引导类,使用如下:
1 | // 1.bossGroup用于接收连接, workerGroup用于具体的处理 |
- Bootstrap 通常使用 connect()方法连接到远程的主机和端口,作为一个Netty TCP协议通信的客户端。另外,Bootstrap也可以通过bind()方法绑定本地的一个端口,作为UDP协议通信中的一端。
- ServerBootstrap 通常使用 bind()方法绑定本地端口,等待客户端的连接。
- Bootstrap 只需配置一个线程组,而ServerBootstrap需要配置两个线程组,一个用于接收连接,一个用于具体的IO处理。
EventLoop
事件循环, 负责处理Channel上的I/O事件。 可以绑定一个或多个Channel。并使用一个线程处理所有绑定到它的 Channel 的事件(一个EventLoop对应一个线程,保证线程安全)。
- NioEventLoopGroup:是一组EventLoop的容器,包含一个或多个 EventLoop,用于分配连接和处理任务。默认的构造函数会创建的线程数为CPU核心数 * 2。
Channel
Channel表示一个连接,是Netty进行网络连接的通道,负责网络通信、注册、数据操作等功能。
工作原理:
当客户端连接成功,将新建一个channel和该客户端进行绑定。
channel 从EventLoopGroup获得一个EventLoop,并注册到该EventLoop,channel生命周期都和EventLoop在一起(注册时获得selectionKey)。
channel同客户端进行网络连接、关闭、读写,生成对应的event(改变selectionKey信息),触发eventLoop调度线程进行执行。
如果是读事件,执行线程会调度pipeline来处理业务逻辑。
1 | // 通过 Bootstrap的connect方法连接到服务端 |
常用的Channel接口实现类是:
- NioServerSocketChannel(服务端)
- NioSocketChannel(客户端)
ChannelPipeline
(ChannelHandler 对象链表)每个Channel有且仅有一个ChannelPipeline,它是一个包含ChannelHandler链的容器(线程安全)。当 Channel 上的事件发生时,ChannelPipeline 会将这些事件传递给相应的 ChannelHandler 进行处理。
ChannelHandler
(消息处理器),是 Netty 中处理网络事件的核心抽象。ChannelHandler 可以用于处理数据的编解码、业务逻辑处理等。用户可以自定义 ChannelHandler 来实现特定的功能。
可以在ChannelPipeline上通过addLast()方法添加一个或多个ChannelHandler。一个数据或者事件可能会被多个Handler处理,当一个ChannelHandler处理完之后就将数据交给下一个ChannelHandler。
1
2
3
4
5
6
7
8
9bootstrap.group(eventLoopGroup)
.handler(new ChannelInitializer<SocketChannel>() {
protected void initChannel(SocketChannel ch) {
ch.pipeline().addLast(new NettyKryoDecoder(kryoSerializer, RpcResponse.class));
ch.pipeline().addLast(new NettyKryoEncoder(kryoSerializer, RpcRequest.class));
ch.pipeline().addLast(new KryoClientHandler());
}
});
ChannelHandlerContext
(通道处理器上下文),为ChannelHandler和ChannelPipeline提供交互。 每个ChannelHandler都有一个关联的ChannelHandlerContext,ChannelPipeline通过ChannelHandlerContext来间接管理ChannelHandler。
ChannelHandlerContext提供了对ChannelHandler的访问,以及它前后相邻的ChannelHandler的访问。在ChannelHandlerContext的抽象实现类AbstractChannelHandlerContext,可以很清楚的看到,它拥有next和prev两个属性,分别对应下一个和上一个`ChannelHandlerContext。
线程模型
Netty线程模型是基于 Reactor线程模型 进行了优化和扩展的,提供了更高级的抽象和更易用的 API。
Reactor线程模型
Reactor是基于事件驱动的网络编程模型,采用多路复用将事件分发给相应的Handler处理,特别适合处理海量的I/O事件。
包含三个组件:
- Reactor:将连接请求和 I/O事件分发给相应的 Handler(处理器)进行处理。
- Handler:负责处理来自 Reactor 分发的连接请求和 I/O 事件。Handler 通常需要实现事件处理的回调接口,例如连接建立、数据读取、数据写入等。
- Channel:表示一个客户端与服务器之间的连接,负责数据的传输。Channel 封装了底层的 I/O 操作,提供了非阻塞的 I/O 操作接口。
根据线程数量和使用方式的不同,Reactor线程模型可分为三种:
单线程Reactor:
只有一个线程负责处理所有的连接请求和 I/O 事件。Reactor 和 Handler 都运行在同一个线程中。只适用于小型应用,并发性能低。
多线程Reactor:
一个主线程负责接收请求,一组NIO线程处理I/O操作(Worker线程池)。 Reactor主线线程接收到新的连接请求,会创建并调用一个Hander对象,Hander只负责响应事件,将具体的业务处理交给Worker线程池中的某个线程。
主线程包含一个Reactor和多个Handler,但Handler只负责响应事件,并将业务处理交由另外的Worker线程来做。
主从多线程Reactor:
包含一个主 Reactor 和多个从 Reactor。主 Reactor 运行在主线程中,负责接收新的连接请求;从 Reactor 运行在工作线程中,负责处理 I/O 事件。
每一个从Reactor的结构和 多线程Reactor 的结构一致,也是有一个Reactor和多个Handler,具体业务交由另外的Worker线程处理。
Netty线程模型
Netty主要靠 NioEventLoopGroup线程池来实现具体的线程模型。
在实现服务端时,一般会初始化两个线程组:
- bossGroup:用于接收连接。
- workerGroup:负责具体的处理,交由对应的Handler处理。
Netty的线程模型:
单线程模型:
一个线程单独处理客户端连接以及/O读写,涉及到accept、read、decode、process、encode、send等事件。
1
2
3
4
5
6
7NioEventLoopGroup eventGroup = new NioEventLoopGroup(1);
try {
// 2.创建服务端启动引导类 ServerBootstrap
ServerBootstrap b = new ServerBootstrap();
// 3.给引导类配置两大线程组, 确定线程模型
b.group(eventGroup, eventGroup)
// ....多线程模型:
一个Acceptor线程只负责监听客户端的连接,一个NIO线程池负责处理I/O读写。
1
2
3
4
5
6
7
8
9// 1.bossGroup用于接收连接, workerGroup用于具体的处理
NioEventLoopGroup bossGroup = new NioEventLoopGroup(1);
NioEventLoopGroup workerGroup = new NioEventLoopGroup();
try {
// 2.创建服务端启动引导类 ServerBootstrap
ServerBootstrap b = new ServerBootstrap();
// 3.给引导类配置两大线程组, 确定线程模型
b.group(bossGroup, workerGroup)
// ....主从多线程模型:
从一个主线程NIO线程池中选择一个线程作为Acceptor线程,绑定监听端口,接收客户端的连接,其他线程负责后续的接入认证等工作。连接建立完成后,Sub NIO线程池负责具体处理I/O读写。
1
2
3
4
5
6
7
8
9// 1.bossGroup用于接收连接, workerGroup用于具体的处理
NioEventLoopGroup bossGroup = new NioEventLoopGroup();
NioEventLoopGroup workerGroup = new NioEventLoopGroup();
try {
// 2.创建服务端启动引导类 ServerBootstrap
ServerBootstrap b = new ServerBootstrap();
// 3.给引导类配置两大线程组, 确定线程模型
b.group(bossGroup, workerGroup)
// ....
启动过程
服务端
- 创建两个NioEventLoopGroup对象实例:bossGroup和workerGroup。
- bossGroup:用于处理客户端的TCP连接请求。
- workerGroup:负责每一条连接的具体读写数据的处理逻辑,真正负责l/O读写操作,交由对应的Handler处理。(线程数量默认为CPU核心数*2).
- 创建一个服务端启动引导类:ServerBootstrap。
- 通过group()方法给引导类配置两个线程组。
- 通过channel()方法给引导类指定IO模型为NIO模型。
- NioServerSocketChannel:指定服务端的IO模型为NIO,与BIO编程模型中的ServerSocket对应
- NioSocketChannel:指定客户端的IO模型为NIO,与BlO编程模型中的Socket对应
- 通过childHandler()方法给引导类创建一个ChannelInitializer,然后在里面指定服务端消息的业务处理逻辑对象,如下述代码中的HelloServerHandler对象。
- 调用ServerBootstrap类的bind()方法绑定端口。
1 | // 1.bossGroup 用于接收连接,workerGroup 用于具体的处理 |
客户端
创建一个NioEventLoopGroup对象实例
创建客户端启动引导类:Bootstrap
通过group()方法给引导类配置一个线程组。
通过channel()方法给引导类指定了IO模型为NIO
通过handler()方法给引导类创建一个ChannelInitializer,然后指定客户端消息的业务处理逻辑HelloClientHandler对象。
调用Bootstrap类的connect()方法进行连接,这个方法需要指定两个参数:ip地址和端口号
connect()方法返回的是一个Future类型的对象,也就是说这个方法是异步的,可以通过addListener方法进行监听,看是否连接成功。代码改动如下:
1
2
3
4
5
6
7
8ChannelFuture f = b.connect(host, port)
.addListener(future -> {
if (future.isSuccess()){
System.out.println("连接成功");
}else {
System.out.println("连接失败");
}
}).sync();
1 | // 1.创建一个NioEventLoopGroup对象实例 |
handler处理器
常用内置处理器
编解码器
- ByteToMessageCodec
- MessageToMessageCodec
安全传输
- SslHandler:用于加密传输。
HTTP相关:
HttpServerCodec
相当于
HttpRequestDecoder加HttpResponseEncoder通常用于服务器上- HttpRequestDecoder: 请求解码器,将请求解码并封装为一个HttpObject,默认为DefaultHttpRequest,并传递给下一个Handler。
- HttpResponseEncoder:响应编码器,对HTTP响应对象(HttpResponse)编码。
HttpClientCodec
相当于
HttpResponseDecoder(响应解码器)加HttpRequestEncoder(请求编码器),通常用于客户端上。HttpObjectAggregator 消息聚合器
对 httpMessage 进行聚合,聚合成FullHttpRequest或FullHttpResponse。 是处理POST请求的必要handler,netty中基本都会用到。
http解压缩处理器:
HttpContentCompressor,放在服务端。
HttpContentDecompressor,放在客户端。
WebSocket处理器
WebSocketServerProtocolHandle
负责处理服务端的握手和控制(Ping、Pong、Close),不负责TextWebSocketFrame、BinaryWebSocketFrame和ContinuationWebSocketFrame。
1
2// "/ws"指定了给客户端连接访问的路由
pipeline.addLast(new WebSocketServerProtocolHandler("/ws"));WebSocketFrame 类型 :
- BinaryWebSocketFrame: (数据帧)二进制数据
- TextWebSocketFrame:(数据帧)文本数据
- ContinuationWebSocketFrame:(数据帧)属于上一个 BinaryWebSocketFrame 或 TextWebSocketFrame 的数据。
- CloseWebSocketFrame:(控制帧)
- PingWebSocketFrame:
- PongWebSocketFrame:
写大型数据
如果直接传输文件内容,不需要额外处理,建议使用 FileRegion,能用到零拷贝。如:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15FileInputStream in = new FileInputStream(file);
// 以该文件的完成长度创建一个DefaultFileRegion
FileRegion region = new DefaultFileRegion(in.getChannel(), 0, file.length());
// 发送DefaultFileRegion, 并注册一个ChannelFutureListener
channel.writeAndFlush(region).addListener(
new ChannelFutureListener() {
public void operationComplete(ChannelFuture future) throws Exception {
if (!future.isSuccess()){ // 处理失败
Throwable cause = future.cause();
.....
}
}
}
);如需要对文件内容进行处理,则可使用处理器 ChunkedWriteHandler,不会消耗大量内存。
空闲检测及超时
IdleStateHandler 空闲状态处理器
空闲检测,通常用于心跳保持,可设置读空闲,写空闲,读写都空间的时间。
超时则触发一个空闲事件
IdleStateEvent,可以下个处理器继承 ChannelInboundHandler或其子类 并覆盖userEventTriggered()来处理该事件。ReadTimeoutHandler 读取超时处理器
指定时间内没有收到任何的入站数据,抛出
ReadTimeoutException异常,并关闭channel,可以通过exceptionCaught()捕获该异常。WriteTimeoutHandler 写入超时读取器
指定时间内没有任何出站数据写入,抛出
WriteTimeoutException异常,并关闭channel,可以通过exceptionCaught()捕获该异常。
粘/拆包处理器
- LineBasedFrameDecoder:以行为单位进行数据包的解码;(包之间以换行符作为分割)
- DelimiterBasedFrameDecoder:以特殊的符号作为分隔来进行数据包的解码;
- FixedLengthFrameDecoder:以固定长度进行数据包的解码;
- LenghtFieldBasedFrameDecoder:适用于消息头包含消息长度的协议(最常用);
自定义处理器
通常我们不会直接实现ChannelInboundHandler接口,因为里面涉及到大量方法需要实现,而是继承现有的类,
ChannelInboundHandlerAdapter和 是最常用的两个类,二者实现的功能大致相同,但是在一些细节上还是有差异,需要正确使用:
ChannelInboundHandlerAdapter
不会自动释放消息对象,消息用Object传递,需要做类型强转。 通常用于处于pipeline链中间的某些环节,对数据进行某些处理,如数据验证,需要将消息继续传递。
重写**channelRead()**方法,加入自己的业务逻辑。
注意!**结尾一定要加上 ctx.fireChannelRead(msg)**,否则消息不会继续传递。
1
2
3
4
5
public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
...
ctx.fireChannelRead(msg);
}SimpleChannelInboundHandler
会自动释放消息对象,消息对象支持泛型。 通常用于pipeline链最后一个环节,该环节处理完后,后续不再需要该消息,因此可以自动释放掉消息对象。
重写**channelRead0()**方法,加入自己的业务逻辑。
注:
如果还需要后续处理器进行业务处理,不想释放掉消息对象,需要手工调用ReferenceCountUtil.retain(msg),也就是让消息的引用计数加1,否则框架对引用计数为0的消息会执行释放和回收。
可能出现的问题: 如果传过来的消息对象需要发给客户端,即调用Channel对象的 writeAndFlush(msg)方法,但是 writeAndFlush() 或 write()是异步的,消息可能还没发送完成,消息对象就被finally块中的ReferenceCountUtil.release(msg)释放掉了,于是就会出现异常情况。
解决: 新创建一个消息对象进行发送,这样原来的消息对象被释放掉了也没关系。 或者在服务端不使用SimpleChannelInboundHandler。
1
2
3
4
protected void channelRead0(ChannelHandlerContext ctx, TextWebSocketFrame msg) {
....
}自动释放的代码:
SimpleChannelInboundHandler继承ChannelInboundHandlerAdapter,重写了channelRead() 方法,在里面调用了channelRead0(), 并在finally中调用ReferenceCountUtil.release(msg) 释放消息对象。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
boolean release = true;
try {
if (acceptInboundMessage(msg)) {
I imsg = (I) msg;
channelRead0(ctx, imsg);
} else {
release = false;
ctx.fireChannelRead(msg);
}
} finally {
if (autoRelease && release) {
ReferenceCountUtil.release(msg);
}
}
}
解决问题
TCP粘包/拆包
指TCP协议中,发送方发送的若干包数据到接收方接收时粘在一起,从接收缓冲区看,后一包数据的头紧接着前一包数据的尾。
因为TCP是面向流的,没有边界,而操作系统在发送TCP数据时,会通过缓冲区来进行优化。
- 如果一次请求发送的数据量比较小,没达到缓冲区大小,TCP则会将多个请求合并为同一个请求进行发送,这就形成了粘包问题。
- 如果一次请求发送的数据量比较大,超过了缓冲区大小,TCP就会将其拆分为多次发送,这就是拆包。
常见的解决方案:
- 消息定长: 发送发将消息固定长度发送,接收方按固定长度接收数据包,不足用空格补齐。
- 添加标识:发送方在每个数据包间添加特殊字符或特殊标识,接收方通过标识来区分数据包。
- 添加消息长度:将消息分为消息头和消息体,头部保存消息的长度,接收根据消息长度读取数据。
- 适用更高层的协议:如HTTP、FTP等,在应用层上封装了数据包的格式,可以避免TCP粘包和拆包问题。
Netty的解决方式:
Netty对解决粘包和拆包的方案做了抽象,提供了一些解码器(Decoder)来解决粘包和拆包的问题。如:
- LineBasedFrameDecoder:以行为单位进行数据包的解码;(包之间以换行符作为分割)
- DelimiterBasedFrameDecoder:以特殊的符号作为分隔来进行数据包的解码;
- FixedLengthFrameDecoder:以固定长度进行数据包的解码;
- LenghtFieldBasedFrameDecoder:适用于消息头包含消息长度的协议(最常用);
也可以自定义序列化编解码器,序列化方法有:java自带的Serializable接口,Protostuff,Hessian2,json,Kryo,FST等。(Kryo,FST是专门用于Java的)
长连接
Netty有心跳机制保证长连接的有效性。
在TCP进行读写前,server与client需要先建立连接,连接和关闭需要三次握手和四次挥手,整个过程是比较消耗网络资源的,且有时间延迟。
如果使用短连接,即读写完成后就马上关闭连接,会造成大量网络资源的消耗,消耗的时间也很多; 如果使用长连接,即一次读写过后不会主动关闭连接,要主要请求关闭连接才行,这种适用于频繁请求资源的客户,但如果中途出现网络异常等情况,client 与 server 是无法发现对方已经掉线。
所以,就引入了心跳机制: 当client和server之间在一定时间内没有数据交互时,即处于idle状态时,一方会发送一个特殊的数据报文交给对方,当接收方收到这个数据包后,也立即发送一个特殊数报文回应对方。
虽然TCP有自带的长连接选项 SO_KEEPALIVE,但它依赖于操作系统的实现,且心跳间隔是2h,修改还需要系统调用,灵活性差。
Netty实现心跳机制的核心类是 IdleStateHandler:
1 | // IdleStateHandler的构造器 |
实例化一个 IdleStateHandler 需要提供三个参数:
- readerIdleTimeSeconds:读超时. 即当在指定的时间间隔内没有从 Channel 读取到数据时, 会触发一个 READER_IDLE 的 IdleStateEvent 事件.
- writerIdleTimeSeconds:写超时. 即当在指定的时间间隔内没有数据写入到 Channel 时, 会触发一个 WRITER_IDLE 的 IdleStateEvent 事件.
- allIdleTimeSeconds:读/写超时. 即当在指定的时间间隔内没有读或写操作时, 会触发一个 ALL_IDLE 的 IdleStateEvent 事件.
使用:
客户端:
在启动引导类中配置
1
2
3
4
5
6
7
8
9
10
11
12
13serverBootstrap.childHandler(new ChannelInitializer<SocketChannel>() {
public void initChannel(SocketChannel ch) {
ChannelPipeline p = ch.pipeline();
// 心跳设置
p.addLast(new IdleStateHandler(5, 0, 0, TimeUnit.SECONDS));
// 解码和编码,应和客户端一致
p.addLast(new StringDecoder());
p.addLast(new StringEncoder());
//处理服务端的业务逻辑
p.addLast(new HeartNettyServerHandler());
}
});具体的心跳超时处理和客户端返回的数据处理:
继承ChannelInboundHandlerAdapter,重写 userEventTriggered() 方法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54public class HeartNettyServerHandler extends ChannelInboundHandlerAdapter {
/** 空闲次数 */
private int idle_count = 1;
/** 发送次数 */
private int count = 1;
/**
* 超时处理,如果5秒没有收到客户端的心跳,就触发; 如果超过两次,则直接关闭;
*/
public void userEventTriggered(ChannelHandlerContext ctx, Object evt) throws Exception {
// 判断是否是 空闲状态事件
if (evt instanceof IdleStateEvent) {
IdleStateEvent event = (IdleStateEvent) evt;
if (IdleState.READER_IDLE.equals(event.state())) { // 如果读通道处于空闲状态,说明没有接收到心跳命令
if (idle_count > 2) {
System.out.println("超过两次无客户端请求,关闭该channel");
ctx.channel().close();
}
System.out.println("已等待5秒还没收到客户端发来的消息");
idle_count++;
}
} else {
super.userEventTriggered(ctx, obj);
}
}
/**
* 业务逻辑处理
*/
public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
System.out.println("第" + count + "次" + ",服务端收到的消息:" + msg);
String message = (String) msg;
// 如果是心跳命令,服务端收到命令后回复一个相同的命令给客户端
if ("hb_request".equals(message)) {
ctx.write("服务端成功收到心跳信息");
ctx.flush();
}
count++;
}
/**
* 异常处理
*/
public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception {
cause.printStackTrace();
ctx.close();
}
}
客户端:
启动引导类中配置:
1
2
3
4
5
6
7
8
9
10
11
12
13serverBootstrap.childHandler(new ChannelInitializer<SocketChannel>() {
public void initChannel(SocketChannel ch) {
ChannelPipeline p = ch.pipeline();
// 心跳设置,服务器是5s,所以客户端设为4s
p.addLast(new IdleStateHandler(4, 0, 0, TimeUnit.SECONDS));
// 解码和编码,和服务端一致
p.addLast(new StringDecoder());
p.addLast(new StringEncoder());
//处理客户端的业务逻辑
p.addLast(new HeartNettyServerHandler());
}
});具体的心跳处理逻辑:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69public class HeartNettyClientHandler extends ChannelInboundHandlerAdapter {
/** 客户端请求的心跳命令 */
private static final ByteBuf HEARTBEAT_SEQUENCE =
Unpooled.unreleasableBuffer(Unpooled.copiedBuffer("hb_request", CharsetUtil.UTF_8));
/** 空闲次数 */
private int idle_count = 1;
/** 发送次数 */
private int count = 1;
/** 循环次数 */
private int fcount = 1;
/**
* 建立连接时
*/
public void channelActive(ChannelHandlerContext ctx) throws Exception {
System.out.println("建立连接时:" + date());
ctx.fireChannelActive();
}
/**
* 关闭连接时
*/
public void channelInactive(ChannelHandlerContext ctx) throws Exception {
System.out.println("关闭连接时:" + date());
}
/**
* 心跳请求处理,每4秒发送一次心跳请求;
*
*/
public void userEventTriggered(ChannelHandlerContext ctx, Object obj) throws Exception {
System.out.println("\r\n循环请求的时间:" + date() + ",次数" + fcount);
if (obj instanceof IdleStateEvent) {
IdleStateEvent event = (IdleStateEvent) obj;
if (IdleState.WRITER_IDLE.equals(event.state())) { // 如果写通道处于空闲状态就发送心跳命令
// 设置发送次数,允许发送3次心跳包
if (idle_count <= 3) {
idle_count++;
ctx.channel().writeAndFlush(HEARTBEAT_SEQUENCE.duplicate());
} else {
System.out.println("心跳包发送结束,不再发送心跳请求!!!");
}
}
}
fcount++;
}
/**
* 业务逻辑处理
*/
public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
System.out.println("第" + count + "次" + ",客户端收到的消息:" + msg);
count++;
}
private String date(){
SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
return sdf.format(new Date());
}
}
零拷贝
在传统I/O编程中,数据从磁盘、内存等存储设备中读取后,需要经过多次复制和传递,才能被写入到Socket缓冲区,这个过程中会产生大量的数据拷贝,降低了I/O的性能。
零拷贝:指计算机执行操作时,CPU 不需要先将数据从某处内存复制到另一个特定区域。这种技术通常用于通过网络传输文件时节省 CPU 周期和内存带宽。
Netty通过两种方式实现零拷贝:
文件传输
当需要传输大文件时,传统的I/O方式需要将文件内容读入内存中,再将数据写入到Socket缓冲区,这个过程中需要经过多次数据拷贝。而Netty通过使用FileRegion来实现文件传输,避免了数据拷贝的过程,提高了传输性能。
堆外内存
Netty使用堆外内存实现零拷贝技术,堆外内存是指操作系统中的内存,与Java虚拟机的堆内存不同。在Netty中,使用DirectByteBuffer来进行零拷贝操作,将数据直接写入堆外内存中,避免了数据拷贝的过程。
零拷贝的局限性:
只能在支持堆外内存的操作系统上使用。
只能用于特定的场景,如文件传输和数据传输等。
需要使用特定的API来实现,对于不熟悉Netty框架的开发者来说可能需要一定的学习成本。
