知识点—Java
基础知识
基础概念
JDK (Java Development Kit):Java开发组件
JRE (Java Runtime Environment):Java运行时环境, 它是运行已编译Java程序所需的所有内容的集合,包括JVM,Java类库,Java命令和其他一些基础构建。但不能用于创建新程序。
JVM(Java Virtual Machine): Java虚拟机是运行Java字节码的虚拟机,有针对不同系统的特定实现,目的是使用相同的字节码,都会给出相同的结果。(最常用HotSpot VM)
字节码: 即JVM可以理解的代码(.class文件),由于字节码只面向虚拟机,因此Java程序无需重新编译即可在不同操作系统上运行。
Java程序运行流程:
.java文件(源代码)——经过javac编译——得到 .class文件(字节码)——经过 解释器&JIT(即时编译器) 解释/编译 —— 得到机器可理解的代码
在字节码到机器码这一步,JVM类加载器首先加载字节码文件,然后使用解释器逐行解释。 而对于一些热点代码,会使用JIT即时编译器,将字节码对应的机器码保存下来,提高运行效率。
JDK9引入了新编译模式:AOT(Ahead Of Time)运行前编译。
- JIT优点:
- 可以根据当前程序的运行情况生成最优的机器指令序列;
- 当程序需要动态链接时只能用JIT;
- 可以根据内存情况调整代码,更充分利用内存。
- JIT缺点:
- 编译需要占用运行时资源;
- 需要花时间准备编译和识别热点代码,所以初始编译不能达到最高性能。
- AOT优点:
- 在程序运行前编译,避免运行时性能和内存消耗;
- 在程序运行初期达到最高性能;
- 显著加快程序启动。
- AOT缺点:
- 在程序运行前编译会增加程序安装的时间;
- 牺牲Java的一致性;
- 将提前编译的内容保存会占用更多的外存
- JIT优点:
Java语言是编译与解释并存的: 源代码先经过javac编译形成字节码,在交由Java解释器执行。
语法、数据类型
成员变量和局部变量的区别:
语法形式 :
从语法形式上看,成员变量是属于类的,而局部变量是在代码块或方法中定义的变量或是方法的参数;
成员变量可以被public,private,static等修饰符修饰,而局部变量不能被访问控制修饰符及static所修饰;但是,成员变量和局部变量都能被final所修饰。存储方式 :
从变量在内存中的存储方式来看,如果成员变量是使用
static修饰的,那么这个成员变量是属于类的,如果没有使用static修饰,这个成员变量是属于实例的。
对象都存在于堆内存,局部变量则存在于栈内存。生存时间 :
从变量在内存中的生存时间上看,成员变量是对象的一部分,它随着对象的创建而存在,而局部变量随着方法的调用而自动生成,随着方法的调用结束而消亡。
默认值 :
成员变量没初始化,会自动赋默认值(例外:被
final修饰的成员变量必须显式地赋值),而局部变量则不会自动赋值。
静态变量:
静态变量被类的所有实例共享。
通常情况下,静态变量会被final关键字修饰成为常量。静态方法不能调用非静态成员:
静态方法是属于类的,在类加载的时候就会分配内存,可以通过类名直接访问。
而非静态成员属于实例对象,只有在对象实例化之后才存在,需要通过类的实例对象去访问。 也就是说:调用静态成员时,非静态成员可能还没创建。
重载:
方法名一样,参数、返回值、修饰符可以不一样。
重写:
重写父类的方法,方法名和参数列表必须一样,返回值类型小于等于父类的,抛出异常小于等于父类的,访问修饰符大于等于父类的。
父类方法修饰符为
private/final/static则子类就不能重写该方法。 构造方法不能被重写。
基本类型:
基本数据类型的局部变量存放在 Java 虚拟机栈中的局部变量表中,成员变量(未被
static修饰 )存放在 Java 虚拟机的堆中。包装类型的缓存机制:
Byte,Short,Integer,Long这 4 种包装类默认创建了数值 [-128,127] 的相应类型的缓存数据,
Character创建了数值在 [0,127] 范围的缓存数据,
Boolean直接返回TrueorFalse。如果用new创建新对象, 不能用”==”来比较值,对象间用”==”比较的是地址。
所以,所有包装对象之间的值的比较,应该全部都用equals方法。
自动装箱:调用包装类的valueOf()
自动拆箱:调用包装类的xxxValue()
1
2
3
4
5
//自动装箱,等价于 Integer i = Integer.valueOf(10)
Integer i = 10;
//自动拆箱,等价于 int n = i.intValue()
int n = i;频繁装拆箱会影响性能,应尽量避免不必要的装拆箱。
解决浮点数精度丢失:
一些小数转化为二进制会无限循环,只能截断,如0.2。
若对精度有要求,应使用
BigDecimal可以实现对浮点数的运算1
2
3
4
5
6
7
8
9
10
11
12
13int i = 1.0f - 0.9f; // 0.100000024
int j = 0.9f - 0.8f; // 0.099999964
BigDecimal a = new BigDecimal("1.0");
BigDecimal b = new BigDecimal("0.9");
BigDecimal c = new BigDecimal("0.8");
BigDecimal x = a.subtract(b);
BigDecimal y = b.subtract(c);
System.out.println(x); /* 0.1 */
System.out.println(y); /* 0.1 */
System.out.println(Objects.equals(x, y)); /* true */超过long整型的数据表示:
使用BigInteger,其内部使用int[]数组来存储任意大小的整型数据。(不过运算效率稍低)
面向对象
面向过程:把解决问题的过程拆成一个个方法,通过一个个方法的执行解决问题。
面向对象:会先抽象出对象,然后用对象执行方法的方式解决问题。
面向对象开发的程序一般更易维护、易复用、易扩展。
性能:
面向过程性能比面向对象高。 因为类调用时需要实例化,开销比较大,比较消耗资源,所以当性能是最重要的考量因素的时候,比如单片机、嵌入式开发、Linux/Unix等一般采用面向过程开发。
不过面向过程也需要分配内存,计算内存偏移量。
Java性能差的主要原因并不是因为它是面向对象语言,而是Java是半编译语言,最终的执行代码并不是可以直接被CPU执行的二进制机械码。而面向过程语言大多都是直接编译成机械码在电脑上执行,并且其它一些面向过程的脚本语言性能也并不一定比Java好。
面向对象三大特征:
封装:封装是指把一个对象的状态信息(也就是属性)隐藏在对象内部,不允许外部对象直接访问对象的内部信息。但是可以提供一些能被外界访问的方法来操作属性。
继承:不同类型的对象,相互之间经常有一定数量的共同点。继承是使用已存在的类的定义作为基础建立新类的技术,新类的定义可以增加新的数据或新的功能,也可以用父类的功能,但不能选择性地继承父类。通过使用继承,可以快速地创建新的类,可以提高代码的重用,程序的可维护性,节省大量创建新类的时间 ,提高我们的开发效率。
父类的私有属性和方法子类无法访问。
多态: 对象类型和引用类型之间具有继承关系。调用的具体是哪个类的方法只能在运行期间确定。多态不能调用父类不存在的方法。
接口和抽象类:
共同点:
- 不能被实例化。
- 可以包含抽象方法。
- 可以有默认实现的方法。(java8可用default在接口中定义默认方法)
区别:
- 接口主要用于约束类的行为,实现接口意味着具有相应的行为;抽象类主要用于代码复用,强调所属、继承关系。
- 类只能单继承,接口可以多继承。
- 接口中的成员变量只能是public,static,final,不能被修改且要有初始值。
对象相等:指内存中 存放的内容 是否相等。
引用相等:指向的 内存地址 是否相等。
浅拷贝:在堆上创建新的对象,而内部中的引用类型属性,只复制引用地址。
深拷贝:完全复制整个对象,包括内部对象。
被拷贝类要实现Cloneable接口,重写clone方法。
实现 Serializable 接口方式也可以实现深拷贝,还可以解决多层克隆问题(引用类型里又有引用类型)
常见类
Object
Object是所有类的父类。提供了11个方法:
1 | /** |
==和equals():
Java只有值传递,基本类型传递的是值,引用类型传递的是内存地址。
使用==是直接比较两者的值/地址。
equals()没有重写时,直接return (this == obj);跟==一样。一般重写为比较对象的属性是否相等。
hashCode():
获取哈希码(int),通常是将对象的内存地址转换为整数。 hashCode()一般和equals()配合用于比较两个对象,大幅提高比较效率(如HashMap,如果hashCode()的值相等,再调用equals())。
由于有哈希冲突,所以两个对象的hashCode()值可能相等。
String
可变性:
String不可变: 因为String被final修饰,不能被继承,里面的字符数组也被final修饰且为私有,且String没有提供修改字符数组的方法。
java9的String的底层实现由char[]改为byte[]。
因为新String支持两个编码方案:Latin-1和UTF-16。
如果串中的汉字都在Latin-1范围内,则可用Latin-1方案:byte占1字节,char占2字节。
而UTF-16方案:byte和char都占2字节。
StringBuilder 与 StringBuffer可变: 它们都继承自
AbstractStringBuilder类,在 AbstractStringBuilder中也是使用字符数组保存字符串,不过没有使用final和private关键字修饰,最关键的是这个AbstractStringBuilder类还提供了很多修改字符串的方法比如append方法。
线程安全:
- String不可变,可看作常量,是线程安全的。
- StringBuilder对方法加了同步锁,是线程安全的。
- StringBuffer没加锁,是非线程安全的。
性能:
- 改变String时需要新建String对象,再将指针指向新对象。性能差。
- StringBuilder的性能比Stringffer稍差一点点,但都比String好很多。
字符串拼接:
+和+=专门为Stirng重载过,是Java中仅有的两个重载过的运算符。
Stirng使用+进行拼接时,会新建一个StringBuilder对象进行拼接,最后在toStirng()返回String对象。
注:在循环中,编译器不会创建单个StringBuilder对象,而是每一次循环都创建一次StringBuilder对象。
建议在循环外新建StringBuilder对象(IDEA的代码检查也会提示)。
字符常量池:
String创建的字符串会保存在字符串常量池中,避免字符串的重复创建。
1
2
3
4
5
6
7
8// 在堆中新建对象"ab",并将"ab"的引用保存在字符串常量池
String aa = "ab";
// 直接返回字符串常量池中 字符串对象”ab“的引用
String bb = "ab";
// 新建String对象,一开始未初始化,
// 如果常量池中"ab"不存在,则会在堆中新建对象"ab"并保存到常量池,最后String对象调用构造方法进行赋值。
// 如果常量池中"ab"存在, 则直接调用构造方法赋值。
String s1 = new String("abc");对于编译截断能确定值的字符串,jvm会字节放入字符串常量池,包括字符串常量拼接得到的字符串常量。
这种叫常量折叠,基本数据类型及其算数运算和位运算、字符串常量都会进行常量折叠。(引用的值在编译器无法确定,不能进行优化)
1
2
3
4
5
6
7
8String str1 = "str";
String str2 = "ing";
String str3 = "str" + "ing"; // 优化成 String str3 = "string";
String str4 = str1 + str2;
String str5 = "string";
System.out.println(str3 == str4); //false
System.out.println(str3 == str5); //true
System.out.println(str4 == str5); //false
异常
层次:
Throwable
- Exception
- Checked Exception: …
- Unchecked Exception:…
- Error:…
- Exception
Exception:程序本身可以处理的异常,可以通过catch来进行捕获。Exception 又可以分为 Checked Exception (受检查异常,必须处理) 和 **Unchecked Exception (不受检查异常,可以不处理)**。- 除了
RuntimeException及其子类以外,其他的Exception类及其子类都属于受检查异常 。常见的受检查异常有: IO 相关的异常、ClassNotFoundException 、SQLException… RuntimeException及其子类都统称为非受检查异常,常见的有(建议记下来):NullPointerException(空指针错误)IllegalArgumentException(参数错误比如方法入参类型错误)NumberFormatException(字符串转换为数字格式错误,是IllegalArgumentException的子类)ArrayIndexOutOfBoundsException(数组越界错误)ClassCastException(类型转换错误)ArithmeticException(算术错误)SecurityException(安全错误比如权限不够)UnsupportedOperationException(不支持的操作错误比如重复创建同一用户)
- 除了
Error:Error 属于程序无法处理的错误 ,不建议通过catch捕获 。例如 Java 虚拟机运行错误(Virtual MachineError)、虚拟机内存不够错误(OutOfMemoryError)、类定义错误(NoClassDefFoundError)等 。这些异常发生时,Java 虚拟机(JVM)一般会选择线程终止。常用方法:
String getMessage(): 返回异常发生时的简要描述
String toString(): 返回异常发生时的详细信息
String getLocalizedMessage(): 返回异常对象的本地化信息。使用 Throwable 的子类覆盖这个方法,可以生成本地化信息。如果子类没有覆盖该方法,则该方法返回的信息与 getMessage()返回的结果相同
void printStackTrace(): 在控制台上打印 Throwable 对象封装的异常信息
异常使用注意事项:
- 不要把异常定义为静态变量,因为这样会导致异常栈信息错乱。每次手动抛出异常,我们都需要手动 new 一个异常对象抛出。
- 建议抛出更加具体的异常,比如字符串转换为数字格式错误的时候应该抛出NumberFormatException而不是其父类IllegalArgumentException。
- 使用日志打印异常之后就不要再抛出异常了
泛型
泛型提供了编译时的 类型安全检测机制,泛型的本质是参数化类型,也就是说所操作的数据类型被指定为一个参数。
使用方式,一般有三种:泛型类,泛型接口,泛型方法。
泛型类
1
2
3
4
5
6
7
8
9
10
11
12
13
14//此处T可以随便写为任意标识,常见的如T、E、K、V等形式的参数常用于表示泛型
//在实例化泛型类时,必须指定T的具体类型
public class Generic<T>{
private T key;
public Generic(T key) {
this.key = key;
}
public T getKey(){
return key;
}
}实例化泛型类,必须指定类型:
1
Generic<Integer> genericInteger = new Generic<Integer>(123456);
泛型接口
1
2
3public interface Generator<T> {
public T method();
}实现泛型接口,可以指定也可以不指定类型:
1
2
3
4
5
6
7// 不指定类型
class GeneratorImpl<T> implements Generator<T>{
public T method() {
return null;
}
}1
2
3
4
5
6
7// 指定类型
class GeneratorImpl<T> implements Generator<String>{
public String method() {
return "hello";
}
}泛型方法
1
2
3
4
5public static <E> void printArray(E[] inputArray){
for (E element : inputArray){
System.out.printf("%s ", element);
}
}使用:
1
2
3
4
5// 创建不同类型数组:Integer, Double 和 Character
Integer[] intArray = {1, 2, 3};
String[] stringArray = {"Hello", "World" };
printArray(intArray);
printArray(stringArray);由于以上是静态方法,先于实例对象加载,而类在实例化时才能使用传递类型参数,所以静态方法无法使用类上声明的泛型参数,只能使用自己声明的 <E>;
反射
通过反射,可以操作字节码文件,可以获取任意一个类的所有属性和方法,并调用。
反射赋予了我们在运行时分析类以及执行类中方法的能力。
反射相关的类在 java.lang.reflect.* 下。
反射相关的类:
| 类 | 含义 |
|---|---|
| java.lang.Class | 代表整个字节码,即一个类型,整个类 |
| java.lang.reflect.Method | 代表字节码中的方法字节码,即类中的方法 |
| java.lang.reflect.Constructor | 代表字节码中的构造字节码,即类中的构造方法 |
| java.lang.reflect.Field | 代表字节码中的属性字节码,即类中的成员变量(静态变量 + 实例变量) |
必须先获取Class才能获取Method、Constructor、Field
属性Field重要的是名字
实例方法Method重要的是名字和形参列表
构造方法Constructor重要的是形参列表
反射操作
获取Class的方法,三种(返回值都是Class类型):
- Class.forName(“完整类名带包名”) —— 是静态方法
- 对象.getClass()
- 任何类型.class
通过反射实例化对象:
1
2Class对象.newInstance()
// newInstance()实际调用的是无参构造方法, 如果没有无参构造方法, 会抛 java.lang.InstantiationException异常例:
1
2
3
4
5
6
7
8
9
10class ReflectTest{
public static void main(String[] args) throws ClassNotFoundException, InstantiationException, IllegalAccessException {
// 通过反射机制,获取Class,通过Class来实例化对象
Class c = Class.forName("com.reflectBean.User");
// newInstance() 这个方法会调用User这个类的无参数构造方法,完成对象的创建。
// 重点是:newInstance()调用的是无参构造,必须保证无参构造是存在的!
Object obj = c.newInstance();
System.out.println(obj);
}
}通过反射,反编译获得一个类的属性Field:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23class ReflectTest06{
public static void main(String[] args) throws ClassNotFoundException {
StringBuilder s = new StringBuilder();
Class studentClass = Class.forName("java.util.ArrayList");
s.append(Modifier.toString(studentClass.getModifiers()) + " class " + studentClass.getSimpleName() + " {\n");// Class类的getName方法
//获取所有的属性
Field[] fields = studentClass.getDeclaredFields();
for (Field f : fields){
s.append("\t");
// 获取属性的修饰符列表,返回的修饰符是一个数字,每个数字是修饰符的代号
// 用Modifier类的toString转换成字符串
s.append(Modifier.toString(f.getModifiers()));
if (f.getModifiers() != 0) s.append(" ");
s.append(f.getType().getSimpleName());// 获取属性的类型
s.append(" ");
s.append(f.getName());// 获取属性的名字
s.append(";\n");
}
s.append("}");
System.out.println(s);
}
}运行得到结果为:
1
2
3
4
5
6
7
8
9public class ArrayList {
private static final long serialVersionUID;
private static final int DEFAULT_CAPACITY;
private static final Object[] EMPTY_ELEMENTDATA;
private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA;
transient Object[] elementData;
private int size;
private static final int MAX_ARRAY_SIZE;
}通过反射访问java对象的属性,并赋值:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17/*
注意:反射机制让代码复杂了,但是为了一个“灵活”,这也是值得的。
*/
class ReflectTest{
public static void main(String[] args) throws ClassNotFoundException, InstantiationException, IllegalAccessException, NoSuchFieldException {
//使用反射机制给属性赋值
Class studentClass = Class.forName("javase.reflectBean.Student");
Object obj = studentClass.newInstance();// obj就是Student对象。(底层调用无参数构造方法)
// 获取no属性(根据属性的名称来获取Field)
Field noField = studentClass.getDeclaredField("no");
// 给obj对象(Student对象)的no属性赋值
noField.set(obj, 22222);
// 读取属性的值
System.out.println(noField.get(obj));
}
}1
2
3
4
5
6
7// set()默认不可以为私有属性赋值, 需要打破封装才行: setAccessible(true)
Field nameField = studentClass.getDeclaredField("name");
// 打破封装(反射机制的缺点:打破封装,可能会给不法分子留下机会!!!)
nameField.setAccessible(true);
// 给name属性赋值并访问
nameField.set(obj, "xiaowu");
System.out.println(nameField.get(obj));通过反射调用方法:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29class ReflectTest10{
public static void main(String[] args) throws Exception {
// 不使用反射机制时,调用方法的过程:
// 创建对象
UserService userService = new UserService();
// 调用方法
System.out.println(userService.login("admin", "123") ? "登入成功!" : "登入失败!");
//使用反射机制调用方法:
Class userServiceClass = Class.forName("javase.reflectBean.UserService");
// 创建对象
Object obj = userServiceClass.newInstance();
// 获取Method
Method loginMethod = userServiceClass.getDeclaredMethod("login", String.class, String.class);
// Method loginMethod = userServiceClass.getDeclaredMethod("login");//注:没有形参就不传
// 调用方法
// 调用方法有几个要素? 也需要4要素。
// 反射机制中最最最最最重要的一个方法,必须记住。
/*
四要素:
方法对象: loginMethod
实例对象: obj
实参: "admin", "123"
返回值: resValues
*/
Object resValues = loginMethod.invoke(obj, "admin", "123");
System.out.println(resValues);
}
}通过反射获取构造方法,再调用构造方法实例化对象:
- 获取构造方法:Class对象的getDeclaredConstructor()方法
- 调用构造方法new对象:Constructor对象的newInstance()方法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22class ReflectTest12{
public static void main(String[] args) throws Exception {
//使用反射机制创建对象(以前)
Class vipClass = Class.forName("javase.reflectBean.Vip");
// 调用无参数构造方法
Object obj1 = vipClass.newInstance();//Class类的newInstance方法
System.out.println(obj1);
//使用反射机制创建对象(现在)
// 调用有参数的构造方法:
// 1. 先获取到这个有参数的构造方法
Constructor c1 = vipClass.getDeclaredConstructor(int.class, String.class, String.class, boolean.class);
// 2. 调用构造方法new对象
Object obj2 = c1.newInstance(321, "lsi", "1999-10-11", true);//Constructor类的newInstance方法
System.out.println(obj2);
// 获取无参数构造方法
Constructor c2 = vipClass.getDeclaredConstructor();
Object obj3 = c2.newInstance();
System.out.println(obj3);
}
}获取一个类的的父类和实现的接口:
- getSuperclass()
- getInterfaces()
1
2
3
4
5
6
7
8
9
10
11
12
13
14class ReflectTest13{
public static void main(String[] args) throws Exception{
// String举例
Class vipClass = Class.forName("java.lang.String");
// 获取String的父类
Class superclass = vipClass.getSuperclass();
// 获取String类实现的所有接口(一个类可以实现多个接口。)
Class[] interfaces = vipClass.getInterfaces();
System.out.println(superclass.getName());
for (Class i : interfaces) {
System.out.println(i.getName());
}
}
}
常用方法
Class类方法:
方法名 含义 public T newInstance() 创建对象 public String getName() 返回完整类名带包名 public String getSimpleName() 返回类名 public Field[] getFields() 返回类中public修饰的属性 public Field[] getDeclaredFields() 返回类中所有的属性 public Field getDeclaredField(String name) 根据属性名name获取指定的属性 public Method[] getDeclaredMethods() 返回类中所有的实例方法 public Method getDeclaredMethod(String name, Class<?>… parameterTypes) 根据方法名name和方法形参获取指定方法 public Constructor getDeclaredConstructor(Class<?>… parameterTypes) 根据方法形参获取指定的构造方法 public native int getModifiers() 获取属性的修饰符列表,返回的修饰符是一个数字【一般配合Modifier类的toString(int x)方法使用】 public Annotation[] getAnnotations() {} 获取元素上所有注解 …. …. public native Class<? super T> getSuperclass() 返回调用类的父类 public Class<?>[] getInterfaces() 返回调用类实现的接口集合 Field类方法:
方法名 含义 public String getName() 返回属性名 public int getModifiers() 获取属性的修饰符列表,返回的修饰符是一个数字【一般配合Modifier类的toString(int x)方法使用】 public Class<?> getType() 以Class类型,返回属性类型【一般配合Class类的getSimpleName()方法使用】 public void set(Object obj, Object value) 设置属性值 public Object get(Object obj) 读取属性值 public void setAccessible(boolean flag) 默认false,设置为true可以打破封装,如设置私有属性 Method类方法:
方法名 含义 public String getName() 返回方法名 public int getModifiers() 获取方法的修饰符列表【一般配合Modifier类的toString(int x)方法使用】 public Class<?> getReturnType() 以Class类型,返回方法类型【一般配合Class类的getSimpleName()方法使用】 public Class<?>[] getParameterTypes() 返回方法的修饰符列表 public Object invoke(Object obj, Object… args) 调用方法 Constructor类方法:
方法名 含义 public String getName() 返回构造方法名 public int getModifiers() 获取构造方法的修饰符列表【一般配合Modifier类的toString(int x)方法使用】 public Class<?>[] getParameterTypes() 返回构造方法的修饰符列表(一个方法的参数可能会有多个) public T newInstance(Object … initargs) 创建对象【参数为创建对象的数据】
注解
Annotation (注解) 是 Java5 开始引入的新特性,可以看作是一种特殊的注释,主要用于修饰类、方法或者变量,提供某些信息供程序在编译或者运行时使用。
注解本质是一个继承了Annotation 的特殊接口,如@Override:
1 |
|
常见注解有两种:
- 编译期直接扫描 :编译器在编译 Java 代码的时候扫描对应的注解并处理,比如某个方法使用@Override 注解,编译器在编译的时候就会检测当前的方法是否重写了父类对应的方法。
- 运行期通过反射处理 :像框架中自带的注解(比如 Spring 框架的 @Value 、@Component)都是通过反射来进行处理的。
创建注解:通过@interface关键字进行定义:
1 | public TestAnnotation { |
元注解
元注解是可以注解到注解上的注解,或者说元注解是一种基本注解,但是它能够应用到其它的注解上面。 元注解有5种:@Retention、@Documented、@Target、@Inherited、@Repeatable
@Retention: 意为保留,是指注解的存活时间。
取值有3种:
- RetentionPolicy.SOURCE:注解只在源码解码保留,在编译时会被忽略丢弃。
- RetentionPolicy.CLASS:注解只保留到编译进行时,不会被加载到JVM中。
- RetentionPolicy.RUNTIME:注解可保留到程序运行时,会被加载到 JVM中。
1
2
3
public TestAnnotation {
}@Documented: 能够将注解中的元素包含到 Javadoc 中去。
@Target: 指定注解运用的场景。取值有:
- ElementType.ANNOTATION_TYPE 可以给一个注解进行注解
- ElementType.CONSTRUCTOR 可以给构造方法进行注解
- ElementType.FIELD 可以给属性进行注解
- ElementType.LOCAL_VARIABLE 可以给局部变量进行注解
- ElementType.METHOD 可以给方法进行注解
- ElementType.PACKAGE 可以给一个包进行注解
- ElementType.PARAMETER 可以给一个方法内的参数进行注解
- ElementType.TYPE 可以给一个类型进行注解,比如类、接口、枚举
@Inherited:继承的意思,如果当前类的超类有@Inherited,且当前类没有被任何注解应用,则当前类继承超类的注解。
1
2
3
4
5
6
7
8
Test {}
public class A {}
public class B extends A {}如上,类B能继承类A的注解。
@Repeatable:可重复的意思,通常指注解的值可以同时取多个。
1
2
3
4
5
6
7
8
9
10
11
12
13
14Persons {
Person[] value();
}
Person{
String role default "";
}
public class SuperMan{
}
注解属性
注解的属性也叫做成员变量。注解只有成员变量,没有方法。
例:定义注解有两个属性,默认值用default关键字指定
1
2
3
4
5
6
public TestAnnotation {
public int id() default -1;
public String msg() default "Hi";
}使用时赋值(有默认值的属性也可以不赋值):
1
2
3
public class Test {
}例:注解仅有一个属性时,使用时可以省略属性名:
1
2
3
4
5
6public Check {
String value();
}
int a;例:注解没有任何属性,使用时不用加括号
1
2
3
4public Perform {}
public void testMethod(){}
Java预置注解
Java 语言本身提供了几个现成的注解:
@Deprecated:用于标记过时的元素。在idea中使用过时元素,会划上删除线。
@Override:提示子类要复写父类中被 @Override 修饰的方法
@SuppressWarnings:阻止警告。如调用@Deprecated标记的元素的地方,可以使用@SuppressWarnings来忽略警告。
@SafeVarargs:
1
2
3
4
5
6
7// 实际上并不安全!
static void m(List<String>... stringLists) {
Object[] array = stringLists;
List<Integer> tmpList = Arrays.asList(42);
array[0] = tmpList; // 语义上是无效的,但编译时没有警告。
String s = stringLists[0].get(0); // 在运行时出现ClassCastException!
}@FunctionalInterface: 函数式接口注解。 函数式接口就是一个只具有一个方抽象法的普通接口。 它主要用在Lambda表达式和方法引用上。
- 函数式接口只能有一个抽象方法,但可以有默认方法,也可以有静态方法。
比如,在线程开发中常用的Runnable就是一个典型的函数式接口。
1
2
3
4
5
6
7
8
public interface Runnable {
/**
当使用对象实现接口Runnable创建线程时,启动线程会导致在该单独执行的线程中调用对象的方法run
该方法run的一般约定是它可以采取任何行动。
*/
public abstract void run();
}
SPI
Service Provider Interface ,即服务提供者的接口,可以理解为 专门提供给服务提供者或框架开发者去使用的接口。 SPI将服务调用方和服务实现者解耦,修改或替换服务不需要修改调用方。
SPI和API的区别:
API调用的接口是由实现方提供的,而SPI调用的接口是自己规定的,再交由实现方实现。
缺点:
- 需要遍历加载所有的实现类,不能做到按需加载,这样效率还是相对较低的。
- 当多个
ServiceLoader同时load时,会有并发问题。
使用 Java 的 SPI 机制是需要依赖 ServiceLoader 来实现的,ServiceLoader加载服务的流程大致是:
- 通过 URL 工具类从 jar 包的
/META-INF/services目录下面找到对应的文件, - 读取这个文件的名称找到对应的 spi 接口,
- 通过
InputStream流将文件里面的具体实现类的全类名读取出来, - 根据获取到的全类名,先判断跟 spi 接口是否为同一类型,如果是的,那么就通过反射的机制构造对应的实例对象,
- 将构造出来的实例对象添加到
Providers的列表中。
实践
利用SPI机制,实现一个简易日志框架。
调用方
首先在调用方,新建一个Java项目(不用Maven项目,因为涉及到一些编译配置,较麻烦),结构如下:
1 | │ service-provider-interface.iml |
首先实现一个Logger接口,这个就是SPI,后面的服务提供者就要针对这个接口进行实现。
1 | package edu.jiangxuan.up.spi; |
接着实现一个LoggerService类,主要用于加载实现方提供的服务。
1 | package edu.jiangxuan.up.spi; |
最后是Main类,查看实现结果
1 | package org.spi.service; |
实现方
- 将调用方的SPI导出为jar包,然后导入到实现方项目的lib目录中,并添加为库。
- 在src目录下新建 META-INF/services文件夹,然后新建文件,文件名为SPI的全类名,文件内容是实现类的全类名:edu.jiangxuan.up.spi.service.Logback
- 编写实现了Logger的类Logback。
目录结构为:
1 | │ service-provider.iml |
Logback类:
1 | package edu.jiangxuan.up.spi.service; |
这样一个简易的SPI实践就完成了,在调用方导入实现方的项目jar包,运行调用方的测试方法(这里是Main方法)即可出结果。
序列化
- 序列化:将数据结构或对象转换成二进制字节流的过程。
- 反序列化:将在序列化过程中所生成的二进制字节流转换成数据结构或对象的过程。
在Java中,序列化的都是对象。
序列化属于OSI七层协议模型中的表示层,即TCP/IP四层模型中的应用层。
序列化场景:
- 对象在进行网络传输(比如远程方法调用 RPC 的时候)之前需要先被序列化,接收到序列化的对象之后需要再进行反序列化;
- 将对象存储到文件之前需要进行序列化,将对象从文件中读取出来需要进行反序列化;
- 将对象存储到数据库(如 Redis)之前需要用到序列化,将对象从缓存数据库中读取出来需要反序列化;
- 将对象存储到内存之前需要进行序列化,从内存中读取出来之后需要进行反序列化
设置变量不进行序列化: 添加 transient 关键字修饰。
注:
transient 只能修饰变量,不能修饰类和方法;
transient 修饰的变量,在反序列化后会被置为默认值;
static变量不属于任何对象,所以无论有没有 transient 修饰,都不会被序列化。
常见的序列化协议: Hessian,Kryo,Protobuf,ProtoStuff。(JDK自带的序列化方式因为不支持跨语言调用、效率和安全问题,一般不用, JSON和XML这种文本类序列化方式,可读性好但性能较差,一般也不用。)
Kryo: 是一个高性能的序列化/反序列化工具,由于其变长存储特性并使用了字节码生成机制,拥有较高的运行速度和较小的字节码体积。(Kryo是专门针对Java语言的序列化方式,其他 Protobuf、 ProtoStuff、hessian 都是跨语言的)
在springboot中使用例子:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57import com.esotericsoftware.kryo.Kryo;
import com.esotericsoftware.kryo.io.Input;
import com.esotericsoftware.kryo.io.Output;
import github.javaguide.exception.SerializeException;
import github.javaguide.remoting.dto.RpcRequest;
import github.javaguide.remoting.dto.RpcResponse;
import github.javaguide.serialize.Serializer;
import lombok.extern.slf4j.Slf4j;
import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
public class KryoSerializer implements Serializer {
/**
* Because Kryo is not thread safe. So, use ThreadLocal to store Kryo objects
* 因为 Kryo不是线程安全的。因此,使用 ThreadLocal存储 Kryo对象
*/
// 因为ThreadLocal只能被当前线程访问, 所以也无法利用其他线程初始化, 需要在此先初始化
private final ThreadLocal<Kryo> kryoThreadLocal = ThreadLocal.withInitial(() -> {
Kryo kryo = new Kryo();
kryo.register(RpcResponse.class);
kryo.register(RpcRequest.class);
return kryo;
});
// 序列化, 其中kryo的Output类继承了java.io.OutputStream
public byte[] serialize(Object obj) {
try (ByteArrayOutputStream byteArrayOutputStream = new ByteArrayOutputStream();
Output output = new Output(byteArrayOutputStream)) {
Kryo kryo = kryoThreadLocal.get();
// Object->byte:将对象序列化为byte数组
kryo.writeObject(output, obj);
kryoThreadLocal.remove();
return output.toBytes();
} catch (Exception e) {
throw new SerializeException("Serialization failed —— 序列化失败");
}
}
// 反序列化
public <T> T deserialize(byte[] bytes, Class<T> clazz) {
try (ByteArrayInputStream byteArrayInputStream = new ByteArrayInputStream(bytes);
Input input = new Input(byteArrayInputStream)) {
Kryo kryo = kryoThreadLocal.get();
// byte->Object:从byte数组中反序列化出对对象
Object o = kryo.readObject(input, clazz);
kryoThreadLocal.remove();
return clazz.cast(o); // cast(): 将对象强制转换为此 Class对象表示的类或接口。
} catch (Exception e) {
throw new SerializeException("Deserialization failed");
}
}
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
void kryoSerializerTest() {
// 构建要序列化的对象
RpcRequest target = RpcRequest.builder().methodName("hello")
.parameters(new Object[]{"sayhelooloo", "sayhelooloosayhelooloo"})
.interfaceName("github.javaguide.HelloService")
.paramTypes(new Class<?>[]{String.class, String.class})
.requestId(UUID.randomUUID().toString())
.group("group1")
.version("version1")
.build();
KryoSerializer kryoSerializer = new KryoSerializer();
// 序列化为byte数组
byte[] bytes = kryoSerializer.serialize(target);
// 反序列
RpcRequest actual = kryoSerializer.deserialize(bytes, RpcRequest.class);
}
I/O
IO 即 Input/Output,输入和输出。数据输入到计算机内存的过程即输入,反之输出到外部存储(比如数据库,文件,远程主机)的过程即输出。
- 数据传输过程类似于水流,因此称为 IO 流。
- IO 流在 Java 中分为输入流和输出流,而根据数据的处理方式又分为字节流和字符流。
- Java IO 流的 40 多个类都是从 4 个抽象类基类中派生出来的:字节输入流 InputStream,字符输入流 Reader, 字节输出流 OutputStream, 字符输入流 Writer。
问题:不管是文件读写还是网络发送接收,信息的最小存储单元都是字节,那为什么 I/O 流操作要分为字节流操作和字符流操作呢?答:
- 字符流是由 Java 虚拟机将字节转换得到的,这个过程还算是比较耗时,而如果转换时编码类型不同,还会出现乱码问题,所以就直接把字符流单独作为一个部分,从而提高字符流的效率;
BIO、NIO、AIO:
BIO(Blocking I/O):同步阻塞的I/O模式,数据的读取和写入必须阻塞在一个线程内,直至完成。 并发性能很差。
NIO(Non-blocking I/O或New I/O):
同步非阻塞的I/O模型,通过java.nio包,提供了Channel,Select,Buffer等抽象,其中Selector可以实现单线程管理多个Channel,当有Channel需要I/O操作时,它会将其交给一个独立的线程池(Reactor线程池)去处理。
NIO能够使用单线程(Selector)处理多个请求,从而避免了线程阻塞导致性能低下的问题。但是,NIO还是需要等待I/O操作完成,因此虽然减少了线程切换和上下文切换的开销,但是在I/O操作较多时,仍然会因为等待I/O操作完成而阻塞。
提供了与传统BIO模型中的Socket和ServerSocket相对应的SocketChannnel 和 ServerSocketChannel 两种套接字实现,两种通道都支持阻塞和非阻塞模式。
AIO(Asynchronous I/O):NIO的改进版,异步非阻塞的I/O模型。是基于事件和回调机制实现的,I/O操作是直接交给操作系统的,当后台处理完,系统会通知对应的线程。
BIO从发起read调用后,会一直阻塞,直到数据拷贝完成。(发起read调用后,内核过程:准备数据—数据就绪——拷贝数据)
NIO的操作仍是同步的,先发起select调用询问数据是否准备就绪(可以轮询,等告知准备好,用户线程才发起read调用(read调用的过程仍是阻塞的)
Java IO中的设计模式:
装饰器模式:在不改变原有对象的情况下拓展其功能,使用组合,而不是继承。
- 比如,对于输入字节流,
FilterInputStream是装饰器的核心,用于增强InputStream的子类。 如常见的BufferedInputStream就是FilterInputStream的子类,可以将InputStream的子类传入 BufferedInputStream 来增强。
- 比如,对于输入字节流,
适配器模式:主要用于协调接口互不兼容的类。字符流和字节流的接口不同,它们之间的互动就是基于适配器模式来做的,具体说是 对象适配器。
InputStreamReader和OutputStreamWriter就是两个适配器(Adapter), 同时,它们两个也是字节流和字符流之间的桥梁。InputStreamReader使用StreamDecoder(流解码器)对字节进行解码,实现字节流到字符流的转换。而 InputStream 和 OutputStream 的子类就是是被适配者。
工厂模式:用于创建对象。NIO 中大量用到了工厂模式,比如
Files类的newInputStream方法用于创建InputStream对象(静态工厂);Paths类的get方法创建Path对象(静态工厂);ZipFileSystem类(sun.nio包下的类,属于java.nio相关的一些内部实现)的getPath的方法创建Path对象(简单工厂)。
观察者模式:又称 发布 - 订阅 模式,能让多个观察者对象同时监听一个主题对象。
NIO中的文件目录监听服务使用到了观察者模式。
语法糖
语法糖是为了方便程序员开发程序而设计的特殊语法,对编程功能无影响。
不过 JVM并不能识别语法糖,所以需要先通过编译器解糖,所以说支持语法糖的是Java编译器。
常见的语法糖:
for-each:实际就是普通for循环和迭代器。
switch支持String与枚举: switch只支持int和char等基本类型,char比较是比较其ascii码,即switch起始只能使用整型。 而switch比较String时,会使用String的 equals() 比较 hashCode()得到的哈希码。
泛型 :所有泛型类的类型参数在编译时都会被擦除,泛型类并没有自己独有的class对象,比如只有List.class,而没有 List<String>.class之类的。
不能通过泛型的不同传入参数来进行方法重载,因为泛型在编译阶段会被擦除,使得两个方法的特征变得一样。例:
1
2
3
4
5
6
7
8
9public class GenericTypes {
// 这样是无法通过编译的
public static void method(List<String> list) {
System.out.println("invoke method(List<String> list)");
}
public static void method(List<Integer> list) {
System.out.println("invoke method(List<Integer> list)");
}
}泛型的类型参数不能用在 Java 异常处理的 catch 语句中。因为异常处理是由 JVM 在运行时刻来进行的。由于类型信息被擦除,JVM 是无法区分两个异常类型
MyException<String>和MyException<Integer>的。泛型类的静态变量 同样也是共享的。由于经过类型擦除,所有的泛型类实例依然关联到同一份字节码上。
自动装箱与拆箱: 自动装箱实际调用的是valueOf(xx),自动拆箱实际调用了 xxxValue();
可变长参数:即方法最后一个参数可以有任意数量的值传入。 实际会将这个可变长参数转变为数组。
枚举类: 当我们使用
enum来定义一个枚举类型的时候,编译器会自动帮我们创建一个 final类型的类 继承Enum类,所以枚举类型不能被继承。数值字面量:允许在数字间插入任意多个下划线,这些下划线不会对数字产生影响,单纯是为了方便阅读。在编译阶段会删除这些下划线。
try-with-resource: 对于需要手动关闭的资源,如IO流、数据库连接, 可以在 try 后接一个括号,括号中建立连接对象,在语句块结束后会自动关闭连接,不用再去手动关闭。代码例子:
1
2
3
4
5
6
7
8try (BufferedReader br = new BufferedReader(new FileReader("d:\\ hollischuang.xml"))) {
String line;
while ((line = br.readLine()) != null) {
System.out.println(line);
}
} catch (IOException e) {
// handle exception
}在编译阶段,仍会转换出关闭资源的代码。
Lambda表达式: Lambda 表达式不是匿名内部类的语法糖,但是他也是一个语法糖。实现方式其实是依赖了几个 JVM 底层提供的 lambda 相关 api。(内部类在编译之后会有两个 class 文件,但是,包含 lambda 表达式的类编译后只有一个文件)
在编译阶段,会转换成调用内部api的方式。
。。。。。
集合
底层数据结构
Collection接口下的集合:
List:
- ArrayList: Object[] 数组
- Vector:Object[] 数组
- LinkedList:双向链表
Set:
- HashSet:基于HashMap实现
- LinkedHashSet: 是HashSet的子类,内部通过LinkedHashMap实现
- TreeSet:红黑树,即自平衡的排序二叉树
Queue:
- PriorityQueue: Object[] 数组实现二叉堆
- ArrayQueue:Object[]数组 + 双指针
Map接口下的集合:
- HashMap:jdk1.8以前是 数组 + 链表(数组是主体,链表是解决哈希冲突),jdk1.8以后, 解决哈希冲突的方法变更为:当链表长度大于8,且数组长度大于64,将链表转化为红黑树,以减少搜索时间。
- LinkedHashMap:在HashMap的 数组 + 链表/红黑树 结构上,增加了一条双向链表,使得能保持键值对的插入顺序。
- HashTable:数组 + 链表
- TreeMap:红黑树
Vector是List的古老实现类,线程安全,Stack继承自Vector,是一个先进先出的栈,这两者都已经被淘汰,需要并发集合的话,推荐使用 ConcurrentHashMap、CopyOnWriteArrayList等。
排序接口
Comparable接口 和 Comparetor接口 都是用于排序的接口。
Comparable接口出自 java.lang包,排序方法是 **compareTo(Object obj)**;
Comparable可以理解为内部比较器,一个类实现了该接口,并实现排序方法compareTo(),那进行排序时默认就是依据这个进行排序。
例如:Collections.sort() 不指定排序方法时,调用的是 list.sort(null),此时 list.sort(null) 调用了 Arrays.sort(a, (Comparator) c), 方法内部实际使用的排序逻辑是泛型参数所实现的compareTo()方法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17public static void main(String[] args) {
List<user> list = new ArrayList<>();
list.sort(null);
Collections.sort(list);
user[] users = new user[1];
Arrays.sort(users);
}
class user implements Comparable<user> {
private int age;
public int compareTo(user o) {
return this.age - o.age;
}
}也就是说,实现了Comparable接口的类的对象的列表或数组可以通过Collections.sort或Arrays.sort进行自动排序。
Comparator接口出自 java.util包,排序方法是 **compare(Object o1, Object o2)**;
可以理解为外部比较器,当要为没有比较方法的类进行排序,或者使用特定比较逻辑时,就需要一个“比较器”,这个“比较器”需实现Comparator接口。
1
2
3
4
5
6
7
8
9
10Collections.sort(list, new Comparator<user>() {
public int compare(user o1, user o2) {
return o1.age - o2.age;
}
});
// 或者写成lambda表达式
Collections.sort(list, (o1, o2) -> o1.age - o2.age);
// 或者使用 Comparator.comparingXxx(...)
Collections.sort(list, Comparator.comparingInt(o -> o.age));
描述与比较
比较 HashSet、LinkedHashSet 和 TreeSet 三者的异同:
HashSet、LinkedHashSet和TreeSet都是Set接口的实现类,都能保证元素唯一,并且都不是线程安全的。- 底层数据结构不同。
HashSet的底层数据结构是哈希表(基于HashMap实现)。LinkedHashSet的底层数据结构是链表和哈希表,元素的插入和取出顺序满足 FIFO。TreeSet底层数据结构是红黑树,元素是有序的,排序的方式有自然排序和定制排序。
- 底层数据结构不同又导致这三者的应用场景不同。
HashSet用于不需要保证元素插入和取出顺序的场景,LinkedHashSet用于保证元素的插入和取出顺序满足 FIFO 的场景,TreeSet用于支持对元素自定义排序规则的场景。
Queue与Deque的区别:
Queue是单端队列,只能从一端插入元素,另一端删除元素,实现上一般遵循 先进先出(FIFO) 规则。Queue扩展了Collection的接口,根据 因为容量问题而导致操作失败后处理方式的不同 可以分为两类方法: 一种在操作失败后会抛出异常(add(),remove(),element()),另一种则会返回特殊值(offer(),poll(),peek())。Deque是双端队列,在队列的两端均可以插入或删除元素。Deque扩展了Queue的接口, 增加了在队首和队尾进行插入和删除的方法,同样根据失败后处理方式的不同分为两类。
ArrayDeque与LinkedList的区别(两者都实现了Deque接口,都有队列的功能):
ArrayDeque是基于可变长的数组和双指针来实现,而LinkedList则通过链表来实现。ArrayDeque不支持存储NULL数据,但LinkedList支持。ArrayDeque插入时可能存在扩容过程, 不过均摊后的插入操作依然为 O(1)。虽然LinkedList不需要扩容,但是每次插入数据时均需要申请新的堆空间,均摊性能相比更慢。
从性能的角度上,选用 ArrayDeque 来实现队列要比 LinkedList 更好。此外,ArrayDeque 也可以用于实现栈。
什么是BlockingQueue:
BlockingQueue(阻塞队列)是一个接口,继承自Queue。BlockingQueue阻塞的原因是其支持当队列没有元素时一直阻塞,直到有有元素;还支持如果队列已满,一直等到队列可以放入新元素时再放入。BlockingQueue常用于生产者-消费者模型中,生产者线程会向队列中添加数据,而消费者线程会从队列中取出数据进行处理。实现类有以下几种:
ArrayBlockingQueue:使用数组实现的有界阻塞队列。在创建时需要指定容量大小,并支持公平和非公平两种方式的锁访问机制。LinkedBlockingQueue:使用单向链表实现的可选有界阻塞队列。在创建时可以指定容量大小,如果不指定则默认为Integer.MAX_VALUE。和ArrayBlockingQueue类似, 它也支持公平和非公平的锁访问机制。PriorityBlockingQueue:支持优先级排序的无界阻塞队列。元素必须实现Comparable接口或者在构造函数中传入Comparator对象,并且不能插入 null 元素。SynchronousQueue:同步队列,是一种不存储元素的阻塞队列。每个插入操作都必须等待对应的删除操作,反之删除操作也必须等待插入操作。因此,SynchronousQueue通常用于线程之间的直接传递数据。DelayQueue:延迟队列,其中的元素只有到了其指定的延迟时间,才能够从队列中出队。……
HashMap 和 Hashtable 的区别:
- 线程是否安全:
HashMap是非线程安全的,Hashtable是线程安全的,因为Hashtable内部的方法基本都经过synchronized修饰。(如果要保证线程安全的话就使用ConcurrentHashMap); - 效率: 因为线程安全的问题,
HashMap要比Hashtable效率高一点。另外,Hashtable基本被淘汰,不要在代码中使用它; - 对 Null key 和 Null value 的支持:
HashMap可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个;Hashtable 不允许有 null 键和 null 值,否则会抛出NullPointerException。 - 初始容量大小和每次扩充容量大小的不同:
- ① 创建时如果不指定容量初始值,
Hashtable默认的初始大小为 11,之后每次扩充,容量变为原来的 2n+1。HashMap默认的初始化大小为 16。之后每次扩充,容量变为原来的 2 倍。 - ② 创建时如果给定了容量初始值,那么
Hashtable会直接使用你给定的大小,而HashMap会将其扩充为 2 的幂次方大小(HashMap中的tableSizeFor()方法保证)。也就是说HashMap总是使用 2 的幂作为哈希表的大小。
- ① 创建时如果不指定容量初始值,
- 底层数据结构: JDK1.8 以后的
HashMap在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树),以减少搜索时间。Hashtable没有这样的机制。
为什么HashMap的容量大小是2的幂次方?
- 因为键值对存放的位置是 根据key计算得到的Hash值 确定的,Hash值int类型,需要对数组长度取模运算,如果直接用 % 符号效率较低,而如果除数n是2的幂次方,则在%操作中等价于 (n - 1) & Hash,位运算效率会更高。 即 n是2的n次方时, Hash % n = (n - 1) & Hash。
HashMap多线程扩容导致死循环问题:
- 当多个线程同时执行 rehash 进行扩容时,jdk1.7以前使用的链表头插法可能会导致链表中的节点指向错误的位置,从而形成一个环形链表,进而使得查询元素的操作陷入死循环无法结束。
- jdk1.8时,HashMap 采用了尾插法而不是头插法来避免链表倒置,使得插入的节点永远都是放在链表的末尾,避免了链表中的环形结构。 不过,多线程下使用还是会出现数据覆盖的问题,并发环境下,推荐使用
ConcurrentHashMap。
JDK 1.7 和 JDK 1.8 的 ConcurrentHashMap 实现有什么不同?
- 线程安全实现方式:JDK 1.7 采用
Segment分段锁来保证安全,Segment是继承自ReentrantLock。JDK1.8 放弃了Segment分段锁的设计,采用Node + CAS + synchronized保证线程安全,锁粒度更细,synchronized只锁定当前链表或红黑二叉树的首节点。 - Hash 碰撞解决方法 : JDK 1.7 采用拉链法,JDK1.8 采用拉链法结合红黑树(链表长度超过一定阈值时,将链表转换为红黑树)。
- 并发度:JDK 1.7 最大并发度是 Segment 的个数,默认是 16。JDK 1.8 最大并发度是 Node 数组的大小,并发度更大。
JDK 1.7 的 ConcurrentHashMap 结构图:
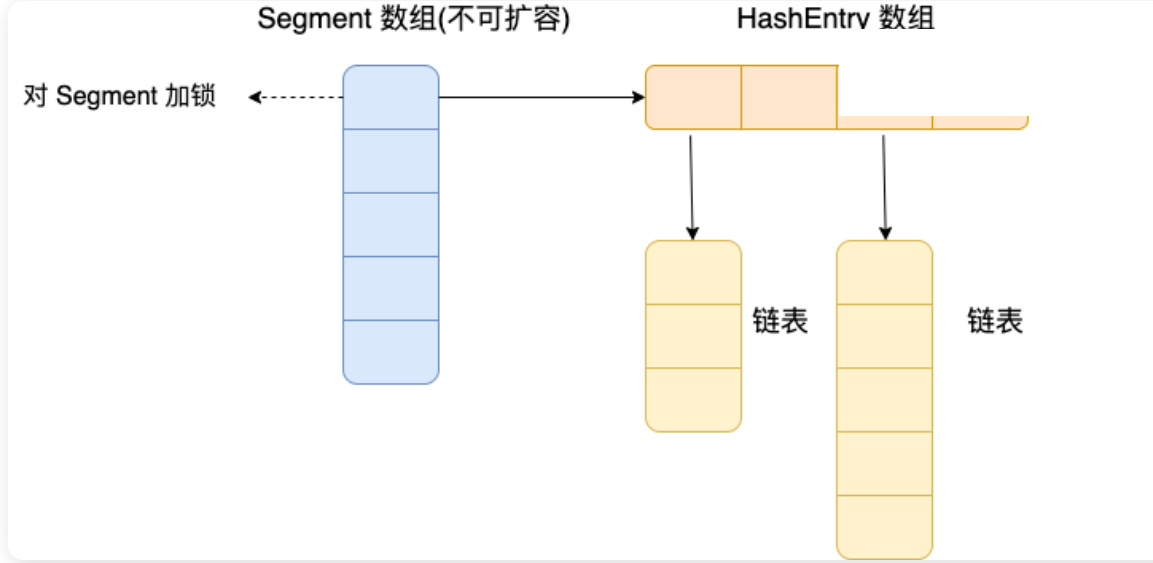
ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成。(Segment数组不能扩容)Segment数组中的每个元素包含一个HashEntry数组,每个HashEntry数组属于链表结构。JDK 1.8 的 ConcurrentHashMap 结构图:
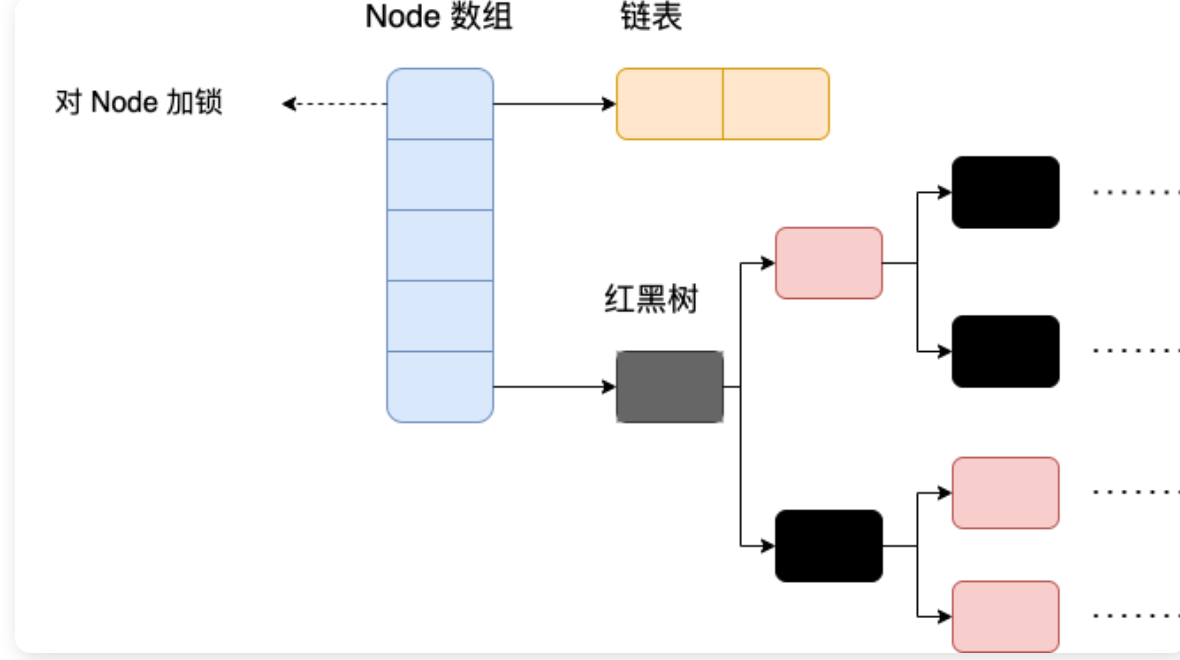
JDK1.8 的
ConcurrentHashMap是 Node 数组 + 链表 / 红黑树。不过,Node 只能用于链表的情况,红黑树的情况需要使用 **TreeNode**。当冲突链表达到一定长度时,链表会转换成红黑树。TreeNode是存储红黑树节点,被TreeBin包装。TreeBin通过root属性维护红黑树的根结点,因为红黑树在旋转的时候,根结点可能会被它原来的子节点替换掉,在这个时间点,如果有其他线程要写这棵红黑树就会发生线程不安全问题,所以在ConcurrentHashMap中TreeBin通过waiter属性维护当前使用这棵红黑树的线程,来防止其他线程的进入。
并发
并发: 两个及两个以上的作业在同一时间段内执行。(宏观上的同时执行)
并行:两个及两个以上的作业在同一时刻执行。(微观上的同时执行,真的同时执行)
同步:发出一个调用后,在没有得到结果之前,该调用会一直等待。
异步:调用在发出之后,不用等待返回结果,该调用直接返回。
进程、线程、协程
**进程: **
进程就是程序的一次执行过程,可以视为程序的一个实例,是系统运行程序的基本单位,因此进程是动态的。
比如:Java中启动main函数就是启动一个JVM的进程,main函数是这个进程中的主线程; 在Windows的任务管理器,可以看到当前运行的应用,也是一个进程(.exe文件的运行)
大部分程序可以同时运行多个实例进程(例如记事本、画图、浏览器
等),也有的程序只能启动一个实例进程(例如网易云音乐、360 安全卫士等)
线程:
线程与进程相似,是一个更小的执行单位。进程在执行过程中会产生多个线程。
多个线程共享该进程的堆和方法区(1.8之后的实现是本地内存的元空间),线程各自拥有自己的程序计数器,虚拟机栈,本地方法栈。所以系统生产一个线程或线程间切换工作,负担都比进程小的多,因此线程也可称为轻量级进程。
总结: 线程是进程划分成的更小的运行单位。不同点在于,进程是相互独立的,而同一进程中的线程可能会相互影响。线程执行开销小,但不利于资源管理和保护,进程相反。
协程:
协程,是一种比线程更加轻量级的存在。正如一个进程可以拥有多个线程一样,一个线程也可以拥有多个协程。
最重要的是,协程不是被操作系统内核所管理,而完全是由程序所控制(也就是在用户态中执行)。这样带来的好处就是性能得到了很大的提升,不会像线程切换那样消耗资源。 因为协程拥有自己的寄存器上下文和栈,协程调度切换时,将寄存器上下文和栈保存到其它地方,在切回来的时候,恢复先前保存的寄存器上下文和栈,直接操作栈是基本没有内核切换的开销,
同时,因为线程进程都是同步机制,而协程则是异步机制。 协程可以不加锁的访问全局变量,所以上下文的切换非常快。
Java原生语法没有实现协程,虽然有某些开源框架实现了,但也很少用。
线程的痛点:
- 涉及到同步锁;
- 涉及到线程阻塞状态和可运行状态之间的切换;
- 涉及线程的上下文切换;
这三点都是很耗费性能的操作。
多线程
为什么要使用多线程?
- 从计算机底层来说: 线程是程序执行的最小单位, 线程间的切换和调度的成本远远小于进程。另外,有多核 CPU 时代意味着多个线程可以同时运行,这减少了线程上下文切换的开销。而对于单个CPU,多线程可以提高进程利用CPU和IO的效率(线程请求IO而阻塞时可以切换另一个线程继续使用CPU)。
- 从当代互联网发展趋势来说: 现在的系统常要求百万级甚至千万级的并发量,而多线程并发编程正是开发高并发系统的基础,利用好多线程机制可以大大提高系统整体的并发能力以及性能。
多线程的问题: 内存泄漏,死锁,线程不安全等
线程的生命周期: 以下6种
NEW: 初始状态,线程被创建出来但没有被调用 start() 。RUNNABLE: 运行状态,线程被调用了 start()等待运行的状态。(也就是RUNNING和READY,分别是运行中和就绪状态)BLOCKED:阻塞状态,需要等待锁释放。WAITING:等待状态,表示该线程需要等待其他线程做出一些特定动作(通知或中断)。TIME_WAITING:超时等待状态,可以在指定的时间后自行返回而不是像 WAITING 那样一直等待。TERMINATED:终止状态,表示该线程已经运行完毕。
操作系统层面,线程区分READY和RUNNING状态,而JVM并不区分,将两个状态统称为RUNNABLE状态。
因为JVM认为线程单次能运行的时间太短(RUNNING状态,可能就0.01s),很快就回调用队列了(READY状态),线程切换很快,没必要区分这两种状态。
当线程执行 wait() 之后,线程就进入 WAITING 状态,此时线程需要依靠其他线程的通知才能回到运行状态。
通过加上超时限制,如sleep(long millis)或wait(long millis) 可以使线程进入 TIME_WAITING 状态。 时间到了线程会回到运行状态。
当线程进入synchronized同步控制的方法或块时,锁被其他线程占用,该线程就会进入BLOCKED状态。
上下文切换:
线程在执行过程中 有自己的运行条件和状态,就是上下文。 如线程的程序计数器,栈信息等。
当线程让出CPU并且线程还未终止时,也就是发生线程切换时,就要保存当前线程的上下文(保留现场),方便下次占用时恢复现场。
让出CPU的情况有
- 主动让出,如调用了sleep(),wait()。
- 时间片用完。
- 调用了阻塞类型的系统中断,如请求IO。
- 线程终止/结束运行
线程死锁:
多个线程同时被阻塞,它们等待的资源被彼此占有且不释放,这样线程就被无限期地阻塞,因此程序不能正常结束。
死锁发生的四个必要条件:
- 互斥条件:该资源任意一个时刻只由一个线程占用。
- 请求并保持:一个线程因请求资源而阻塞时,对以获得的资源保持不放。
- 不剥夺条件:线程以获得的资源在未使用完之前不能被其他线程强行剥夺,只能自己选择释放。
- 循环等待:若干线程之间形成一种头尾相接的循环等待资源的关系。
预防死锁: 只需破坏死锁产生的必要条件即可
- 破坏“请求并保持条件”:一次性申请所有的资源;
- 破坏“不剥夺条件“:占用部分资源的线程进一步申请其他资源时,如果申请不到,可以主动释放它占有的资源。
- 破坏”循坏等待条件“:按序申请资源,释放资源则反序释放。
避免死锁:
- 在资源分配时,使用算法(如银行家算法)对资源分配进行计算评估,保证其进入安全状态(系统按某种顺序为线程分配资源,使所有线程都能顺利完成)。
sleep()方法和wait()方法对比:
共同点:两者都可以暂停线程的执行。
区别:
sleep()方法没有释放锁,而wait()方法释放了锁 。sleep()通常被用于暂停执行。wait()通常被用于线程间交互/通信,sleep()方法执行完成后,线程会自动苏醒;wait()方法被调用后,线程不会自动苏醒,需要别的线程调用同一个对象上的notify()或者notifyAll()方法。或者也可以使用wait(long timeout)超时后线程会自动苏醒。sleep()是Thread类的静态本地方法,wait()则是Object类的本地方法。
为什么wait()方法定义为本地方法?
- 每个对象(
Object)都拥有对象锁,而wait()是让获得对象锁的线程实现等待,会自动释放当前线程占有的对象锁。 既然要释放当前线程占有的对象锁并让其进入 WAITING 状态,自然是要操作对应的对象(Object)而非当前的线程(Thread)。
为什么sleep()方法定义在Thread中?
- 因为
sleep()是让当前线程暂停执行,不涉及到对象类,也不需要获得对象锁。
Java锁的种类
- 乐观锁、悲观锁(是一种概念)
- 独享锁、共享锁(是一种概念)
- 公平锁、非公平锁(是一种概念)
- 互斥锁、读写锁(是具体的实现)
- 可重入锁(是一种概念)
- 分段锁(是一种涉及)
- 锁升级(无锁 -> 偏向锁 -> 轻量级锁 -> 重量级锁)JDK1.6
乐观锁:乐观锁认为一个线程去拿数据的时候不会有其他线程对数据进行更改,所以不会上锁。 实现方式:CAS机制、版本号机制
悲观锁:悲观锁认为一个线程去拿数据时一定会有其他线程对数据进行更改。所以一个线程在拿数据的时候都会顺便加锁,这样别的线程此时想拿这个数据就会阻塞。比如Java里面的synchronized关键字的实现就是悲观锁。 实现方式:就是直接加锁。
独享锁:该锁一次只能被一个线程所持有
共享锁:该锁可以被多个线程所持有
独享锁与共享锁通过AQS(AbstractQueuedSynchronizer)来实现的,通过实现不同的方法,来实现独享或者共享。
例子:
synchronized是独享锁;可重入锁ReentrantLock是独享锁;
读写锁ReentrantReadWriteLock中的读锁ReadLock是共享锁,写锁WriteLock是独享锁。
互斥锁:具体实现就是synchronized、ReentrantLock。 (ReentrantLock是JDK1.5的新特性,采用ReentrantLock可以完全替代替换synchronized传统的锁机制,更加灵活。)
读写锁:具体实现就是读写锁ReadWriteLock。
可重入锁:对于同一个线程在外层方法获取锁的时候,在进入内层方法时也会自动获取锁。可以有效避免死锁。 具体实现:ReentrantLock、synchronized
公平锁:多个线程相互竞争时要排队,多个线程按照申请锁的顺序来获取锁。
非公平锁:多个线程相互竞争时,先尝试插队,插队失败再排队,比如:synchronized、ReentrantLock
分段锁: 分段锁的设计目的是细化锁的粒度,当操作不需要更新整个数组的时候,就仅仅针对数组中的一项进行加锁操作。 例如:CurrentHashMap底层就用了分段锁,使用Segment,就可以进行并发使用了,
乐观锁和悲观锁
悲观锁:总是假设最坏的情况,认为共享资源每次被访问的时候就会出现问题,所以每次在获取资源操作的时候都会上锁。 —— 也就是说,共享资源每次只给一个线程使用,其它线程阻塞,用完后再把资源转让给其它线程。
synchronized和ReentrantLock等独占锁就是悲观锁。
1
2
3
4
5
6
7
8
9
10
11
12
13public void performSynchronisedTask() {
synchronized (this) {
// 需要同步的操作
}
}
private Lock lock = new ReentrantLock();
lock.lock();
try {
// 需要同步的操作
} finally {
lock.unlock();
}缺点:高并发的场景下,激烈的锁竞争会造成线程阻塞,进而增加系统的上下文切换,系统性能开销变大。并且,悲观锁还可能会存在死锁问题。
乐观锁:总是假设最好的情况,认为共享资源每次被访问的时候不会出现问题,线程可以不停地执行,无需加锁也无需等待,只是在提交修改的时候去验证对应的资源是否被其它线程修改了。
版本号机制 和 CAS算法 是乐观锁。(Atomic原子变量类就是使用了CAS算法)
1
2LongAdder sum = new LongAdder();
sum.increment();优点:高并发的场景下,乐观锁相比悲观锁来说,不存在锁竞争造成线程阻塞,也不会有死锁的问题,在性能上往往会更胜一筹。
缺点:如果冲突频繁发生(写占比非常多的情况),会频繁失败和重试,这样同样会非常影响性能,导致 CPU 飙升。
使用建议:
- 悲观锁通常多用于写比较多的情况下(多写场景,竞争激烈),这样可以避免频繁失败和重试影响性能,悲观锁的开销是固定的。不过,如果乐观锁解决了频繁失败和重试这个问题的话(比如
LongAdder),也是可以考虑使用乐观锁的,要视实际情况而定。 - 乐观锁通常多于写比较少的情况下(多读场景,竞争较少),这样可以避免频繁加锁影响性能。不过,乐观锁主要针对的对象是单个共享变量。
乐观锁的实现:
版本号机制:
一般是在数据表中加一个数据版本号 version字段,表示数据被修改的次数。当数据被修改时,version 加一。
线程要更新数据值时,在读取数据的同时也会读取version值,在提交更新时,若刚才读取到的version值==当前数据库中的version值 才更新,否则重试整个更新操作,重新读取,直到更新成功。
CAS算法:
Compare And Swap(比较与交换),即用一个预期值和要更新的变量值进行比较,相等时才会进行更新。
- CAS是一个原子操作,底层依赖于一条CPU的原子指令。
CAS的三个操作数:
- Var:要更新的变量值
- Expected:预期值,即一开始Var的值
- New:拟写入的新值
只有Var等于Expected时,CAS通过原子方式用新值New更新Var的值。如果不等,说明已经有其它线程更新了 Var,则当前线程放弃更新。
乐观锁存在的问题:
ABA问题:
如果一个变量一开始是A值,它可能被其他线程改为其他值,又改回A值,那 CAS 操作就会误认为它从来没有被修改过。
- 解决:在变量前追加版本号或时间戳。
AtomicStampedReference类可以用来解决 ABA 问题
- 解决:在变量前追加版本号或时间戳。
循环时间开销大:
CAS 经常会用到自旋操作来进行重试,如果长时间不成功,会给 CPU 带来非常大的执行开销。
- 如果 JVM 能支持处理器提供的 pause 指令那么效率会有一定的提升,pause 指令有两个作用:
- 可以延迟流水线执行指令,使 CPU 不会消耗过多的执行资源,延迟的时间取决于具体实现的版本,在一些处理器上延迟时间是零。
- 可以避免在退出循环的时候因内存顺序冲而引起 CPU 流水线被清空,从而提高 CPU 的执行效率。
- 如果 JVM 能支持处理器提供的 pause 指令那么效率会有一定的提升,pause 指令有两个作用:
只能保证一个共享变量的原子操作:
当操作涉及跨多个共享变量时 CAS 无效。
但是从 JDK 1.5 开始,提供了
AtomicReference类来保证引用对象之间的原子性,你可以把多个变量放在一个对象里来进行 CAS 操作
常见线程安全类
线程安全类是指,多个线程调用它们同一个实例的某个方法时,是线程安全的。(每个方法是原子的,但方法组合不是原子的)
- String
- Integer
- StringBuffer
- Random
- Vector
- Hashtable
- java.util.concurrent 包下的类
Atomic原子类
原子类: 具有原子操作特征的类。 原子类都在 java.util.concurrent.atomic 下。
原理(举例):
AtomicInteger类主要利用 CAS (compare and swap) + volatile 和 native 方法来保证原子操作,从而避免 synchronized 的高开销,执行效率大为提升。(值是volatile 变量,在内存中可见,因此 JVM 可以保证任何时刻任何线程总能拿到该变量的最新值。)
根据操作的数据类型,可以将 JUC 包中的原子类分为 4 类
基本类型
使用原子的方式更新基本类型
AtomicInteger:整型原子类AtomicLong:长整型原子类AtomicBoolean:布尔型原子类
1 | // 常用方法, 以AtomicInteger为例 |
1 | // 多线程下和基本数据类型的对比 |
数组类型
使用原子的方式更新数组里的某个元素
AtomicIntegerArray:整型数组原子类AtomicLongArray:长整型数组原子类AtomicReferenceArray:引用类型数组原子类
1 | // 常用方法, 以AtomicIntegerArray为例 |
引用类型
AtomicReference:引用类型原子类AtomicMarkableReference:原子更新带有标记的引用类型。该类将 boolean 标记与引用关联起来,也可以解决使用 CAS 进行原子更新时可能出现的 ABA 问题。AtomicStampedReference:原子更新带有版本号的引用类型。该类将整数值与引用关联起来,可用于解决原子的更新数据和数据的版本号,可以解决使用 CAS 进行原子更新时可能出现的 ABA 问题。
1 | // 使用例子 |
对象的属性修改类型
AtomicIntegerFieldUpdater:原子更新整型字段的更新器AtomicLongFieldUpdater:原子更新长整型字段的更新器AtomicReferenceFieldUpdater:原子更新引用类型里的字段
使用:
- 因为对象的属性修改类型原子类都是抽象类,所以每次使用都必须使用静态方法 newUpdater()创建一个更新器,并且需要设置想要更新的类和属性。
- 更新的对象属性必须使用 public volatile 修饰符。
1 | // 使用例子 |
Future类 - TODO
volatile关键字
volatile 关键字可以保证变量的可见性,如果我们将变量声明为 volatile ,这就指示 JVM,这个变量是共享且不稳定的,每次使用它都到主存中进行读取。
volatile关键字只保证数据的可见性,但不保证数据的原子性。synchronized关键字两者都能保证。volatile除了可以保证变量的可见性,还有一个重要的作用就是防止 JVM 的指令重排序。如果我们将变量声明为volatile,在对这个变量进行读写操作的时候,会通过插入特定的 内存屏障 的方式来禁止指令重排序。
关于指令重排, 假设new一个使用单例模式的对象实例,它的执行步骤可能为:
1 | public class Singleton { |
- 为
T分配内存空间 - 初始化
T - 将
T指向分配的内存地址
但是由于 JVM 具有指令重排的特性,执行顺序有可能变成 1->3->2。指令重排在单线程环境下不会出现问题,但是在多线程环境下会导致一个线程获得还没有初始化的实例。例如,线程 A 执行了 1 和 3,此时 B 调用 getT() 后发现 T 不为空,因此返回 T,但此时 T 还未被初始化。
锁的使用
Monitor:
Monitor 被翻译为监视器或管程,是一种syncronized的构造,每个 Java 对象都可以关联一个 Monitor 对象,如果使用 synchronized 给对象上锁(重量级)之后,该对象头的 Mark Word 就会被设置指向 Monitor 对象的指针。
Monitor能实现线程间的排斥和协作。排斥相当于竞争锁,协作相当于 生产和消费模式(wait,notify模式)。每个线程进入monitor会经过三个区域: entry set,the owner,wait set。
1. 进入monitor,此时是被分配在entry set 中,等待lock的拥有者释放锁;
2. 当线程获得lock就会成为lock的拥有者(仅有一个线程可以拥有),此时处于 the owner 区域;
3. 当释放lock就会进入wait set ,但是处于wait set 中的线程还是有机会获得lock的拥有权。
synchronized
使用:
synchronized用于多个线程之间访问资源的同步性,让资源在任意时刻只能有一个线程访问。
早期版本,synchronized是重量级锁,效率低。不过Java 6之后,synchronized经过了大量优化,加入了自旋锁、适应性自旋锁、锁消除、锁粗化、偏向锁、轻量级锁等技术来减少锁操作的开销。
使用:
- 修饰实例方法
- 修饰静态方法
- 修饰代码块
修饰实例方法,锁当前对象实例,进入该同步代码前要获得当前对象实例的锁。
1
2
3synchronized void method() {
//业务代码
}修饰静态方法,锁当前类,进入同步代码块前要获得当前class的锁。
1
2
3synchronized static void method() {
//业务代码
}修饰代码块,锁括号中的指定对象/类
1
2
3
4
5
6synchronized(对象) {
//业务代码
}
synchronized(类.class) {
//业务代码
}
原理:
Synchronized的重量级锁在Java JVM里的实现是基于进入和退出Monitor对象来实现方法同步和代码块同步的。任何对象都有一个monitor与之关联,当且一个monitor被持有后,它将处于锁定状态。(线程执行到monitor enter指令时,将会尝试获取对象所对应的monitor的所有权,即尝试获得对象的锁。)
synchronized用的锁是存在Java对象头里的Mark Word中,在运行期间,Mark Word里存储的数据会随着锁标志位的变化而变化:
| Mark Word | State |
|---|---|
| hash code:25 | age:4 | biased_lock:0 | 01 (锁标志位) | 无锁 |
| thread_id:23 | epoch:2 | age:4 | biased_lock:1 | 01 | 偏向锁 |
| ptr_to_lock_record:30 (指向栈中锁记录的指针) | 00 | 轻量级锁 |
| ptr_to_heavyweight_monitor:30 (指向monitor对象的指针) | 10 | 重量级锁 |
| 为空 | 11 | GC标记 |
锁一共有4种状态,级别从低到高依次是:无锁状态、偏向锁状态、轻量级锁状态和重量级锁状态,这几个状态会随着竞争情况逐渐升级, 且只能升级但不能降级。
偏向锁
在锁不存在多线程竞争情况下,为了减小线程获取锁的代价而引入了偏向锁。
当一个线程访问同步块并获取锁时,会在对象头和栈帧中的锁记录里存储锁偏向的线程ID(CAS设置偏向锁指向自己),以后该线程再进入同步块时只需简单判断下对象头的Mark Word里是否存储着的偏向锁指向的线程id是不是自己的就行。
- 升级为轻量级锁:由于持有偏向锁的线程使用完毕后不会主动释放锁,所以当有另一个线程判断当前对象是偏向锁,且偏向的线程还存在,则会进行锁升级: 暂停拥有偏向锁的线程A,设置锁标志位为00,并将对象头中的 Mark Word 和 线程A的栈帧中的锁记录交换位置(即CAS操作),然后持有锁的线程A会继续运行,竞争者会开始自选尝试获取该对象的锁。
显然,偏向锁只适用于从始至终都只有一个线程在运行的情况,省略掉了自旋获取锁,以及重量级锁互斥的开销,这种锁的开销最低,性能最好接近于无锁状态。但是如果线程之间存在竞争的话,就需要频繁的去暂停拥有偏向锁的线程然后检查状态,决定是否重新偏向还是升级为轻量级别锁,性能就会大打折扣了,如果事先能够知道可能会存在竞争那么可以选择关掉偏向锁。
轻量级锁
线程在执行同步块之前,JVM会先在当前线程的栈桢中创建用于存储锁记录的空间,并将对象头中的Mark Word复制到锁记录中。然后线程尝试使用CAS将对象头中的Mark Word替换为指向锁记录的指针。如果成功,当前线程获得锁,如果失败,表示其他线程竞争锁,当前线程便尝试使用自旋来获取锁。
- 升级为重量级锁:自旋次数超过n次(默认为10,可通过 -XX:PreBlockSpin 来更改),锁会升级为重量级锁,过程为:竞争者会设置锁标志位为10,并将对象头的 Mark Word 修改为指向Monitor对象的指针,然后将自己阻塞在该Monitor上。 当持有锁的线程要释放时,发现锁升级为重量级锁了,此时解锁失败,会直接将对象的monitor中的owner置为null,让通知竞争者去竞争该锁。
重量级锁
重量级锁也就是普通的悲观锁,即竞争锁失败会阻塞,然后等待唤醒再次竞争。 获得锁的线程会将该对象指向的Monitor中的owner设为自己,运行完后放入Monitor的wait set, 而竞争者则放在Monitor的entry set中,等待锁的释放。
ReentrantLock
ReentrantLock实现了 Lock 接口,是一个可重入且独占式的锁,和synchronized类似,但更灵活。其中增加了轮询,超时,中断,公平锁和非公平锁等高级功能。
ReentrantLock里面有一个内部类 Sync,Sync 继承 AQS(AbstractQueuedSynchronizer),添加锁和释放锁的大部分操作实际上都是在 Sync 中实现的。Sync 有公平锁 FairSync 和非公平锁 NonfairSync 两个子类。
1 | // ReentrantLock 默认使用非公平锁, 可以通过构造器来指定使用公平锁。 |
- 公平锁和非公平锁的底层都是使用AQS进行排队的,区别在于线程使用lock()加锁时:公平锁检查到有线程排队,会跟着排队;非公平锁则不会检查排队,而是直接竞争锁, 而没能竞争到锁时,非公平锁也会去排队。 在唤醒时,两者都只是唤醒队列前排的线程,是一样的。
使用:
加锁,释放锁: 释放锁的操作要放在finally块中,保证锁释放。
1
2
3
4
5
6
7
8Lock lock = new ReentrantLock();
lock.lock(); // 获取锁
try {
// 业务代码...
} finally {
lock.unlock(); // 释放锁
}ReentrantLock的加锁方式有:
- lock() —— 拿不到lock就不罢休,不然线程就一直阻塞。
- tryLock() —— 马上返回,拿到 lock就返回true,不然返回false。
- tryLock(long,TimeUnit) —— 带时间限制的tryLock(),拿不到lock,就等一段时间,超时返回false。
- lockInterruptibly() —— 调用后一直阻塞到获得锁,但是接受中断信号,此时会放弃获取锁。
- 在代码运行过程中抛出了InterruptedException,不论当前线程是否拥有锁,都会继续运行**run()**方法中捕获到异常部分代码块。
- 对一个线程,调用 interrupt() 时,1. 如果线程处于正常运行状态,只会将该线程的中断标志设为true,线程继续运行; 2. 如果线程处于阻塞状态(sleep,wait,join等),则立即退出阻塞状态,并抛出 InterruptedException 异常;
释放锁方式:
- unlock()
使用公平锁: 构造器传入true即为公平锁, 默认不传则为false,是非公平锁。
1
Lock lock = new ReentrantLock(true);
其他方法:
getHoldCount():当前线程调用 lock() 方法的次数。
getQueueLength():当前正在等待获取 Lock 锁的线程的估计数。
getWaitQueueLength(Condition condition):当前正在等待状态的线程的估计数,需要传入 Condition 对象。
hasWaiters(Condition condition):查询是否有线程正在等待与 Lock 锁有关的 Condition 条件。
hasQueuedThread(Thread thread):查询指定的线程是否正在等待获取 Lock 锁。
hasQueuedThreads():查询是否有线程正在等待获取此锁定。
isFair():判断当前 Lock 锁是不是公平锁。
isHeldByCurrentThread():查询当前线程是否保持此锁定。
isLocked():查询此锁定是否由任意线程保持。
ReentrantReadWriteLock
ReentrantReadWriteLock 实现了 ReadWriteLock ,是一个可重入的读写锁,既可以保证多个线程同时读的效率,同时又可以保证有写入操作时的线程安全。(一般锁的并发控制会读读互斥,而读写锁是 读读不互斥; 两种锁的读写,写写都是互斥的)
1 | public class ReentrantReadWriteLock |
ReentrantReadWriteLock 其实是两把锁,一把是 WriteLock (写锁),一把是 ReadLock(读锁) 。读锁是共享锁,写锁是独占锁。读锁可以被同时读,可以同时被多个线程持有,而写锁最多只能同时被一个线程持有。
- 在线程持有读锁的情况下,该线程不能取得写锁;
- 在线程持有写锁的情况下,该线程可以继续获取读锁(获取读锁时如果发现写锁被占用,只有写锁没有被当前线程占用的情况才会获取失败);
和 ReentrantLock 一样,ReentrantReadWriteLock 底层也是基于 AQS 实现的。
1 | // ReentrantReadWriteLock 也支持公平锁和非公平锁,默认使用非公平锁。 |
ThreadLocal
通常情况下,我们创建的变量是可以被任何一个线程访问并修改的,不过可以使用ThreadLocal,来让每一个线程都有自己的专属本地变量。
创建一个ThreadLocal变量,那么访问这个变量的每个线程都会有这个变量的本地副本,这也是ThreadLocal变量名的由来。各线程可以使用ThreadLocal变量的 get() 和 set(xxx) 方法来获取默认值或将其值更改为当前线程所存的副本的值,从而避免了线程安全问题。
- 使用: 可以将ThreadLocal变量包装进一个工具类,然后让线程调用。
原理:
从源代码可以看到,Thread 类中有一个 threadLocals 和 一个 inheritableThreadLocals 变量,它们都是 ThreadLocalMap 类型的变量,默认情况下这两个变量都是 null,只有当前线程调用 ThreadLocal 类的 set或get方法时才创建它们,实际上调用这两个方法的时候,我们调用的就是ThreadLocalMap类对应的 get()、set()方法。
所以,最终的变量是放在了当前线程的 ThreadLocalMap 中,并不是存在 ThreadLocal 上。ThrealLocal 类中可以通过Thread.currentThread()获取到当前线程对象后,直接通过getMap(Thread t)可以访问到该线程的ThreadLocalMap对象。
ThreadLocalMap 是 ThreadLocal 的静态内部类,底层是一个Entry的键值对数组,key是ThreadLocal对象,且是一个弱引用(弱引用,生命周期只能存活到下次GC前),value是要存放的变量;
一个线程最多只有一个ThreadLocalMap, 但是可以有多个ThreadLocal;
一个ThreadLocal对应一个变量数据,封装成Entry存到ThreadLocalMap中,所以就有多个Entry。比如有两个变量,就要建两个ThreadLocal对象;
ThreadLocal 内存泄露问题: 由于ThreadLocalMap中的key是弱引用,value是强引用,所以,如果
ThreadLocal没有被外部强引用的情况下,在垃圾回收的时候,key 会被清理掉,而 value 不会被清理掉。这样一来,
ThreadLocalMap中就会出现 key 为 null 的 Entry。假如不做任何措施的话,value 永远无法被 GC 回收,这个时候就可能会产生内存泄露。(尽管ThreadLocalMap会在get、set、remove时会清理key为null的记录,还是建议使用完 ThreadLocal 后手动调用remove方法)
1 | public class Thread implements Runnable { |
1 | public class ThreadLocal<T> { |
线程池
线程池就是管理一系列线程的资源池。当有任务要处理时,直接从线程池中获取线程来处理,处理完之后线程并不会立即被销毁,而是等待下一个任务。
使用线程池的好处:
- 降低资源消耗。通过重复利用已创建的线程降低线程 创建和销毁造成的消耗。
- 提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。
- 提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。
阿里巴巴开发手册要求:
- 线程资源必须通过线程池提供,不允许在应用中自行显式创建线程。
- 线程池不允许使用
Executors去创建,而是通过ThreadPoolExecutor构造函数的方式,这样的处理方式让开发人员更加明确线程池的运行规则,规避资源耗尽的风险。
线程池处理任务的流程:
- 提交任务
- 判断核心线程池是否已满 —— 未满,则创建线程;
- 核心线程池已满,判断等待队列是否已满 —— 未满,把任务加入队列;
- 等待队列已满,判断线程池是否已满 —— 未满,则创建线程;
- 线程池已满,则会拒绝任务,并则根据 饱和策略 来处理。
使用:
方式1. 通过 ThreadPoolExecutor 构造函数来创建(推荐)。
方式2. 使用 Executors 来创建 (不推荐)
ThreadPoolExecutor
构造函数如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26/**
* 用给定的初始参数创建一个新的ThreadPoolExecutor。
*/
public ThreadPoolExecutor(
int corePoolSize,//线程池的核心线程数量
int maximumPoolSize,//线程池的最大线程数
long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
TimeUnit unit,//时间单位
BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
) {
if (corePoolSize < 0 ||
maximumPoolSize <= 0 ||
maximumPoolSize < corePoolSize ||
keepAliveTime < 0)
throw new IllegalArgumentException();
if (workQueue == null || threadFactory == null || handler == null)
throw new NullPointerException();
this.corePoolSize = corePoolSize;
this.maximumPoolSize = maximumPoolSize;
this.workQueue = workQueue;
this.keepAliveTime = unit.toNanos(keepAliveTime);
this.threadFactory = threadFactory;
this.handler = handler;
}饱和策略/拒绝策略:
如果当前同时运行的线程数量达到最大线程数量并且队列也已经被放满了任务时,ThreadPoolTaskExecutor 定义一些策略:
- ThreadPoolExecutor.AbortPolicy: 抛出
RejectedExecutionException来拒绝新任务的处理。 - ThreadPoolExecutor.CallerRunsPolicy: 将任务回退给调用者,使用调用者的线程来执行任务,也就是直接在调用 execute方法的线程中运行(
run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。- 这种策略会降低对于新任务提交速度,影响程序的整体性能。如果程序可以承受此延迟并且要求任何一个任务请求都要被执行的话,可以选择这个策略。
- ThreadPoolExecutor.DiscardPolicy: 不处理新任务,直接丢弃掉。
- ThreadPoolExecutor.DiscardOldestPolicy: 此策略将丢弃最早的未处理的任务请求。
- ThreadPoolExecutor.AbortPolicy: 抛出
阻塞队列:
新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
BlockingQueue 阻塞队列,它的实现有:
- ArrayBlockingQueue, 是一个由数组实现的容量固定的有界阻塞队列。
- SynchronousQueue,是一个同步队列,消费者调用take()会发生阻塞,直到生产者产生一个元素,消费者才可以拿走并返回,同样的,生产者调用put()也会发生阻塞,直到有消费者消费了该元素,生产者才会返回。
- LinkedBlockingQueue,是一个单链表实现的无界阻塞队列,也提供了一个可选有界的构造参数。
其他队列:
DelayQueue 和 PriorityBlockingQueue底层都是使用二叉堆实现的优先级阻塞队列。
区别在于:
- 前者要求队列中的元素实现Delayed接口,通过执行时延从队列中提取任务,时间没到任务取不出来;
- 后者对元素没有要求,可以实现Comparable接口也可以提供Comparator来对队列中的元素进行比较,跟时间没有任何关系,仅仅是按照优先级取任务。
使用例子:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29// 这是一个简单的Runnable类,需要大约5秒钟来执行其任务。
public class MyRunnable implements Runnable {
private String command;
public MyRunnable(String s) {
this.command = s;
}
public void run() {
System.out.println(Thread.currentThread().getName() + " Start. Time = " + new Date());
processCommand();
System.out.println(Thread.currentThread().getName() + " End. Time = " + new Date());
}
private void processCommand() {
try {
Thread.sleep(5000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
public String toString() {
return this.command;
}
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;
public class ThreadPoolExecutorDemo {
private static final int CORE_POOL_SIZE = 5;
private static final int MAX_POOL_SIZE = 10;
private static final int QUEUE_CAPACITY = 100;
private static final Long KEEP_ALIVE_TIME = 1L;
public static void main(String[] args) {
//使用阿里巴巴推荐的创建线程池的方式
//通过ThreadPoolExecutor构造函数自定义参数创建
ThreadPoolExecutor executor = new ThreadPoolExecutor(
CORE_POOL_SIZE,
MAX_POOL_SIZE,
KEEP_ALIVE_TIME,
TimeUnit.SECONDS,
new ArrayBlockingQueue<>(QUEUE_CAPACITY),
new ThreadPoolExecutor.CallerRunsPolicy());
for (int i = 0; i < 10; i++) {
//创建WorkerThread对象(WorkerThread类实现了Runnable 接口)
Runnable worker = new MyRunnable("" + i);
//执行Runnable
executor.execute(worker);
}
//终止线程池
executor.shutdown();
while (!executor.isTerminated()) {
}
System.out.println("Finished all threads");
}
}
Executors
使用 Executors 可以创建多种类型的ThreadPoolExecutor:
- **
FixedThreadPool**:该方法返回一个固定线程数量的线程池。该线程池中的线程数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。 SingleThreadExecutor: 该方法返回一个只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。CachedThreadPool: 该方法返回一个可根据实际情况调整线程数量的线程池。初始大小为0。当有新任务提交时,如果当前线程池中没有线程可用,它会创建一个新的线程来处理该任务。如果在一段时间内(默认为60秒)没有新任务提交,核心线程会超时并被销毁,从而缩小线程池的大小。- **
ScheduledThreadPool**:该方法返回一个用来在给定的延迟后运行任务或者定期执行任务的线程池。
弊端:
- FixedThreadPool 和 SingleThreadExecutor 的任务队列是无界的LinkedBlockingQueue,最大长度Integer.MAX_VALUE, 如果堆积大量请求,可能会OOM。
- CachedThreadPool 使用的是同步队列 SynchronousQueue ,允许最多创建的线程数为Integer.MAX_VALUE, 当任务过多且执行速度较慢,会创建大量线程,导致OOM。
- ScheduledThreadPool 和 SingleThreadScheduledExecutor 使用的是无界的延迟阻塞队列 DelayedWorkQueue,最大长度Integer.MAX_VALUE, 同样会因为堆积大量请求,导致OOM。
AQS
AQS,即 AbstractQueuedSynchronizer ,翻译过来的意思就是抽象队列同步器。这个类在 java.util.concurrent.locks 包下面。 是一个抽象类,主要用来构建锁和同步器。
1 | public abstract class AbstractQueuedSynchronizer extends AbstractOwnableSynchronizer implements java.io.Serializable { |
AQS 为构建锁和同步器提供了一些通用功能的实现,因此,使用 AQS 能简单且高效地构造出应用广泛的大量的同步器,比如 ReentrantLock,Semaphore,ReentrantReadWriteLock,SynchronousQueue 都是基于AQS的。
AQS 核心思想:
- 如果被请求的共享资源空闲,则将当前请求资源的线程设置为有效的工作线程,并且将共享资源设置为锁定状态。
- 如果被请求的共享资源被占用,那么就需要一套线程阻塞等待以及被唤醒时锁分配的机制,这个机制 AQS 是用 CLH 队列锁 实现的,即将暂时获取不到锁的线程加入到队列中。
- CLH(Craig,Landin,Hagersten,是作者名)队列是一个虚拟的双向队列(即不存在队列实例,仅存在结点之间的关联关系)。AQS 是将每条请求共享资源的线程封装成一个 CLH 锁队列的一个结点(Node)来实现锁的分配。在 CLH 同步队列中,一个节点表示一个线程,它保存着线程的引用(thread)、 当前节点在队列中的状态(waitStatus)、前驱节点(prev)、后继节点(next)。
同步状态表示:
AQS使用 volatile 修饰的 int型成员变量 state 表示同步状态,通过内置的 线程等待队列 来完成 等待线程的排队工作。
1
2// 共享变量,使用volatile修饰保证线程可见性
private volatile int state;state 可以通过 getState(),setState(),compareAndSetState() 进行操作,这几个方法被 protected 和 finally 修饰,在之类中无法被重写。
1
2
3
4
5
6
7
8
9
10
11
12//返回同步状态的当前值
protected final int getState() {
return state;
}
// 设置同步状态的值
protected final void setState(int newState) {
state = newState;
}
//原子地(CAS操作)将同步状态值设置为给定值update如果当前同步状态的值等于expect(期望值)
protected final boolean compareAndSetState(int expect, int update) {
return unsafe.compareAndSwapInt(this, stateOffset, expect, update);
}以
ReentrantLock为例,state初始值为 0,表示未锁定状态。A 线程lock()时,会调用 tryAcquire() 独占该锁并将 state+1 。此后,其他线程再 tryAcquire() 时就会失败,直到 A 线程 unlock() 到 state=0(即释放锁)为止,其它线程才有机会获取该锁。当然,释放锁之前,A 线程自己是可以重复获取此锁的(state会累加),这就是可重入。但要注意,获取多少次就要释放多少次,这样才能保证 state 是能回到零态的。
Semaphore
Semaphore(信号量)是共享锁的一种实现,可以用来控制同时访问特定资源的线程数量。它将 AQS的state值构造为 permits,表示许可证的数量,只有拿到许可证的线程才能执行。
调用
semaphore.acquire(),线程尝试获取许可证,如果state >= 0的话,则表示可以获取成功。如果获取成功的话,使用 CAS 操作去修改 state 的值state=state-1。如果state<0的话,则表示许可证数量不足。此时会创建一个 Node 节点加入阻塞队列,挂起当前线程。调用
semaphore.release();,线程尝试释放许可证,并使用 CAS 操作去修改 state 的值state=state+1。释放许可证成功之后,同时会唤醒同步队列中的一个线程。被唤醒的线程会重新尝试去修改 state 的值state=state-1,如果state>=0则获取令牌成功,否则重新进入阻塞队列,挂起线程。
1 | // 初始共享资源数量 |
当初始的资源个数为 1 的时候,Semaphore 退化为排他锁。
Semaphore的构造方法可以选择公平和非公平模式,而许可数量 permits 是必填的。
1 | public Semaphore(int permits) { |
CountDownLatch
CountDownLatch 允许 count 个线程阻塞在一个地方,直至所有线程的任务都执行完毕。 它是一次性的,计数器的值只能在构造方法中初始化一次。
原理:
CountDownLatch 是共享锁的一种实现,它默认构造 AQS 的 state 值为 count。当线程使用 countDown() 方法时,其实使用了tryReleaseShared方法以 CAS 的操作来减少 state,直至 state 为 0 。
当调用 await() 方法的时候,如果 state 不为 0,那就证明任务还没有执行完毕,await() 方法就会一直阻塞,也就是说 await() 方法之后的语句不会被执行。直到count 个线程调用了countDown()使state值被减为0,或者调用await()的线程被中断,该线程才会从阻塞中被唤醒,await() 方法之后的语句得到执行。
使用例子:
读取处理 6 个文件,这 6 个任务都是没有执行顺序依赖的任务,但是要求返回给用户的时候将这几个文件的处理的结果进行统计整理。
1 | public class CountDownLatchExample1 { |
CyclicBarrier
CyclicBarrier 和 CountDownLatch 非常类似,它也可以实现线程间的技术等待。
CyclicBarrier,字面意思是可循环使用(Cyclic)的屏障(Barrier)。它要做的事情是:让一组线程到达一个屏障(也可以叫同步点)时被阻塞,直到最后一个线程到达屏障时,屏障才会开门,所有被屏障拦截的线程才会继续干活。
CycliBarrier 是基于 ReentrantLock和 Condition 的。(ReentrantLock 也属于 AQS 同步器)
原理:
CyclicBarrier 内部通过一个 count 变量作为计数器,count 的初始值为 parties 属性的初始化值,每当一个线程到了栅栏这里了,那么就将计数器减 1。如果 count 值为 0 了,表示这是这一代最后一个线程到达栅栏,就尝试执行我们构造方法中输入的任务。
1 | //每次拦截的线程数 |
JavaGuide那里有一些源码分析
JVM
Java虚拟机(Java Virtual Machine,JVM)是Java语言的核心组成部分,它是一种能够运行Java字节码的虚拟计算机。Java程序在运行时,首先需要将Java源代码编译成Java字节码文件(.class文件),然后由JVM进行解释和执行。
JVM具有独立于硬件平台的特点,它提供了一种抽象的计算机模型,使得Java程序可以在任何支持Java虚拟机的计算机上运行。JVM的主要作用是将Java字节码转换为本地机器指令,同时还提供了一些重要的功能,如内存管理、垃圾回收、线程管理、安全性管理等,以保证Java程序的安全性和稳定性。
JVM的工作原理可以简单概括为以下几个步骤:
- 加载:JVM通过类加载器(ClassLoader)从磁盘或网络中加载Java字节码文件,并将字节码转换为JVM内部的数据结构。
- 验证:JVM对字节码进行验证,检查字节码是否符合Java虚拟机规范,是否包含安全漏洞等。
- 准备:JVM为类变量(静态变量)分配内存,并设置默认值。
- 解析:JVM将符号引用转换为直接引用,即将类、方法和变量的引用解析为具体的内存地址。
- 初始化:JVM执行类的初始化代码,包括静态代码块和静态变量的赋值操作等。
- 执行:JVM执行Java字节码,将Java字节码解释为机器指令并执行,同时提供一些基本的服务,如垃圾回收、异常处理等。
除了上述基本功能,JVM还提供了一些高级功能,如动态编译、代码优化、多线程支持、远程调试等,这些功能为Java程序的开发和调试提供了重要的支持。
Java内存区域详解
JVM能自动管理内存,使得Java不容易发生内存泄漏和内存溢出,但如果真出现内存问题,就需要我们对JVM对内存的管理有一定的了解才能排错。
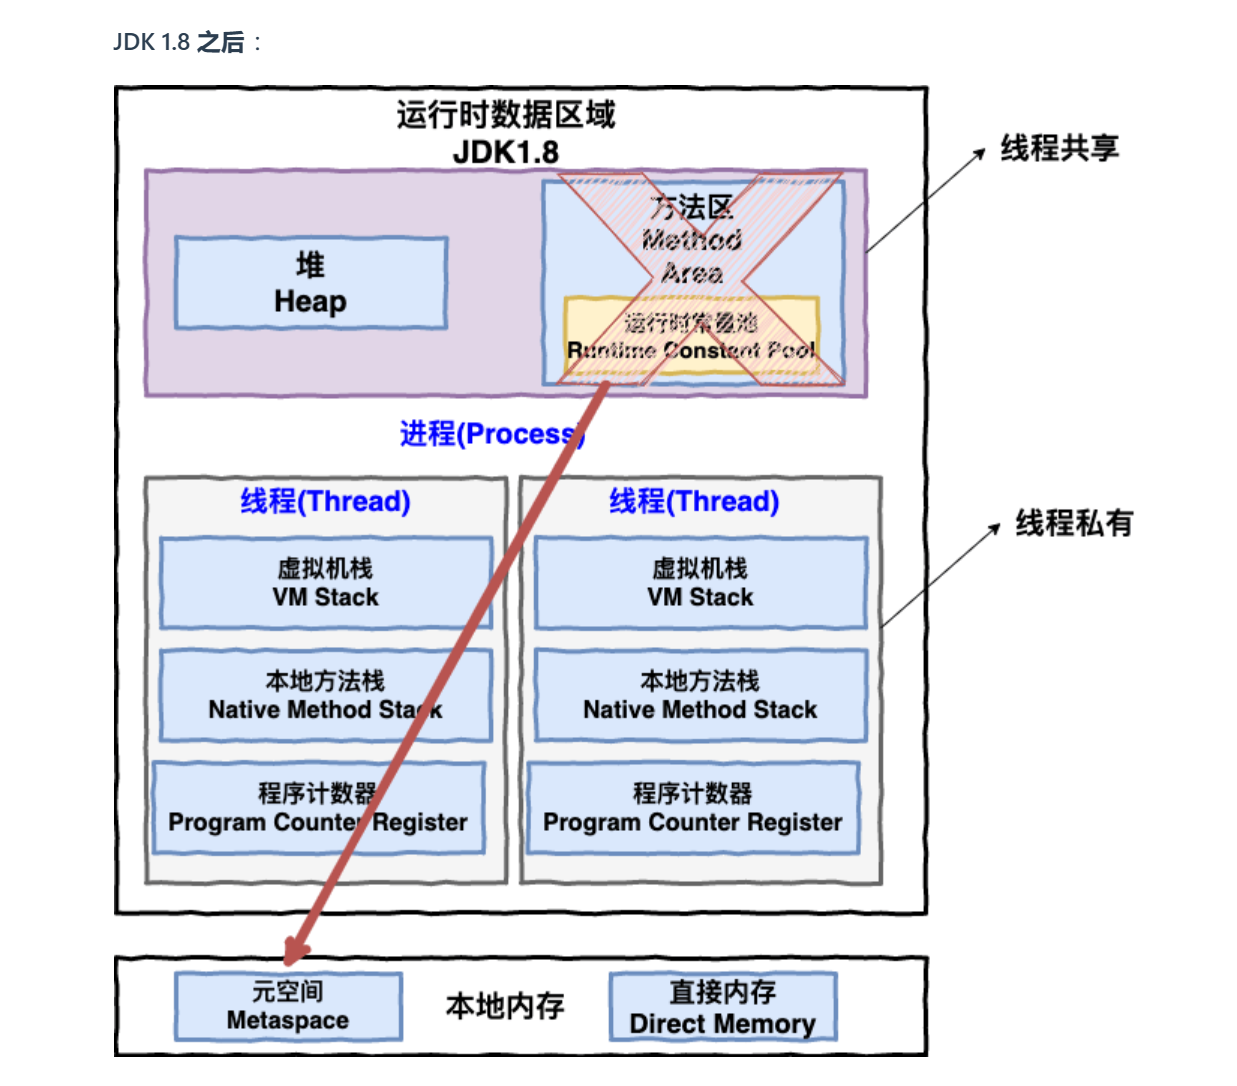
内存划分
JVM在运行Java程序时会对管理的内存区进行划分:
运行时数据区域,每一个进程都有:
- 堆 (1.8及以后,字符串常量和静态变量放在这里)
- 方法区:内含运行时常量池(1.8及以后移除方法区,用元空间替代)
- 每个线程的私有区域:
- 虚拟机栈
- 本地方法栈
- 程序计数器
本地内存:
元空间(1.8及以后才有,用于替代方法区)
直接内存(是非运行时数据区的一部分)
其中堆,方法区/元空间,直接内存都是线程共享的。
线程区域
程序计数器
是当前线程执行的字节码的行号指示器, 通过改变计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等功能都需要依赖这个计数器来完成。
作用: 代码流程控制,线程切换后恢复。
(程序计数器是唯一不会发生
OutOfMemoryError的内存区域,因为它的生命和线程一致,且不需要拓展空间)虚拟机栈
栈是JVM运行时数据区域的一个核心,基本所有的Java方法调用都是通过栈来实现的。
虚拟机栈和本地方法栈为线程私有,是为了保证线程中的局部变量不被别的线程访问到。
方法调用的数据需要通过栈进行传递,
每一次方法调用都会有一个对应的栈帧被压入栈中,每一个方法调用结束后,都会有一个栈帧被弹出。==栈帧==的组成:
- 局部变量表
- 操作数栈
- 动态链接
- 方法
局部变量表
主要存放了编译期可知的各种基本数据类型、对象引用(reference 类型,它不是对象本身,而是一个指向对象起始地址的引用指针,或者是指向一个代表对象的句柄)。
操作数栈
作为方法调用的中转站使用,用于存放方法执行过程中产生的中间计算结果和临时变量。
动态链接
当方法内需要调用其他方法,就需要用到动态链接。首先,Java程序编译后会得到每个类和接口各自的Class文件,里面包含了该类所有变量和方法的符号引用。 动态链接的作用就是将符号引用转换为调用目标方法的直接引用。
方法返回地址
Java 方法有两种返回方式,一种是 return 语句正常返回,一种是抛出异常。两者都会让栈帧被弹出。
虚拟机栈可能会出现的错误:
StackOverFlowError: 若栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前 Java 虚拟机栈的最大深度的时候,就抛出 StackOverFlowError 错误。OutOfMemoryError: 如果栈的内存大小可以动态扩展, 如果虚拟机在动态扩展栈时无法申请到足够的内存空间,则抛出OutOfMemoryError异常。
本地方法栈
本地方法栈和虚拟机栈类似,区别在于:虚拟机栈为虚拟机执行 Java 方法 (也就是字节码)服务,而本地方法栈则为虚拟机使用到的 Native 方法服务。
本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。
同样可能出现两种错误: StackOverFlowError 和 OutOfMemoryError。
堆
堆是Java 虚拟机所管理的内存中最大的一块,是所有线程共享的内存区域,在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,几乎所有的对象实例以及数组都在这里分配内存。
JIT有一个重要的优化,叫逃逸分析。JDK1.7默认开启逃逸分析,即方法中的对象引用没有被返回或未被外界使用(未逃逸出去),那么对象可以直接在栈上分配内存。
因为Java堆是垃圾收集器管理的主要区域,所以也被叫做GC堆(Garbage Collected Heap)。垃圾收集器一般都采用分代收集算法,即分为新生代和老年代。
Hotspot VM 的堆结构:
- 新生代内存: Eden + S0 + S1
- 老年代内存:Tenured
- 永久代:MetaSpace,即元空间 (JDK1.7及以前是PermGen,永久代内存空间)
– Tenured的内存空间要比新生代内存大的多;
– 新生代中Eden占80%的空间,Survivor0和Survivor1用于交换复制在Minor GC后还存活的对象。在16次Minor GC还存活的对象将送至老年代。(即进行minor GC时,会将Eden和其中一个Survivor的存活对象移动到另一个Survivor)
– 如果新对象在分配新生代空间时,空间不够并且立即进行一次minor GC后还是没有足够空间进行分配,就会通过 分配担保机制 把新生代的对象提前转移到老年代中去。
– 大对象(字符串、数组)因为需要大量连续内存空间,会直接进入老年代。
堆中最容易出现的错误:OutOfMemoryError。
方法区
方法区是JVM运行时数据区域的一块逻辑区域,是各个线程共享的内存区域。
方法区是一个抽象概念/规范,在JDK1.7,方法区的具体实现是永久代,在JDK1.8,方法区的实现是元空间。(它们的关系类似于接口和类)
- 方法区的作用: 当JVM要使用一个类时,它需要读取并解析 Class 文件获取相关信息,再将信息存入到方法区。方法区会存储已被虚拟机加载的 类信息、字段信息、方法信息、常量、静态变量、即时编译器编译后的代码缓存等数据。
为什么永久代会被替换:
永久代受JVM设置的固定大小所限,无法调节大小;
元空间使用的是本地内存,受本机可用内存限制;
—— 元空间内存溢出的几率比永久代小的多。
元空间存放的是类的元数据,这样加载多少类的元数据就不由 MaxPermSize 控制了, 而由系统的实际可用空间来控制,这样能加载的类就更多了。
(元数据:指描述数据的数据。在Java中元数据以标签(Annotation,注解)的形式存在于Java代码中,让文件或针在运行时知道被运行代码的描述信息。 元数据可以用于说明数据的名称、类型、范围、所属等)
运行时常量池:
Class文件中有存放编译期生成的各种字面量(Literal)和符号引用(Symbolic Reference)的 常量池表 (Constant Pool Table) 。
常量池表 会在类加载后存放到 方法区的运行时常量池中。
字面量:通过直面能直接知道 值,包括整数、浮点数、字符串字面量。
符号引用:用一组符号来描述引用的目标,能无歧义地定位到目标,与虚拟机的内存布局无关。(直接引用受虚拟机内存布局影响)
字符串常量池:
为了避免字符串重复创建而开辟的内存区域。
HotSpot 虚拟机中字符串常量池的实现是 src/hotspot/share/classfile/stringTable.cpp,
StringTable本质上就是一个HashSet<String>,容量为 StringTableSize。- StringTable保存的是字符串对象的引用,指向堆中的字符串对象。
- 1.7以前字符串常量放在方法区的永久代中,
1.8以后字符串常量和静态变量放到Java堆中。(因为永久代只有在整堆收集Full GC时才会被执行垃圾回收,而通常有许多被创建的字符串需要被回收,所以将字符串常量放到Java堆中,能高效回收字符串)
运行时常量池 和 字符串常量池 的变迁:
- JDK1.7 之前运行时常量池 逻辑包含 字符串常量池存放在方法区, 此时 hotspot 虚拟机对方法区的实现为永久代。
- JDK1.7 字符串常量池和静态变量被单独从方法区拿到了堆中, 而运行时常量池剩下的东西(即永久代)还在方法区。
- JDK1.8 hotspot 移除了永久代,用元空间(Metaspace)取而代之, 这时候字符串常量池还在堆, 运行时常量池还在方法区, 只不过方法区的实现从永久代变成了元空间(Metaspace)
— 运行时常量池、方法区、字符串常量池 这些都是不随虚拟机实现而改变的逻辑概念,是公共且抽象的;
— Metaspace、Heap 是与具体某种虚拟机实现相关的物理概念,是私有且具体的。
直接内存
直接内存并不在 Java 堆或方法区中分配的,而是通过 JNI (Java Native Interface,java本地接口)的方式在本地内存上分配的。
java的
NIO类,是一种基于通道(Channel)与缓存区(Buffer)的 I/O 方式,它可以直接使用 Native 函数库直接分配堆外内存,然后通过一个存储在 Java 堆中的DirectByteBuffer 对象作为这块内存的引用进行操作。这样就能在一些场景中显著提高性能,因为避免了在 Java 堆和 Native 堆之间来回复制数据。
对象创建过程
==类加载检查==
虚拟机遇到一条 new 指令时,首先将去检查这个指令的参数是否能在常量池中定位到这个类的符号引用,并且检查这个符号引用代表的类是否已被加载过、解析和初始化过。如果没有,那必须先执行相应的类加载过程。
==分配内存==
类加载过后,对象所需的内存大小确定了,可以开始分配内存。 有两种方式:
- 指针碰撞 :
- 适用场合:堆内存规整(即没有内存碎片)的情况下。(GC收集器使用“标记-整理”算法)
- 原理 :用过的内存全部整合到一边,没有用过的内存放在另一边,中间有一个分界指针,只需要向着没用过的内存方向将该指针移动对象内存大小位置即可。
- 使用该分配方式的 GC 收集器:Serial, ParNew
- 空闲列表 :
- 适用场合:堆内存不规整的情况下。(GC收集器使用“标记-清除”算法)
- 原理 :虚拟机会维护一个列表,该列表中会记录哪些内存块是可用的,在分配的时候,找一块儿足够大的内存块儿来划分给对象实例,最后更新列表记录。
- 使用该分配方式的 GC 收集器:CMS
内存分配有线程安全问题,一般采用CAS+失败重试,或使用TLAB分配
- 指针碰撞 :
==初始化零值==
内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头)。
这一步操作保证了对象的实例字段在 Java 代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值。
==设置对象头==
初始化零值后,虚拟机还需要为对象设置一些必要信息,这些信息存放在对象头中,如:对象是哪个类的实例、如何才能找到类的元数据信息、对象的哈希码、对象的 GC 分代年龄等信息。另外,根据虚拟机当前运行状态的不同,如是否启用偏向锁等,对象头会有不同的设置方式。
==执行init方法==
对虚拟机来说,此时对象已经产生,不过对于Java程序来说,对象创建才刚开始,一般来说,new指令之后会接着执行init方法,按程序逻辑进行初始化,这样一个对象才算真正产生。
对象的内存布局:
分为三部分:
- 对象头:
- 存储对象的运行时数据(哈希码,GC分代年龄,锁状态标志等)
- 存储类型指针(指向它的类元数据,能确定对象是哪个类的实例)
- 实例数据: 程序中定义的字段内容。
- 对齐填充: 仅起占位作为,因为Hotspot 虚拟机的自动内存管理系统要求对象起始地址必须是 8 字节的整数倍。
Java对象头,以32位虚拟机为例:
普通对象: Mark Word存储运行时数据或锁指针,Klass Word存储类型指针
Mark Word(32 bits) Klass Word(32bits) 数组对象
Mark Word(32 bits) Klass Word(32bits) array length(32bits) 其中Mark Word结构如下:
Mark Word State hash code:25 | age:4 | biased_lock:0 | 01 (锁标记位) Normal thread:23 | epoch:2 | age:4 | biased_lock:0 | 01 Biased ptr_to_lock_record:30 (指向栈中锁记录的指针) | 00 Lightweight Locked ptr_to_heavyweight_monitor:30 (指向互斥量/重量级锁的指针) | 10 Heavyweight Locked 为空 | 11 Marked for GC
对象的访问定位:
Java程序通过栈上的 reference 数据来操作堆上的具体对象。 具体的访问形式,当前主流的有两种方式:
直接指针
reference 中存储的直接就是对象的内存地址(这块内存中,也包含有 到对象类型数据的指针。)
- 特点:速度快,只用定位一次即可访问实例数据。
使用句柄
Java 堆中将会划分出一块内存来作为句柄池,reference 中存储的是对象的句柄地址,而句柄中包含了 对象实例数据与对象类型数据 各自的具体地址信息。
- 特点: reference 中存储的是稳定的句柄地址,在对象被移动时只会改变句柄中的实例数据指针,而 reference 本身不需要修改。(需要定位两次指针才能访问到实例数据)
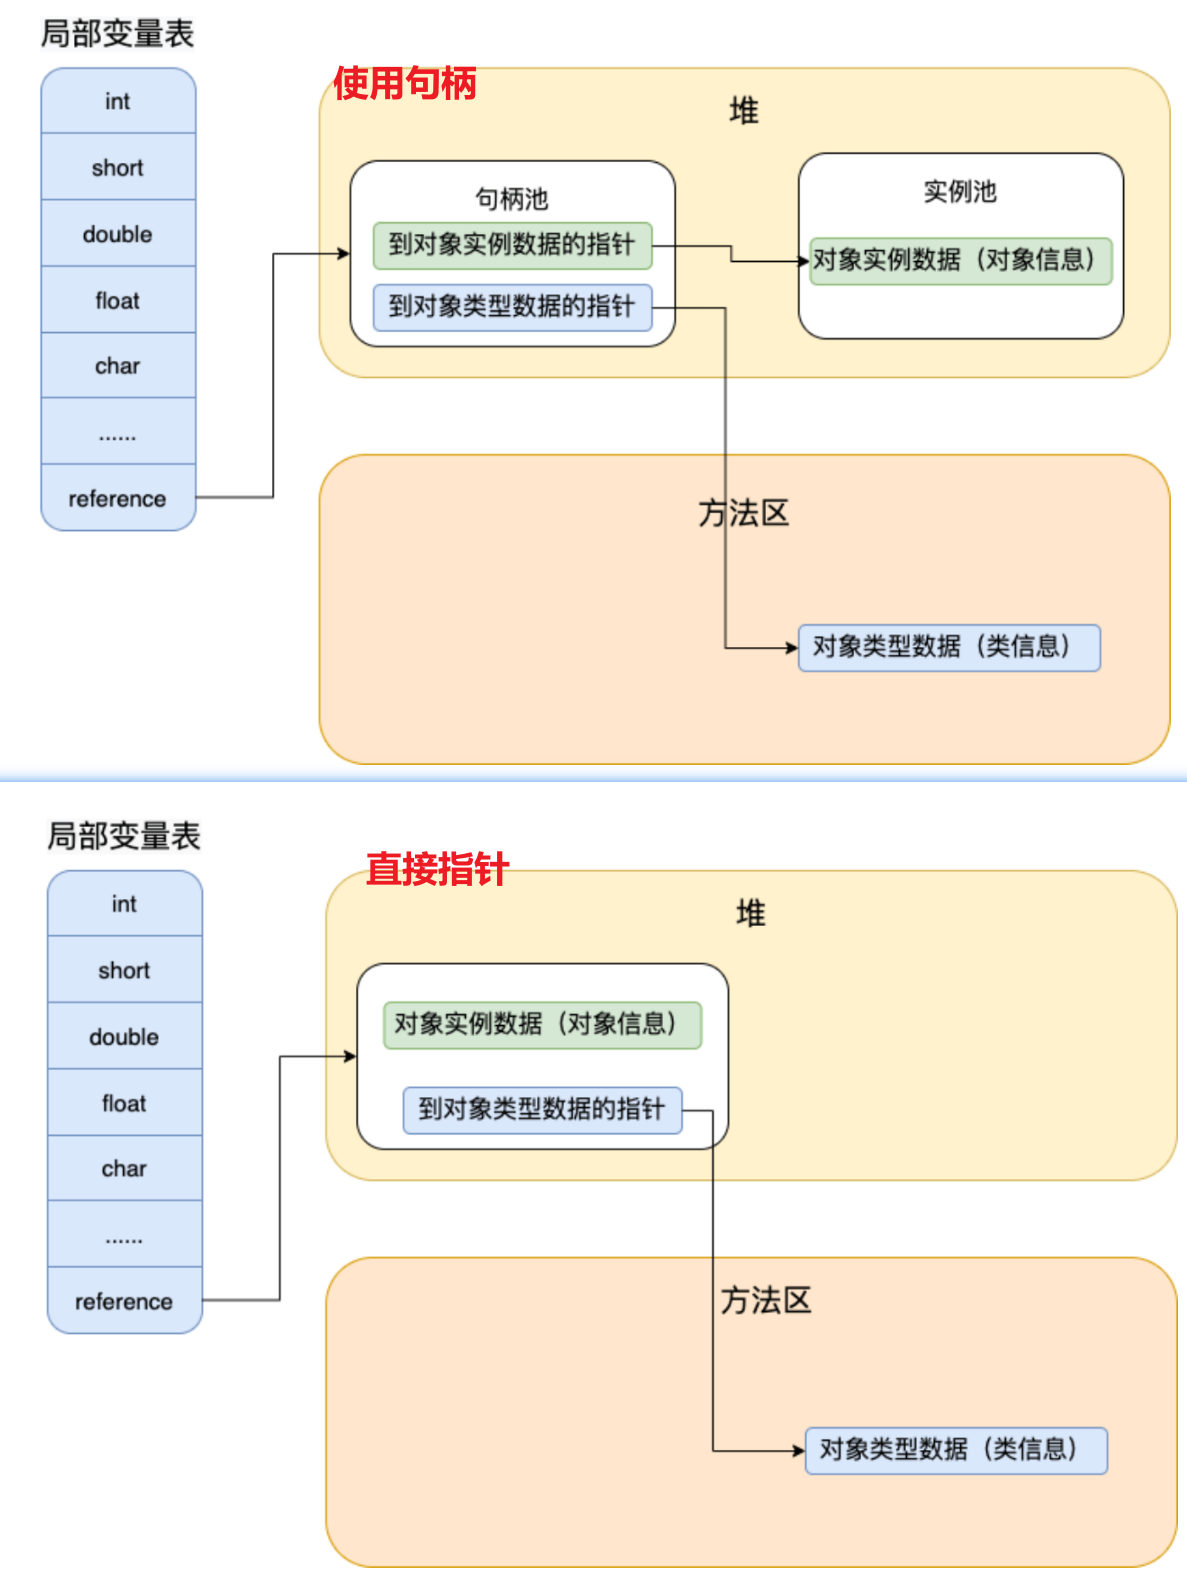
垃圾回收机制
针对 HotSpot VM 的实现,它里面的 GC 其实准确分类只有两大种:
部分收集 (Partial GC):
- 新生代收集(Minor GC / Young GC):只对新生代进行垃圾收集;
- 老年代收集(Major GC / Old GC):只对老年代进行垃圾收集。(注: Major GC 在一些语境中也用于指代整堆收集)
- 混合收集(Mixed GC):对整个新生代和部分老年代进行垃圾收集。
整堆收集 (Full GC):收集整个 Java 堆和方法区。
Partial: 部分的,局部的; minor: 较小的,次要的; major: 主要的
空间分配担保:
确保在 Minor GC 之前,老年代还有容纳新生代所有对象的剩余空间。
规则: 只要老年代的连续空间大于新生代对象总大小或者历次晋升的平均大小,就会进行 Minor GC,否则将进行 Full GC。
死亡对象判断
对堆的垃圾回收第一步:判断哪些对象已经死亡(不再被任何途径使用)。
引用计数法:
只需在对象中添加一个引用计数器:
- 每当有一个地方引用它,计数器就加1;
- 当一个引用失效,计数器就减1;
- 计数器为0的对象不可能再被使用。
引用计数法实现简单、效率高,但有个致命问题:不能解决对象间的相互循环引用问题。
对象间的相互循环引用问题:除了对象A和对象B相互引用对方之外,无其他任何引用。这样它两的引用计数器都不为0,导致无法被回收。
可达性算法:
以“GC Roots”对象为起点形成的引用链中的节点对象都是可用的,如果有对象与任何GC Roots没有引用链相连的话,这个对象就是不可用的,需要被回收。
可以被作为GC Roots的对象有:
- 虚拟机栈(栈帧中的本地变量表) 中引用的对象
- 本地方法栈(Native 方法) 中引用的对象
- 方法区中类静态属性 引用的对象
- 方法区中常量 引用的对象
- 所有被同步锁持有的对象
如何判断一个常量是废弃常量?
如果字符串常量池中的一个字符串”abc”,没有任何String对象引用该字符串常量,那么常量”abc”就是废弃常量,可被回收。
如何判断一个类是无用类? 需要满足以下3各条件才行:
- 该类所有的实例都已经被回收,也就是 Java 堆中不存在该类的任何实例。
- 加载该类的
ClassLoader已经被回收。 - 该类对应的
java.lang.Class对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法。
引用类型
Java判定对象的存活与”引用”相关。引用分为 强引用、软引用、弱引用、虚引用四种(引用强度逐渐减弱)
强引用:
平时使用的大部分引用都是强引用,这是默认的引用类型。当创建一个对象并赋值给一个变量时,这个变量就是该对象的强引用。
一个对象具有强引用,说明它是必不可少的,垃圾回收器就不会进行回收。(就算内存不足也不会回收,而是抛出OutOfMemoryError 错误让程序终止)
1
String str = new String("Hello, world!"); // 一般使用的变量赋值都是强引用
软引用:
一个对象只具有软引用,说明是可有可无的,垃圾回收器在内存足够时不会回收,在内存不足时会回收。
(平时很少用弱引用与虚引用,而使用软引用的情况较多,这是因为软引用可以加速 JVM 对垃圾内存的回收速度)
1
2
3
4
5// 创建一个字符串对象并创建一个软引用
String str = new String("Hello, world!");
SoftReference<String> softRef = new SoftReference<>(str);
str = null; // 此时str只有软引用,当内存不足时,垃圾回收器会尽可能回收只被软引用指向的对象弱引用:
一个对象只具有弱引用,说明是可有可无的,它的生命周期比软引用的对象更断。垃圾回收器如果发现只有弱引用的对象会直接进行回收。
1
2
3
4
5// 创建一个字符串对象并创建一个弱引用
String str = new String("Hello, world!");
WeakReference<String> weakRef = new WeakReference<>(str);
str = null; // 当对象只被弱引用所指向时,被垃圾回收器发现就会回收它虚引用:
虚引用几乎不对对象的生命周期产生影响。与软引用和弱引用不同,虚引用并不会影响对象的可达性和垃圾回收时机。虚引用主要用于跟踪对象被垃圾回收活动。
虚引用必须和引用队列(ReferenceQueue)联合使用。当垃圾回收器准备回收一个对象时,如果发现它还有虚引用,就会在回收对象的内存之前,把这个虚引用加入到与之关联的引用队列中。程序可以通过判断引用队列中是否已经加入了虚引用,来了解被引用的对象是否将要被垃圾回收。程序如果发现某个虚引用已经被加入到引用队列,那么就可以在所引用的对象的内存被回收之前采取必要的行动。
(软引用和弱引用同样可以关联一个引用队列,来看对象是否被回收或在回收前采取行动)
1
2
3
4
5
6
7
8
9
10
11
12// 创建一个字符串对象并创建一个虚引用
String str = new String("Hello, world!");
ReferenceQueue<String> queue = new ReferenceQueue<>();
PhantomReference<String> phantomRef = new PhantomReference<>(str, queue);
// 当垃圾回收器回收被虚引用所指向的对象时,虚引用将被放入引用队列
str = null;
System.gc(); // 手动触发垃圾回收器
Reference<? extends String> ref = queue.poll();
if (ref != null) {
// 对象已被回收
}
垃圾收集算法
标记-清除 算法
首先标记出所有不需要回收的对象,在标记完成后统一回收掉所有没有被标记的对象。它是最基础的收集算法,后续的算法都是对其不足进行改进得到。
不足: 效率问题, 空间问题(会产生大量碎片空间)
标记-复制 算法
标记-复制算法 可以将内存分为大小相同的两块,每次使用其中的一块。当这一块的内存使用完后,就将还存活的对象复制到另一块去,然后再把使用的空间一次清理掉。这样就使每次的内存回收都是对内存区间的一半进行回收。
(只需遍历一半内存空间,不会产生碎片空间)
标记-整理 算法
标记过程仍然与“标记-清除”算法一样,但后续步骤是让所有存活的对象向一端移动,然后直接清理掉端边界以外的内存。
当前虚拟机的垃圾收集都采用分代收集算法,可以根据不同年代的特点选择合适的垃圾收集算法。
比如在新生代中,每次收集都会有大量对象死去,所以可以选择”标记-复制“算法,只需要付出少量对象的复制成本就可以完成每次垃圾收集。
而老年代的对象存活几率是比较高的,而且没有额外的空间对它进行分配担保,所以我们必须选择“标记-清除”或“标记-整理”算法进行垃圾收集。
垃圾收集器
Serial收集器
Serial(串行)收集器是一个单线程收集器。这意味着它只会使用一条垃圾收集线程去完成垃圾收集工作,并且在进行垃圾收集工作的时候必须暂停其他所有的工作线程( “Stop The World” ),直到它收集结束。
Serial 收集器由于没有线程交互的开销,自然可以获得很高的单线程收集效率。对于运行在 Client 模式下的虚拟机来说是个不错的选择。
ParNew收集器
是Serial收集器的多线程版本。(工作线程仍要暂停)
ParNew收集器是许多运行在 Server 模式下的虚拟机的首要选择,除了 Serial 收集器外,只有它能与 CMS 收集器(真正意义上的并发收集器)配合工作。
Parallel Scavenge收集器 (并行清理收集器)(JDK1.8默认收集器)
Parallel Scavenge 收集器关注点是吞吐量(高效率的利用 CPU)。CMS 等垃圾收集器的关注点更多的是用户线程的停顿时间(提高用户体验)。
所谓吞吐量就是 CPU 中用于运行用户代码的时间与 CPU 总消耗时间的比值。 Parallel Scavenge 收集器提供了很多参数供用户找到最合适的停顿时间或最大吞吐量。
Serial Old收集器 :Serial收集器的老年代版本
Parallel Old收集器 :Parallel Scavenge收集器的老年代版本。
CMS收集器
CMS(Concurrent Mark Sweep)收集器是一种以获取最短回收停顿时间为目标的收集器。它非常符合在注重用户体验的应用上使用。
( 是HotSpot 虚拟机第一款真正意义上的并发收集器,它第一次实现了让垃圾收集线程与用户线程(基本上)同时工作。)
采用“标记-清除”算法实现,运行过程分四步:
- 初始标记: 暂停所有的其他线程,并记录下直接与 root 相连的对象,速度很快 ;
- 并发标记: 同时开启 GC 和用户线程,用一个闭包结构去记录可达对象。但因为用户线程可能会不断的更新引用域,所以这个闭包结构并不能保证包含当前所有的可达对象。所以此算法在这阶段会跟踪记录这些发生引用更新的地方。
- 重新标记: 重新标记阶段就是为了修正并发标记期间因为用户程序继续运行而导致标记产生变动的那一部分对象的标记记录,这个阶段的停顿时间一般会比初始标记阶段的时间稍长,比并发标记阶段时间短很多。
- 并发清除: 开启用户线程,同时 GC 线程开始对未标记的区域做清扫。
优点: 并发收集,低停顿
缺点:对CPU资源敏感;无法处理浮动垃圾;会产生碎片空间。
G1收集器
G1 (Garbage-First) 是一款面向服务器的垃圾收集器, 主要针对配备多颗处理器及大容量内存的机器。 以极高概率满足 GC 停顿时间要求的同时,还具备高吞吐量性能特征。
特点:并行+并发(利用多个CPU优势),空间整合(标记-整理算法),可预测停顿时间
步骤:初始标记——并发标记——最终标记——筛选回收
G1 收集器在后台维护了一个优先列表,每次根据允许的收集时间,优先选择回收价值最大的 Region(这也就是它的名字 Garbage-First 的由来) 。
这种使用 Region 划分内存空间以及有优先级的区域回收方式,保证了 G1 收集器在有限时间内可以尽可能高的收集效率(把内存化整为零)
类文件结构
根据 Java 虚拟机规范,Class 文件通过 ClassFile 定义,有点类似 C 语言的结构体。
ClassFile 的结构如下:
1 | ClassFile { |
魔数 Magic Number
每个 Class 文件的头 4 个字节称为魔数(Magic Number),它的唯一作用是确定这个文件是否为一个能被虚拟机接收的 Class 文件。
Class文件版本号 Minor&Major Version
紧接着魔数的四个字节存储的是 Class 文件的版本号:第 5 和第 6 位是次版本号,第 7 和第 8 位是主版本号。
当 Java 发布大版本(比如 Java 8,Java9)的时候,主版本号都会加 1。使用
javap -v命令可以快速查看 Class 文件的版本号信息。高版本的 Java 虚拟机可以执行低版本编译器生成的 Class 文件,但是低版本的 Java 虚拟机不能执行高版本编译器生成的 Class 文件。
常量池 Constant Pool
1
2u2 constant_pool_count;//常量池的数量
cp_info constant_pool[constant_pool_count-1];//常量池注:常量池计数器是从 1 开始计数的,索引值为 0 代表“不引用任何一个常量池项”。
常量池存放两大常量: 字面量和符号引用,
- 字面量: 可以说是常量,如文本字符串,声明为final的常量值等。
- 符号引用:属于编译原理方面的概念,有三类:
- 类和接口 的全限定名
- 字段 的名称和描述符
- 方法 的名称和描述符
.class文件可以通过javap -v class类名指令来看一下其常量池中的信息(javap -v class类名-> temp.txt:将结果输出到 temp.txt 文件)。访问标志 Access Flags
这个标志用于识别一些类或接口层次的访问信息,如:这个 Class 是类还是接口,是否为 public 或者 abstract 类型,如果是类的话是否声明为 final 等等。
通过
javap -v class类名指令来看一下类的访问标志。当前类(This Class)、父类(Super Class)、接口(Interfaces)索引集合
Java 类的
继承关系由类索引、父类索引和接口索引集合三项确定。类索引确定这个类的全限定名,父类索引确定这个类的父类的全限定名,由于 Java 语言的单继承,所以父类索引只有一个,除了
java.lang.Object之外,所有的 Java 类都有父类,因此除了java.lang.Object外,所有 Java 类的父类索引都不为 0。接口索引集合用来描述这个类实现了那些接口。
字段表集合 Fields
用于描述 接口或类 中声明的变量。包括类的变量和实例变量,不包括方法内的局部变量。
field info(字段表)的结构:
1
2
3
4
5
6
7field_info {
u2 access_flags; // 作用域
u2 name_index; // 字段名称(引用)
u2 descriptor_index; // 字段和方法的描述符(引用)
u2 attributes_count; // 属性个数
attribute_info attributes[attributes_count]; //属性集合
}- access_flags: 字段的作用域(
public,private,protected修饰符),是实例变量还是类变量(static修饰符),可否被序列化(transient 修饰符),可变性(final),可见性(volatile 修饰符,是否强制从主内存读写)。 - name_index: 对常量池的引用,表示的字段的名称;
- descriptor_index: 对常量池的引用,表示字段和方法的描述符;
- attributes_count: 一个字段还会拥有一些额外的属性,attributes_count 存放属性的个数;
- attributes[attributes_count]: 存放具体属性具体内容。
- access_flags: 字段的作用域(
方法集合 Methods
Class文件中对方法的描述和字段的描述几乎一致。
属性表集合 Attributes
在 Class 文件,字段表,方法表中都可以携带自己的属性表集合,以用于描述某些场景专有的信息。
Class 文件中不要求各个属性表具有严格的顺序,并且只要不与已有的属性名重复即可。
类的生命周期
从加载到虚拟机内存开始,到卸载出内存,类的生命周期为:
- 加载
- 链接
- 验证
- 准备
- 解析
- 初始化
- 使用
- 卸载
Class文件需要加载到虚拟机中才能运行和使用,系统加载Class文件的步骤: 加载——链接(验证, 准备, 解析)——初始化
加载 :
主要完成3件事:
- 通过全类名获取定义此类的二进制字节流
- 将字节流所代表的静态存储结构 转换为 方法区的运行时数据结构。
- 在内存中生成一个代表该类的Class对象,作为访问入口。
这个过程是由类加载器完成的, 每个Java类都有一个引用指向自己的ClassLoader。 不过,数组类不是ClassLoader创建的,而是JVM在需要时自动创建,且数组通过 getClassLoader() 获取到的是数组内元素的类加载器
**验证: **
确保Class文件中的字节流信息符合《Java虚拟机规范》的全部要求。
验证阶段在整个类加载过程中耗费的资源较多,但从程序安全来讲是有必要的。(如果程序已经被反复使用或验证过,可以使用
-Xverify:none参数来关闭大部分的类验证措施,以缩短类加载时间)主要由四个验证阶段组成:
- 文件格式验证 —— Class文件格式检查
- 元数据验证 —— 字节码语义检查(是否有父类,是否继承了final修饰的类。。)
- 字节码验证 —— 程序语义检查(函数参数正确性,对象类型转换是否合理。。)
- 符号引用验证 —— 类的正确性检查(类中使用的其他类、方法、字段是否存在,访问权限是否正确)
第一步的文件格式是基于类的二进制字节流进行的, 保证输入的字节流能正确解析并存储到方法区。其他三个阶段的验证都是在方法区的存储结构上进行的,不再读取、操作字节流。
准备:
为类变量分配内存并设置初始值,这些内存都在方法区中分配。要注意的是:
进行内存分配的仅有 类变量(static修饰的静态变量),不包括实例变量。(实例变量会随对象实例化一起分配到Java堆中)
理论上,类变量的内存都应该在方法区中分配。
JDK1.7之前,用永久代实现方法区时,确实是在方法区中分配类变量的内存的。
JDK1.7及之后,HotSpot把永久代中的字符串常量池,静态变量移到堆中,此时,类变量是随Class对象一起放在Java堆中的。
解析:
虚拟机将 常量池中的符号引用替换为直接引用的过程。解析动作主要针对 类和接口、字段、类方法、接口方法、方法类型、方法句柄、调用限定符 这7种符号引用进行的。
- 符号引用: 用符号/文字描述目标,是一种抽象的引用方式,只描述名字,不指明在内存中的具体位置。
- 直接引用:具体的引用方式,包含了目标在内存中的地址或偏移量等信息,可以直接访问具体内存或执行代码。
所以,Java虚拟机在执行Java代码时,需要将符号引用解析为直接引用,才能真正地访问数据和执行代码。
初始化:
此阶段执行初始化方法 <clinit>(),是类加载的最后一步,此时JVM开始真正执行类中定义的Java程序代码(字节码)。(<clinit>()是编译后自动生成的)
JVM严格规范了只有以下5种情况,才会进行初始化:
- 遇到 new,getstatic,putstatic,invokestatic 这4条直接指令码时。
- new指令: 创建一个类的实例对象。
- getstatic指令:程序访问类的静态变量。(不是静态常量,常量是加载到运行时常量池)
- putstatic指令:程序给类的静态变量赋值。
- invokestatic指令:程序调用类的静态方法。
- 使用 java.lang.reflect 包的方法对类进行反射调用,如Class.forname(“…”),newInstance()等, 需要初始化。
- 初始化时,如果父类还未初始化,则先进行父类的初始化。
- 当虚拟机启动时,用户需要定义一个要执行的主类(要有main方法),虚拟机会先初始化这个类。
- MethodHandle 和 VarHandle 可以看作是轻量级的反射调用机制,而要想使用这 2 个调用, 就必须先使用 findStaticVarHandle 来初始化要调用的类。
类卸载:
满足以下3个要求,类才可被卸载:
- 该类的所有实例对象都已被GC。
- 该类没有在其他地方被引用。
- 该类的类加载器的实例已被GC。
注:在JVM的生命周期内,JVM自带的类加载器 BootstrapClassLoader, ExtClassLoader, AppClassLoader 负责加载 JDK 提供的类,这几个类加载器的实例是不会被回收的,所以它们加载的类是不会被卸载的。
类加载器
类加载器是一个负责加载类的对象,用于实现类加载过程中的”加载”。每个Java类都有一个引用指向加载它的ClassLoader。(数组类没有对应的二进制字节流,不是由ClassLoader创建的,而是由JVM直接生成)
- 主要作用:加载Java类的字节码文件到JVM中(在内存中生成一个代表该类的Class对象)
1 | class Class<T> { |
其实除了加载类之外,类加载器还可以加载 Java 应用所需的资源如文本、图像、配置文件、视频等等文件资源。
类加载器的加载规则
JVM启动的时候,并不会一次性加载所有类,而是按需加载。
对于已经加载的类会被放在
ClassLoader中。在类加载的时候,系统会首先判断当前类是否被加载过。已经被加载的类会直接返回,否则才会尝试加载。也就是说,对于一个类加载器来说,相同二进制名称的类只会被加载一次。1
2
3
4
5
6
7
8
9
10
11
12
13public abstract class ClassLoader {
...
private final ClassLoader parent;
// 由这个类加载器加载的类。
private final Vector<Class<?>> classes = new Vector<>();
// 由VM调用,用此类加载器记录每个已加载类。
void addClass(Class<?> c) {
classes.addElement(c);
}
...
}JVM内置的三个重要的ClassLoader:
BootstrapClassLoader(启动类加载器) :最顶层的加载类,由 C++实现,通常表示为 null,并且没有父级,主要用来加载 JDK 内部的核心类库 以及被 -Xbootclasspath参数指定的路径下的所有类。
JDK内部的核心类库指 %JAVA_HOME%/lib目录下的 rt.jar 、resources.jar 、charsets.jar等 jar 包和类。
rt.jar:是Java基础类库,包含java doc里看到的所有类的类文件,即常用的内置库都在里面,如java.util.*, java.io.*, java.lang.*, java.nio.*等。(rt指RunTime)
ExtensionClassLoader(扩展类加载器) :主要负责加载 %JRE_HOME%/lib/ext 目录下的 jar 包和类以及被 java.ext.dirs 系统变量所指定的路径下的所有类。
AppClassLoader(应用程序类加载器) :面向用户的加载器,负责加载当前应用 classpath 下的所有 jar 包和类。
加载方式:
ClassLoader有两个关键方法:
protected Class loadClass(String name, boolean resolve):加载指定二进制名称的类,实现了双亲委派机制 。
name为类的二进制名称,resove 如果为 true,在加载时调用 resolveClass(Class<?> c) 方法解析该类。protected Class findClass(String name):根据类的二进制名称来查找类,默认实现是空方法。
当我们自定义类加载器时,如果不想打破双亲委派模型,就只重写findClass()方法即可,使无法被父类加载器加载的类通过这个方法加载。 要打破双亲委派模型就要重写 loadClass()方法。
—— 双亲委派模型
ClassLoader类使用委托模型来搜索类和资源, ClassLoader实例在自己搜索类和资源前,会先将搜索任务委托给父类加载器,一直往上委托直到顶层启动类加载器。 然后从顶层开始往下,各加载器会返回自己能加载的类。
- 大致逻辑:每当一个类加载器接收到加载请求时,它会先将请求转发给父类加载器。在父类加载器没有找到所请求的类的情况下,该类加载器才会尝试去加载。
- 双亲委派模型要求除了顶层的启动类加载器外,其余的类加载器都应有自己的父类加载器。
类加载器之间的父子关系一般不是以继承的关系来实现的,而是通常使用组合关系来复用父加载器的代码。(设计原则:组合优于继承)
1
2
3
4
5
6
7
8
9
10public abstract class ClassLoader {
...
// 组合
private final ClassLoader parent;
protected ClassLoader(ClassLoader parent) {
this(checkCreateClassLoader(), parent);
}
...
}好处:可以避免类的重复加载(JVM根据类名,类加载器区分不同的类。相同的类文件如果被不同类加载器加载,产生的也是不同的类,会造成混乱。)
双亲委派模型的执行流程(java.lang.ClassLoader的loadClass()方法):
- 在类加载的时候,系统会首先判断当前类是否被加载过。已经被加载的类会直接返回,否则才会尝试加载(每个父类加载器都会走一遍这个流程)。
- 类加载器在进行类加载的时候,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成(调用父加载器
loadClass()方法来加载类)。这样的话,所有的请求最终都会传送到顶层的启动类加载器 BootstrapClassLoader 中。 - 只有当父加载器反馈自己无法完成这个加载请求(它的搜索范围中没有找到所需的类)时,子加载器才会尝试自己去加载(调用自己的
findClass()方法来加载类)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40protected Class<?> loadClass(String name, boolean resolve)
throws ClassNotFoundException
{
synchronized (getClassLoadingLock(name)) {
//首先,检查该类是否已经加载过
Class c = findLoadedClass(name);
if (c == null) {
//如果 c 为 null,则说明该类没有被加载过
long t0 = System.nanoTime();
try {
if (parent != null) {
//当父类的加载器不为空,则通过父类的loadClass来加载该类
c = parent.loadClass(name, false);
} else {
//当父类的加载器为空,则调用启动类加载器来加载该类
c = findBootstrapClassOrNull(name);
}
} catch (ClassNotFoundException e) {
//非空父类的类加载器无法找到相应的类,则抛出异常
}
if (c == null) {
//当父类加载器无法加载时,则调用findClass方法来加载该类
//用户可通过覆写该方法,来自定义类加载器
long t1 = System.nanoTime();
c = findClass(name);
//用于统计类加载器相关的信息
sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
sun.misc.PerfCounter.getFindClasses().increment();
}
}
if (resolve) {
//对类进行link操作
resolveClass(c);
}
return c;
}
}
OOM
java堆内存溢出
当出现java.lang.OutOfMemoryError:Java heap space异常时,就是堆内存溢出了。
问题描述
- 设置的jvm内存太小,对象所需内存太大,创建对象时分配空间,就会抛出这个异常。
- 流量/数据峰值,应用程序自身的处理存在一定的限额,比如一定数量的用户或一定数量的数据。而当用户数量或数据量突然激增并超过预期的阈值时,那么就会峰值停止前正常运行的操作将停止并触发java . lang.OutOfMemoryError:Java堆空间错误
解决方法
- 首先,如果代码没有什么问题的情况下,可以适当调整-Xms和-Xmx两个jvm参数,使用压力测试来调整这两个参数达到最优值。
- 其次,尽量避免大的对象的申请,像文件上传,大批量从数据库中获取,这是需要避免的,尽量分块或者分批处理,有助于系统的正常稳定的执行。
- 最后,尽量提高一次请求的执行速度,垃圾回收越早越好,否则,大量的并发来了的时候,再来新的请求就无法分配内存了,就容易造成系统的雪崩。
java堆内存泄漏
问题描述
- Java中的内存泄漏是一些对象不再被应用程序使用但垃圾收集无法识别的情况。因此,这些未使用的对象仍然在Java堆空间中无限期地存在。不停的堆积最终会触发java . lang.OutOfMemoryError。
垃圾回收超时内存溢出
问题描述
当应用程序耗尽所有可用内存时,GC开销限制超过了错误,而GC多次未能清除它,这时便会引发java.lang.OutOfMemoryError。
当JVM花费大量的时间执行GC,而收效甚微,而一旦整个GC的过程超过限制便会触发错误(默认的jvm配置GC的时间超过98%,回收堆内存低于2%)
解决方法
要减少对象生命周期,尽量能快速的进行垃圾回收。
Metaspace内存溢出
问题描述
- 元空间的溢出,系统会抛出java.lang.OutOfMemoryError: Metaspace。出现这个异常的问题的原因是 系统的代码非常多,或引用的第三方包非常多,或者通过动态代码生成类加载等方法,导致元空间的内存占用很大。
解决办法
默认情况下,元空间的大小仅受本地内存限制。但是为了整机的性能,尽量还是要对该项进行设置,以免造成整机的服务停机。
优化参数配置,避免影响其他JVM进程
-XX:MetaspaceSize,初始空间大小,达到该值就会触发垃圾收集进行类型卸载,同时GC会对该值进行调整:如果释放了大量的空间,就适当降低该值;如果释放了很少的空间,那么在不超过MaxMetaspaceSize时,适当提高该值。
-XX:MaxMetaspaceSize,最大空间,默认是没有限制的。
除了上面两个指定大小的选项以外,还有两个与 GC 相关的属性:-XX:MinMetaspaceFreeRatio,在GC之后,最小的Metaspace剩余空间容量的百分比,减少为分配空间所导致的垃圾收集 。
-XX:MaxMetaspaceFreeRatio,在GC之后,最大的Metaspace剩余空间容量的百分比,减少为释放空间所导致的垃圾收集。
慎重引用第三方包
对第三方包,一定要慎重选择,不需要的包就去掉。这样既有助于提高编译打包的速度,也有助于提高远程部署的速度。
关注动态生成类的框架
对于使用大量动态生成类的框架,要做好压力测试,验证动态生成的类是否超出内存的需求会抛出异常。
直接内存内存溢出
问题描述
在使用ByteBuffer中的allocateDirect()的时候会用到,很多javaNIO(像netty)的框架中被封装为其他的方法,出现该问题时会抛出java.lang.OutOfMemoryError: Direct buffer memory异常。
如果你在直接或间接使用了ByteBuffer中的allocateDirect方法的时候,而不做clear的时候就会出现类似的问题。
栈内存溢出
问题描述
- 当一个线程执行一个Java方法时,JVM将创建一个新的栈帧并且把它push到栈顶。此时新的栈帧就变成了当前栈帧,方法执行时,使用栈帧来存储参数、局部变量、中间指令以及其他数据。
- 当一个方法递归调用自己时,新的方法所产生的数据(也可以理解为新的栈帧)将会被push到栈顶,方法每次调用自己时,会拷贝一份当前方法的数据并push到栈中。因此,递归的每层调用都需要创建一个新的栈帧。这样的结果是,栈中越来越多的内存将随着递归调用而被消耗,如果递归调用自己一百万次,那么将会产生一百万个栈帧。这样就会造成栈的内存溢出。
解决办法
- 如果程序中确实有递归调用,出现栈溢出时,可以调高-Xss大小,就可以解决栈内存溢出的问题了。递归调用防止形成死循环,否则就会出现栈内存溢出。
创建本地线程内存溢出
问题描述
- 线程基本只占用heap以外的内存区域,也就是这个错误说明除了heap以外的区域,无法为线程分配一块内存区域了,这个要么是内存本身就不够,要么heap的空间设置得太大了,导致了剩余的内存已经不多了,而由于线程本身要占用内存,所以就不够用了。
解决方法
- 首先检查操作系统是否有线程数的限制,使用shell也无法创建线程,如果是这个问题就需要调整系统的最大可支持的文件数。
- 日常开发中尽量保证线程最大数的可控制的,不要随意使用线程池。不能无限制的增长下去。
超出交换区内存溢出
问题描述
- 在Java应用程序启动过程中,可以通过-Xmx和其他类似的启动参数限制指定的所需的内存。而当JVM所请求的总内存大于可用物理内存的情况下,操作系统开始将内容从内存转换为硬盘。
- 一般来说JVM会抛出Out of swap space错误,代表应用程序向JVM native heap请求分配内存失败并且native heap也即将耗尽时,错误消息中包含分配失败的大小(以字节为单位)和请求失败的原因。
解决办法
- 增加系统交换区的大小,我个人认为,如果使用了交换区,性能会大大降低,不建议采用这种方式,生产环境尽量避免最大内存超过系统的物理内存。
- 其次,去掉系统交换区,只使用系统的内存,保证应用的性能。
数组超限内存溢出
问题描述
- 有的时候会碰到这种内存溢出的描述Requested array size exceeds VM limit,一般来说java对应用程序所能分配数组最大大小是有限制的,只不过不同的平台限制有所不同,但通常在1到21亿个元素之间。当Requested array size exceeds VM limit错误出现时,意味着应用程序试图分配大于Java虚拟机可以支持的数组。JVM在为数组分配内存之前,会执行特定平台的检查:分配的数据结构是否在此平台是可寻址的。
解决方法
- 因此数组长度要在平台允许的长度范围之内。不过这个错误一般少见的,主要是由于Java数组的索引是int类型。 Java中的最大正整数为2 ^ 31 - 1 = 2,147,483,647。 并且平台特定的限制可以非常接近这个数字,例如:我的环境上(64位macOS,运行Jdk1.8)可以初始化数组的长度高达2,147,483,645(Integer.MAX_VALUE-2)。若是在将数组的长度再增加1达到nteger.MAX_VALUE-1会出现的OutOfMemoryError。
系统杀死进程内存溢出
问题概述
在描述该问题之前,先熟悉一点操作系统的知识:操作系统是建立在进程的概念之上,这些进程在内核中作业,其中有一个非常特殊的进程,称为“内存杀手(Out of memory killer)”。当内核检测到系统内存不足时,OOM killer被激活,检查当前谁占用内存最多然后将该进程杀掉。
一般Out of memory:Kill process or sacrifice child错会在当可用虚拟虚拟内存(包括交换空间)消耗到让整个操作系统面临风险时,会被触发。在这种情况下,OOM Killer会选择“流氓进程”并杀死它。
虽然增加交换空间的方式可以缓解Java heap space异常,还是建议最好的方案就是升级系统内存,让java应用有足够的内存可用,就不会出现这种问题。
总结,在实际编码中要记得:
- 第三方jar包要慎重引入,坚决去掉没有用的jar包,提高编译的速度和系统的占用内存。
- 对于大的对象或者大量的内存申请,要进行优化,大的对象要分片处理,提高处理性能,减少对象生命周期。
- 尽量固定线程的数量,保证线程占用内存可控,同时需要大量线程时,要优化好操作系统的最大可打开的连接数。
- 对于递归调用,也要控制好递归的层级,不要太高,超过栈的深度。
- 分配给栈的内存并不是越大越好,因为栈内存越大,线程多,留给堆的空间就不多了,容易抛出OOM。JVM的默认参数一般情况没有问题(包括递归)。
JVM调优
什么是调优:
- 根据需求进行JVM规划和预调优;
- 优化 JVM运行环境(慢,卡顿)
- 解决 JVM运行过程中出现的各种问题(OOM)
常用命令:
- jps
- jinfo
- jstat
- jstack
- jmap
