知识点—框架
Sping
Spring 是一款开源的轻量级 Java 开发框架,旨在提高开发人员的开发效率以及系统的可维护性。
一般说 Spring 框架指的都是 Spring Framework,它是很多模块的集合,使用这些模块可以很方便地协助我们进行开发。
IoC
Inversion of Control,控制反转,是一种设计思想,而不是具体的思想。 其思想就是将原本在程序手中手动创建对象的控制权,交由Spirng框架来管理。
- 控制: 指的是对象创建(实例化、管理)的权利。
- 反转:将控制权交给外部环境。
Spring对IoC思想的实现:
提供了IoC容器,充当“外部”:
IoC容器负责对象的创建、初始化等一系列工作,被创建或被管理的对象在Ioc容器中统称为
Bean。IoC容器实际上是个Map,Map中存放的是各种对象。
提供实现方式: 依赖注入(DI,Dependency Injection):
在容器中建立bean与bean之间的依赖关系,直接将对象作为外部输入传递给组件,就是依赖注入。
IoC容器
容器管理着 Bean 的生命周期,控制着 Bean 的依赖注入,可以说容器是Spring IoC 最重要的部分,其设计主要是基于以下两个接口:
实现BeanFactory接口的简单容器:
—— BeanFactory 是Spring IoC容器的最底层接口,它只提供了IOC容器最基本的功能,给具体的IOC容器的实现提供了规范,所以我们称它为简单容器。
—— 它主要是负责配置、生产和管理bean,其内部定义了对单个bean的获取,对bean的作用域判断,获取bean类型,获取bean别名等功能。
实现ApplicationContext接口的高级容器:(一般用这个,需要更灵活地定制容器才用BeanFactory接口)
—— ApplicationContext 扩展(继承)了 BeanFactory,它不仅包含BeanFactory的所有功能,同时它又继承了MessageSource、ListableBeanFactory、ResourceLoader、ApplicationEventPublisher 等接口,这样ApplicationContext 就拥有更高级的IOC容器特性,我们称它为高级容器。
实现类:DefaultListableBeanFactory类 实现了 BeanFactory接口,是spring中默认的IoC容器。
BeanDefinition在Spring中是用来描述Bean对象的,它本身并不是一个Bean实例,而是包含了Bean实例的所有信息,比如类名、属性值、构造器参数、scope、依赖的bean、是否是单例类、是否是懒加载以及其它信息。其实就是将Bean实例定义的信息存储到这个BeanDefinition相应的属性中,后面Bean对象的创建是根据BeanDefinition中描述的信息来创建的,例如拿到这个BeanDefinition后,可以根据里面的类名、构造函数、构造函数参数,使用反射进行对象创建。也就是说 IOC容器可以有多个BeanDefinition,并且一个BeanDefinition对象对应一个<bean>标签中的信息。
当然BeanDefinition的最终目的不只是用来存储Bean实例的所有信息,而是为了可以方便的进行修改属性值和其他元信息
IoC容器的启动步骤:
- 解析本地配置文件;
- 调用 refresh() 方法, refresh方法涉及容器启动的一系列操作;
- 其中 IOC 容器初始化包括 BeanDefinition 的 资源定位、载入和注册三个基本过程(走完这三步,就是Bean被定义了,但还没有被初始化):
- Resource定位:指的是对开发者的配置文件(Xml)进行资源的定位,并将其封装成Resource对象。它由ResourceLoader通过统一的Resource接口来完成(这个Resource对各种形式的BeanDefinition的使用都提供了统一接口)。这个定位过程类似于容器寻找数据的过程,就像用水捅装水先要把水找到一样。
- BeanDefinition的载入:这个载入过程是将 Resource 定位到的信息 表示成IoC容器内部的数据结构,而这个容器内部的数据结构就是BeanDefinition。
- BeanDefinition的注册:这个注册过程把上面载入过程中解析得到的BeanDeftnition向IoC容器进行注册。注册过程是通过调用BeanDefinitionRegistry接口的实现来完成的。在IoC容器内部将BeanDefinition注人到一个HashMap中去,IoC容器就是通过这个HashMap来持有这些BeanDefinition数据的。
- 其中 IOC 容器初始化包括 BeanDefinition 的 资源定位、载入和注册三个基本过程(走完这三步,就是Bean被定义了,但还没有被初始化):
1 | //AbstractApplicationContext.refresh()方法 |
Bean
Bean就是被IoC容器所管理的对象。 我们可以通过XML,注解或Java配置的方式来告诉IoC容器需要管理的对象。
org.springframework.beans和org.springframework.context这两个包是 IoC 实现的基础
使用
Bean注解声明方式:
@Component:通用的注解,可标注任意类为Spring组件。如果一个 Bean 不知道属于哪个层,可以使用@Component注解标注。@Repository: 对应持久层即 Dao 层,主要用于数据库相关操作。@Service: 对应服务层,主要涉及一些复杂的逻辑,需要用到 Dao 层。@Controller: 对应 Spring MVC 控制层,主要用于接受用户请求并调用Service层返回数据给前端页面。@Bean:作用于方法, 此方法返回的实例对象作为Bean交给IoC容器。很多时候只能通过@Bean来注册Bean,如引用第三方库的类要装配到IoC容器中时。
注入Bean的注解方法:
@Autowired: 属于 org.springframework.bean.factory,是Spring内置的注解,默认注入方式是byType(根据类型匹配)。当一个接口存在多个实现类时,byType方法就无法正确注入对象,此时,注入方式会变成
byName(根据名称匹配,名称通常是类名,首字母小写)。一般还是要用@Qualifier来显示指定名称,而不是依赖变量的名称。1
2
3
4
5
6
7
8
9
10
11
12
13// 报错,byName 和 byType 都无法匹配到 bean
private SmsService smsService;
// 正确注入 SmsServiceImpl1 对象对应的 bean
private SmsService smsServiceImpl1;
// 正确注入 SmsServiceImpl1 对象对应的 bean
// smsServiceImpl1 就是上述所说的名称
private SmsService smsService;@Resource:属于 javax.annotation,是 JDK提供的注解,默认注入方式为byName,如果无法通过名称匹配,注入方式会变成byType。 @Resource有两个常用属性:name,type,分别指定名称和类型,同时指定的话注入方式会是byType+byName,不推荐。1
2
3
4
5
6
7
8
9
10
11// 报错,byName 和 byType 都无法匹配到 bean
private SmsService smsService;
// 正确注入 SmsServiceImpl1 对象对应的 bean
private SmsService smsServiceImpl1;
// 正确注入 SmsServiceImpl1 对象对应的 bean(比较推荐这种方式)
private SmsService smsService;@Inject:属于 javax.inject。
作用域
- singleton : IoC 容器中只有唯一的 bean 实例。Spring 中的 bean 默认都是单例的,是对单例设计模式的应用。
- prototype : 每次获取都会创建一个新的 bean 实例。也就是说,连续
getBean()两次,得到的是不同的 Bean 实例。 - request (仅 Web 应用可用): 每一次 HTTP 请求都会产生一个新的 bean(请求 bean),该 bean 仅在当前 HTTP request 内有效。
- session (仅 Web 应用可用) : 每一次来自新 session 的 HTTP 请求都会产生一个新的 bean(会话 bean),该 bean 仅在当前 HTTP session 内有效。
- application/global-session (仅 Web 应用可用): 每个 Web 应用在启动时创建一个 Bean(应用 Bean),该 bean 仅在当前应用启动时间内有效。
- websocket (仅 Web 应用可用):每一次 WebSocket 会话产生一个新的 bean。
配置作用域,字段为scope:
1 |
|
或
1 | <bean id="..." class="..." scope="singleton"></bean> |
线程安全
单例 Bean 存在线程问题,主要是因为当多个线程操作同一个对象的时候是存在资源竞争的。
常见的有两种解决办法:
- 在 Bean 中尽量避免定义可变的成员变量。
- 在类中定义一个
ThreadLocal成员变量,将需要的可变成员变量保存在ThreadLocal中(推荐的一种方式)。
不过,大部分 Bean 实际都是无状态(没有实例变量)的(比如 Dao、Service),这种情况下, Bean 是线程安全的。
生命周期
加载Bean定义
调用 loadBeanDefinitions方法,扫描所有xml配置、注解,将Bean记录在beanDefinitionMap中。
创建Bean对象
调用 createBean方法 遍历 beanDefinitionMap 创建bean。
构建对象
利用反射机制从 Bean定义中获取类的构造方法。 (优先使用带@Autowired的构造方法,其次是无参构造方法,最后是有参构造方法)
寻找构造方法的参数: 根据类查找>参数名查找(先byType再byName)
构造对象/实例化
填充属性:为Bean内部所需的属性进行赋值,通常是类中 @Autowired 注解的变量。
初始化Bean对象:通过initializeBean对填充后的实例进行初始化
添加到单例池
通过 addSingleton 方法,将Bean 加入到单例池 singleObjects
销毁
- 销毁前调用 bean中@PreDestory 注解的方法,通过 postProcessBeforeDestruction 方法调用destoryBean逐一销毁Bean
- 销毁:调用 destoryBeans
- 执行客户自定义销毁:调用 invokeCustomDestoryMethod
填充初始化容器相关信息:
通过 invokeAwareMethods 方法:为实现aware接口【信息感知接口】的Bean 设置注入beanName、beanFactory等容器信息
初始化构造方法:
- 通过 invokeInitMethods 方法进行初始化:
如果Bean实现InitializingBean接口进行处理【未实现则不进行】
- afterPropertiesSet方法【bean填充属性后执行】
- initMethod 方法
Bean的后置处理:
在invokeInitMethods 的前后进行
- applyBeanPostProcessorsBeforeInitialization
- invokeInitMethods
- applyBeanPostProcessorsAfterInitialization
在后置处理中处理了包括:AOP【AnnotationAwareAspectJAutoProxyCreator】,负责 构造后@PostConstruct 和 销毁前@PreDestroy 的 InitDestoryAnnotationBeanPostProcessor 等
注册销毁:
通过reigsterDisposableBean处理实现了DisposableBean接口的Bean的注册
AOP
Aspect-Oriented Programming,面向切面编程。
首先,面向对象编程OOP可以利用继承的方式实现代码复用,当对于同一个类中的不同方法的特定位置,都出现的重复代码,却没办法复用。
于是,AOP要做的就是将 与业务无关,却为业务模块共用的逻辑封装起来(如 事务处理,日志管理,权限控制)。
AOP是基于动态代理的,代理的对象如果有实现某个接口,就用JDK Proxy,没有实现接口的就用Cglib。
更多使用详情在 Java—SSM笔记中
Spirng AOP 和 AspectJ AOP 的区别:
Spirng AOP 是运行时增强,基于代理; AspectJ AOP是编译时增强,基于字节码操作。 在切面较少时两者差距不大,当切面太多的话,应当选择用AspectJ。
Spring AOP 已经集成了 AspectJ
设计模式
工厂模式
Spring 使用工厂模式可以通过 BeanFactory 或 ApplicationContext 创建 bean 对象。
比如:
BeanFactory:延迟注入(使用到某个 bean 的时候才会注入),相比于ApplicationContext来说会占用更少的内存,程序启动速度更快。ApplicationContext:容器启动的时候,不管你用没用到,一次性创建所有 bean 。BeanFactory仅提供了最基本的依赖注入支持,ApplicationContext扩展了BeanFactory,除了有BeanFactory的功能还有额外更多功能,所以一般开发人员使用ApplicationContext会更多。三个实现类:
ClassPathXmlApplication:把上下文文件当成类路径资源。FileSystemXmlApplication:从文件系统中的 XML 文件载入上下文定义信息。XmlWebApplicationContext:从 Web 系统中的 XML 文件载入上下文定义信息。
1 | ApplicationContext context = new FileSystemXmlApplicationContext( |
单例设计模式
如 线程池,缓冲,对话框,注册表等都是只能有一个实例,多个实例可能会造成程序的行为异常,结果不一致,资源使用过量等。
Spring 中 bean 的默认作用域就是 singleton(单例)的。
代理设计模式
Spring AOP就是基于动态代理实现。
注:AspectJ AOP不是基于动态代理, 而是使用编译时织入或者运行时织入的方式来实现AOP。—— 在编译时织入,会在编译阶段把切面织入到目标代码中,生成织入切面后的class文件。—— 在运行时织入,会在应用启动时或者类加载时动态地把切面织入到目标对象的字节码中。
模板方法
Spring中的 JdbcTemplate、HibernateTemplate 等以 Template 结尾的对数据库操作的类,它们就使用到了模板模式。
一般情况下,我们都是使用继承的方式来实现模板模式,但是 Spring 并没有使用这种方式,而是使用 Callback 模式与模板方法模式配合,既达到了代码复用的效果,同时增加了灵活性。
观察者模式
Spring 的事件驱动模型就是观察者模式很经典的一个应用。
Spring 事件驱动模型非常有用,在很多场景都可以解耦我们的代码。比如我们每次添加商品的时候都需要重新更新商品索引,这个时候就可以利用观察者模式来解决这个问题。
使用:
- 定义 事件角色 继承 ApplicationEvent 抽象类,重写构造函数;
- 定义 事件监听者 实现 ApplicationListener 接口,重写 onApplicationEvent() 方法 实现监听;
- 定义 事件发布者 实现 ApplicationEventPublisher 接口, Spring中的 ApplicationContext 就实现了这个接口,通过publishEvent() 方法发布消息;
1 | // 定义一个事件,继承自ApplicationEvent并且写相应的构造函数 |
适配器模式
Spring AOP 的实现是基于代理模式,但是 Spring AOP 的增强或通知(Advice)使用到了适配器模式,与之相关的接口是AdvisorAdapter 。
因为 通知Advice 和 切点Join Point 两者的接口不匹配,适配器(Adapter)将Advice对象转换为 Adapter对象,这样就可以将Advice对象应用于任何类型的切点(Join Point)上。
如: MethodBeforeAdviceAdapter 通过调用 getInterceptor 方法,将 MethodBeforeAdvice 适配成 MethodBeforeAdviceInterceptor )。
Spring MVC的适配器模式:
在 Spring MVC 中,DispatcherServlet 根据请求信息调用 HandlerMapping,解析请求对应的 Handler。解析到对应的 Handler(即Controller控制器)后,开始由HandlerAdapter 适配器处理。
因为Spring MVC中的Controller种类众多,不同类型的 Controller 通过不同的方法来对请求进行处理。如果不利用适配器模式的话,DispatcherServlet 直接获取对应类型的 Controller,需要判断获取到的具体是哪个 Controller,这样会有很多判断语句,使程序难以维护,不好拓展。
1 | // DispatcherServlet自己判断Controller类型 |
装饰者模式?
SpringBoot
传统Spring框架存在的弊端:
- Spring事物管理,MVC,启用第三方库都需要XML或Java进行显示配置,配置过重
- 写配置挤占了实际写应用的逻辑的时间
- 项目依赖管理,要考虑用那些库,还要知道哪些版本和库不会有冲突,影响开发效率
SpringBoot的优势:
- 自动配置:针对很多Spring常见的应用功能,SpringBoot能自动提供相关配置
- 起步依赖:告诉SpringBoot需要什么功能,它就能引入需要的库
- 内置tomcat等服务器,可以直接达成jar包运行
- CLI命令行界面:通过SpringBootCLI,借此你只需写代码就能完成完整的应用程序,无须传统项目构建
- Actuator: 提供在运行时检视应用程序内部情况的能力
Springbooot两大特性:
- 依赖管理
- 自动装配
常用注解说明
@Controller标记此类是一个控制器,可以返回视图解析器指定的html,通过@ResponseBody可以将结果以json、xml形式返回;
@RestController = @Controller + @ResponseBody,实现rest接口开发,只能返回json数据,不能返回html页面;
@RequestMapping:定义接口地址,可以标记在类上、方法上,支持http的post、get、put等方法;
@GetMapping、xxxMapping:定义对应的get或其他方法,只能标记在方法上;
@RequestBody:定义在方法参数上,将json传参转成java对象;
2
3
4
5
public class BookController {
.
}@PathVarible:接口请求路径中占位符的值;
@SpringBootApplication
创建SpringBoot项目会默认在主类加上。 可以把@SpringBootApplication 看作是 @SpringBootConfiguration、@EnableAutoConfiguration、@ComponentScan 的集合。
- @SpringBootConfiguration:等价于@Configuration,标注当前类是一个配置类并注入到 IOC容器中。
- @EnableAutoConfiguration:启动SpringBoot的自动配置机制
- @ComponentScan:允许在Spring上下文注册额外的bean或导入其他配置类。
Bean相关
@Autowired
自动导入对象到类中,要求被注入的类要被Spring容器管理。
@Component、@Repository、@Service、@Controller
将类交由Spring容器管理:
- @Component :通用的注解,可标注任意类为
Spring组件。如果一个 Bean 不知道属于哪个层,可以使用@Component注解标注。 - @Repository : 对应持久层即 Dao 层,主要用于数据库相关操作。
- @Service : 对应服务层,主要涉及一些复杂的逻辑,需要用到 Dao 层的Bean。
- @Controller : 对应 Spring MVC 控制层,主要用于接受用户请求并调用 Service 层返回数据给前端页面
- @Component :通用的注解,可标注任意类为
@RestController
@RestController是 @Controller和@ResponseBody的合集。表示这是 控制器bean,将函数返回值直接填入HTTP响应体中,是REST风格的控制器。
@Scope
声明bean的作用域。
1
2
3
4
5
public Person personSingleton() {
return new Person();
}常见的作用域有:
- singleton : 唯一 bean 实例,Spring 中的 bean 默认都是单例的。
- prototype : 每次请求都会创建一个新的 bean 实例。
- request : 每一次 HTTP 请求都会产生一个新的 bean,该 bean 仅在当前 HTTP request 内有效。
- session : 每一个 HTTP Session 会产生一个新的 bean,该 bean 仅在当前 HTTP session 内有效。
@Configuration
用于声明配置类,也可以使用@Component代替,不过@Configuration更加语义化。
1
2
3
4
5
6
7
public class AppConfig {
public TransferService transferService() {
return new TransferServiceImpl();
}
}
处理常见的HTTP请求
有5种常见的请求类型:GET—请求资源,POST—创建资源,PUT—更新资源,DELETE—删除资源,PATCH—更新资源(客户端提供部分更改的属性)
GET请求
@GetMapping(“users”) 等价于 @RequestMapping(value=”/users”,method=RequestMethod.GET)
1
2
3
4
public ResponseEntity<List<User>> getAllUsers() {
return userRepository.findAll();
}POST请求
1
2
3
4
public ResponseEntity<User> createUser( UserCreateRequest userCreateRequest) {
return userRespository.save(userCreateRequest);
}PUT请求
1
2
3
4
5
public ResponseEntity<User> updateUser( Long userId,
UserUpdateRequest userUpdateRequest) {
......
}DELETE请求
1
2
3
4
public ResponseEntity deleteUser( Long userId){
......
}PATCH请求
1
2
3
4
5
public ResponseEntity updateStudent( StudentUpdateRequest studentUpdate) {
studentRepository.updateDetail(studentUpdate);
return ResponseEntity.ok().build();
}
前后端传值
@PathVariable 和 @RequestParam
@PathVariable用于获取路径参数, @RequestParam用于获取查询参数。
假设请求的url是:/klasses/123456/teachers?type=web;—— 那么以下代码获取到的参数是 klassId=123456, type=web。
1
2
3
4
5
6
public List<Teacher> getKlassRelatedTeachers(
Long klassId,
String type ) {
...
}@RequestBody
用于读取Request请求的body部分,并且 Content-Type 为 application/json 格式,接收数据之后会自动将数据绑定到 Java对象上去。
系统会使用 HttpMessageConverter 或者自定义的HttpMessageConverter 将请求的 body 中的 json 字符串转换为 java 对象。
1
2
3
4
5
6
7
8
9
10
11
12// 对象
public class UserRegisterRequest {
private String userName;
private String password;
private String fullName;
}1
2// 请求参数body部分携带的JSON数据
{"userName":"coder","fullName":"shuangkou","password":"123456"}1
2
3
4
5
public ResponseEntity signUp( UserRegisterRequest userRegisterRequest) {
userService.save(userRegisterRequest);
return ResponseEntity.ok().build();
}
注意: 一个请求方法只能有一个 @RequestBody,但可以有@RequestParam 和 @PathVaiable。
读取配置信息
@Value (常用)
1
wuhan2020: 2020年初武汉爆发了新型冠状病毒,疫情严重,但是,我相信一切都会过去!武汉加油!中国加油!
1
2
String wuhan2020;@ConfigurationProperties (常用)
1
2
3
4
5
6
7
8
9library:
location: 湖北武汉加油中国加油
books:
- name: 天才基本法
description: 二十二岁的林朝夕。。。
- name: 时间的秩序
description: 为什么我们记得过去,而非未来?。。。
- name: 了不起的我
description: 如何养成一个新习惯?如何让。。。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class LibraryProperties {
private String location;
private List<Book> books;
static class Book {
String name;
String description;
}
......
}@PropertySource (不常用)
读取指定properties文件
1
2
3
4
5
6
7
8
class WebSite {
private String url;
......
}
参数校验
JSR(Java Specification Requests) 是一套 JavaBean 参数校验的标准,它定义了很多常用的校验注解,我们可以直接将这些注解加在 Bean 的属性上面。
一般使用的是JSR注解,即 javax.validation.constraints 。
验证请求体(RequestBody):
先在对应的Bean中加上字段对应的校验注解。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public class Person {
private String classId;
private String name;
private String sex;
}在需要验证的参数上加上@Valid注解。如果验证失败,它将抛出
MethodArgumentNotValidException。1
2
3
4
5
6
7
8
9
public class PersonController {
public void getPerson( Person person) {
...
}
}验证请求参数:
在类上加上 @Validated 注解,Spring才知道要验证参数。参数上加 @Valid 和对应的验证注解
1
2
3
4
5
6
7
8
9
10
public class PersonController {
public void getPersonByID( Integer id) {
...
}
}
- 字段验证:
@NotEmpty被注释的字符串的不能为 null 也不能为空@NotBlank被注释的字符串非 null,并且必须包含一个非空白字符@Null被注释的元素必须为 null@NotNull被注释的元素必须不为 null@AssertTrue被注释的元素必须为 true@AssertFalse被注释的元素必须为 false@Pattern(regex=,flag=)被注释的元素必须符合指定的正则表达式@Email被注释的元素必须是 Email 格式。@Min(value)被注释的元素必须是一个数字,其值必须大于等于指定的最小值@Max(value)被注释的元素必须是一个数字,其值必须小于等于指定的最大值@DecimalMin(value)被注释的元素必须是一个数字,其值必须大于等于指定的最小值@DecimalMax(value)被注释的元素必须是一个数字,其值必须小于等于指定的最大值@Size(max=, min=)被注释的元素的大小必须在指定的范围内@Digits(integer, fraction)被注释的元素必须是一个数字,其值必须在可接受的范围内@Past被注释的元素必须是一个过去的日期@Future被注释的元素必须是一个将来的日期- …
全局处理Controller层异常
相关注解:
- @ControllerAdvice: 定义全局异常处理类。
- @ExceptionHandler:声明异常处理方法。
1 |
|
JPA(TODO)
Java Persistence API, 允许Java程序使用 类 来表示 数据库表,使用java对象来执行数据库操作,而不必编写SQL语句。
。。。
事务
在要开启事务的public方法上使用 @Transactional 即可。 (事务所在的类,必须被Spring管理,否则不生效)
@Transactional 常用配置参数:propagation, isolation, timeout, rollbackFor
propagation —— 事务传播行为,默认为REQUIRED。以下是可能的值:
(写法: propagation = Propagation.REQUIRED。虽然TransactionDefinition里面定义了传播行为的常量,不过为了方便使用,Spring又定义一个枚举类Propagation来使用)
TransactionDefinition.PROPAGATION_REQUIRED 默认使用,如果当前存在事务,则加入该事务; 否则创建一个新事务。 (两个方法都是PROPAGATION_REQUIRED传播行为的话,两者使用同一个事务,其中一个方法回滚,整个事务都会回滚)
TransactionDefinition.PROPAGATION_REQUIRES_NEW 直接创建新事务,与其他事务相互独立,互不干扰。
(假如外部方法使用PROPAGATION_REQUIRED修饰, 当前方法使用PROPAGATION_REQUIRES_NEW修饰,如果外部方法发生异常回滚了,当前方法不会回滚; 如果当前方法抛出未捕获的异常且满足回滚规则,那么外部方法会检测到异常,发生回滚)
TransactionDefinition.PROPAGATION_NESTED 如果当前存在事务,则在其内部开启新事务,作为嵌套事务存在,否则创建一个新事务。
(内部方法发生回滚,外部方法也会回滚)
还有四种用的很少的传播行为:
- TransactionDefinition.PROPAGATION_MANDATORY —— 当前存在事务,则加入; 否则直接抛出异常
- TransactionDefinition.PROPAGATION_SUPPORTS —— 当前存在事务,则加入; 否则以非事务的方式继续运行。
- TransactionDefinition.PROPAGATION_NOT_SUPPORTED: 以非事务方式运行,如果当前存在事务,则把当前事务挂起。
- TransactionDefinition.PROPAGATION_NEVER: 以非事务方式运行,如果当前存在事务,则抛出异常。
isolation —— 事务隔离级别,默认为DEFAULT。
(同样有枚举类:Isolation,如 isolation = Isolation.REPEATABLE_READ)
TransactionDefinition.ISOLATION_DEFAULT—— 使用后端数据库默认的隔离级别。TransactionDefinition.ISOLATION_READ_UNCOMMITTED—— 读未提交。(极少用)TransactionDefinition.ISOLATION_READ_COMMITTED—— 读已提交TransactionDefinition.ISOLATION_READ_COMMITTED—— 可重复读TransactionDefinition.ISOLATION_SERIALIZABLE—— 可串行化
timeout —— 事务的超时时间,单位是秒,默认值-1,表示不会超时。如果超过该时间还未完成事务,则回滚事务。
rollbackFor —— 指定能触发回滚的异常类型,可以指定多个。
1 |
|
@Transactional 注解原理: 是基于AOP实现的,AOP又是使用动态代理实现。目标对象有实现接口,默认使用 JDK动态代理,没有实现接口,则使用CGLIB动态代理。
注意点:
@Transactional 如果不配置 rollbackFor 属性的话,那么事务只有遇到运行时异常才会回滚。 加上 rollbackFor = Exception.class ,可以让事务在遇到非运行时异常时也回滚。
@Transactional 加在类上,表示类的所有Public方法都配置相同的事务属性信息。 方法和类都加@Transactional,方法的事务优先。
自调用问题: 使用Spring AOP时,同一类中没有@Transactional的方法调用有@Transactional注解的方法, 被调用方法的事务会失效。 只有在类以外被调用,才不会失效。
解决:避免同一类中自调用,或用AspectJ 取代之。
JSON
过滤 json 数据: @JsonIgnoreProperties 放在类上, @JsonIgnore 放在属性字段上。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19//生成json时将userRoles属性过滤
public class User {
private String userName;
private String fullName;
private List<UserRole> userRoles = new ArrayList<>();
}
// 上下两个作用一样
public class User {
private String userName;
private String fullName;
//生成json时将userRoles属性过滤
private List<UserRole> userRoles = new ArrayList<>();
}格式化 json: @JsonFormat
1
2
private Date date;扁平化类中的对象: @JsonUnwrapped
1
2
3
4
5
6
7
8
9
10
public class Account {
private Location location;
private PersonInfo personInfo;
......
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18// 扁平化前
{
"location": {
"provinceName":"湖北",
"countyName":"武汉"
},
"personInfo": {
"userName": "coder1234",
"fullName": "shaungkou"
}
}
// 扁平化后
{
"provinceName":"湖北",
"countyName":"武汉",
"userName": "coder1234",
"fullName": "shaungkou"
}
测试相关
@ ActiveProfiles —— 作用于测试类上,用于声明生效的Spring配置文件。
1
2
3
4
5
6
public abstract class TestBase {
......
}@Test —— 声明当前方法为测试方法。
@Transactional —— 声明测试方法的数据需要回滚,避免污染测试数据。
@WithMockUser —— Spring Security 提供,用来模拟一个真实用户,并且可以赋予权限。
1
2
3
4
5
6
void should_import_student_success() throws Exception {
......
}
自动装配
SpringBoot 定义了一套接口规范,这套规范规定:SpringBoot 在启动时会扫描外部引用 jar 包中的META-INF/spring.factories文件,将文件中配置的类型信息加载到 Spring 容器,并执行类中定义的各种操作。
通过@EnableAutoConfiguration开启自动装配,通过 SpringFactoriesLoader 最终加载META-INF/spring.factories中的自动配置类实现自动装配,自动配置类其实就是通过@Conditional按需加载的配置类,想要其生效必须引入spring-boot-starter-xxx包实现起步依赖。
根据导入依赖,来自动装配tomcat,springMVC,web常见功能(如编码问题),默认包结构 等,就是按需加载所有自动配置项。
约定大于配置
意思是通过约定来减少配置。
例如,在 Spring Boot 中,当我们导入一个 spring-boot-starter-web 后,就会自动的帮我们导入 Spring MVC 的相关依赖(包括 Json 支持的 Jackson 和数据校验的 Hibernate Validator)和一个内置的 Tomcat 容器,这使得在开发阶段可以直接通过 main 方法或是 JAR 包独立运行一个 Web 项目。
类似的,新建项目时默认的 application.properties或application.yml文件,默认的包目录(main,resources,target)等
启动流程
Springboot启动类:
1 |
|
只需在启动类上标注@SpringBootApplication,再调用 SpringApplication.run(MyApplication.class, args) 就可以完成Srpingboot的启动流程了。
- 其中 @SpringBootApplication 可以看作是 @Configuration、@EnableAutoConfiguration、@ComponentScan 的集合。 能够触发 包扫描和自动配置,让相关的bean被注册进spring容器。
具体的流程:
- 启动main方法开始
- 初始化配置: 通过类加载器(loadFactories)读取classpath下所有的spring.factories配置文件,创建一些初始配置对象;通知监听者应用程序启动开始,创建环境对象environment,用于读取环境配置 如 application.yml
- 创建应用程序上下文createApplicationContext,同时创建 bean工厂对象
- 刷新上下文(启动核心):
- 配置工厂对象,包括上下文类加载器,对象发布处理器,beanFactoryPostProcessor
- 注册并实例化bean工厂发布处理器,并且调用这些处理器,对包扫描解析(主要是class文件)
- 注册并实例化bean发布处理器 beanPostProcessor
- 初始化一些与上下文有特别关系的bean对象(创建tomcat服务器)
- 实例化所有bean工厂缓存的bean对象(剩下的)
- 发布通知-通知上下文刷新完成(启动tomcat服务器)
- 通知监听者 —— 启动程序完成
源码:
SpringApplication的构造方法:
1 | public SpringApplication(ResourceLoader resourceLoader, Class<?>... primarySources) { |
SpringApplication最终调用的run方法:
1 | public ConfigurableApplicationContext run(String... args) { |
刷新上下文方法 refreshContext(context) 做了很多重要行为:
工厂配置,bean处理器配置,类的扫描,解析,bean定义,bean类信息缓存,服务器创建,bean实例化,动态代理对象的创建等。
spring中注册bean信息和实例化bean是两件事情。
注册bean信息不是创建bean对象,是解析bean类获取详细信息,会创建BeanDefinition对象,携带bean类的字节码和方法等信息,把BeanDefinition对象注册保存到工厂BeanDefinitionMap中。
工厂实例化bean时直接BeanDefinitionMap.get(beanName) 获取bean的字节码信息,通过反射创建对象,然后将bean对象保存到singletonObjects中。
大体分为11步:
通过prepareRefresh方法 ,在已有环境配置上,准备servlet相关的环境Environment。
- 调用 initServletPropertySources方法 对servlet初始化参数 servletContextInitParams 和 servletConfigInitParams 进行赋值。
- 调用validateRequiredProperties方法检验是否有必填的环境变量
调用obtainFreshBeanFactory获取BeanFactory容器,调用prepareBeanFactory方法,在使用BeanFactory前进行准备工作,主要准备以下处理器和Bean:
- 系统级处理器:类加载器BeanClassLoader,表达式解析器BeanExpressionResolver,配置文件处理器PropertyEditorRegistrar等;
- 两个bean后置处理器:用于解析Aware接口的ApplicationContextAwareProcessor,用于处理自定义监听器注册和销毁的ApplicationListenerDetector。
- 注册一些特殊Bean和系统级Bean: 如容器本身BeanFactory和ApplicationContext,系统环境environment,系统属性systemProperties等。 (会被放入特殊对象池或单例池)
springboot默认使用ServletWebServerApplicationContext,容器创建时一并创建beanFactory,所以obtainFreshBeanFactory方法是空的,不过原始 spring的上下文容器可能是其他的,所以可以通过obtainFreshBeanFactory重新构造beanFactory,加载bean定义BeanDefinition。
调用postProcessBeanFactory方法,对BeanFactory进行额外设置或修改,主要定义Servlet相关作用域Scopes,同时注册与Servlet相关的Bean,如ServletRequest,ServletResponse,HttpSession等。
调用 invokeBeanFactoryPostProcessors 方法,逐一执行前面注册的各种 BeanFactoryPostProcessor(BeanFactory后置处理器),其中最重要的是用于 加载所有”Bean定义“的ConfigurationClassPostProcessor。它会加载所有@Configuration配置类,并检索Bean扫描路径,将所有扫描到的”Bean定义“放到”Bean定义池”中。
通过 registerBeanPostProcessors 方法检索所有Bean后置处理器,并根据指定的order进行排序,然后放入 “Bean后置处理器池” 中。(Bean后置处理器会在Bean初始前和后 分别执行逻辑)
调用 initMessageSource和initApplicationEventMulticaster方法从单例池中获取两个Bean放入ApplicationContext中:messageSource和applicationEventMulticaster。 前者可自定义名为”messageSource“的Bean结合messages.properties配置文件进行多语言配置, 后者是消息广播器,用于自定义广播事件。
调用 onRefresh方法 构造并启动Web服务器,springboot默认服务器是tomcat,所以会使用一个叫TomcatServletWebServerFactory的应用服务器Bean构造Tomcat对象。
调用RegisterListeners,查找所有的监听器Bean,将其注册到第6步的消息广播器 applicationEventMulticaster中。
调用 finishBeanFactoryInitialization方法 生产所有Bean。(大致步骤:构造对象,填充属性,初始化实例,注册销毁)Bean生成后会放入单例池中。
调用finishRefresh方法,构造并注册 生命周期管理器lifecycleProcessor,同时调用所有实现了 生命周期接口Lifecycle的Bean中的start方法(在容器关闭时自动调用stop方法)。
发布【ContextRefreshedEvent】事件,标志context容器刷新完成。
SpringCloud
Gateway
为了提升网关的性能,Spring Cloud Gateway 基于 Spring WebFlux 。Spring WebFlux 使用 Reactor 库来实现响应式编程模型,底层基于 Netty 实现同步非阻塞的 I/O。
Gateway 提供了统一的路由方式,和基于 Filter 链的网关基本功能。
Gateway的处理流程:
- 路由判断:客户端的请求到达网关后,先经过 Gateway Handler Mapping 处理,这里面会做断言(Predicate)判断,看下符合哪个路由规则,这个路由映射后端的某个服务。
- 请求过滤:然后请求到达 Gateway Web Handler,这里面有很多过滤器,组成过滤器链(Filter Chain),这些过滤器可以对请求进行拦截和修改,比如添加请求头、参数校验等等,有点像净化污水。然后将请求转发到实际的后端服务。这些过滤器逻辑上可以称作 Pre-Filters,Pre 可以理解为“在…之前”。
- 服务处理:后端服务会对请求进行处理。
- 响应过滤:后端处理完结果后,返回给 Gateway 的过滤器再次做处理,逻辑上可以称作 Post-Filters,Post 可以理解为“在…之后”。
- 响应返回:响应经过过滤处理后,返回给客户端。
总结就是:客户端的请求先通过匹配规则找到合适的路由,也就能映射到具体的服务。然后请求经过过滤器处理后转发给具体的服务,服务处理后,再次交给过滤器处理,最后返回给客户端。
断言(Predicate)
断言可以理解为 对一个表达式进行 if 判断,如果为真则做这件事,否则做那件事。 在 Gateway 中,如果客户端发送的请求满足了断言的条件,则映射到指定的路由器,就能转发到指定的服务上进行处理。
使用 predicates 可以进行断言配置,如下:当请求 url 中包含 api/xxx,就匹配到了该路由 route_first。
1
2
3
4
5
6
7
8
9
10spring:
cloud:
gateway:
routes:
- id: route_first
uri: lb://xxxx
predicates:
- Path=/api/xxx/**
filters:
-常见的断言规则有:
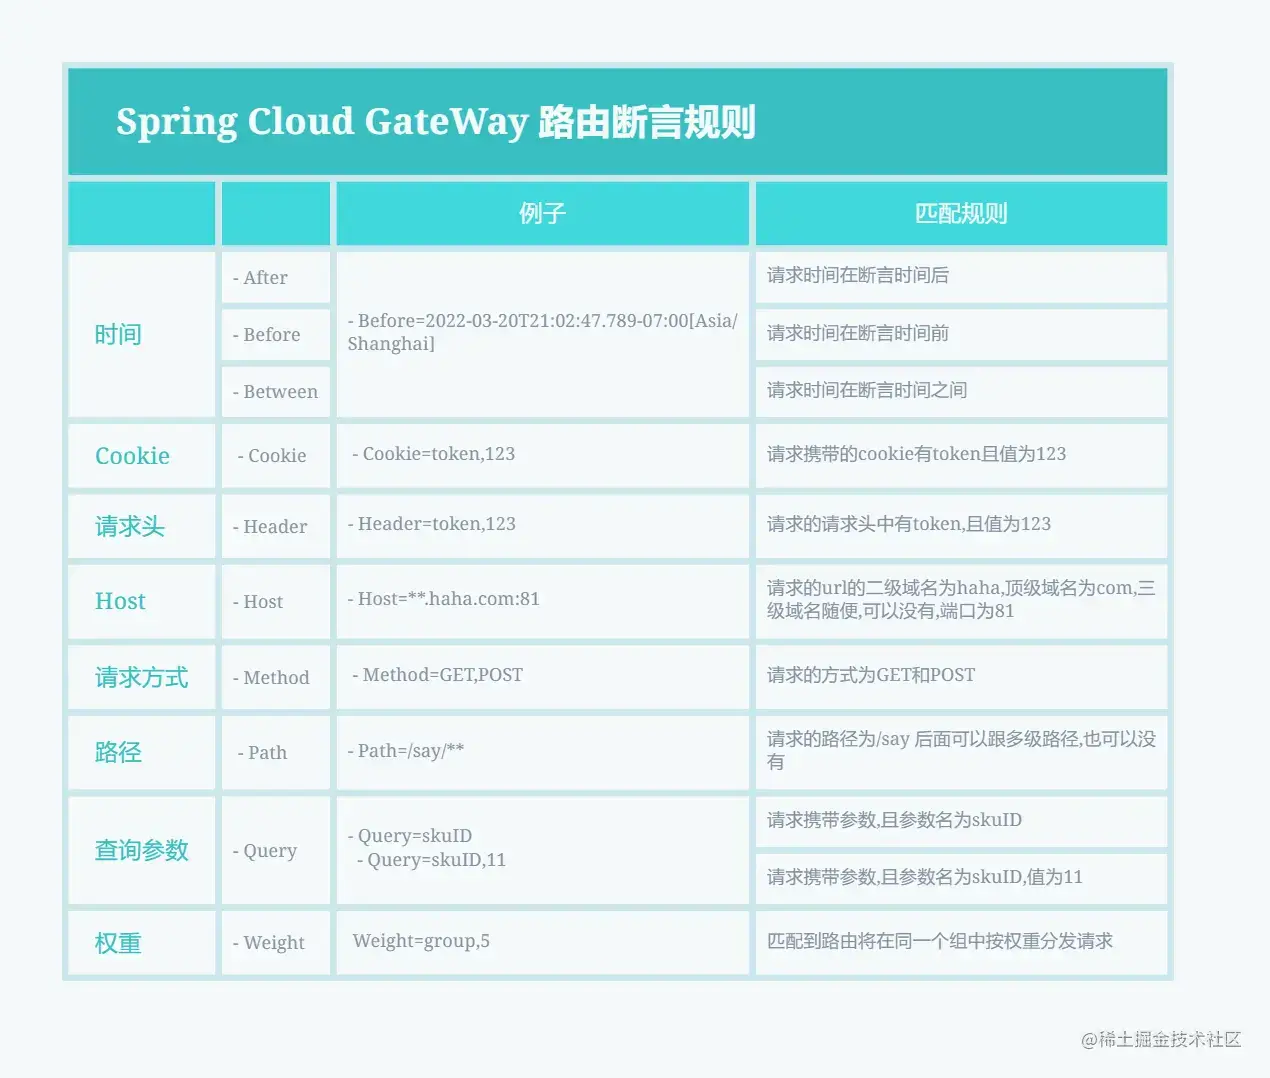
实现动态路由:
可以基于Nacos来做,Gateway可以从注册中心获取服务的元数据(服务名称、路径等),然后根据这些信息自动生成路由规则。这样,当服务实例被添加、移除、更新时,网关会自动感知并调整路由规则。(这些操作通过nacos server和nacos config即可完成)
过滤器
常见局部过滤器如下(标红为常用):
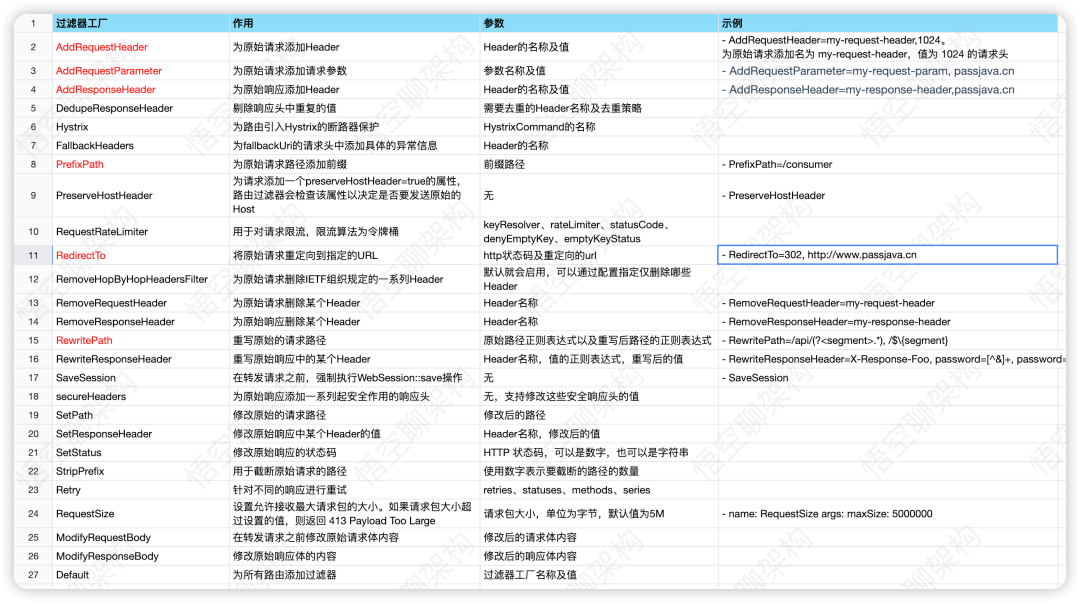
常见全局过滤器:
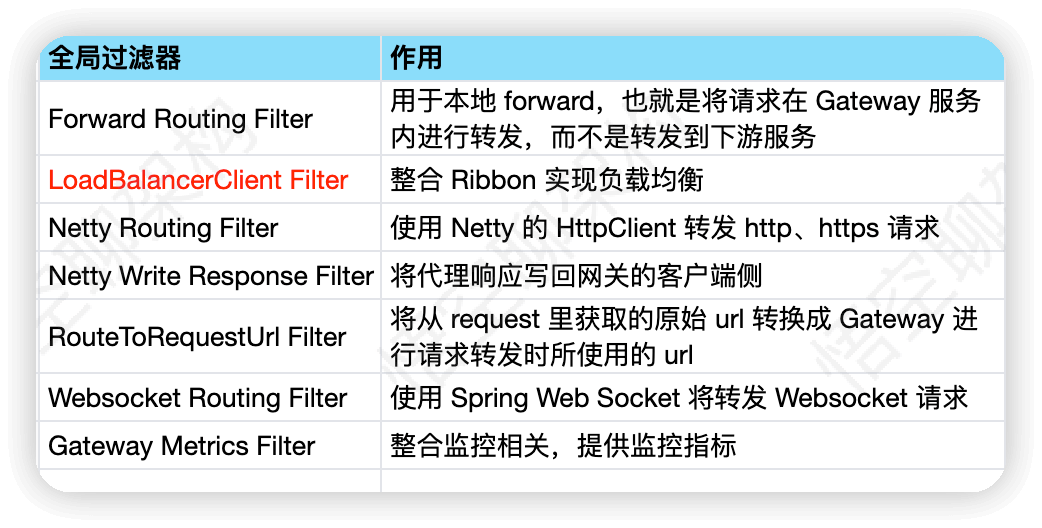
限流:
sentinel1.6引入了gateway适配模块,gateway可以结合sentinel来实现网关流量控制。
自定义全局异常处理:
在 SpringBoot 项目中捕获全局异常只需要在项目中配置 @RestControllerAdvice和 @ExceptionHandler就可以了。不过,这种方式在 Spring Cloud Gateway 下不适用。
Spring Cloud Gateway 提供了多种全局处理的方式,比较常用的一种是实现ErrorWebExceptionHandler并重写其中的handle方法。
1
2
3
4
5
6
7
8
9
10
11
public class GlobalErrorWebExceptionHandler implements ErrorWebExceptionHandler {
private final ObjectMapper objectMapper;
public Mono<Void> handle(ServerWebExchange exchange, Throwable ex) {
// ...
}
}
分布式事务
分布式系统的数据一致性问题,以及相关的一致性算法。
分布式基本理论——CAP,BASE
分布式数据一致性协议/共识算法——2PC,3PC,Paxos算法,Raft算法
分布式发散消息协议——Gossip协议
CAP理论
- consistency 数据一致性: 从不同服务器读到的数据是一致的。
- availability 系统可用性: 非故障的节点在合理的时间内返回合理的响应。
- partition tolerance 分区容忍性: 分布式系统出现网络分区的时候,仍然能够对外提供服务。
网络分区是指: 分布式系统中,多个节点之间的网络本来是连通的,但是因为某些故障(比如部分节点网络出了问题)某些节点之间不连通了,整个网络就分成了几块区域,这就叫 网络分区。
一般CAP是不能同时满足的,而P是必要的,只能从A和C中选一个满足,例如Zookeeper实现的是CP, 因为选举leader和同步时系统不能对外提供服务,不满足A。 还有HBase也是 CP 架构,Cassandra、Eureka 就是 AP 架构,Nacos 不仅支持 CP 架构也支持 AP 架构。
BASE理论
BASE本质上是AP方案的补充,因为没有出现分区故障时,CA是可以满足的,所以BASE要求分区故障时允许部分不可用或数据不一致,但系统恢复后需要数据达到最终一致性。
Basically Available 基本可用: 分布式系统在出现不可预知故障的时候,允许损失部分可用性。(如延长响应时间,非核心功能暂停使用)
Soft-state 软状态: 允许系统中的数据存在中间状态(CAP 理论中的数据不一致),并认为该中间状态的存在不会影响系统的整体可用性,即允许系统在不同节点的数据副本之间进行数据同步的过程存在延时。
Eventually Consistent 最终一致性: 最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能够达到一个一致的状态。
实现最终一致性的方案有:
- 读时修复 : 在读取数据时,检测到不同节点的数据不一致,进行修复。
- 写时修复(性能消耗小,推荐) : 在写入数据,检测数据的不一致时,进行修复。比如 Cassandra 的 Hinted Handoff 实现。具体来说,Cassandra 集群的节点之间远程写数据的时候,如果写失败 就将数据缓存下来,然后定时重传,修复数据的不一致性。
- 异步修复 : 这个是最常用的方式,通过定时对账检测副本数据的一致性,并修复。
2PC和3PC
二阶段提交——2PC(phase commit)
- 协调者: 发送prepare请求。
- 参与者:YES/NO(先执行事务,暂不提交)
- 协调者:发送commit请求。
- 参与者:YES/NO(提交事务)
缺点:
- 单点故障:如果协调者挂了,系统就不可用了。
- 阻塞:参与者执行了事务,但暂不提交,会一直占着资源不放;一旦协调者此时挂了,这些资源就无法释放。
- 数据不一致:协调者只发了部分commit就挂了,这样参与者之间的数据就不一致了。
三阶段提交——3PC
CanCommit阶段:
- 协调者:发送CanCommit请求。
- 参与者:确认是否能执行,发送YES/NO。
PreCommit阶段:
- 协调者:收到全部的YES,则可以发送PreCommit预提交请求。
- 参与者:执行事务,并写Undo和Redo日志,事务执行完发送YES。
如果协调者在此过程收到任意一个NO,或在一定时间内没有收到全部的响应,则向所有参与者发送中断请求(abort)。
DoCommit阶段:
- 协调者:发送DoCommit请求。
- 参与者:提交事务,返回YES。
如果协调者在此过程收到任意一个NO,或在一定时间内没有收到全部的响应,则向所有参与者发送中断请求,参与者通过Undo回滚。
3PC加入了很多超时中断的处理,可以缓解阻塞问题。但一致性问题仍没解决。—— 解决:Paxos算法
Paxos算法
Zookeeper的ZAB协议是根据paxos算法定制,主要支持崩溃恢复 和 消息广播。
是一种基于消息传递且具有高度容错特性的一致性算法。 解决的问题是在分布式系统中如何就某个值达成一致。
Paxos中有三个角色:
- Proposer提案者:每个提案者在提出提案时都会首先获取到一个具有全局唯一性的、递增的提案编号N。
- Acceptor表决者:仅会接收编号大于本地保存的最大编号的提案,并保存该提案编号N,反馈之前的最大编号给提案者。
- Learner学习者。
过程:
- prepare阶段:
- Porposer提案者: 将编号N赋予提案,向所有 表决者 发出提案。
- Acceptor表决者:仅会接收编号大于本地保存的最大编号的提案,并保存该提案编号N,反馈之前的最大编号给提案者。
- accept阶段:
- Porposer提案者: 收到超过半数 表决者 同意后,提案者会给所有 表决者 发送真正的提案(内容和提案编号)。
- Acceptor表决者: 比对编号是否大于本地最大编号,是的话就接收该提案,执行,但不提交,反馈给提案者accept。如果不接受提案或事务出错,则返回NO。
- Porposer提案者:收到超过半数的accept,就向所有表决者发送提案的提交请求。(也让有些未批准提案内容的表决者无条件执行并提交)。 如果没有收到超过半数的accept,就会递增提案的编号,重新进入prepare阶段。
注意:
- paxos算法在一段时间内,只能允许一个请求提交,否则会出现死循环。
Raft算法
Consul 是一个用于服务发现、配置管理和分布式一致性的工具,它使用了 Raft 算法来维护集群状态并保证一致性。
节点类型:
一个 Raft 集群包括若干服务器,在任意的时间,每个服务器一定会处于以下三个状态中的一个:
Leader:负责发起心跳,响应客户端,创建日志,同步日志。Candidate:Leader 选举过程中的临时角色,由 Follower 转化而来,发起投票参与竞选。Follower:接受 Leader 的心跳和日志同步数据,投票给 Candidate。
在正常的情况下,只有一个服务器是 Leader,剩下的服务器是 Follower。Follower 是被动的,它们不会发送任何请求,只是响应来自 Leader 和 Candidate 的请求。
任期:
raft 算法将时间划分为任意长度的任期(term),任期用连续的数字表示,记作当前 term 号。
每一个任期的开始都是一次选举,在选举开始时,一个或多个 Candidate 会尝试成为 Leader。如果一个 Candidate 赢得了选举,它就会在该任期内担任 Leader。如果没有选出 Leader,将会开启另一个任期,并立刻开始下一次选举。raft 算法保证在给定的一个任期最少要有一个 Leader。
每个节点都会存储当前的 term 号,当服务器之间进行通信时会交换当前的 term 号:
如果有服务器发现自己的 term 号比其他人小,那么他会更新到较大的 term 值。
如果一个 Candidate 或者 Leader 发现自己的 term 过期了,他会立即退回成 Follower。
如果一台服务器收到的请求的 term 号是过期的,那么它会拒绝此次请求。
Leader选举过程:
raft 使用心跳机制来触发 Leader 的选举:
如果一台服务器能够收到来自 Leader 或者 Candidate 的有效信息,那么它会一直保持为 Follower 状态,并且刷新自己的 electionElapsed,重新计时。
Leader 会向所有的 Follower 周期性发送心跳来保证自己的 Leader 地位。如果一个 Follower 在一个周期内没有收到心跳信息,就叫做选举超时,然后它就会认为此时没有可用的 Leader,并且开始进行一次选举以选出一个新的 Leader。
为了开始新的选举,Follower 会自增自己的 term 号并且转换状态为 Candidate。然后他会向所有节点发起 RequestVoteRPC 请求, Candidate 的状态会持续到以下情况发生:
- 赢得选举
- 其他节点赢得选举
- 一轮选举结束,无人胜出
赢得选举的条件是:一个 Candidate 在一个任期内收到了来自集群内的超过半数的选票(N/2+1),就可以成为 Leader。
在 Candidate 等待选票的时候,它可能收到其他节点声明自己是 Leader 的心跳,此时有两种情况:
- 该 Leader 的 term 号大于等于自己的 term 号,说明对方已经成为 Leader,则自己回退为 Follower。
- 该 Leader 的 term 号小于自己的 term 号,那么会拒绝该请求并让该节点更新 term。
由于可能同一时刻出现多个 Candidate,导致没有 Candidate 获得大多数选票,如果没有其他手段来重新分配选票的话,那么可能会无限重复下去。
raft 使用了随机的选举超时时间来避免上述情况。每一个 Candidate 在发起选举后,都会随机化一个新的选举超时时间,这种机制使得各个服务器能够分散开来,在大多数情况下只有一个服务器会率先超时;它会在其他服务器超时之前赢得选举。
数据同步:
当一个数据修改的请求过来,会直接找到 Leader 节点,所有的增删改查都由 Leader 受理。然后同步给各个 Follower。
每次数据同步操作同时也是一个心跳,会更新 Follower 的 election timeout。另外只有当多数节点返回同步成功之后,Leader 才会给客户端返回操作成功。
分布容错:
当出现网络分区时,比如原本五个节点的集群,被分成了双节点和三节点的两个集群。假设原本的 Leader 在双节点的集群里面,那么这个集群会照常运作。而新出现的三个节点的集群,由于没有收到心跳,会开始选举,然后选出新的 Leader。
这时候,如果有客户端发起请求,有可能发送到两个不同的 Leader 上面,如果发送到原来的那个 Leader 上,即双节点的集群中,Leader 把操作同步给 Follower,会发现收不到足够多的 Follower 响应(因为这个 Follower 还以为自己的集群是五个节点),然后就没办法同步数据。而三节点的新集群,就可以顺利更新数据。
如果这时候网络恢复了,各个节点又可以正常通信,三节点集群中的 Leader 和 双节点集群中的 Leader 会互相通信,然后会发现三节点的 Leader 由于一直正常运行,term 值会不断增大,所以大家会采信他的数据。于是双节点的两台机器会回滚,然后全部接受新 Leader 的数据同步。
Gossip协议-TODO
分布式ID
常见解决方案:
UUID
UUID 可以做到全局唯一性,但是一般很少会使用它。
因为UUID 作为 MySQL 数据库主键的时候就非常不合适:
- 数据库主键要尽量越短越好,而 UUID 的消耗的存储空间比较大(32 个字符串,128 位)。
- UUID 是无顺序的,InnoDB 引擎下,数据库主键的无序性会严重影响数据库性能。
优缺点 :
- 优点:生成速度比较快、简单易用
- 缺点:
- 存储消耗空间大(32 个字符串,128 位)
- 不安全(基于 MAC 地址生成 UUID 的算法会造成 MAC 地址泄露)
- 无序(非自增)
- 没有具体业务含义
- 需要解决重复 ID 问题(当机器时间不对的情况下,可能导致会产生重复 ID)
Snowflake
即雪花算法,Snowflake 由 64 bit 的二进制数字组成,这 64bit 的二进制被分成了几部分,每一部分存储的数据都有特定的含义:
- 第 0 位:符号位(标识正负),始终为 0,没有用,不用管。
- 第 1~41 位:一共 41 位,用来表示时间戳,单位是毫秒,可以支撑 2 ^41 毫秒(约 69 年)
- 第 42~52 位:一共 10 位,一般来说,前 5 位表示机房 ID,后 5 位表示机器 ID(实际项目中可以根据实际情况调整)。这样就可以区分不同集群/机房的节点。
- 第 53~64 位:一共 12 位,用来表示序列号。 序列号为自增值,代表单台机器每毫秒能够产生的最大 ID 数(2^12 = 4096),也就是说单台机器每毫秒最多可以生成 4096 个 唯一 ID。
使用:现在有很多基于 Snowflake 算法的开源实现比如美团 的 Leaf、百度的 UidGenerator,并且这些开源实现对原有的 Snowflake 算法进行了优化。
另外,在实际项目中,我们一般也会对 Snowflake 算法进行改造,最常见的就是在 Snowflake 算法生成的 ID 中加入业务类型信息。
Snowflake 算法的优缺点:
- 优点:生成速度比较快、生成的 ID 有序递增、比较灵活(可以对 Snowflake 算法进行简单的改造比如加入业务 ID)
- 缺点:需要解决重复 ID 问题(依赖时间,当机器时间不对的情况下,可能导致会产生重复 ID)。
开源框架
如 美团的 Leaf、百度的 UidGenerator,滴滴的 Tinyid 等。
而Zookeeper这类的中间件也可以用于生成唯一id。
分布式锁
对于单机多线程来说,在 Java 中通常使用 ReetrantLock 类、synchronized 关键字这类 JDK 自带的本地锁 来控制一个JVM进程内的多个线程对本地共享资源的访问。
而在分布式系统下,不同的服务/客户端通常运行在独立的 JVM 进程上。如果多个 JVM 进程共享同一份资源的话,就需要分布式锁来实现互斥访问了。
一个最基本的分布式锁需要满足:
- 互斥:任意一个时刻,锁只能被一个线程持有。
- 高可用:锁服务是高可用的,当一个锁服务出现问题,能够自动切换到另外一个锁服务。并且,即使客户端的释放锁的代码逻辑出现问题,锁最终一定还是会被释放,不会影响其他线程对共享资源的访问。这一般是通过超时机制实现的。
- 可重入:一个节点获取了锁之后,还可以再次获取锁。
除了上面这三个基本条件之外,一个好的分布式锁还需要满足下面这些条件:
- 高性能:获取和释放锁的操作应该快速完成,并且不应该对整个系统的性能造成过大影响。
- 非阻塞:如果获取不到锁,不能无限期等待,避免对系统正常运行造成影响。
实现方案中,Redis实现分布式锁 性能较高,ZooKeeper实现分布式锁 可靠性更高。
基于Redis
使用SETNX命令
锁的核心在于互斥,Redis中可用SETNX来实现互斥,如果key不存在才会设置值,如果存在则什么也不做。 要释放锁则直接删除对应的key即可。
1
2
3
4
5
6
7SETNX lockKey uniqueValue
(integer) 1
SETNX lockKey uniqueValue
(integer) 0
DEL lockKey
(integer) 1为了防止误删,应该使用lua脚本判断key对应的唯一值,lua脚本可以保证操作的原子性;
1
2
3
4
5
6// 释放锁时,先比较锁对应的 value 值是否相等,避免锁的误释放
if redis.call("get",KEYS[1]) == ARGV[1] then
return redis.call("del",KEYS[1])
else
return 0
end为了防止线程突然挂掉而无法释放锁,应该给锁设置一个过期时间;
1
SET lockKey uniqueValue EX 3 NX
不过有个问题就是,如果操作资源的时间大于过期时间,锁会提前过期,导致无法发挥分布式锁的功能; 如果过期时间设置太大,又会影响性能。 —— 解决办法是: 操作共享资源的操作还未完成时,锁过期时间能够自己续期;(使用Redisson)
使用Redisson分布式锁
Redisson 中的分布式锁自带自动续期机制,其原理是:使用一个专门用来监控和续期锁的 Watch Dog( 看门狗),如果操作共享资源的线程还未执行完成的话,Watch Dog 会不断地延长锁的过期时间,进而保证锁不会因为超时而被释放。
默认情况下,每过 10 秒,看门狗就会执行续期操作,将锁的超时时间设置为 30 秒。看门狗续期前也会先判断是否需要执行续期操作,需要才会执行续期,否则取消续期操作。
Redisson内置多种锁类型:可重入锁(Reentrant Lock)、自旋锁(Spin Lock)、公平锁(Fair Lock)、多重锁(MultiLock)、 红锁(RedLock)、 读写锁(ReadWriteLock)
使用:
以 Redisson 的分布式可重入锁 RLock 为例来设置分布式锁:
1
2
3
4
5
6
7
8// 1.获取指定的分布式锁对象
RLock lock = redissonClient.getLock("lock");
// 2.拿锁且不设置锁超时时间,具备 Watch Dog 自动续期机制
lock.lock();
// 3.执行业务
...
// 4.释放锁
lock.unlock();只有未指定锁超时时间,才会使用到 Watch Dog 自动续期机制。
1
2// 手动给锁设置过期时间,不具备 Watch Dog 自动续期机制
lock.lock(10, TimeUnit.SECONDS);
源码:
renewExpiration() 方法包含了看门狗的主要逻辑:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30private void renewExpiration() {
//......
Timeout task = commandExecutor.getConnectionManager().newTimeout(new TimerTask() {
public void run(Timeout timeout) throws Exception {
//......
// 异步续期,基于 Lua 脚本
CompletionStage<Boolean> future = renewExpirationAsync(threadId);
future.whenComplete((res, e) -> {
if (e != null) {
// 无法续期
log.error("Can't update lock " + getRawName() + " expiration", e);
EXPIRATION_RENEWAL_MAP.remove(getEntryName());
return;
}
if (res) {
// 递归调用实现续期
renewExpiration();
} else {
// 取消续期
cancelExpirationRenewal(null);
}
});
}
// 延迟 internalLockLeaseTime/3(默认 10s,也就是 30/3) 再调用
}, internalLockLeaseTime / 3, TimeUnit.MILLISECONDS);
ee.setTimeout(task);
}Watch Dog 通过调用 renewExpirationAsync() 方法实现锁的异步续期:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16protected CompletionStage<Boolean> renewExpirationAsync(long threadId) {
return evalWriteAsync(
getRawName(),
LongCodec.INSTANCE,
RedisCommands.EVAL_BOOLEAN,
// 判断是否为持锁线程,如果是就执行续期操作,就锁的过期时间设置为 30s(默认)
"if (redis.call('hexists', KEYS[1], ARGV[2]) == 1) then " +
"redis.call('pexpire', KEYS[1], ARGV[1]); " +
"return 1; " +
"end; " +
"return 0;",
Collections.singletonList(getRawName()),
internalLockLeaseTime,
getLockName(threadId)
);
}
问题:
Redis 集群数据同步到各个节点时是异步的,如果在 Redis 主节点获取到锁后,在没有同步到其他节点时,Redis 主节点宕机了,此时新的 Redis 主节点依然可以获取锁,所以多个应用服务就可以同时获取到锁。
解决办法是使用Redlock 算法(直接操作 Redis 节点,客户端和半数以上的节点完成加锁操作才认为获得分布式锁),以此保证可靠性,但性能会变差很多,往往不会用。一般单机Redis就够用了。
基于Zookeeper
ZooKeeper 分布式锁是基于 临时顺序节点 和 Watcher(事件监听器) 实现的。
获取锁:
- 首先我们要有一个持久节点/locks,客户端获取锁就是在locks下创建临时顺序节点。
- 假设客户端 1 创建了**/locks/lock1**节点,创建成功之后,会判断 lock1是否是 /locks 下最小的子节点。
- 如果 lock1是最小的子节点,则获取锁成功。
- 否则,获取锁失败。
- 如果获取锁失败,则说明有其他的客户端已经成功获取锁。客户端 1 不会循环去尝试加锁,而是在前一个节点比如**/locks/lock0上注册一个事件监听器**。这个监听器的作用是在前一个节点释放锁之后通知客户端 1(避免无效自旋),这样客户端 1 就加锁成功了。
释放锁:
- 成功获取锁的客户端在执行完业务流程之后,会将对应的子节点删除。
- 成功获取锁的客户端在出现故障之后,对应的子节点由于是临时顺序节点,也会被自动删除,避免了锁无法被释放。 (事件监听器监听的就是这个子节点删除事件,子节点删除就意味着锁被释放。)
实际项目中,推荐使用 Curator 来实现 ZooKeeper 分布式锁。
Curator主要实现了下面四种锁:
- InterProcessMutex:分布式可重入排它锁
- InterProcessSemaphoreMutex:分布式不可重入排它锁
- InterProcessReadWriteLock:分布式读写锁
- InterProcessMultiLock:将多个锁作为单个实体管理的容器,获取锁的时候获取所有锁,释放锁也会释放所有锁资源(忽略释放失败的锁)。
1 | CuratorFramework client = ZKUtils.getClient(); |
问题
过滤器和拦截器的区别
过滤器Filter基于Servlet实现,主要应用场景是对字符编码、跨域等问题进行过滤。原理是拦截配置好的客户端请求,然后对Request和Response进行处理。Filter过滤器随着web应用的启动而启动,只初始化一次。
Filter的使用比较简单,继承Filter 接口,实现对应的init、doFilter以及destroy方法即可。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20public class MyFilter implements Filter {
// 在容器启动时调用初始化方法,只会初始化一次
public void init(FilterConfig filterConfig) throws ServletException {
System.out.println("初始化拦截器");
}
// 每次请求都会调用doFilter方法,通过FilterChain 调用后续的方法
public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {
//做一些处理
chain.doFilter(request,response);
}
// 当容器销毁时,执行destory方法,只会被调用一次。
public void destroy() {
System.out.println("销毁拦截器");
}
}拦截器interceptor 是SpringMVC中的一种基于Java反射(动态代理)机制的方法增强工具。
拦截器的实现是 继承HandlerInterceptor 接口,并实现接口的preHandle、postHandle和afterCompletion方法, 以及配置一个拦截器config类。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51// 编写一个拦截器
public class UserInterceptor implements HandlerInterceptor {
// 请求方法前置拦截,该方法会在Controller处理之前进行调用;
// Spring中可以有多个Interceptor,这些拦截器会按照设定的Order顺序调用;
// 当有一个拦截器在preHandle中返回false的时候,请求就会终止。
public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {
System.out.println("preHandle");
String userName=request.getParameter("userName");
String password = request.getParameter("password");
if (userName==null||password==null){
response.setStatus(500);
response.setContentType("text/html; charset=UTF-8");
response.getWriter().print("参数缺失");
return false;
}
//进行用户校验
if (userName.equals("admin")&&password.equals("admin")){
return true;
}else {
response.setStatus(500);
response.setContentType("text/html; charset=UTF-8");
response.getWriter().print("用户名或密码错误");
return false;
}
}
// 在Controller方法执行之后,视图渲染之前被调用
public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, ModelAndView modelAndView) throws Exception {
System.out.println("postHandle");
}
// 在整个请求结束之后,执行该方法。
public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) throws Exception {
System.out.println("afterCompletion");
}
}
// 拦截器配置类
public class MvcConfig implements WebMvcConfigurer {
private UserInterceptor userInterceptor;
public void addInterceptors(InterceptorRegistry registry) {
registry.addInterceptor(userInterceptor)
.addPathPatterns("/**")
.excludePathPatterns("/error");
}
}过滤器和拦截器的比较区别:
相同点: 1.都体现了AOP的思想,对方法实现增强,都可以拦截请求方法; 2.都可以通过Order注解设定执行顺序
不同:
过滤器属于Servlet级别,拦截器属于Spring级别
Filter是在javax.servlet包中定义的,要依赖于网络容器,因此只能在web项目中使用。
Interceptor是SpringMVC中实现的,拦截器是一个Spring组件,由Spring容器进行管理。
过滤器基于函数回调方式实现,拦截器基于Java反射机制实现。
应用场景不同:(实际开发中,拦截器的应用场景会比过滤器要更多)
- 拦截器景:权限控制,日志打印,参数校验
- 过滤器:跨域问题解决,编码转换
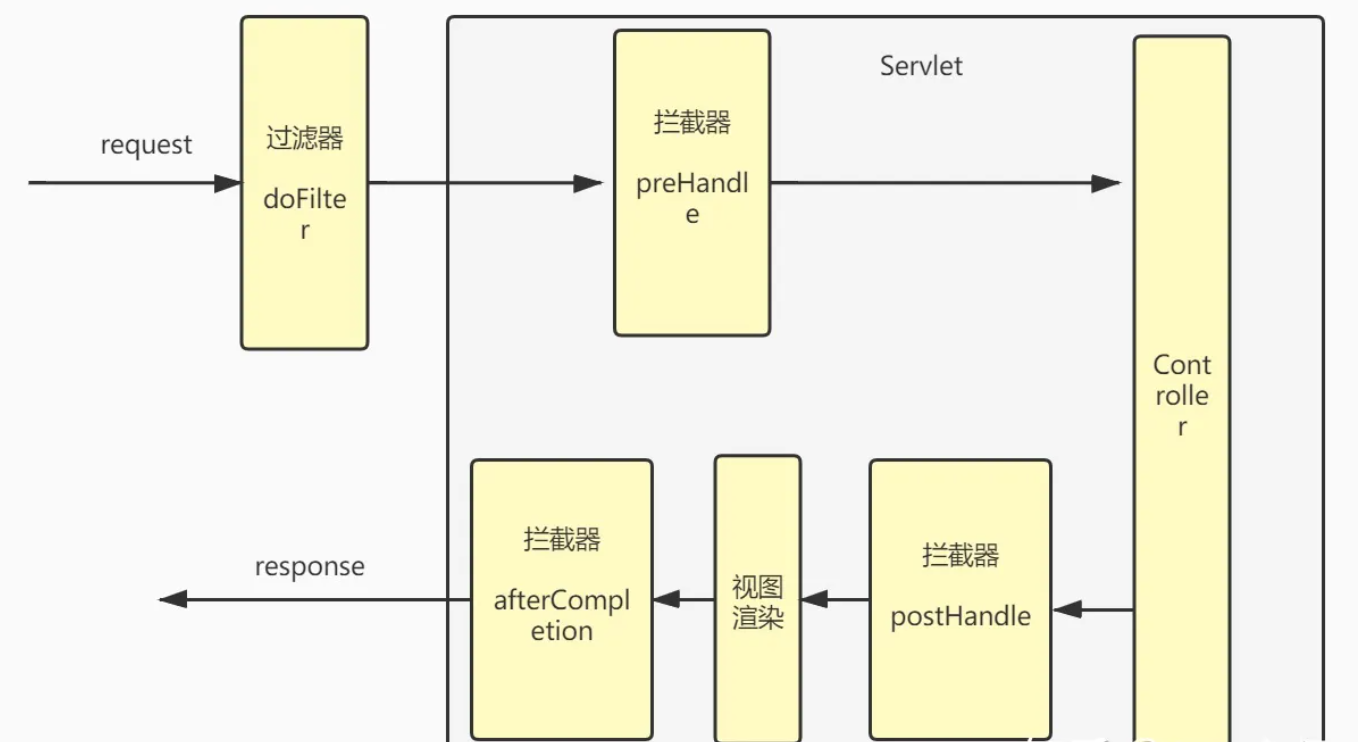
执行顺序不一样:
首先当一个请求进入Servlet之前,先通过过滤器的doFilter方法进行过滤;
进入Servlet容器之后,执行Controller方法之前,拦截器的preHandle方法进行拦截;
执行Controller方法之后,视图渲染之前,拦截器的postHandle方法进行拦截;
请求结束之后,执行拦截器的postHandle方法。
Mybatis的一二级缓存
一级缓存的作用域是SQlSession, Myabits默认开启一级缓存。
在同一个SqlSession中,执行相同的SQL查询时;第一次会去查询数据库,并写在缓存中,第二次会直接从缓存中取。 当执行SQL时候两次查询中间发生了增删改的操作,则SQLSession的缓存会被清空。
缓存开启时,每次查询会先去缓存中找,如果找不到,再去数据库查询,然后把结果写到缓存中。 Mybatis的内部缓存使用一个HashMap,key为hashcode+statementId+sql语句。Value为查询出来的结果集映射成的java对象。 SqlSession执行insert、update、delete等操作commit后会清空该SQLSession缓存。
- 问题: 不同sqlsession对同一条数据操作,可能会出现数据不一致现象(例: sqlsession-A进行更新操作,则A对应的一级缓存被清空;然后sqlsession-B进行更新操作,此时B的更新对A不可见,A紧接着去查数据,得到的就是过时数据 )
- 建议:单个sqlsession的生命周期不能过长; 如果是对同一个语句更新尽量使用同一个sql,也就是同一个sqlsession;
Mybatis二级缓存是默认不开启的,二级缓存作用于同一个namespace下的所有操作语句,影响着同一个Cache,是Mapper级别的,即多个SqlSession使用同一个Mapper的sql能够使用二级缓存。
当开启缓存后,查询数据的流程就是 二级缓存 -> 一级缓存 -> 数据库。
- 问题:1. 对某个表的操作和查询必须写在同一个namespace下,不然涉及其他的namespace对该表操作就会有问题,会脏数据; 2. 对表的关联查询,关联的所有表的操作都必须在同一个namespace下(这个就不太现实了);
SqlSession相当于一个JDBC的Connection对象,在一次请求事务会话后,我们会将它关闭。它可以为我们获得Mapper, 而Mapper用于发送SQL语句并返回执行结果。
建议: 不建议使用Mybatis的一二级缓存,如果需要缓存热点数据,可以用第三方缓存应用,如redisden
