计算机网络1.0
概述
计算机网络已由一种通信基础设施发展为一种重要的信息服务基础设施。
概述
网络、互联网 和 因特网:
网络:网络(Network)由若干结点(Node)和连接这些结点的链路(Link)组成。
互连网(互联网):多个网络通过路由器互连起来,这样就构成了一个覆盖范围更大的网络,即互连网(互联网)。因此,互联网又称为“网络的网络(Network of Networks)”。

因特网:因特网(Internet)是世界上最大的互连网络(用户数以亿计,互连的网络数以百万计)。
internet与Internet的区别
- internet(互联网或互连网)是一个通用名词,它泛指多个计算机网络互连而成的网络。在这些网络之间的通信协议可以是任意的。
- Internet(因特网)则是一个专用名词,它指当前全球最大的、开放的、由众多网络互连而成的特定计算机网络,它采用TCP/IP协议族作为通信的规则,其前身是美国的ARPANET。
任意把几个计算机网络互连起来(不管采用什么协议),并能够相互通信,这样构成的是一个互连网(internet) ,而不是因特网(Internet)。
因特网发展的三个阶段:
一,从单个网络AEPANET向互联网发展
1969年,第一个分组交换网AEPANET;
70年代中期,研究多种网络之间的互联;
1983年,TCP/IP协议成为ARPANET的标准协议(因特网诞生)
二,逐步建成三级结构的因特网
1985年,NSF围绕六个大型计算机中心建设NSFNET(主干网,地区网,校园网);
1990年,ARPANET任务完成,正式关闭;
1991年,美国政府将因特网主干网交给私人公式经营,并开始对接入因特网的单位收费;
三,逐步形成了多层次的ISP结构的因特网
1993年,NSFNET逐渐被若干个商用因特网主干网替代,政府不再负责因特网运营,让各种因特网服务提供者ISP来运营;
1994年,万维网WWW技术促使因特网迅速发展;
1995年,NSFNET停止运作,因特网彻底商业化
因特网服务提供者ISP(Internet Service Provider)
普通用户是如何接入到因特网的呢?
答:通过ISP接入因特网
ISP可以从因特网管理机构申请到成块的IP地址,同时拥有通信线路以及路由器等联网设备。任何机构和个人只需缴纳费用,就可从ISP的得到所需要的IP地址。
因为因特网上的主机都必须有IP地址才能进行通信,所以要通过该ISP接入到因特网
中国的三大
ISP:中国电信,中国联通和中国移动一旦某个用户能够接入到因特网,那么他也可以成为一个ISP,所需要做的就是购买一些如调制解调器或路由器这样的设备,让其他用户可以和他相连。
因特网的标准化工作:
因特网的标准化工作对因特网的发展起到了非常重要的作用。
因特网在指定其标准上的一个很大的特点是
面向公众。
- 因特网所有的RFC(Request For Comments)技术文档都可从因特网上免费下载;
- 任何人都可以随时用电子邮件发表对某个文档的意见或建议。
因特网协会ISOC
是一个国际性组织,它负责对因特网进行全面管理,以及在世界范围内促进其发展和使用。
- 因特网体系结构委员会IAB,负责管理因特网有关协议的开发;
- 因特网工程部IETF,负责研究中短期工程问题,主要针对协议的开发和标准化;
- 因特网研究部IRTF,从事理论方面的研究和开发一些需要长期考虑的问题。
制订因特网的正式标准要经过以下4个阶段:
1、因特网草案(在这个阶段还不是RFC文档)
2、建议标准(从这个阶段开始就成为RFC文档)
3、草案标准
4、因特网标准
组成
边缘部分
由所有连接在因特网上的主机组成(台式电脑,大型服务器,笔记本电脑,平板,智能手机等)。这部分是用户直接使用的,用来进行通信(传送数据、音频或视频)和资源共享。
核心部分
由大量网络和连接这些网络的路由器组成。这部分是为边缘部分提供服务的(提供连通性和交换)。
路由器是一种专用计算机,但我们不称它为主机,路由器是实现分组交换的关键构建,其任务是转发收到的分组,这是网络核心最重要的部分。
处在互联网边缘的部分就是连接在互联网上的所有的主机。这些主机又称为**端系统 (end system)**。
端系统在功能上可能有很大的差别:
- 小的端系统可以是一台普通个人电脑,具有上网功能的智能手机,甚至是一个很小的网络摄像头。
- 大的端系统则可以是一台非常昂贵的大型计算机。
- 端系统的拥有者可以是个人,也可以是单位(如学校、企业、政府机关等),当然也可以是某个ISP。
端系统之间通信的含义
“主机 A 和主机 B 进行通信”实际上是指:“运行在主机 A 上的某个程序和运行在主机 B 上的另一个程序进行通信”。即“主机 A 的某个进程和主机 B 上的另一个进程进行通信”。简称为“计算机之间通信”。
端系统之间的通信方式通常可划分为两大类:
客户-服务器方式(C/S方式):
- 客户 (client) 和服务器 (server) 都是指通信中所涉及的两个应用进程。
- 客户 - 服务器方式所描述的是进程之间服务和被服务的关系。
- 客户是服务的请求方,服务器是服务的提供方。
服务请求方和服务提供方都要使用网络核心部分所提供的服务。
对等连接方式:
- 对等连接 (peer-to-peer,简写为 P2P ) 是指两个主机在通信时并不区分哪一个是服务请求方还是服务提供方。
- 只要两个主机都运行了对等连接软件 ( P2P 软件) ,它们就可以进行平等的、对等连接通信。
- 双方都可以下载对方已经存储在硬盘中的共享文档。
三种交换方式
网络核心部分是互联网中最复杂的部分。
网络中的核心部分要向网络边缘中的大量主机提供连通性,使边缘部分中的任何一个主机都能够向其他主机通信(即传送或接收各种形式的数据)。
在网络核心部分起特殊作用的是路由器(router)。
路由器是实现分组交换 (packet switching) 的关键构件,其任务是转发收到的分组,这是网络核心部分最重要的功能。
三种交换方式:
分组交换
(Packet Switching)
通常我们把表示该消息的整块数据成为一个报文。
在发送报文之前,先把较长的报文划分成一个个更小的等长数据段,在每一个数据段前面。加上一些由必要的控制信息组成的首部后,就构成一个分组,也可简称为“包”,相应地,首部也可称为“包头”。
首部包含了分组的目的地址
分组从源主机到目的主机,可走不同的路径。
发送方
- 构造分组
- 发送分组
路由器
缓存分组
转发分组
简称为“分组转发”
在路由器中的输入和输出端口之间没有直接连线。
路由器处理分组的过程是:
- 把收到的分组先放入缓存(暂时存储);
- 查找转发表,找出到某个目的地址应从哪个端口转发;
- 把分组送到适当的端口转发出去。
接收方
- 接收分组
- 还原报文
报文交换(Message Switching)
报文交换中的交换结点也采用存储转发方式,但报文交换对报文的大小没有限制,这就要求交换结点需要较大的缓存空间。报文交换主要用于早期的电报通信网,现在较少使用,通常被较先进的分组交换方式所取代。
电路交换(Circuit Switching)
传统两两相连的方式,当电话数量很多时,电话线也很多,就很不方便
所以要使得每一部电话能够很方便地和另一部电话进行通信,就应该使用一个中间设备将这些电话连接起来,这个中间设备就是电话交换机
电话交换机接通电话线的方式称为电路交换;
从通信资源的分配角度来看,交换(Switching)就是按照某种方式动态地分配传输线路的资源;
电路交换的三个步骤:
1、建立连接(分配通信资源)
2、通话(一直占用通信资源)
3、释放连接(归还通信资源)
当使用电路交换来传送计算机数据时,其线路的传输效率往往很低。
这是因为计算机数据是突发式地出现在传输线路上的。
所以计算机通常采用的是分组交换,而不是线路交换
三种交换方式的对比
假设A,B,C,D是分组传输路径所要经过的4个结点交换机,纵坐标为时间
分析:

电路交换:
- 通信之前首先要建立连接;连接建立好之后,就可以使用已建立好的连接进行数据传送;数据传送后,需释放连接,以归还之前建立连接所占用的通信线路资源。
- 一旦建立连接,中间的各结点交换机就是直通形式的,比特流可以直达终点;
报文交换:
- 可以随时发送报文,而不需要事先建立连接;整个报文先传送到相邻结点交换机,全部存储下来后进行查表转发,转发到下一个结点交换机。
- 整个报文需要在各结点交换机上进行存储转发,由于不限制报文大小,因此需要各结点交换机都具有较大的缓存空间。
分组交换:
- 可以随时发送分组,而不需要事先建立连接。构成原始报文的一个个分组,依次在各结点交换机上存储转发。各结点交换机在发送分组的同时,还缓存接收到的分组。
- 构成原始报文的一个个分组,在各结点交换机上进行存储转发,相比报文交换,减少了转发时延,还可以避免过长的报文长时间占用链路,同时也有利于进行差错控制。
定义和分类
定义
计算机网络的精确定义并未统一
计算机网络的最简单的定义是:一些互相连接的、自治的计算机的集合
- 互连:是指计算机之间可以通过有线或无线的方式进行数据通信;
- 自治:是指独立的计算机,他有自己的硬件和软件,可以单独运行使用;
- 集合:是指至少需要两台计算机;
计算机网络的较好的定义是:计算机网络主要是由一些通用的,可编程的硬件(一定包含有中央处理机CPU)互连而成的,而这些硬件并非专门用来实现某一特定目的(例如,传送数据或视频信号)。这些可编程的硬件能够用来传送多种不同类型的数据,并能支持广泛的和日益增长的应用。
- 计算机网络所连接的硬件,并不限于一般的计算机,而是包括了智能手机等智能硬件。
计算机网络并非专门用来传送数据,而是能够支持很多种的应用(包括今后可能出现的各种应用)。
分类:
按交换技术分类:
- 电路交换网络
- 报文交换网络
- 分组交换网络
按使用者分类:
公用网
专用网
按传输介质分类:
- 有线网络
- 无线网络
按覆盖范围分类:
- 广域网WAN(Wide Area Network)
作用范围通常为几十到几千公里,因而有时也称为远程网(long haul network)。广域网是互联网的核心部分,其任务是通过长距离(例如,跨越不同的国家)运送主机所发送的数据。
- 城域网MAN
作用范围一般是一个城市,可跨越几个街区甚至整个城市
- 局域网LAN
一般用微型计算机或工作站通过高速通信线路相连(速率通常在 10 Mbit/s 以上),但地理上范围较小(1 km 左右)
- 个域网PAN
就是在个人工作的地方把个人使用的电子设备用无线技术连接起来的网络。
按拓扑结构分类:
总线型网络
星型网络
环形网络
网状型网络

性能指标
速率 ,带宽,吞吐量,时延
时延带宽积,往返时间RTT,利用率,丢包率
速率

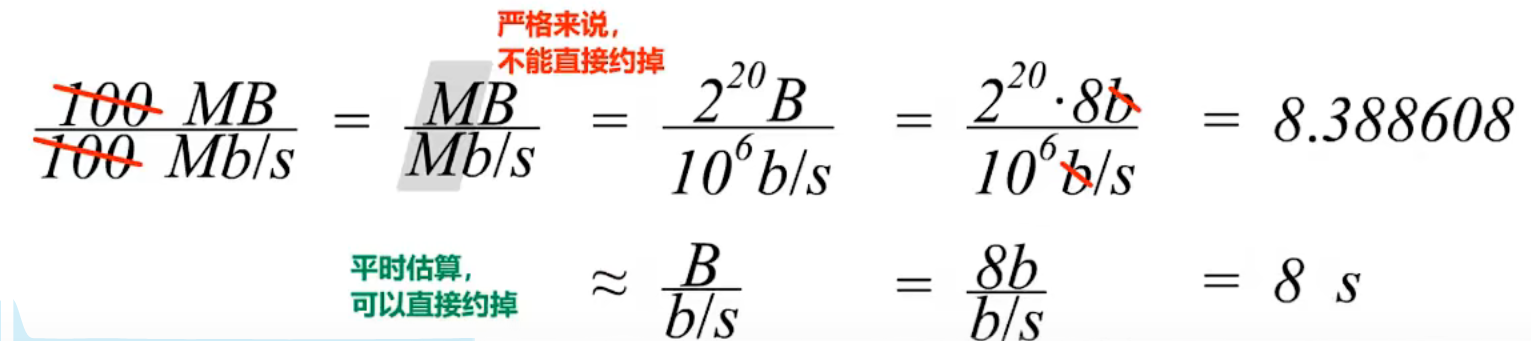
带宽
带宽在计算机网络中的意义:
用来表示网络的通信线路所能传送数据的能力,因此网络带宽表示在单位时间内从网络中的某一点到另一点所能通过的“最高数据率”;
单位:b/s (kb/s,Mb/s,Gb/s,Tb/s)
平时说的出口网速 200兆之类,就是指带宽200Mb/s
带宽在模拟信号系统中的意义:
信号所包含的各种不同频率成分所占据的频率范围;
单位:Hz (kHz,MHz,GHz)
吞吐量
吞吐量表示在单位时间内通过某个网络 (或信道、接口) 的数据量。吞吐量被经常用于对现实世界中的网络的一种测量,以便知道实际上到底有多少数据量能够通过网络。
吞吐量受网络的带宽或额定速率的限制。
带宽1 Gb/s的以太网,代表其额定速率是1 Gb/s,这个数值也是该以太网的吞吐量的绝对上限值。因此,对于带宽1 Gb/s的以太网,可能实际吞吐量只有 700 Mb/s,甚至更低。
注意:吞吐量还可以用每秒传送的字节数或帧数表示
时延
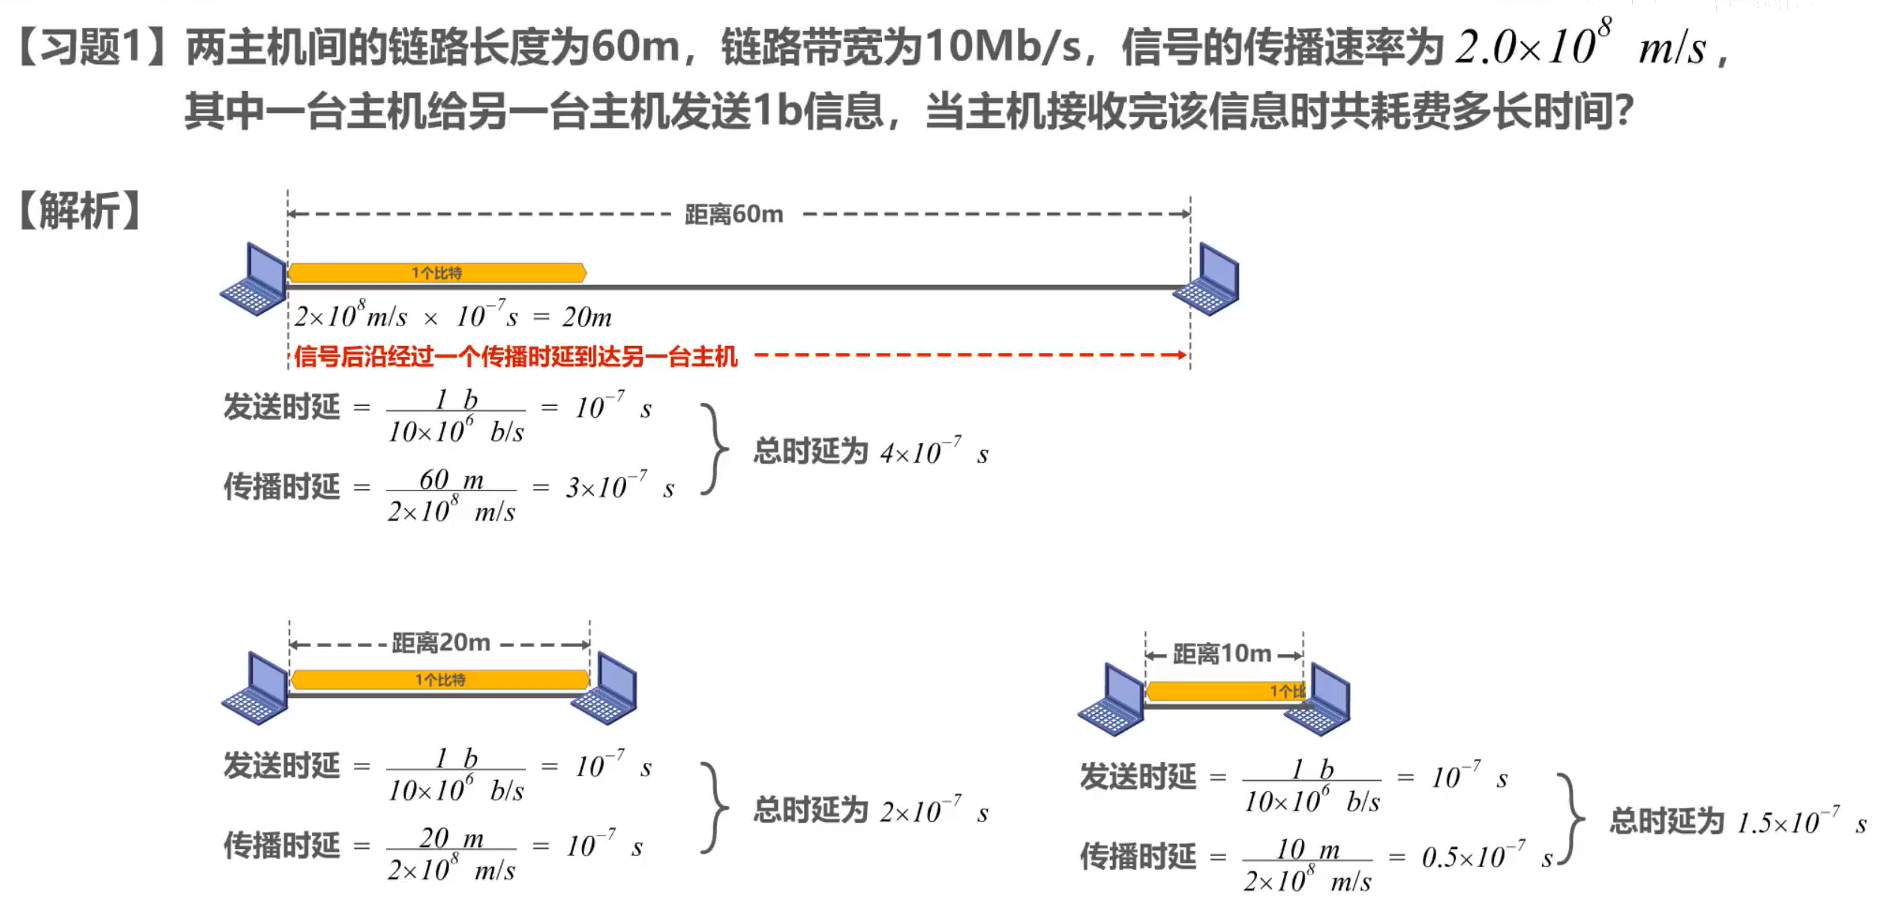
时延时指数据(一个报文或分组,甚至比特)从网络(或链路)的一端传送到另一端所需的时间。
网络时延由几部分组成:
- 发送时延 = 分组长度(b) / 发送速率 (b/s)
主机或路由器发送数据帧所需要的时间,也就是从发送数据帧的第一个比特算起,到该帧的最后一个比特发送完毕所需的时间。
- 传播时延 = 信道长度(m) / 电磁波传播速率(m/s)
电磁波在信道中传播一定的距离需要花费的时间。
常见的电磁波传播速率:
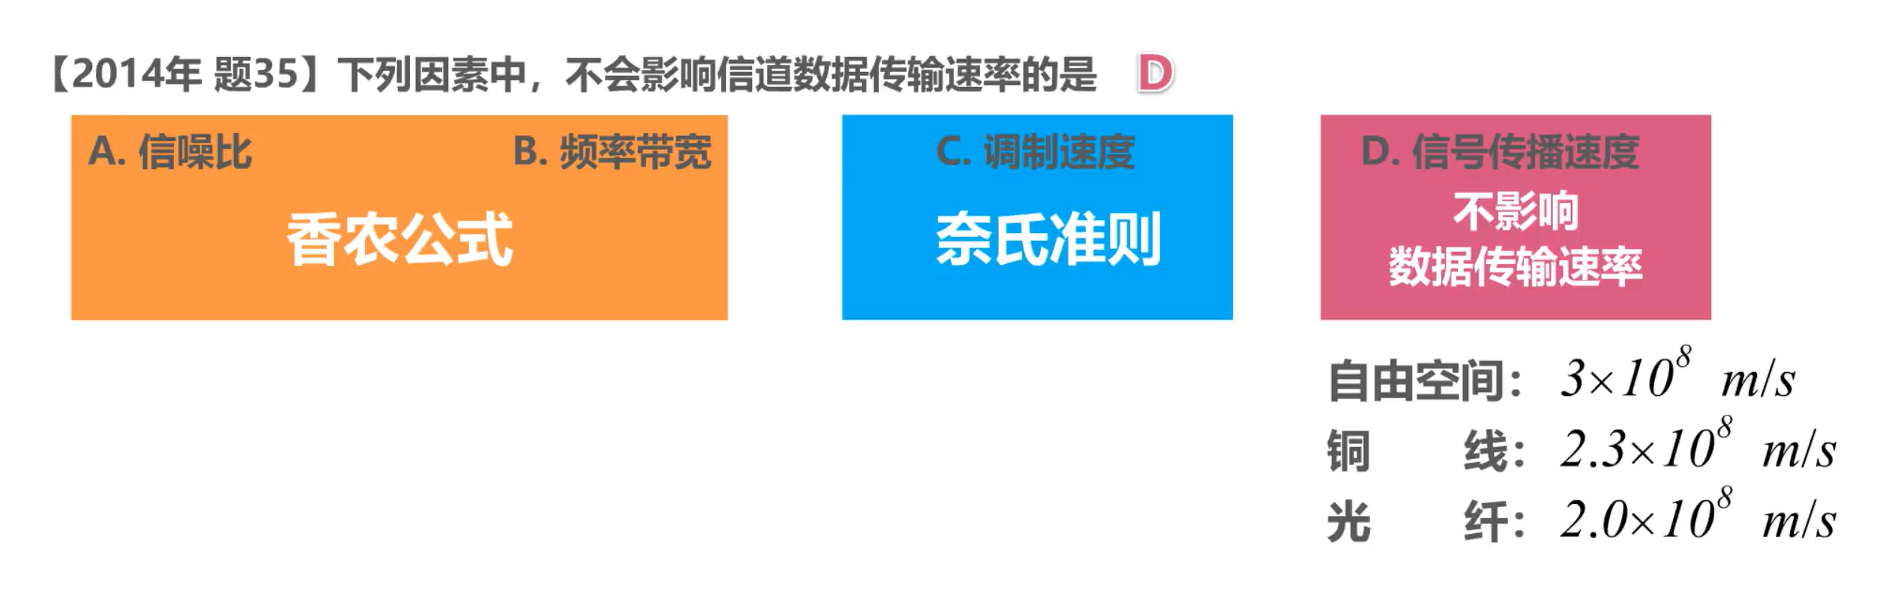
自由空间: 3 * 10^8^ m/s
铜线:2.3 * 10^8^ m/s
光纤:2.0 * 10^8^ m/s
- 处理时延
主机或路由器在收到分组时要花费一定时间进行处理
- 排队时延
分组在进过网络传输时,要经过许多路由器。但分组在进入路由器后要先在输入队列中排队等待处理。
有时会把排队时延看成处理时延 一部分
总时延 = 发送时延 + 传播时延 + 处理时延 (处理时延 + 排队时延)
当处理时延忽略不计时,发送时延 和 传播时延谁占主导,要具体情况具体分析
时延带宽积
时延带宽积 = 传播时延 * 带宽
可以把时延带宽积看作一个圆柱体管道,传播时延是长度,带宽的圆柱面积,则时延带宽积就是圆柱的体积。
往返时间RTT
互联网上的信息很多时候是双向交互的。往返时间RTT(route-trip-time)就是双向交互一次所需的时间。
利用率
利用率有信道利用率和网络利用率两种。
- 信道利用率:用来表示某信道有百分之几的时间是被利用的。(有数据通过)
- 网络利用率:全网络的信道利用率的加权平均。
根据排队论,当某信道的利用率增大时,该信道的时延也会迅速增加。对此,信道利用率不是越多越好。
令U为利用率,D0表示网络空闲时的时延,D表示网络当前的时延,那么在适当的假定条件下,可以用简单公司来表示: D = D0 / (1-U ) 或 U = 1 - D0/D
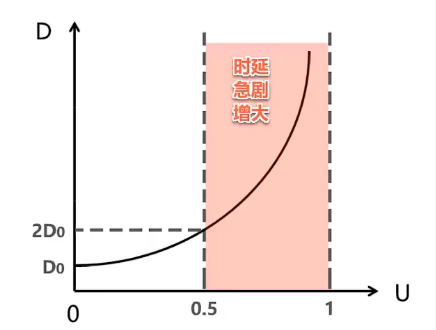
一般ISP会控制他们的信道利用率不超过50%,否则就要准备扩容增大线路带宽。
丢包率
即分组丢失率,指在一定的时间范围内,传输过程中丢失的分组数量于总分组数量的比率。
分组丢失主要分为:
- 分组在传输过程中出现误码,被节点丢弃;
- 分组到达一台队列已满的分组交换机时会被丢弃,在通信量较大时可能造成网络拥塞。
体系结构
概述
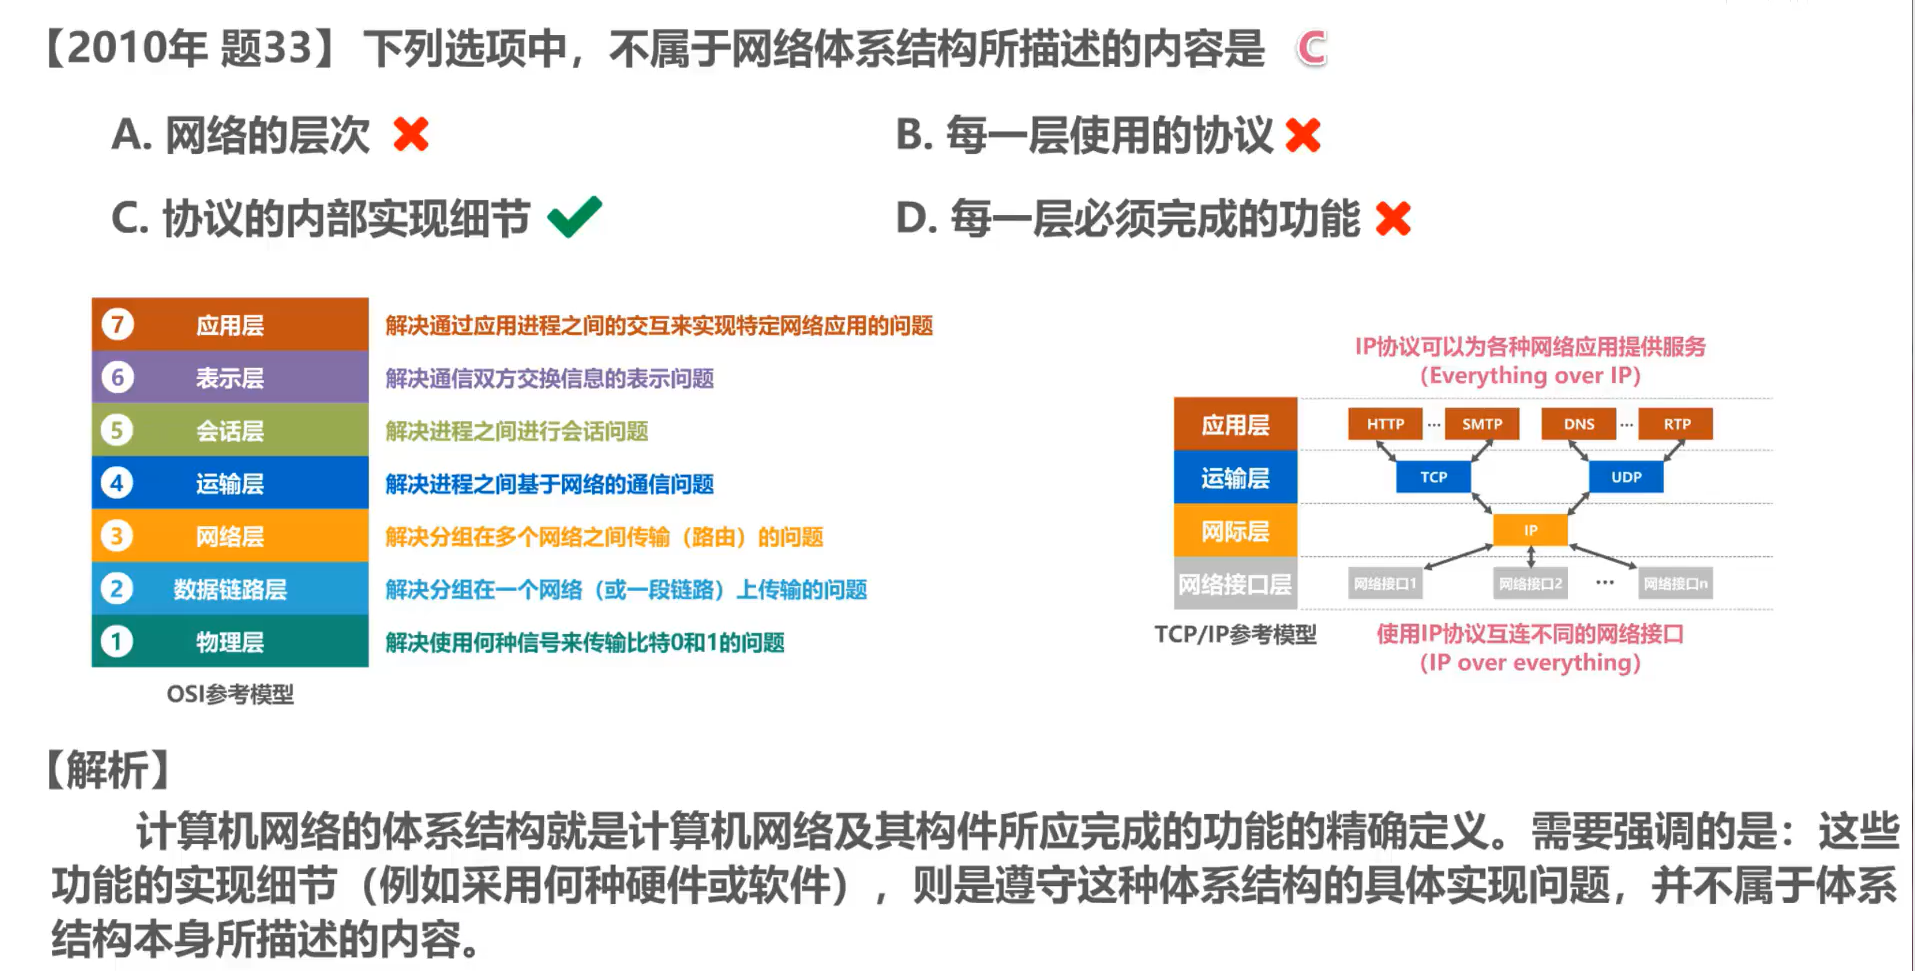
常见体系结构:
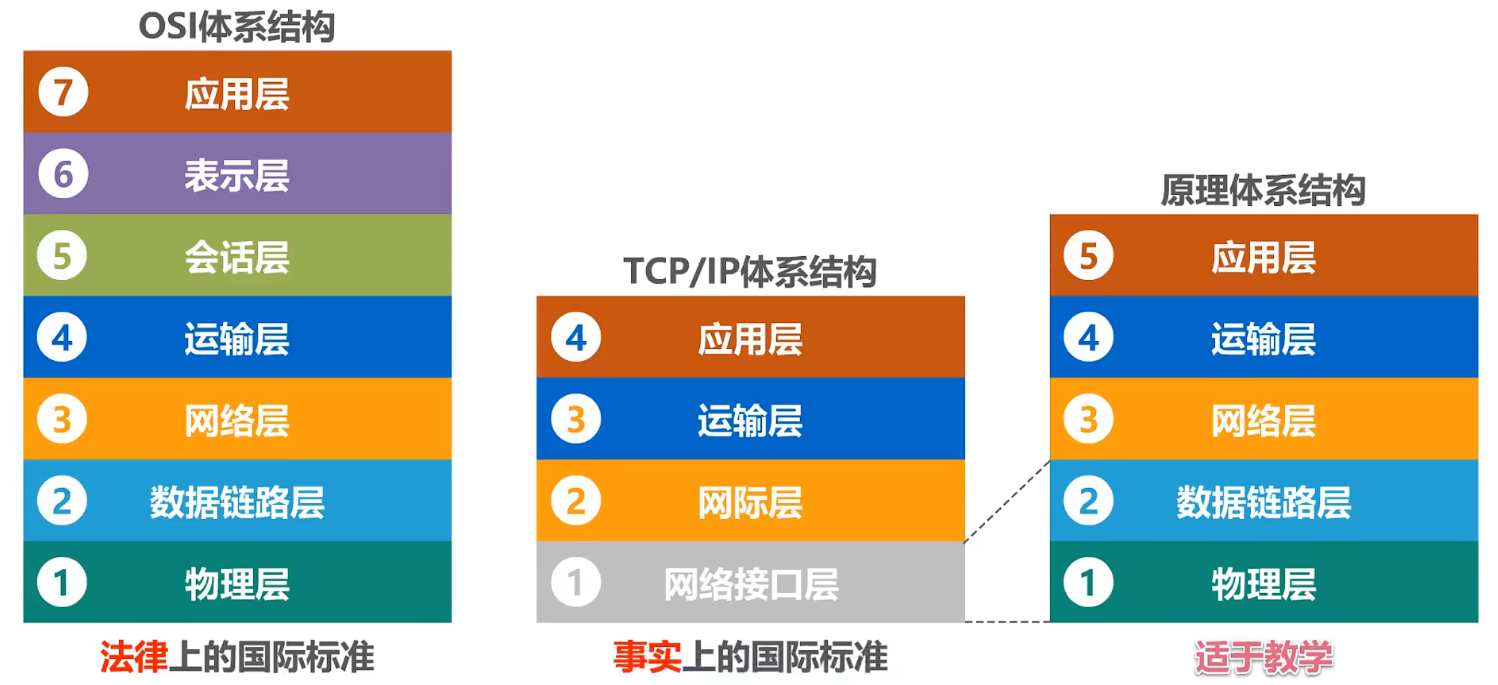
如今用的最多的是TCP/IP体系结构,现今规模最大的、覆盖全球的、基于TCP/IP的互联网并未使用OSI标准。
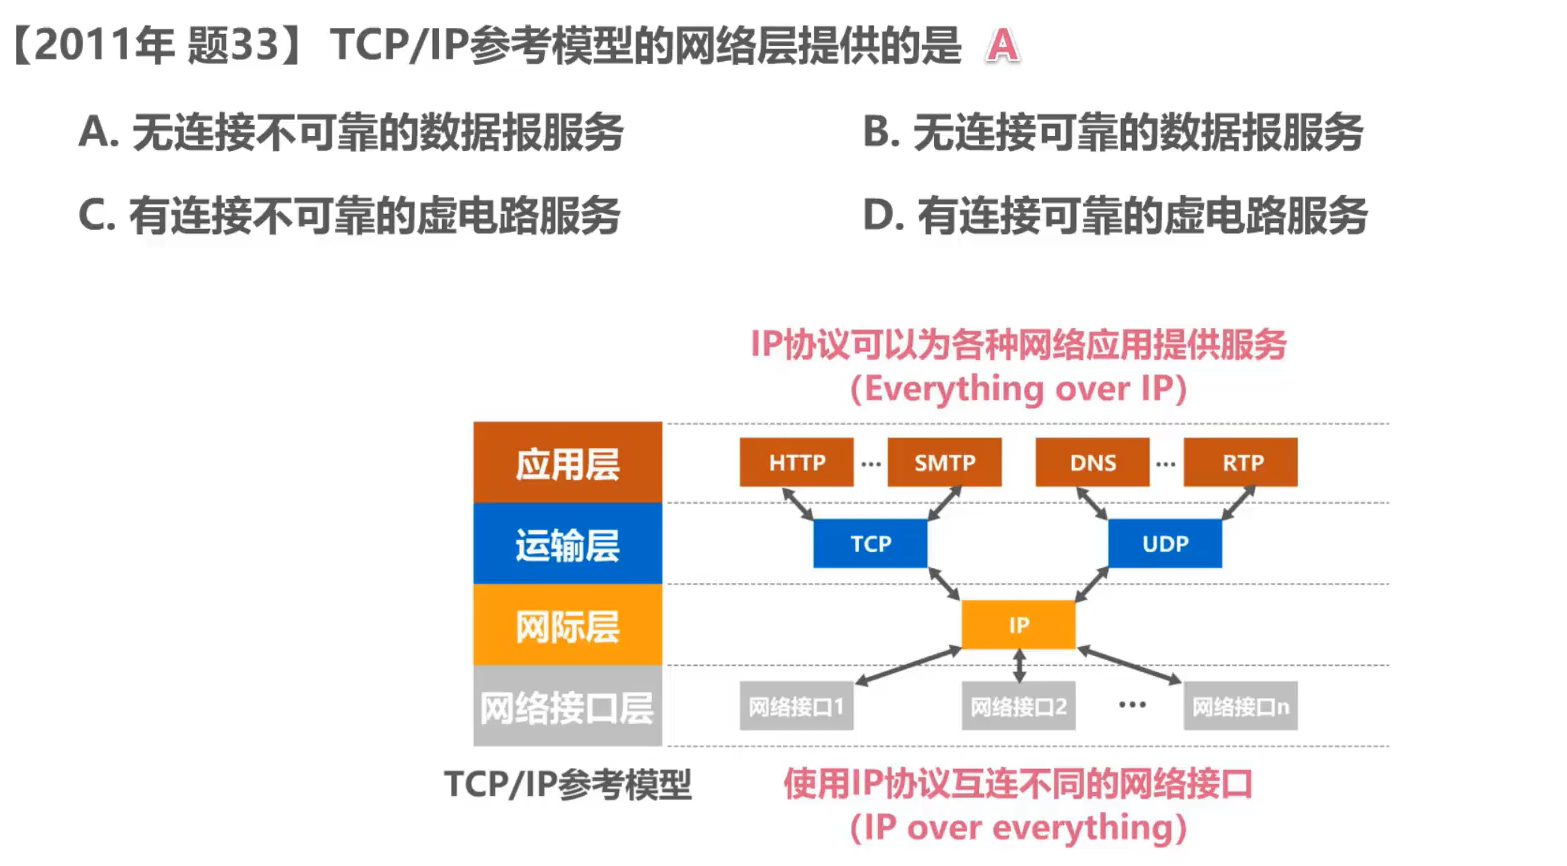
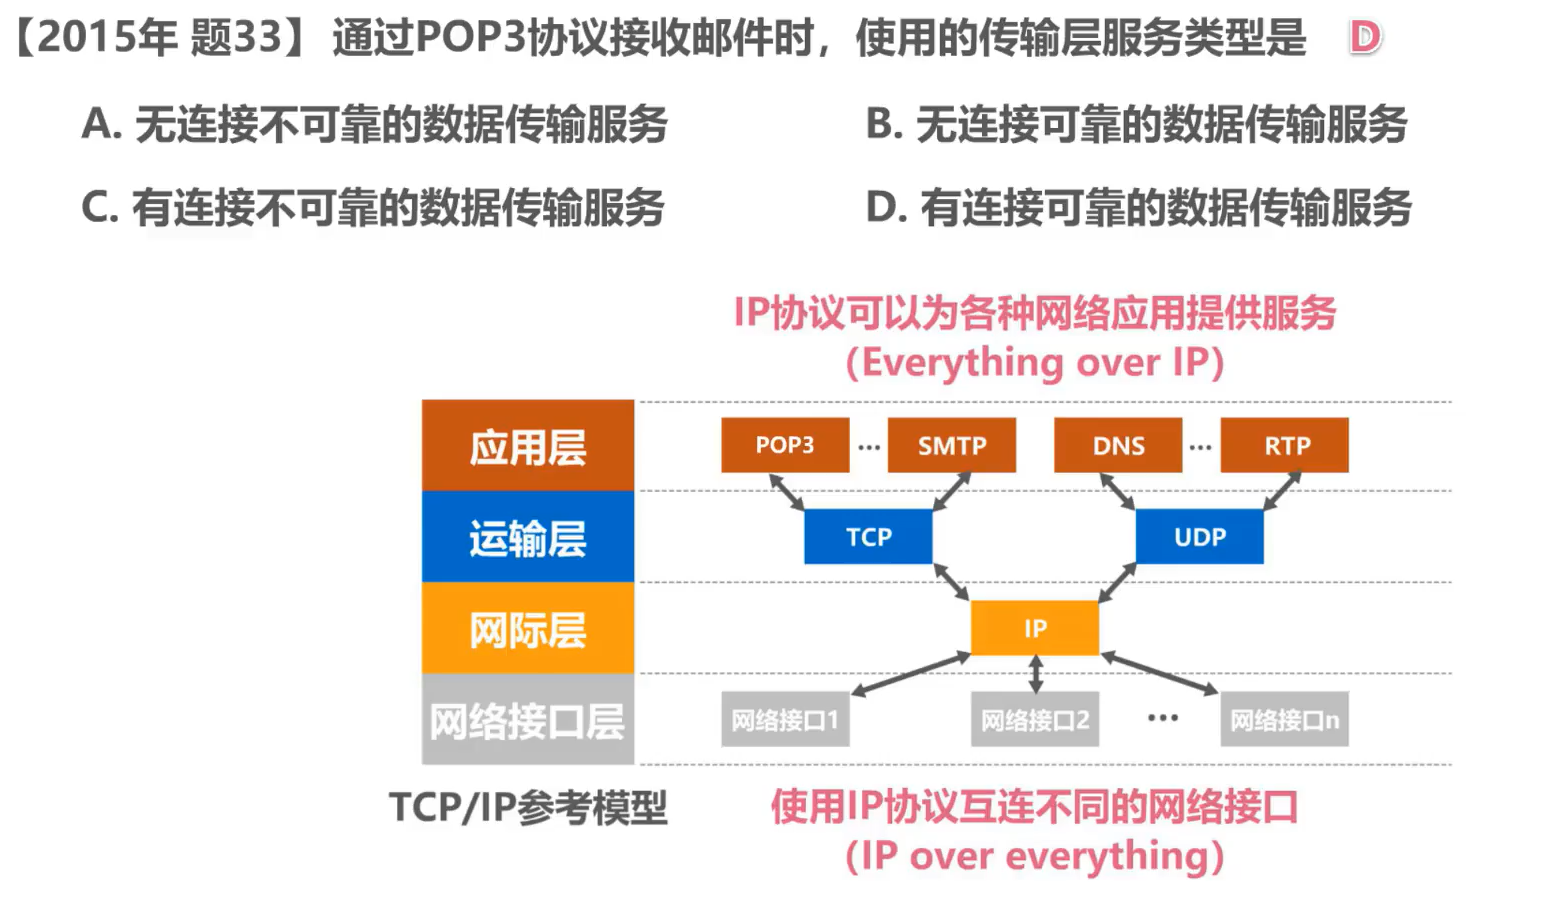
TCP/IP体系结构相当于将OSI体系结构的物理层和数据链路层合并为了网络接口层,并去掉了会话层和表示层。
TCP/IP在网络层使用的协议是IP协议,IP协议的意思是网际协议,因此TCP/IP体系结构的网络层称为网际层
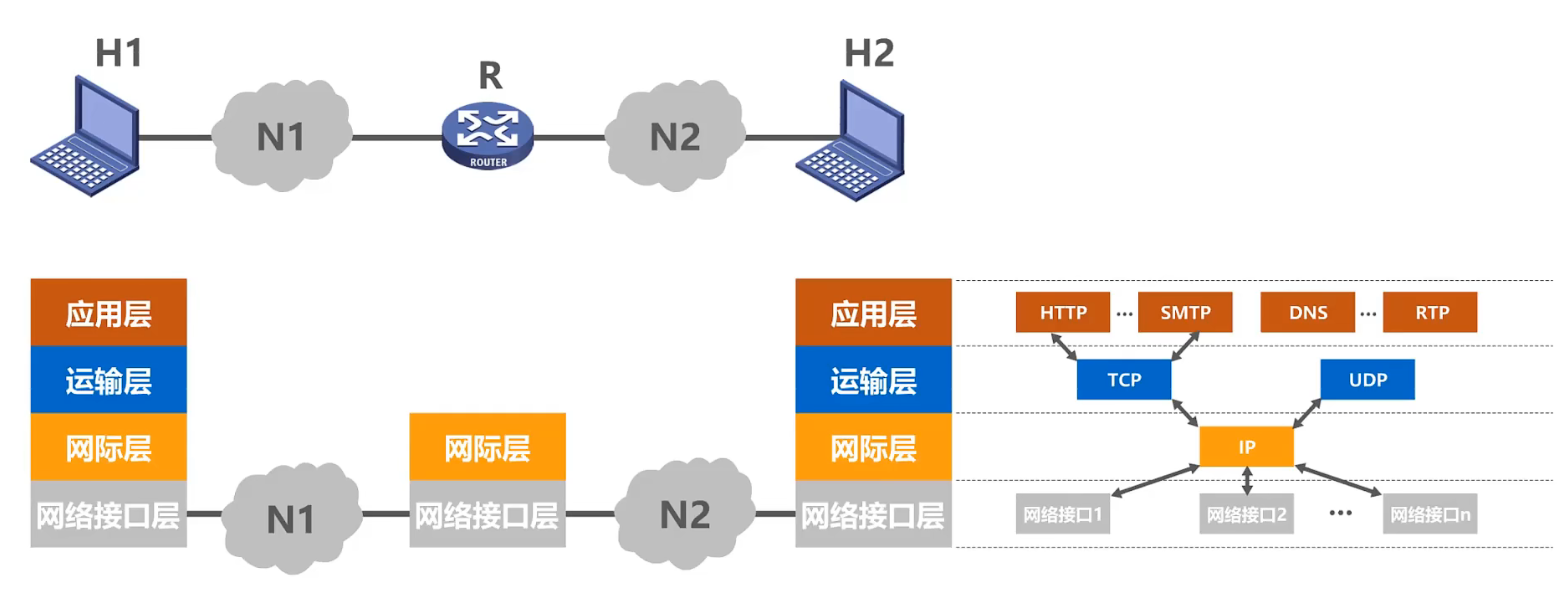
在用户主机的操作系统中,通常都带有符合TCP/IP体系结构标准的TCP/IP协议族。
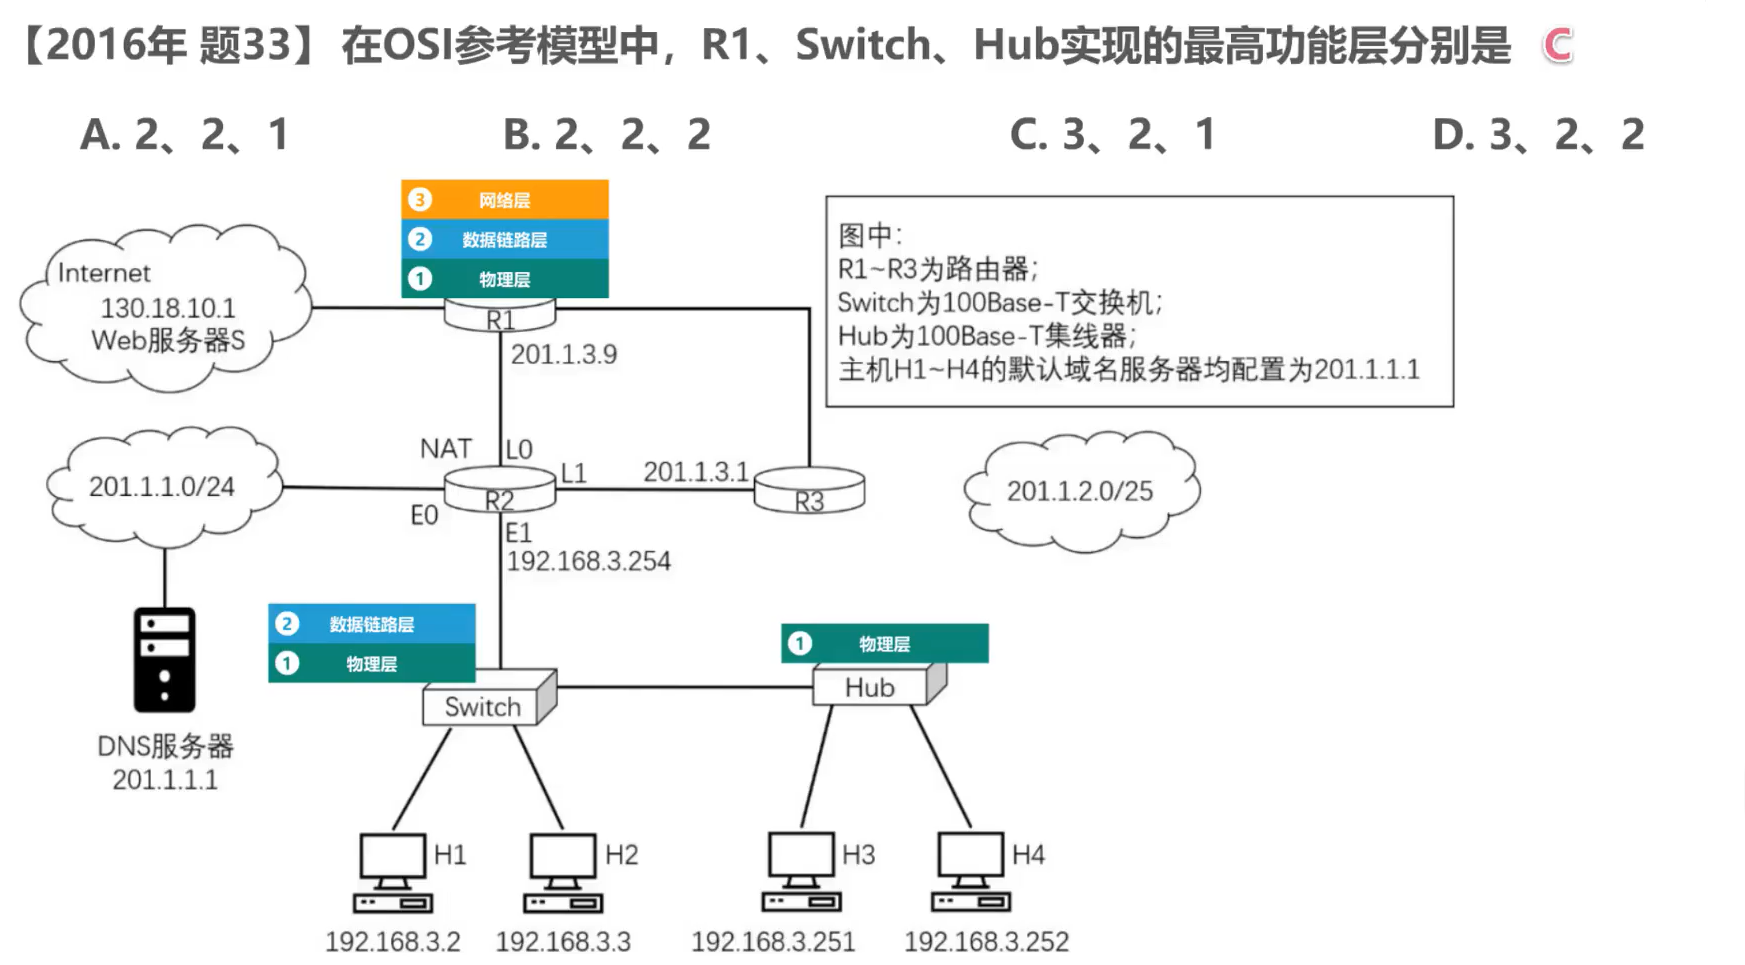
而用于网络互连的路由器中,也带有符合TCP/IP体系结构标准的TCP/IP协议族。只不过路由器一般只包含网络接口层和网际层。
网络接口层:并没有规定具体内容,这样做的目的是可以互连全世界各种不同的网络接口,例如:有线的以太网接口,无线局域网的WIFI接口等。
网际层:它的核心协议是IP协议。
运输层:TCP和UDP是这层的两个重要协议。
应用层:这层包含了大量的应用层协议,如 HTTP , DNS 等。
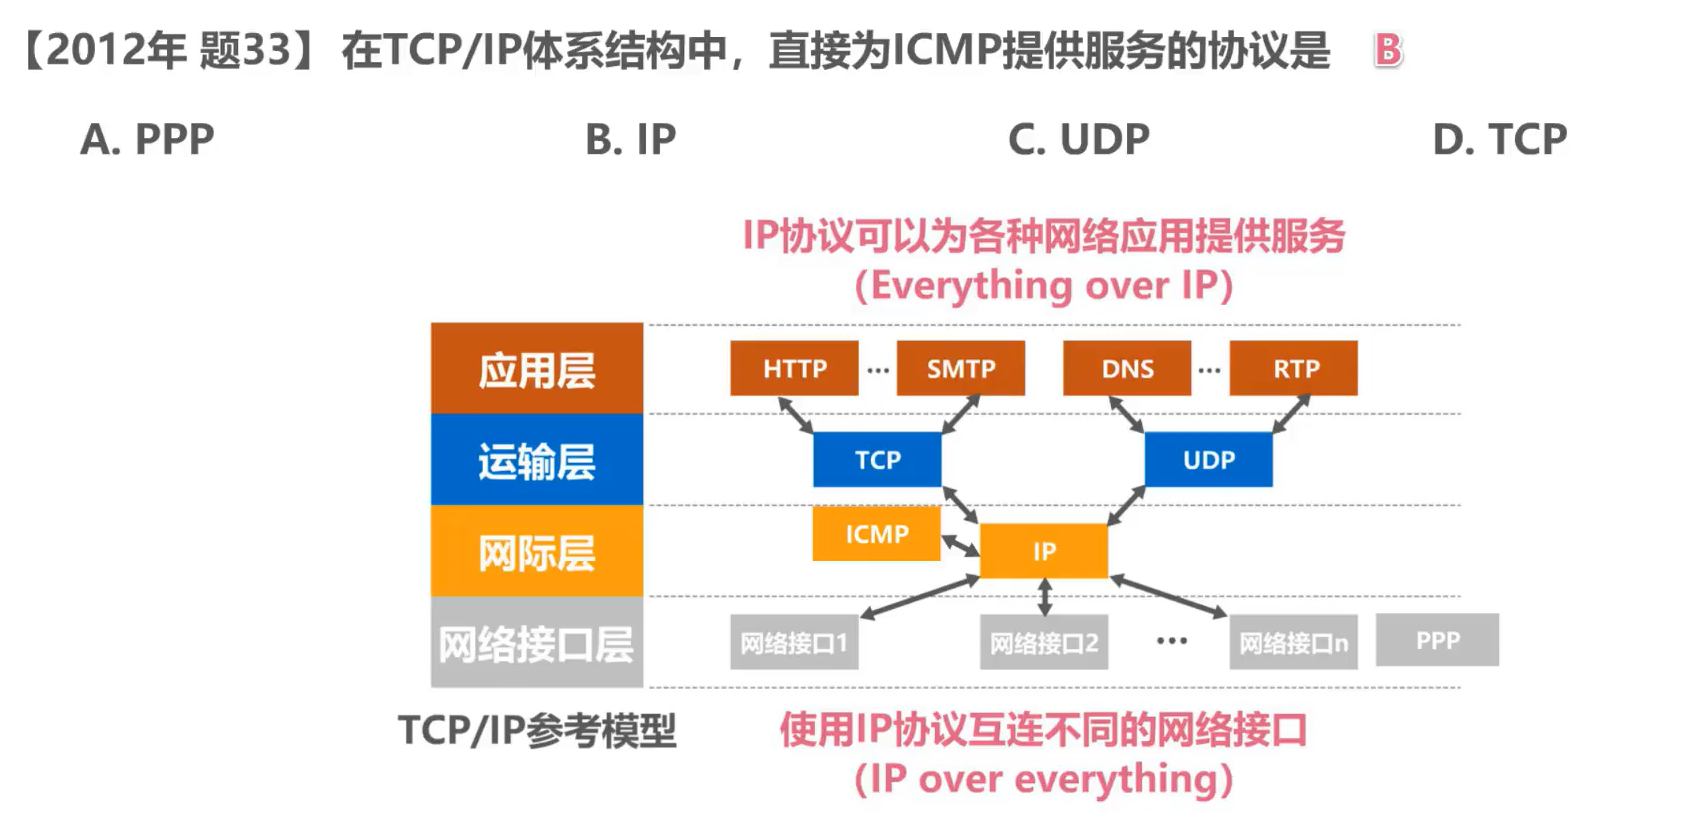
IP协议(网际层)可以将不同的网络接口(网络接口层)进行互连,并向其上的TCP协议和UDP协议(运输层)提供网络互连服务
而TCP协议在享受IP协议提供的网络互连服务的基础上,可向应用层的相应协议提供可靠的传输服务。
UDP协议在享受IP协议提供的网络互连服务的基础上,可向应用层的相应协议提供不可靠的传输服务。
TCP/IP体系结构中最重要的是IP协议和TCP协议,因此用TCP和IP来表示整个协议大家族。
结构分层的必要性:
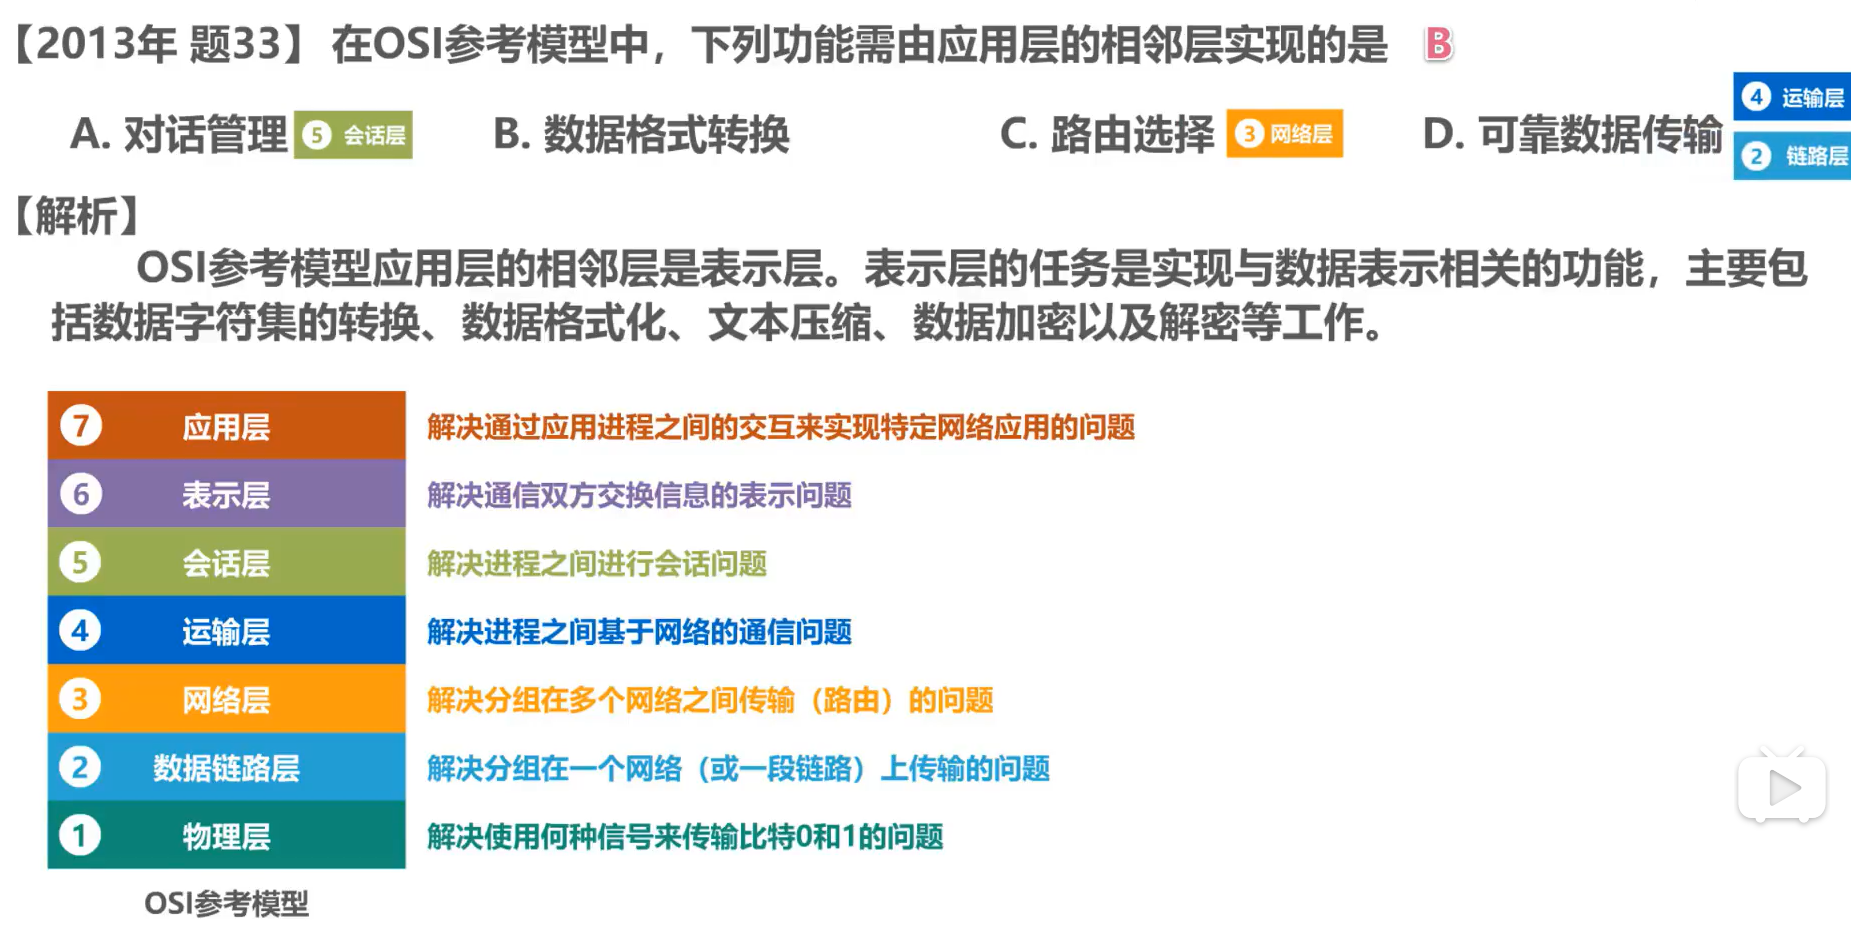
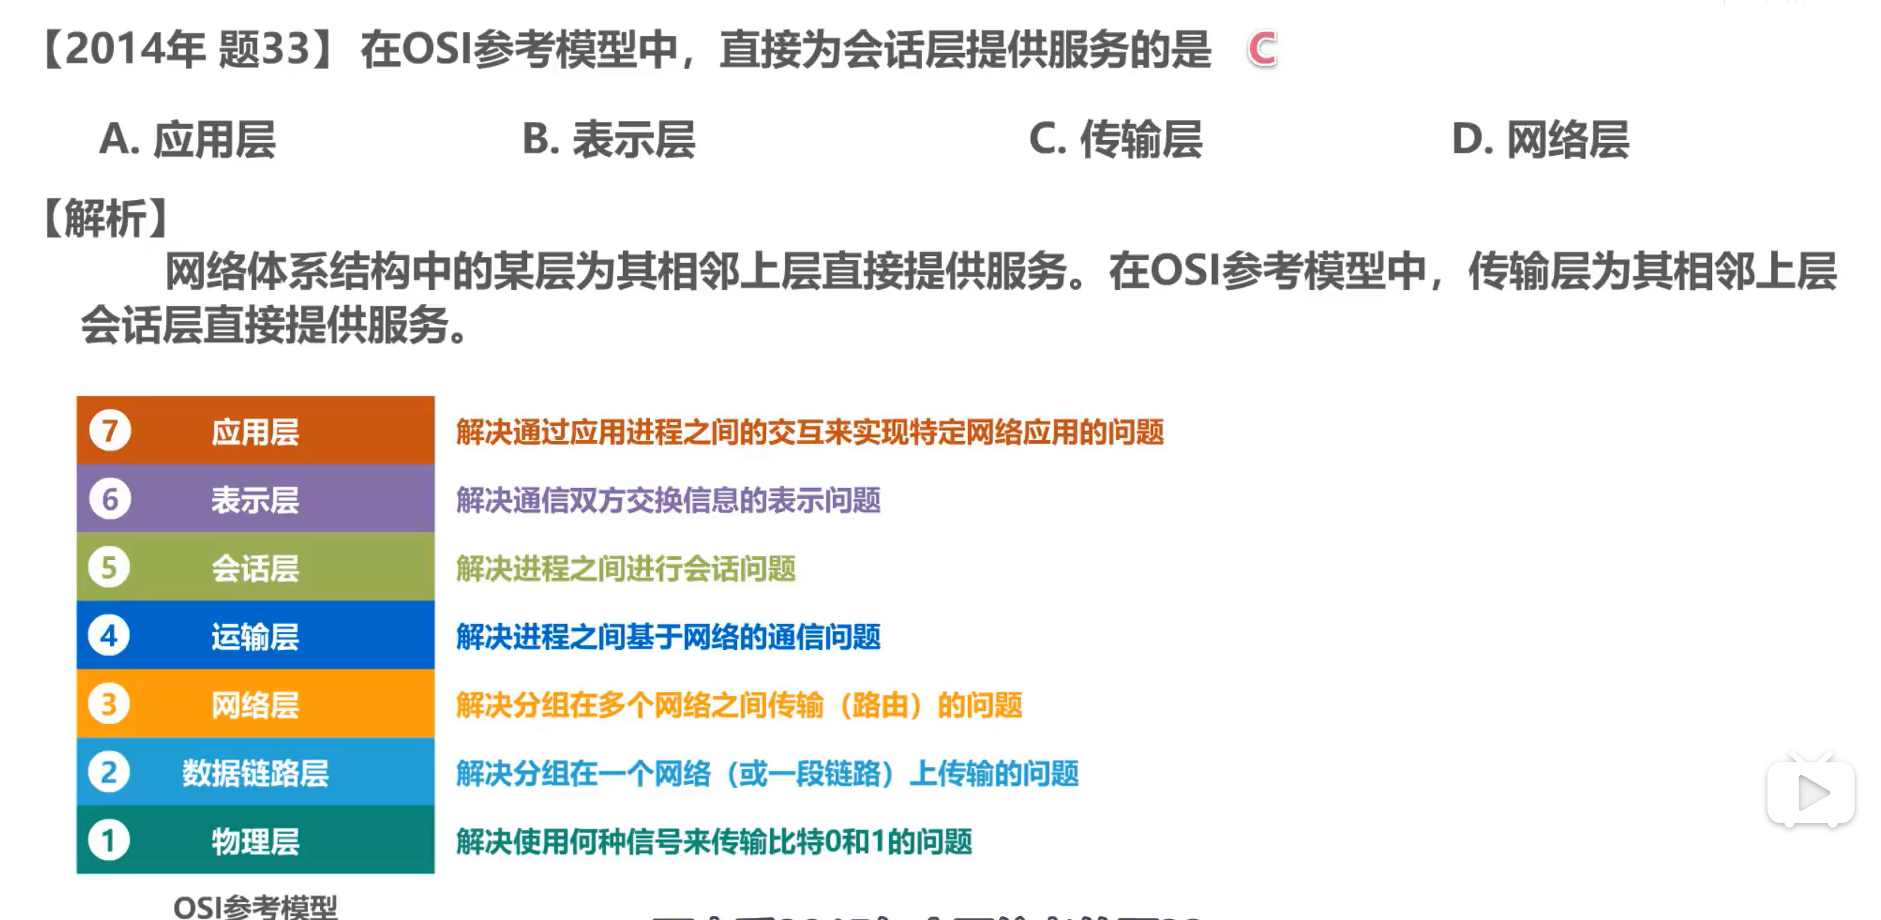
物理层:解决使用何种信号来传输比特的问题
数据链路层:解决分组在一个网络或一段链路上传输的问题
网络层:解决分组在多个网络上传输(路由)的问题
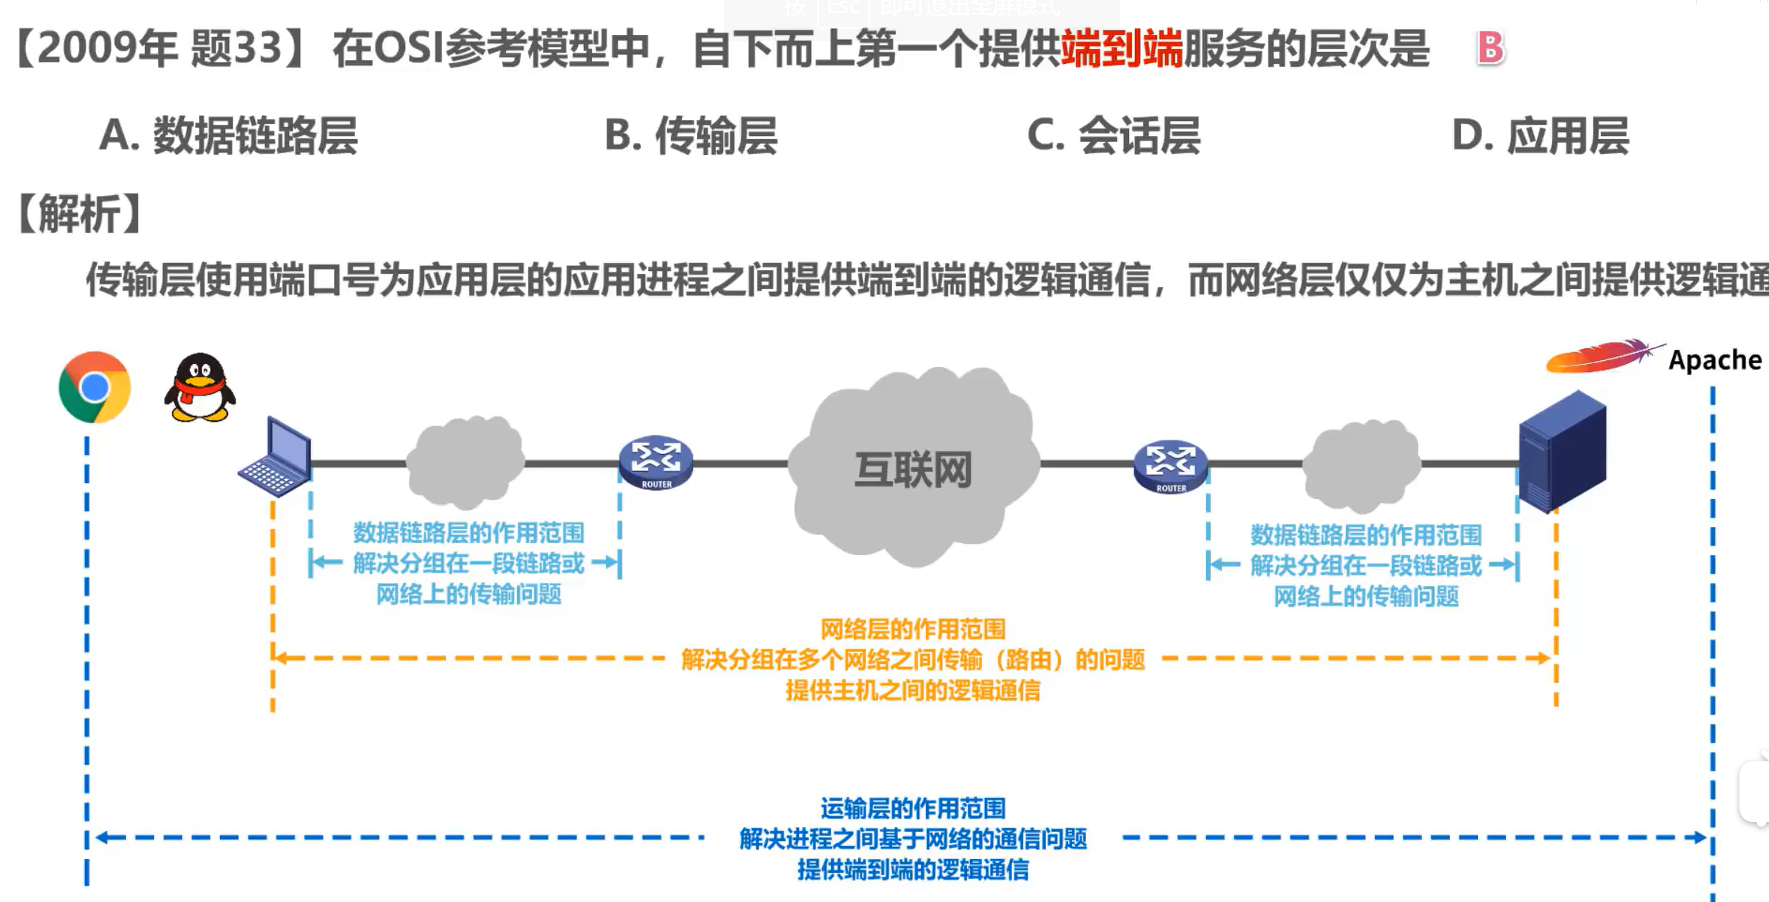
传输层:解决进程间基于网络的通信问题
应用层:解决通过应用进程的交互来实现特定网络应用的问题
物理层问题
- 采用怎样的传输媒体(介质)
- 采用在怎样的物理接口
- 使用怎样的信号表示比特1和0
严格来说,传输媒体并不属于物理层
数据链路层问题
- 如何标识网络中的各主机(主机编制问题,如MAC地址)
- 如何从信号所表示的一连串比特流中区分出地址和数据
- 如何协调各主机争用总线(总线已被淘汰),以太网交换机如何实现
网络层问题
- 如何标识各网络,以及d网络中的各主机(网络和主机共同编址的问题,如IP地址)
- 路由器如何转发分组,如何进行路由选择
运输层问题
- 如何解决进程间基于网络的通信问题
- 出现传输错误时,如何处理
应用层问题
- 通过应用进程间的交互来完成特定的网络应用
应用层该用什么方法(应用层协议)去解析数据
结构分层思想举例
例子:主机的浏览器如何与Web服务器进行通信
解析:
主机和Web服务器之间基于网络的通信,实际上是主机中的浏览器应用进程与Web服务器中的Web服务器应用进程之间基于网络的通信
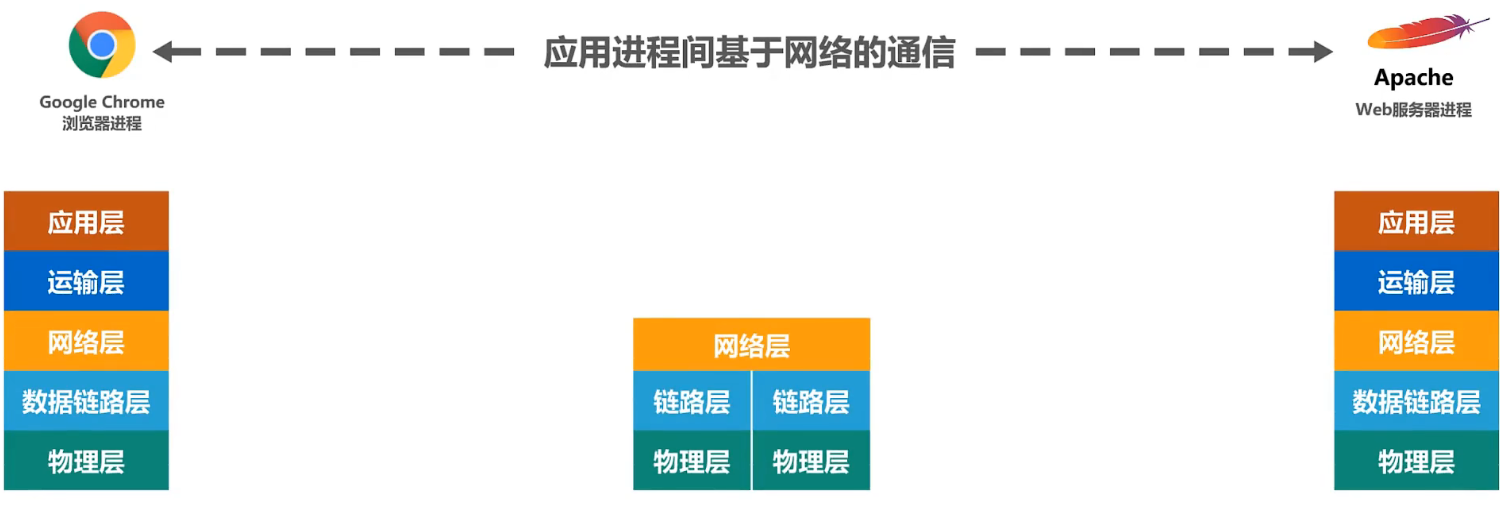
体系结构的各层在整个过程中起到怎样的作用?
1、发送方发送
第一步:
- 应用层按照HTTP协议的规定构建一个HTTP请求报文
- 应用层将HTTP请求报文交付给运输层处理
第二步:
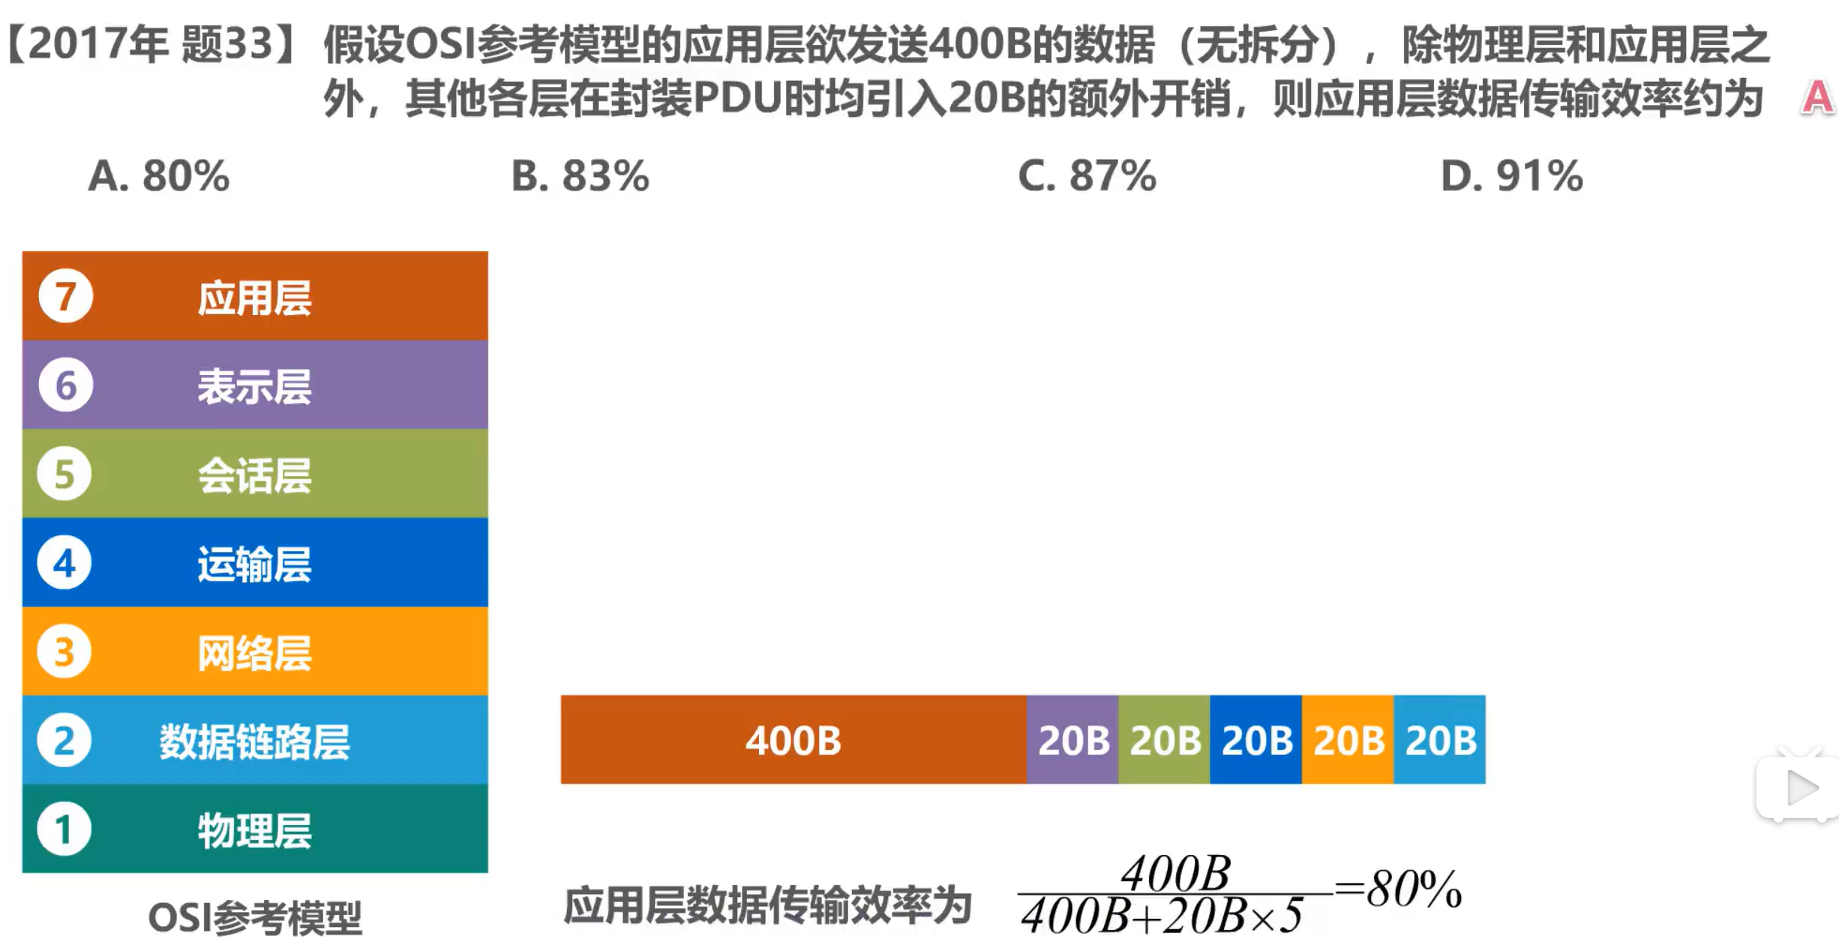
- 运输层给HTTP请求报文添加一个TCP首部,使之成为TCP报文段
- TCP报文段的首部格式作用是区分应用进程以及实现可靠传输
- 运输层将TCP报文段交付给网络层处理
第三步:
- 网络层给TCP报文段添加一个IP首部,使之成为IP数据报
- IP数据报的首部格式作用是使IP数据报可以在互联网传输,也就是被路由器转发
- 网络层将IP数据报交付给数据链路层处理
第四步:
- 数据链路层给IP数据报添加一个首部和一个尾部,使之成为帧
- 该首部的作用主要是为了让帧能够在一段链路上或一个网络上传输,能够被相应的目的主机接收
- 该尾部的作用是让目的主机检查所接收到的帧是否有误码
- 数据链路层将帧交付给物理层
第五步:
- 物理层先将帧看做是比特流,并在该比特流前面添加前导码
- 前导码的作用是为了让目的主机做好接收帧的准备
- 物理层将装有前导码的比特流变换成相应的信号发送给传输媒体
第六步:
- 信号通过传输媒体到达路由器
2、路由器转发
在路由器中
物理层将信号变为比特流,然后去掉前导码后,将其交付给数据链路层
数据链路层将帧的首部和尾部去掉后,将其交付给网络层,这实际交付的是IP数据报
网络层解析IP数据报的首部,从中提取目的网络地址
提取目的网络地址后查找自身路由表。确定转发端口, 以便进行转发
网络层将IP数据报交付给数据链路层
数据链路层给IP数据报添加一个首部和一个尾部,使之成为帧
数据链路层将帧交付给物理层
物理层先将帧看成比特流,这里的网络N2假设是以太网,所以物理层还会给该比特流前面添加前导码
物理层将装有前导码的比特流变换成相应的信号发送给传输媒体,信号通过传输媒体到达Web服务器
3、接收方接收
和发送方(主机)发送过程的封装正好是反着来
在Web 服务器上
- 物理层将信号变换为比特流,然后去掉前导码后成为帧,交付给数据链路层
- 数据链路层将帧的首部和尾部去掉后成为IP数据报,将其交付给网络层
- 网络层将IP数据报的首部去掉后成为TCP报文段,将其交付给运输层
- 运输层将TCP报文段的首部去掉后成为HTTP请求报文,将其交付给应用层
- 应用层对HTTP请求报文进行解析,然后给主机发回响应报文
发回响应报文的步骤和之前过程类似
结构中的专用术语
以下介绍的专用术语来源于OSI的七层协议体系结构,但也适用于TCP/IP的四层体系结构和五层协议体系结构
实体
实体:任何可发送或接受信息的硬件或软件进程;
对等实体:收发双方相同层次中的实体。

协议
协议:控制两个对等实体进行逻辑通信的规则的集合
协议三要素:
- 语法:定义所交换信息的格式
- 语义:定义收发双方所要完成的操作
- 同步:定义收发双发的时序关系
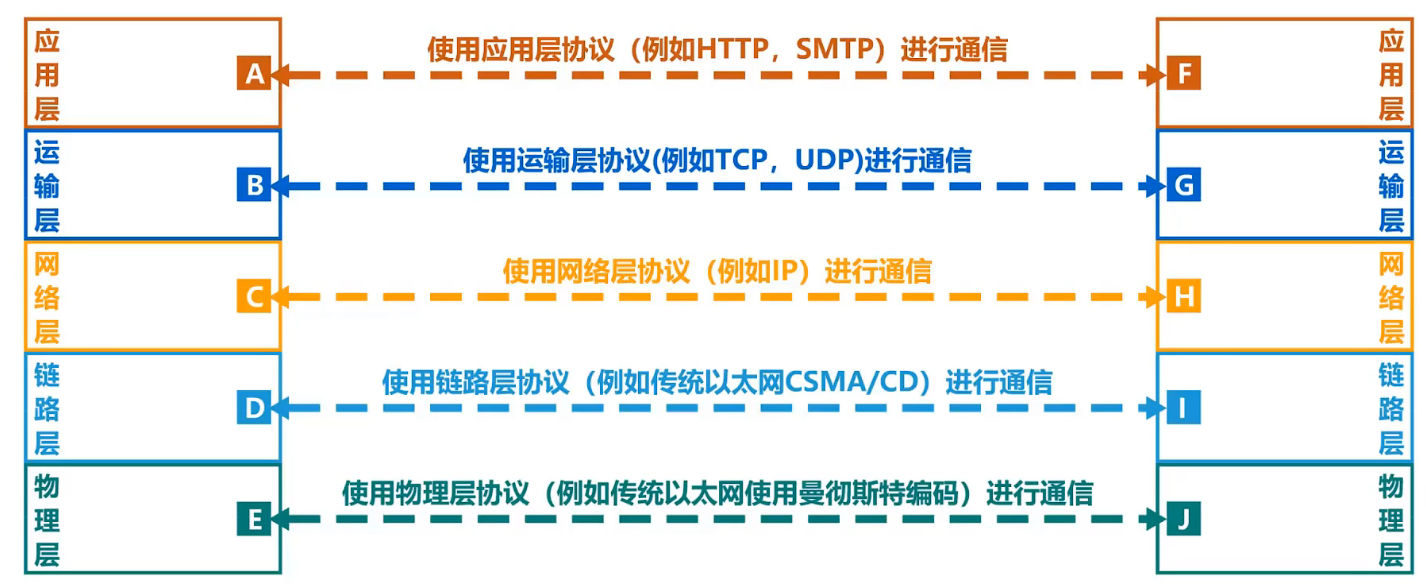
服务
在协议的控制下,两个对等实体间的逻辑通信使得本层能够向上一层提供服务;要实现本层协议,还需要实现下面一层所提供的服务。
协议是水平的,服务的垂直的。
实体看的见相邻下层所提供的服务,但并不知道实现该服务的具体协议。
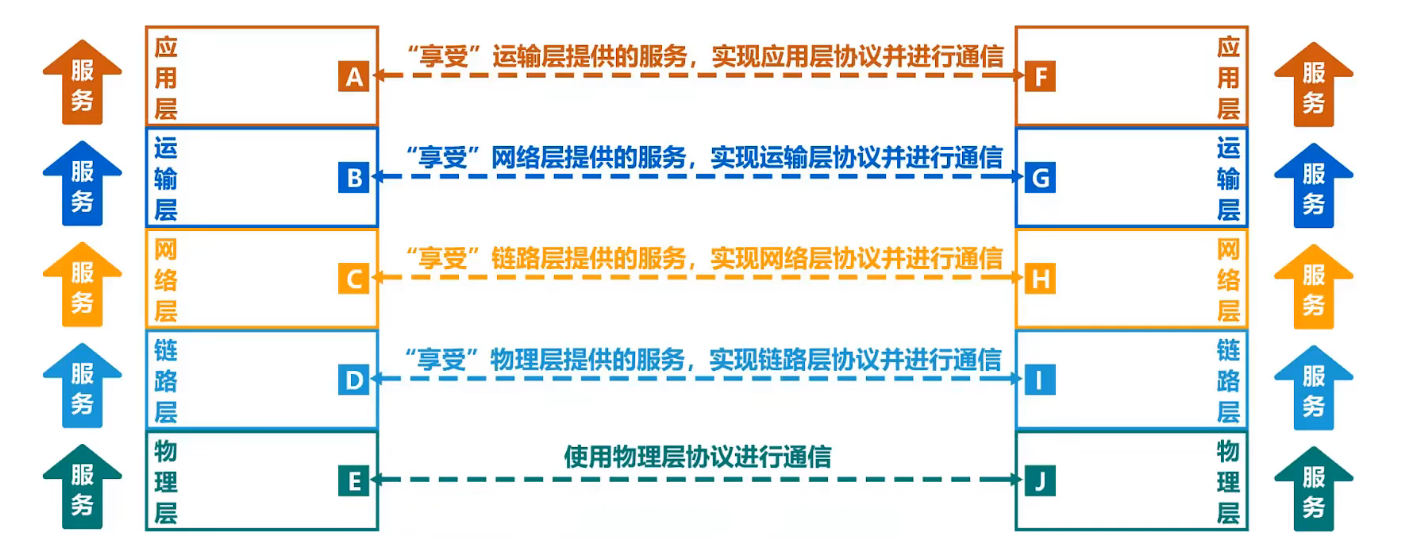
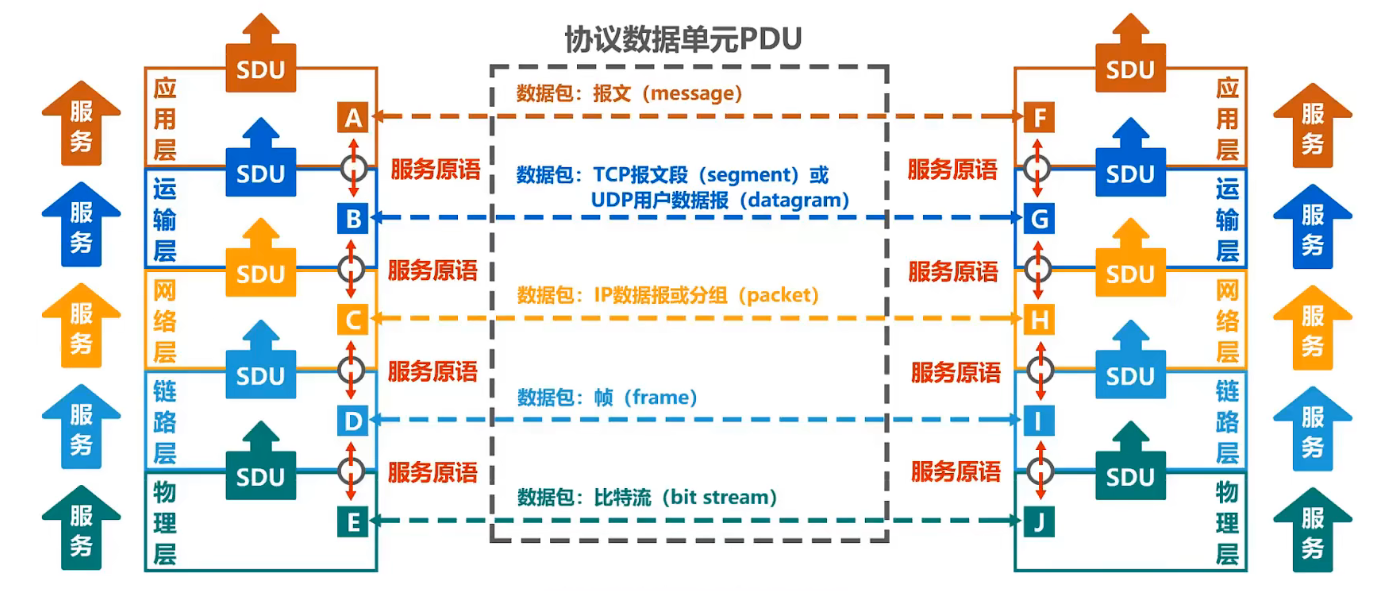
服务访问点:在同一系统中相邻两层的实体交换信息的逻辑接口,用于区分不同的服务类型。
- 数据链路层的服务访问点为 帧的“类型”字段;
- 网络层的服务访问点为 IP数据报首部的“协议字段”
- 运输层的服务访问点为 “端口号”
服务原语:上层使用下层所提供的服务必须通过与下层交换的 一些命令。
协议数据单元PDU:对等层次之间传送的数据包。
服务数据单元SDU:同一系统内,层与层之间交换的数据报。
多个SDU可以合成为一个PDU,一个SDU也可以划分为几个PDU
习题
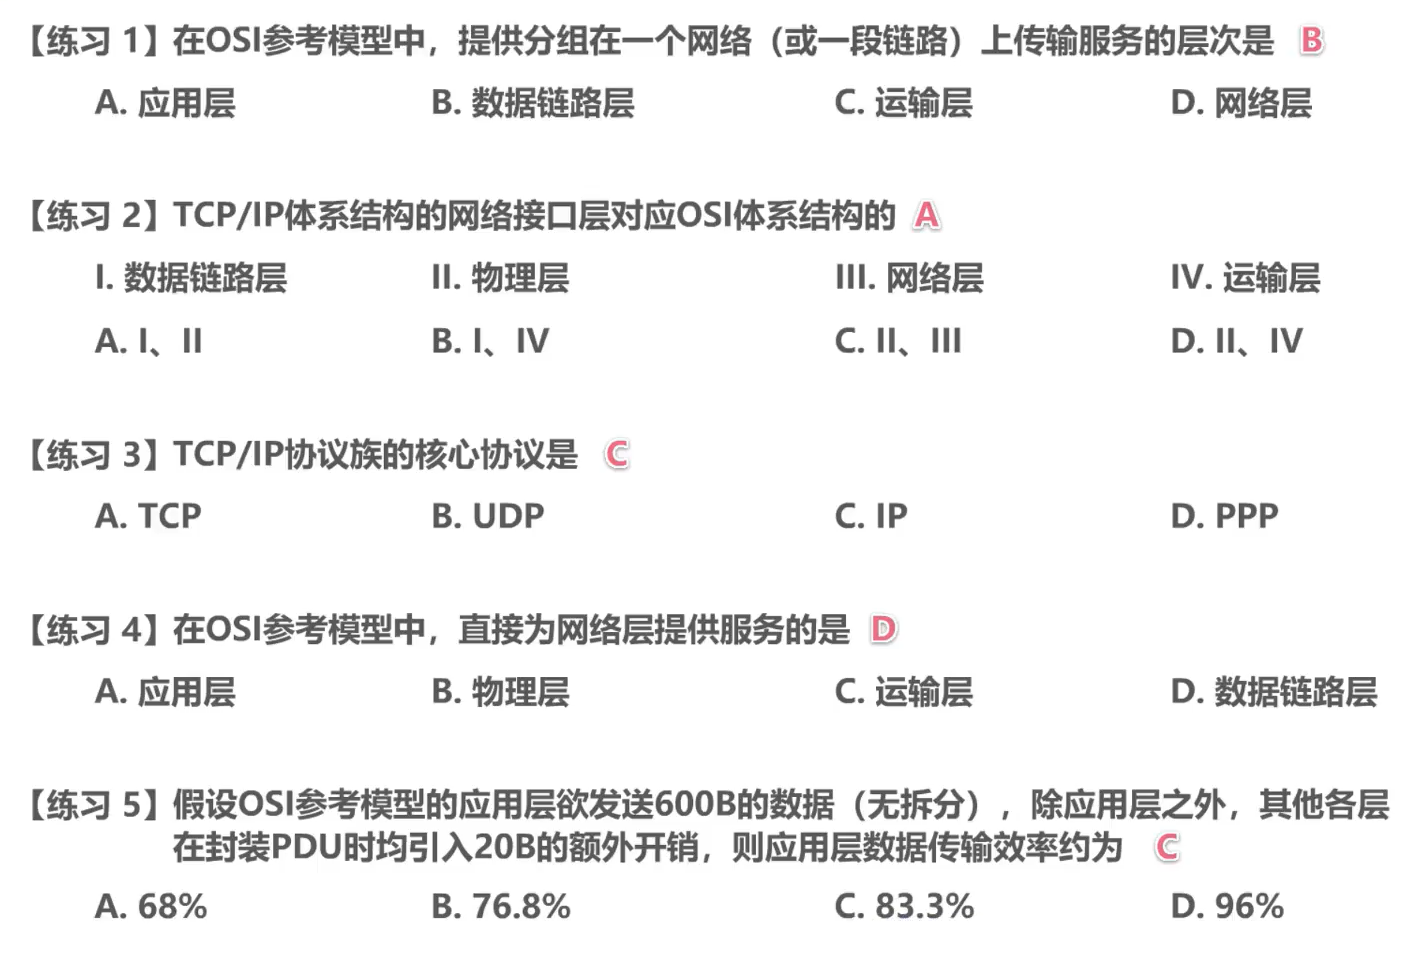
体系结构题目
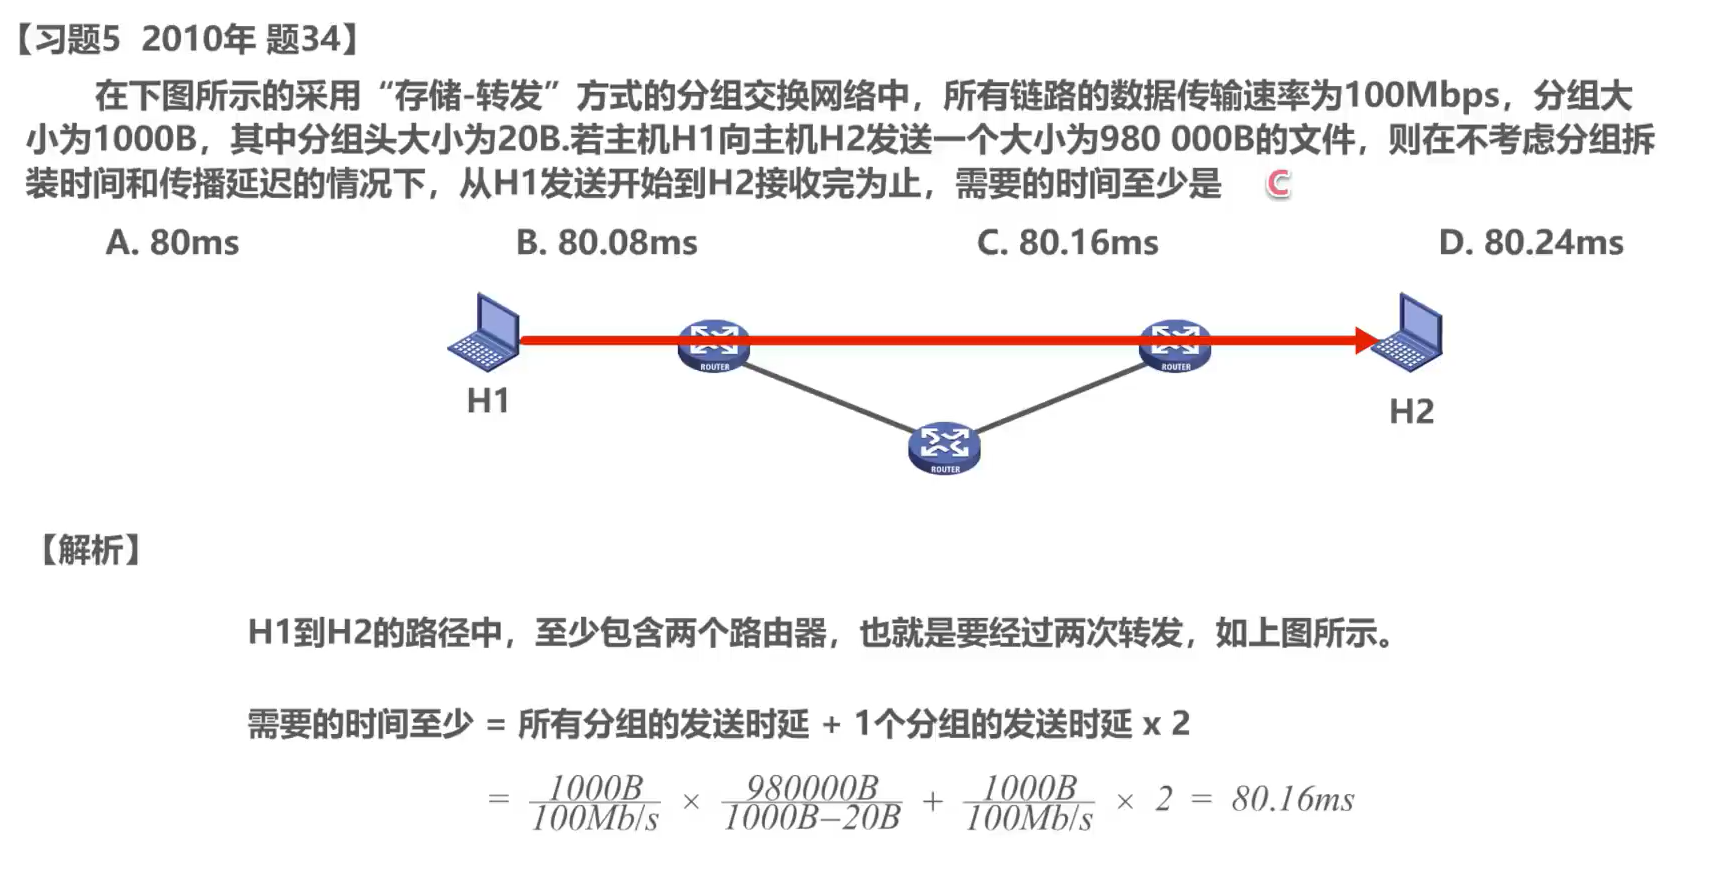
时延相关题目
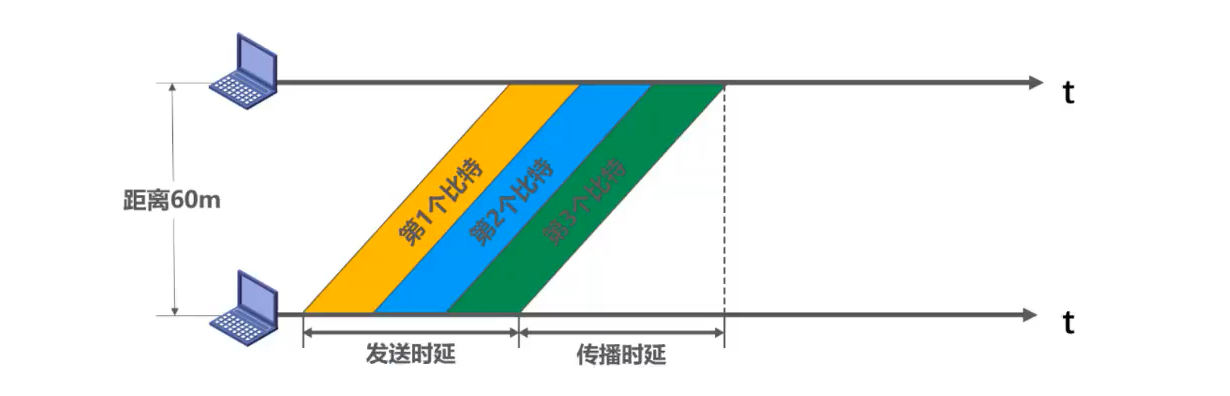
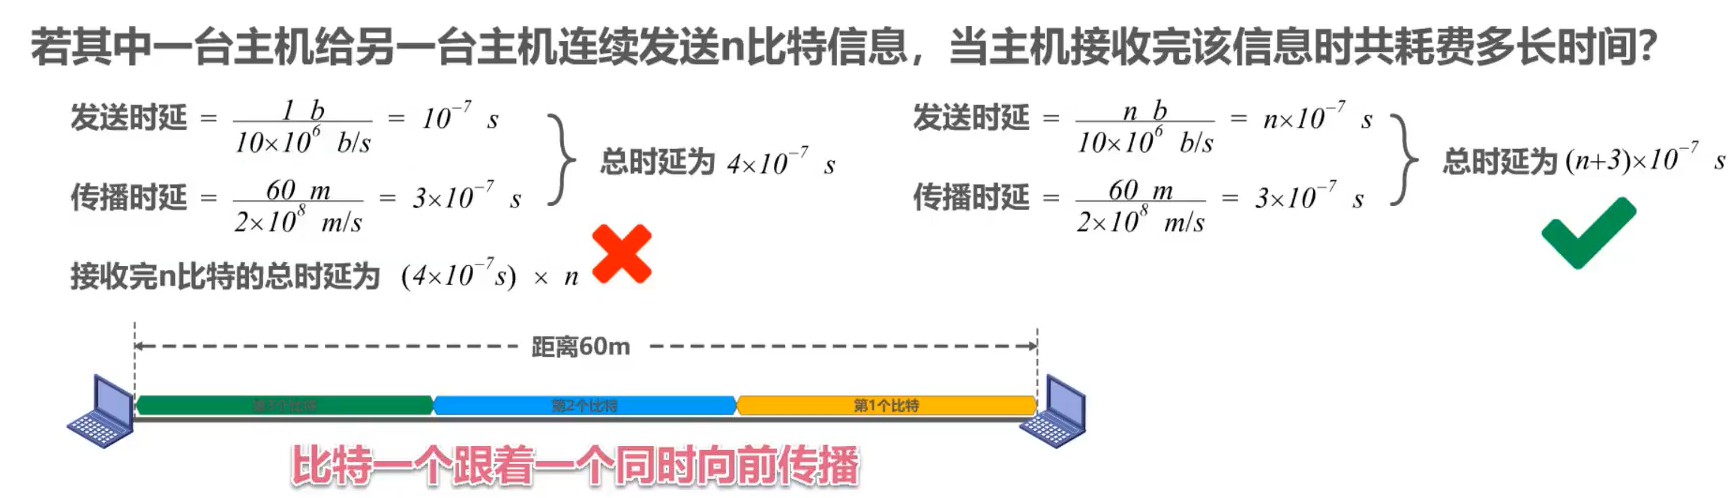
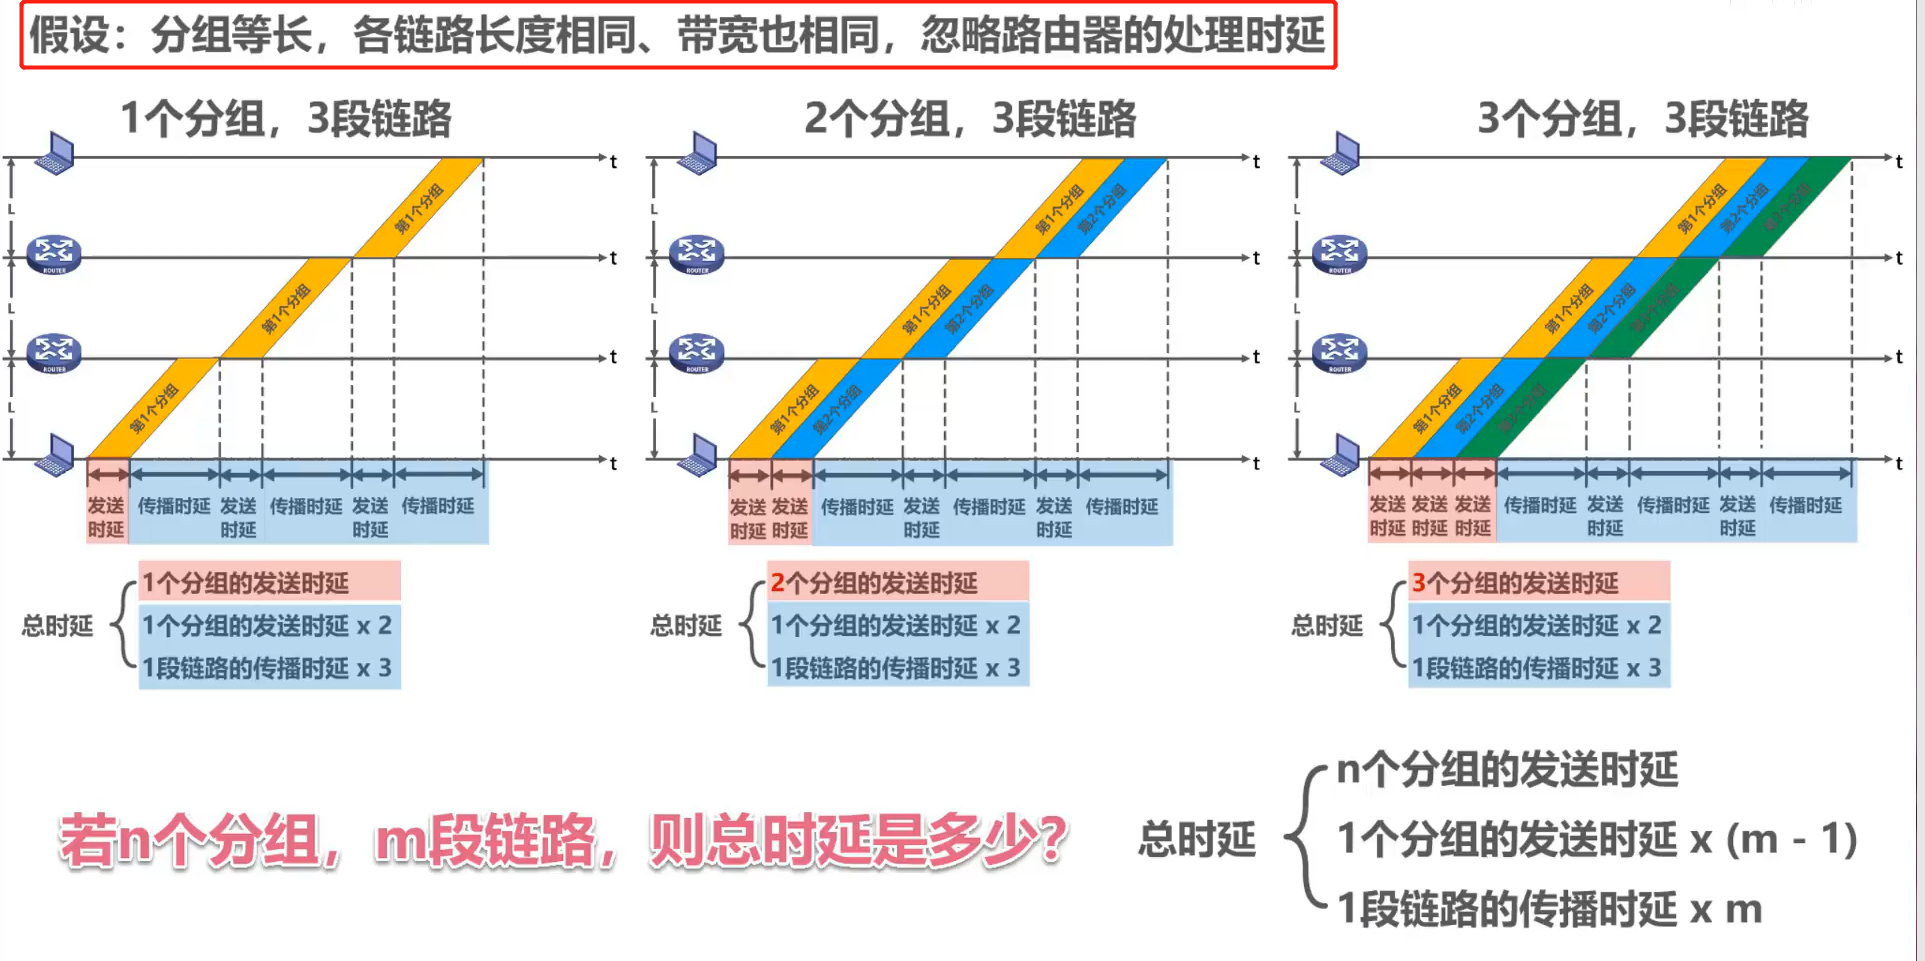
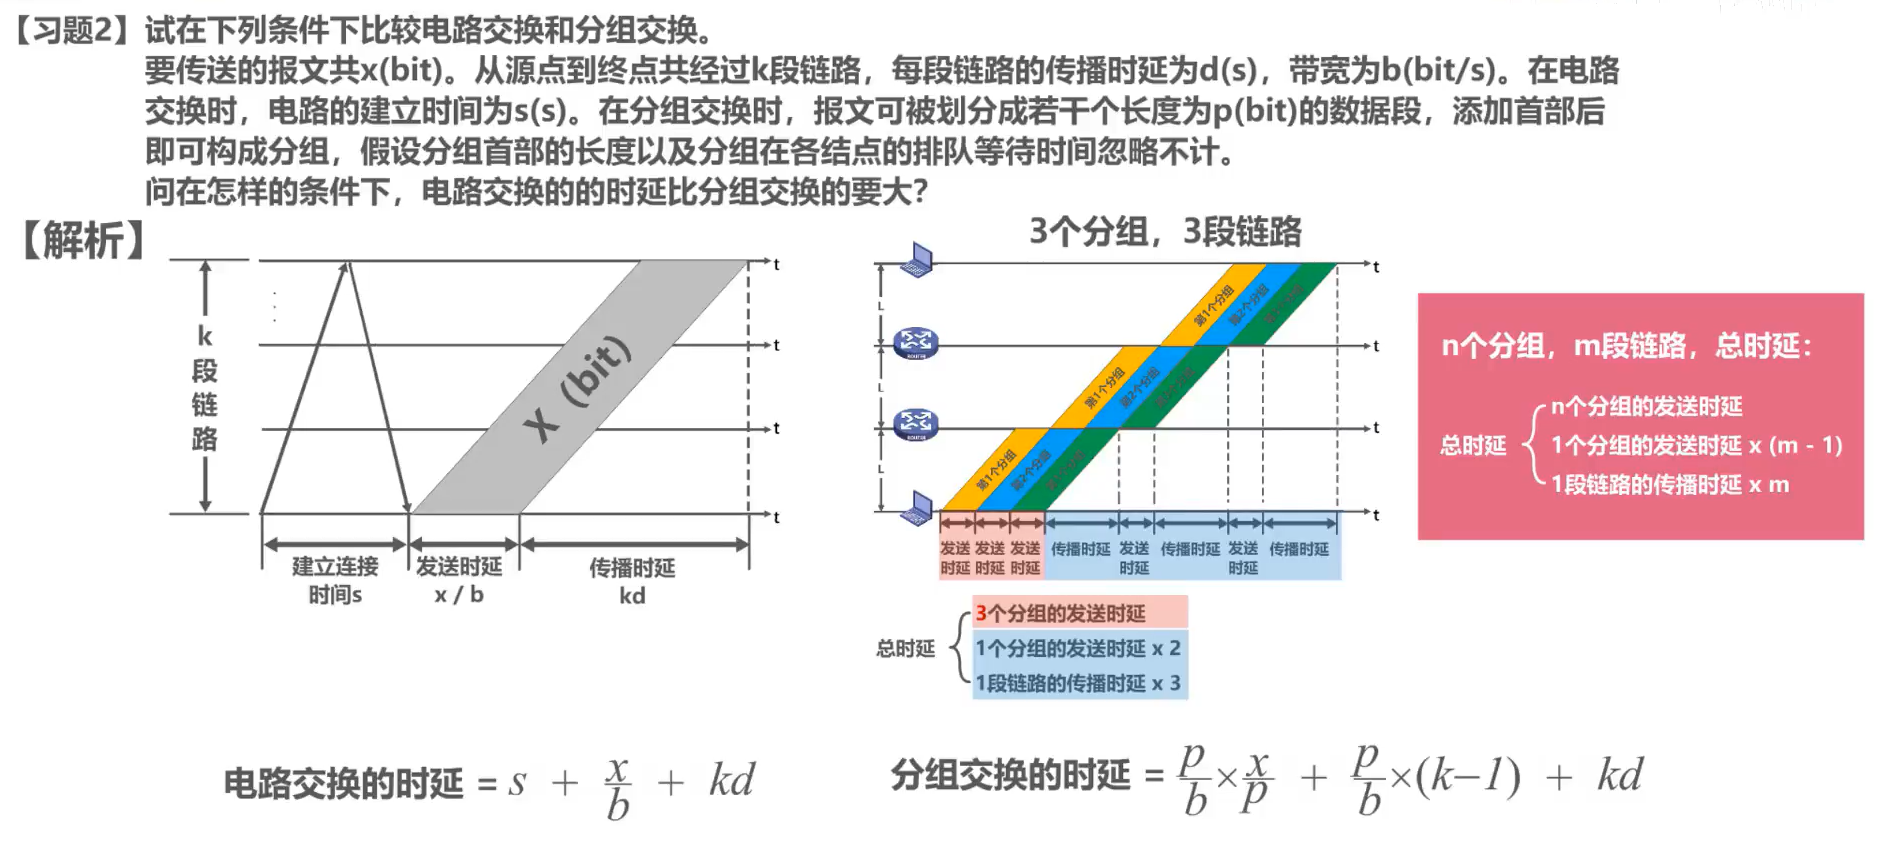
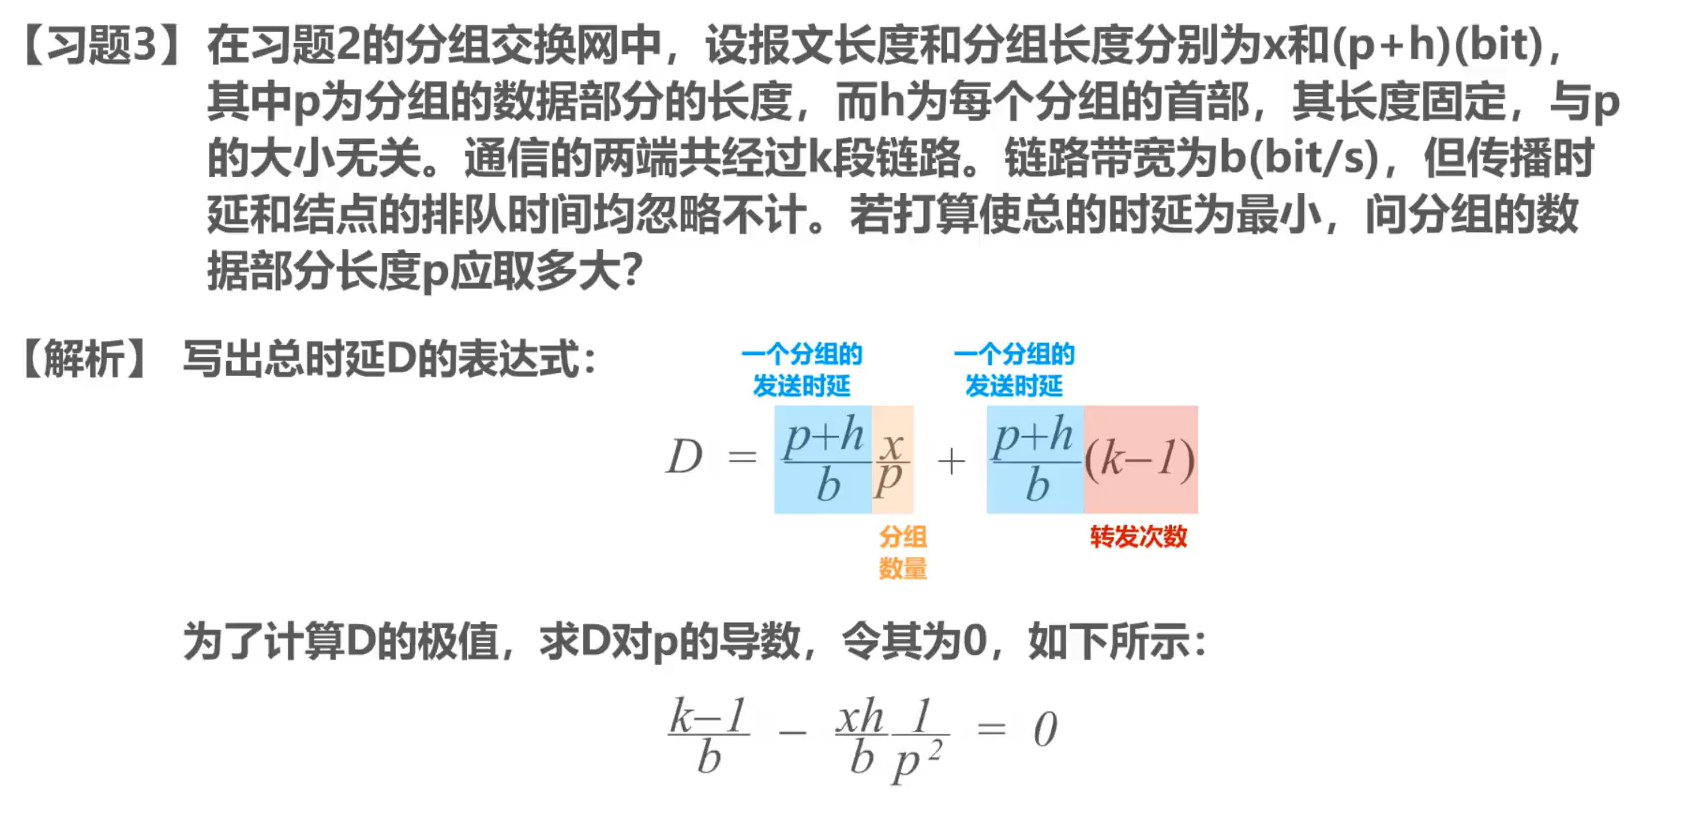
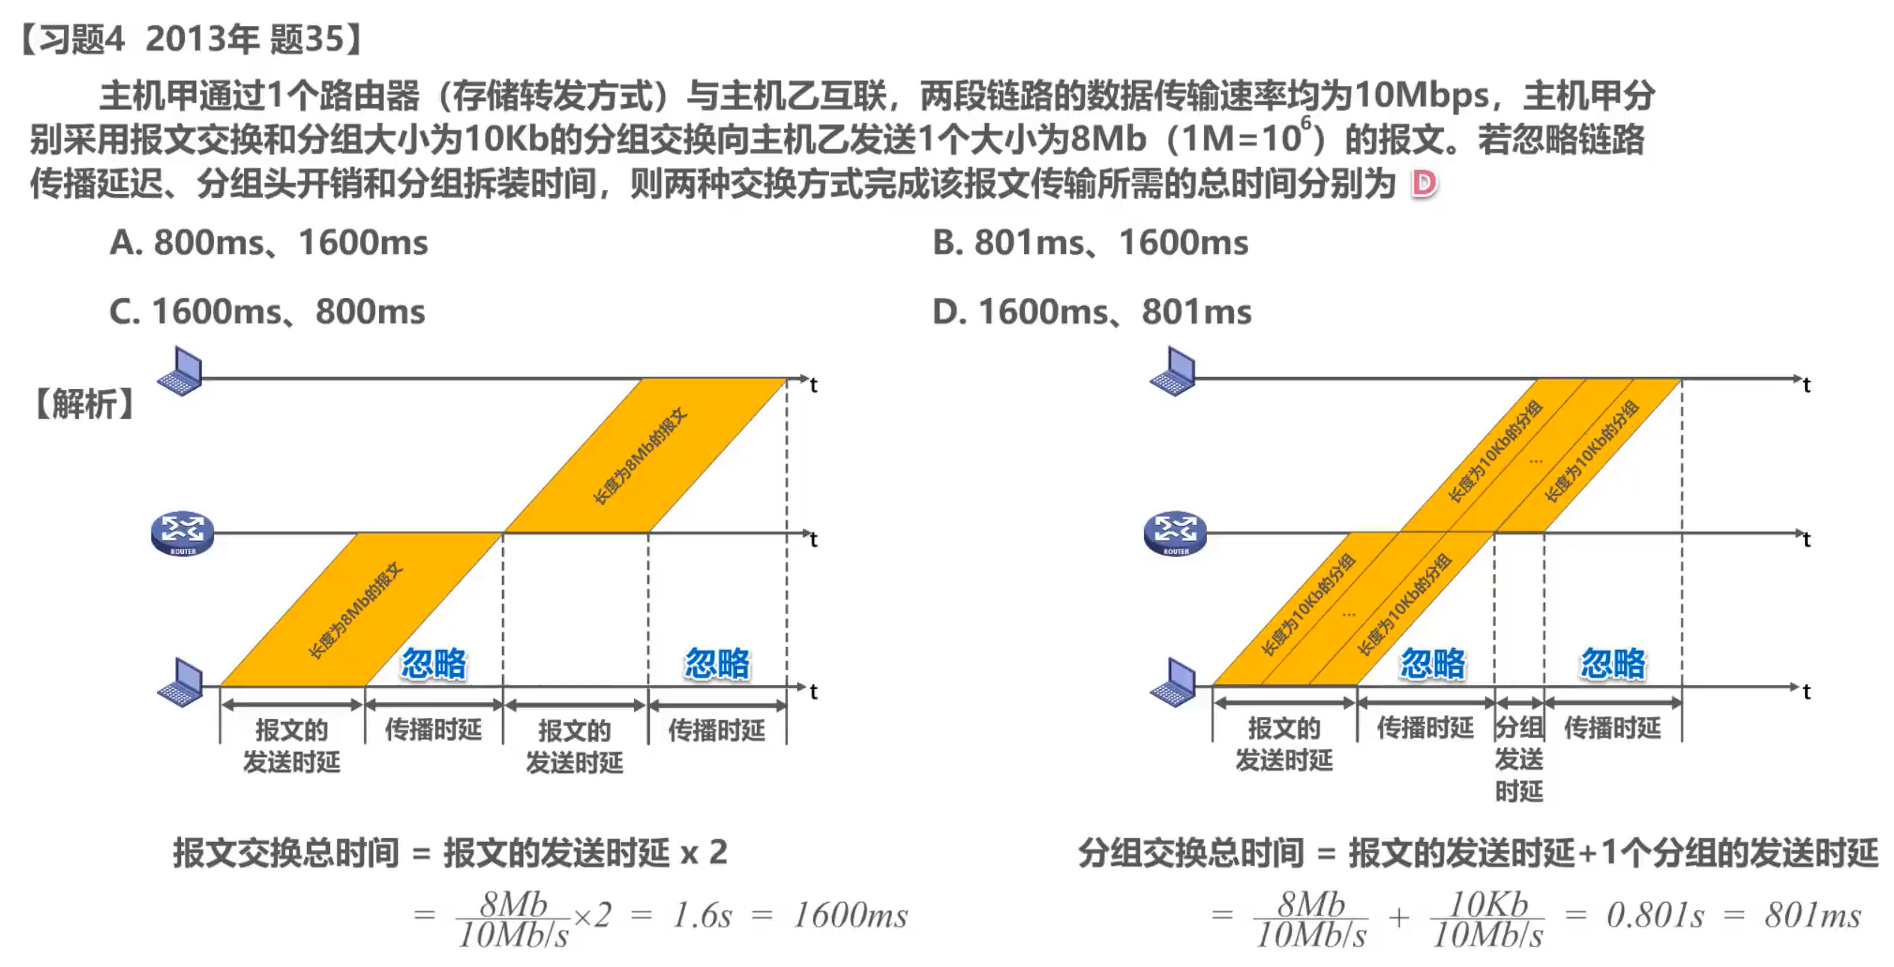
物理层
概念
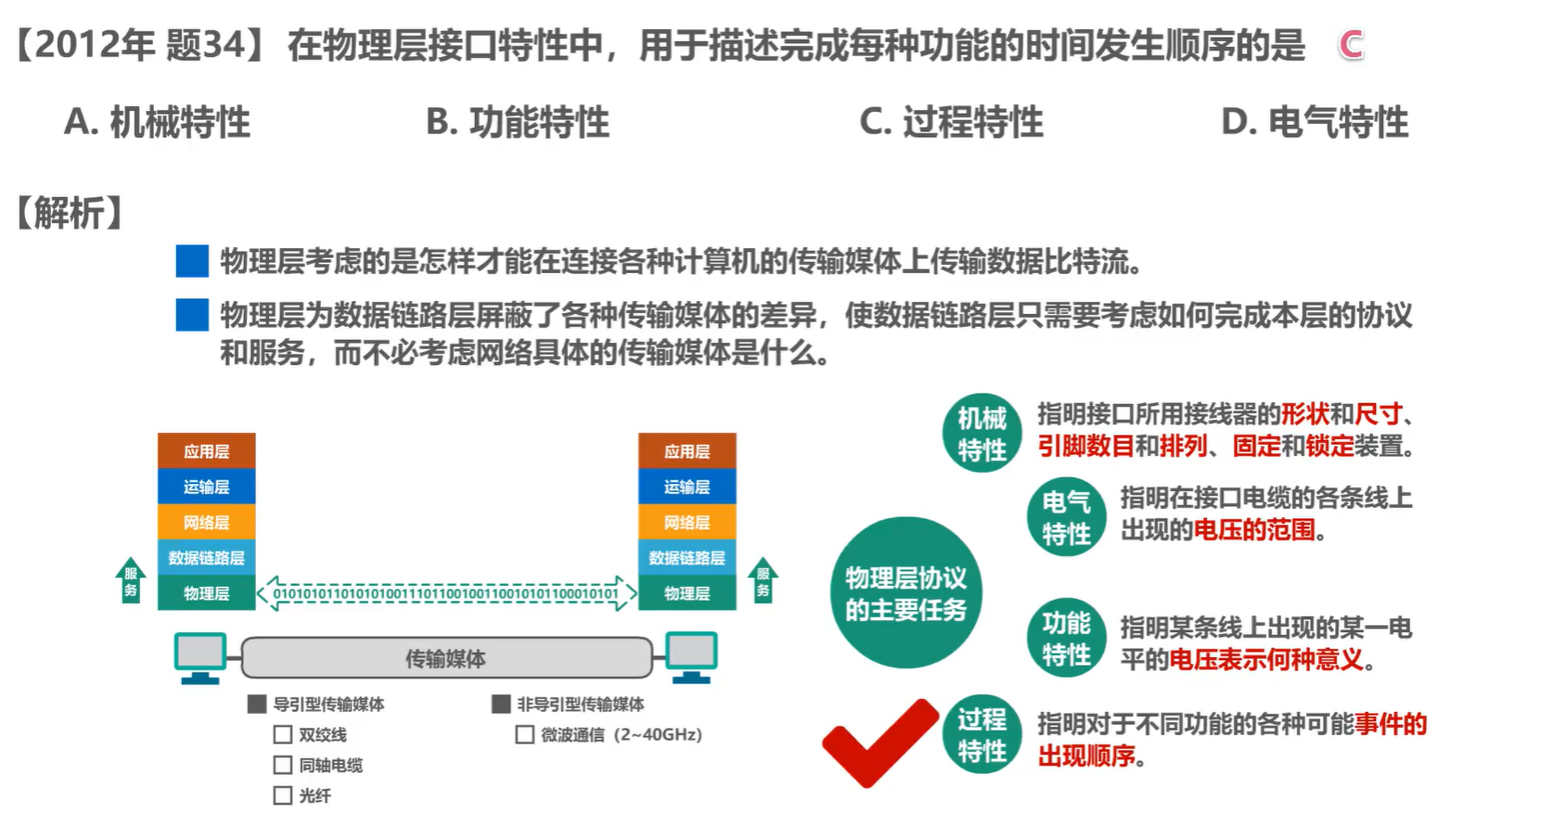
物理层考虑的是怎样才能在连接各种计算机的传输媒体上传输数据比特流。
物理层为数据链路层屏蔽了各种传输媒体的差异,使数据链路层只需要考虑如何完成本层的协议和服务,而不必考虑网络具体的传输媒体是什么。
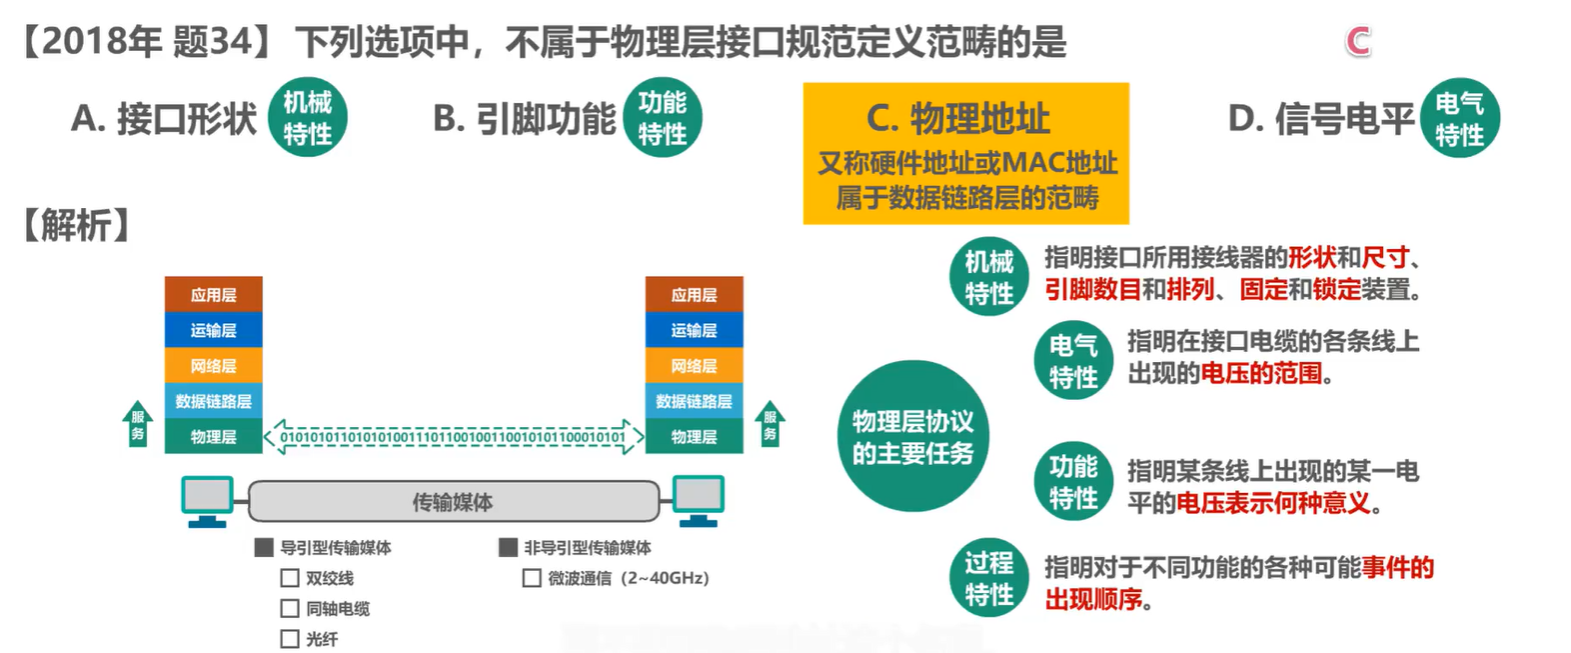
物理层协议的主要任务:
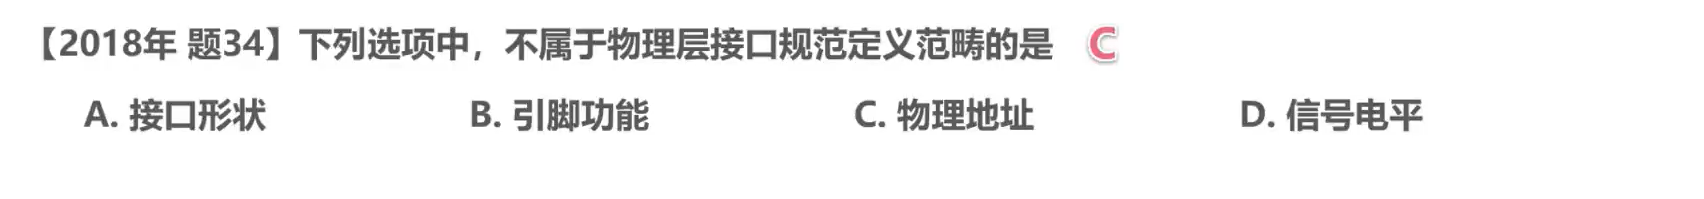
- 机械特性:指明接口所用接线器的形状和尺寸、引脚数目和排列、固定和锁定装置。
- 电气特性:指明在接口电缆的各条线上出现的电压的范围。
- 功能特性:指明某条线上出现的某一电平的电压表示何种意义。
- 过程特性:指明对于不同功能的各种可能事件的出现顺序。
物理层下面的传输媒体
传输媒体也称为传输介质或传输媒介,他就是数据传输系统中在发送器和接收器之间的物理通路。可分为两大类,即导引型传输媒体和非导引型传输媒体
传输媒体不属于计算机网络体系结构的任何一层。如果非要将它添加到体系结构中,那只能将其放置到物理层之下。
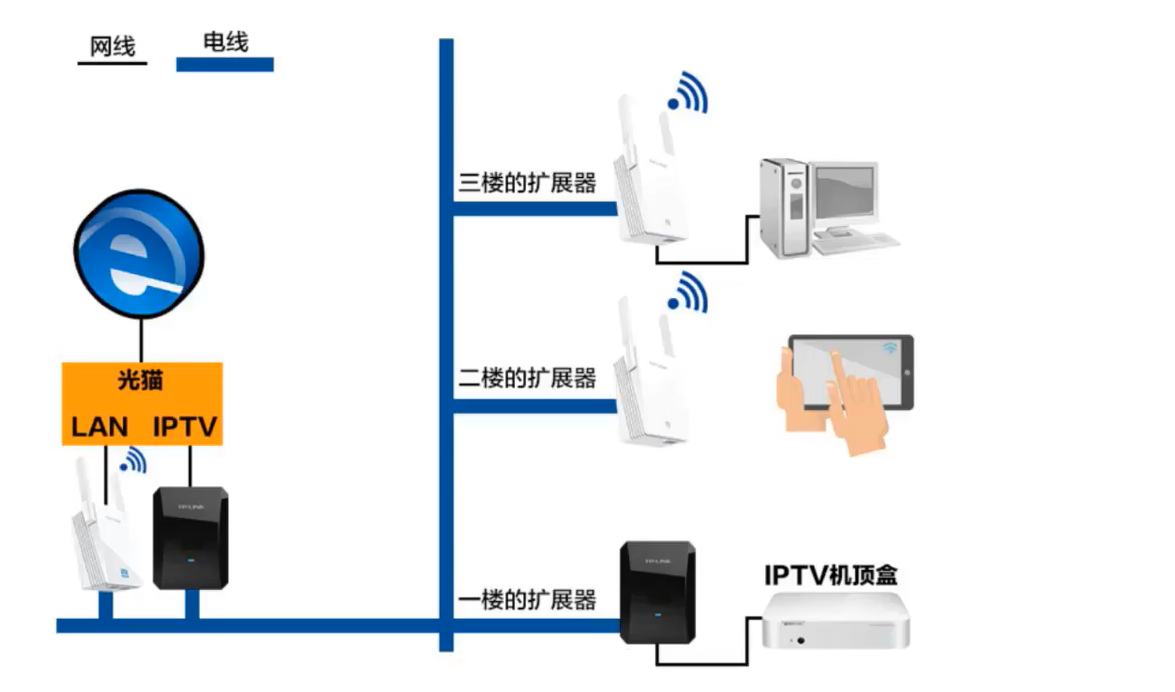
导引型传输媒体—— 同轴电缆,双绞线,光纤,电力线
在导引型传输媒体中,电磁波被导引沿着固体媒体传播。
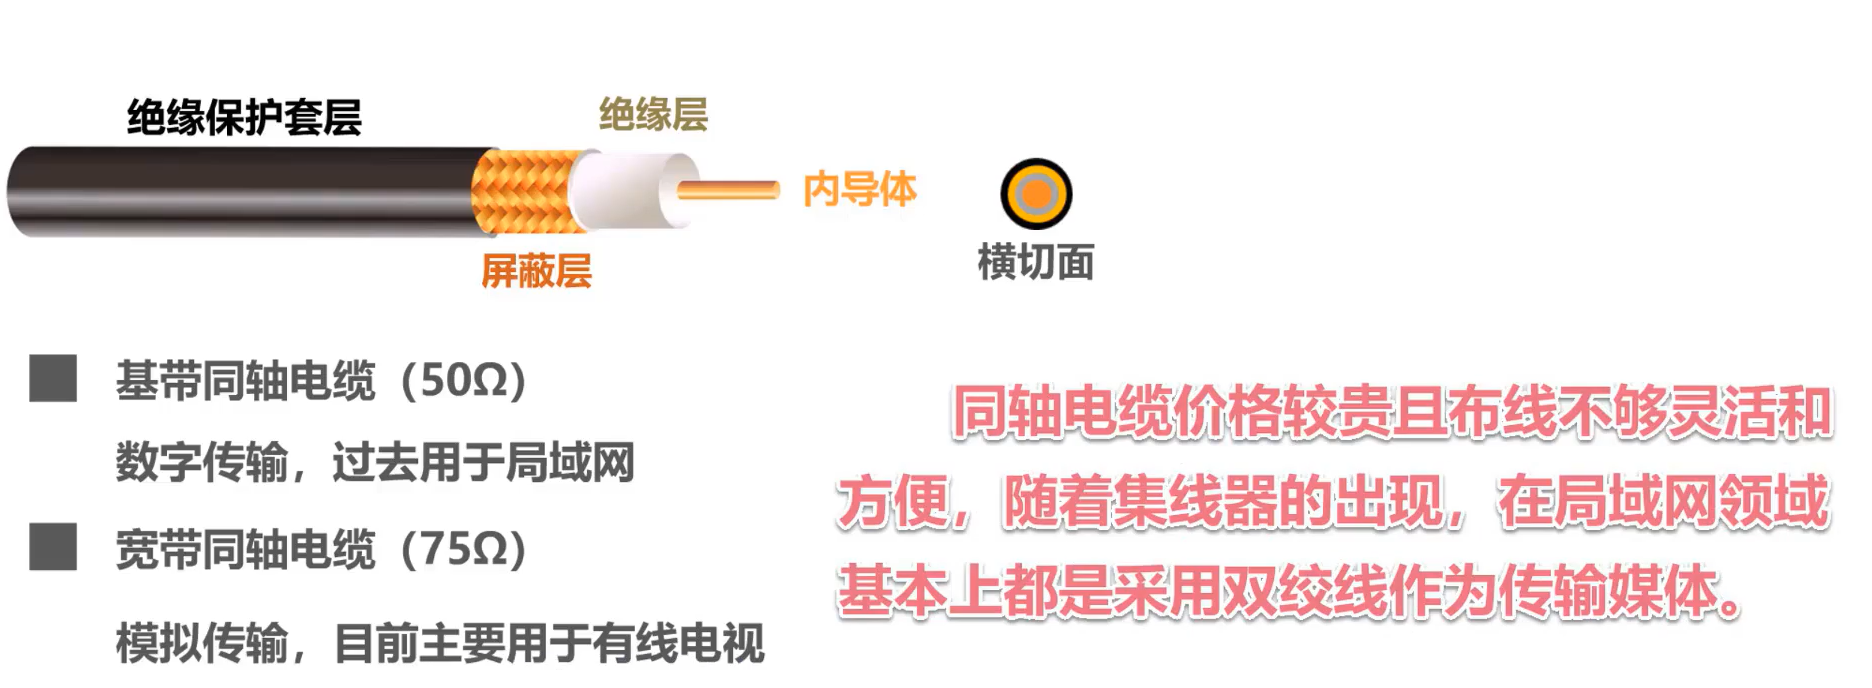
同轴电缆
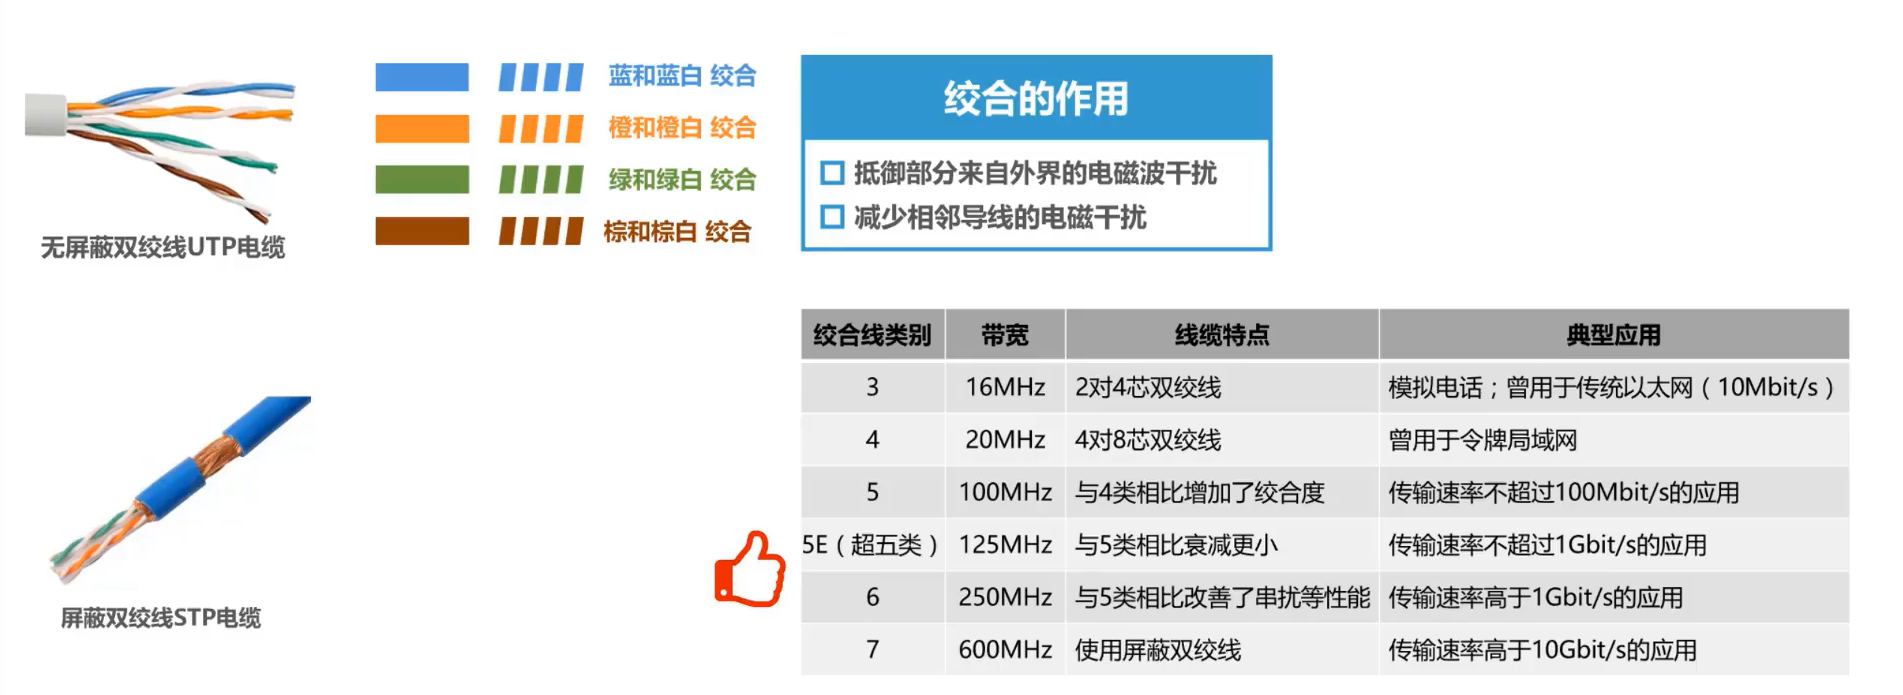
双绞线
绞合的作用:抵御外部的电磁波干扰,减少相邻导线的电磁干扰
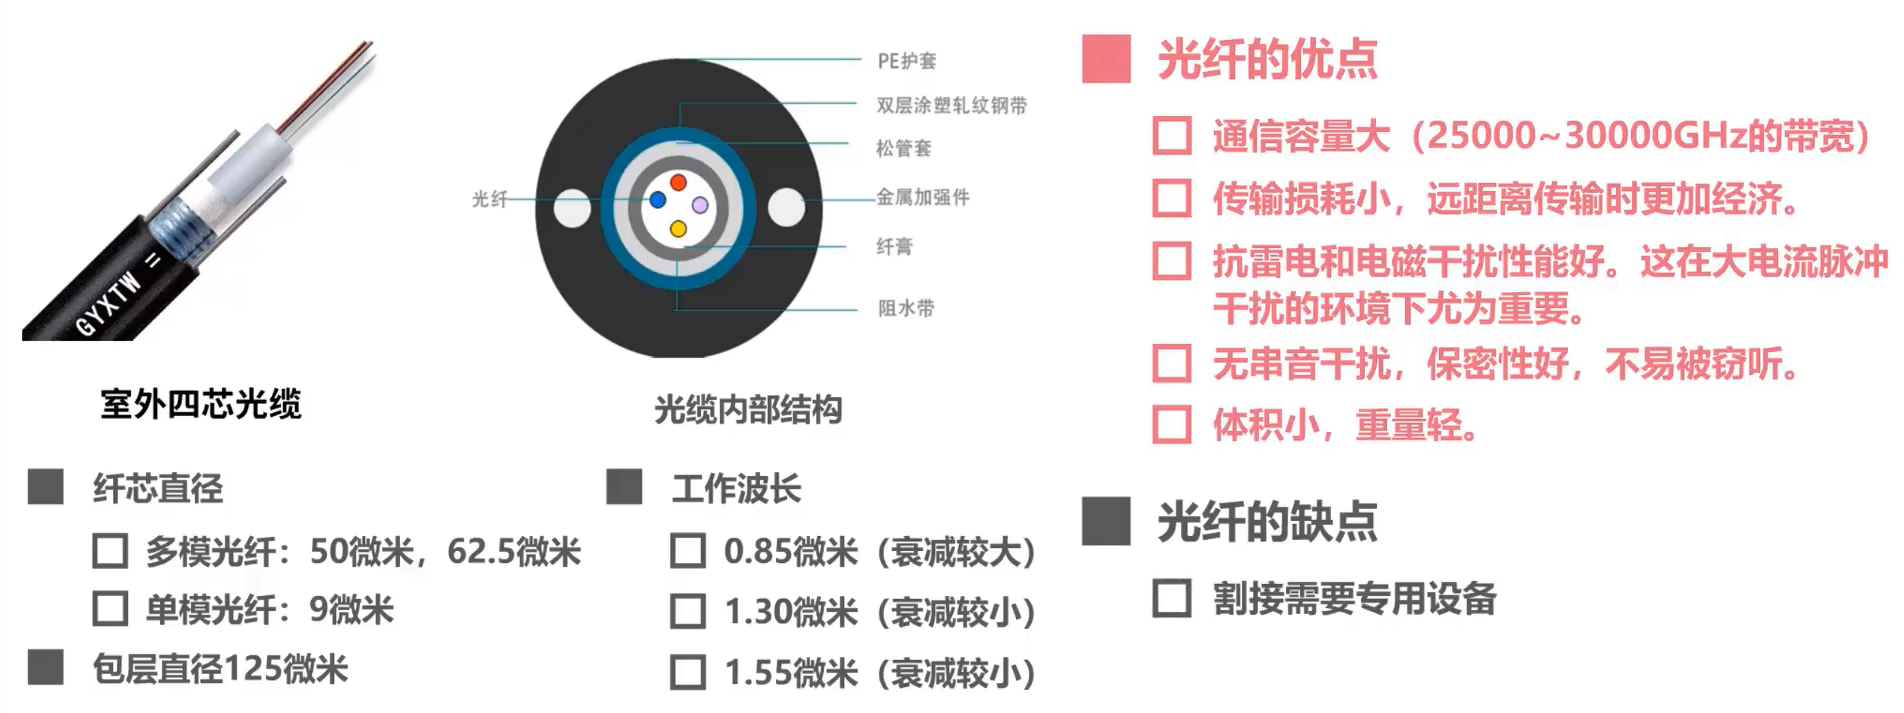
光纤
光纤的优点:
- 通信容量大(25000~30000GHz的带宽)
- 传输损耗小,远距离传输时更加经济
- 抗雷电和电磁干扰性能好。这在大电流脉冲干扰的环境下尤为重要
- 无串音干扰,保密性好,不易被窃听。
- 体积小,重量轻。
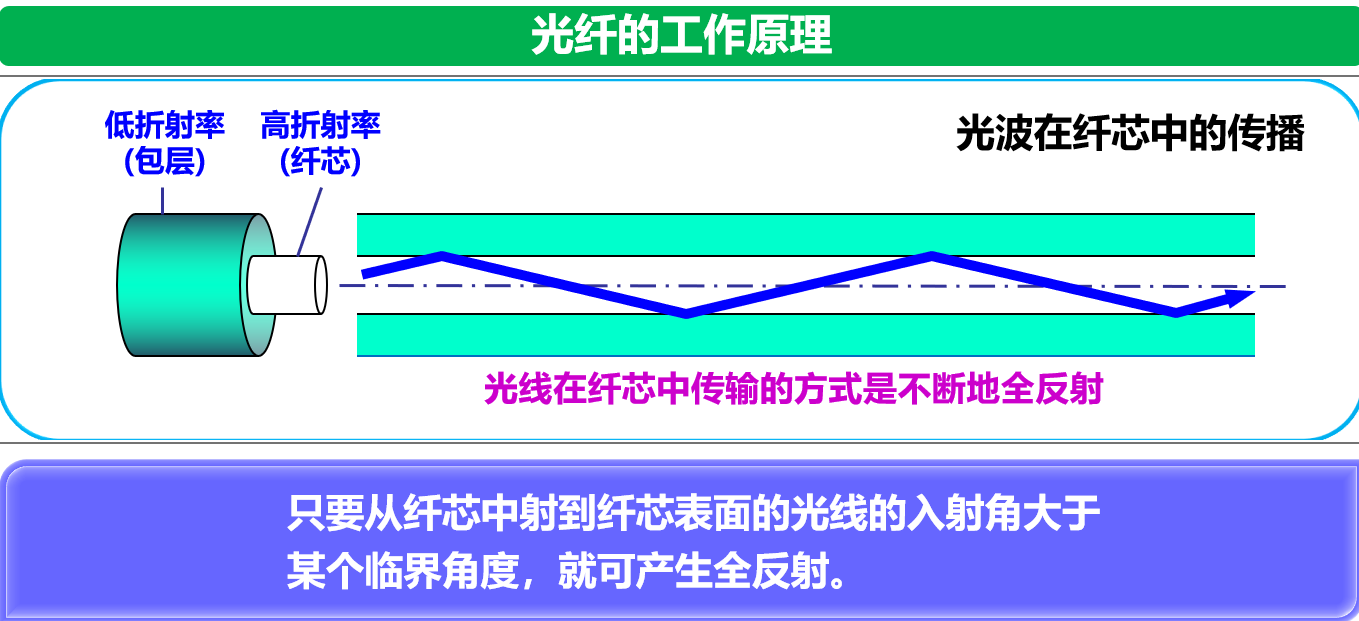
多模光纤
- 可以存在多条不同角度入射的光线在一条光纤中传输。这种光纤就称为多模光纤。
单模光纤
- 若光纤的直径减小到只有一个光的波长,则光纤就像一根波导那样,它可使光线一直向前传播,而不会产生多次反射。这样的光纤称为单模光纤。
电力线
**非导引型传输媒体—— ** 无线电波,微波,红外线,可见光
非导引型传输媒体是指自由空间。
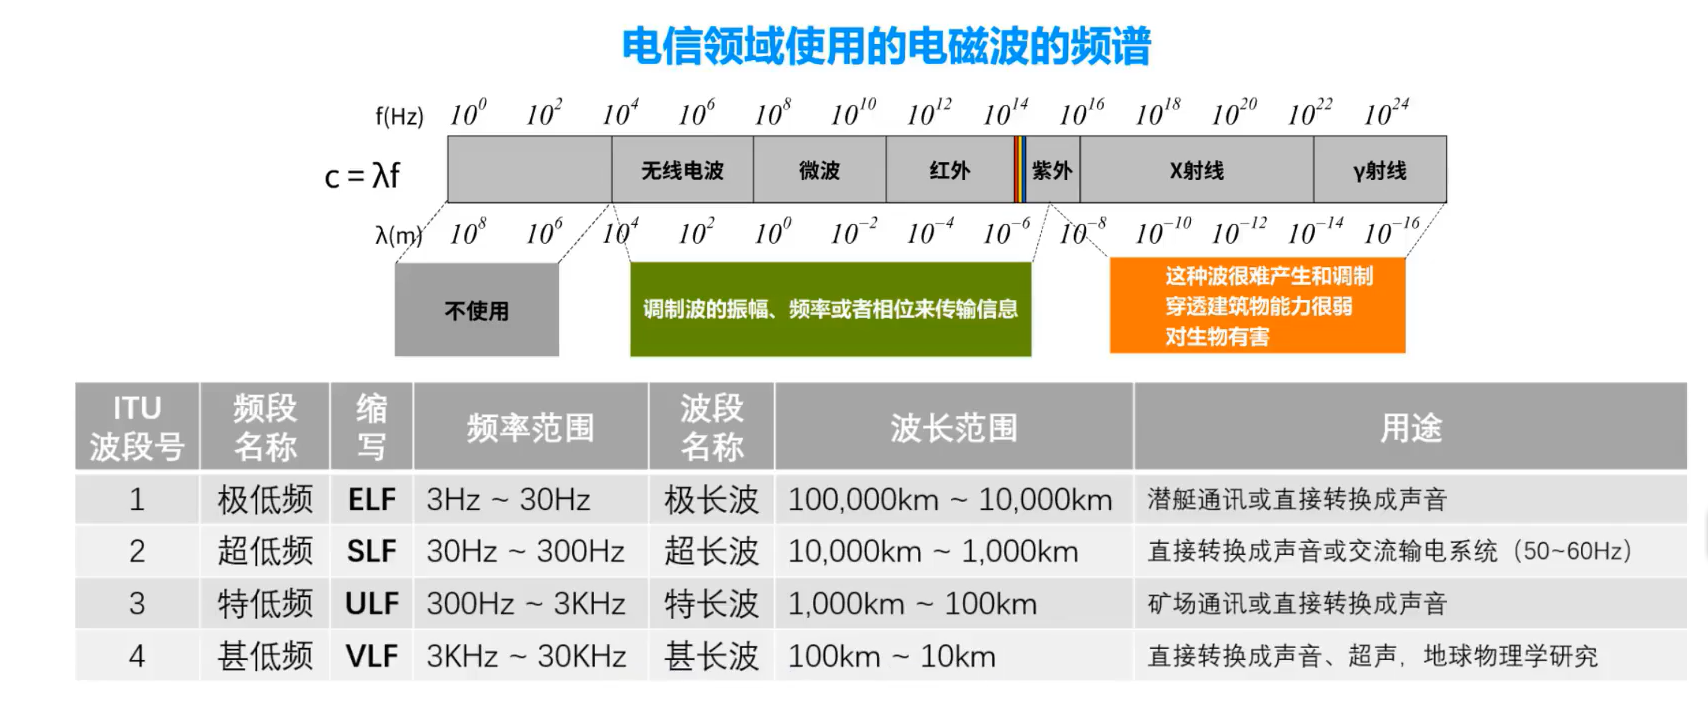
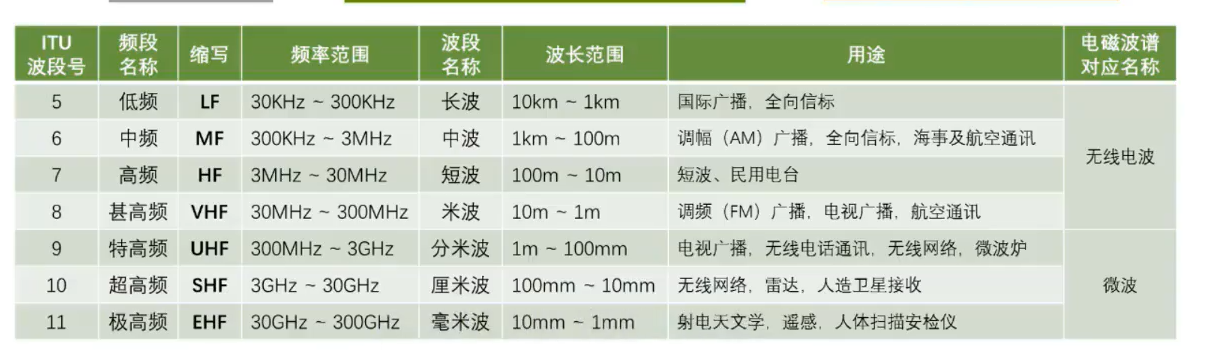
无线电波
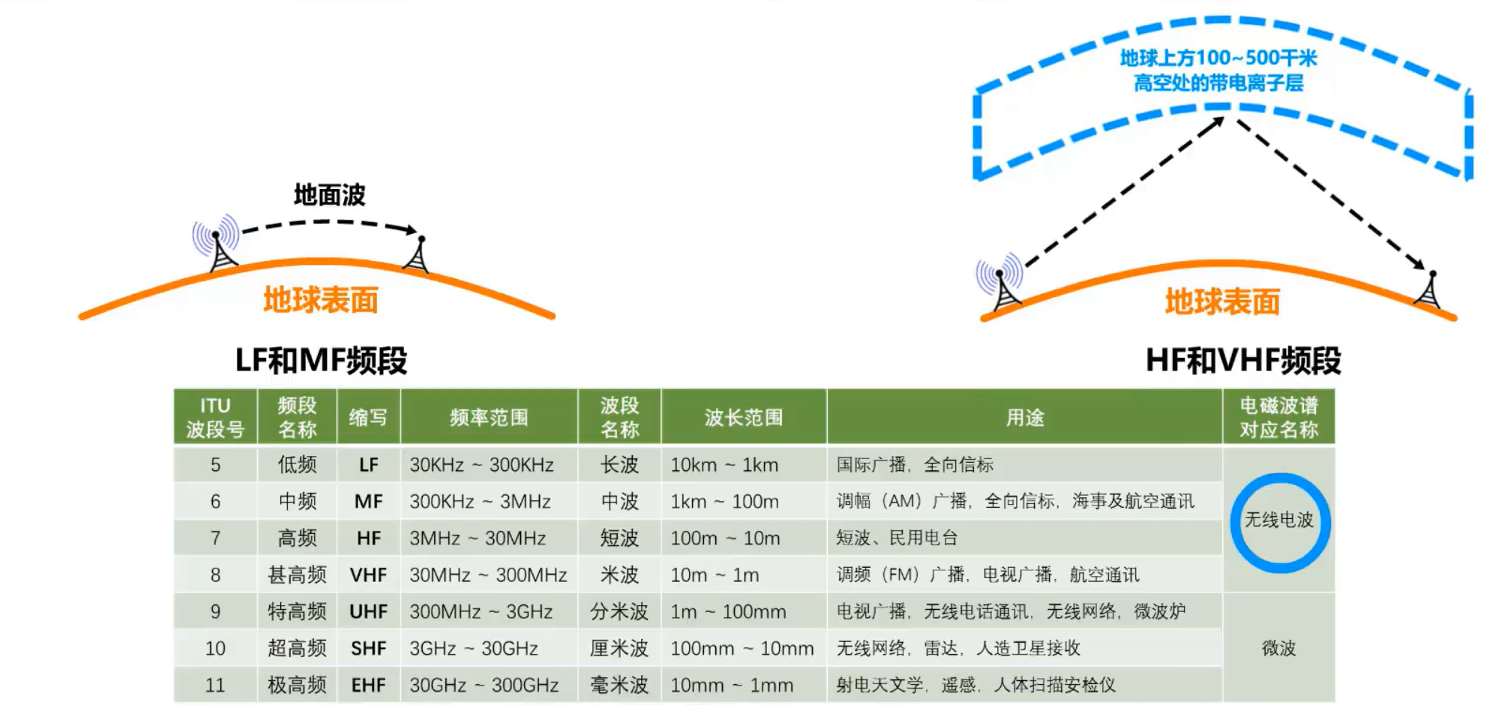
微波
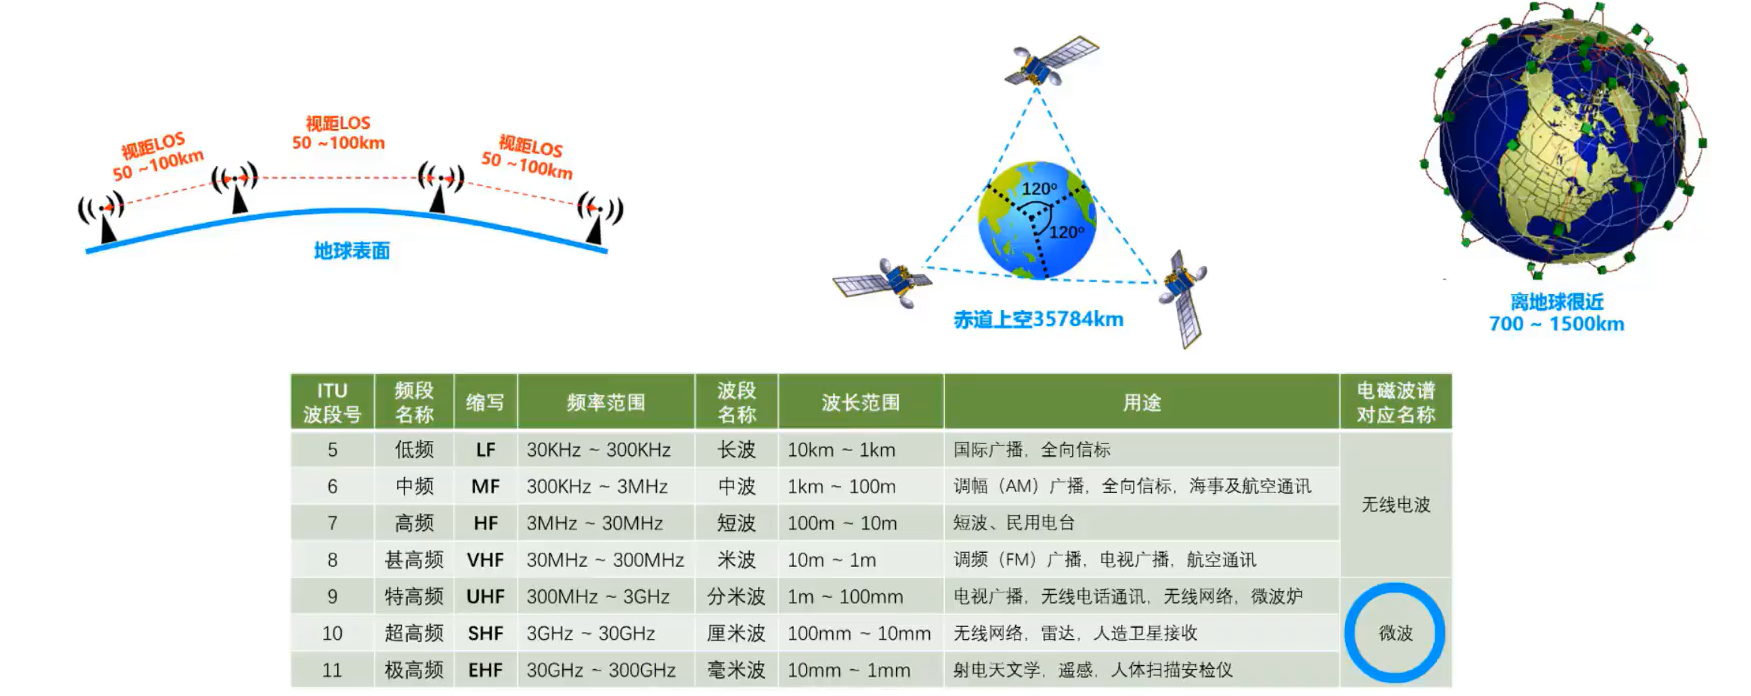
红外线
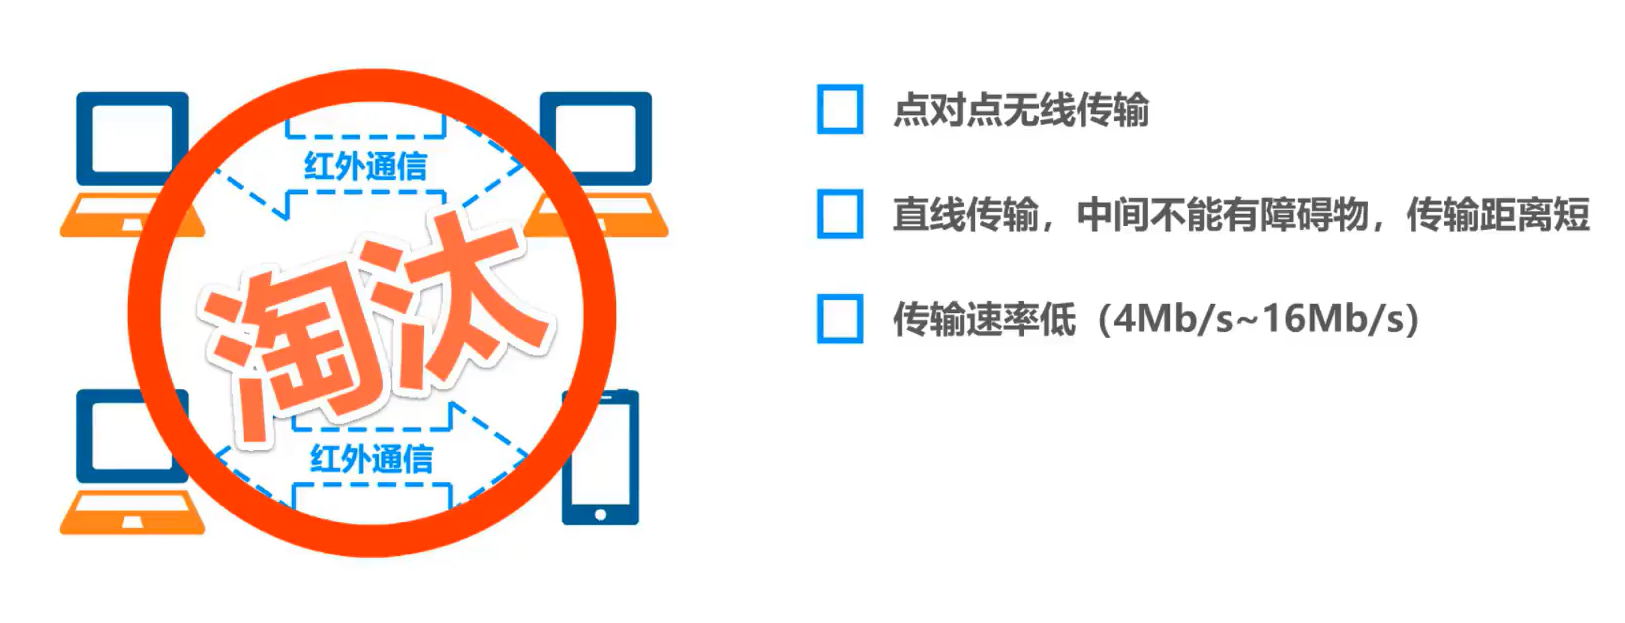
可见光
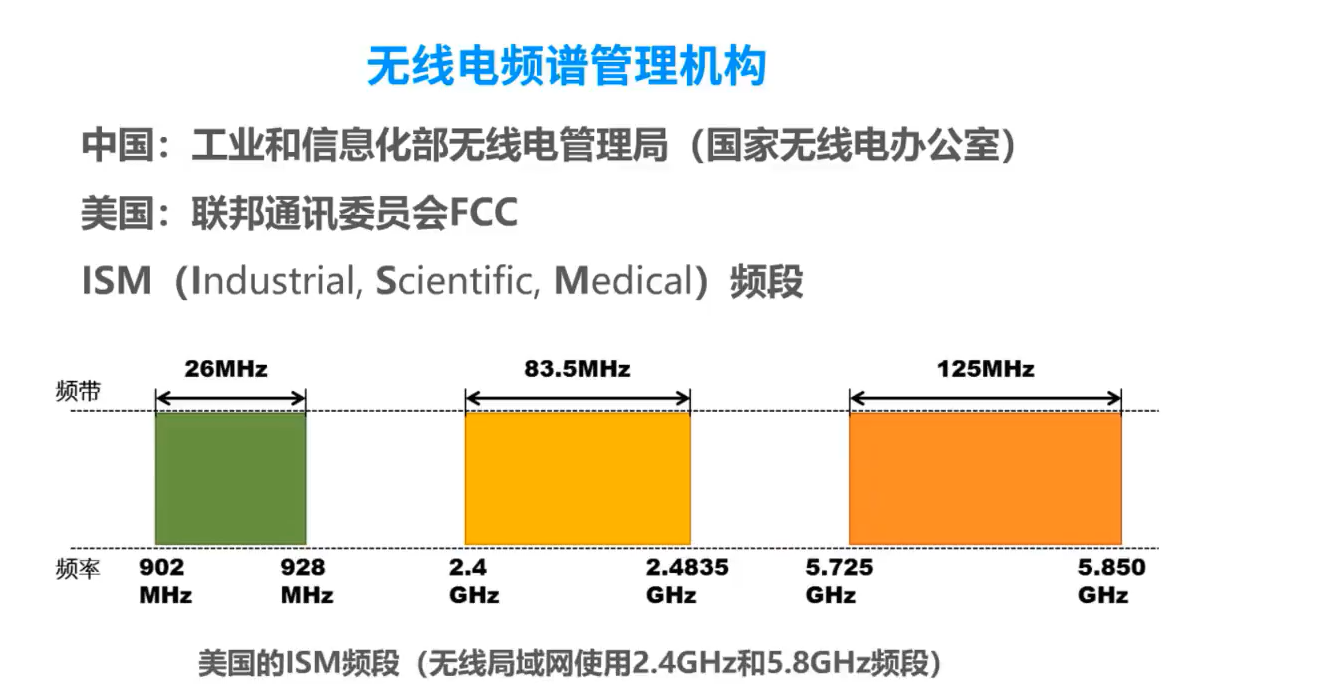
传输方式
串行传输和并行传输
串行传输:
- 数据是一个比特一个比特依次发送的,因此在发送端与接收端之间,只需要一条数据传输线路即可
并行传输:
一次发送n个比特,因此,在发送端和接收端之间需要有n条传输线路
并行传输的优点是比串行传输的速度快n倍,但成本高
数据在传输线路上的传输采用是串行传输,计算机内部的数据传输常用并行传输
同步传输和异步传输
同步传输:
- 数据块以稳定的比特流的形式传输。字节之间没有间隔
- 接收端在每个比特信号的中间时刻进行检测,以判别接收到的是比特0还是比特1
- 由于不同设备的时钟频率存在一定差异,不可能做到完全相同,在传输大量数据的过程中,所产生的判别时刻的累计误差,会导致接收端对比特信号的判别错位
所以要使收发双发时钟保持同步
- 外同步:在收发双方之间添加一个单独的时钟信号线;
- 内同步:发送端将时钟同步信号编码到发送数据中一起传输(如曼切斯特编码)
异步传输:
- 以字节为独立的传输单位,字节之间的时间间隔不是固定
- 接收端仅在每个字节的起始处对字节内的比特实现同步
- 通常在每个字节前后分别加上起始位和结束位
字节间异步(字节间的时间间隔不固定)
但字节中的每个比特仍是同步的(各比特的持续时间相同)
单向通信(单工)、双向交替通信(半双工)和双向同时通信(全双工)
在许多情况下,我们要使用“信道(channel)”这一名词。信道和电路并不等同。信道一般都是用来表示向某一个方向传送信息的媒体。因此,一条通信电路往往包含一条发送信道和一条接收信道。
从通信的双方信息交互的方式来看,可以有以下三种基本方式:
单向通信:
又称为单工通信,即只能有一个方向的通信而没有反方向的交互。无线电广播或有线电以及电视广播就属于这种类型
双向交替通信:
又称为半双工通信,即通信的双方可以发送信息,但不能双方同时发送(当然也就不能同时接收)。这种通信方式使一方发送另一方接收,过一段时间后可以再反过来。
- 双向同时通信:
又称为全双工通信,即通信的双发可以同时发送和接收信息。
单向通信只需要一条信道,而双向交替通信或双向同时通信则需要两条信道(每个方向各一条)
双向同时通信的传输效率最高
编码与调制
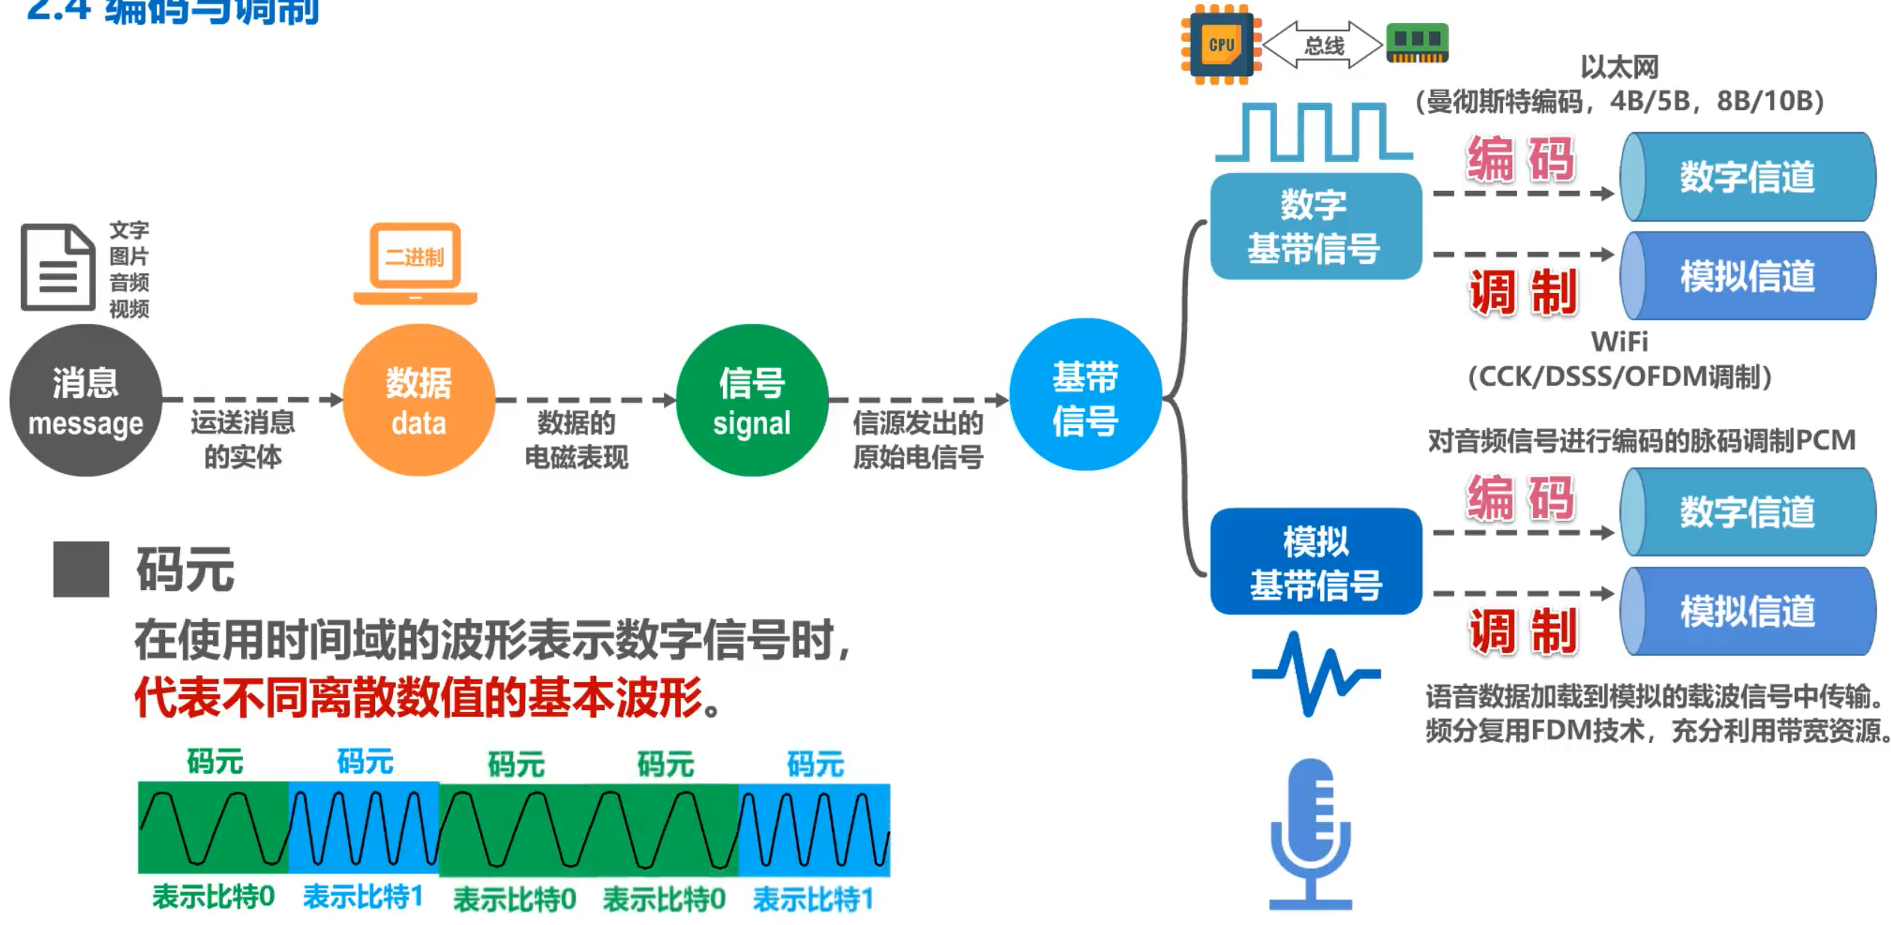
常用术语
数据 (data) —— 运送消息的实体。
信号 (signal) —— 数据的电气的或电磁的表现。
模拟信号 (analogous signal) —— 代表消息的参数的取值是连续的。
数字信号 (digital signal) —— 代表消息的参数的取值是离散的。
码元 (code) —— 在使用时间域(或简称为时域)的波形表示数字信号时,代表不同离散数值的基本波形。
简单的说,码元就是构成信号的一段波形。
基带信号(即基本频带信号)—— 来自信源的信号。像计算机输出的代表各种文字或图像文件的数据信号都属于基带信号。
基带信号往往包含有较多的低频成分,甚至有直流成分,而许多信道并不能传输这种低频分量或直流分量。因此必须对基带信号进行调制 (modulation)。
在计算机网络中,常见的是将数字基带信号通过编码或调制的方法在相应信道进行传输。
- 编码:不改变信号性质,仅对数字基带信号的波形进行变换。编码后产生的信号仍为数字信号。
- 调制:把数字基带信号的频率范围搬移到较高的频段,并转换为模拟信号。
传输媒体与信道的关系
信道的几个基本概念
- 信道 —— 一般用来表示向某一个方向传送信息的媒体。
- 单向通信(单工通信)——只能有一个方向的通信而没有反方向的交互。
- 双向交替通信(半双工通信)——通信的双方都可以发送信息,但不能双方同时发送(当然也就不能同时接收)。
- 双向同时通信(全双工通信)——通信的双方可以同时发送和接收信息。
严格来说,传输媒体不能和信道划等号
对于单工传输,传输媒体只包含一个信道,要么是发送信道,要么是接收信道
对于半双工和全双工,传输媒体中要包含两个信道,一个发送信道,另一个是接收信道
如果使用信道复用技术,一条传输媒体还可以包含多个信道
常用编码
不归零编码
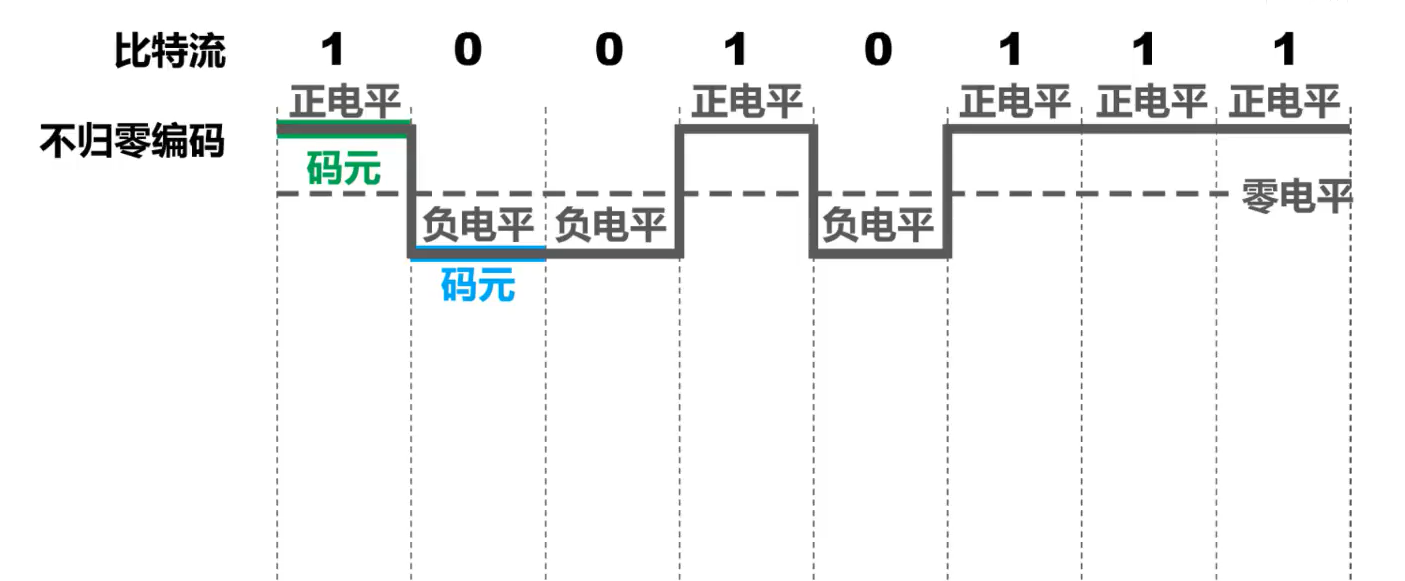
正电平表示比特1/0
负电平表示比特0/1
中间的虚线是零电平,所谓不归零编码,就是指在整个码元时间内,电平不会出现零电平
实际比特1和比特0的表示要看现实怎么规定。
接收端如何判断连续的高或低电平是多少个码元?
这需要发送方的发送与接收方的接收做到严格的同步
- 需要额外一根传输线来传输时钟信号,使发送方和接收方同步,接收方按时钟信号的节拍来逐个接收码元
- 但是对于计算机网络,宁愿利用这根传输线传输数据信号,而不是传输时钟信号
由于不归零编码存在同步问题,因此计算机网络中的数据传输不采用这类编码!
归零编码
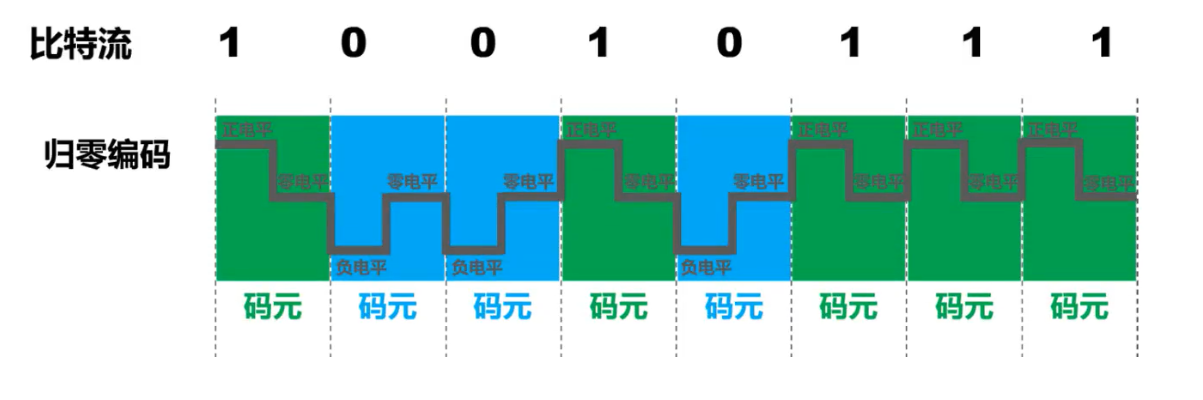
每个码元传输结束后信号都要“归零”。
归零编码虽然自同步,但编码效率低
曼彻斯特编码
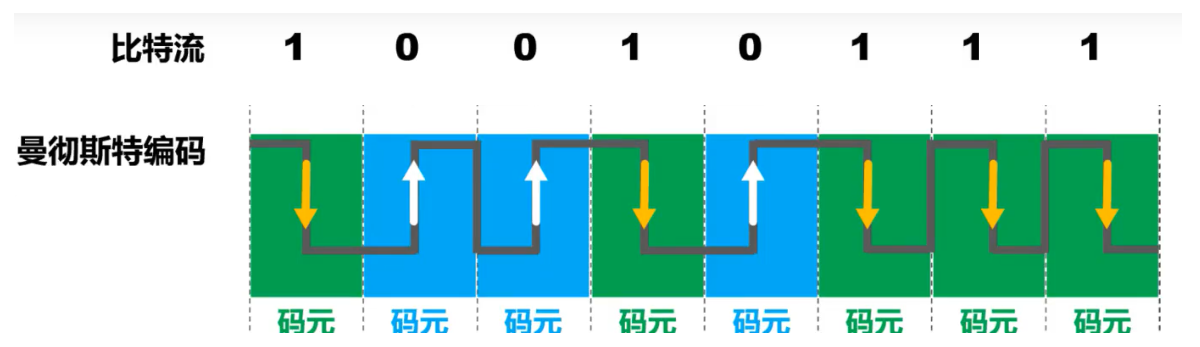
在每个码元时间的中间时刻,信号都会发生跳变
- 负跳变表示比特1/0
- 正跳变表示比特0/1
- 码元中间时刻的跳变即表示时钟,又表示数据
实际比特1和比特0的表示要看现实怎么规定
传统以太网使用的就是曼切斯特编码
差分曼彻斯特编码
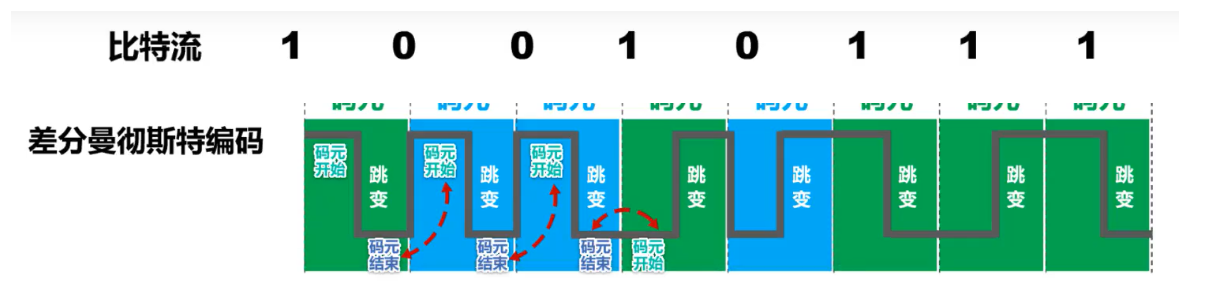
在每个码元时间的中间时刻,信号都会发送跳变,但与曼彻斯特不同
- 跳变仅表示时钟
- 码元开始处电平是否变换表示数据
- 变化表示比特1/0
- 不变化表示比特0/1
实际比特1和比特0的表示要看现实怎么规定
比曼彻斯特编码变化少,更适合较高的传输速率
调制
数字信号转换为模拟信号,在模拟信道中传输,例如WiFi,采用补码键控CCK/直接序列扩频DSSS/正交频分复用OFDM等调制方式。
模拟信号转换为另一种模拟信号,在模拟信道中传输,例如,语音数据加载到模拟的载波信号中传输。频分复用FDM技术,充分利用带宽资源。
基本调制方法
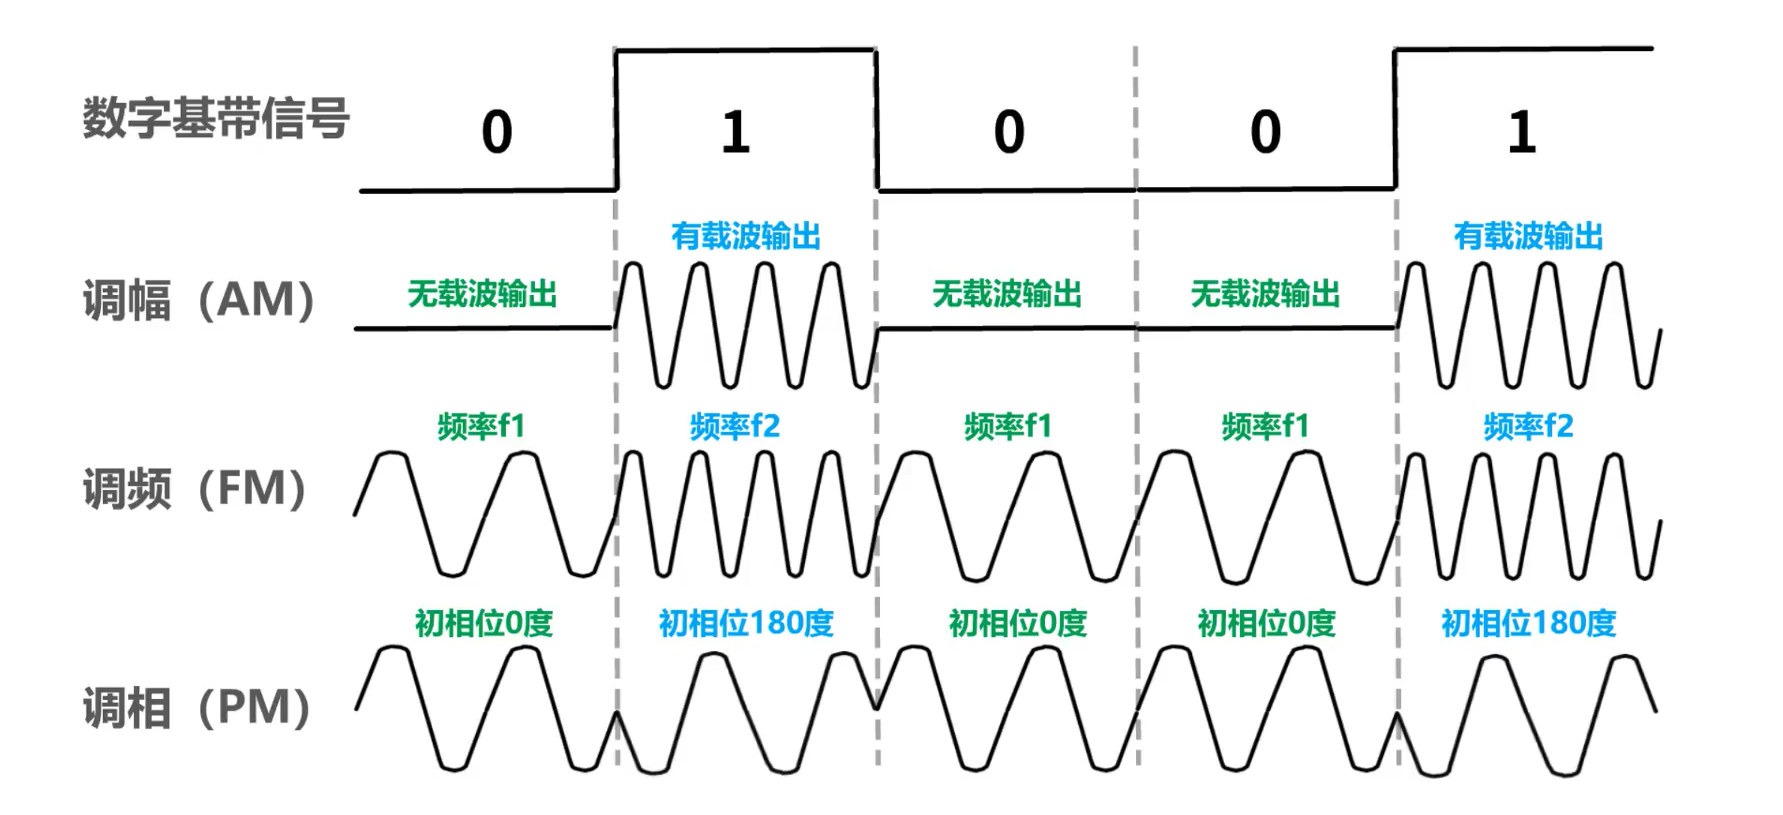
- 调幅AM:所调制的信号由两种不同振幅的基本波形构成。每个基本波形只能表示1比特信息量。
- 调频FM:所调制的信号由两种不同频率的基本波形构成。每个基本波形只能表示1比特信息量。
- 调相PM:所调制的信号由两种不同初相位的基本波形构成。每个基本波形只能表示1比特信息量。
但是使用基本调制方法,1个码元只能包含1个比特信息
混合调制
对于频率,相位,振幅:
因为频率和相位是相关的,即频率是随时间的变化率,所以一次只能调制频率和相位两个中的一个。
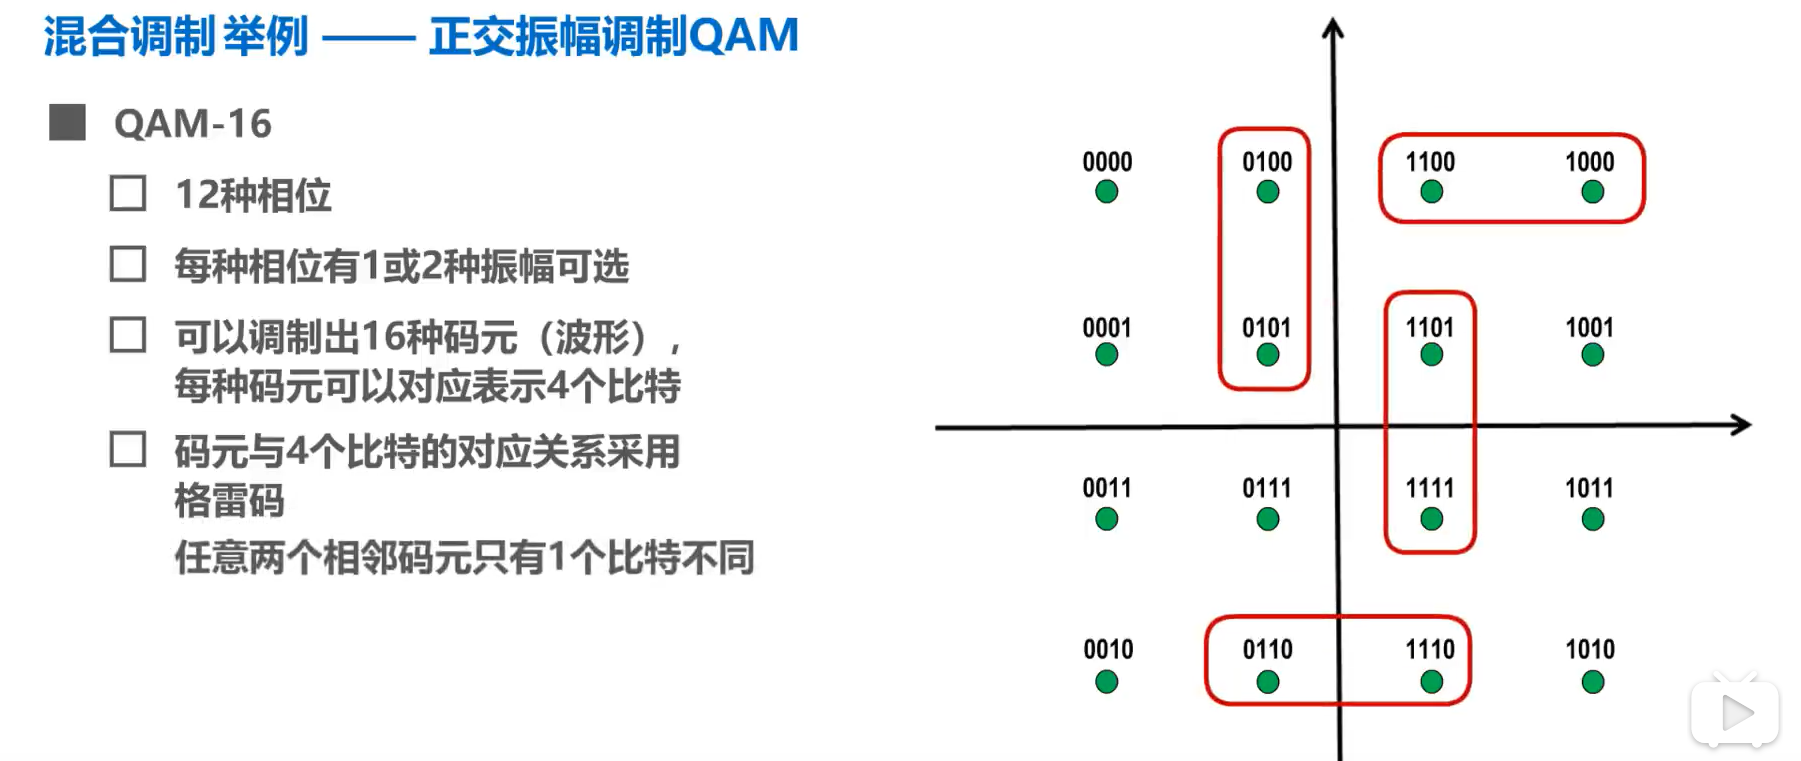
而相位和振幅是可以一起调制的,称为正交振幅调制QAM。
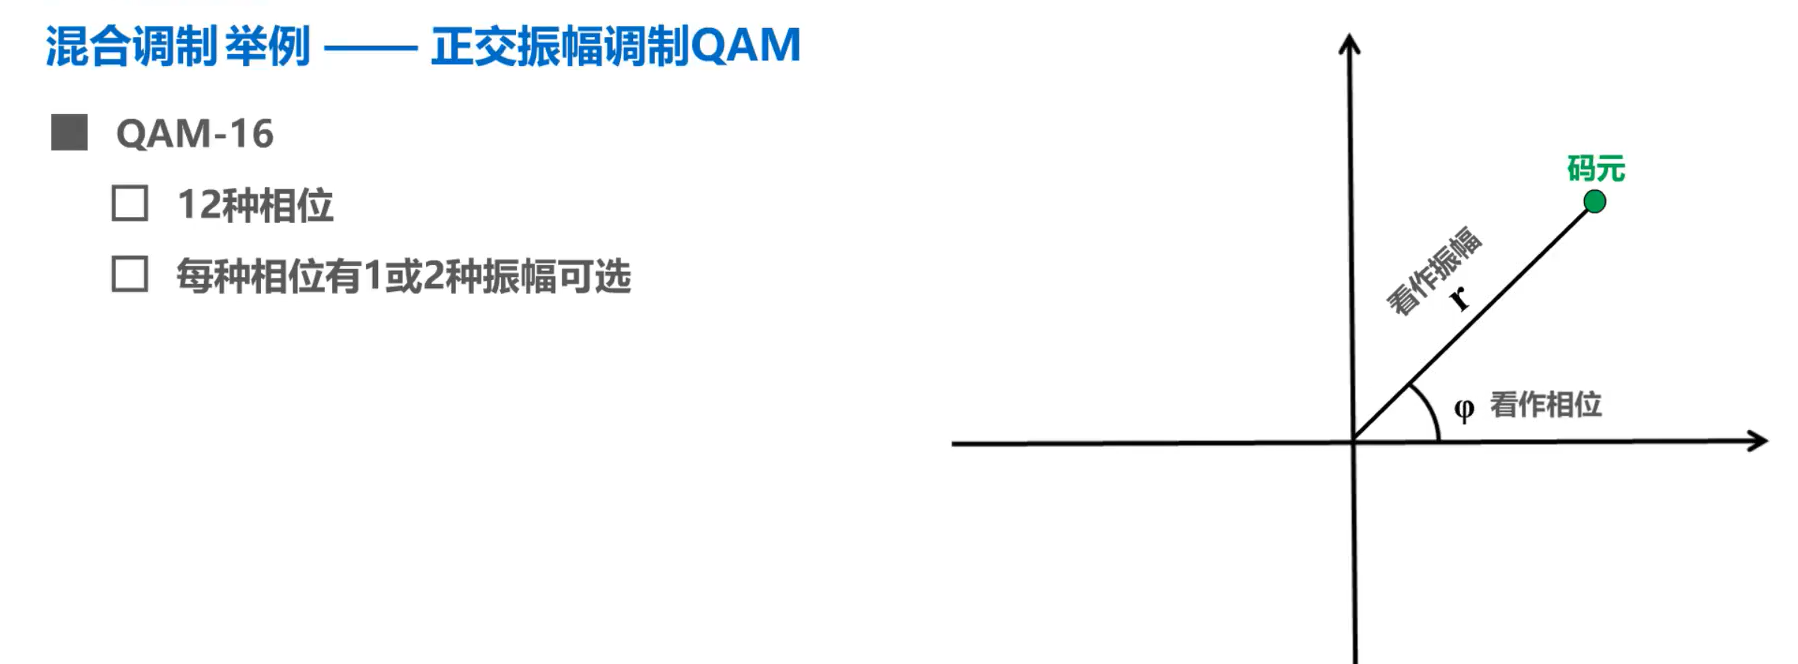
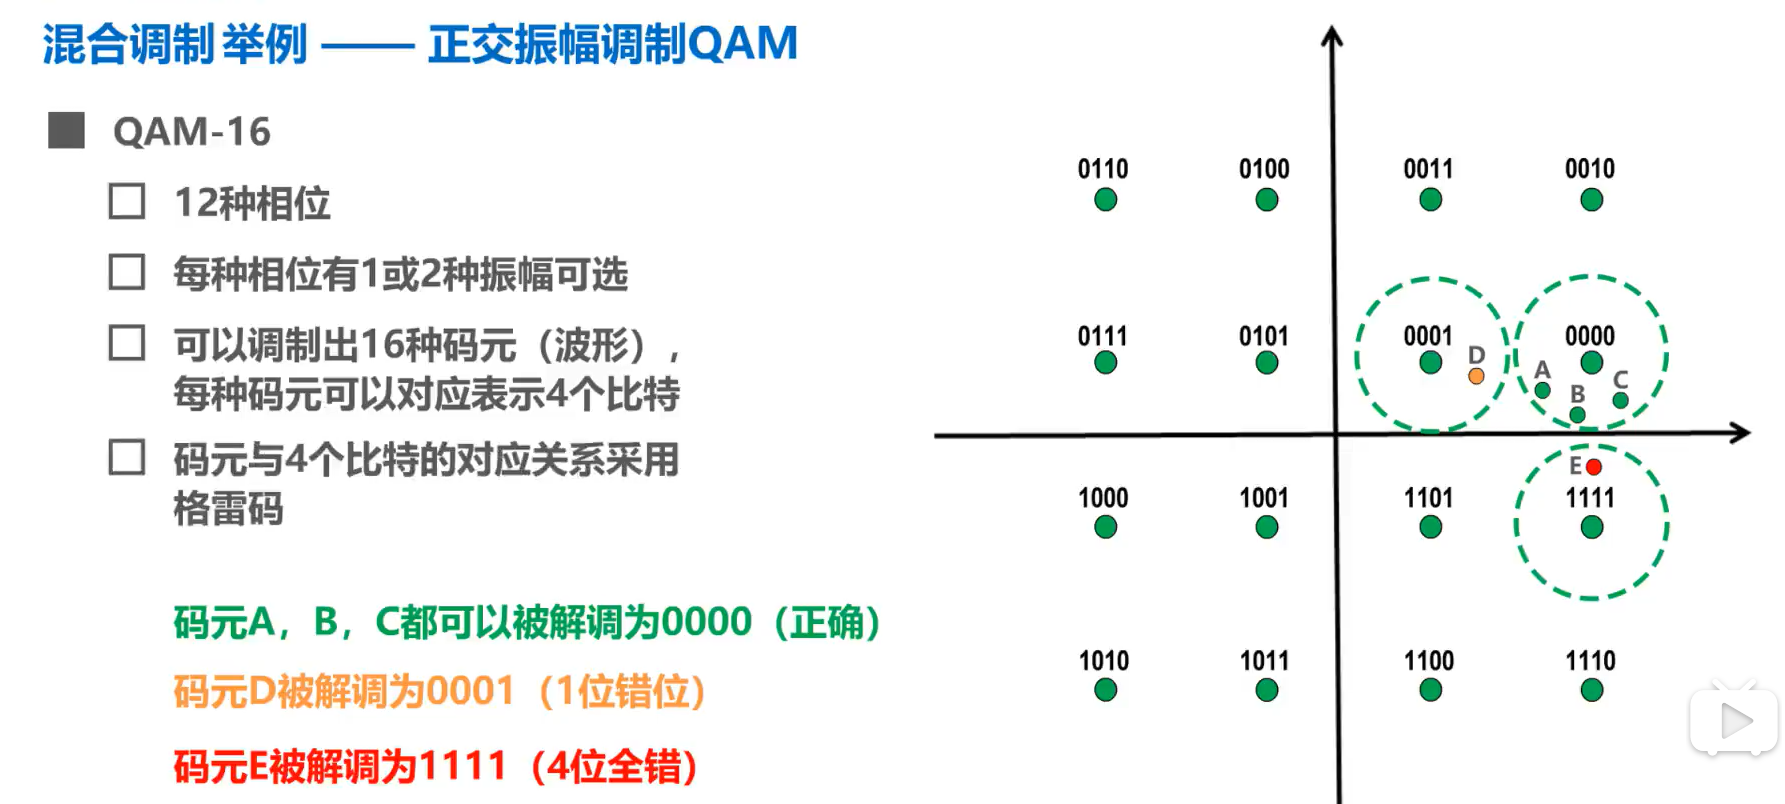
上图码元所对应的4个比特是错误的,码元不能随便对应4个比特
信道的极限容量
- 任何实际的信道都不是理想的,在传输信号时会产生各种失真以及带来多种干扰。
- 码元传输的速率越高,或信号传输的距离越远,或传输媒体质量越差,在信道的输出端的波形的失真就越严重。
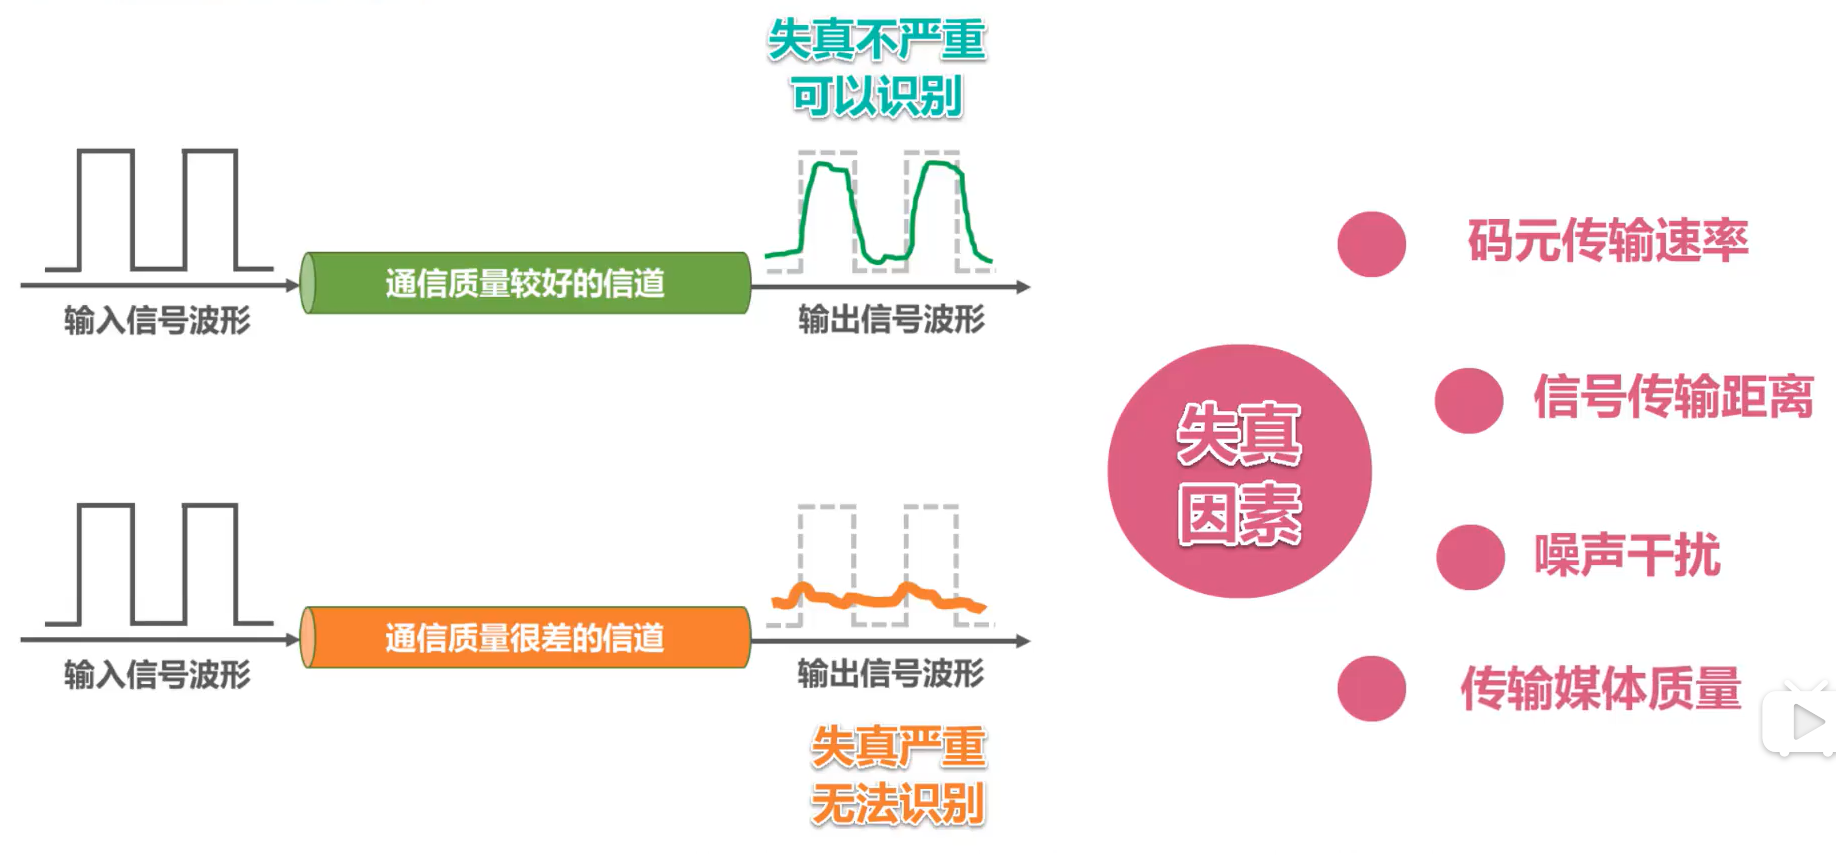
失真的原因:
- 码元传输的速率越高
- 信号传输的距离越远
- 噪声干扰越大
- 传输媒体质量越差
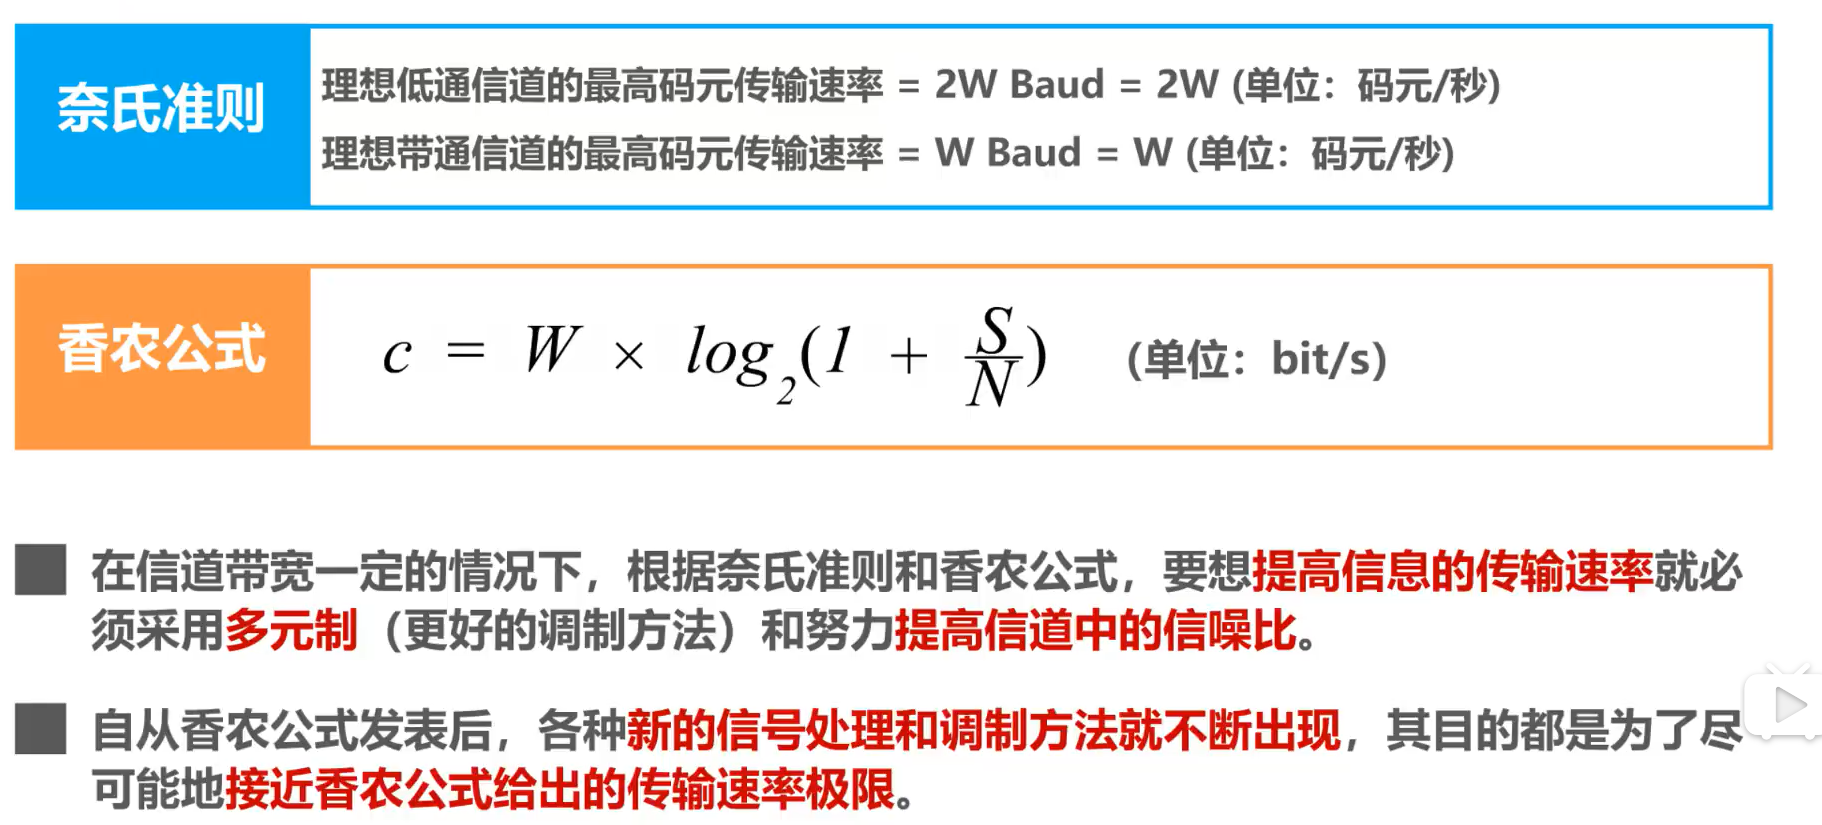
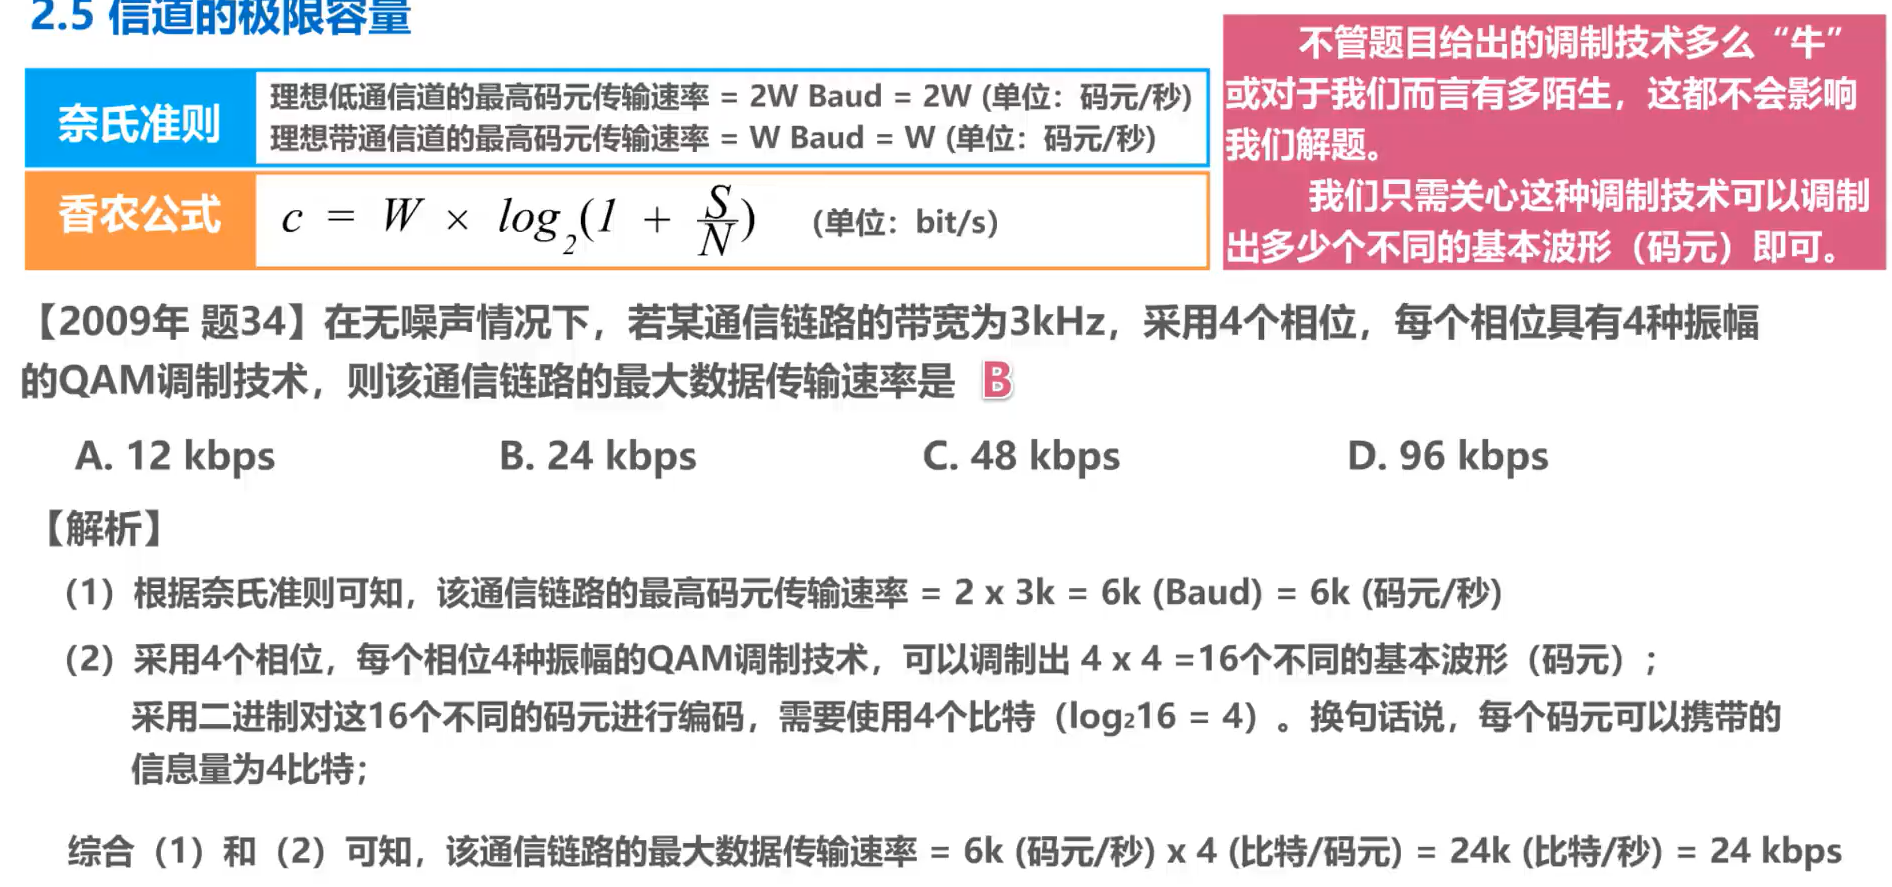
奈氏准则和香农公式
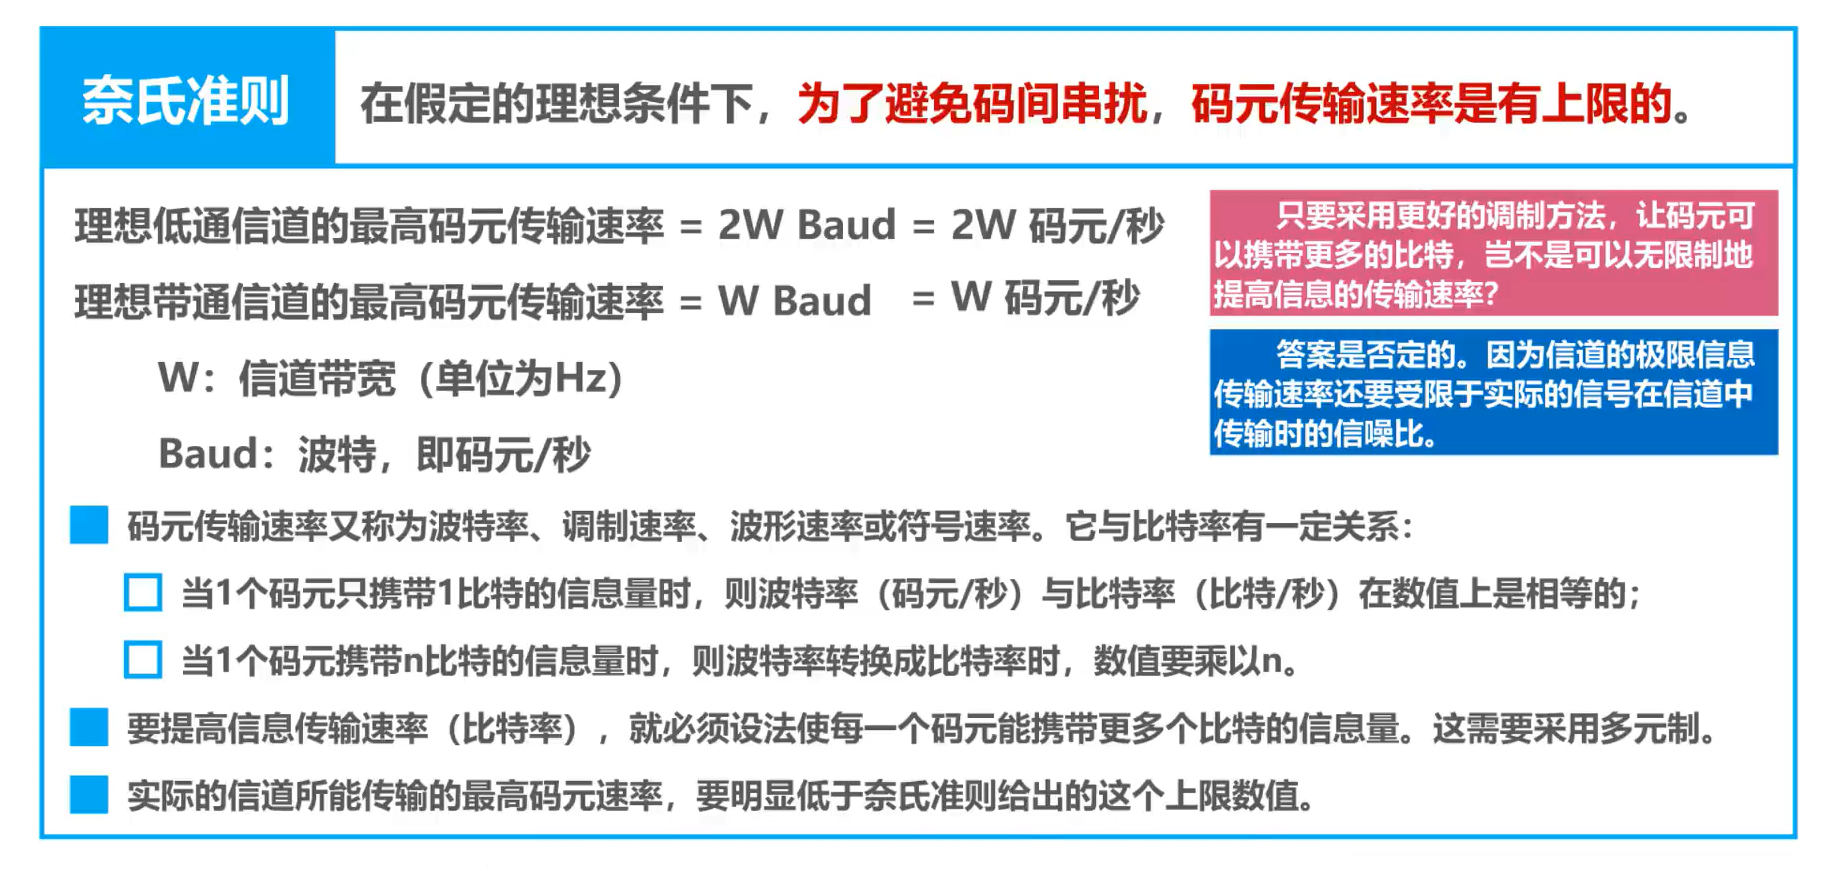
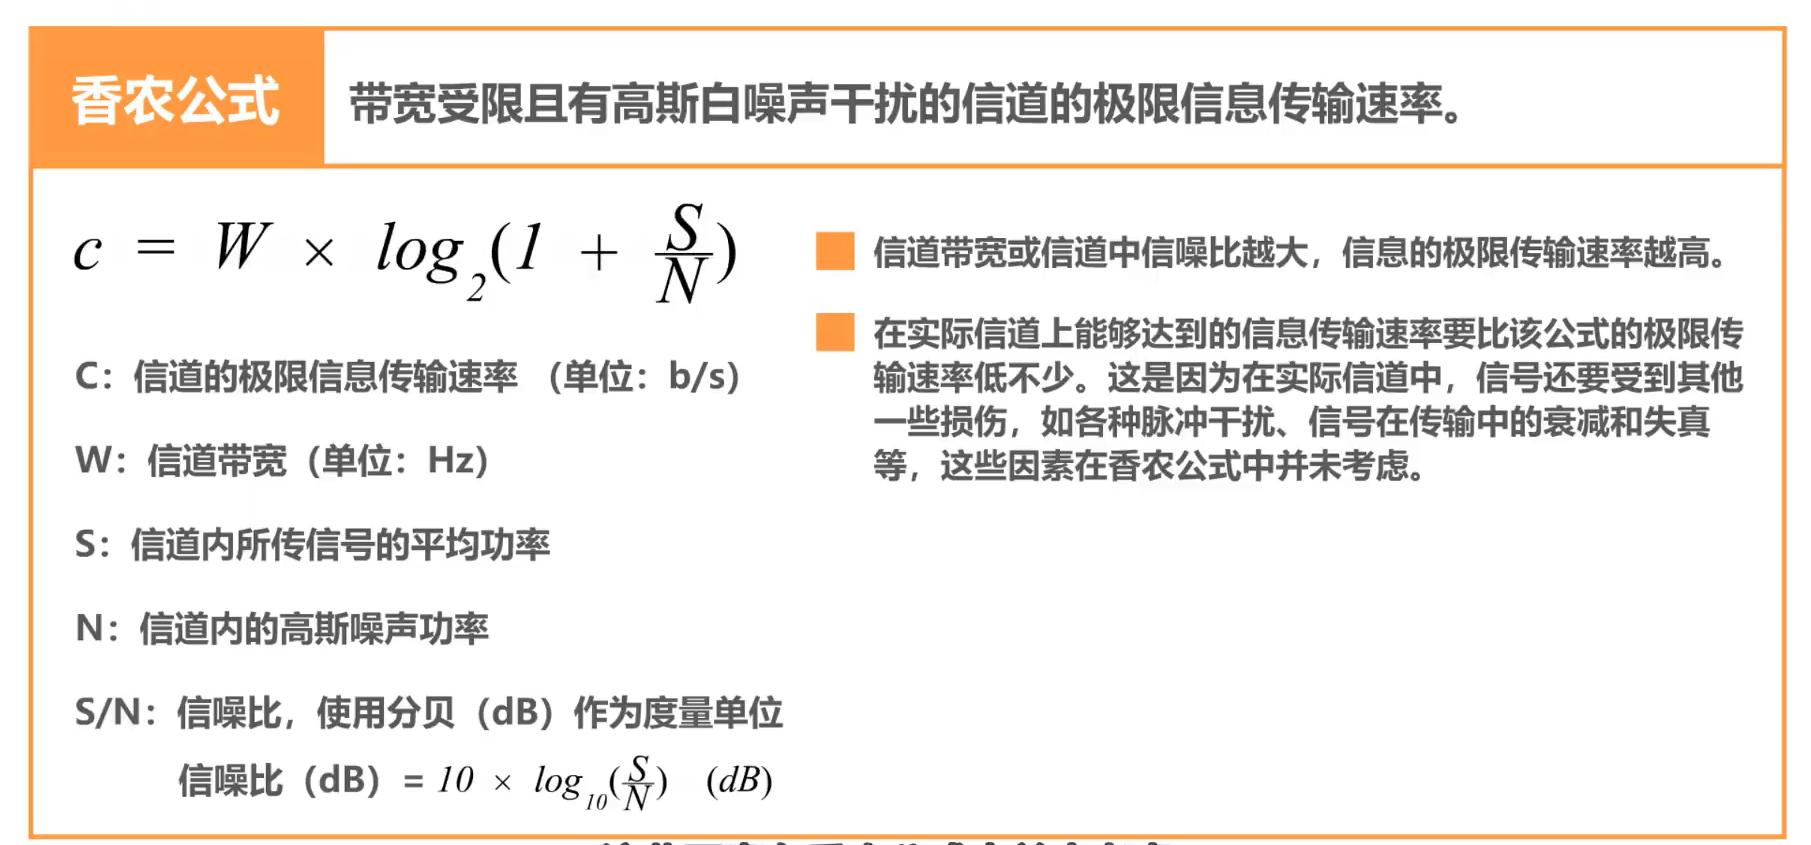
奈氏准则和香农公式对比:
信道复用技术
频分复用、时分复用和统计时分复用
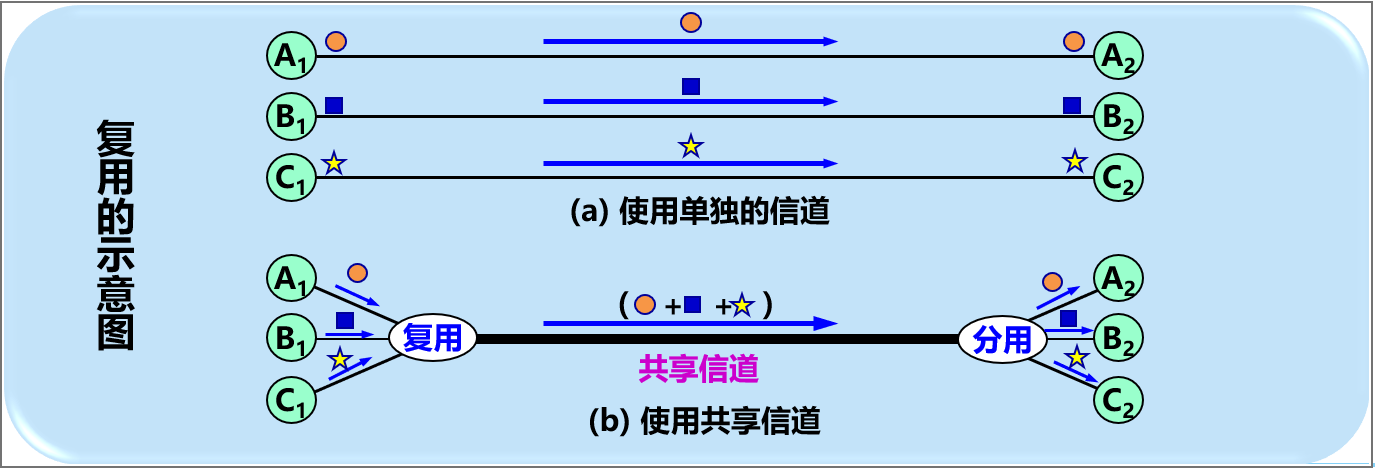
复用 (multiplexing) 是通信技术中的基本概念。
它允许用户使用一个共享信道进行通信,降低成本,提高利用率。
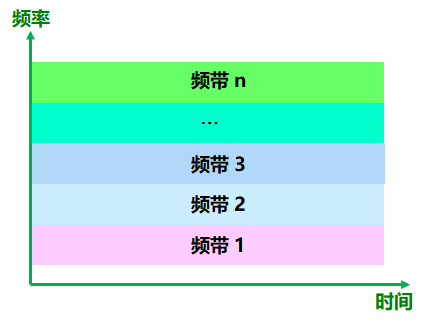
频分复用 FDM (Frequency Division Multiplexing)
- 将整个带宽分为多份,用户在分配到一定的频带后,在通信过程中自始至终都占用这个频带。
- 频分复用的所有用户在同样的时间占用不同的带宽资源(请注意,这里的“带宽”是频率带宽而不是数据的发送速率)。
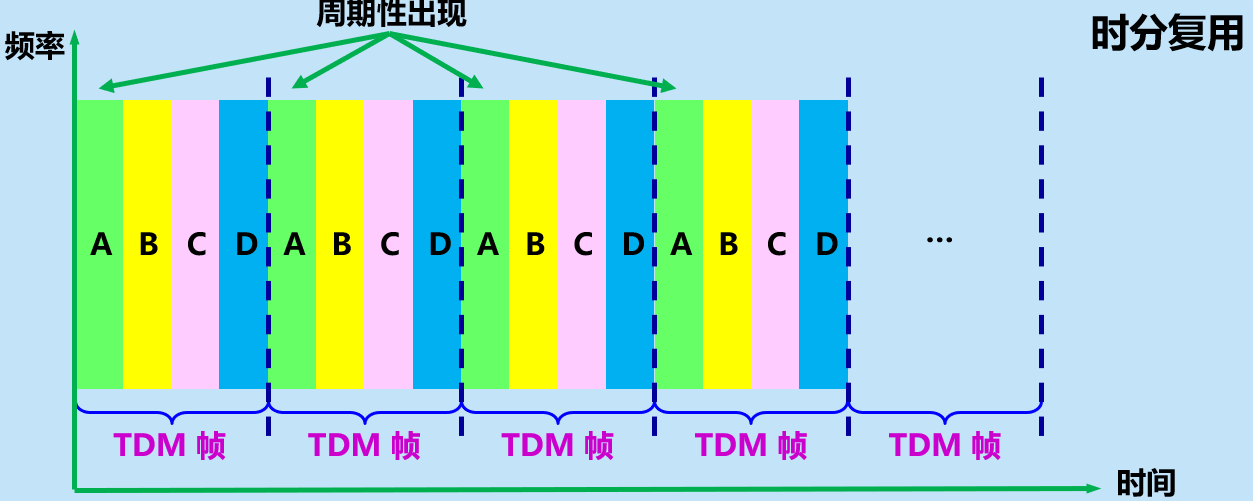
时分复用TDM (Time Division Multiplexing)
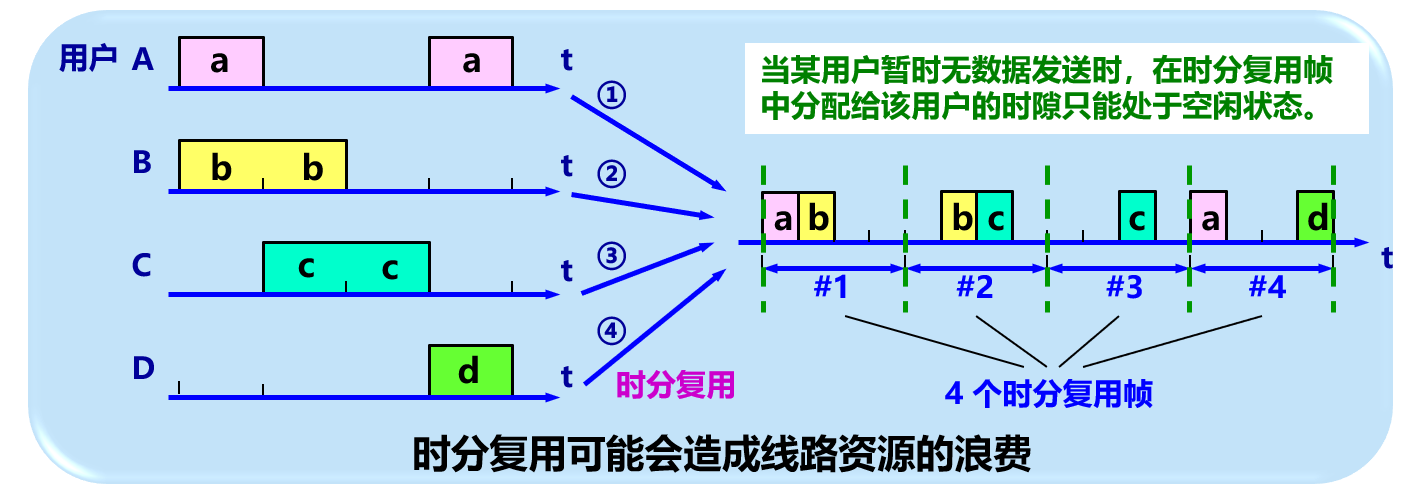
- 时分复用则是将时间划分为一段段等长的时分复用帧(TDM帧)。每一个时分复用的用户在每一个 TDM 帧中占用固定序号的时隙。
- 每一个用户所占用的时隙是周期性地出现(其周期就是TDM帧的长度)的。
- TDM 信号也称为等时 (isochronous) 信号。
- 时分复用的所有用户在不同的时间占用同样的频带宽度。
- 时分复用可能会造成线路资源的浪费
- 使用时分复用系统传送计算机数据时,由于计算机数据的突发性质,用户对分配到的子信道的利用率一般是不高的。
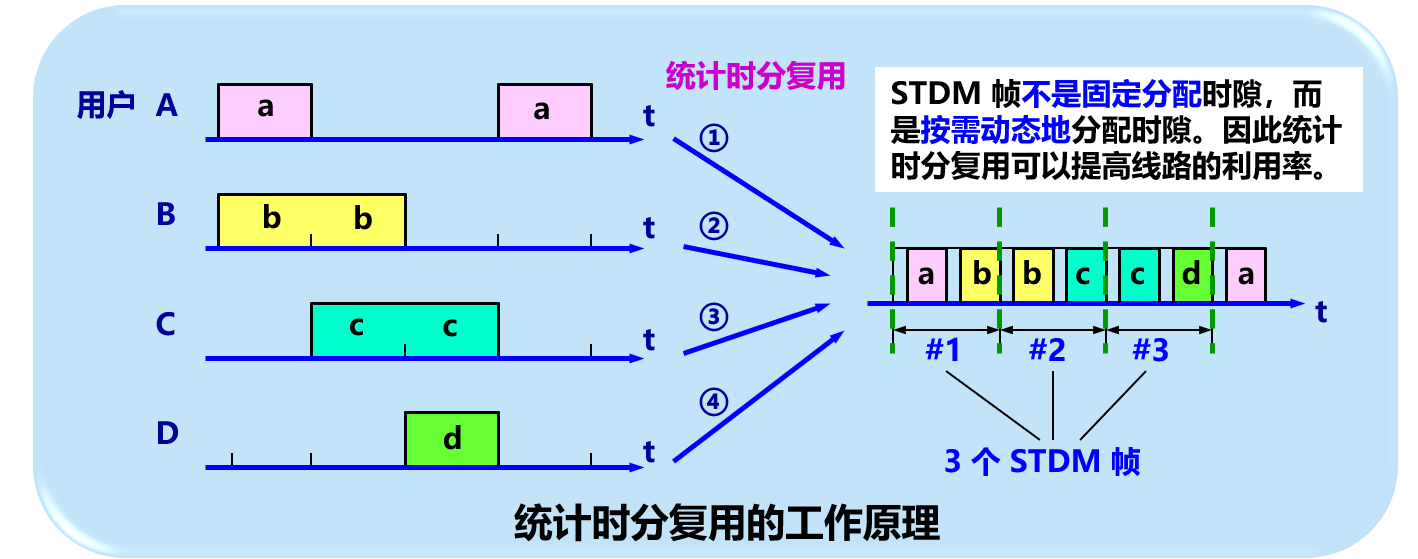
统计时分复用 STDM (Statistic TDM)
波分复用
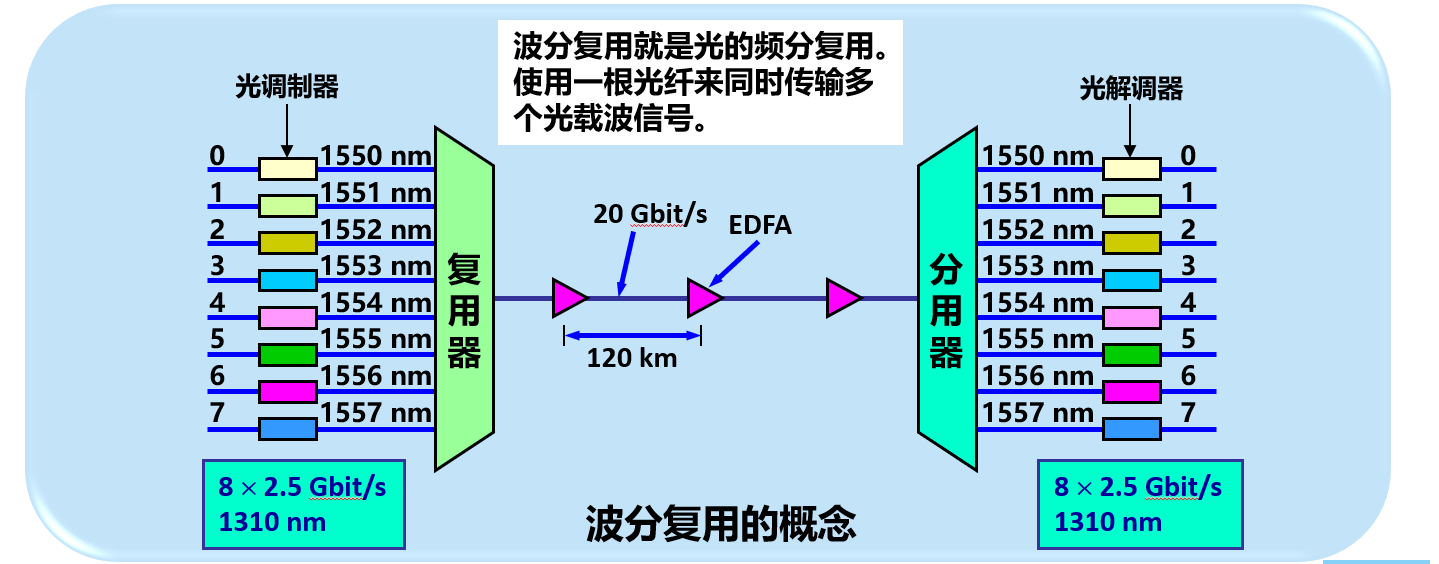
波分复用 WDM(Wavelength Division Multiplexing)
码分复用
码分复用 CDM (Code Division Multiplexing)
- 常用的是码分多址 CDMA (Code Division Multiple Access)。
- 各用户使用经过特殊挑选的不同码型,因此彼此不会造成干扰。
- 这种系统发送的信号有很强的抗干扰能力,其频谱类似于白噪声,不易被敌人发现。
习题
物理层的基本概念:
信道的极限容量习题:
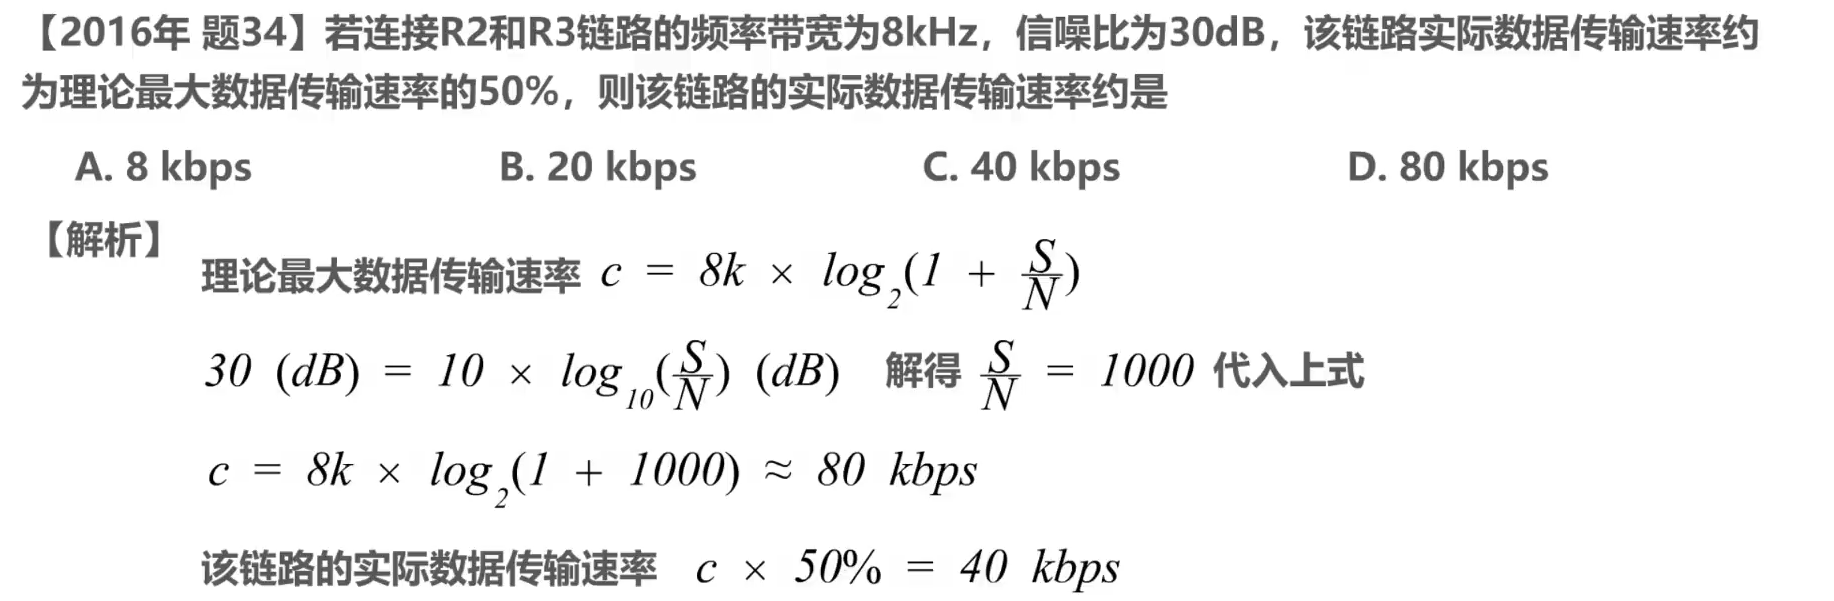
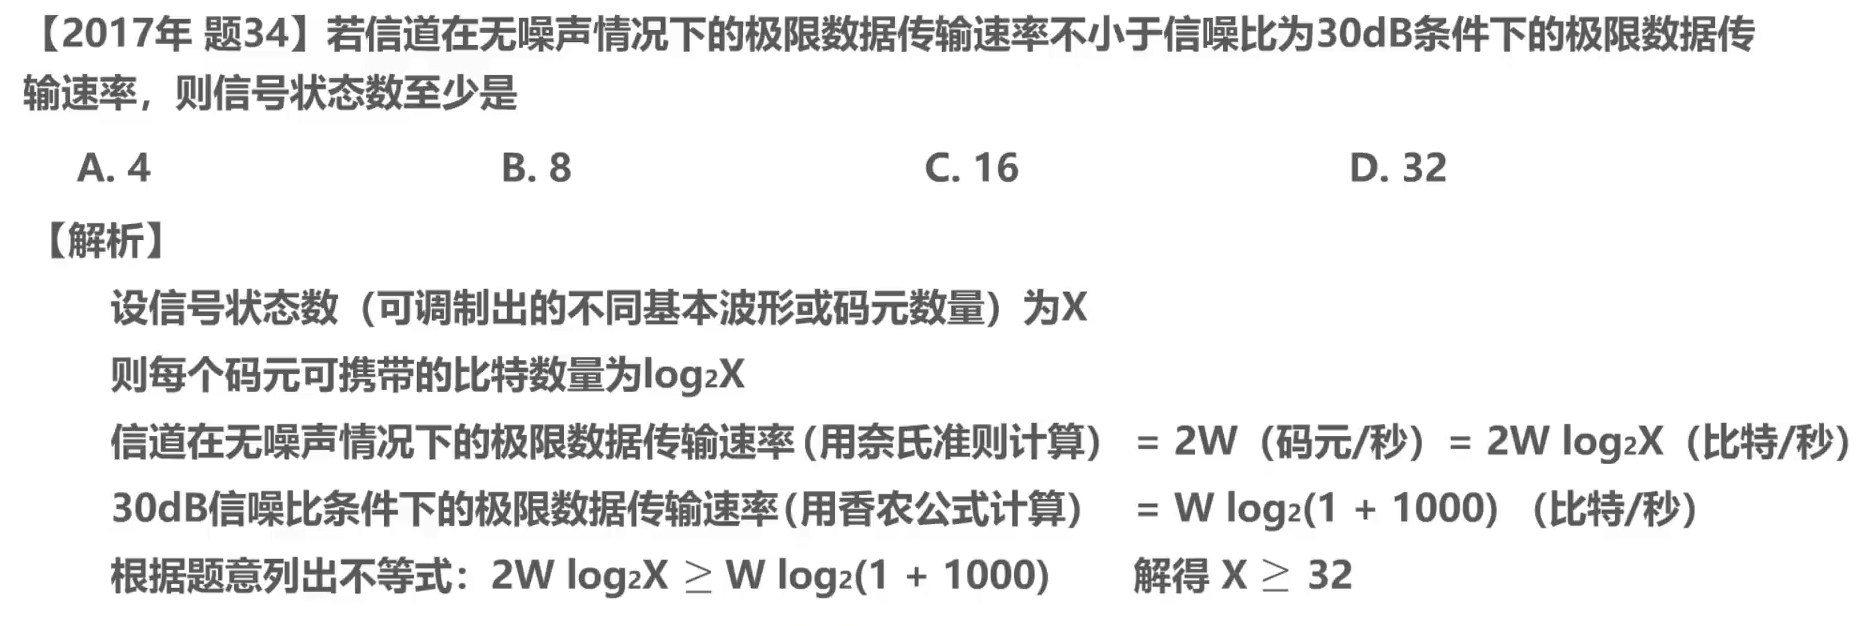
数据链路层
概述
链路是从一个结点到相邻结点的一段物理线路,数据链路则是在链路的基础上增加了一些必要的硬件(如网络适配器)和软件(如协议的实现)
数据链路层以帧为单位传输和处理数据。(即传送的协议数据单元是帧)
网络中的主机、路由器等都必须实现数据链路层
局域网中的主机、交换机等都必须实现数据链路层
注意:不同的链路层可能采用不同的数据链路层协议
数据链路层属于计算机网路的低层。数据链路层使用的信道主要有以下两种类型:
- 点对点信道:一对一
- 广播信道:一对多,必须使用专用的共享信道协议来协调。
局域网属于数据链路层
局域网虽然是个网络。但我们并不把局域网放在网络层中讨论。这是因为在网络层要讨论的是多个网络互连的问题,是讨论分组怎么从一个网络,通过路由器,转发到另一个网络。
而在同一个局域网中,分组怎么从一台主机传送到另一台主机,但并不经过路由器转发。从整个互联网来看,局域网仍属于数据链路层的范围
三个重要问题:封装成帧,差错控制,可靠传输
封装成帧
- 封装成帧 (framing) 就是在一段数据的前后分别添加首部和尾部,然后就构成了一个帧。
- 首部和尾部的一个重要作用就是进行帧定界。
差错控制
在传输过程中可能会产生比特差错:1 可能会变成 0, 而 0 也可能变成 1。可以根据帧尾的检错码检测。
可靠传输
接收方主机收到有误码的帧后,是不会接受该帧的,会将它丢弃
如果数据链路层向其上层提供的是不可靠服务,那么丢弃就丢弃了,不会再有更多措施
如果数据链路层向其上层提供的是可靠服务,那就还需要其他措施,来确保接收方主机还可以重新收到被丢弃的这个帧的正确副本
如果使用广播信道的数据链路层除了包含上面三个问题外,还有一些问题要解决
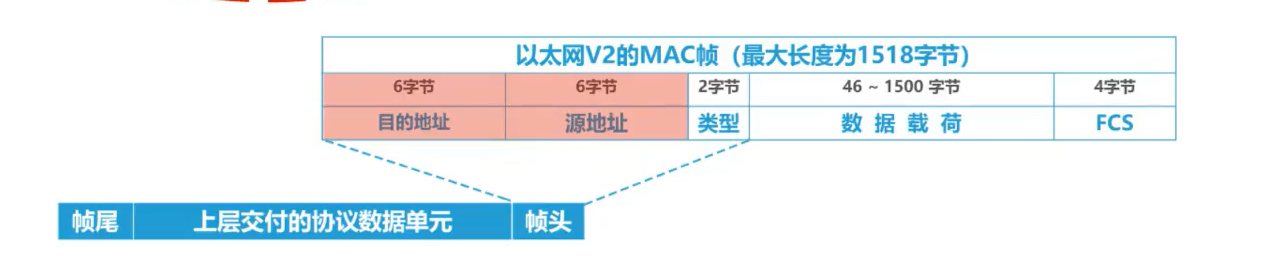
j假设主机A,B,C,D,E通过一根总线进行互连,主机A要给主机C发送数据,代表帧的信号会通过总线传输到总线上的其他各主机,那么主机B,D,E如何知道所收到的帧不是发送给她们的,主机C如何知道发送的帧是发送给自己的?
—— 可以用编址(地址)的来解决
将帧的目的地址添加在帧中一起传输
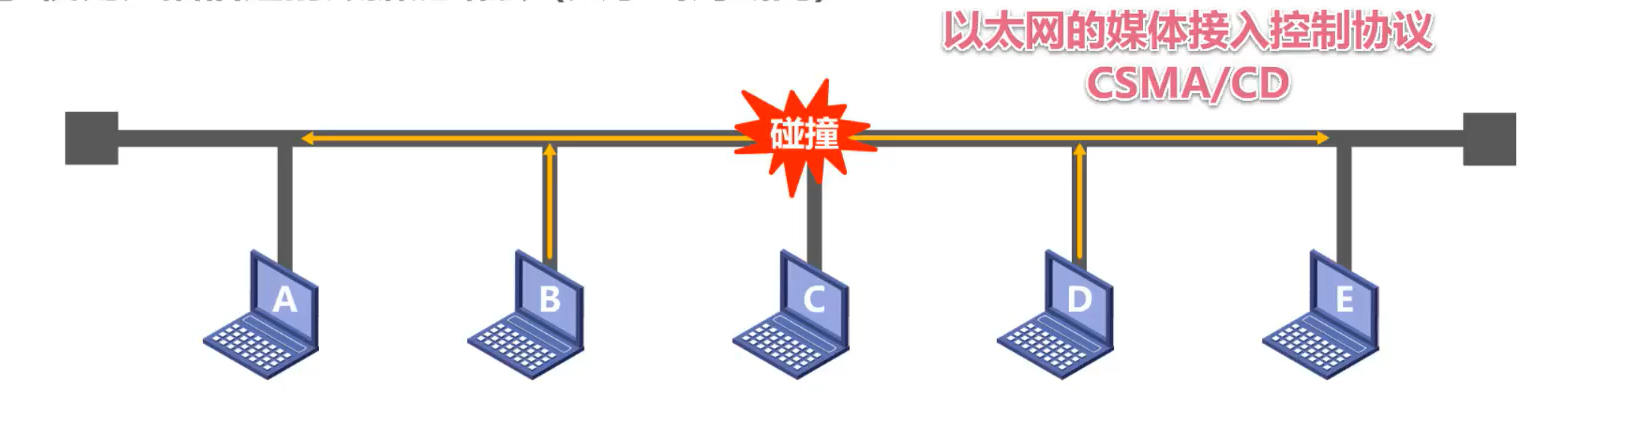
还有数据碰撞问题
随着技术的发展,交换技术的成熟,在有线(局域网)领域 使用点对点链路和链路层交换机的交换式局域网取代了
共享式局域网在无线局域网中仍然使用的是共享信道技术
封装成帧
封装成帧是指数据链路层给上层交付的协议数据单元添加帧头和帧尾使之成为帧
- 帧头和帧尾中包含有重要的控制信息
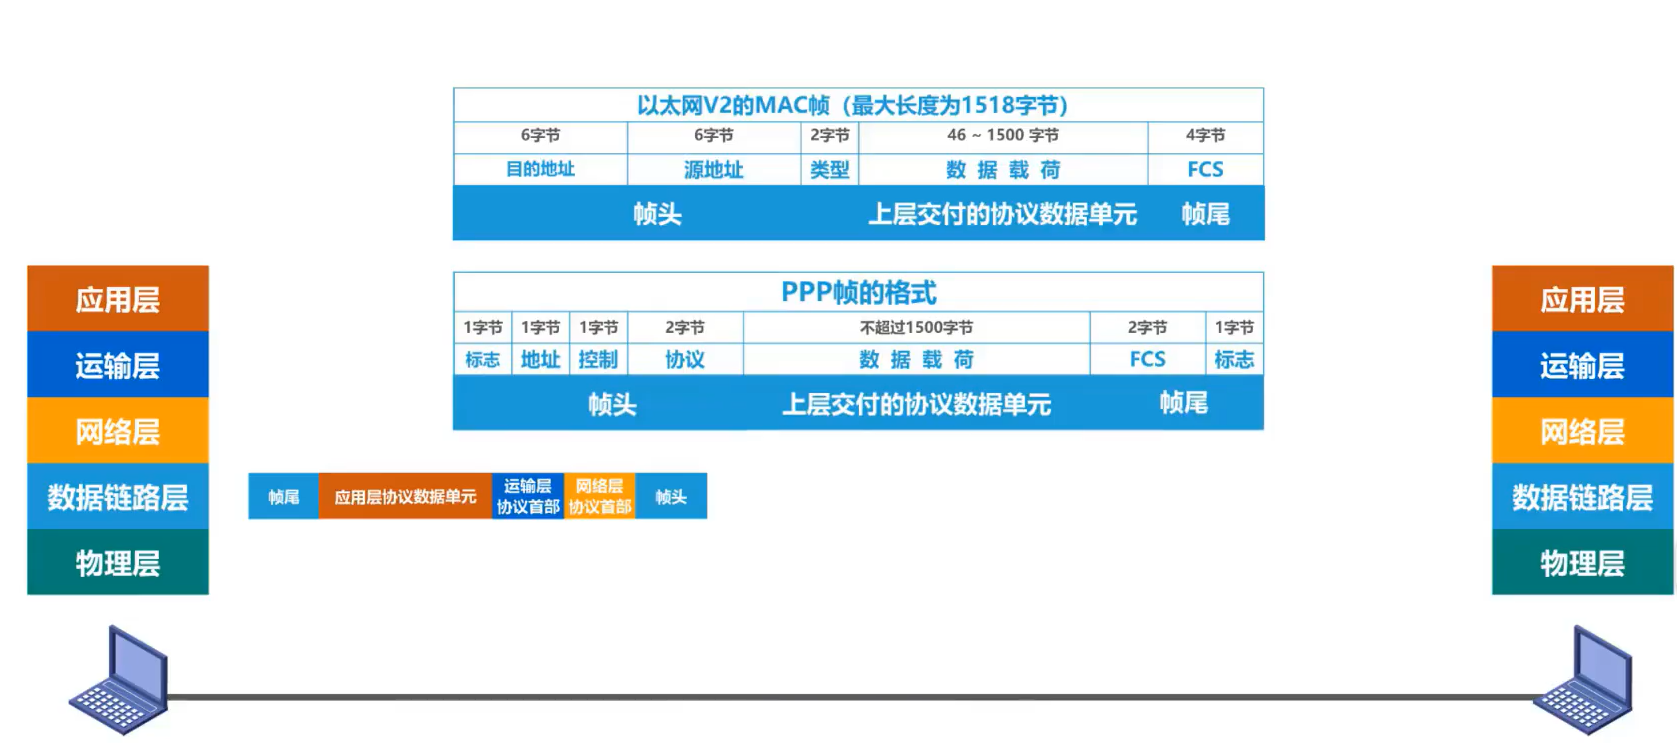
发送方的数据链路层将上层交付下来的协议数据单元封装成帧后,还要通过物理层,将构成帧的各比特,转换成电信号交给传输媒体,那么接收方的数据链路层如何从物理层交付的比特流中提取出一个个的帧?
答:需要帧头和帧尾来做帧定界。
但并不是每一种数据链路层协议的帧都包含有帧定界标志,例如,以太网的数据链路层封装好MAC帧后,物理层会再添加8字节的前导码,另外以太网还规定了帧间间隔为96比特时间,因此,MAC帧不需要帧结束定界符。
前导码
- 前同步码:作用是使接收方的时钟同步
- 帧开始定界符:表明其后面紧跟着的就是MAC帧
透明传输问题:
透明
指某一个实际存在的事物看起来却好像不存在一样。
透明传输是指数据链路层对上层交付的传输数据没有任何限制,好像数据链路层不存在一样
帧界定标志也就是个特定数据值,如果在上层交付的协议数据单元中, 恰好也包含这个特定数值,接收方就不能正确接收
所以数据链路层应该对上层交付的数据有限制,其内容不能包含帧定界符的值
解决透明传输问题:
- 面向字节的物理链路使用字节填充 (byte stuffing) 或字符填充 (character stuffing),面向比特的物理链路使用比特填充的方法实现透明传输
- 发送端的数据
- 链路层在数据中出现控制字符“SOH”或“EOT”的前面插入一个转义字符“ESC”(其十六进制编码是1B)。
- 接收端的数据链路层在将数据送往网络层之前删除插入的转义字符。
- 如果转义字符也出现在数据当中,那么应在转义字符前面插入一个转义字符 ESC。当接收端收到连续的两个转义字符时,就删除其中前面的一个。
帧的数据部分长度
为了提高帧的传输效率,应当使帧的数据部分的长度尽可能大些。
考虑到差错控制等多种因素,每一种数据链路层协议都规定了帧的数据部分的长度上限,即最大传送单元MTU(Maximum Transfer Unit).
差错检测
在一段时间内,传输错误的比特占所传输比特总数的比率称为误码率BER(Bit Error Rate)。
使用差错检测码来检测数据在传输过程中是否产生了比特差错,是数据链路层所要解决的重要问题之一。
奇偶校验
在待发送的数据后面添加1位奇偶校验位,使整个数据(包括所添加的校验位在内)中**“1”的个数为奇数(奇校验)或偶数(偶校验) **
奇偶校验只有奇数个位发生误码时,才能检测出错误。
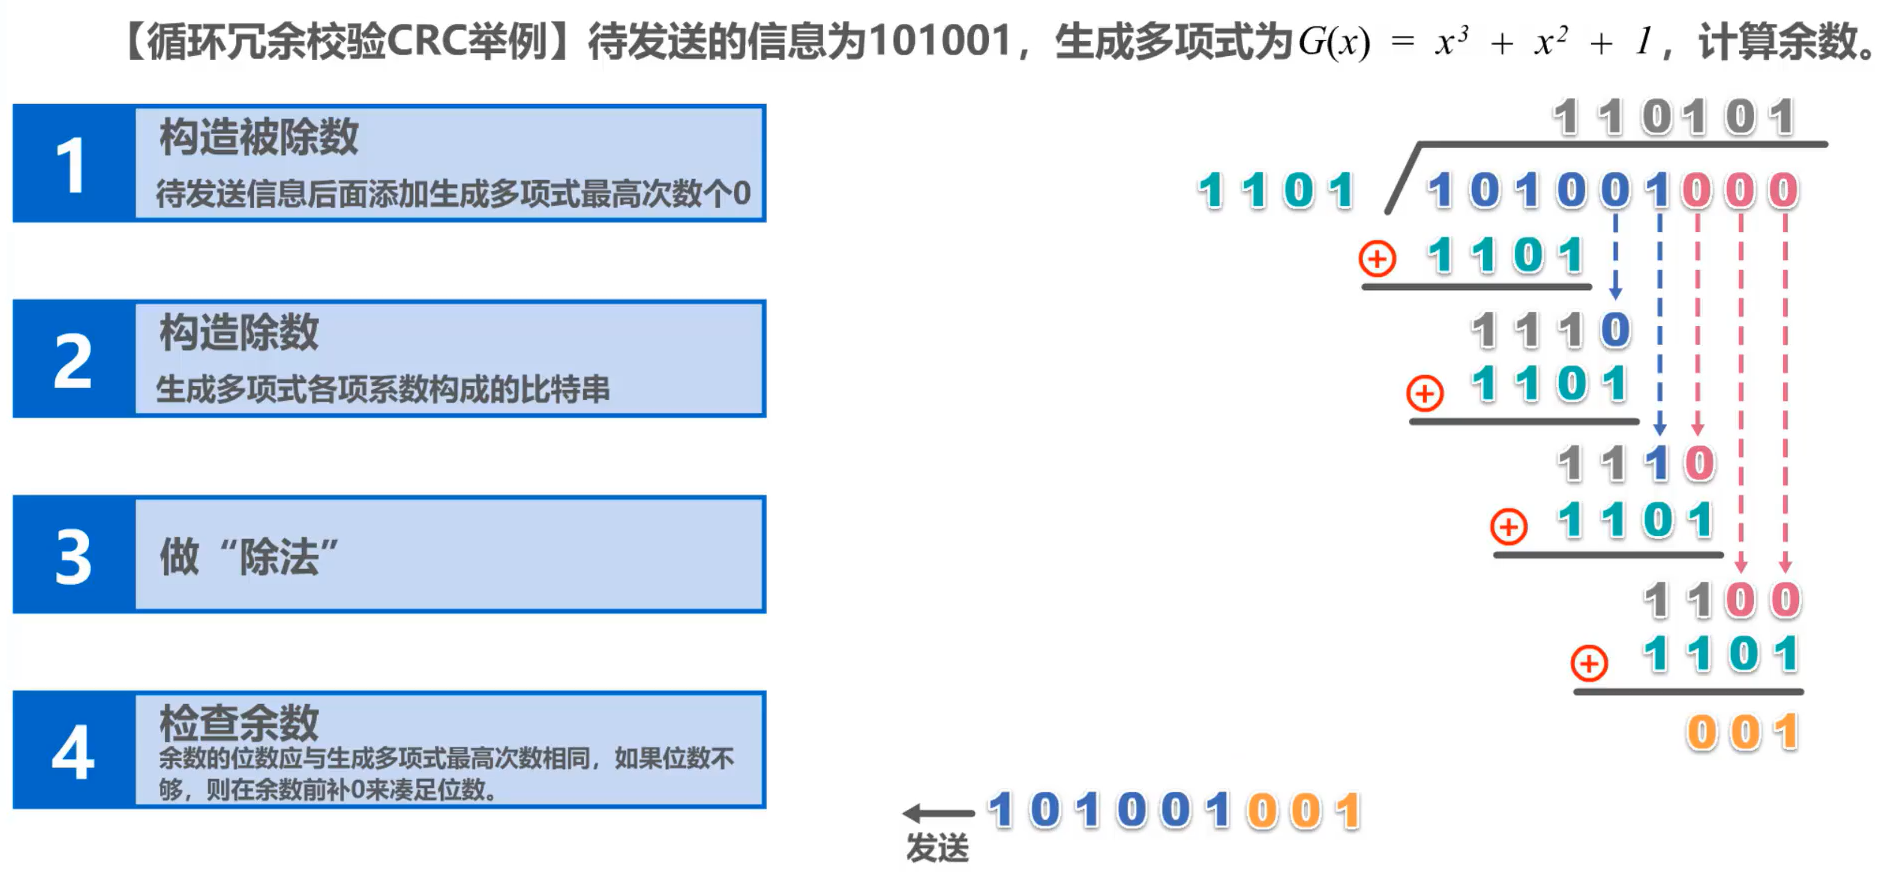
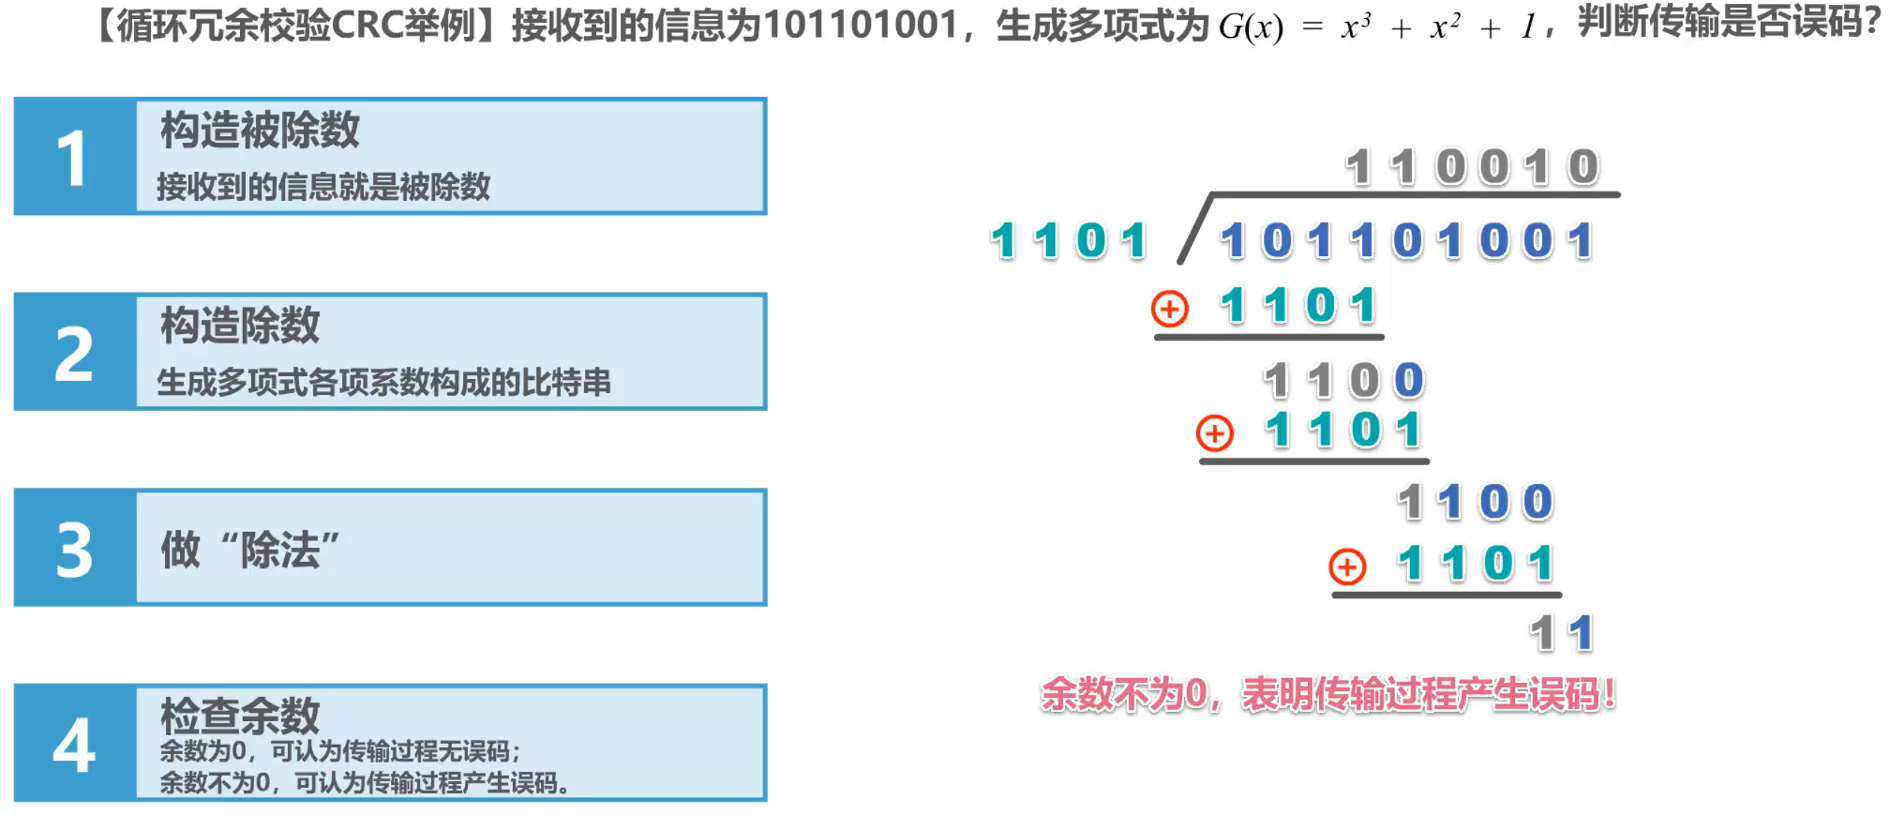
循环冗余校验CRC
(Cyclic Redundancy Check)
- 收发双方约定好一个**生成多项式G(x)**;
- 发送方基于待发送的数据和生成多项式计算出差错检测码(冗余码),将其添加到待传输数据的后面一起传输;
- 接收方通过生成多项式来计算收到的数据是否产生了误码;
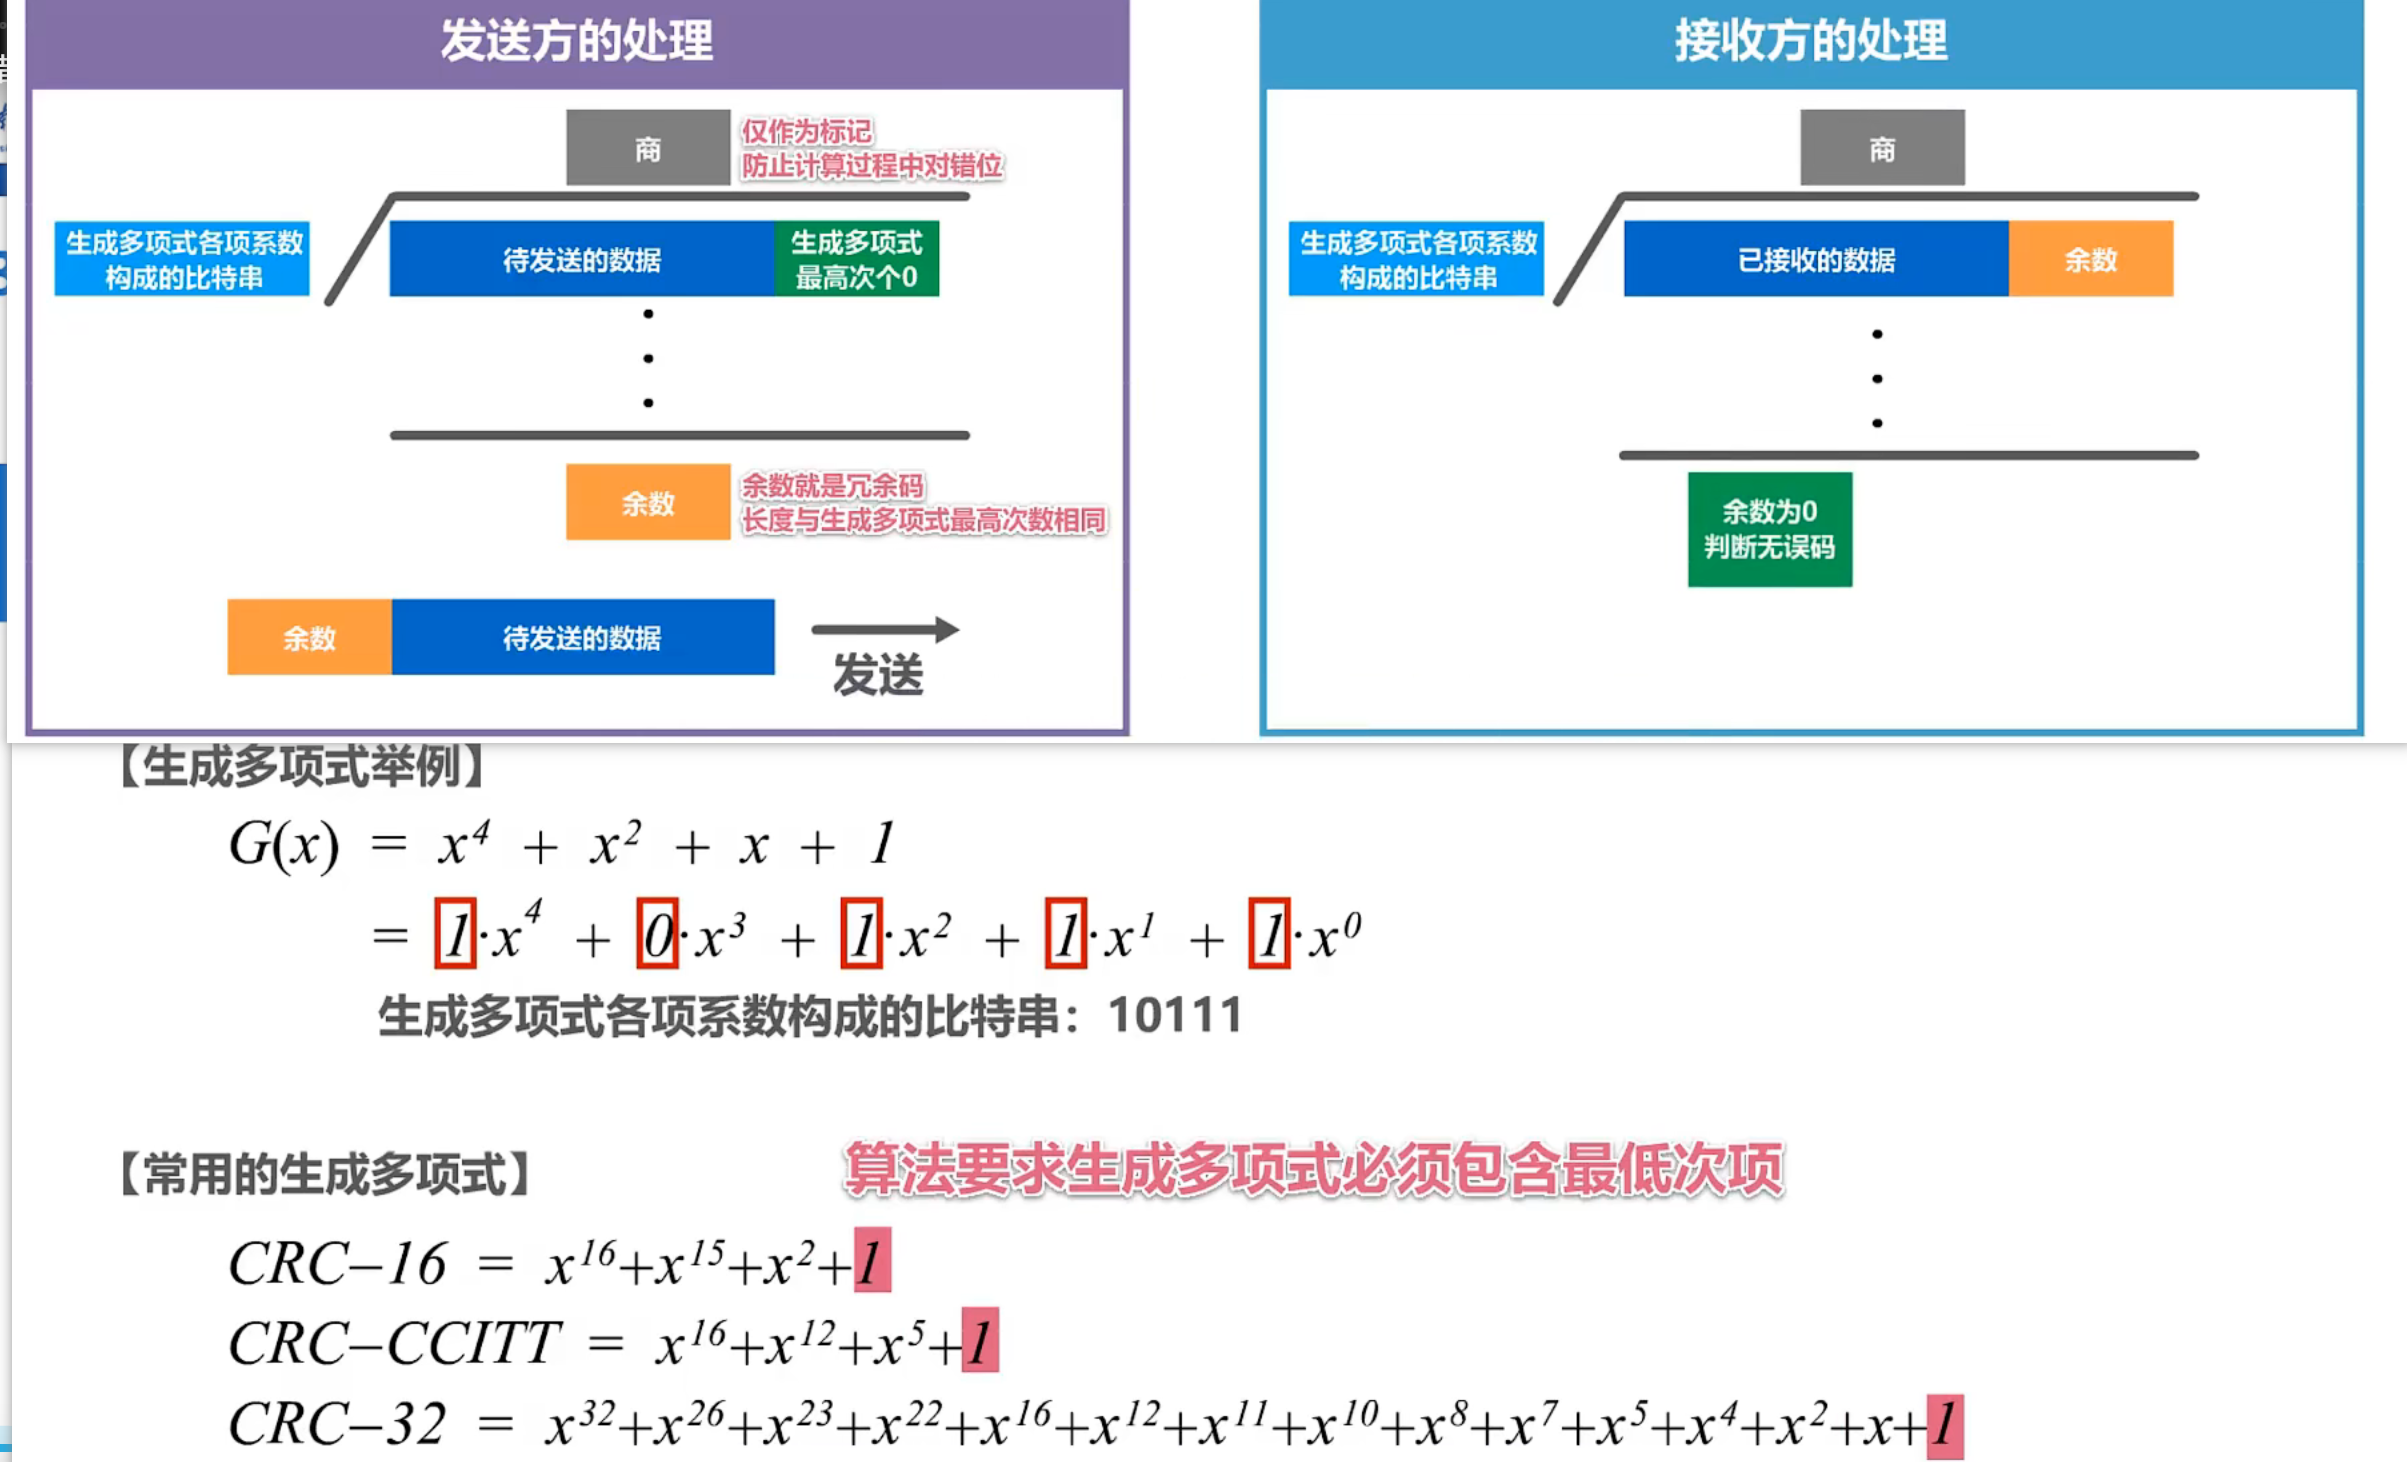
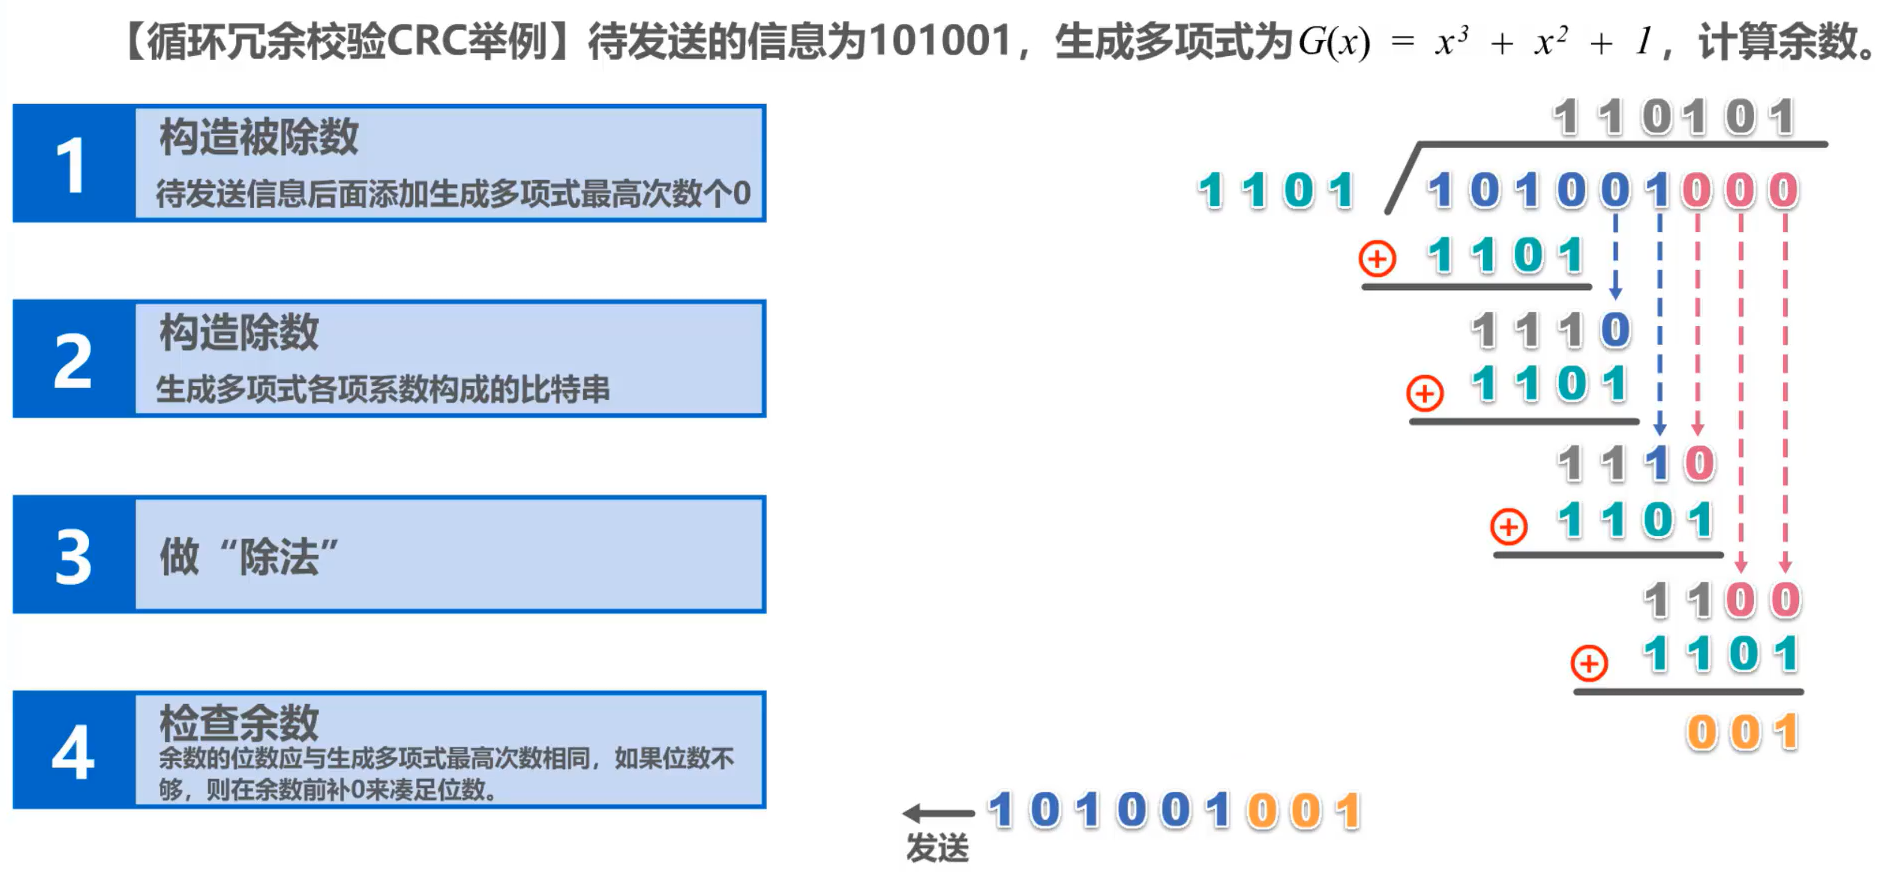
例题
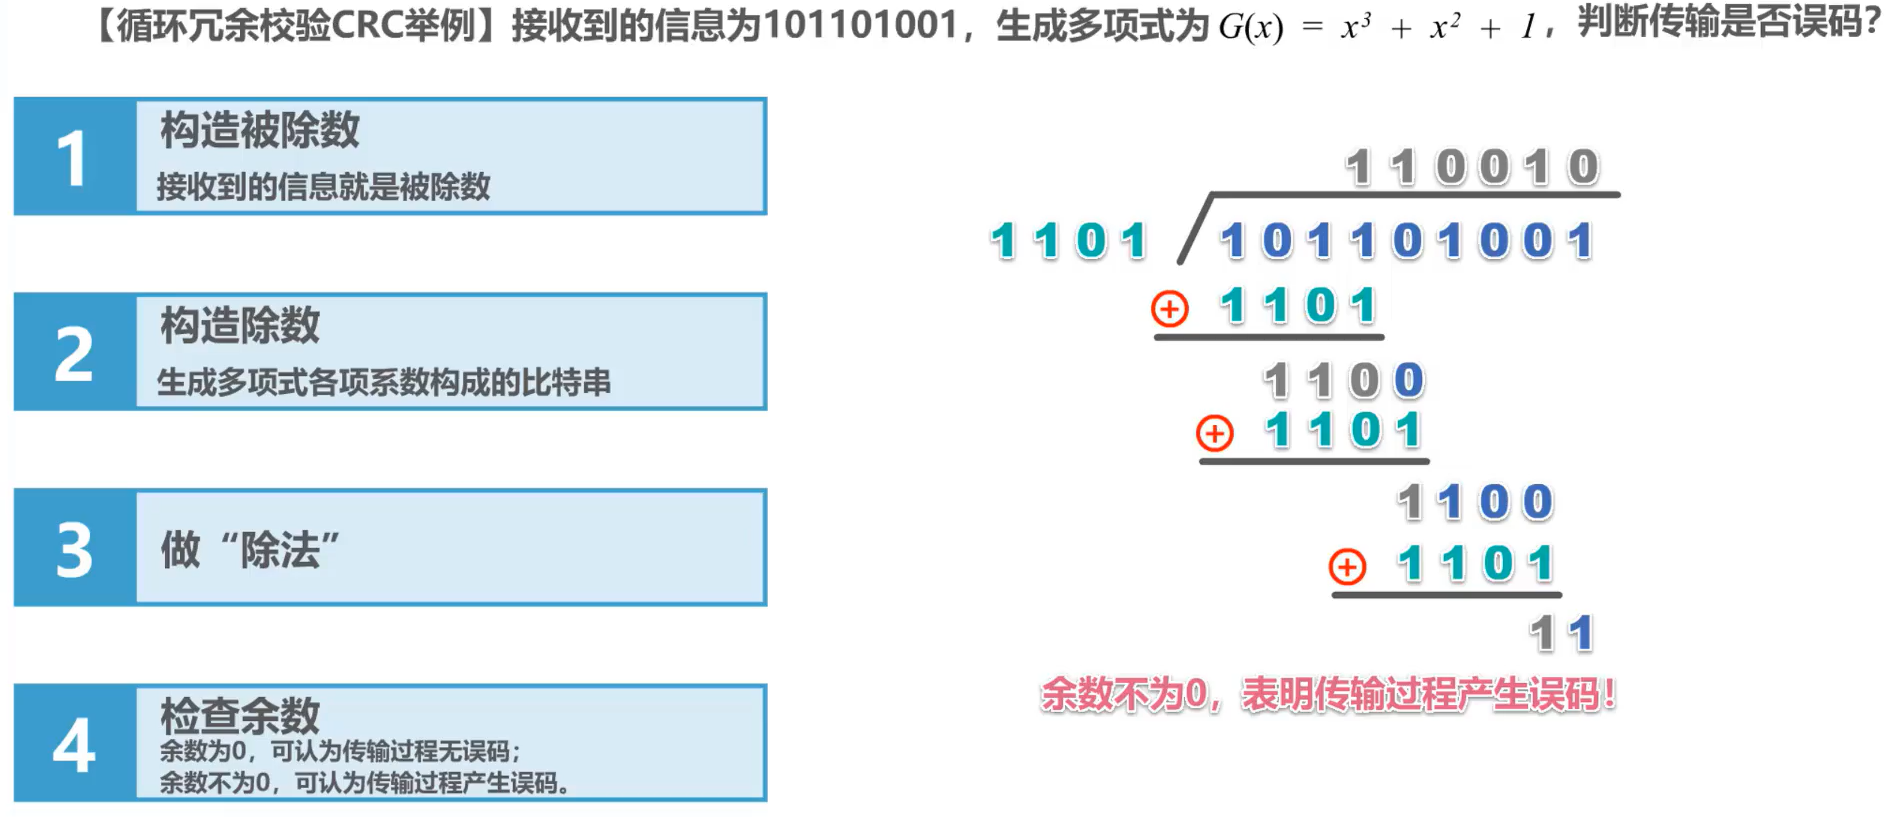
总结
- 检错码只能检测出帧在传输过程中出现了差错,但并不能定位错误,因此无法纠正错误。
- 要想纠正传输中的差错,可以使用冗余信息更多的纠错码进行前向纠错。但纠错码的开销比较大,在计算机网络中较少使用。
- 循环冗余校验CRC有很好的检错能力(漏检率非常低),虽然计算比较复杂,但非常易于用硬件实现,因此被广泛应用于数据链路层。
- 在计算机网络中通常采用 检错重传方式 来纠正传输中的差错,或者仅仅是丢弃检测到差错的帧,这取决于数据链路层向其上层提供的是可靠传输服务还是不可靠传输服务。
循环冗余校验 CRC 是一种检错方法,而帧校验序列 FCS 是添加在数据后面的冗余码
可靠传输
比特差错:
有线链路的误码率比较低,为了减小开销,并不要求数据链路层向上提供可靠传输服务。即使出现了误码,可靠传输的问题由其上层处理。
无线链路易受干扰,误码率比较高,因此要求数据链路层必须向上层提供可靠传输服务。
比特差错只是传输差错中的一种。从整个计算机网络体系结构来看,传输差错还包括分组丢失、分组失序以及分组重复。
分组丢失、分组失序以及分组重复这些传输差错,一般不会出现在数据链路层,而会出现在其上层。
- 分组丢失
路由器输入队列快满了,主动丢弃收到的分组
- 分组失序
数据并未按照发送顺序依次到达接收端
- 分组重复
由于某些原因,有些分组在网络中滞留了,没有及时到达接收端,这可能会造成发送端对该分组的重发,重发的分组到达接收端,但一段时间后,滞留在网络的分组也到达了接收端,这就造成分组重复的传输差错
可靠传输服务并不仅局限于数据链路层,其他各层均可选择实现可靠传输。
不过可靠传输的实现比较复杂,开销也比较大,是否使用可靠传输取决于应用需求。
TCP向其上层提供面向连接的可靠传输服务
UDP向其上层提供无连接、不可靠传输服务
IP向其上层提供无连接、不可靠传输服务
802.11无线局域网要求数据链路层实现可靠传输
以太网不要求数据链路层实现可靠传输
三种可靠传输:
- 停止-等待协议SW
- 回退N帧协议GBN
- 选择重传协议SR
这三种可靠传输实现机制的基本原理并不仅限于数据链路层,可以应用到计算机网络体系结构的各层协议中
停止-等待协议SW
停止-等待协议实现的四点:
确认与否认
接受方收到数据分组后,根据数据是否误码,发送确认分组ACK或NAK,发送方需要收到确认分组后才会继续发送下一个数据分组。
超时重传
如果数据中途丢失,接收方收不到数据分组,就不会发送ACK或NAK。如果不采取其他措施,发送方就会一直处于等待接收方ACK回或NAK的状态。
为解决该问题,可以在发送方发送完一个数据分组时启动一个超时计时器。若到了超时计时器所设置的重传时间而发送方仍收不到接收方的任何ACK或NAK,则重传原来的数据分组,这就叫做超时重传
一般可将重传时间选为略大于“从发送方到接收方的平均往返时间“。
确认丢失
如果ACK或NAK丢失,就会导致超时重传而发生分组重复,对于这种传输错误,必须给每个分组带上序号。
由于停止-等待协议,每发送一个数据分组就停止等待,只要保证每发送一个新的数据分组,其发送序号与上次发送的数据分组的序号不同就可以了,因此用一个比特来编号就够了。
确认迟到
如果接收方正确接受了分组,但应答的ACK迟到了,发送方未能及时收到确认分组,触发超时重传,所以接受方会再发送了一个确认分组;这两个是重复的确认分组,为了区分,确认分组也要带上序号。
数据链路层由于点对点信道往返时间固定,一般不会出现ACK迟到的情况,不用给ACK分组编号
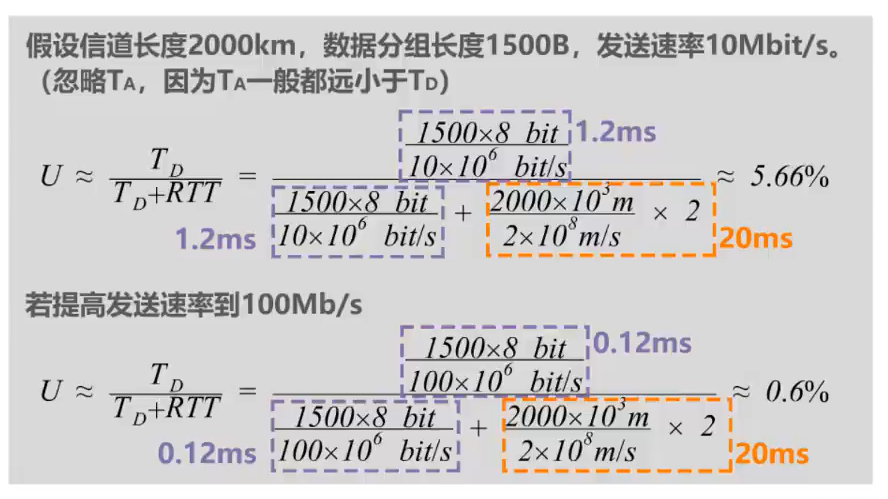
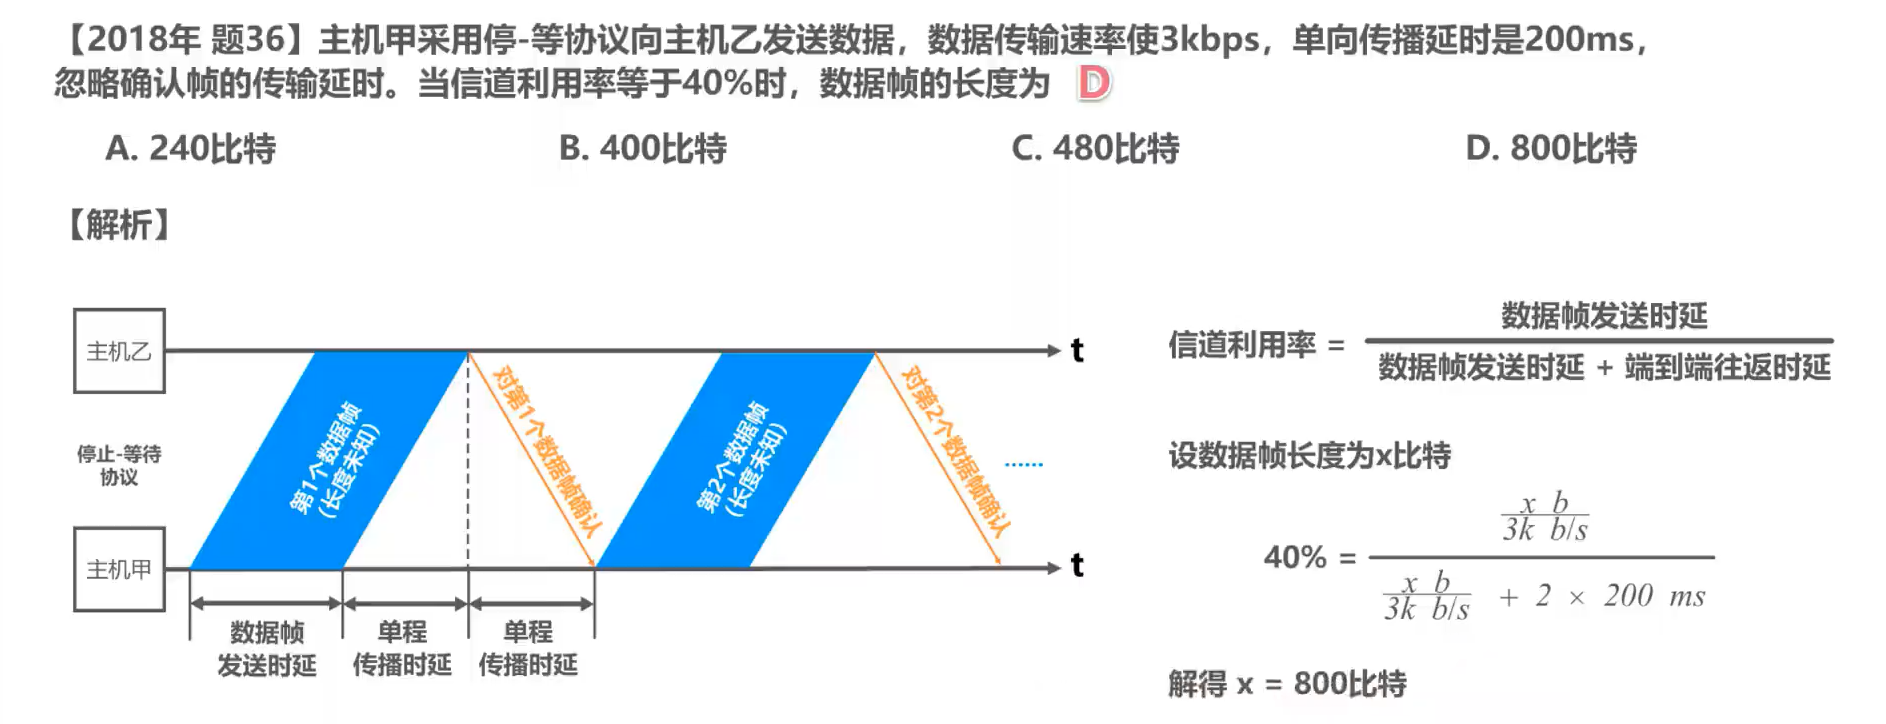
停止-等待协议的信道利用率:
假设收发双方之间是一条直通的信道
- TD:是发送方发送数据分组所耗费的发送时延
- RTT:是收发双方之间的往返时间
- TA:是接收方发送确认分组所耗费的发送时延
TA一般都远小于TD,可以忽略,当RTT远大于TD时,信道利用率会非常低
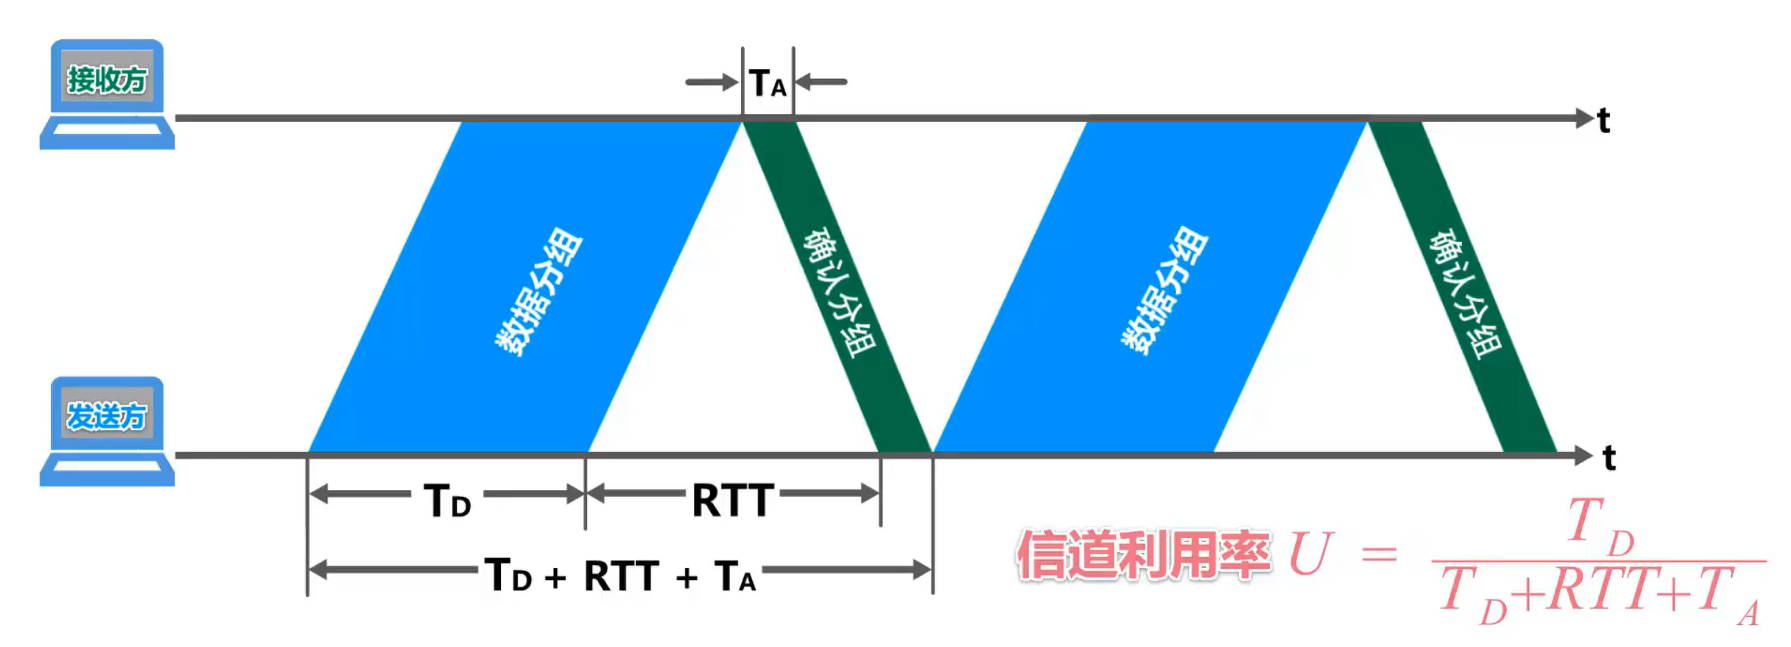
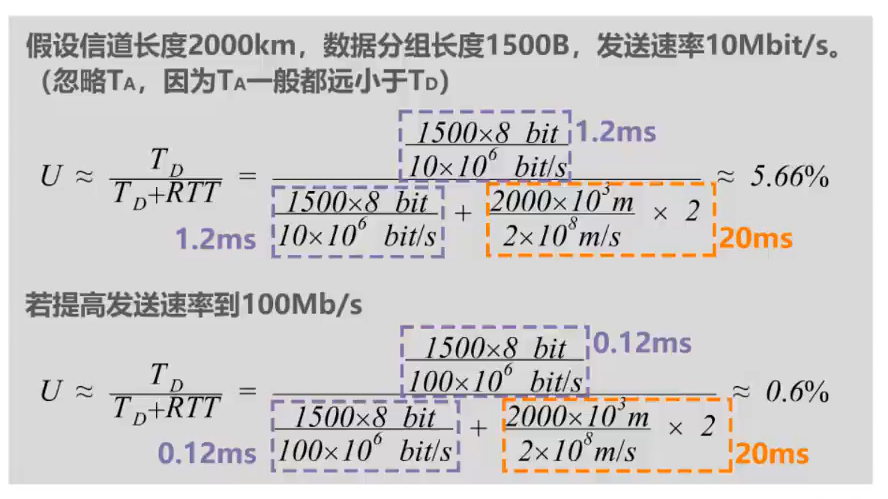
可以看出,当往返时延RTT远大于数据帧发送时延T时(例如使用卫星链路),信道利用率非常低。
- 若出现重传,则对于传送有用的数据信息来说,信道利用率还要降低。
- 为了克服停止-等待协议信道利用率很低的缺点,就产生了另外两种协议,即后退N帧协议GBN和选择重传协议SR。
像停止-等待协议这样通过确认和重传机制实现的可靠传输协议,常称为自动请求重传协议ARQ(Automatic Repeat reQuest),意思是重传的请求是自动进行,因为不需要接收方显式地 请求发送方重传某个发送的分组。
回退N帧协议GBN
为什么用回退N帧协议?
在相同的时间内,使用停止-等待协议的发送方只能发送一个数据分组,而采用流水线传输的发送方,可以发送多个数据分组。
回退N帧协议在流水线传输的基础上,利用发送窗口来限制发送方可连续发送数据分组的个数。
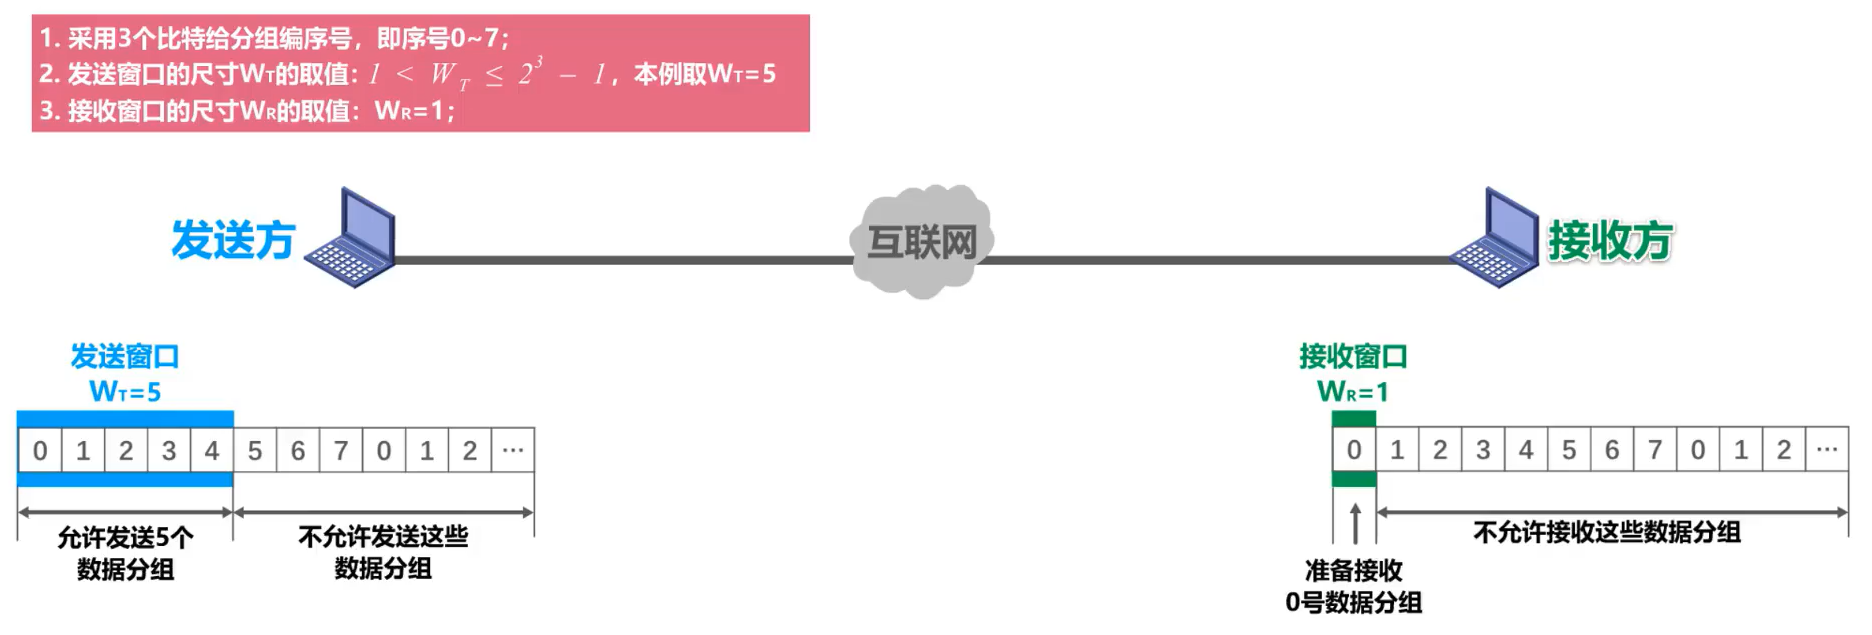
无差错情况流程:
发送方将序号落在发送窗口内的0~4号数据分组,依次连续发送出去
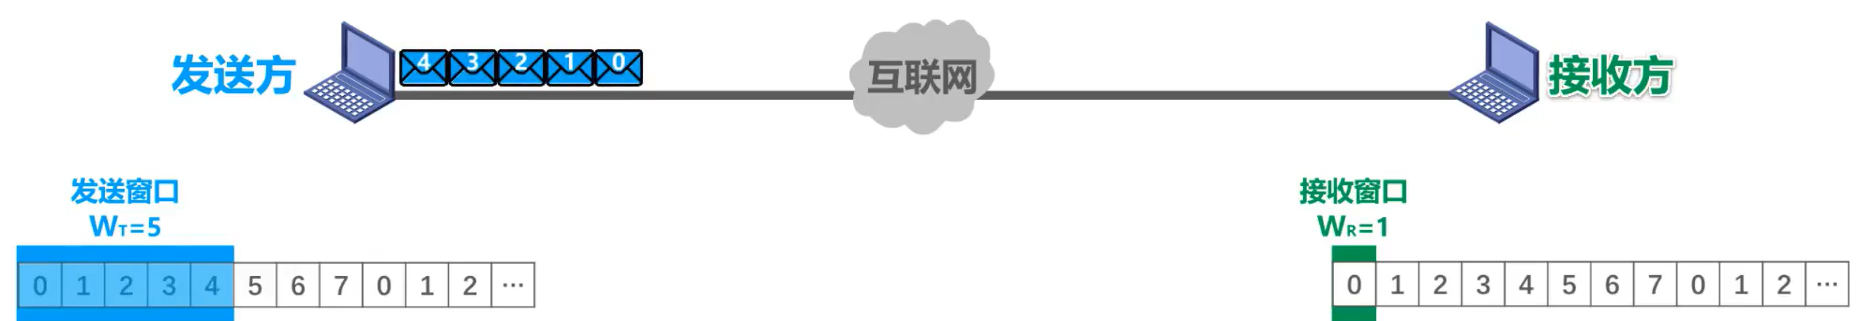
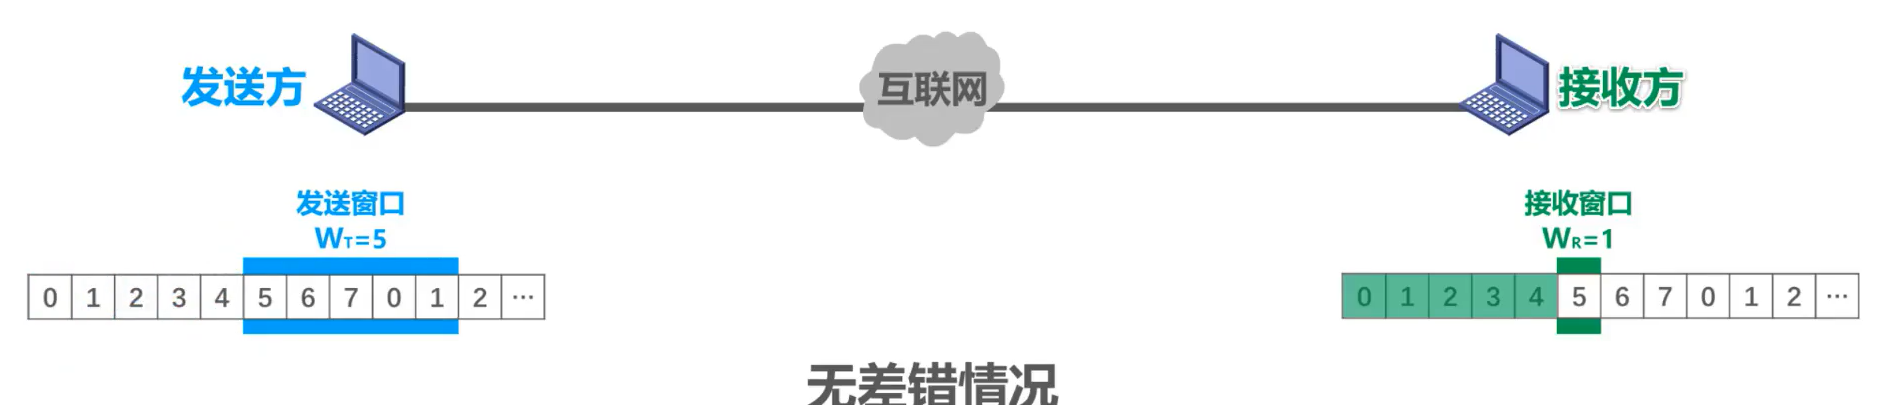
他们经过互联网传输正确到达接收方,就是没有乱序和误码,接收方按序接收它们,每接收一个,接收窗口就向前滑动一个位置,并给发送方发送针对所接收分组的确认分组,在通过互联网的传输正确到达了发送方
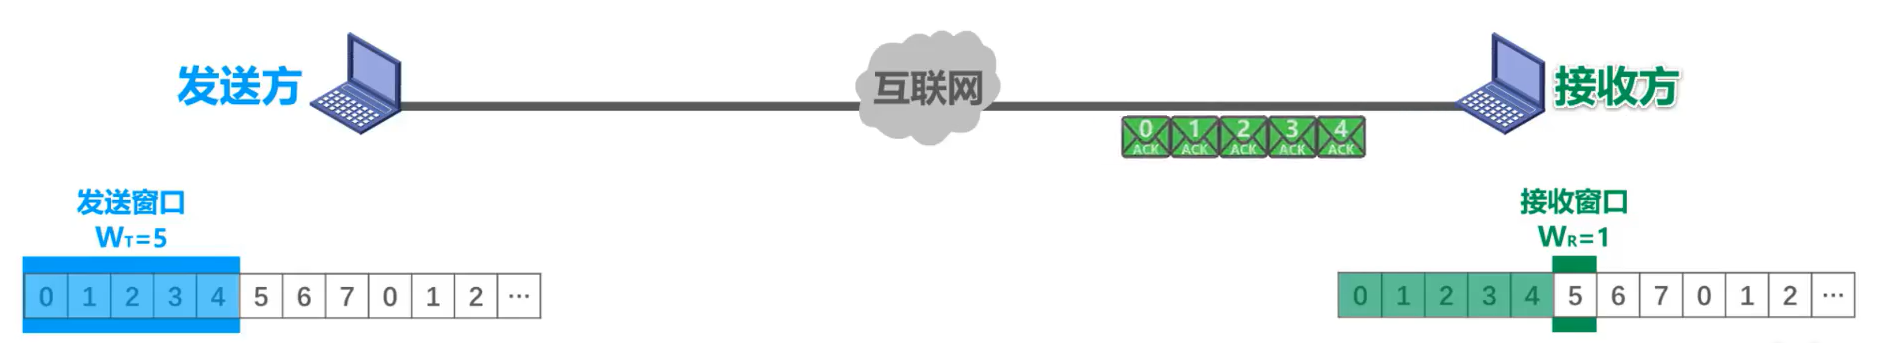
发送方每接收一个、发送窗口就向前滑动一个位置,这样就有新的序号落入发送窗口,发送方可以将收到确认的数据分组从缓存中删除了,而接收方可以择机将已接收的数据分组交付上层处理
累计确认
只对按序到达的最后一个分组发送确认分组。(ACKn表示序号n及以前的所有数据分组都正确接受)
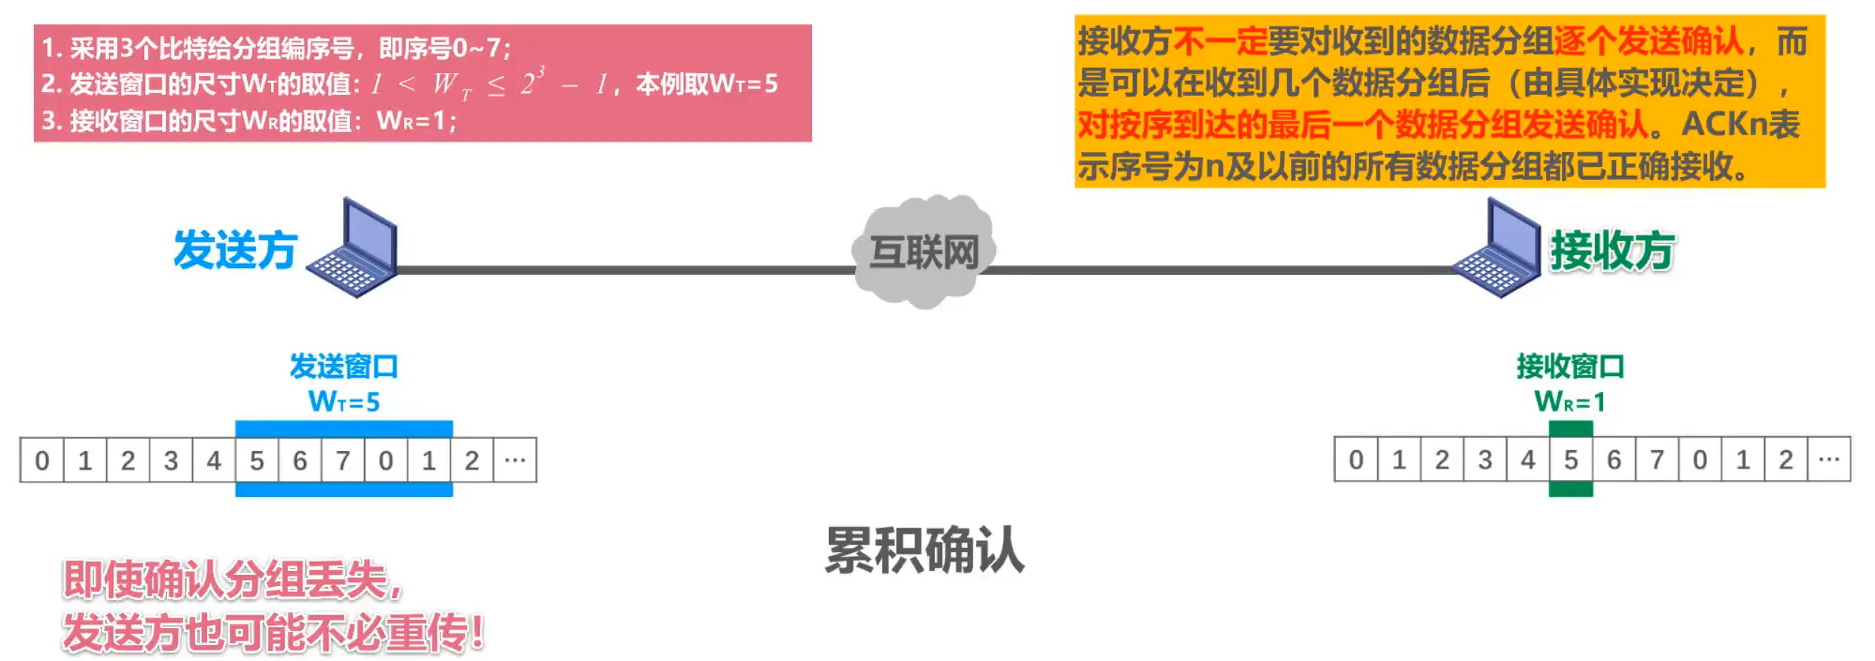
优点:
- 即使确认分组丢失,发送方也可能不必重传
- 减小接收方的开销
- 减小对网络资源的占用
缺点:
- 不能向发送方及时反映出接收方已经正确接收的数据分组信息
有差错情况
例如
在传输数据分组时,5号数据分组出现误码,接收方通过数据分组中的检错码发现了错误
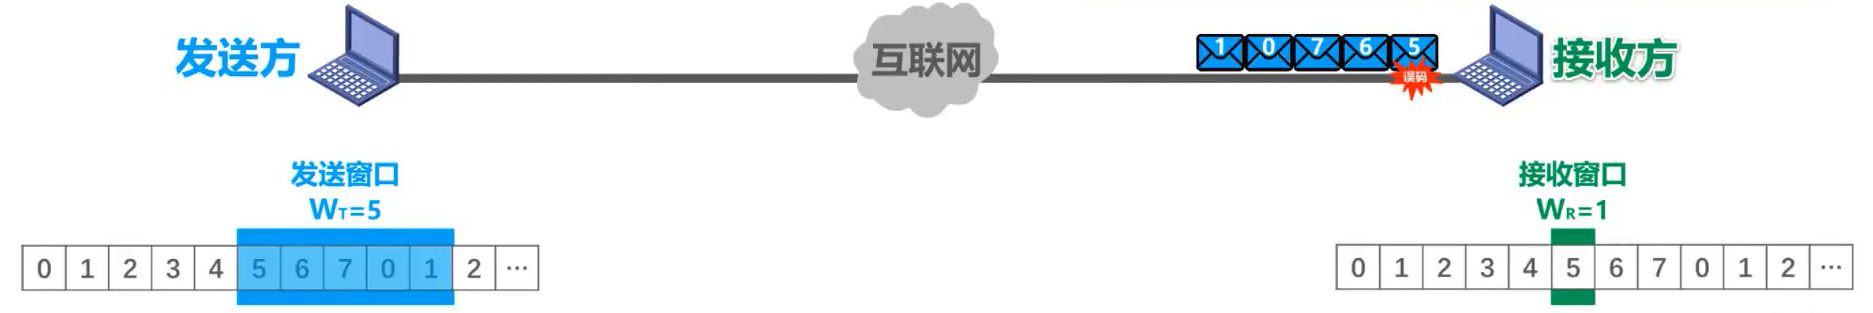
于是丢弃该分组,而后续到达的这剩下四个分组与接收窗口的序号不匹配
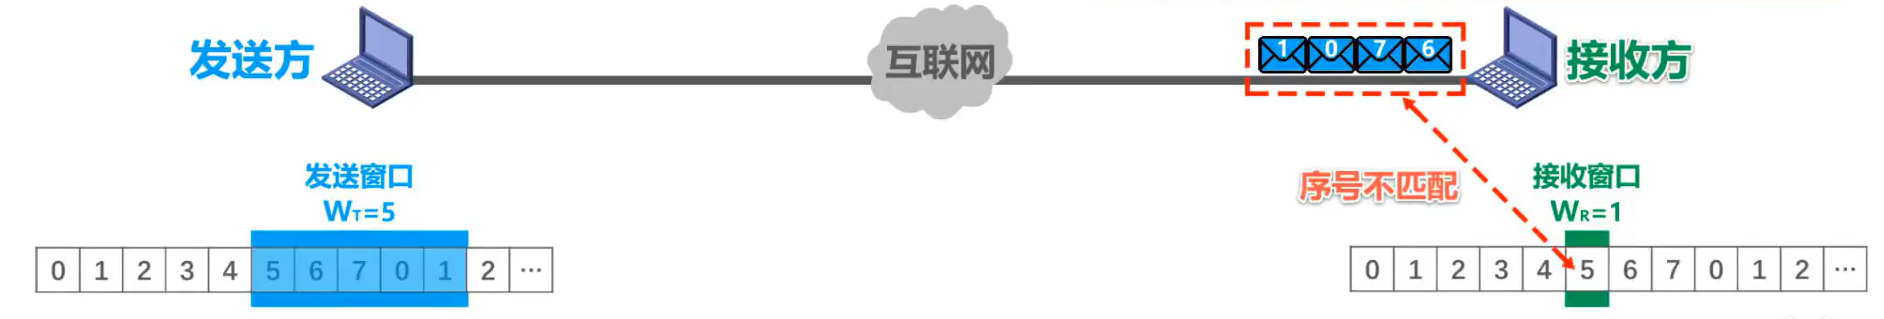
接收同样也不能接收它们,讲它们丢弃,并对之前按序接收的最后一个数据分组进行确认,发送ACK4,每丢弃一个数据分组,就发送一个ACK4
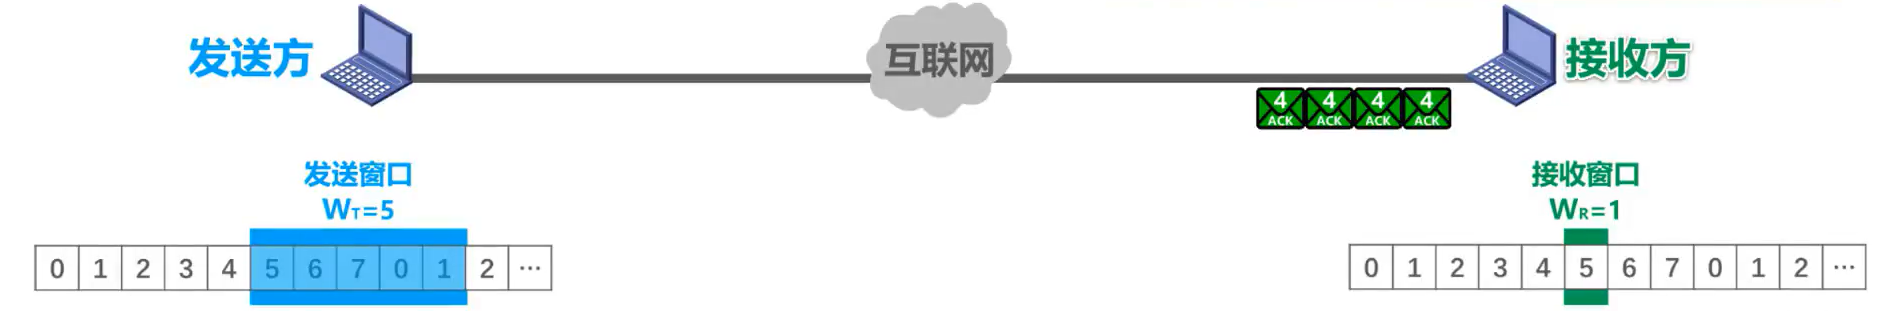
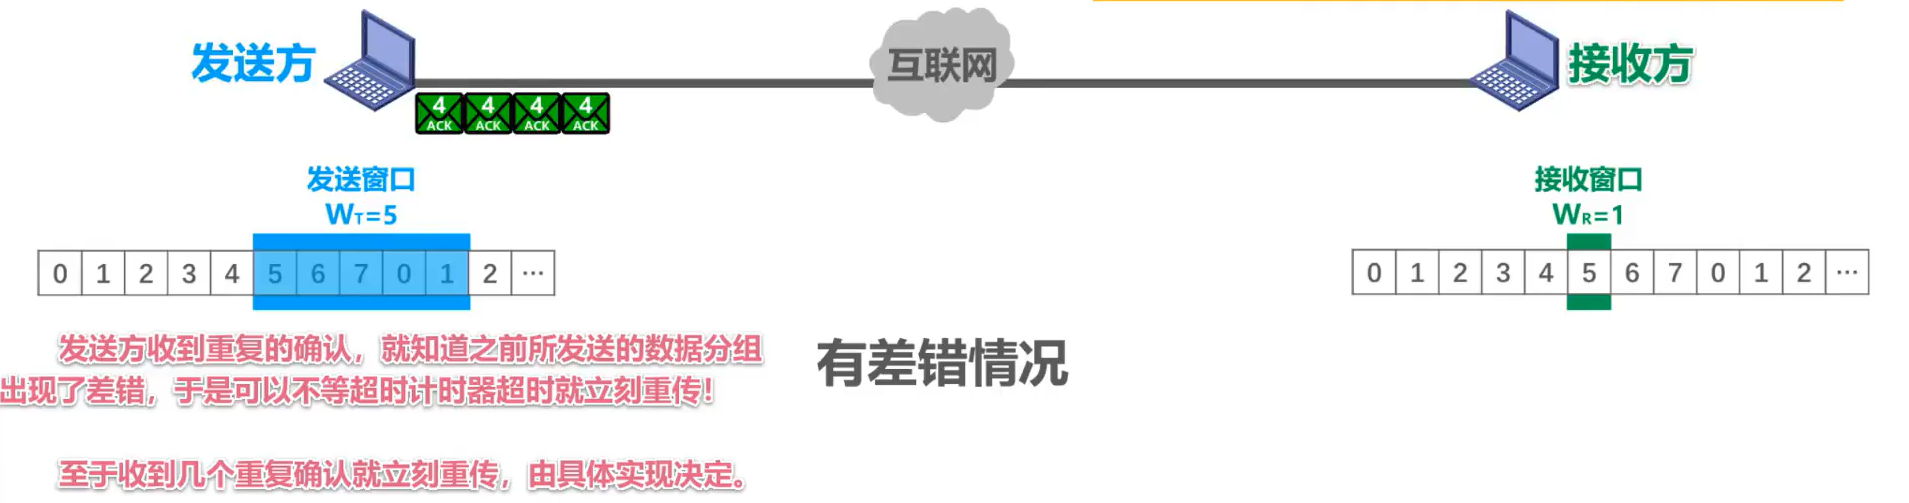
当收到重复的ACK4 时,就知道之前所发送的数据分组出现了差错,于是可以不等超时计时器超时就立刻开始重传,具体收到几个重复确认就立刻重传,根据具体实现决定
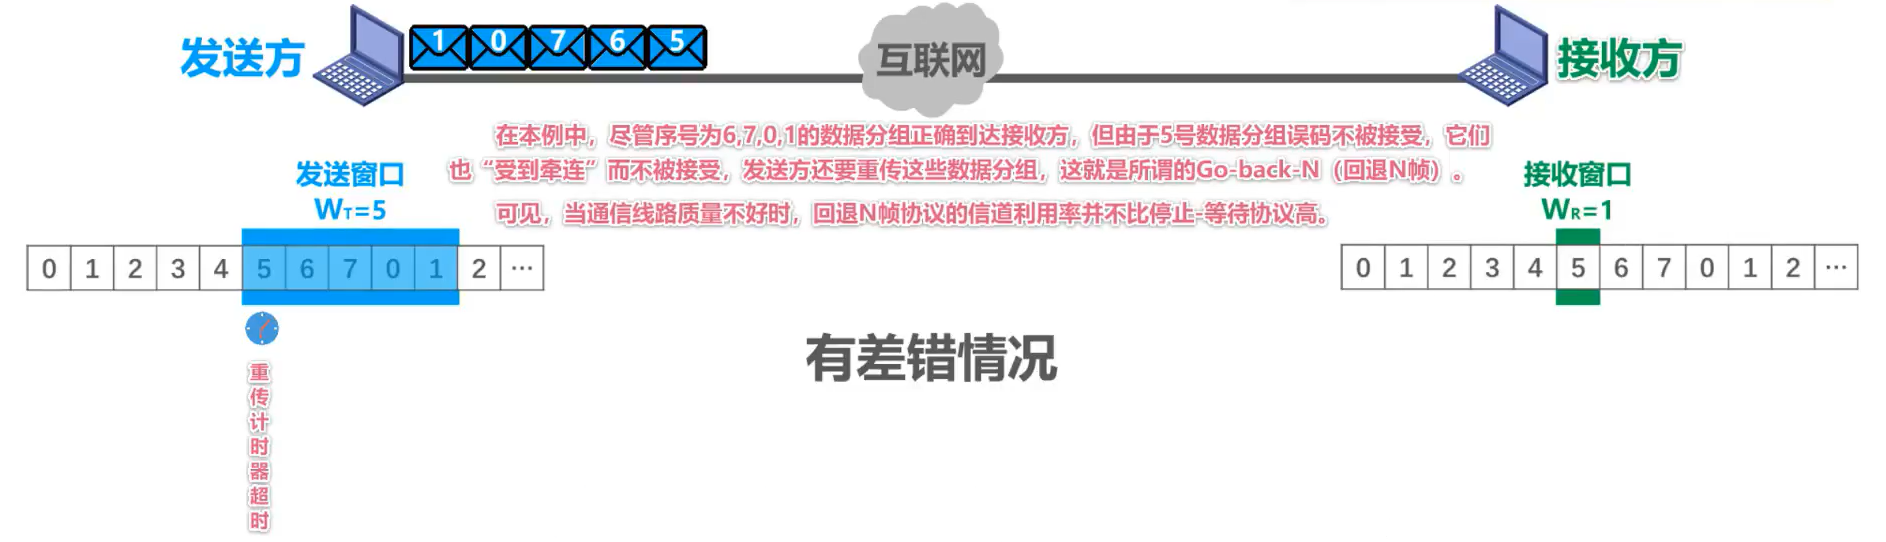
因为5号被丢弃,后续同时到达的几个也会被牵连,同样需要重传。
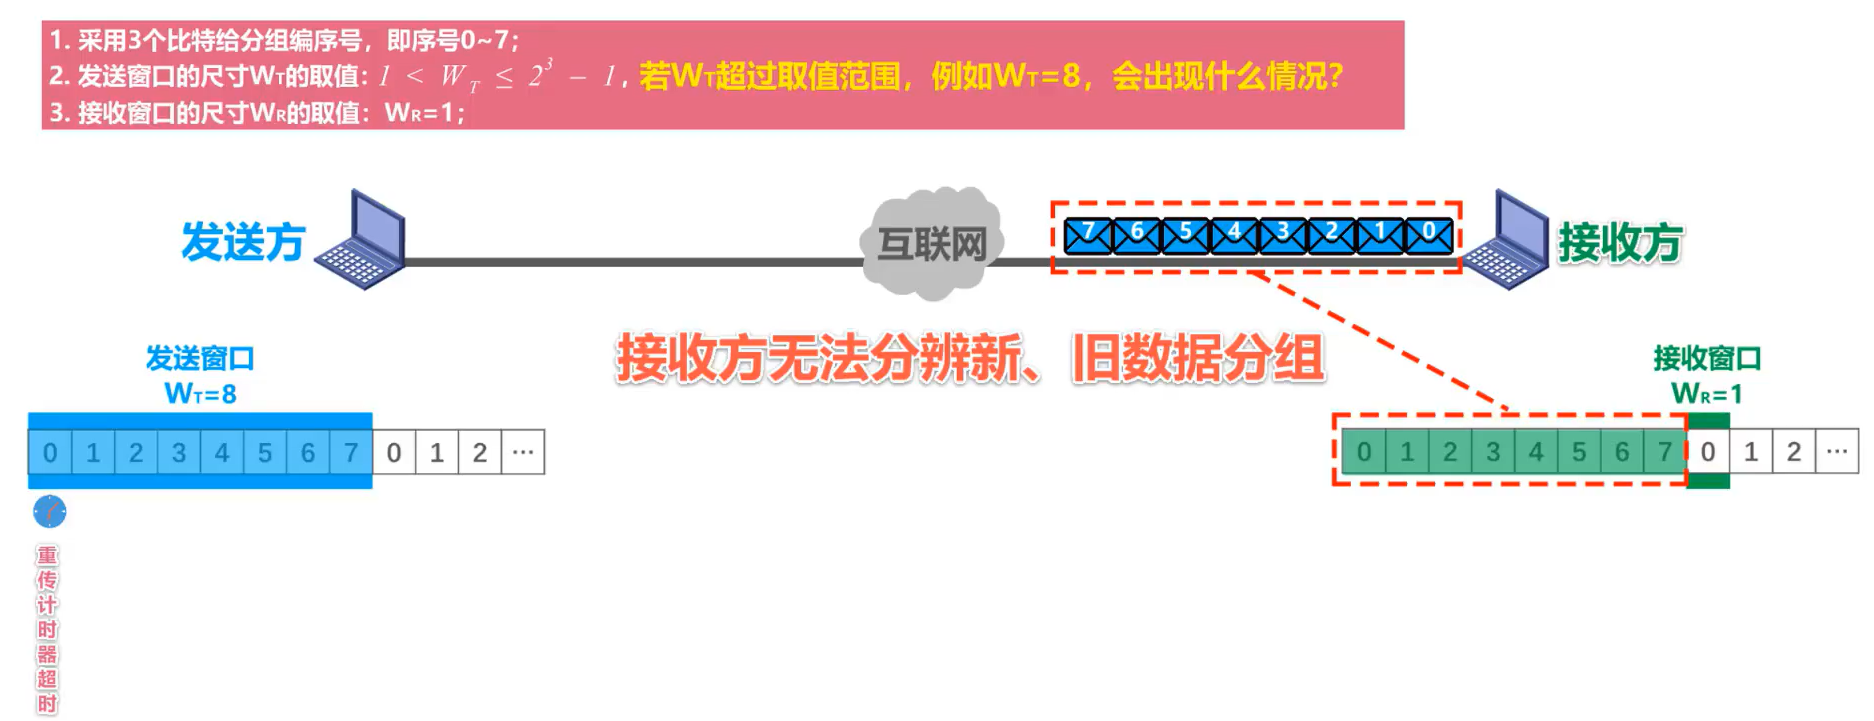
若WT超过取值范围,例如WT=8,会出现什么情况?
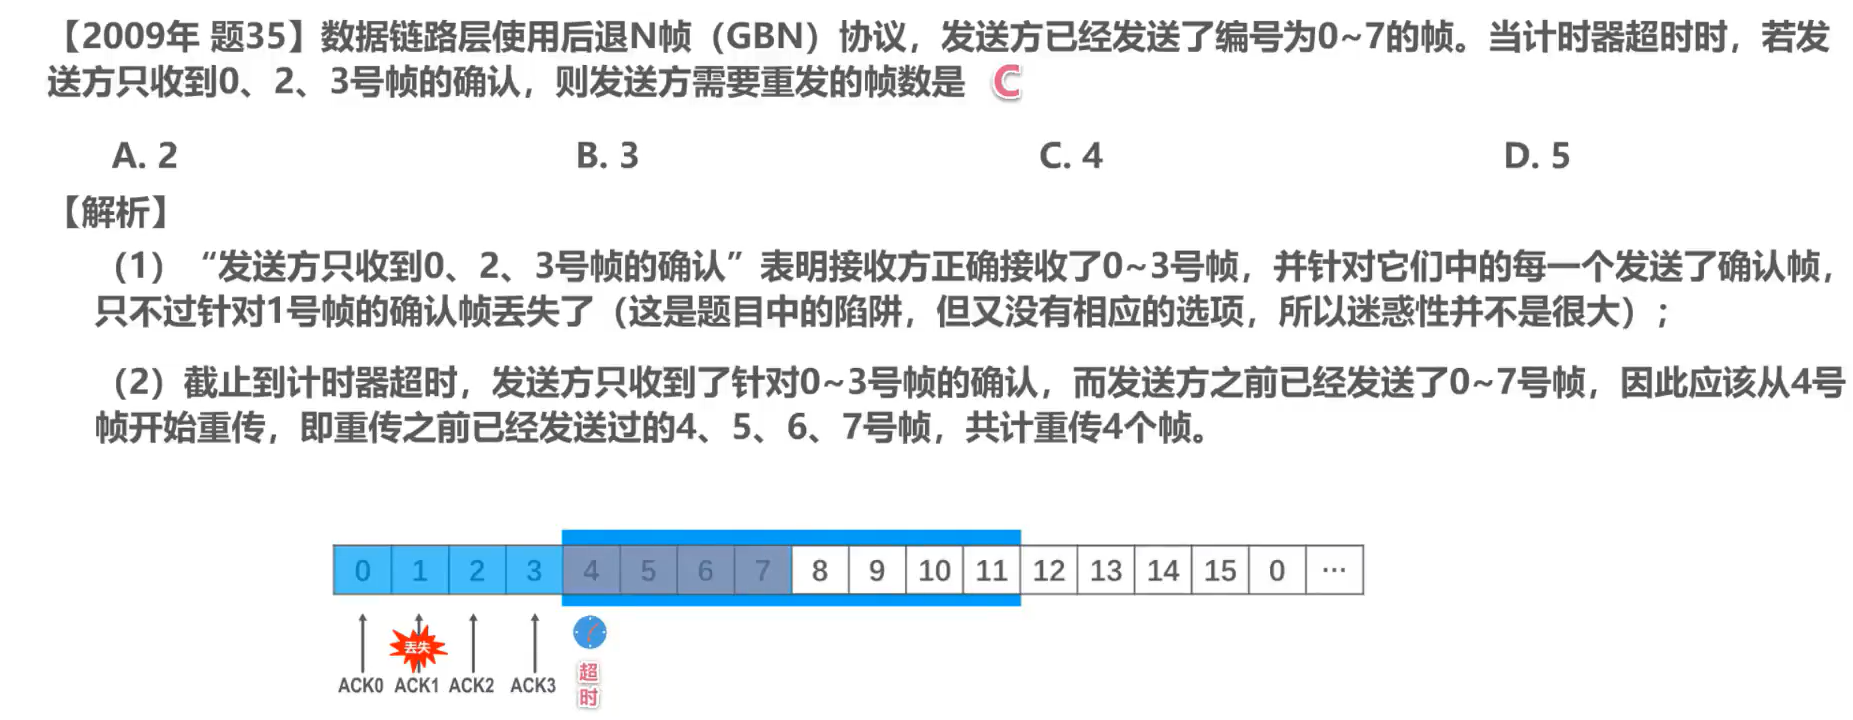
习题
总结
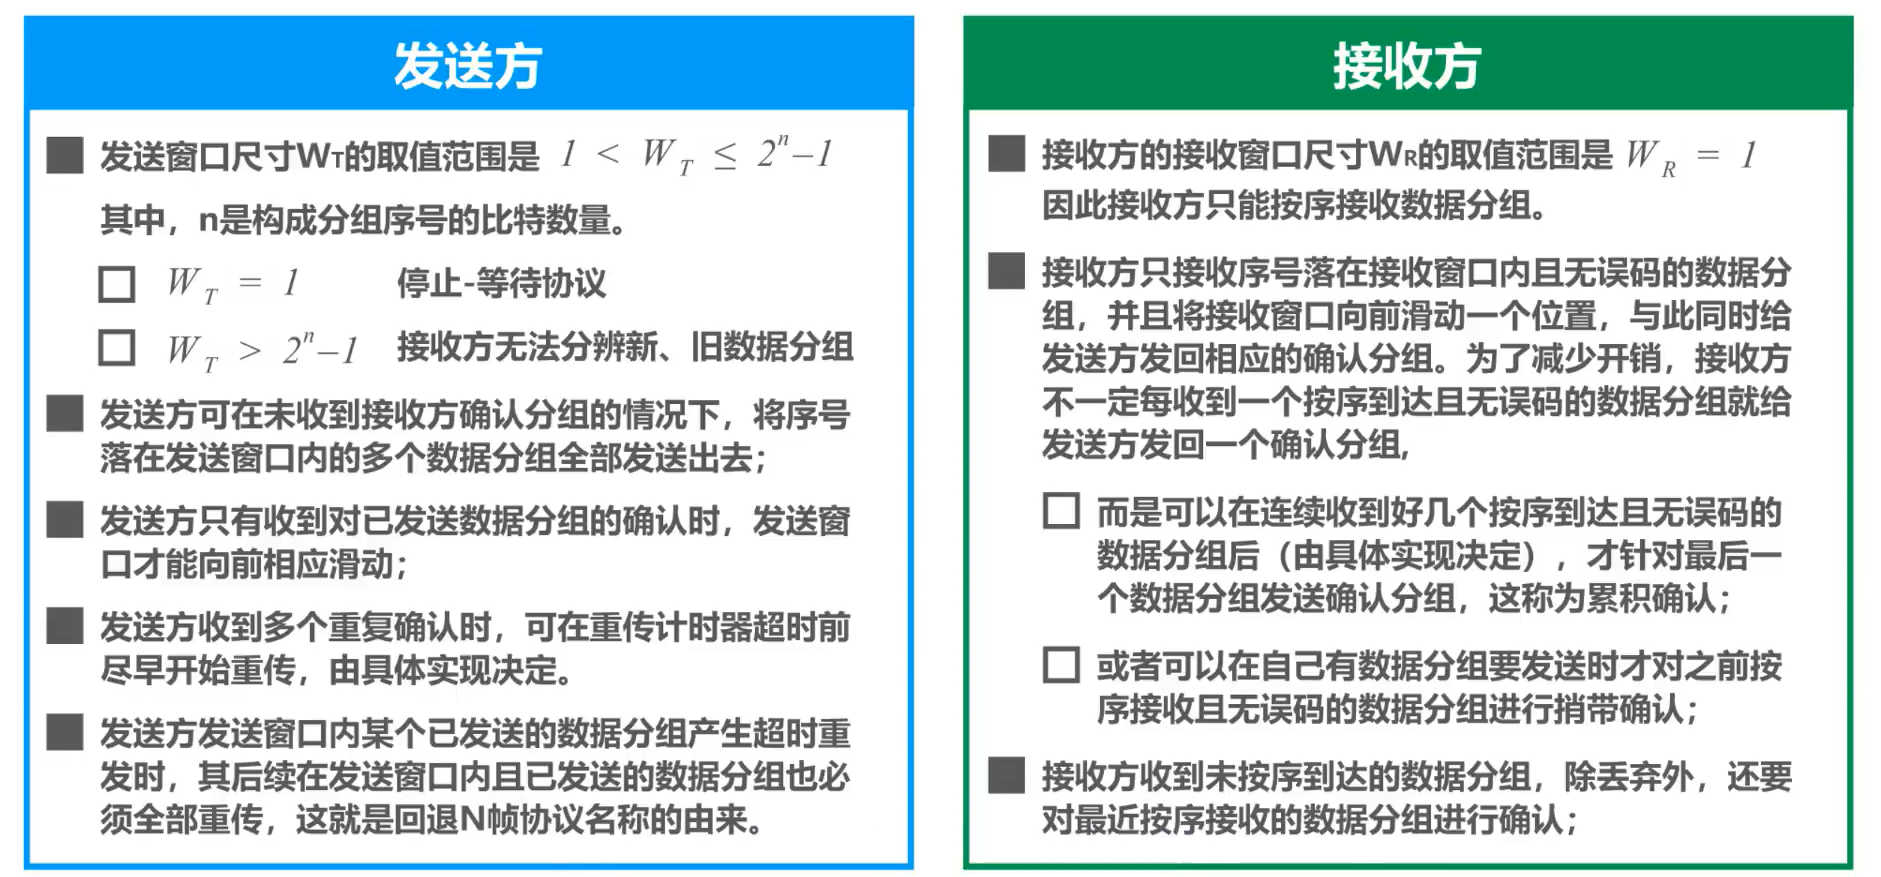
- 回退N帧协议在流水线传输的基础上利用发送窗口来限制发送方连续发送数据分组的数量,是一种连续ARQ协议
- 在协议的工作过程中发送窗口和接收窗口不断向前滑动,因此这类协议又称为滑动窗口协议
- 由于回退N帧协议的特性,当通信线路质量不好时,其信道利用率并不比停止-等待协议高
选择重传协议SR
回退N帧协议 存在的问题:
回退N帧协议的接收窗口尺寸W只能等于1,因此接收方只能按序接收正确到达的数据分组。
一个数据分组的误码就会导致其后续多个数据分组不能被接收方按序接收而丢弃(尽管它们无乱序和误码)。这必然会造成发送方对这些数据分组的超时重传,显然这是对通信资源的极大浪费。
选择重传协议:
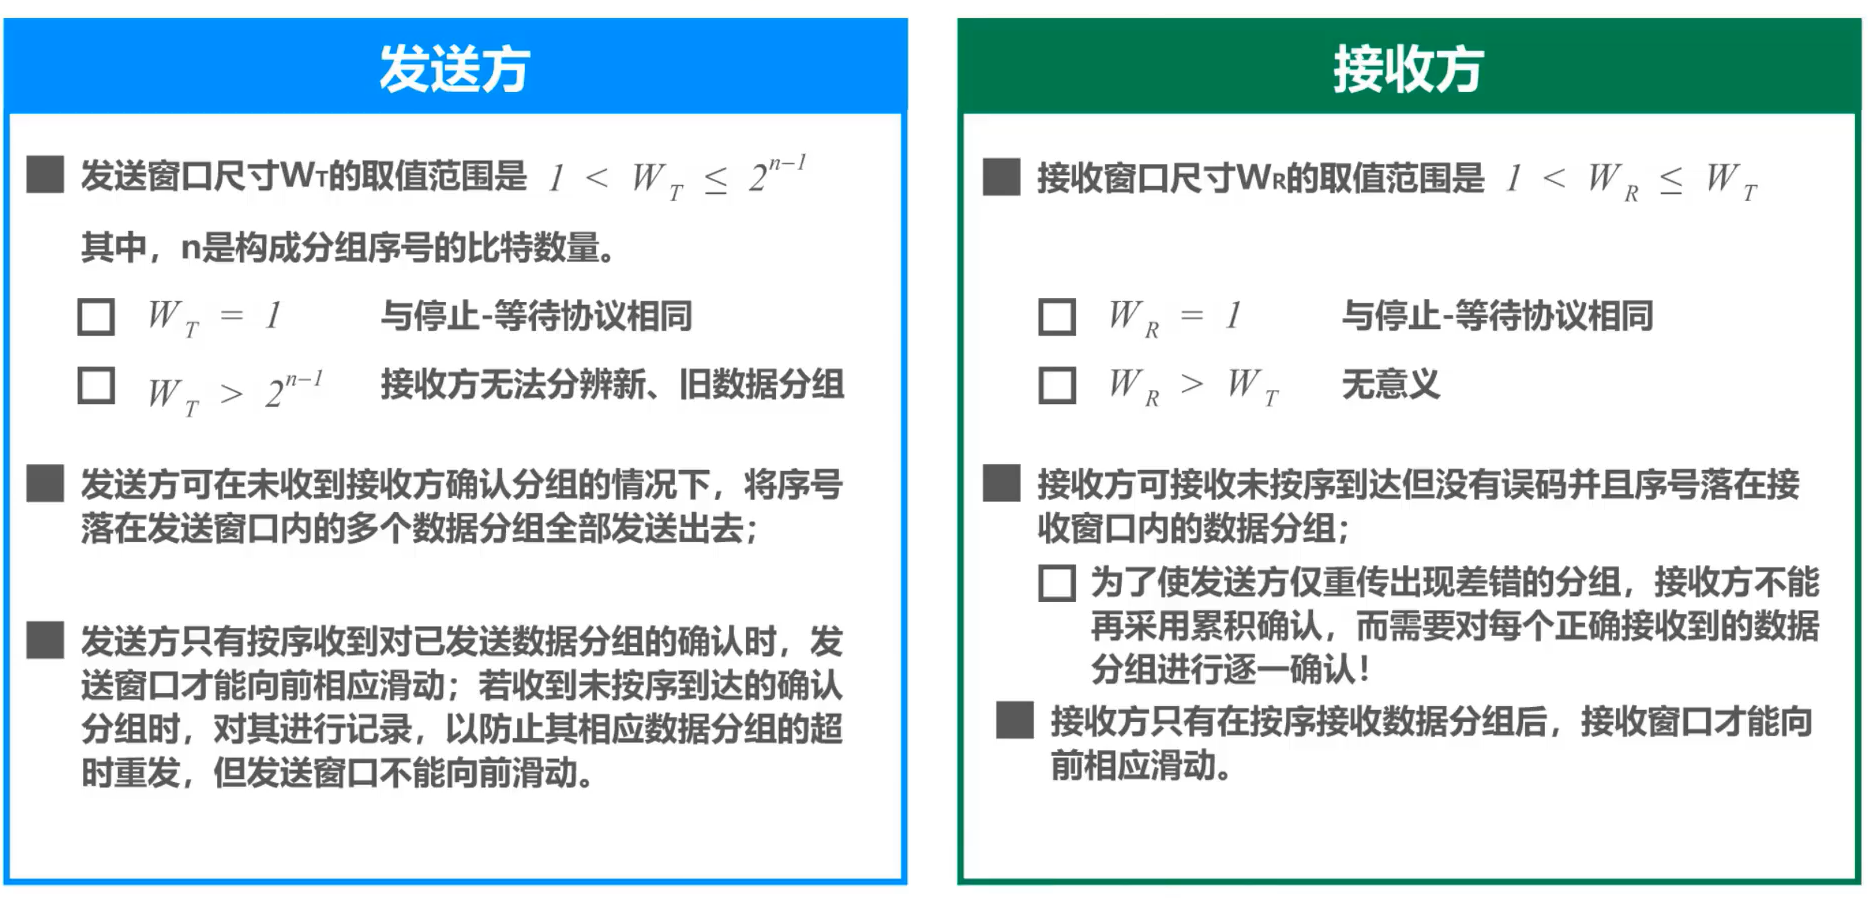
为了进一步提高性能,只重传出现误码的数据分组。因此,接收窗口的尺寸W不应再等于1(而应大于1),以便接收方先收下失序到达但无误码并且序号落在接收窗口内的那些数据分组,等到所缺分组收齐后再一并送交上层。
注:为了使发送方仅重传出错的分组,接收方不能再使用累计确认了。
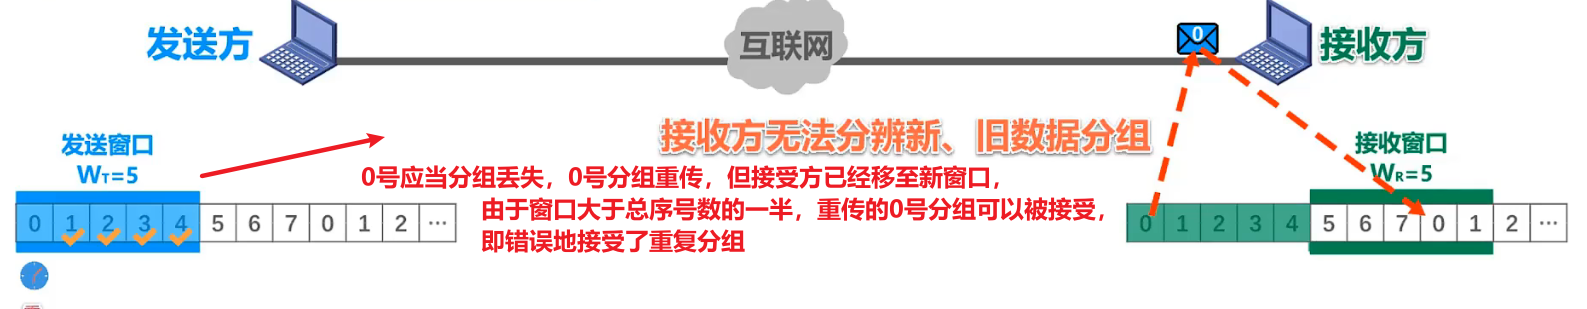
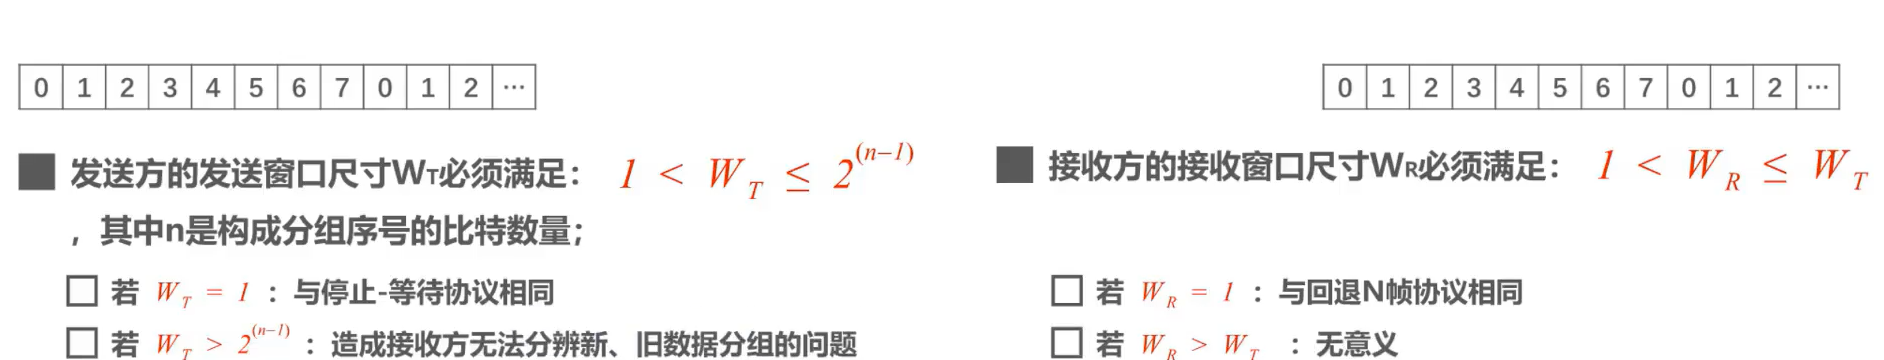
发送窗口大小:大于1,小于等于 2^n-1^(即一半)
接受窗口大小:大于1,小于等于发送窗口
因为可以接受失序分组,所以前后两个窗口不应该有重复的序号位,否则,如果重传了上个窗口某个序号的分组,而接收方新的下一个窗口也有这个序号位置,就会错误接受重复分组。
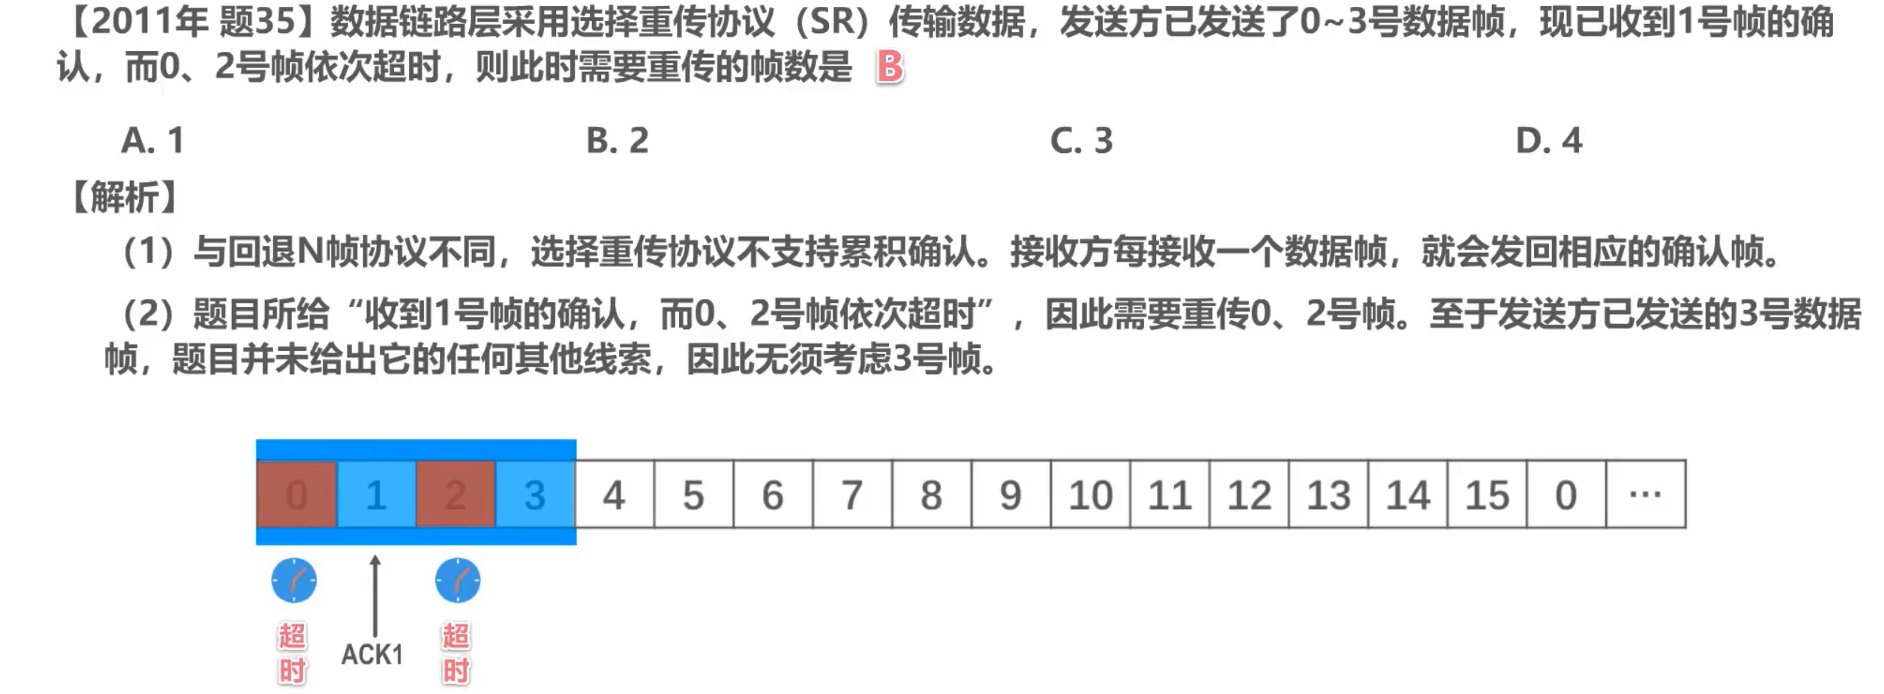
习题
总结
点对点协议PPP
用户计算机只有获取到ISP所分配的合法IP地址后,才能称为因特网上的主机。
而用户计算机与ISP通信时,使用的数据链路层协议通常都是PPP协议。
PPP协议也广泛应用于广域路由器之间的专用线路。
点对点协议PPP(Point-to-Point Protocol)是目前使用最广泛的点对点数据链路层协议
是数据链路层使用的一种协议,它的特点是:
- 简单;
- 只检测差错,而不是纠正差错;
- 不使用序号,也不进行流量控制;
- 可同时支持多种网络层协议
PPPoE 是为宽带上网的主机使用的链路层协议
PPP协议在点对点链路传输各种数据报提供了标准方法,其由三部分组成:
- 对各种协议数据报的封装方法(封装成帧)
- 链路控制协议LCP,用于建立,配置以及测试数据链路层的链接;
- 一套网络控制协议NCPs,其中的每一种协议支持不同的网络层协议。
PPP协议是因特网工程任务组IEIF在1992年制定的。经过1993年和1994年的修订,现在的PPP协议已成为因特网的正式标准[RFC1661,RFC1662]
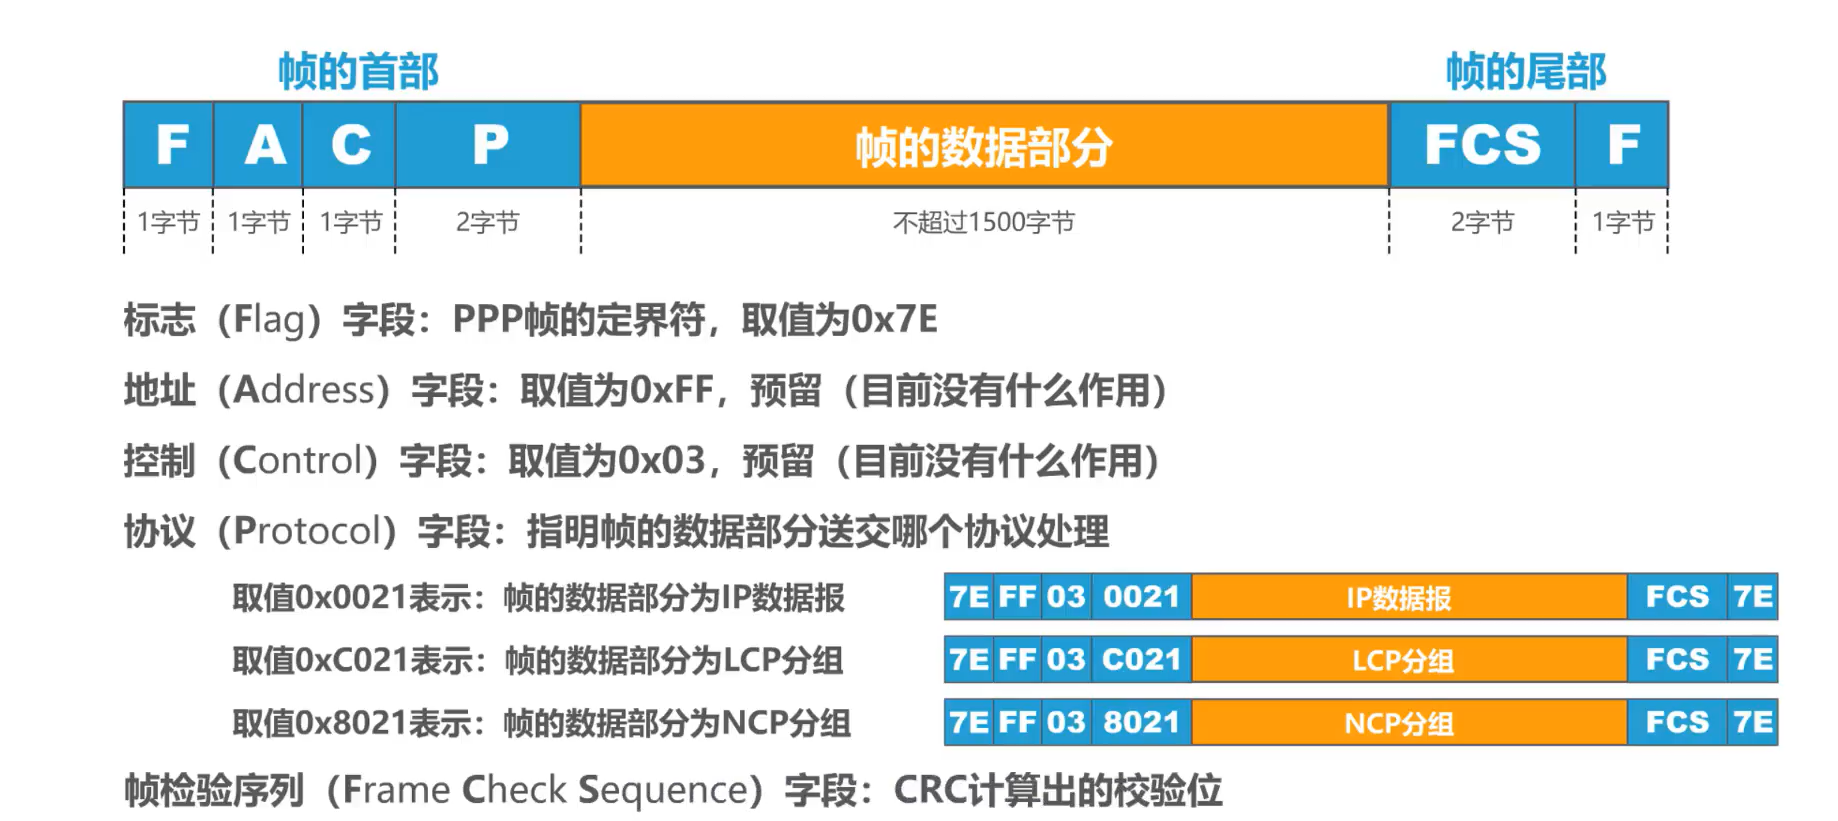
帧格式:
必须规定特殊的字符作为帧定界符
帧首:
- 标志字段:PPP帧的定界符,值为0x7E
- 协议字段:指明帧的数据部分送交哪个协议处理。
- 0x0021:帧的数据部分为IP数据报
- 0xC021:为LCP分组
- 0X8021:为NCP分组
帧尾:
- 帧检验序列FCS:CRC计算出的校验位
- 标志字段
透明传输:
必须保证数据传输的透明性(区分数据中出现的定界符),方法:
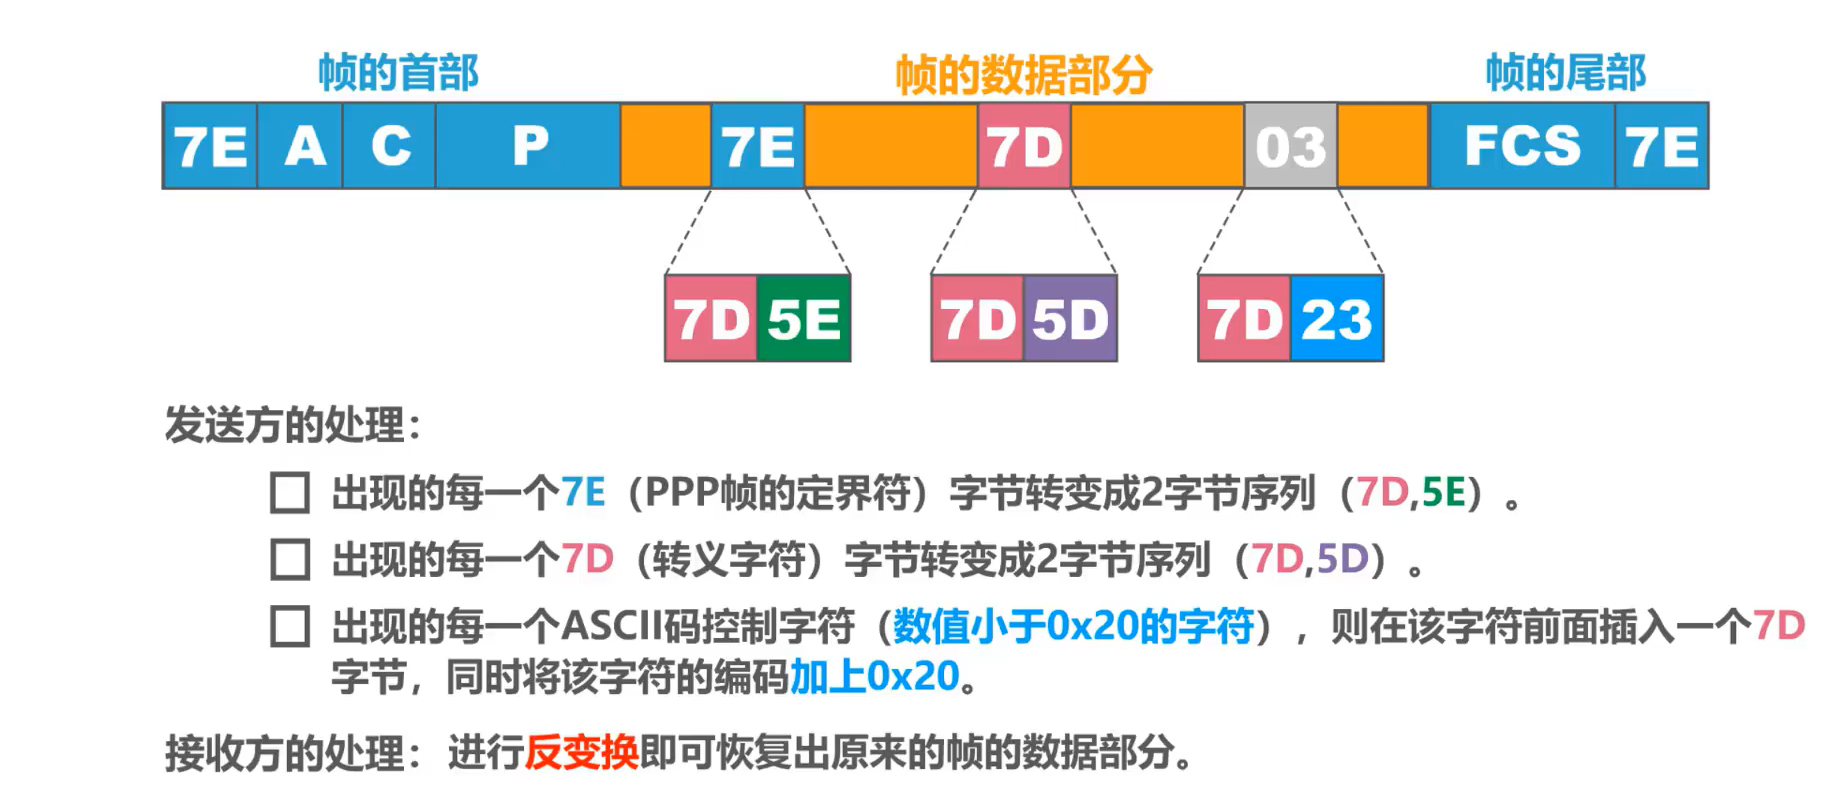
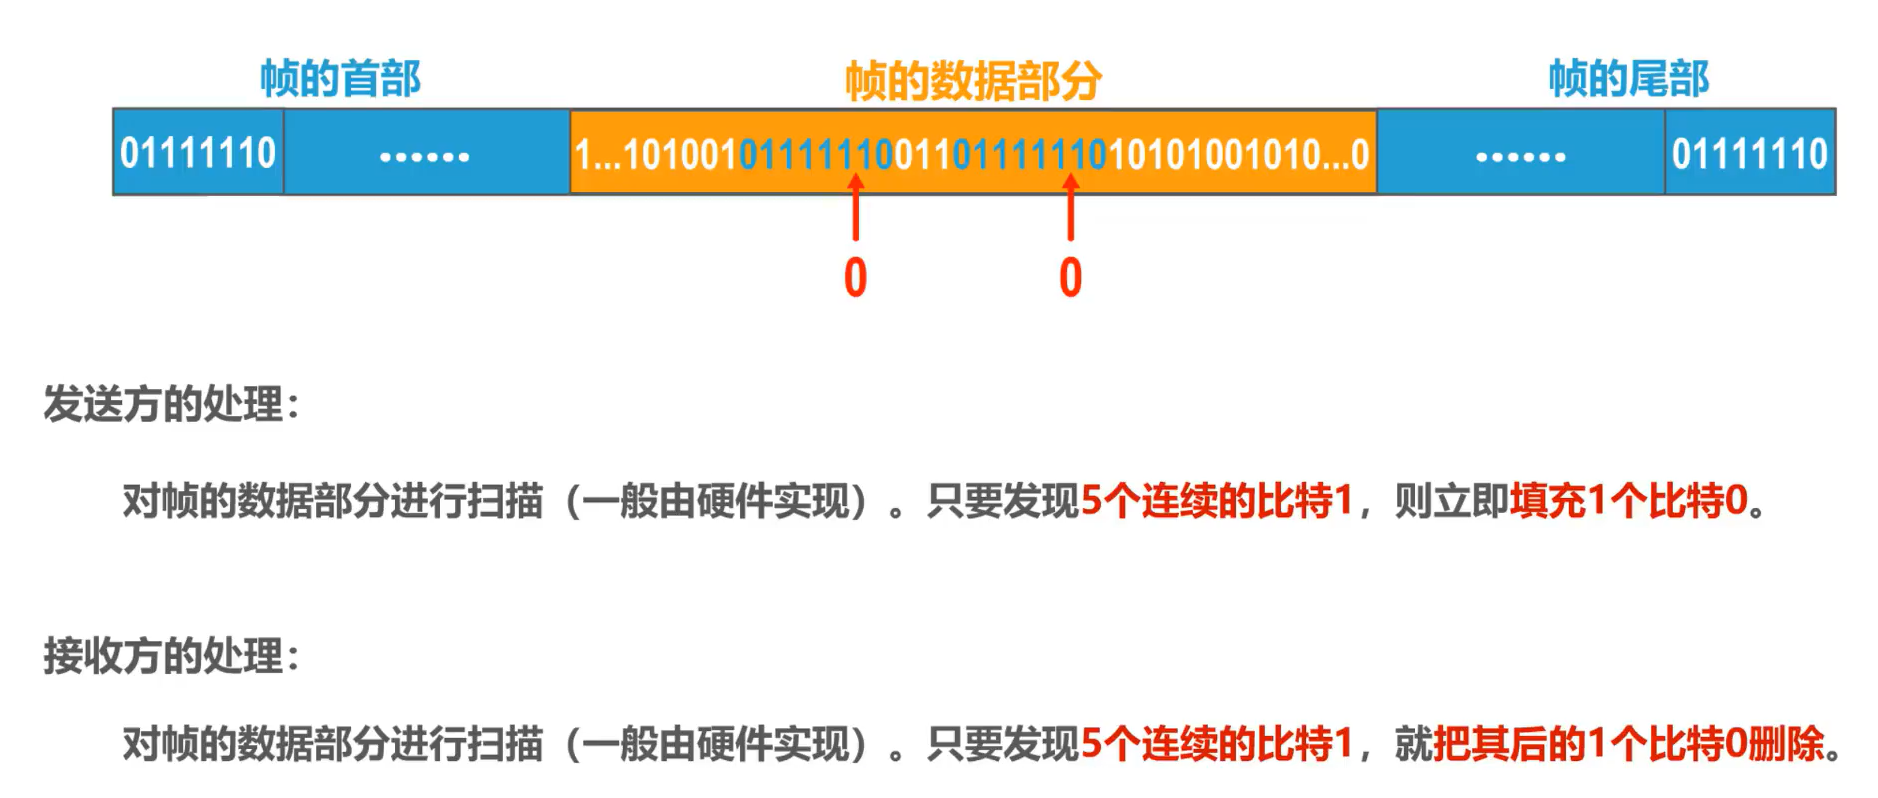
- 面向字节的异步链路:字节填充法(插入“转义字符”)7E→7D 5E,7D→7D 5D,ASCII(小于20)加上0x20,前插7D
- 面向比特的同步链路:比特填充法(插入“比特0”)
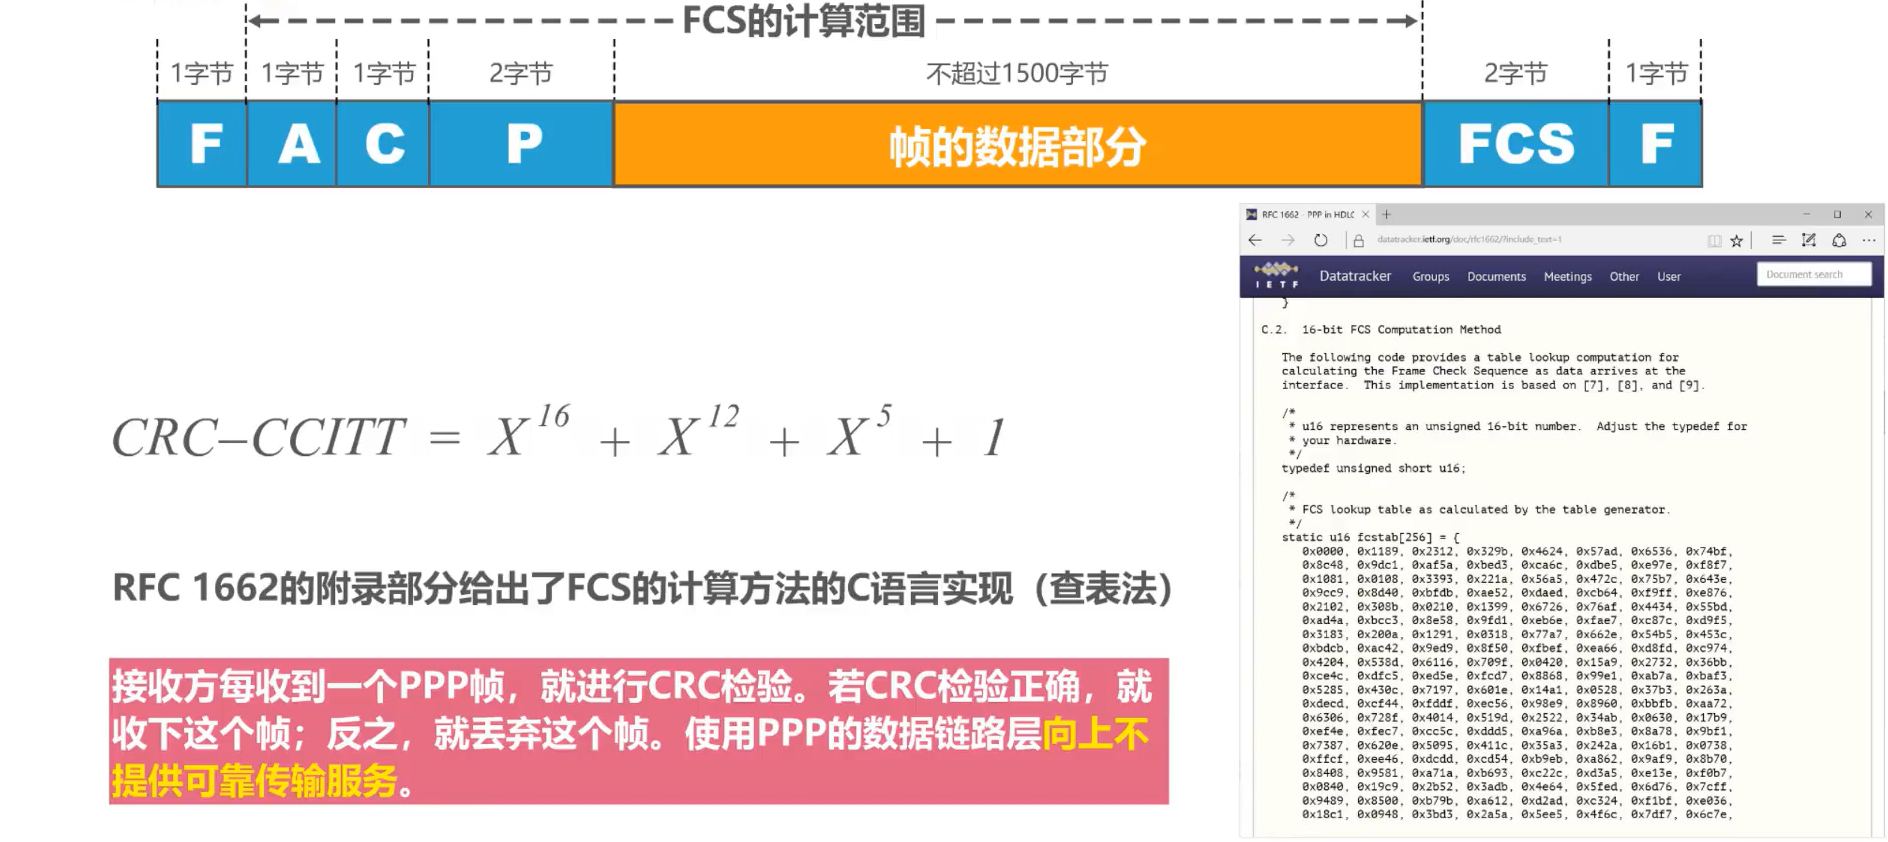
差错检测:
能够对接收端收到的帧进行检测,并立即丢弃有差错的帧。
工作状态:
- 当用户拨号接入 ISP 时,路由器的调制解调器对拨号做出确认,并建立一条物理连接。
- PC 机向路由器发送一系列的 LCP 分组(封装成多个 PPP 帧)。
- 这些分组及其响应选择一些 PPP 参数,并进行网络层配置,NCP 给新接入的 PC 机
- 分配一个临时的 IP 地址,使 PC 机成为因特网上的一个主机。
- 通信完毕时,NCP 释放网络层连接,收回原来分配出去的 IP 地址。接着,LCP 释放数据链路层连接。最后释放的是物理层的连接。
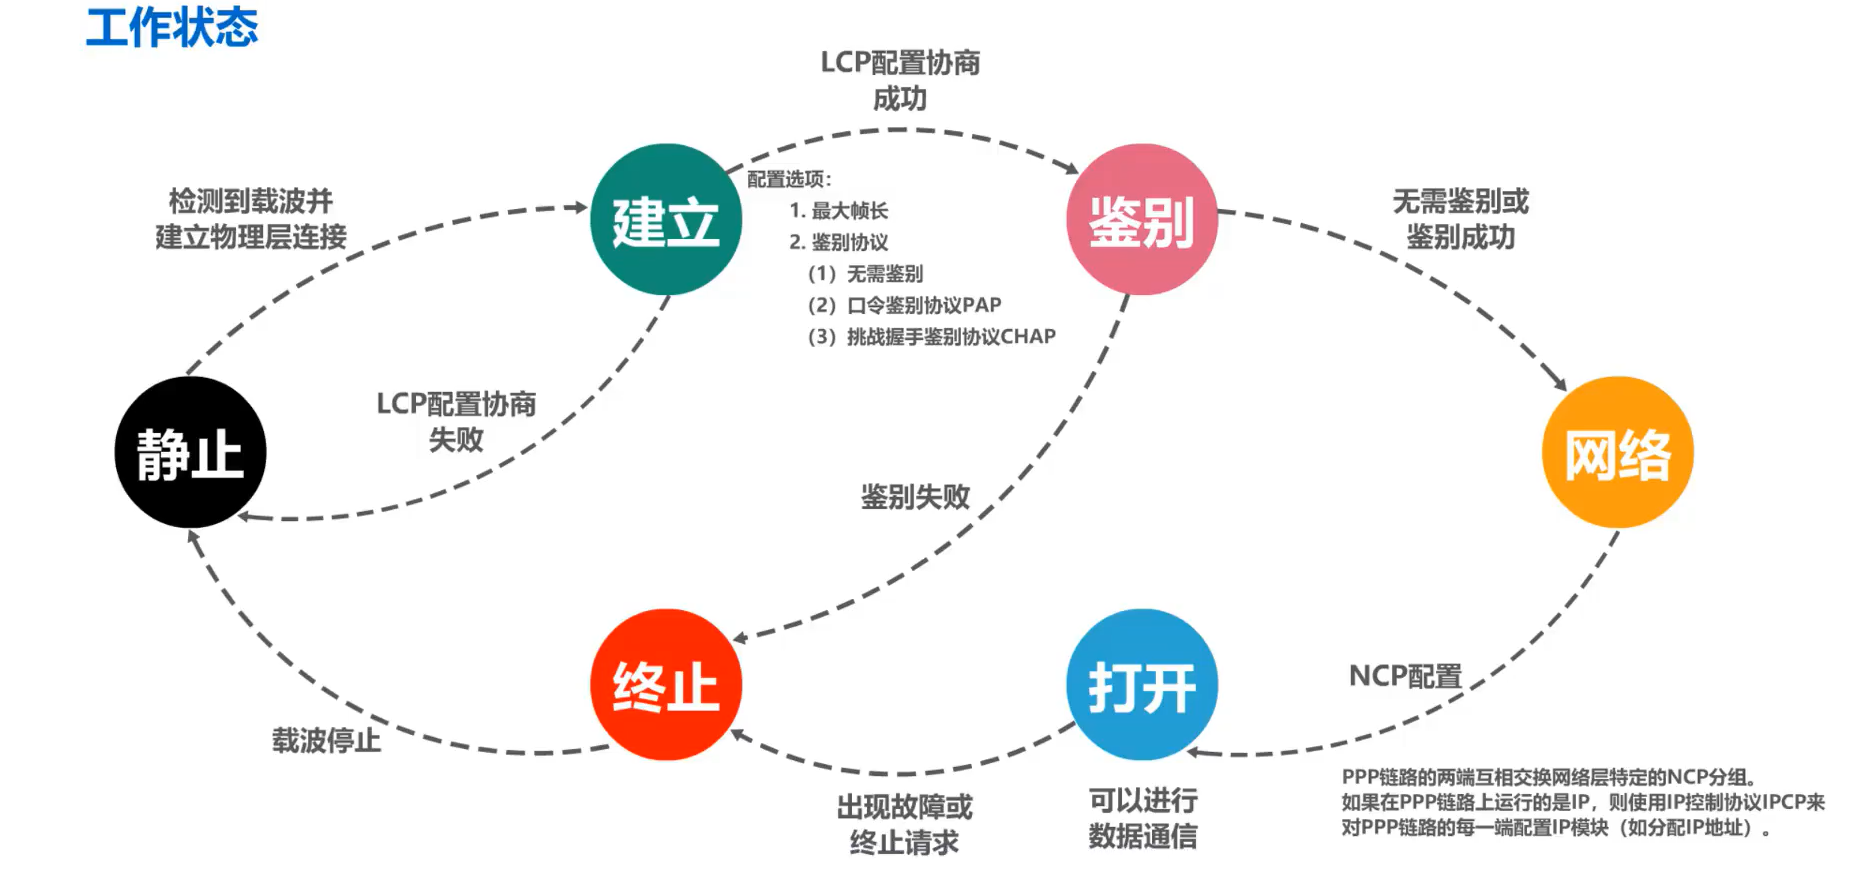
可见,PPP 协议已不是纯粹的数据链路层的协议,它还包含了物理层和网络层的内容。
媒体接入控制——广播信道
媒体接入控制(介质访问控制)使用一对多的广播通信方式
Medium Access Control翻译成媒体接入控制,有些翻译成介质访问控制,主要考虑多个发送点和接受点对一个共享传输媒体的占用问题。
局域网的数据链路层
- 局域网最主要的特点是:
- 网络为一个单位所拥有;
- 地理范围和站点数目均有限。
- 局域网具有如下主要优点:
- 具有广播功能,从一个站点可很方便地访问全网。局域网上的主机可共享连接在局域网上的各种硬件和软件资源。
- 便于系统的扩展和逐渐地演变,各设备的位置可灵活调整和改变。
- 提高了系统的可靠性、可用性和残存性。
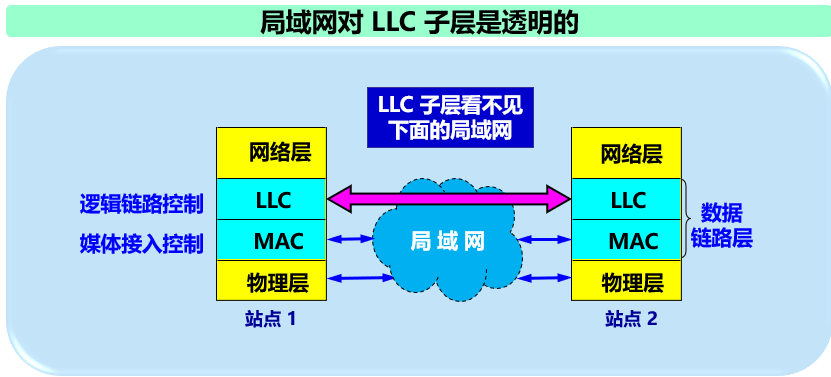
数据链路层的两个子层
为了使数据链路层能更好地适应多种局域网标准,IEEE 802 委员会就将局域网的数据链路层拆成两个子层:
- 逻辑链路控制 LLC (Logical Link Control)子层;
- 媒体接入控制 MAC (Medium Access Control)子层。
与接入到传输媒体有关的内容都放在 MAC子层,而 LLC 子层则与传输媒体无关。
不管采用何种协议的局域网,对 LLC 子层来说都是透明的。
基本概念
为什么要媒体接入控制(介质访问控制)?
共享信道带来的问题
若多个设备在共享信道上同时发送数据,则会造成彼此干扰,导致发送失败。
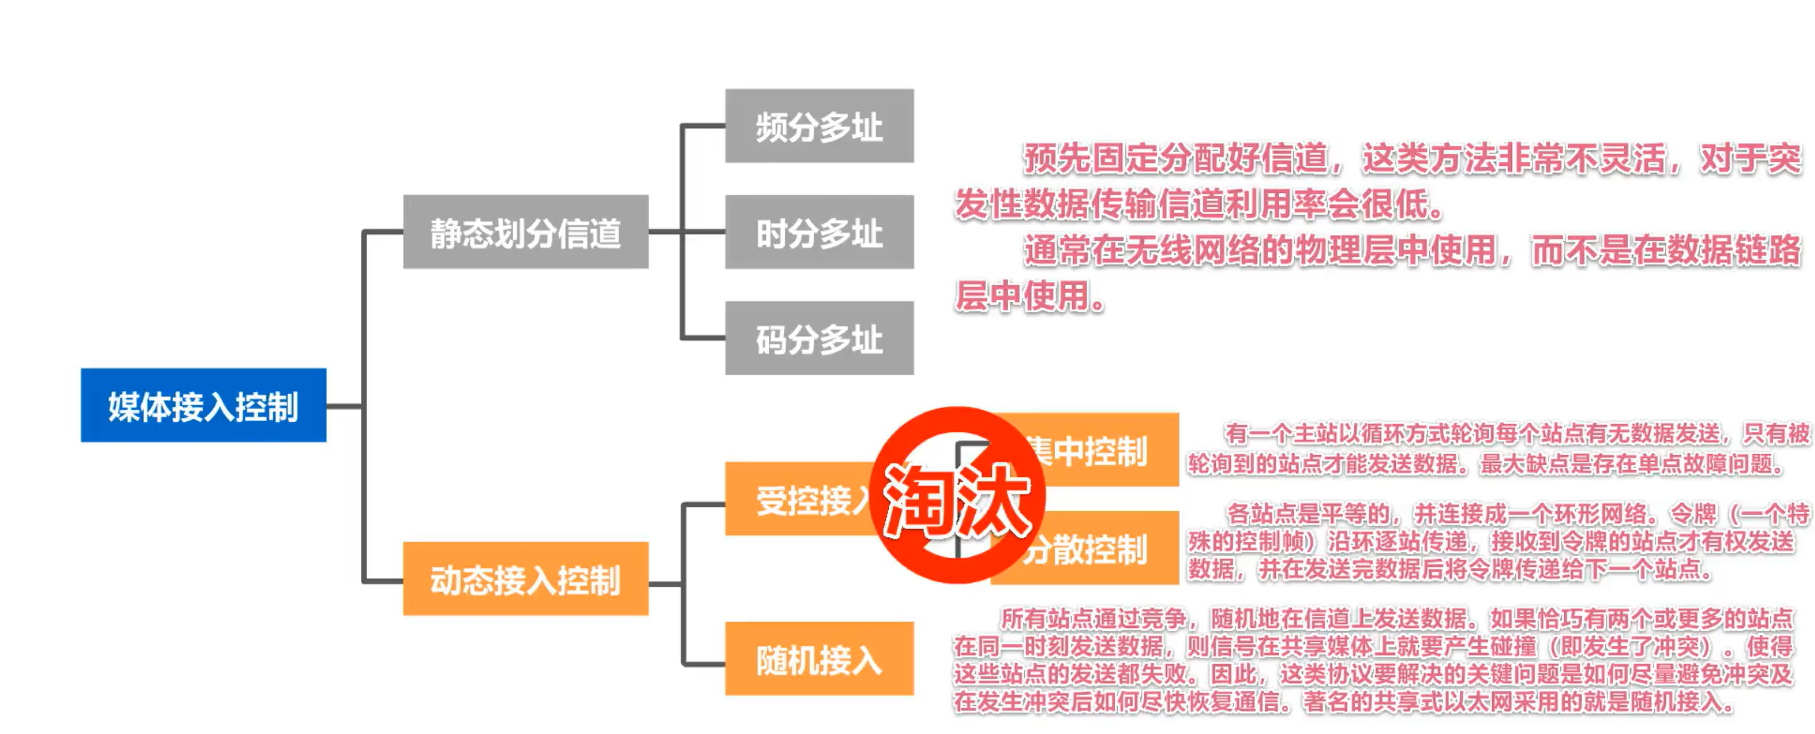
随着技术的发展,交换技术的成熟和成本的降低,具有更高性能的使用点对点链路和链路层交换机的交换式局域网在有线领域已完全取代了共享式局域网,但由于无线信道的广播天性,无线局域网仍然使用的是共享媒体技术。
静态划分信道
信道复用技术:通过一条物理线路同时传输多路用户的信号。
当网络中传输媒体的传输容量大于多条单一信道传输的总通信量时,可利用复用技术在一条物理线路上建立多条通信信道来充分利用传输媒体的带宽。
常用的有:频分复用,时分复用,波分复用,码分复用。
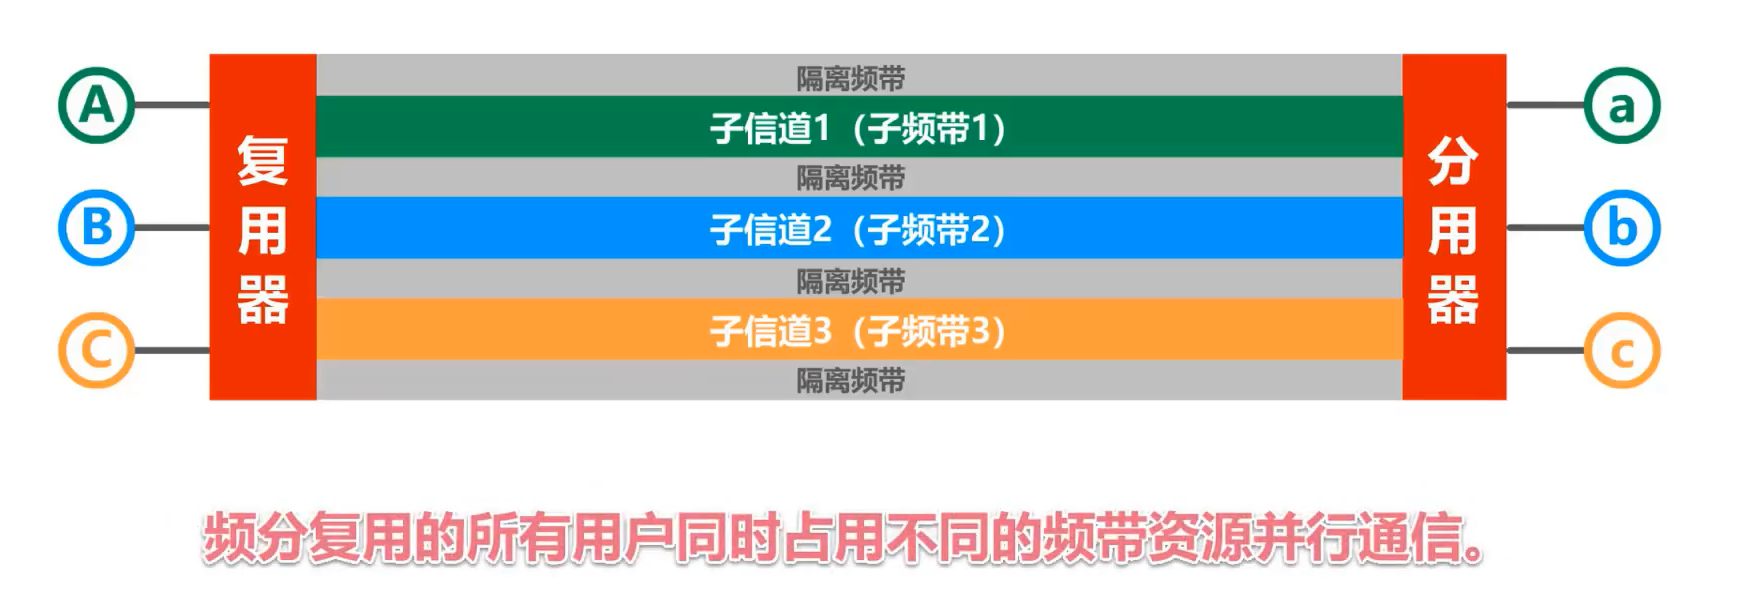
频分复用FDM (Frequency Division Multiplexing)
将整个带宽分为多份,用户在分配到一定的频带后,在通信过程中自始至终都占用这个频带。
频分复用的所有用户在同样的时间占用不同的带宽资源(请注意,这里的“带宽”是频率带宽而不是数据的发送速率)。
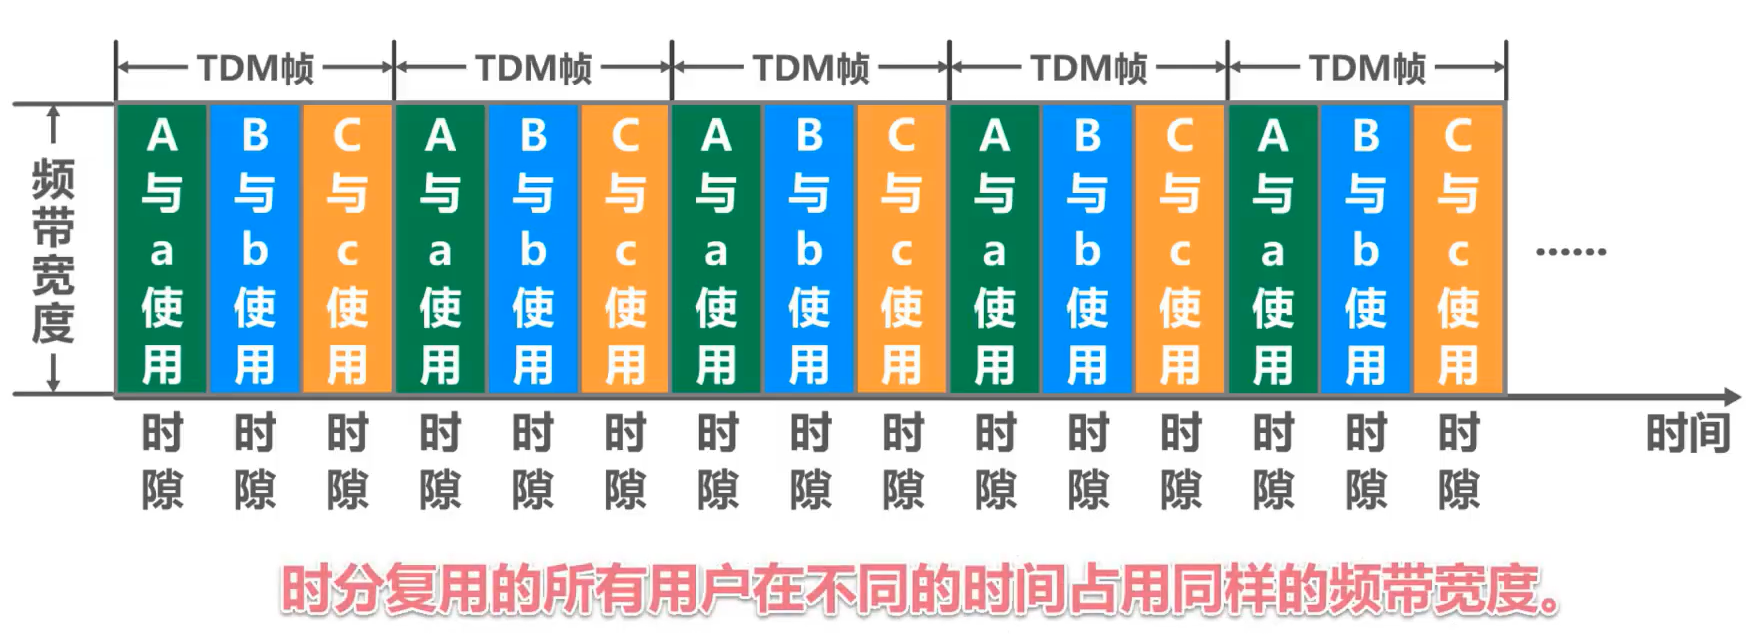
时分复用TDM (Time Division Multiplexing)
- 时分复用则是将时间划分为一段段等长的时分复用帧(TDM帧)。每一个时分复用的用户在每一个 TDM 帧中占用固定序号的时隙。
- 每一个用户所占用的时隙是周期性地出现(其周期就是TDM帧的长度)的。
- TDM 信号也称为等时 (isochronous) 信号。
- 时分复用的所有用户在不同的时间占用同样的频带宽度。
波分复用 WDM(Wavelength Division Multiplexing)
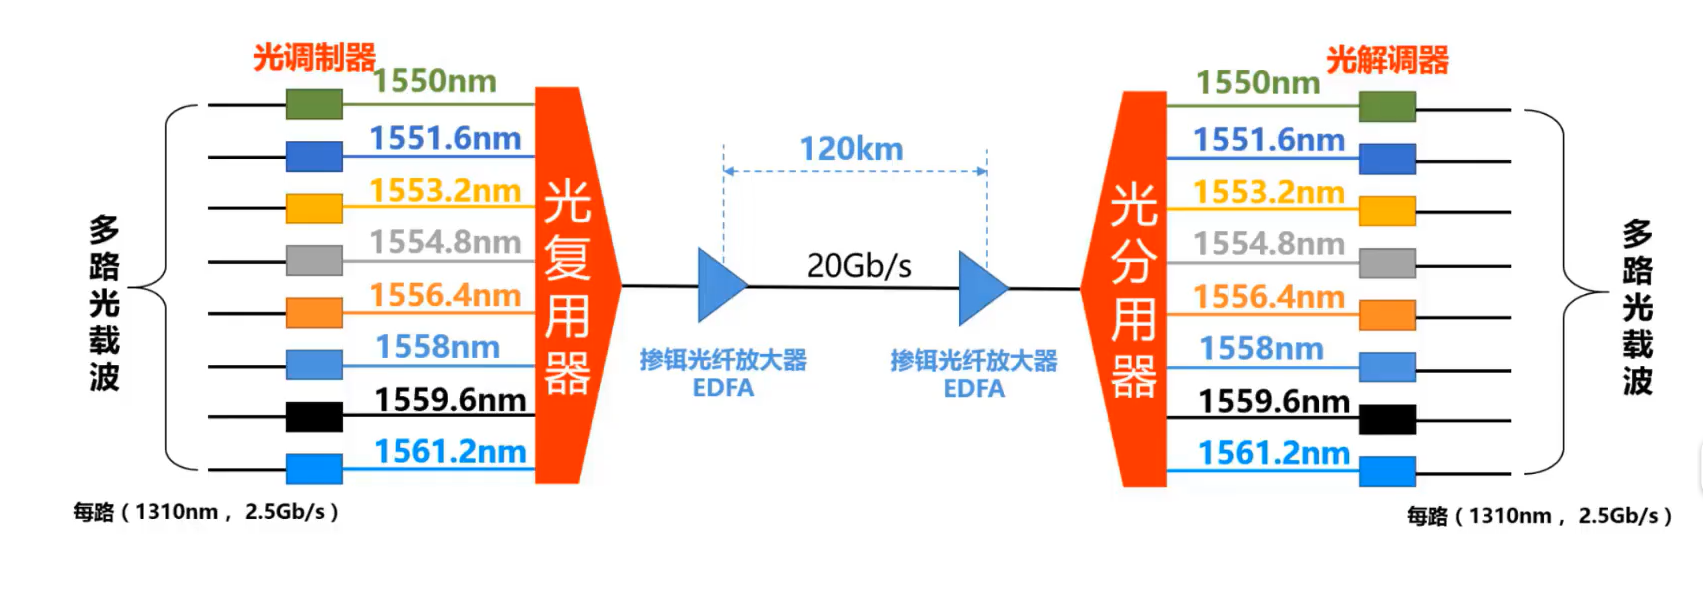
波分复用就是光的频分复用,使用一根光纤来同时传输多个光载波信号
光信号传输一段距离后悔衰减,所以要用 掺铒光纤放大器 放大光信号
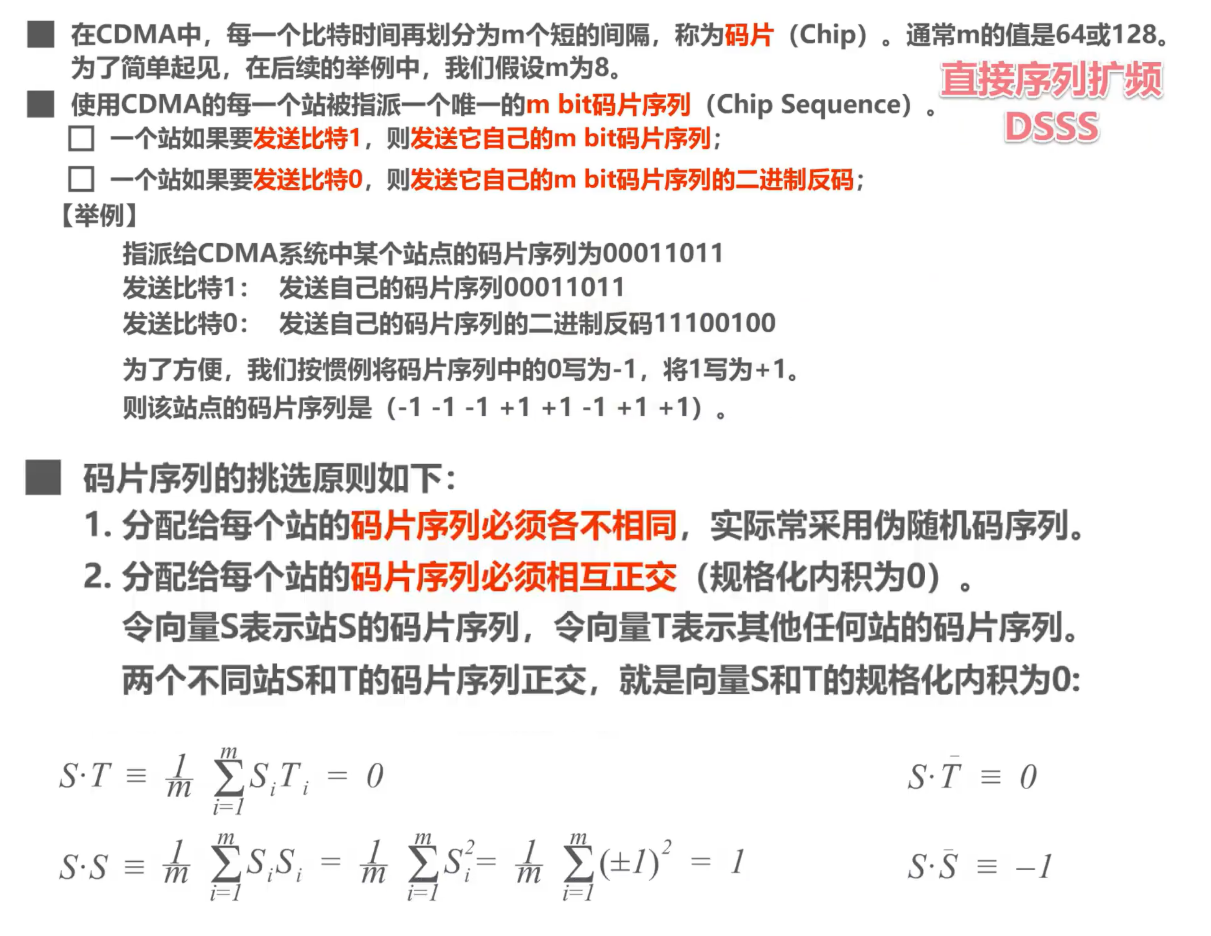
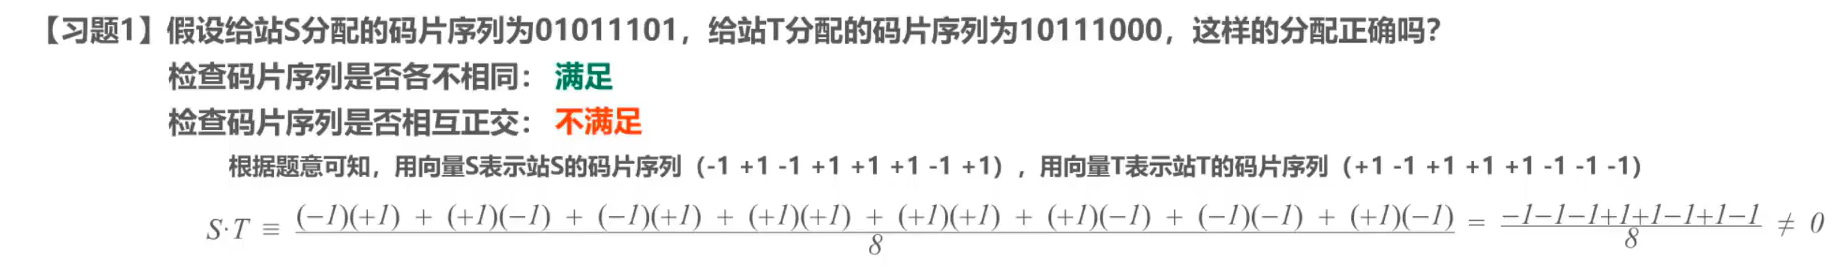
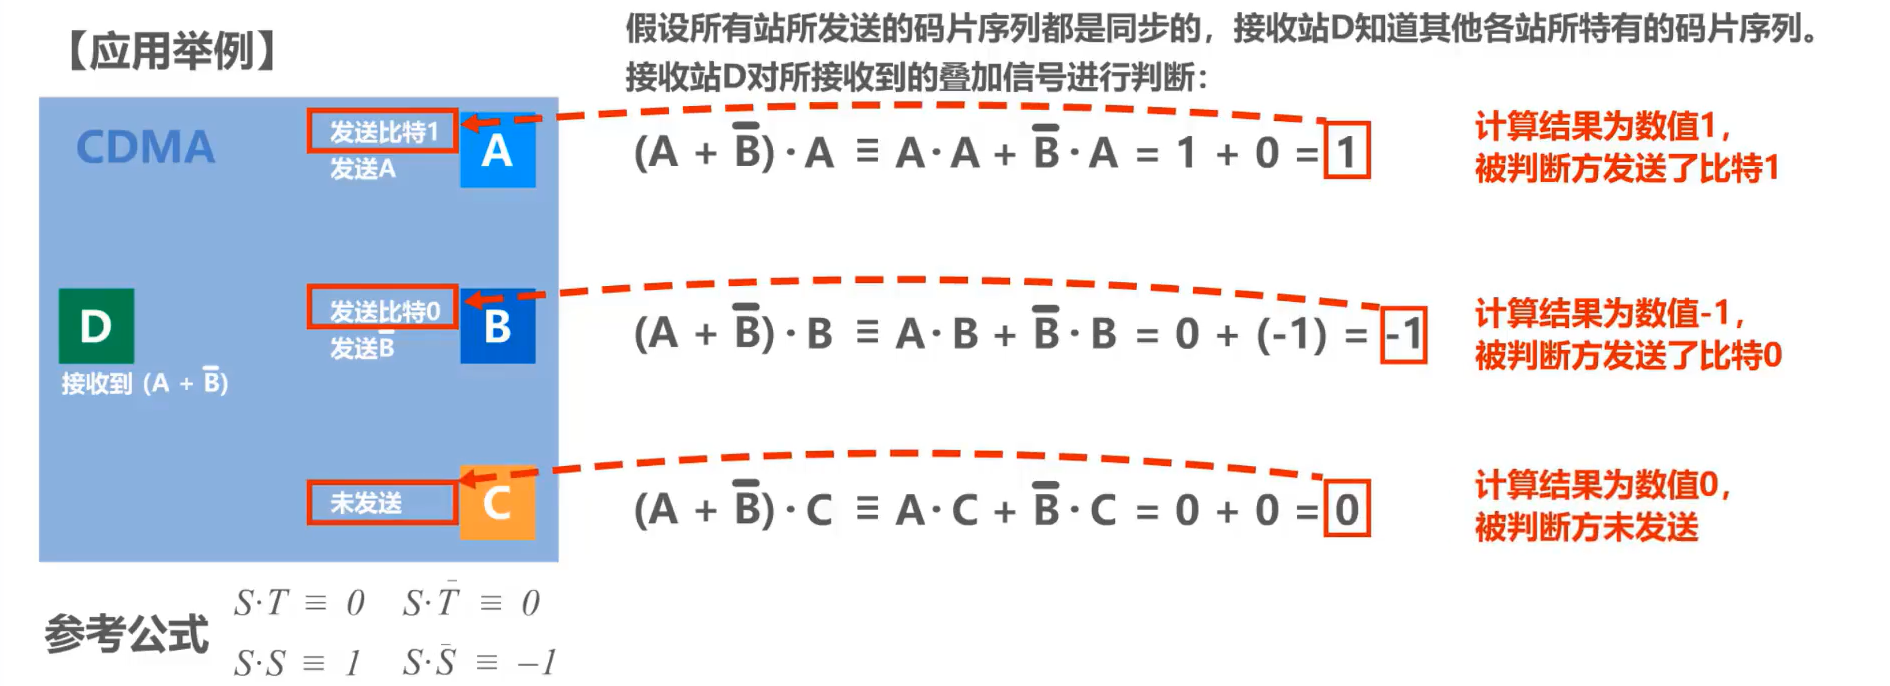
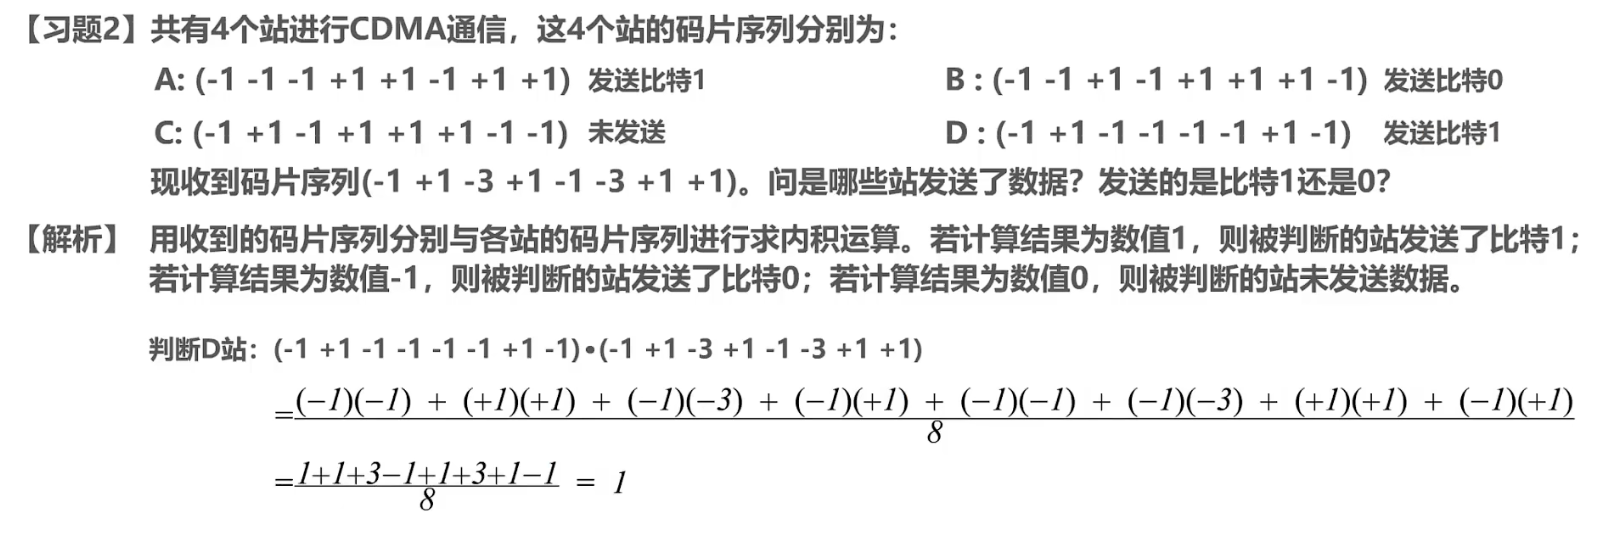
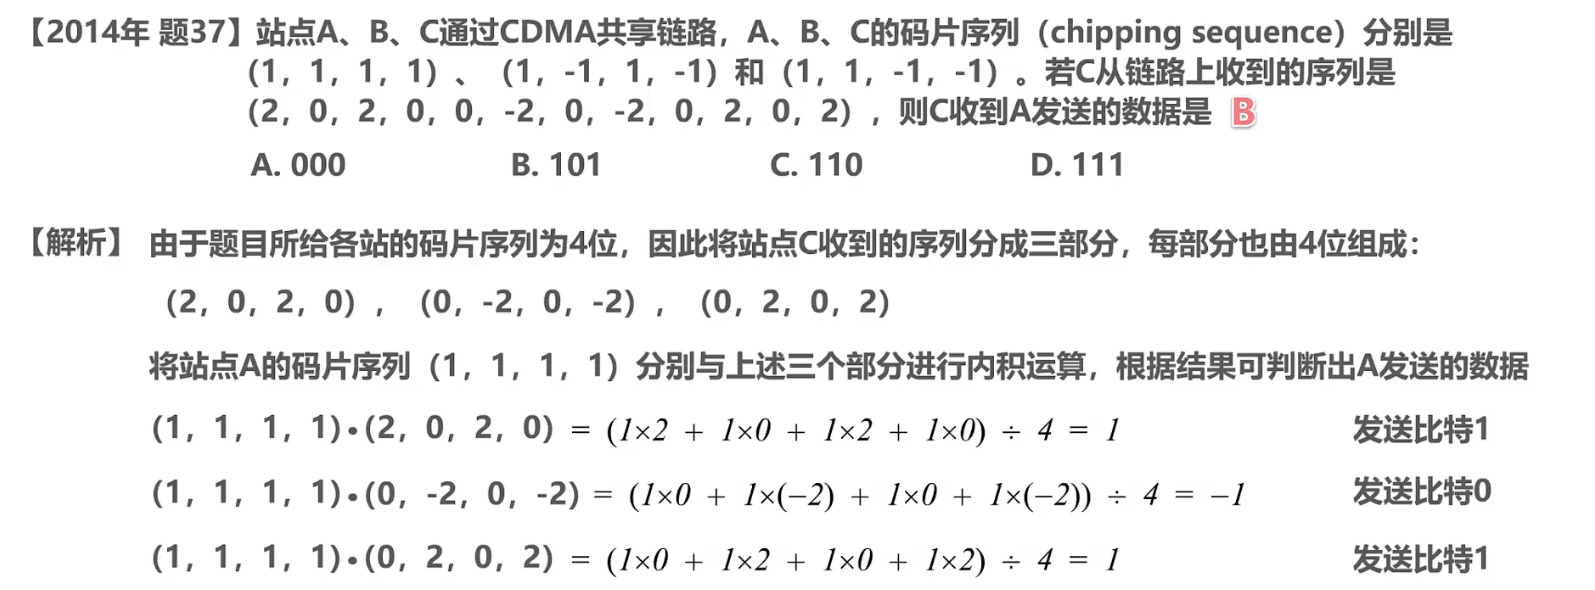
码分复用 CDM (Code Division Multiplexing)
由于该技术主要用于多址接入,人们更常用的名词是码分多址CDMA(Code Division Multiple Access).
同理,频分复用FDM 和 时分复用TDM同样可用于多址接入,相应的名词是频分多址 FDMA (Frequency Division Multiple Access) 和时分多t址 TDMA (Time Division Multiple Access)。
复用和多址的简单区分:
- 复用 —— 是将单一媒体的频带资源划分成很多子信道,这些子信道之间相互独立,互不干扰。从媒体的整体频带资源上看,每个子信道只占用该媒体频带资源的一部分。
- 多址(多点接入)—— 处理的是动态分配信道给用户。用户仅仅暂时性地占用信道,
所有的移动通信系统基本上都是多点接入。相反,在信道永久性地分配给用户的应用中,多址是不需要的(比如 无线广播或电视广播站)。
动态接入控制
受控接入在局域网中使用得较少,不讨论
随机接入CSMA/CD
CSMA/CA 指:载波监听 多址接入 / 碰撞检测
最初的以太网是将许多计算机都连接到一根总线上。易于实现广播通信。当初认为这样的连接方法既简单又可靠,因为总线上没有有源器件。
以太网(Ethernet)是一种计算机局域网技术。IEEE组织的IEEE 802.3标准制定了以太网(Ethernet)的技术标准
以太网采用无连接的工作方式,对发送的数据帧不进行编号,也不要求对方发回确认。目的站收到有差错帧就把它丢弃,其他什么也不做
多址接入MA:
多个主机以多点接入的方式连接在一根总线上,竞争使用总线。
载波监听CS:
是指每一个站在发送数据之前先要检测一下总线上是否有其他计算机在发送数据,如果有,则暂时不要发送数据,以免发生碰撞。(先听后说)“载波监听”就是用电子技术检测总线上有没有其他计算机发送的数据信号。
- 若检测到总线空闲96比特时间,则发送这个帧;
- 若检测到总线忙,则继续检测并等待总线转为空闲96比特时间,然后发送这个帧。
碰撞检测CD:
每一个正在发送帧的站边发送边检测碰撞(边说边听):一旦发现总线上出现碰撞,则立即停止发送,退避一段随机时间后再次发送;
“碰撞检测”就是计算机边发送数据边检测信道上的信号电压大小。
- 当几个站同时在总线上发送数据时,总线上的信号电压摆动值将会增大(互相叠加)。
- 当一个站检测到的信号电压摆动值超过一定的门限值时,就认为总线上至少有两个站同时在发送数据,表明产生了碰撞。
- 所谓“碰撞”就是发生了冲突。因此“碰撞检测”也称为“冲突检测”。
- 在发生碰撞时,总线上传输的信号产生了严重的失真,无法从中恢复出有用的信息来。
每一个正在发送数据的站,一旦发现总线上出现了碰撞,就要立即停止发送,免得继续浪费网络资源,然后等待一段随机时间后再次发送。
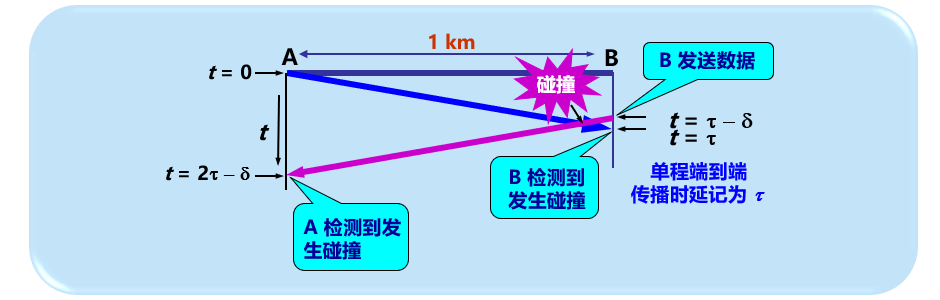
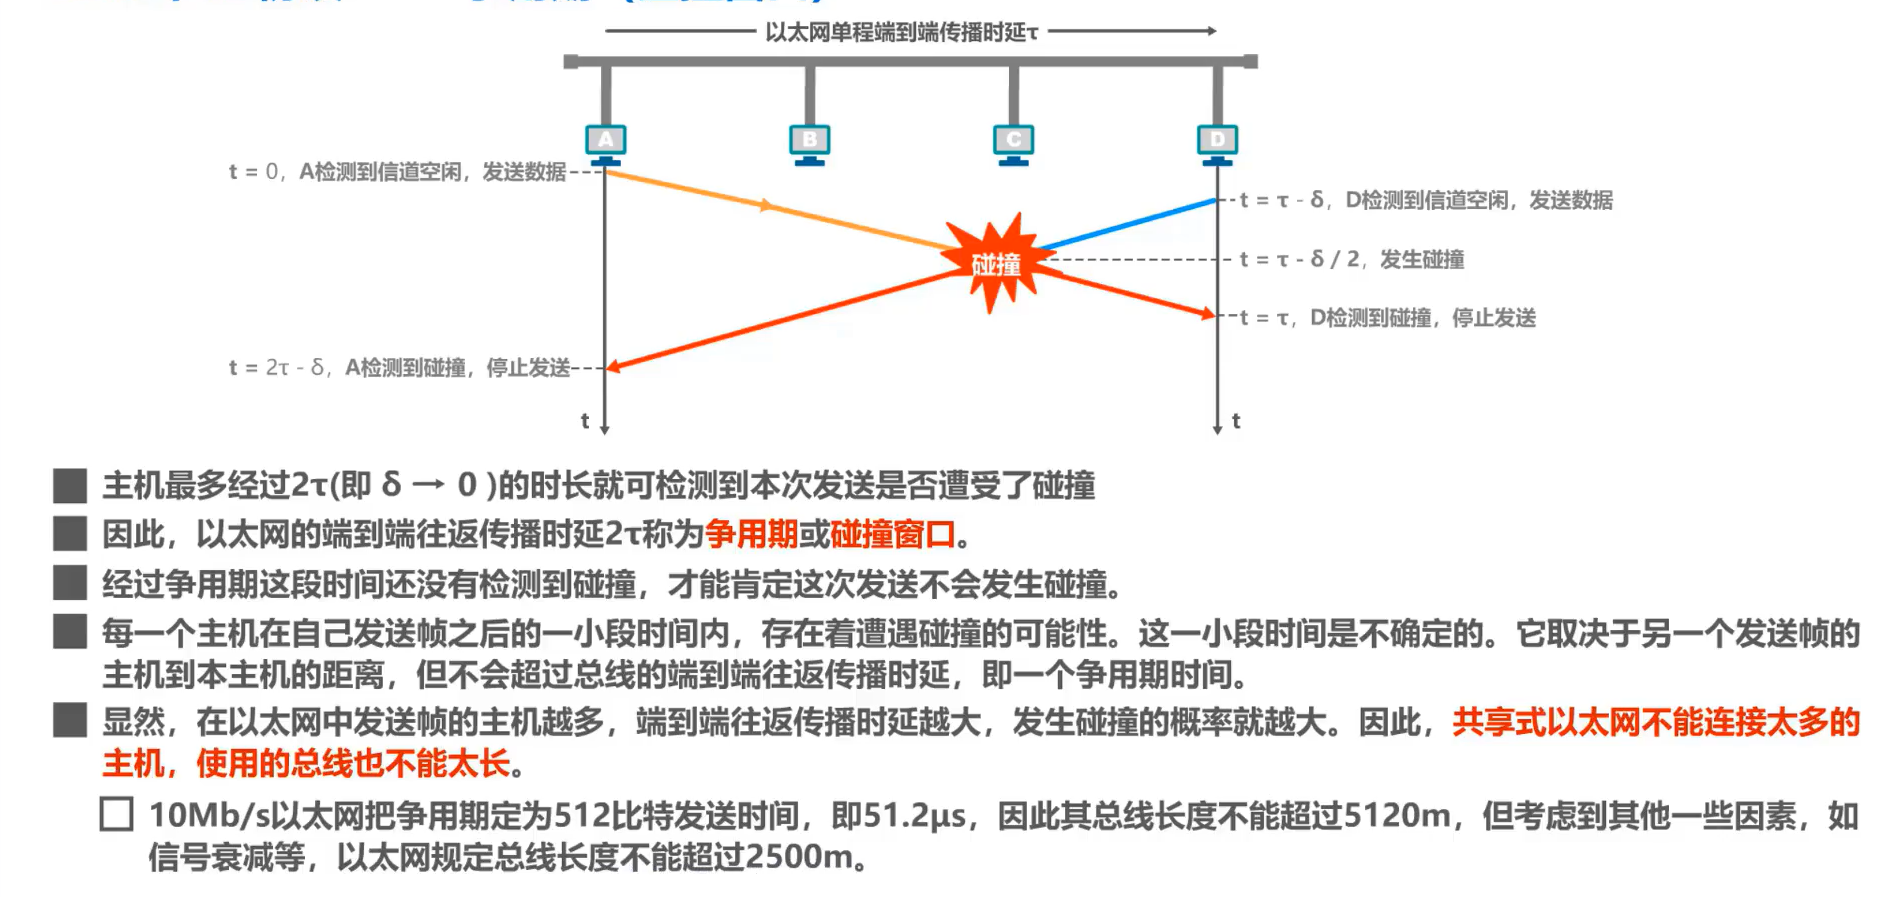
为什么要进行碰撞检测? 因为信号传播时延对载波监听产生了影响
A 需要单程传播时延的 2 倍的时间,才能检测到与 B 的发送产生了冲突
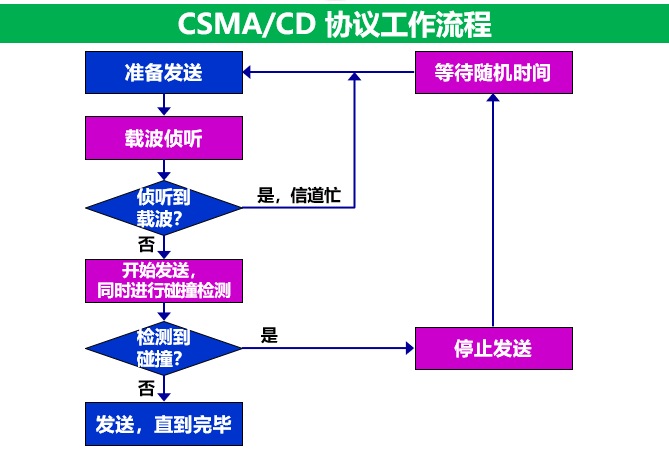
协议工作流程:
CSMA/CD 协议工作——争用期(碰撞窗口)
主机最多经过一个端到端的往返传播时延可以检测到本次发送是否遭受碰撞,所以端到端往返传播时延称为争用期/碰撞窗口。 (10Mb/S以太网的争用期定为512比特发送时间,即51.2纳秒)
CSMA/CD 协议工作——最小帧长
以太网规定最小帧长为64字节,即512比特(512比特发送时间就是争用期),可以加入填充字节,使帧长大于64字节。
- 作用:确保主机可在帧发送完成之前就检测到该帧是否在发送过程发生了碰撞。
- 如果在争用期(共发送64字节)没用检测到碰撞,那后续发送的数据也不会发生碰撞。
- 如果在争用期发生碰撞,那发送出的数据一定小于64字节,因此,接收方可以认为,凡是小于64字节的帧都是由于碰撞而异常终止的无效帧。
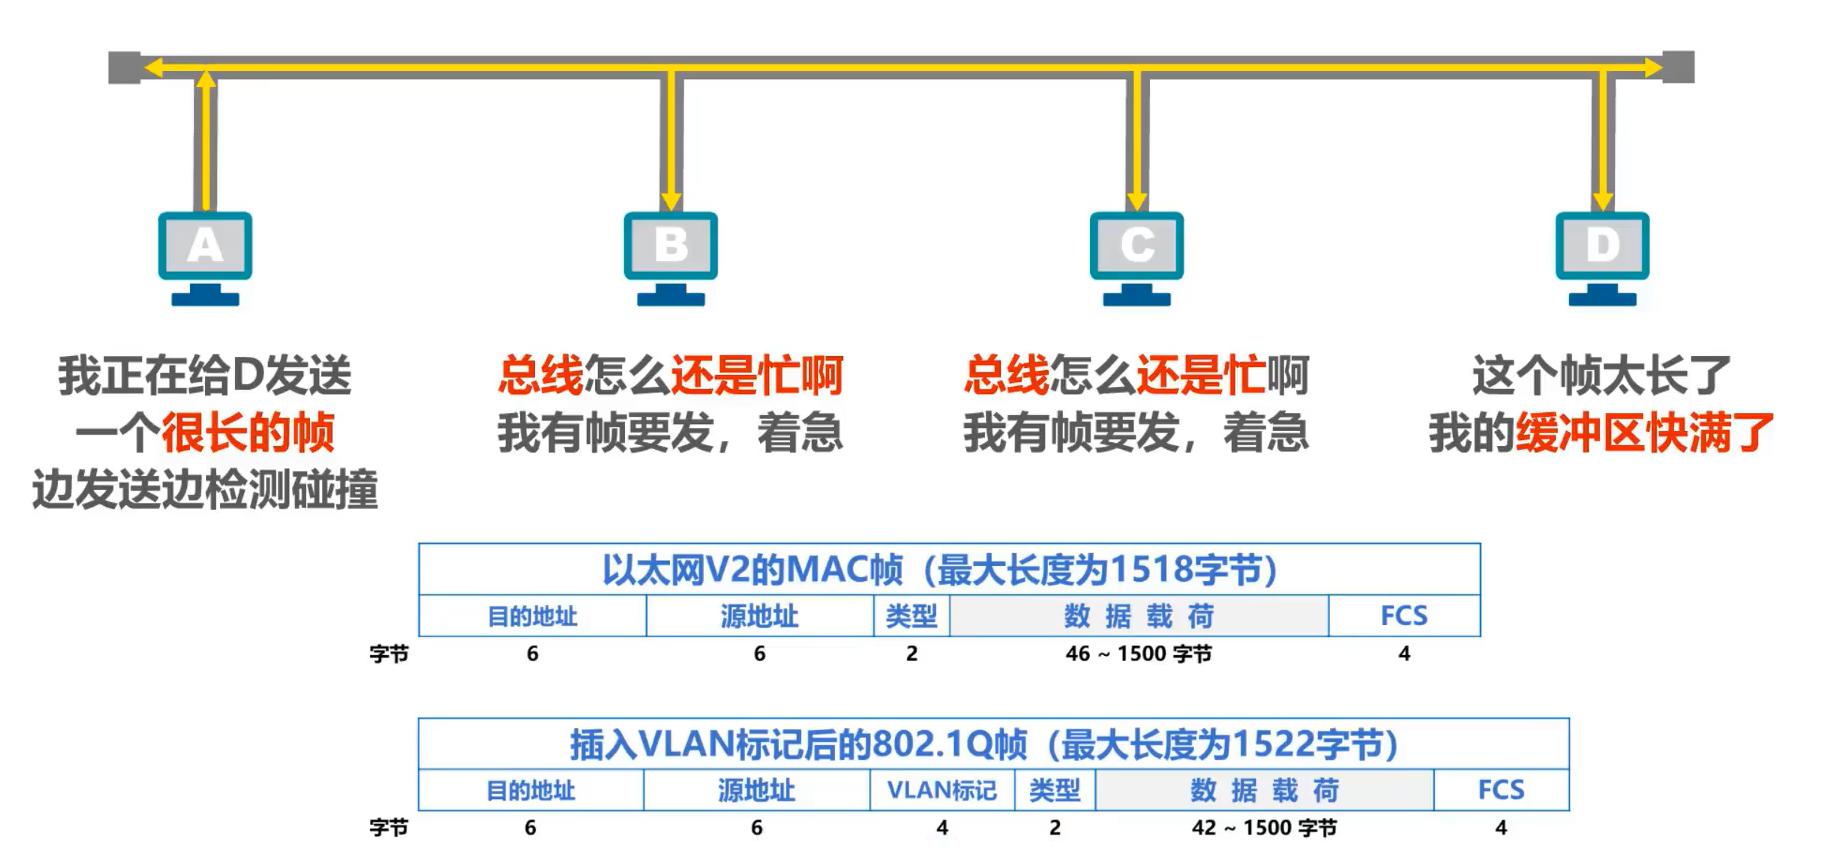
CSMA/CD 协议工作——最大帧长
避免长时间占用总线,且也要考虑接收方的缓冲区大小
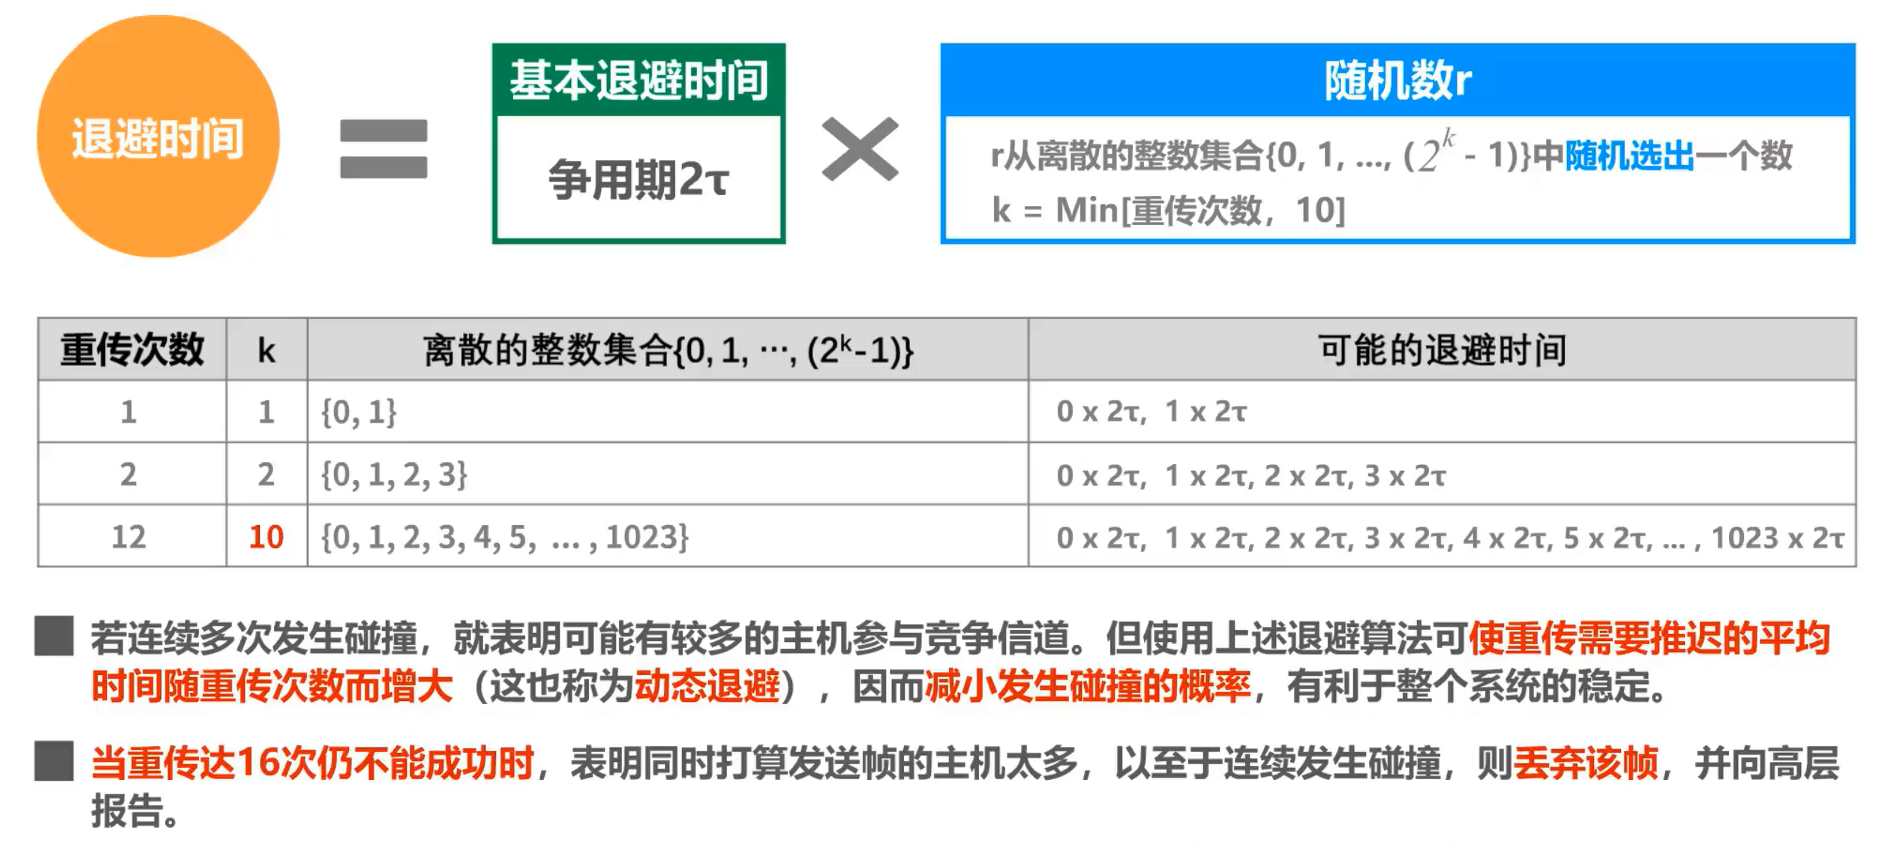
CSMA/CD 协议工作——截断二进制指数退避算法
退避时间 = 争用期时长 * 随机数r
当重传16次都不成功,则说明同时争用总线的主机太多了,丢弃该帧。
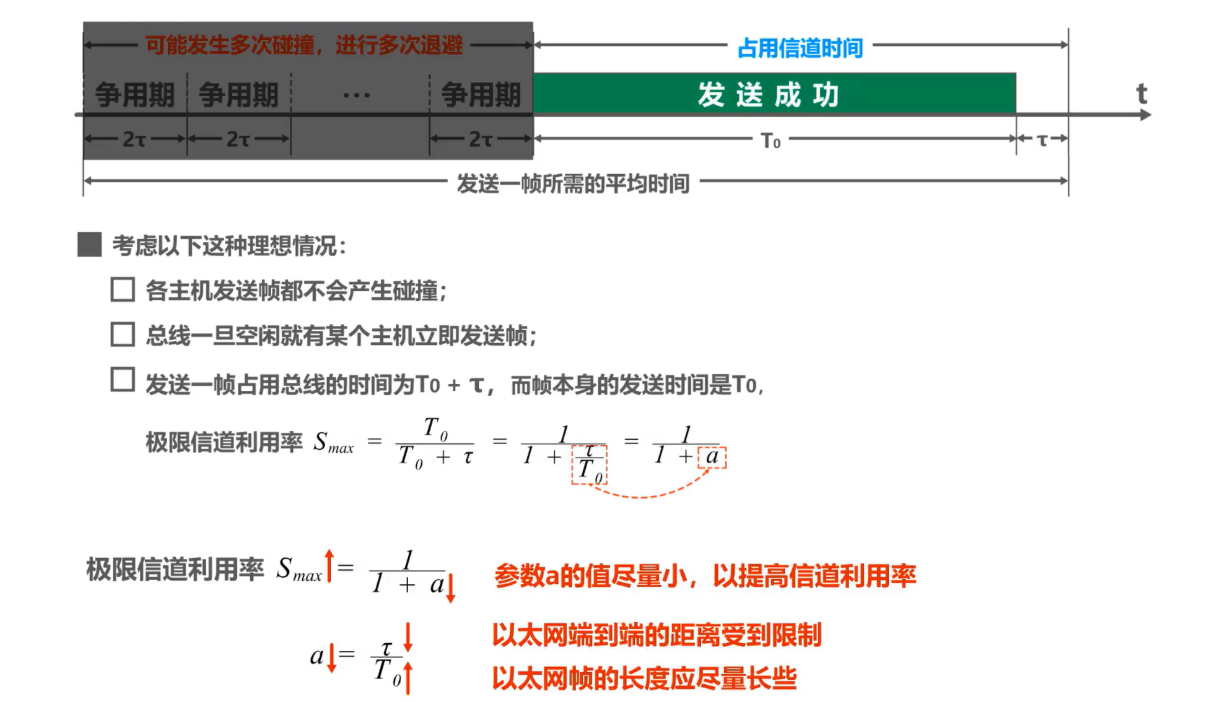
CSMA/CD 协议工作——信道利用率
CSMA/CD 协议工作——帧接收流程
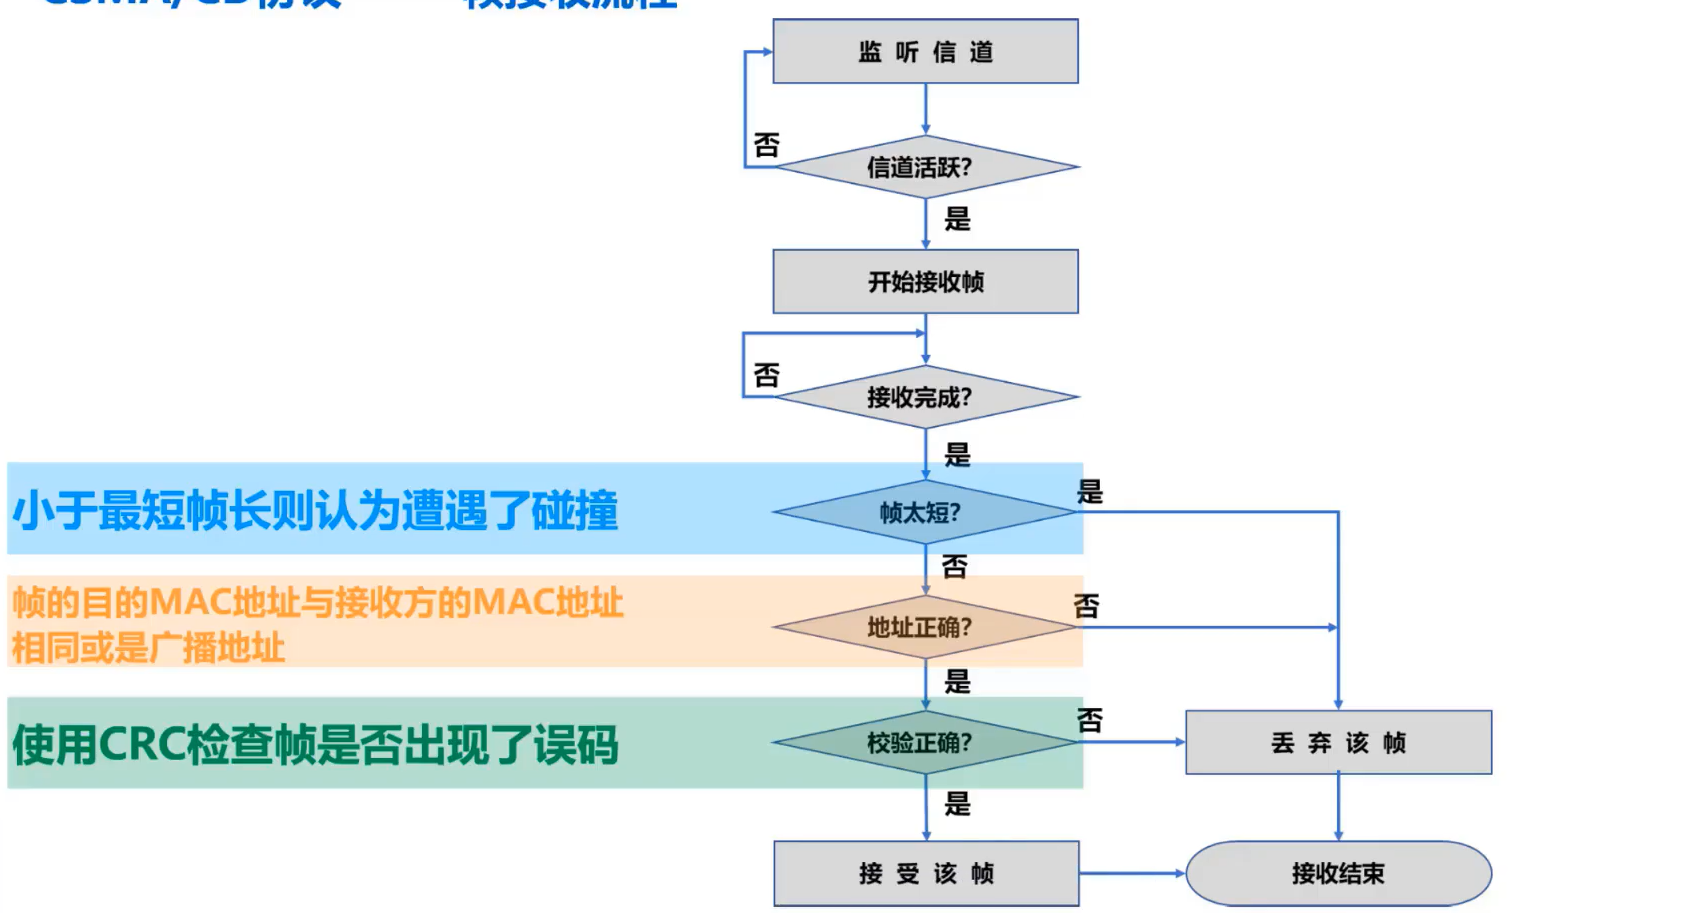
CSMA/CD 协议的重要特性
- 使用 CSMA/CD 协议的以太网不能进行全双工通信而只能进行双向交替通信(半双工通信)。
- 每个站在发送数据之后的一小段时间内,存在着遭遇碰撞的可能性。
- 这种发送的不确定性使整个以太网的平均通信量远小于以太网的最高数据率。
CSMA/CD协议曾经用于各种总线结构以太网和双绞线以太网的早起版本中。
现在的以太网基于交换机和全双工连接,不会有碰撞,因此没有必要使用CSMA/CD协议
随机接入CSMA/CA
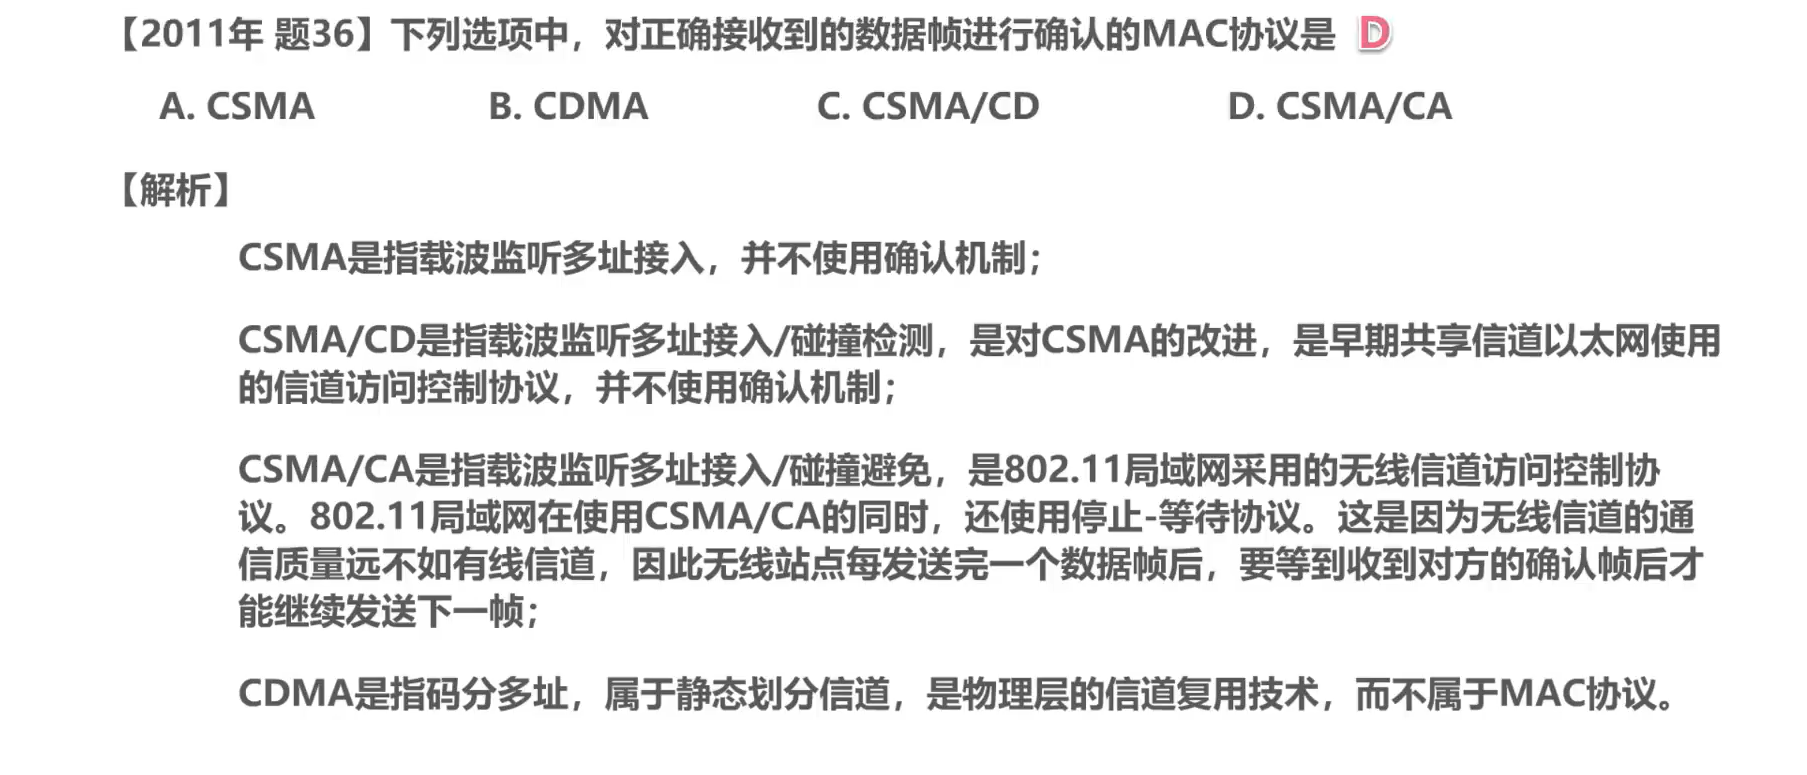
无线局域网使用的协议:CSMA/CA ,即 载波监听多址接入 / 碰撞避免
为什么无线局域网要使用CSMA/CA协议?
- 仍使用 载波监听多址接入CSMA:同样能在发送帧之前先对传输媒体进行载波监听。若发现有其他站在发送帧,就推迟发送。
- 不使用 碰撞检测CD:无线信道的传输条件特殊(信号强度波动范围很大,实现CD对硬件要求很大);无线电波传播的特殊性(存在隐蔽站问题,如b在a, c的范围内,但a和c都不在对方范围内,则a, c同时给b发送帧时,a, c都检测不到碰撞),用碰撞检测意义不大。
但是不可能避免所有的碰撞,并且无线信道误码率较高,802.11标准还使用了数据链路层 确认机制 (停止-等待协议) 来保证数据被正确接收。
802.11的MAC层标准定义了两种不同的媒体接入控制方式:
- 分布式协调功能DCF (Distributed Coordination Function)。在DCF方式下,没有中心控制站点,每个站点使用CSMA/CA协议通过争用信道来获取发送权,这是802.11定义的默认方式。
- 点协调功能PCF (Point Coordination Function)。PCF方式使用集中控制的接入算法(一般在接入点AP实现集中控制),是802.11定义的可选方式,在实际中较少使用。
帧间间隔IFS(InterFrame Space): 802.11标准规定,所有的站点必须在持续检测到信道空闲一段指定时间后才能发送帧,这段时间称为 帧间间隔 IFS。
帧间间隔的长短取决于该站点要发送的帧的类型:
- 高优先级帧需要等待的时间较短,因此可优先获得发送权;
- 低优先级帧需要等待的时间较长。若某个站的低优先级帧还没来得及发送,而其他站的高优先级帧已发送到信道上,则信道变为忙态,因而低优先级帧就只能再推迟发送了。这样就减少了发生碰撞的机会。
常用的两种帧间间隔:
- 短帧间间隔SFS(28μs) —— 是最短的帧间间隔,用来分隔开属于一次对话的各帧。一个站点应当能够在这段时间内从发送方式切换到接收方式。使用SFS的帧类型有ACK帧、CTS帧、由过长的MAC帧分片后的数据帧、以及所有回答AP探询的帧和在PCF方式中接入点AP发送出的任何帧。
- DCF帧间间隔DIFS(128μs) —— 它比短帧间间隔SIFS要长得多,在DCF方式中用来发送数据帧和管理帧。
CSMA/CA协议的工作原理
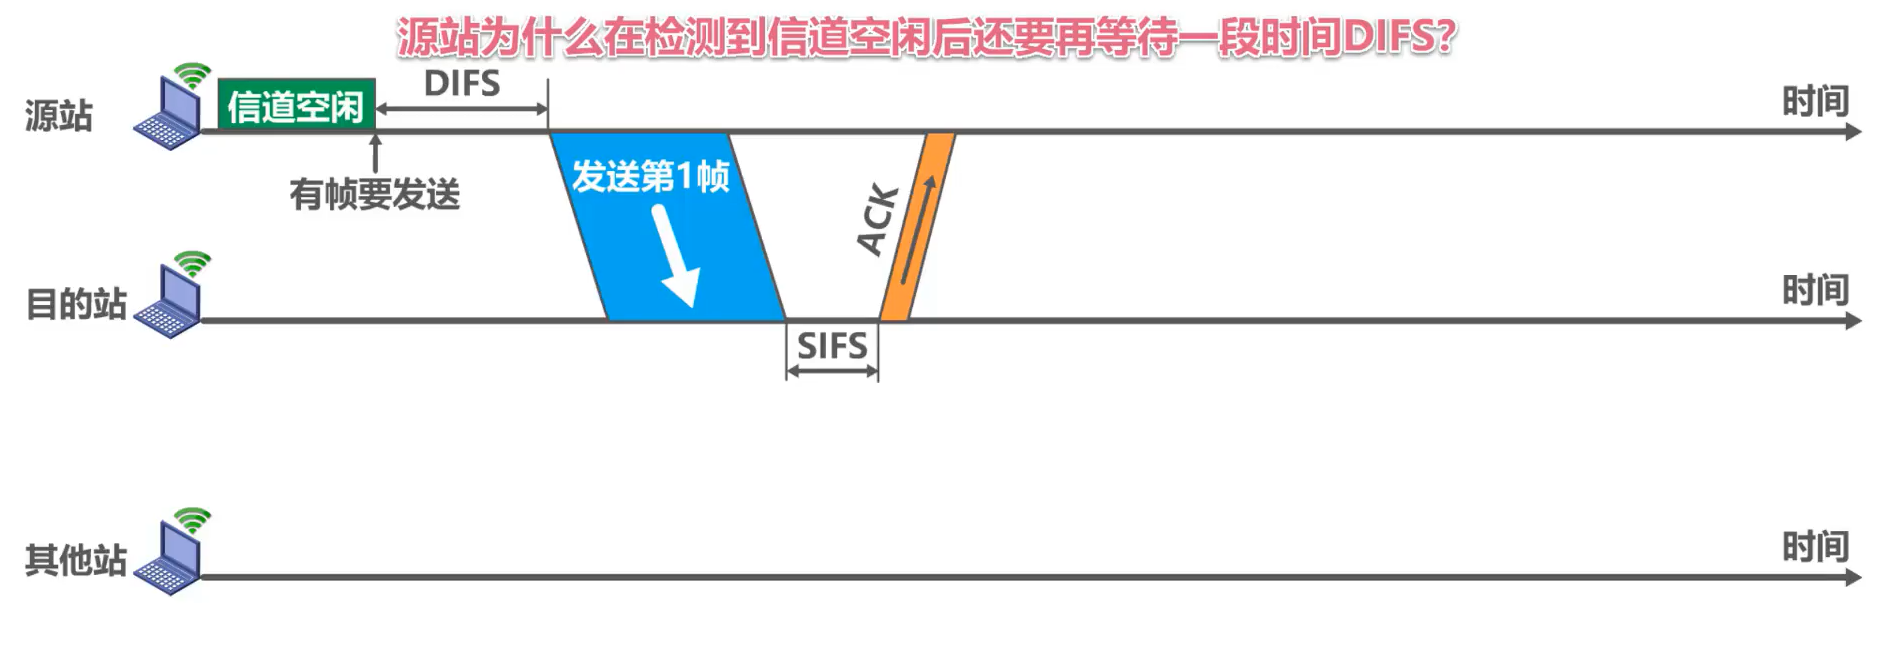
源站为什么在检测到信道空闲后还要再等待一段时间DIFS?
- 考虑到可能有其他的站有高优先级的帧要发送。若有,就要让高优先级帧先发送
目的站为什么正确接收数据帧后还要等待一段时间SIFS才能发送ACK帧?
- SIFS是最短的帧间间隔,用来分隔开属于一次对话的各帧,在这段时间内,一个站点应当能够从发送方式切换到接收方式
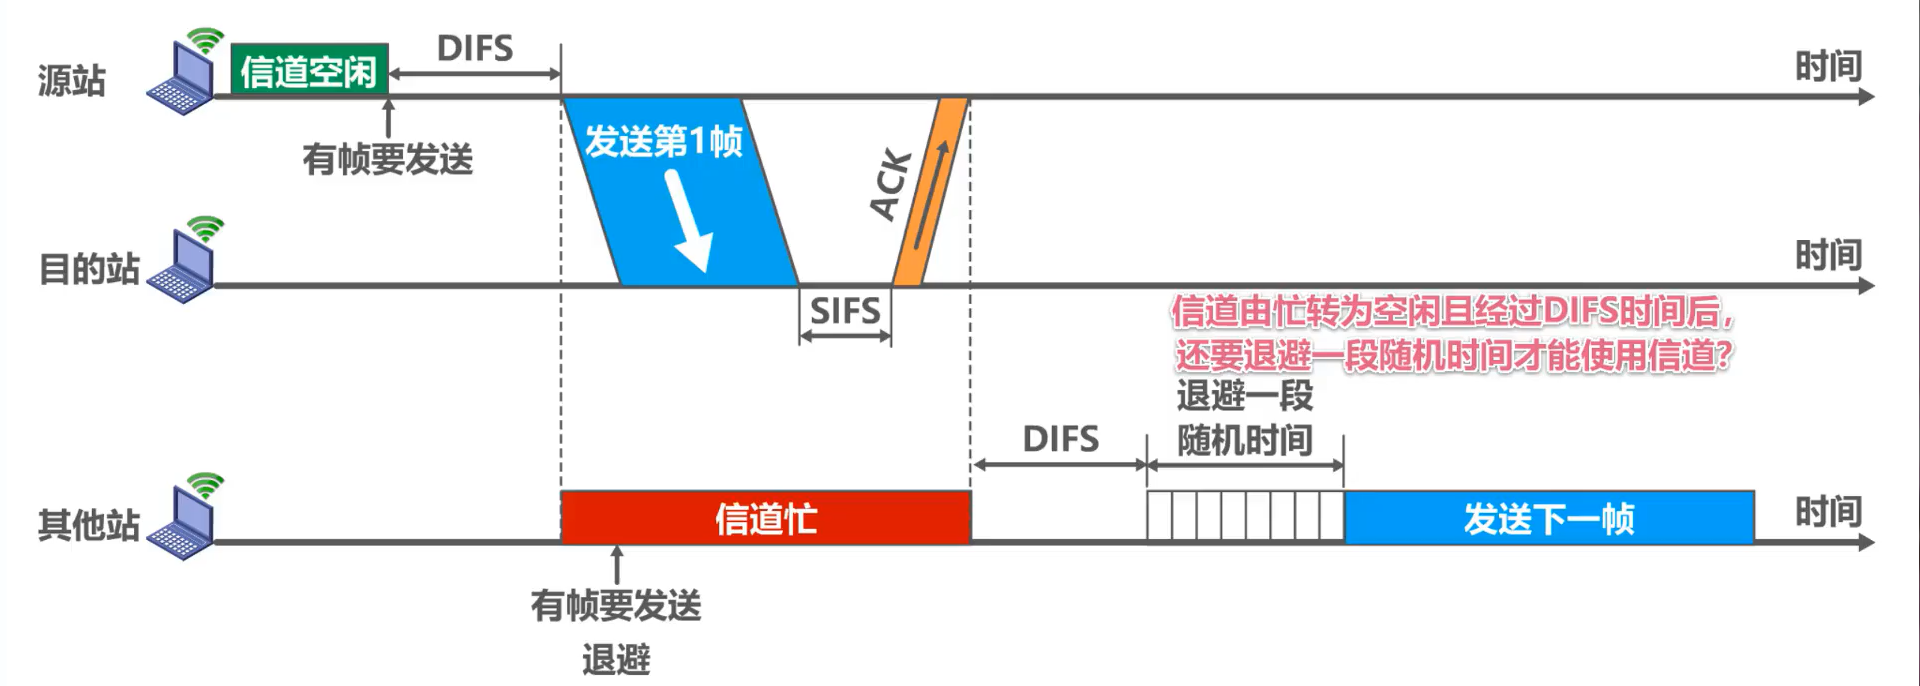
信道由忙转为空闲且经过DIFS时间后,为什么还要退避一段随机时间才能使用信道?
防止多个站点同时发送数据而产生碰撞
使用退避算法的时机:
- 当站点检测到信道是空闲的,并且所发送的数据帧不是成功发送完上一个数据帧之后立即连续发送的数据帧,则不使用退避算法。
- 以下情况必须使用退避算法:
- 在发送数据帧之前检测到信道处于忙状态时;
- 在每一次重传一个数据帧时;
- 在每一次成功发送后要连续发送下一个帧时(这是为了避免一个站点长时间占用信道)。
CSMA/CA协议的退避算法 :
- 在执行退避算法时,站点为退避计时器设置一个随机的退避时间:
- 当退避计时器的时间减小到零时,就开始发送数据;
- 当退避计时器的时间还未减小到零时而信道又转变为忙状态,这时就冻结退避计时器的数值,重新等待信道变为空闲,再经过时间DIFS后,继续启动退避计时器。
- 在进行第 i 次退避时,退避时间在时隙编号 {0,1, … , 2^2+i^-1} 中随机选择一个,然后乘以基本退避时间(也就是一个时隙的长度)就可以得到随机的退避时间。这样做是为了使不同站点选择相同退避时间的概率减少。当时隙编号达到255时(对应于第6次退避)就不再增加了。
退避算法的示例
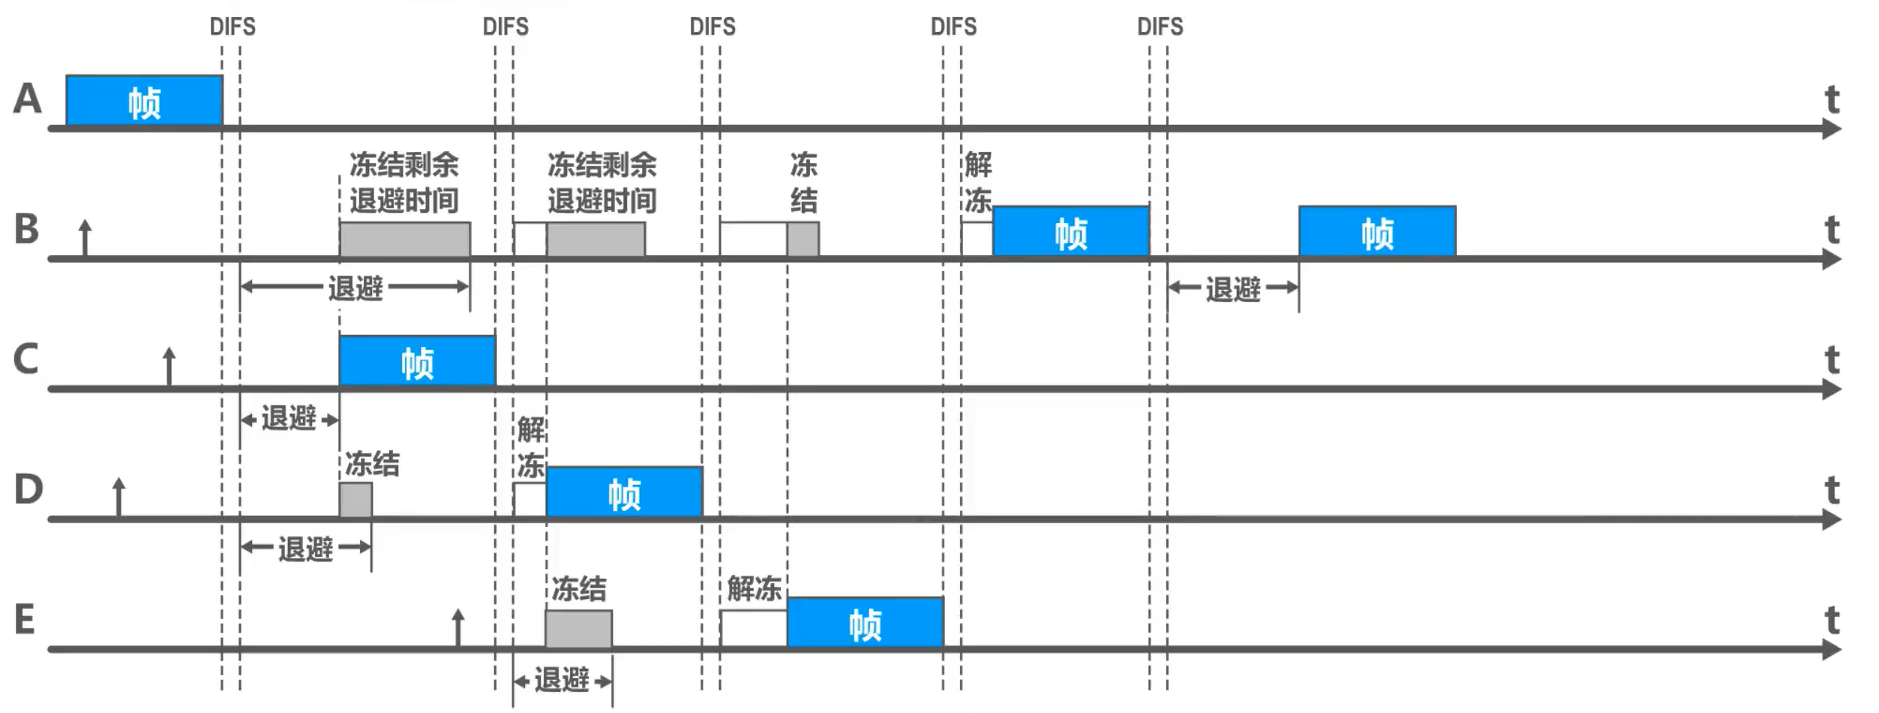
CSMA/CA协议的信道预约和虚拟载波监听 :
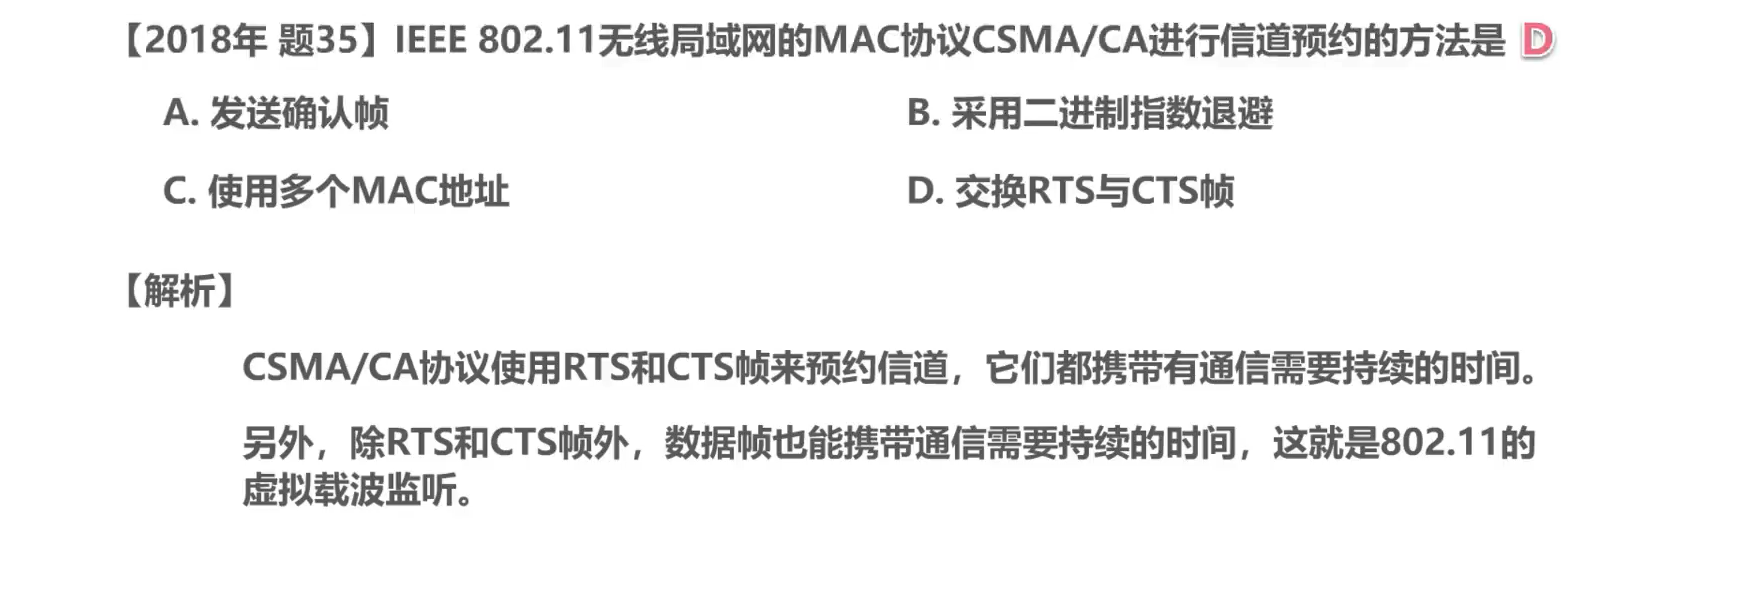
为了尽可能减少碰撞的概率和降低碰撞的影响,802.11标准允许要发送数据的站点对信道进行预约。
源站/发送站 和 目的站:
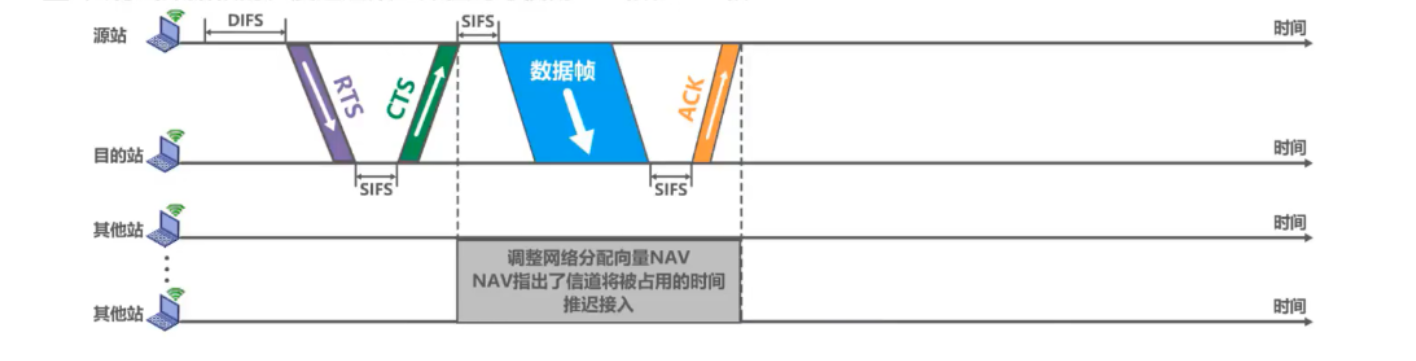
- 源站在发送数据帧之前先发送一个短的控制帧,称为请求发送RTS (Request To Send),它包括源地址、目的地址以及这次通信(包括相应的确认帧)所需的持续时间。
- 若目的站正确收到源站发来的RTS帧,且媒体空闲,就发送一个响应控制帧,称为允许发送CTS (Clear To Send),它也包括这次通信所需的持续时间(从RTS帧中将此持续时间复制到CTS帧中)。
- 源站收到CTS帧后,再等待一段时间SIFS后,就可发送其数据帧。
- 若目的站正确收到了源站发来的数据帧,在等待时间SFS后,就向源站发送确认帧ACK。
其他站:
- 除源站和目的站以外的其他各站,在收到CTS帧(或数据帧)后就推迟接入到无线局域网中。这样就保证了源站和目的站之间的通信不会受到其他站的干扰。
RTS和CTS帧的主义事项:
如果RTS帧发生碰撞,源站就收不到CTS帧,需执行退避算法重传RTS帧。
由于RTS帧和CTS帧很短,发送碰撞的概率、碰撞产生的开销及本身的开销都很小。而对于一般的数据帧,其发送时延往往大于传播时延(因为是局域网),碰撞的概率很大,且一旦发生碰撞而导致数据帧重发,则浪费的时间就很多,因此用很小的代价对信道进行预约往往是值得的。
802.11标准规定了3种情况供用户选择:
- 使用RTS帧和CTS帧
- 不使用RTS帧和CTS帧口
- 只有当数据帧的长度超过某一数值时才使用RTS帧和CTS帧
除RTS帧和CTS帧会携带通信需要持续的时间,数据帧也能携带通信需要持续的时间,这称为802.11的虚拟载波监听机制。
由于利用虚拟载波监听机制,站点只要监听到RTS帧、CTS帧或数据帧中的任何一个,就能知道信道被占用的持续时间,而不需要真正监听到信道上的信号,因此虚拟载波监听机制能减少隐蔽站带来的碰撞问题。
MAC地址、IP地址、ARP协议
数据链路层 —— MAC地址是以太网的MAC子层所使用的地址
网际层 —— IP地址是TCP/IP体系结构的网际层所使用的地址;
—— ARP协议属于TCP/IP体系结构的网际层,它通过已知设备分配到的IP地址,获取到设备的MAC地址;
MAC地址
- 使用点对点信道的数据链路层不需要使用地址
- 使用广播信道的数据链路层必须使用地址来区分各主机
广播信道的数据链路层必须使用地址(MAC):
当多个主机连接在同一个广播信道上,要想实现两个主机之间的通信,则每个主机都必须有一个唯一的标识,即一个数据链路层地址;
在每个主机发送的帧中必须携带标识发送主机和接收主机的地址。由于这类地址是
用于煤体接入控制MAC(Media Access Control),因此这类地址被称为 MAC地址;
MAC地址:
- MAC地址一般被固化在网卡(网络适配器)的电可擦可编程只读存储器EEPROM中,因此MAC地址也被称为硬件地址,有时也被称为物理地址。
一般情况下,用户主机会包含两个网络适配器:
- 有线局域网适配器(有线网卡)
- 无线局域网适配器(无线网卡)。
每个网络适配器都有一个全球唯一的MAC地址。而交换机和路由器往往拥有更多的网络接口,所以会拥有更多的MAC地址。所以严格来说,MAC地址是对网络上各接口的唯一标识,而不是对网络上各设备的唯一标识。
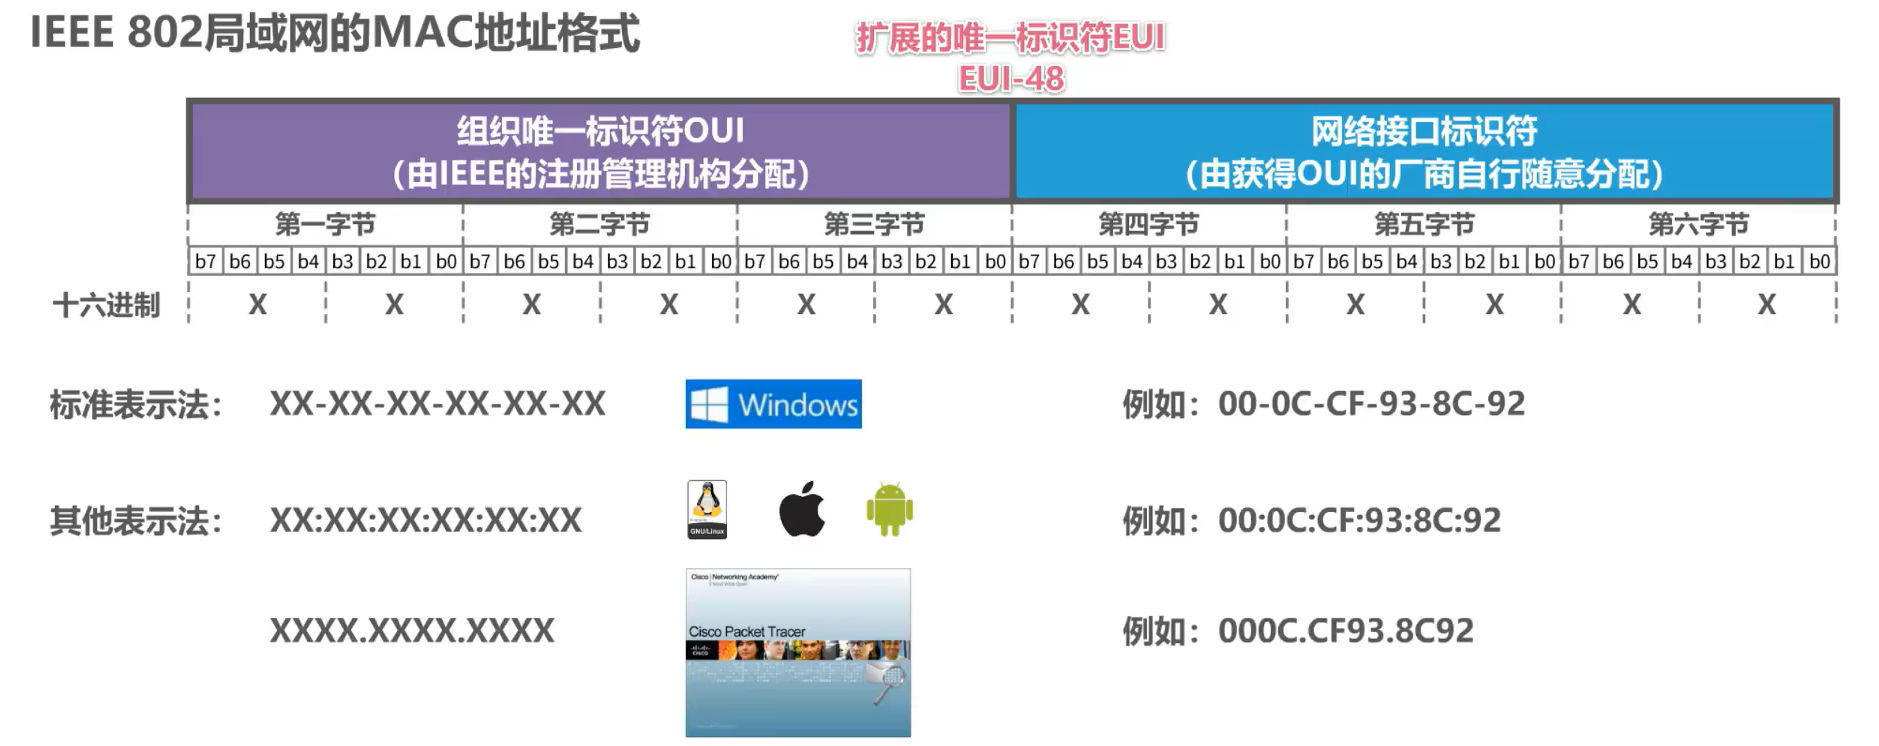
IEEE 802局域网的MAC地址格式:
拓展的唯一标识符 EUI-48 (48是这个MAC地址的位数)
组织唯一标识符OUI
生产网络设备的厂商,需要向IEEE的注册管理机构申请一个或多个OUI
网络接口标识符
由获得OUI的厂商自行随意分配
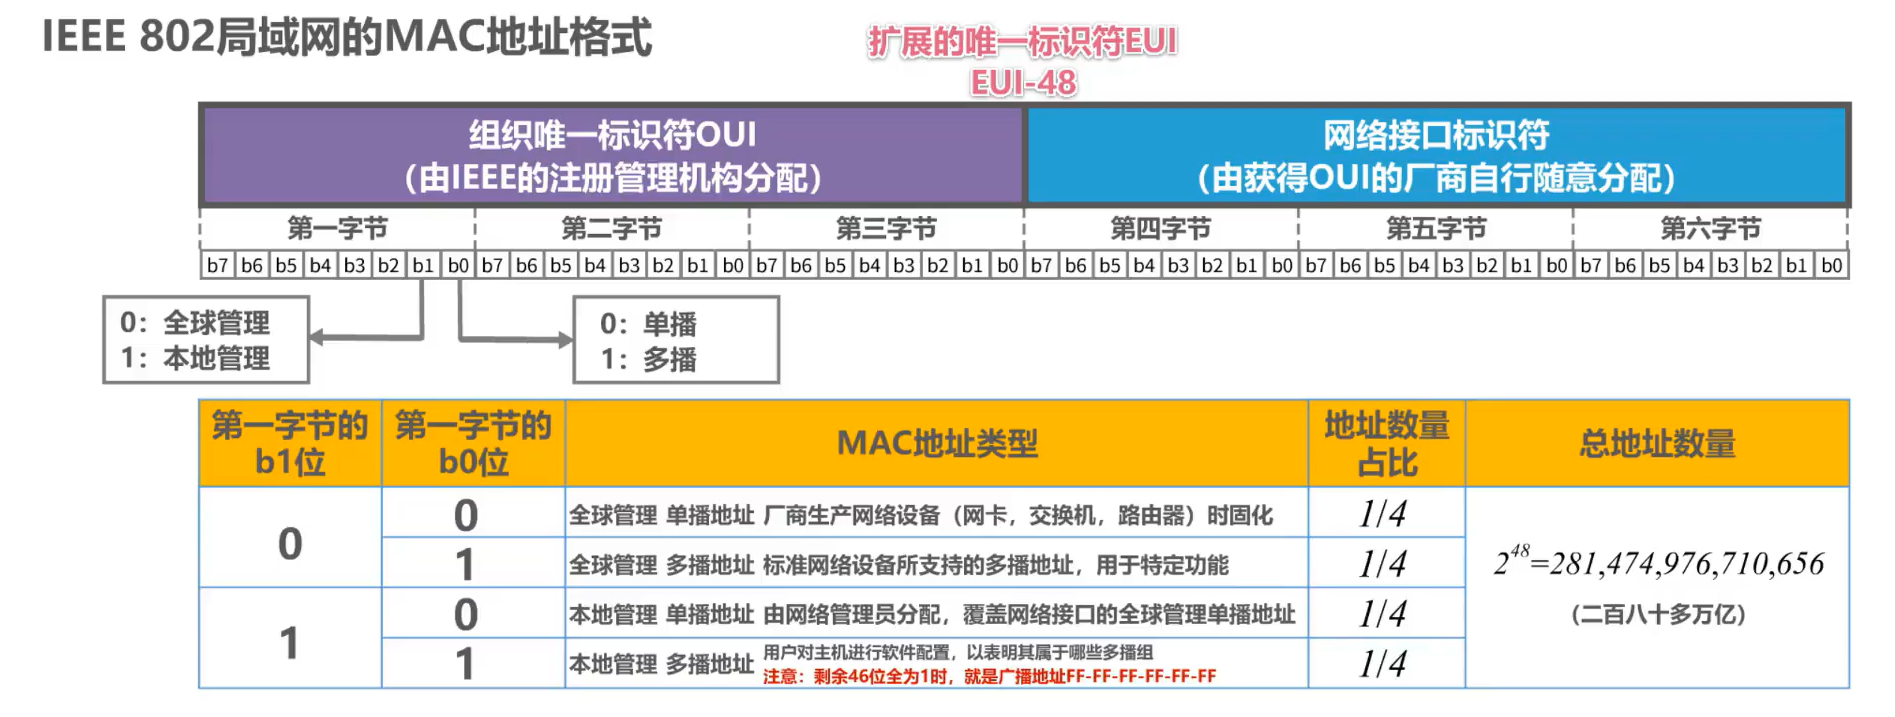
对于使用EUI-48空间的应用程序,IEEE的目标寿命为100年(直到2080年),但是鼓励采用EUI-64作为替代
关于无效的 MAC 帧
- 数据字段的长度与长度字段的值不一致;
- 帧的长度不是整数个字节;
- 用收到的帧检验序列 FCS 查出有差错;
- 数据字段的长度不在 46 ~ 1500 字节之间。
- 有效的 MAC 帧长度为 64 ~ 1518 字节之间。
对于检查出的无效 MAC 帧就简单地丢弃。以太网不负责重传丢弃的帧。
单播MAC地址举例
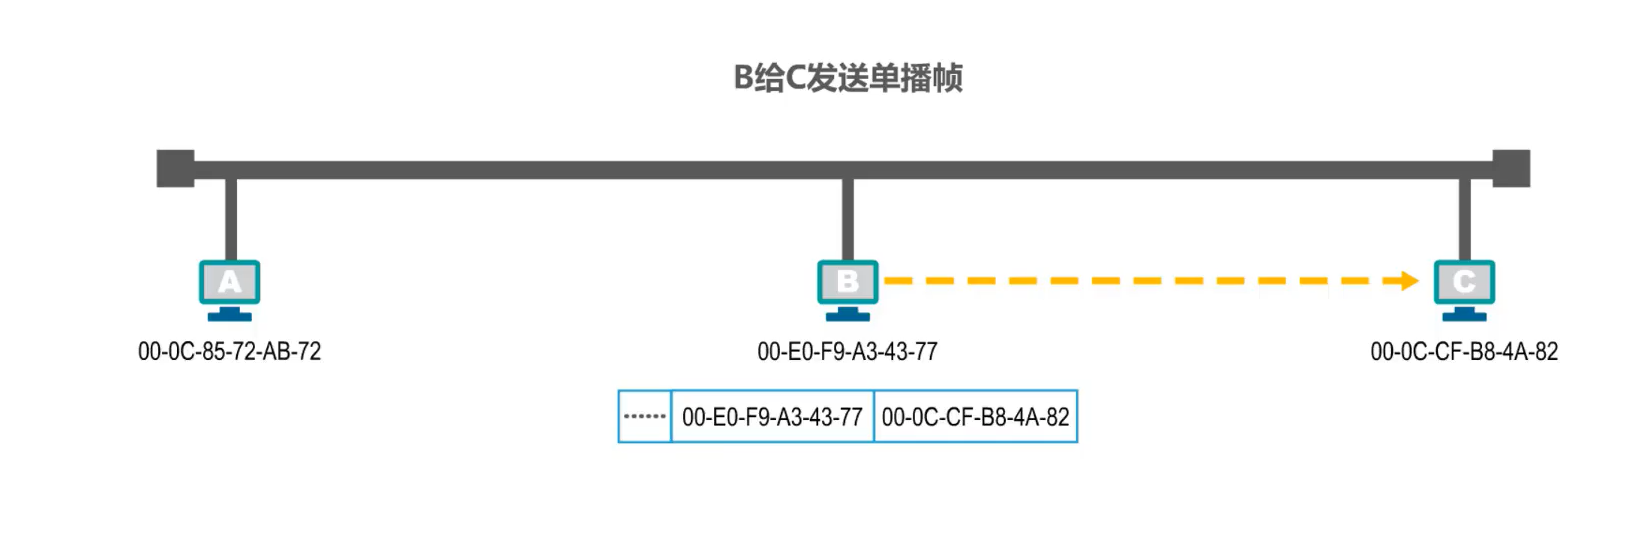
主机B给主机C发送单播帧,主机B首先要构建该单播帧,在帧首部中的目的地址字段填入主机C的MAC地址,源地址字段填入自己的MAC地址,再加上帧首部的其他字段、数据载荷以及帧尾部,就构成了该单播帧
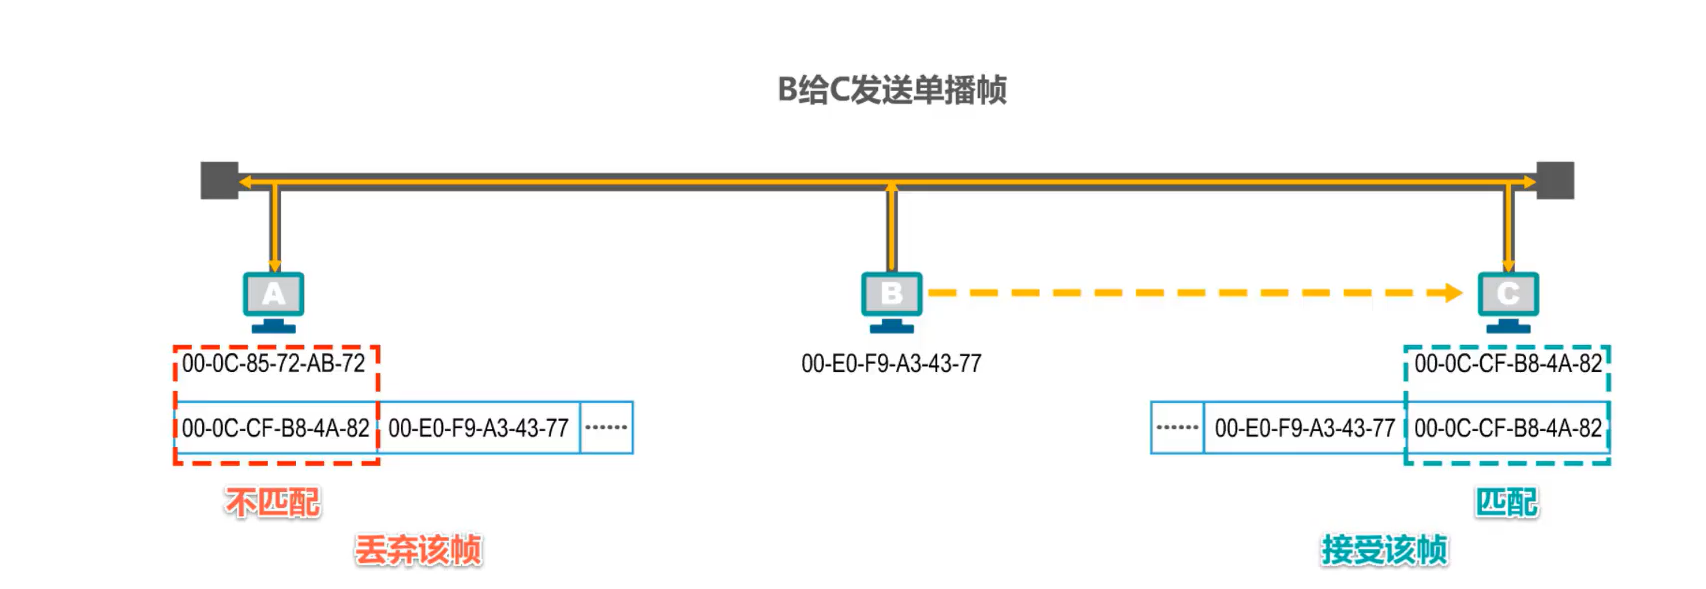
主机B将该单播帧发送出去,主机A和C都会收到该单播帧
主机A的网卡发现该单播帧的目的MAC地址与自己的MAC地址不匹配,丢弃该帧
主机C的网卡发现该单播帧的目的MAC地址与自己的MAC地址匹配,接受该帧
并将该帧交给其上层处理
广播MAC地址举例
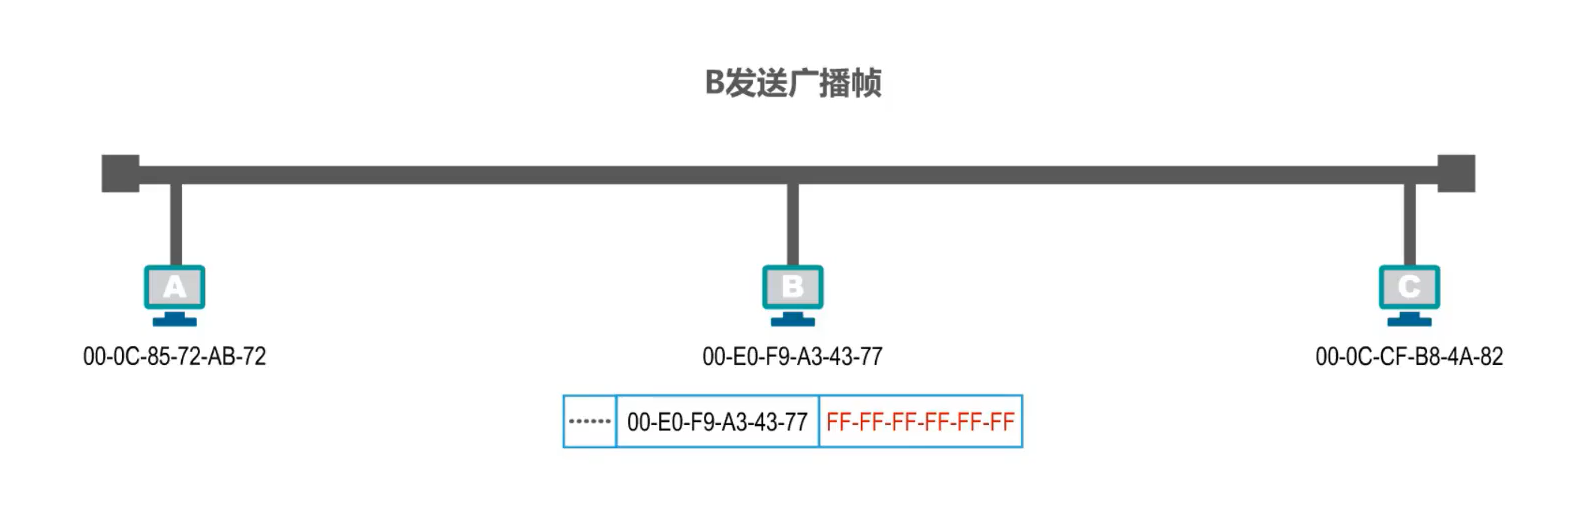
假设主机B要发送一个广播帧,主机B首先要构建该广播帧,在帧首部中的目的地址字段填入广播地址,也就是十六进制的全F,源地址字段填入自己的MAC地址,再加上帧首部中的其他字段、数据载荷以及帧尾部,就构成了该广播帧
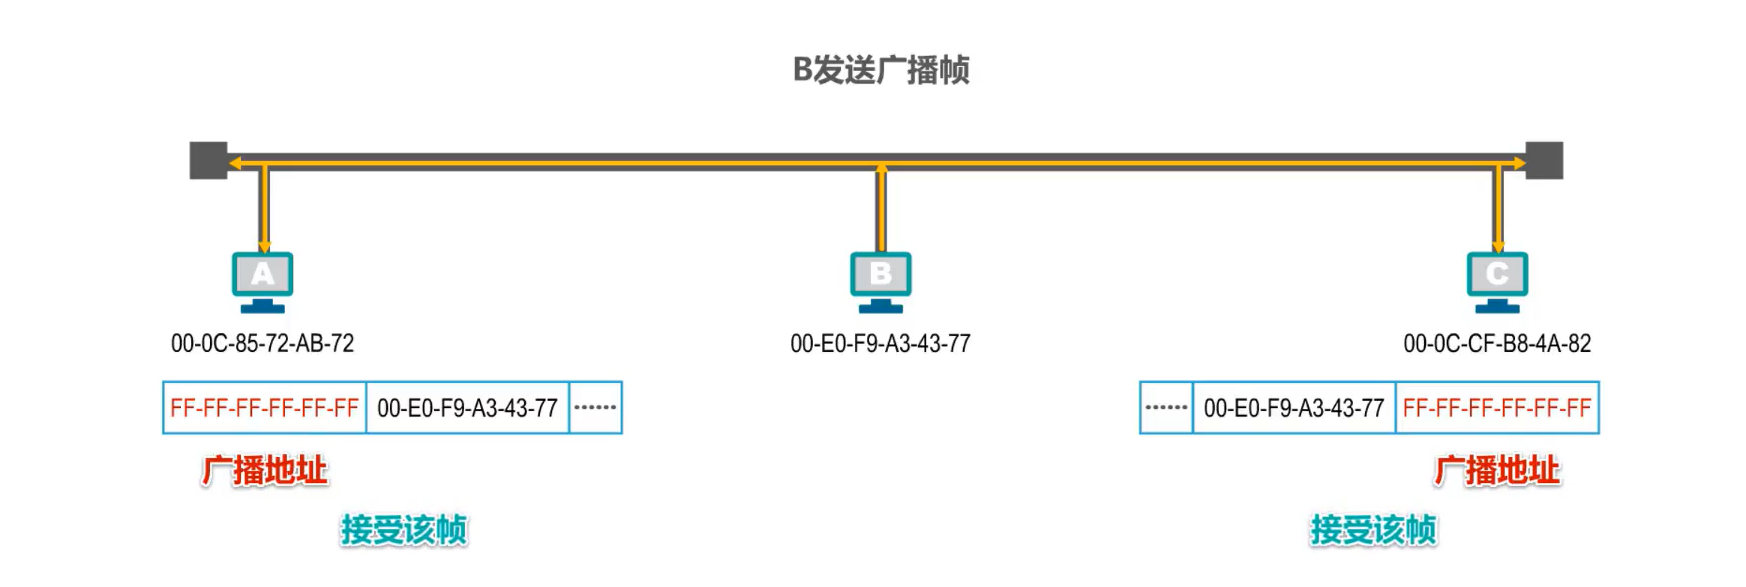
主机B讲该广播帧发送出去,主机A和C都会收到该广播帧,发现该帧首部中的目的地址字段的内容是广播地址,就知道该帧是广播帧,主机A和主机C都接受该帧,并将该帧交给上层处理
多播MAC地址举例
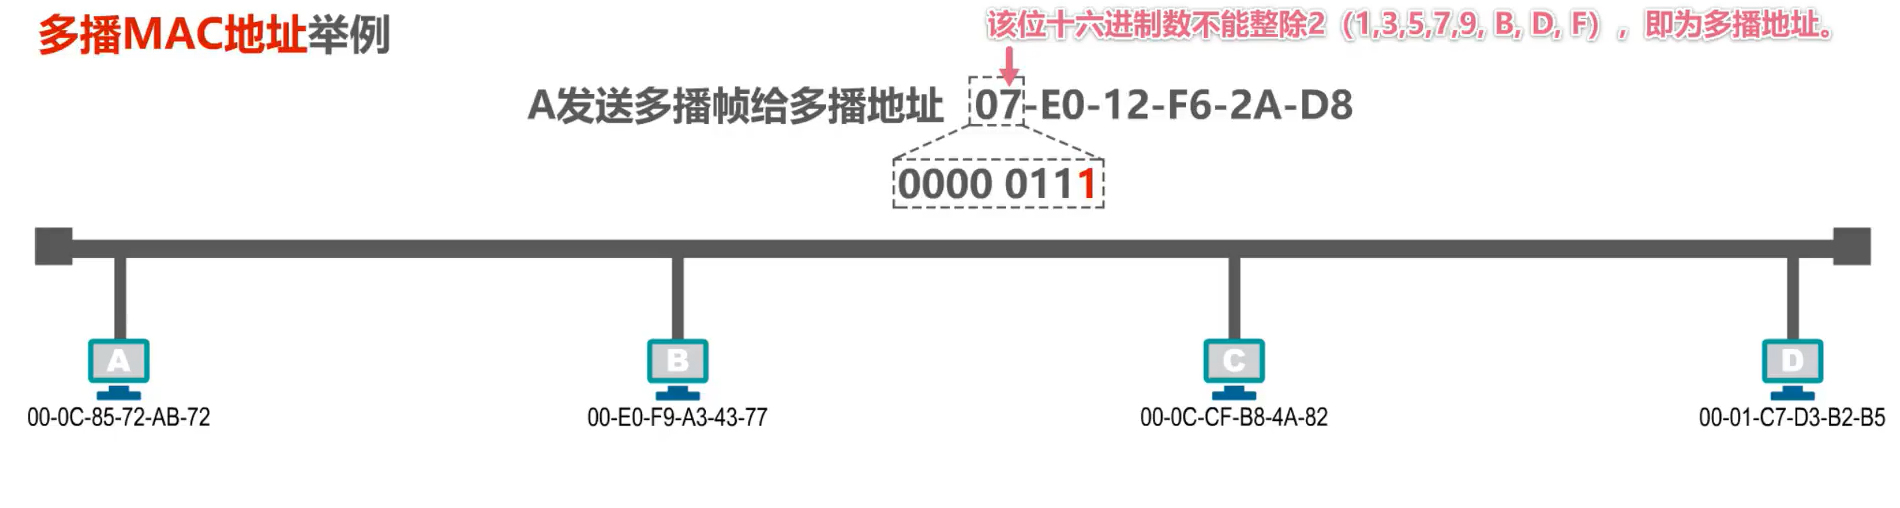
假设主机A要发送多播帧给该多播地址。将该多播地址的左起第一个字节写成8个比特,第一个字节的最低比特位是1,这就表明该地址是多播地址。
快速判断地址是不是多播地址,就是第一个字节的第十六进制数不能整除2(即为1,3,5,7,9,B,D,F),则该地址是多播地址
假设主机B,C和D支持多播,各用户给自己的主机配置多播组列表如下所示
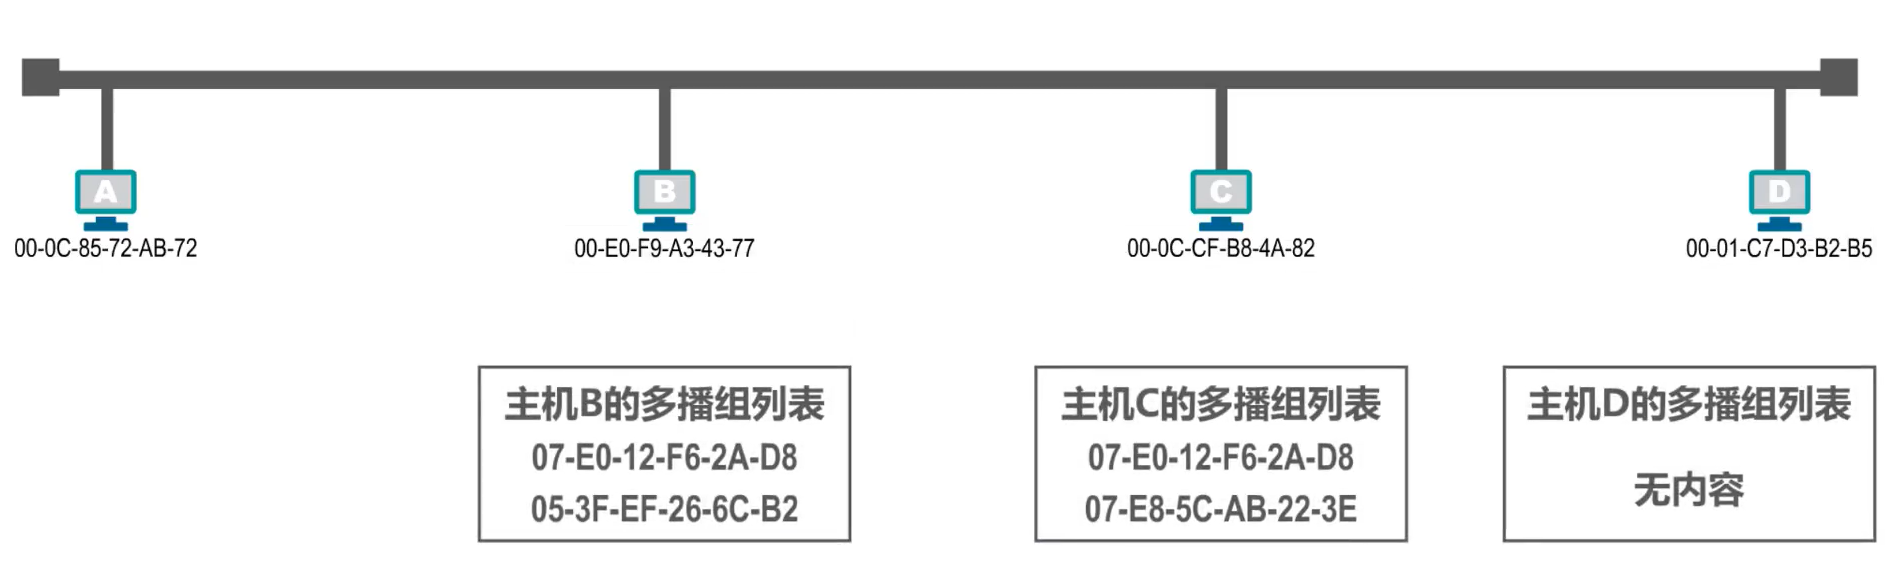
主机B属于两个多播组,主机C也属于两个多播组,而主机D不属于任何多播组
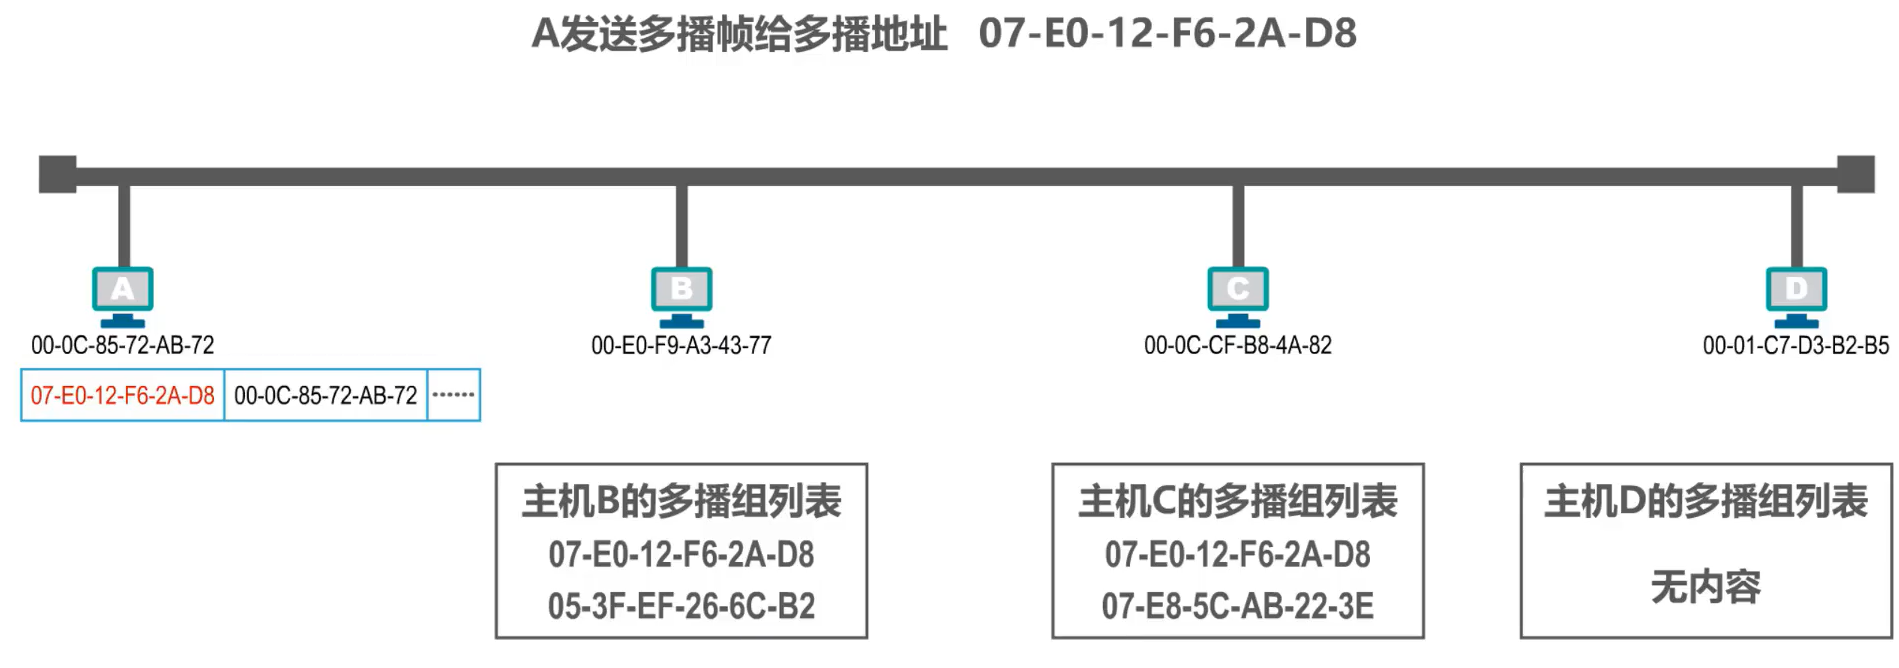
主机A首先要构建该多播帧,在帧首部中的目的地址字段填入该多播地址,源地址点填入自己的MAC地址,再加上帧首部中的其他字段、数据载荷以及帧尾部,就构成了该多播帧
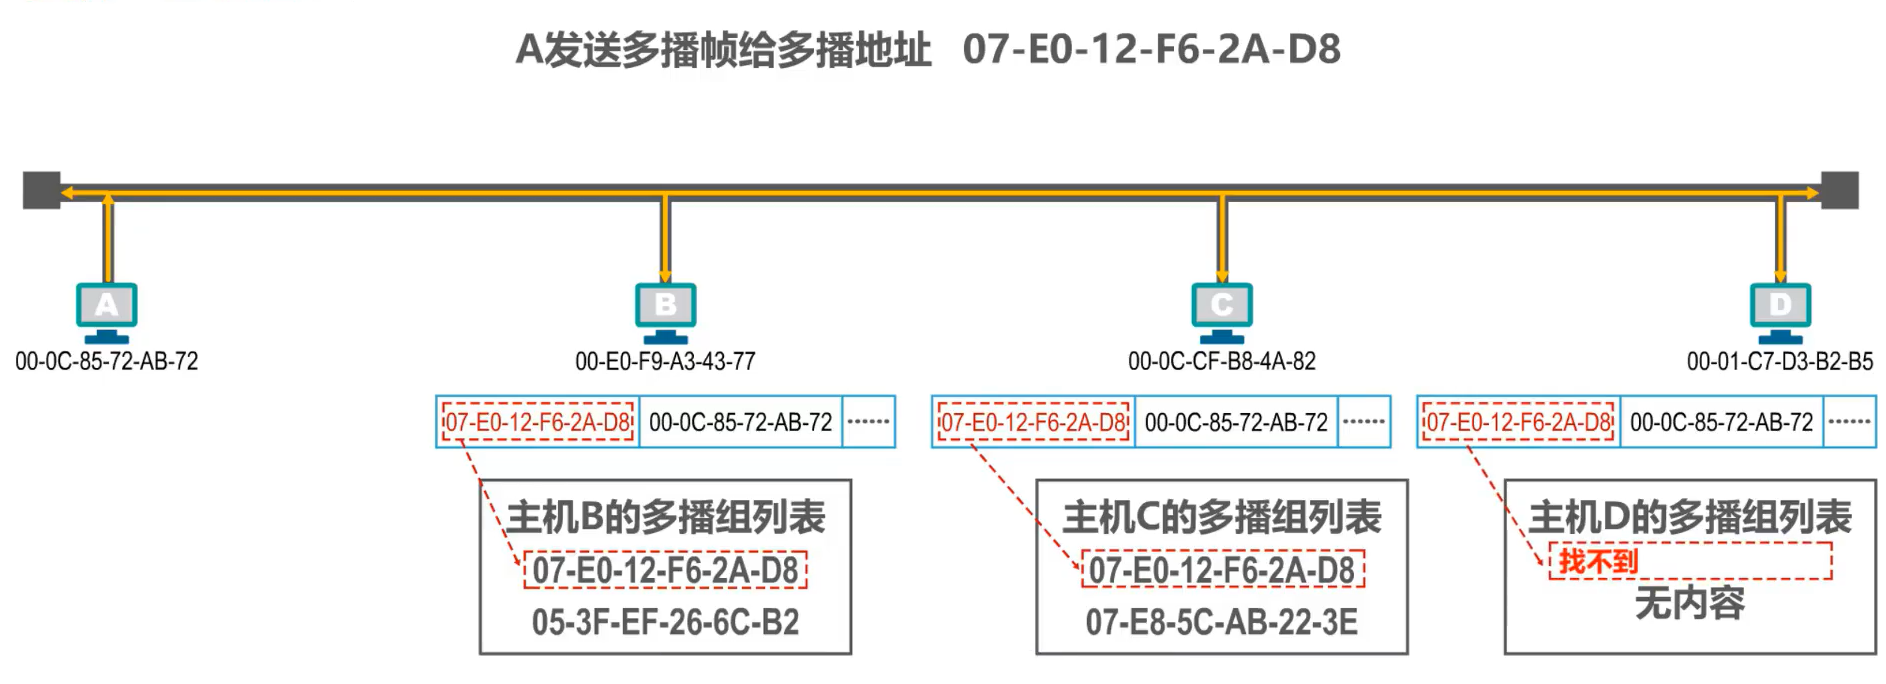
主机A将该多播帧发送出去,主机B、C、D都会收到该多播帧
主机B和C发现该多播帧的目的MAC地址在自己的多播组列表中,主机B和C都会接受该帧
主机D发现该多播帧的目的MAC地址不在自己得多播组列表中,则丢弃该多播帧
给主机配置多播组列表进行私有应用时,不得使用公有的标准多播地址
IP地址
IP地址属于网络层的范畴,不属于数据链路层的范畴
下面内容讲的是IP地址的使用,详细的IP地址内容在网络层中介绍
基本概念
IP地址是因特网(Internet)上的主机和路由器所使用的地址,用于标识两部分信息:
- 网络编号:标识因特网上的网络;
- 主机编号:标识同一网络上的不同主机(或路由器各接口)
MAC地址不具有区分不同网络的功能,如果只是单独的网络,不接入因特网,可以只用MAC地址;
如果主机所在网络需要接入因特网,则 IP地址和MAC地址都要用。
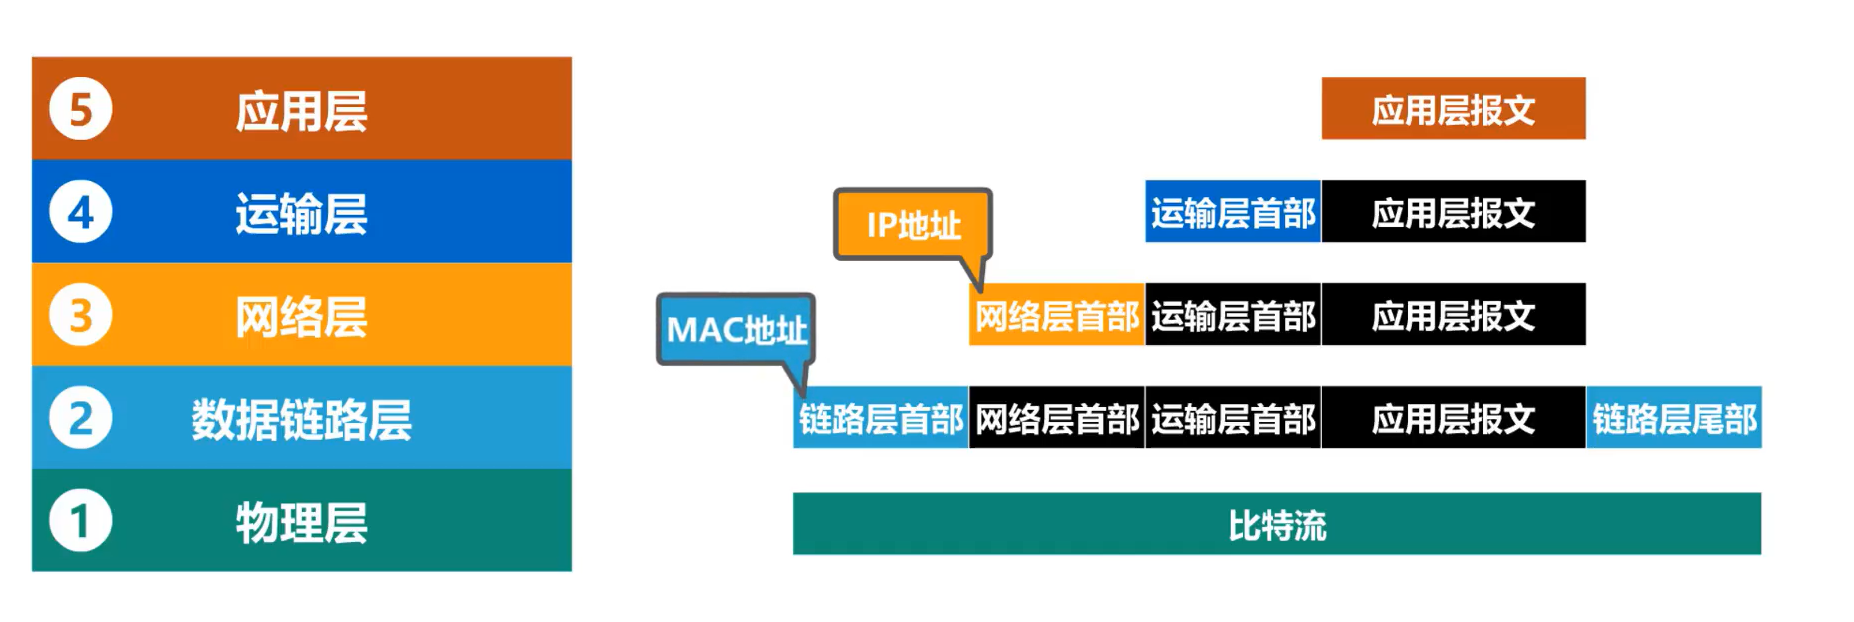
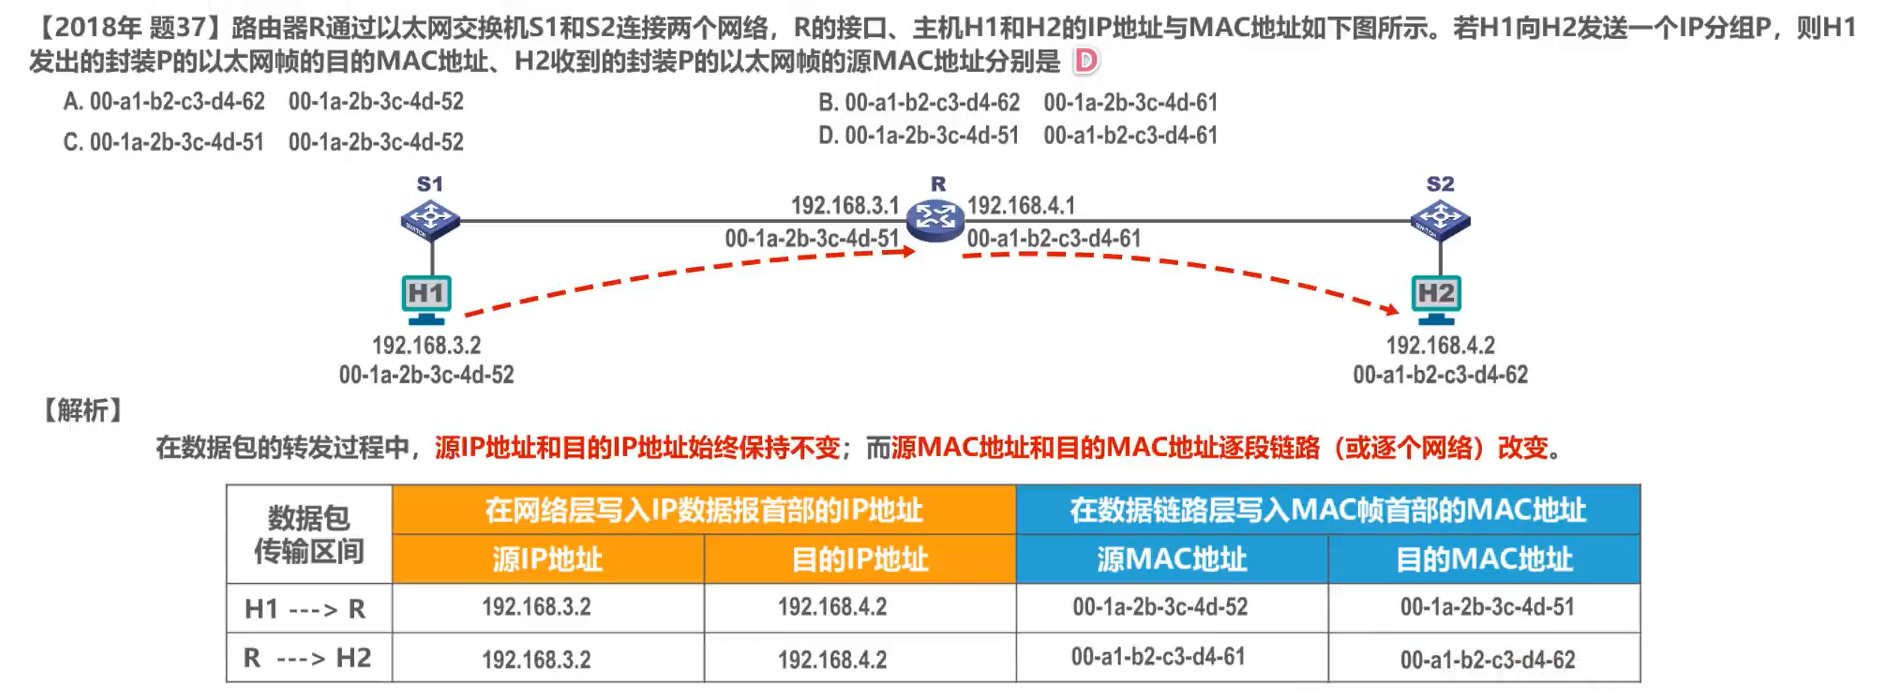
数据包转发过程中IP地址与MAC地址的变化情况:
- 数据包转发过程中,源IP地址和目的IP地址不变, 源MAC地址和目的MAC地址随着链路(或网络)更换而改变。
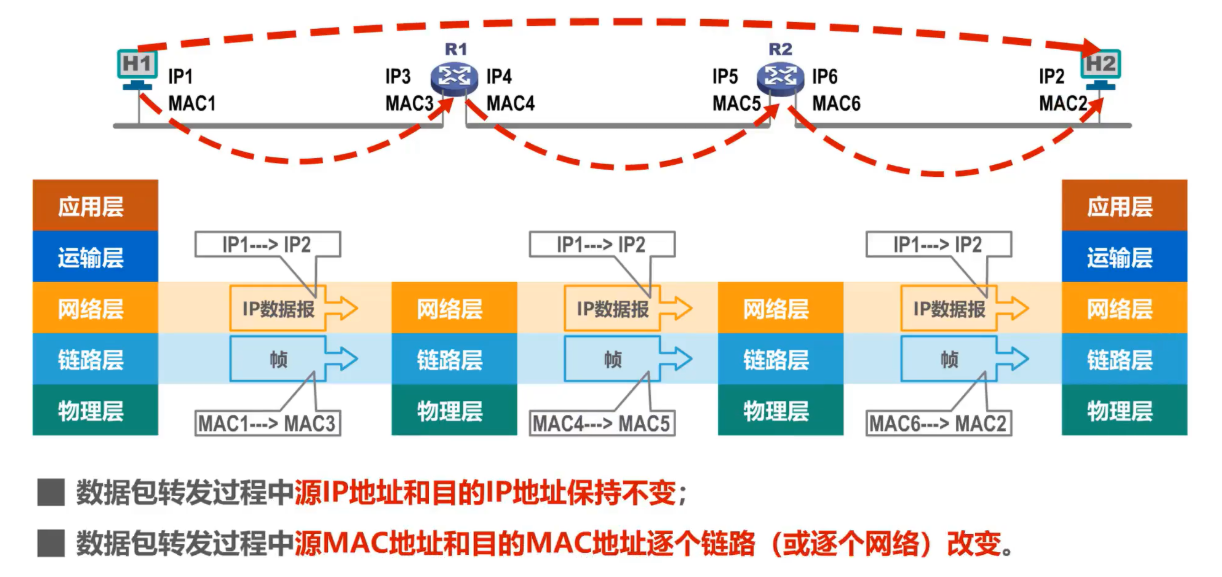
如何从IP地址找出其对应的MAC地址?
- 使用ARP协议
ARP协议
ARP协议(地址解析协议),可以通过IP地址找出其对应的MAC地址。
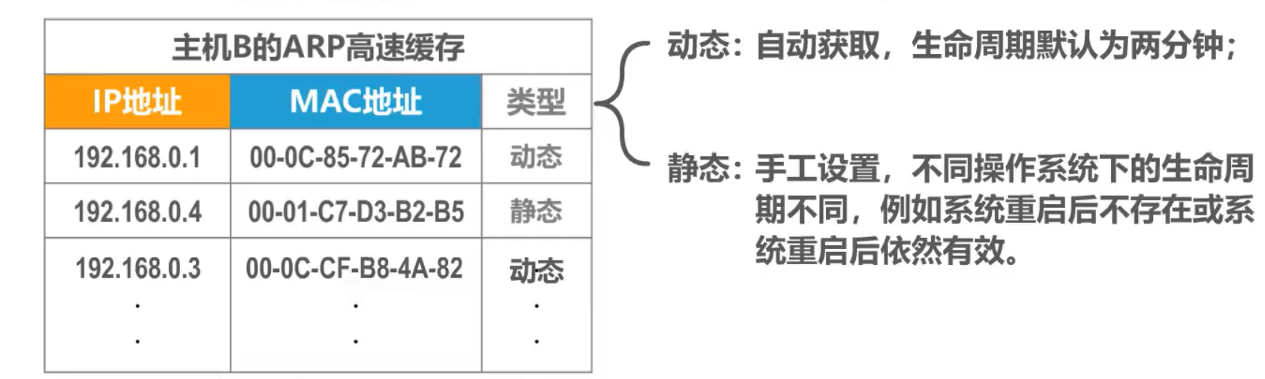
- 各主机有各自的 ARP高速缓存表,用于记录其他主机IP地址所对应的MAC地址;
- 如果缓存表中没有记录,则可以通过广播询问,目标主机收到广播,会将发送方的IP和MAC地址记到ARP缓存表中,并给对方 发送ARP响应应。
ARP高速缓存表
- 动态记录:自动获取,生命周期为2分钟;
- 静态记录:手工设置,不同操作系统下的生命周期不同。
注意:ARP只能在一段链路/一段网络上使用,不能跨网络使用。
流程
ARP高速缓存表
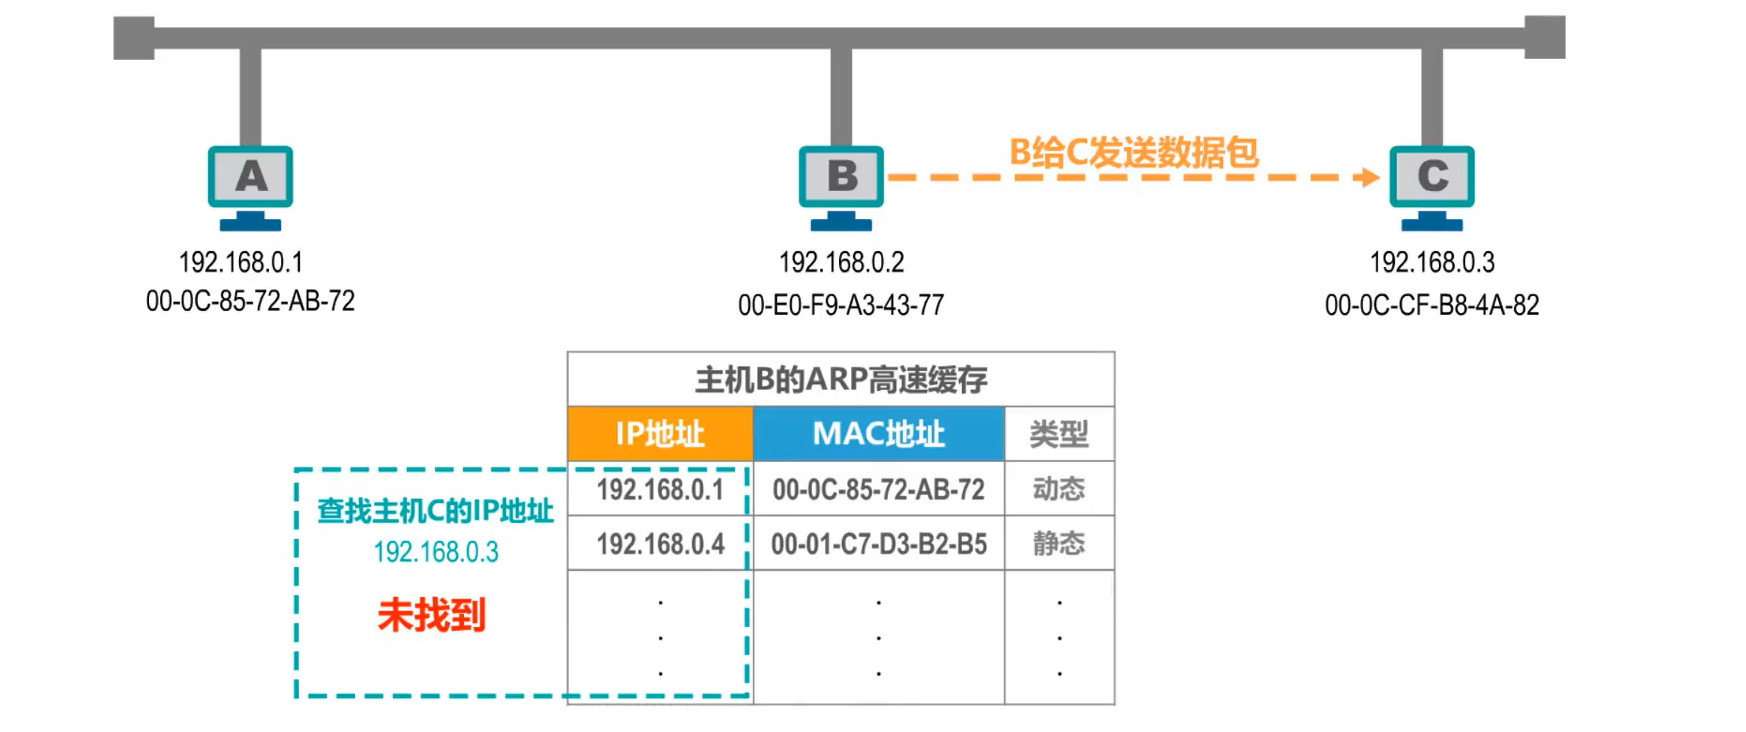
当主机B要给主机C发送数据包时,会首先在自己的ARP高速缓存表中查找主机C的IP地址所对应的MAC地址,但未找到,因此,主机B需要发送ARP请求报文,来获取主机C的MAC地址
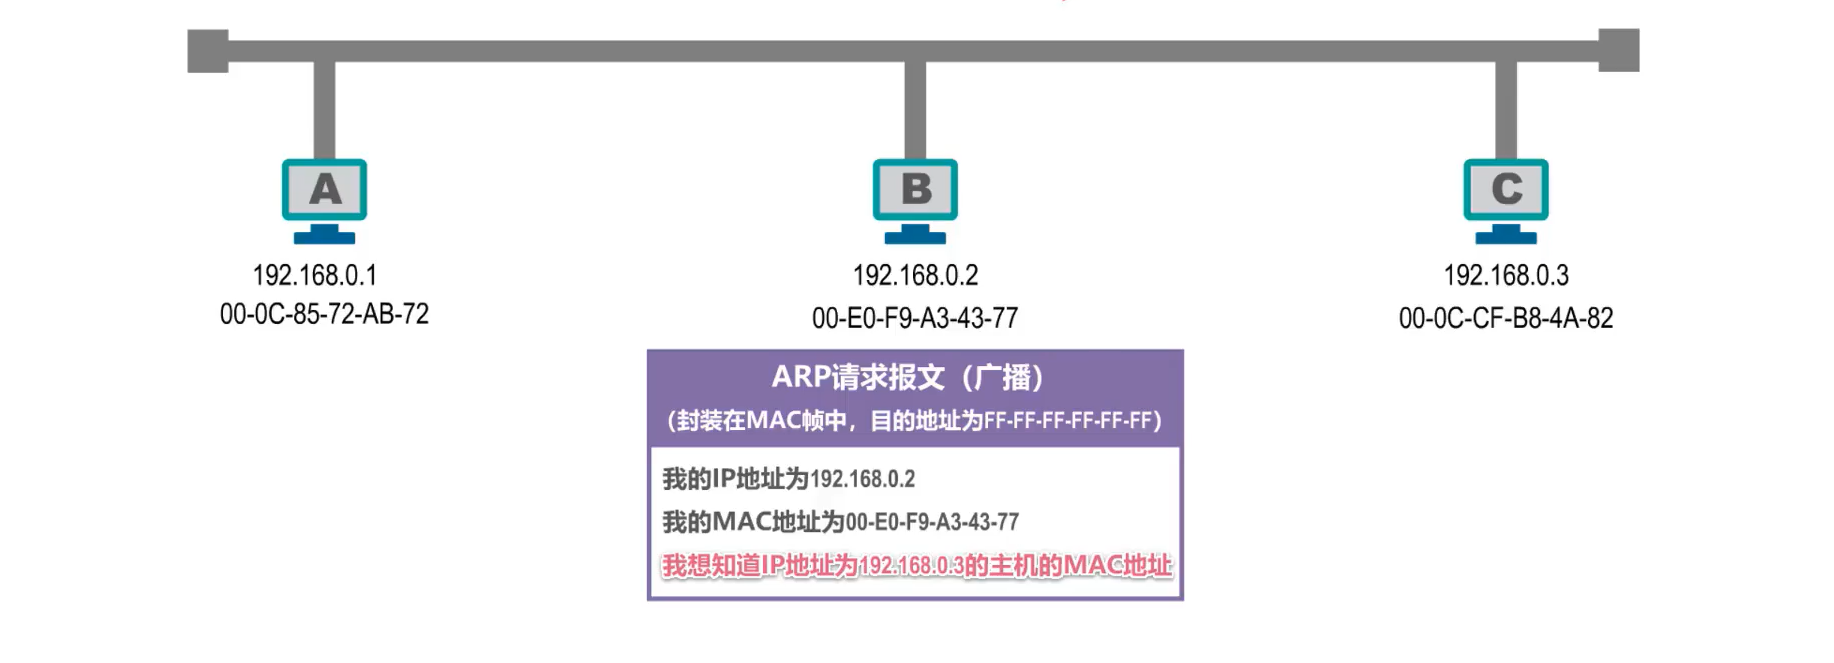
ARP请求报文被封装在MAC帧中发送,目的地址为广播地址
主机B发送封装有ARP请求报文的广播帧,总线上的其他主机都能收到该广播帧
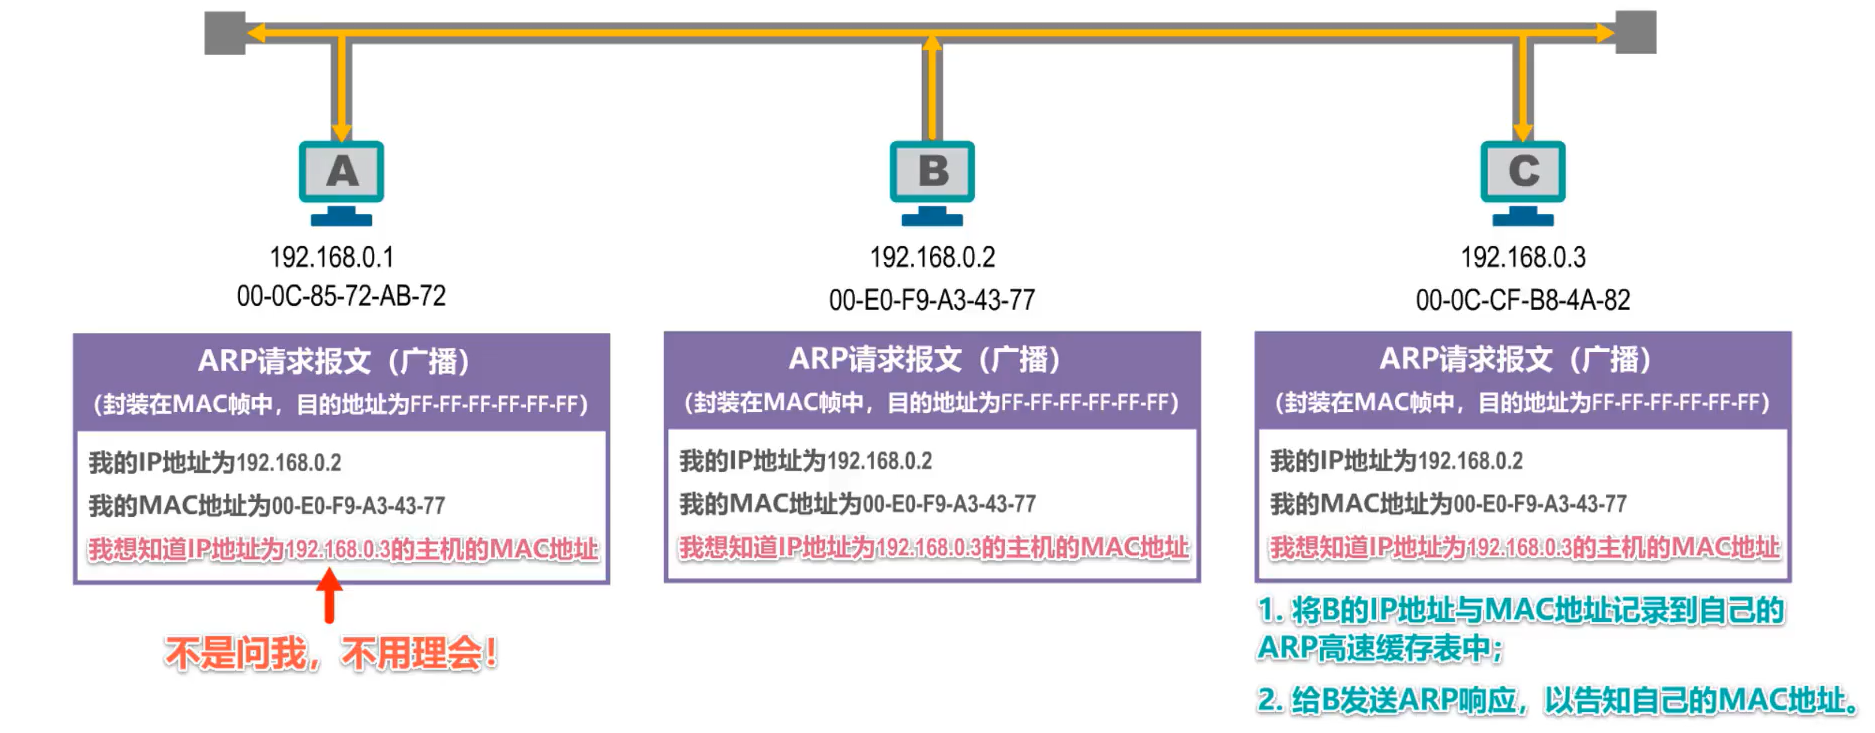
收到ARP请求报文的主机A和主机C会把ARP请求报文交给上层的ARP进程
主机A发现所询问的IP地址不是自己的IP地址,因此不用理会
主机C发现所询问的IP地址是自己的IP地址,需要进行处理:将B的IP地址与MAC地址记录到自己的高速缓存表中,然后给B发送ARP响应,告知自己的MAC地址。
动态与静态的区别
ARP协议只能在一段链路或一个网络上使用,而不能跨网络使用
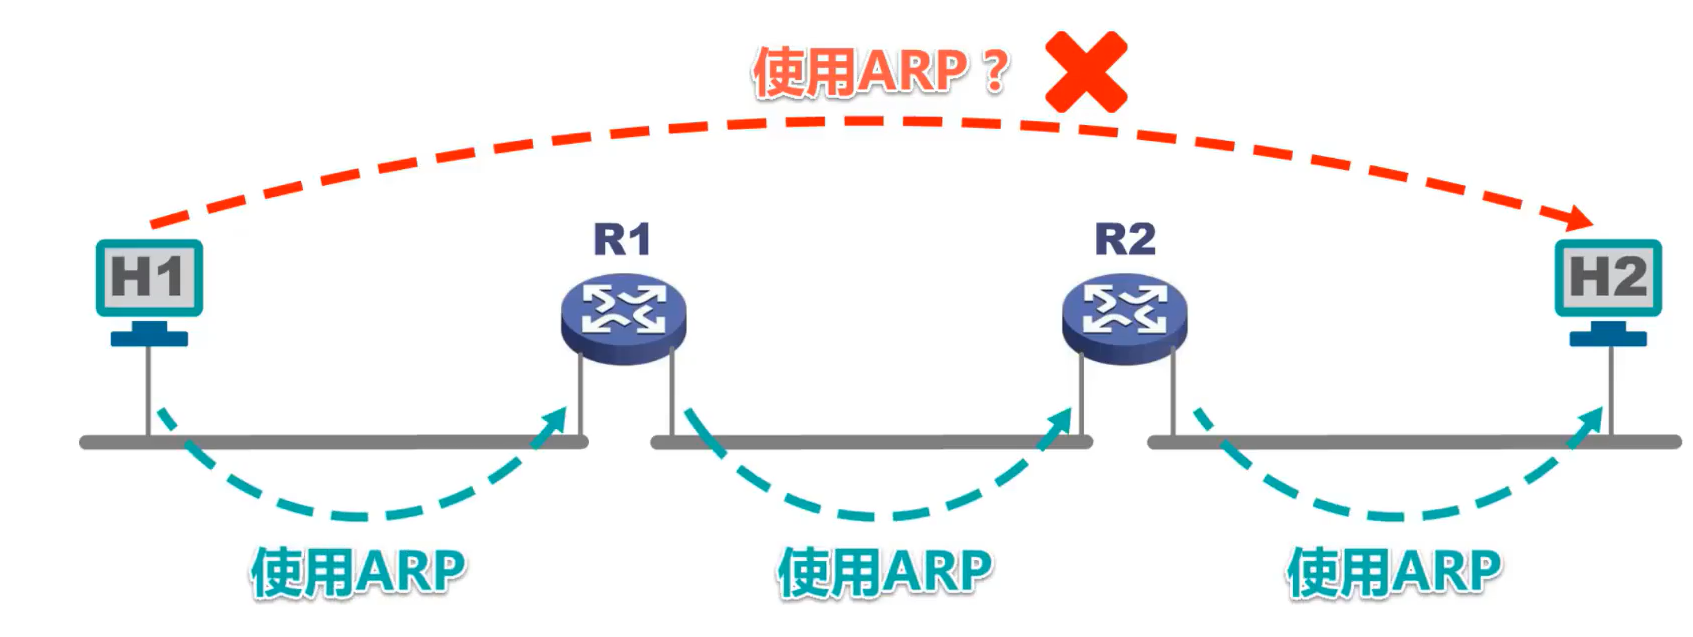
ARP协议的使用是逐段链路进行的
总结
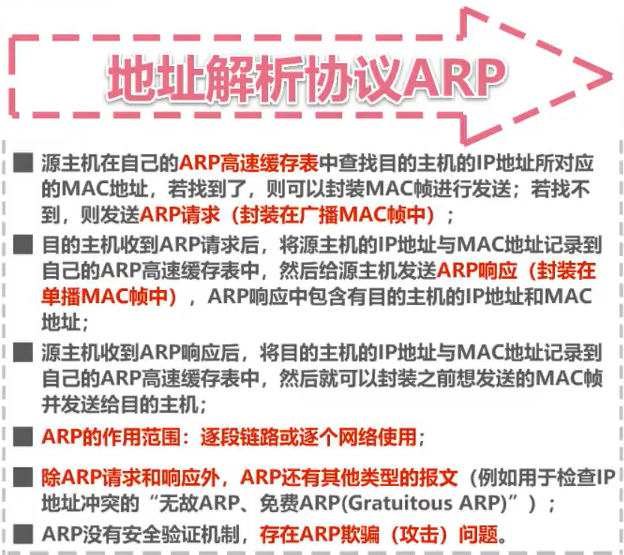
ARP表中的IP地址与MAC地址的对应关系记录,是会定期自动删除的,因为IP地址与MAC地址的对应关系不是永久性的
集线器与以太网交换机
集线器HUB
- 传统以太网最初是使用粗同轴电缆,后来演进到使用比较便宜的细同轴电缆,最后发展为使用更便宜和更灵活的双绞线。
- 采用双绞线的以太网采用星形拓扑,在星形的中心则增加了一种可靠性非常高的设备,叫做集线器 (hub)。
- 集线器只工作在物理层,它的每个端口仅简单地转发比特,不进行碰撞检测(由各站的网卡检测)。
- 集线器是也可以看做多口中继器,每个端口都可以成为一个中继器,中继器是对减弱的信号进行放大和发送的设备
- 集线器的以太网在逻辑上仍是个总线网,需要使用CSMA/CD协议来协调各主机争用总线,只能工作在半双工模式,收发帧不能同时进行。
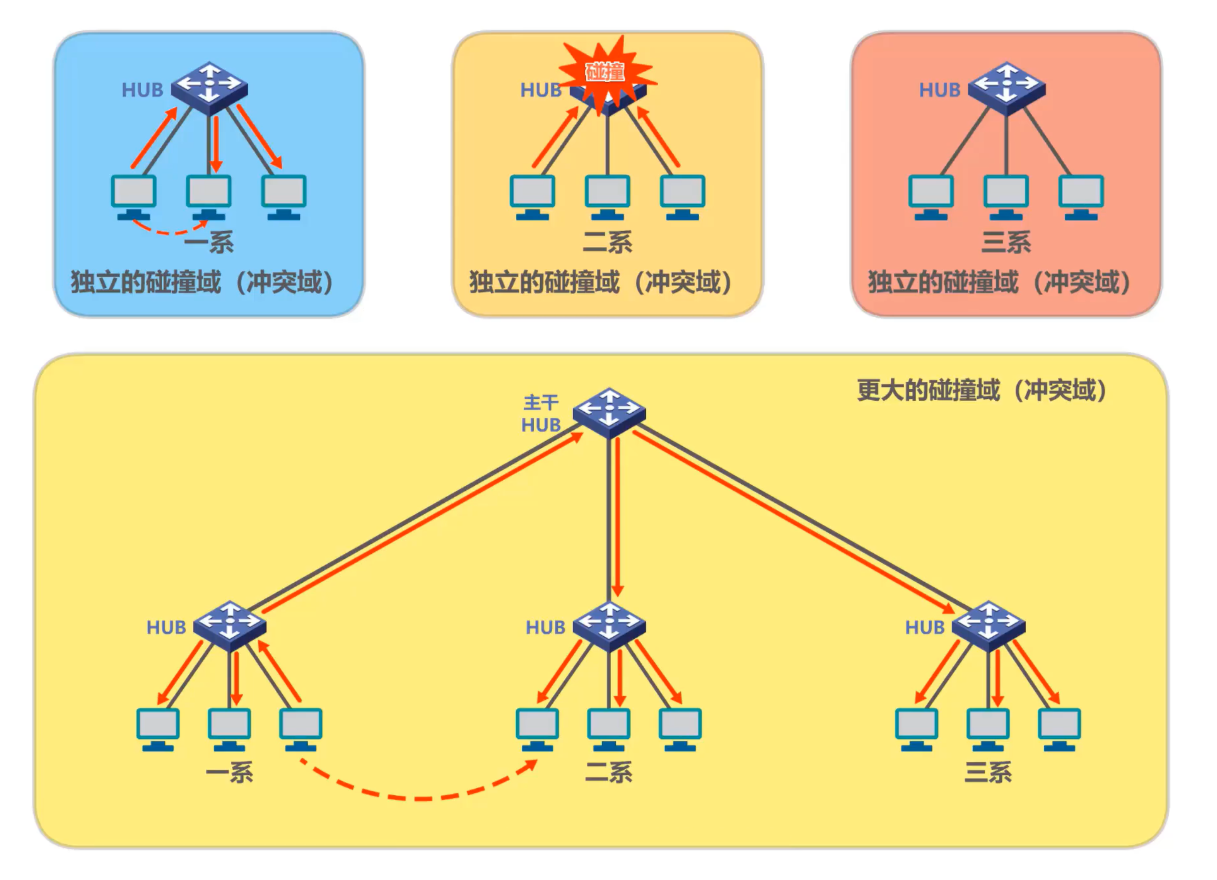
使用集线器HUB 在物理层扩展以太网: 将多个以太网段连成更大的、多级星形结构的以太网
- 优点
- 使原来属于不同碰撞域的以太网上的计算机能够进行跨碰撞域的通信。
- 扩大了以太网覆盖的地理范围。
- 缺点
- 碰撞域增大了,但总的吞吐量并未提高。
- 如果不同的碰撞域使用不同的数据率,那么就不能用集线器将它们互连起来。
碰撞域
- 碰撞域(collision domain)又称为冲突域,是指网络中一个站点发出的帧会与其他站点发出的帧产生碰撞或冲突的那部分网络。
- 碰撞域越大,发生碰撞的概率越高
以太网交换机switch
- 扩展以太网更常用的方法是在数据链路层进行。
- 早期使用网桥,现在使用以太网交换机。
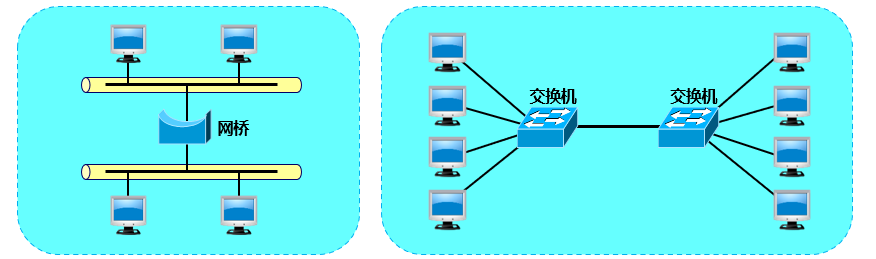
网桥
- 网桥工作在数据链路层。
- 它根据 MAC 帧的目的地址对收到的帧进行转发和过滤。
- 当网桥收到一个帧时,并不是向所有的接口转发此帧,而是先检查此帧的目的MAC 地址,然后再确定将该帧转发到哪一个接口,或把它丢弃。
交换机
- 1990 年问世的交换式集线器 (switching hub) 可明显地提高以太网的性能。
- 交换式集线器常称为以太网交换机 (switch) 或第二层交换机 (L2 switch),强调这种交换机工作在数据链路层。
- 以太网交换机实质上就是一个多接口的网桥,每个接口可与一台主机或另一个交换机相连,一般工作在全双工方式。
- 具有并行性,能同时连通多对接口,使多对主机能同时通信,无碰撞(不使用CSMA/CD协议)。
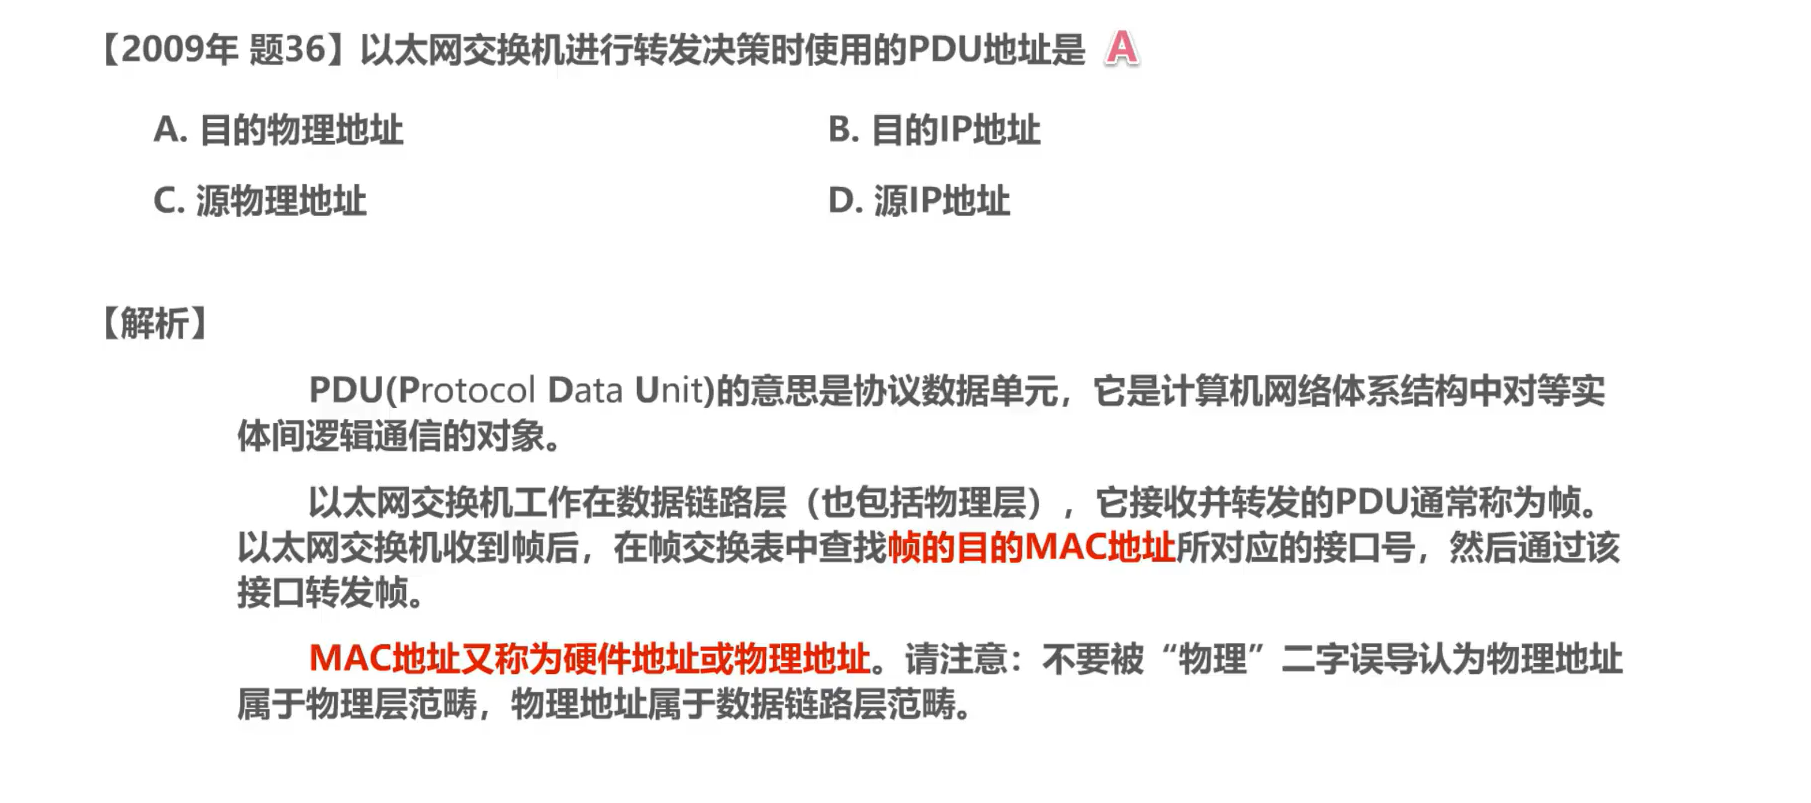
- 工作在数据链路层(也包括物理层),它收到帧后,在帧交换表中查找帧的目的MAC地址所对应的接口号,然后通过该接口转发帧。 (交换机是一种即插即用设备,其帧交换表是通过自学习算法 自动地逐渐建立起来)
以太网交换机的交换方式
- 存储转发方式
- 把整个数据帧先缓存后再进行处理。
- 直通 (cut-through) 方式
- 接收数据帧的同时就立即按数据帧的目的 MAC 地址决定该帧的转发接口,因而提高了帧的转发速度。
- 缺点是它不检查差错就直接将帧转发出去,因此有可能也将一些无效帧转发给其他的站。
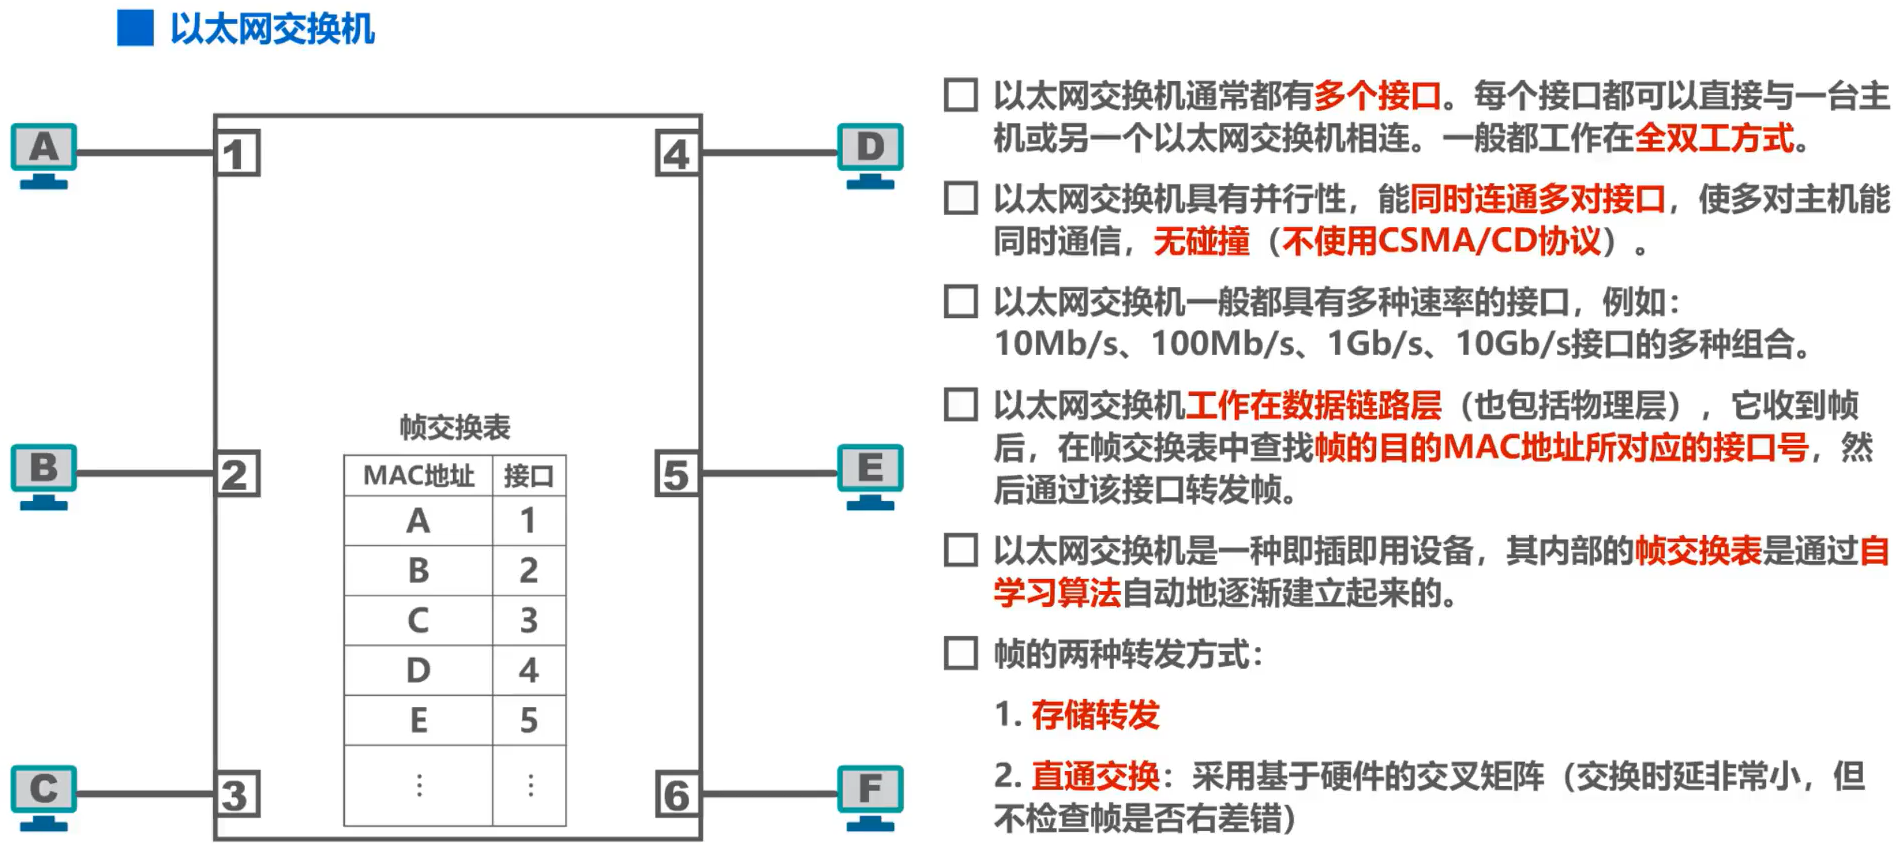
区别
转发方式:
使用集线器互连而成的共享总线式以太网上的某个主机,要给另一个主机发送单播帧,该单播帧会通过共享总线传输到总线上的其他各个主机
使用交换机互连而成的交换式以太网上的某个主机,要给另一个主机发送单播帧,该单播帧进入交换机后,交换机会将该单播帧转发给目的主机,而不是网络中的其他各个主机
是否会发生碰撞:
多台主机同时给另一台主机发送单播帧
集线器以太网:会产生碰撞,遭遇碰撞的帧会传播到总线上的各主机
交换机以太网:会将它们缓存起来,然后逐个转发给目的主机,不会产生碰撞
总结:
集线器现在已被淘汰,而交换机是目前以太网中使用最广泛的互联设备。
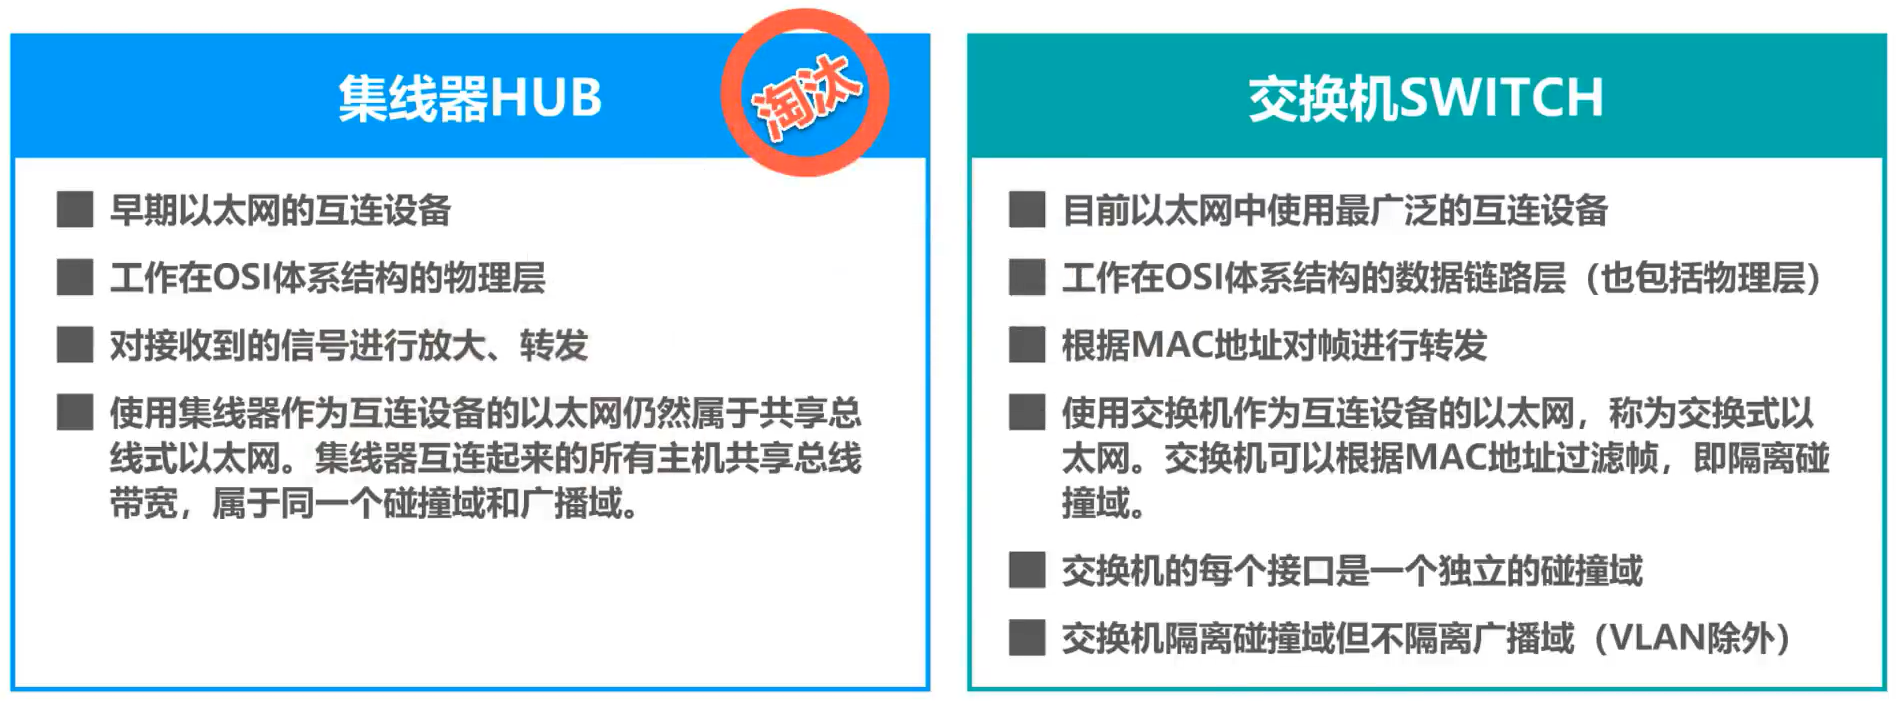
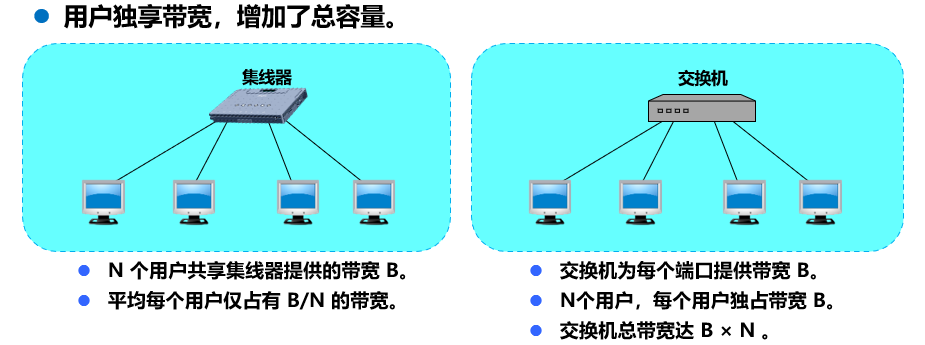
工作在数据链路层的以太网交换机,其性能远远超过工作在物理层的集线器,而且价格并不贵,这就使得集线器逐渐被市场淘汰
以太网交换机
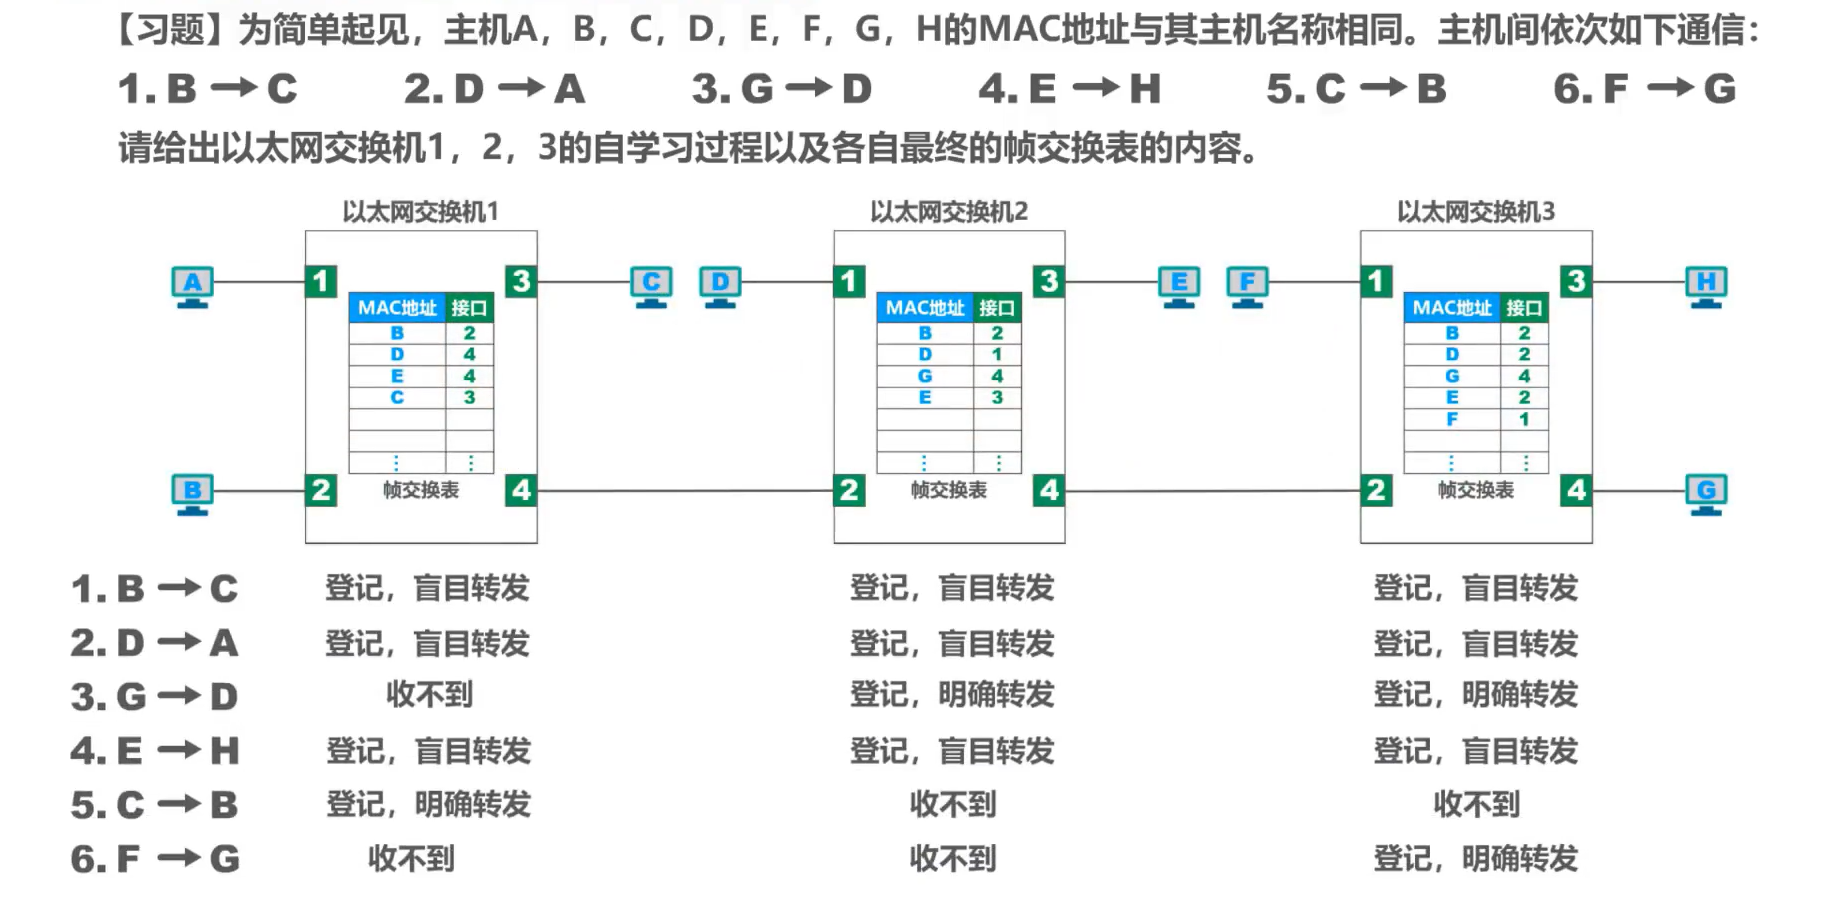
自学习和转发帧的流程
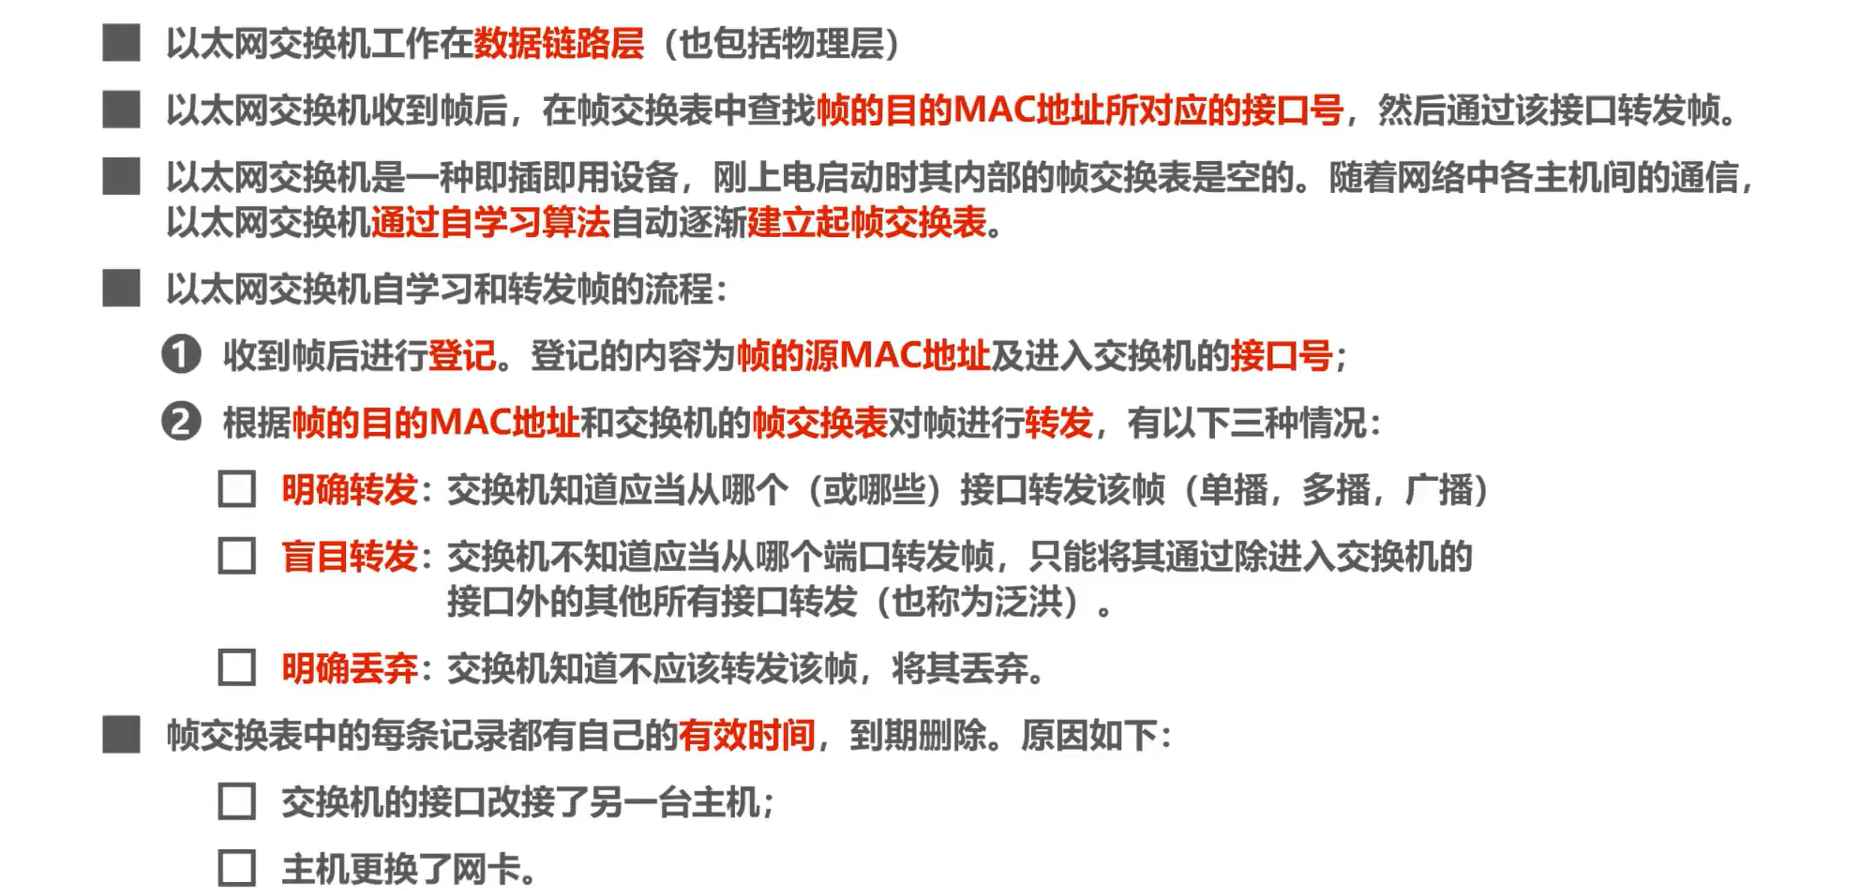
- 以太网交换机工作在数据链路层(也包括物理层)
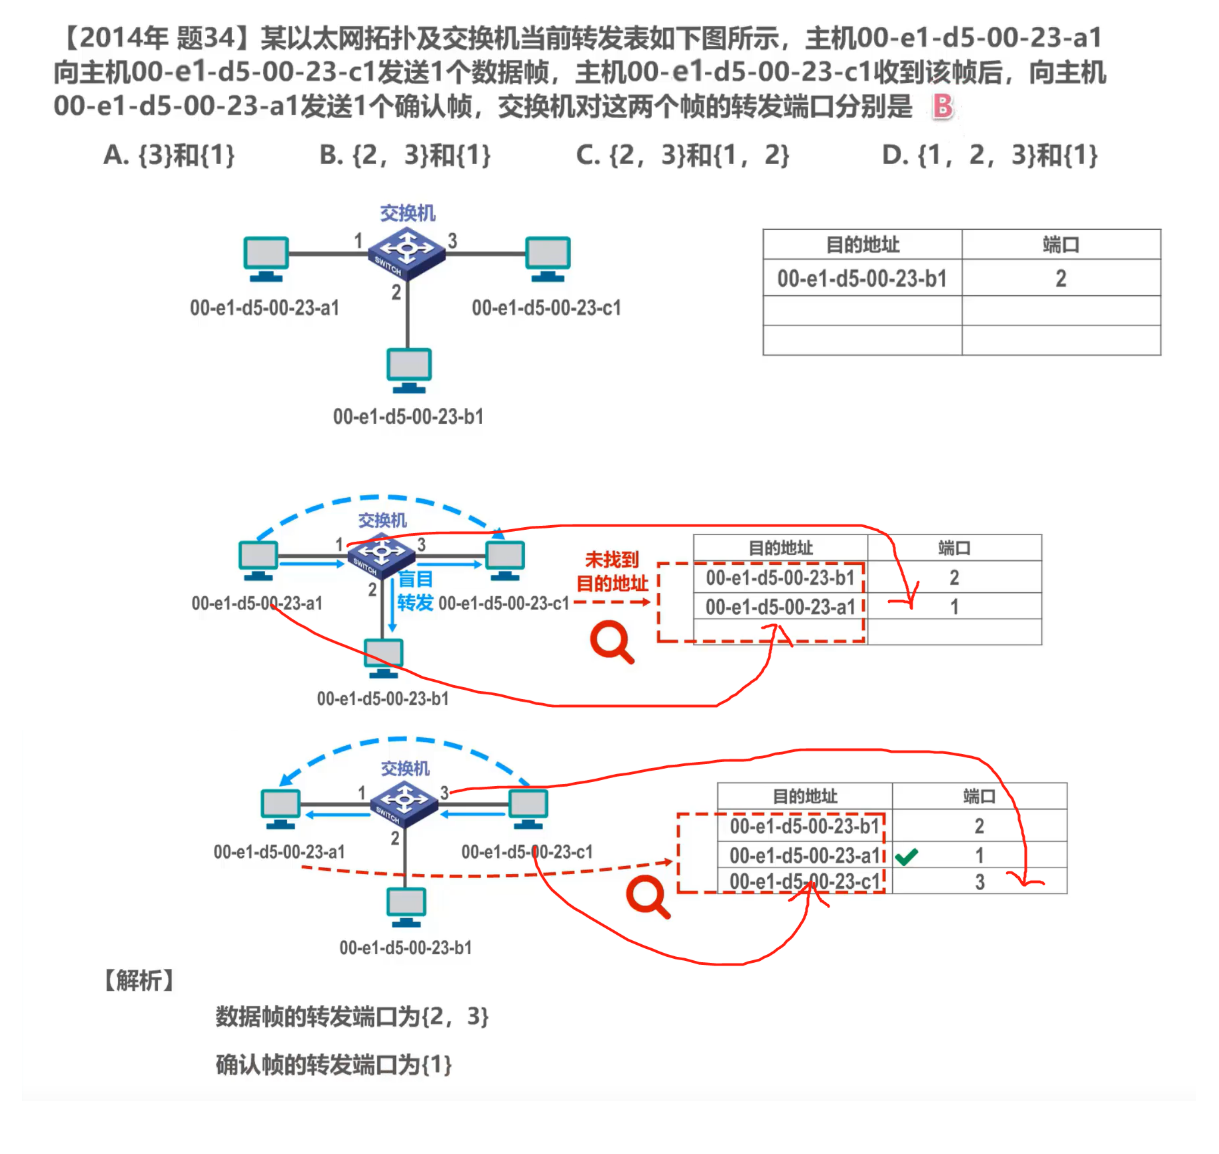
- 以太网交换机收到帧后,在帧交换表中查找帧的目的MAC地址所对应的接口号,然后通过该接口转发帧。
- 以太网交换机是一种即插即用设备,刚上电启动时其内部的帧交换表是空的。随着网络中各主机间的通信,以太网交换机通过自学习算法自动逐渐建立起帧交换表。
例子:
以下例子假设各主机知道网络中其他各主机的MAC地址(无需进行ARP)
A -> B
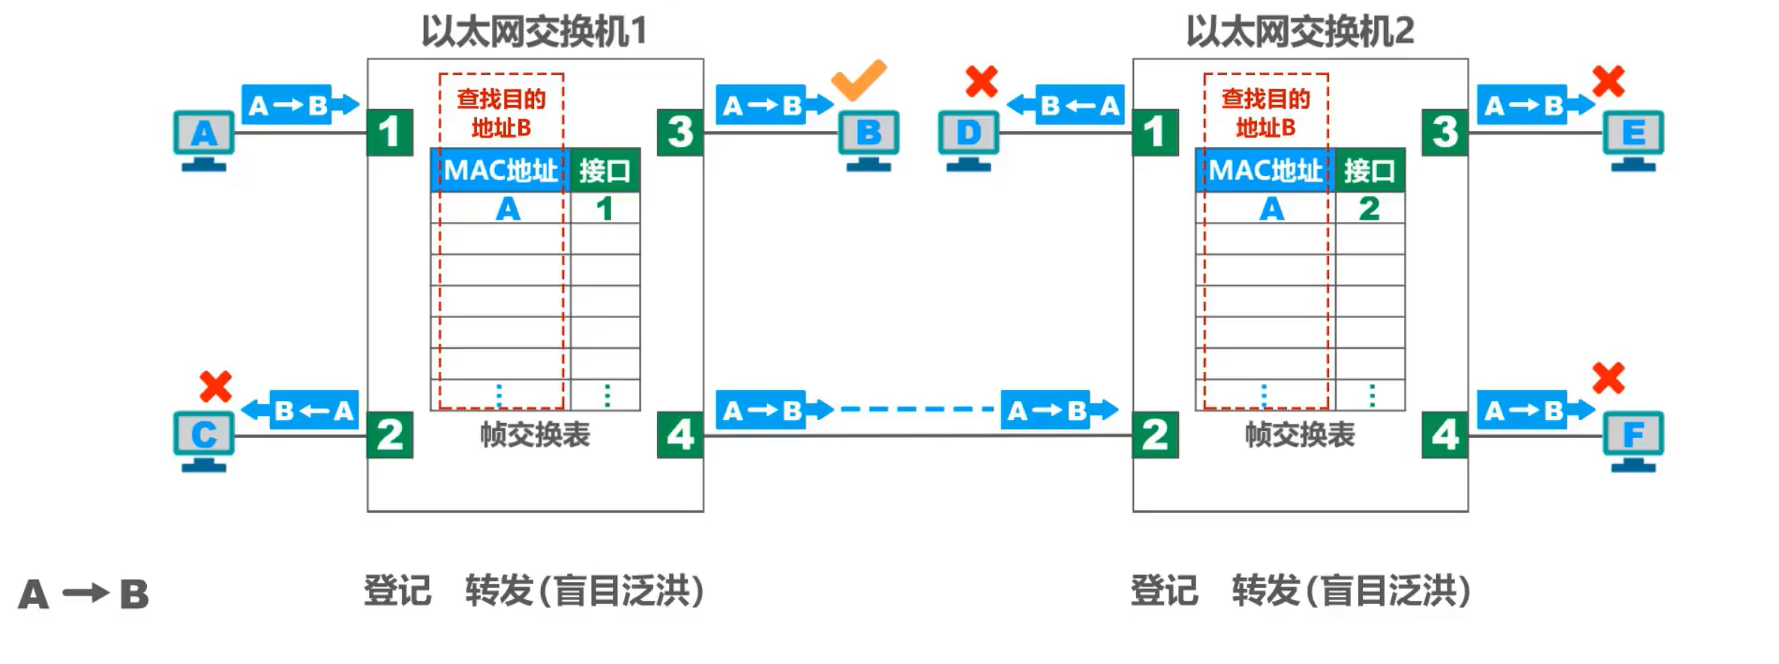
- A 先向 B 发送一帧。该帧从接口 1 进入到交换机
- 交换机收到帧后,先查找(图中左边)交换表。没有查到应从哪个接口转发这个帧给 B
- 交换机把这个帧的源地址 A 和接口 1 写入(图中左边)交换表中
- 交换机向除接口 1 以外的所有的接口广播这个帧
- 接口4到另一交换机的接口 2,先查找(图中右边)交换表。没有查到应从哪个接口转发这个帧给 B
- 交换机把这个帧的源地址 A 和接口 2 写入(图中右边)交换表中
- 除B主机之外与该帧的目的地址不相符,将丢弃该帧
- 主机B发现是给自己的帧,接受该帧
B -> A
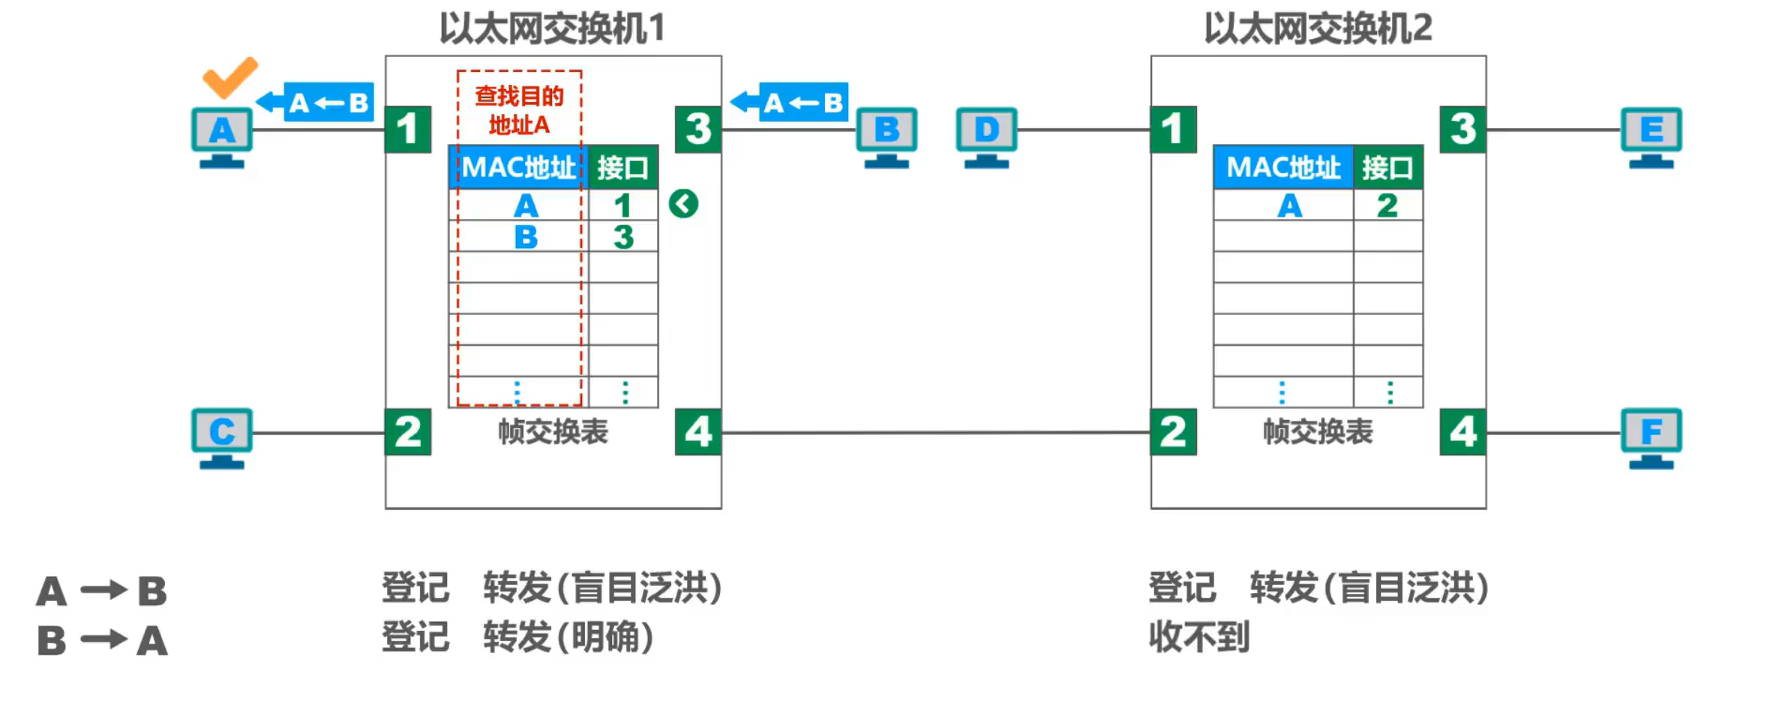
- B 向 A 发送一帧。该帧从接口 3 进入到交换机
- 交换机收到帧后,先查找(图中左边)交换表。发现(图中左边)交换表中的 MAC 地址有 A,表明要发送给A的帧应从接口1转发出去。于是就把这个帧传送到接口 1 转发给 A。
- 主机 A 发现目的地址是它,就接受该帧
- 交换机把这个帧的源地址 B 和接口 3 写入(图中左边)交换表中
E -> A
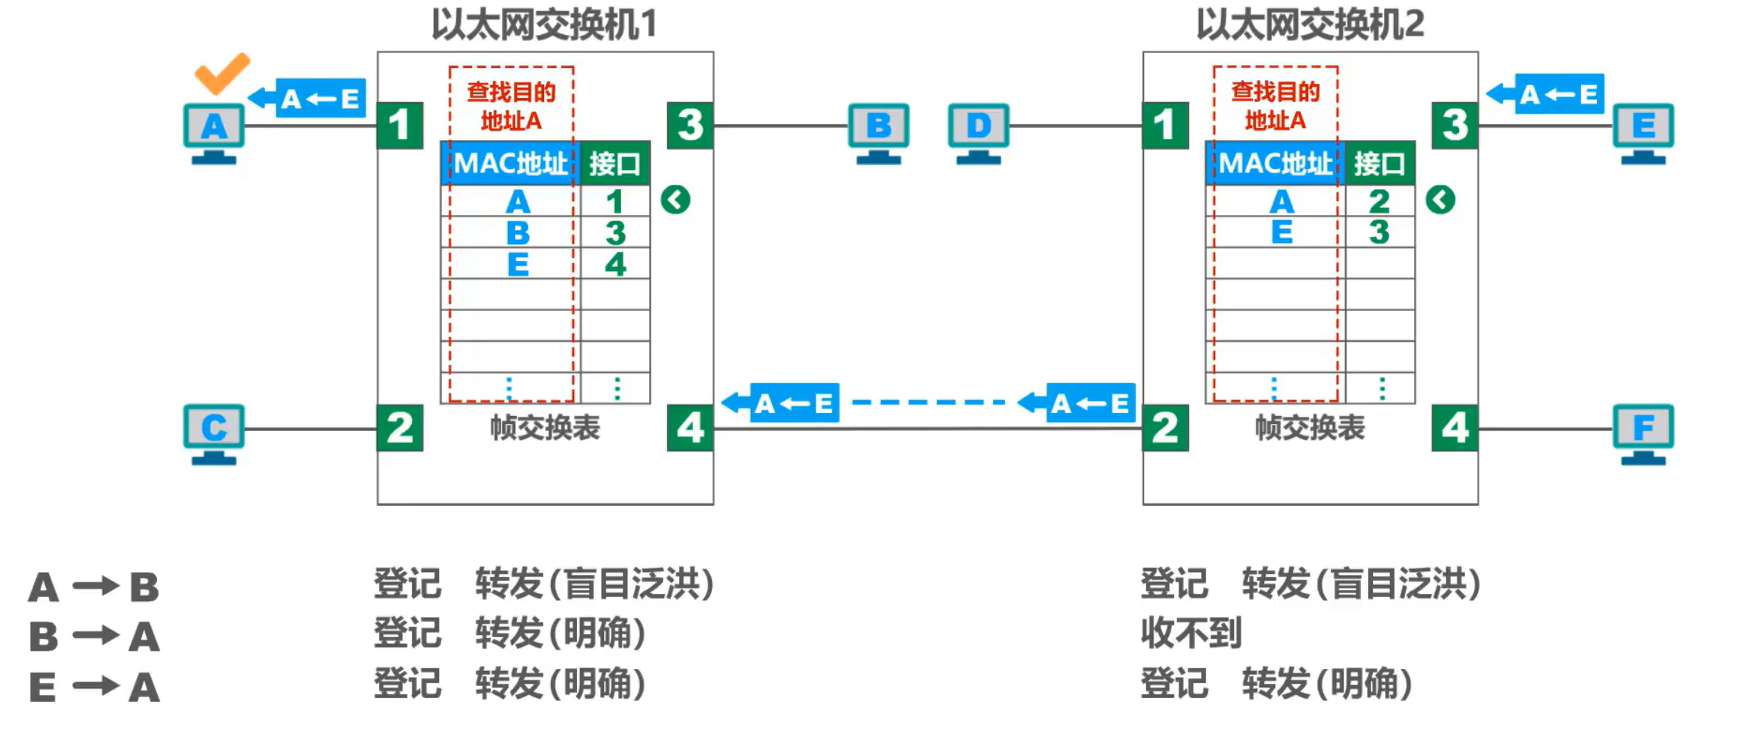
- E 向 A发送一帧
- 交换机收到帧后,先查找(图中右边)交换表。发现(图中右边)交换表中的 MAC 地址有 A,表明要发送给A的帧应从接口2转发出去。于是就把这个帧传送到接口 2 转发给 接口 4。
- 交换机把这个帧的源地址 E 和接口 3 写入(图中右边)交换表中
- 接口 4 到 左边的交换机,先查找(图中左边)交换表。发现(图中左边)交换表中的 MAC 地址有 A,表明要发送给A的帧应从接口1转发出去。于是就把这个帧传送到接口 1 转发给 A。
- 交换机把这个帧的源地址 E 和接口 4 写入(图中左边)交换表中
- 主机 A 发现目的地址是它,就接受该帧
G -> A
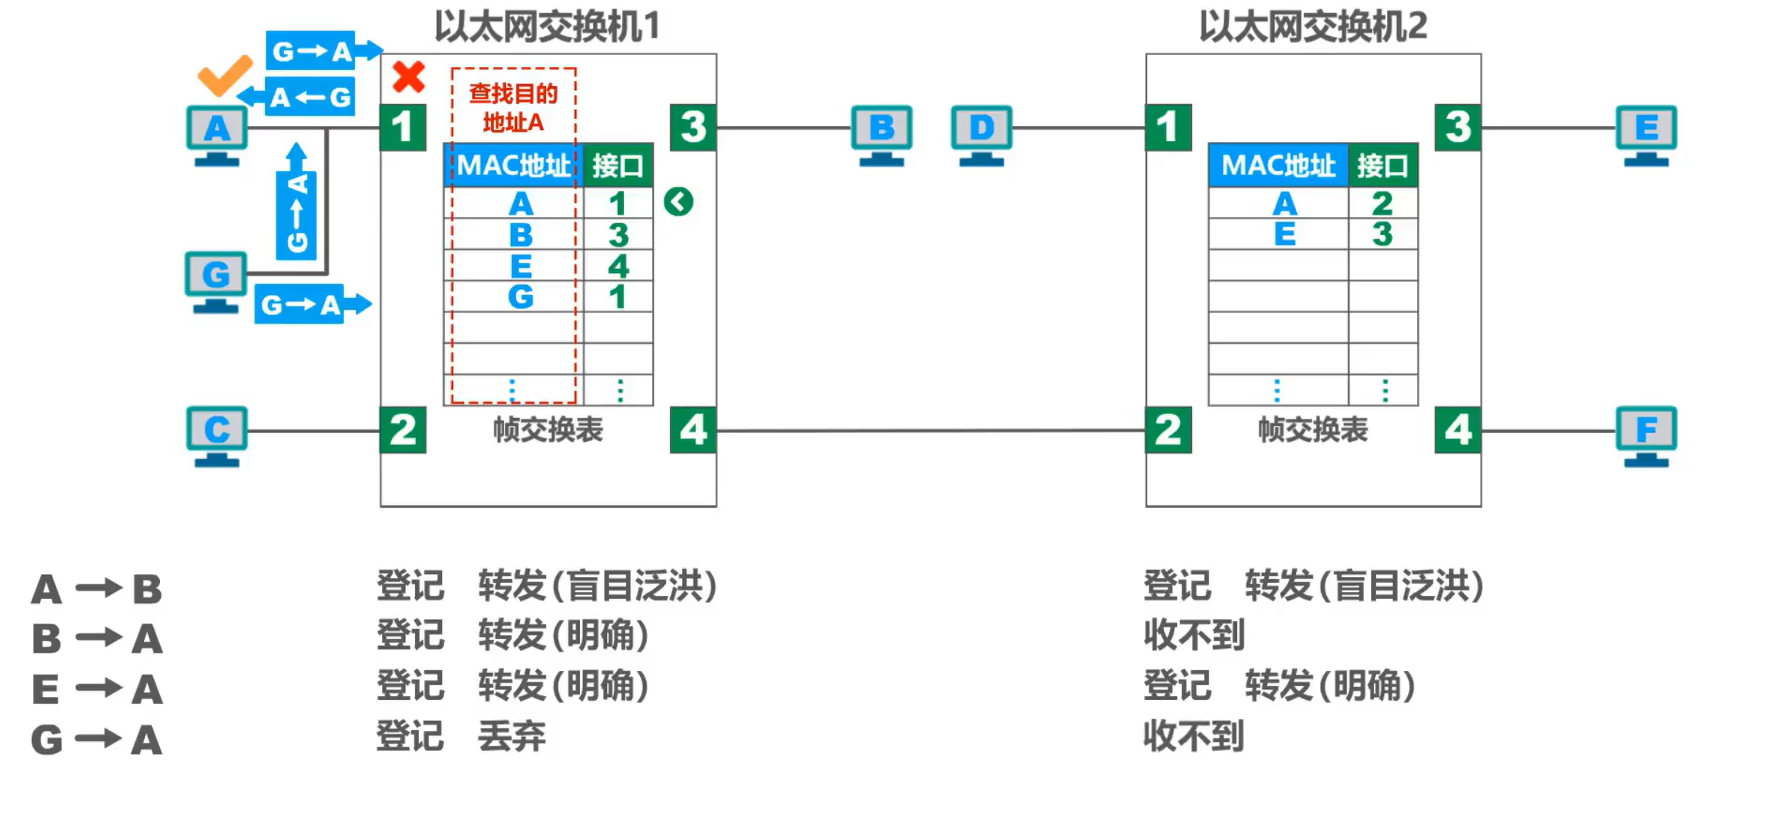
主机 A、主机 G、交换机 1的接口 1就共享同一条总线(相当于总线式网络,可以想象成用集线器连接了)
- 主机 G 发送给 主机 A 一个帧
- 主机 A 和 交换机接口 1都能接收到
- 主机 A 的网卡收到后,根据帧的目的MAC地址A,就知道是发送给自己的帧,就接受该帧
- 交换机 1收到该帧后,首先进行登记工作
- 然后交换机 1对该帧进行转发,该帧的MAC地址是A,在(图中左边)交换表查找MAC 地址有 A
- MAC 地址为 A的接口号是1,但是该帧正是从接口 1 进入交换机的,交换机不会再从该接口 1 将帧转发出去,因为这是没有必要,于是丢弃该帧
随着网络中各主机都发送了帧后,网络中的各交换机就可以学习到各主机的MAC地址,以及它们与自己各接口的对应关系
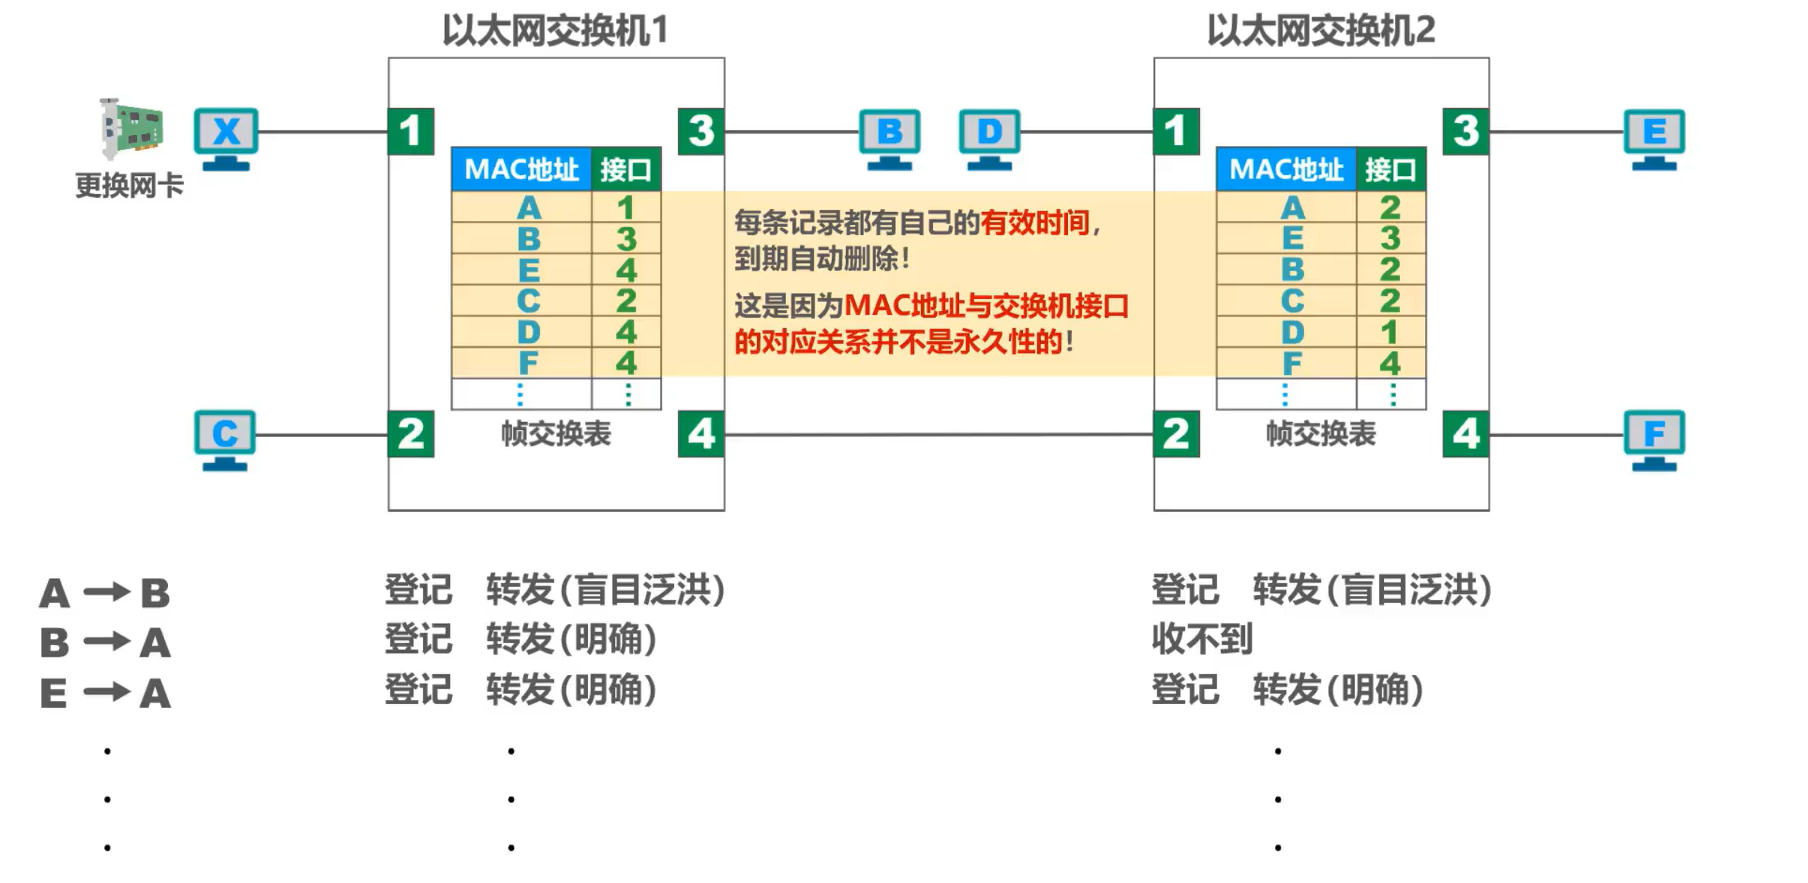
考虑到可能有时要在交换机的接口更换主机,或者主机要更换其网络适配器,这就需要更改交换表中的项目。为此,在交换表中每个项目都设有一定的有效时间。过期的项目就自动被删除。
以太网交换机的这种自学习方法使得以太网交换机能够即插即用,不必人工进行配置,因此非常方便。
总结:
交换机自学习和转发帧的步骤归纳
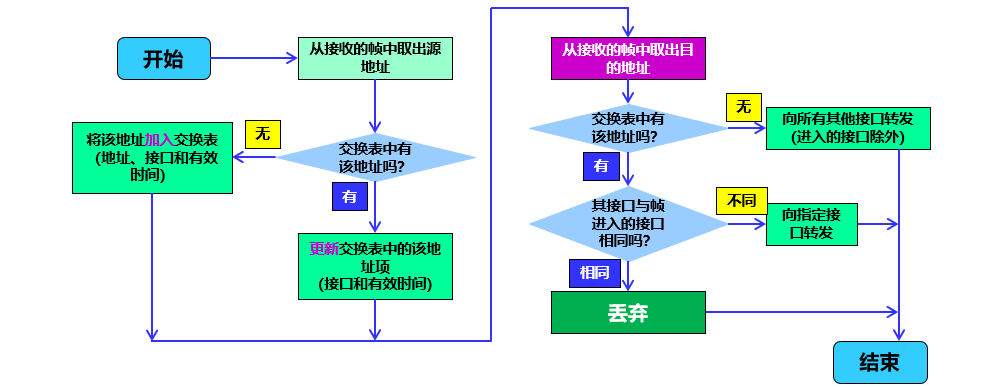
生成树协议STP
如果连接交换机的某条链路故障,导致不同交换机上的主机无法通信,那么,该如何提高以太网的可靠性?
- 添加冗余链路,可以提高以太网的可靠性;(即有多条线路通往另一个交换机)
- 但冗余链路会带来负面效应:可能会形成网络环路,网络环路会导致广播风暴,主机收到重复的广播帧,交换机的帧交换表震荡(漂移)
于是,就有了生成树协议STP:
以太网交换机使用生成树协议STP (Spanning Tree Protocol) ,可以在增加冗余链路来提高网络可靠性的同时又避免网络环路带来的各种问题。
- 不论交换机之间采用怎样的物理连接,交换机都能够自动计算并构建一个逻辑上没有环路的网络,其逻辑拓扑结构必须是树型的(无逻辑环路);
- 最终生成的树型逻辑拓扑要确保连通整个网络;
- 当首次连接交换机或网络物理拓扑发生变化时(有可能是人为改变或故障),交换机都将进行生成树的重新计算。
- IEEE 802.1D 标准制定了一个生成树协议 STP (Spanning Tree Protocol)。
- 其要点是:不改变网络的实际拓扑,但在逻辑上则切断某些链路,使得从一台主机到所有其他主机的路径是无环路的树状结构,从而消除了兜圈子现象。
虚拟局域网VLAN
为什么要虚拟局域网VLAN?
广播风暴
使用一个或多个以太网交换机互连起来的交换式以太网,其所有站点都属于同一个广播域。随着交换式以太网规摸的扩大,广播域相应扩大。巨大的广播域会带来很多弊端:广播风暴(浪费网络资源和主机的CPU资源),且难以管理和维护,有潜在的安全问题。
常见的广播:
- TCP/IP协议栈的许多协议都会使用广播: 地址解析协议ARP,路由信息协议RIP,动态主机配置协议DHCP;
- NetBEUI:Widnows下使用的广播型协议
- IPX/SPX:Novell 网络的协议栈
- Apple Talk:Apple公司的网络协议栈
分割广播域的方法
- 使用路由器可以隔离广播域,但路由器成本较高
- 使用虚拟局域网VLAN技术
为了分割广播域,所以虚拟局域网VLAN技术应运而生
概念
虚拟局域网VLAN (Virtual Local Area Network) 是一种将局域网内的设备划分成与物理位置无关的逻辑组的技术,这些逻辑组具有某些共同的需求。
- 利用以太网交换机可以很方便地实现虚拟局域网 VLAN (Virtual LAN)。
- IEEE 802.1Q 对虚拟局域网 VLAN 的定义:
虚拟局域网 VLAN 是由一些局域网网段构成的与物理位置无关的逻辑组,而这些网段具有某些共同的需求。每一个 VLAN 的帧都有一个明确的标识符,指明发送这个帧的计算机是属于哪一个 VLAN。- 同一个VLAN内部可以广播通信,不同VLAN不可以广播通信
- 虚拟局域网其实只是局域网给用户提供的一种服务,而并不是一种新型局域网。
- 由于虚拟局域网是用户和网络资源的逻辑组合,因此可按照需要将有关设备和资源非常方便地重新组合,使用户从不同的服务器或数据库中存取所需的资源。
实现机制
虚拟局域网VLAN技术是在交换机上实现的,需要交换机能够实现以下功能
- 能够处理带有VLAN标记的帧——IEEE 802.1Q帧
- 交换机的各端口可以支持不同的端口类型,不同端口类型的端口对帧的处理方式有所不同。一般有三种端口类型
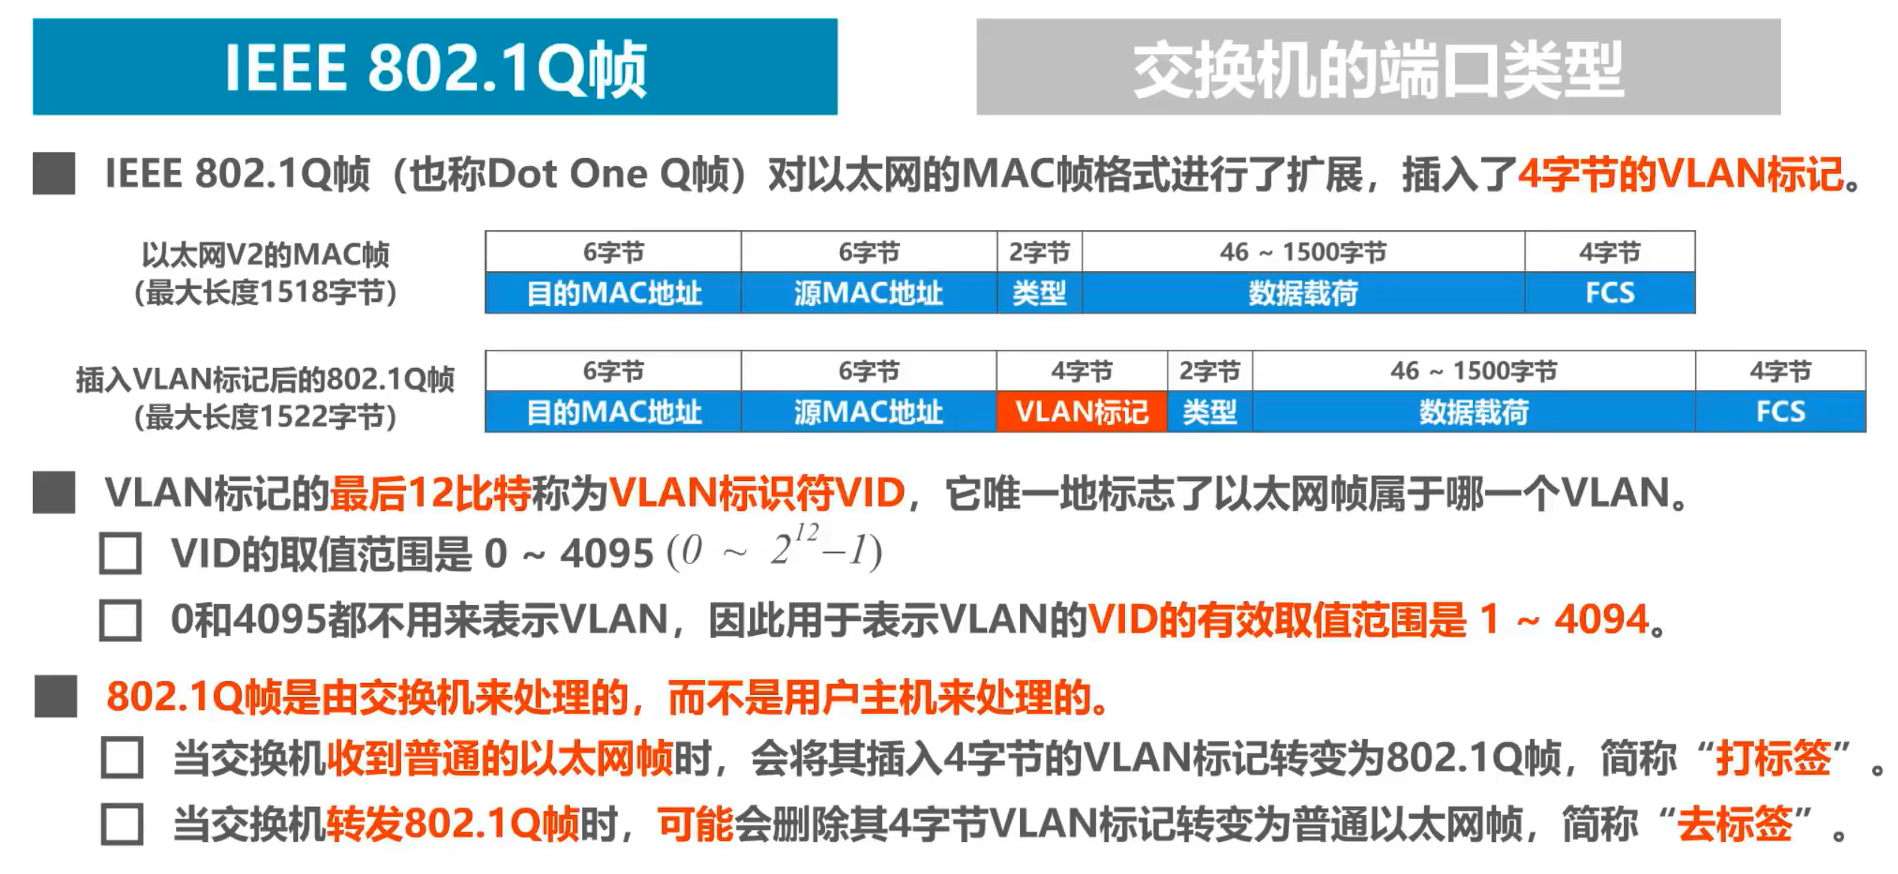
Access端口
交换机与用户计算机之间的互连,每个端口额外有一个PVID值,用于区分是属于哪一个VLAN,广播时带上4字节的VID标记字段,只有VID与PVID相等,才转发给该端口。
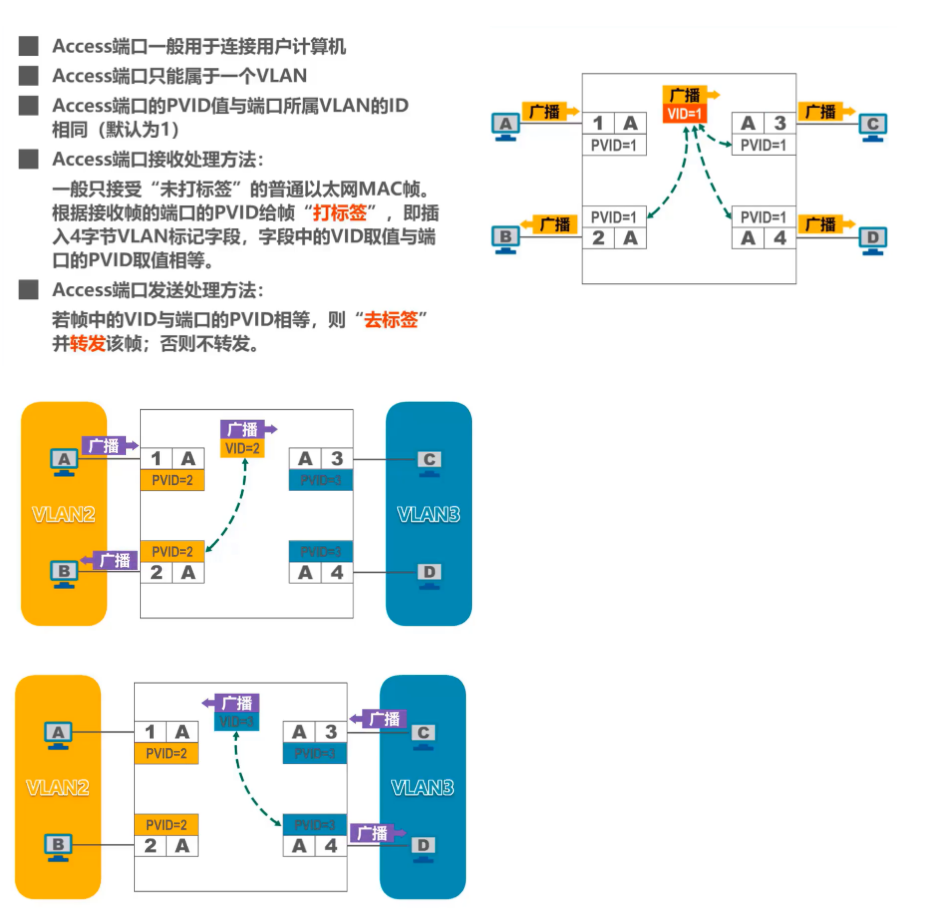
同一个VLAN内部可以广播通信,不同VLAN不可以广播通信
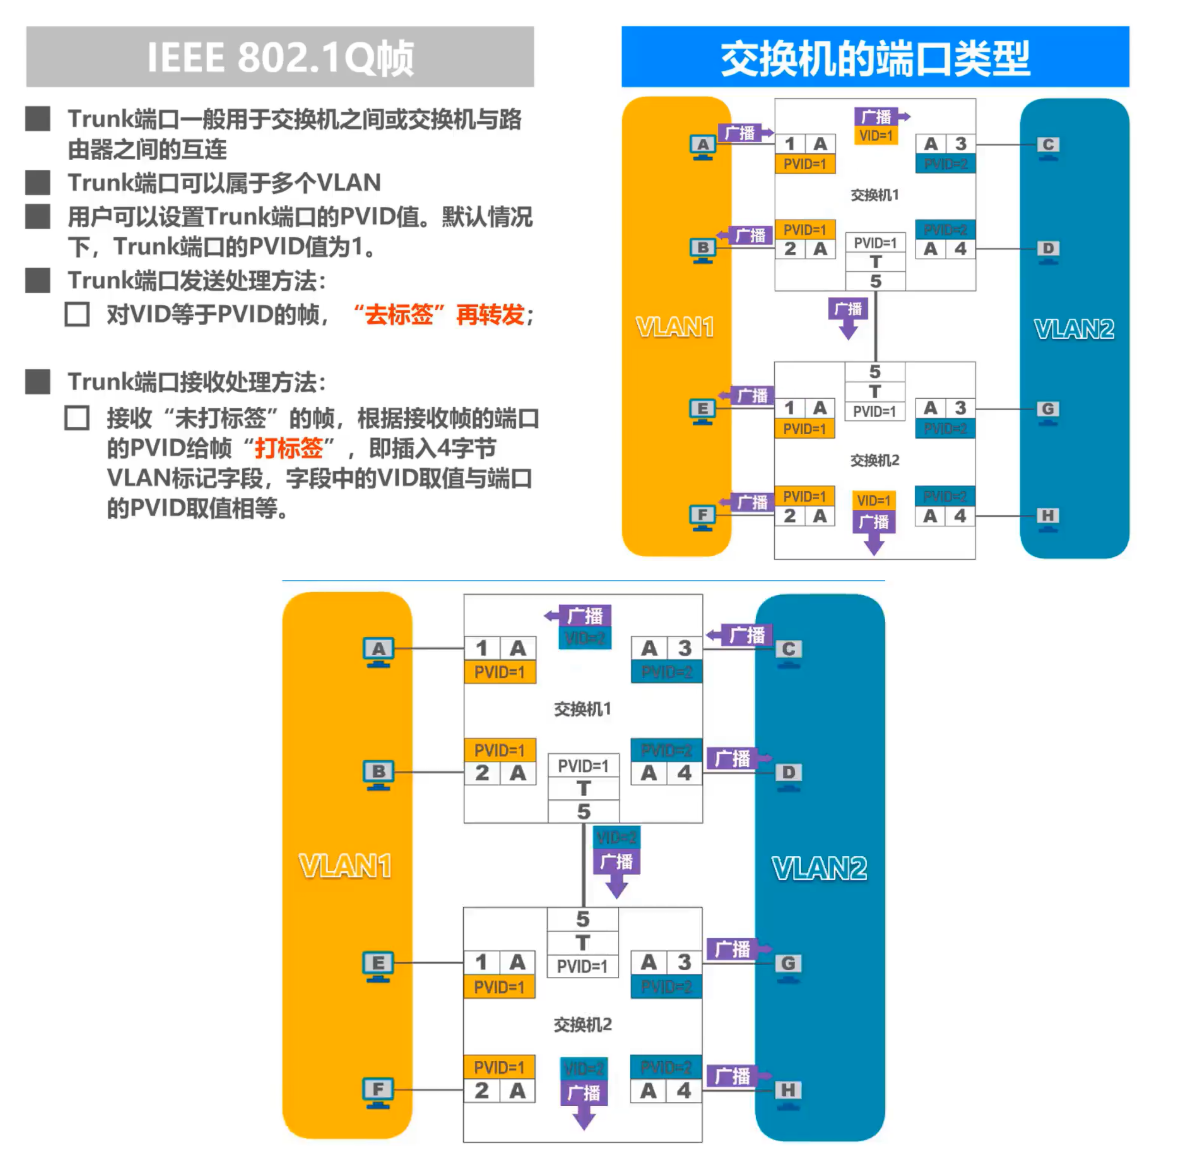
Truck端口
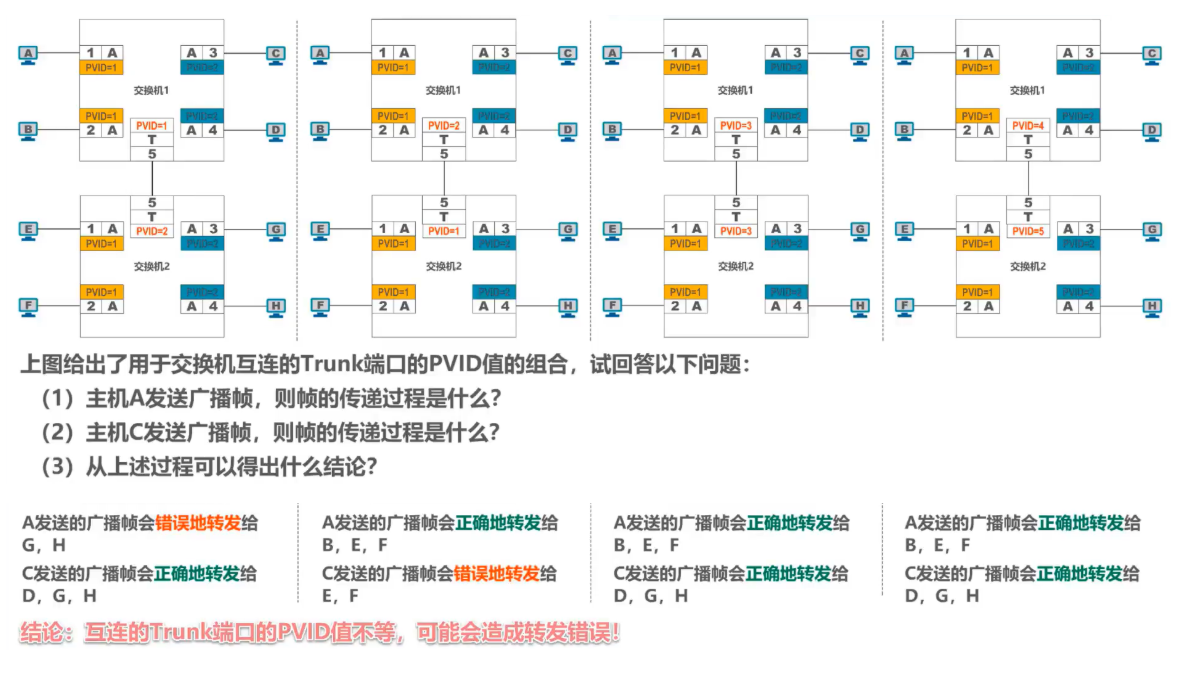
交换机之间或交换机与路由器之间的互连,相连的端口的PVID值建议相同,不然可能会转发出错。
小例题
华为交换机私有的Hybrid端口类型
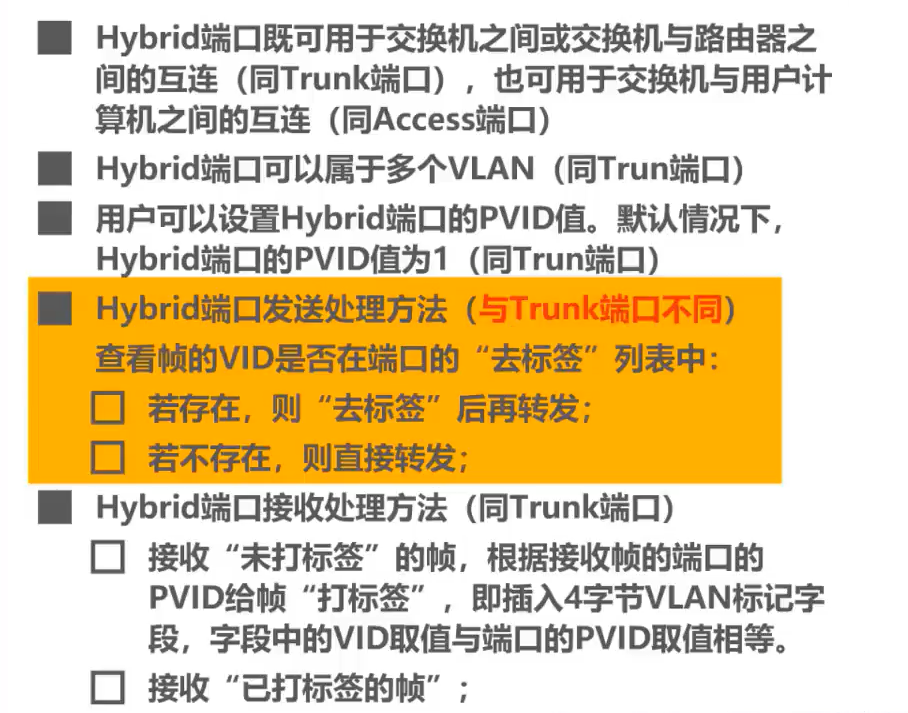
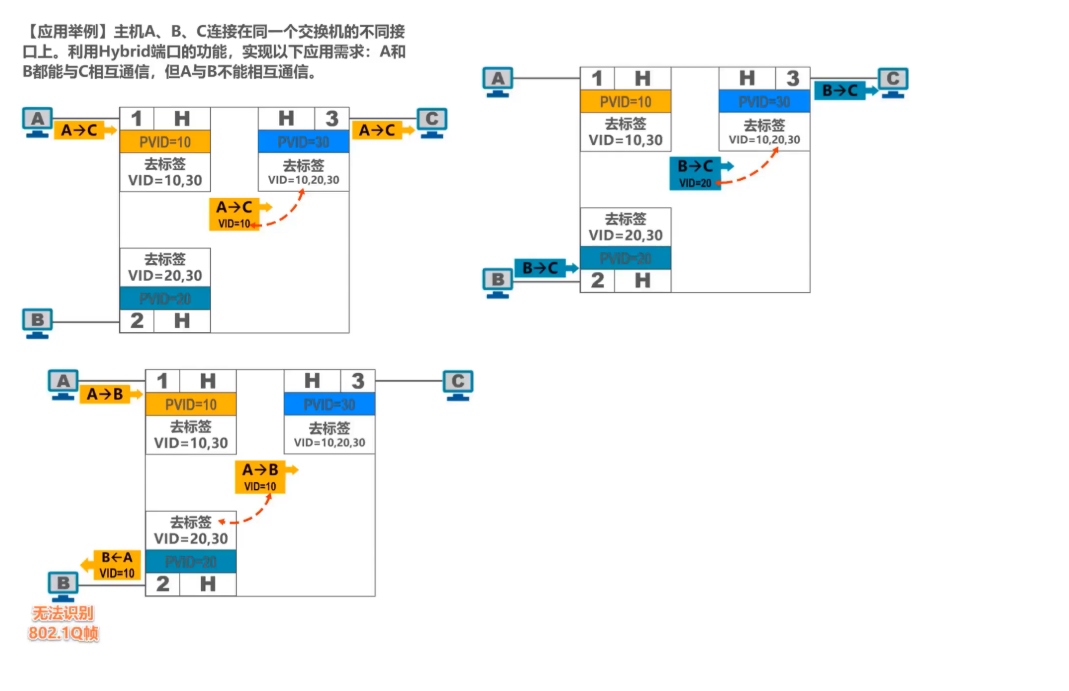
总结
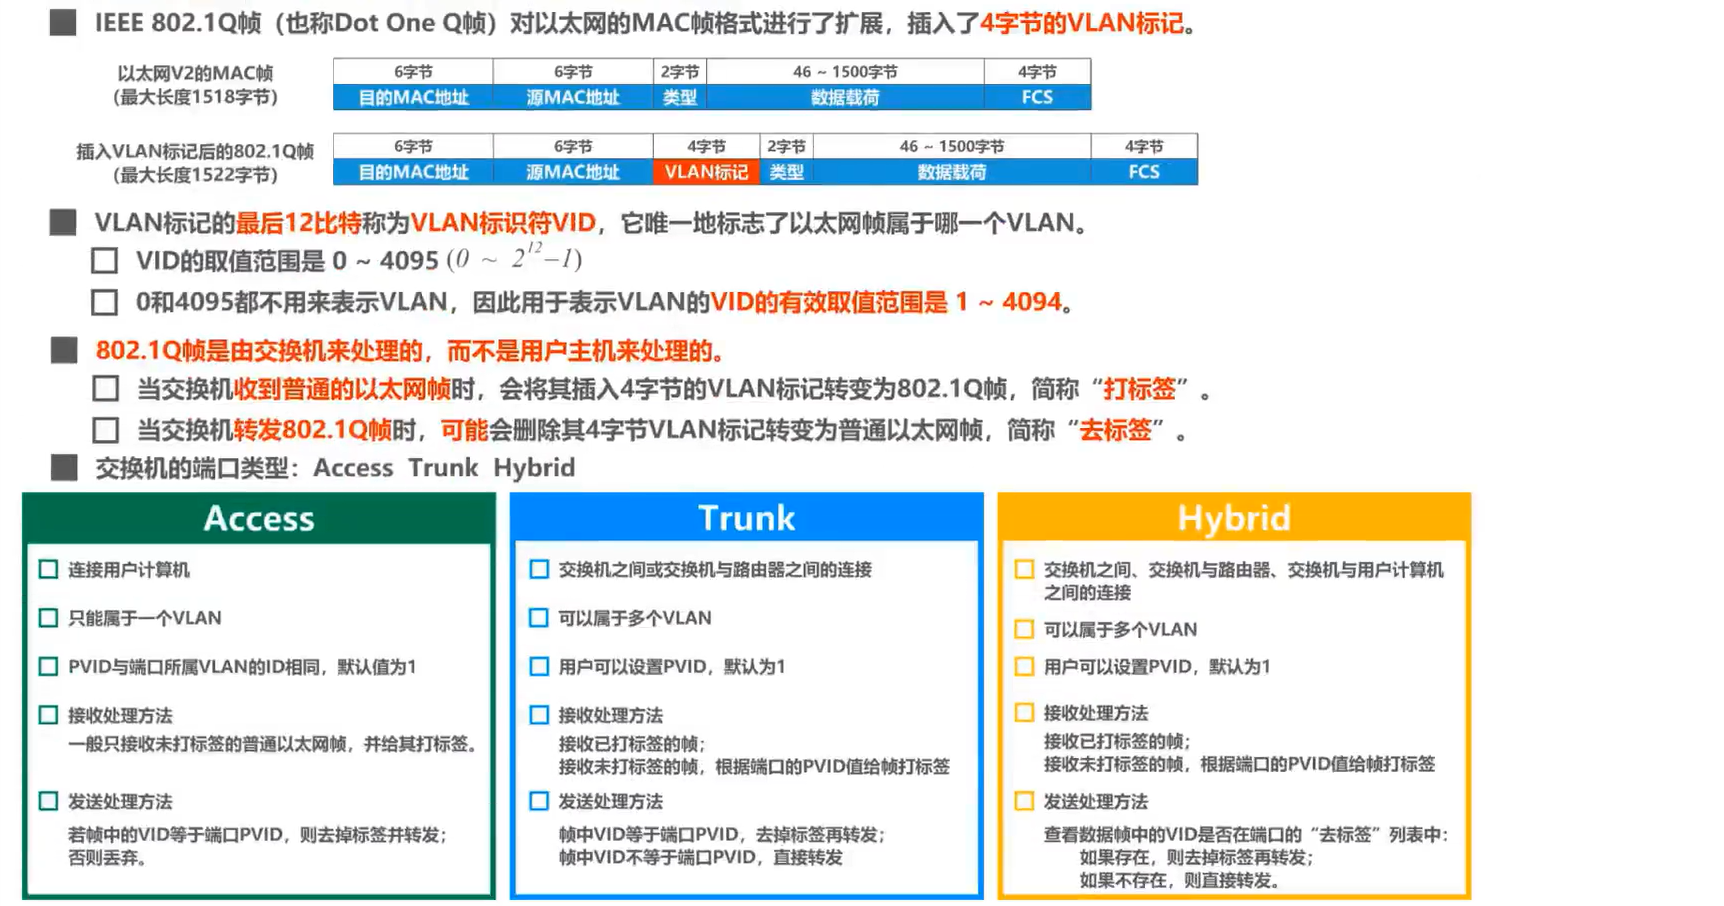
虚拟局域网优点
虚拟局域网(VLAN)技术具有以下主要优点:
- 改善了性能
- 简化了管理
- 降低了成本
- 改善了安全性
习题
封装成帧习题
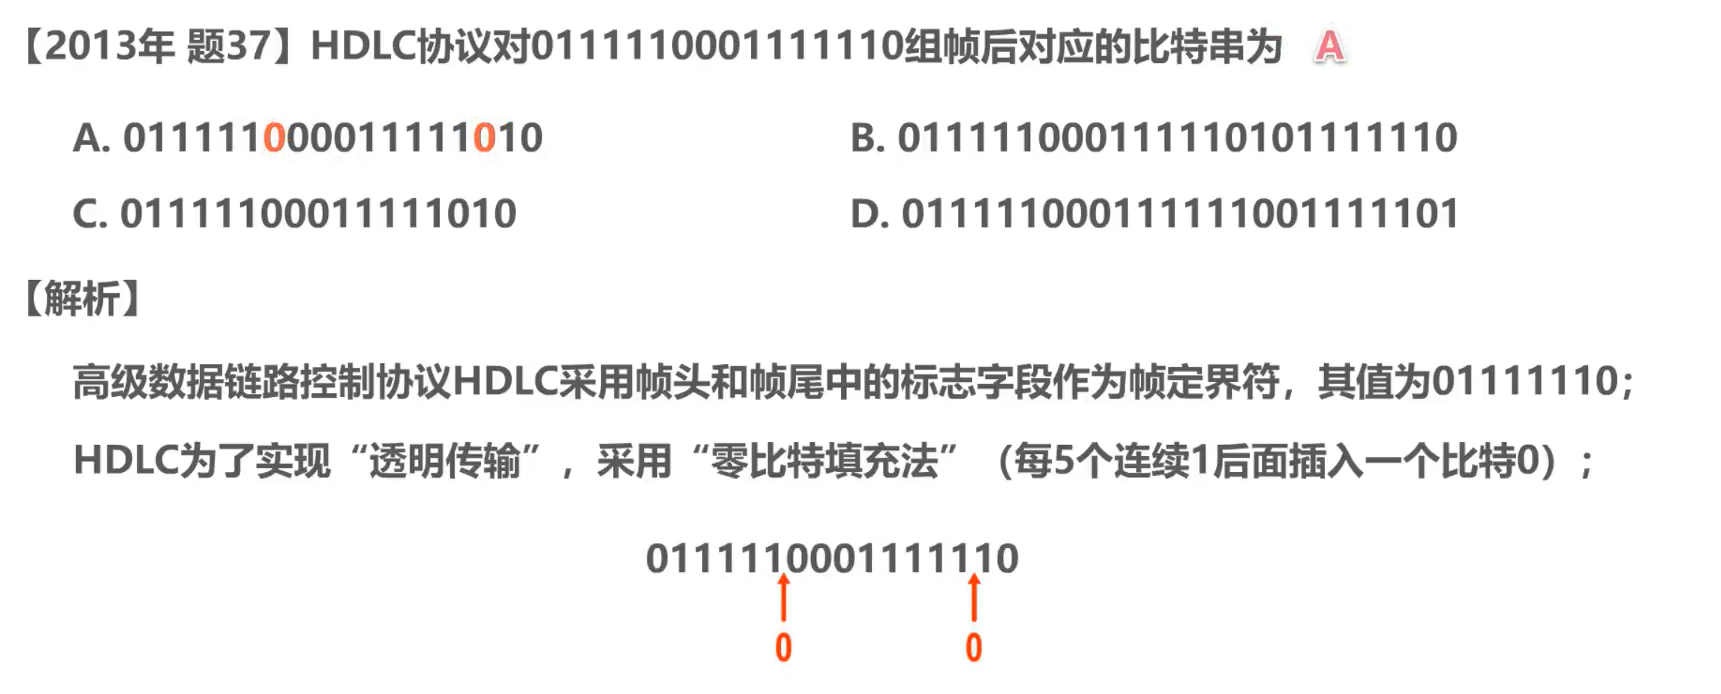
差错检测习题
可靠传输习题
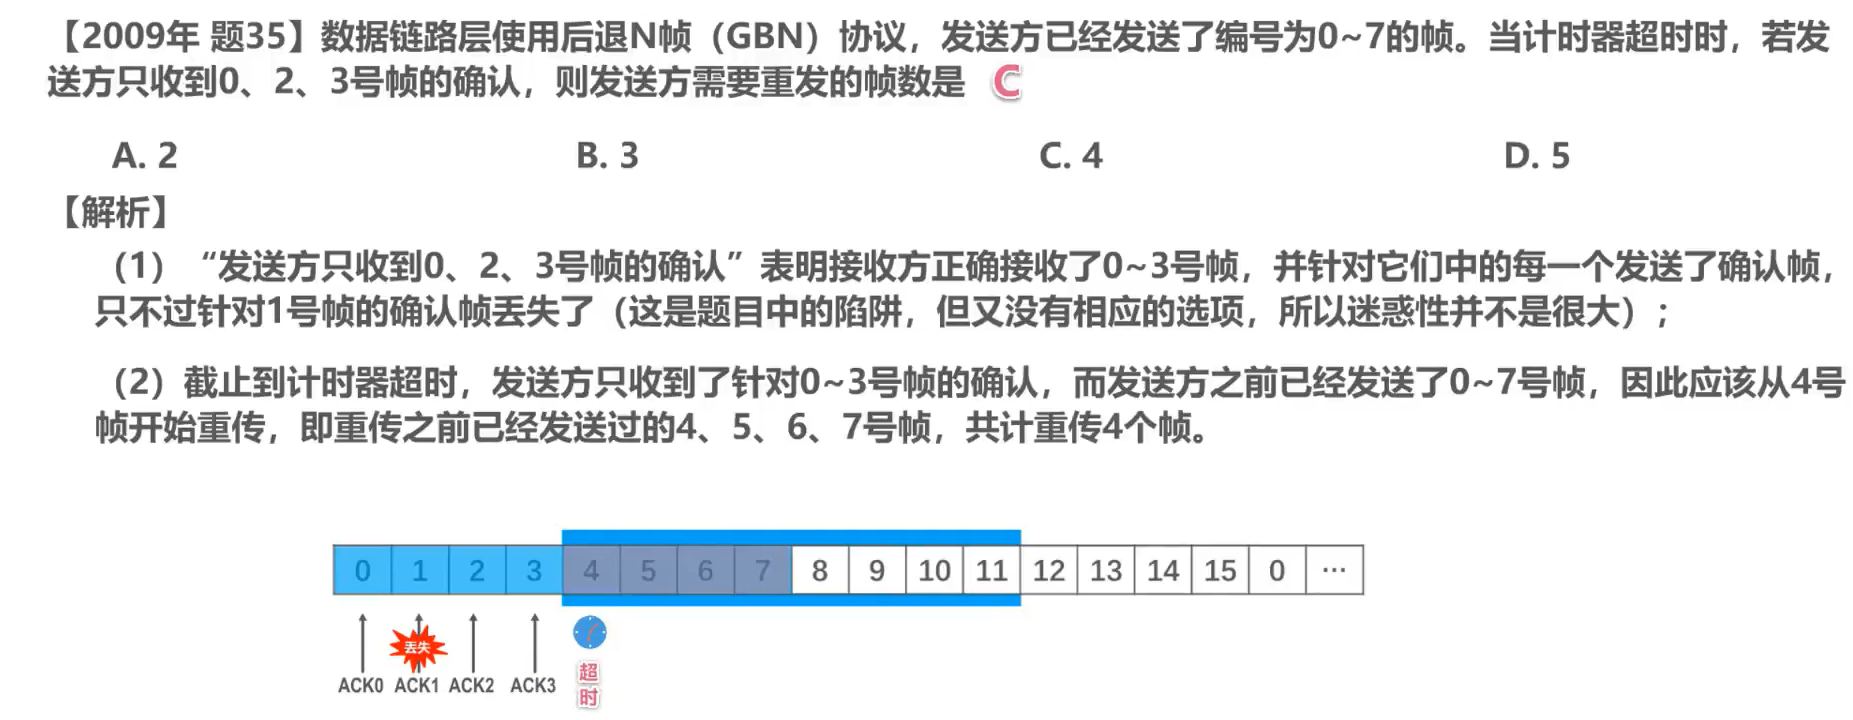
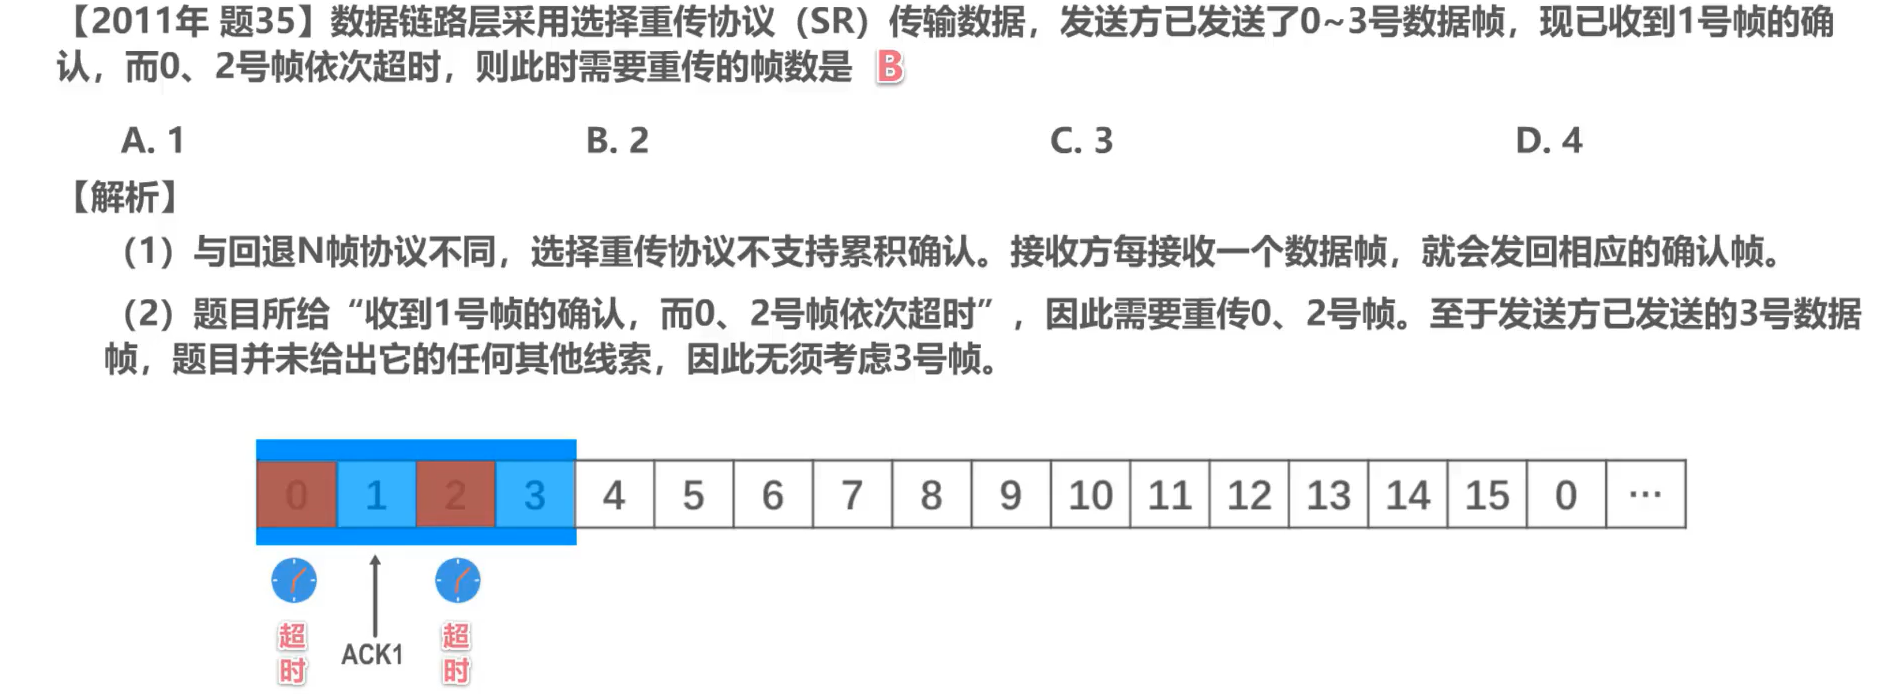
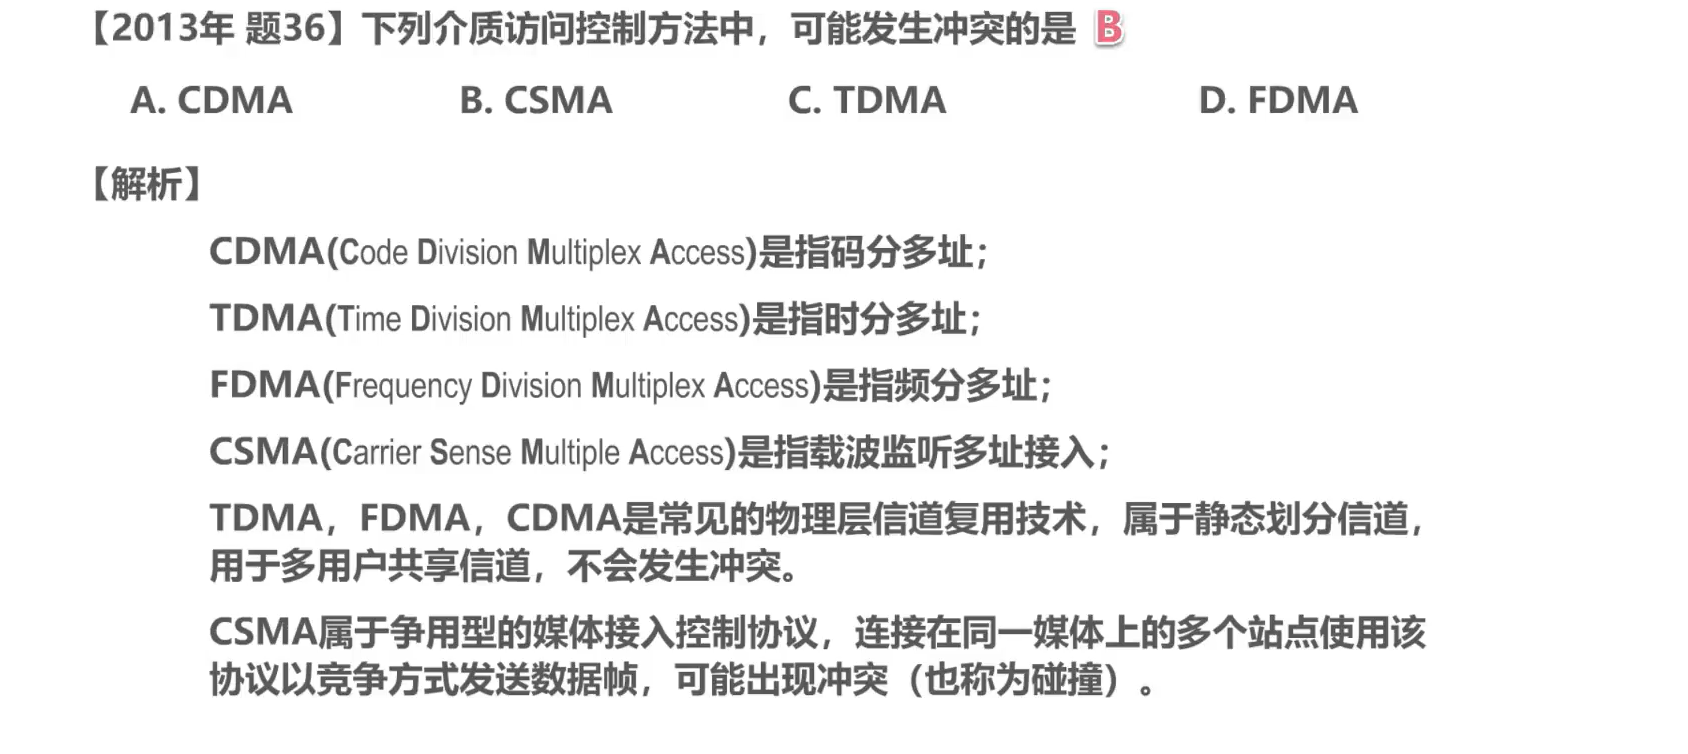
媒体接入控制习题
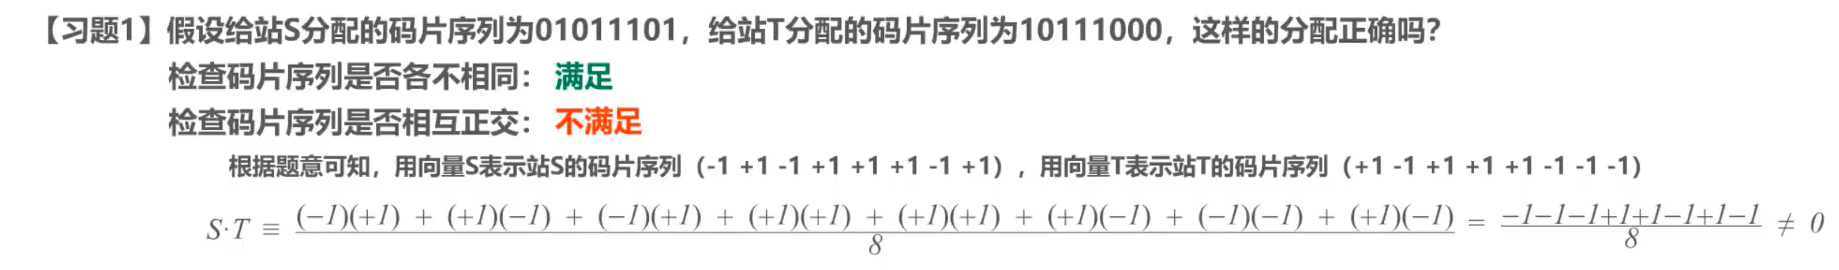
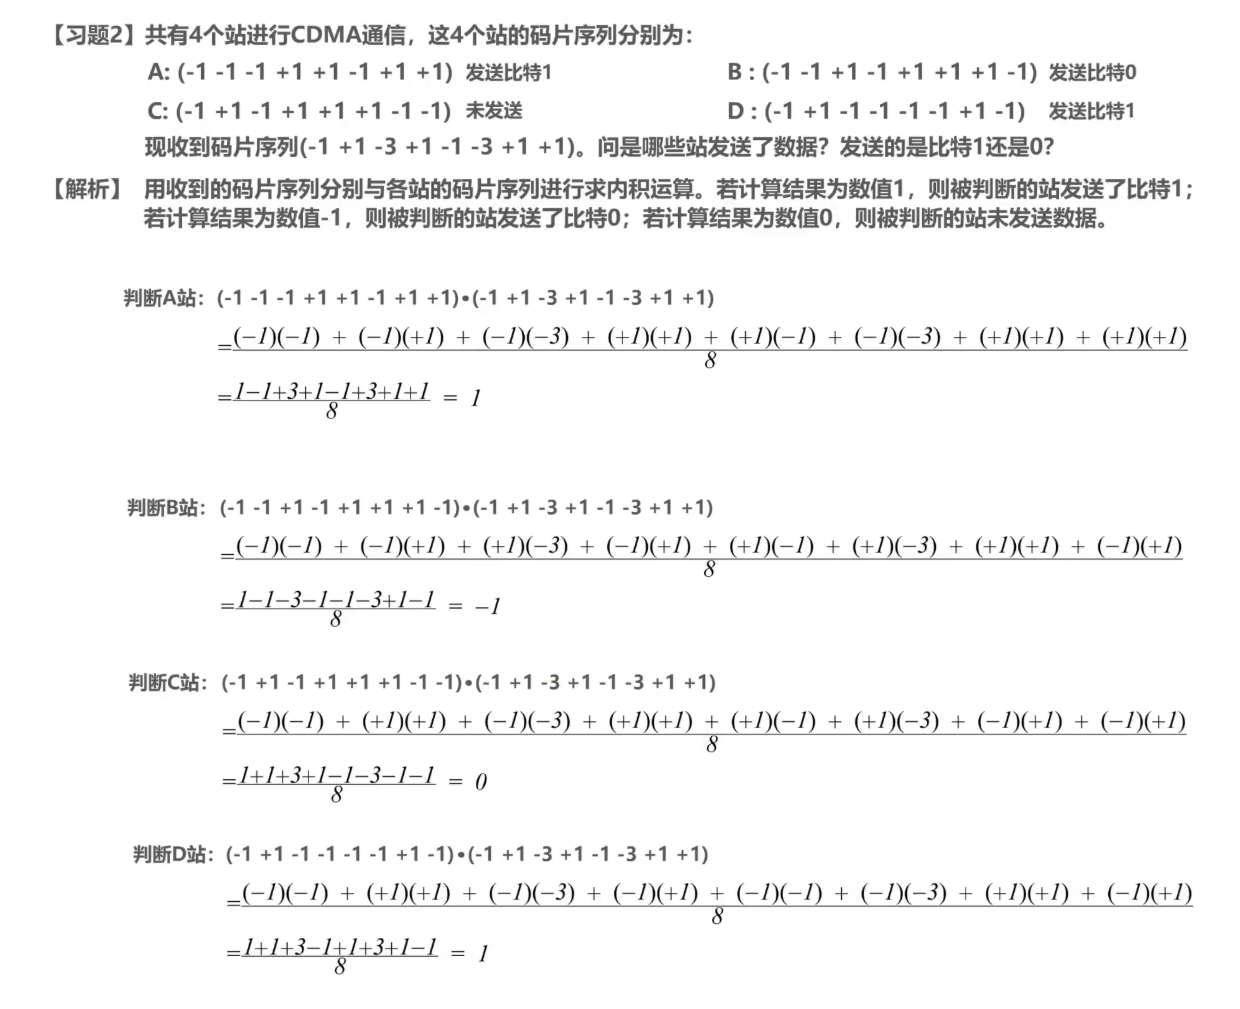
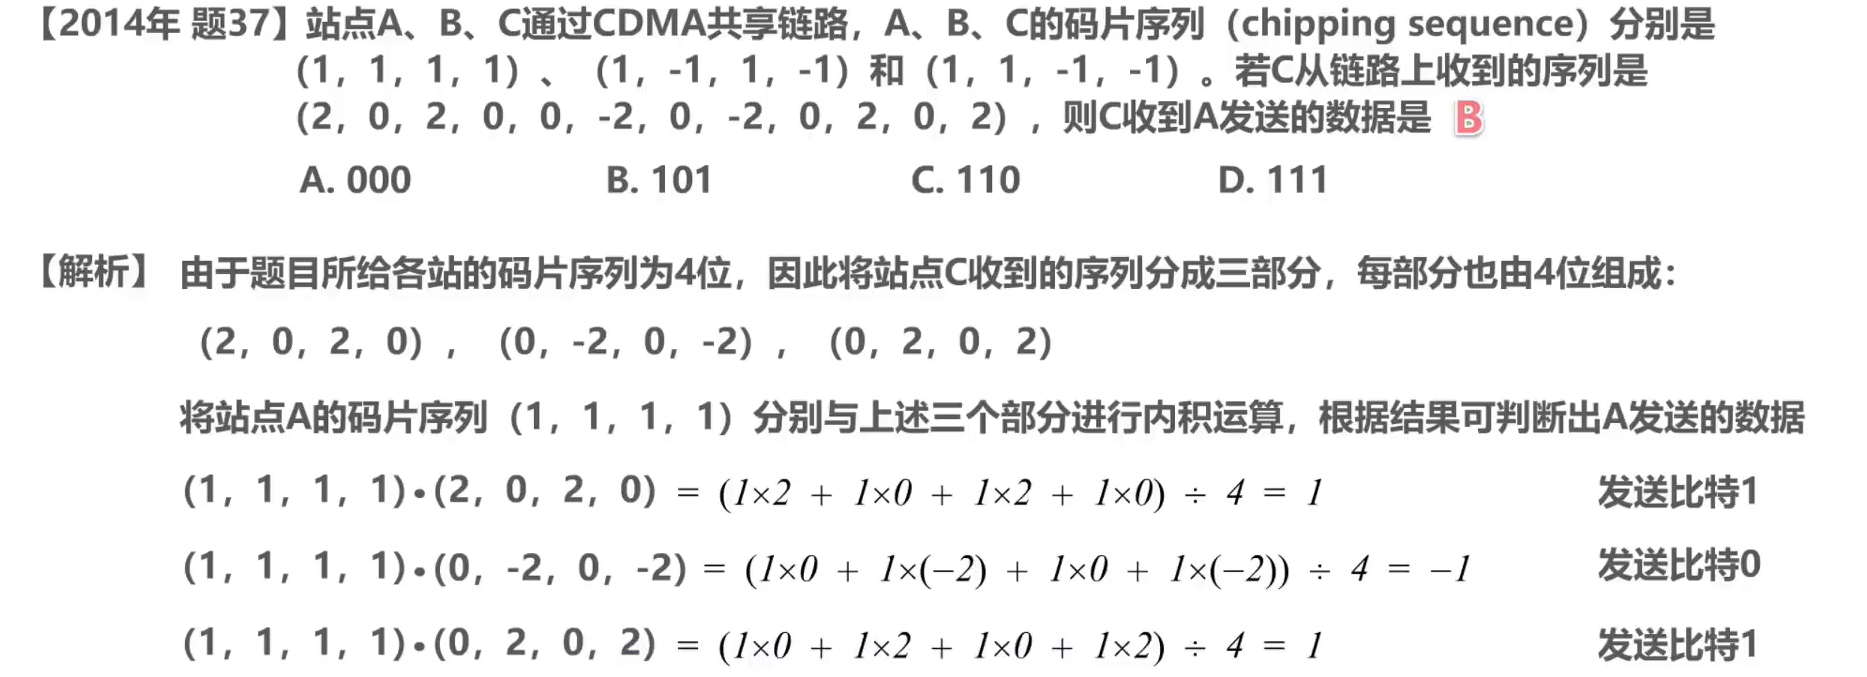
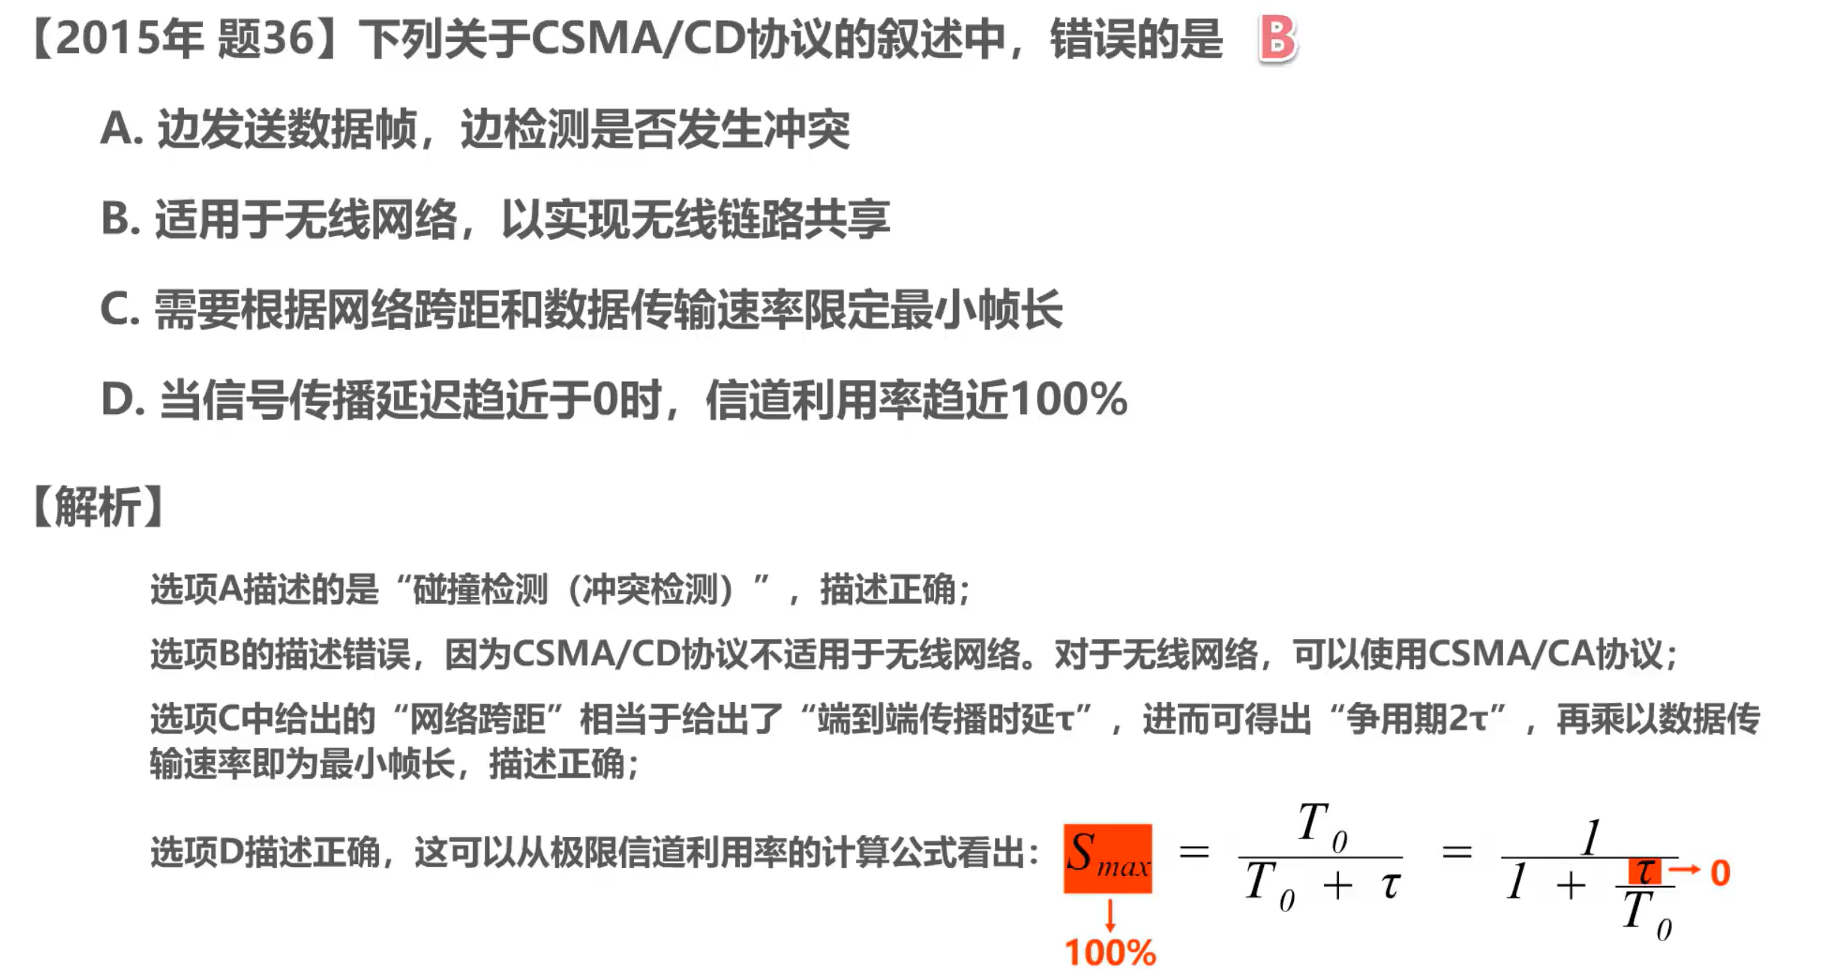
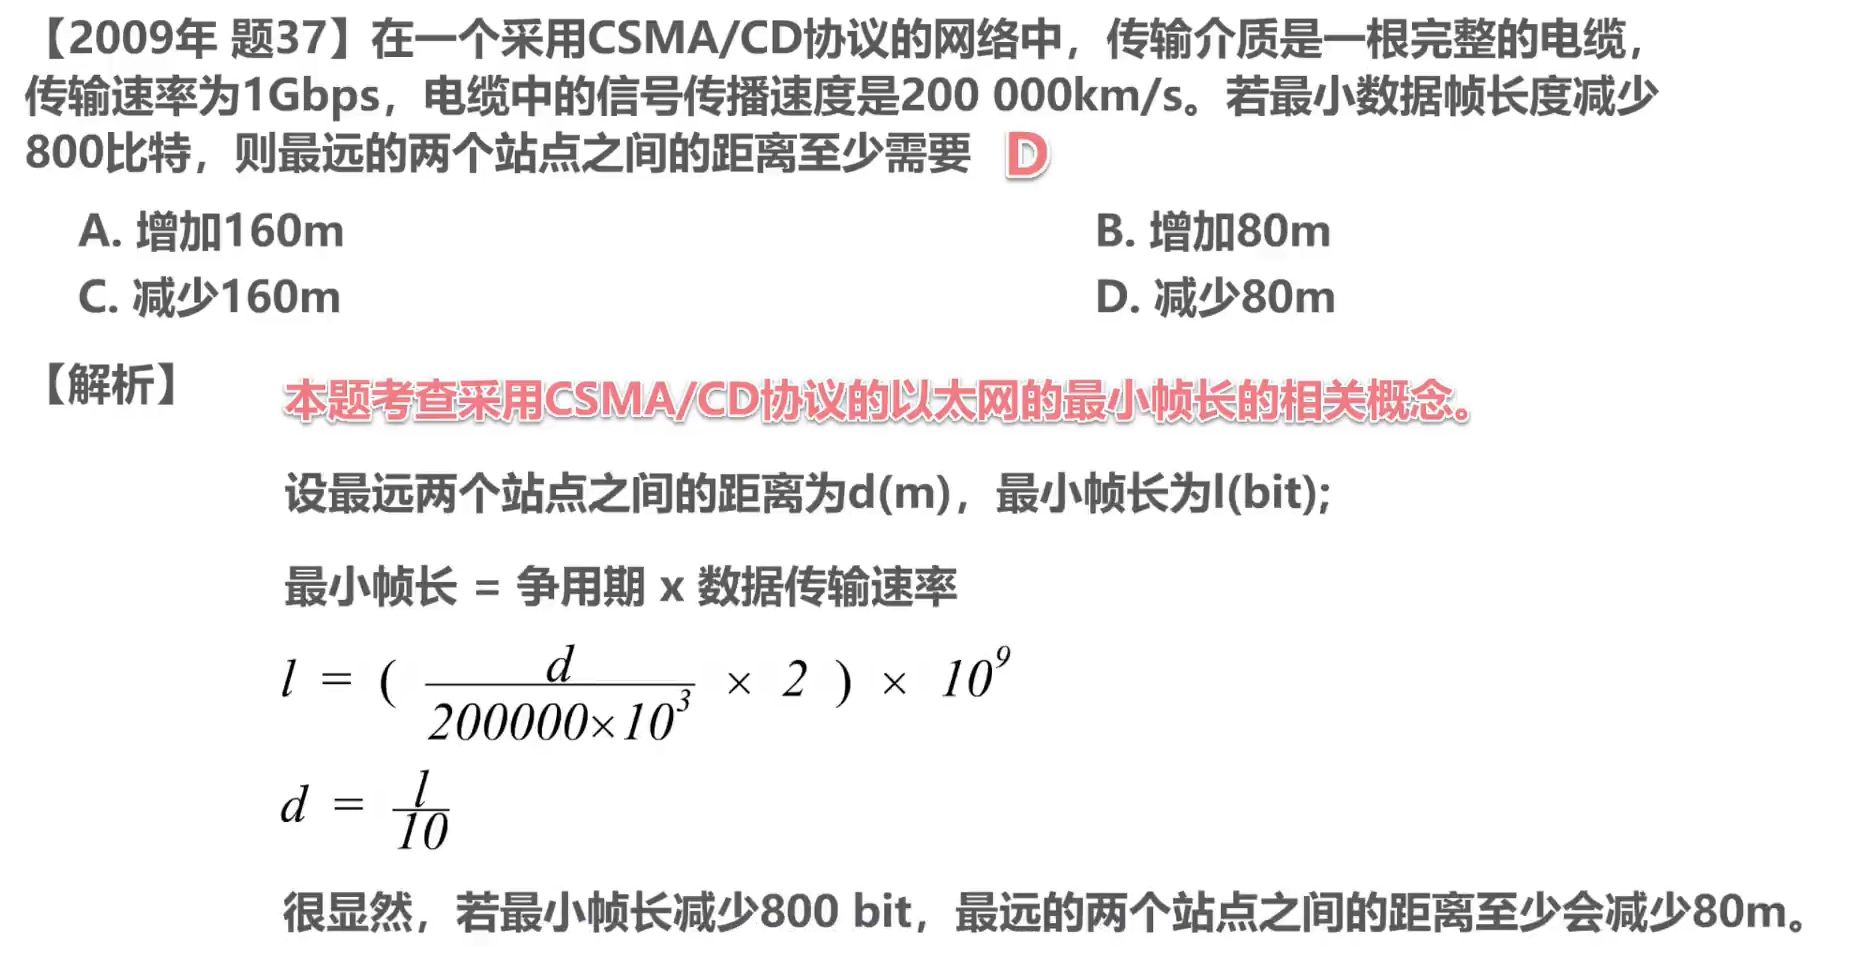
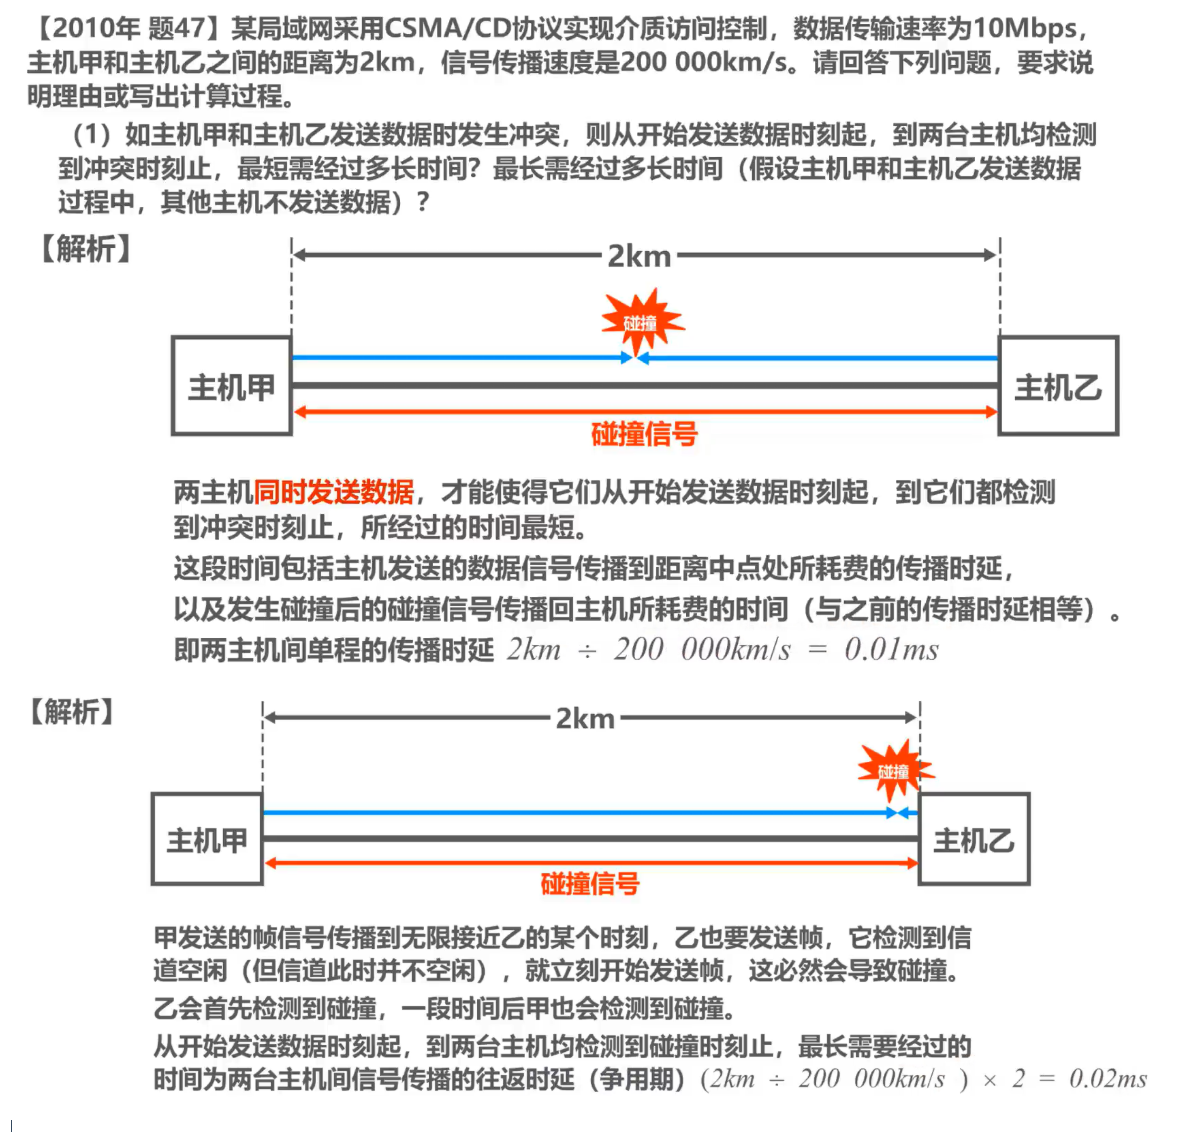
MAC地址、IP地址以及ARP协议习题
以太网交换机自学习和转发帧的流程
网络层
网络层概述
网络层的主要任务是实现网络互连,进而实现数据包在各网络之间的传输
要实现网络层任务,需要解决一下主要问题:
网络层向运输层提供怎样的服务(“可靠传输”还是“不可靠传输”)
网络层寻址问题
路由选择问题
路由器收到数据后,是依据什么来决定将数据包从自己的哪个接口转发出去?
答:依据 数据包的目的地址 和 路由器中的路由表
在实际当中,路由器是怎样知道这些路由记录?
- 由用户或网络管理员进行人工配置,这种方法只适用于规模较小且网络拓扑不改变的小型互联网
- 另一种是实现各种路由选择协议,由路由器执行路由选择协议中所规定的路由选择算法,而自动得出路由表中的路有记录,这种方法更适合规模较大且网络拓扑经常改变的大型互联网
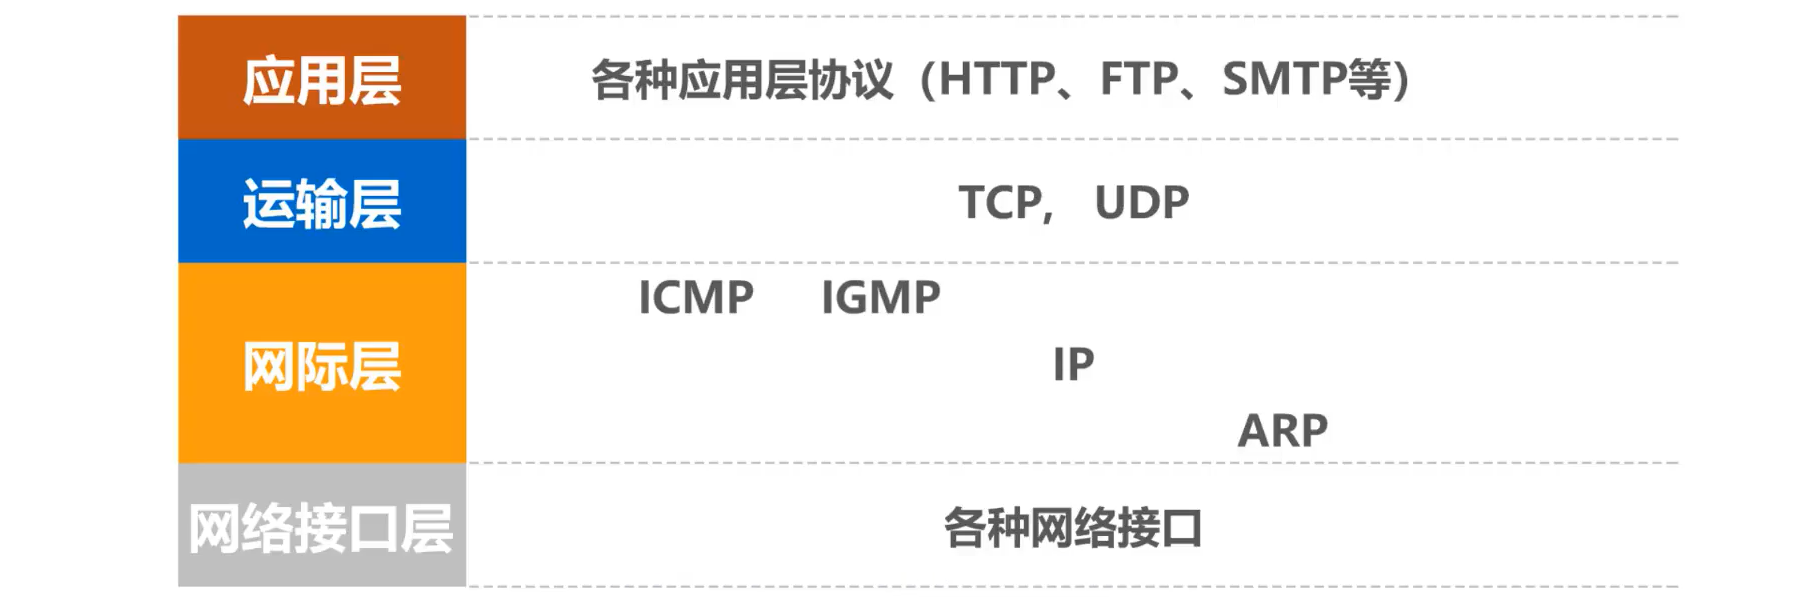
补充: 网络层(网际层)除了 IP协议外,还有地址解析协议ARP,网际控制报文协议ICMP,网际组管理协议IGMP
两种服务
- 在计算机网络领域,网络层应该向运输层提供怎样的服务(“面向连接”还是“无连接”)曾引起了长期的争论。
- 争论焦点的实质就是:在计算机通信中,可靠交付应当由谁来负责?是网络还是端系统?
面向连接的虚电路服务
一种观点:让网络负责可靠交付
- 这种观点认为,应借助于电信网的成功经验,让网络负责可靠交付,计算机网络应模仿电信网络,使用面向连接的通信方式。
- 通信之前先建立虚电路 (Virtual Circuit),以保证双方通信所需的一切网络资源。
- 如果再使用可靠传输的网络协议,就可使所发送的分组无差错按序到达终点,不丢失、不重复。
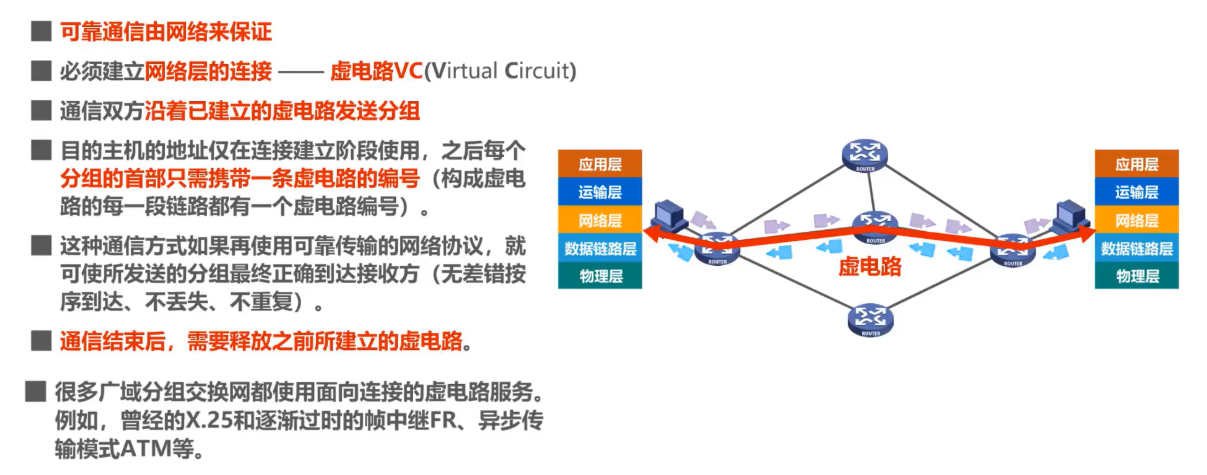
发送方 发送给 接收方 的所有分组都沿着同一条虚电路传送
- 虚电路表示这只是一条逻辑上的连接,分组都沿着这条逻辑连接按照存储转发方式传送,而并不是真正建立了一条物理连接。
- 请注意,电路交换的电话通信是先建立了一条真正的连接。因此分组交换的虚连接和电路交换的连接只是类似,但并不完全一样
无连接的数据报服务
另一种观点:网络提供数据报服务
- 互联网的先驱者提出了一种崭新的网络设计思路。
- 网络层向上只提供简单灵活的、无连接的、尽最大努力交付的数据报服务。
- 网络在发送分组时不需要先建立连接。每一个分组(即 IP 数据报)独立发送,与其前后的分组无关(不进行编号),注:每个分组的首部必须携带目的主机的完整地址。
- 网络层不提供服务质量的承诺。即所传送的分组可能出错、丢失、重复和失序(不按序到达终点),当然也不保证分组传送的时限。
发送方 发送给 接收方 的分组可能沿着不同路径传送
尽最大努力交付
- 如果主机(即端系统)中的进程之间的通信需要是可靠的,那么就由网络的主机中的运输层负责可靠交付(包括差错处理、流量控制等) 。
- 采用这种设计思路的好处是:网络的造价大大降低,运行方式灵活,能够适应多种应用。
- 互连网能够发展到今日的规模,充分证明了当初采用这种设计思路的正确性。
对比
| 对比的方面 | 虚电路服务 | 数据报服务 |
|---|---|---|
| 思路 | 可靠通信应当由网络来保证 | 可靠通信应当由用户主机来保证 |
| 连接的建立 | 必须有 | 不需要 |
| 终点地址 | 仅在连接建立阶段使用,每个分组使用短的虚电路号 | 每个分组都有终点的完整地址 |
| 分组的转发 | 属于同一条虚电路的分组均按照同一路由进行转发 | 每个分组独立选择路由进行转发 |
| 当结点出故障时 | 所有通过出故障的结点的虚电路均不能工作 | 出故障的结点可能会丢失分组,一些路由可能会发生变化 |
| 分组的顺序 | 总是按发送顺序到达终点 | 到达终点时不一定按发送顺序 |
| 端到端的差错处理和流量控制 | 可以由网络负责,也可以由用户主机负责 | 由用户主机负责 |
IPv4
概述
IPv4地址 就是给因特网(Internet)上的每一台主机(或路由器)的每一个接口分配一个在全世界范围内是唯一的32比特的标识符。
IP地址由因特网名字和数字分配机构ICANN (Internet Corporation for Assigned Names and Numbers) 进行分配。
- 我国用户可向亚太网络信息中心APNIC (Asia Pacific Network Information Center) 申请IP地址,需要缴费。
- 2011年2月3日,互联网号码分配管理局 IANA(由ICANN行使职能) 宣布,IPv4地址已经分配完毕。
- 我国在2014至2015年也逐步停止了向新用户和应用分配IPv4地址。同时全面开展商用部署IPv6.
IPV4地址的编址方法经历了如下三个历史阶段:
- 1981—— 分类编址
- 1985 —— 划分子网
- 1993 —— 无分类编址
由于32比特的IPv4地址不方便阅读、记录,于是IPv4地址采用点分十进制表示方法以便用户使用:每8位为一组,写成十进制形式,每组以点号分隔。
IP 地址的一些重要特点
(1) IP 地址是一种分等级的地址结构。分两个等级的好处是:
- 第一,IP 地址管理机构在分配 IP 地址时只分配网络号,而剩下的主机号则由得到该网络号的单位自行分配。这样就方便了 IP 地址的管理。
- 第二,路由器仅根据目的主机所连接的网络号来转发分组(而不考虑目的主机号),这样就可以使路由表中的项目数大幅度减少,从而减小了路由表所占的存储空间。
(2) 实际上 IP 地址是标志一个主机(或路由器)和一条链路的接口。
- 当一个主机同时连接到两个网络上时,该主机就必须同时具有两个相应的 IP 地址,其网络号 net-id 必须是不同的。这种主机称为多归属主机 (multihomed host)。
- 由于一个路由器至少应当连接到两个网络(这样它才能将 IP 数据报从一个网络转发到另一个网络),因此一个路由器至少应当有两个不同的 IP 地址。
(3) 用转发器或网桥连接起来的若干个局域网仍为一个网络,因此这些局域网都具有同样的网络号 net-id。
(4) 所有分配到网络号 net-id 的网络,无论是范围很小的局域网,还是可能覆盖很大地理范围的广域网,都是平等的。
分类编制
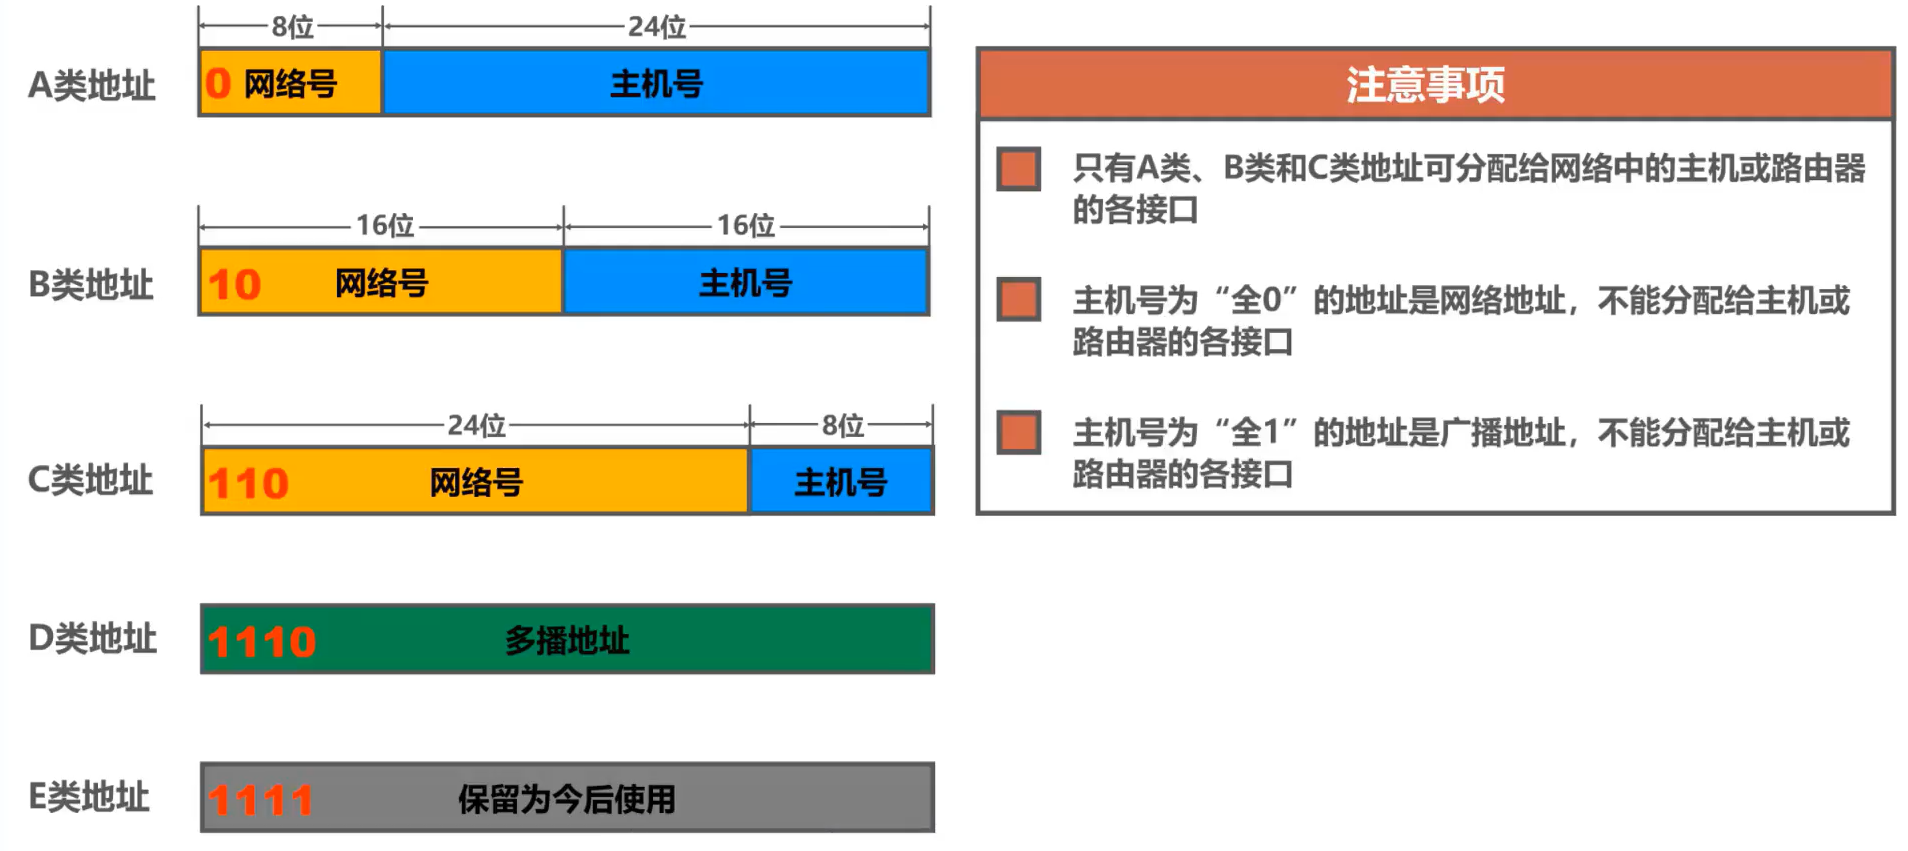
- 每一类地址都由两个固定长度的字段组成,其中一个字段是网络号 net-id,它标志主机(或路由器)所连接到的网络,而另一个字段则是主机号 host-id,它标志该主机(或路由器)。
- 主机号在它前面的网络号所指明的网络范围内必须是唯一的。
- 由此可见,一个 IP 地址在整个互联网范围内是唯一的。
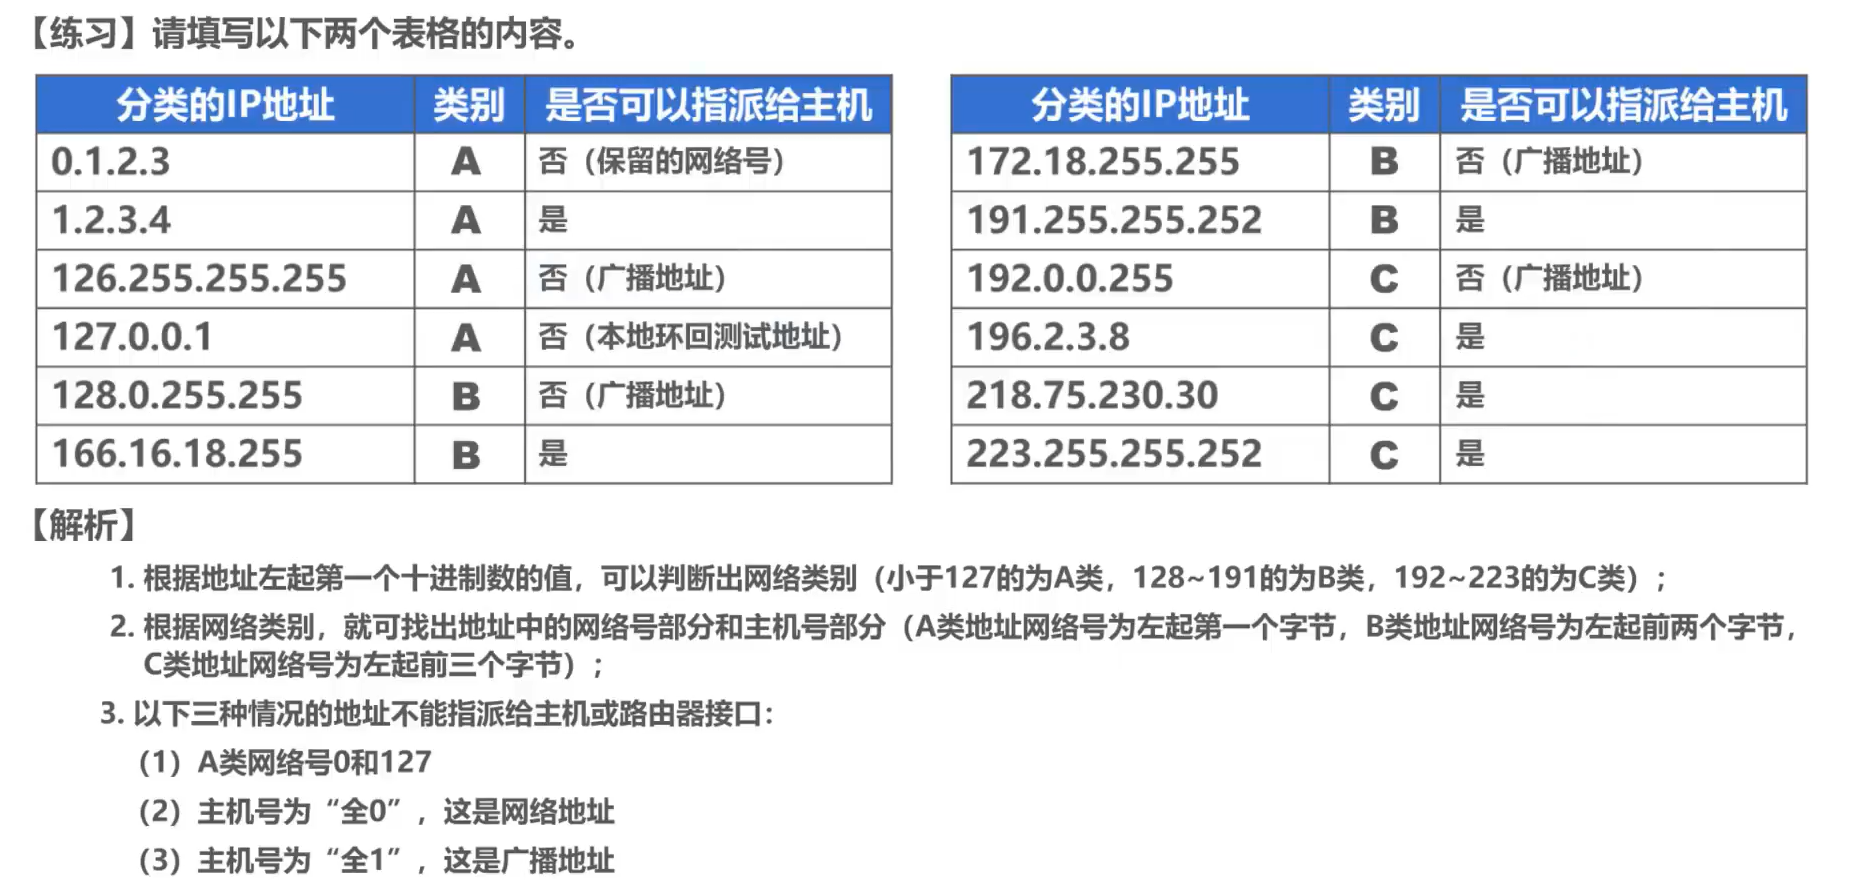
只有A、B、C类地址可分给网络中的主机/路由的各接口。
主机号为 “全0” 的地址是网络地址,不能分配给主机/路由的各接口。
主机号为 “全1” 的地址是广播地址,不能分配给主机/路由的各接口。
A类地址
- 第一位固定为0,前8位作为网络号。
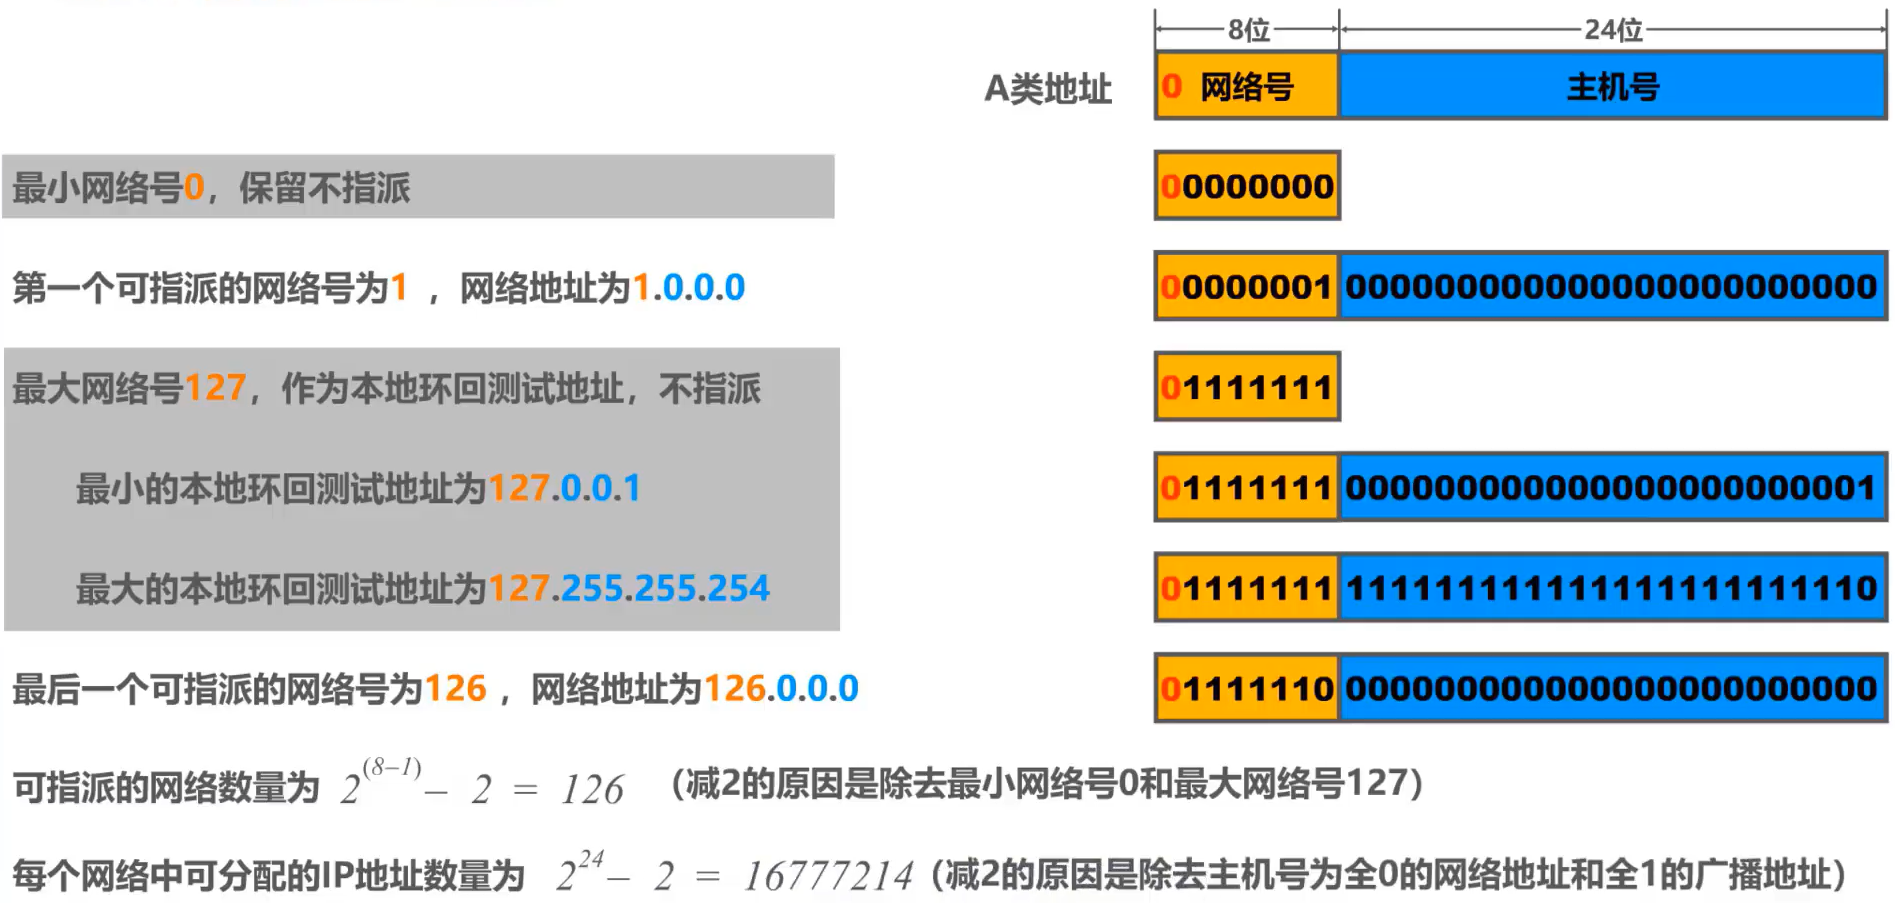
B类地址
- 前两位固定为01,前16位作为网络号。
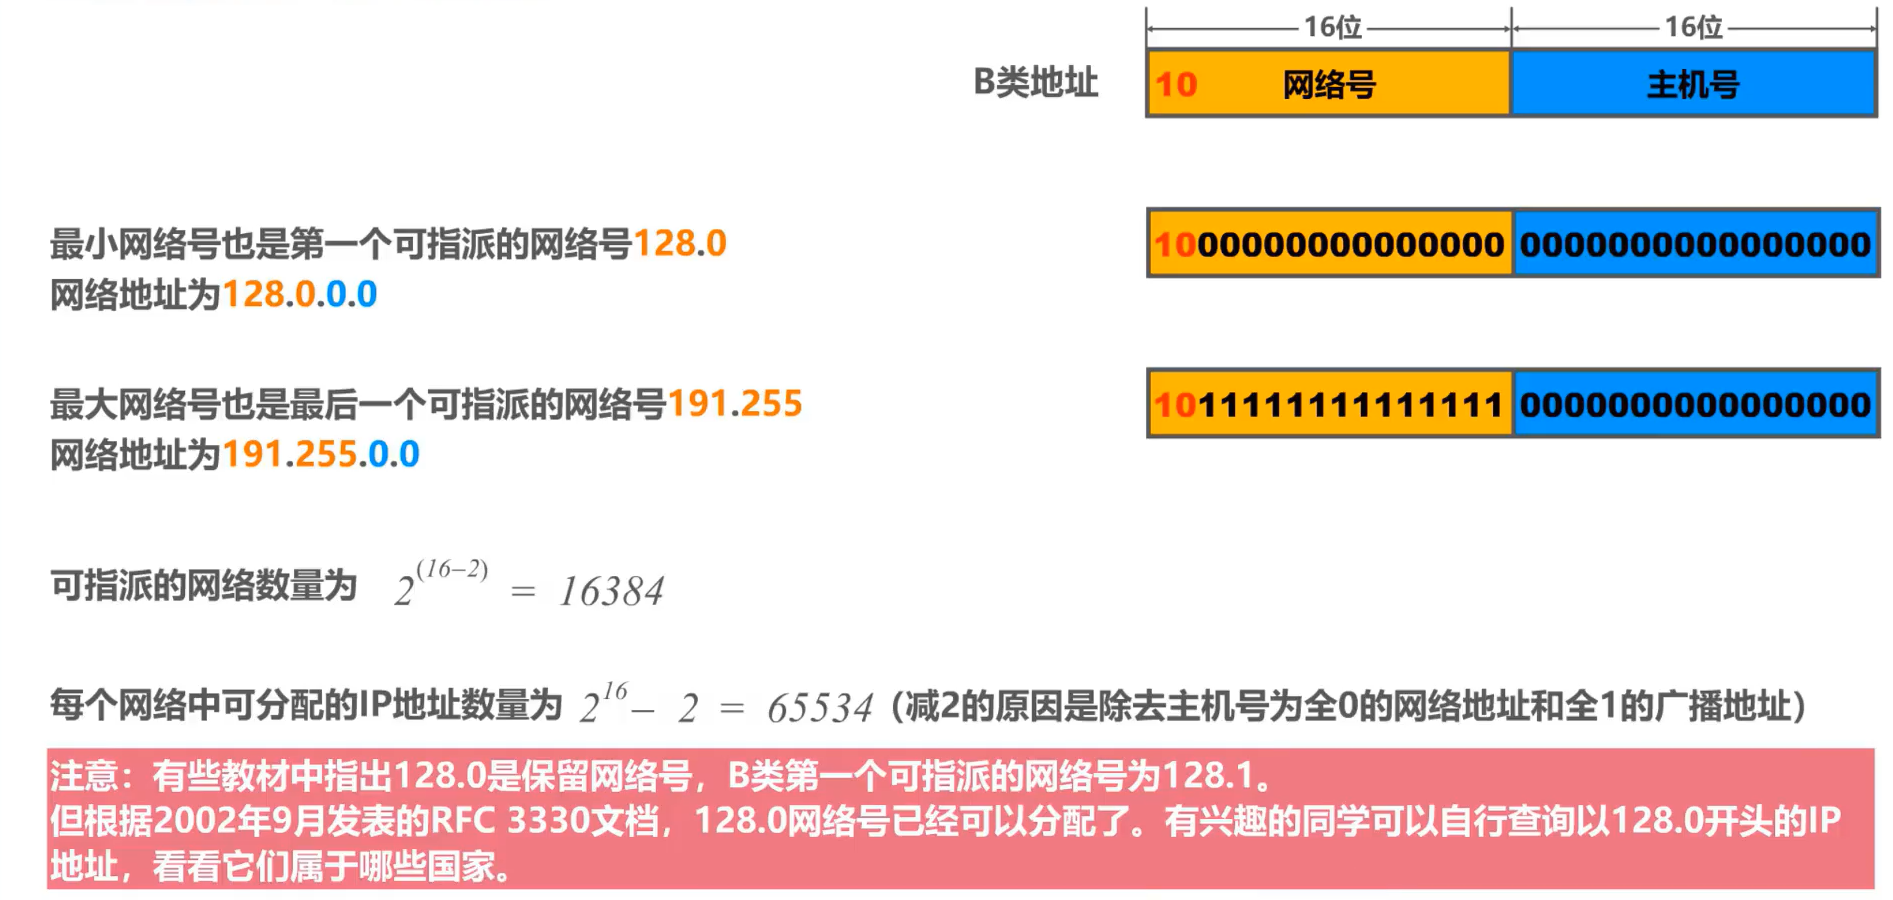
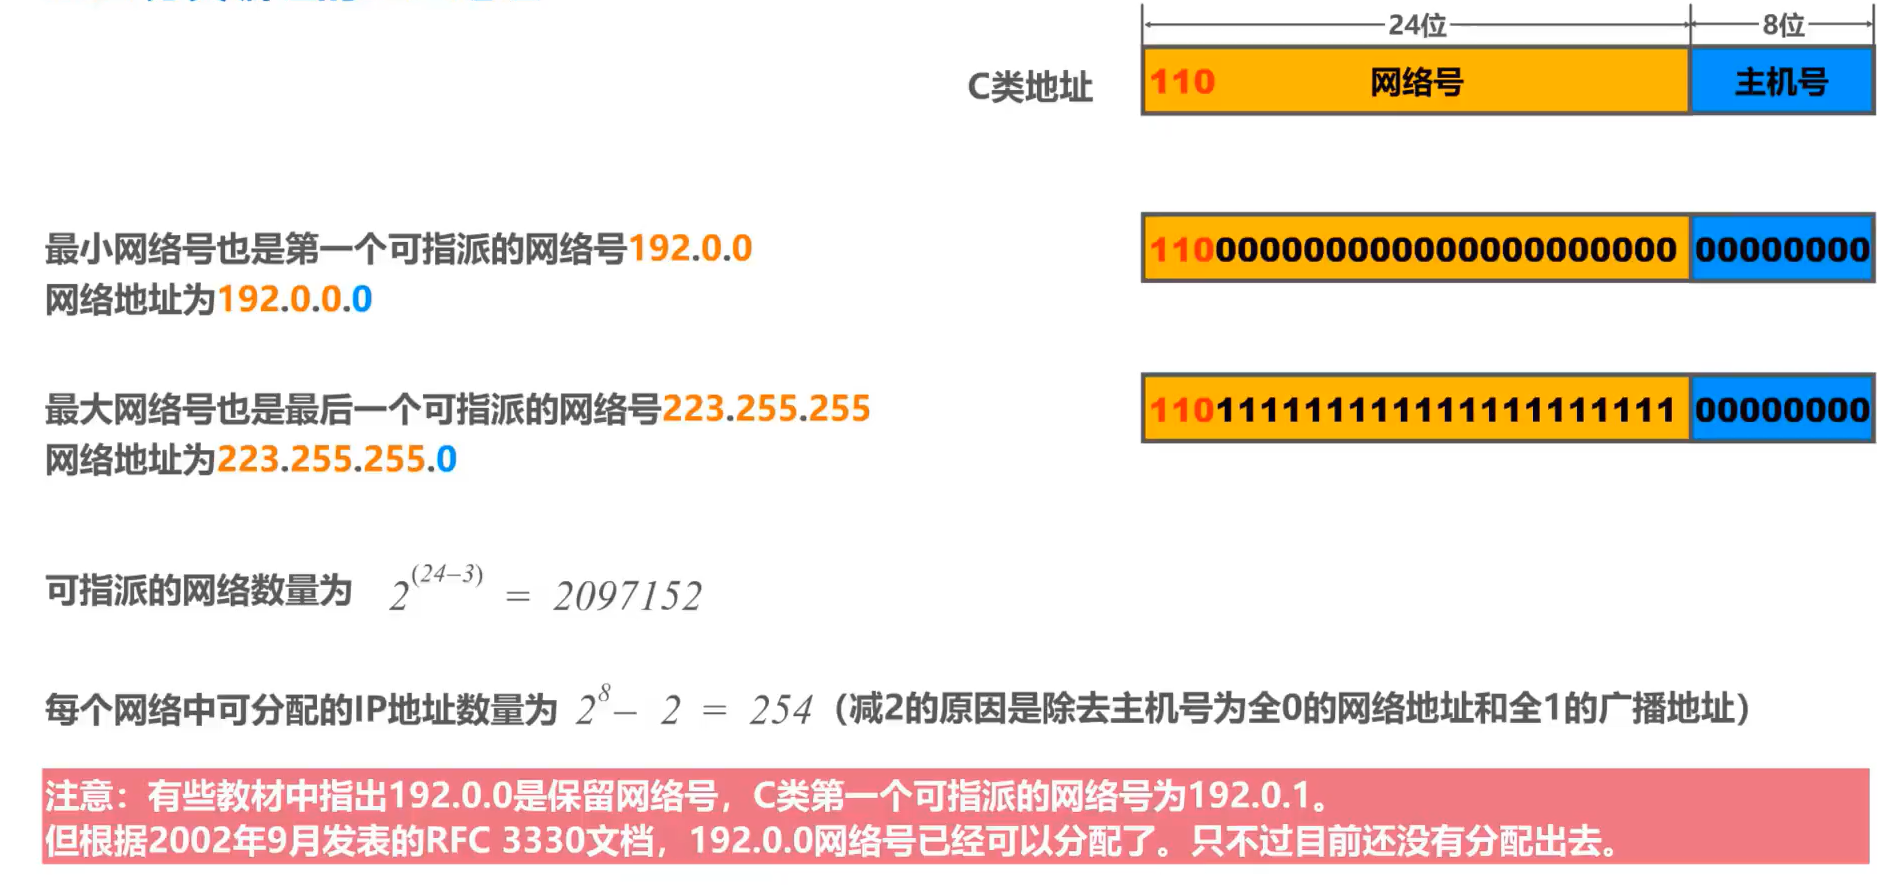
C类地址
- 前3位固定为110,前24位作为网络号。
练习
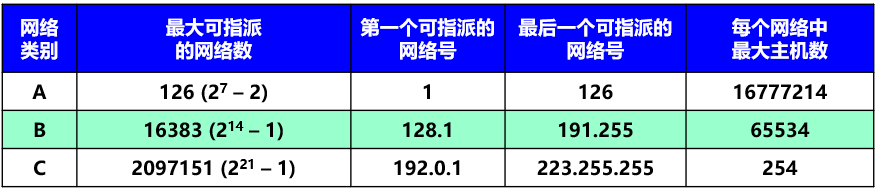
总结
IP 地址的指派范围
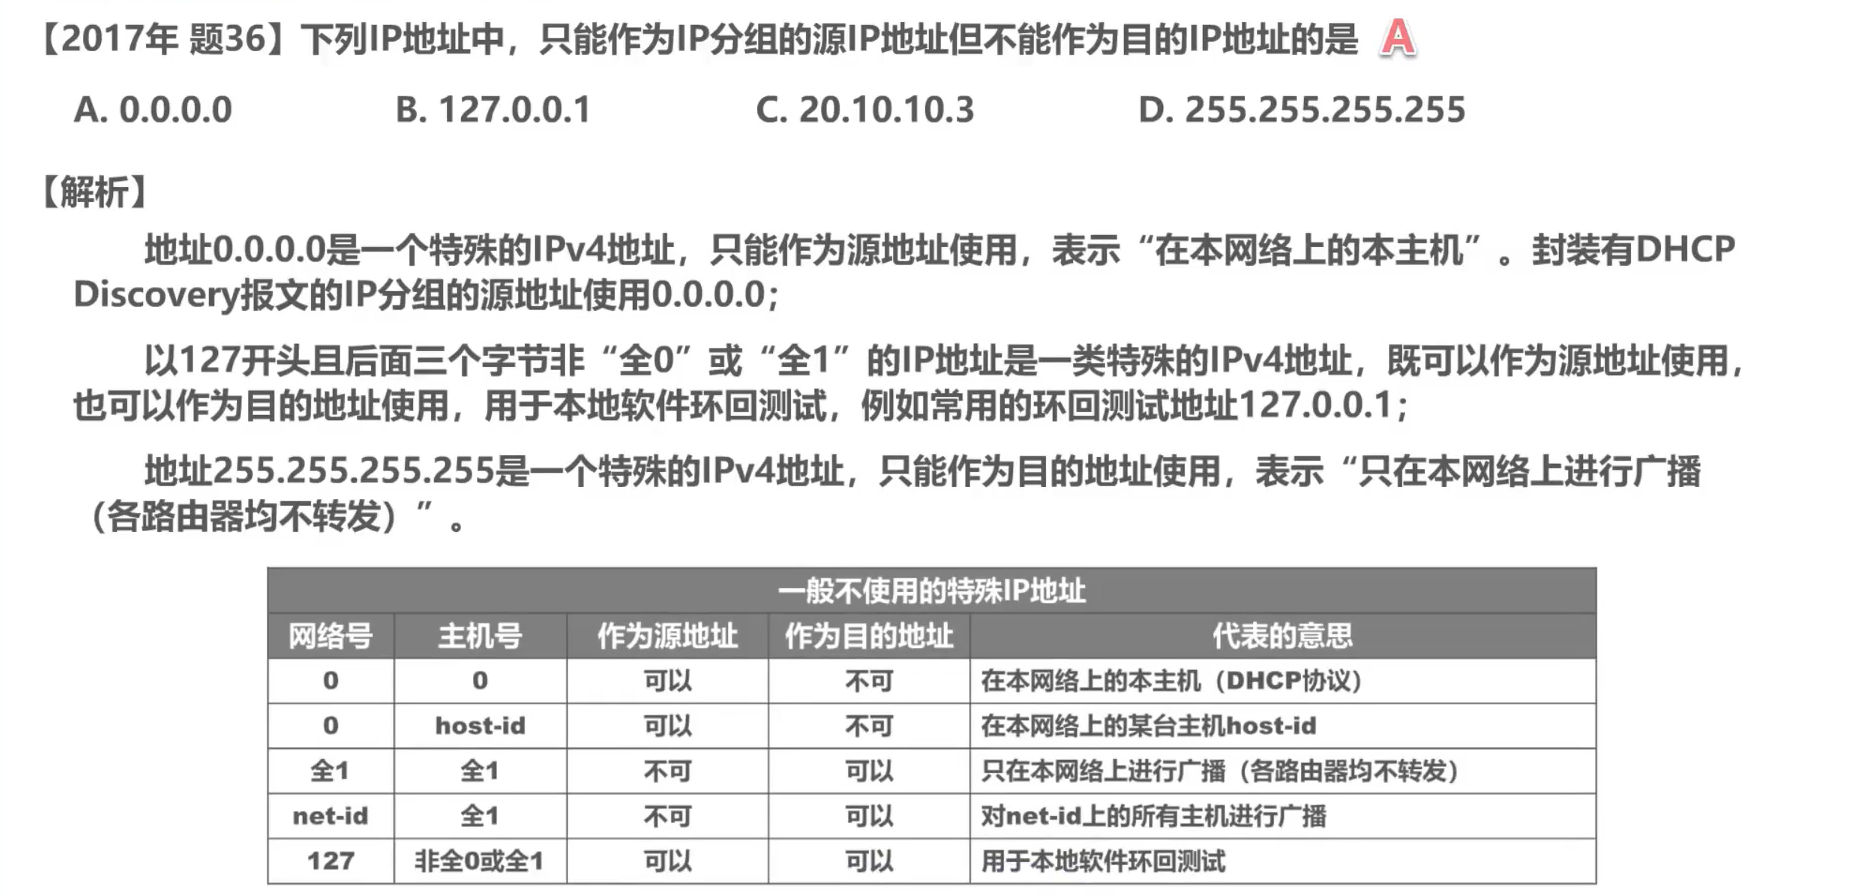
一般不使用的特殊的 IP 地址
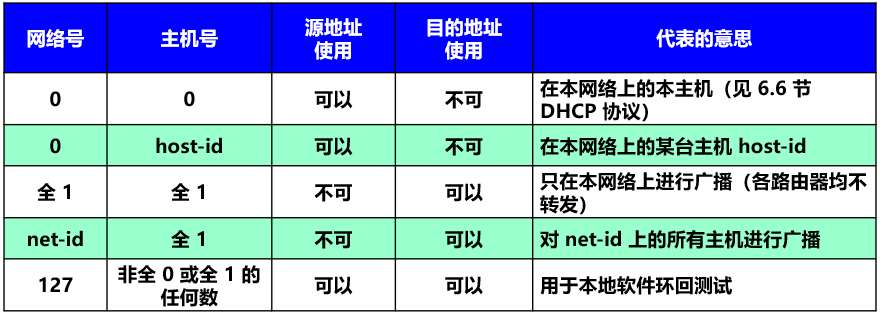
划分子网
为什么要划分子网?
在 ARPANET 的早期,IP 地址的设计确实不够合理:
- IP 地址空间的利用率有时很低。
- 给每一个物理网络分配一个网络号会使路由表变得太大因而使网络性能变坏。
- 两级的 IP 地址不够灵活。
比如:如果想要将原来的网络划分成三个独立的网路,就需要申请新的网络号,这需要花费更多的时间和费用,浪费原有网络中剩余的大量IP地址。
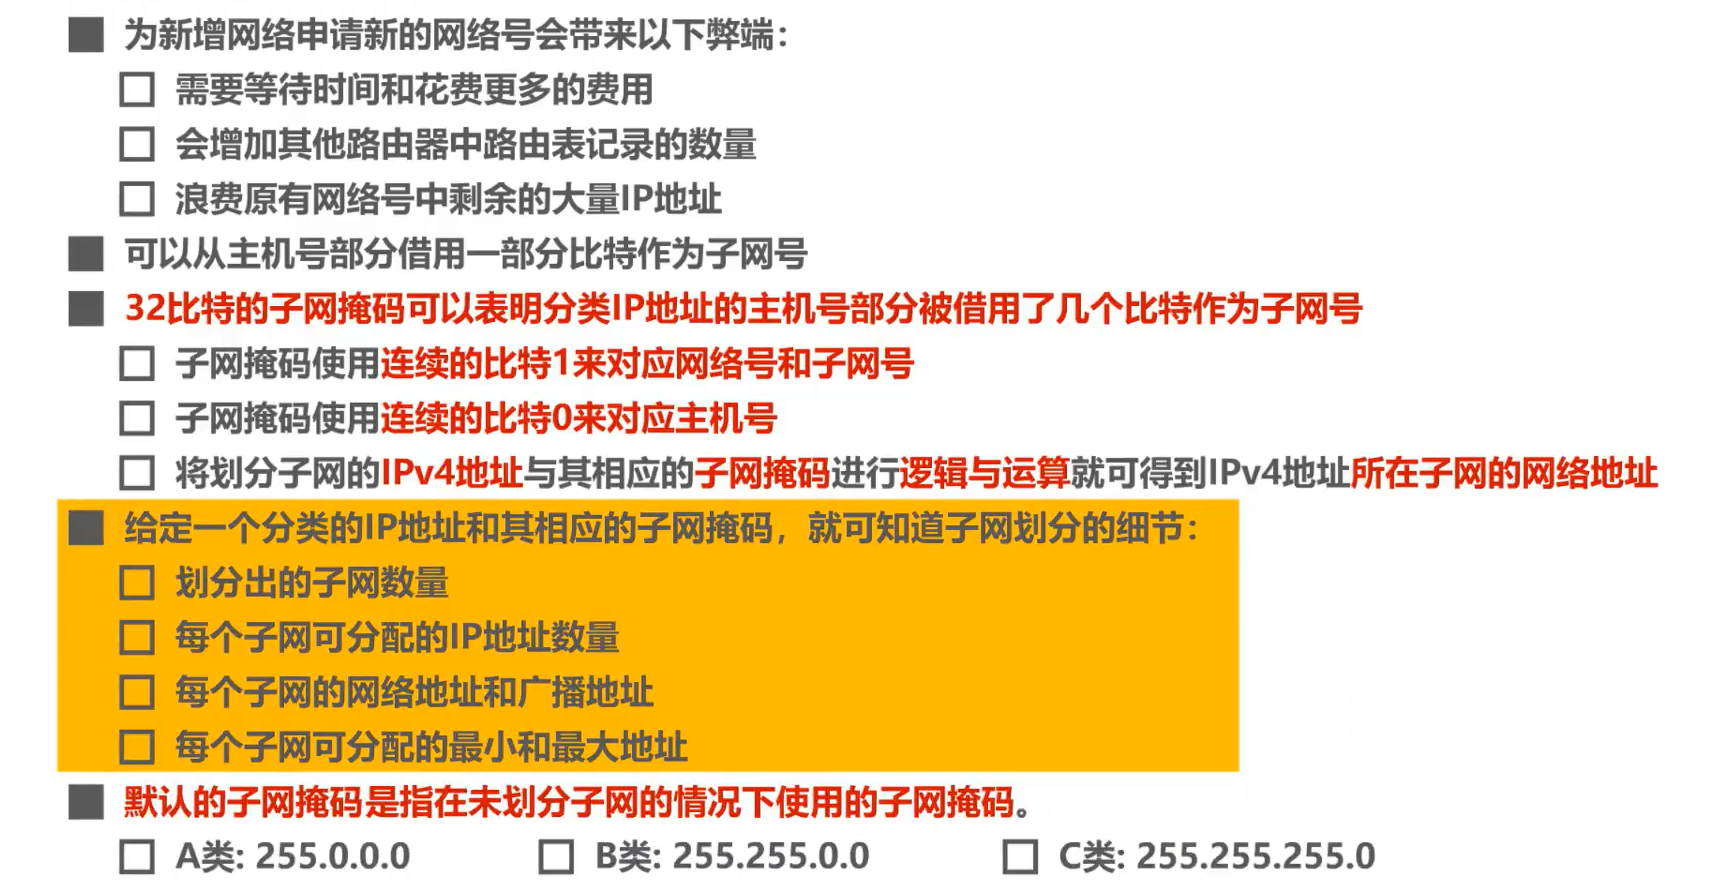
所以可以从主机号部分借用一部分作为子网号,而为了知道分类地址中主机号有多少比特被用作子网号,所以就有了划分子网的工具:子网掩码
- 从 1985 年起在 IP 地址中又增加了一个“子网号字段”,使两级的 IP 地址变成为三级的 IP 地址。
- 这种做法叫做划分子网 (subnetting) 。
- 划分子网已成为互联网的正式标准协议。
如何划分子网:
基本思路
划分子网纯属一个单位内部的事情。单位对外仍然表现为没有划分子网的网络。
从主机号借用若干个位作为子网号 subnet-id,而主机号 host-id 也就相应减少了若干个位。
凡是从其他网络发送给本单位某个主机的 IP 数据报,仍然是根据 IP 数据报的目的网络号 net-id,先找到连接在本单位网络上的路由器。
然后此路由器在收到 IP 数据报后,再按目的网络号 net-id 和子网号 subnet-id 找到目的子网。
最后就将 IP 数据报直接交付目的主机。
划分为三个子网后对外仍是一个网络
- 优点
- 减少了 IP 地址的浪费
- 使网络的组织更加灵活
- 更便于维护和管理
- 划分子网纯属一个单位内部的事情,对外部网络透明,对外仍然表现为没有划分子网的一个网络。
子网掩码:
使用32比特的子网掩码,可以表明分类IP地址的主机号部分被借用了几个比特作为子网号
使用连续的比特1来对应网络号和子网号
使用连续的比特0来对应主机号
将划分子网的IPv4地址与其相应的子网掩码进行逻辑与运算就可得到IPv4地址所在子网的网络地址
“与”运算后,地址中的 网络号和子网号会保留,而主机号会清零
举例
例子1
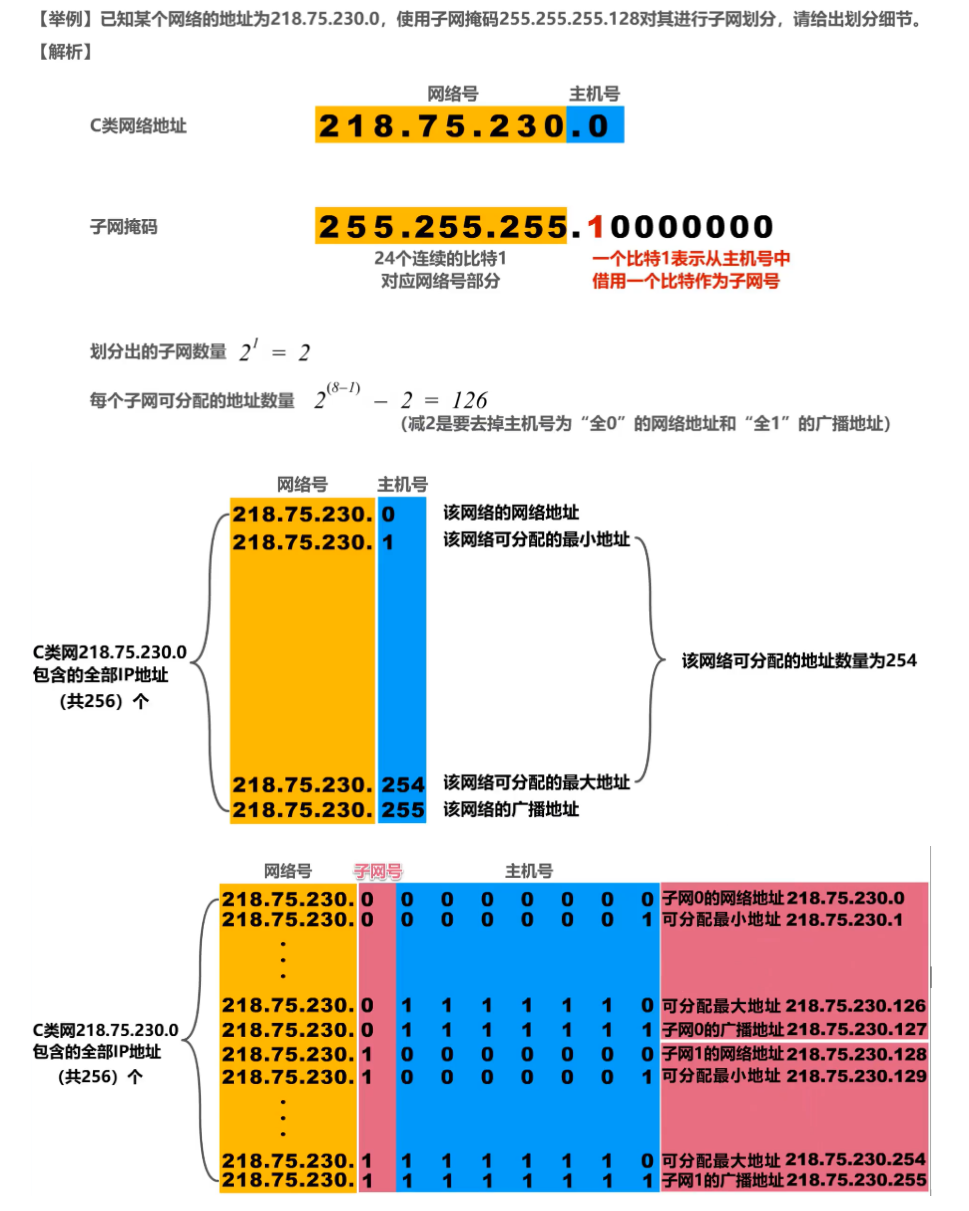
例子2
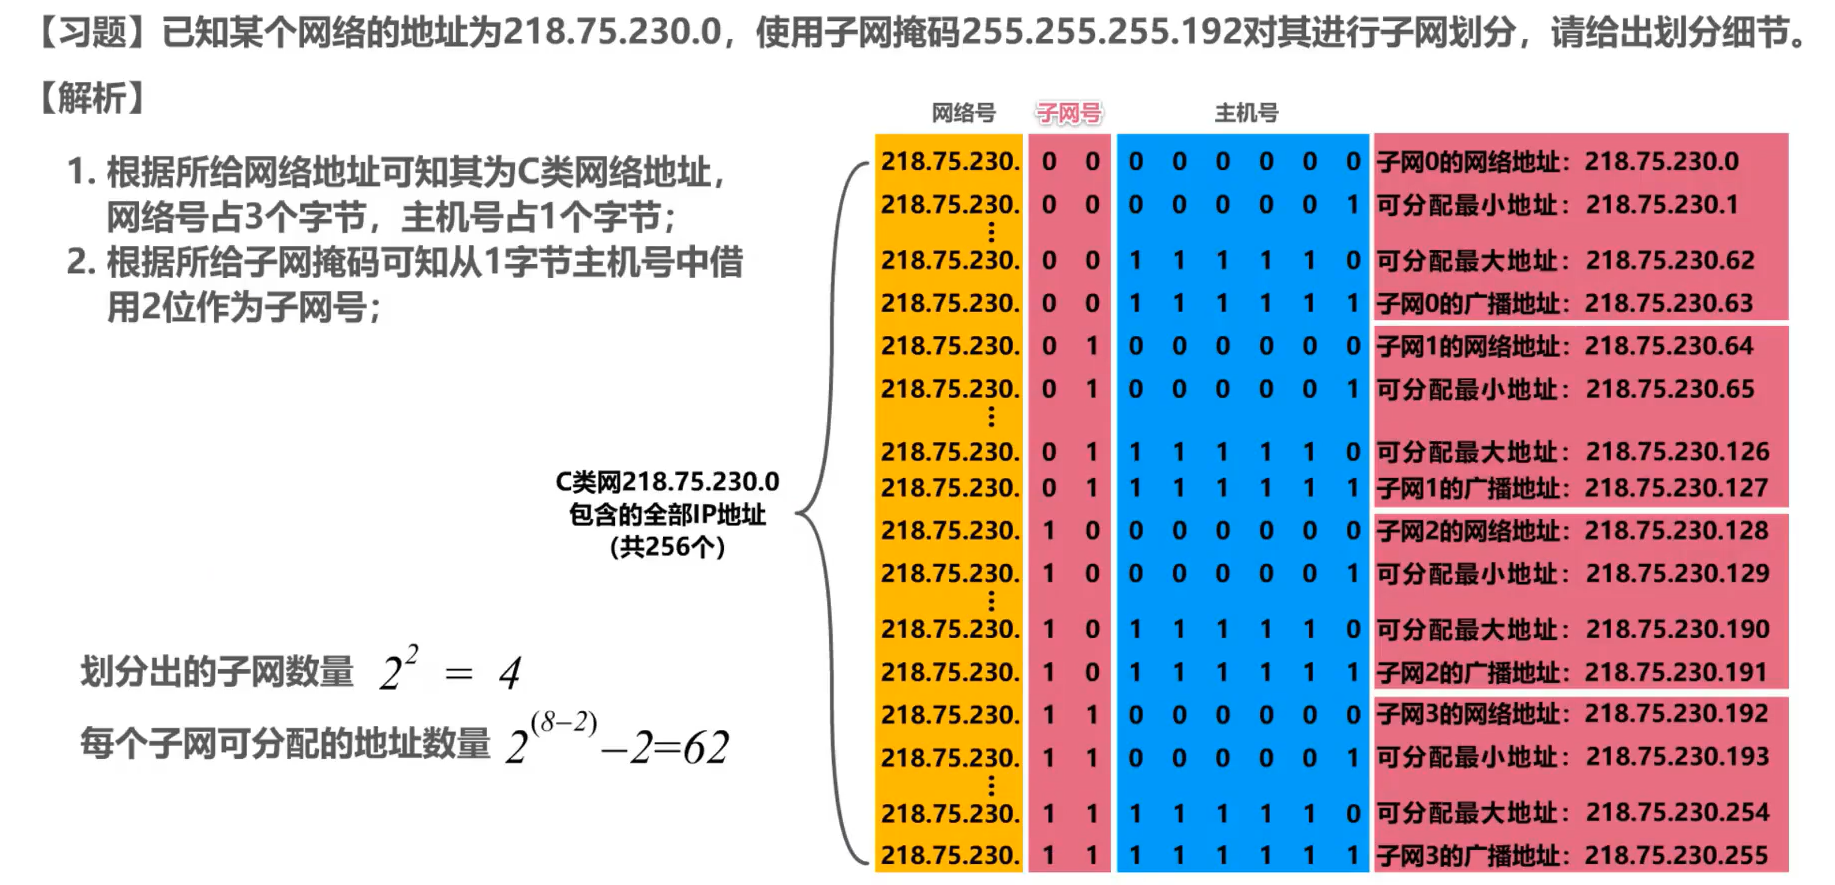
默认子网掩码
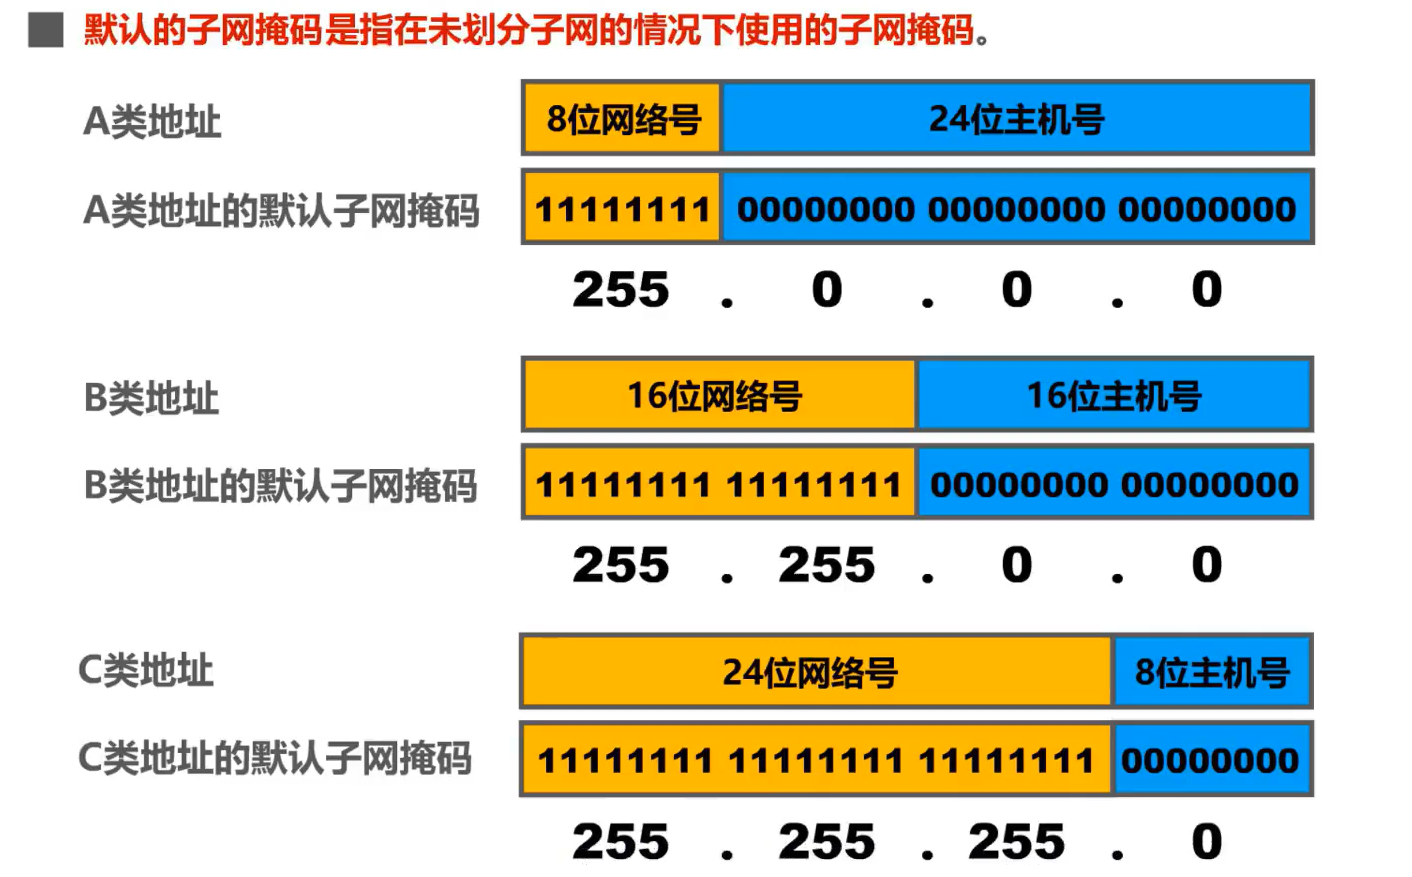
总结:
- 子网掩码是一个网络或一个子网的重要属性。
- 路由器在和相邻路由器交换路由信息时,必须把自己所在网络(或子网)的子网掩码告诉相邻路由器。
- 路由器的路由表中的每一个项目,除了要给出目的网络地址外,还必须同时给出该网络的子网掩码。
- 若一个路由器连接在两个子网上,就拥有两个网络地址和两个子网掩码。
无分类编址
为什么使用无分类编址?
- 尽管划分子网在一定程度上缓解了因特网在发展中遇到的困难,但是数量巨大的C类网因为其地址空间太小并没有得到充分使用,而因特网的P地址仍在加速消耗,整个PV4地址空间面临全部耗尽的威胁。
于是就提出了无分类域间路由选择 CIDR (Classless Inter-Domain Routing)
- CIDR消除了传统的A类、B类和C类地址,以及划分子网的概念;
- CIDR可以更加有效地分配IPV4的地址空间,并且可以在新的IPv6使用之前允许因特网的规模继续增长。
CIDR 最主要的特点
- CIDR使用各种长度的“网络前缀”(network-prefix)来代替分类地址中的网络号和子网号。
- IP 地址从三级编址(使用子网掩码)又回到了两级编址。
使用无分类编址:
CIDR使用 “斜线记法”,或称CIDR记法。即在IPV4地址后面加上斜线 “**/”,在斜线后面写上网络前缀所占的比特数量**。
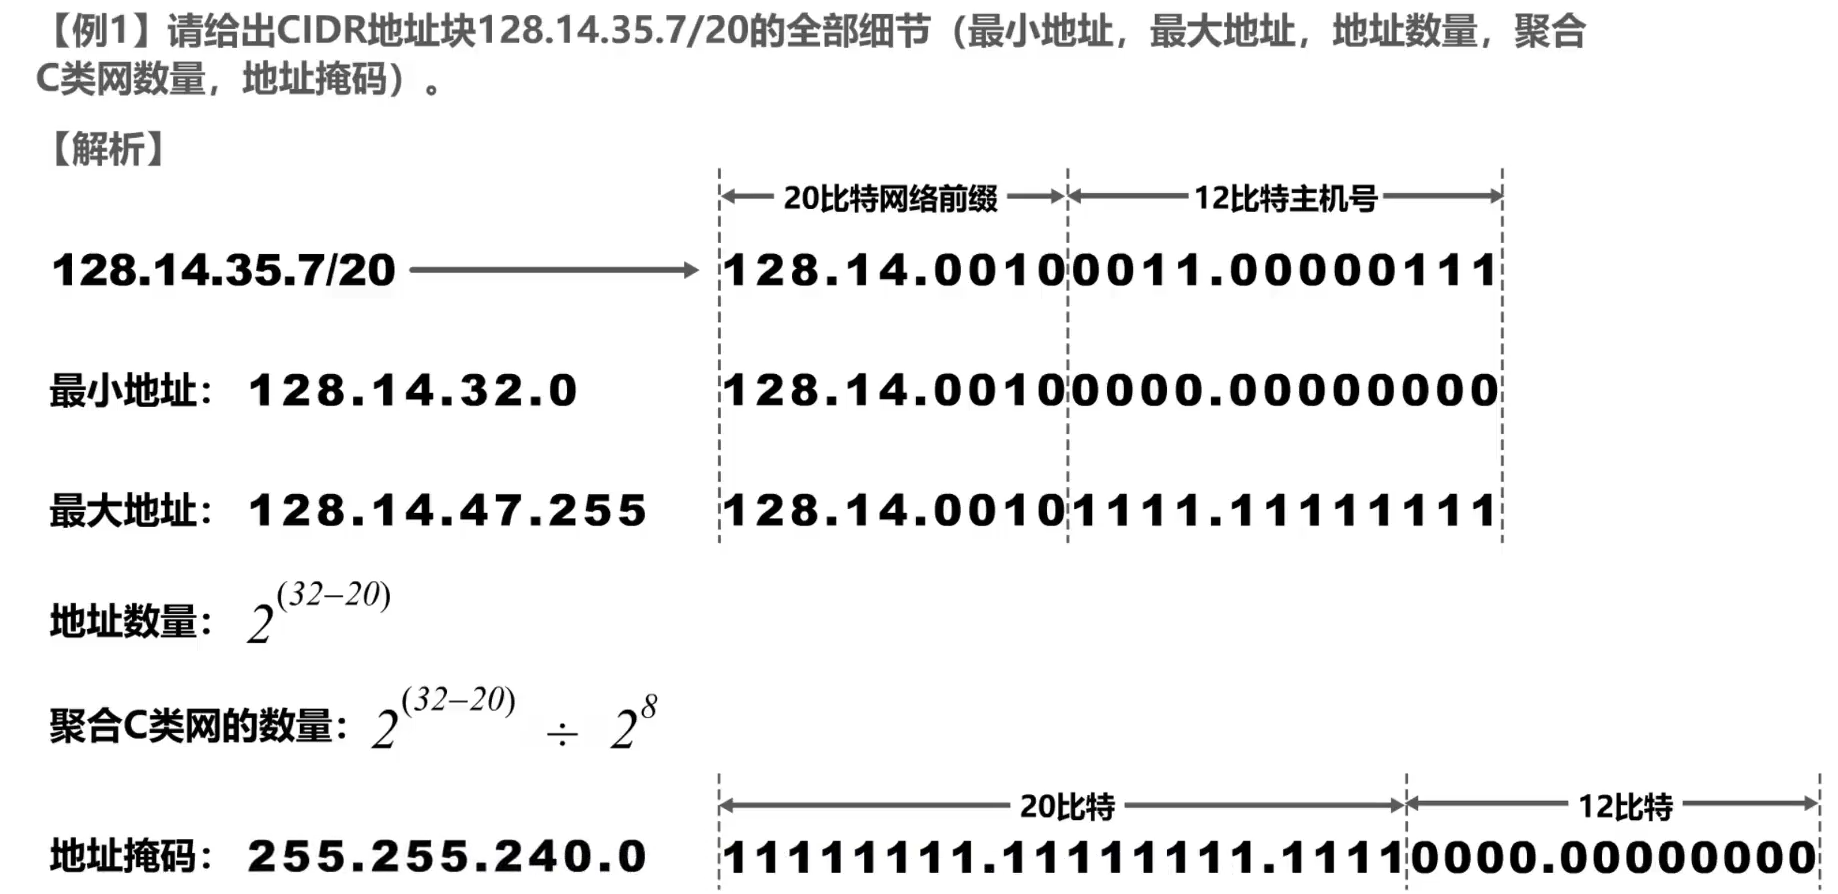
例: 128.14.35.7 / 20 表示网络前缀占用比特数20,主机编号占用比特 32-20=12
我们只要知道CIDR地址块中的任何一个地址,就可以知道该地址块的全部细节:
- 地址块的最小地址
- 地址块的最大地址
- 地址块中的地址数量
- 地址块聚合某类网络(A类、B类或C类)的数量
- 地址掩码(也可继续称为子网掩码)
举例
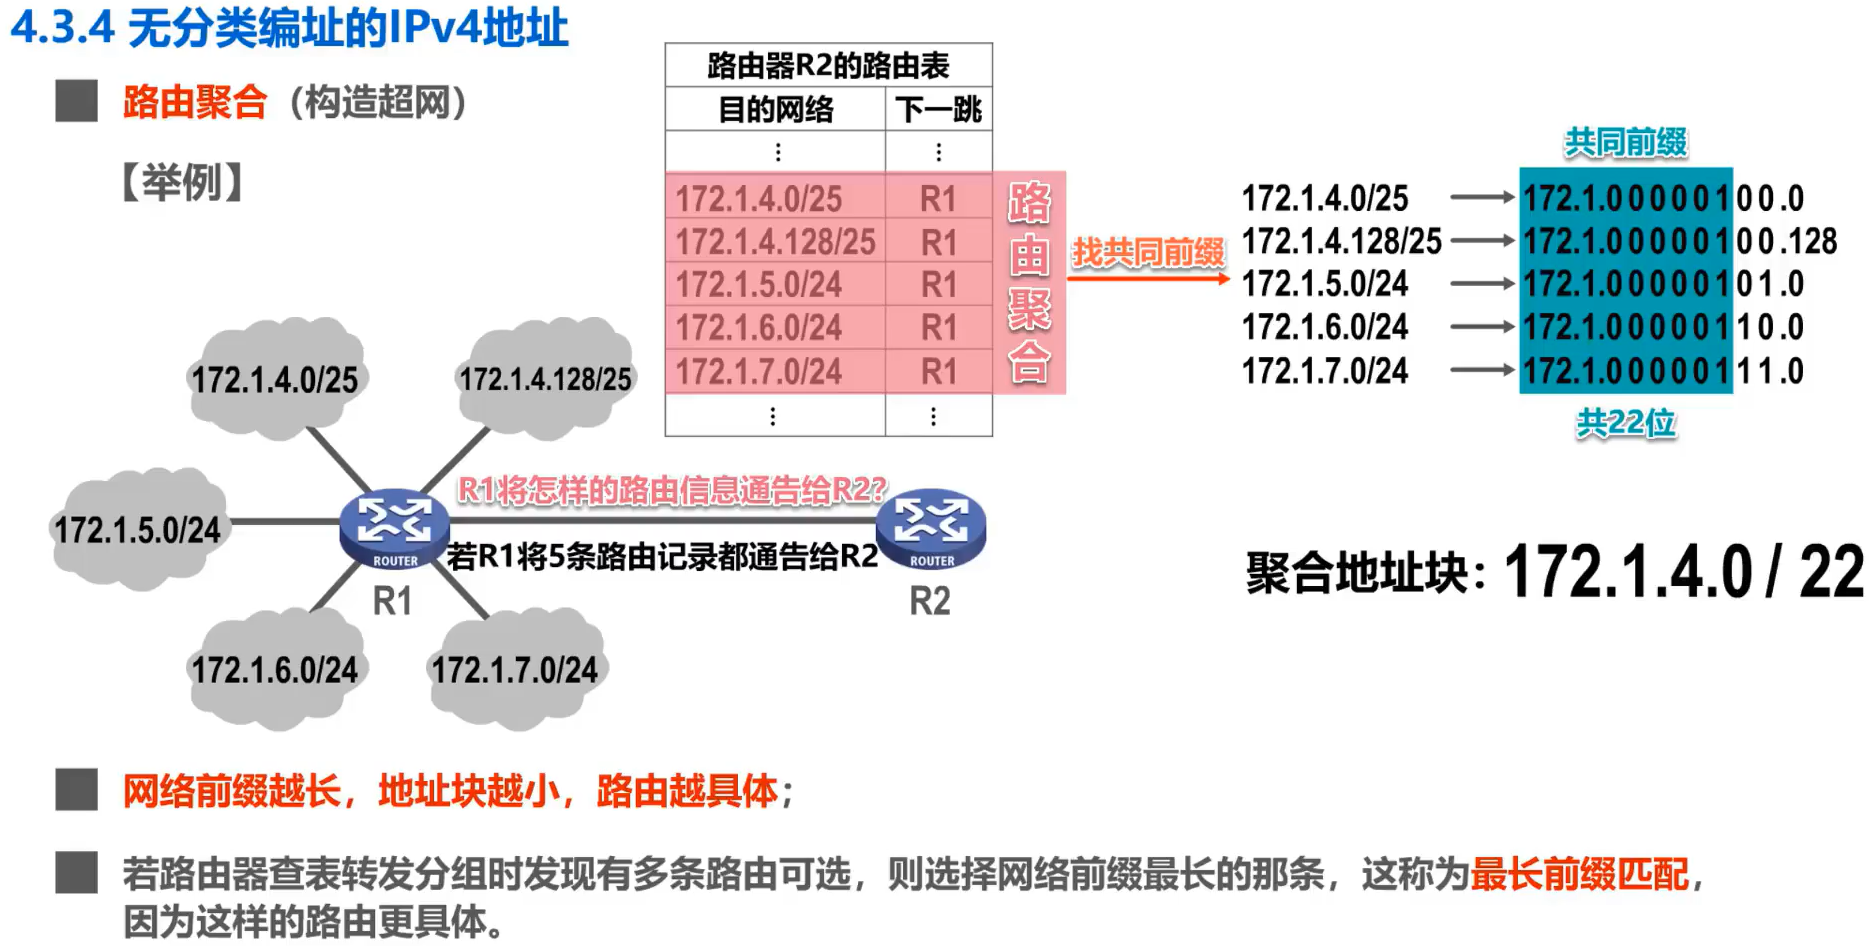
路由聚合(构造超网)
网络前缀越长,地址块越小,路由越具体;
若路由器查表转发分组时发现有多条路由可选,则选择网络前缀最长的那条,这称为最长前缀匹配,因为这样的路由更具体。
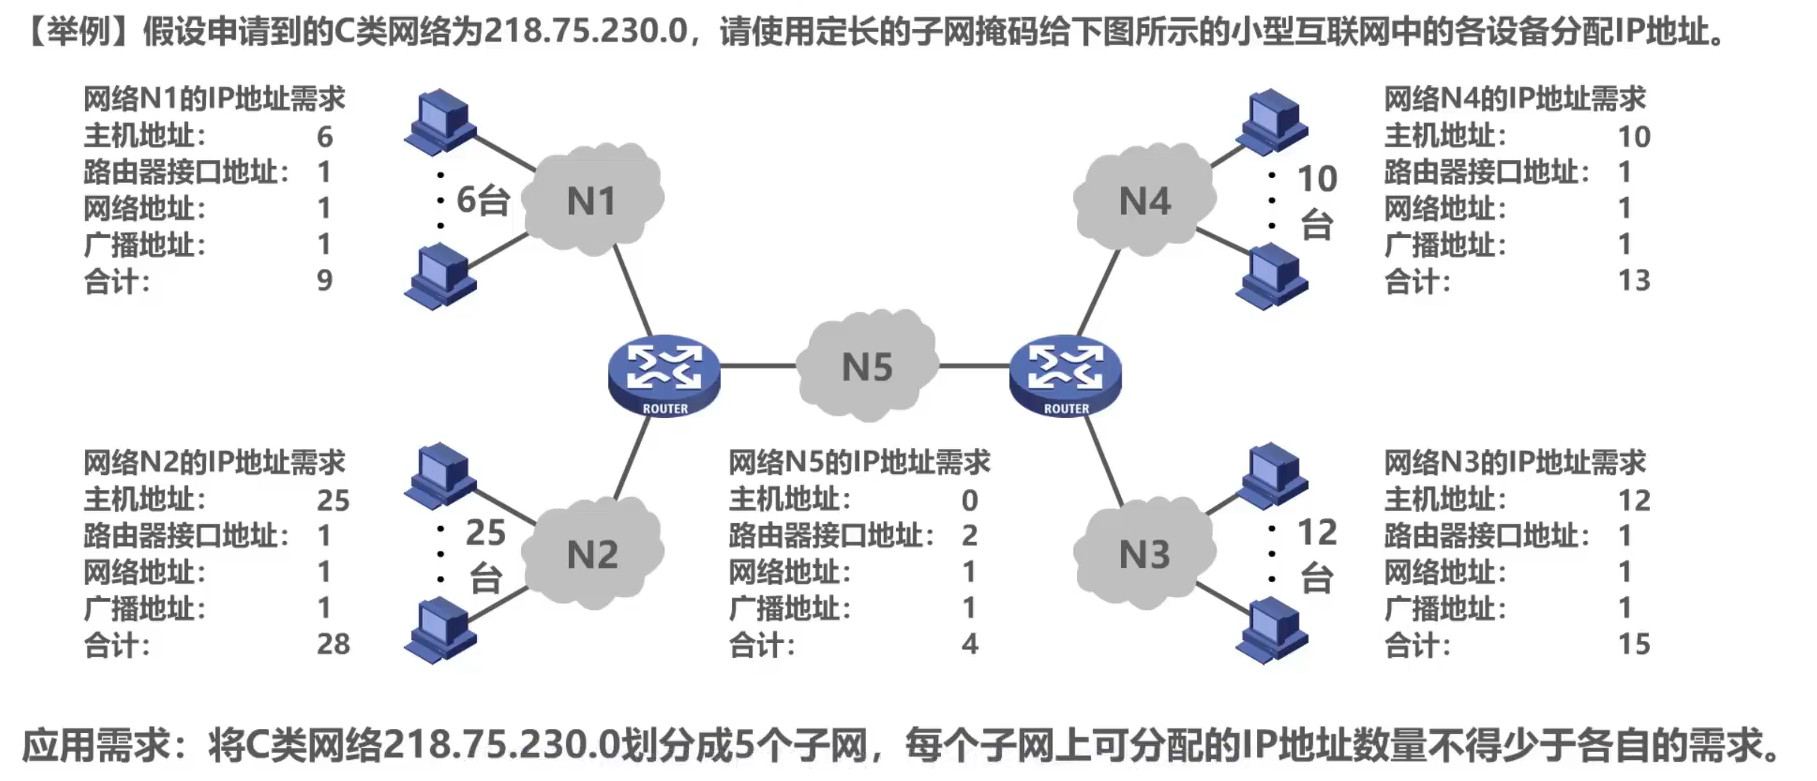
IPv4地址的应用规划
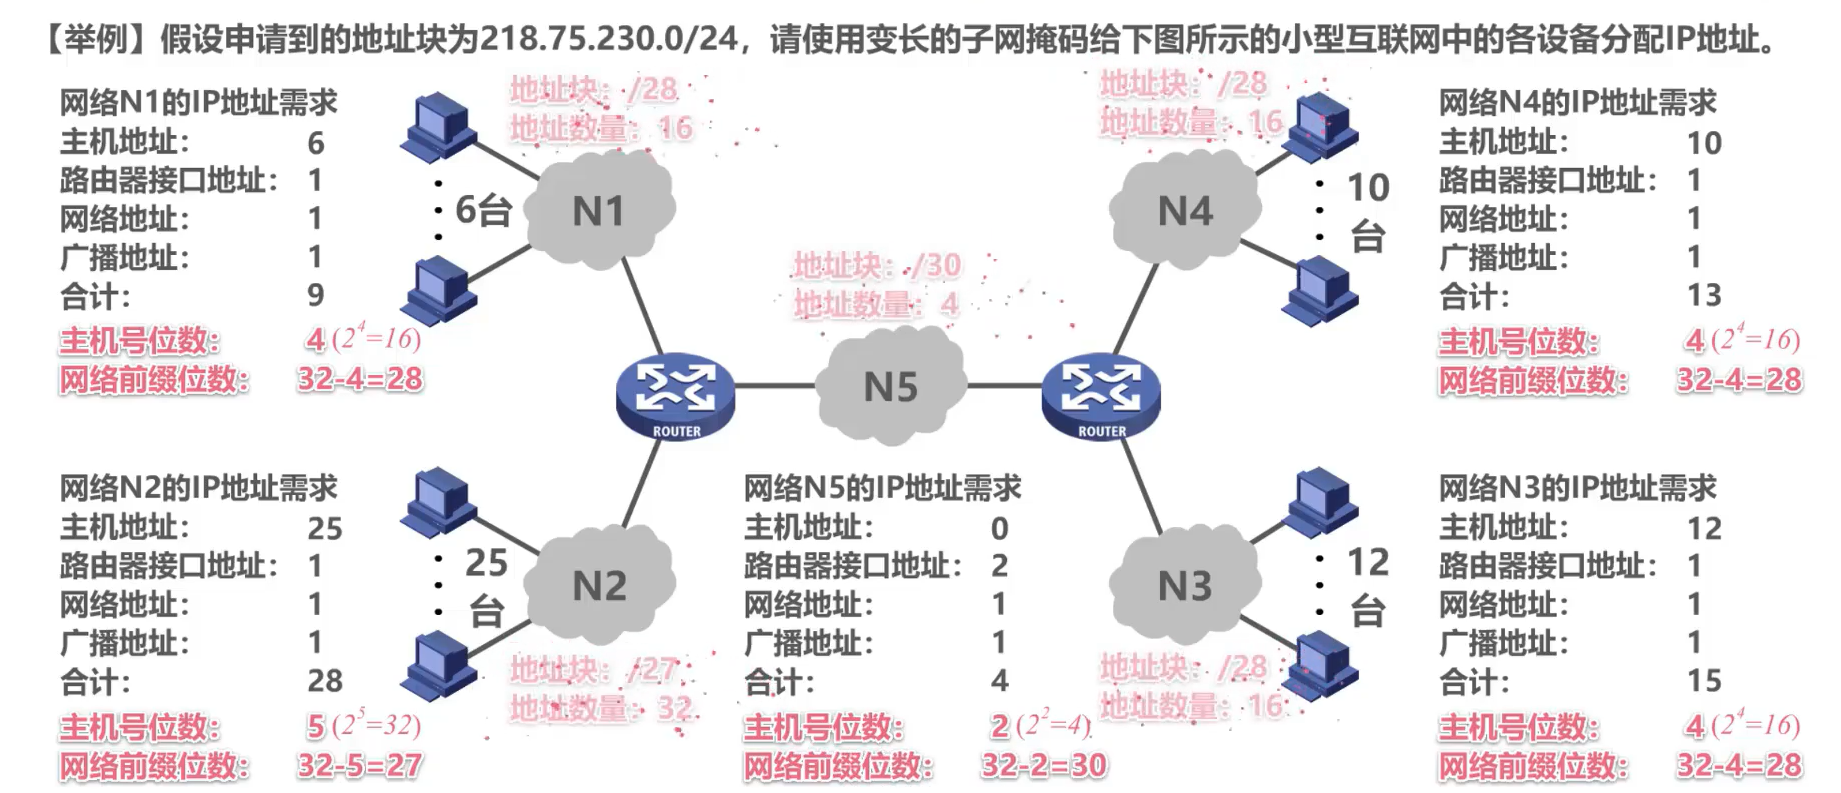
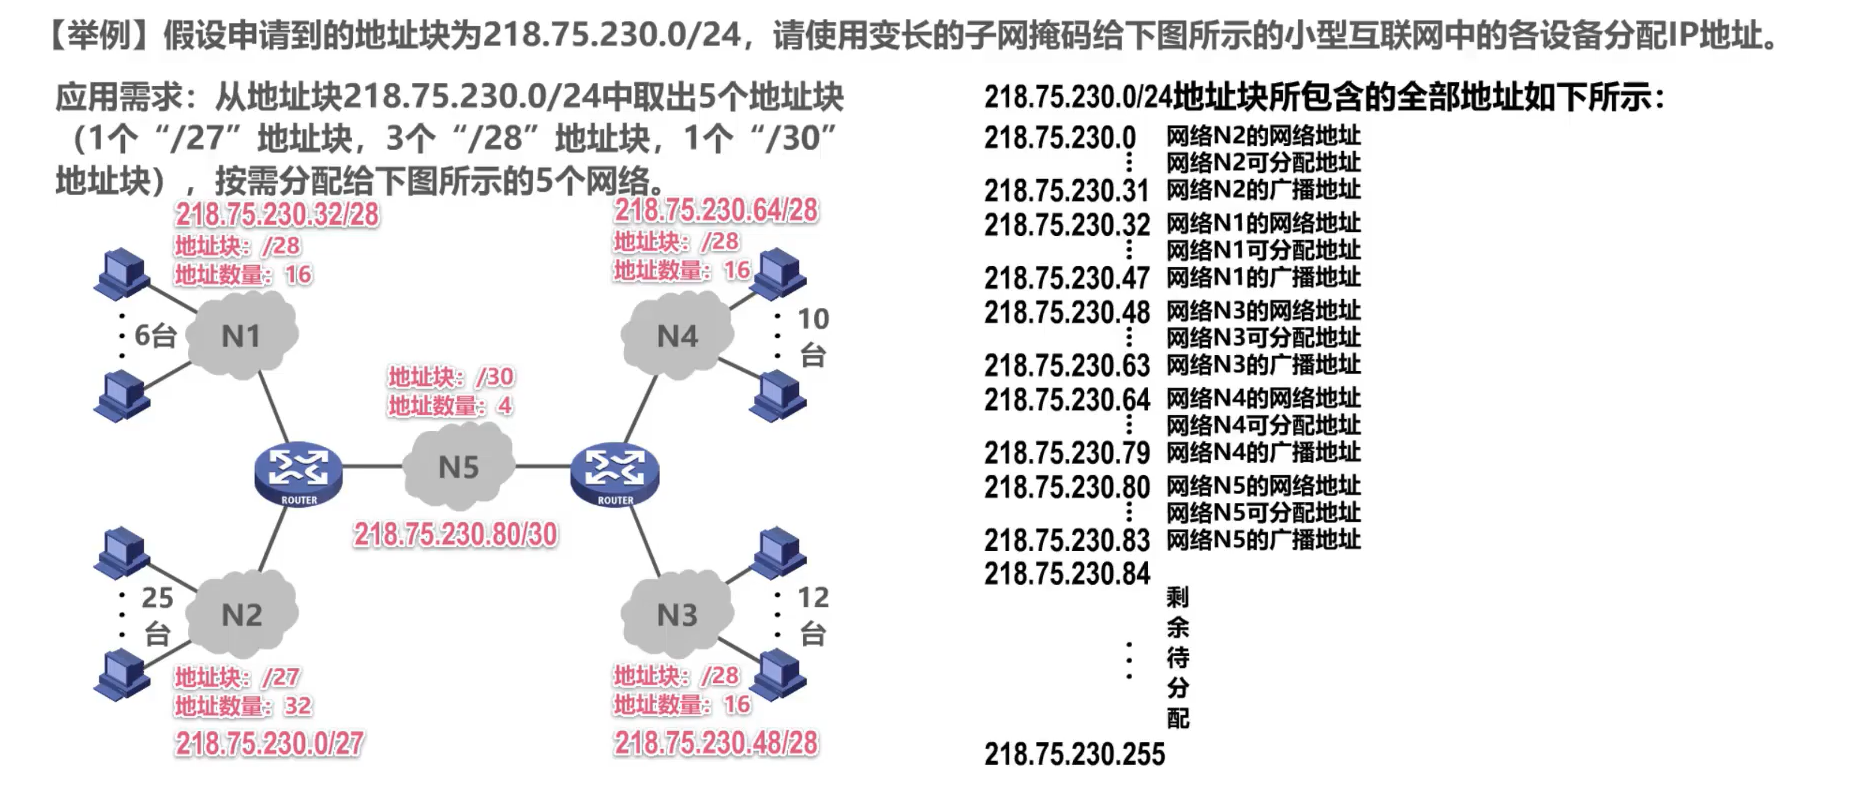
给定一个IPv4地址快,如何将其划分成几个更小的地址块,并将这些地址块分配给互联网中不同网络,进而可以给各网络中的主机和路由器接口分配IPv4地址
定长的子网掩码FLSM(Fixed Length Subnet Mask):
- 使用同一个子网掩码来划分子网
- 子网划分方式不灵活:只能划分出2^n^个子网(是从主机号部分借用的用来作为子网号的比特数量)
- 每个子网所分配的IP地址数量相同容易造成P地址浪费
如,划分子网的IPv4就是定长的子网掩码
举例
变长的子网掩码VLSM(Variable Length Subnet Mask):
- 使用不同的子网掩码来划分子网
- 子网划分方式灵活:可以按需分配
- 每个子网所分配的IP地址数量可以不同,尽可能减少对P地址的浪费
如,无分类编址的IPv4就是变长的子网掩码
举例
IP数据报的发送和转发
P数据报的发送和转发过程包含以下两部分:
- 主机发送IP数据报
- 路由器转发IP数据报
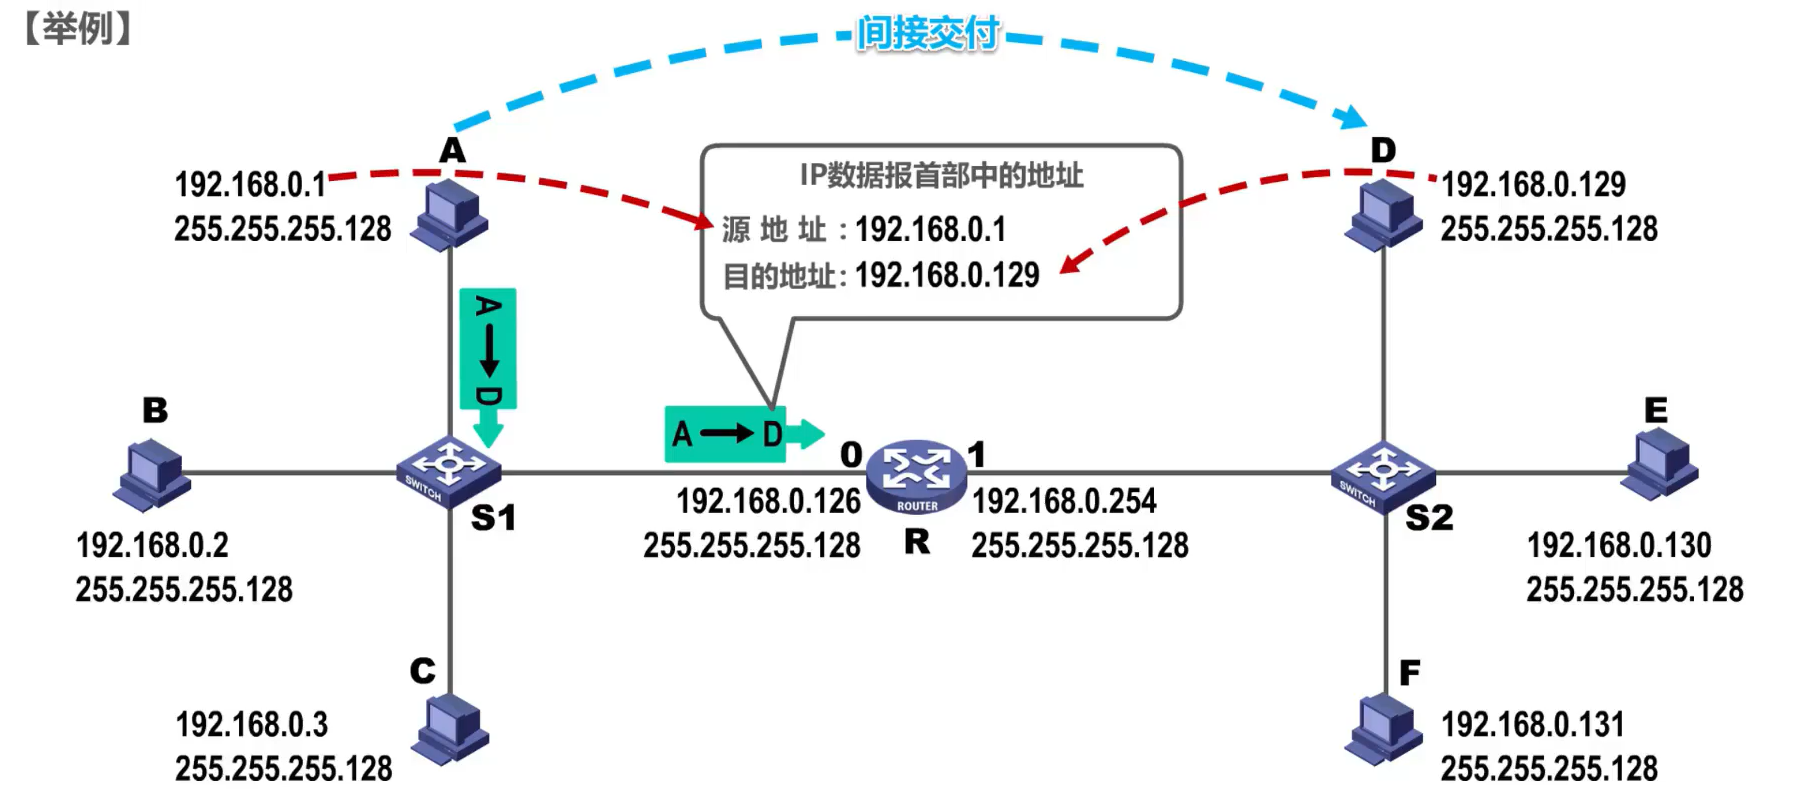
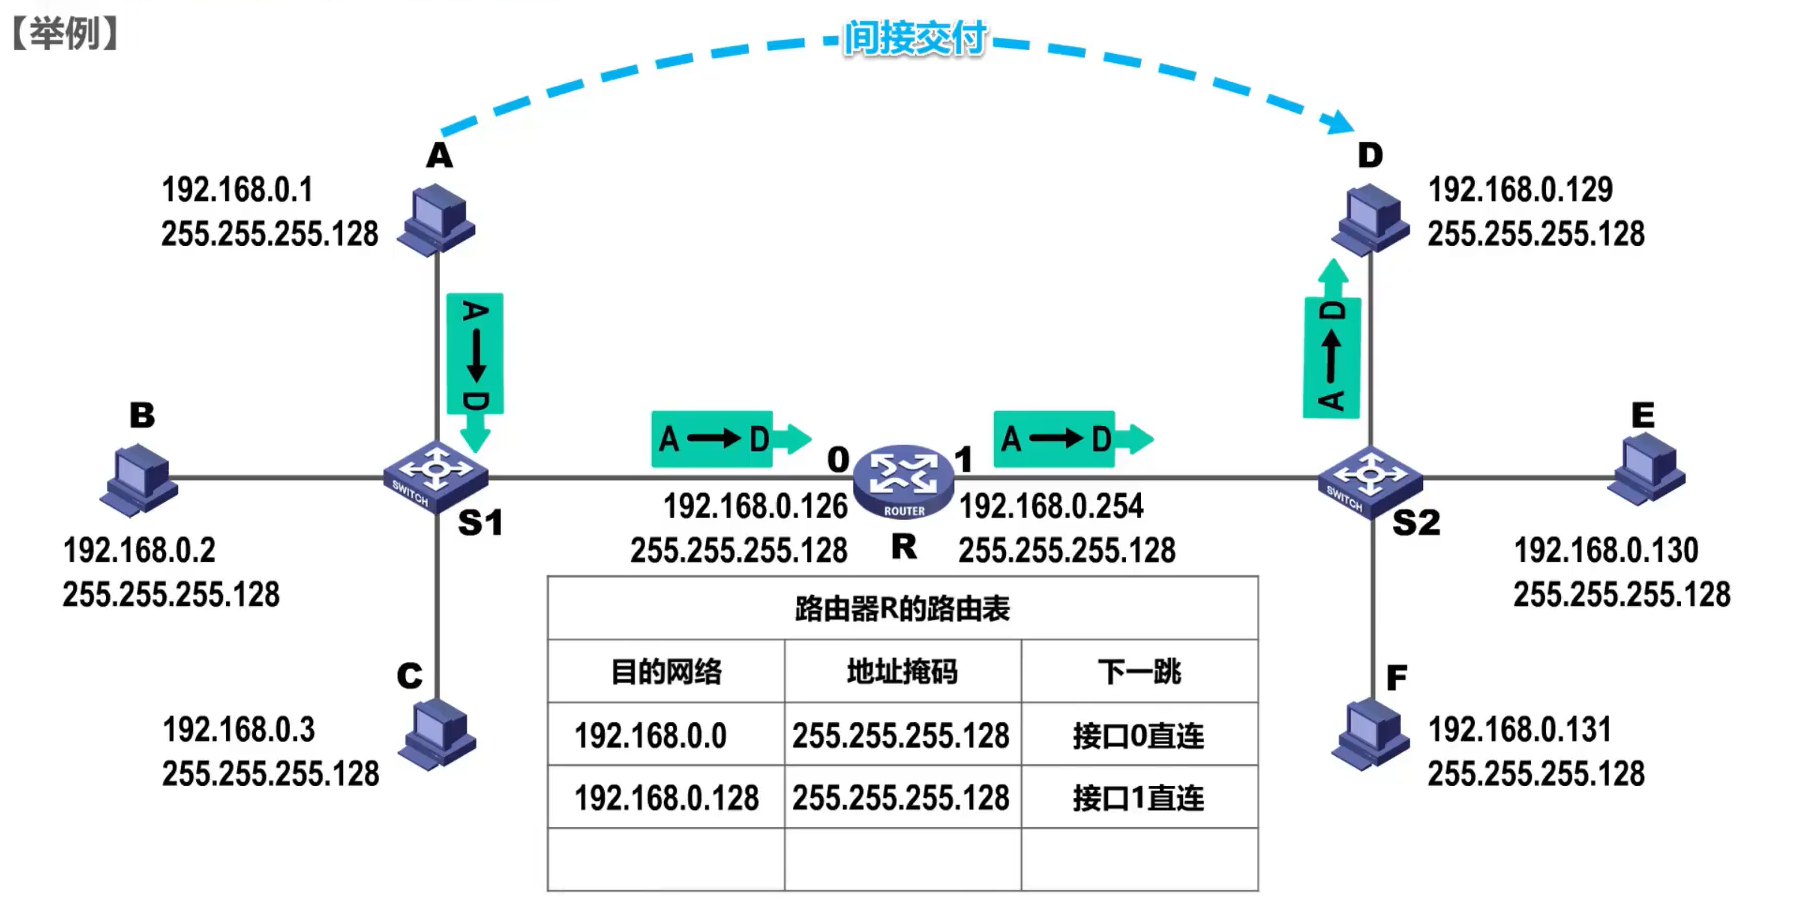
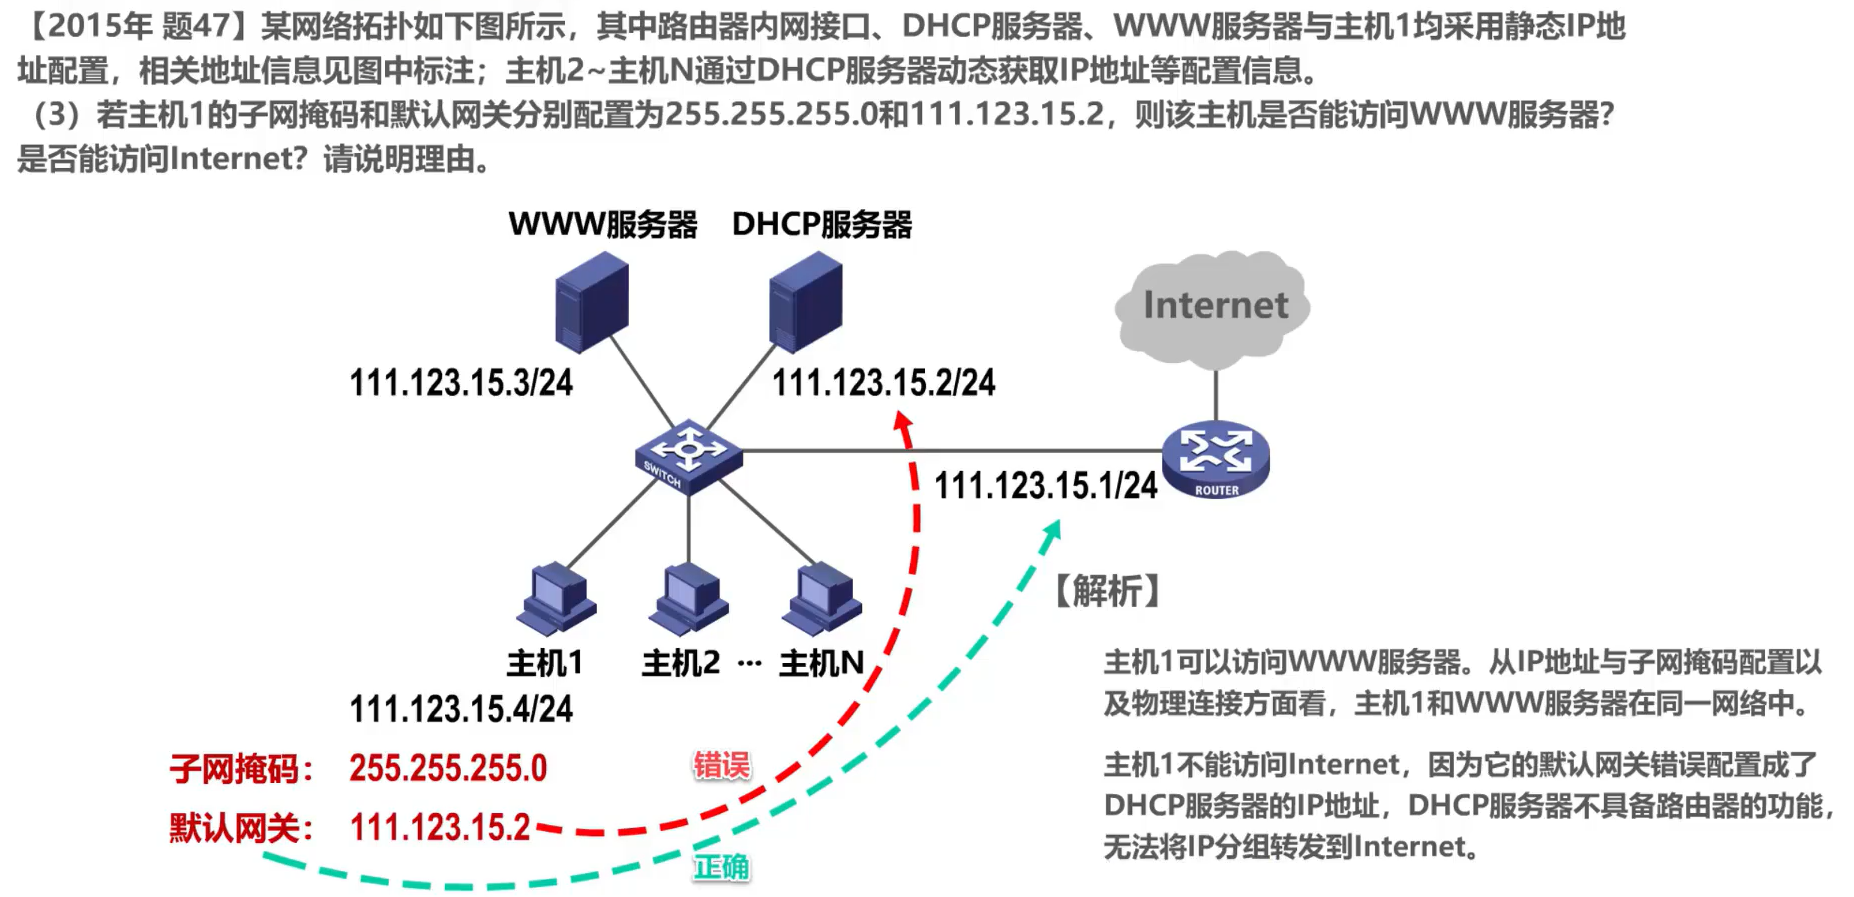
源主机如何知道目的主机是否与自己在同一个网络中,是直接交付,还是间接交付?
可以通过目的地址IP和源地址的子网掩码进行逻辑与运算得到目的网络地址
- 如果目的网络地址和源网络地址 相同,就是在同一个网络中,属于直接交付
- 如果目的网络地址和源网络地址 不相同,就不在同一个网络中,属于间接交付,传输给主机所在网络的默认网关(路由器),由默认网关帮忙转发
主机C如何知道路由器R的存在?
用户为了让本网络中的主机能和其他网络中的主机进行通信,就必须给其指定本网络的一个路由器的接口,由该路由器帮忙进行转发,所指定的路由器,也被称为默认网关
路由器收到IP数据报后如何转发?
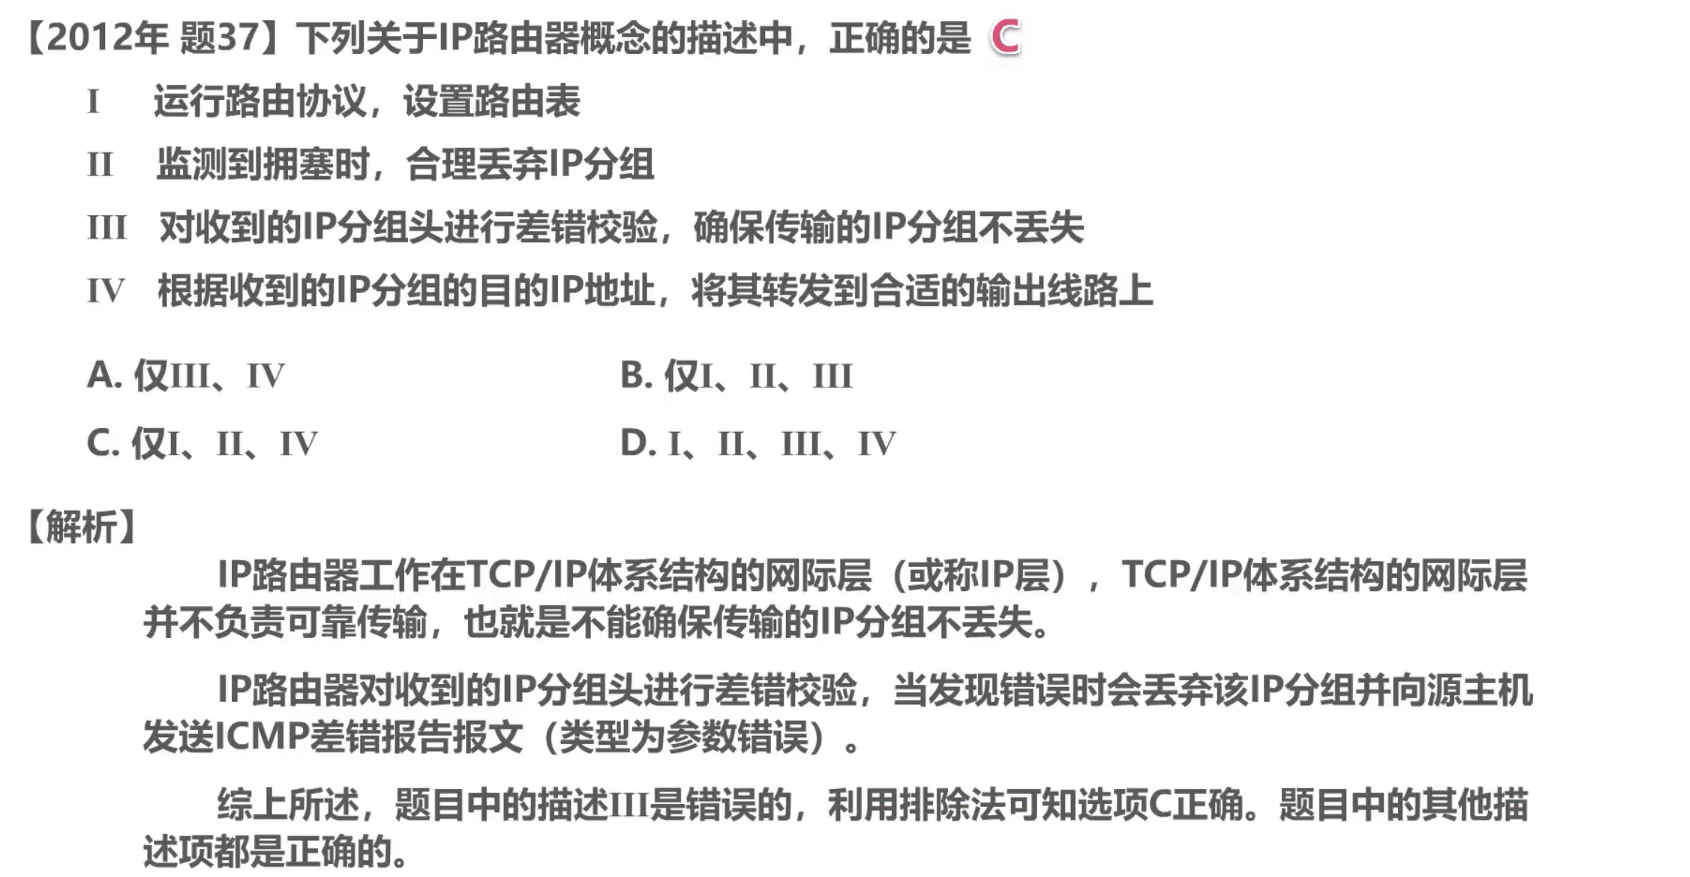
- 检查IP数据报首部是否出错:
- 若出错,则直接丢弃该IP数据报并通告源主机
- 若没有出错,则进行转发
- 根据IP数据报的目的地址在路由表中查找匹配的条目:
- 若找到匹配的条目,则转发给条目中指示的下一跳
- 若找不到,则丢弃该数据报并通告源主机
假设IP数据报首部没有出错,路由器取出IP数据报首部各地址字段的值,然后路由器对该IP数据报进行查表转发。
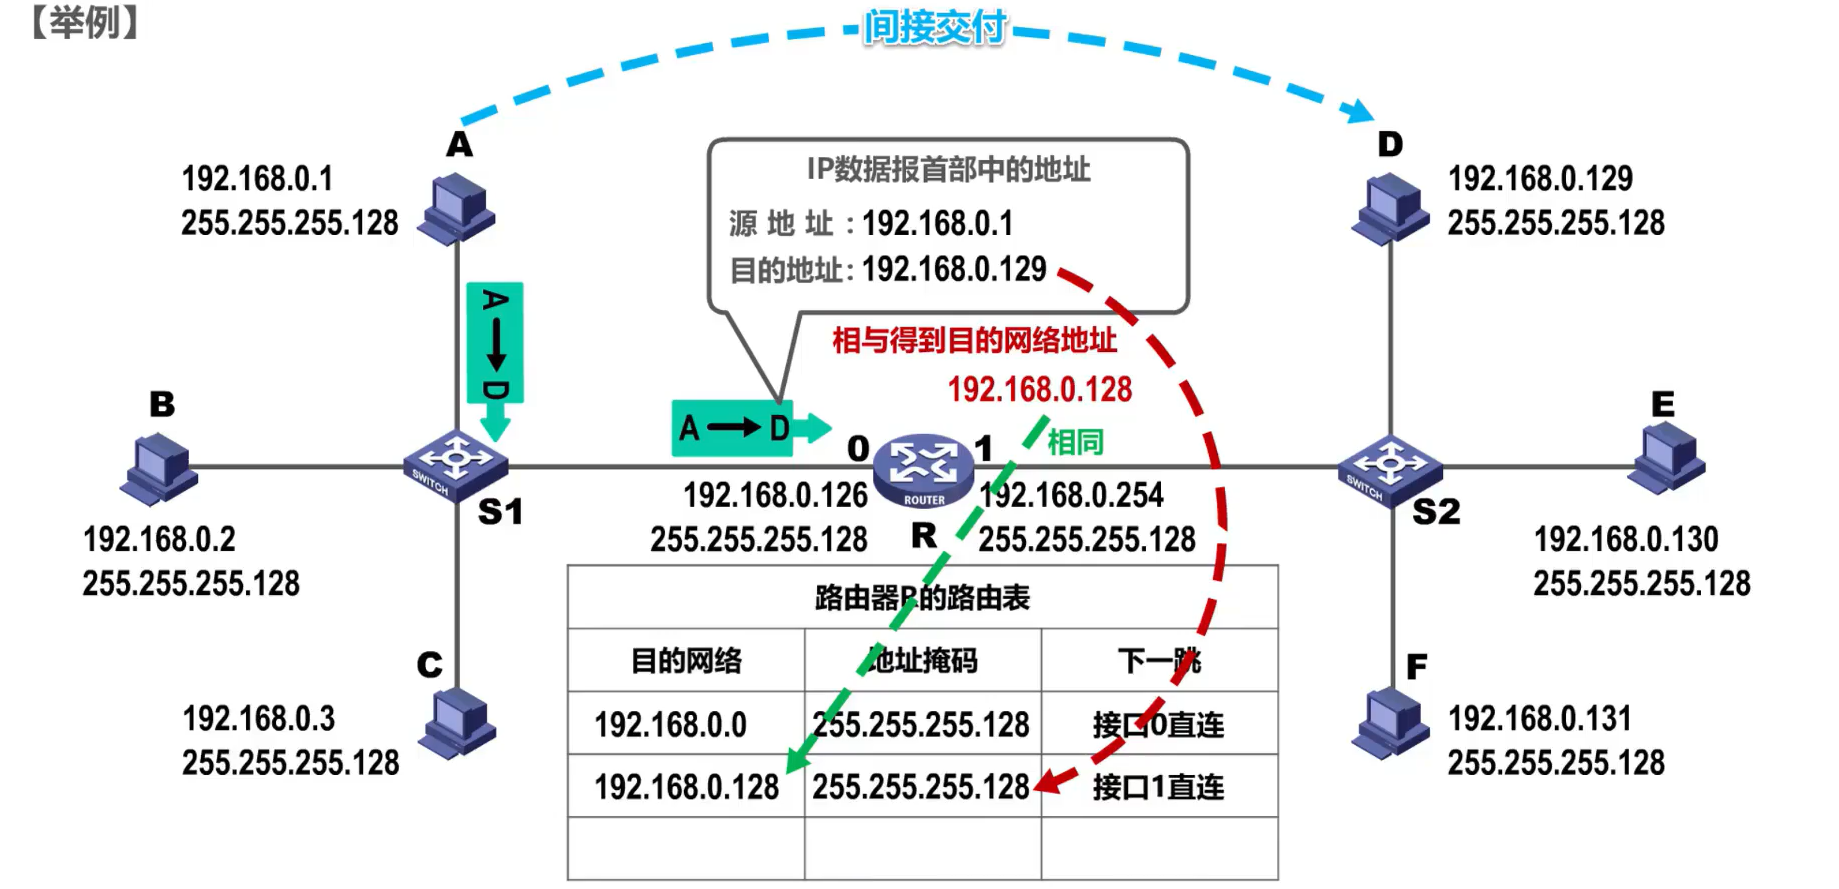
逐条检查路由条目,将目的地址与路由条目中的地址掩码进行逻辑与运算得到目的网络地址,然后与路由条目中的目的网络进行比较,如果相同,则这条路由条目就是匹配的路由条目,按照它的下一条指示,图中所示的也就是接口1转发该IP数据报
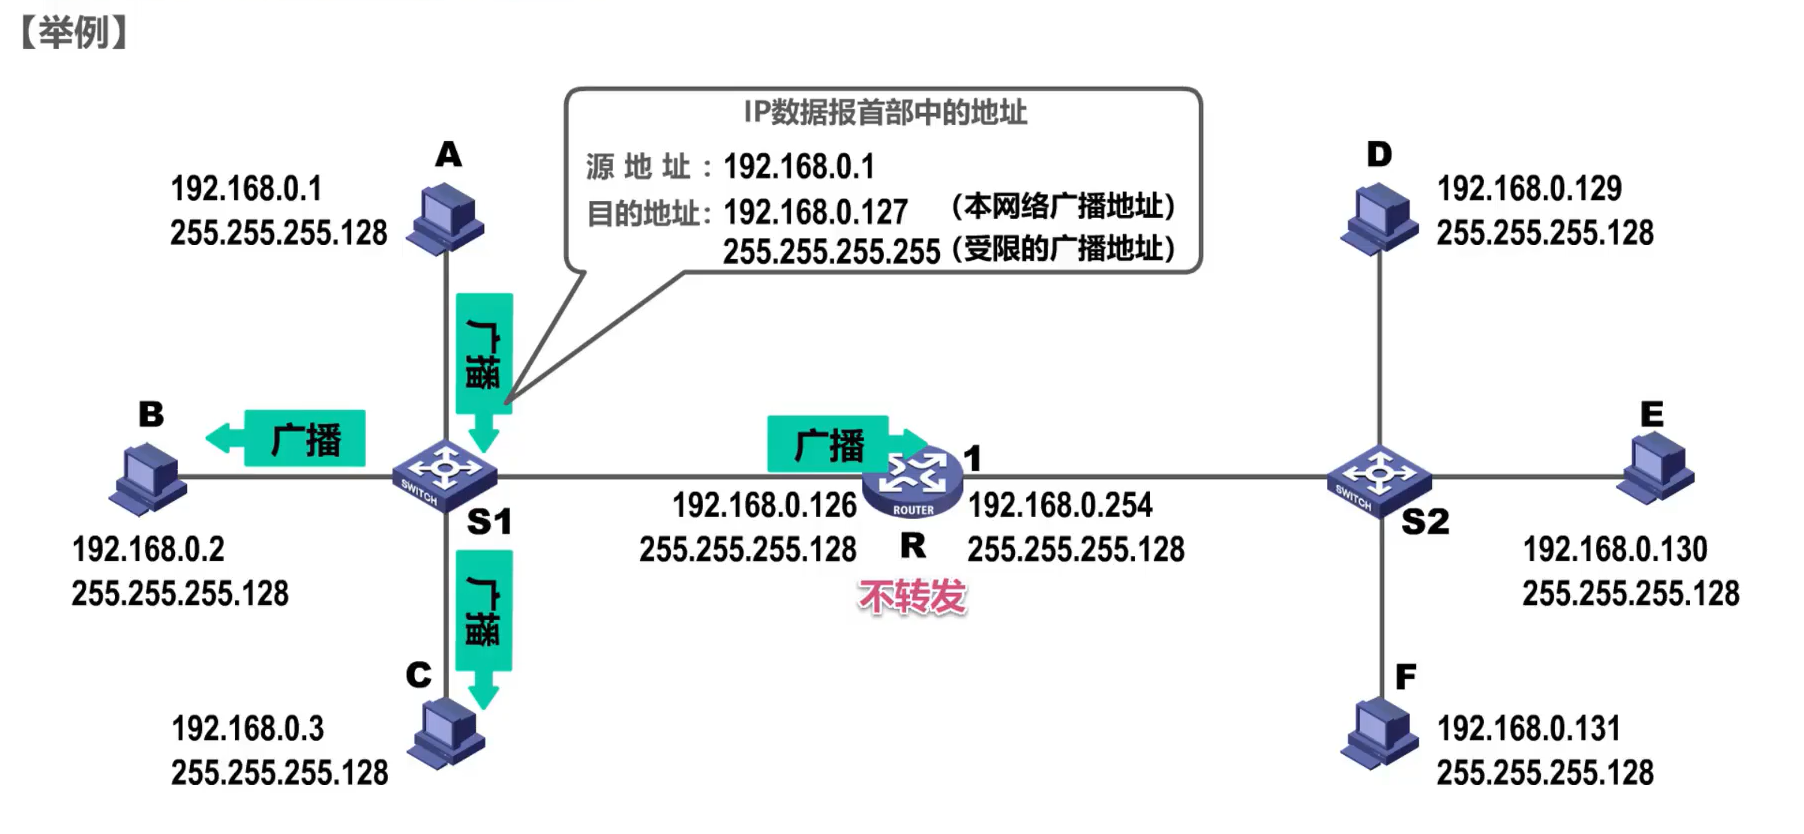
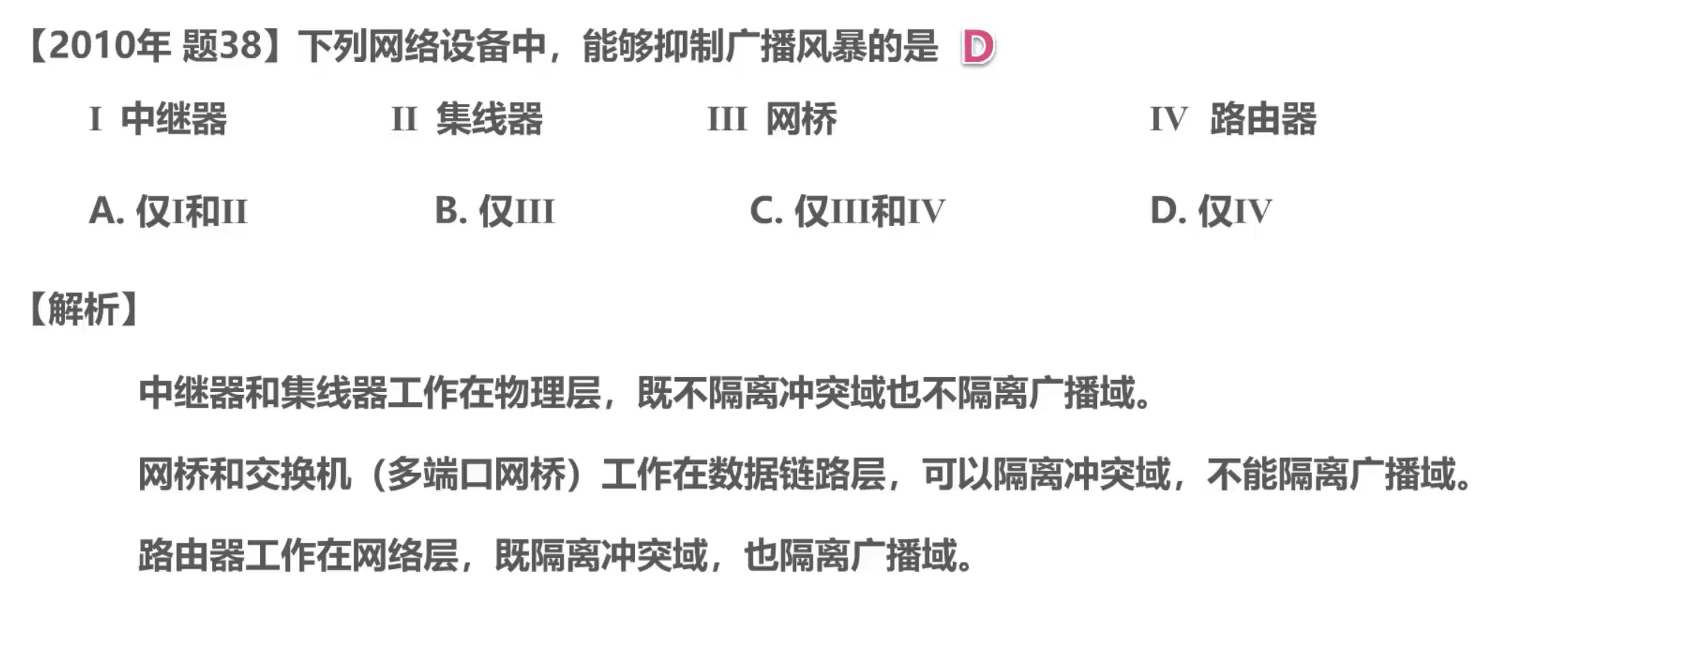
路由器是隔离广播域的
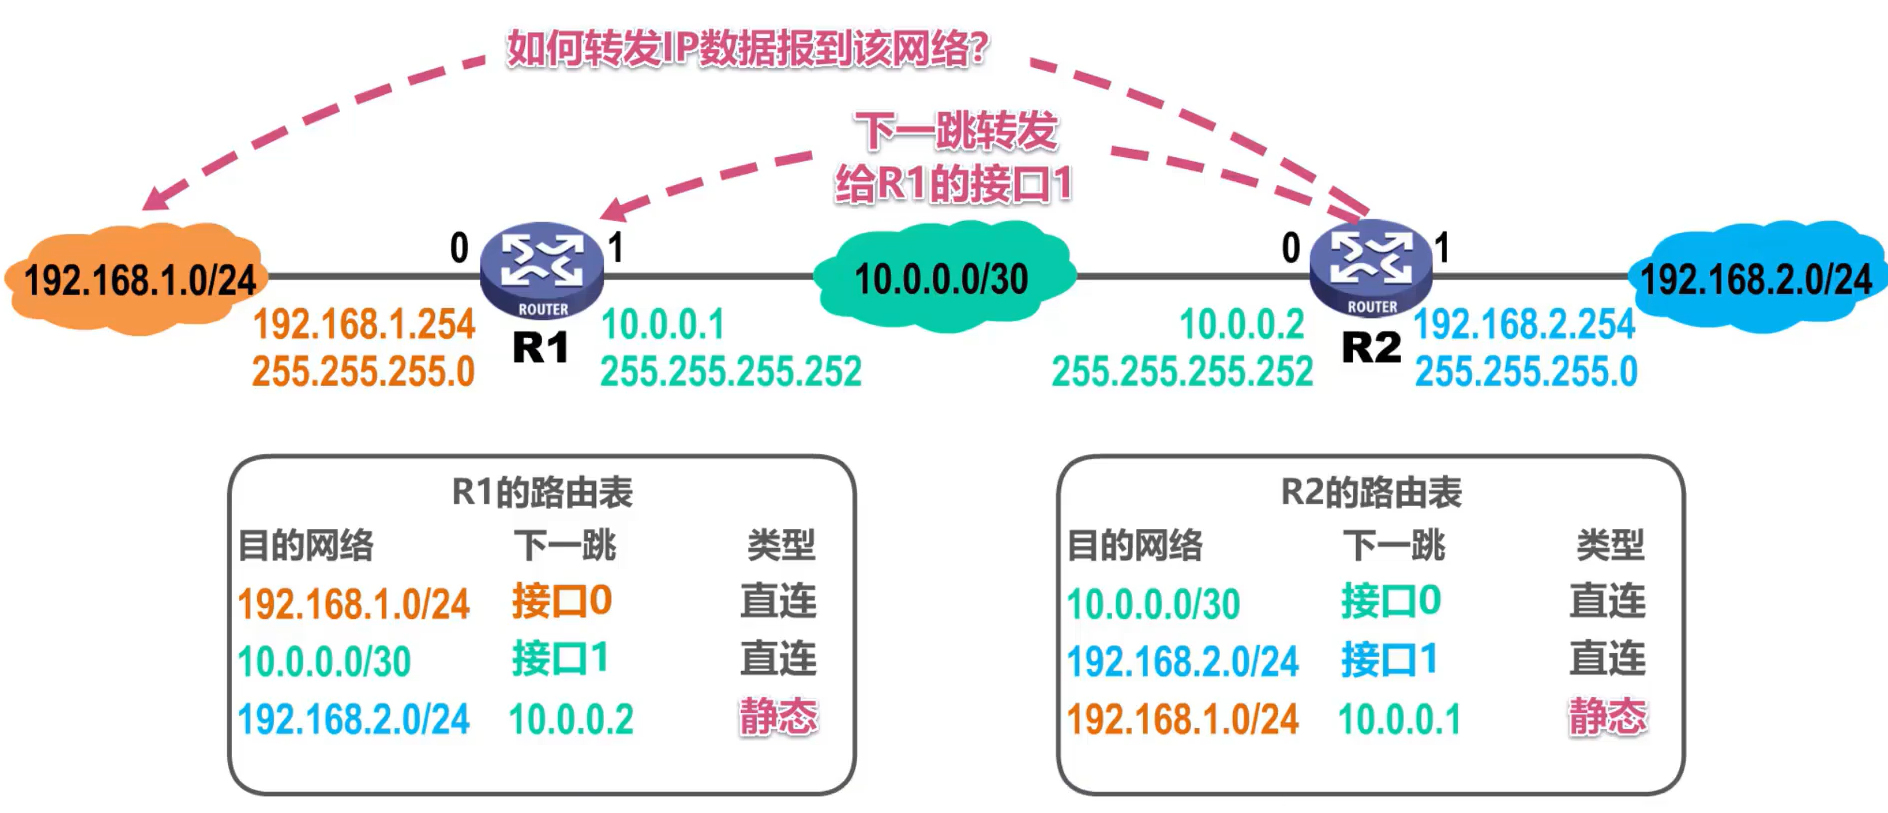
静态路由配置
概念
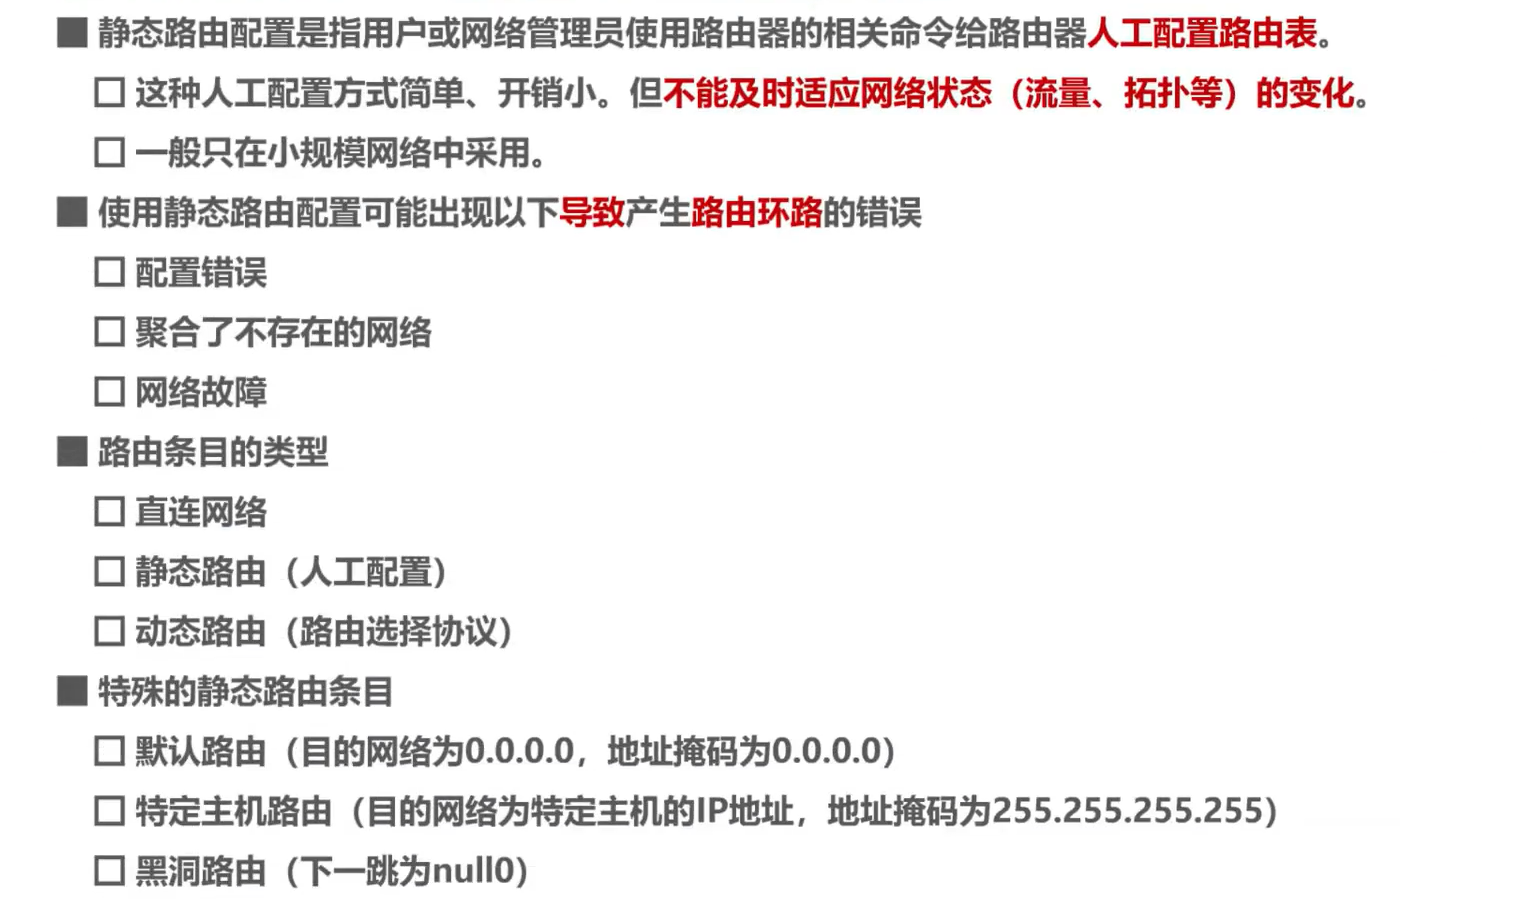
静态路由配置是指用户或网络管理员使用路由器的相关命令给路由器人工配置路由表。
- 简单、开销小。但不能及时适应网络状态(流量、拓扑等)的变化。
- 一般只在小规模网络中采用。
使用静态路由配置可能出现以下导致产生路由环路错误
- 配置错误
- 聚合了不存在的网络
- 网络故障
举例:
静态路由配置
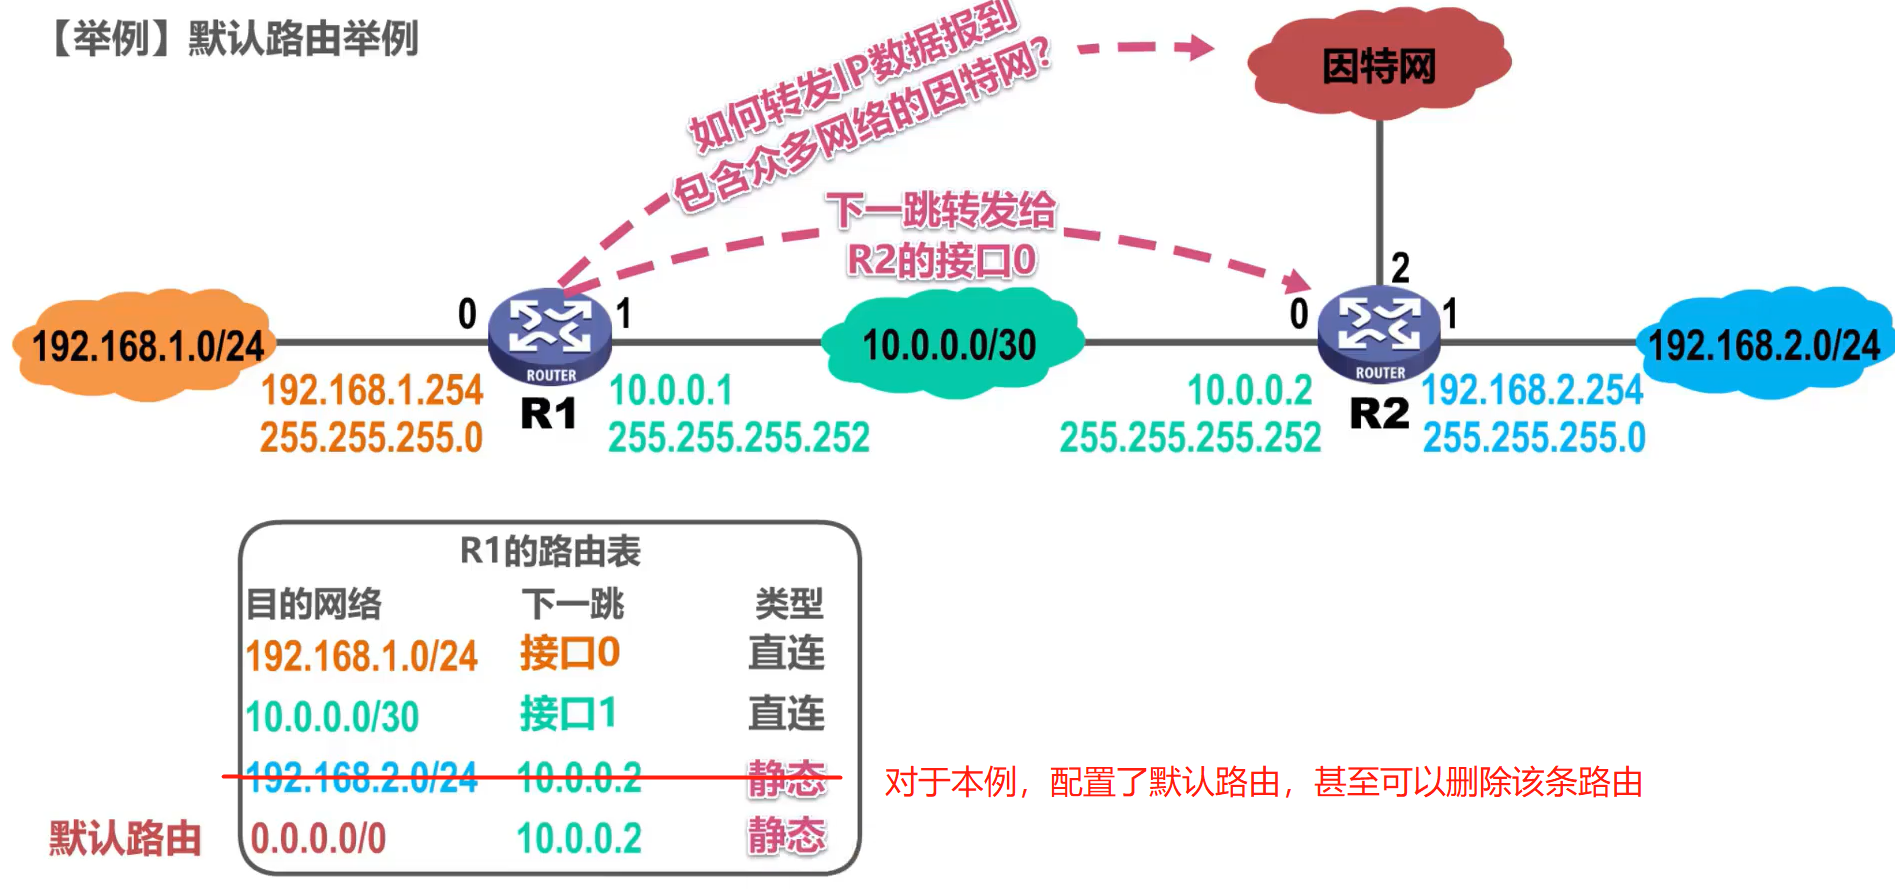
默认路由
默认路由可以被所有网络匹配,但路由匹配有优先级,默认路由是优先级最低的
特定主机路由
有时候,我们可以给路由器添加针对某个主机的特定主机路由条目
一般用于网络管理人员对网络的管理和测试
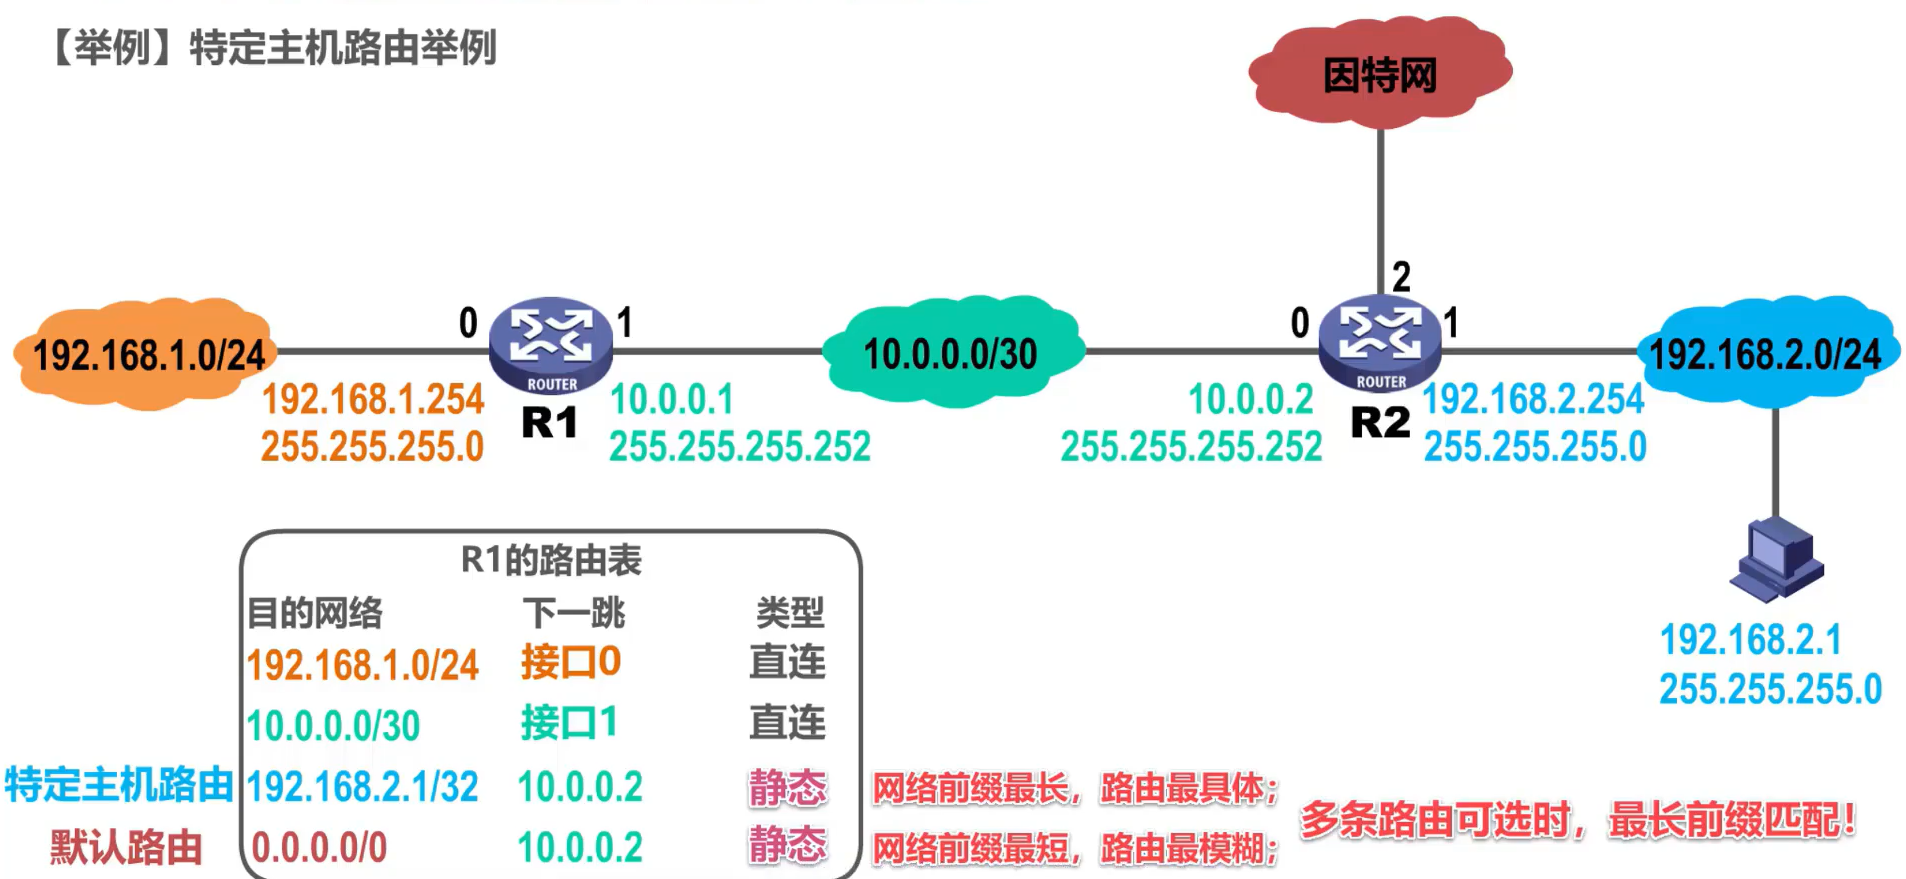
多条路由可选,匹配路由最具体的
静态路由配置错误导致路由环路
举例
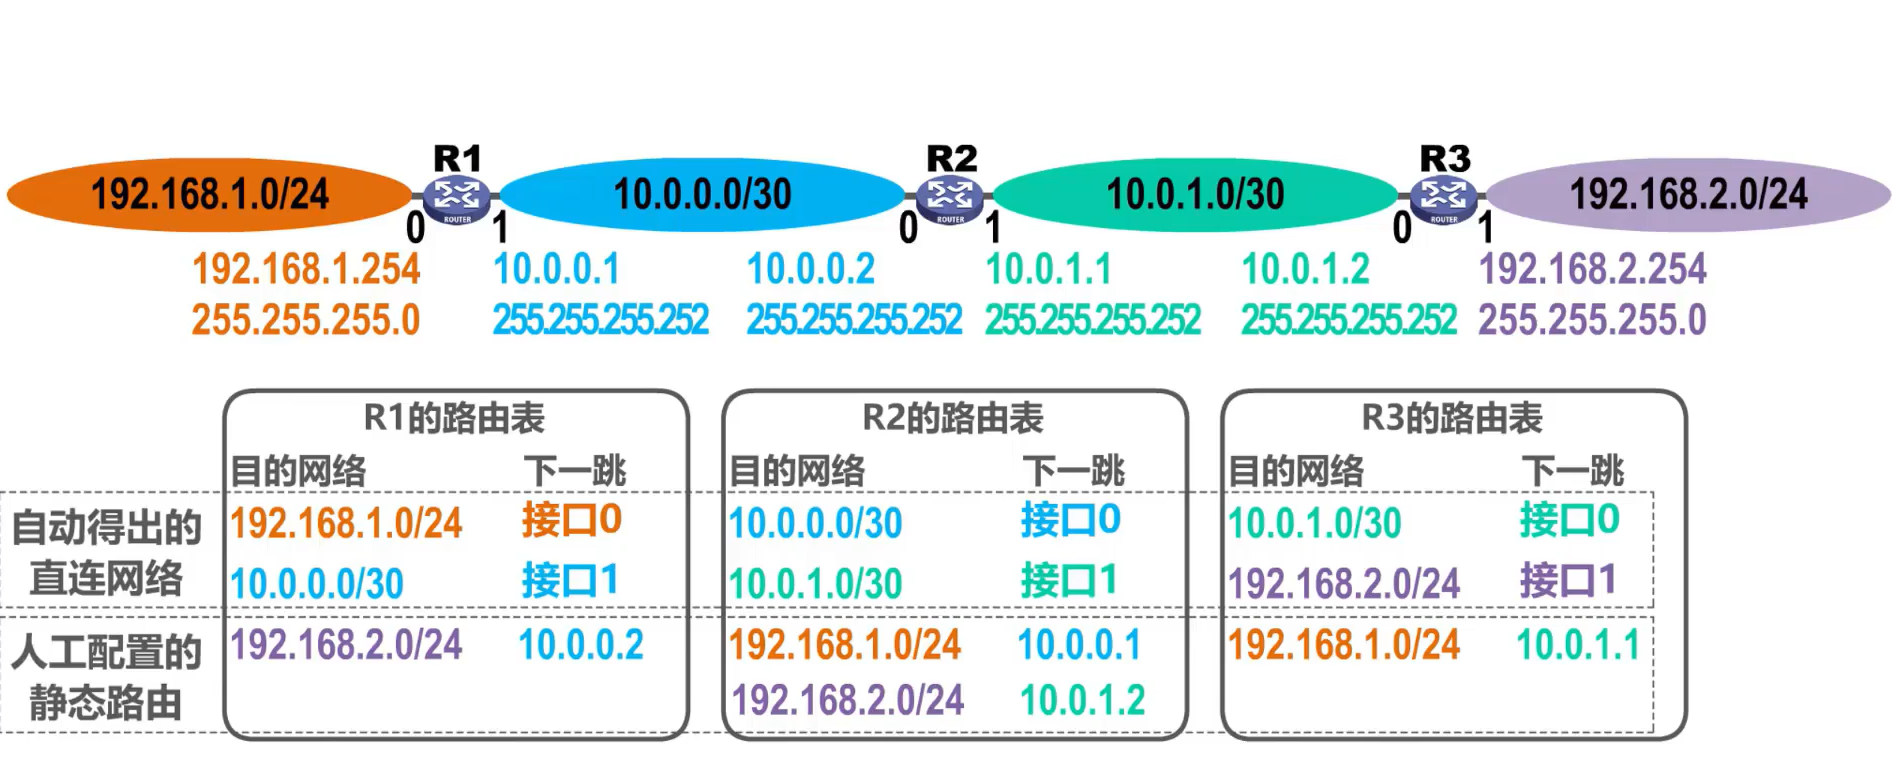
假设将R2的路由表中第三条目录配置错了下一跳
这导致R2和R3之间产生了路由环路
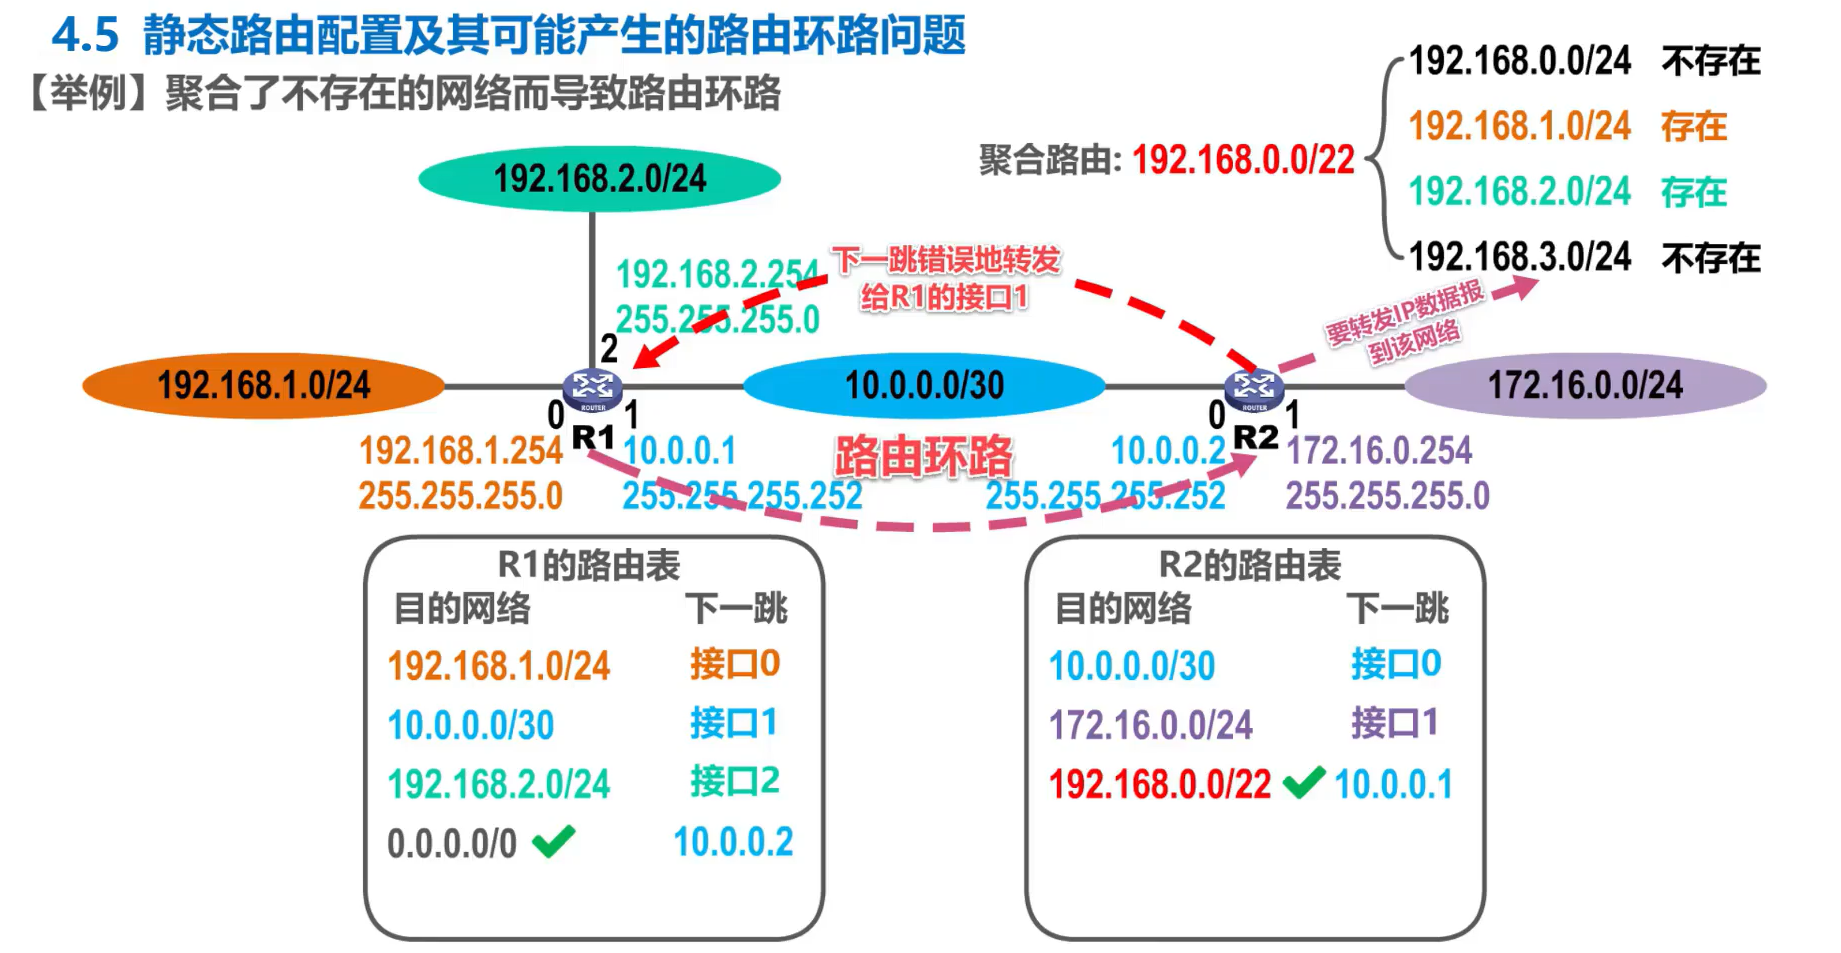
聚合了不存在的网络而导致路由环路
举例
正常情况
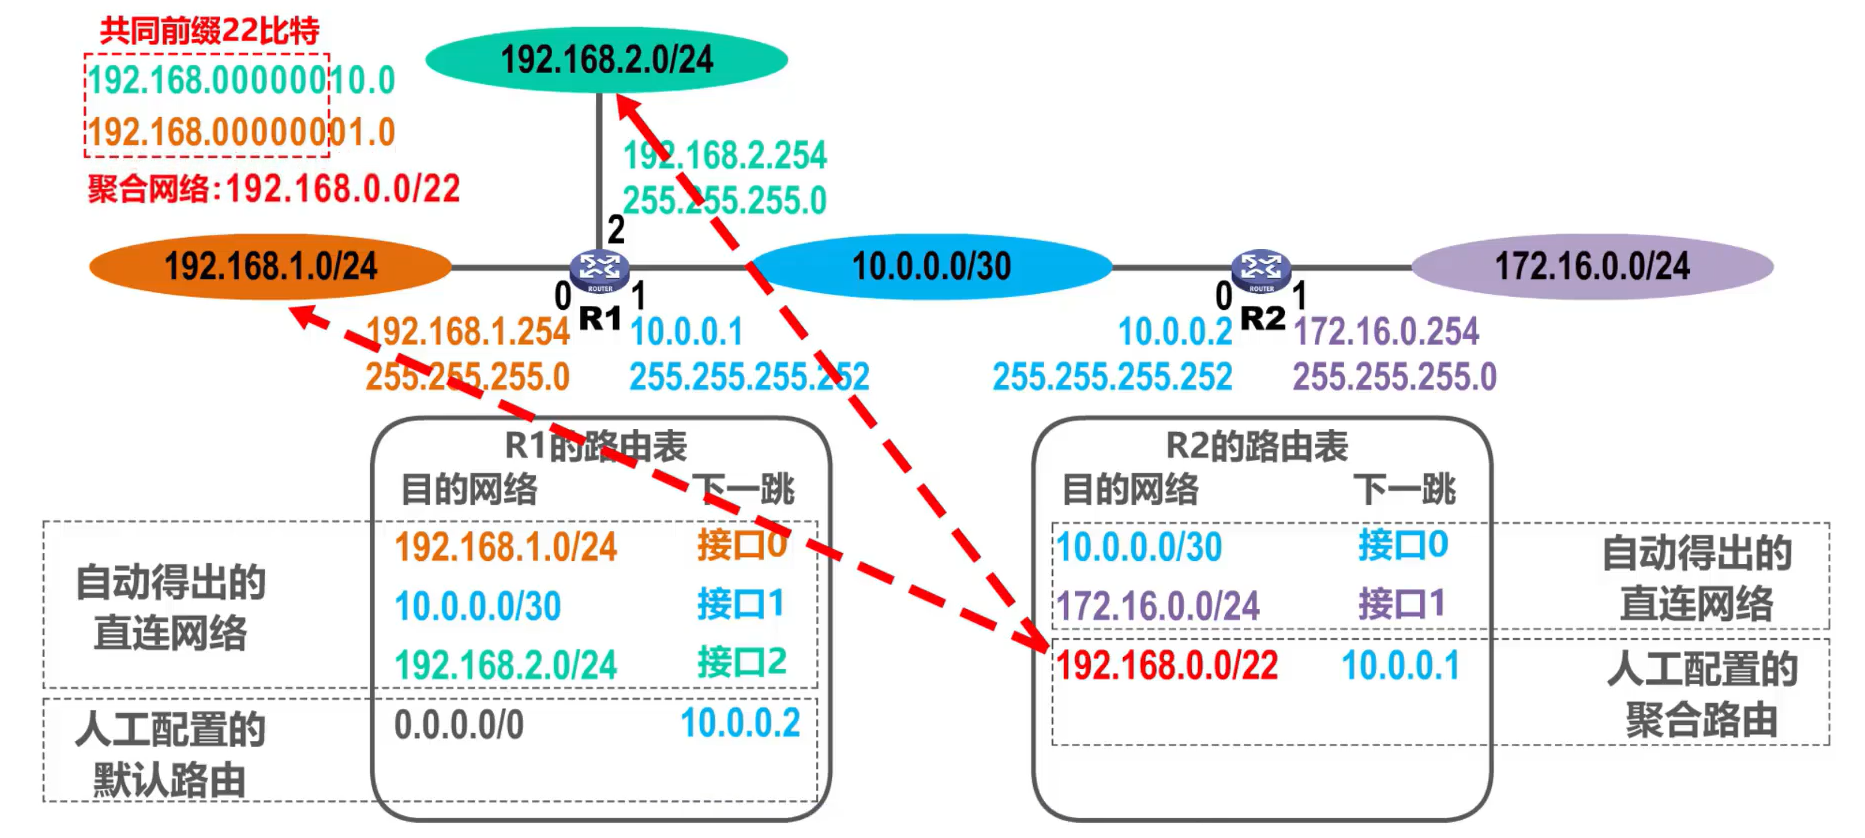
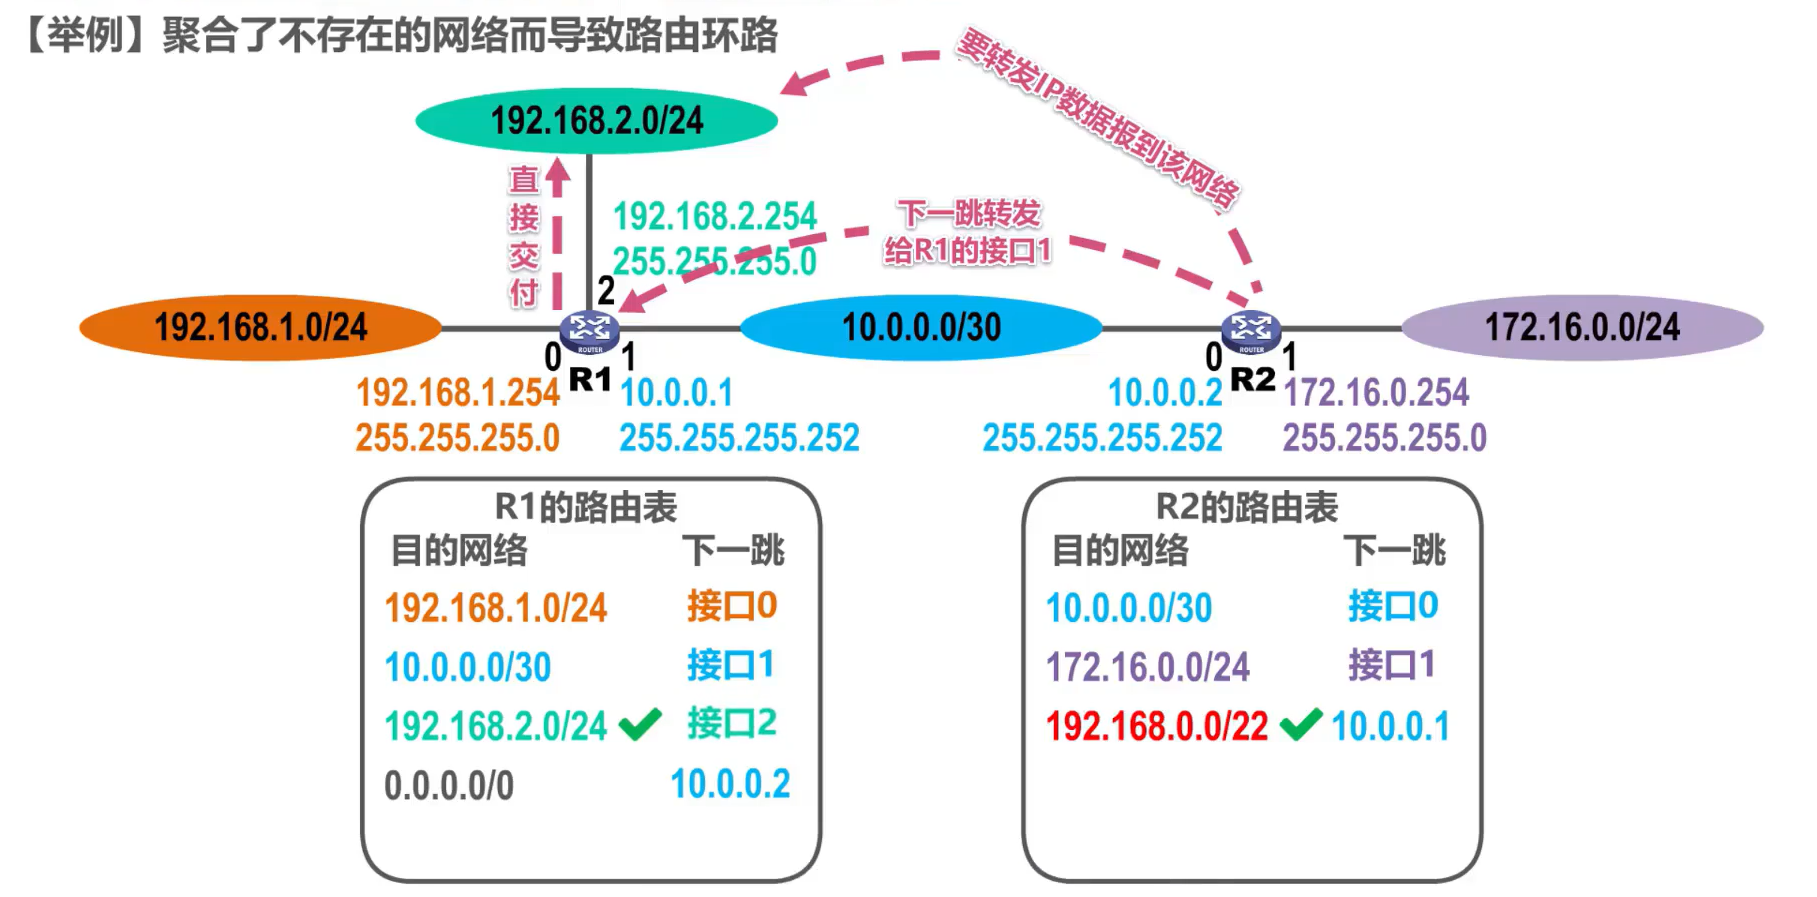
错误情况
解决方法
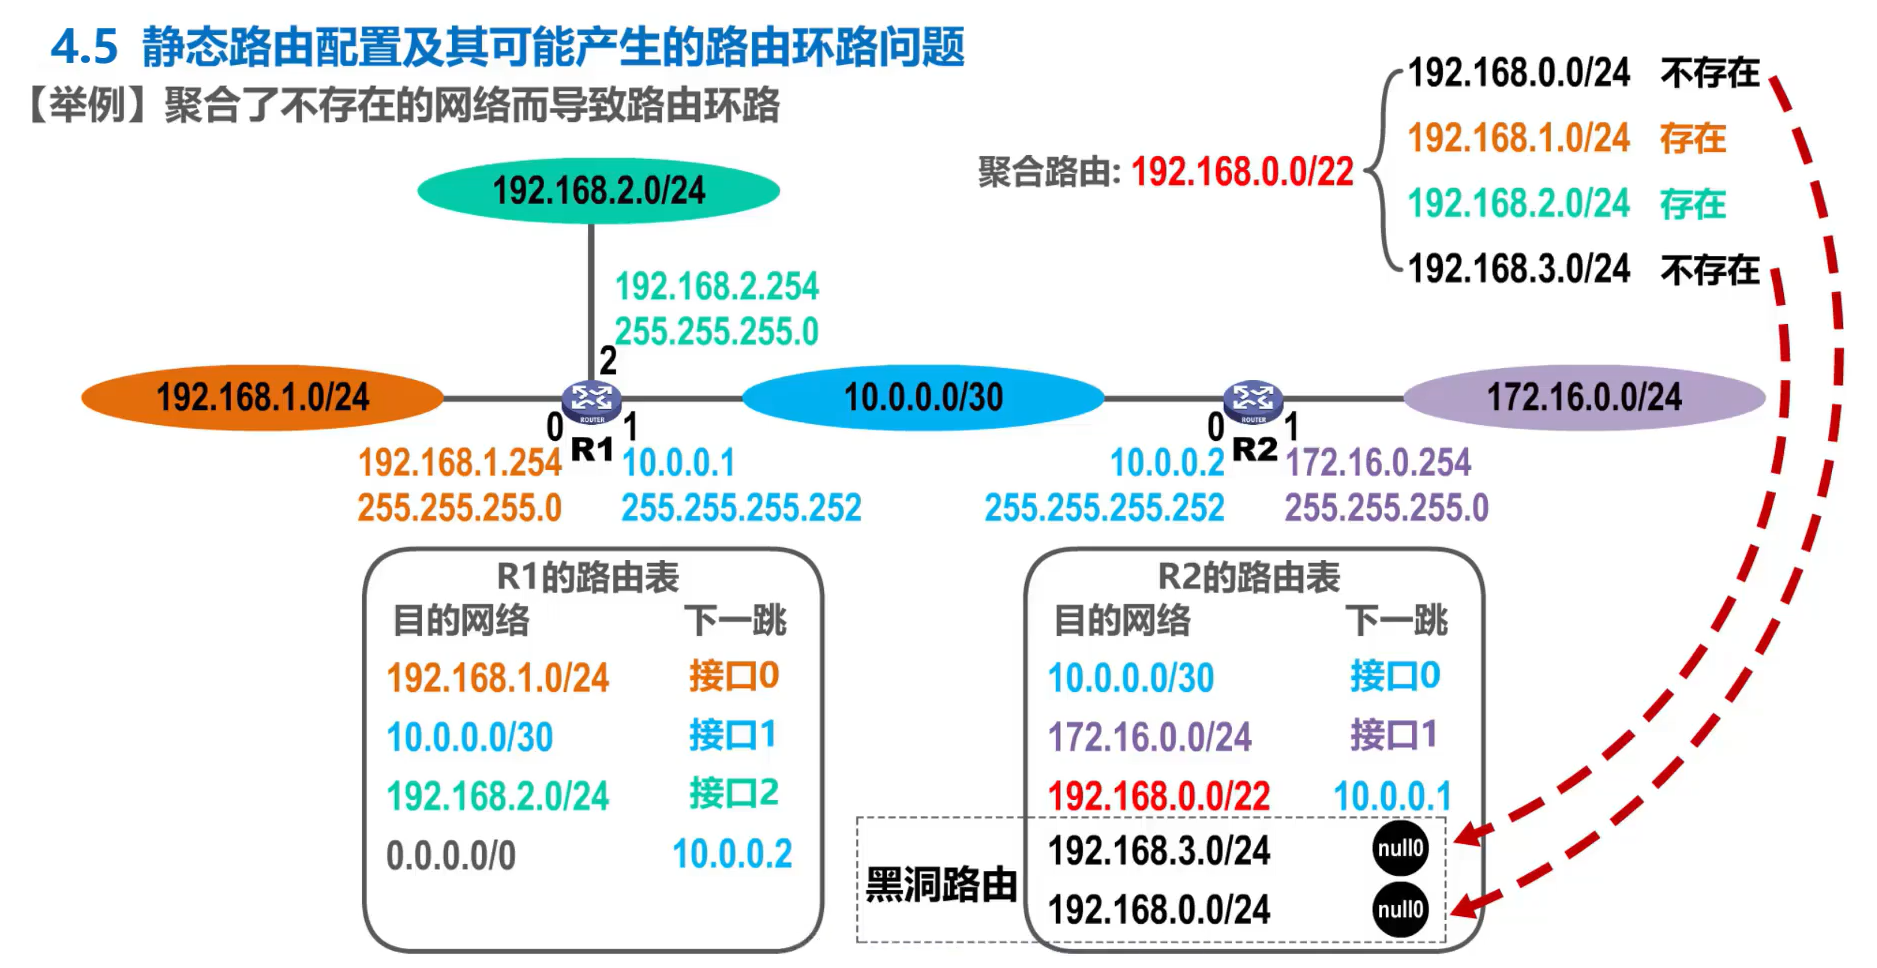
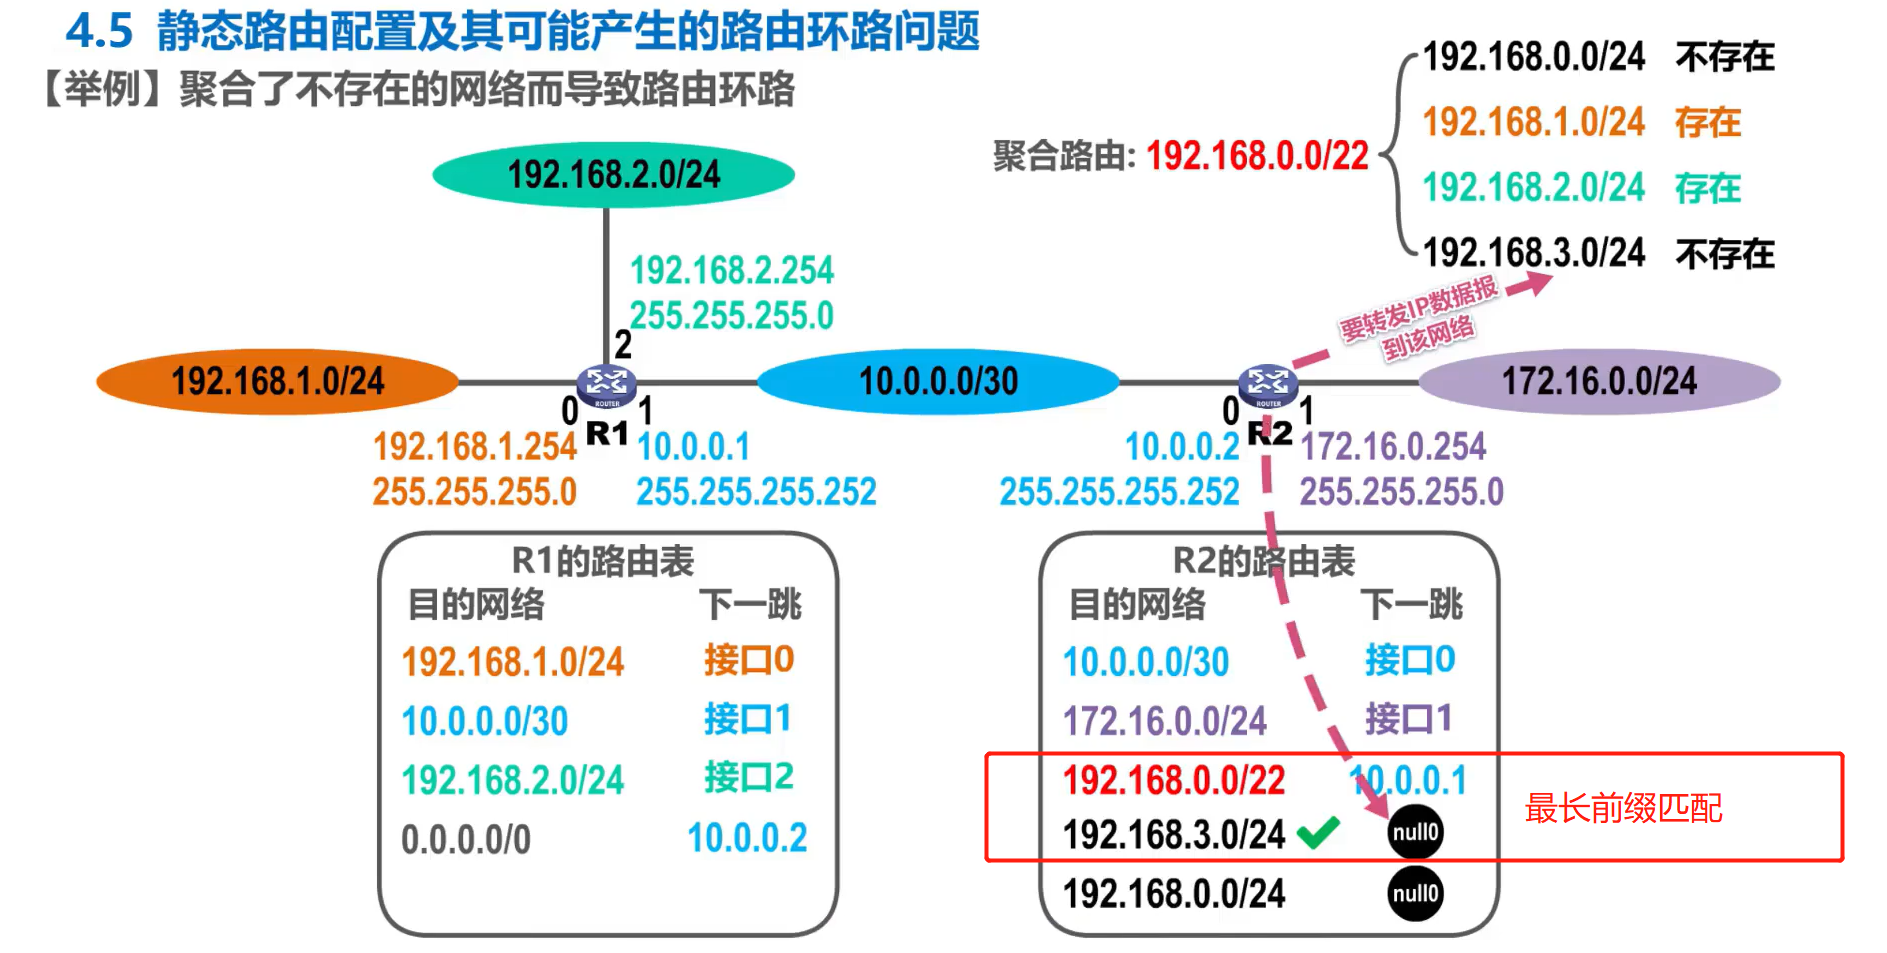
黑洞路由的下一跳为null0,这是路由器内部的虚拟接口,IP数据报进入它后就被丢弃
网络故障而导致路由环路
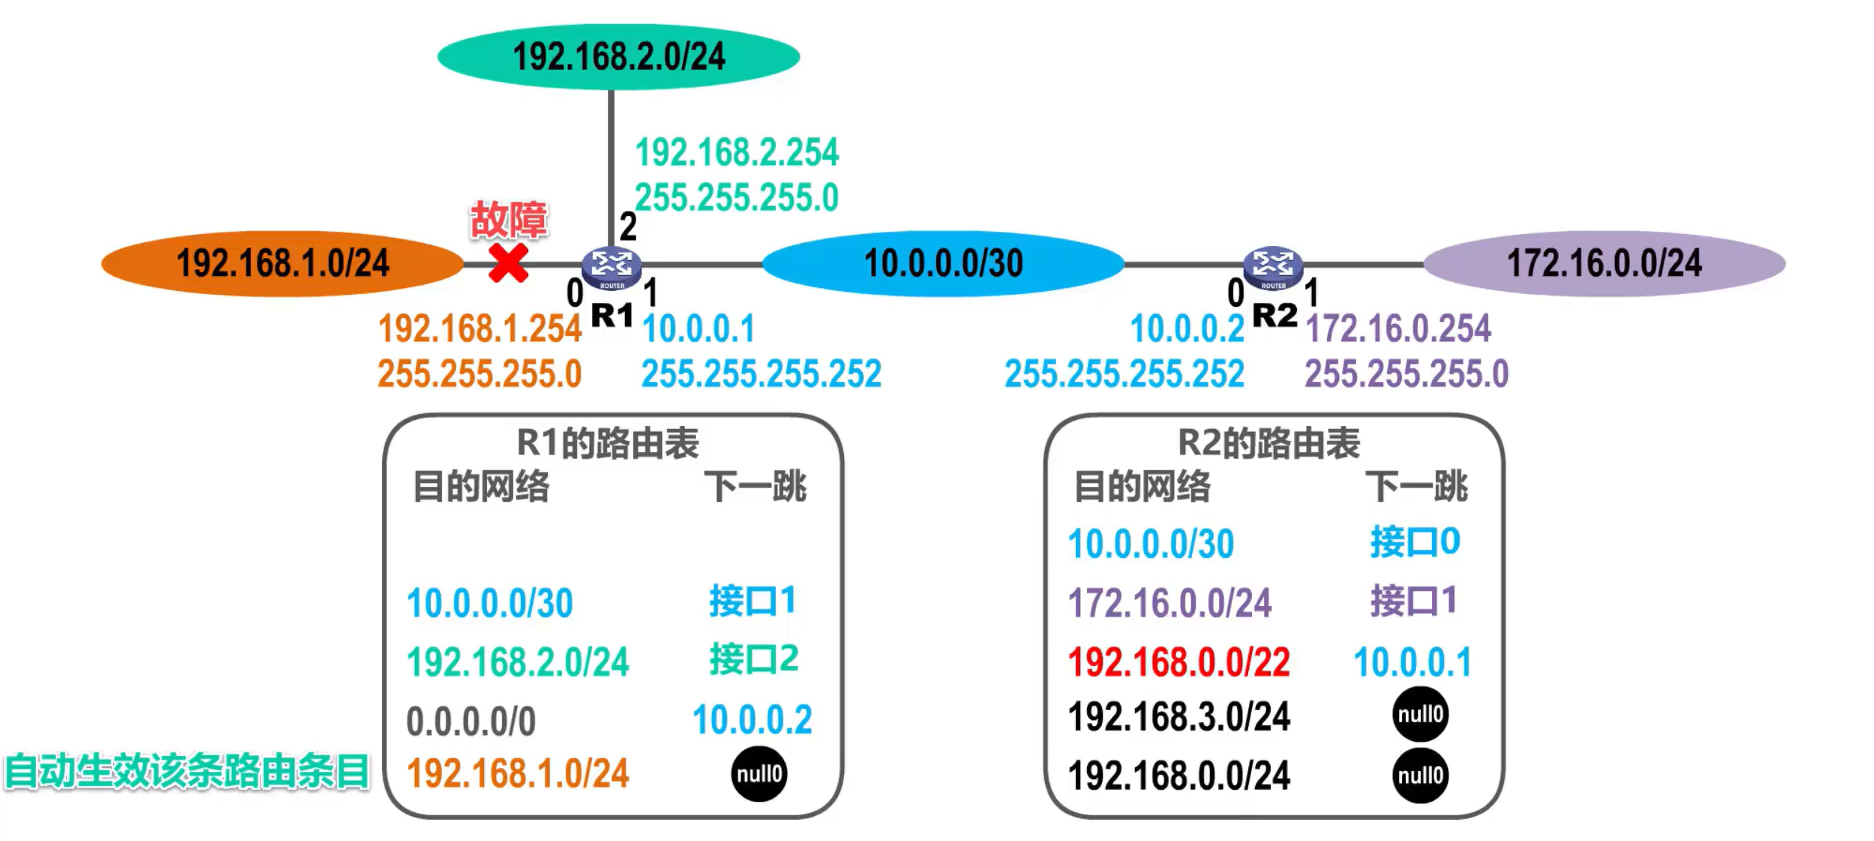
举例
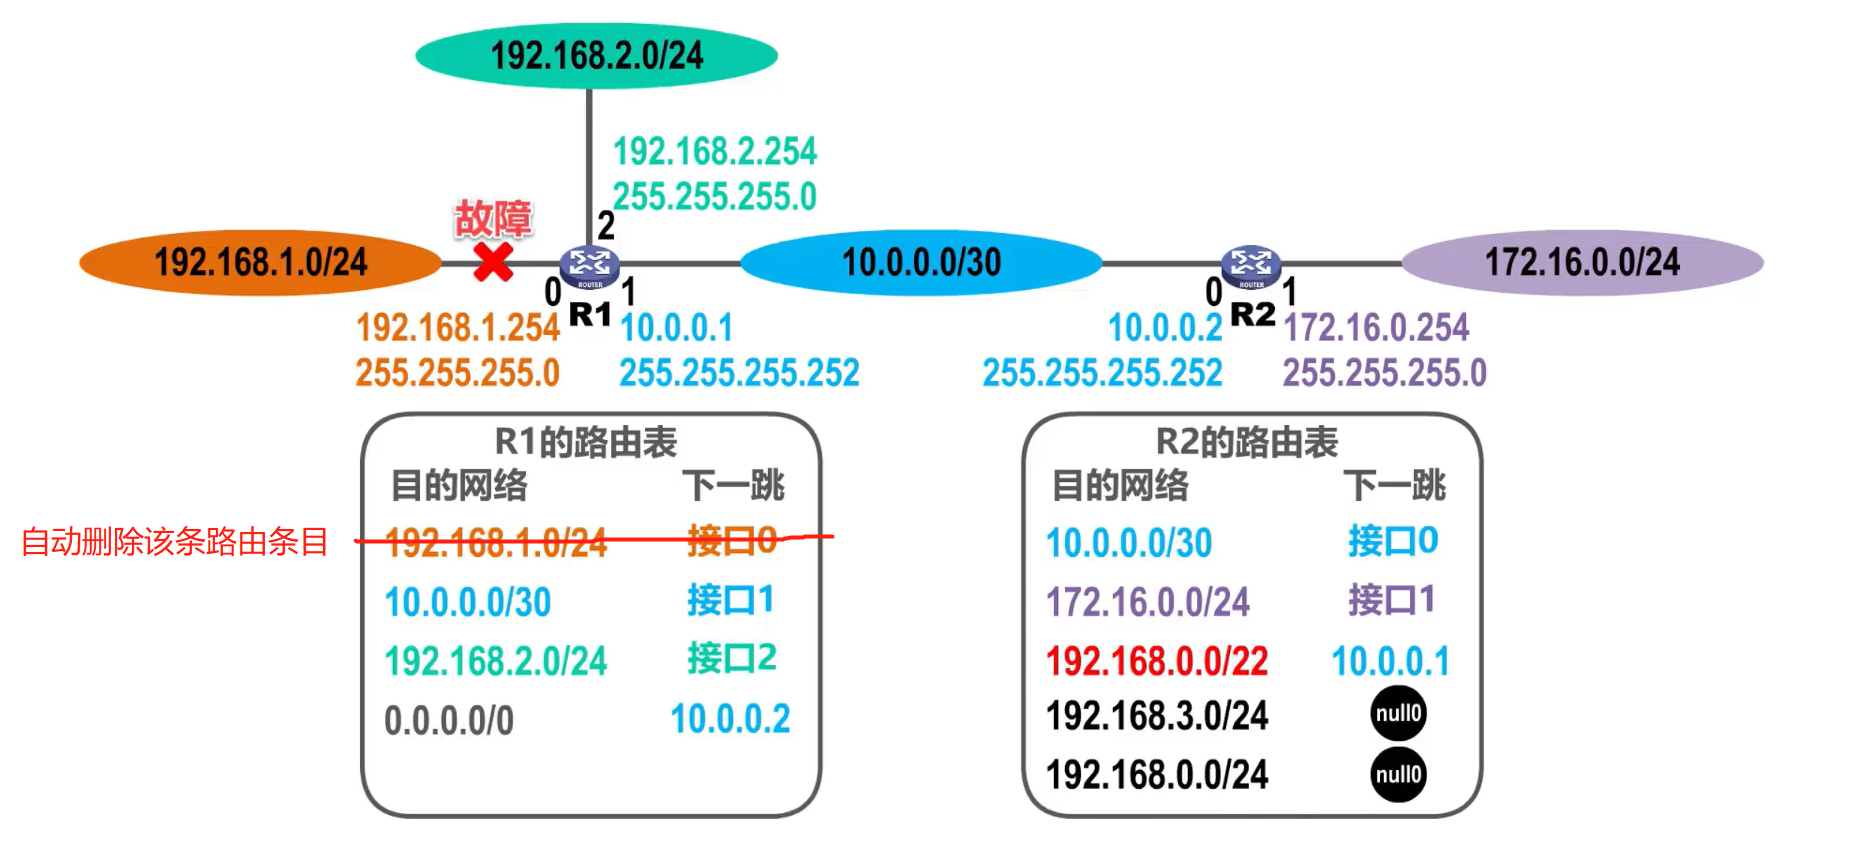
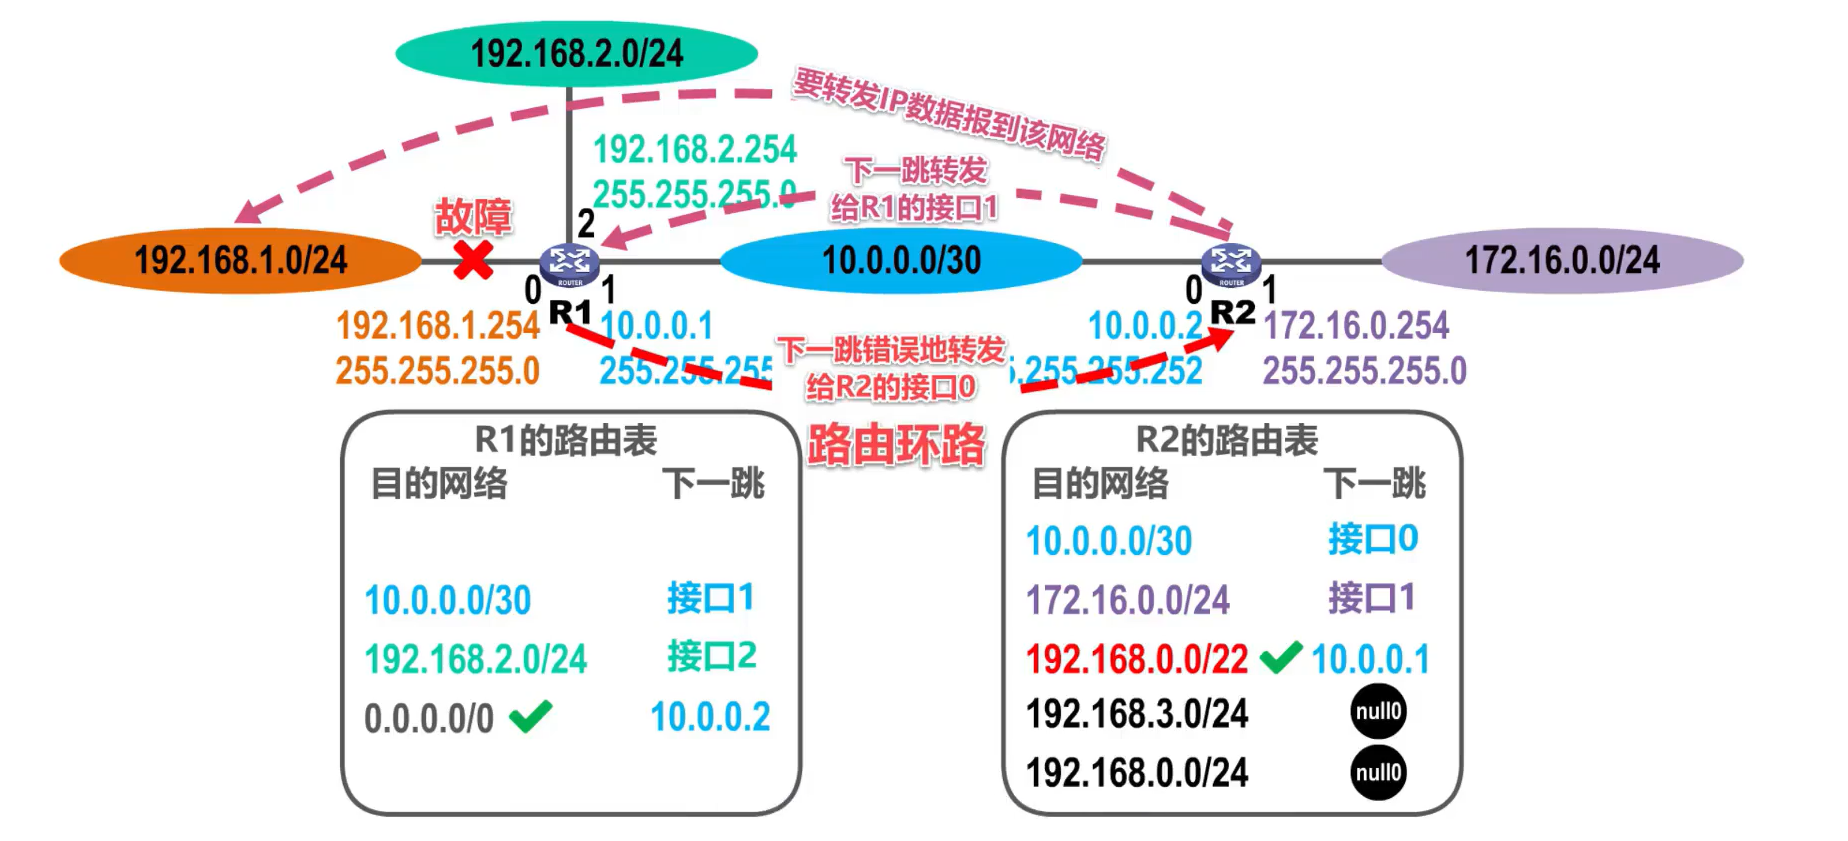
解决方法
添加故障的网络为黑洞路由
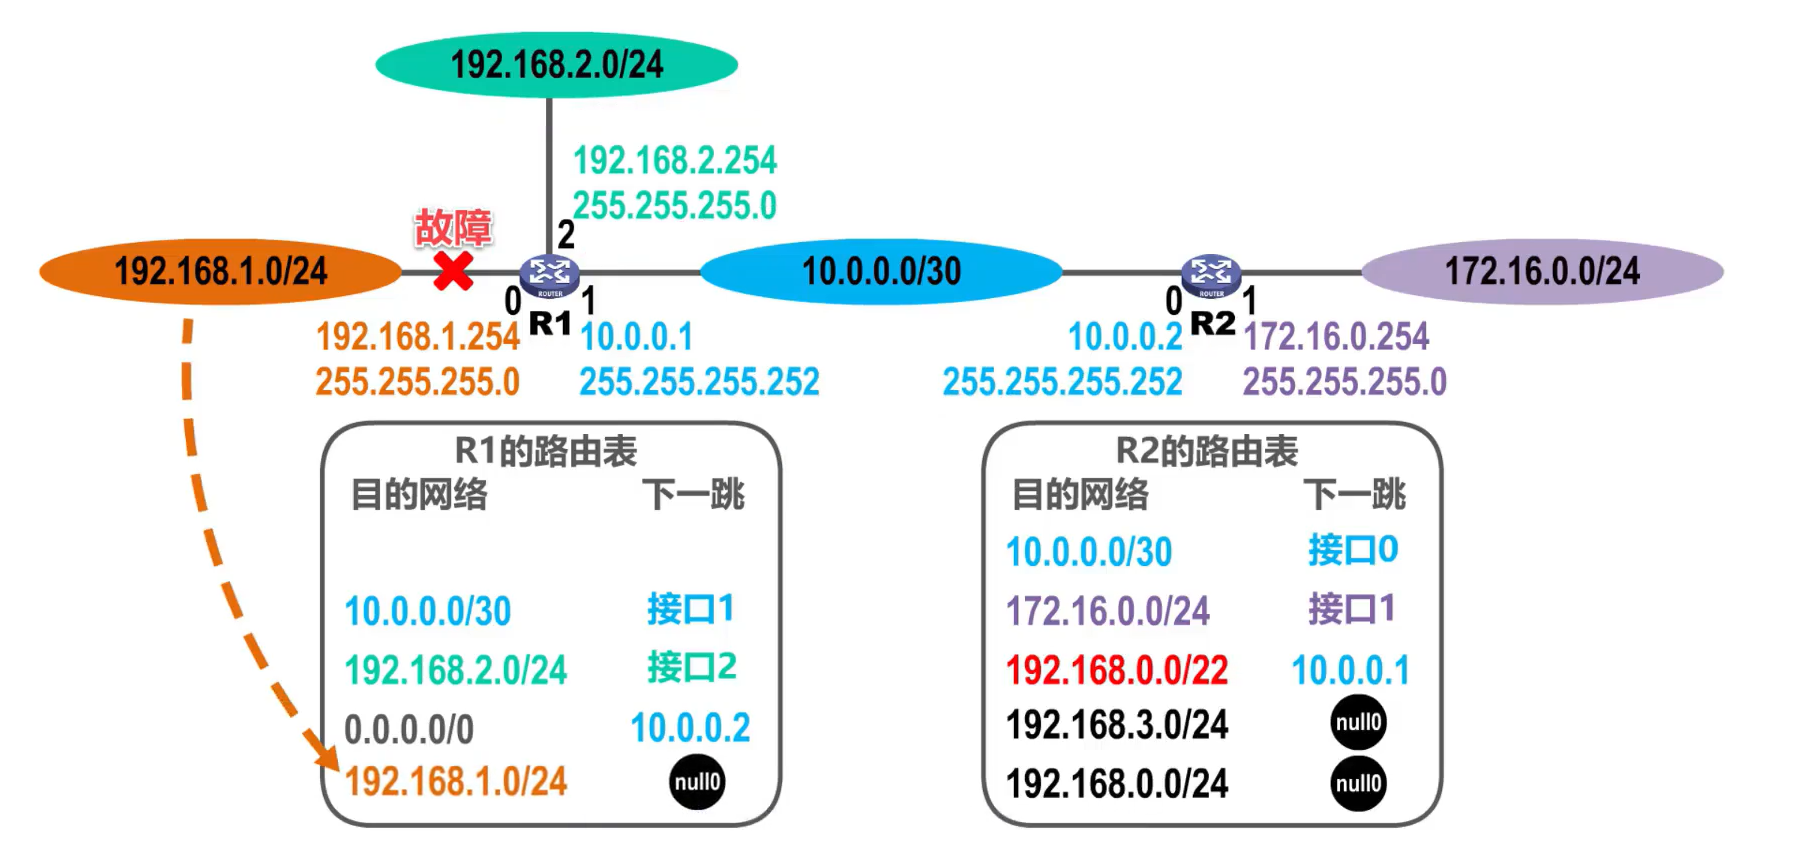
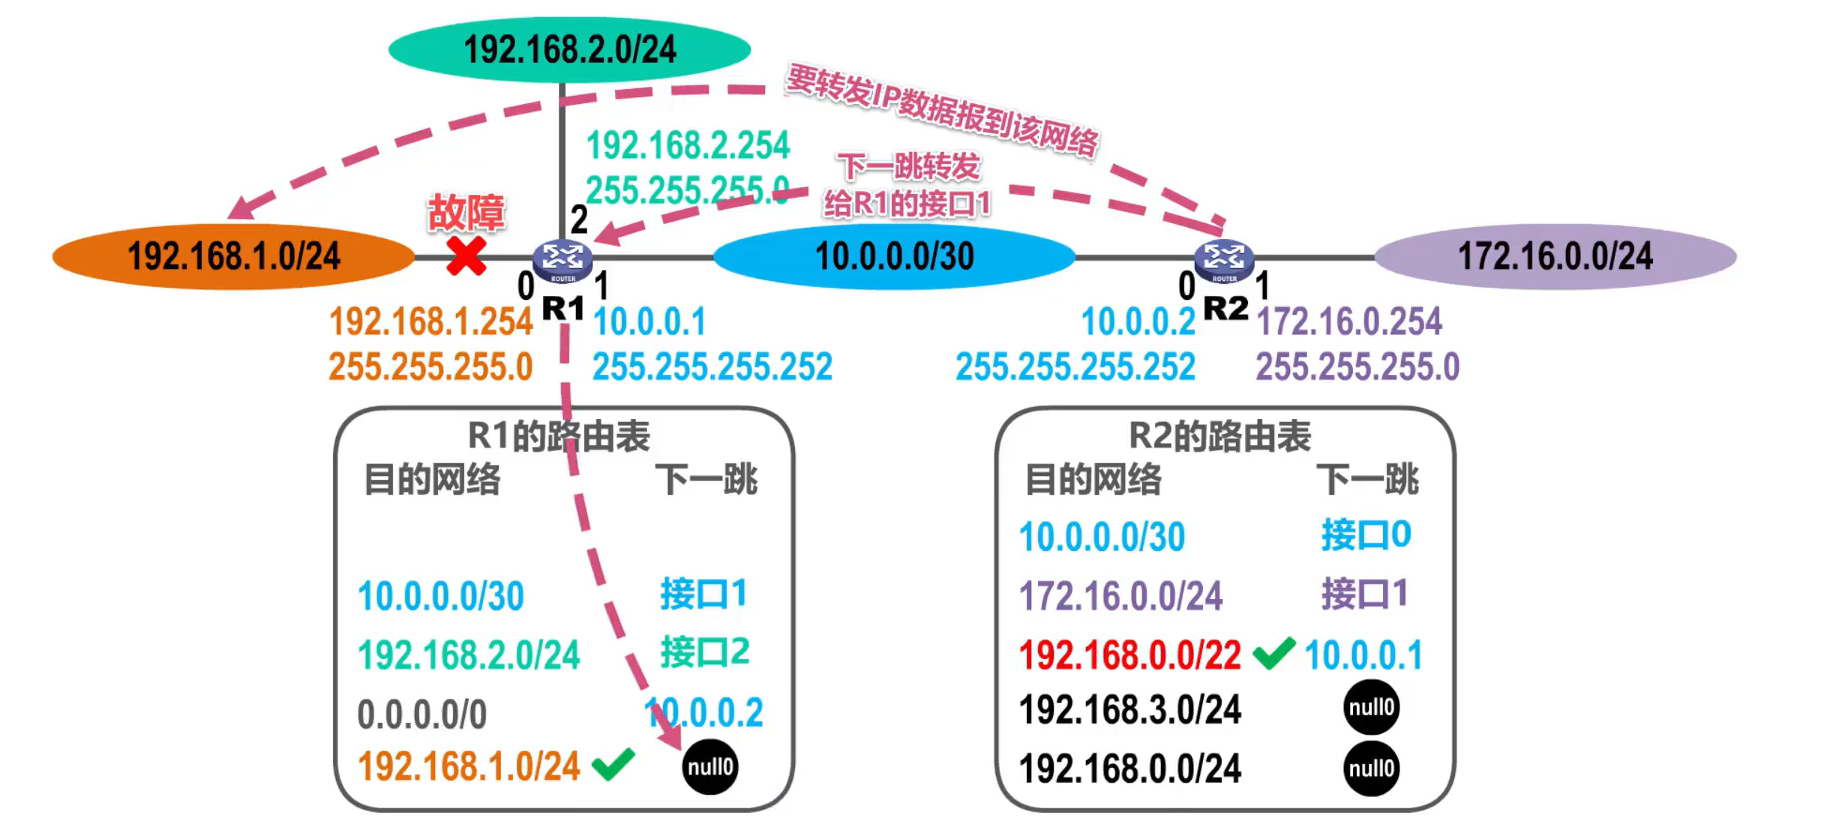
假设。一段时间后故障网络恢复了
R1又自动地得出了其接口0的直连网络的路由条目
针对该网络的黑洞网络会自动失效
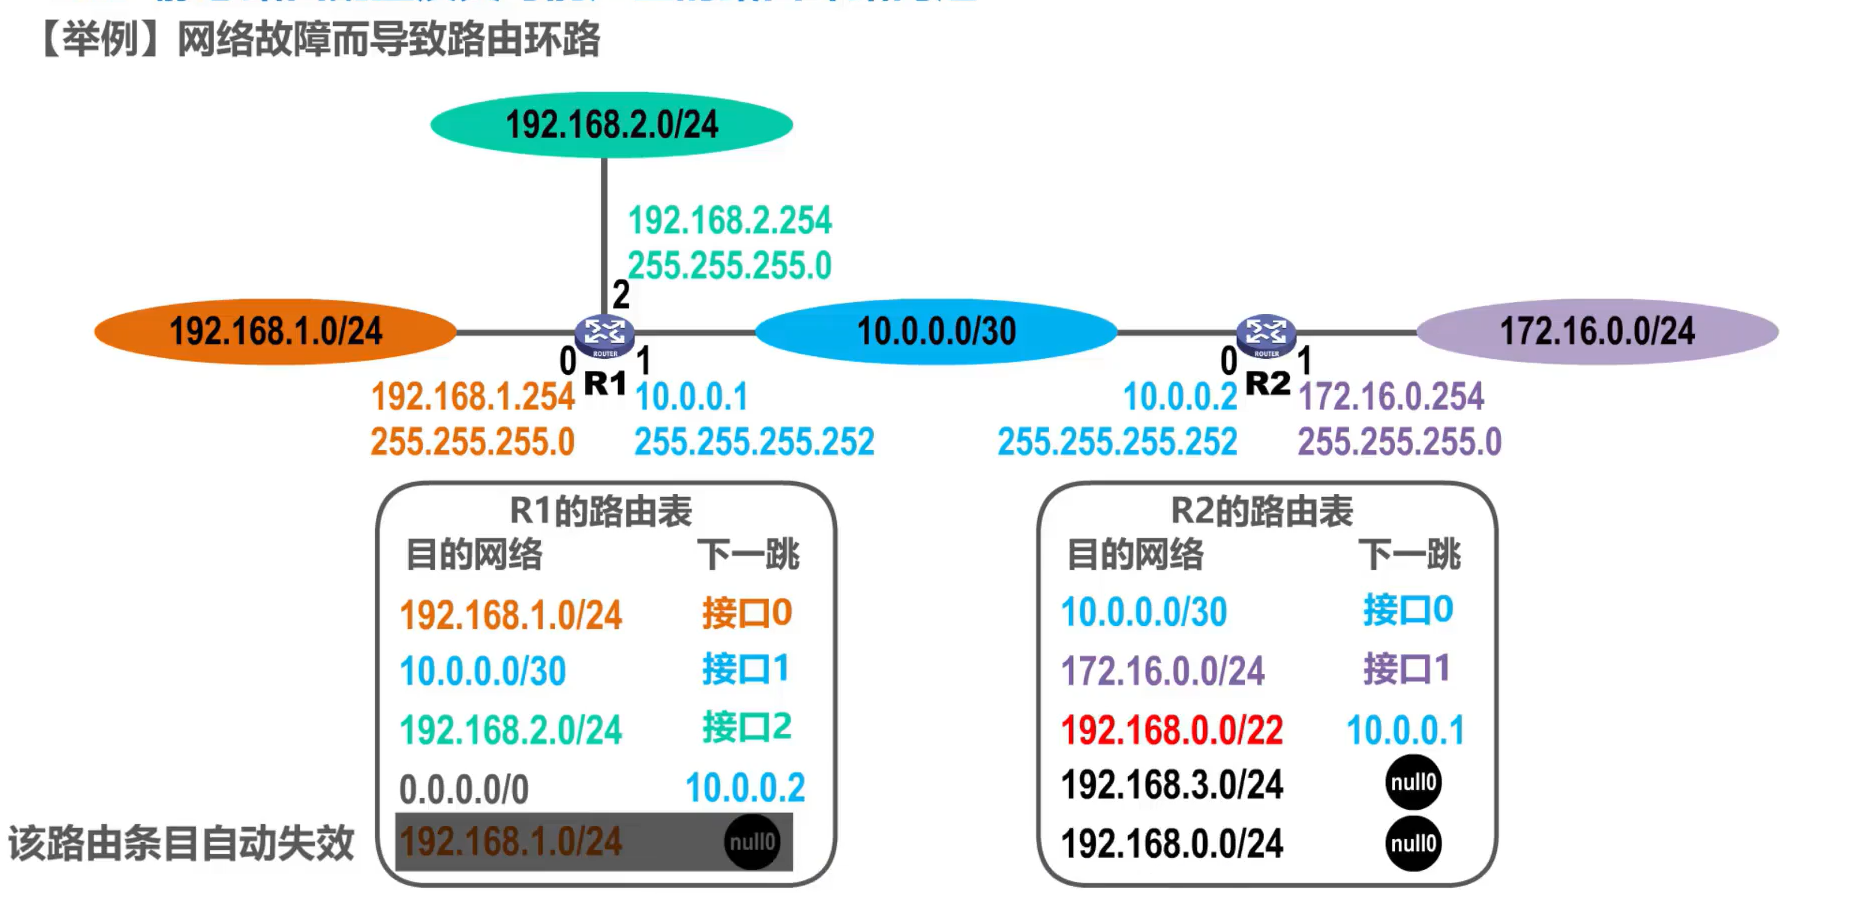
如果又故障
则生效该网络的黑洞网络
总结:
路由选择协议
概述
动态路由选择协议:
- 路由器通过路由选择协议自动获取路由信息。
- 比较复杂、开销比较大。能较好地适应网络状态的变化。
- 适用于大规模网络。
因特网所采用的路由选择协议的主要特点
- 自适应:动态路由选择,能较好适应网络状态的变化
- 分布式:路由器之间交换路由信息
- 分层次:将整个因特网划分为许多较小的自治系统AS (Autonomous System)
因特网采用分层次的路由选择协议
- 自治系统 AS:在单一的技术管理下的一组路由器,而这些路由器使用一种 AS 内部的路由选择协议和共同的度量以确定分组在该 AS 内的路由,同时还使用一种 AS 之间的路由选择协议用以确定分组在 AS之间的路由。
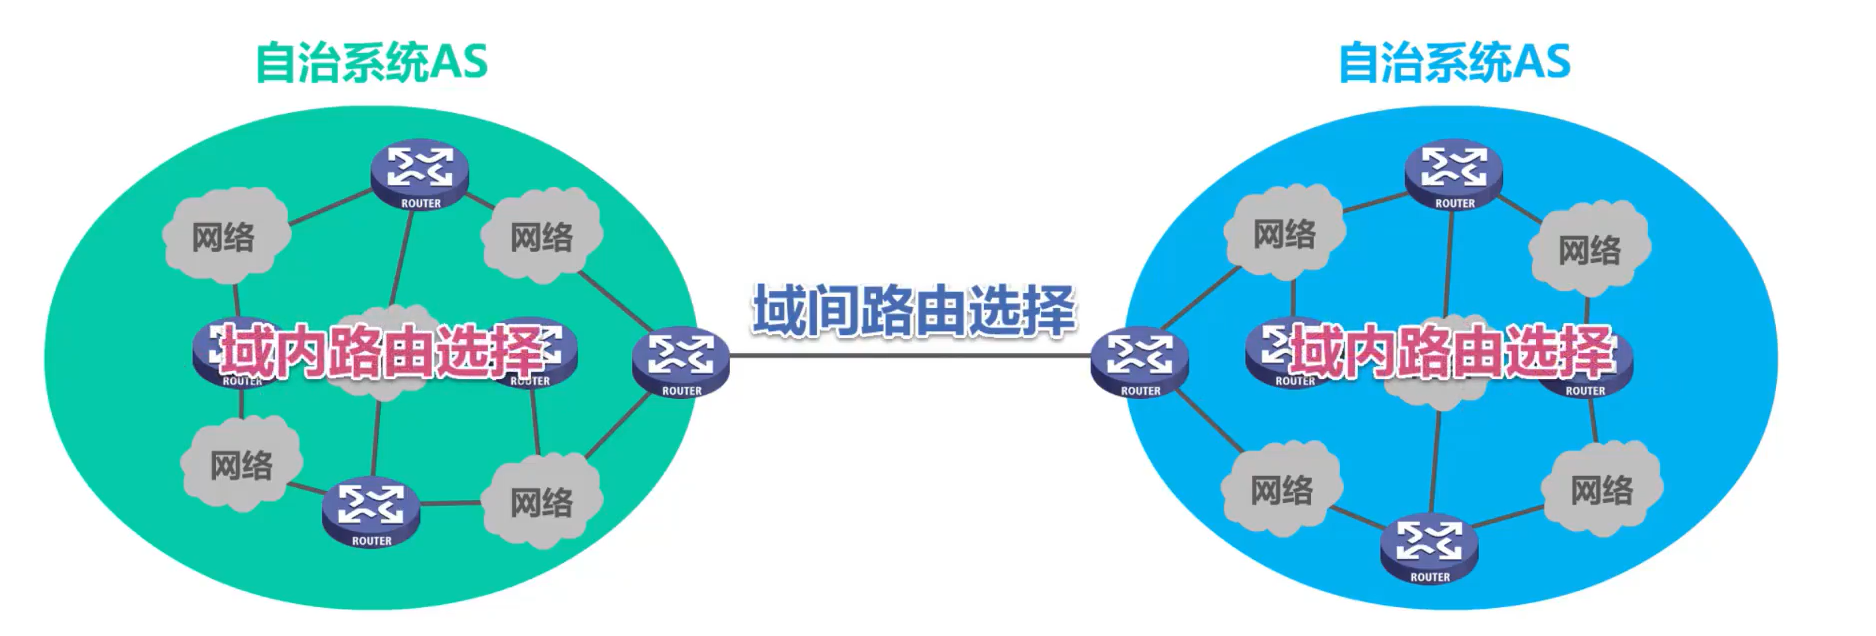
自治系统之间的路由选择简称为“域间路由选择”,自治系统内部的路由选择简称为“域内路由选择”
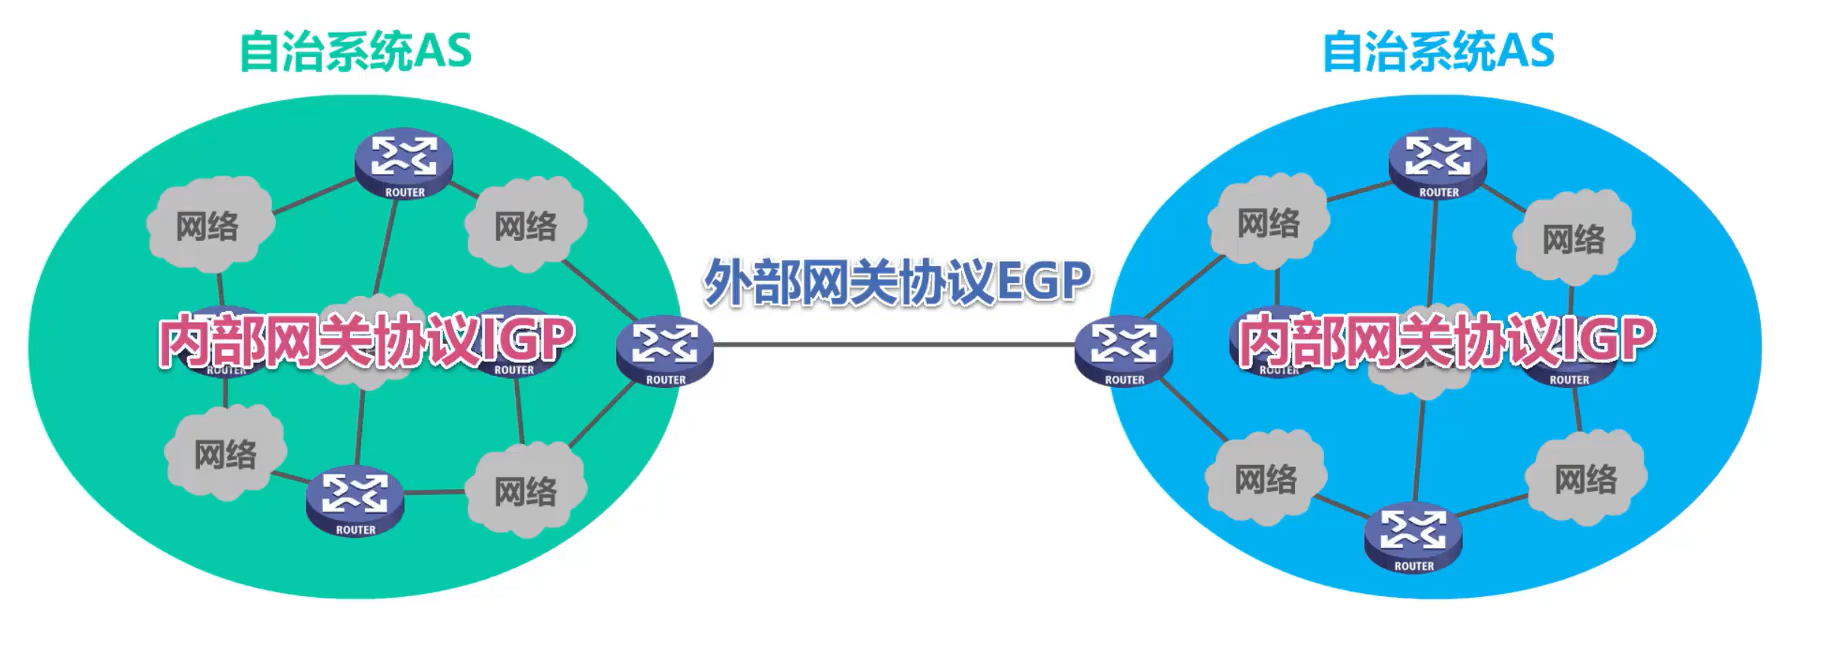
域间路由选择使用外部网关协议EGP
域内路由选择使用内部网关协议IGP
网关协议的名称可称为路由协议
常见的路由选择协议
- 内部网关协议IGP
- 路由信息协议RIP
- 内部网关路由协议IGRP
- 增强型内部网关路由协议EIGRP
- 开放式最短路径优先OSPF
- 中间系统到中间系统S-IS
- 外部网关协议EGP
- 边界网关协议BGP
路由器结构
路由器是一种具有多个输入端口,和输出端口的专用计算机,其任务是转发分组。
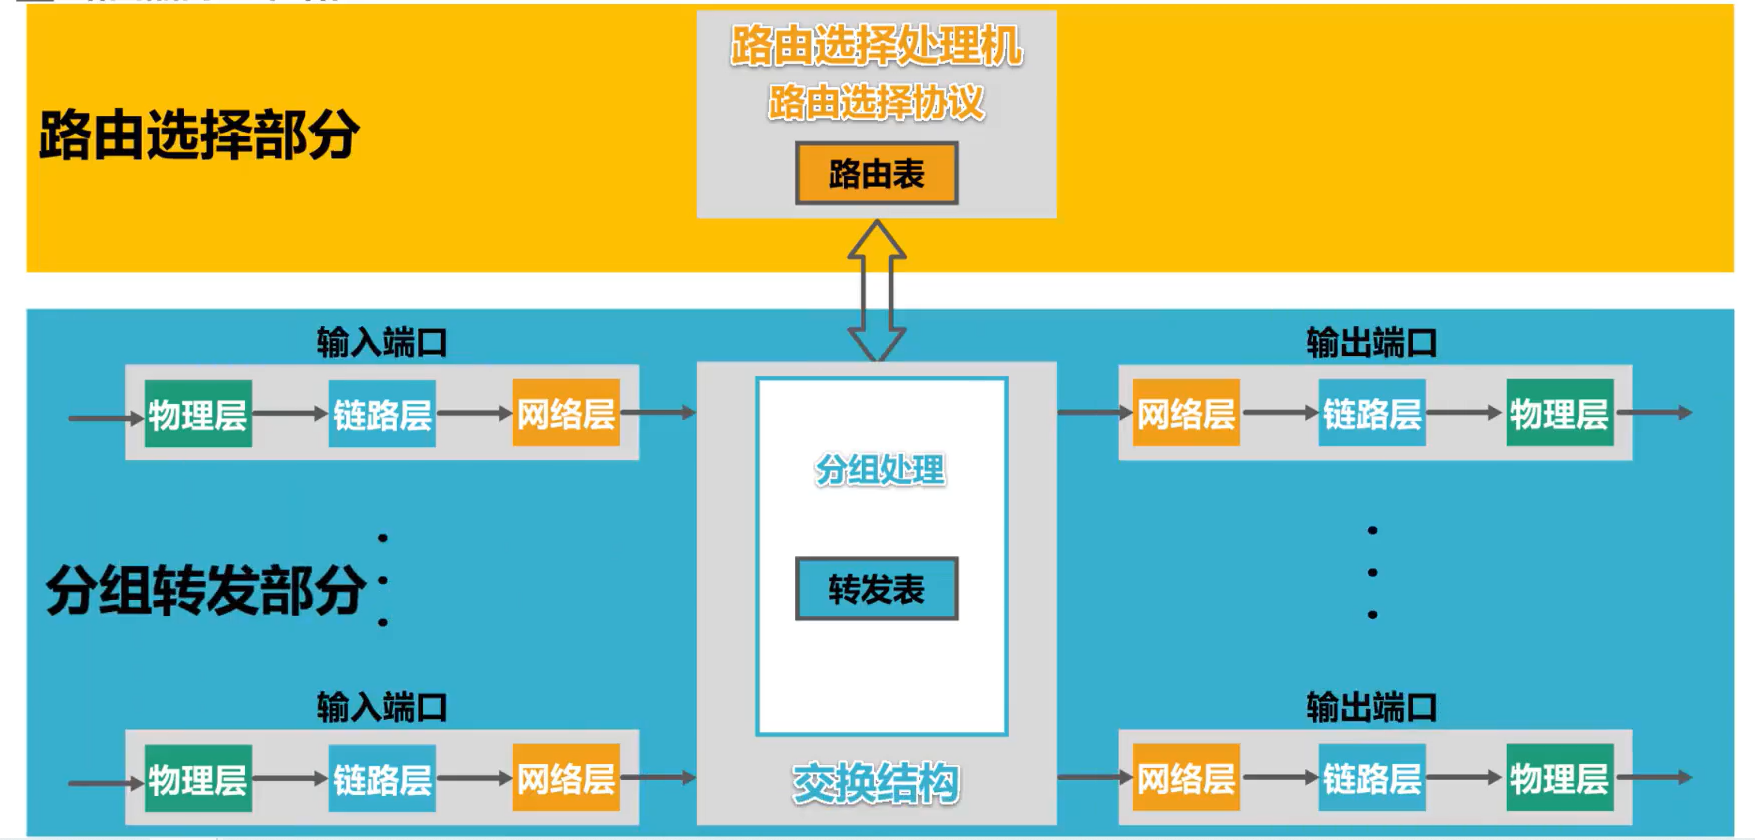
路由器结构可划分为两大部分:
1、分组转发部分
由三部分构成
交换结构
一组输入端口:
- 信号从某个输入端口进入路由器
- 物理层将信号转换成比特流,送交数据链路层处理
- 数据链路层识别从比特流中识别出帧,去掉帧头和帧尾后,送交网络层处理
- 如果送交网络层的分组是普通待转发的数据分组,则根据分组首部中的目的地址进行查表转发
- 若找不到匹配的转发条目,则丢弃该分组,否则,按照匹配条目中所指示的端口进行转发
一组输出端口
- 网络层更新数据分组首部中某些字段的值,例如将数据分组的生存时间减1,然后送交数据链路层进行封装
- 数据链路层将数据分组封装成帧,交给物理层处理
- 物理层将帧看成比特流将其变换成相应的电信号进行发送
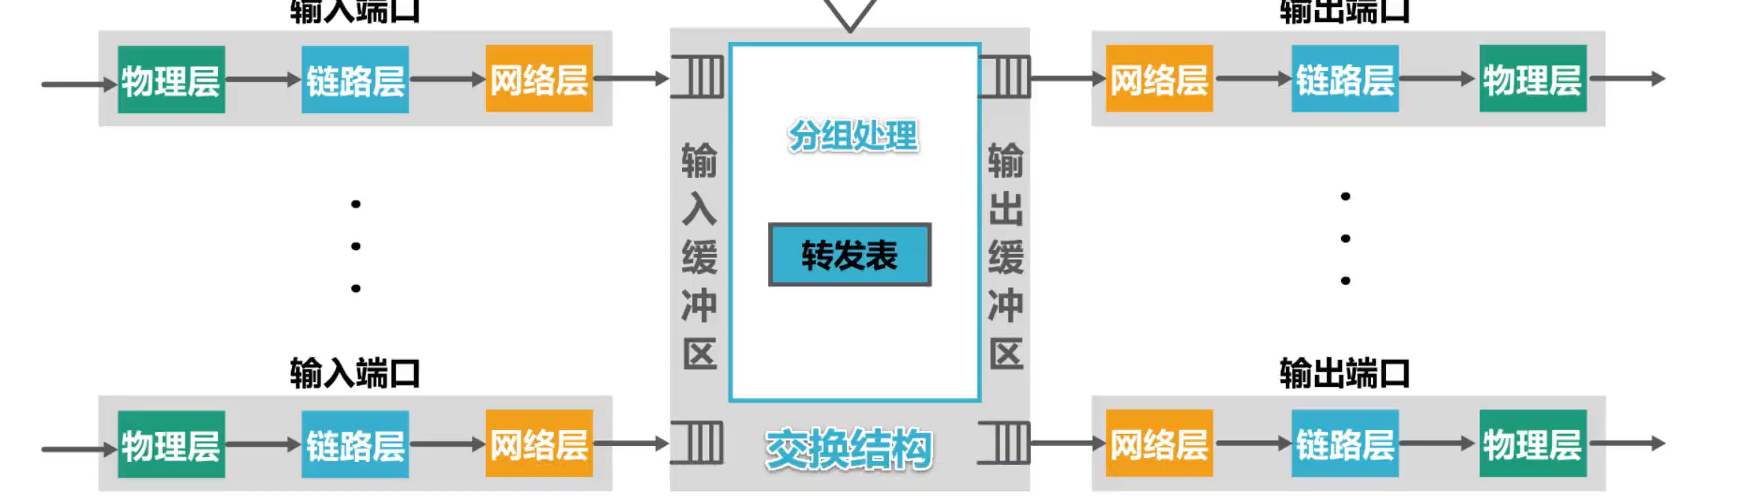
路由器的各端口还会有输入缓冲区和输出缓冲区
输入缓冲区用来暂存新进入路由器但还来不及处理的分组
输出缓冲区用来暂存已经处理完毕但还来不及发送的分组
路由器的端口一般同时具有输入和输出功能。
2、路由选择部分
路由选择部分的核心构件是路由选择处理机,它的任务是根据所使用的路由选择协议。周期性地与其他路由器 进行路由信息的交互,来更新路由表。
如果送交给输入端口的网络层的分组是路由器之间交换路由信息的路由报文,则把这种分组送交给路由选择处理机。
路由选择处理机根据分组的内容来更新自己的路由表
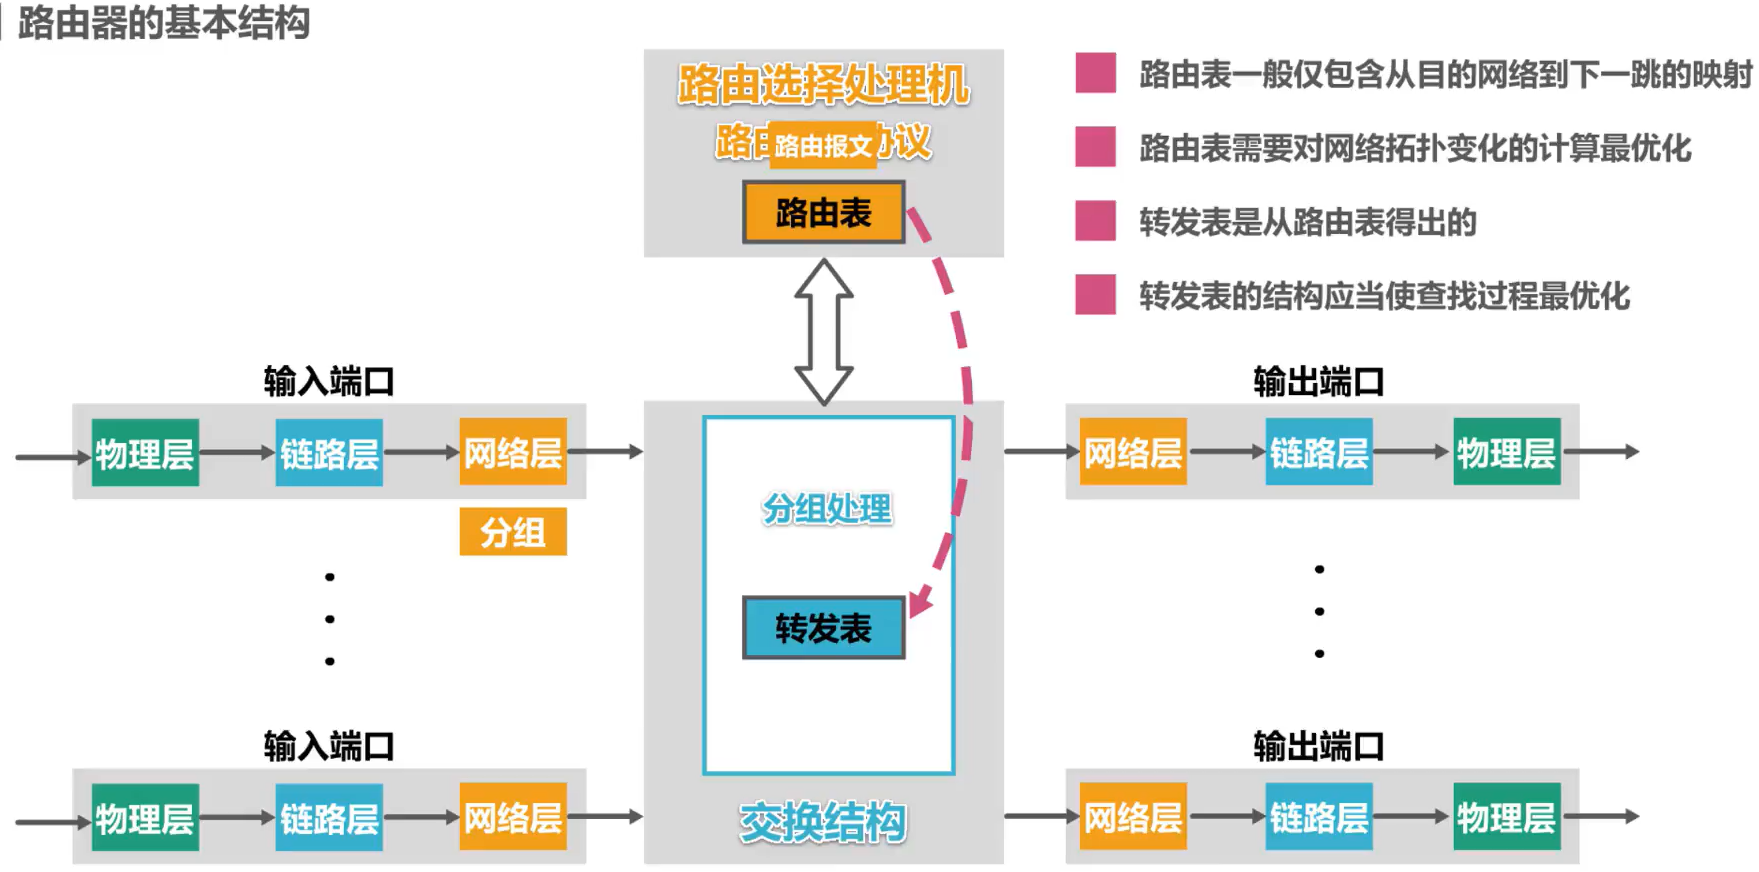
路由选择处理机还会周期性地给其他路由器发送自己所知道的路由信息
路由信息协议RIP
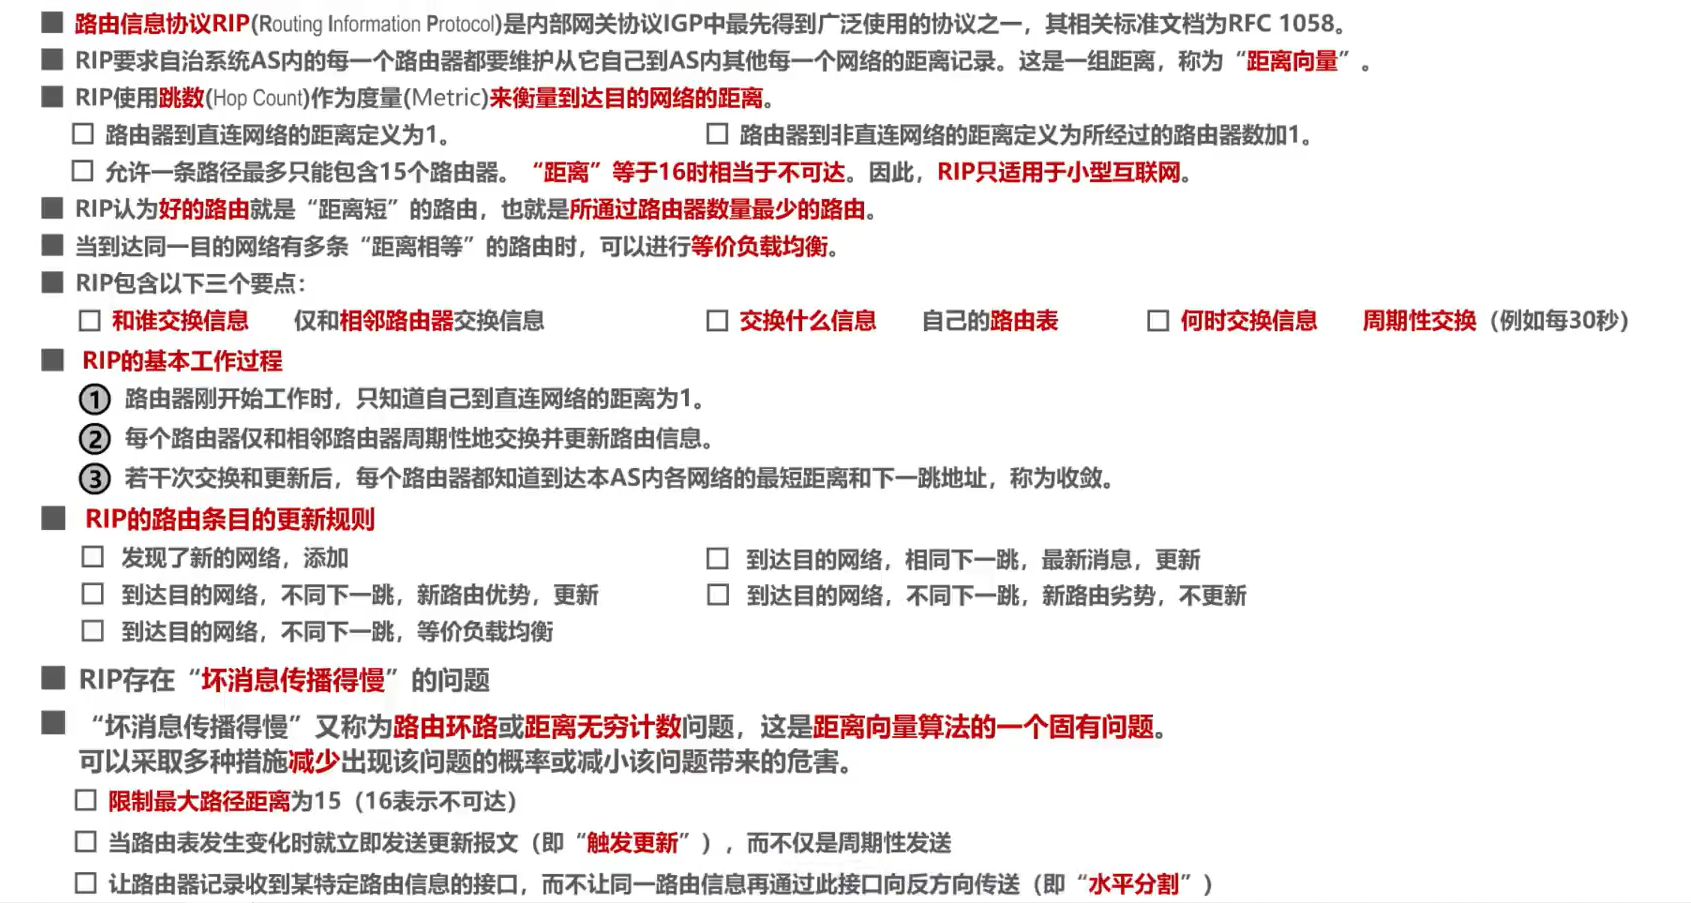
RIP 要求自治系统AS内的每一个路由器都要维护从它自己到AS内其他每一个网络的距离记录。这是一组距离,称为 “距离向量D-V(Distance-Vector)”。
RIP使用跳数(Hop Count)作为度量(Metric)来衡量到达目的网络的距离。
- 路由器到直连网络的距离定义为1。
- 路由器到非直连网络的距离定义为所经过的路由器数加1。
- 允许一条路径最多只能包含15个路由器。
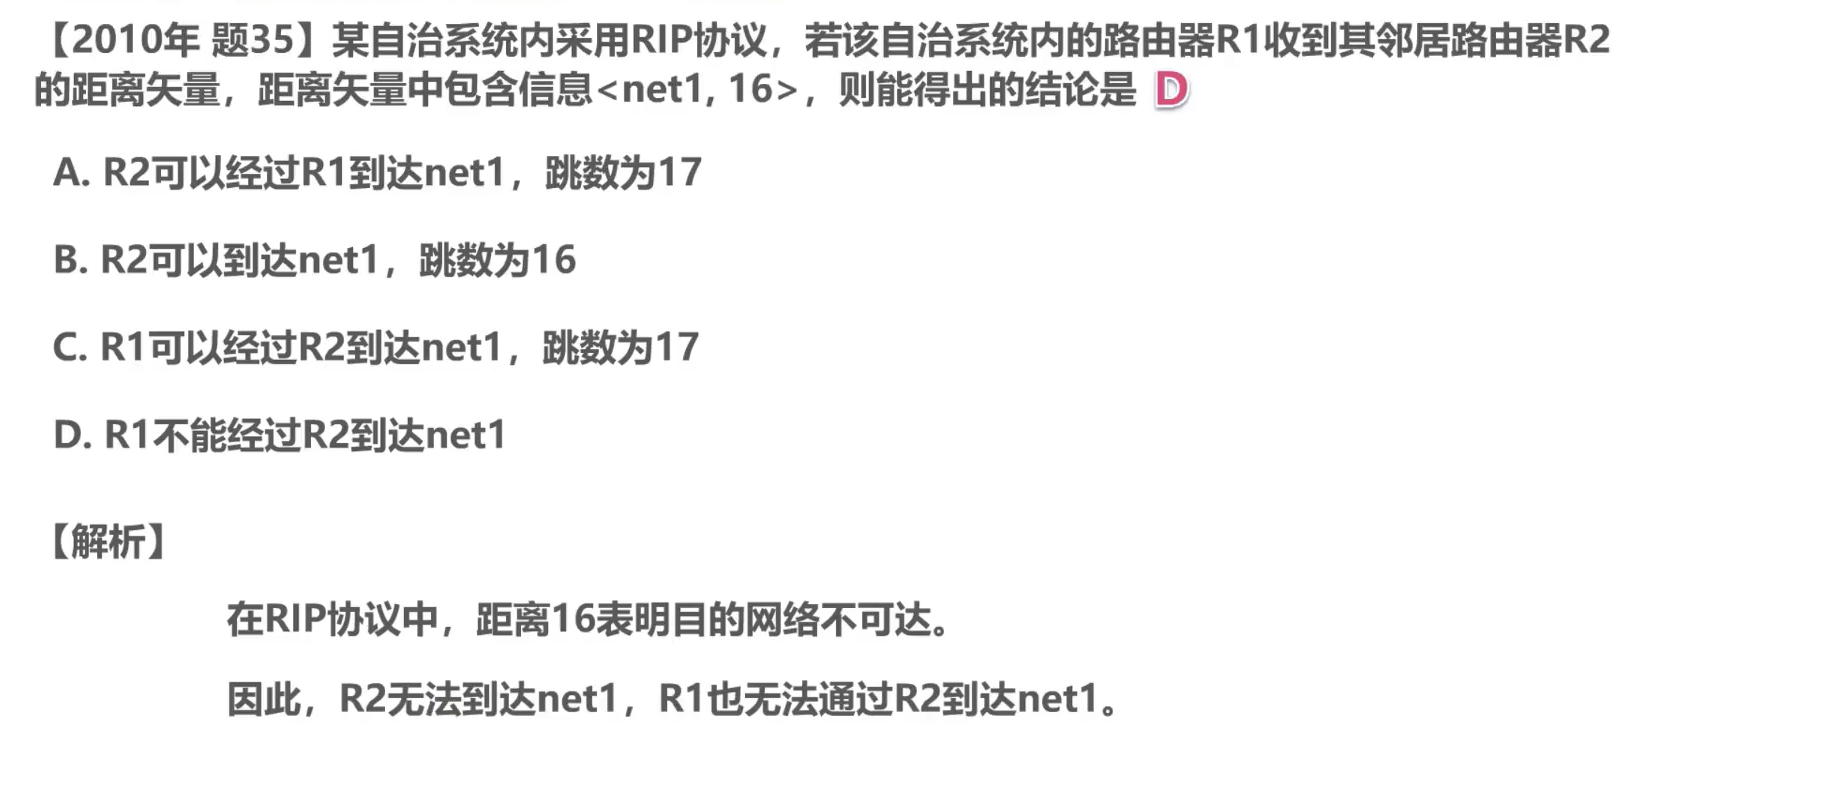
“距离”等于16时相当于不可达。因此,RIP只适用于小型互联网。
RIP认为好的路由就是“距离短”的路由,也就是所通过路由器数量最少的路由。
RIP包含以下三个要点:
- 和谁交换信息:仅和相邻路由器交换信息
- 交换什么信息:路由表
- 何时交换信息:周期性交换(例如每30秒)
RIP的基本工作过程
举例
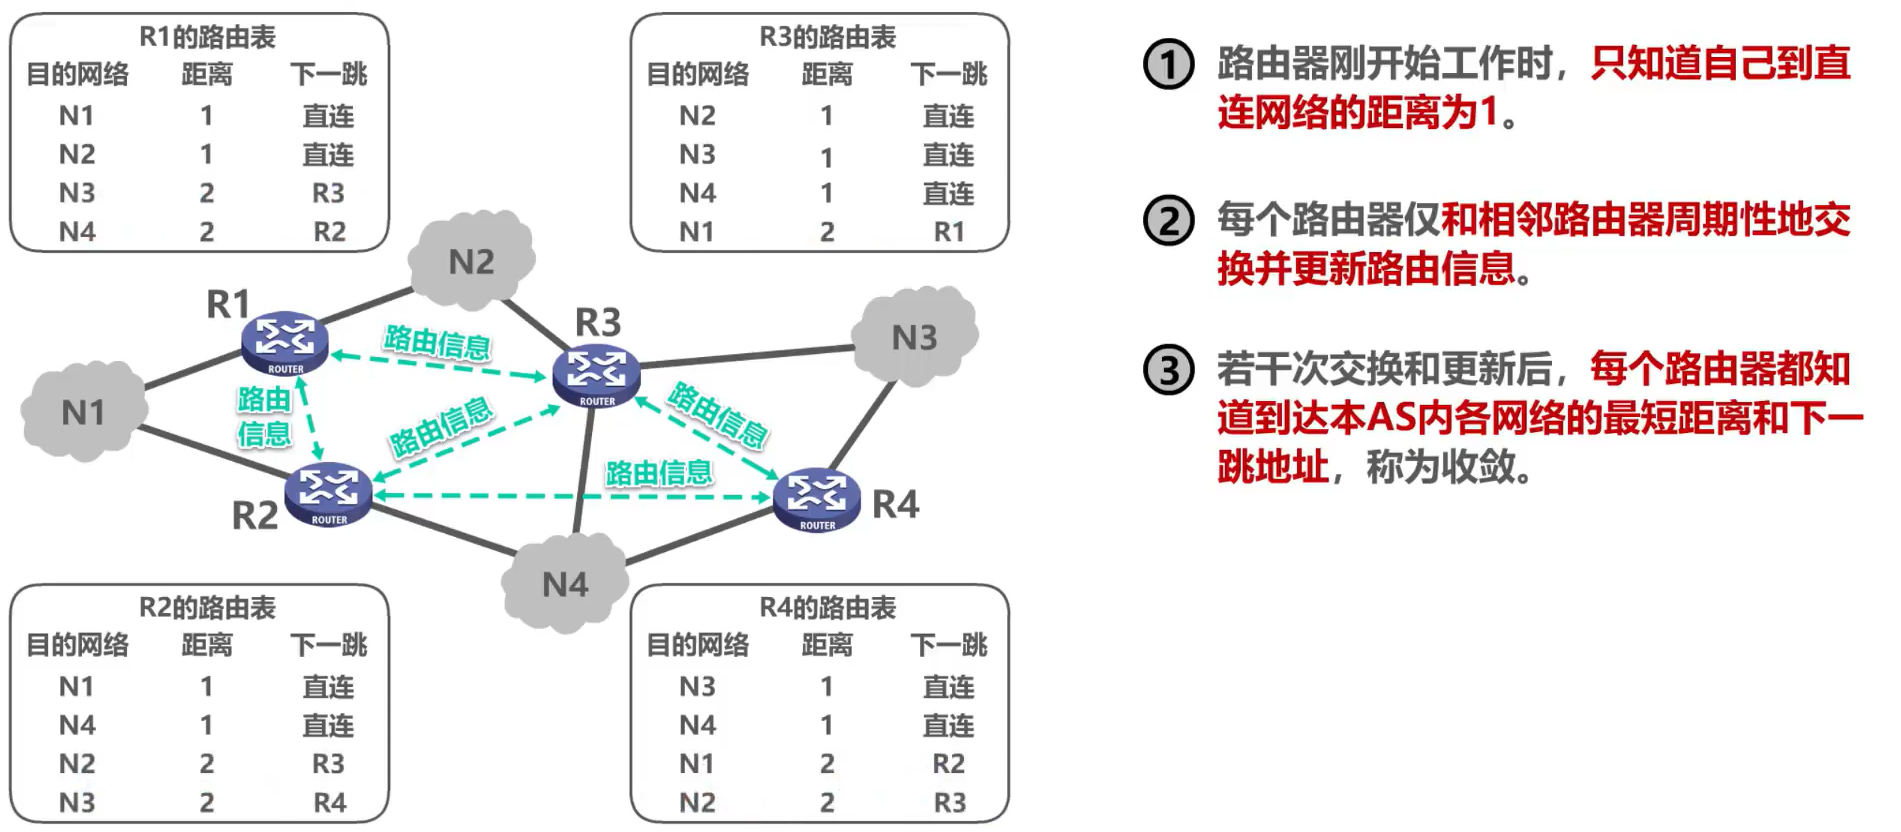
RIP的路由条目的更新规则
举例1
假设路由器C的RIP更新报文发送周期到了,则路由器C将自己路由表中的相关路由信息封装到RIP更新报文中发送给路由器D
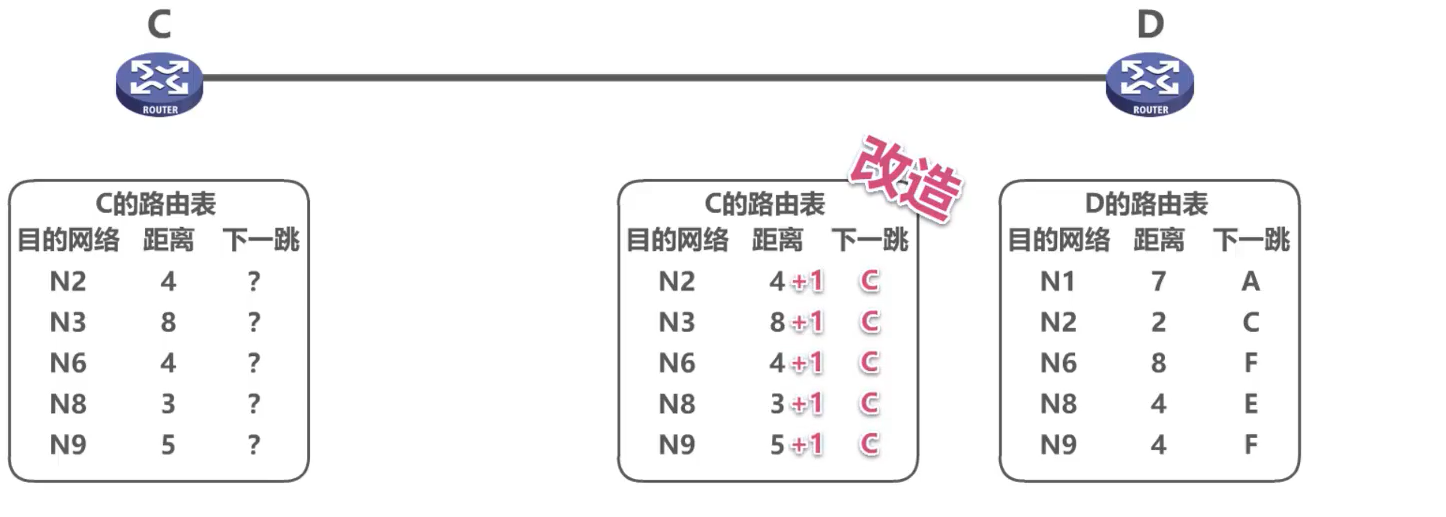
路由器C能到达这些网络,说明路由器C的相邻路由器也能到达,只是比路由器C的距离大1,于是根据距离的对比,路由器D更新自己的路由表
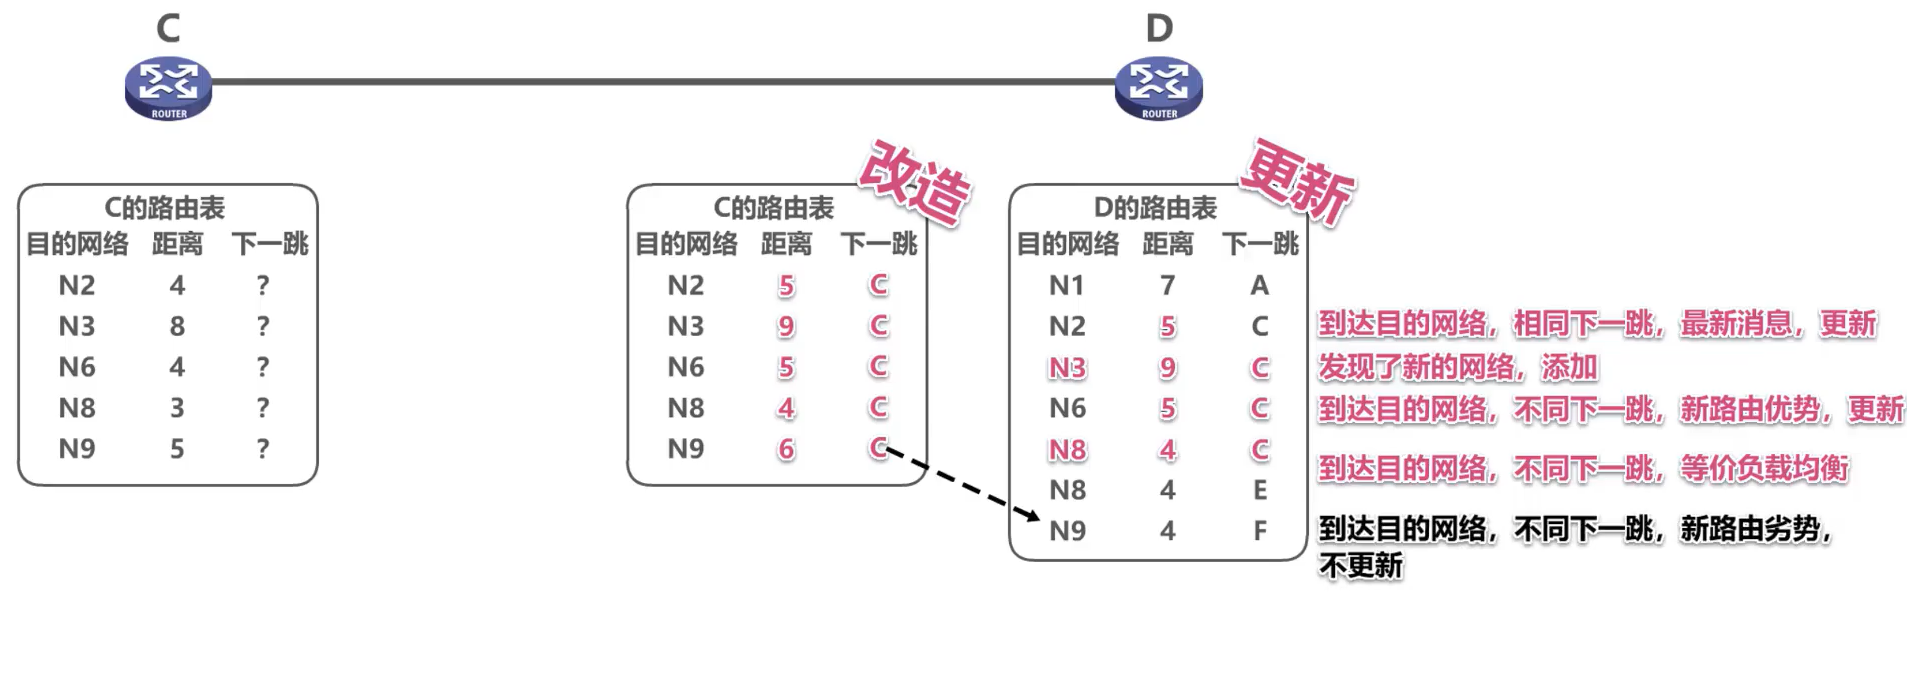
举例2
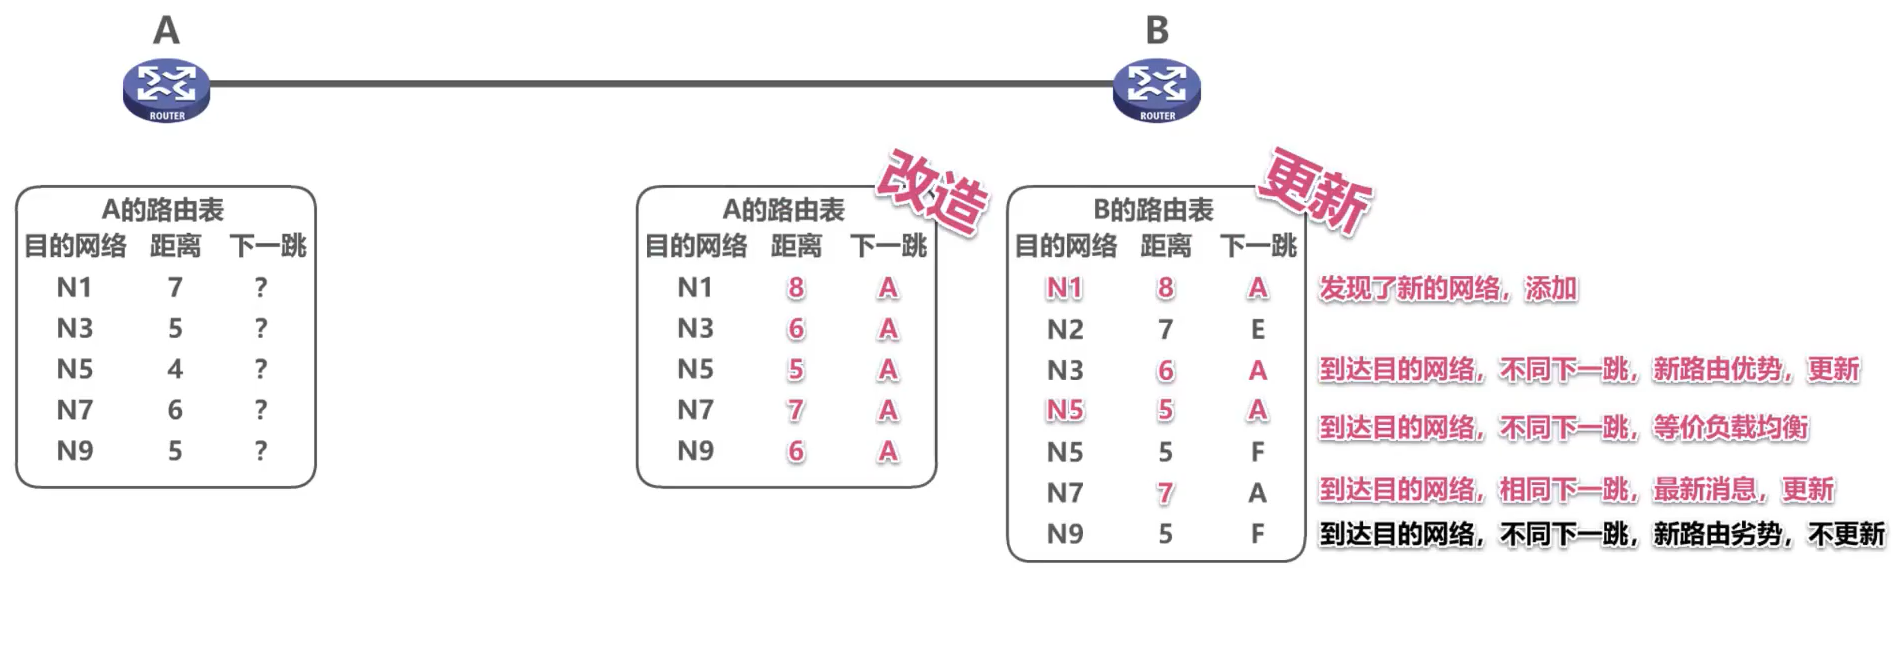
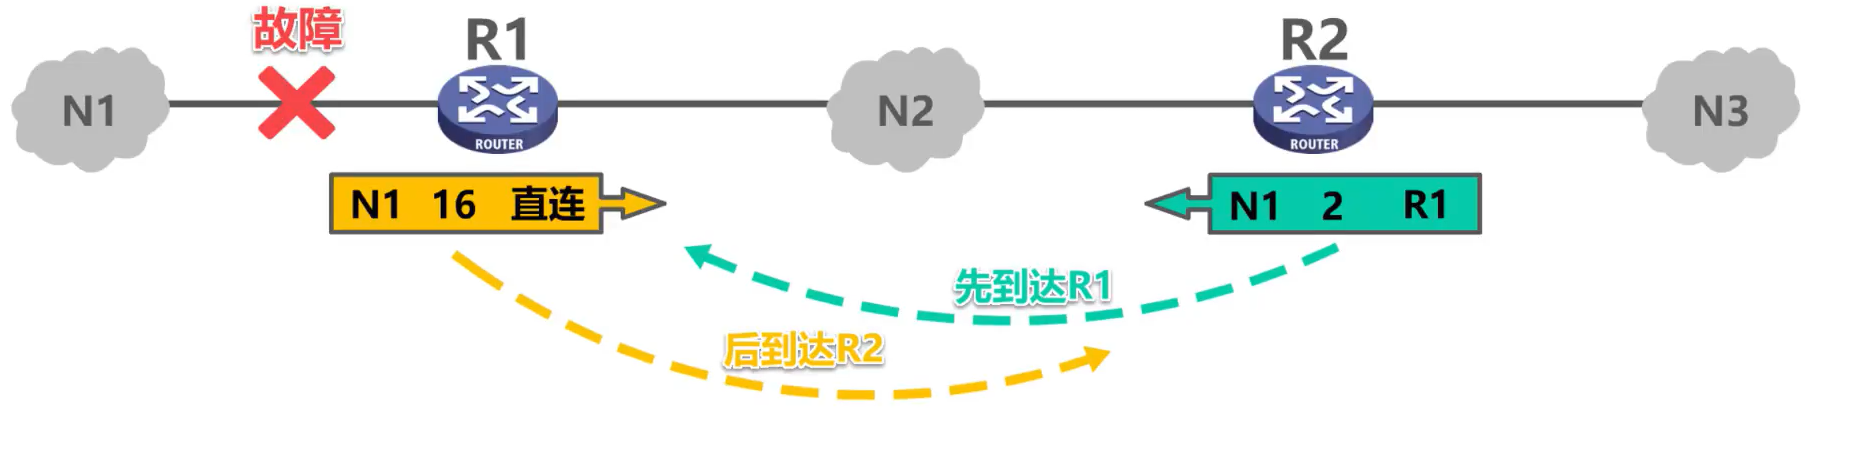
RIP存在“坏消息传播得慢”的问题
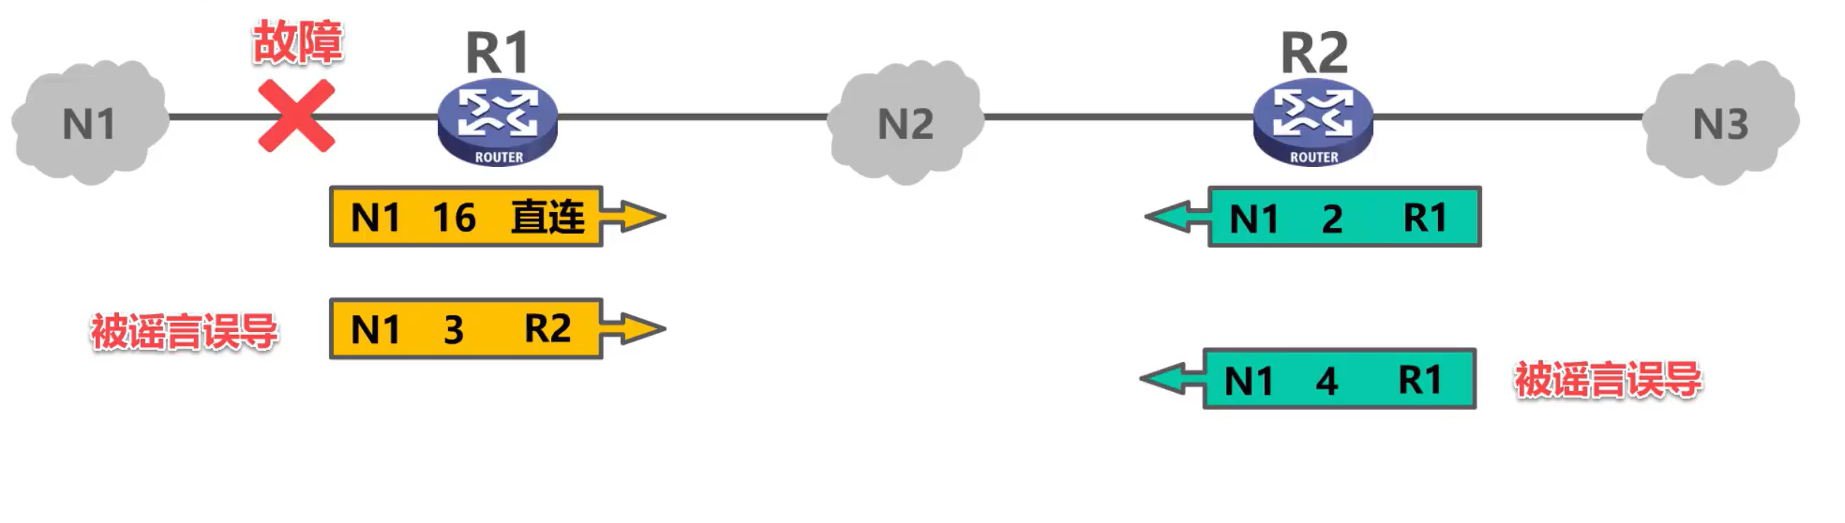
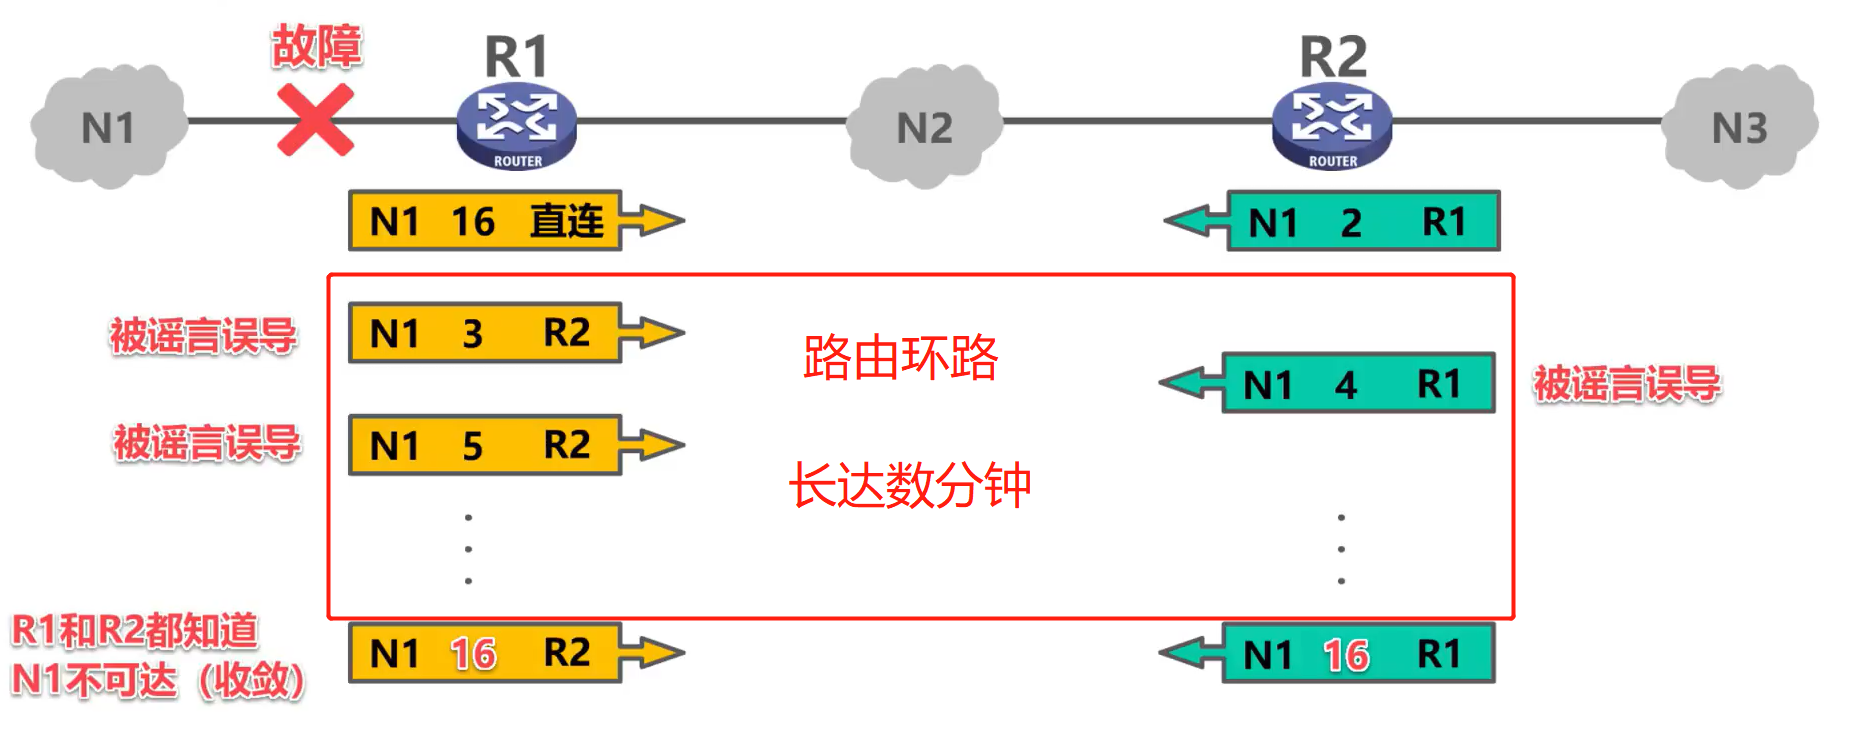
解决方法
“坏消息传播得慢”又称为路由环路或距离无穷计数问题,这是距离向量算法的一个固有问题。
可以采取多种措施减少出现该问题的概率或减小该问题带来的危害。
- 限制最大路径距离为15(16表示不可达)
- 当路由表发生变化时就立即发送更新报文(即“触发更新”),而不仅是周期性发送
- 让路由器记录收到某特定路由信息的接口,而不让同一路由信息再通过此接口向反方向传送(即“水平分割”)
但是,这些方法也不能完全解决“坏消息传播得慢”的问题,这是距离向量的本质决定
总结
RIP 协议的优缺点
优点:
- 实现简单,开销较小。
缺点:
RIP 限制了网络的规模,它能使用的最大距离为 15(16 表示不可达)。
路由器之间交换的路由信息是路由器中的完整路由表,因而随着网络规模的扩大,开销也就增加。
“坏消息传播得慢”,使更新过程的收敛时间过长。
开放最短路径优先OSPF
开放最短路径优先 OSPF (Open Shortest Path First)
注意:OSPF 只是一个协议的名字,它并不表示其他的路由选择协议不是“最短路径优先”。
概念
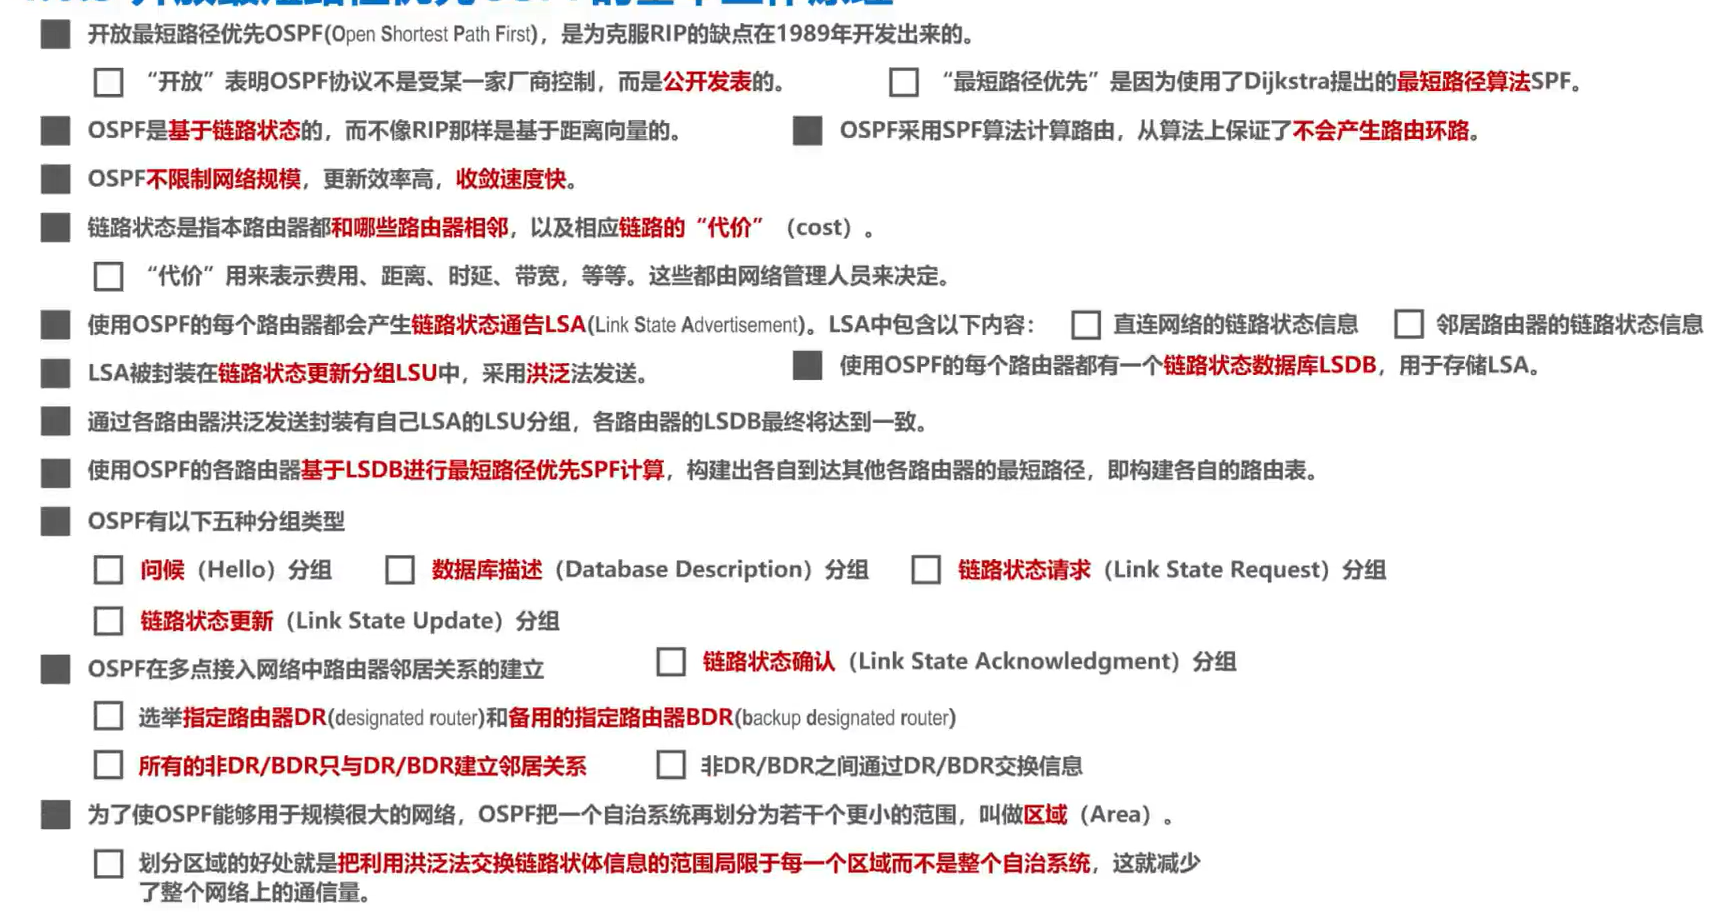
开放最短路径优先OSPF(Open Shortest Path First),是为克服RIP的缺点在1989年开发出来的。
- “开放”表明OSPF协议不是受某一家厂商控制,而是公开发表的。
- “最短路径优先”是因为使用了Dijkstra提出的最短路径算法SPF.
OSPF是基于链路状态的,而不像RIP那样是基于距离向量的。
OSPF采用SPF算法计算路由,从算法上保证了不会产生路由环路。
OSPF不限制网络规摸,更新效率高,收敛速度快。
使用链路状态 表示本路由器都和哪些路由器相邻,以及相应链路的“代价”(cost)。
- “代价”用来表示费用、距离、时延、带宽,等等。这些都由网络管理人员来决定。
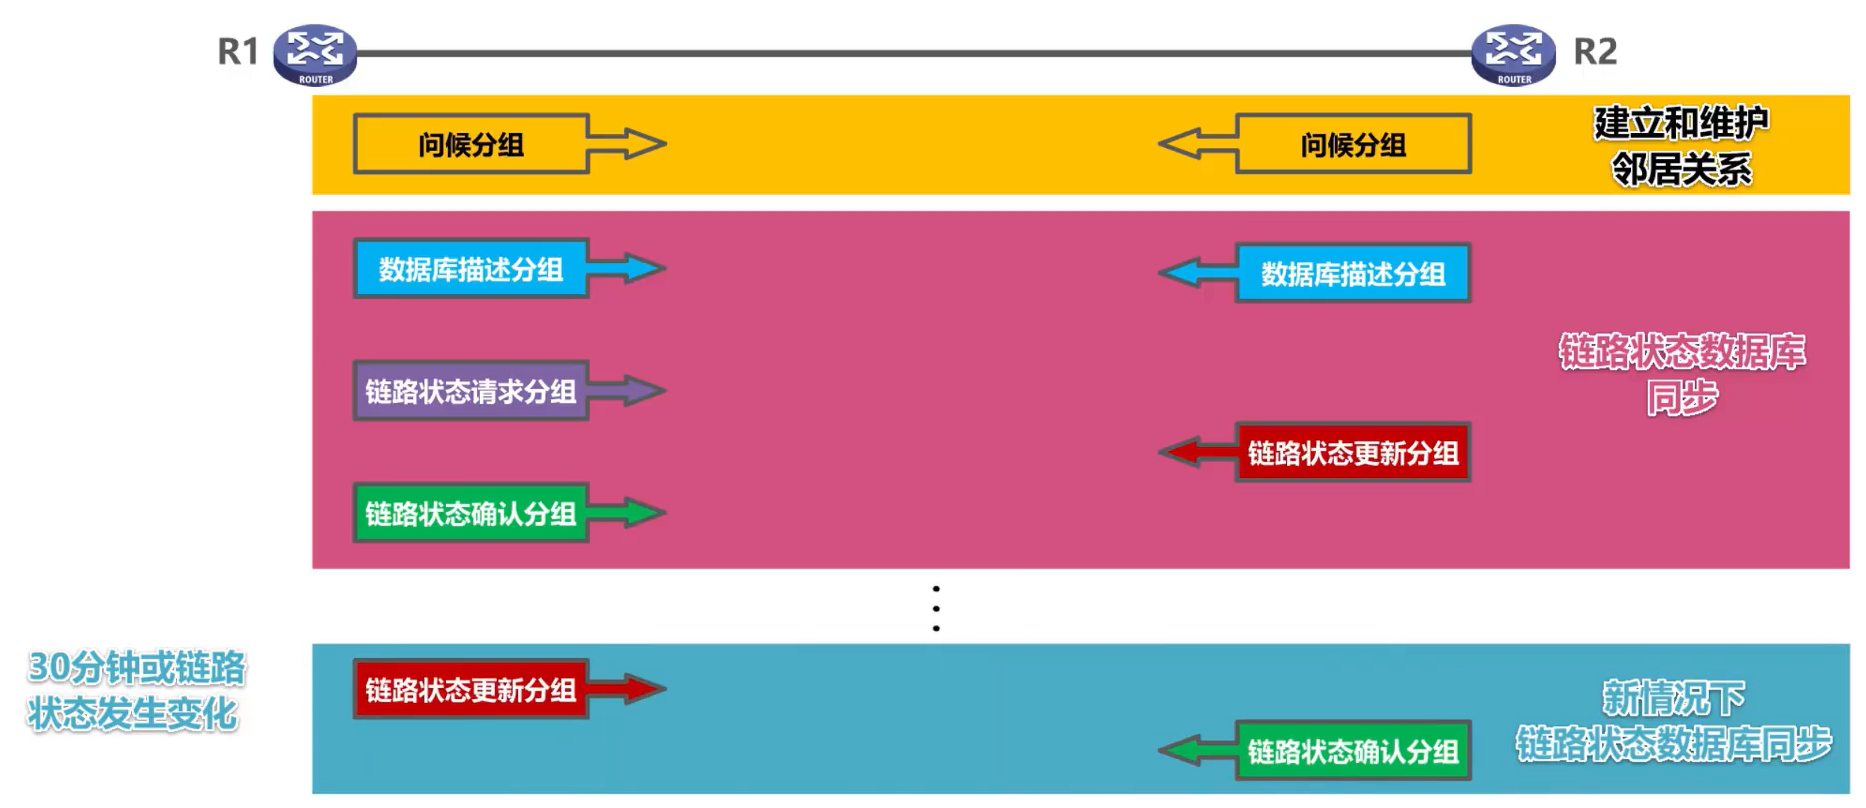
问候(Hello)分组 :用于建立和维护邻居关系
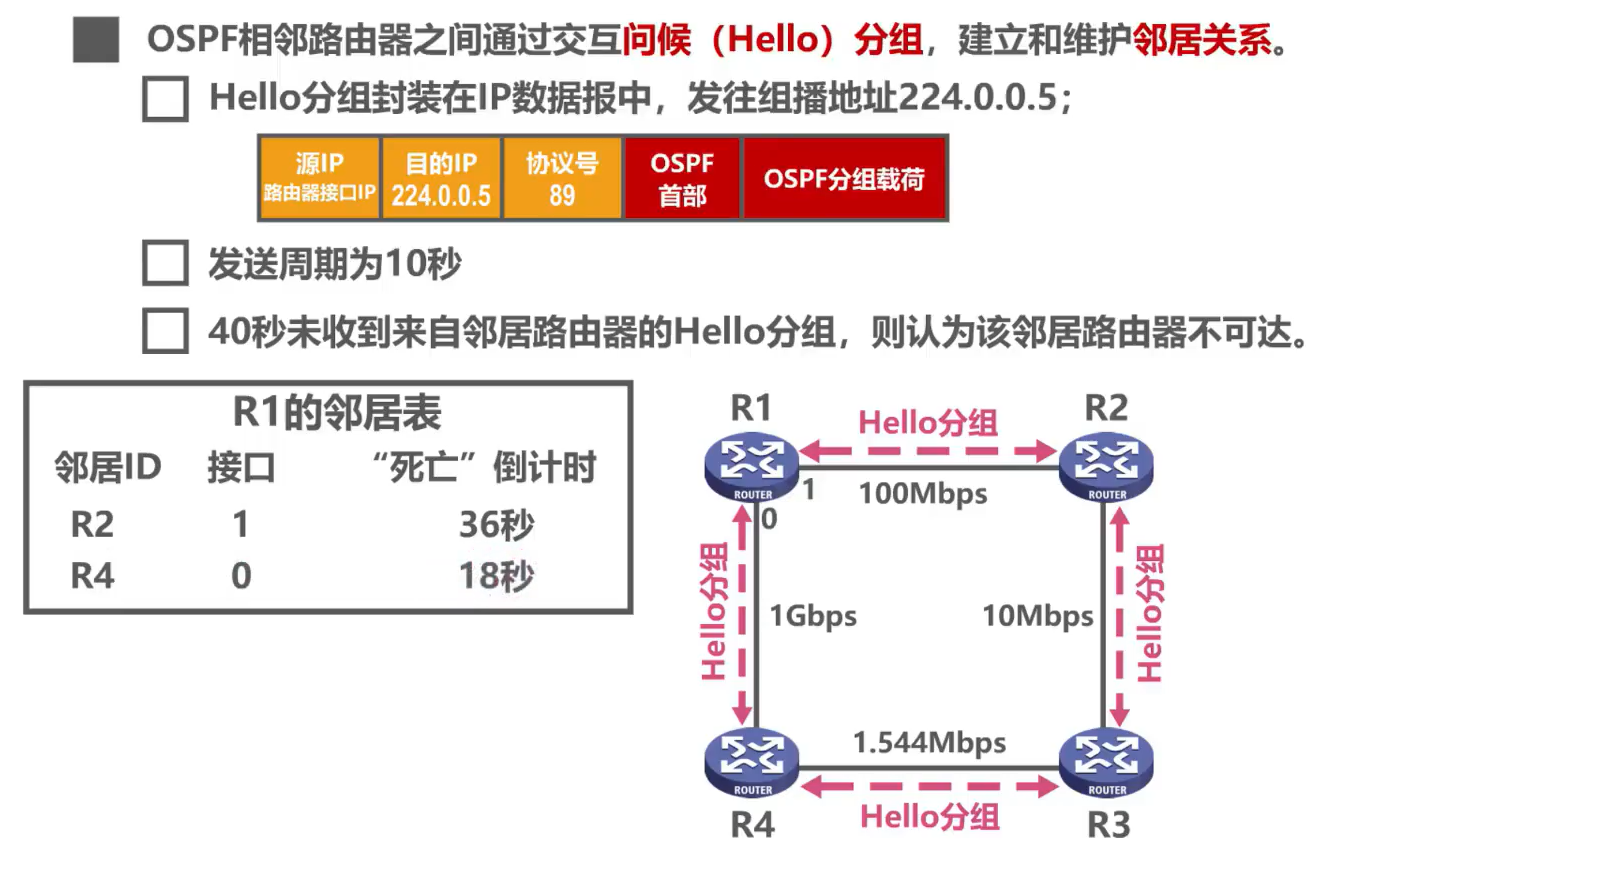
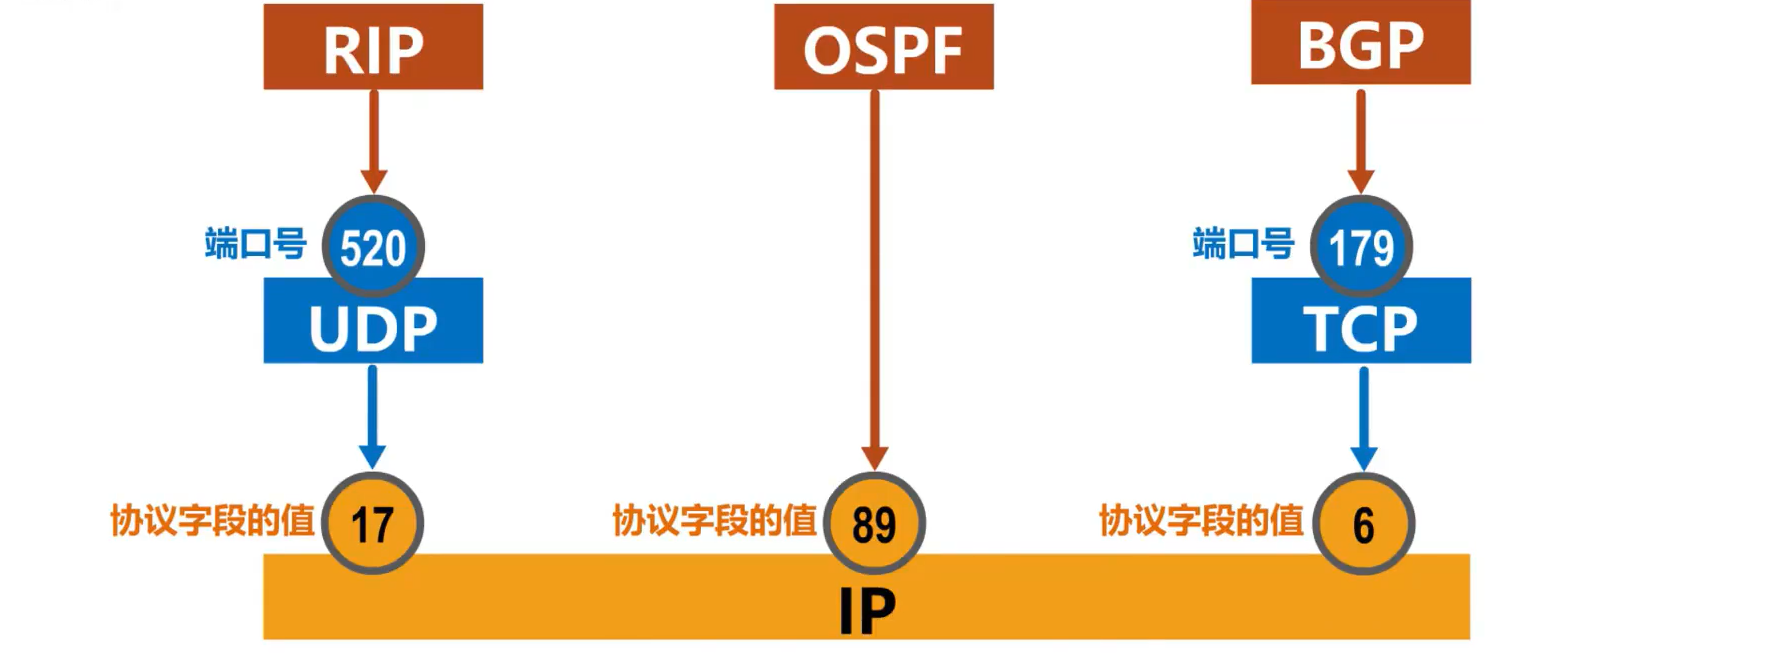
IP数据报首部中协议号字段的取值应为89,来表明IP数据报的数据载荷为OSPF分组
链路状态通告LSA 包含:
- 直连网络的链路状态信息
- 邻居路由器的链路状态信息
LSA被封装在链路状态更新分组LSU中,采用洪泛法发送,
洪泛法有点类似于广播,就是从一个接口进来,从其他剩余所有接口出去
链路状态数据库同步LSDB
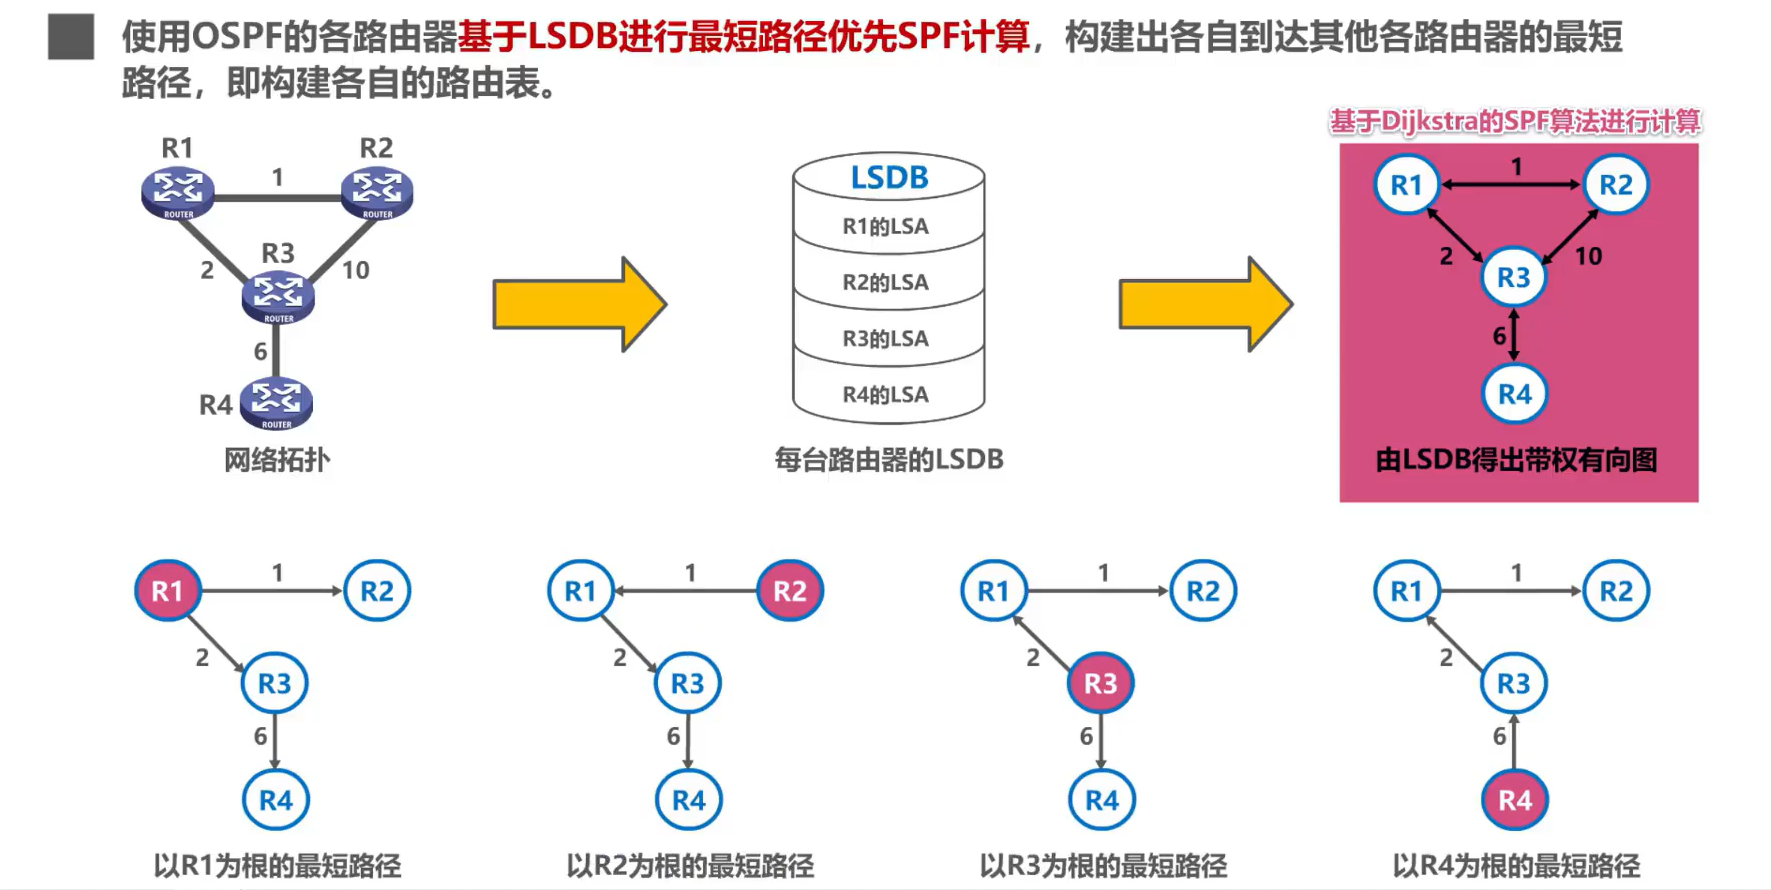
使用OSPF的每个路由器都有一个链路状态数据库LSDB,用于存储LSA。 通过各路由器洪泛发送封装有自己LSA的LSU分组,各路由器的LSDB最终将达到一致。
基于LSDB,使用SPF算法计算出各自路由器到达其他路由器的最短路径,构建出各自的路由表
OSPF五种分组类型
- 类型1,问候(Hello)分组 —— 用来发现和维护邻居路由器的可达性。
- 类型2,数据库描述分组 —— 向邻居路由器给出自己的链路状态数据库中的所有链路状态项目的摘要信息
- 类型3,链路状态请求分组 —— 向邻居路由器请求发送某些链路状态项目的详细信息。
- 类型4,链路状态更新分组 —— 路由器使用这种分组将其链路状态进行洪泛发送,即用洪泛法对全网更新链路状态。
- 类型5,链路状态确认分组 —— 这是对链路状态更新分组的确认分组。
OSPF的基本工作过程
OSPF在多点接入网络中路由器邻居关系建立
如果不采用其他机制,将会产生大量的多播分组。
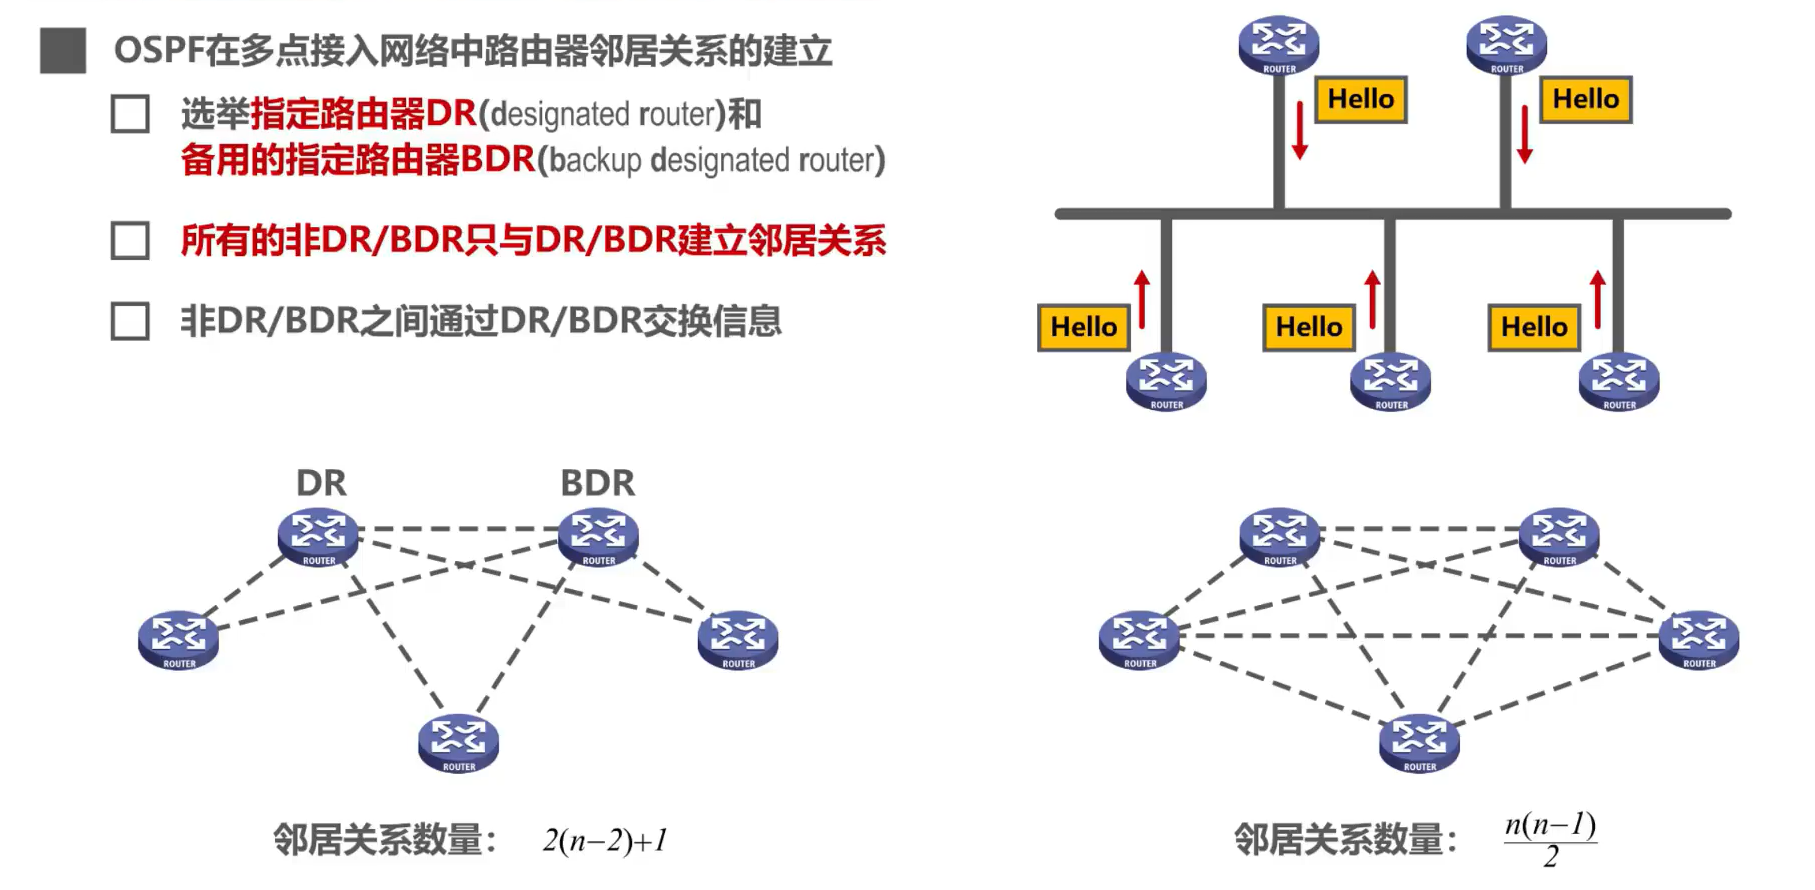
若DR出现问题,则由BDR顶替DR
为了使OSPF能够用于规模很大的网络,OSPF把一个自治系统再划分为若干个更小的范围,叫做区域(Area)
在该自治系统内,所有路由器都使用OSPF协议,OSPF将该自治系统再划分成4个更小的区域
每个区域都有一个32比特的区域标识符
主干区域的区域标识符必须为0,主干区域用于连通其他区域
其他区域的区域标识符不能为0且不相同
每个区域一般不应包含路由器超过200个
划分区域的好处就是,利用洪泛法交换链路状态信息局限于每一个区域而不是自治系统,这样减少整个网络上的通信量
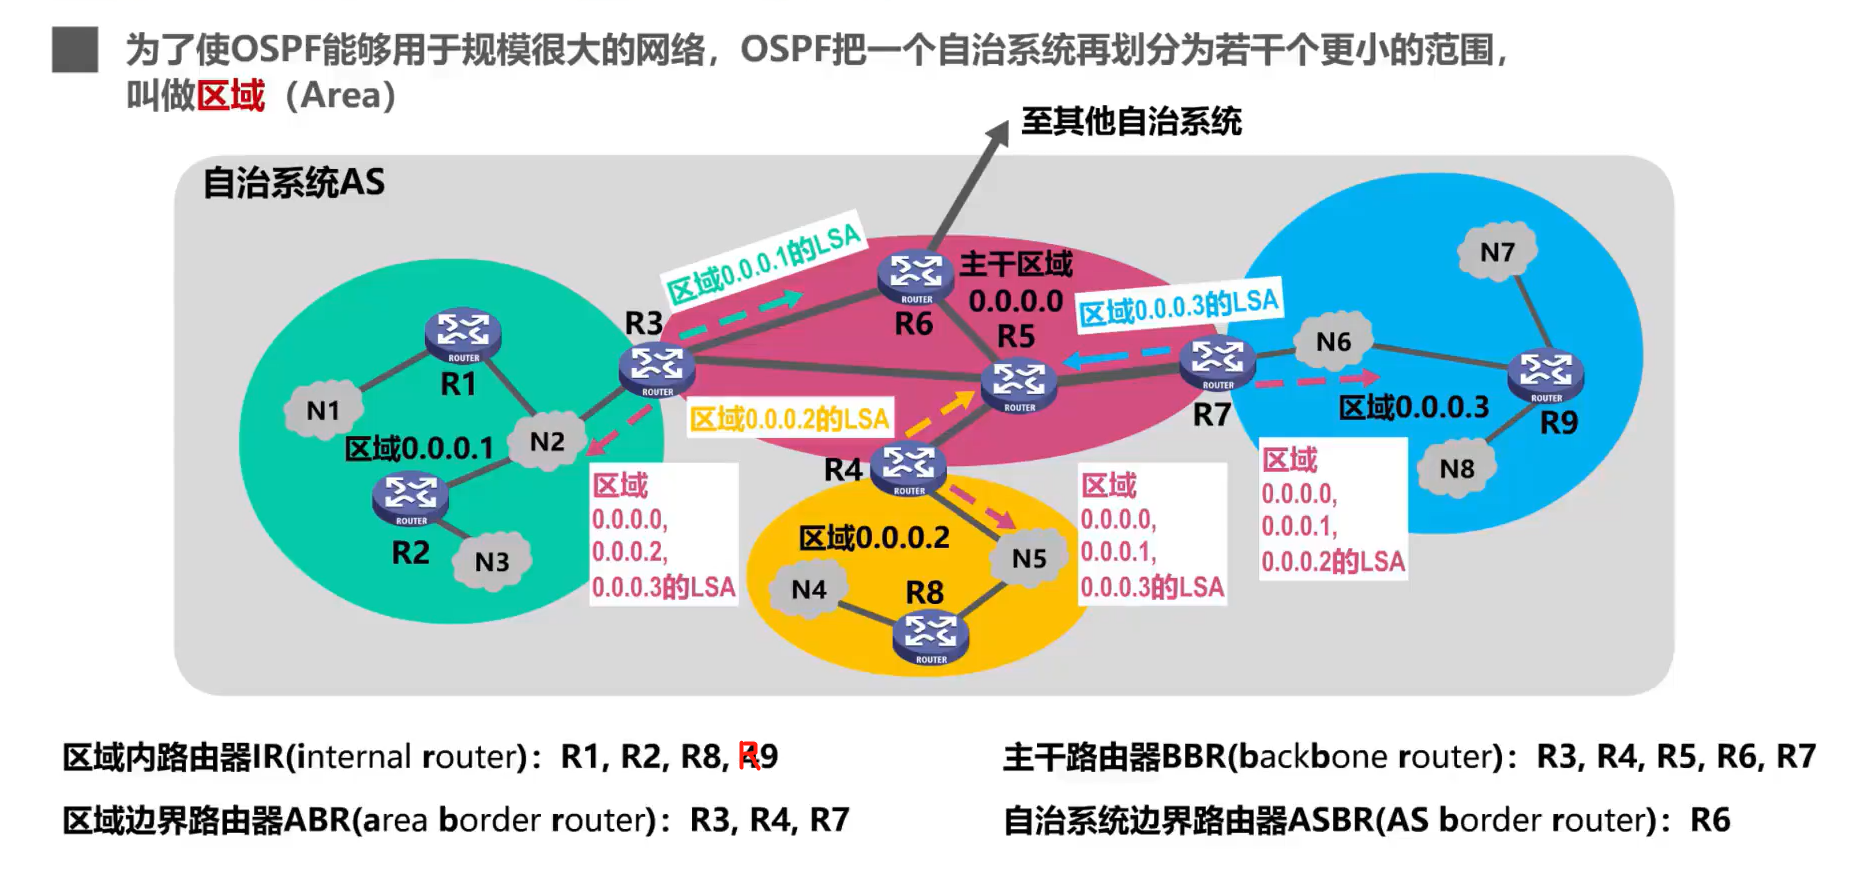
总结
边界网关协议BGP
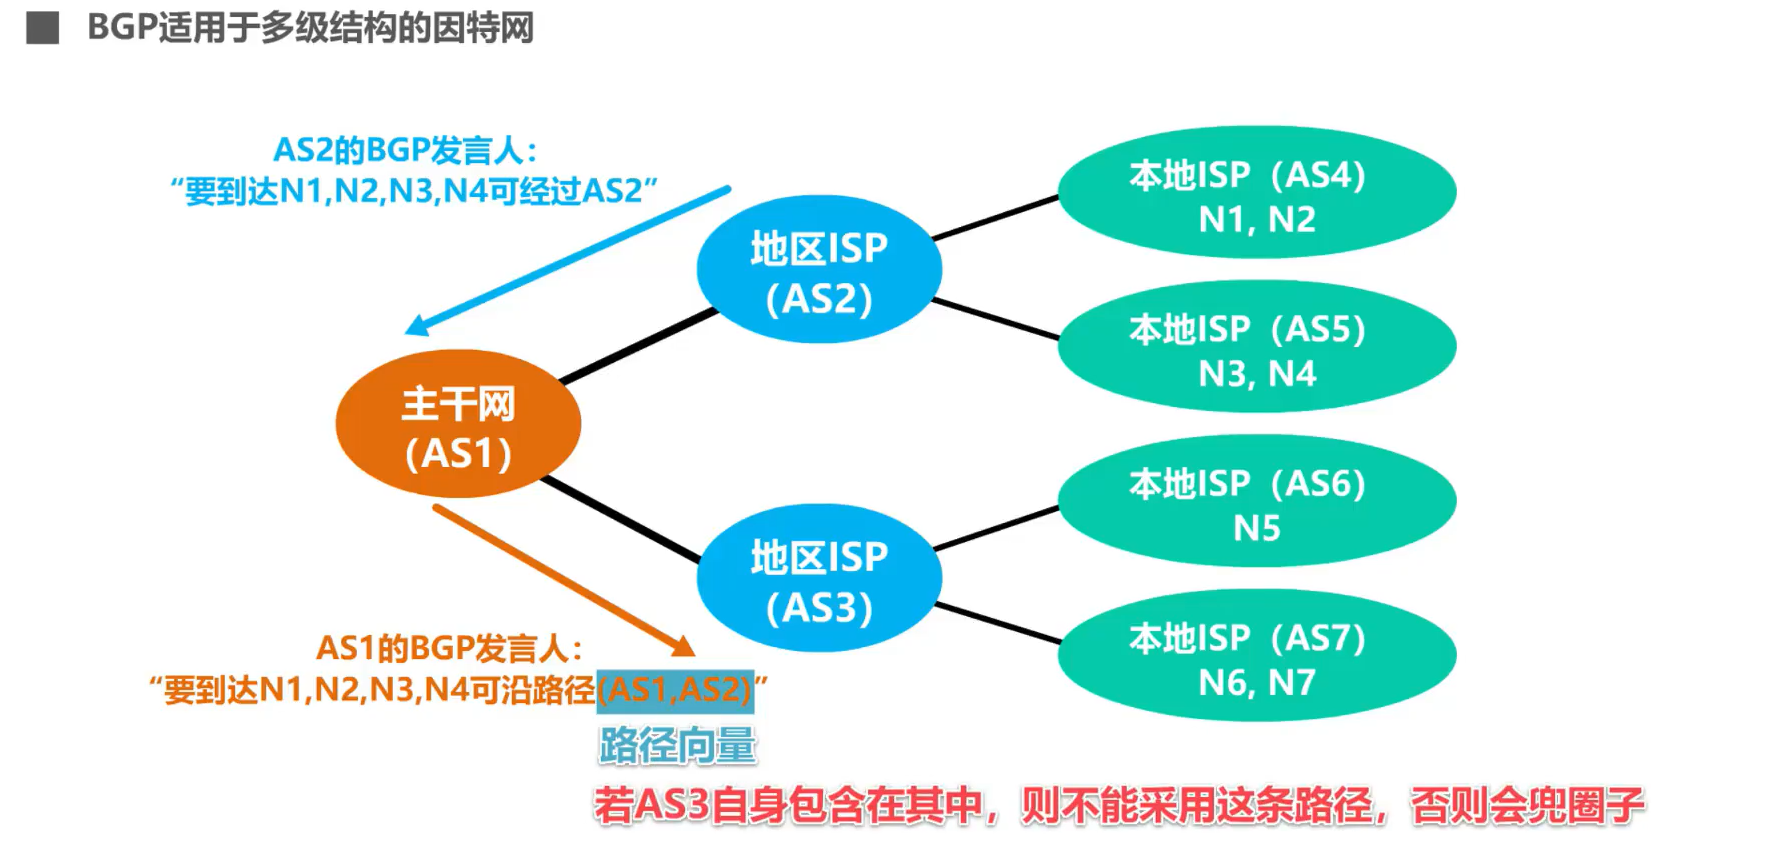
不同自治系统内,度量路由的“代价”可能不同,因此,自治系统间的路由选择不能使用“代价”来寻找最佳路由。
BGP只是尽量寻找一条能够到达目的网络且比较好的路由(不绕圈子),而并非寻找一条最佳路由。
BGP(Border Gateway Protocol) 是不同自治系统的路由器之间交换路由信息的协议。
- 每个自治系统至少要选择一个路由作为该自治系统的“BGP”发言人;
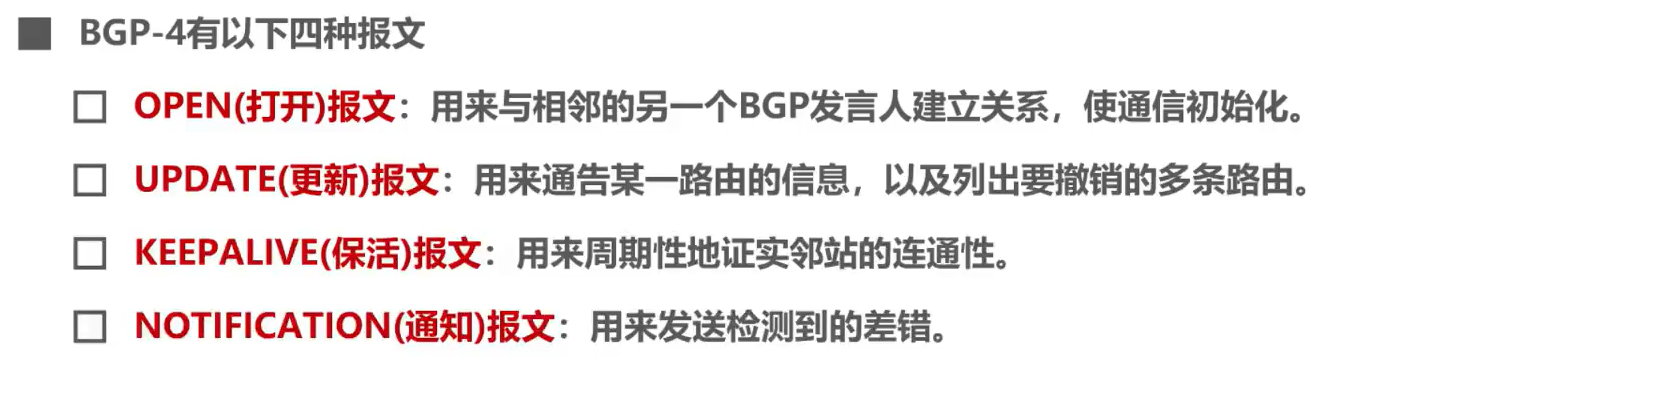
- 不同自治系统的BGP发言人要交换路由信息,首先必须建立TCP连接,端口号为179;
- 在此TCP连接上交换BGP报文以建立BGP会话;
- 利用BGP会话交换路由信息(增加新路由,撤销过时路由,报告出错等)
- 使用TCP连接交换路由信息的两个BGP发言人,称彼此为领站或对等站。
通过交换的网络可达性的信息,构建出树形结构/不存在回路的自治系统连通图。
直接封装RIP、OSPF和BGP报文的协议
IPv4数据报的首部格式
- 一个 IP 数据报由首部和数据两部分组成。
- 首部的前一部分是固定长度,共 20 字节,是所有 IP 数据报必须具有的。
- 在首部的固定部分的后面是一些可选字段,其长度是可变的。
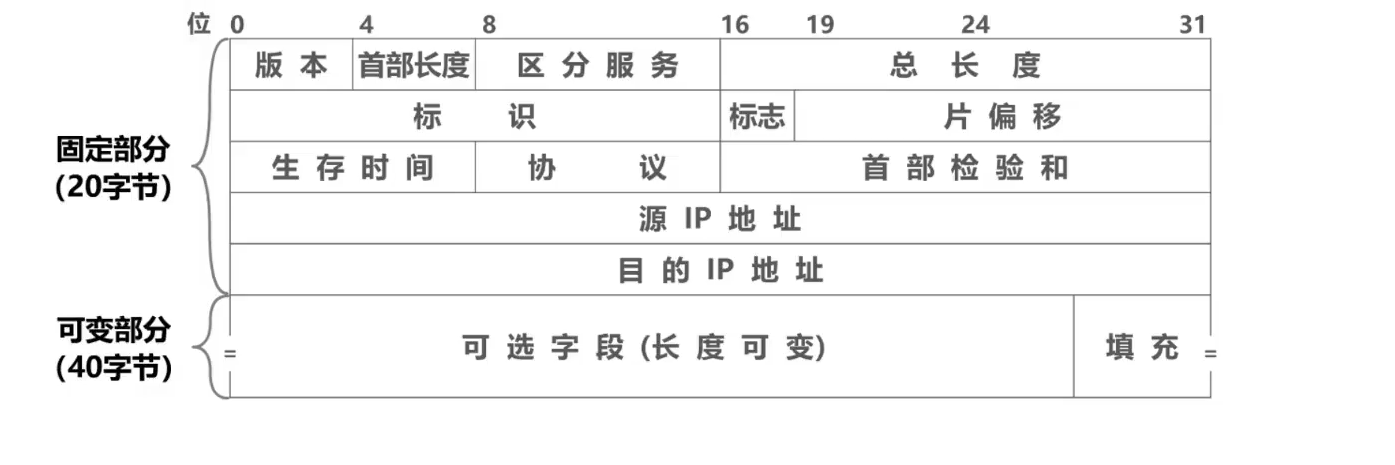
图中的每一行都由32个比特(也就是4个字节)构成,每个小格子称为字段或者域,每个字段或某些字段的组合用来表达IP协议的相关功能
版本
占4比特,表示IP协议的版本。
通信双方使用的1P协议的版本必须一致。目前广泛使用的IP协议版本号为4(即IPV4)。
首部长度
占4比特,表示P数据报首部的长度。该字段的取值以4字节为单位。
最小十进制取值为5,表示P数据报首部只有20字节固定部分;一个单位为4字节比如这4*5=20字节
最大十进制取值为15,表示P数据报首部包含20字节固定部分和最大40字节可变部分。
可选字段
长度从1个字节到40个字节不等。用来支持排错、测量及安全等措施。
可选字段增加了IP数据报的功能,但这同时也使得P数据报的首部长度成为可变的。这就增加了每一个路由器处理P数据报的开销。实际上可选字段很少被使用。
填充字段
确保首部长度为4字节的整数倍。使用全0进行填充。
IP数据报的首部长度一定是4字节的整数倍
因为首部中的可选字段的长度从1个字节到40个字节不等,那么,当20字节的固定部分加上1到40个字节长度不等的可变部分,会造成首部长度不是4字节整数倍时,就用取值为全0的填充字段填充相应个字节,以确保IP数据报的首部长度是4字节的整数倍
区分服务
占8比特,用来获得更好的服务。该字段在旧标准中叫作服务类型,但实际上一直没有被使用过。1998年,因特网工程任务组IETF把这个字段改名为区分服务。利用该字段的不同数值可提供不同等级的服务质量。只有在使用区分服务时,该字段才起作用。一般情况下都不使用该字段。
总长度
占16比特,表示IP数据报的总长度(首部+数据载荷)。最大取值为十进制的65535,单位字节。
标识、标志、片偏移 :这三个字段用于IP数据报分片 (当IPV4数据报长度超过MTU时,无法封装,需要进行分片,以太网规定MTU值为1500字节)
标识
占16比特,属于同一个数据报的各分片数据报应该具有相同的标识。
IP软件维持一个计数器,每产生一个数据报,计数器值加1, 并将此值赋给标识字段。
标志:占3比特,各比特含义如下:
- DF位:1表示不允许分片:0表示允许分片
- MF位:1表示“后面还有分片”;0表示“这是最后一个分片”
- 保留位:必须为0
片偏移
占13比特,指出分片数据报的数据载荷部分偏移其在原数据报的位置有多少个单位。
片偏移以8个字节为单位。
生存时间 TTL
占8比特,防止IP数据报在网络中永久兜圈。
最初以秒为单位,最大生存周期为255秒:路由器转发1P数据报时,将P数据报首部中的该字段的值减去IP数据报在本路由器上所耗费的时间,若不为0就转发,否则就丢弃。
现在以“跳数”为单位,路由器转发IP数据报时,将P数据报首部中的该字段的值减1,若不为0就转发,否则就丢弃。
协议
占8比特,指明引PV4数据报的数据部分是何种协议数据单元。堂用的一些协议知相应的协议字段值加下
协议名称 ICMP IGMP TCP UDP IPv6 OSPF 协议字段值 1 2 6 17 41 89 首部校验和
占16比特,用来检测首部在传输过程中是否出现差错。比CRC检验码简单,称为因特网检验和。
IP数据报每经过一个路由器,路由器都要重新计算首部检验和,因为某些字段 (生存时间、标志、片偏移等) 的取值可能发生变化。
由于引P层本身并不提供可靠传输的服务,并且计算首部校验和是一项耗时的操作,因此在IPV6中,路由器不再计算首部校验和,从而更快转发IP数据报。
源IP地址、目的IP地址
各占32比特,用来填写发送该IP数据报的源主机的IP地址 和 接收该IP数据报的目的主机的IP地址
网际控制报文协议ICMP
概念
架构IP网络时需要特别注意两点:
- 确认网络是否正常工作
- 遇到异常时进行问题诊断
而ICMP就是实现这些问题的协议
ICMP的主要功能包括:
- 确认IP包是否成功送达目标地址
- 通知在发送过程当中IP包被废弃的具体原因
- 改善网络设置等
有了这些功能以后,就可以获得网络是否正常,设置是否有误以及设备有何异常等信息,从而便于进行网络上的问题诊断
ICMP报文:
询问报文
回送请求和回答
ICMP回送请求报文是由主机或路由器向一个特定的目的主机发出的询问。
收到此报文的主机必须给源主机或路由器发送 ICMP回送回答报文。
这种询问报文用来测试目的站是否可达及了解其有关状态。
时间戳请求和回答
ICMP时间戳请求报文是请某个主机或路由器回答当前的日期和时间。
在ICMP时间戳回答报文中有一个32位的字段,其中写入的整数代表从1900年1月1日起到当前时刻一共有多少秒。
这种询问报文用来进行时钟同步和测量时间。
差错报告报文
终点不可达
当路由器或主机不能交付数据报时,就向源点发送终点不可达报文。具体可再根据引CMP的代码字段细分为目的网络不可达、目的主机不可达、目的协议不可达、目的端口不可达、目的网络未知、目的主机未知等13种错误。
源点抑制
当路由器或主机由于拥塞而丢弃数据报时,就向源点发送源点抑制报文,使源点知道应当把数据报的发送速率放慢。
时间超过
当路由器收到一个目的IP地址不是自己的IP数据报,会将其生存时间TTL字段的值减1。
- 若结果不为0,则将该P数据报转发出去;
- 若结果为0,除丢弃该P数据报外,还要向源点发送时间超过报文。
另外,当终点在预先规定的时间内不能收到一个数据报的全部数据报片时,就把已收到的数据报片都丢弃,也会向源点发送时间超过报文。
参数问题
当路由器或目的主机收到P数据报后,根据其首部中的检验和字段发现首部在传输过程中出现了误码,就丢弃该数据报,并向源点发送参数问题报文。
改变路由(重定向)
路由器把改变路由报文发送给主机,让主机知道下次应将数据报发送给另外的路由器(可通过更好的路由)。
不应该发送差错报告报文的情况:
- 对ICMP差错报告报文不再发送ICMP差错报告报文
- 对第一个分片的数据报片的所有后续数据报片都不发送ICMP差错报告报文
- 对具有多播地址的数据报都不发送ICMP差错报告报文
- 对具有特殊地址(如127.0.0.0或0.0.0.0)的数据报不发送1CMP差错报告报文
ICMP 不是高层协议(看起来好像是高层协议,因为 ICMP 报文是装在 IP 数据报中,作为其中的数据部分),而是 IP 层的协议。
ICMP 报文的格式:
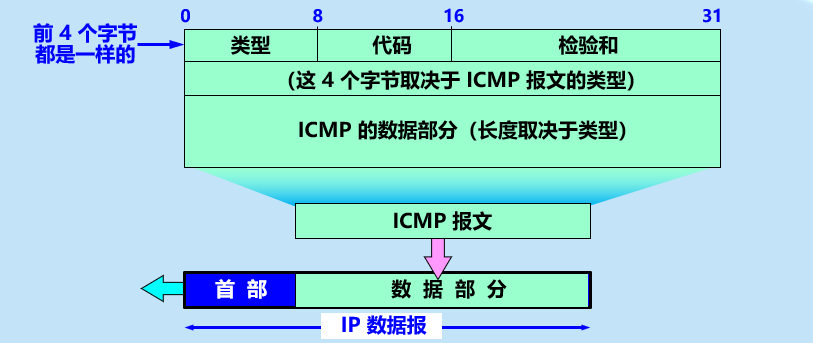
ICMP应用举例
分组网间探测PING(Packet InterNet Groper)
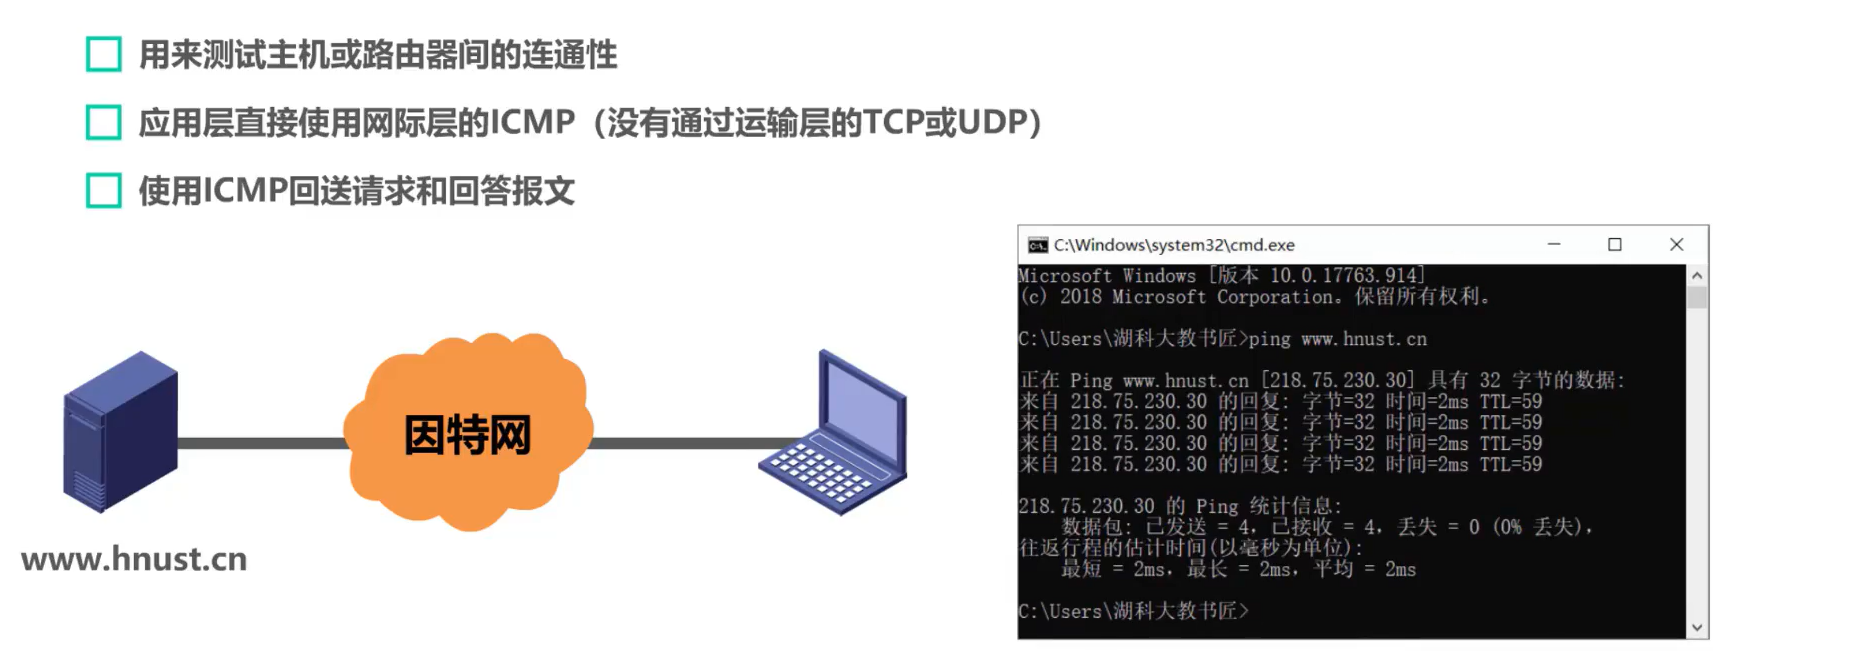
跟踪路由(traceroute)
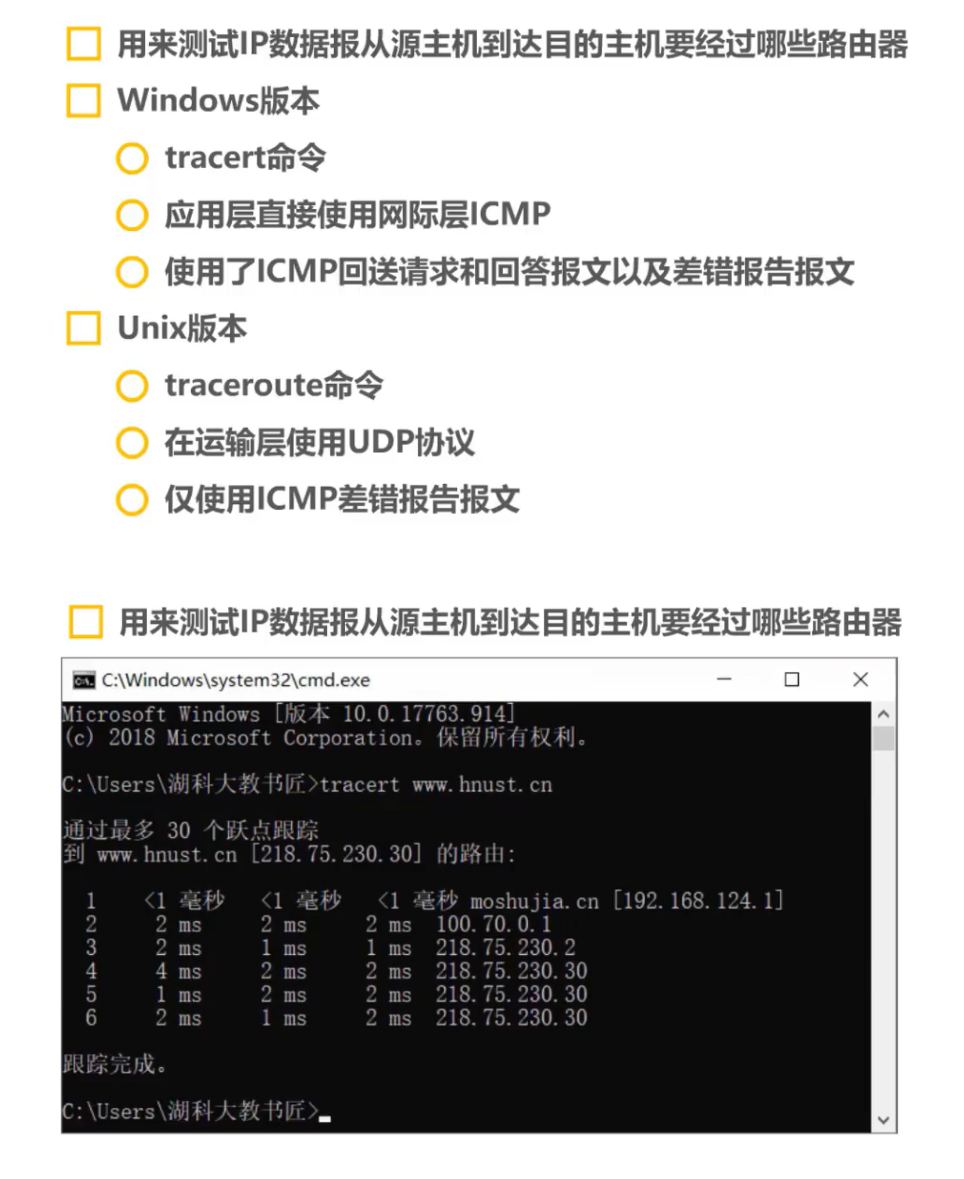
tracert命令的实现原理
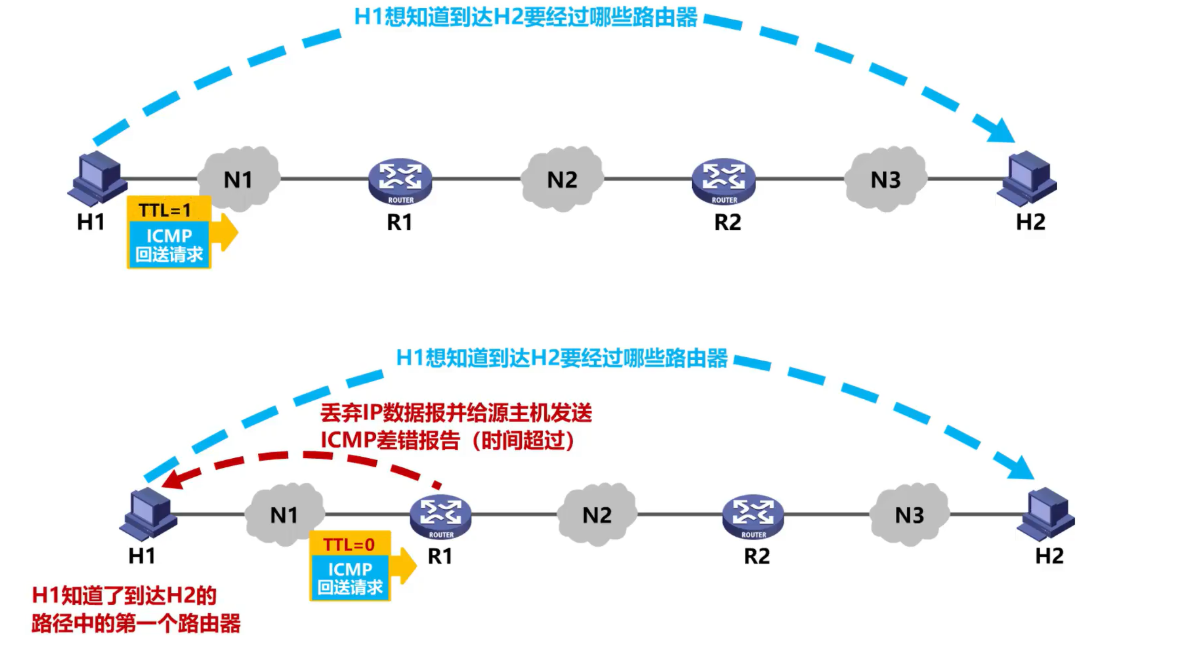
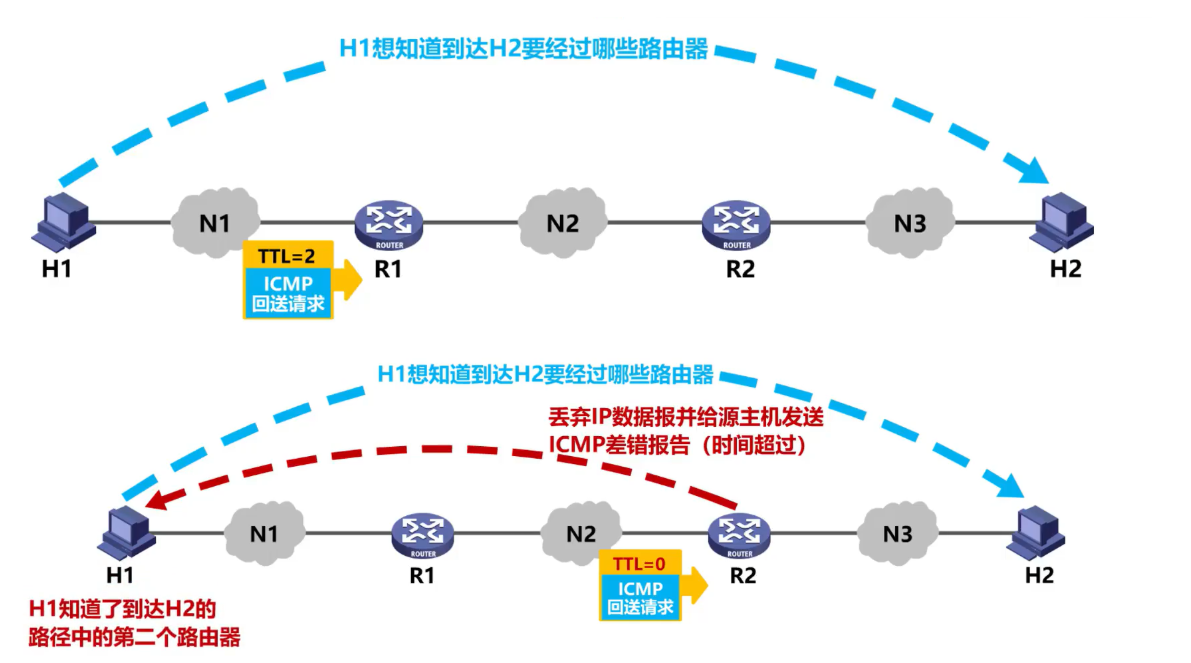
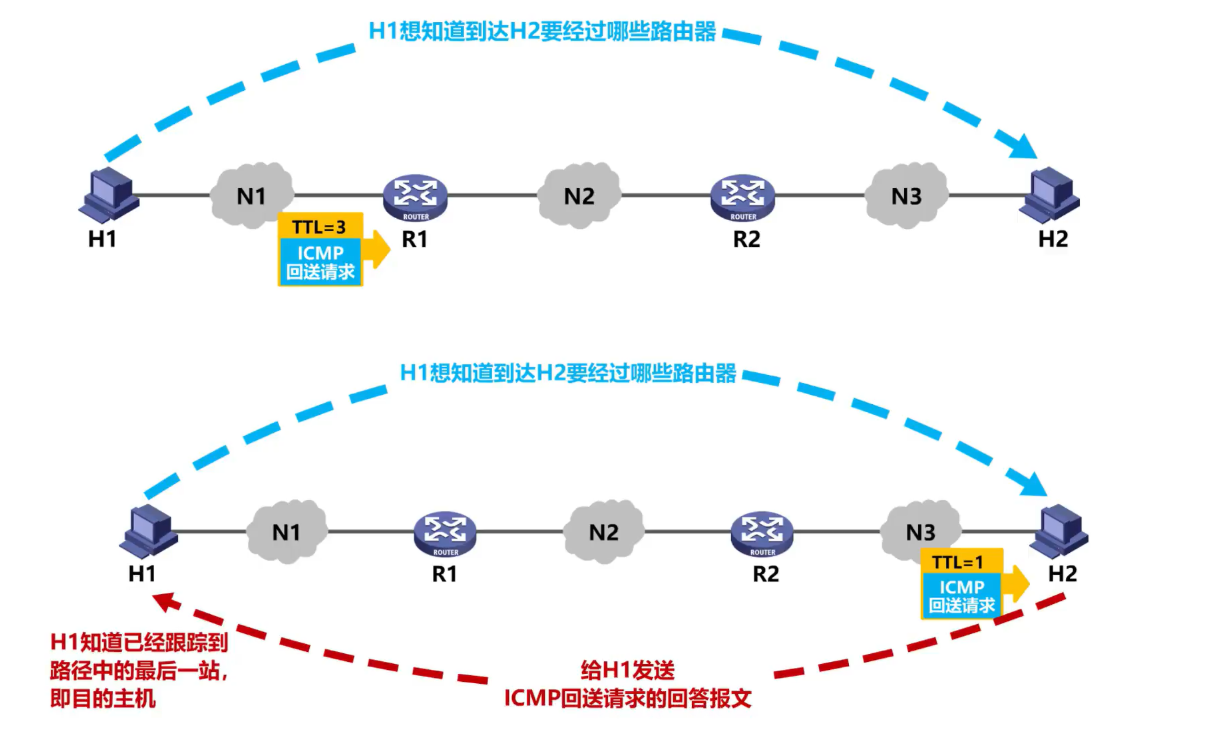
虚拟专用网VPN
(Virtual Private Network)
- 由于 IP 地址的紧缺,一个机构能够申请到的IP地址数往往远小于本机构所拥有的主机数。
- 考虑到互联网并不很安全,一个机构内也并不需要把所有的主机接入到外部的互联网。
- 假定在一个机构内部的计算机通信也是采用 TCP/IP 协议,那么从原则上讲,对于这些仅在机构内部使用的计算机就可以由本机构自行分配其 IP 地址。
VPN:
- 同一机构内不同部门的内部网络所构成的虚拟专用网VPN,又称为内联网VPN;
- 有时一个机构的VPN需要有某些外部机构(通常就是合作伙伴)参加进来,这样的VPN就称为外联网VPN。
- 在外地工作的员工需要访问公司内部的专用网络时,只要在任何地点接入到因特网,运行驻留在员工PC中的VPN软件,在员工的PC和公司的主机之间建立VPN隧道,即可访问专用网络中的资源。这种VPN称为远程接入VPN。
无需申请,可自由分配的专用地址,或称私有地址:
- 10.0.0.0~10.255.255.255(10/8地址块)
- 172.16.0.0-172.31.255.255(172.16/12地址块)
- 192.168.0.0-192.168.255.255(192.168/16地址块)
私有地址
只能用于一个机构的内部通信,而不能用于和因特网上的主机通信
只能用作本地地址而不能用作全球地址
因特网中所有路由器对目的地址是私有地址的IP数据报一律不进行转发
本地地址与全球地址
- 本地地址——仅在机构内部使用的 IP 地址,可以由本机构自行分配,而不需要向互联网的管理机构申请。
- 全球地址——全球唯一的 IP 地址,必须向互联网的管理机构申请。
- 问题:在内部使用的本地地址就有可能和互联网中某个 IP 地址重合,这样就会出现地址的二义性问题。
所以部门A和部门B至少需要一个 路由器具有合法的全球IP地址,这样各自的专用网才能利用公用的因特网进行通信
部门A向部门B发送数据流程:本地地址的主机先封装好内部IP数据报,交给路由,封装成正常的IP数据报,转发出去。
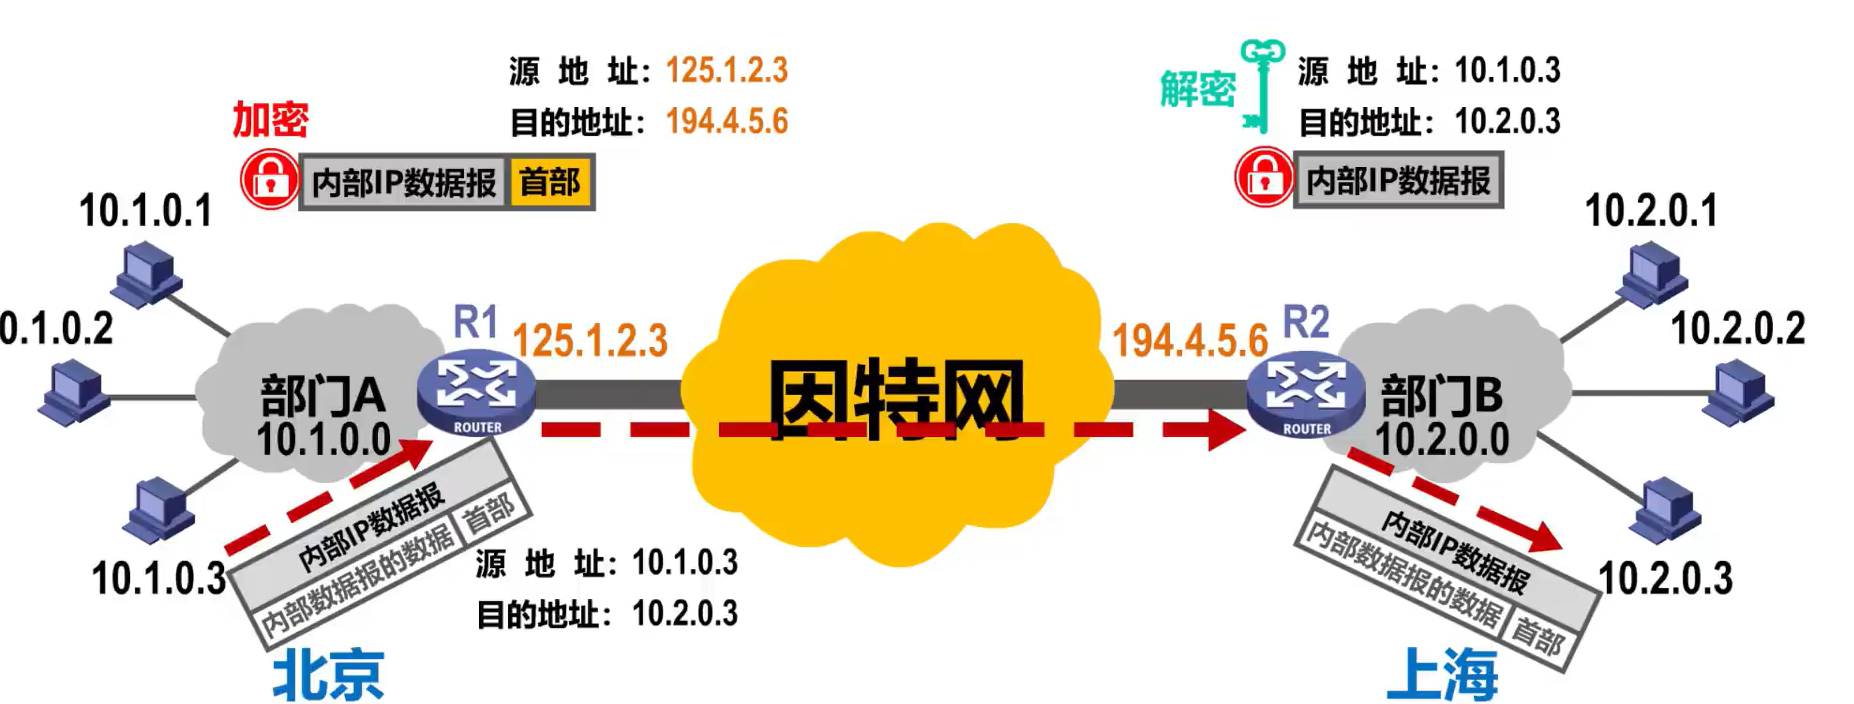
两个专用网内的主机间发送的数据报是通过了公用的因特网,但在效果上就好像是在本机构的专用网上传送一样
数据报在因特网中可能要经过多个网络和路由器,但从逻辑上看,R1和R2之间好像是一条直通的点对点链路
因此也被称为IP隧道技术
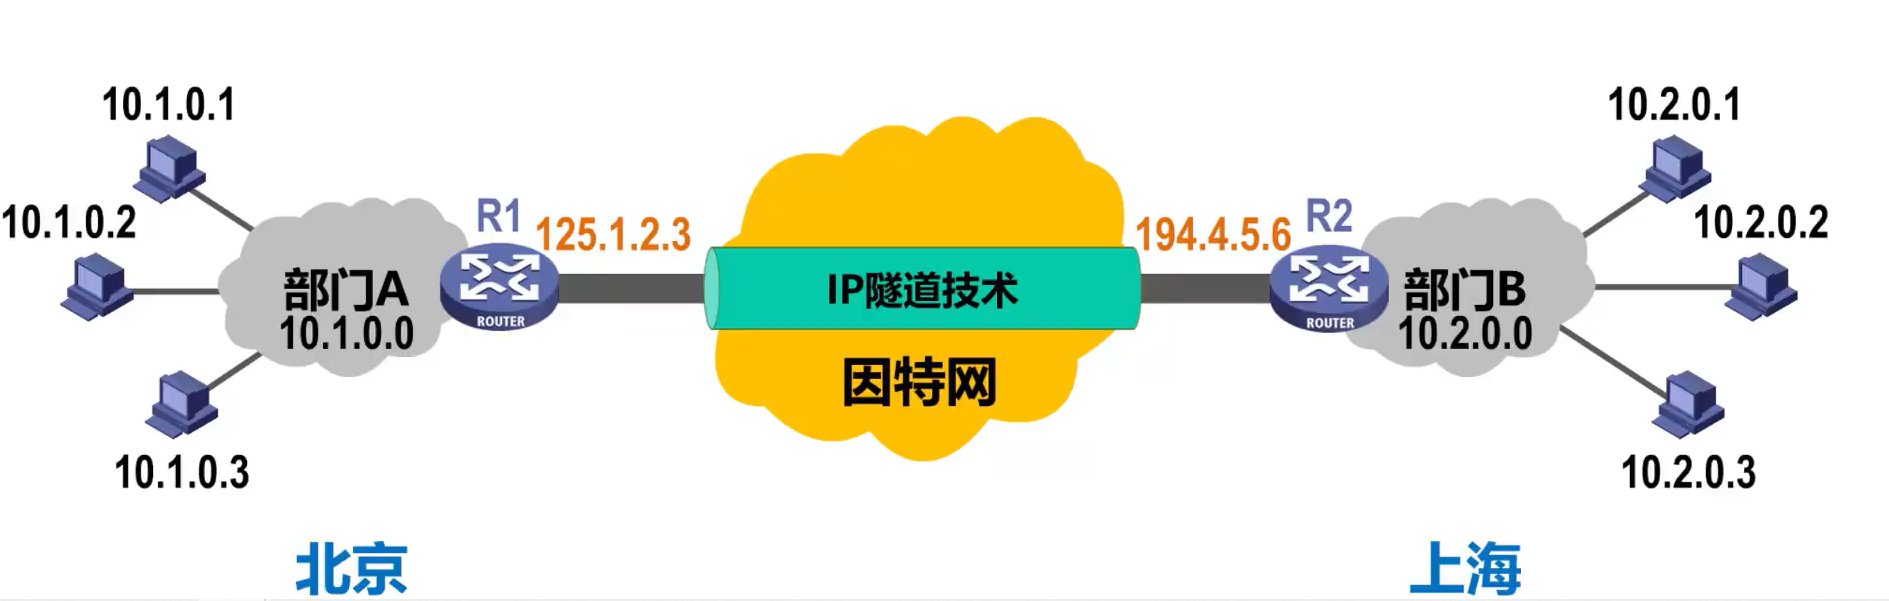
网络地址转换NAT
(Network Address Translation)
1994年,又提出了一种网络地址转换NAT的方法,再次缓解IPv4地址空间即将耗尽的问题。
NAT能让大量 使用内部专用地址的专用网络用户 共享 少量外部全球地址 来访问因特网上的主机和资源。
NAT路由
使用私有地址的主机,如何才能与因特网上使用全球IP地址的主机进行通信?
这需要在专用网络连接到因特网的 路由器 上安装NAT软件
- 装有NAT软件的路由器叫做NAT路由器,它至少有一个有效的外部全球IP地址
这样,所有使用私有地址的主机在和外界通信时,都要在NAT路由器上将其私有地址转换为全球IP地址
NAT路由器工作流程:
- 收到本地主机的数据报,修改其IP数据报的源地址为本路由拥有的全球IP地址,
- 在NAT转换表 记录下 本地IP和全球IP的对应关系(内网地址—外网地址),
- 转发IP数据报
这种基本转换存在一个问题:如果NAT路由器有N个全球IP地址,那么最多只能有N个内网主机能同时向外通信。
解决方法:
由于大多数网络应用都使用TCP/UDP来传送数据,因此可以将传输层的端口号和IP地址 一起进行转换。这种叫网络地址与端口转换NAPT(Netword Address and Port Translation)
我们现在用的很多家用路由器都是这种NAPT路由器
内网主机与外网主机的通信,是否能由外网主机首先发起?
不能!对于一些P2P网络应用,需要外网主机主动与内网主机进行通信,通过NAT时会遇到问题,需要网络应用自己使用一些特殊的NAT穿越技术来解决问题。另外,NAT对外屏蔽了内网主机的网络地址,能提供一定的安全保护。
习题
IPv4习题
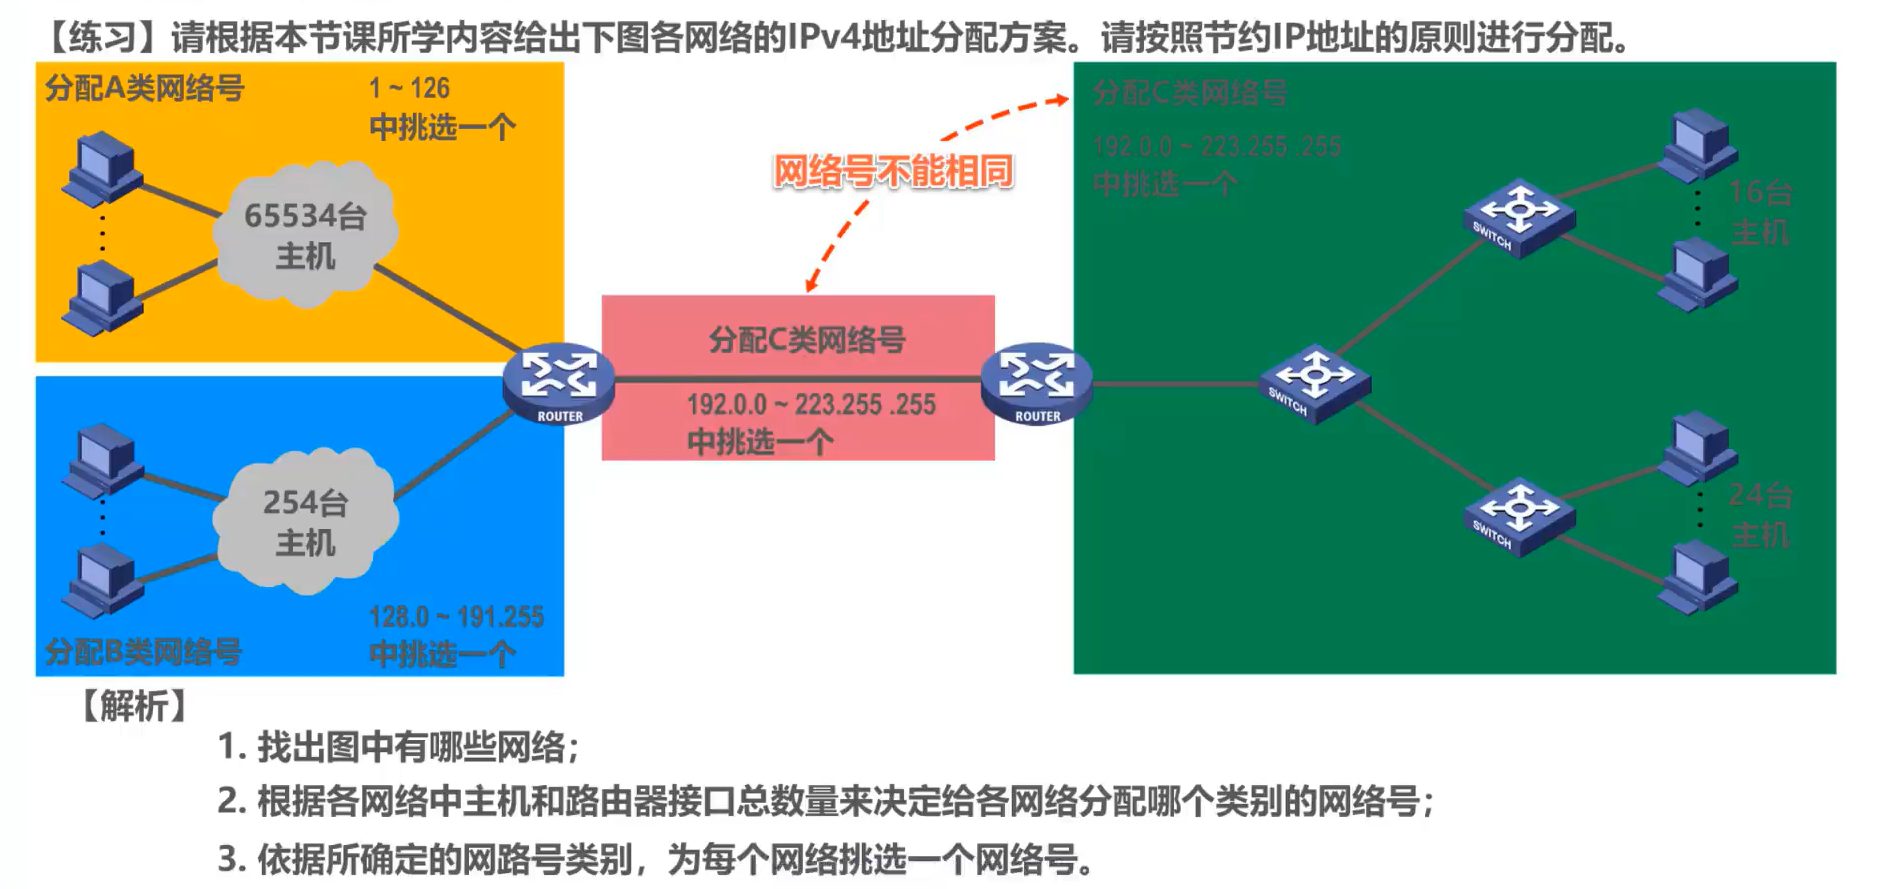
题目的注意点
本题按照节约原则
路由器的接口也要分配一个IP地址
所以橙色网络的IP地址数量是 65534 + 1 = 65535,同理 蓝色网络的是 255 个,绿色网络(交换式以太网)的是 16 + 24 + 1 = 41 个,红色网络(两台路由器通过一段链路直连,它们的直连接口也属于一个网络)是 2 个
分配IP地址不能相同
不能出现两个一样的网络号
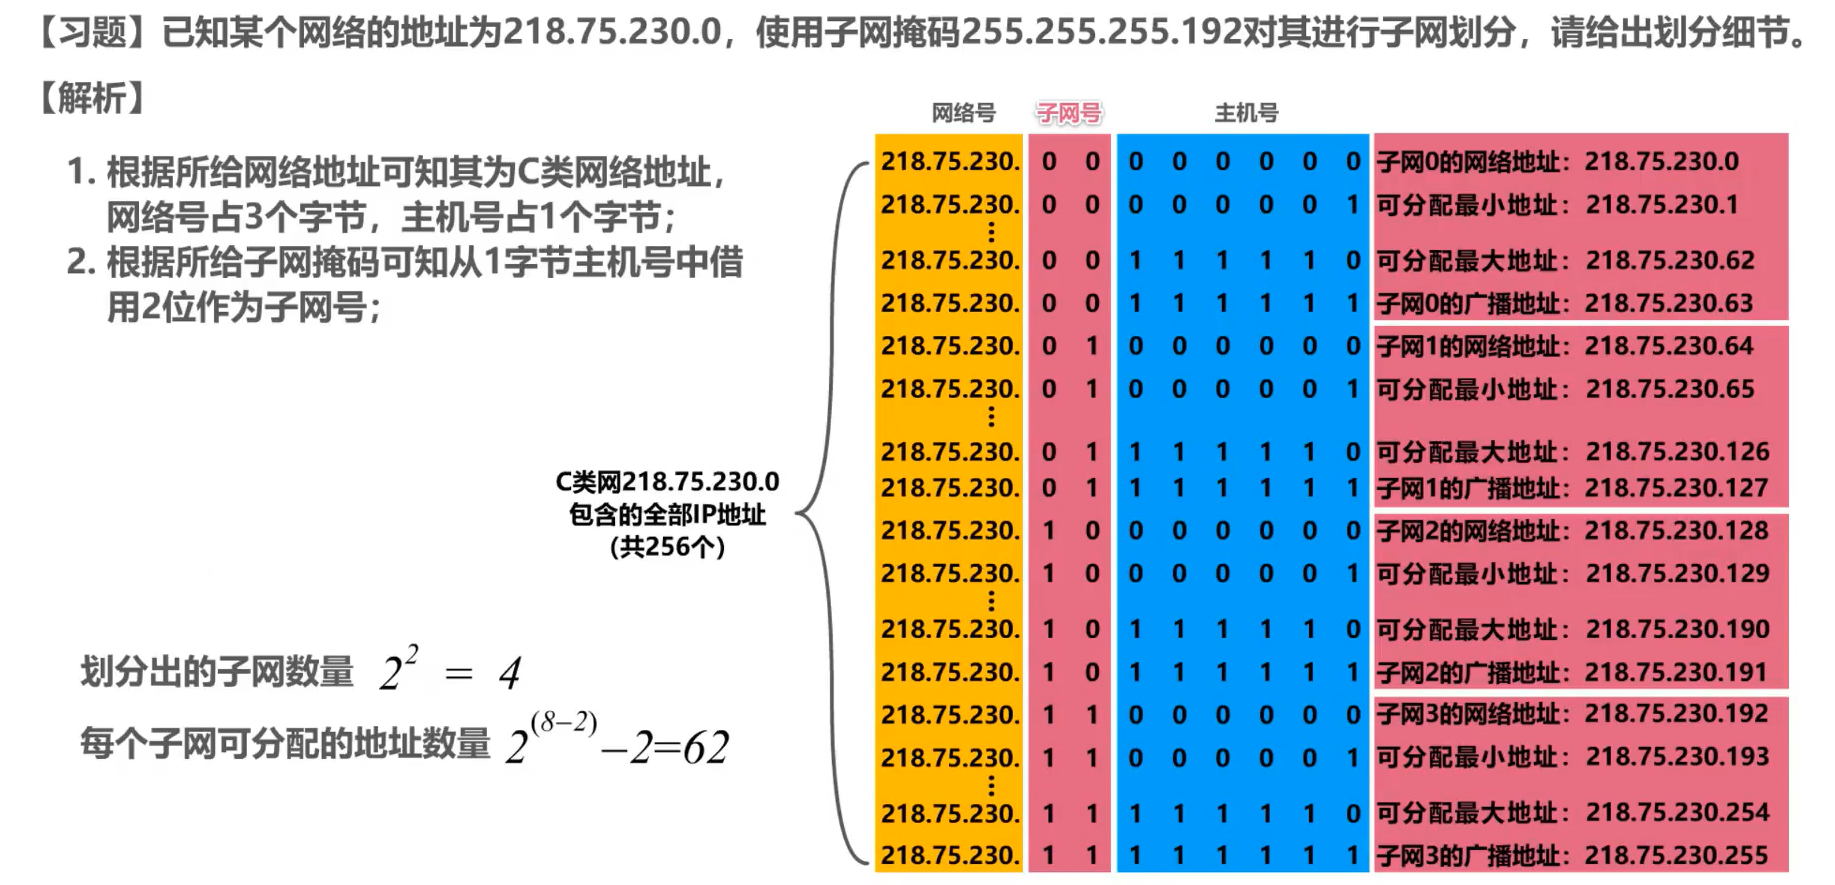
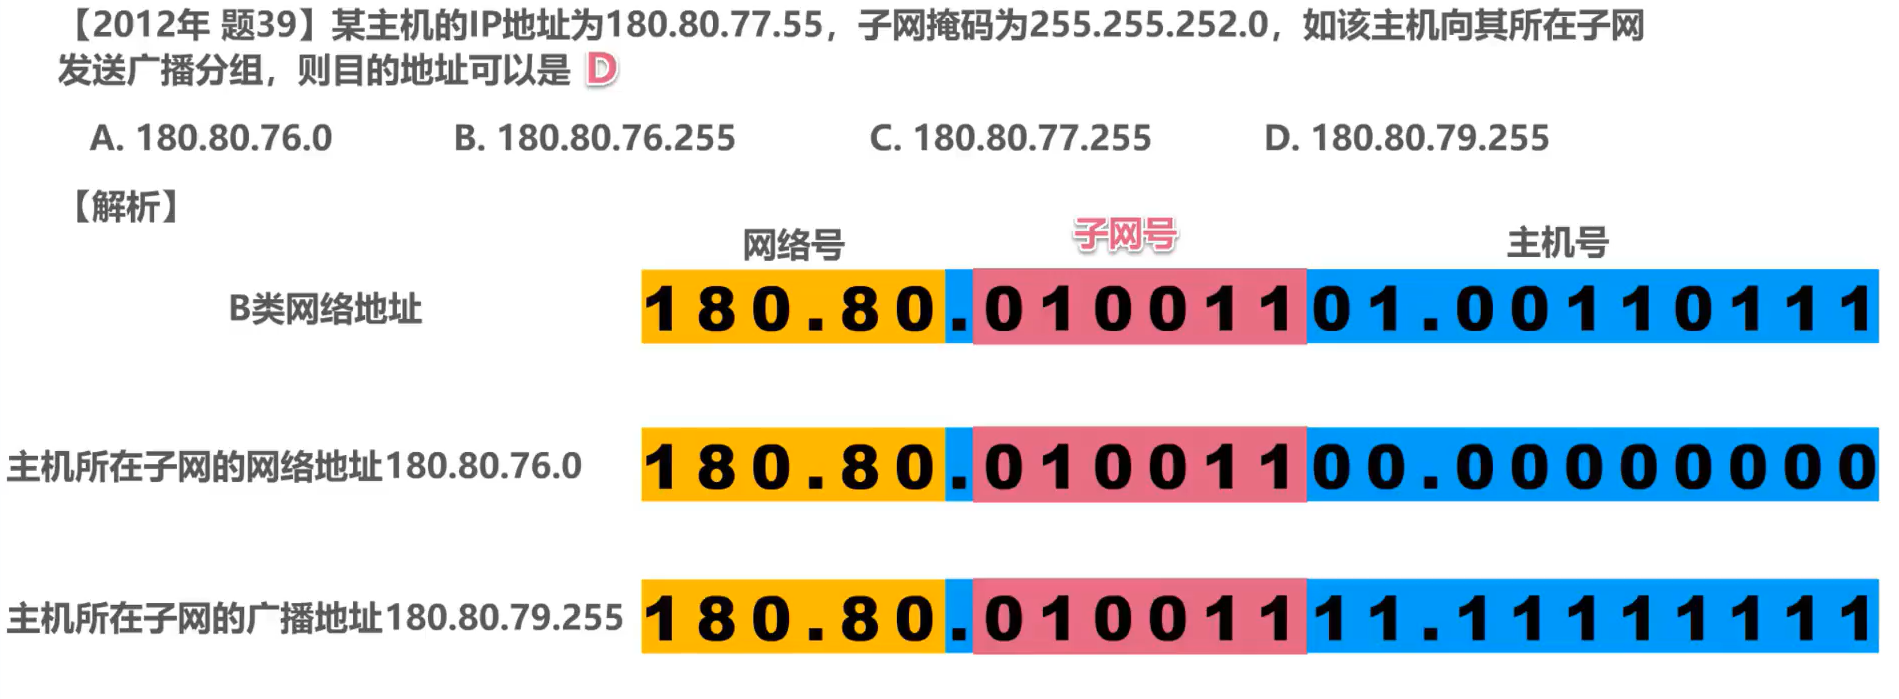
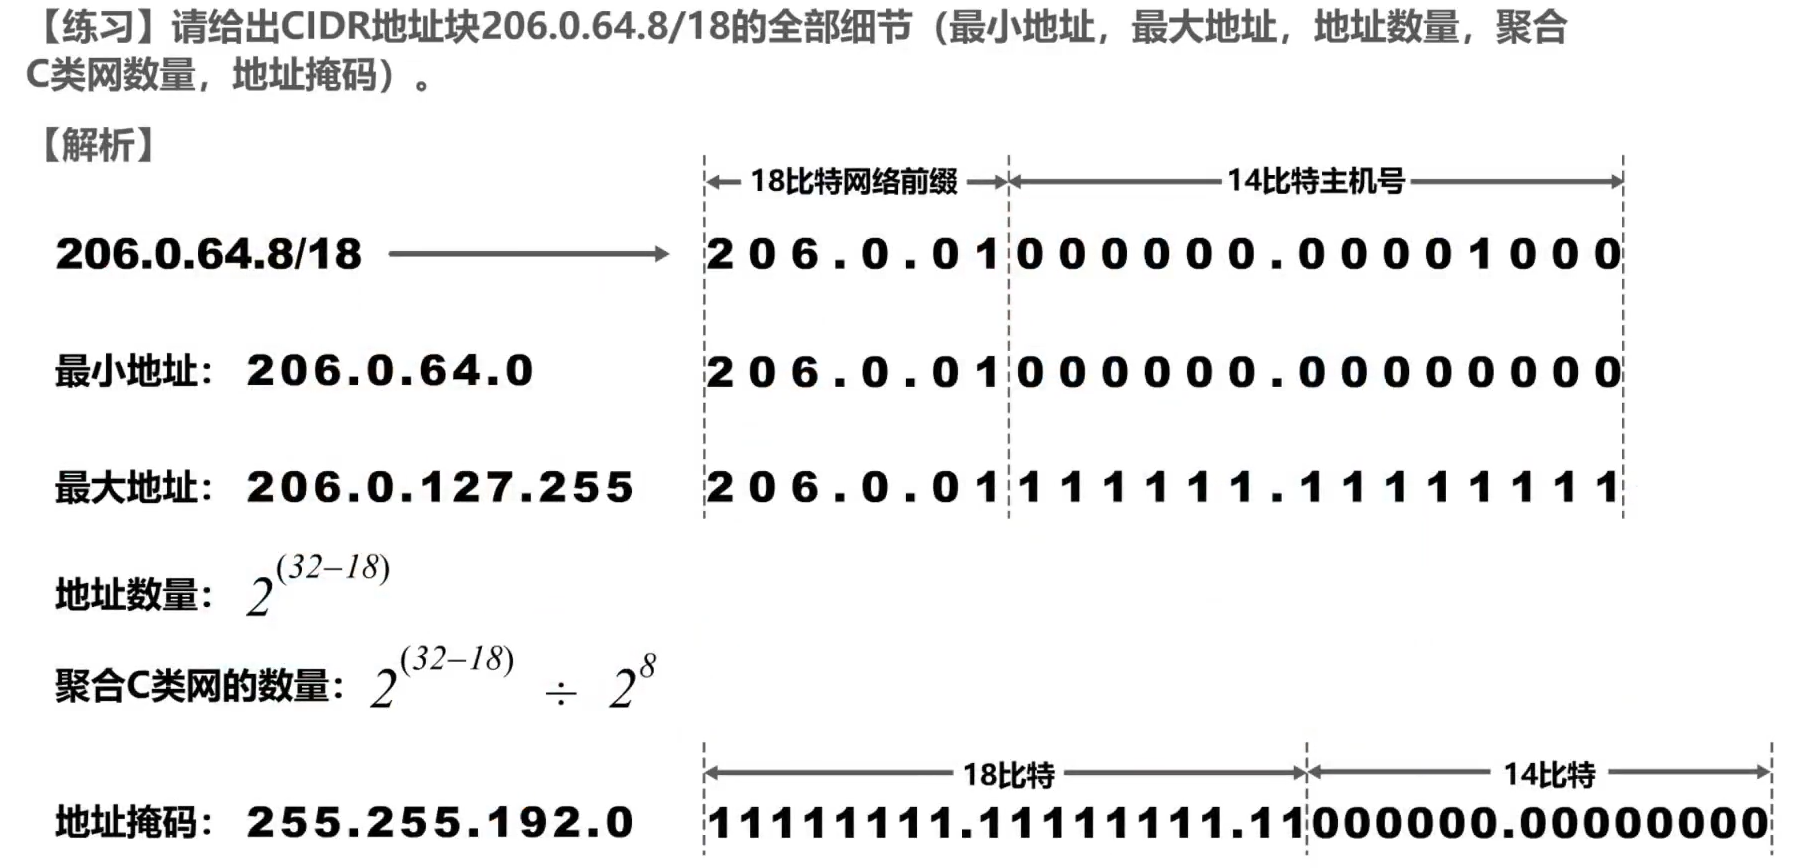
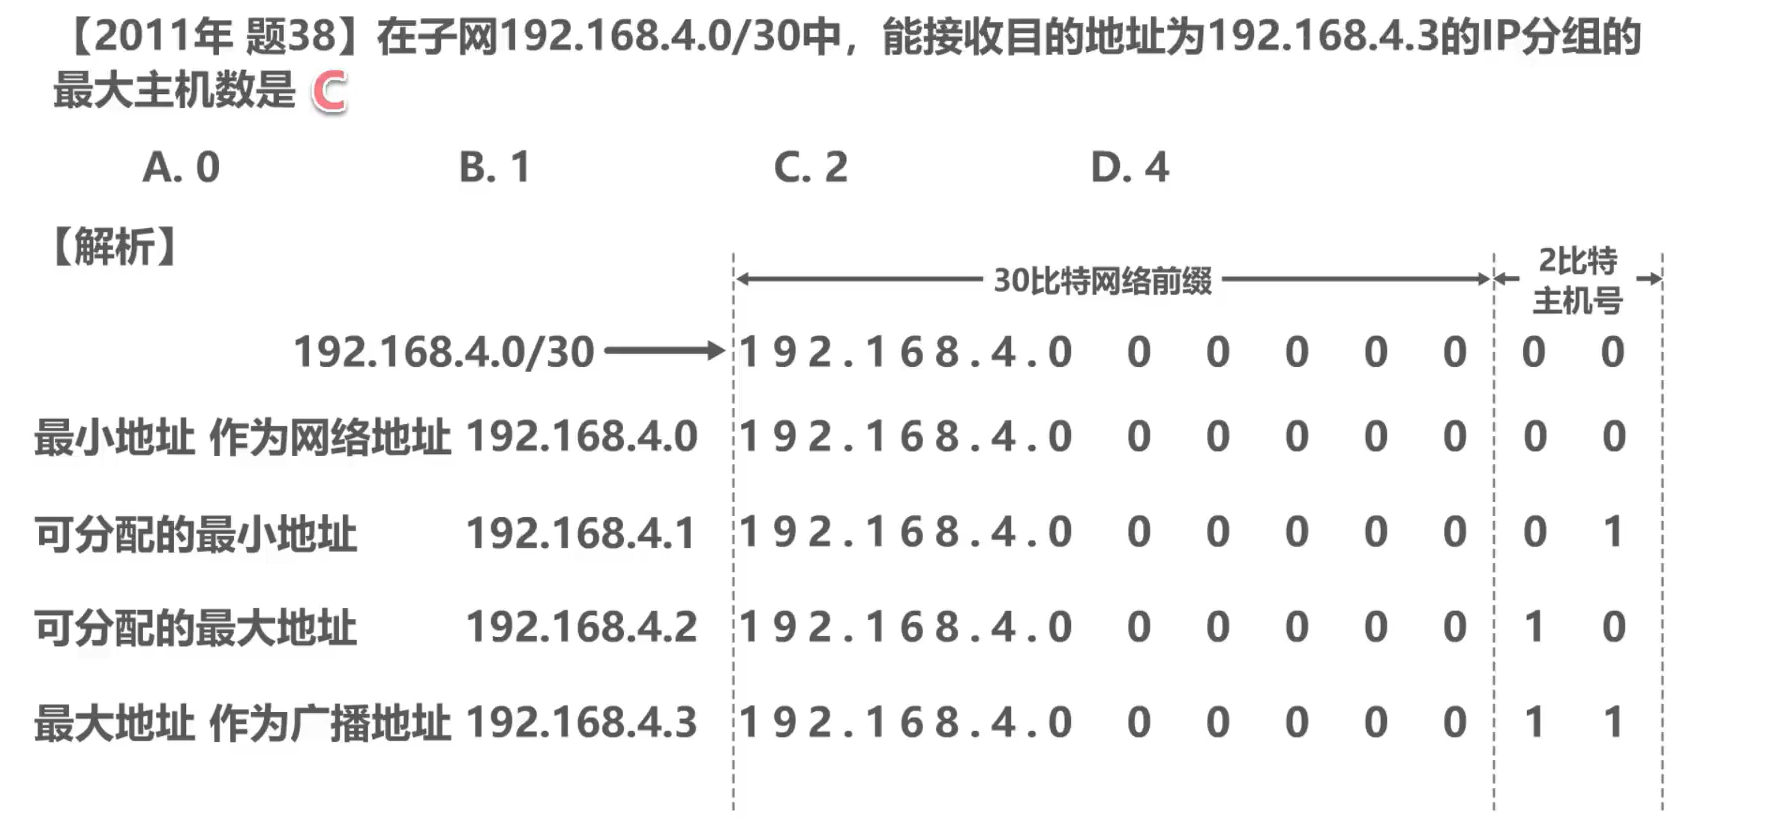
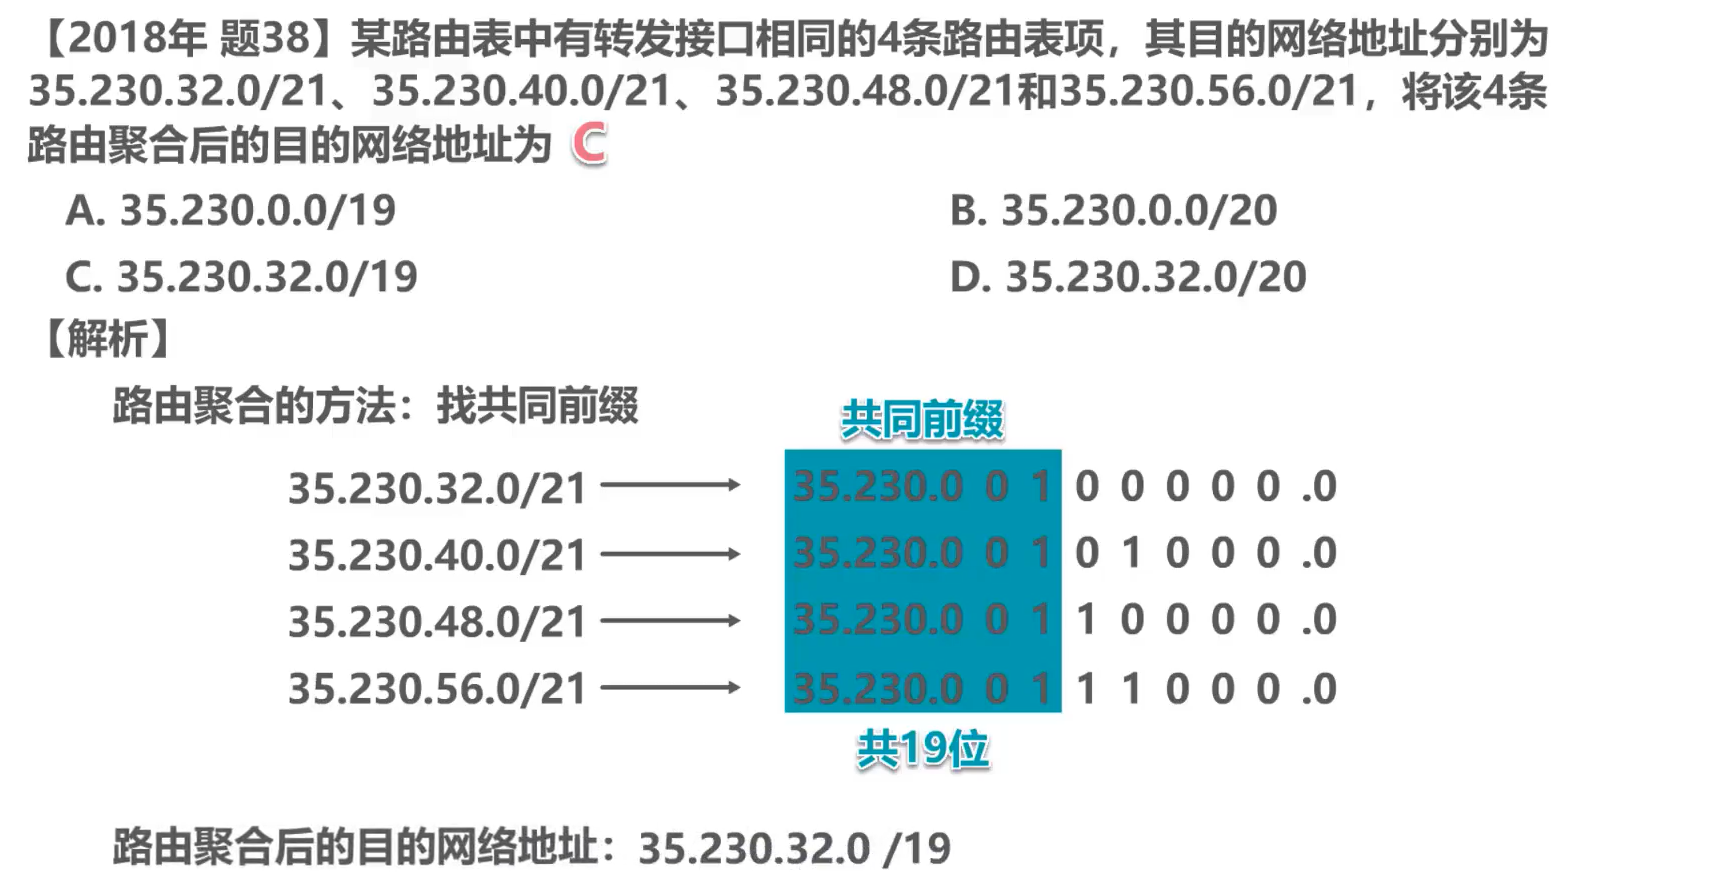
IP数据报的发送和转发过程
路由选择协议
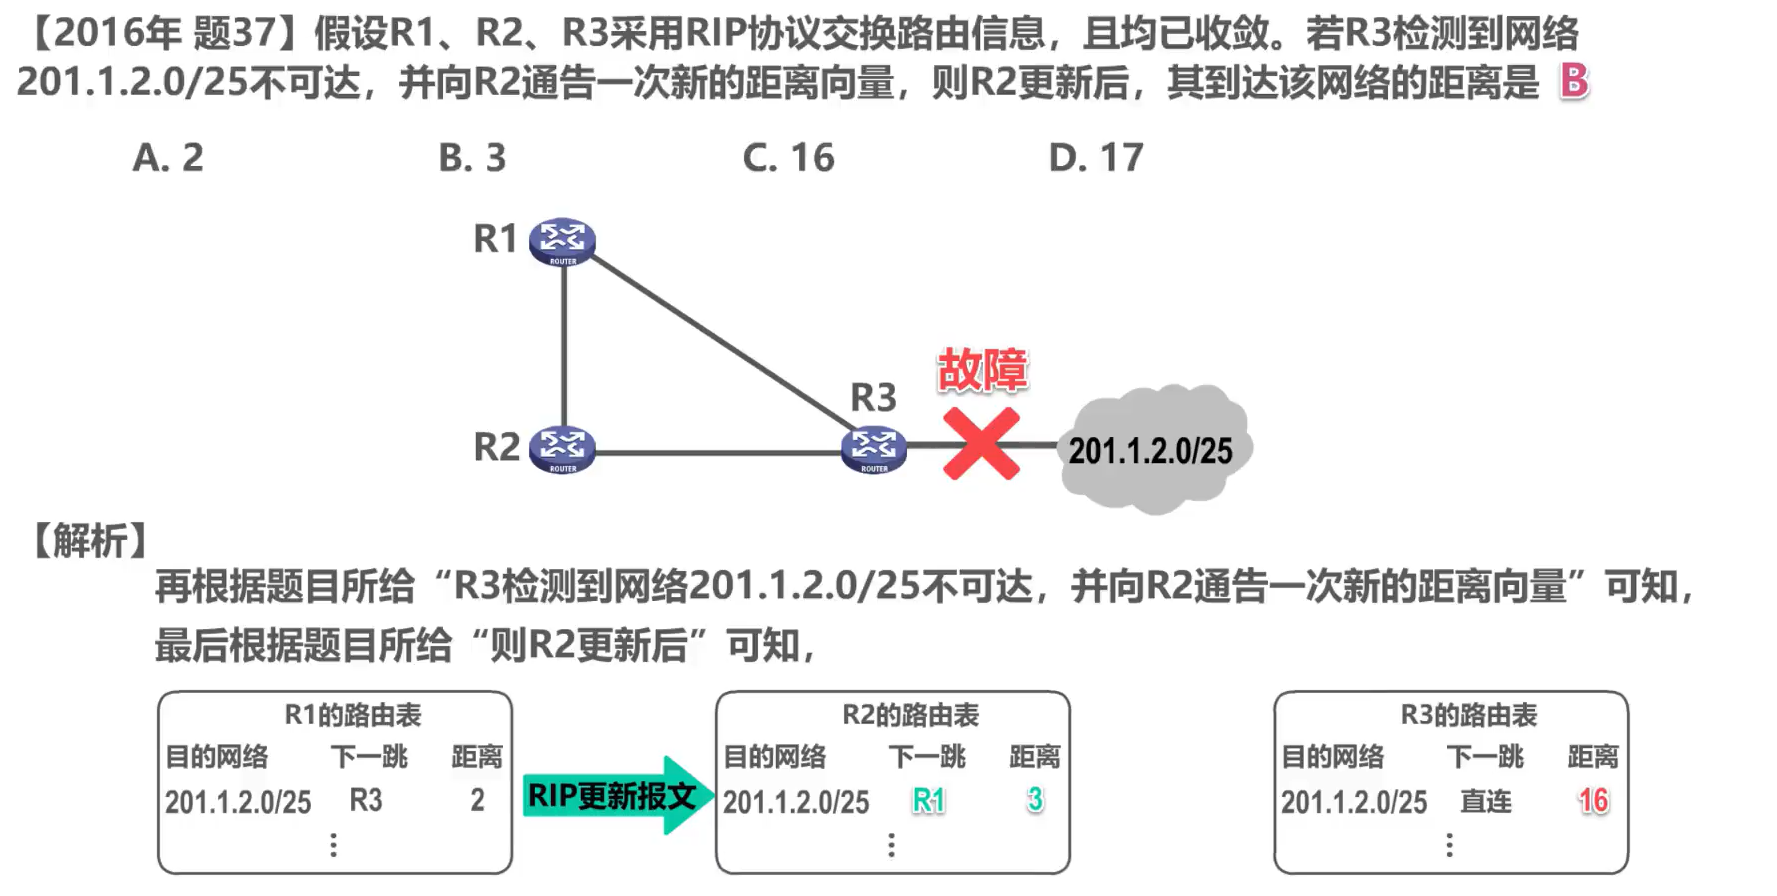
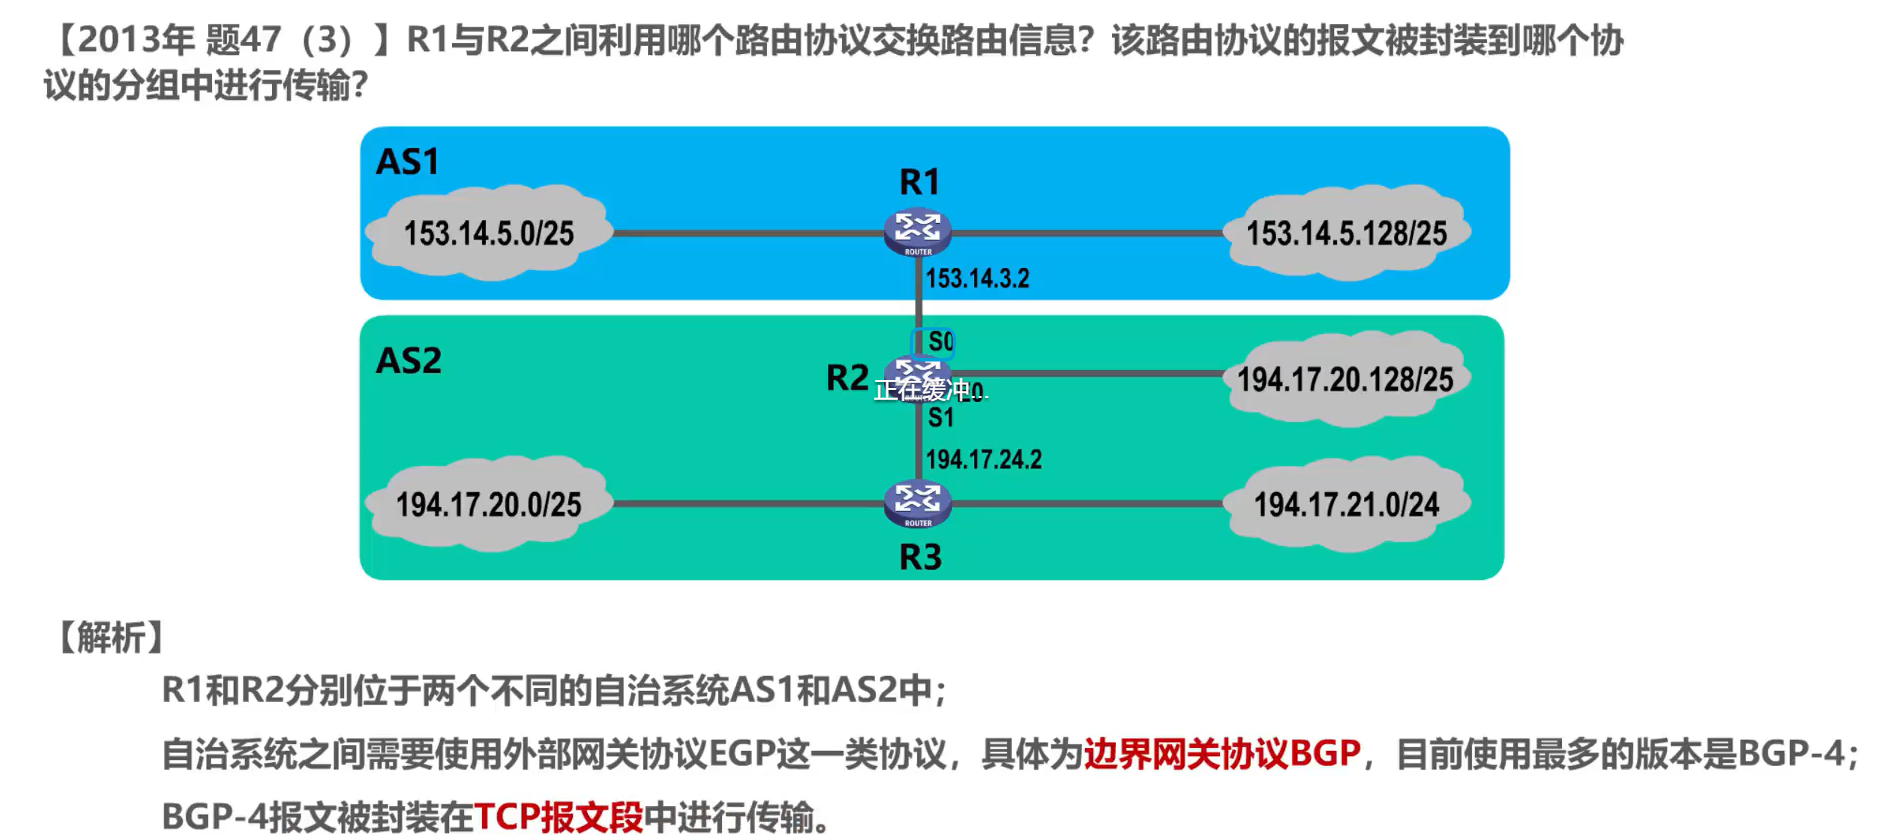
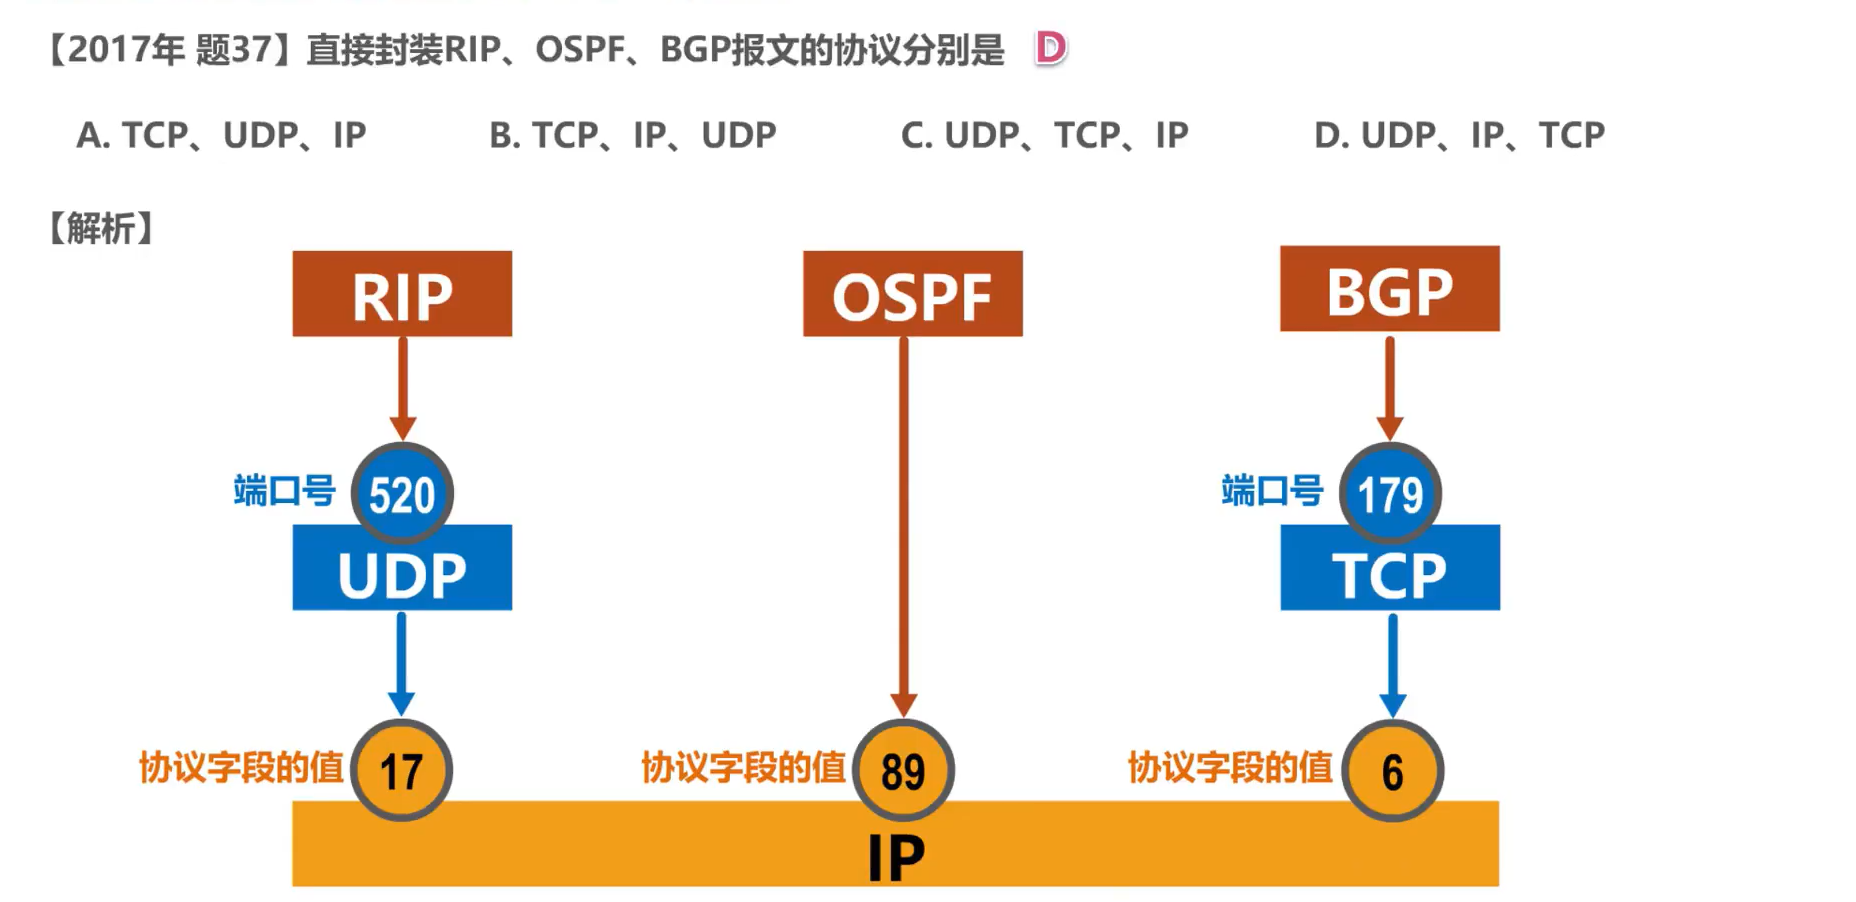
IPv4数据报的首部格式
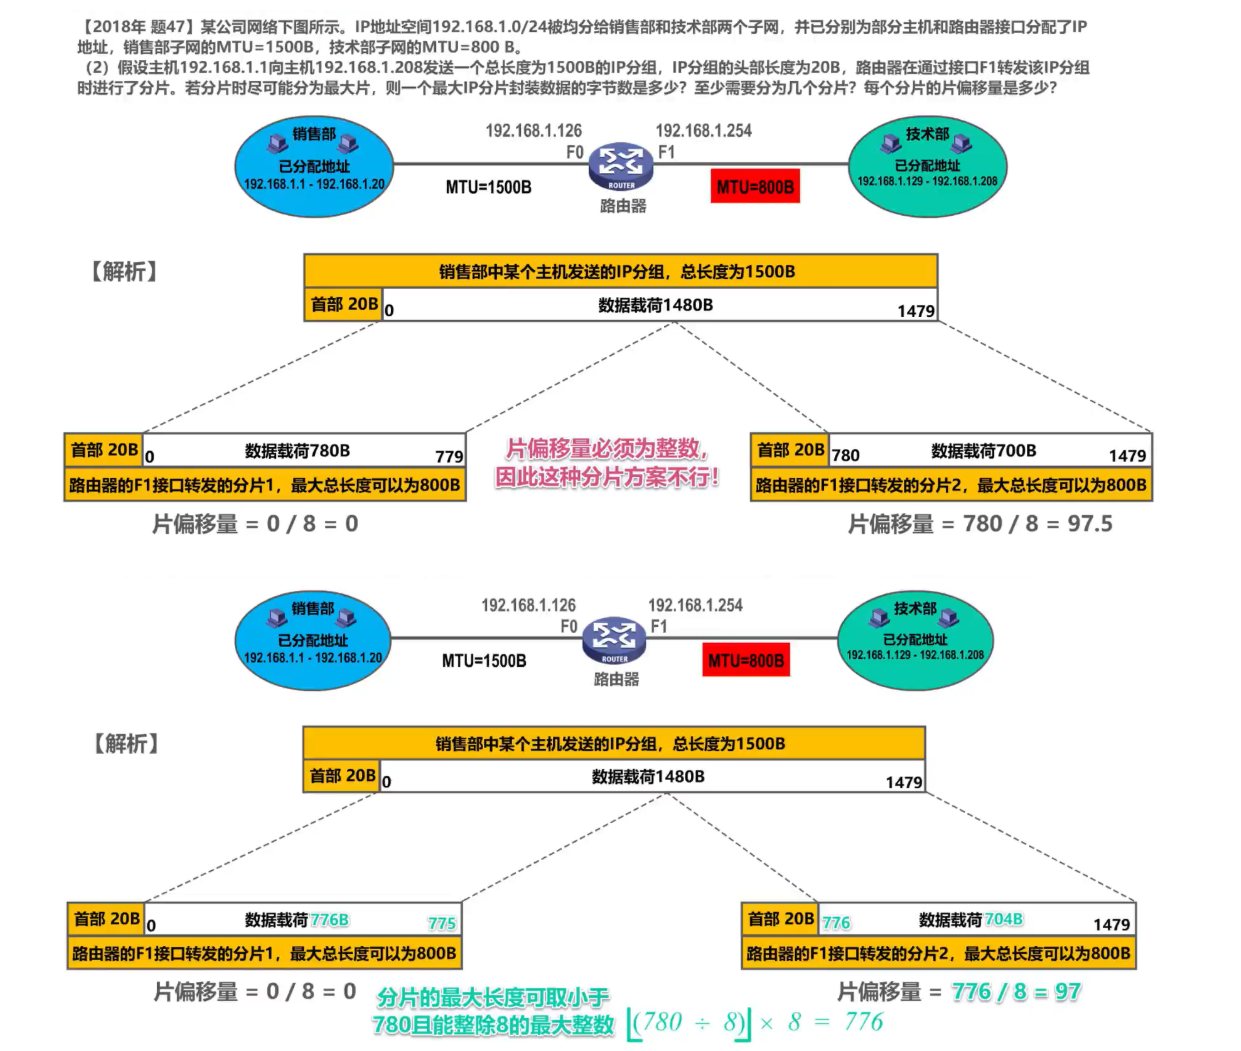
780/8向下取整等于97
97*8 = 776
网际控制报文协议ICMP
传输层
运输层概述
进程之间的通信
- 从通信和信息处理的角度看,运输层向它上面的应用层提供通信服务,它属于面向通信部分的最高层,同时也是用户功能中的最低层。
- 当网络的边缘部分中的两个主机使用网络的核心部分的功能进行端到端的通信时,只有位于网络边缘部分的主机的协议栈才有运输层,而网络核心部分中的路由器在转发分组时都只用到三层(到网络层)的功能。
物理层、数据链路层、网络层 共同实现了主机到主机的通信。
不过在网络中通信的真正主体是位于两端主机中的进程, 为运行在不同主机上的应用进程提供直接的通信服务就是运输层的任务,所以,运输层协议又称端到端协议。
“逻辑通信”:
“逻辑通信”是指运输层向高层用户屏蔽了下面网络核心的细节,使得两个运输层实体之间的通信好像是沿水平方向传送数据。
分类:
- 面向连接的TCP
- 无连接的UDP
端口号、复用与分用
为什么用端口号?
- 运行在计算机上的进程使用进程标识符PID来标志。但因特网上的计算机并不是使用统一的操作系统,不同的操作系统又使用不同格式的进程标识符。
- 为了使运行不同操作系统的计算机的应用进程之间能够进行网络通信,就必须使用统一的方法对TCP/IP体系的应用进程进行标识。TCP/IP体系的运输层使用端口号来区分应用层的不同应用进程。
- 端口号使用16比特表示,取值范围0 ~ 65535;
- 熟知端口号:0 ~ 1023, IANA把这些端口号指派给了TCP/IP体系中最重要的一些应用协议,例如:FTP使用21/20,HTTP使用80,DNS使用53。
- 登记端口号:1024~49151,为没有熟知端口号的应用程序使用。使用这类端口号必须在IANA按照规定的手续登记,以防止重复。例如:Microsoft RDP微软远程桌面使用的端口是3389。
- 短暂端口号:49152~65535,留给客户进程选择暂时使用。当服务器进程收到客户进程的报文时,就知道了客户进程所使用的动态端口号。通信结束后,这个端口号可供其他客户进程以后使用。
- 端口号只具有本地意义,即端口号只是为了标识本计算机应用层中的各进程,在因特网中,不同计算机中的相同端口号是没有联系的。
- 端口号使用16比特表示,取值范围0 ~ 65535;
发送方的复用、接收方的分用:
多个进程 利用一个运输层协议(或者称为运输层接口)发送数据称为 复用
多个进程 利用一个运输层协议(或者称为运输层接口)接收数据称为 分用。
TCP/IP体系的应用层常用协议所使用的运输层熟知端口号:
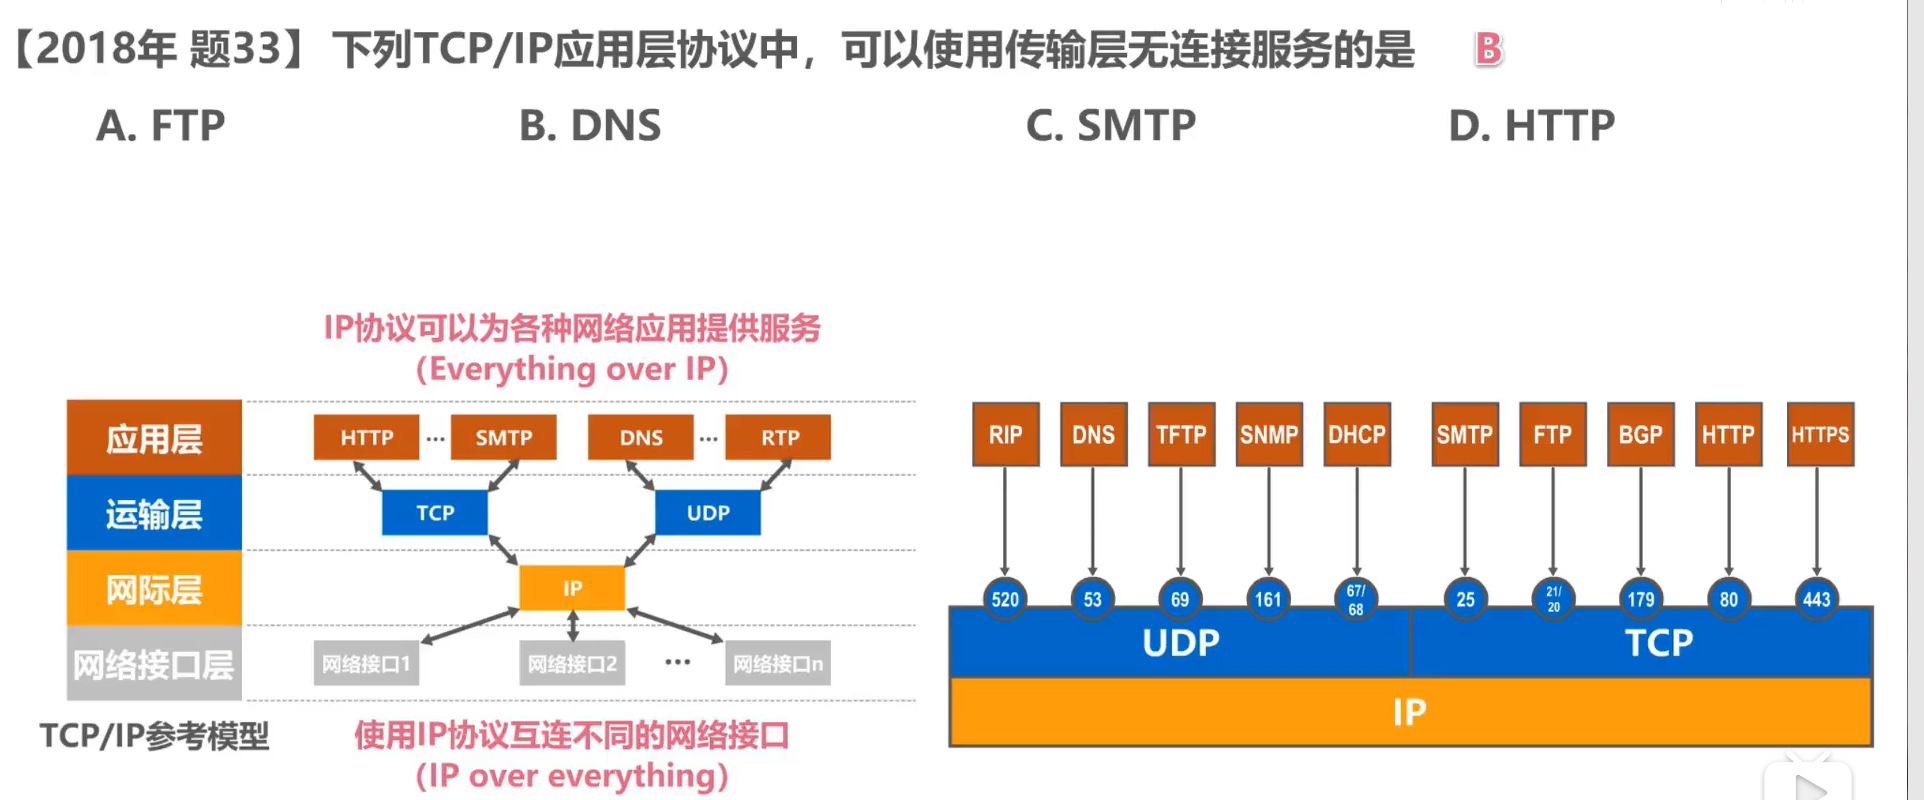
- UDP:协议字段 17
- SMTP —— 端口25
- FTP —— 21/20
- BGP —— 179
- HTTP —— 80
- HTTPS —— 443
- TCP:协议字段 6
- RIP —— 520
- DNS —— 53
- TFTP —— 69
- SNMP —— 161
- DHCP —— 67/68
UDP和TCP的对比
TCP:Transmission Control Protocol
UDP:User Datagram Protocol
是否可靠:
- UDP 和 TCP 是TCP/IP体系结构运输层中的两个重要协议
- 当运输层采用面向连接的 TCP 协议时,尽管下面的网络是不可靠的(只提供尽最大努力服务),但这种逻辑通信信道就相当于一条全双工的可靠信道。
- 当运输层采用无连接的 UDP 协议时,这种逻辑通信信道是一条不可靠信道。
数据单位:
- 两个对等运输实体在通信时传送的数据单位叫作运输协议数据单元 TPDU (Transport Protocol Data Unit)。
- TCP 传送的数据单位协议是 TCP 报文段(segment)。
- 支持点对点单播,不支持多播、广播;
- 复杂,用于大多应用:万维网,电子邮件,文件传送
- UDP 传送的数据单位协议是 UDP 报文或用户数据报。
- 支持单播,多播,广播;
- 简单,使用于很多应用:多媒体应用;
套接字:
UDP的通信是无连接的,不需要套接字(Socket)
TCP是面向连接的,TCP之间的通信必须要在两个套接字(Socket)之间建立连接
运输过程:
UDP是面向应用报文的,UDP对应用进程交下来的报文既不合并也不拆分,而是保留这些报文的边界。
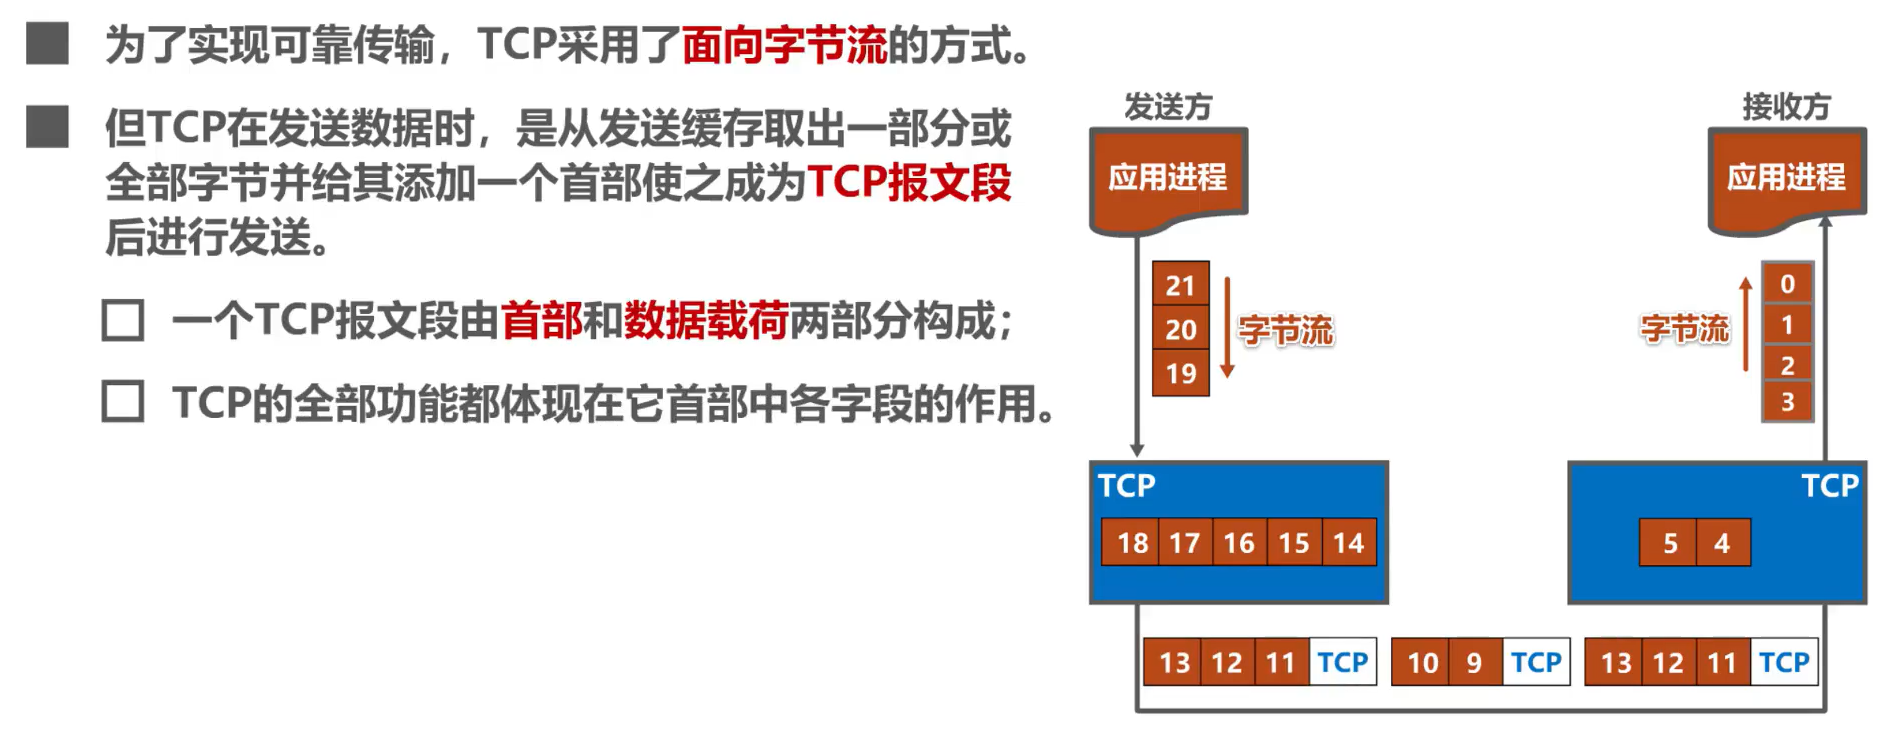
TCP是面向字节流的,这正是TCP实现可靠传输、流量控制、以及拥塞控制的基础
发送方
TCP会把应用进程交付下来的数据块看作是一连串无结构的字节流,TCP并不知道这些待传送的字节流的含义
并将他们编号,并存储在自己发送缓存中
TCP会根据发送策略,提取一定量的字节构建TCP报文并发送
接收方
- 一方面从所接受到的TCP报文段中,取出数据载荷部分并存储在接收缓存中;一方面将接收缓存中的一些字节交付给应用进程
- TCP不保证接收方应用进程所收到的数据块与发送方发送的数据块,具有对应大小的关系(例如,发送方应用进程交给发送方的TCP共10个数据块,但接收方的TCP可能只用了4个数据块,就把收到的字节流交付给了上层的应用进程,但接收方收到的字节流必须和发送方应用进程发出的字节流完全一样)
- 接收方的应用进程必须有能力识别收到的字节流,把它还原成有意义的应用层数据
首部结构:
- UDP首部: 仅8字节
- 源端口:2字节
- 目的端口:2字节
- 长度:2字节
- 校验和:2字节
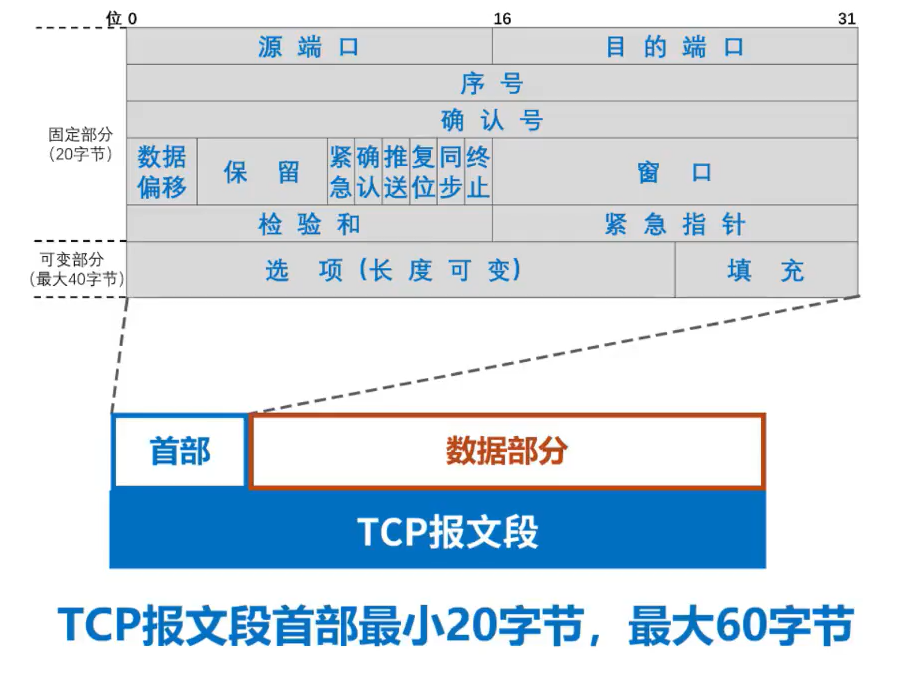
- TCP首部:最小20字节,最大60字节
TCP流量控制
一般来说,我们总是希望数据传输得更快一些。但如果发送方把数据发送得过快,接收方就可能来不及接收,这就会造成数据的丢失。
所谓流量控制 (flow control) 就是让发送方的发送速率不要太快,要让接收方来得及接收。
利用滑动窗口机制可以很方便地在TCP连接上实现对发送方的流量控制。
TCP接收方利用自己的接收窗口的大小来限制发送方发送窗口的大小。
TCP发送方收到接收方的零窗口通知后,应启动持续计时器。持续计时器超时后,向接收方发送零窗口探测报文。
过程 。。。。。。。。。。。。
上图如果零窗口探测报文在发送过程中如果丢失,还是能打破死锁局面
因为零窗口探测报文段也有重传计时器,重传计时器超时后,零窗口探测报文段会被重传
TCP拥塞控制
概念
在某段时间,若对网络中某一资源的需求超过了该资源所能提供的可用部分,网络性能就要变坏。这种情况就叫做拥塞(congestion)。若出现拥塞而不进行控制,整个网络的吞吐量将随输入负荷的增大而下降。
网络拥塞往往是由许多因素引起的。例如:
- 节点缓存的容量太小;
- 链路的容量不足;
- 处理机处理的速率太慢;
- 拥塞本身会进一步加剧拥塞;
拥塞控制的一般原理
- 拥塞控制的前提:网络能够承受现有的网络负荷。
- 实践证明,拥塞控制是很难设计的,因为它是一个动态问题。
- 分组的丢失是网络发生拥塞的征兆而不是原因。
- 在许多情况下,甚至正是拥塞控制本身成为引起网络性能恶化、甚至发生死锁的原因。
开环控制和闭环控制
- 开环控制:设计网络时,力争避免发生拥塞。
- 闭环控制:在发生拥塞后,采取措施进行控制,消除拥塞
监测网络的拥塞
主要指标有:
- 由于缺少缓存空间而被丢弃的分组的百分数;
- 平均队列长度;
- 超时重传的分组数;
- 平均分组时延;
- 分组时延的标准差,等等。
上述这些指标的上升都标志着拥塞的增长。
拥塞控制算法
- 慢开始
- 拥塞避免
- 快重传
- 快恢复
发送方维护一个叫做拥塞窗口cwnd的状态变量,其值取决于网络的拥塞程度,且动态变化。
- 拥塞窗口cwnd的维护原则:只要网络没有出现拥塞,拥塞窗口就再增大一些;但只要网络出现拥塞,拥塞窗口就减少一些。
- 判断出现网络拥塞的依据:没有按时收到应当到达的确认报文(即发生超时重传)。
发送方将拥塞窗口作为发送窗口swnd,即swnd=cwnd。
维护一个慢开始门限ssthresh状态变量:
- 当cwnd < ssthresh时,使用慢开始算法;
- 当cwnd > ssthresh时,停止使用慢开始算法而改用拥塞避免算法;
- 当cwnd = ssthresh时,既可使用慢开始算法,也可使用拥塞避免算法。
真正的发送窗口值 = Min (接收方窗口值,拥塞窗口值)
慢开始
- 目的:用来确定网络的负载能力或拥塞程度。
- 算法的思路:由小到大逐渐增大拥塞窗口数值。
- 两个变量:
- 拥塞窗口(cwnd):初始拥塞窗口值:2 种设置方法。窗口值逐渐增大。
- 1 至 2 个最大报文段 (旧标准)
- 2 至 4 个最大报文段 (RFC 5681)
- 慢开始门限(ssthresh):防止拥塞窗口增长过大引起网络拥塞。
- 拥塞窗口(cwnd):初始拥塞窗口值:2 种设置方法。窗口值逐渐增大。
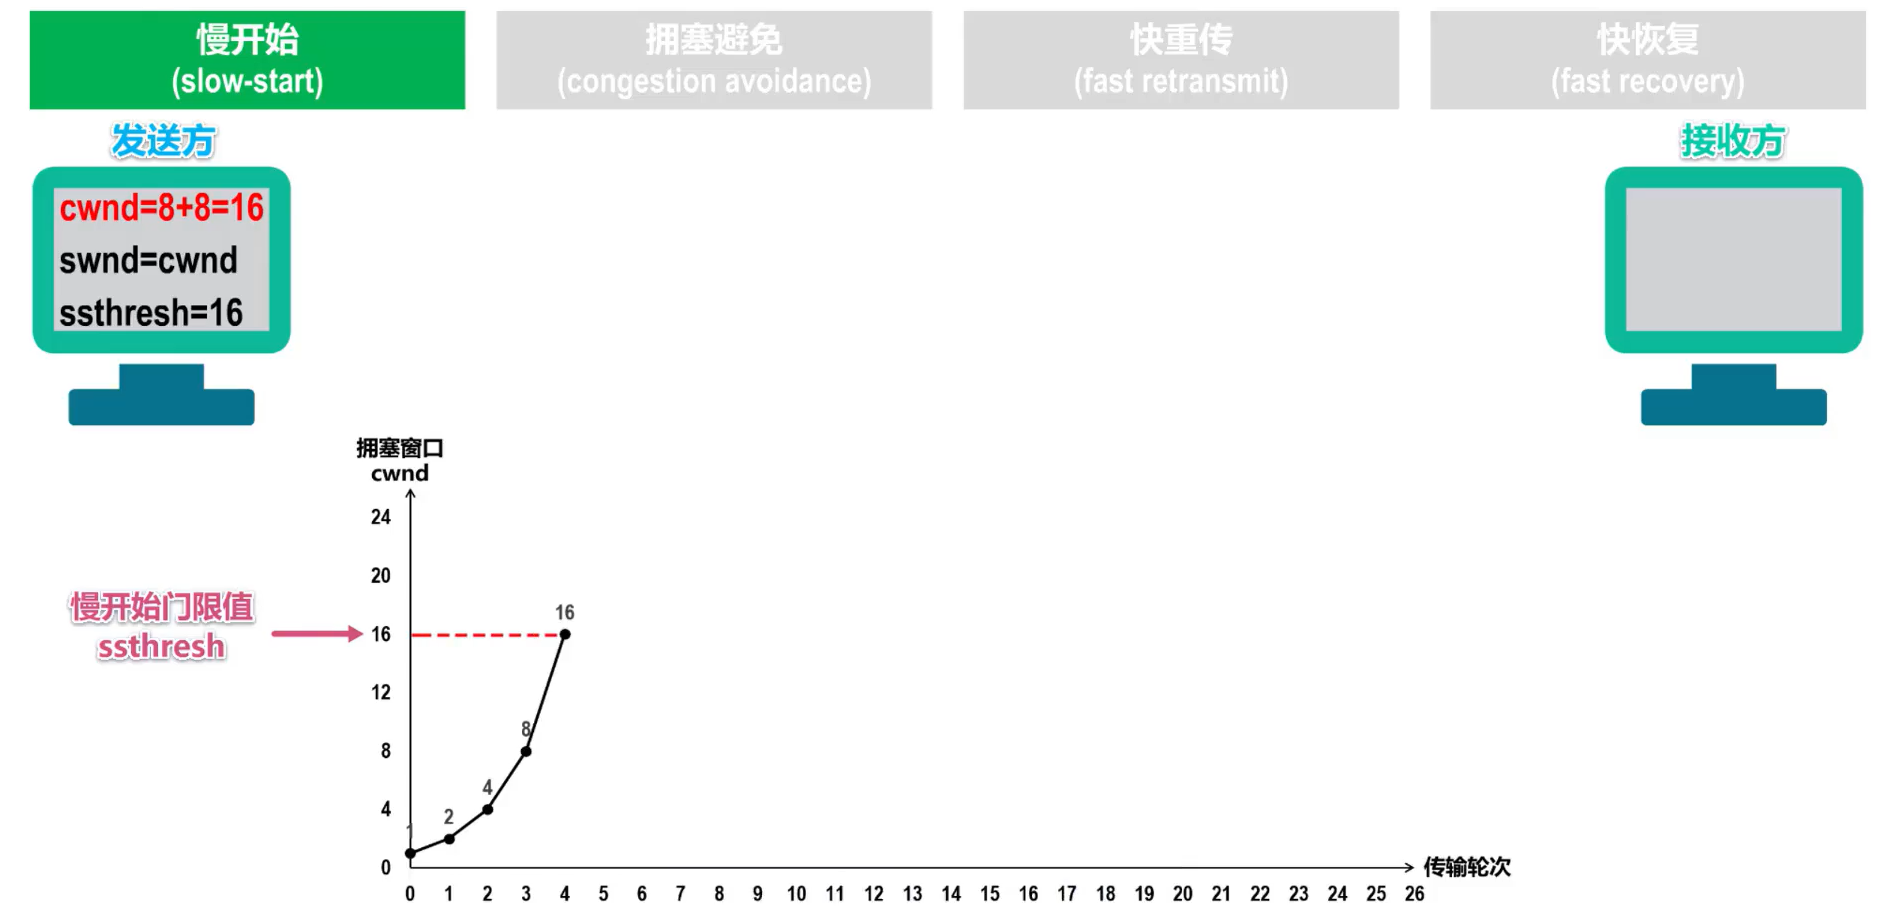
每经过一个传输轮次,拥塞窗口就加倍
窗口大小按指数增加,2^n-1^次方
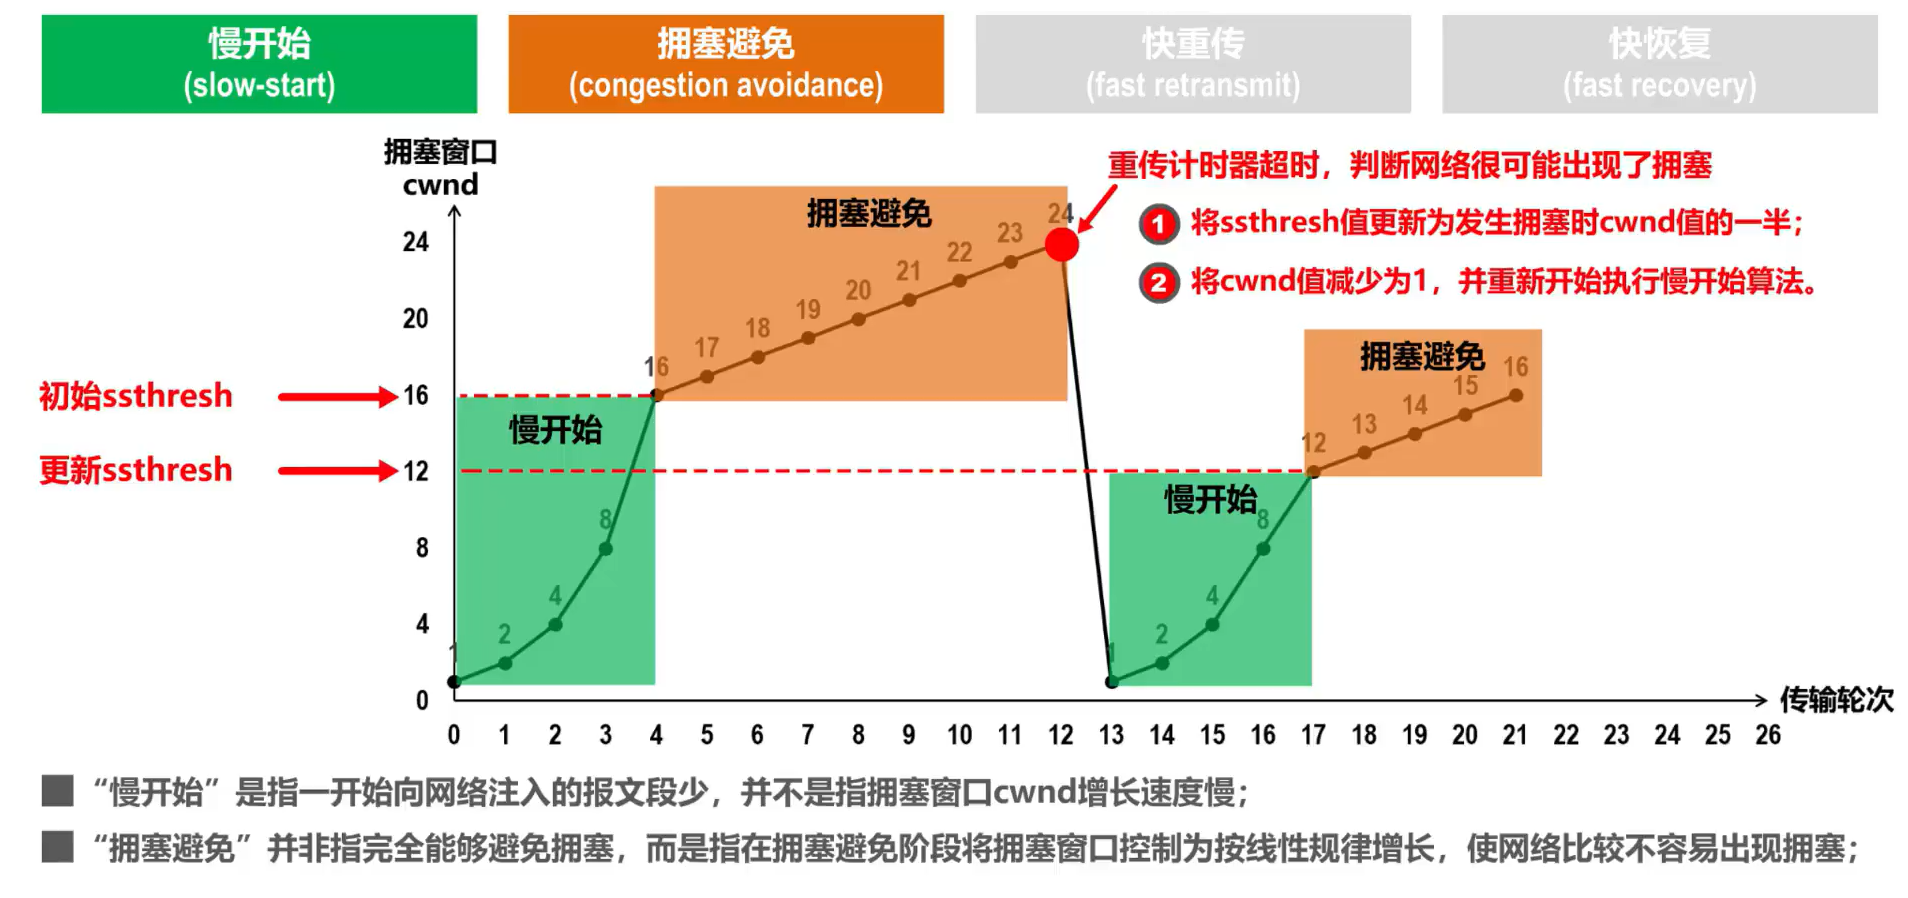
拥塞避免
- 思路:让拥塞窗口 cwnd 缓慢地增大,避免出现拥塞。
- 每经过一个传输轮次,拥塞窗口 cwnd = cwnd + 1。
- 使拥塞窗口 cwnd 按线性规律缓慢增长。
- 在拥塞避免阶段,具有 “加法增大” (Additive Increase) 的特点。
如果在发送过程中出现部分报文段丢失,这必然会造成发送方对这些丢失报文段的超时重传。
发生超时重传时,网络可能是出现了拥塞:
- ssthresh 变更为cwnd值的一半;
- cwnd值减为1,重新开始慢开始算法;
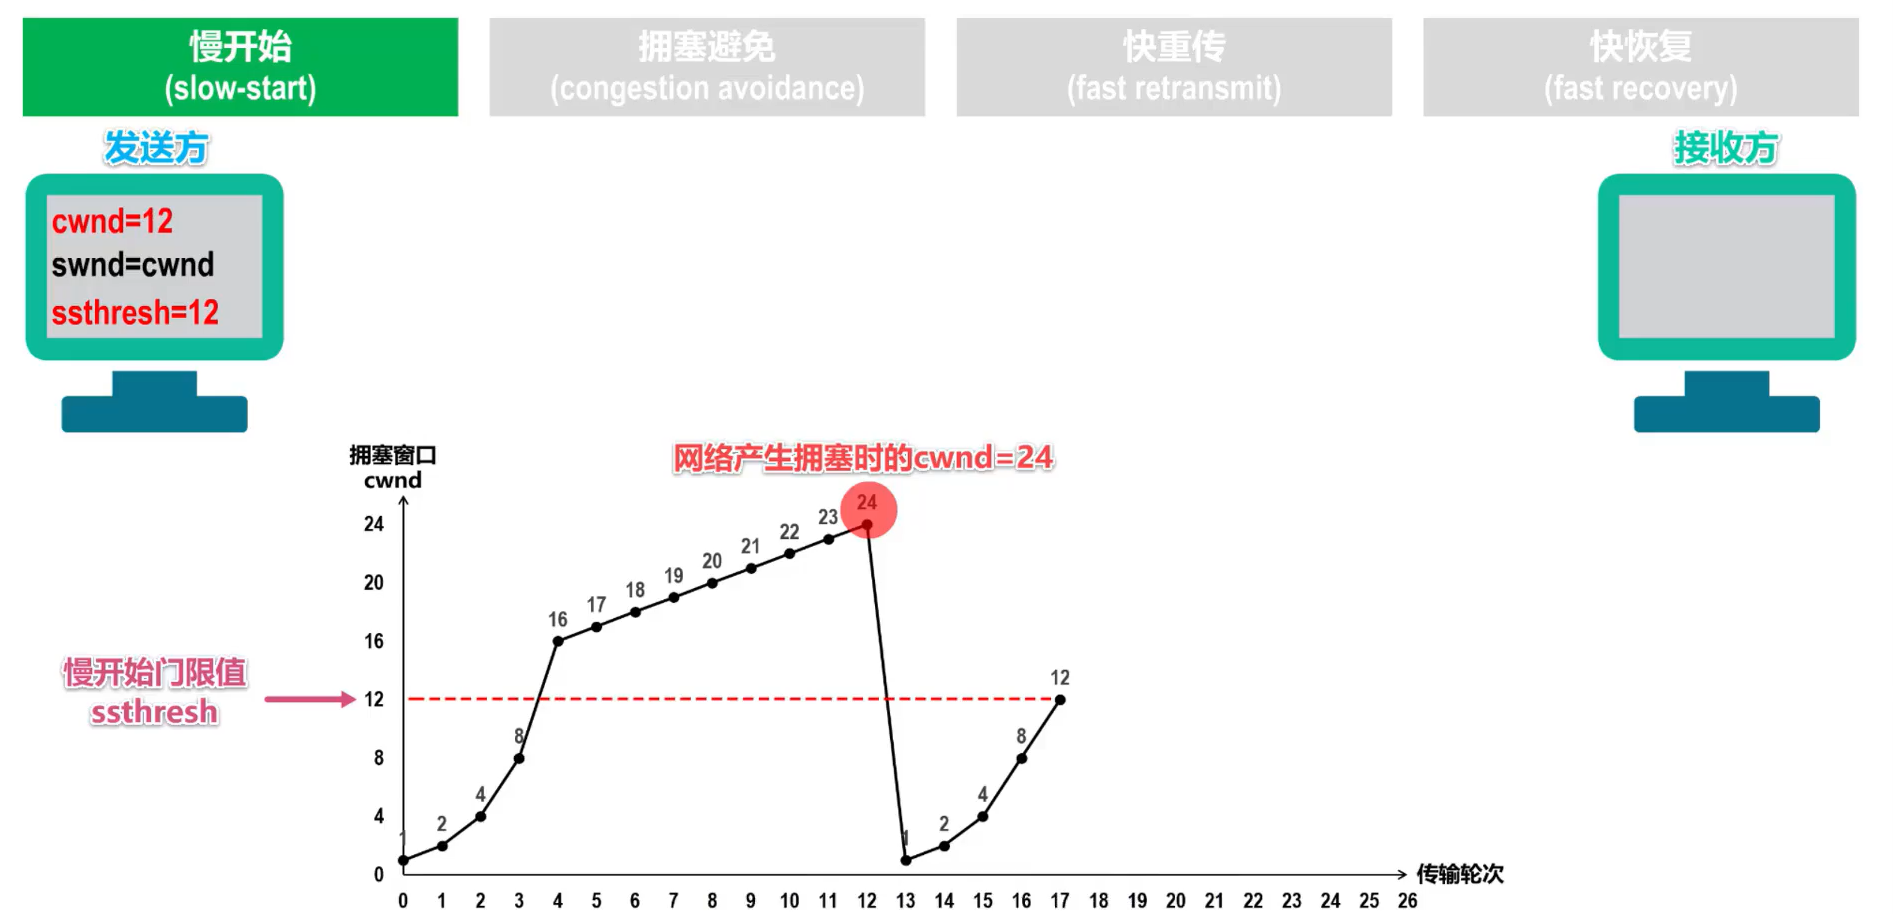
两个法完整示意图
快重传
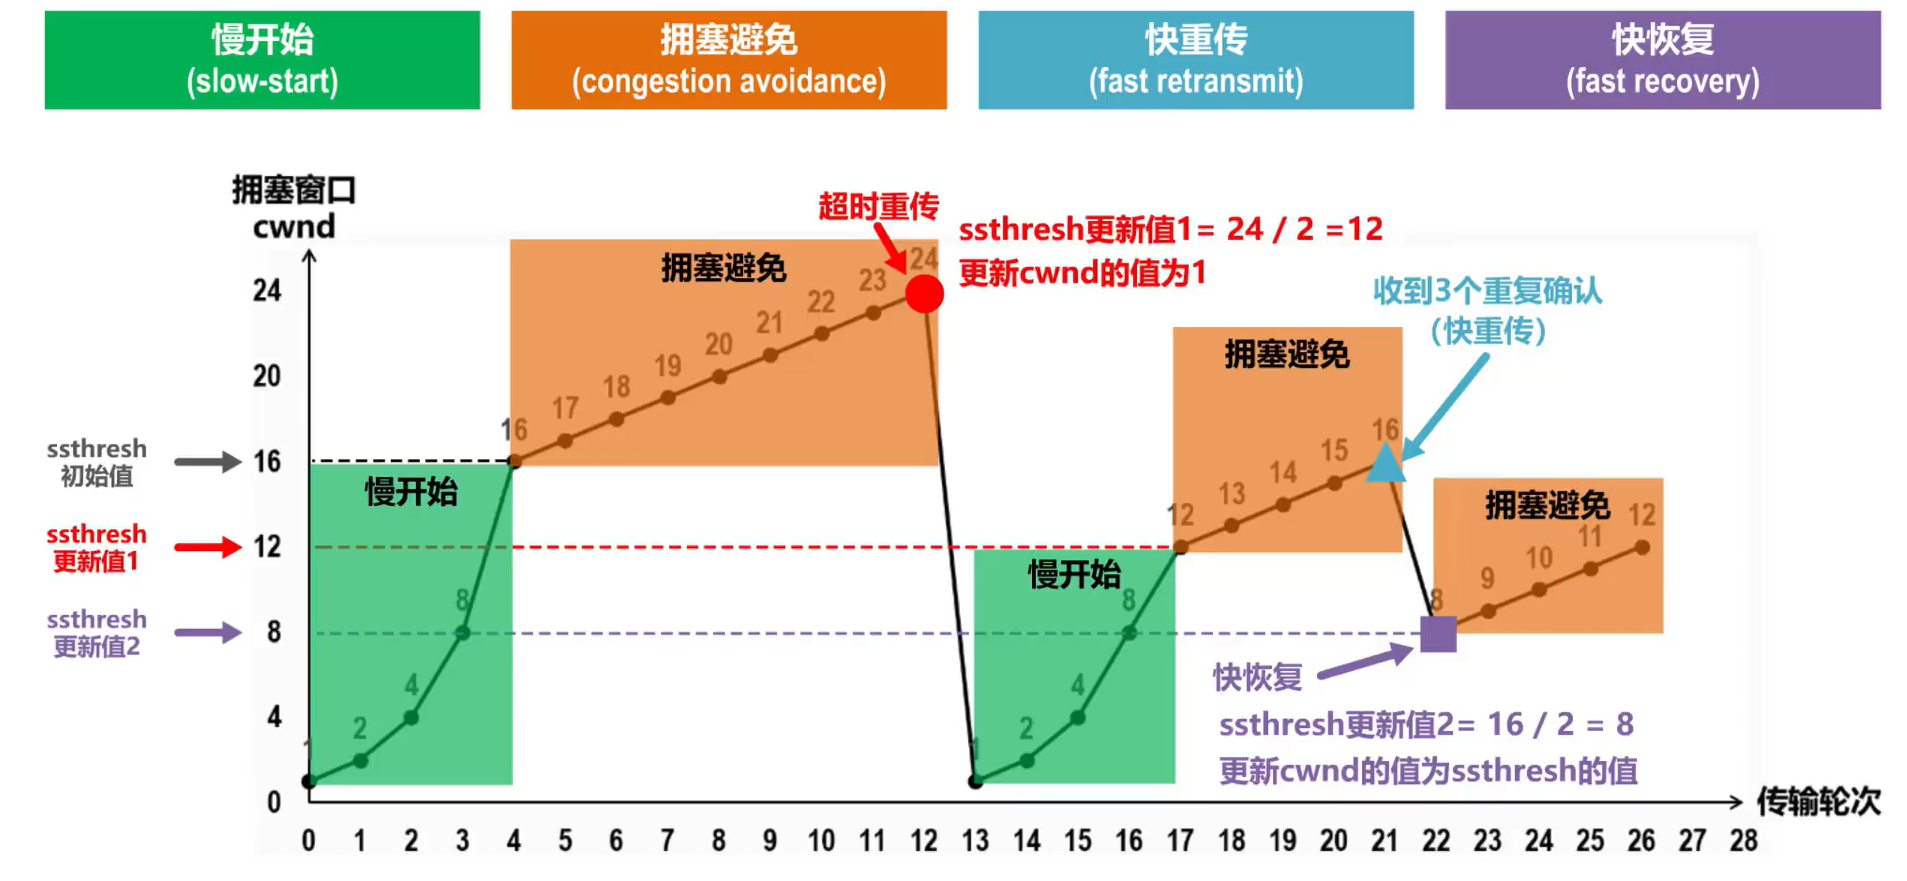
有时,个别报文段会在网络中丢失,但实际上网络并未发生拥塞
- 这将导致发送方超时重传,并误认为网络发生了拥塞;
- 发送方把拥塞窗口cwd又设置为最小值1,并错误地启动慢开始算法,因而降低了传输效率。
快重传:就是使发送方尽快进行重传,而不是等超时重传。
- 要求接收方不要等待自己发送数据时才进行捎带确认,而是要立即发送确认;
- 即使收到了失序的报文段也要立即发出对已收到的报文段的重复确认。
- 发送方一旦收到3个连续的重复确认,就将相应的报文段立即重传,而不是等该报文段的超时重传计时器超时再重传。
- 对于个别丢失的报文段,发送方不会出现超时重传,也就不会误认为出现了拥塞(进而降低拥塞窗口cwd为1)。使用快重传可以使整个网络的吞吐量提高约20%。
快恢复
发送方一旦收到3个重复确认,就知道现在只是丢失了个别的报文段。于是不启动慢开始算法,而执行快恢复算法
- 发送方将慢开始门限ssthresh值和拥塞窗口cwnd值调整为当前窗口的一半开始执行拥塞避免算法。
- 也有的快恢复实现是把快恢复开始时的拥塞窗口cwnd值再增大一些,即等于新的ssthresh+3。
- 既然发送方收到3个重复的确认,就表明有3个数据报文段已经离开了网络:
- 这3个报文段不再消耗网络资源而是停留在接收方的接收缓存中;
- 可见现在网络中不是堆积了报文段而是减少了3个报文段。因此可以适当把拥塞窗口扩大些。
算法示意图
TCP超时重传时间的选择
超时重传时间的选择是TCP最复杂的问题之一。
如果超时重传时间RTO的值设置得比 往返时间RTT0 的值小很多,这会引起报文段不必要的重传,使网络负荷增大;
如果超时重传时间RTO的值设置得远大于RTT0的值,这会使重传时间推迟的太长,使网络的空闲时间增大,降低传输效率;
所以 超时重传时间RTO的值 应该略大于 往返时间RTT0 的值。
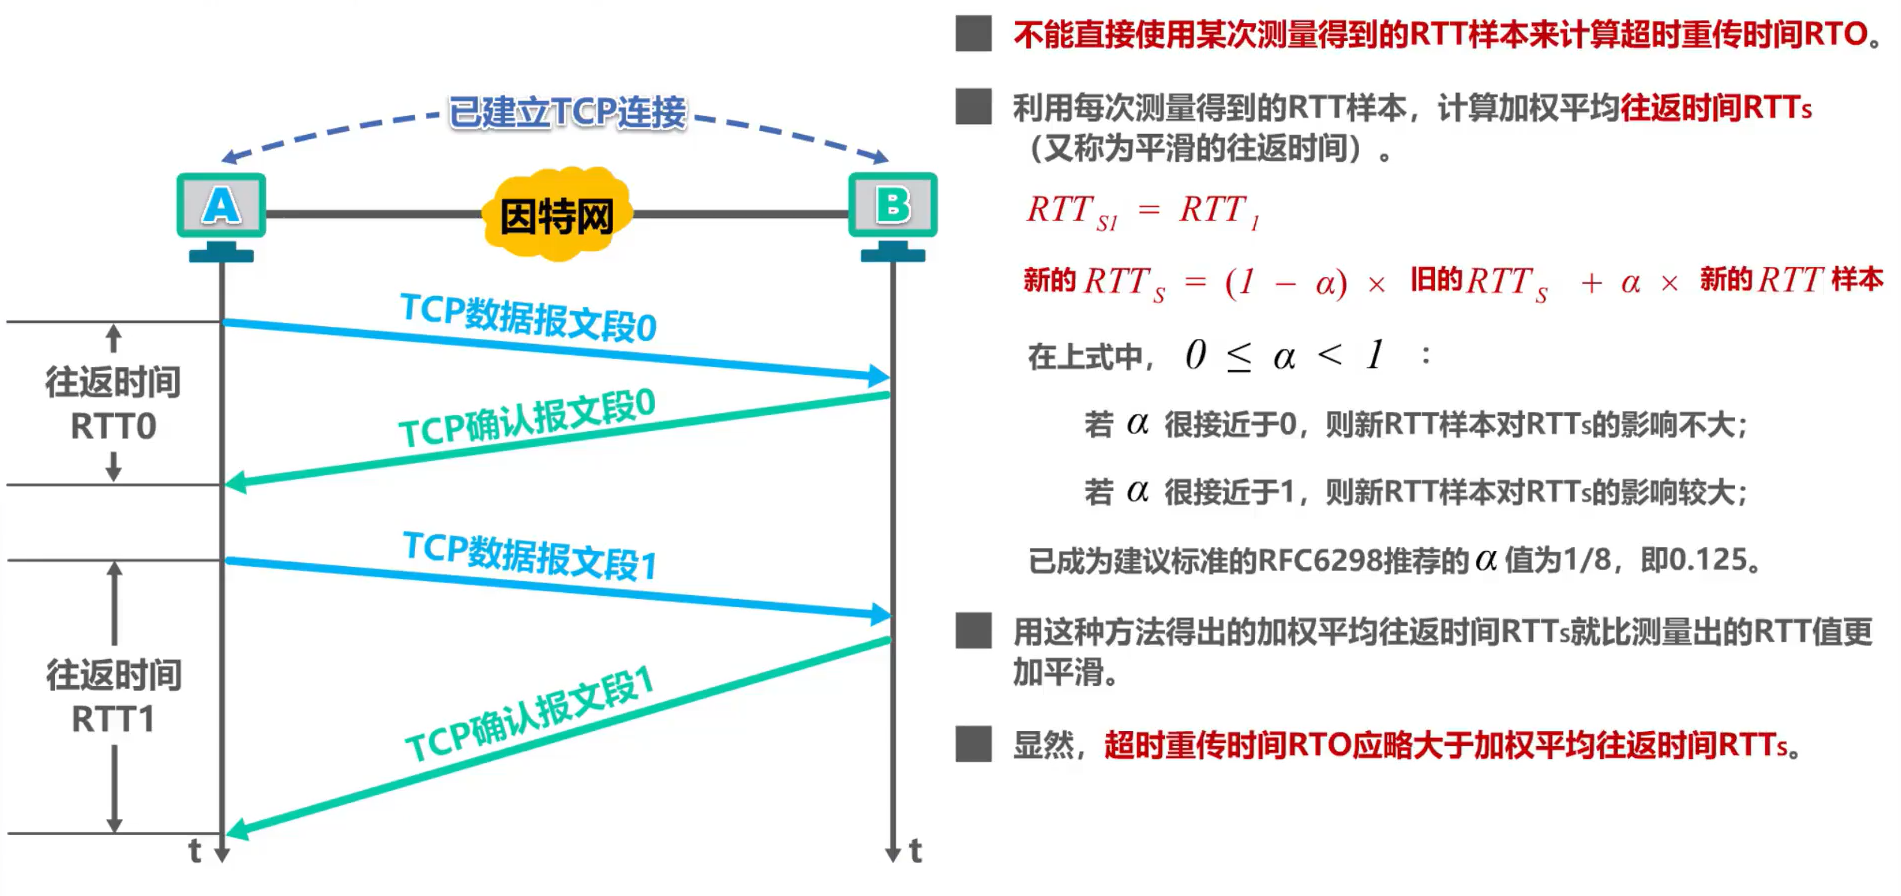
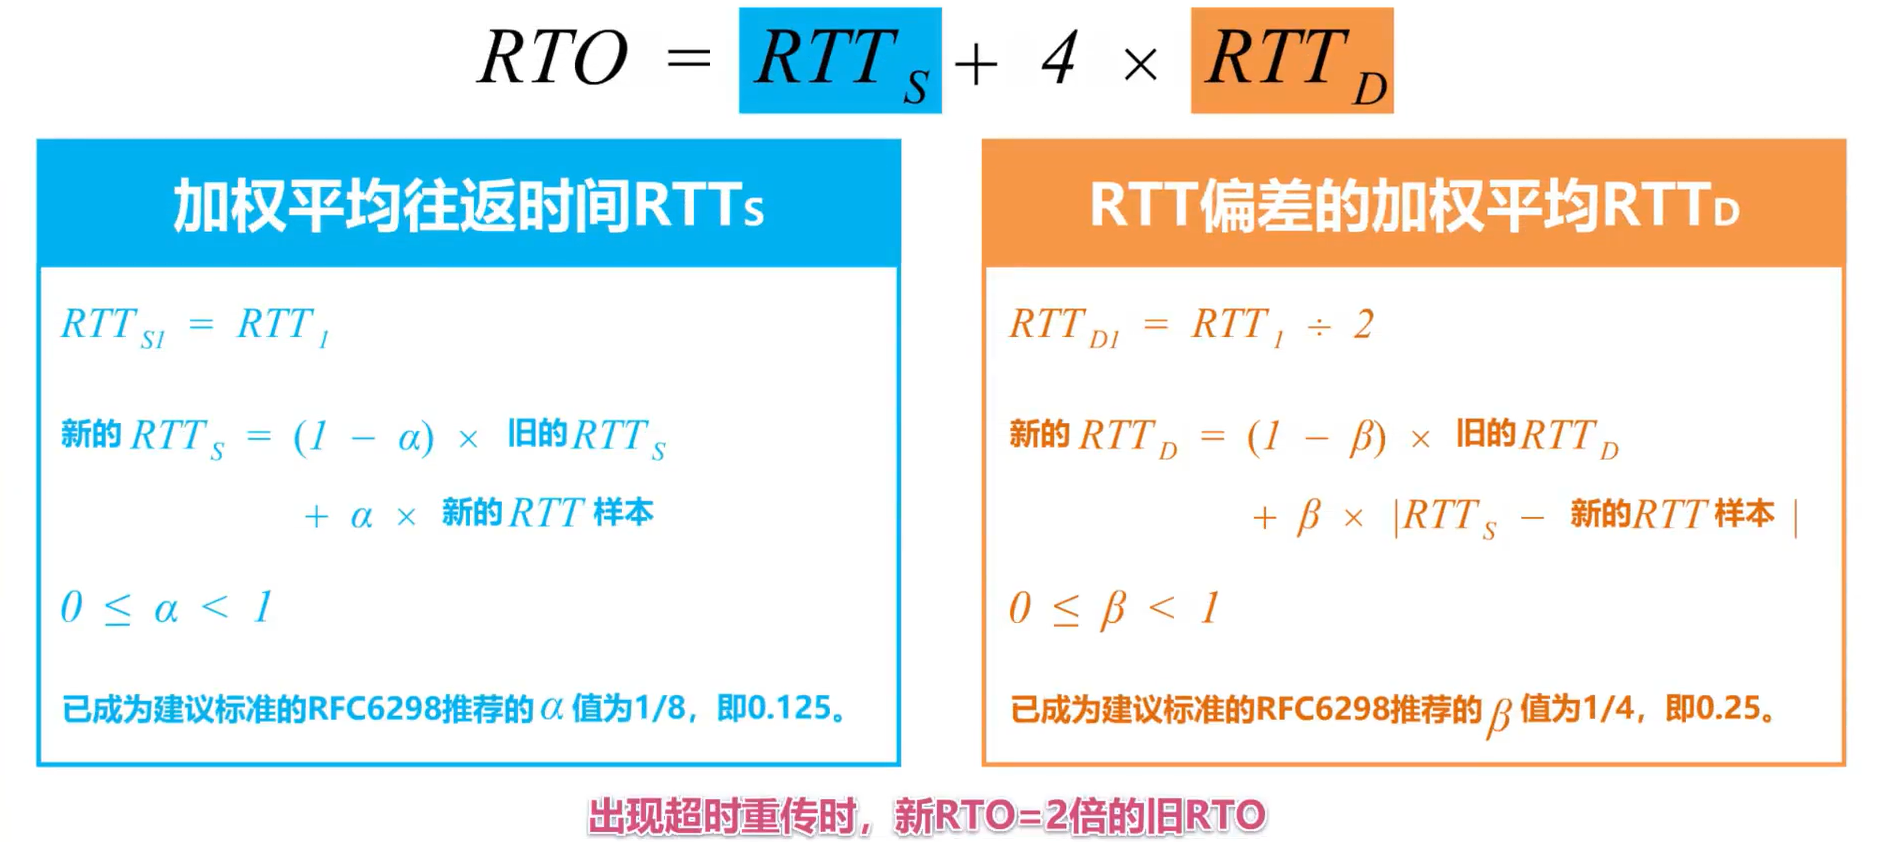
RFC6298建议使用下式计算超时重传时间RTO
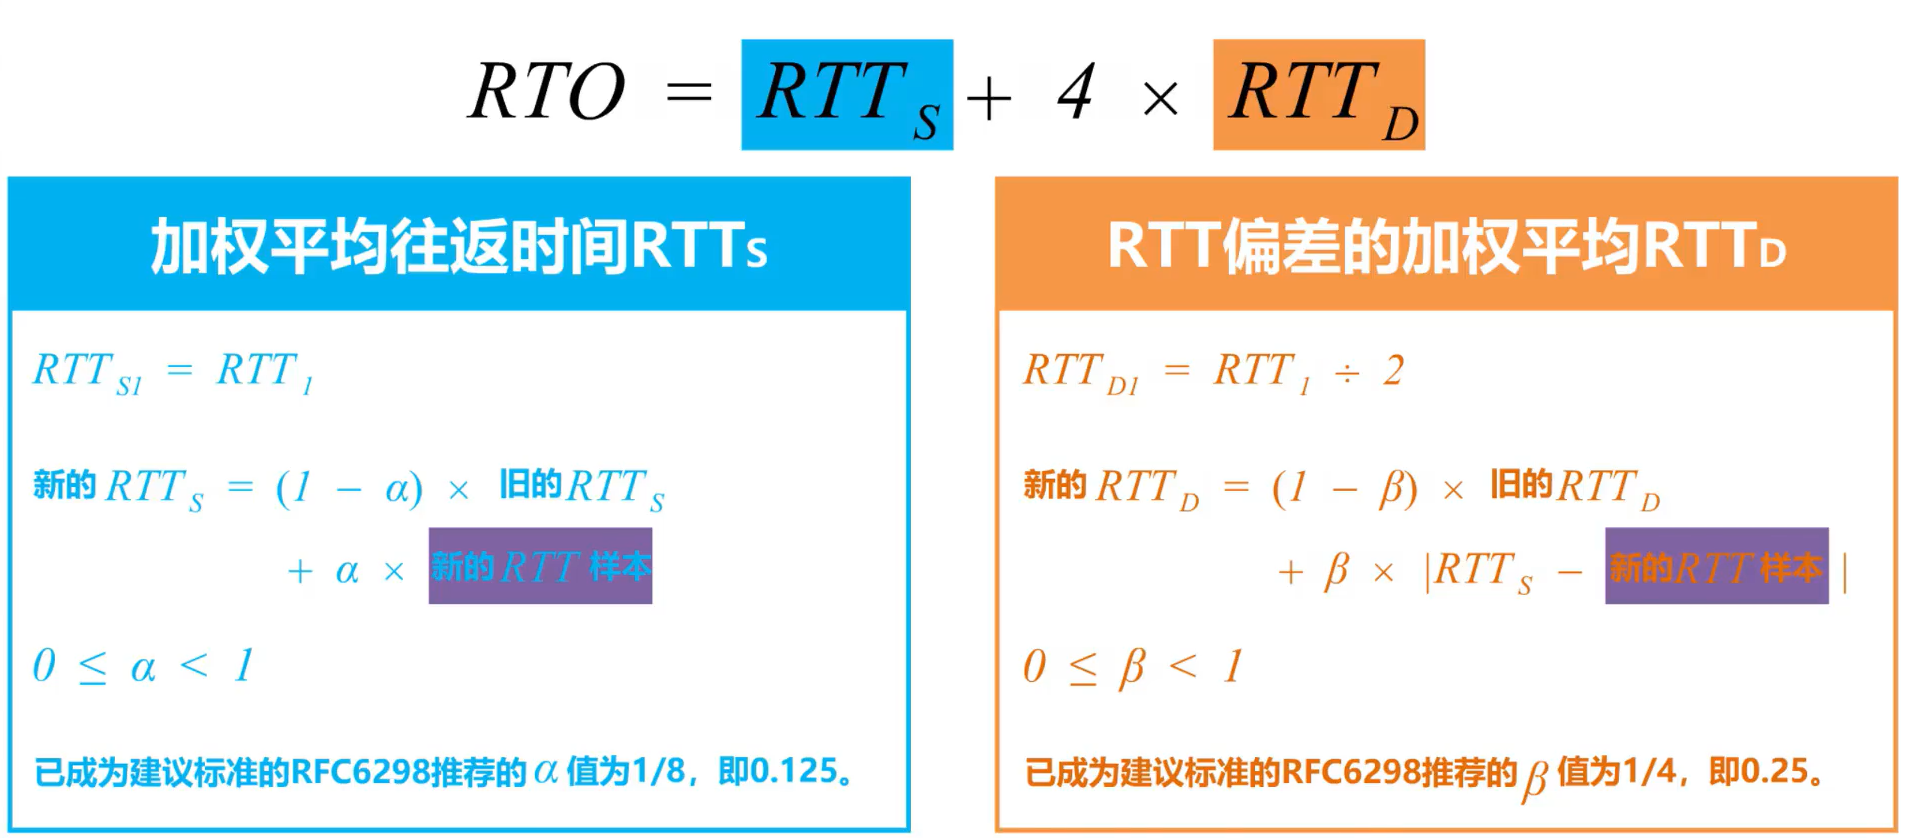
往返时间RTT的测量比较复杂
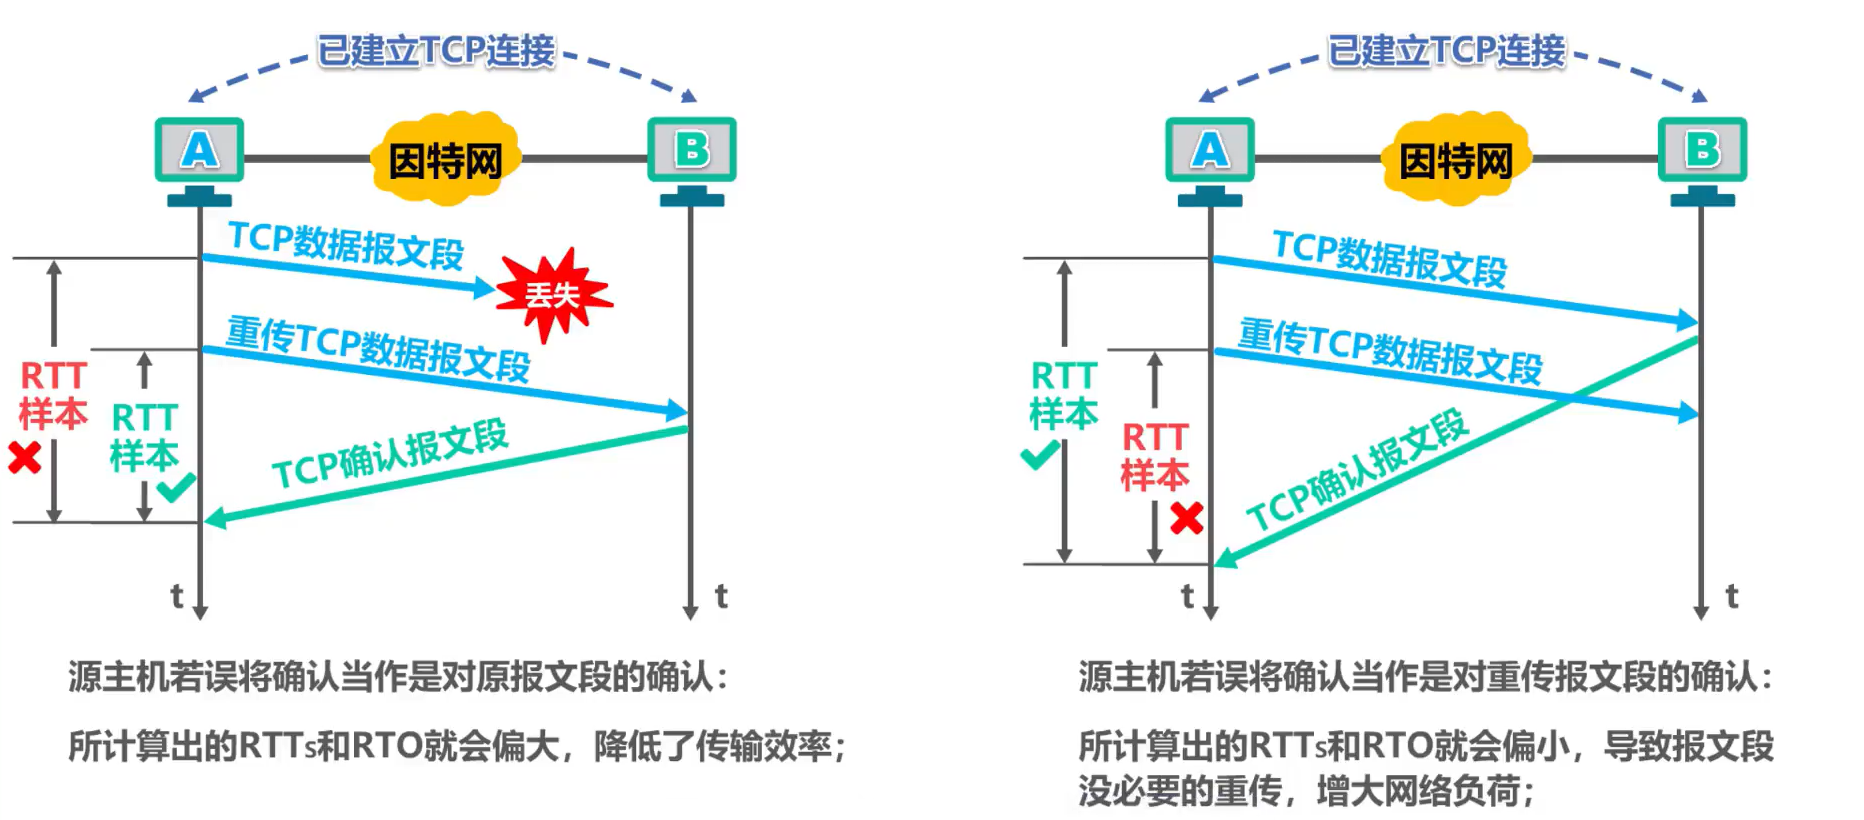
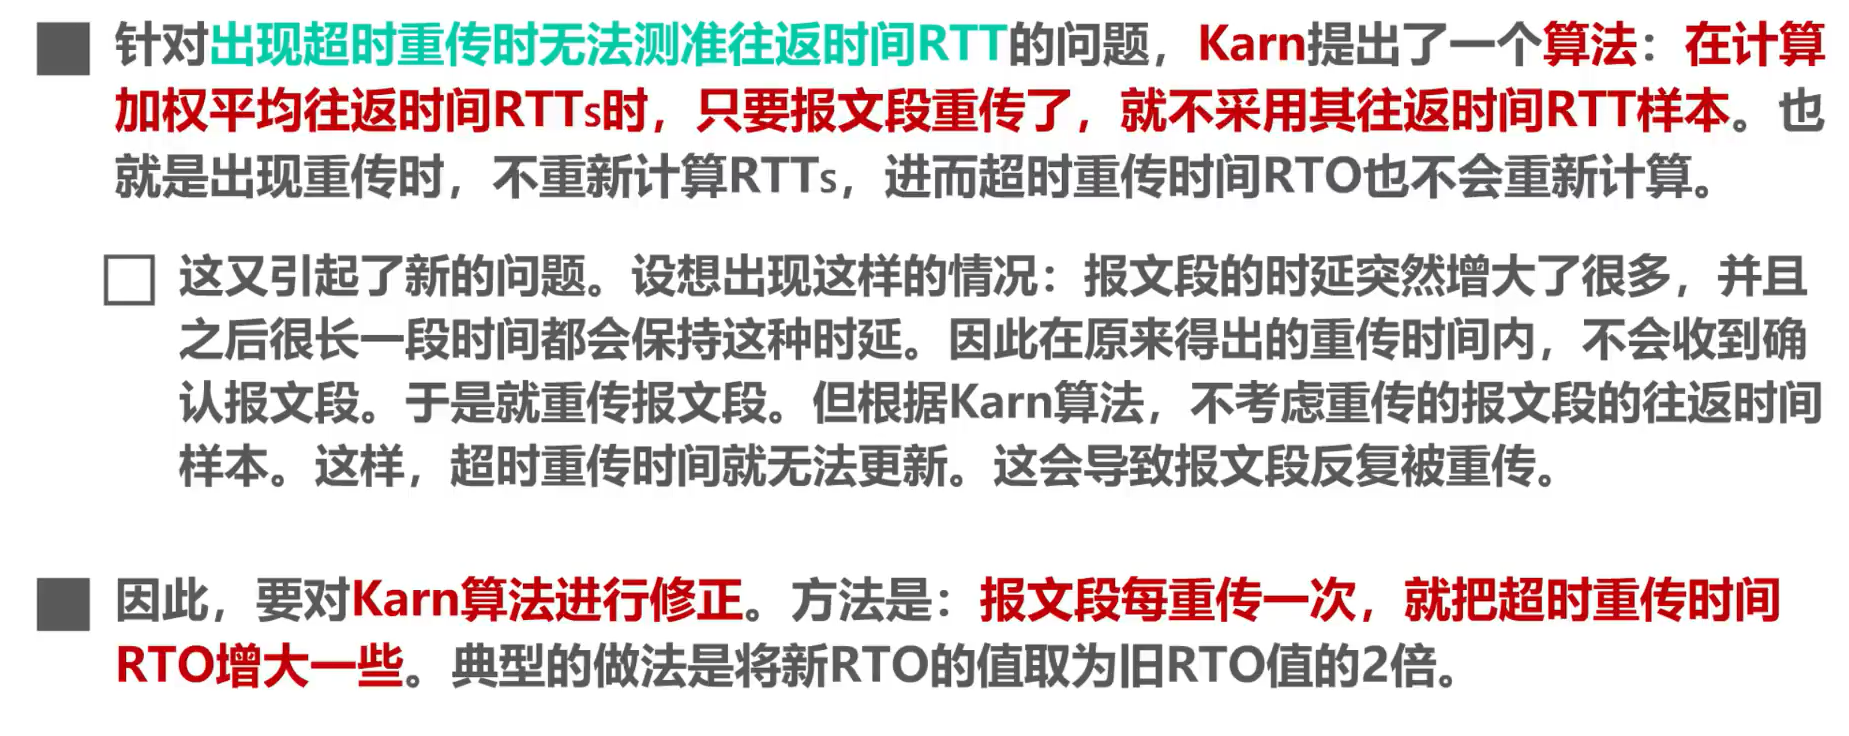
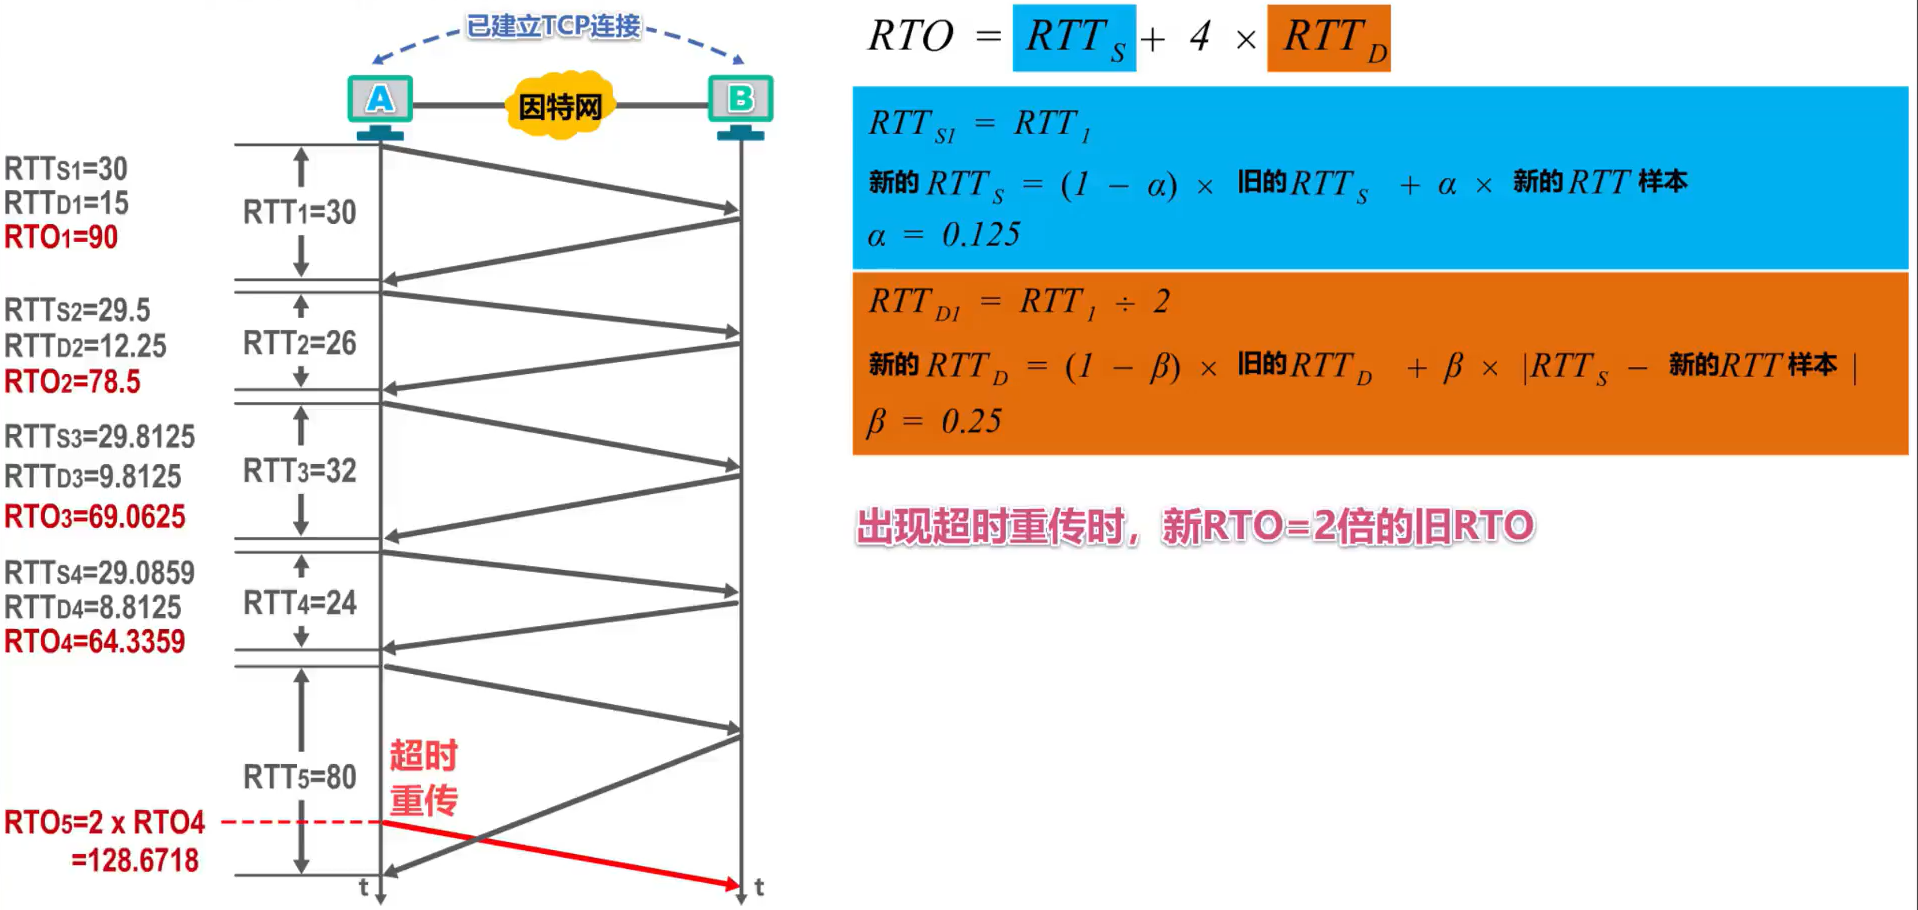
TCP超时重传的计算
举例
总结
TCP可靠传输的实现
TCP基于以字节为单位的滑动窗口来实现可靠传输。
- 发送方在未收到接收方的确认时,可将发送窗口内还未发送的数据全部发送出去;
- 接收方只接收序号落入发送窗口内的数据;
虽然发送方的发送窗口是根据接收方的接收窗口设置的,但在同一时刻,发送方的发送窗口并不总是和接收方的接收窗口一样大。
- 网络传送窗口值需要经历一定的时间滞后,并且这个时间还是不确定的。
- 发送方还可能根据网络当时的拥塞情况适当减小自己的发送窗口尺寸。
对于不按序到达的数据应如何处理,TCP并无明确规定。
- 一般,TCP通常对不按序到达的数据是先临时存放在接收窗口中,等到字节流中所缺少的字节收到后,再按序交付上层的应用进程。
TCP要求接收方必须有累积确认和捎带确认机制,这样可以减小传输开销。接收方可以在合适的时候发送确认,也可以在自己有数据要发送时把确认信息顺便捎带上。
接收方不应过分推迟发送确认,否则会导致发送方不必要的超时重传,这反而浪费了网络的资源。
TCP标准规定,确认推迟的时间不应超过0.5秒。若收到一连串具有最大长度的报文段,则必须每隔一个报文段就发送一个确认[RFC1122]。
捎带确认实际上并不经常发生,因为大多数应用程序很少同时在两个方向上发送数据
TCP的通信是全双工通信。通信中的每一方都在发送和接收报文段。因此,每一方都有自己的发送窗口和接收窗口。在谈到这些窗口时,一定要弄清楚是哪一方的窗口。
TCP建立和断开连接
TCP是面向连接的协议,每一次连接的三个阶段:
- 建立TCP连接(三报文握手);
- 数据传送;
- 释放TCP连接(四报文握手);
TCP建立连接需要3次握手。
注:第三次握手是可以携带数据的,前两次握手是不可以携带数据的
TCP连接的定义:是一些用于保证可靠性和流量控制维护的某些状态信息,这些信息的组合,包括Socket、序列号和窗口大小。
所以三次握手的目的,是为了保证能 初始化Socket、序列号和窗口大小并建立 TCP 连接。
三次握手的原因:
- 三次握手才可以阻止重复历史连接的初始化(主要原因)
- 三次握手才可以同步双方的初始序列号
- 三次握手才可以避免资源浪费
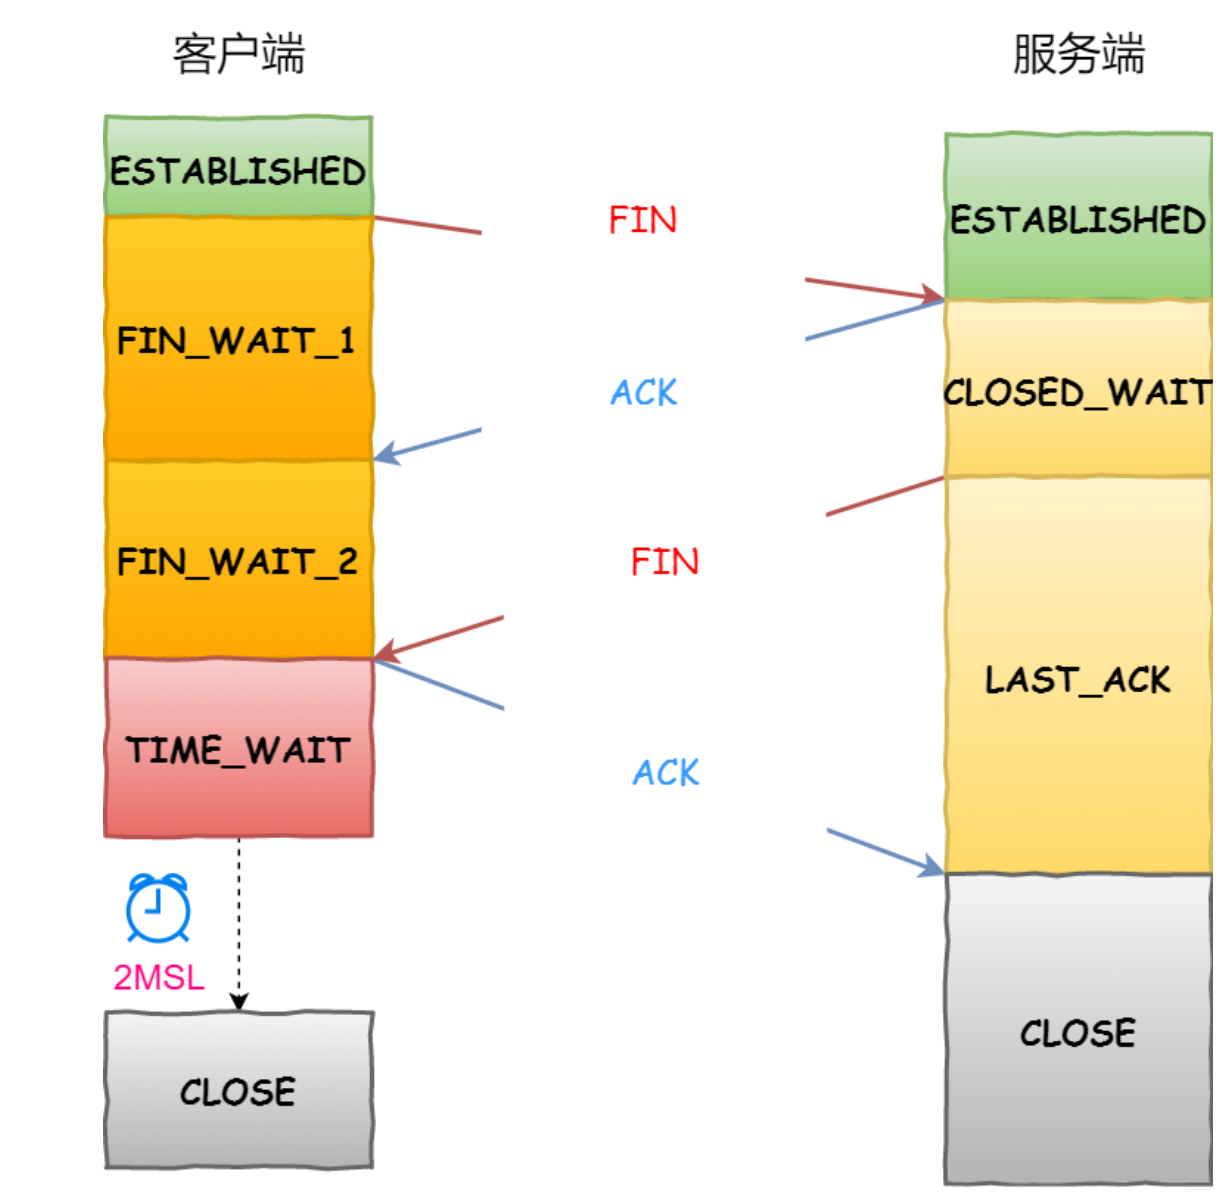
TCP断开连接需要四次挥手。双方都需要发送一个FIN报文 和 回应FIN的 ACK报文。
服务端收到客户端的FIN后,先回应一个ACK,然后处理完剩下的数据后,才发送FIN给客户端;
主动关闭连接的,最后会有一个 TIME_WAIT 状态,即等待2MSL,原因有二:保证被动连接方能正确关闭;防止历史连接中的数据,被后面相同四元组的连接错误的接收。
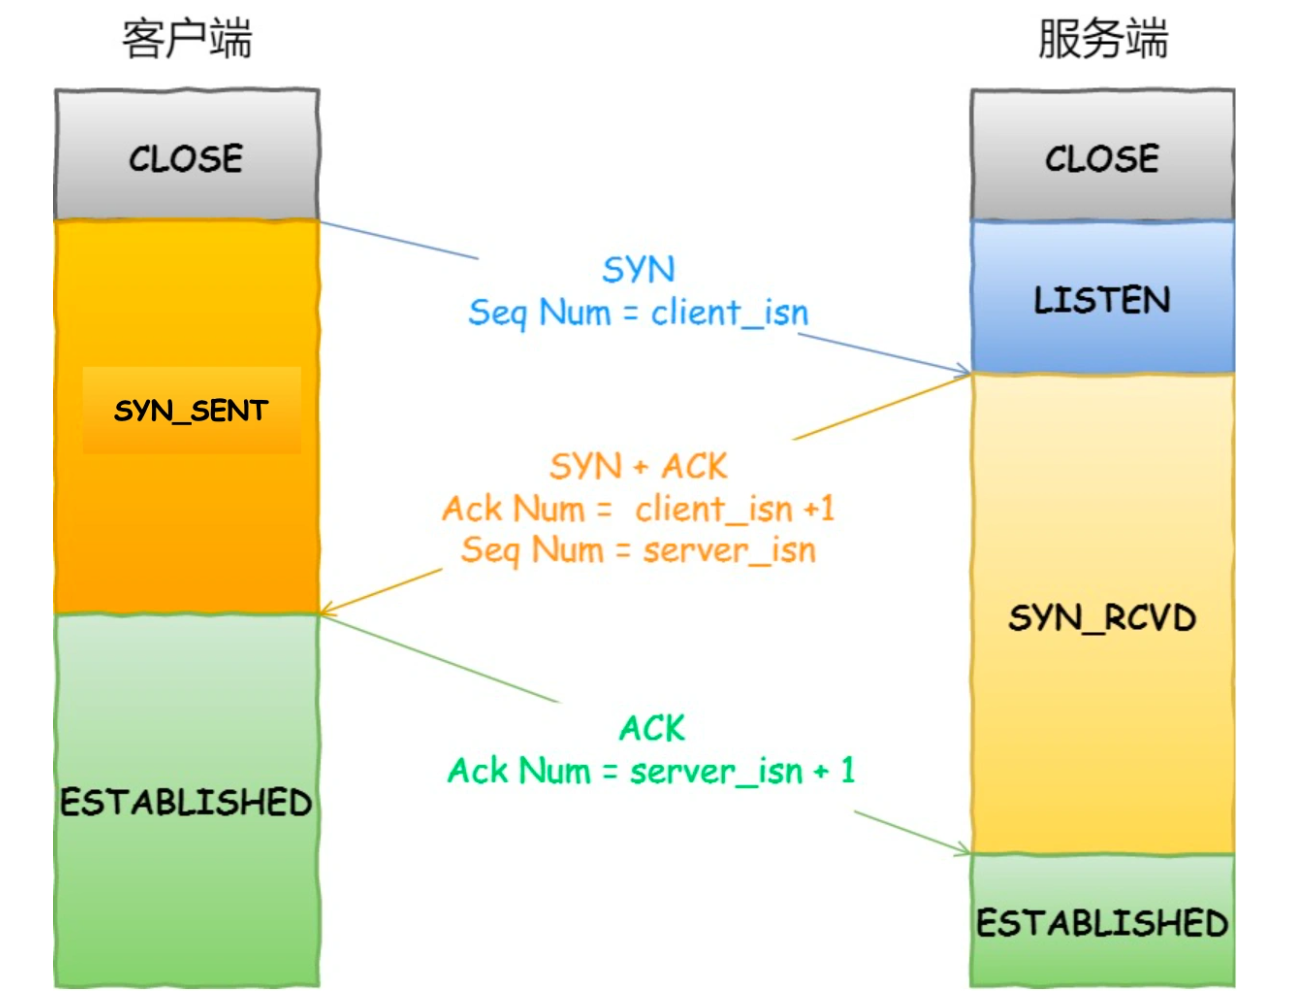
TCP的连接建立
- TCP 建立连接的过程叫做握手。
- 握手需要在客户和服务器之间交换三个 TCP 报文段。称之为三报文握手。
- 采用三报文握手主要是为了防止已失效的连接请求报文段突然又传送到了,因而产生错误。
TCP的连接建立要解决以下三个问题:
- 使TCP双方能够确知对方的存在;
- 使TCP双方能够协商一些参数(如最大窗口值、是否使用窗口扩大选项和时间戳选项以及服务质量等);
- 使TCP双方能够对运输实体资源(如缓存大小、连接表中的项目等)进行分配。
TCP使用“三报文握手”建立连接 :
- TCP 连接的建立采用客户-服务器方式。
- 主动发起连接建立的应用进程叫做TCP客户 (client)。
- 被动等待连接建立的应用进程叫做TCP服务器 (server)。
“握手”需要在TCP客户端和服务器之间交换三个TCP报文段
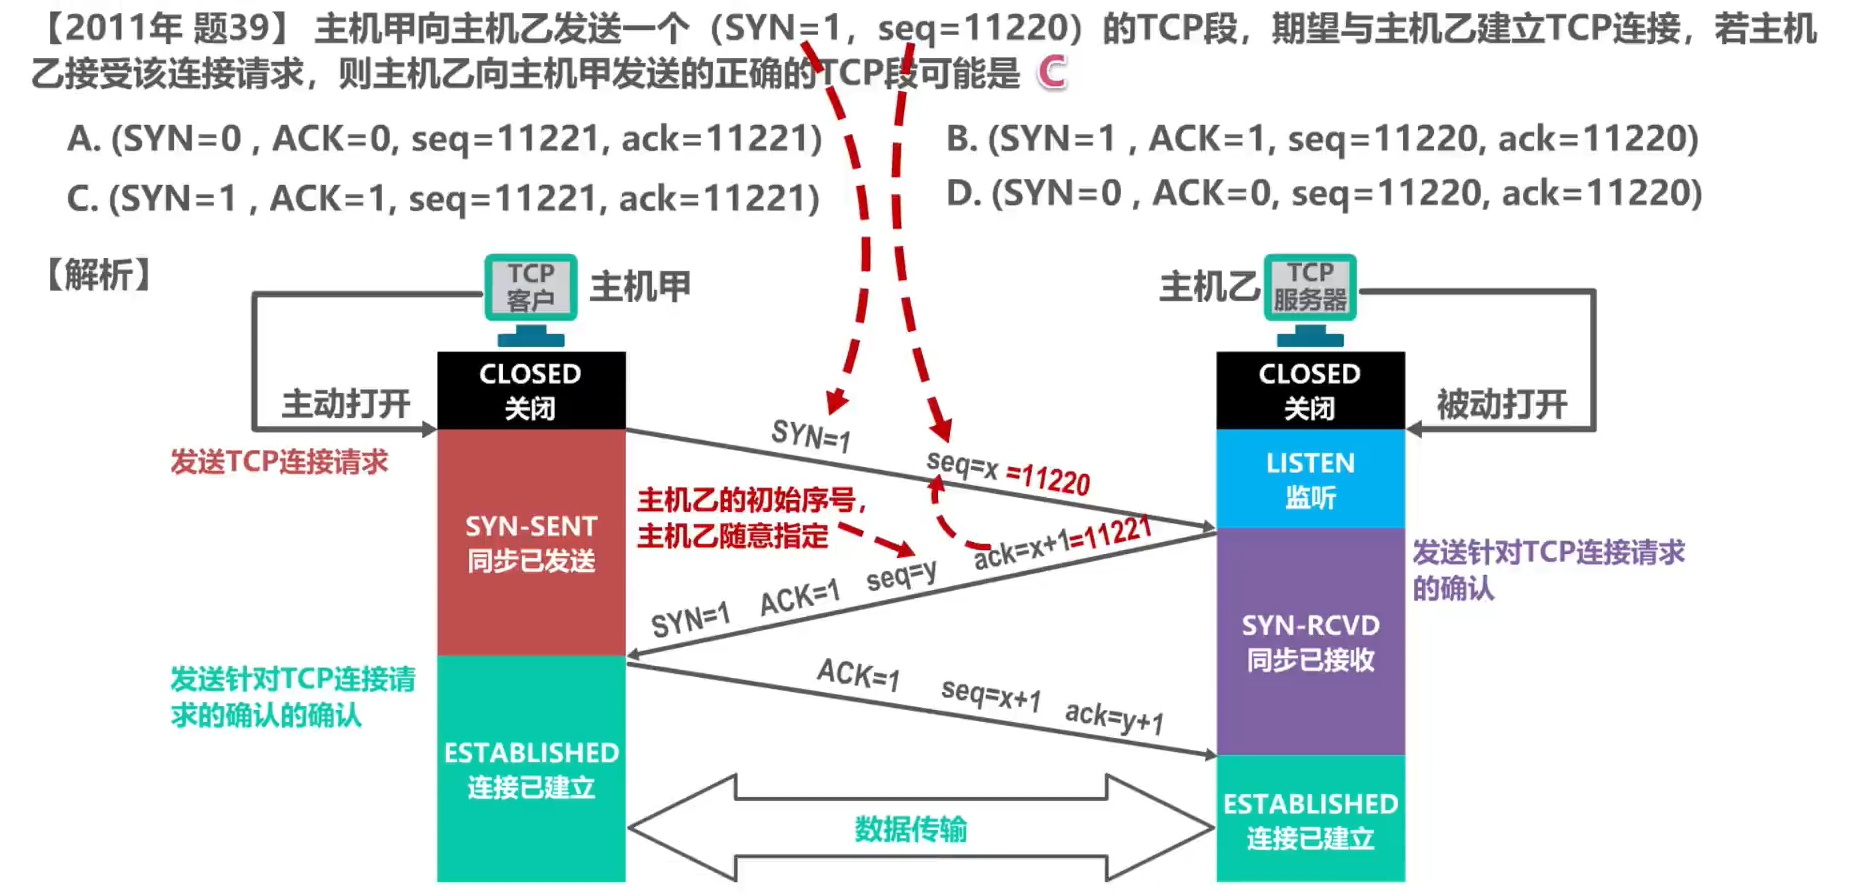
过程
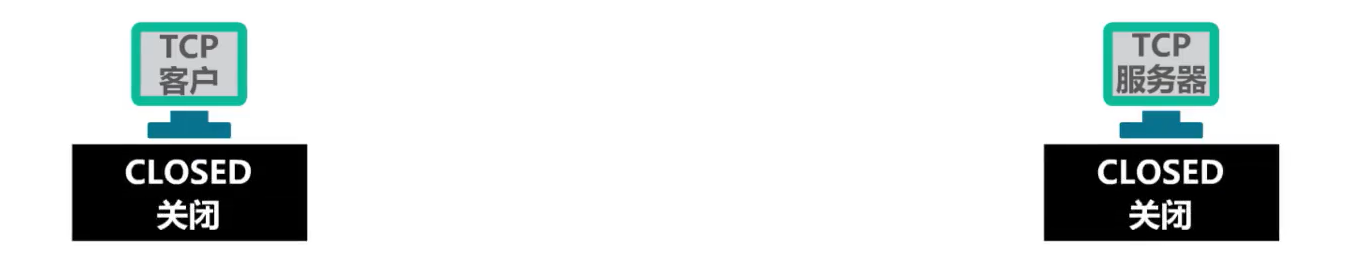
最初两端的TCP进程都处于关闭状态
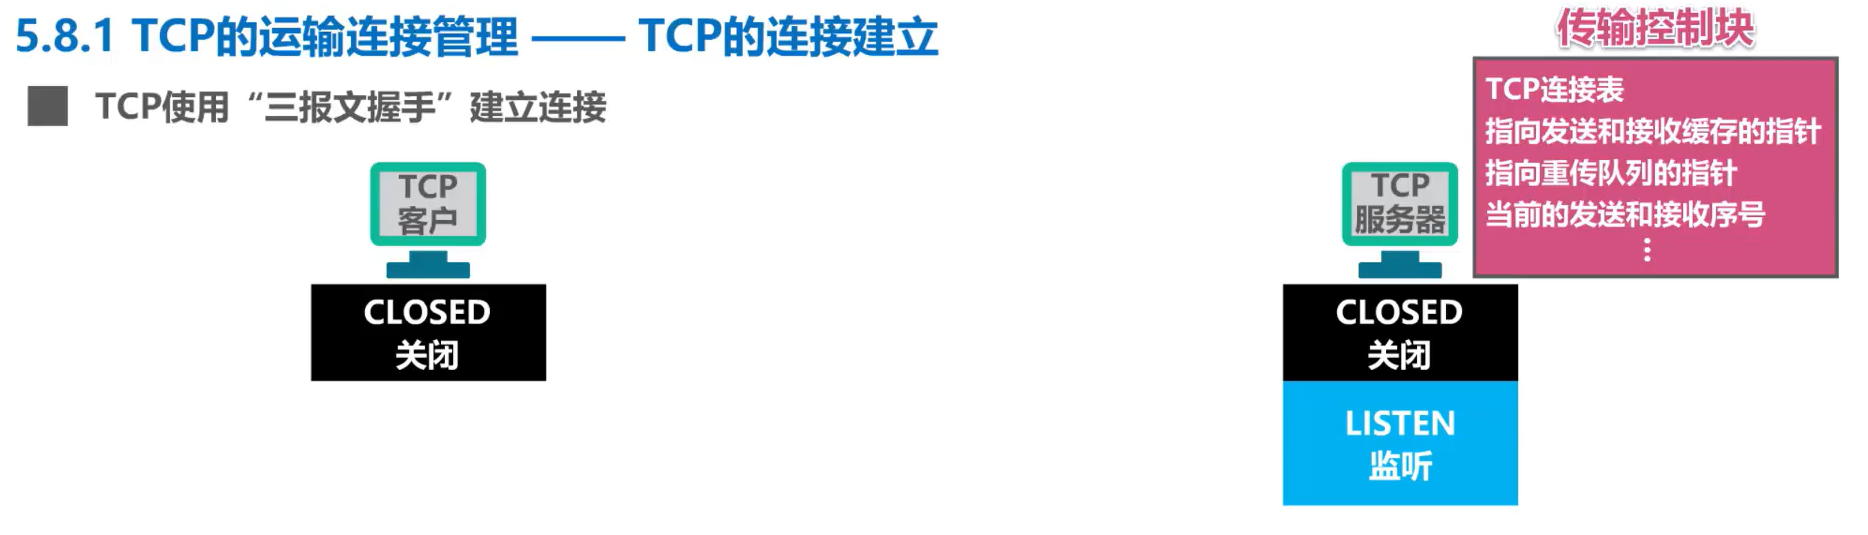
一开始,TCP服务器进程首先创建传输控制块,用来存储TCP连接中的一些重要信息。例如TCP连接表、指向发送和接收缓存的指针、指向重传队列的指针,当前的发送和接收序号等
之后,就准备接受TCP客户端进程的连接请求
此时,TCP服务器进程就进入监听状态,等待TCP客户端进程的连接请求
TCP服务器进程是被动等待来自TCP客户端进程的连接请求,因此成为被动打开连接
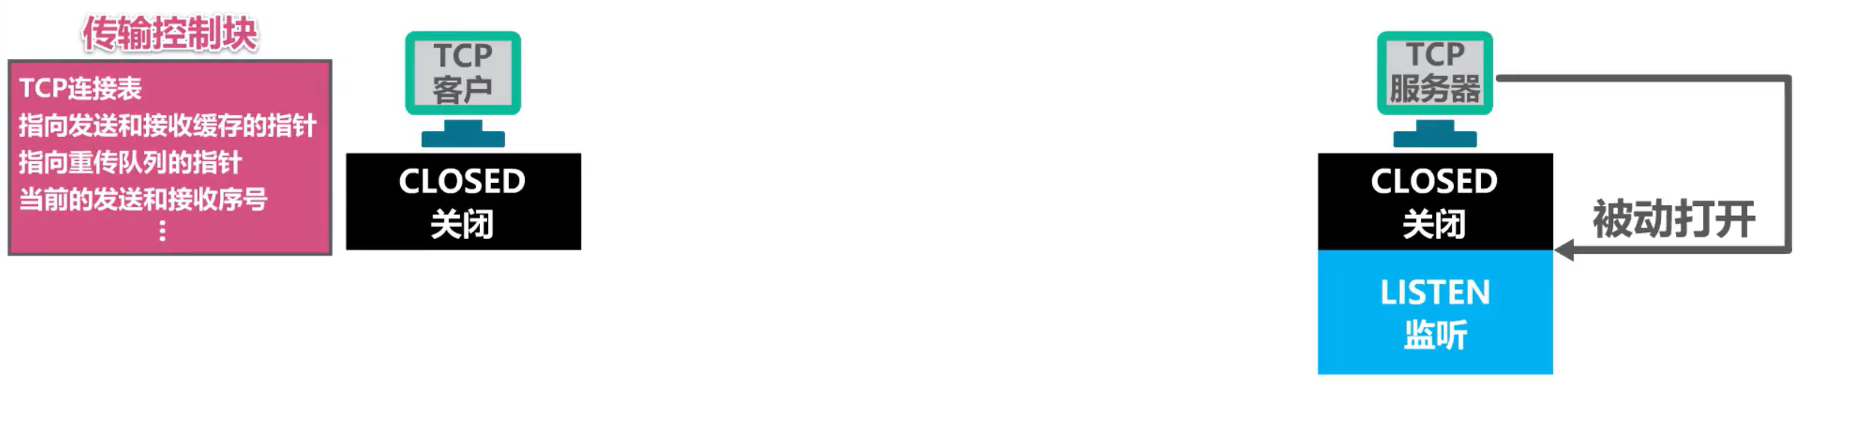
TCP客户进程也是首先创建传输控制块
由于TCP连接建立是由TCP客户端主动发起的,因此称为主动打开连接
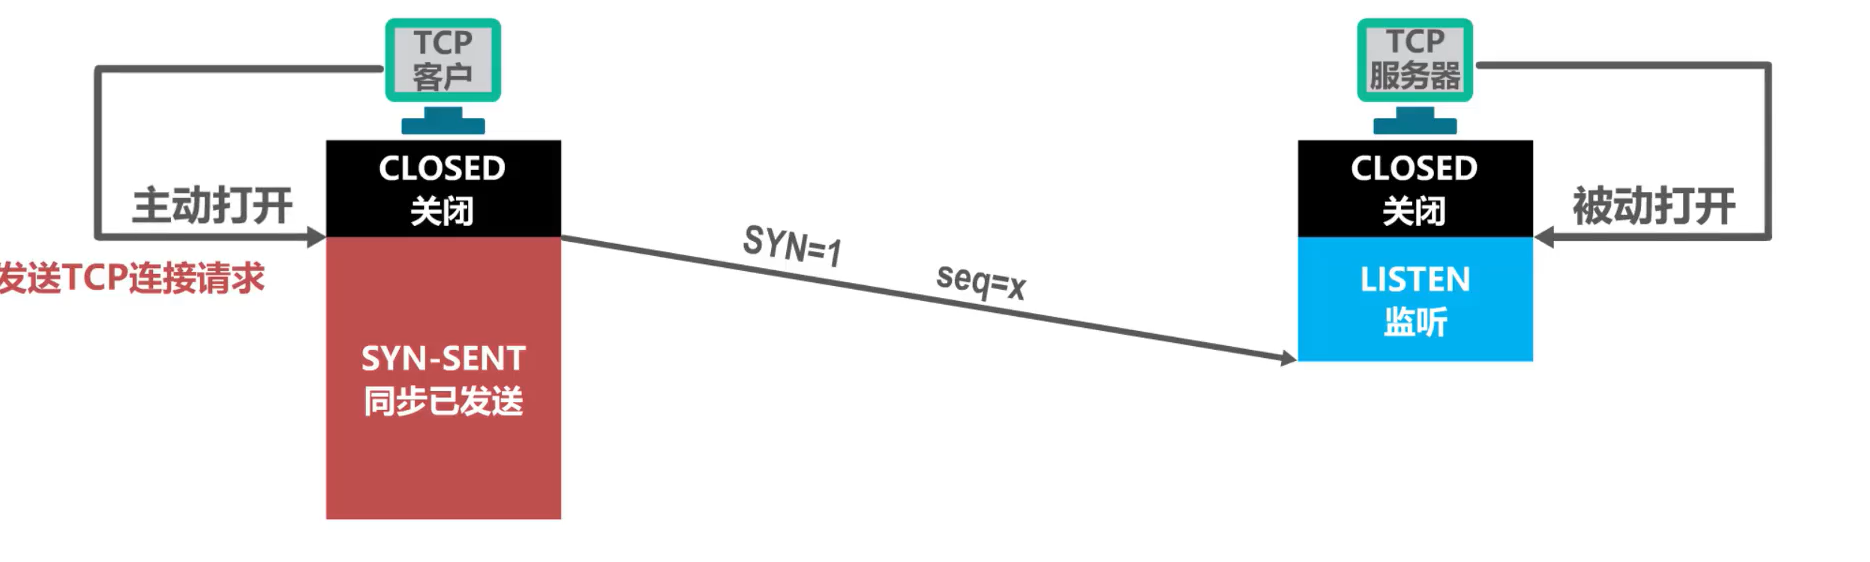
然后,在打算建立TCP连接时,向TCP服务器进程发送TCP连接请求报文段,并进入同步已发送状态
TCP连接请求报文段首部中
- 同步位SYN被设置为1,表明这是一个TCP连接请求报文段
- 序号字段seq被设置了一个初始值x,作为TCP客户端进程所选择的初始序号
请注意:TCP规定SYN被设置为1的报文段不能携带数据,但要消耗掉一个序号
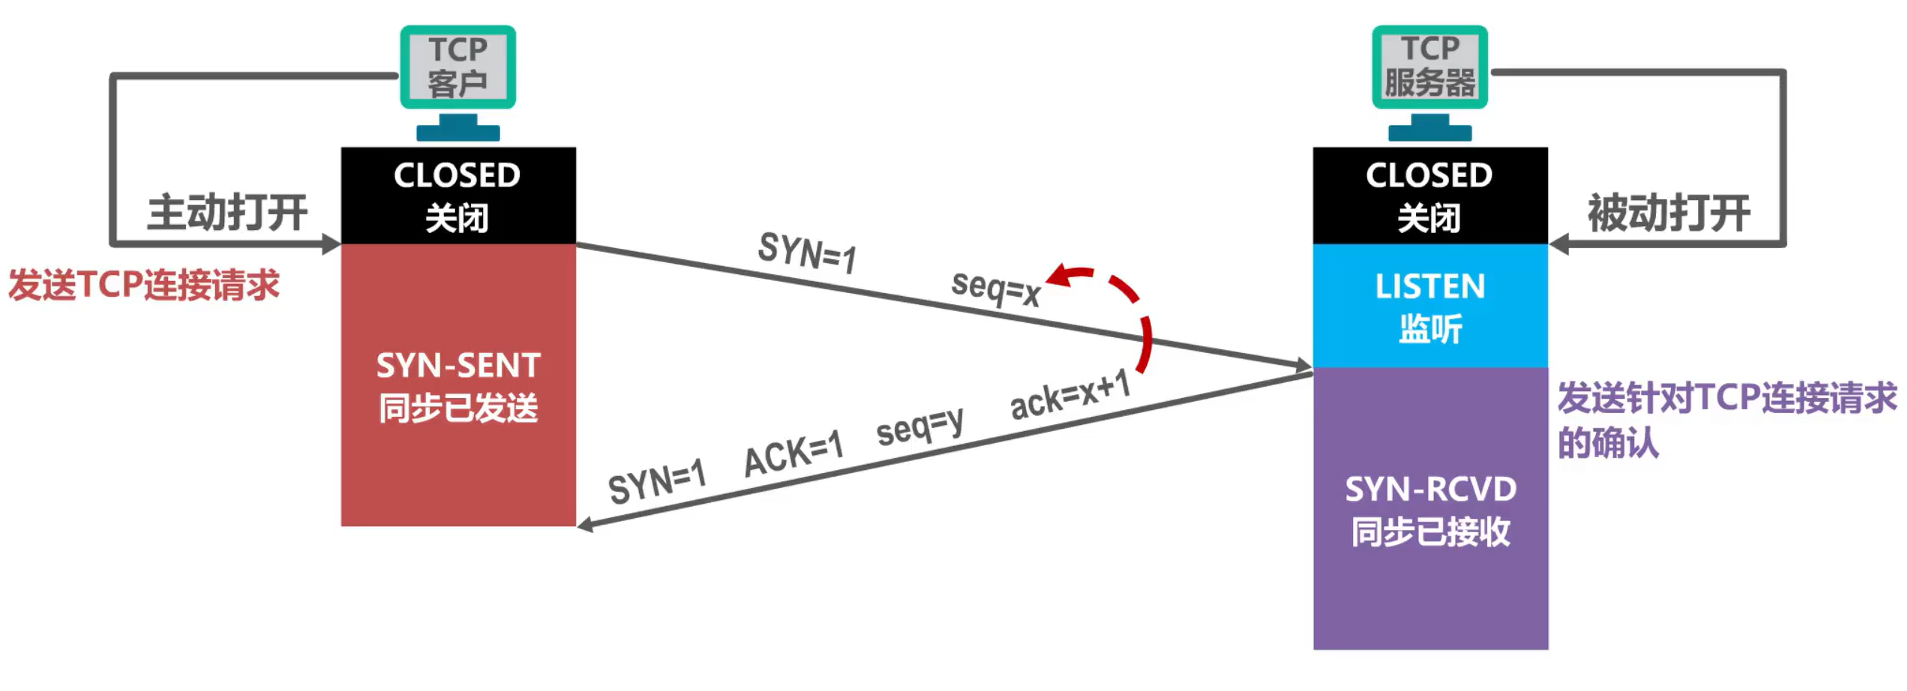
TCP服务器进程收到TCP连接请求报文段后,如果同意建立连接,则向TCP客户进程发送TCP连接请求确认报文段,并进入同步已接收状态
TCP连接请求确认报文段首部中
- 同步位SYN和确认为ACK都设置为1,表明这是一个TCP连接请求确认报文段
- 序号字段seq被设置了一个初始值y,作为TCP服务器进程所选择的初始序号,
- 确认号字段ack的值被设置成了x+1,这是对TCP客户进程所选择的初始序号(seq)的确认
请注意:这个报文段也不能携带数据,因为它是SYN被设置为1的报文段,但同样要消耗掉一个序号
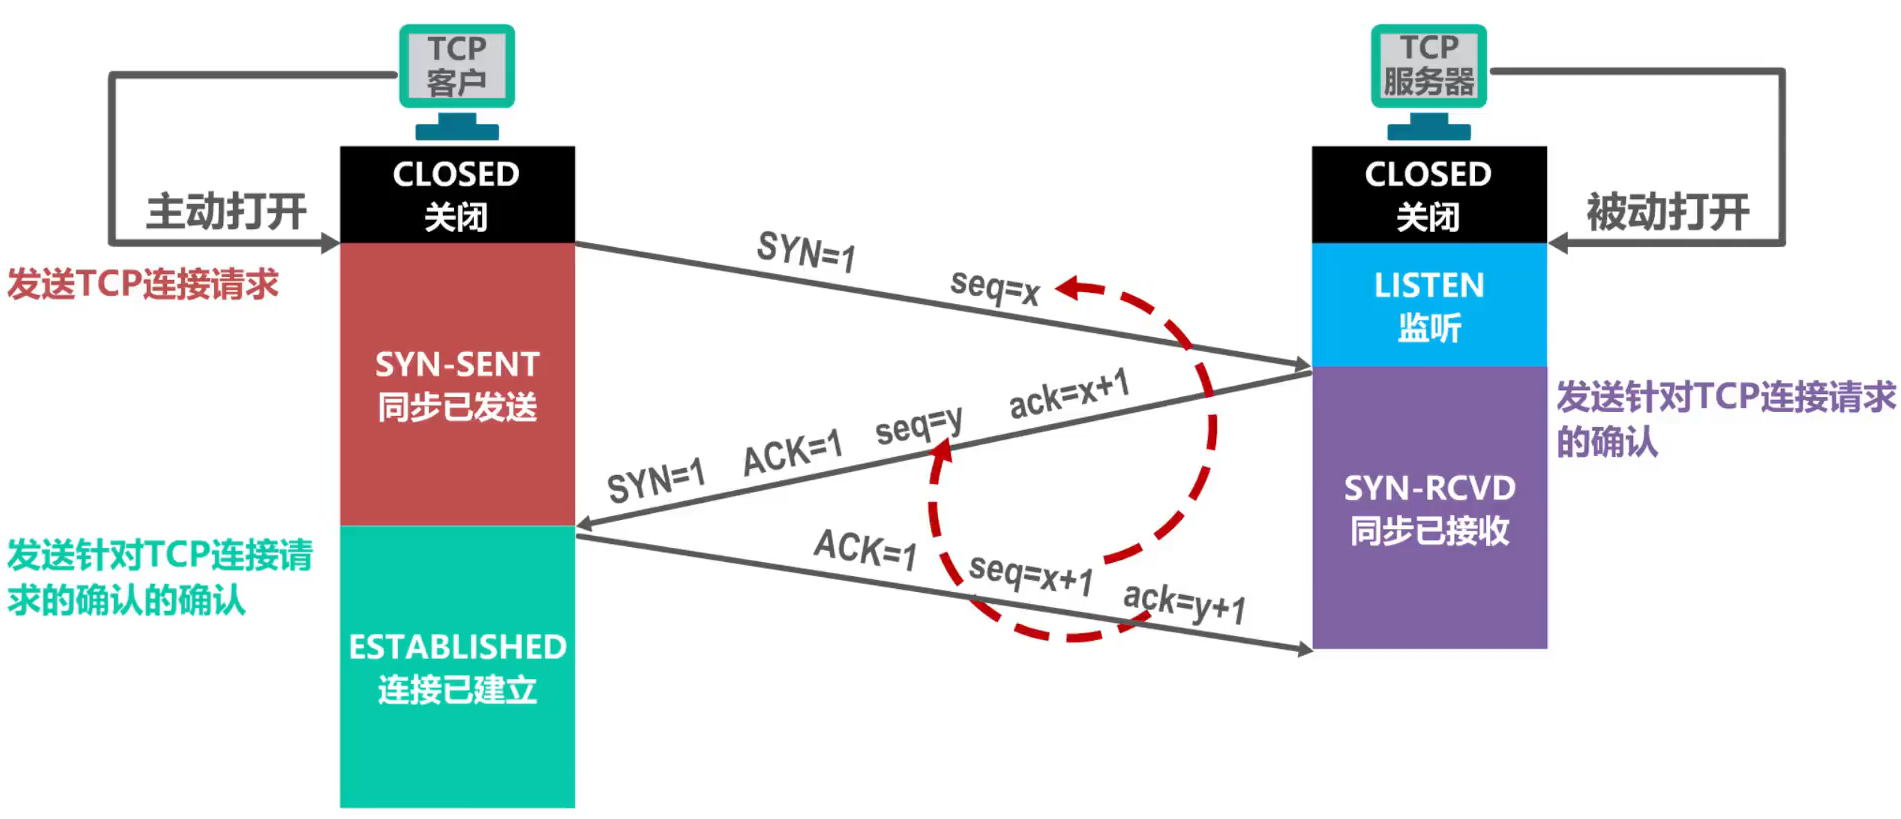
TCP客户进程收到TCP连接请求确认报文段后,还要向TCP服务器进程发送一个普通的TCP确认报文段,并进入连接已连接状态
普通的TCP确认报文段首部中
- 确认位ACK被设置为1,表明这是一个普通的TCP确认报文段
- 序号字段seq被设置为x+1,这是因为TCP客户进程发送的第一个TCP报文段的序号为x,所以TCP客户进程发送的第二个报文段的序号为x+1
- 确认号字段ack被设置为y+1,这是对TCP服务器进程所选择的初始序号的确认
请注意:TCP规定普通的TCP确认报文段可以携带数据,但如果不携带数据,则不消耗序号
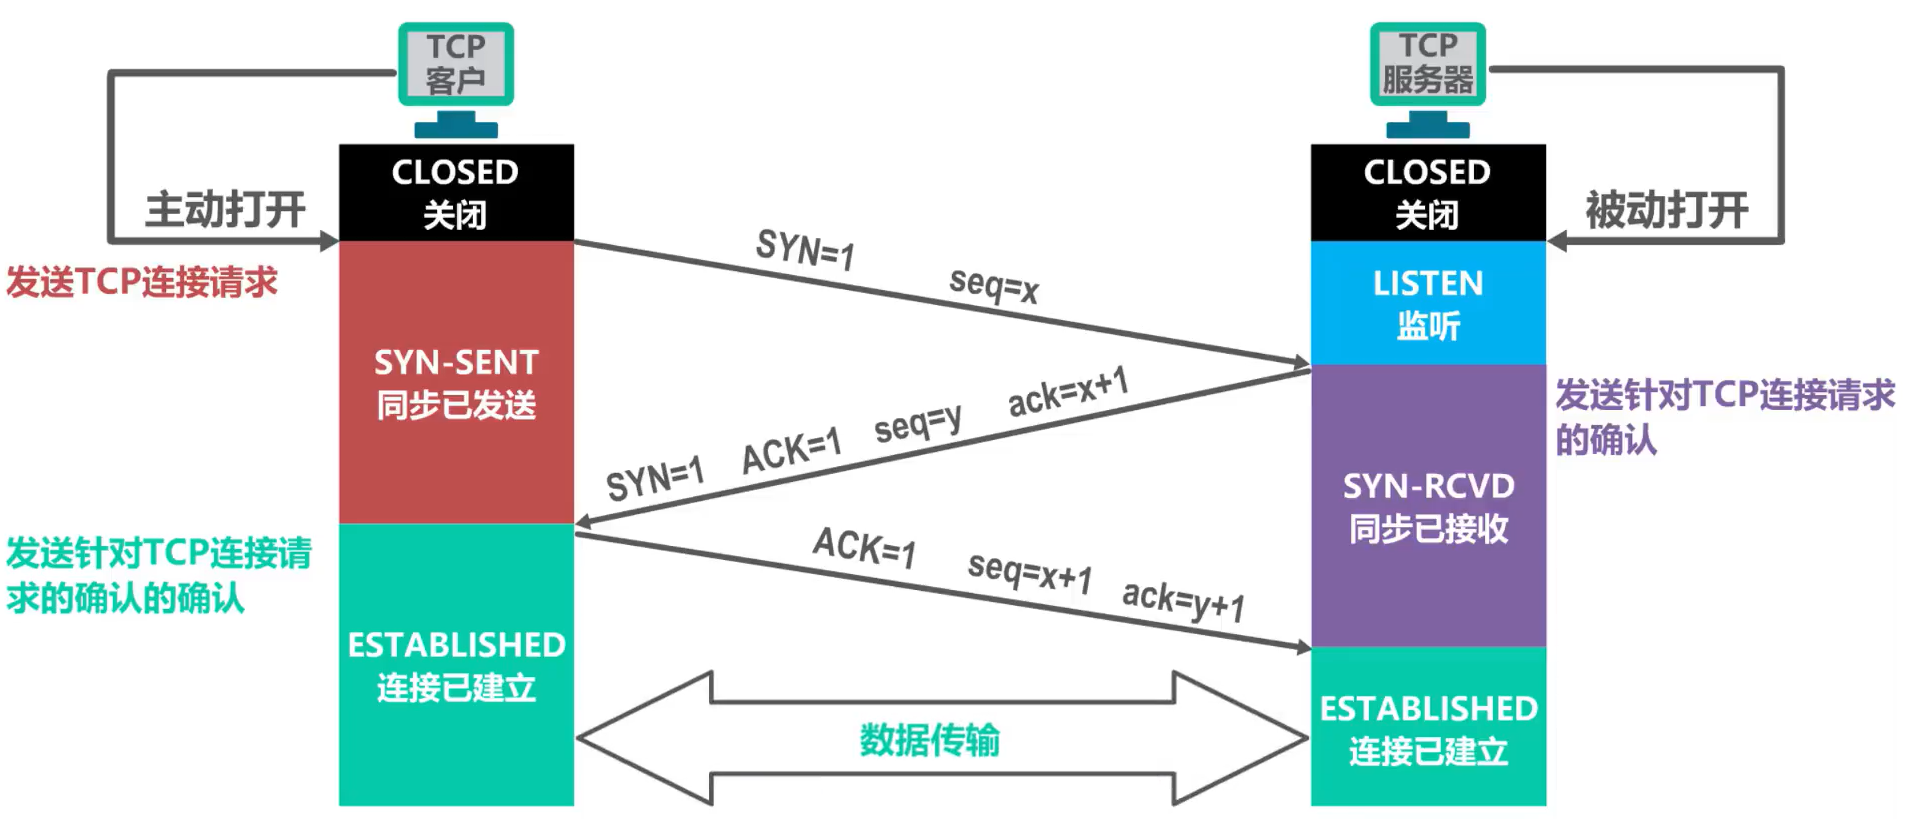
TCP服务器进程收到该确认报文段后也进入连接已建立状态
现在,TCP双方都进入了连接已建立状态,它们可以基于已建立好的TCP连接,进行可靠的数据传输
为什么TCP客户进程最后还要发送一个普通的TCP确认报文段?能否使用“两报文握手”建立连接?
下图实例是“两报文握手”
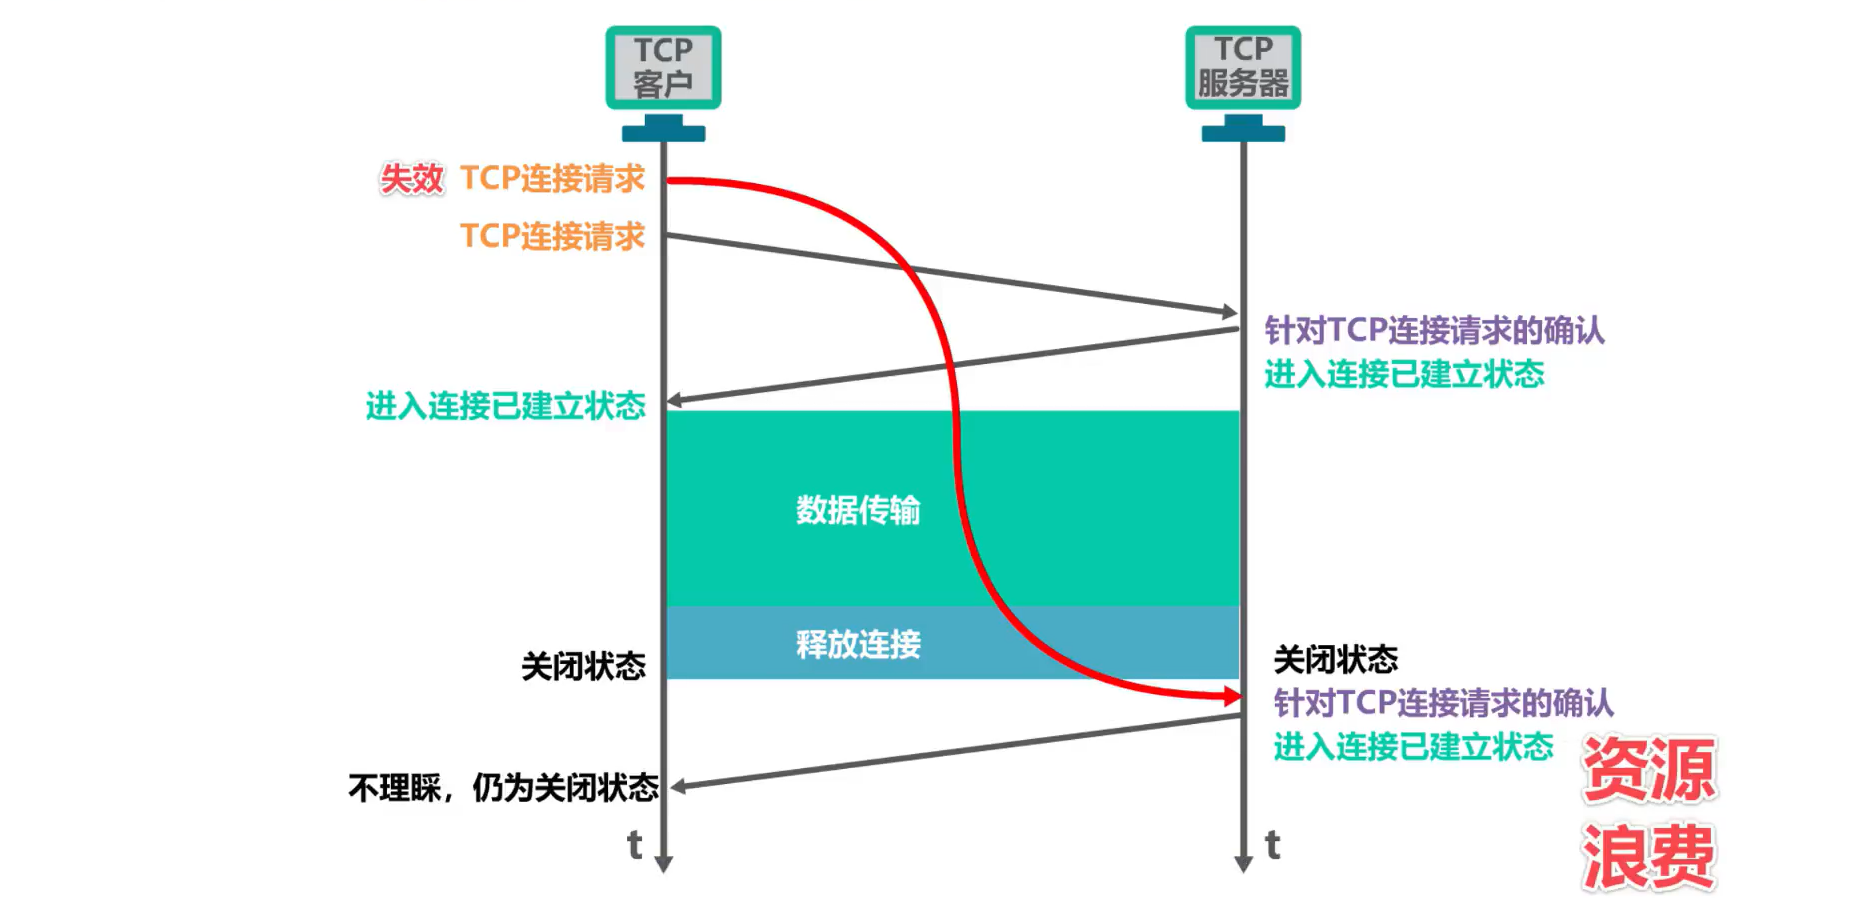
为了防止已经失效的连接请求报文段突然又传到服务端,因而产生错误”,这种情况是:一端(client)A发出去的第一个连接请求报文并没有> 丢失,而是因为某些未知的原因在某个网络节点上发生滞留,导致延迟到连接释放以后的某个时间才到达另一端(server)B。本来这是一个> 早已失效的报文段,但是B收到此失效的报文之后,会误认为是A再次发出的一个新的连接请求,于是B端就向A又发出确认报文,表示同> 意建立连接。如果不采用“三次握手”,那么只要B端发出确认报文就会认为新的连接已经建立了,但是A端并没有发出建立连接的请求,因> 此不会去向B端发送数据,B端没有收到数据就会一直等待,这样B端就会白白浪费掉很多资源。
所以并不多余,这是为了防止已失效的连接请求报文段突然又传送到了TCP服务器,因而导致错误
总结:
TCP的连接建立要解决以下三个问题:
①使TCP双方能够确知对方的存在;
②使TCP双方能够协商一些参数(如最大窗口值、是否使用窗口扩大选项和时间戳选项以及服务质量等);
③使TCP双方能够对运输实体资源(如缓存大小、连接表中的项目等)进行分配。
TCP使用“三报文握手”建立连接
注:
(1)TCP的标准规定,SYN=1的报文段不能携带数据,但要消耗掉一个序号。
(2)TCP的标准规定,普通的确认报文段如果不携带数据,则不消耗序号。
TCP的连接释放
- TCP 连接释放过程比较复杂。
- 数据传输结束后,通信的双方都可发出释放连接的通知。
- TCP 连接释放过程是四报文握手。
过程
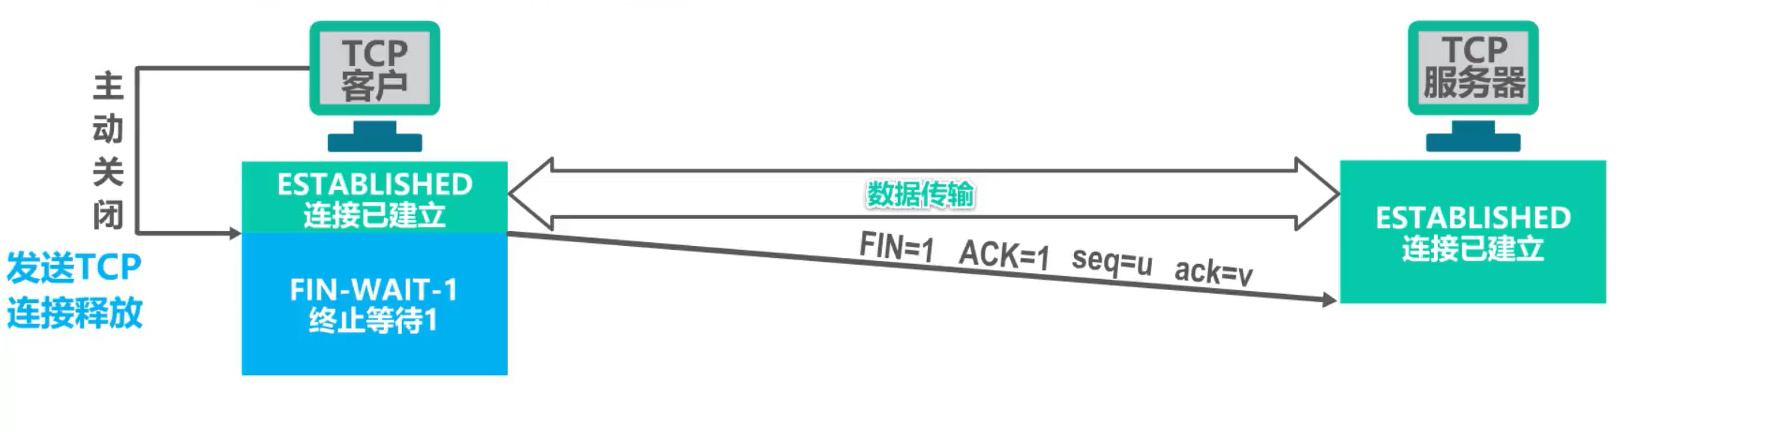
现在TCP客户进程和TCP服务器进程都处于连接已建立状态
TCP客户进程的应用进程通知其主动关闭TCP连接
TCP客户进程会发送TCP连接释放报文段,并进入终止等待1状态
TCP连接释放报文段首部中
- 终止位FIN和确认为ACK的值都被设置为1,表明这是一个TCP连接释放报文段,同时也对之前收到的报文段进行确认
- 序号seq字段的值设置为u,它等于TCP客户进程之前已传送过的数据的最后一个字节的序号加1
- 确认号ack字段的值设置为v,它等于TCP客户进程之前已收到的、数据的最后一个字节的序号加1
请注意:TCP规定终止位FIN等于1的报文段即使不携带数据,也要消耗掉一个序号
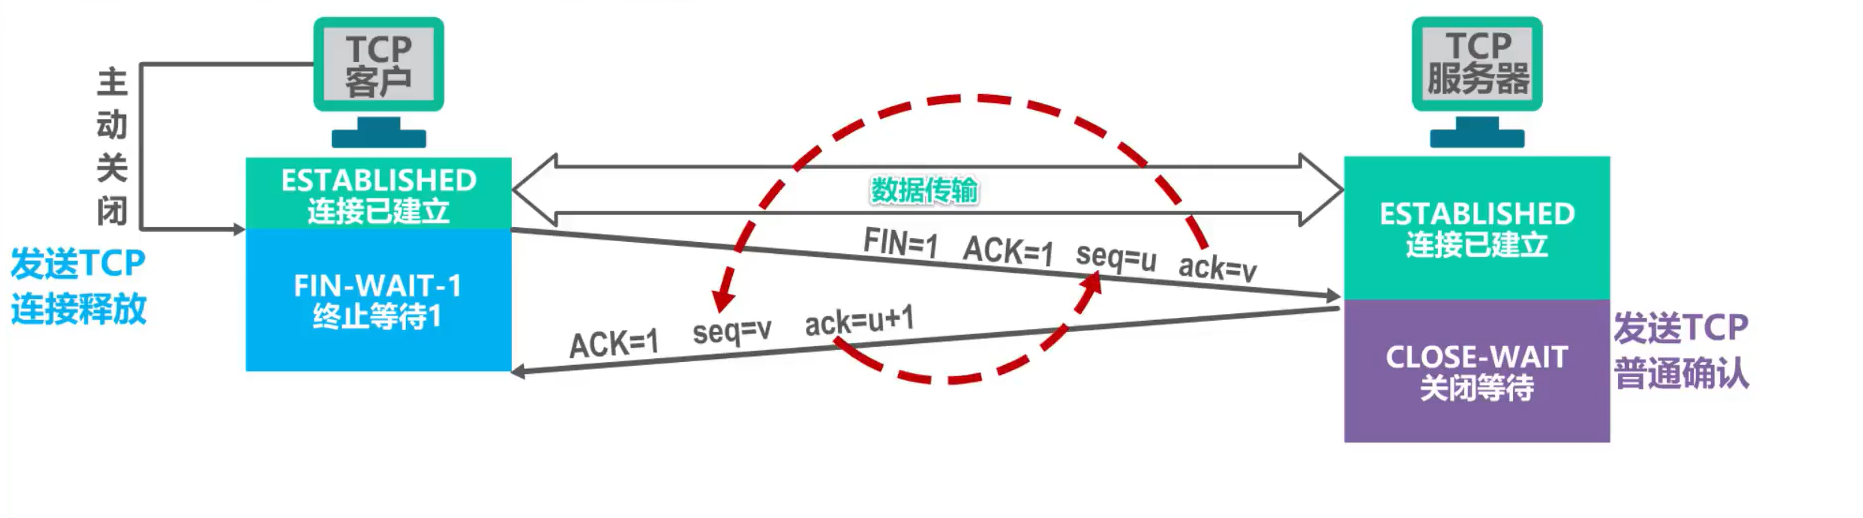
TCP服务器进程收到TCP连接释放报文段后,会发送一个普通的TCP确认报文段并进入关闭等待状态
普通的TCP确认报文段首部中
- 确认位ACK的值被设置为1,表明这是一个普通的TCP确认报文段
- 序号seq字段的值设置为v,它等于TCP服务器进程之前已传送过的数据的最后一个字节的序号加1,这也与之前收到的TCP连接释放报文段中的确认号匹配
- 确认号ack字段的值设置为u+1,这是对TCP连接释放报文段的确认
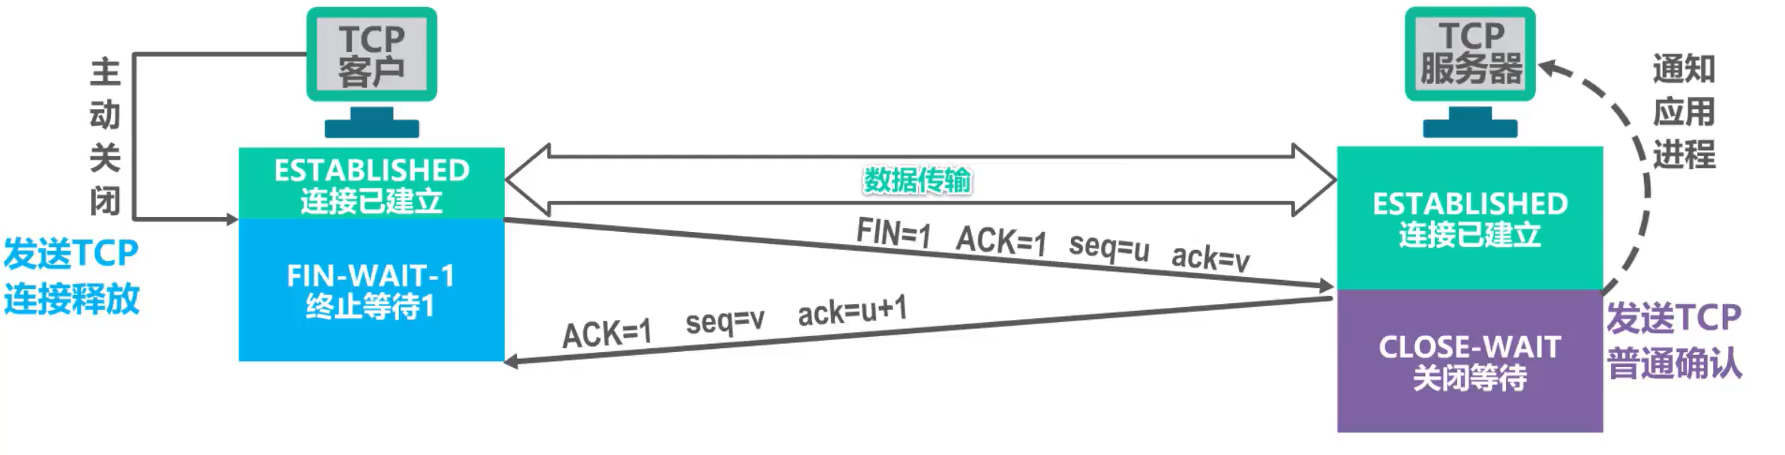
TCP服务器进程应该通知高层应用进程,TCP客户进程要断开与自己的TCP连接
此时,从TCP客户进程到TCP服务器进程这个方向的连接就释放了
这时的TCP连接属于半关闭状态,也就是TCP客户进程已经没有数据要发送了
但如果TCP服务器进程还有数据要发送,TCP客户进程仍要接收,也就是说从TCP服务器进程到TCP客户进程这个方向的连接并未关闭
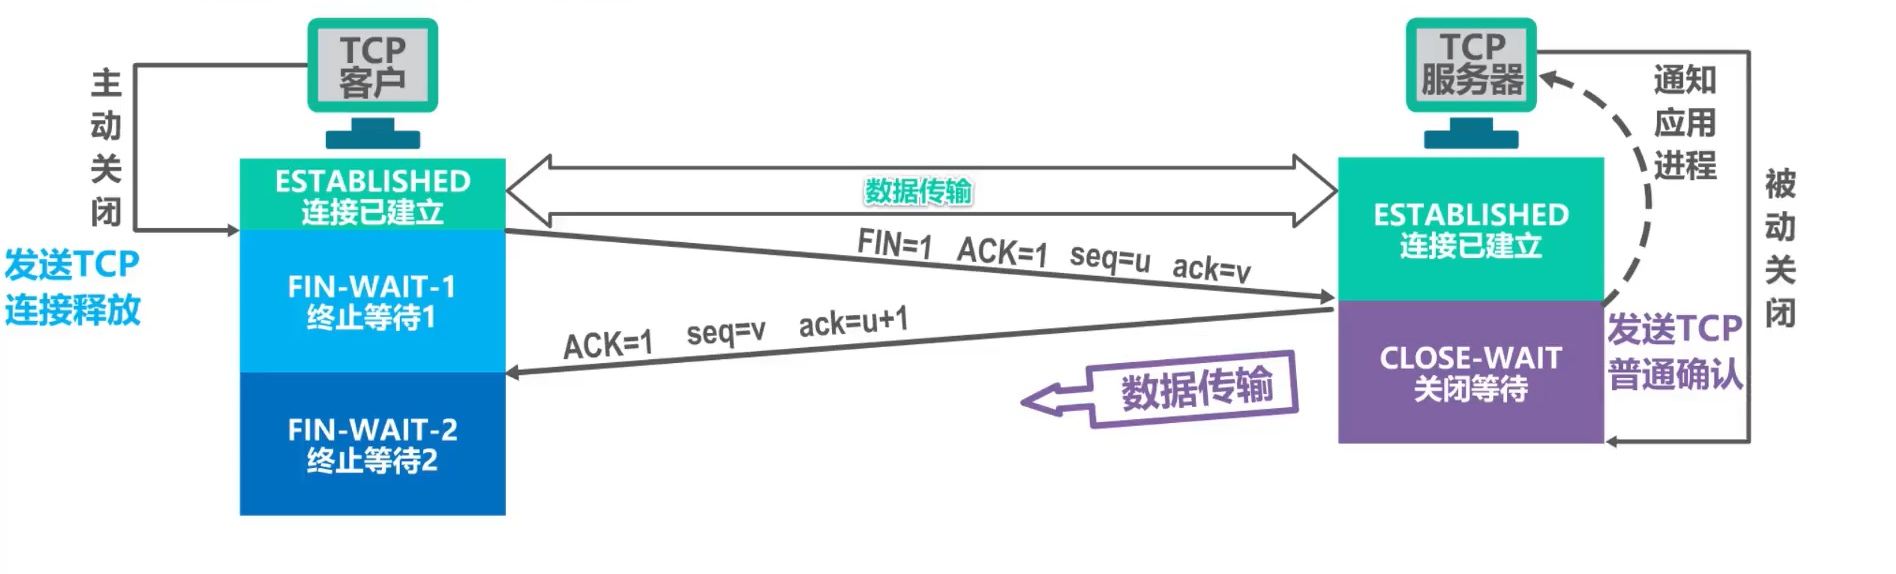
TCP客户进程收到TCP确认报文段后就进入终止等待2状态,等待TCP服务器进程发出的TCP连接释放报文段
若使用TCP服务器进程的应用进程已经没有数据要发送了,应用进程就通知其TCP服务器进程释放连接
由于TCP连接释放是由TCP客户进程主动发起的,因此TCP服务器进程对TCP连接的释放称为被动关闭连接
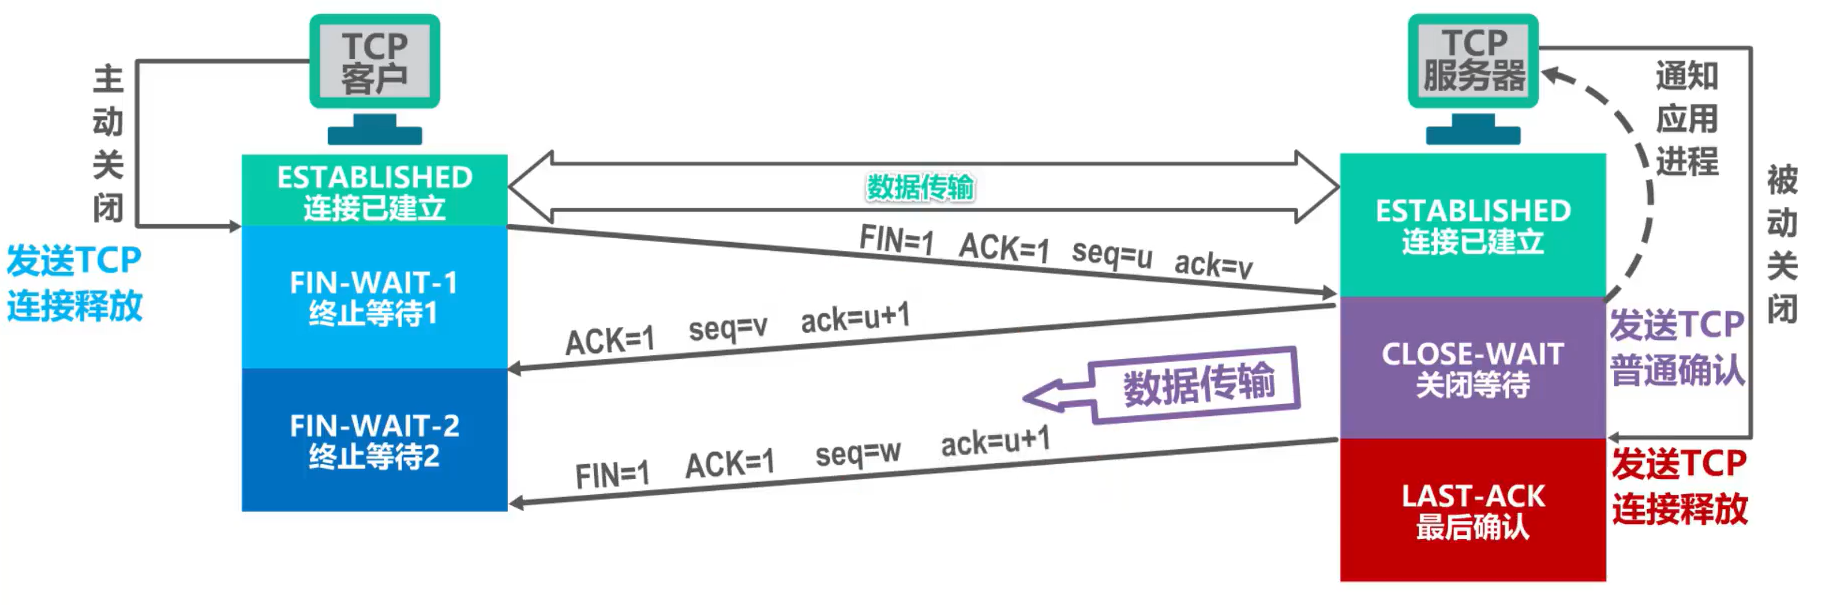
TCP服务器进程发送TCP连接释放报文段并进入最后确认状态
该报文段首部中
- 终止位FIN和确认位ACK的值都被设置为1,表明这是一个TCP连接释放报文段,同时也对之前收到的报文段进行确认
- 序号seq字段的值为w,这是因为在半关闭状态下,TCP服务器进程可能又发送
- 确认号ack字段的值为u+1,这是对之前收到的TCP连接释放报文段的重复确认
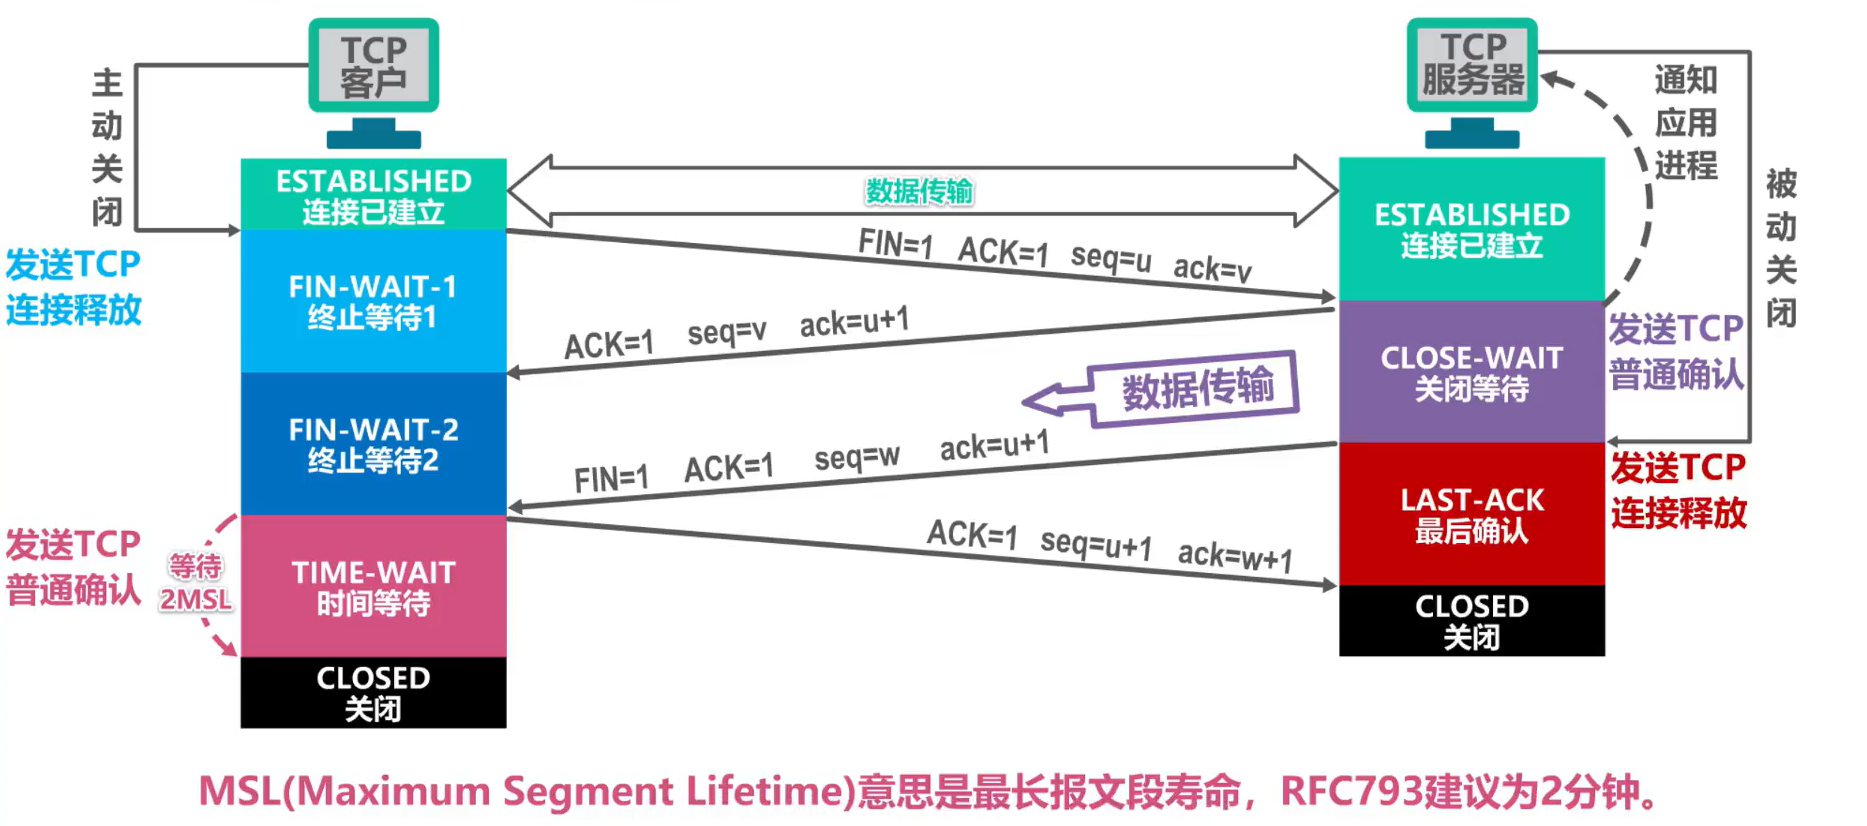
TCP客户进程收到TCP连接释放报文段后,必须针对该报文段发送普通的TCP确认报文段,之后进入时间等待状态
该报文段首部中
- 确认为ACK的值被设置为1,表明这是一个普通的TCP确认报文段
- 序号seq字段的值设置为u+1,这是因为TCP客户进程之前发送的TCP连接释放报文段虽然不携带数据,但要消耗掉一个序号
- 确认号ack字段的值设置为w+1,这是对所收到的TCP连接释放报文段的确认
TCP服务器进程收到该报文段后就进入关闭状态,而TCP客户进程还要进过2MSL后才能进入关闭状态
TCP客户进程在发送完最后一个确认报文后,为什么不直接进入关闭状态?而是要进入时间等待状态?
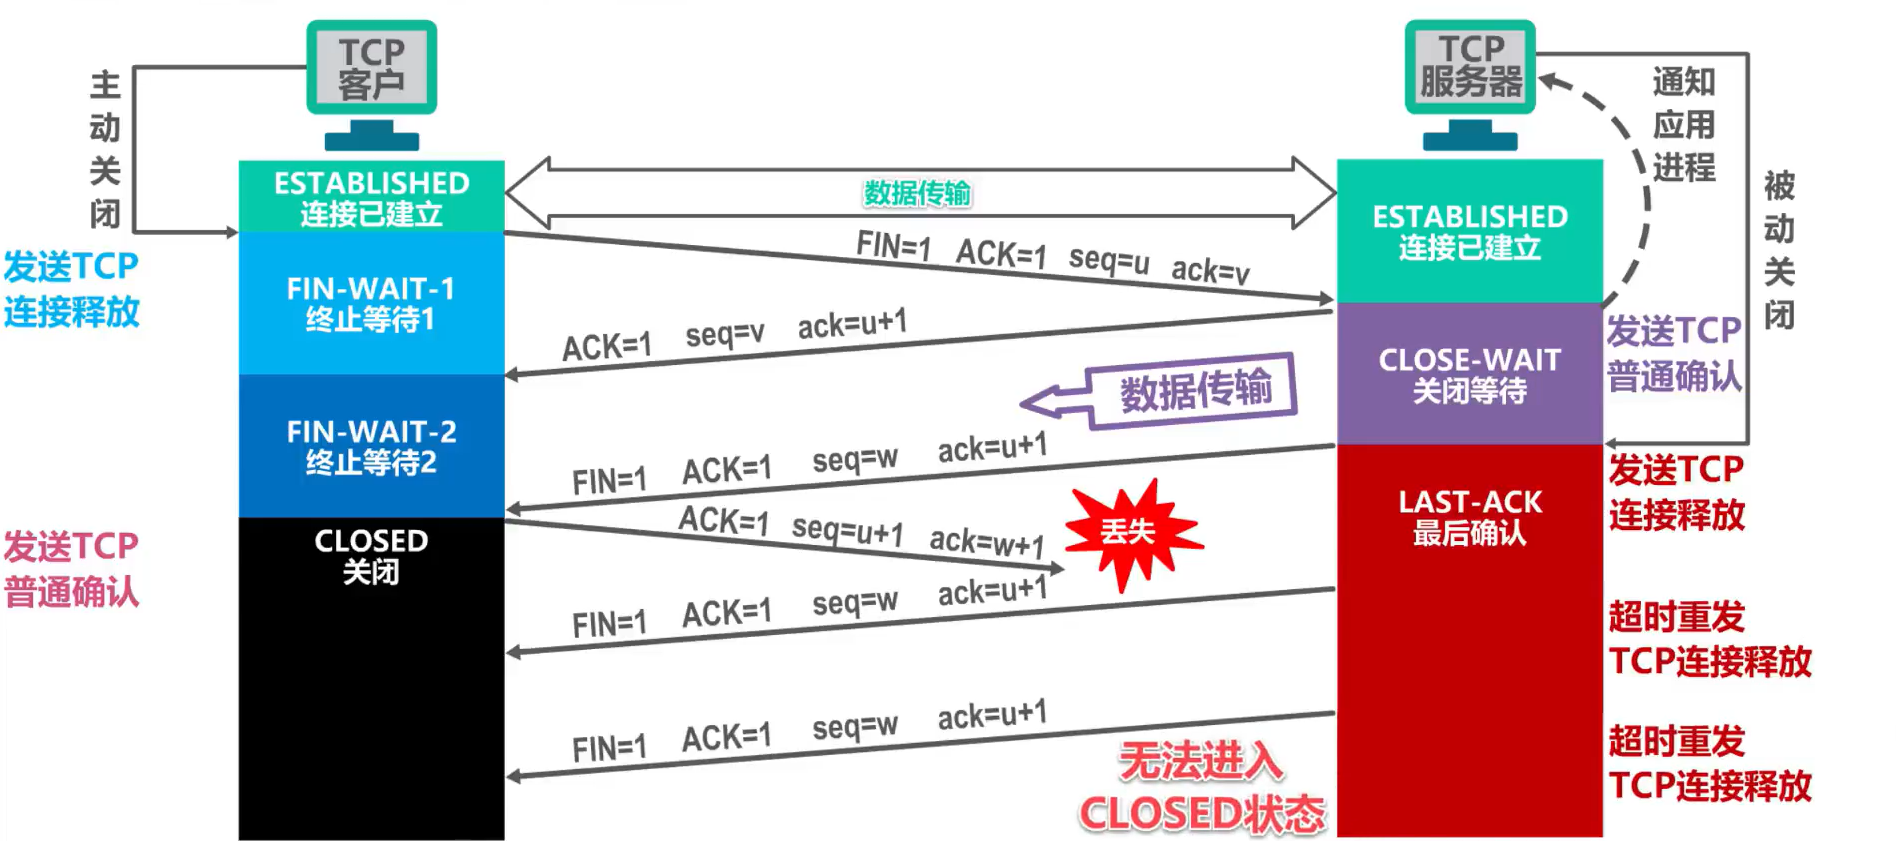
因为时间等待状态以及处于该状态2MSL时长,可以确保TCP服务器进程可以收到最后一个TCP确认报文段而进入关闭状态
另外,TCP客户进程在发送完最后一个TCP确认报文段后,在经过2MSL时长,就可以使本次连接持续时间内所产生的所有报文段都从网络中消失,这样就可以使下一个新的TCP连接中,不会出现旧连接中的报文段
TCP保活计时器的作用:
TCP双方已经建立了连接,后来,TCP客户进程所在的主机突然出现了故障,TCP服务器进程以后就不能再收到TCP客户进程发来的数据;因此,应当有措施使TCP服务器进程不要再白白等待下去:
TCP服务器进程每收到一次TCP客户进程的数据,就重新设置并启动保活计时器(2小时定时)。
若保活计时器定时周期内未收到TCP客户进程发来的数据,则当保活计时器到时后,TCP服务器进程就向TCP客户进程发送一个探测报文段,以后则每隔75秒钟发送一次。若一连发送10个探测报文段后仍无TCP客户进程的响应,TCP服务器进程就认为TCP客户进程所在主机出了故障,接着就关闭这个连接。
TCP报文段的首部格式
源端口和目的端口
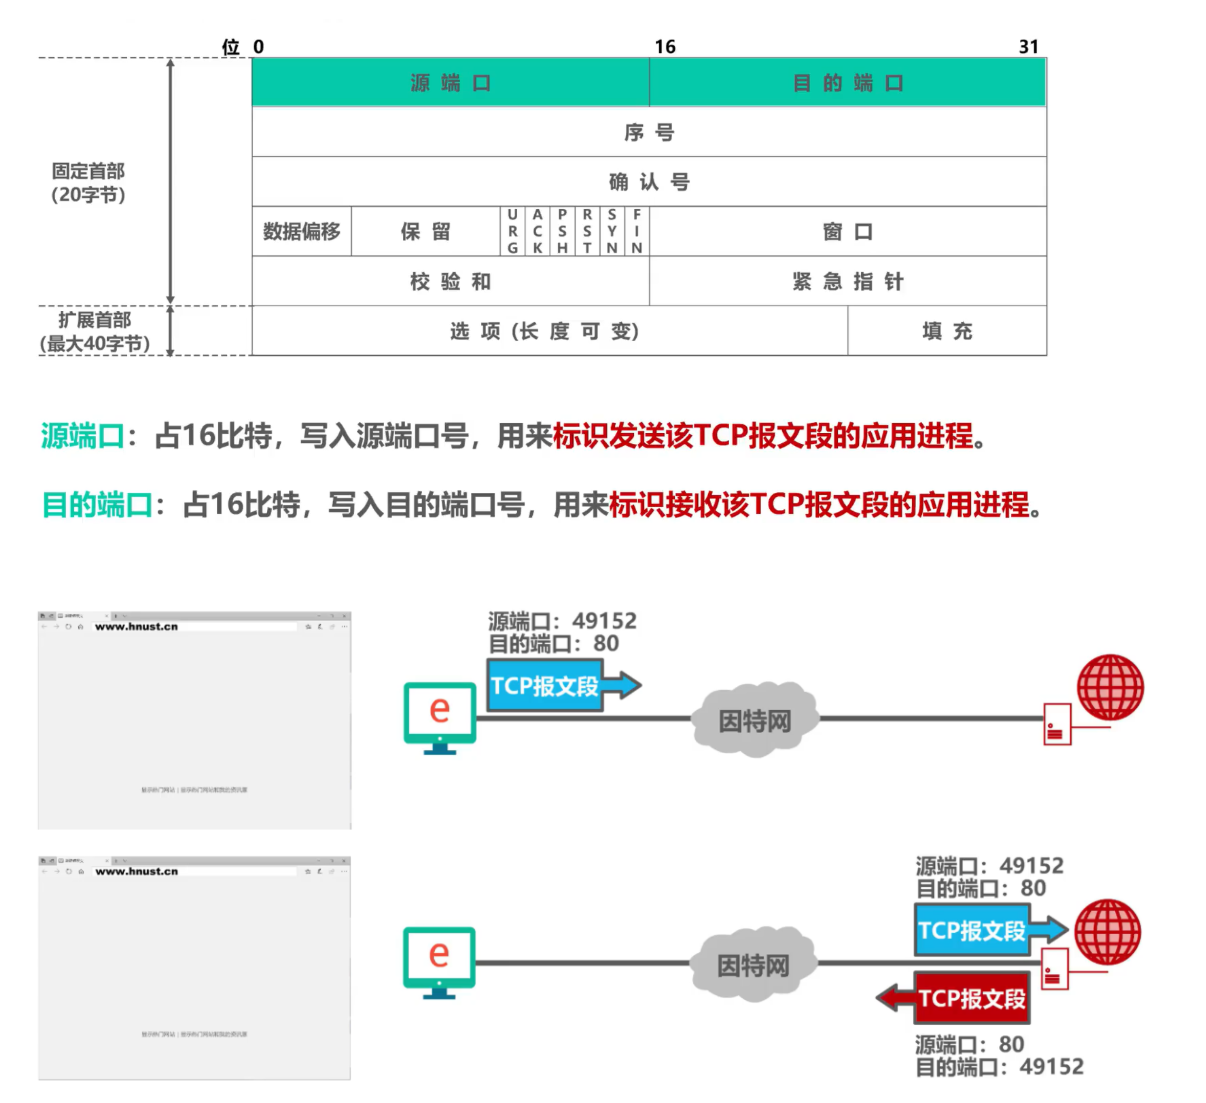
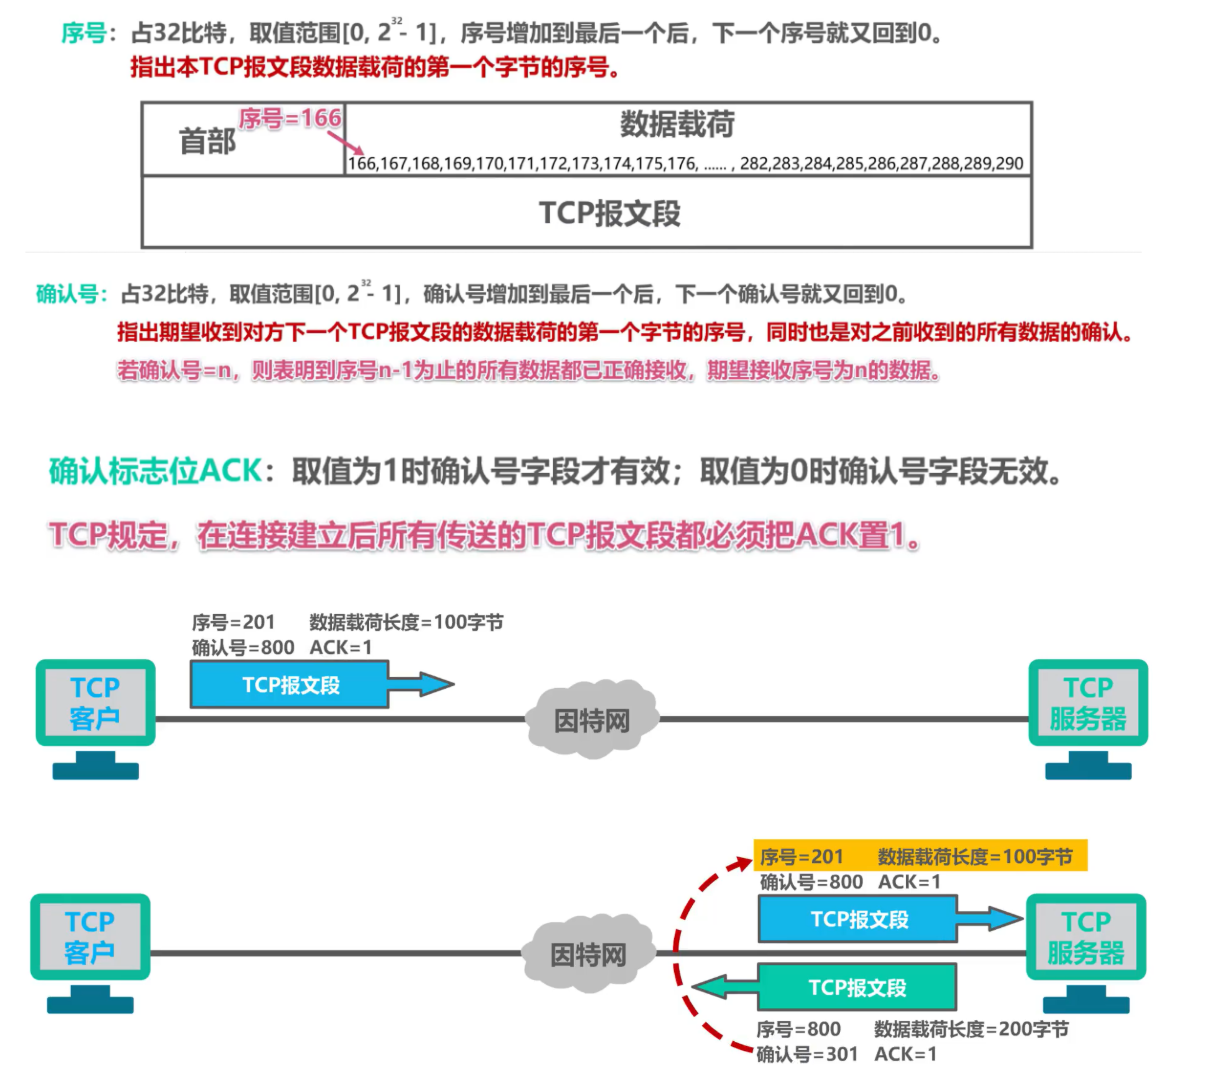
序号、确认号和确认标志位
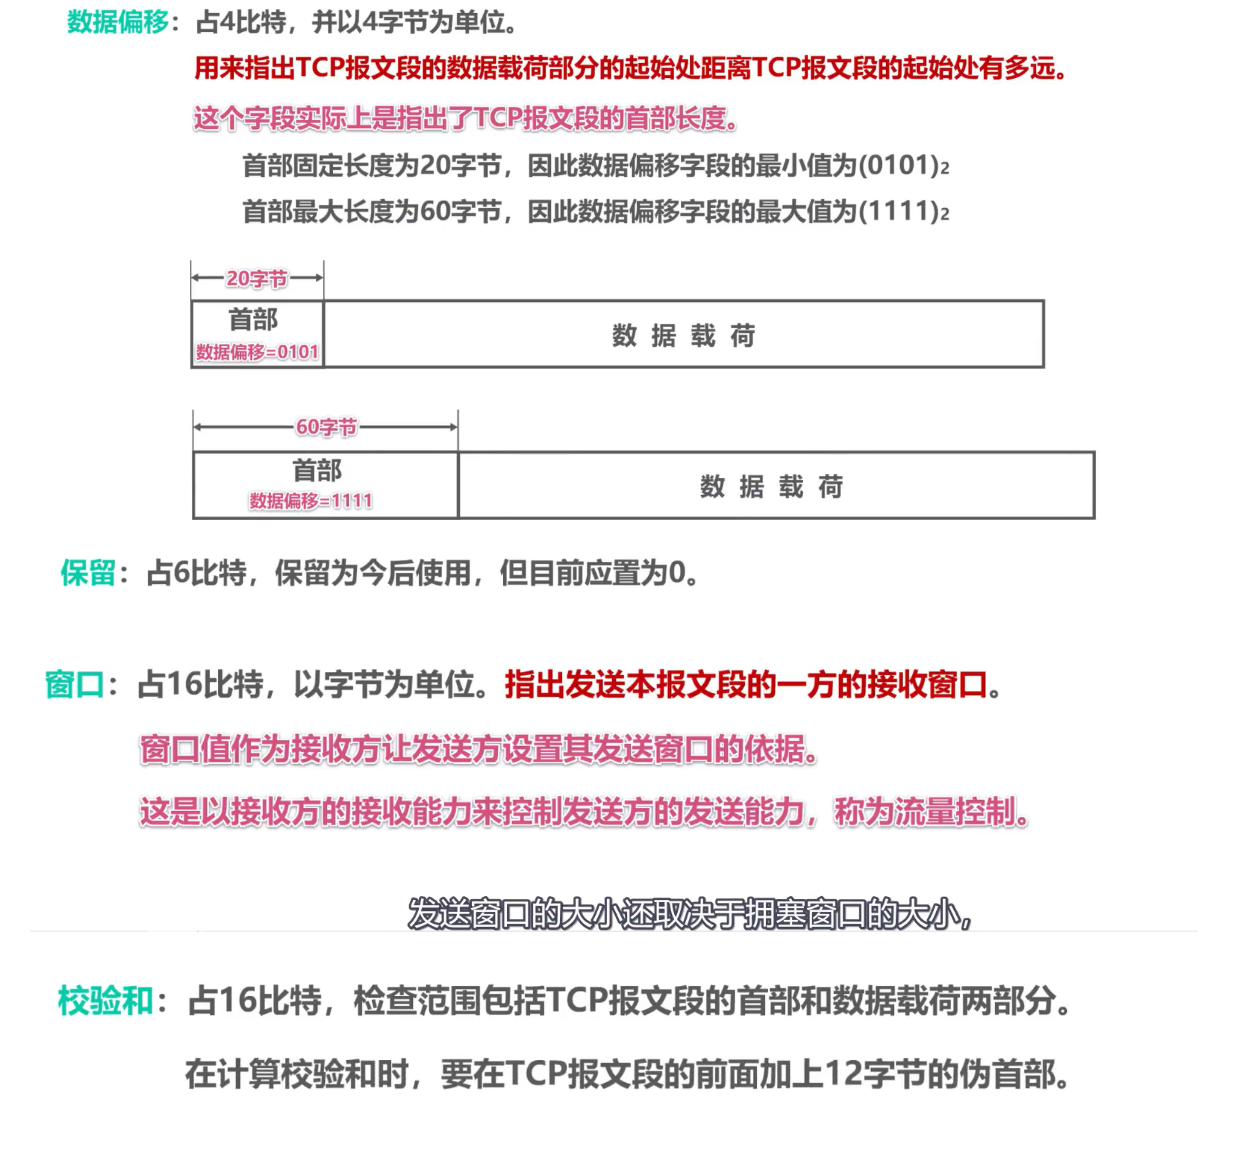
数据偏移、保留、窗口和校验和
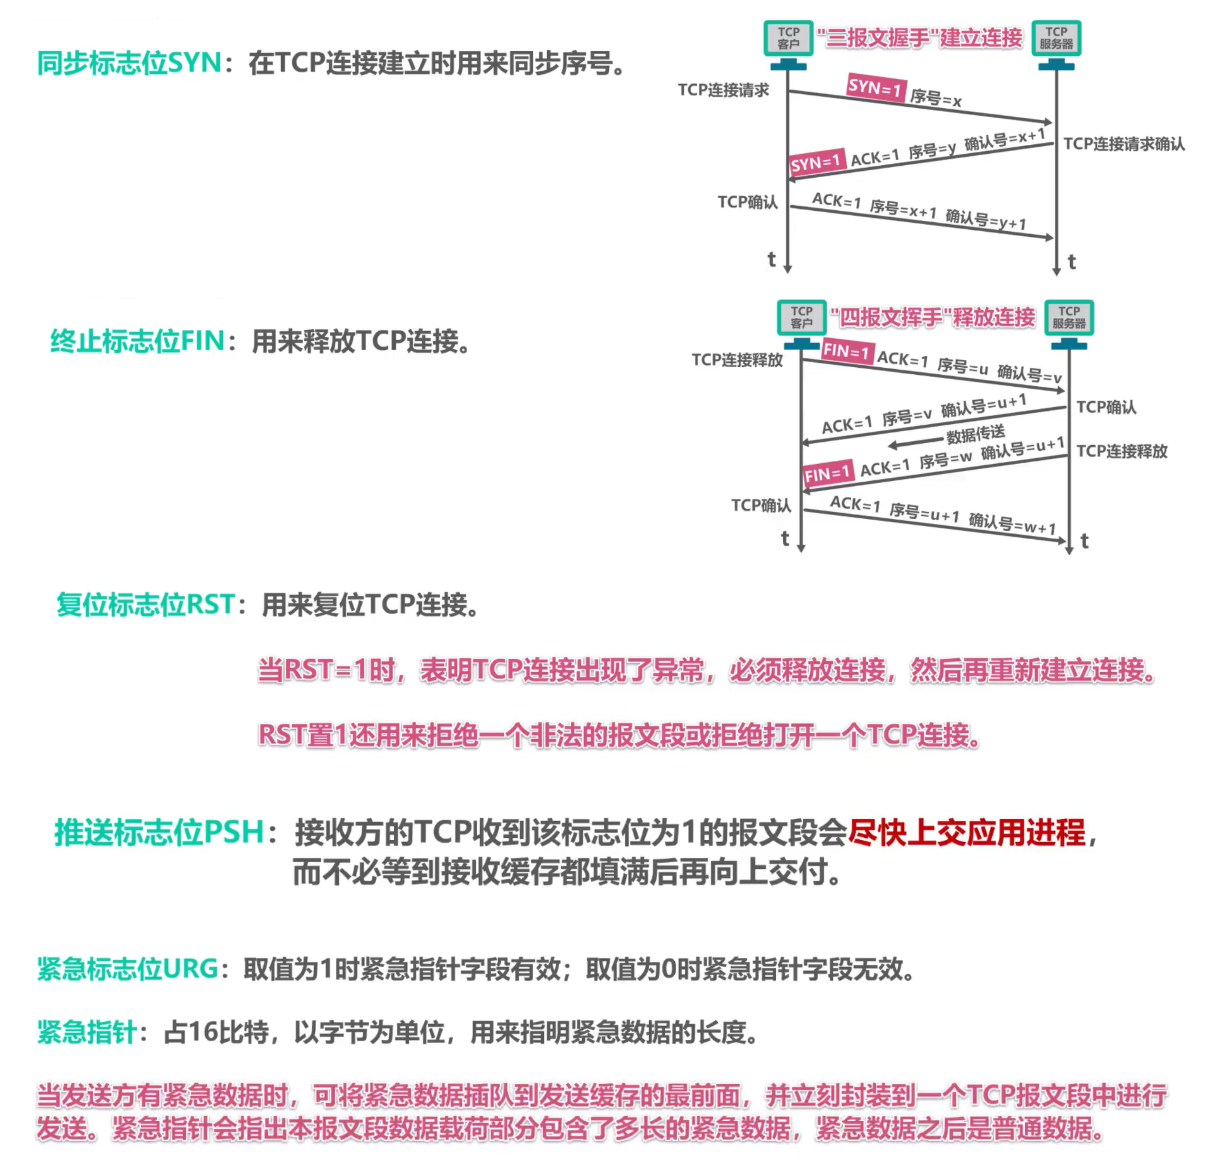
同步标志位、终止标志位、复位标志位、推送标志位、紧急标志位和紧急指针
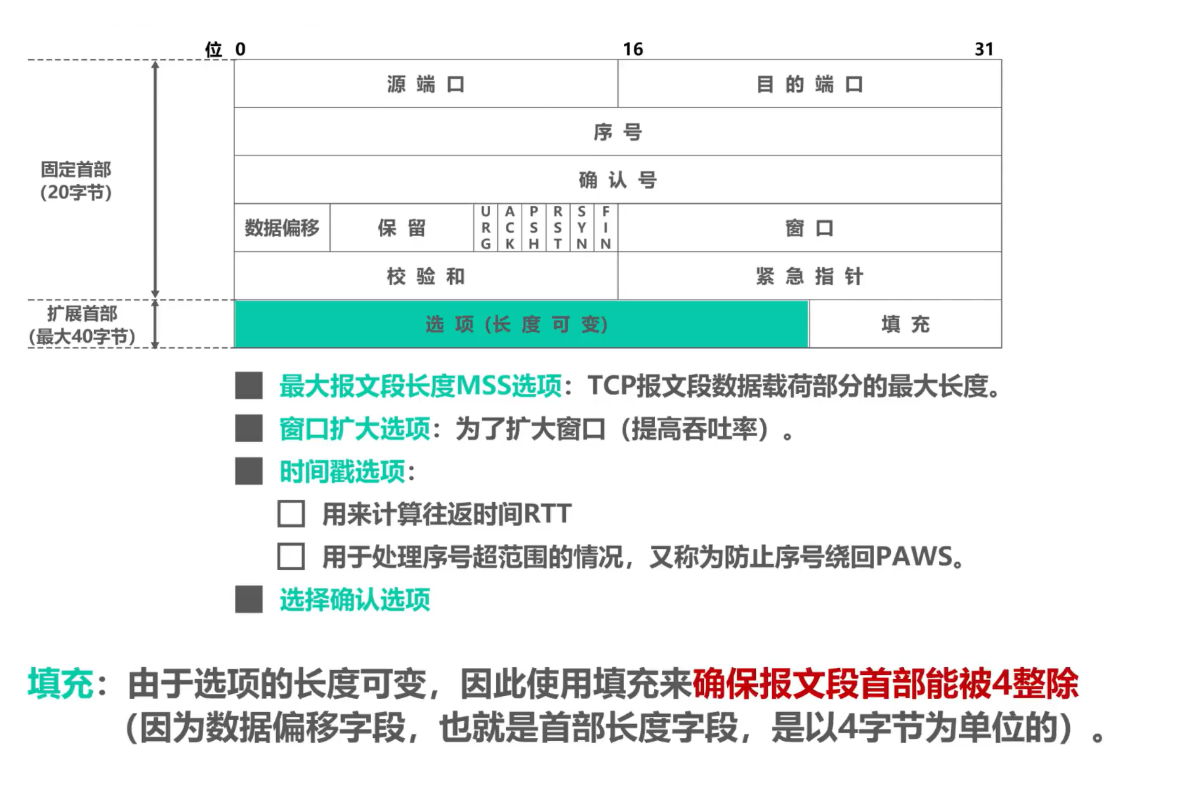
选项和填充
习题
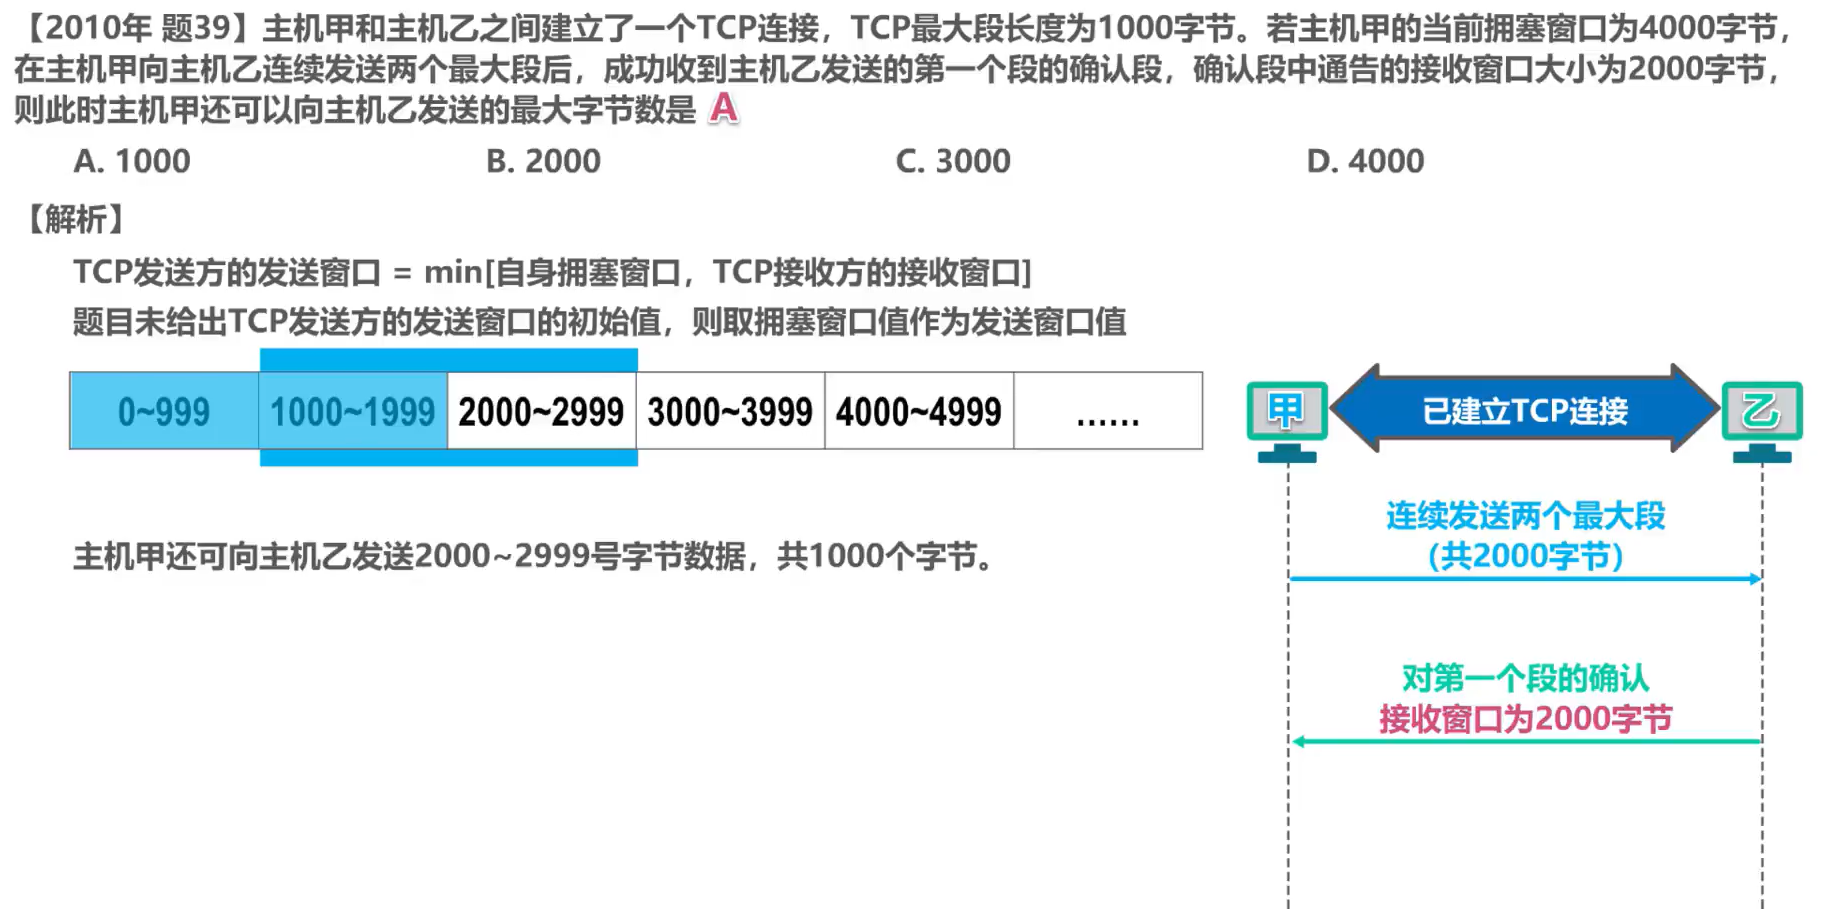
TCP的流量控制
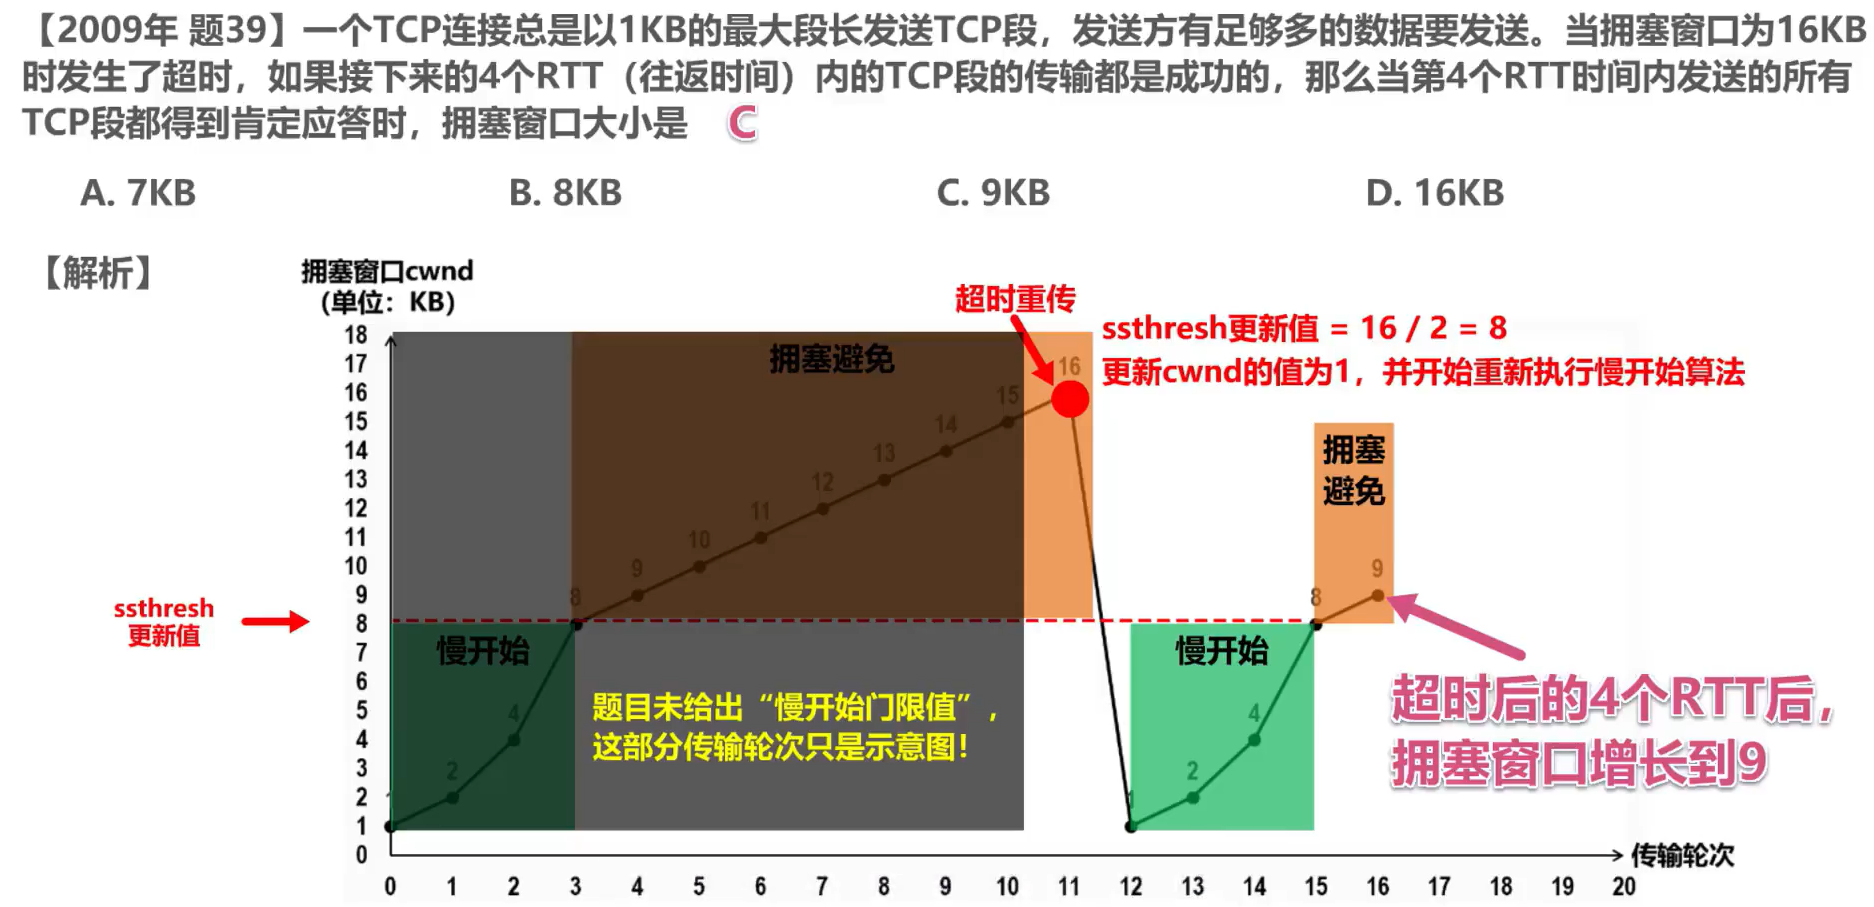
TCP的拥塞控制
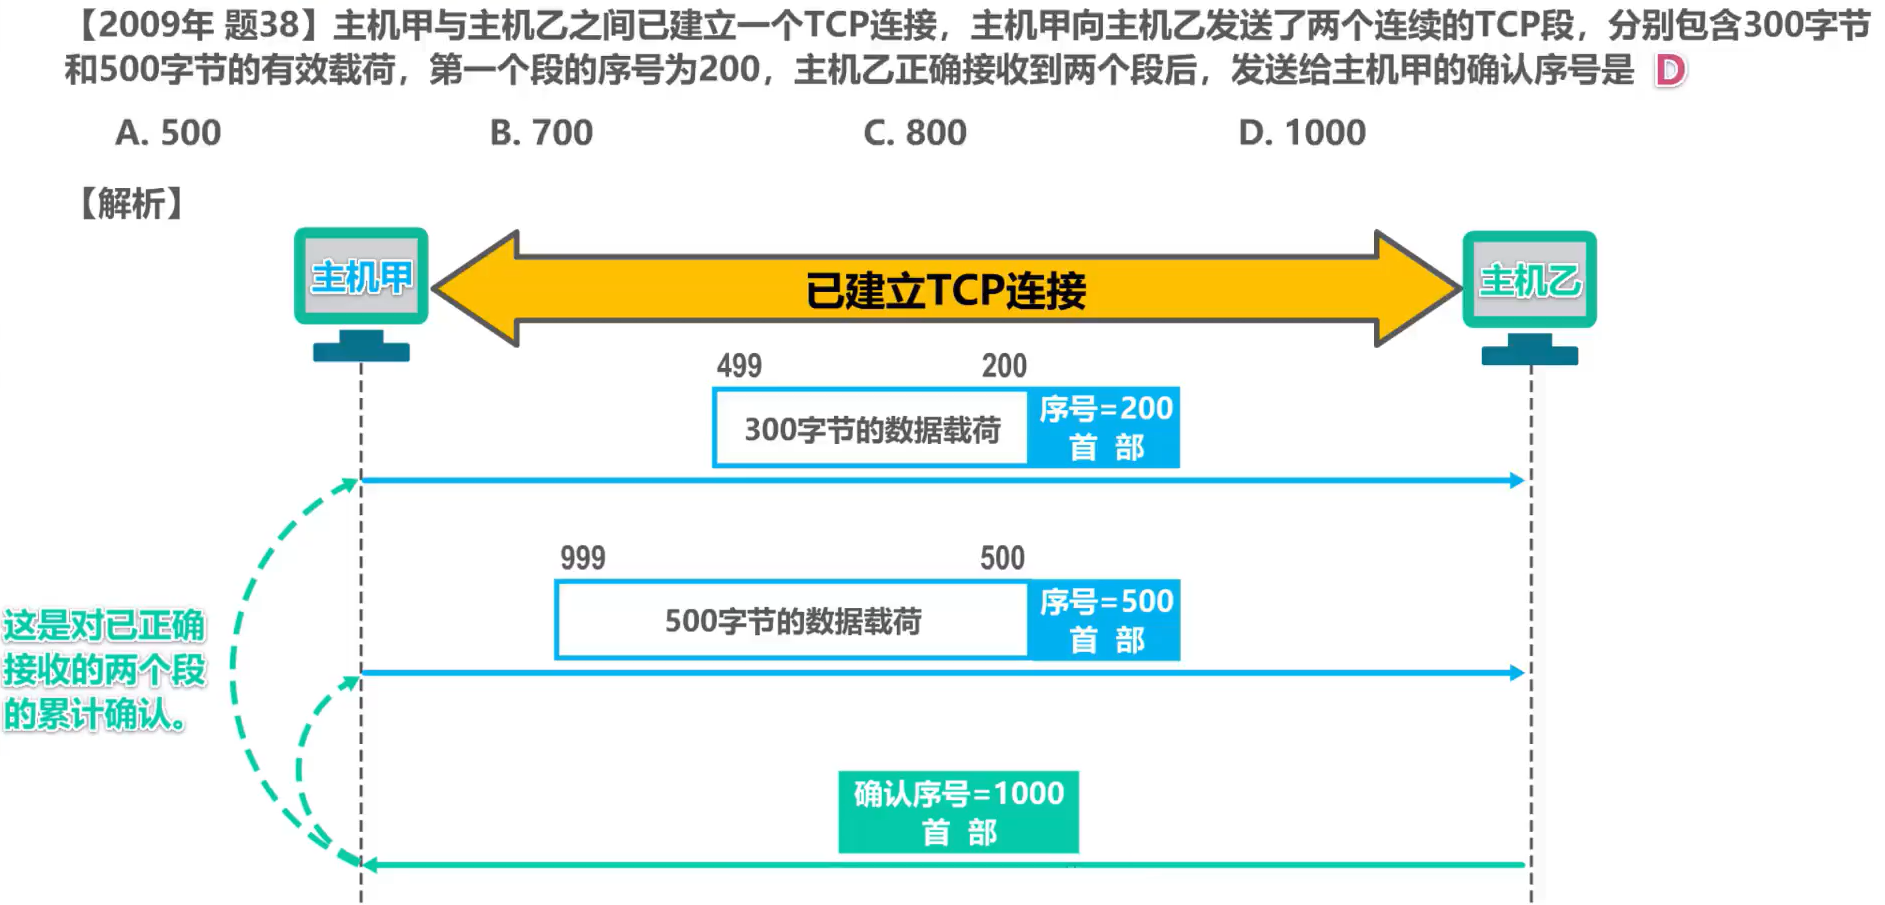
TCP可靠传输的实现
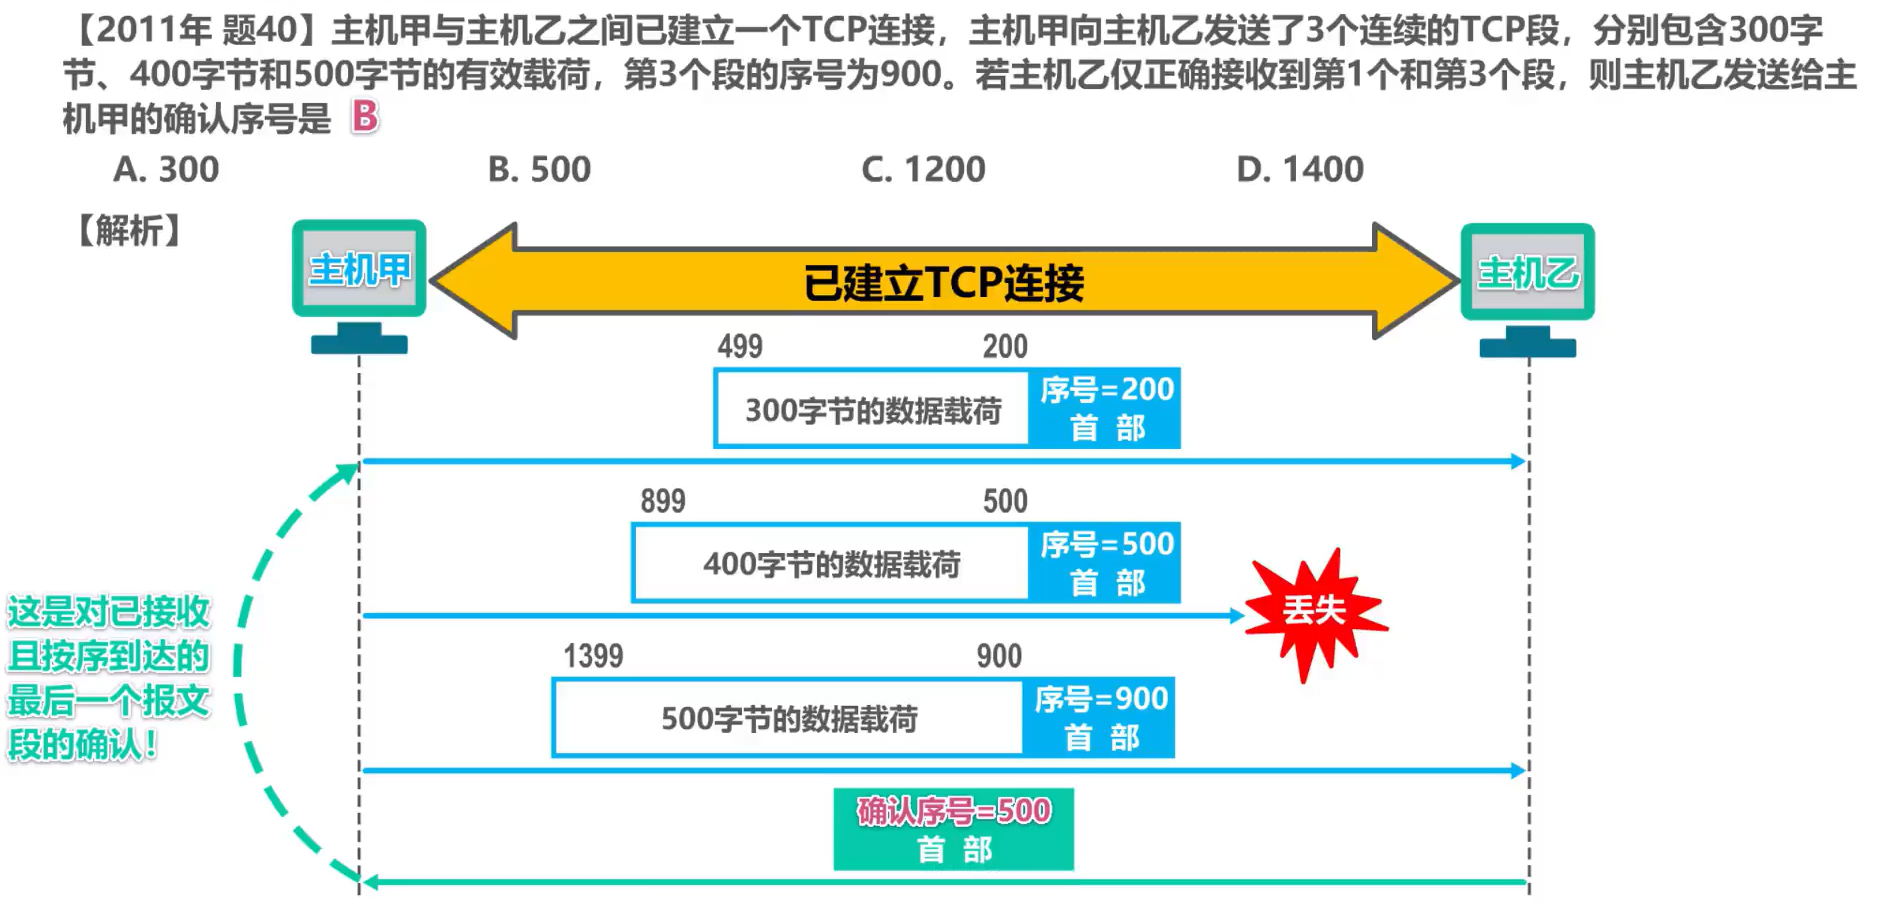
TCP的运输连接管理
应用层
概述
应用层是计算机网络体系结构的最顶层,是设计和建立计算机网络的最终目的,也是计算机网络中发展最快的部分。
- 早期基于文本的应用(电子邮件、远程登录、文件传输、新闻组)
- 20世纪90年代将因特网带入干家万户的万维网WWW
- 当今流行的即时通信、P2P文件共享及各种音视频应用
- 计算设备的小型化和广泛应用,宽带住宅接入和无线接入的日益普及和迅速发展
平时在浏览器的地址中输入某个网站的域名后,就可以访问该网站的内容,这个就是万维网WWW应用,其相关的应用层协议为超文本传送协议HTTP
用户在浏览器地址栏中输入的是“见名知意”的域名,而TCP/IP的网际层使用IP地址来表示目的主机,从域名到IP地址的装转换,由属于应用层范畴的域名系统DNS,在后台帮用户完成
常见的应用
- 万维网WWW
- 多媒体应用
- 电子邮件
- 文件传送FTP和P2P文件共享
- 域名系统DNS
- 动态主机配置DHCP
C/S和P2P
网络应用程序运行在处于网络边缘的不同的端系统上,通过彼此间的通信来共同完成某项任务。
而开发一种新的网络应用首先要考虑的问题就是网络应用程序在各种端系统上的组织方式和它们之间的关系。目前流行的主要有以下两种:
- 客户/服务器 C/S (Client/Server)方式
- 对等P2P (Peer-to-Peer)方式
客户/服务器方式(C/S方式):
- 客户和服务器是指通信中所涉及的两个应用进程。
- 客户/服务器方式所描述的是进程之间服务和被服务的关系。
- 客户是服务请求方,服务器是服务提供方。
- 服务器总是处于运行状态,并等待客户的服务请求。服务器具有固定端口号 (例如TTP服务器的默认端口号为80),而运行服务器的主机也具有固定的IP地址。
C/S方式是因特网上传统的、同时也是最成熟的方式,很多我们熟悉的网络应用采用的都是C/S方式包括万维网WWW、电子邮件、文件传输FTP等。
基于C/S方式的应用服务通常是服务集中型的。由于一台服务器计算机要为多个客户机提供服务,在C/S应用中,常会出现服务器计算机跟不上众多客户机请求的情况。为此,在C/S应用中,常用计算机群集(或服务器场)构建一个强大的虚拟服务器。
对等方式(P2P方式):
- 在P2P方式中,没有固定的服务请求者和服务提供者,分布在网络边缘各端系统中的应用进程是对等的,被称为对等方。对等方相互之间直接通信,每个对等方既是服务的请求者,又是服务的提供者。
- 目前,在因特网上流行的P2P应用主要包括P2P文件共享、即时通信、P2P流媒体、分布式存储等。
- 基于P2P的应用是服务分散型的,因为服务不是集中在少数几个服务器计算机中,而是分散在大量对等计算机中,这些计算机并不为服务提供商所有,而是为个人控制的桌面计算机和笔记本电脑,它们通常位于
- P2P方式的最突出特性之一就是它的可扩展性。因为系统每增加一个对等方,不仅增加的是服务的请求者,同时也增加了服务的提供者,系统性能不会因规模的增大而降低。
- P2P方式具有成本上的优势,因为它通常不需要庞大的服务器设施和服务器带宽。为了降低成本,服务提供商对于将P2P方式用于应用的兴趣越来越大。
动态主机配置协议DHCP
- 互联网广泛使用的动态主机配置协议 DHCP (Dynamic Host Configuration Protocol) 提供了即插即用连网 (plug-and-play networking) 的机制。
- 这种机制允许一台计算机加入新的网络和获取 IP 地址,而不用手工配置。
DHCP的作用:
在之前,如果要正常访问Web服务器,需要该主机手动配置网络的相关配置信息,万一主机数很多,工作量大,就很容易出错。
- 如果我们给网络中添加一台DHCP服务器,在其中设置好可为网络中其他各主机进行配置的网络配置信息。
- 然后网络中各主机开机后自动启动DHCP程序,向DHCP服务器请求自己的网络配置信息。
- 这样,网络中的主机就可以通过DHCP自动获得网络相关配置了。
DHCP的工作过程
DHCP 使用客户 - 服务器方式
- 需要 IP 地址的主机在启动时就向 DHCP 服务器广播发送发现报文(DHCP DISCOVER),这时该主机就成为 DHCP客户。
- 本地网络上所有主机都能收到此广播报文,但只有 DHCP 服务器才回答此广播报文。
- DHCP 服务器先在其数据库中查找该计算机的配置信息。若找到,则返回找到的信息。若找不到,则从服务器的 IP 地址池 (address pool) 中取一个地址分配给该计算机。DHCP服务器的回答报文叫做提供报文(DHCP OFFER)。
DHCP 工作方式
- DHCP 使用客户-服务器方式,采用请求/应答方式工作。
- DHCP 基于 UDP 工作(DHCP报文在运输层会被封装成为UDP用户数据报),DHCP 服务器运行在 67 号端口, DHCP客户运行在 68 号端口。
DHCP交互过程
客户端 ——
DHCP客户端广播发送DHCP发现报文(DHCP DISCOVER),包含:
事务ID
DHCP客户端的MAC地址
封装该报文的IP数据报的源IP地址为0.0.0.0,这是因为主机目前还未分配到IP地址,因此使用该地址代替,目的IP地址为广播地址255.255.255.255,之所以广播发送,是因为主机现在并不知道网络中有哪几个DHCP服务器,它们的IP地址各是什么。
DHCP服务器收到DHCP发现报文后,根据其中封装的DHCP客户端的MAC地址来查找自己的数据库,如果查到匹配信息,则使用这些配置信息来构建并发送DHCP提供报文,如果没有则采用默认配置信息来构建报文并发送
服务器 ——
- DHCP服务端将广播发送DHCP提供报文(DHCP OFFER),包含:
- 事务ID:DHCP客户端会与之前DHCP发现报文的事务ID做对比,来判断该DHCP提供报文是否是自己的
- 配置信息:
- IP地址:DHCP服务器从自己的IP地址池中挑选待租用给主机的IP地址(使用ARP来确保所选IP地址未被网络中其他主机占用)
- 子网掩码
- 地址租期
- 默认网关
- DNS服务器
- 源IP地址:发送DHCP提供报文的DHCP服务器的IP
- 目的地址:因为目的主机还没分配到IP,所以使用广播地址
如果DHCP客户会收到多个DHCP服务器发来的DHCP提供报文,DHCP客户从中选择一个,一般选择先到的,并向所选择的DHCP服务器发送DHCP请求报文。
客户端 ——
DHCP客户端将广播发送DHCP请求报文(DHCP REQUEST),包括:
- 事务ID
- DHCP客户端的MAC地址
- 接收的租约中的IP地址
- 提供此租约的DHCP服务器端的IP地址
源地址:0.0.0.0,因为此时DHCP客户才从多个DHCP服务器中挑选一个作为自己的DHCP服务器。它首先要征得该服务器的同意,之后才能正式使用向该DHCP服务器租用的IP地址
目的地址:广播地址,这样可以一次性向所有DHCP服务器发送DHCP请求报文,来告知它们是否请求它们作为自己的DHCP服务器
服务器 ——
DHCP服务器接受该请求,于是给DHCP客户端发送DHCP确认报文
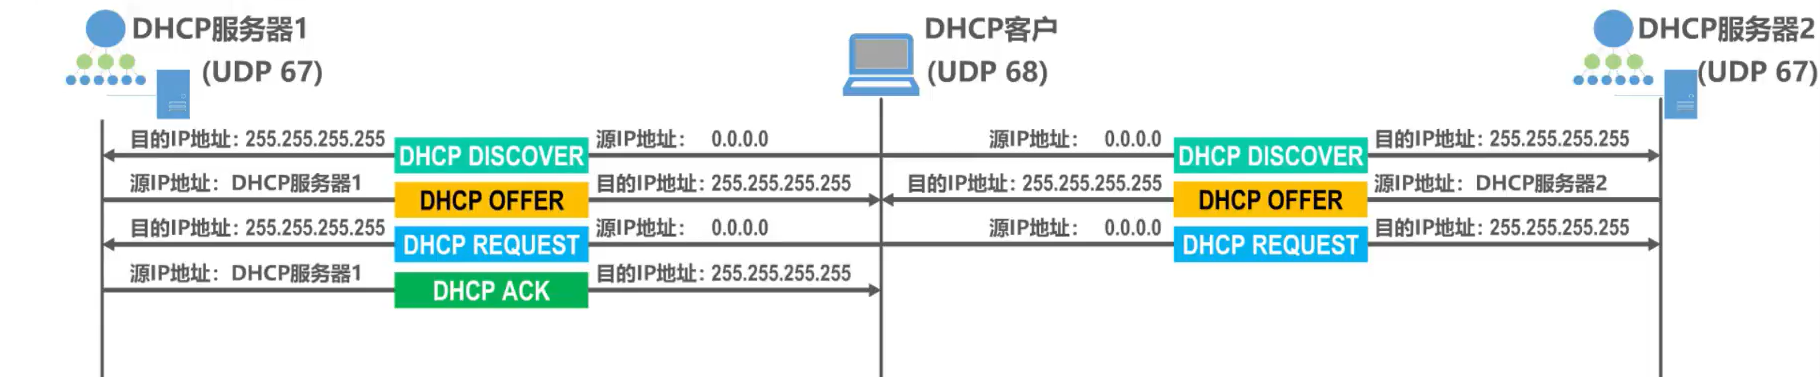
- 源地址:DHCP服务器1的IP地址
- 目的地址:广播地址
DHCP客户收到该报文后就可以使用租用的IP地址。
在使用前还会进行ARP检测:
- 若被占用:给DHCP服务器发送“DHCPDECLINE”报文撤销IP地址租约,并重新发送“DHCP DISCOVER”报文;
- 若未被占用:可以使用租约中的P地址与网络中其他主机通信了。
DHCP中继代理
使用DHCP中继代理是因为我们不用给每一个网络上都设置一个DHCP服务器,这样会使DHCP服务器的数量太多。
因此现在每一个至少有一个DHCP中继代理(通常是一台路由器),它配置了DHCP服务器的IP地址信息,作为各网络中计算机与DHCP服务器的桥梁。
域名系统DNS
概述
域名相比IP地址更容易记忆
因特网是否可以只使用一台DNS服务器?
不行,这种做法并不可取。因为因特网的规模很大,这样的域名服务器肯定会因为超负荷而无法正常工作,而且一旦域名服务器出现故障,整个因特网就会瘫痪
早在1983年,因特网就开始采用层次结构的命名树作为主机的名字(即域名)并使用分布式的域名系统DNS
DNS使大多数域名都在本地解析,仅少量解析需要在因特网上通信,因此系统效率很高由于DNS是分布式系统,即使单个计算机出了故障,也不会妨碍整个系统的正常运行
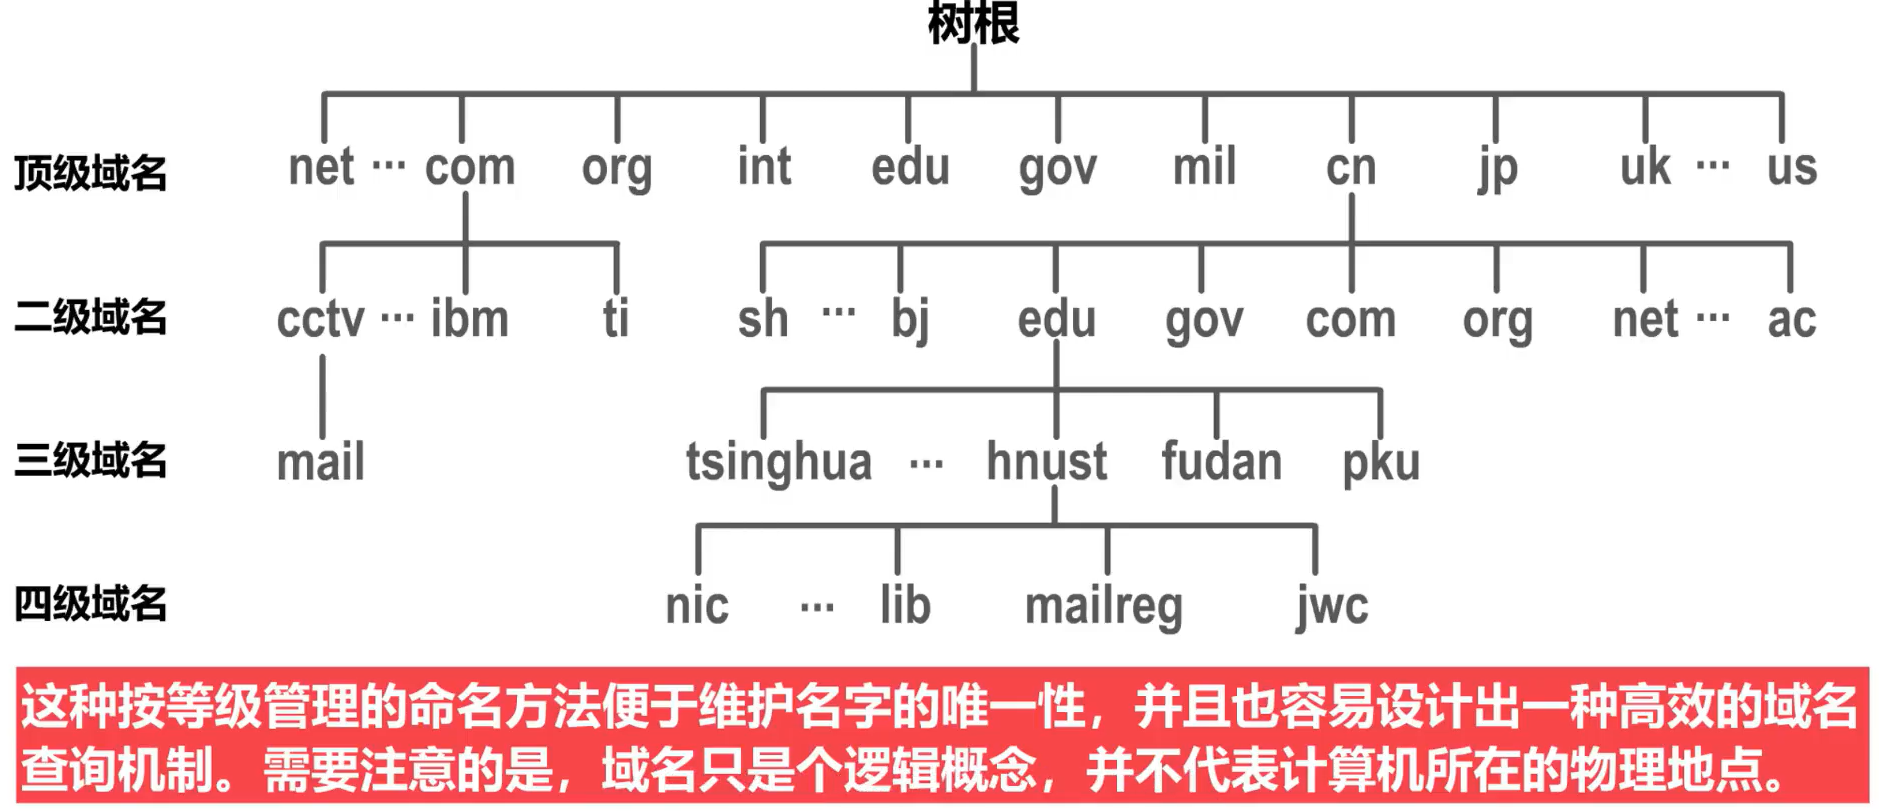
因特网采用层次树状结构的域名结构
域名的结构由若干个分量组成,各分量之间用 “点” 隔开,分别代表不同级别的域名。
如: xxx.三级域名.二级域名.顶级域名
- 每一级域名都是由英文字母和数字组成,不超过63个字符,不区分大小写;
- 级别低的域名在左,级别高的在右;
- 完整域名不超过255个字符;
或名系统既不规定一个域名需要包含多少个下级域名,也不规定每一级的域名代表什么意思。
各级域名由其上一级的域名管理机构管理,而最高的顶级域名则由因特网名称与数字地址分配机构ICANN进行管理。
域名分类:
顶级域名TLD (Top Level Domain) 分为以下三类:
- 国家顶级域名nTLD:采用IS03166的规定。如cn表示中国,us表示美国,uk表示英国、等等。
- 通用顶级域名gTLD:最常见的通用顶级域名有七个,即:com(公司企业)、net(网络服务机构)、org(非营利性组织)、int(国际组织)、edu(美国教育结构)、gov(美国政府部门)、mil(美国军事部门)。
- 反向域arpa : 用于反向域名解析,即IP地址反向解析为域名。
在国家顶级域名下注册的二级域名均由该国家自行确定。例如,顶级域名为j的日本,将其教育和企业机构的二级域名定为ac和co,而不用edu和com。
我国则将二级域名划分为以下两类:
- 类别域名共七个:ac(科研机构)、com(工,商,金融等企业)、edu(教育机构)、gov(政府部门)、net(提供网络服务的机构)、mi(军事机构)和org(非营利性组织)。
- 行政区域名共34个,适用于我国的各省、自治区、直辖市。例如:bj为北京市、Sh为上海市、js为江苏省,等等。
名称相同的域名其等级未必相同
域名服务器:
域名和IP地址的映射关系必须保存在域名服务器中,供所有其他应用查询。显然不能将所有信息都储存在一台域名服务器中。DNS使用分布在各地的域名服务器来实现域名到IP地址的转换。
域名服务器可以划分为以下四种不同的类型:
根域名服务器
根域名服务器是最高层次的域名服务器。每个根域名服务器都知道所有的顶级域名服务器的域名及其IP地址。因特网上共有13个不同P地址的根域名服务器。尽管我们将这13个根域名服务器中的每一个都视为单个的服务器,但“每台服务器”实际上是由许多分布在世界各地的计算机构成的服务器群集。当本地域名服务器向根域名服务器发出查询请求时,路由器就把查询请求报文转发到离这个DNS客户最近的一个根域名服务器。这就加快了DNS的查询过程,同时也更合理地利用了因特网的资源。根域名服务器通常并不直接对域名进行解析,而是返回该域名所属顶级域名的顶级域名服务器的P地址。
顶级域名服务器
这些域名服务器负责管理在该顶级域名服务器注册的所有二级域名。当收到DNS查询请求时就给出相应的回答(可能是最后的结果,也可能是下一级权限域名服务器的IP地址)。
权限域名服务器
这些域名服务器负责管理某个区的域名。每一个主机的域名都必须在某个权限域名服务器处注册登记。因此权限域名服务器知道其管辖的域名与IP地址的映射关系。另外,权限域名服务器还知道其下级域名服务器的地址。
本地域名服务器
本地域名服务器不属于上述的域名服务器的等级结构。当一个主机发出DNS请求报文时,这个报文就首先被送往该主机的本地域名服务器。本地域名服务器起着代理的作用,会将该报文转发到上述的域名服务器的等级结构中。每一个因特网服务提供者ISP,一个大学,甚至一个大学里的学院,都可以拥有一个本地域名服务器,它有时也称为默认域名服务器。本地域名服务器离用户较近,一般不超过几个路由器的距离,也有可能就在同一个局域网中。本地域名服务器的IP地址需要直接配置在需要域名解析的主机中。
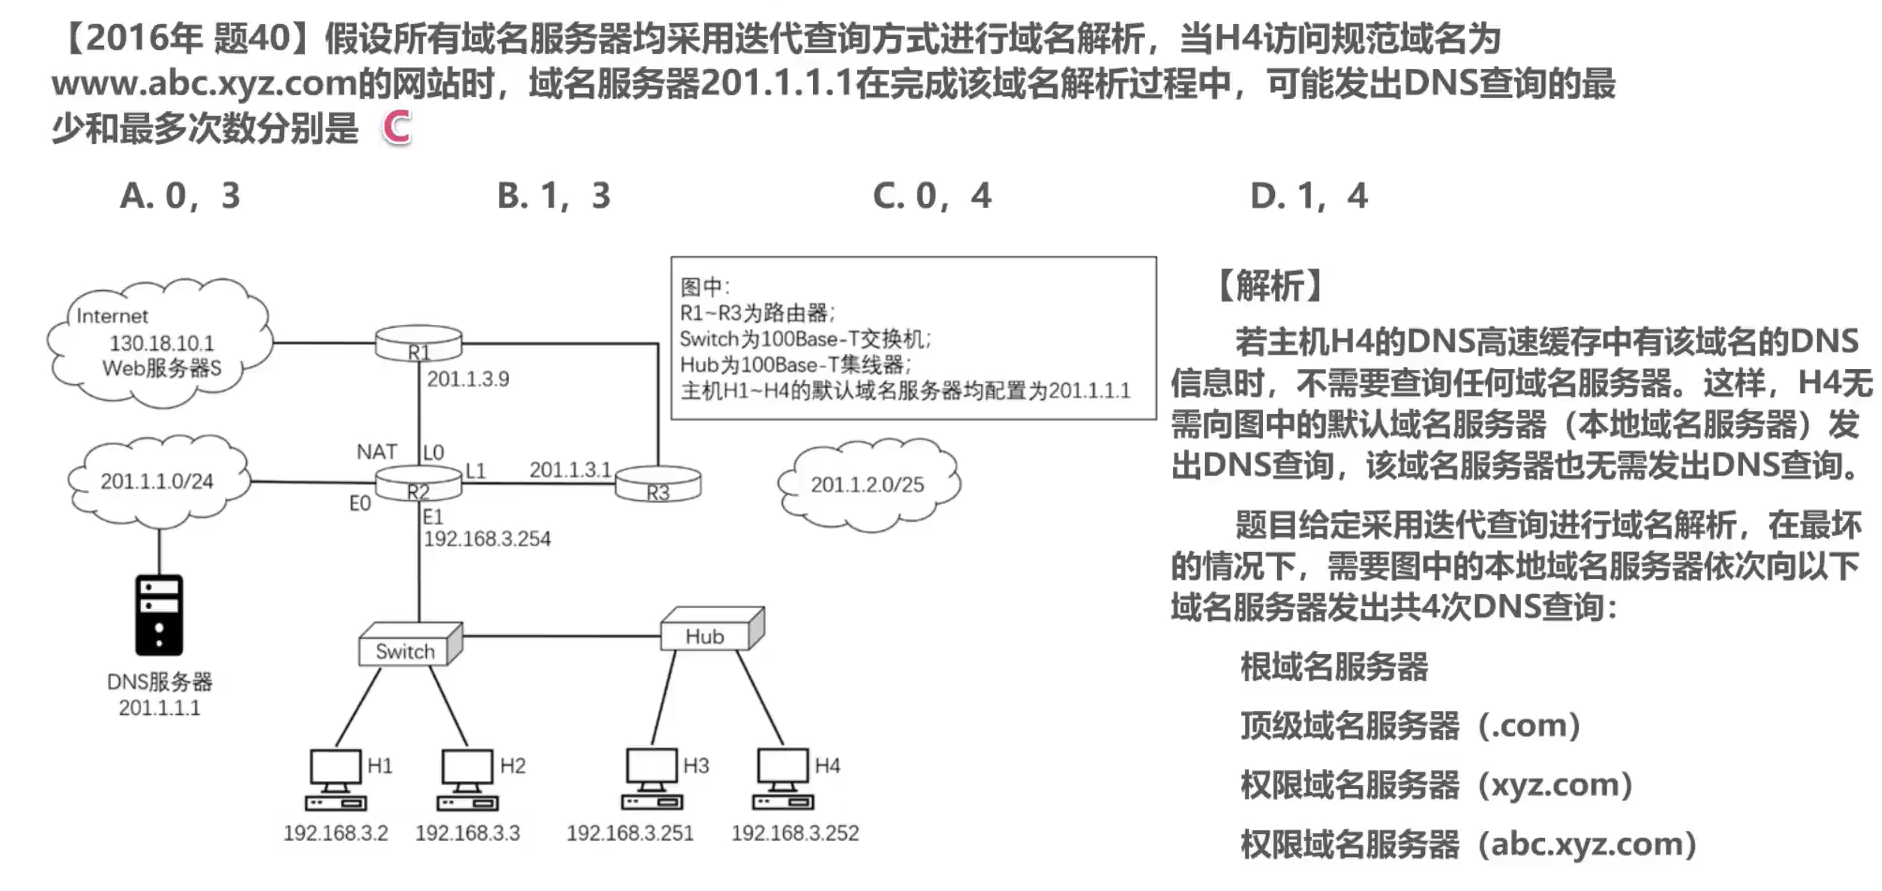
域名解析过程
DNS报文使用运输层的UDP协议进行封装,运输层端口号为53
递归查询,先查本地域名服务器,没有记录的话,本地域名服务器会向根域名服务器查询,根域名服务器查询回向下属的顶级域名服务器查询,逐层往下查,查到了就沿原路传递信息。
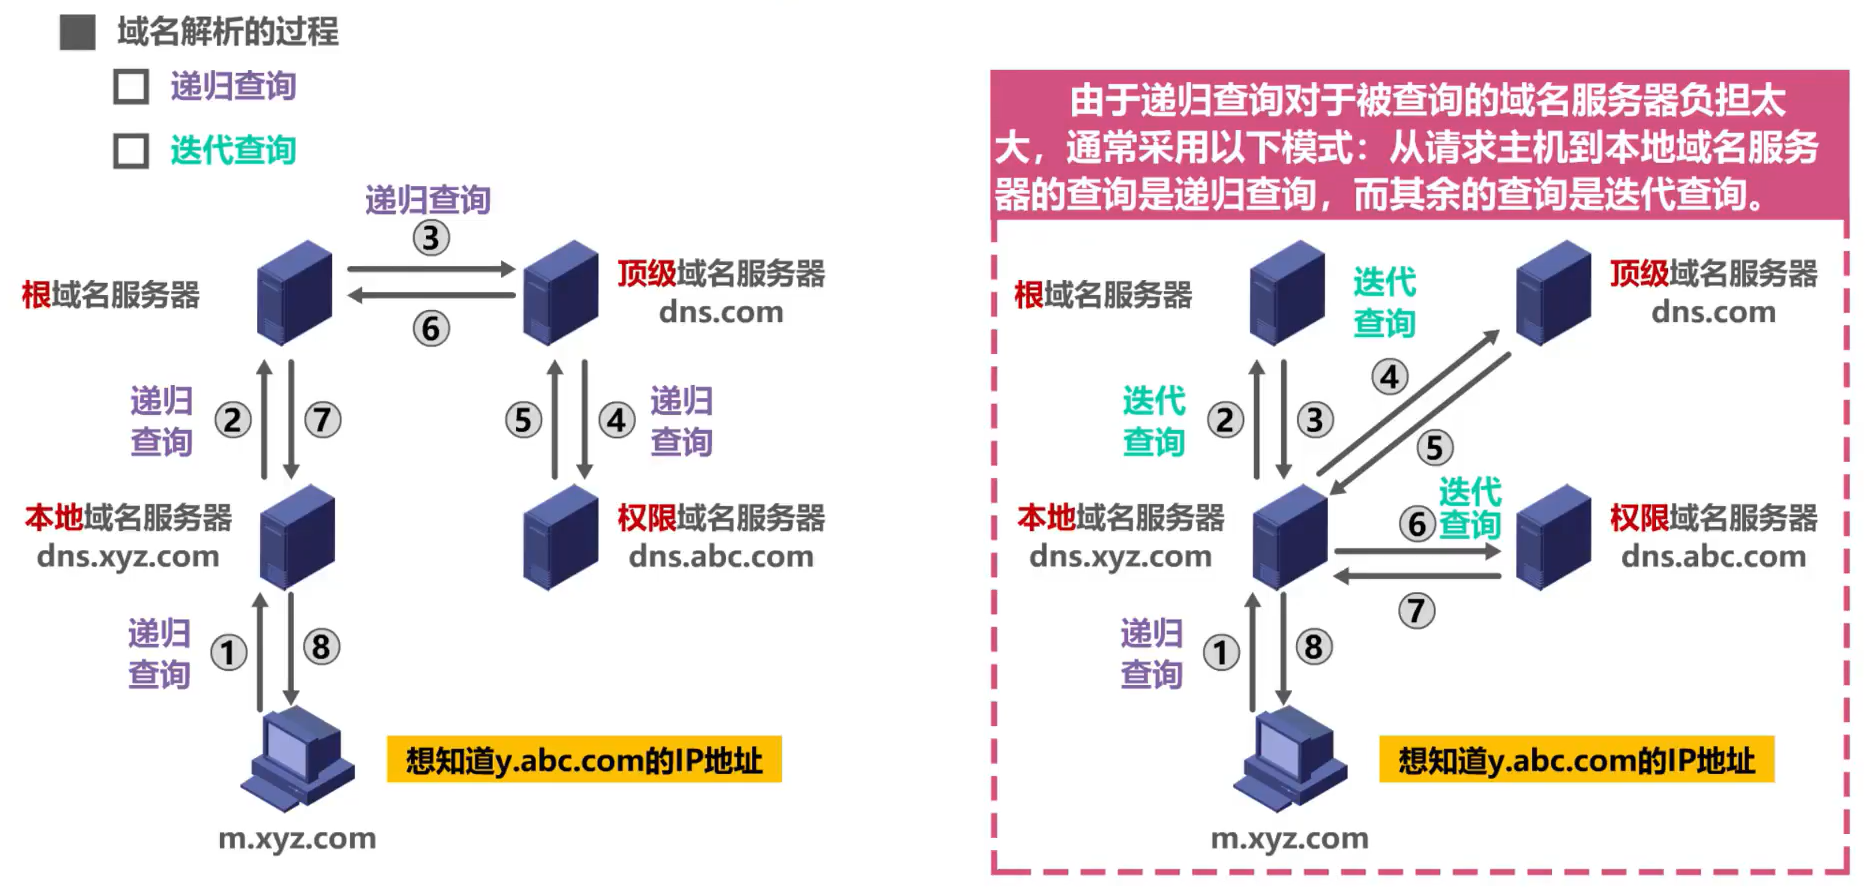
- 为了提高DNS的查询效率,并减轻根域名服务器的负荷和减少因特网上的DNS查询报文数量,在域名服务器中广泛地使用了高速缓存。高速缓存用来存放最近查询过的域名以及从何处获得域名映射信息的记录。
- 由于域名到P地址的映射关系并不是永久不变,为保持高速缓存中的内容正确,域名服务器应为每项内容设置计时器并删除超过合理时间的项(例如,每个项目只存放两天)。
- 不但在本地域名服务器中需要高速缓存,在用户主机中也很需要。许多用户主机在启动时从本地域名服务器下载域名和P地址的全部数据库,维护存放自己最近使用的域名的高速缓存,并且只在从缓存中找不到域名时才向域名服务器查询。同理,主机也需要保持高速缓存中内容的正确性。
习题:
文件传送协议FTP
- 文件传送:将某台计算机中的文件通过网络传送到可能相距很远的另一台计算机中,是一项基本的网络应用。
- 文件传送协议FTP (File Transfer Protocol) 是因特网上使用得最广泛的文件传送协议。
- FTP提供交互式的访问,允许客户指明文件的类型与格式(如指明是否使用ASC川码),并允许文件具有存取权限(如访问文件的用户必须经过授权,并输入有效的口令)。
- FTP屏蔽了各计算机系统的细节,因而适合于在异构网络中任意计算机之间传送文件。
在因特网发展的早期阶段,用FTP传送文件约占整个因特网的通信量的三分之一,而由电子邮件和域名系统所产生的通信量还要小于FTP所产生的通信量。只是到了1995年,万维网WWW的通信量才首次超过了FTP。
FTP采用C/S方式(客户/服务器方式)。
FTP客户计算机可将各种类型的文件上传到FTP服务器计算机,也可以从FTP服务器计算机下载文件。
常见用途:
- 计算机之间传输文件,尤其是批量传输;
- 网站设计者将构成网站内容的大量文件批量上传到他们的Web服务器。
FTP基本工作原理:
建立传送命令的TCP连接:
FTP服务器监听熟知端口(端口号为 21),使客户进程能够连接上。
- FTP客户随机选择一个临时端口号与其建立TCP连接,这条TCP连接用于FTP客户与服务器之间传送FTP的相关控制命令(这条连接是FTP客户与服务器之间的命令通道)
建立传送数据的TCP连接,分为服务器主动和被动建立连接:
主动:客户端在命令通道告知服务器主动来与自己的另一个临时端口号建立TCP连接,建立数据通道。
FTP服务器使用熟知端口号20,与客户端的另一个临时端口号建立连接。
被动:客户端在命令通道告知服务器开启某个临时端口,被动等待TCP连接。
电子邮件
概念
电子邮件(E-mail)
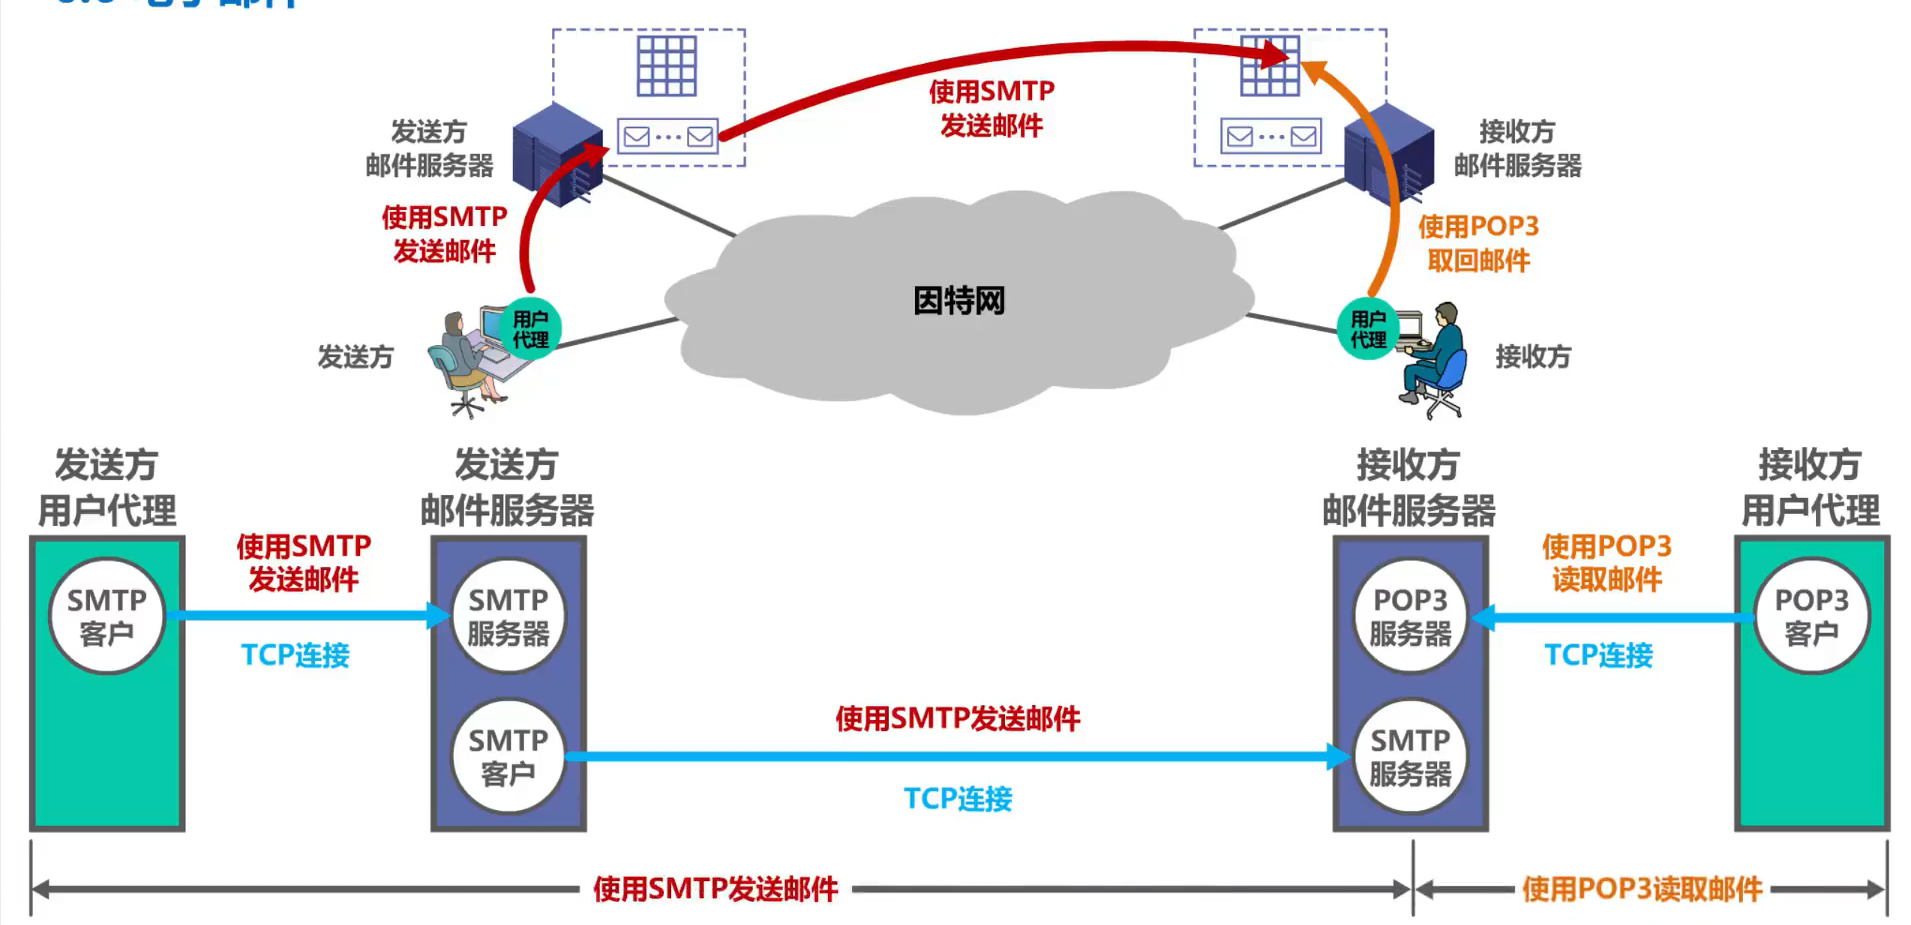
- 发件人将邮件发送到自己使用的邮件服务器;
- 发件人的邮件服务器将收到的邮件按其目的地址转发到收件人邮件服务器中的收件人邮箱;
- 收件人在方便的时候访问收件人邮件服务器中自己的邮箱,获取收到的电子邮件。
优点:使用方便、传递迅速而且费用低廉。它不仅可以传送文字信息,而且还可附上声音和图像。
组成:
- 电子邮件系统采用客户/服务器方式。
- 电子邮件系统的三个主要组成构件:用户代理,邮件服务器,以及电子邮件所需的协议。
- 用户代理:是用户与电子邮件系统的接口,又称为电子邮件客户端软件。
- 邮件服务器:是电子邮件系统的基础设施。因特网上所有的ISP都有邮件服务器,其功能是发送和接收邮件,同时还要负责维护用户的邮箱。
- 协议:包括邮件发送协议(例如SMTP)和邮件读取协议(例如POP3,IMAP)
邮件发送和接收过程:
简单邮件传送协议SMTP
(Simple Mail Transfer Protocol)
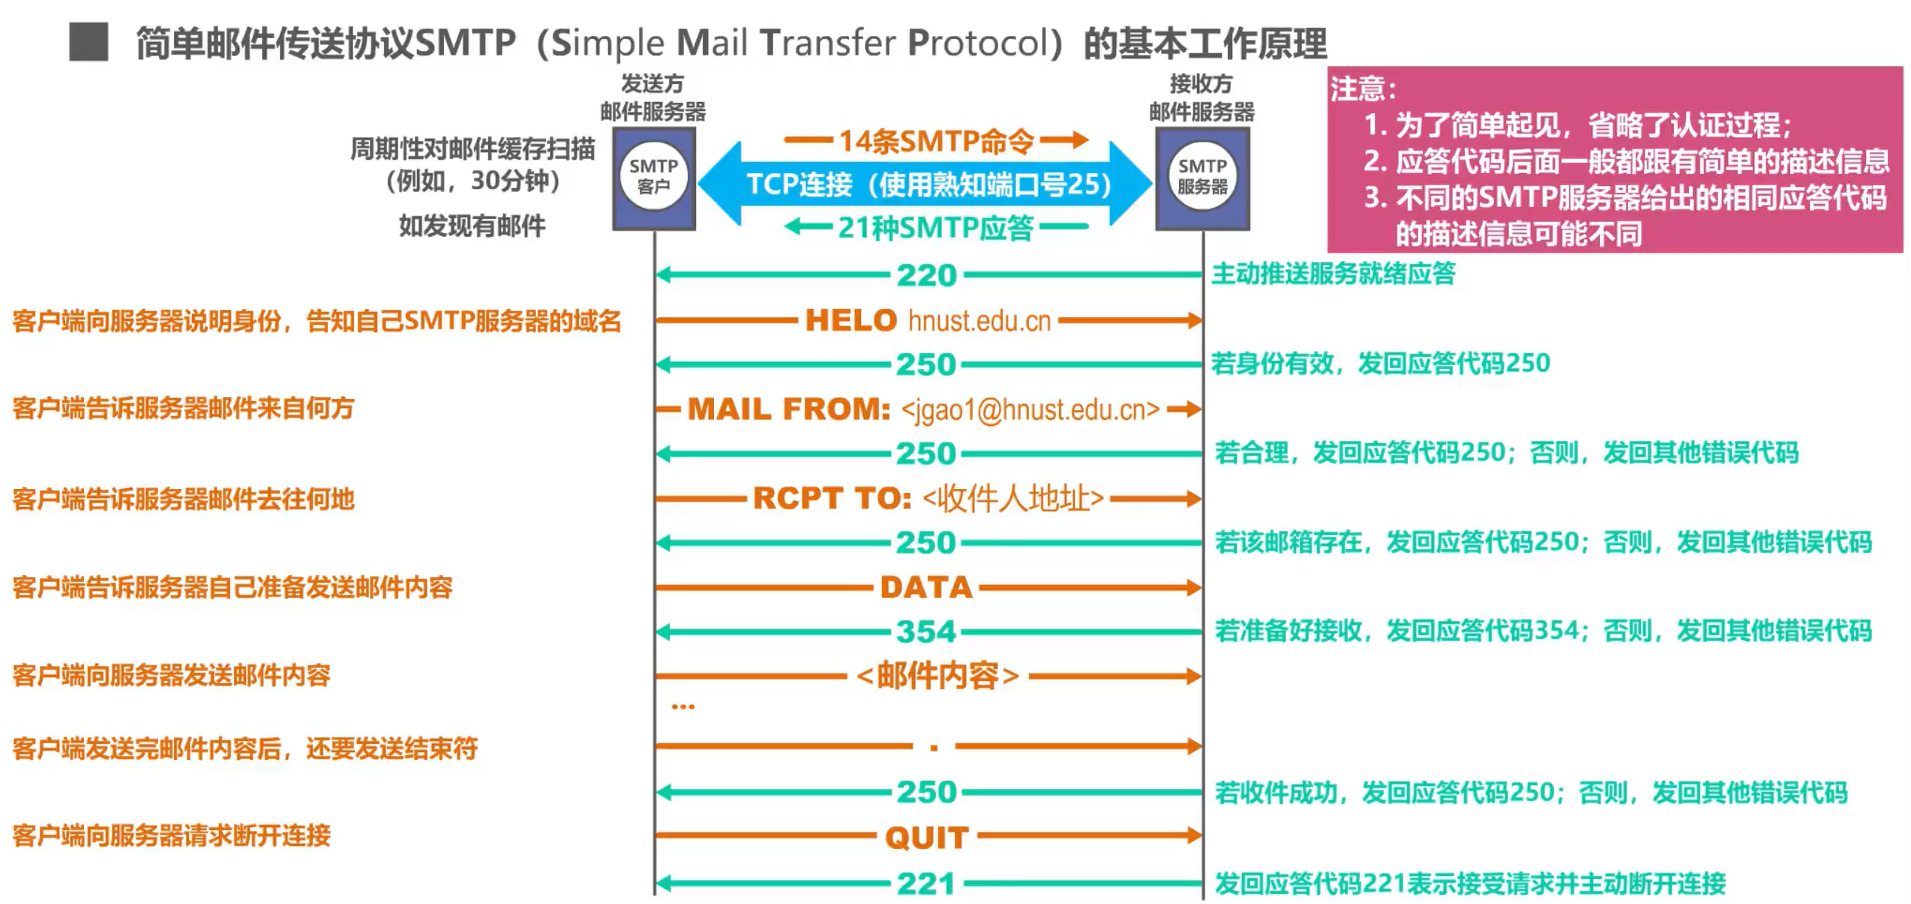
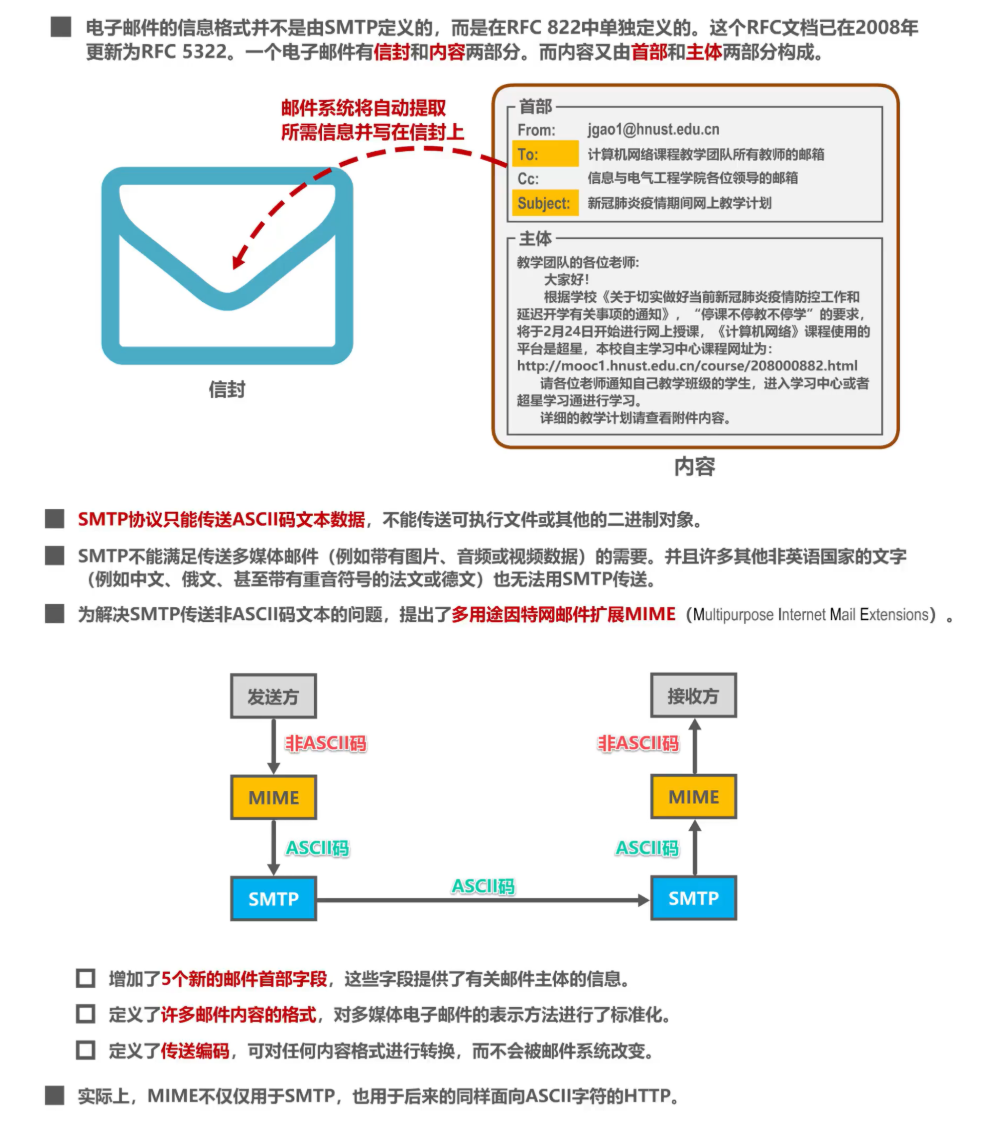
电子邮件的信息格式
分为两部分:
- 信封:提取内容中的相关信息写在信封上。
- 内容
- 首部
- 主体
邮件读取
常用的邮件读取协议有两个:
邮局协议POP(Post Office Protocol),POP3是其第三个版本,是因特网正式标准。
非常简单、功能有限的邮件读取协议。用户只能以下载并删除方式或下载并保留方式从邮件服务器下载邮件到用户方计算机。不允许用户在邮件服务器上管理自己的邮件。(例如创建文件夹,对邮件进行分类管理等)
因特网邮件访问协议IMAP(Internet Message Access Protocol),IMAP4是其第四个版本,目前还只是因特网建议标准。
功能比POP3强大的邮件读取协议。用户在自己的计算机上就可以操控邮件服务器中的邮箱,就像在本地操控一样,因此IMAP是一个联机协议。
POP3和MAP4都采用基于TCP连接的客户/服务器方式。POP3使用熟知端口110,IMAP4使用熟知端口143。
万维网WWW
概念
概述
- 万维网 WWW (World Wide Web) 并非某种特殊的计算机网络。
- 万维网是一个大规模的、联机式的信息储藏所。
- 万维网利用网页之间的超链接将不同网站的网页链接成一张逻辑上的信息网,用链接的方法能非常方便地从互联网上的一个站点访问另一个站点,从而主动地按需获取丰富的信息。
- 这种访问方式称为“链接”。
万维网的工作方式
- 万维网以客户 - 服务器方式工作。
- 浏览器就是在用户计算机上的万维网客户程序。万维网文档所驻留的计算机则运行服务器程序,因此这个计算机也称为万维网服务器。
- 客户程序向服务器程序发出请求,服务器程序向客户程序送回客户所要的万维网文档。
- 在一个客户程序主窗口上显示出的万维网文档称为页面 (page)。
统一资源定位符URL:标志分布在整个互联网上的万维网文档,能指明资源的位置。
- 组成: <协议>://<主机>:<端口>/<路径>
万维网的文档:
- HTML:超文本标记语言,使用多种标签来描述网页的结构和内容
- CSS:描述网页的样式
- JavaScript:控制网页行为
超文本传输协议HTTP
(Hyper Transfer Protocol)
概念和传输过程
在万维网客户程序与万维网服务器程序之间进行交互所使用的协议,是超文本传送协议 HTTP (HyperText Transfer Protocol)。
HTTP 是一个应用层协议,它使用 TCP 连接进行可靠的传送。
每个万维网网点都有一个服务器进程,它不断地 监听TCP 的端口80,以便发现是否有浏览器向它发出连接建立请求。
一旦监听到连接建立请求并建立了 TCP 连接之后,浏览器就向万维网服务器发出浏览某个页面的请求,服务器接着就返回所请求的页面作为响应。
最后,TCP 连接释放。
版本:
- HTTP/1.0采用非持续连接方式。在该方式下,每次浏览器要请求一个文件都要与服务器建立TCP连接当收到响应后就立即关闭连接。
- 每请求一个文档就要有两倍的RTT的开销。若一个网页上有很多引用对象(例如图片等),那么请求每一个对象都需要花费2RTT的时间
- 为了减小时延,浏览器通常会建立多个并行的TCP连接同时请求多个对象。但是,这会大量占用万维网服务器的资源,特别是万维网服务器往往要同时服务于大量客户的请求,这会使其负担很重。
- HTTP/1.1采用持续连接方式。在该方式下,万维网服务器在发送响应后仍然保持这条连接,使同一个客户(浏览器)和该服务器可以继续在这条连接上传送后续的HTTP请求报文和响应报文。这并不局限于传送同一个页面上引用的对象,而是只要这些文档都在同一个服务器上就行。
- 为了进一步提高效率,HTTP/1.1的持续连接还可以使用流水线方式工作,即浏览器能够连续发送多个请求报文。这样的一个接一个的请求报文到达服务器后,服务器就发回一个接一个的响应报文。这样就节省了很多个RTT时间,使TCP连接中的空闲时间减少,提高了下载文档的效率。
HTTP报文格式
HTTP请求报文格式
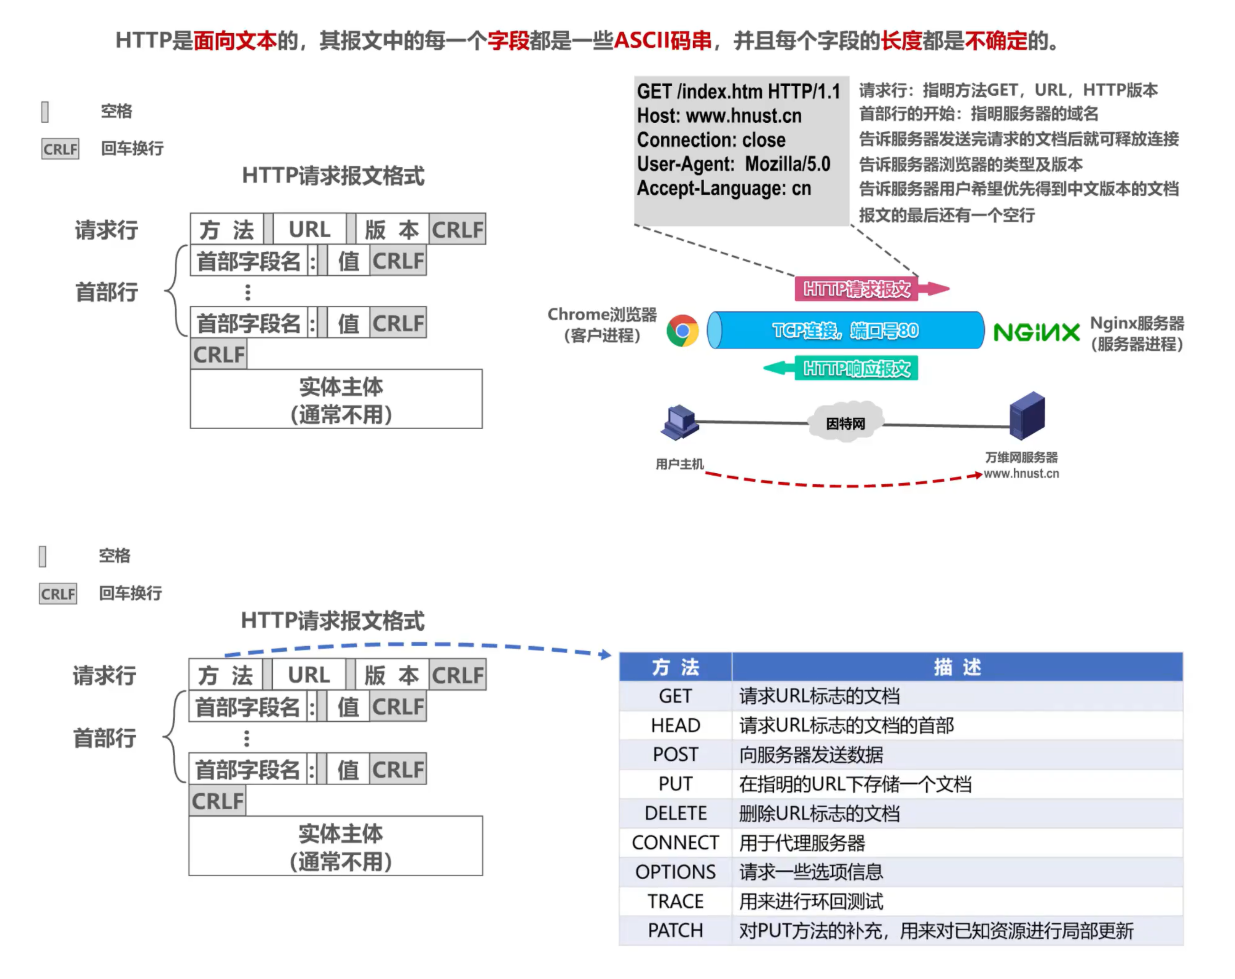
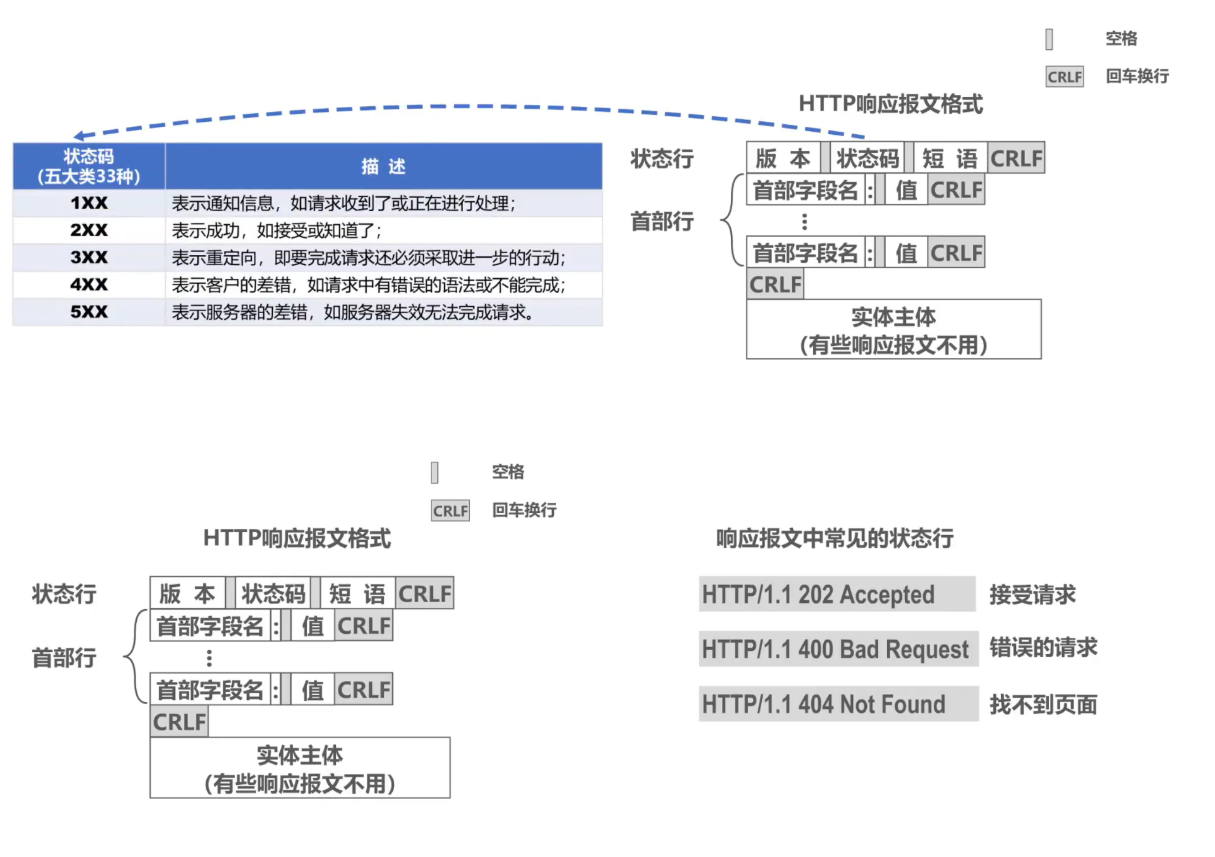
HTTP响应报文格式
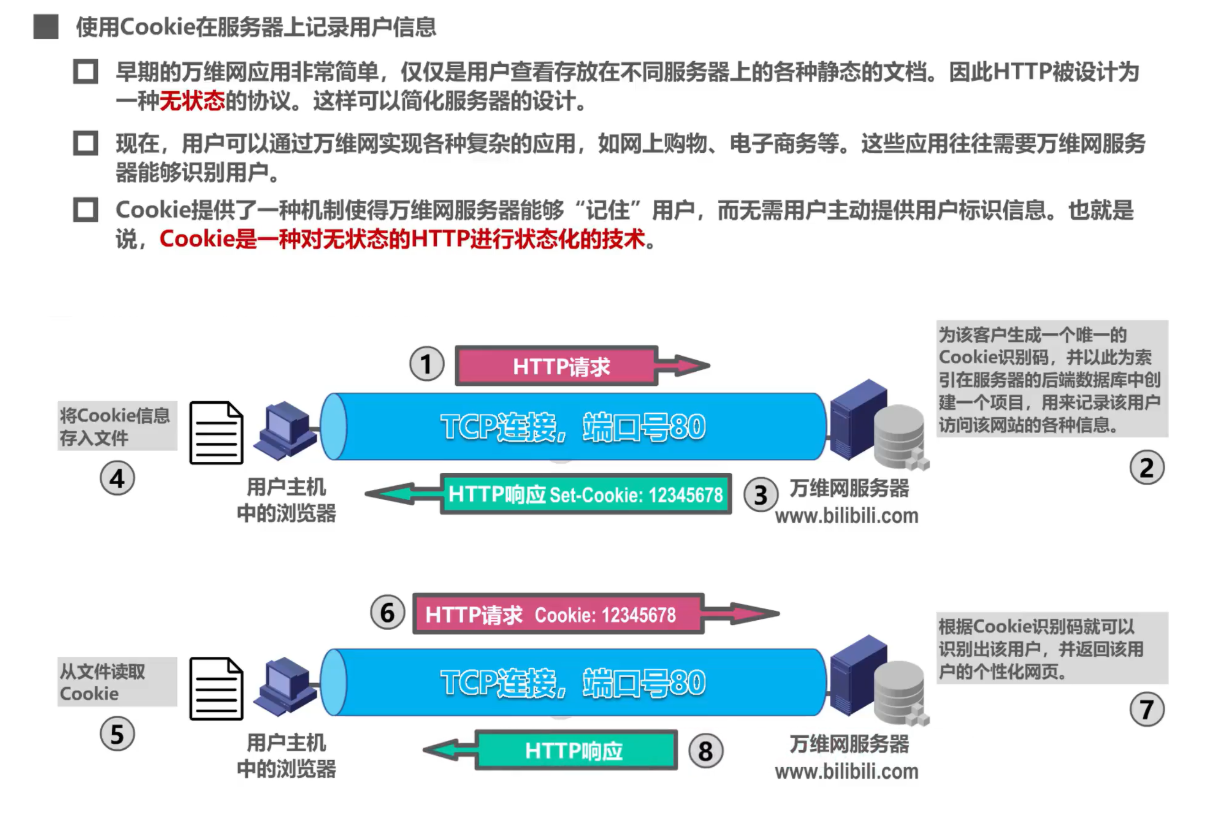
使用Cookie在服务器上记录用户信息
万维网缓存与代理服务器
万在万维网中还可以使用缓存机制以提高万维网的效率
- 万维网缓存又称为Web缓存(Web Cache),可位于客户机,也可位于中间系统上,位于中间系统上的Web缓存又称为代理服务器(Proxy Server)
- Web缓存把最近的一些请求和响应暂存在本地磁盘中。当新请求到达时,若发现这个请求与暂时存放的请求相同,就返回暂存的响应,而不需要按URL的地址再次去因特网访问该资源。
若WEb缓存的命中率比较高
则会大大减小了该链路上的通信量,因而减少了访问因特网的时延
假设原始服务器的文档被更改,这样代理服务器的文档就不是最新的
所以原始服务器通常会为每个响应的对象设定一个修改时间字段和一个有效日期字段
若过期并且代理服务器的文档和原始服务器的文档一致,原始服务器则给代理服务器发送不包含实体主体的响应(304 Not Modified)
若过期并且代理服务器的文档和原始服务器的文档不一致,原始服务器则给代理服务器发送封装有该文档的响应报文
习题
域名系统DNS
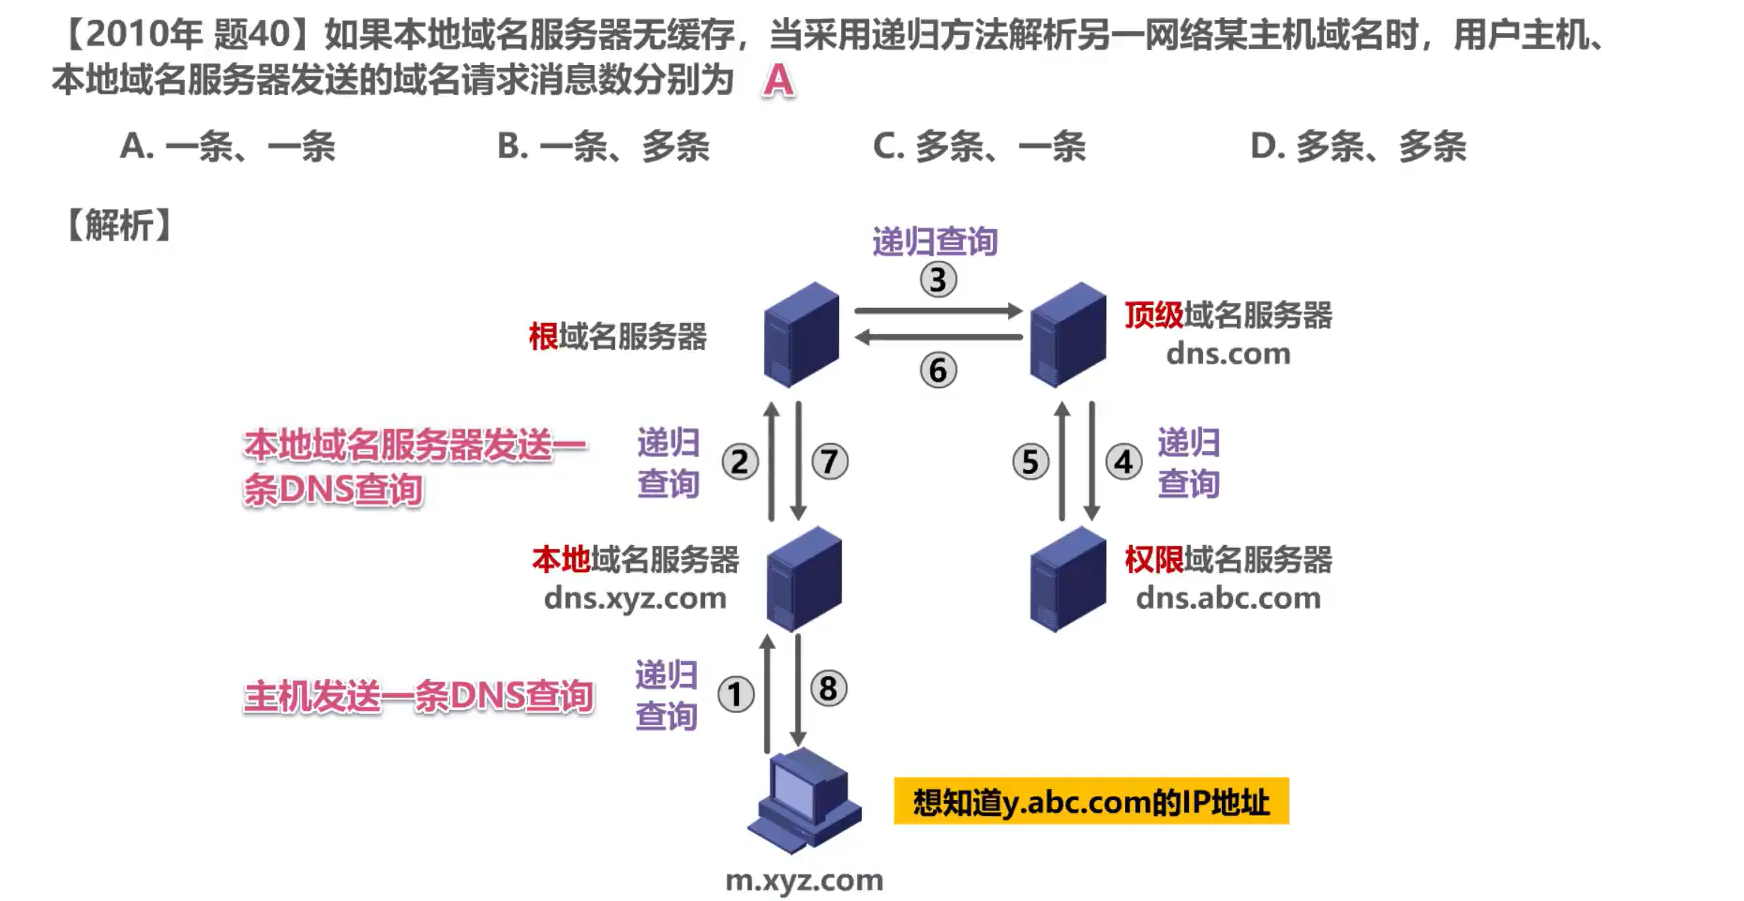
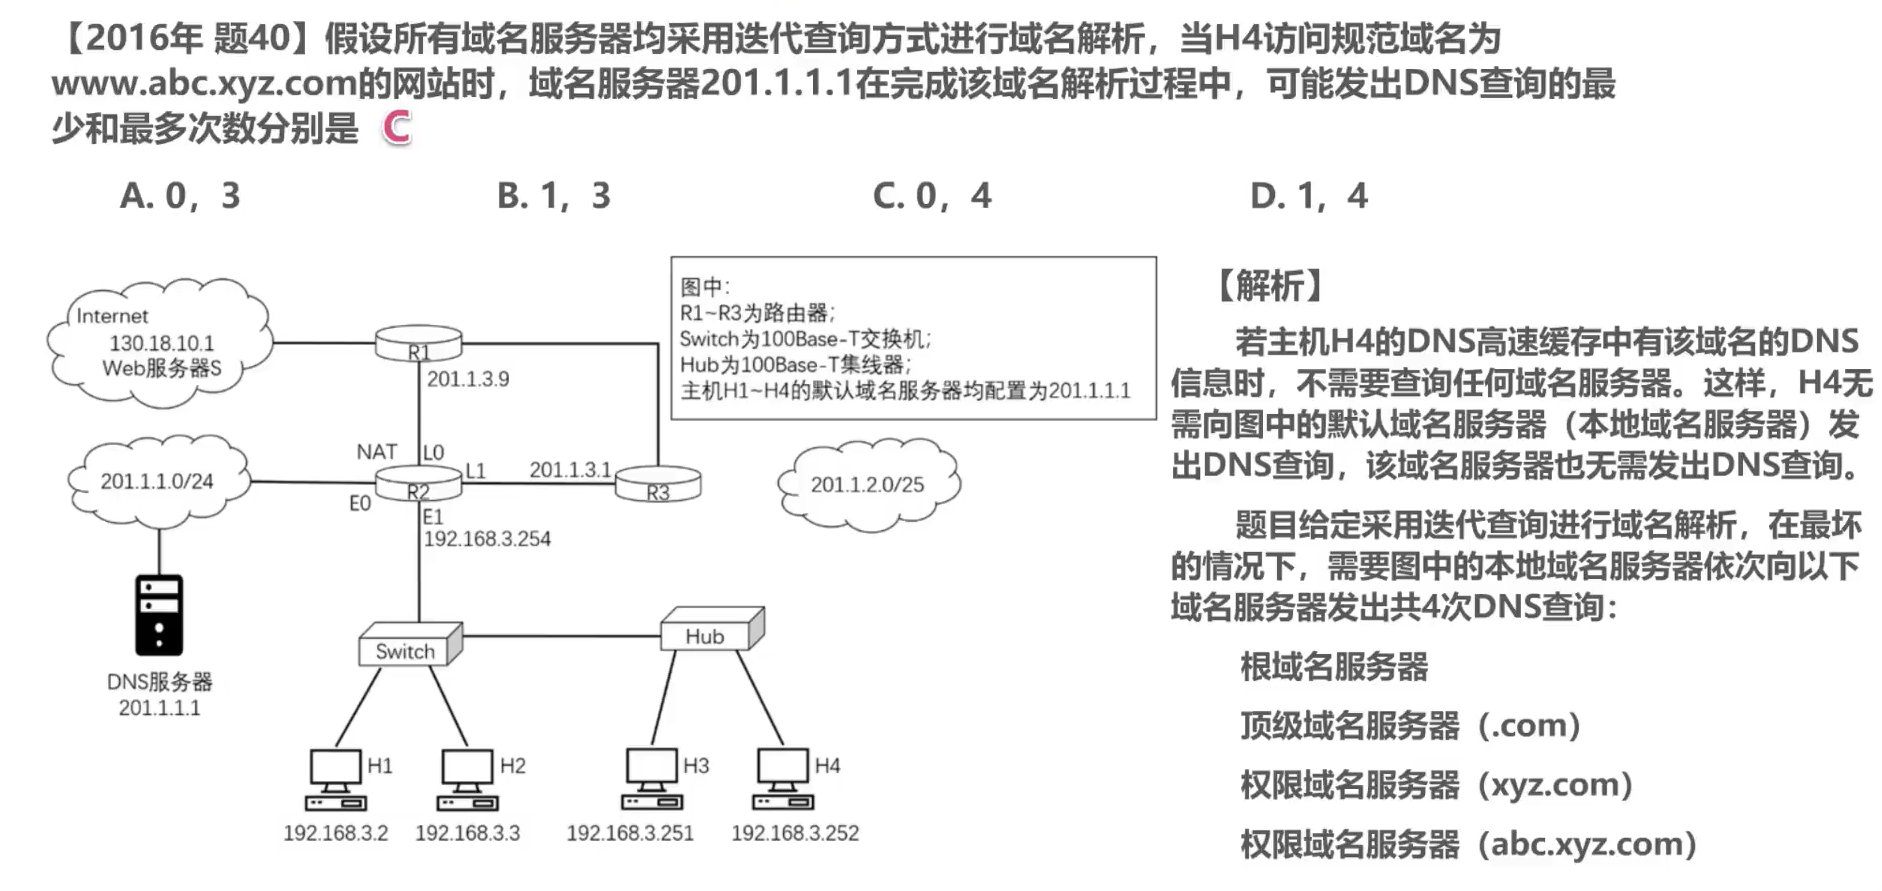
文件传送协议FTP
电子邮件
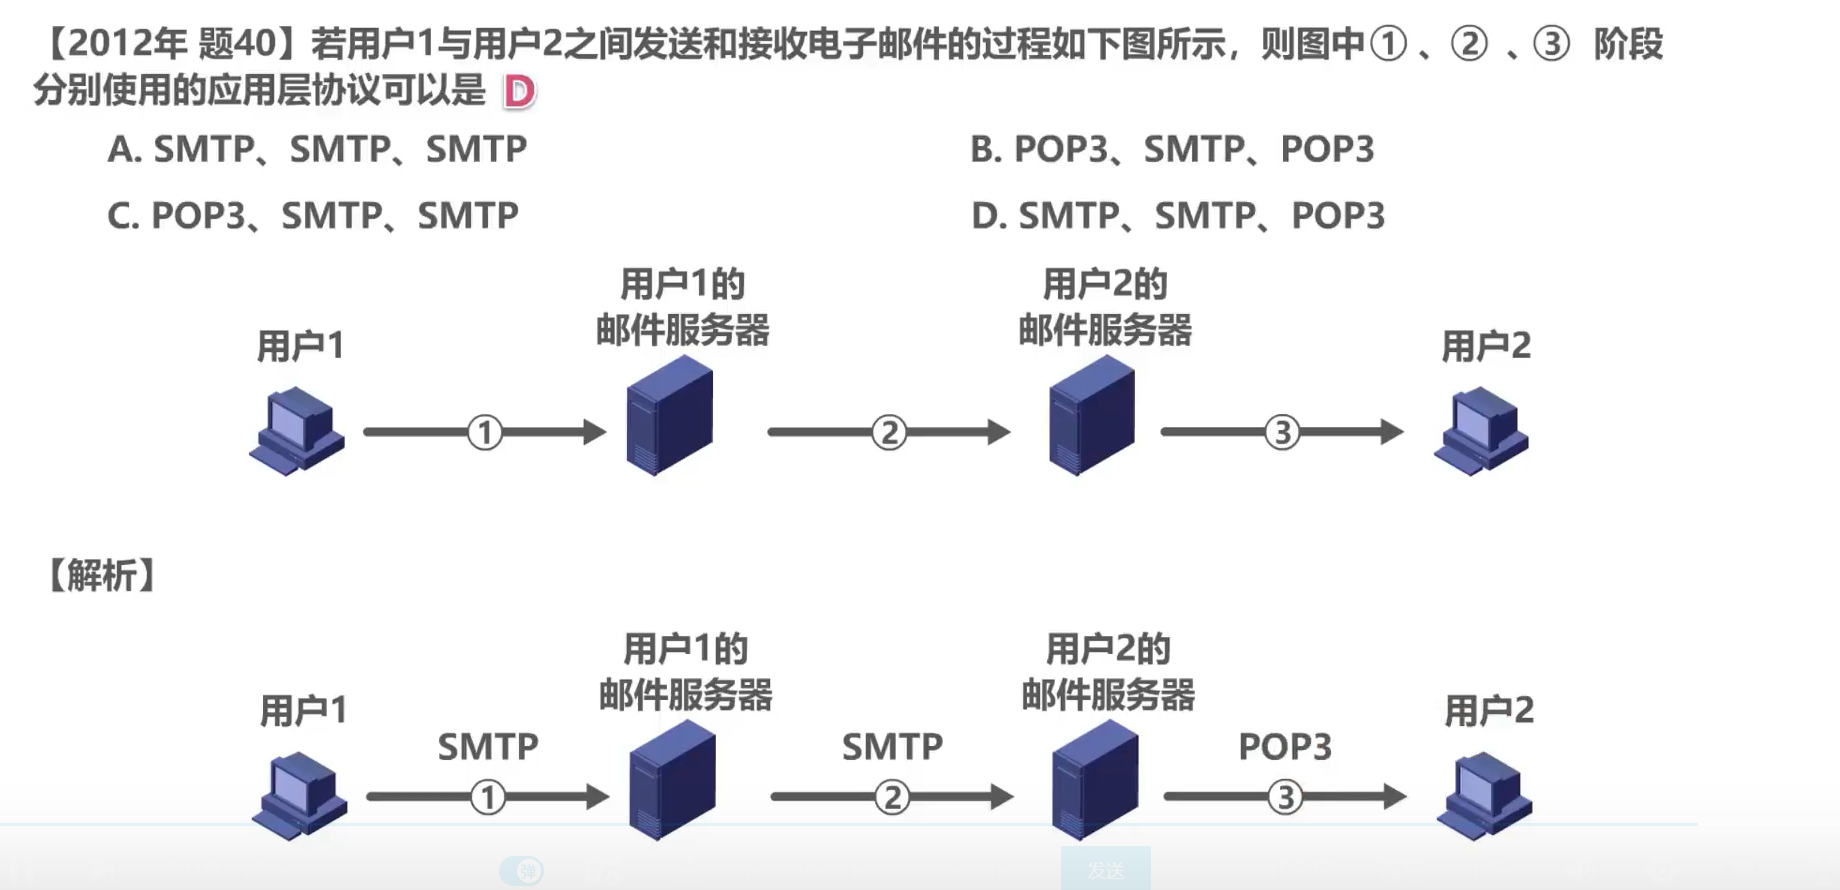
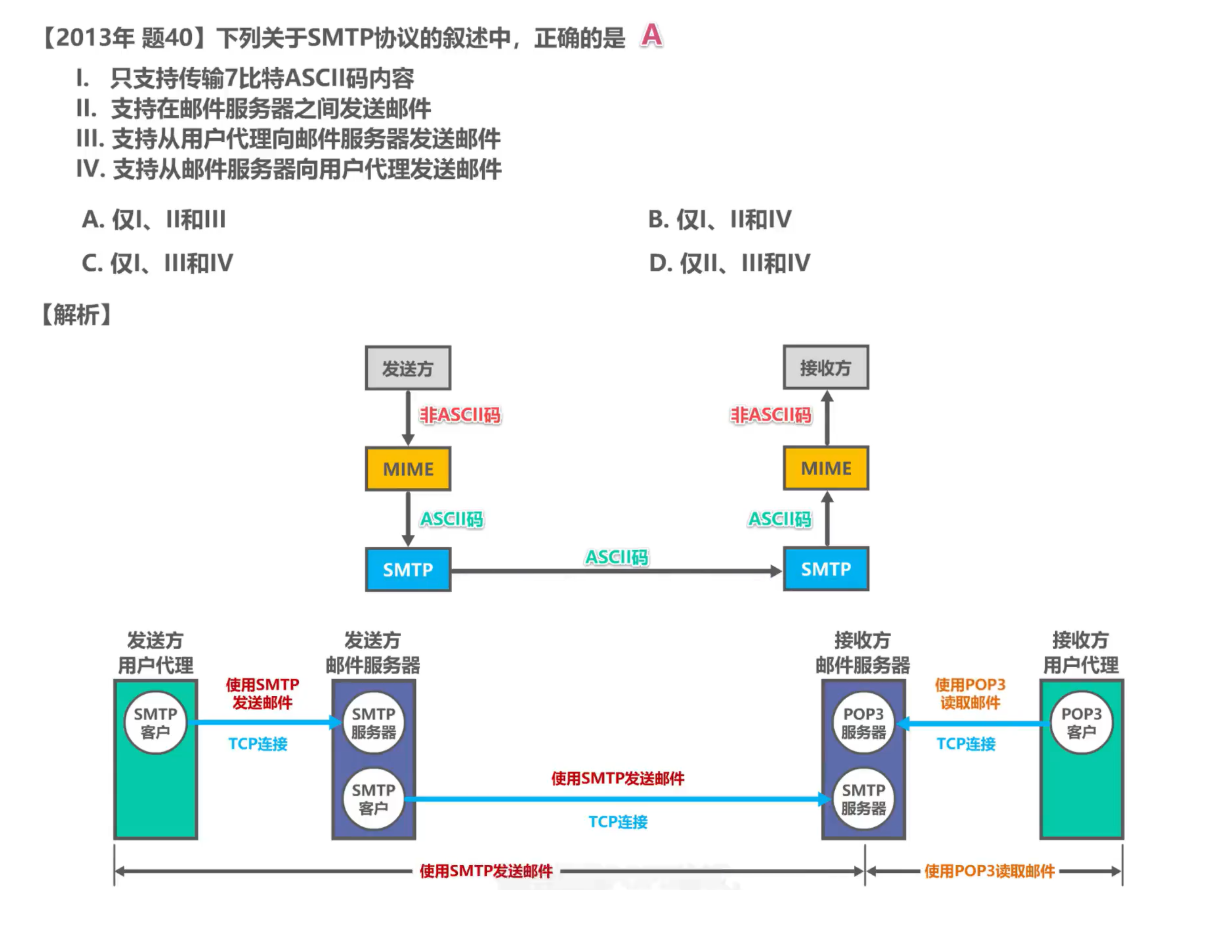
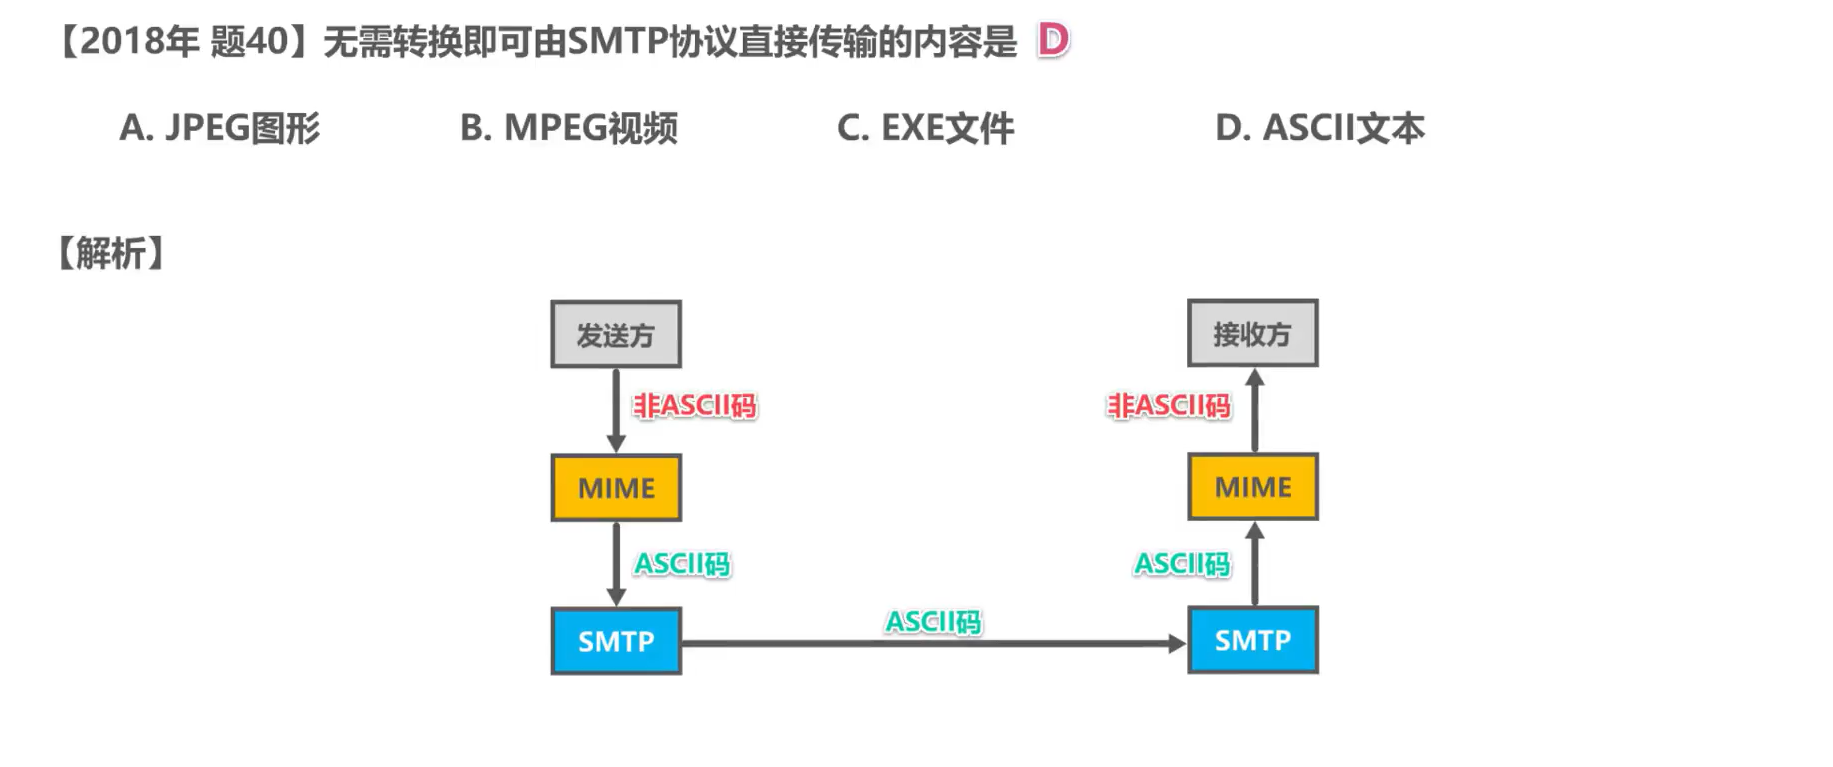
超文本传输协议HTTP
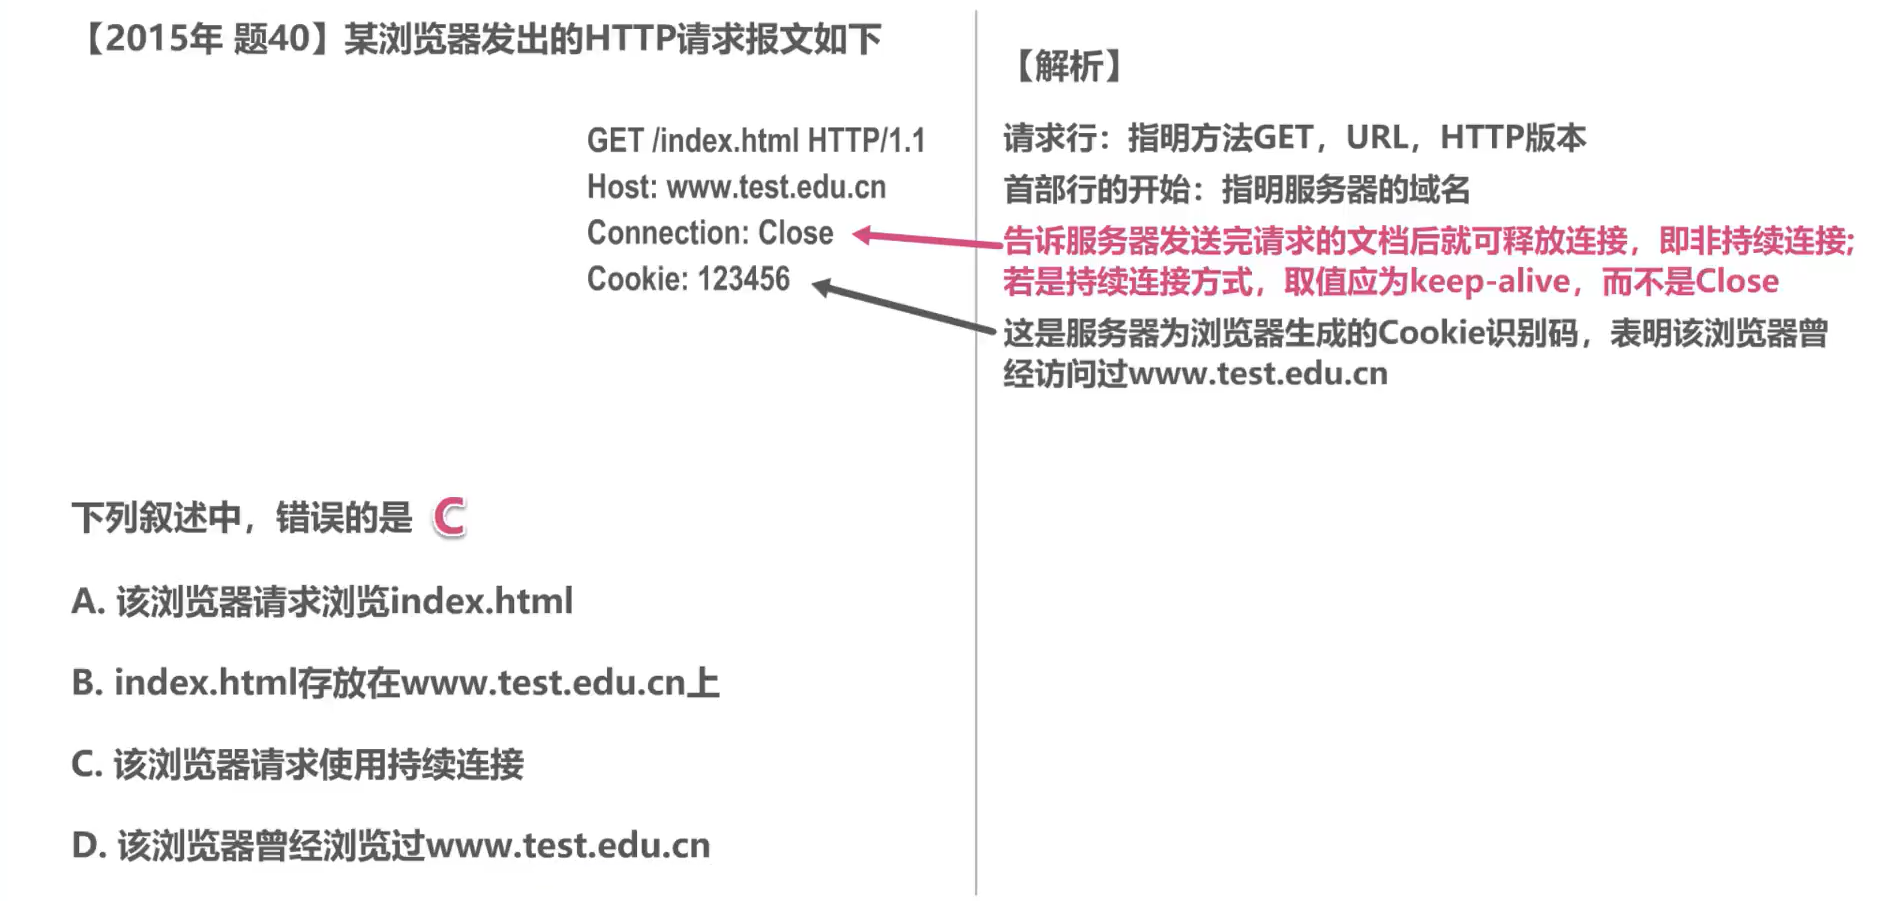
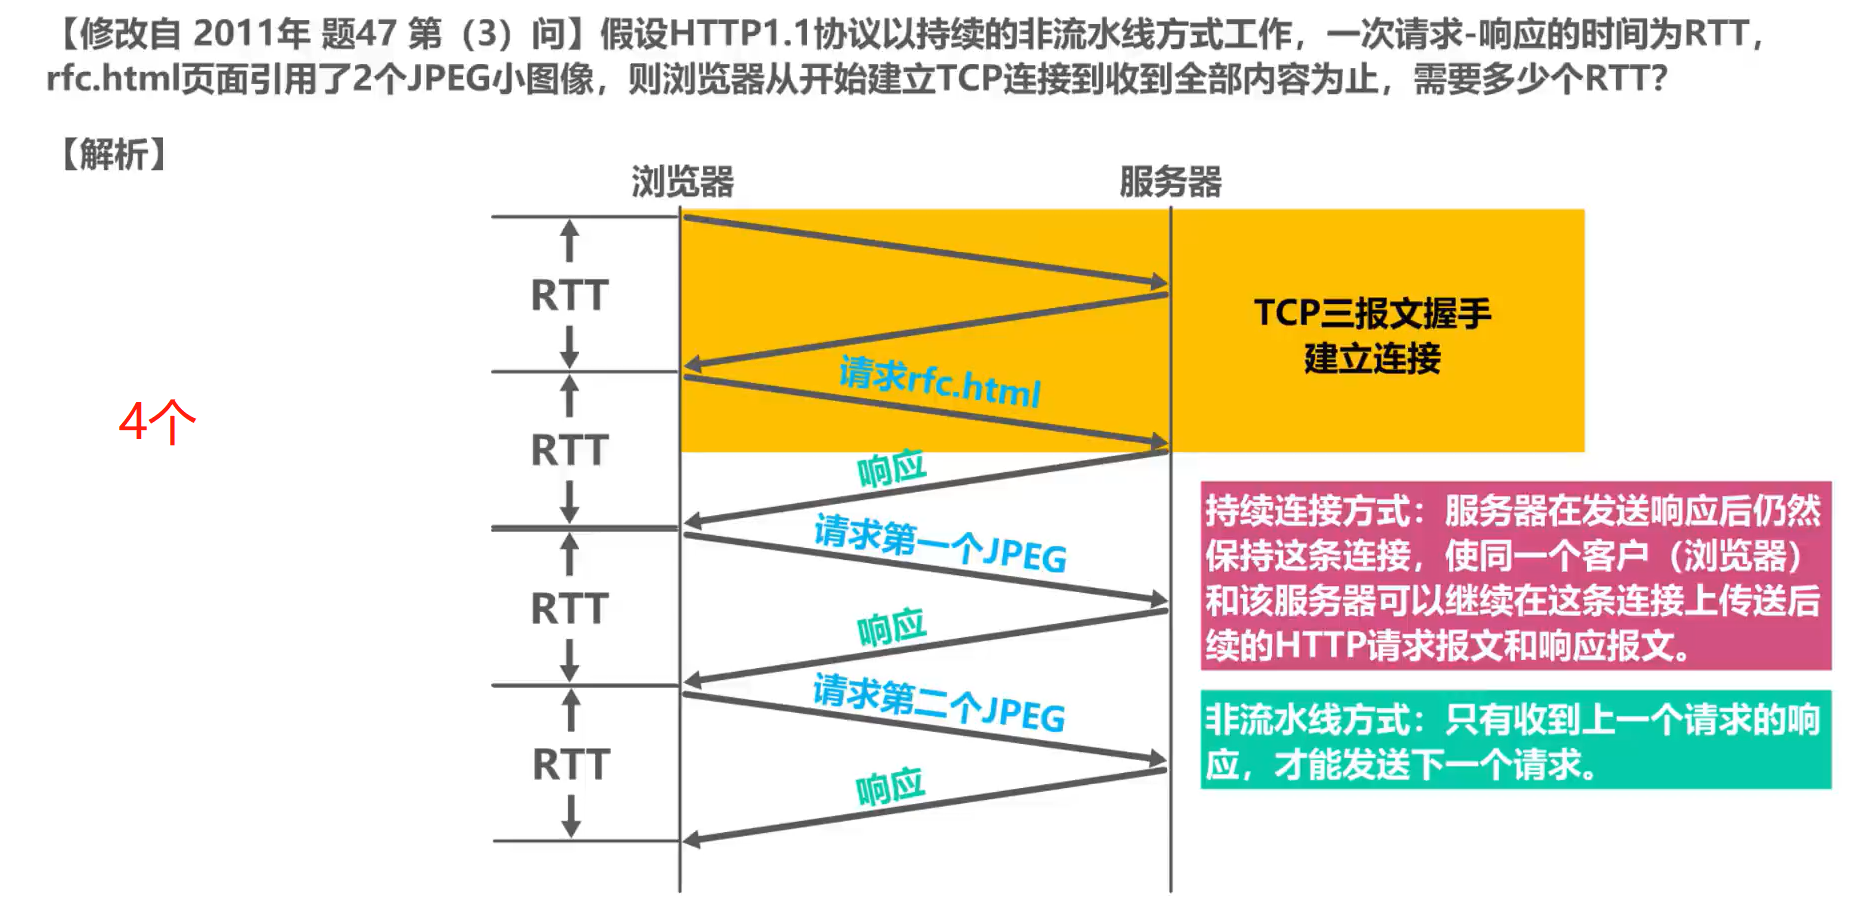
网络是怎么连接的
0、大致流程
- 首先,用户输入网址
- 浏览器解析网址,生成HTTP消息并转交给Socket库
- Socket库将收到 的HTTP消息作为数据转交给协议栈
- TCP按照网络包的长度对数据进行拆分,在每个包前面加上TCP头部并转交给IP——【TCP-HTTP数据块】
- IP在TCP包前加上IP头部,然后查询MAC地址并加上MAC头部,然后将包转交给网卡驱动——【MAC-IP-TCP-HTTP数据块】
- 网卡驱动收到IP发来的包,将其转交给网卡并发出发送指令
- 网卡检查以太网的可发送状态,将包转换成电信号,通过双绞线发送出去
- 信号通过双绞线到达集线器
- 集线器将信号广播到所有端口,信号会到达交换机
- 交换机根据收到的包的接收方MAC地址查询自身的地址表,找到输出端口,并将包转发到输出端口——【IP-TCP-HTTP数据块】
- 互联网接入路由器根据收到的包的接收方IP地址查询自身的路由表,找到输出端口,并将包转发到输出端口(互联网接入路由器输出到互联网的包带有PPPoE头部和PPP头部)——【MAC-PPPoE-PPP-IP-TCP-HTTP数据块】
- ADSL Modem将收到的包拆分成ATM信元,然后转换成电信号通过电话线发送到电话局的DSLAM
- DSLAM(局端多路Modem)将收到的电信号还原成ATM信号并发送给BAS
- BAS将ATM信元还原成网络包,根据接收方IP地址进行转发——【MAC-PPPoE-PPP-IP-TCP-HTTP数据块】
- BAS转发的包加上L2TP头部并通过隧道——【L2TP-PPP-IP-TCP-HTTP数据块】
- 网络包到达位于隧道出口的隧道路由器,L2TP头部和PPP头部被丢弃,通过互联网流向Web服务器【MAC-IP-TCP-HTTP数据块】
- 服务器端的局域网中有防火墙,对进入的包进行检查,判断是否允许通过。Web服务器前面如果有缓存服务器,会拦截通过防火墙的包。如果用户请求的页面已经缓存在服务器上,则代替服务器向用户返回页面数据。如果请求的页面没有被缓存,缓存服务器会将请求转发给Web服务器
- Web服务器收到包后,网卡和网卡驱动会接收这个包并转交给协议栈
- 协议栈依次检查IP头部和TCP头部,如果没有问题则取出HTTP消息的数据进行组装
- HTTP消息被恢复成原始状态,然后通过Socket库转交给Web服务器,Web服务器分析HTTP信息的内容,并根据请求内容将读取的数据返回给客户端
一、浏览器生成消息
1.生成HTTP[^1]请求消息
当使用浏览器输入网址时,浏览器首先会对URL[^2]进行解析,(URL有多种格式^3)浏览器由此可确定服务器的域名和文件名,接下来便根据这些信息生成HTTP请求消息,
[^2]:URL:Uniforn Resource Locator,统一资源定位符,即网址。
[^1]:HTTP:Hypertext Transfer Protocol,超文本传送协议
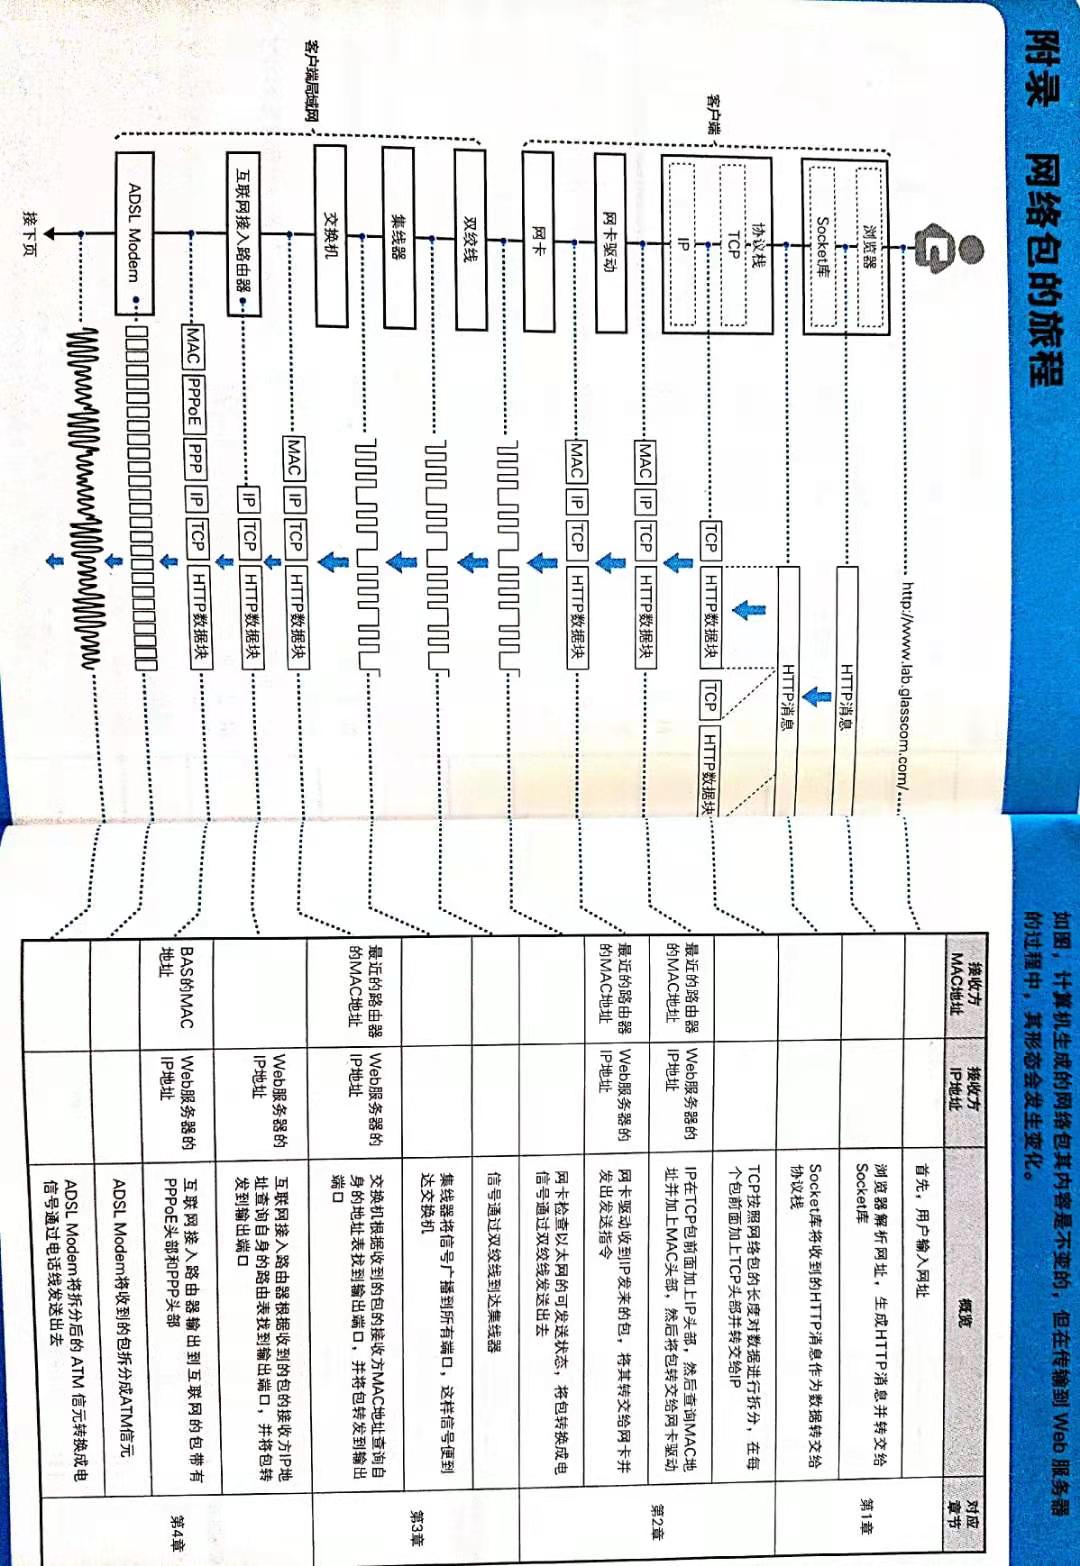
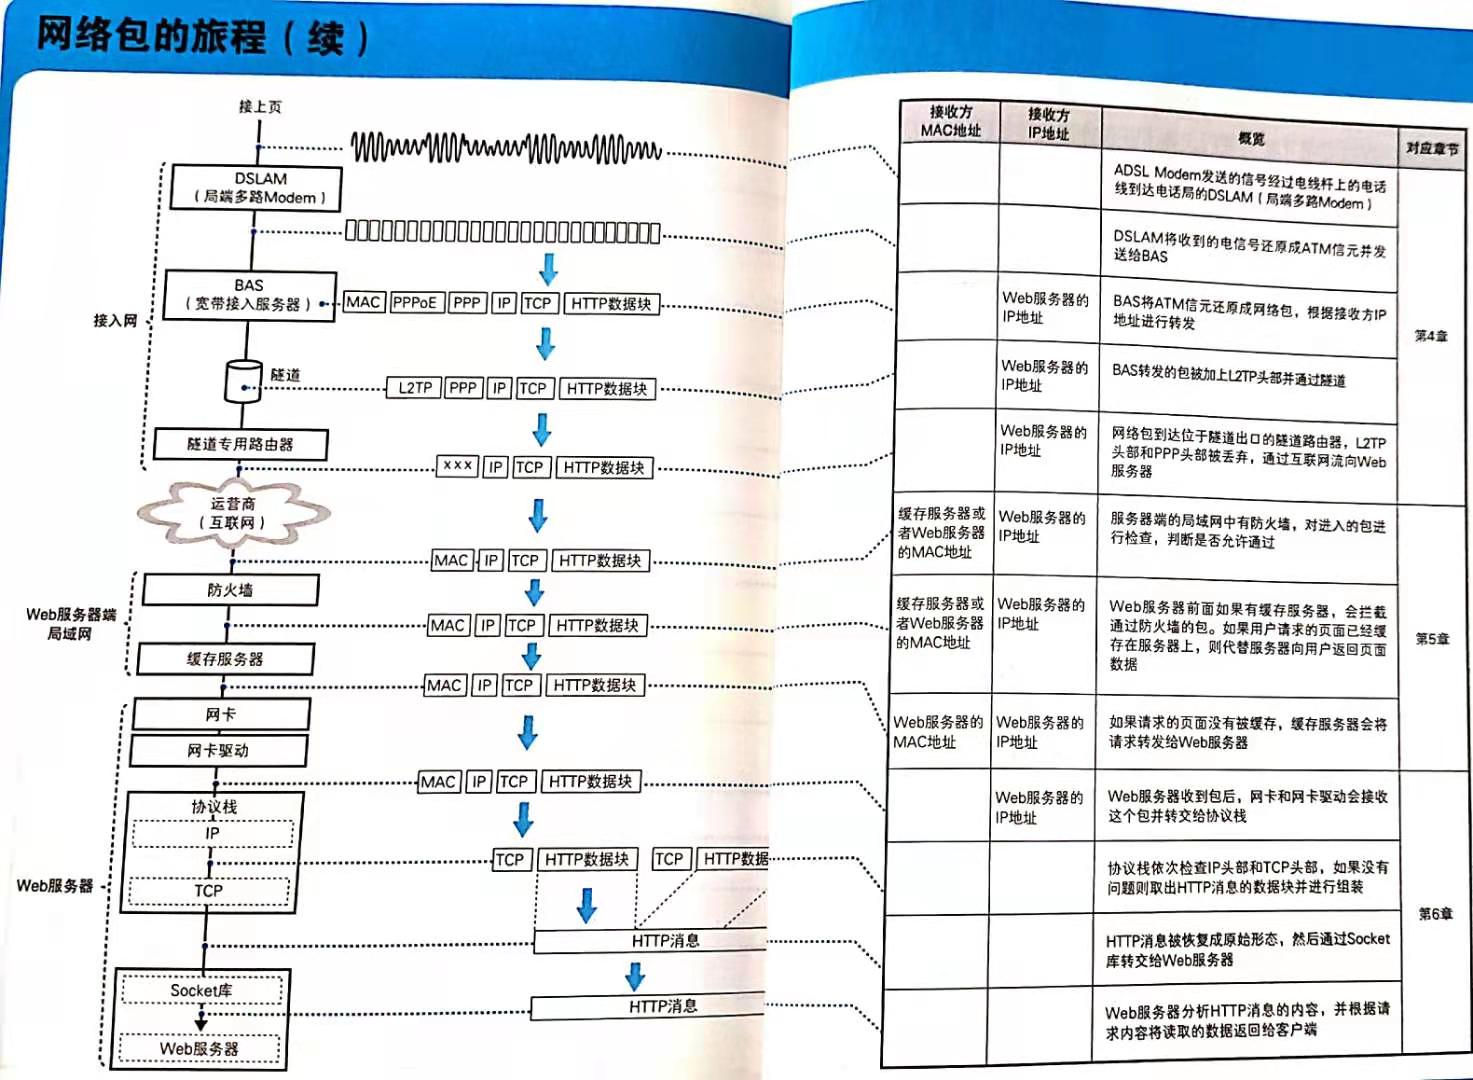
总结
缩写简称
TCP —— 传输控制协议(Transmission Control Protocol)
UDP —— 用户数据报协议(User Datagram Protocol)
HTTP —— 超文本传输协议, HyperText Transfer Protocol
ARP协议 —— 地址解析协议 (Address Resolution Protocol)
QUIC —— 快速UDP互联网连接(Quick UDP Internet Connection)
SSL/TLS ——
SSL 叫 安全套接层,Secure Sockets Layer ,由网景公司设计,因为应用广泛,成为互联网上的事实标准。
IETF 就把 SSL 标准化。标准化之后的名称改为 TLS(Transport Layer Security),叫 传输层安全协议。
RTT —— 往返时间 (Round-Trip Time)
MTU —— 最大传输单元(Maximum Transmit Unit),一个网络包的最大长度,以太网中一般为1500字节
MSS —— 最大分段大小(Maximum Segment Size),TCP提交给IP层最大分段大小(除去IP和TCP头部后,一个网络包所能容纳的TCP数据的最大长度),如果底层物理接口MTU= 1500 byte,则 MSS = 1500- 20(IP Header) -20 (TCP Header) = 1460 byte
ISP —— 因特网服务提供者(Internet Service Provideer)
RFC —— 需求/技术文档(Request For Comments)
ISOC —— 因特网协会(Internet Society)
MPLS —— 多协议标签交换(Multiprotocol Label Switching)
C/S方式 —— 客户端client/服务器server
P2P方式 —— 对等连接(peer-to-peer)
广域网WAN(Wide Area Network)
城域网MAN
局域网LAN
ADSL —— 非对称数字用户线路(Asymmetric Digital Subscriber Line)
数据链路层三种可靠传输:
- 停止-等待协议SW(stop-and-wait)
- 回退N帧协议GBN(go-back-N)
- 选择重传协议SR(Selective Repeat)
PPP协议 —— 点对点协议(Point-to-Point Protocol)
MAC —— 媒体接入控制 / 介质访问控制 (Medium Access Control)
静态划分信道:
FDM —— 频分复用(Frequency Division Multiplexing)
TDM —— 时分复用(Time Division Multiplexing)
STDM —— 统计时分复用(Statistic TDM)
WDM —— 波分复用(Wavelength Division Multiplexing)
CDM —— 码分复用(Code Division Multiplexing)
FDMA —— 频分多址(Frequency Division Multiplexing Access)
TDMA —— 时分多址
CDMA —— 码分多址
动态接入控制:
随机接入 CSMA/CD —— 载波监听多址接入 / 碰撞检测
随机接入 CSMA/CA —— 载波监听多址接入 / 碰撞避免
- 帧间间隔 IFS (InterFrame Space)
MAC地址
HDLC —— 高级数据链路控制(High-Level Data Link Control),面向比特,用以实现远程用户间资源共享以及信息交互。
集线器HUB,交换机Switch
STP —— 生成树协议(用于交换机的协议,Spanning Tree Protocol)
VLAN —— 虚拟局域网(Virtual Local Area Network)
ARP —— 地址解析协议(Address Resolution Protocol)
ICMP —— 网际控制报文协议(Internet Control Message Protocol)
IGMP —— 网际组管理协议(Internet Group Management Protocol)
CIDR —— 无分类域间路由选择 / 无分类编址 (Classless Inter-Domain Routing)
内部网关协议IGP(Interior Gateway Protocol)
- 路由信息协议RIP(Routing Information Protocol)
- 开放式最短路径优先OSPF(Open Shortest Path First)
外部网关协议EGP(Exterior Gateway Protocol)
- 边界网关协议BGP(Border Gateway Protocol)
VPN —— 虚拟专用网(Virtual Private Network)
NAT —— 网络地址转换(Network Address Translation)
TCP —— 传输控制协议(Transmission Control Protocol)
UDP —— 用户数据报协议(User Datagram Protocol)
- TCP:协议字段 6
- SMTP —— 端口25
- FTP —— 21/20
- BGP —— 179
- HTTP —— 80
- HTTPS —— 443
- UDP:协议字段 17
- RIP —— 520
- DNS —— 53
- TFTP —— 69
- SNMP —— 161
- DHCP —— 67/68
- TCP:协议字段 6
DHCP —— 动态主机配置协议(Dynamic Host Configuration Protocol)
DNS —— 域名系统(Domain Name System)
FTP —— 文件传送协议(File Transfer Protocol)
SMTP —— 简单邮件传送协议(Simple Mail Transfer Protocol)
POP —— 邮局协议(Post Office Protocol)
IMAP —— 因特网消息访问协议 / 因特网邮件存放协议(Internet Message Access Protocol)
WWW —— 万维网(World Wide Web)
HTTP —— 超文本传送协议(Hyper Transfer Protocol)
RTSP —— 实时流协议(Real Time Streaming Protocol),是一个网络控制协议,设计用于娱乐、会议系统中控制流媒体服务器。
公式
奈氏准则和香农公式
奈氏准则和香农公式对比:
CSMA/CA 的退避协议:退避时间 = 争用期时长 * 随机数r
拥塞控制算法:
拥塞窗口cwnd,慢开始门限ssthresh
TCP超时重传时间RTO(Retransmission TimeOut):
RTT
S:加权平均往返时间RTT
D:RTT偏差的加权平均标准建议ɑ = 1/8, β = 1/4
RTT
S1= RTT1;新RTT
S= (1-ɑ)*旧RTTS+ ɑ*新RTT样本。RTT
D1= RTT1/ 2;新RTT
D= (1-β)*旧RTTD+ β*|RTTS- 新RTT样本|。RTO = RTT
S+ 4 * RTTD
报文格式
以太网MAC帧,PPP帧格式
IP数据报首部
TCP首部
UDP首部: 仅8字节
- 源端口:2字节
- 目的端口:2字节
- 长度:2字节
- 校验和:2字节
常见端口
| 端口 | 服务 | 描述 |
|---|---|---|
| 20 /TCP,UDP | FTP [Default Data] | 文件传输协议 - 默认数据端口 |
| 21 /TCP,UDP | FTP [Control] | 文件传输协议 - 控制端口 |
| 22 /TCP,UDP | SSH | SSH(Secure Shell) - 远程登录协议,用于安全登录文件传输(SCP,SFTP)及端口重新定向 |
| 23 /TCP,UDP | Telnet | Telnet终端仿真协议 - 未加密文本通信 |
| 25 /TCP,UDP | SMTP | SMTP(简单邮件传输协议) - 用于邮件服务器间的电子邮件传递 |
| 43 /TCP | WHOIS | WHOIS协议(who is ,查询域名的相关信息) |
| 53 /TCP,UDP | DNS | DNS(域名服务系统) |
| 67 /UDP | BOOTPs | BOOTP服务端;同时用于动态主机设置协议 (BootStrap协议,引导程序协议,是DHCP的前身) |
| 68 /UDP | BOOTPc | BOOTP客户端;同时用于动态主机设定协议 |
| 69 /UDP | TFTP | 小型文件传输协议(小型文件传输协议) |
| 80 /TCP | HTTP | 超文本传输协议(超文本传输协议)- 用于传输网页 |
| 110 /TCP | POP3 | 邮局协议,“邮局协议”,第3版 - 用于接收电子邮件 |
| 113 /TCP | Windows验证服务 | Ident - 旧的服务器身份识别系统,仍然被IRC服务器用来认证它的用户 |
| 123 /UDP | NTP | NTP(Network Time Protocol) - 用于网络时间同步 |
| 137 /TCP,UDP | NetBIOS Name Service | NetBIOS(网上基本输入输出系统), NetBIOS 名称服务 |
| 138 /TCP,UDP | NetBIOS Datagram Service | NetBIOS NetBIOS 数据报文服务 |
| 139 /TCP,UDP | NetBIOS Session Service | NetBIOS NetBIOS 会话服务 |
| 143 /TCP,UDP | IMAP | 因特网信息访问协议(Internet Message Access Protocol) - 用于检索 电子邮件 |
| 161 /TCP,UDP | SNMP | 简单网络管理协议 |
| 179 /TCP | Bgp | 边界网关协议 (Border Gateway Protocol) |
| 194 /TCP | IRC | 互联网中继聊天(Internet Relay Chat) |
| 220 /TCP,UDP | IMAP3 | 因特网信息访问协议,交互邮件访问协议第3版 |
| 389 /TCP,UDP | LDAP | 轻型目录访问协议(Lightweight Directory Access Protocol) |
| 443 /TCP | HTTPS | 超文本传输安全协议 - 超文本传输协议 over TLS/SSL(加密传输) |
| 546 /TCP,UDP | DHCPv6 client | DHCPv6客户端(动态主机配置协议,Dynamic Host Configuration Protocol) |
| 547 /TCP,UDP | DHCPv6 server | DHCPv6服务器 |
| 631 /TCP,UDP | CUPS | 通用Unix打印系统 |
| 636 /TCP,UDP | LDAPS | LDAP over SSL(加密传输,也被称为LDAPS) |
| 991 /TCP,UDP | NAS | NAS (Netnews Admin System, 网络新闻管理系统 ) |
| 1080 /tcp | SOCKS | SOCKS代理 |
| 1194 /udp | OpenVPN | OpenVPN |
| 1433 /tcp,udp | SQL Server | Microsoft SQL 数据库系统 |
| 1434 /tcp,udp | SQL Server monitor | Microsoft SQL 活动监视器 |
| 1521 /tcp | Oracle | Oracle数据库 default listener, in future releases official port 2483 |
| 3306 /tcp,udp | MySQL | MySQL数据库系统 |
| 3389 /tcp | RDP | 远程桌面协议(RDP) |
| 5432 /tcp | PostgreSQL | PostgreSQL database system |
一些试题
脉冲编码调制的过程简单的说可分为三个过程,它们是采样、量化和编码。
载波监听多路访问/冲突检测(CDMA/CD)的原理可以概括为先听后发,边听边
发,冲突停发,随机重发。
频分多址、时分多址、码分多址
答:
频分多址:是把通信系统的总频段划分成若干个等间隔的信道分配给不同的用户使用。
时分多址:是把时间分割成周期性的帧,每一帧再分割成若干个时隙(互不重叠的),然后根据一定的时隙分配原则,分配给不同的用户使用。
码分多址:不同用户间用各自不同的编码序列来区分,不同的用户可以使用相同的信道和时隙。
试简单说明IPv6如何通过隧道技术实现IPv6与IPv4设备间的通信(画图与文字描述结合说明)。(本题6分)
答:在 IPv6 数据报要进入 IPv4 网络时,把 IPv6 数据报封装成为 IPv4 数据报,整个的 IPv6 数据报变成了 IPv4 数据报的数据部分。(1.5分)
当 IPv4 数据报离开 IPv4 网络中的隧道时,再把数据部分(即原来的 IPv6 数据报)交给主机的 IPv6 协议栈。(1.5分)
TCP/IP协议包括:
应用层:Telnet,FTP,SMTP,SNMP,DHCP,
传输层:UDP,TCP
网络层:IP,ICMP,IGMP
网络接口层:ARP,RARP,PPP
平常使用的PING属于ICMP协议
数据链路层使用的两种主要信道分别是 点对点信道 和 广播信道。
能同时兼容IEEE802.11a和IEEE802.11b的协议是 IEEE 802.11n
以太网交换机进行转发决策时使用的PDU地址是 目的物理地址
若将网络21.3.0.0/16划分为128个规模相同的子网,则每个子网可以分配的最大IP地址个数是 510.
解:
128个子网,占用的地址bit位是7个,因此主机位是32 - 16 - 7 = 9 位,主机IP有 2^9^-2 ,所以每个子网最多的可用IP是510个。
为什么ICMP协议要读取运输层端口号开始的前4个字节?
便于ICMP协议读取端口号前4个字节,端口号对应相关进程。
共有四个站进行码分多址CDMA通信。四个站的码片序列为:
A(-1 -1-1+1+1-1+1+1)      B(-1-1+1-1+1+1+1-1)

C(-1+1-1+1+1+1-1-1)       D(-1+1-1-1-1-1+1-1)

现在收到这样的码片序列:(-1+1-3+1-1-3+1+1).问哪个站发送数据了?发送数据的站发送的1还是0?

S·A=(+1-1+3+1-1+3+1+1)/8=1, A 发送1

S·B=(+1-1-3-1-1-3+1-1)/8=-1, B 发送0

S·C=(+1+1+3+1-1-3-1-1)/8=0, C 无发送

S·D=(+1+1+3-1+1+3+1-1)/8=1, D 发送1
14.