2.两数相加(M) 给你两个 非空 的链表,表示两个非负的整数。它们每位数字都是按照 逆序 的方式存储的,并且每个节点只能存储 一位 数字。
请你将两个数相加,并以相同形式返回一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0 开头。
1
2
3
输入:l1 = [2,4,3], l2 = [5,6,4] 输出:[7,0,8] 解释:342 + 465 = 807.
模拟 要注意的点:
节点和大于9,要注意进位;
最后一个节点进位要额外新加一个节点
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 class Solution { public ListNode addTwoNumbers (ListNode l1, ListNode l2) { ListNode list = new ListNode (l1.val + l2.val); int flag = 0 ; if (list.val > 9 ) { flag = 1 ; list.val %= 10 ; } ListNode ans = list; l1 = l1.next; l2 = l2.next; while (l1 != null || l2 != null ) { list.next = new ListNode (0 ); if (l1 != null && l2 != null ) { list.next = new ListNode (l1.val + l2.val); l1 = l1.next; l2 = l2.next; } else { list.next = new ListNode (l1 != null ? l1.val : l2.val); l1 = l1 != null ? l1.next : l1; l2 = l2 != null ? l2.next : l2; } list = list.next; if (flag == 1 ) { list.val++; flag = 0 ; } if (list.val > 9 ) { list.val %= 10 ; flag = 1 ; } } if (flag == 1 ) { list.next = new ListNode (1 ); } return ans; } }
3.无重复字符的最长子串(M) 给定一个字符串 s ,请你找出其中不含有重复字符的 最长子串 的长度。
1
2
3
4
5
6
7
8
示例: 输入: s = "pwwkew" 输出: 3 解释: 因为无重复字符的最长子串是 "wke" ,所以其长度为 3 。 请注意,你的答案必须是 子串 的长度,"pwke" 是一个子序列,不是子串。 输入: s = "" 输出: 0
滑动窗口 思路:
使用滑动窗口:每一步的操作中,我们会将左指针向右移动一格,表示 我们开始枚举下一个字符作为起始位置 ,然后我们可以不断地向右移动右指针,但需要保证这两个指针对应的子串中没有重复的字符。在移动结束后,这个子串就对应着 以左指针开始的,不包含重复字符的最长子串 。我们记录下这个子串的长度;
使用哈希集合判断是否有字符重复
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution { public int lengthOfLongestSubstring (String s) { HashSet<Character> set= new HashSet <>(); int ans = 0 , r = -1 ; int n = s.length(); for (int i = 0 ; i < n; i++) { if (i != 0 ){ set.remove(s.charAt(i - 1 )); } while (r + 1 < n && !set.contains(s.charAt(r + 1 ))){ set.add(s.charAt(r + 1 )); r++; } ans = Math.max(ans, r - i + 1 ); } return ans; } }
4.寻找两个正序数组的中位数(D ) 给定两个大小分别为 m 和 n 的正序(从小到大)数组 nums1 和 nums2。请你找出并返回这两个正序数组的 中位数 。
1
2
3
输入:nums1 = [1 ,3 ], nums2 = [2 ] 输出:2.00000 解释:合并数组 = [1 ,2 ,3 ] ,中位数 2
方法一:
暴力法:直接将两个数组加入到一个新数组,排序,再求中位数
时间复杂度:O((m+n)*log(m+n) );空间:O(m+n)
将两个数组的值从小到大 合并到新数组,再求中位数
时间复杂度:O(m+n );空间:O(m+n)
方法二:
不需要合并两个有序数组,只要找到中位数的位置即可。由于两个数组的长度已知,因此中位数对应的两个数组的下标之和也是已知的。维护两个指针,初始时分别指向两个数组的下标 00 的位置,每次将指向较小值的指针后移一位(如果一个指针已经到达数组末尾,则只需要移动另一个数组的指针),直到到达中位数的位置。
时间复杂度:O(m+n );空间:O(1)
二分查找 这道题可以转化成寻找两个有序数组中的第 k 小的数,其中 k 为 (m+n)/2 或 (m+n)/2+1。
找到第 k 个元素,我们可以比较 A[k/2-1] 和B[k/2-1],
可以归纳出三种情况:
如果 A[k/2-1] < B[k/2-1],则比 A[k/2−1] 小的数最多只有 A 的前 k/2−1 个数和 B 的前 k/2−1 个数,即比 A[k/2−1] 小的数最多只有 k-2 个,因此 A[k/2−1] 不可能是第 k 个数,A[0] 到 A[k/2−1] 也都不可能是第 k 个数,可以全部排除。
如果 A[k/2−1]>B[k/2−1],则可以排除 B[0] 到 B[k/2−1]。
如果 A[k/2−1]=B[k/2−1],则可以归入第一种情况处理。
可以看到,比较 A[k/2−1] 和 B[k/2−1] 之后,可以排除 k/2k/2 个不可能是第 k 小的数,查找范围缩小了一半。同时,我们将在排除后的新数组上继续进行二分查找,并且根据我们排除数的个数,减少 k 的值,这是因为我们排除的数都不大于第 k 小的数。
有以下三种情况需要特殊处理:
如果 A[k/2−1] 或者B[k/2−1] 越界,那么我们可以选取对应数组中的最后一个元素。在这种情况下,我们必须根据排除数的个数减少 k 的值,而不能直接将 k 减去 k/2。
如果一个数组为空,说明该数组中的所有元素都被排除,我们可以直接返回另一个数组中第 k 小的元素。
如果 k=1,我们只要返回两个数组首元素的最小值即可。
用一个例子说明:
A: 1 3 4 93 4 5 6 7 8 9
k = (4 + 9 ) / 2 + 1 = 7;
比较两个数组下标为k / 2 - 1 = 2的数,即A[2] 和B[2]
由于A[2] > B[2] ,所以排除B[0] 到B[2],数组B的下标偏移变为3,同时更新k的值:K = K - K / 2 = 4;
下一步寻找,比较下标为 K / 2 - 1 = 1的数,即A[1] 和B[4]
A: 1 3 4 91 2 3 4 5 6 7 8 9
由于 A[1] < B[4],因此排除 A[0] 到 A[1],即数组 A 的下标偏移变为 2,同时更新 k 的值:k = k - k/2=2。
下一步寻找,比较两个有序数组中下标为 k/2-1=0 的数,即比较 A[2] 和 B[3]
A: 1 3 4 91 2 3 4 5 6 7 8 9
由于A[2]=B[3],根据之前的规则,排除A 中的元素,因此排除 A[2],即数组 A 的下标偏移变为 3,同时更新 k 的值: k=k-k/2=1。
由于 k 的值变成 1,因此比较两个有序数组中的未排除下标范围内的第一个数,其中较小的数即为第 k 个数,由于 A[3] > B[3],因此第 k 个数是 B[3]=4。
A: 1 3 4 9
B: 1 2 3 4 5 6 7 8 9
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
class Solution { public double findMedianSortedArrays (int [] nums1, int [] nums2) { int length1 = nums1.length, length2 = nums2.length; int totalLength = length1 + length2; if (totalLength % 2 == 1 ) { int midIndex = totalLength / 2 ; double median = getKthElement(nums1, nums2, midIndex + 1 ); return median; } else { int midIndex1 = totalLength / 2 - 1 , midIndex2 = totalLength / 2 ; double median = (getKthElement(nums1, nums2, midIndex1 + 1 ) + getKthElement(nums1, nums2, midIndex2 + 1 )) / 2.0 ; return median; } } public int getKthElement (int [] nums1, int [] nums2, int k) { int length1 = nums1.length, length2 = nums2.length; int index1 = 0 , index2 = 0 ; int kthElement = 0 ; while (true ) { if (index1 == length1) { return nums2[index2 + k - 1 ]; } if (index2 == length2) { return nums1[index1 + k - 1 ]; } if (k == 1 ) { return Math.min(nums1[index1], nums2[index2]); } int half = k / 2 ; int newIndex1 = Math.min(index1 + half, length1) - 1 ; int newIndex2 = Math.min(index2 + half, length2) - 1 ; int pivot1 = nums1[newIndex1], pivot2 = nums2[newIndex2]; if (pivot1 <= pivot2) { k -= (newIndex1 - index1 + 1 ); index1 = newIndex1 + 1 ; } else { k -= (newIndex2 - index2 + 1 ); index2 = newIndex2 + 1 ; } } } }
时间复杂度:O(log(m+n) );空间:O(1)
划分数组 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 class Solution { public double findMedianSortedArrays (int [] nums1, int [] nums2) { int leftLength = nums1.length; int rightLength = nums2.length; if (leftLength > rightLength) { return findMedianSortedArrays(nums2, nums1); } int totalLeft = (leftLength + rightLength + 1 ) / 2 ; int left = 0 ; int right = leftLength; while (left < right) { int i = left + (right - left + 1 ) / 2 ; int j = totalLeft - i; if (nums1[i - 1 ] > nums2[j]) { right = i - 1 ; } else { left = i; } } int i = left; int j = totalLeft - i; int nums1LeftMax = i == 0 ? Integer.MIN_VALUE : nums1[i - 1 ]; int nums1RightMin = i == leftLength ? Integer.MAX_VALUE : nums1[i]; int nums2LeftMax = j == 0 ? Integer.MIN_VALUE : nums2[j - 1 ]; int nums2RightMin = j == rightLength ? Integer.MAX_VALUE : nums2[j]; if (((leftLength + rightLength) % 2 ) == 1 ) { return Math.max(nums1LeftMax, nums2LeftMax); } else { return (double ) ((Math.max(nums1LeftMax, nums2LeftMax) + Math.min(nums1RightMin, nums2RightMin))) / 2 ; } } }
时间复杂度:O(log min(m+n) );空间:O(1)
5.最长回文子串(M) 给你一个字符串 s,找到 s 中最长的回文子串。
1 2 3 4 5 6 7 示例1 : 输入:s = "babad" 输出:"bab" 解释:"aba" 同样是符合题意的答案。 示例2 : 输入:s = "ac" 输出:"a"
中心扩散 从每一个位置出发,向两边扩散即可。遇到不是回文的时候结束。
首先往左寻找与当期位置相同的字符,直到遇到不相等为止。
然后往右寻找与当期位置相同的字符,直到遇到不相等为止。
最后左右双向扩散,直到左和右不相等。
每个位置向两边扩散都会出现一个窗口大小(templen)。如果 templen > maxLen,则更新 maxLen 的值。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
class Solution { public String longestPalindrome (String s) { int n = s.length(); if (n == 1 || n == 2 && s.charAt(0 ) == s.charAt(1 )) return s; int maxlen = 0 , templen = 0 , lIndex = 0 , rIndex = 0 ; for (int mid = 1 ; mid < n - 1 ; mid++){ int i = mid - 1 , j = mid + 1 ; while (i >= 0 && s.charAt(i) == s.charAt(mid)){ i--; templen++; } while (j < n &&s.charAt(j) == s.charAt(mid)){ j++; templen++; } for (; i >= 0 && j < n; i--, j++){ if (s.charAt(i) == s.charAt(j)){ templen += 2 ; }else break ; } if (maxlen < templen){ maxlen = templen; lIndex = i + 1 ; rIndex = j - 1 ; } templen = 0 ; } return s.substring(lIndex, rIndex + 1 ); } }
时间复杂度:O(n^2)空间复杂度: O(1)
动态规划 对于一个子串而言,如果它是回文串,并且长度大于 22,那么将它首尾的两个字母去除之后,它仍然是个回文串。
边界条件: 子串长度小于2 时一定为回文串,即 : j - 1 - ( i + 1 ) + 1 < 2 ,整理得 j - i = 3
状态转移方程:
dp[ i ] [ j ] = ( s [ i ] == s [ j ] ) and ( j - i < 3 or dp[ i + 1] [j - 1] )
由于dp [ i ] [ j ] 参考它左下方的值,所以应该按列升序 填写
例如:
字符
b
a
b
a
b
下标
0
1
2
3
4
子串右边界
0
1
2
3
4
子串左边界
0
true
false
true false
true
1
true
false
true false
2
true
false
true
3
true
flase
4
true
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
public class Solution { public String longestPalindrome (String s) { int len = s.length(); if (len < 2 ) { return s; } int maxLen = 1 ; int begin = 0 ; boolean [][] dp = new boolean [len][len]; for (int i = 0 ; i < len; i++) { dp[i][i] = true ; } char [] charArray = s.toCharArray(); for (int L = 2 ; L <= len; L++) { for (int i = 0 ; i < len; i++) { int j = L + i - 1 ; if (j >= len) { break ; } if (charArray[i] != charArray[j]) { dp[i][j] = false ; } else { if (j - i < 3 ) { dp[i][j] = true ; } else { dp[i][j] = dp[i + 1 ][j - 1 ]; } } if (dp[i][j] && j - i + 1 > maxLen) { maxLen = j - i + 1 ; begin = i; } } } return s.substring(begin, begin + maxLen); } }
时间复杂度:O(n^2)空间复杂度: O(n^2)
Manacher (马拉车)算法 专门用于查找最长回文子串的算法,时间复杂度:O(n)
10.正则表达式匹配(D) 给你一个字符串 s 和一个字符规律 p,请你来实现一个支持 ‘ . ‘ 和 ‘ * ‘ 的正则表达式匹配。
‘ . ‘ 匹配任意单个字符
所谓匹配,是要涵盖 整个 字符串 s的,而不是部分字符串。
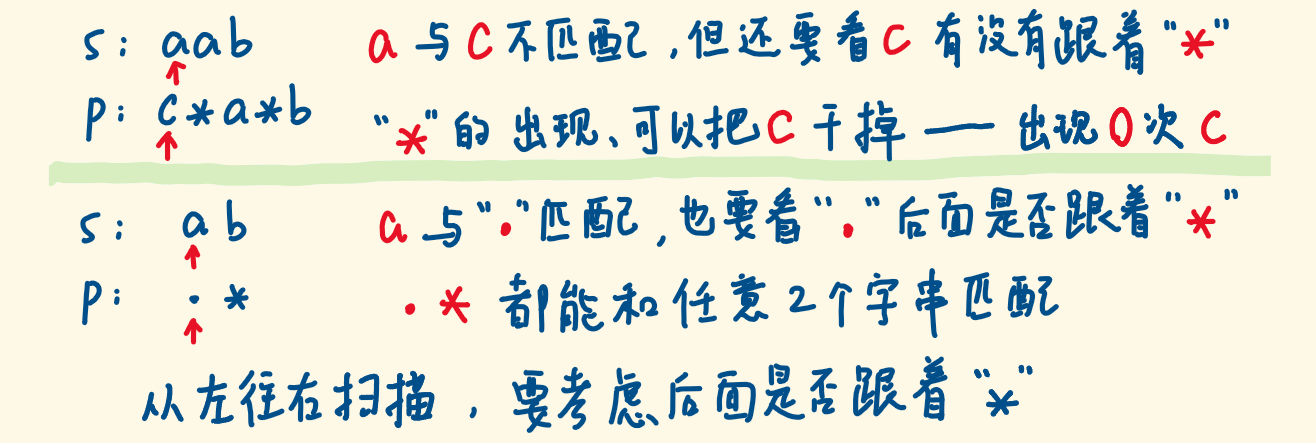
动态规划 从左往右扫的话
字符后面是否跟着星号会影响结果,分析起来有点复杂。
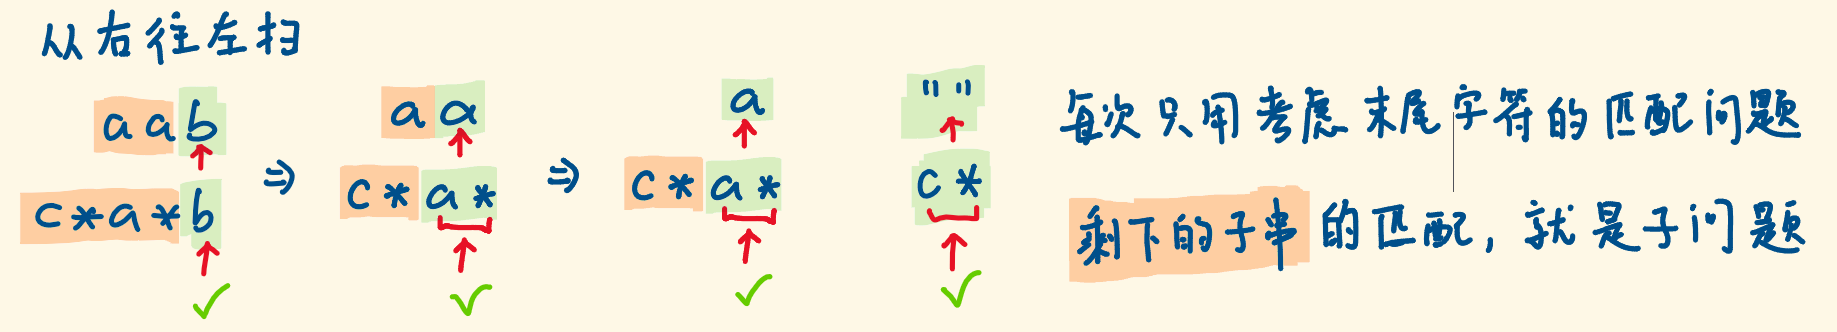
所以选择从右往左扫描:
星号的前面肯定有一个字符,星号也只影响这一个字符,它就像一个拷贝器。
s、p 串是否匹配,取决于:最右端是否匹配、剩余的子串是否匹配。
只是最右端可能是特殊符号,需要分情况讨论而已。
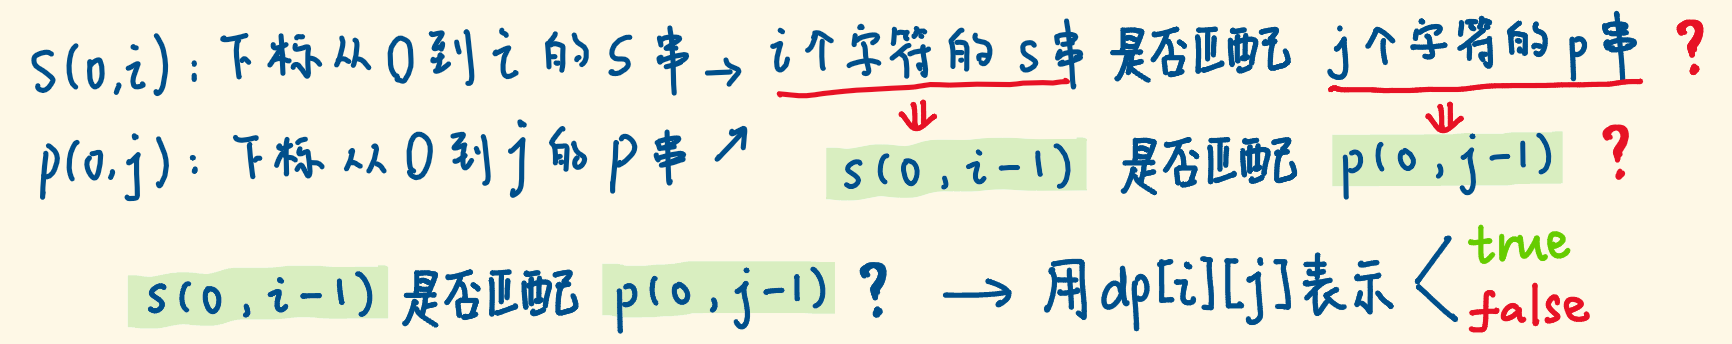
通用地表示出子问题:
大子串是否匹配,和剩余子串是否匹配,是规模不一样的同一问题。
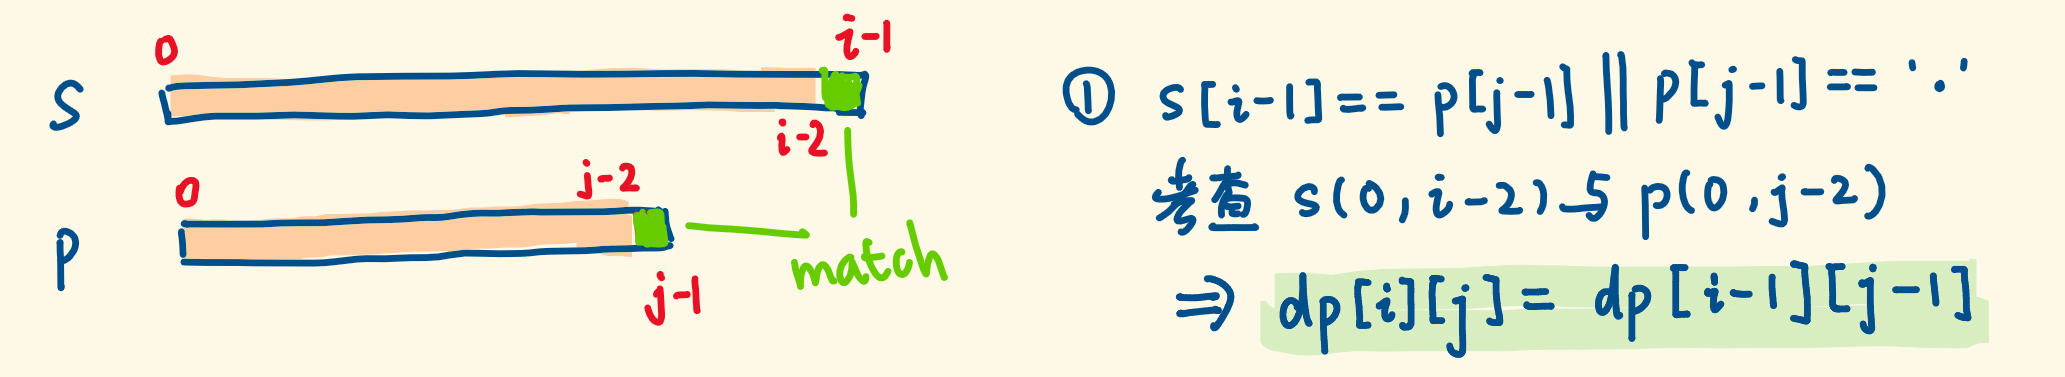
*情况1:s[i-1] 和 p [j −1] 是匹配的 *
最右端的字符是匹配的,那么,大问题的答案 = 剩余子串是否匹配。
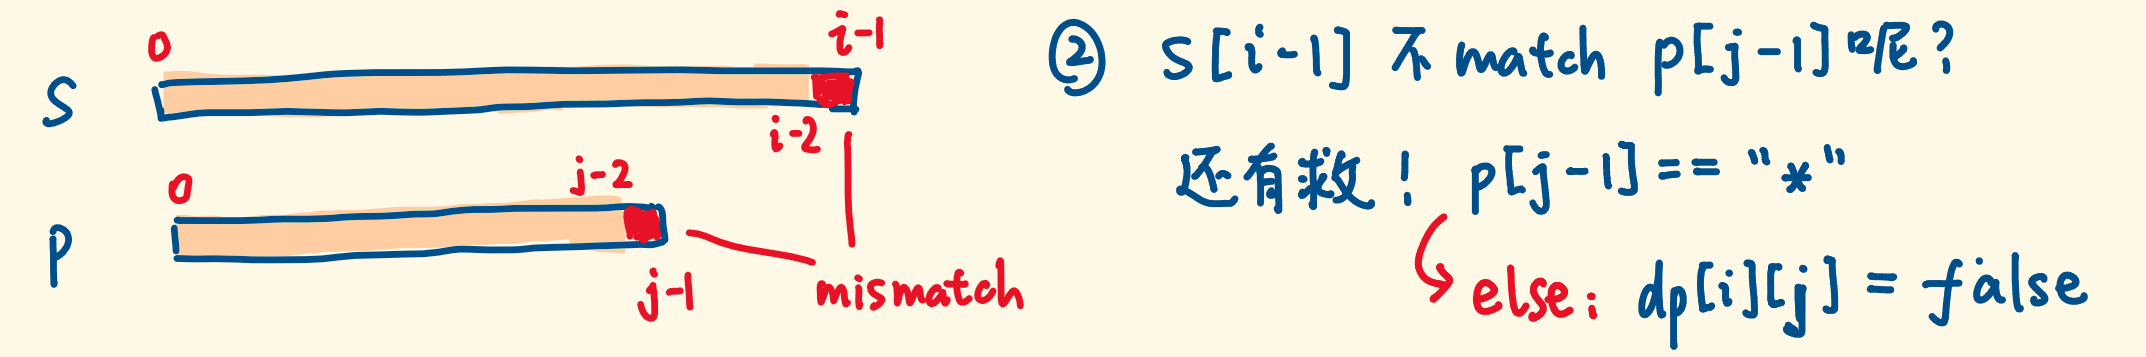
情况2:s[i-1] 和 p[j-1] 是不匹配的
右端不匹配,还不能判死刑——可能是 p[j-1]p [j −1] 为星号造成的不匹配,星号不是真实字符,它不匹配不算数。
如果 p[j-1]p [j −1] 不是星号,那就真的不匹配了。
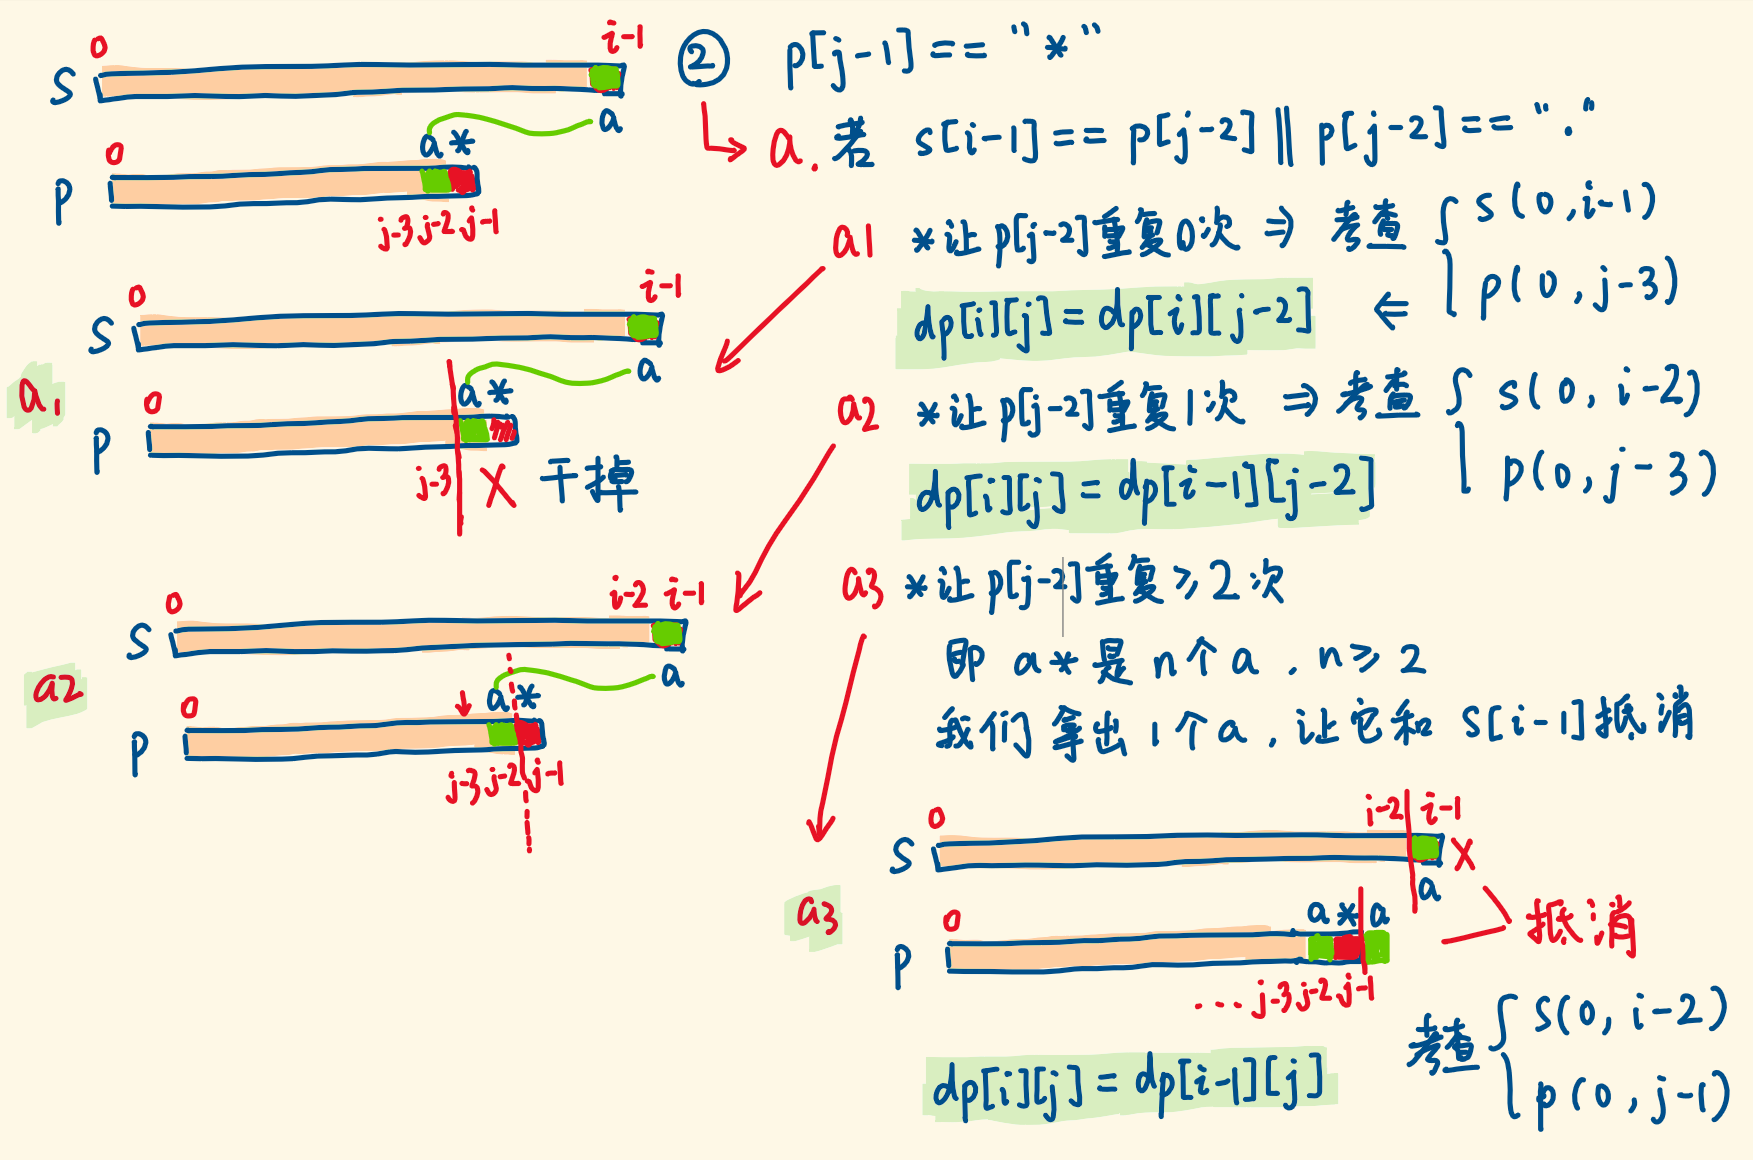
p[j-1] ==”∗”,且 s[i-1] 和 p[j-2] 匹配
p[j-1]p [j −1]是星号,并且 s[i-1] 和 p[j-2] 匹配,要考虑三种情况:
p[j-1] 星号可以让 p[j-2]在 p 串中消失、出现 1 次、出现 >=2 次。
只要其中一种使得剩余子串能匹配,那就能匹配,见下图 a1、a2、a3。
a3 情况:假设 s 的右端是一个 a,p 的右端是a* ,* 让 a 重复 >= 2 次
星号不是真实字符,s、p是否匹配,要看 s 去掉末尾的 a,p 去掉末尾一个 a,剩下的是否匹配。
星号拷贝了 >=2 个 a,拿掉一个,剩下 >=1 个a,p 末端依旧是 a* 没变。
s 末尾的 a 被抵消了,继续考察 s(0,i-2) 和 p(0,i-1) 是否匹配。
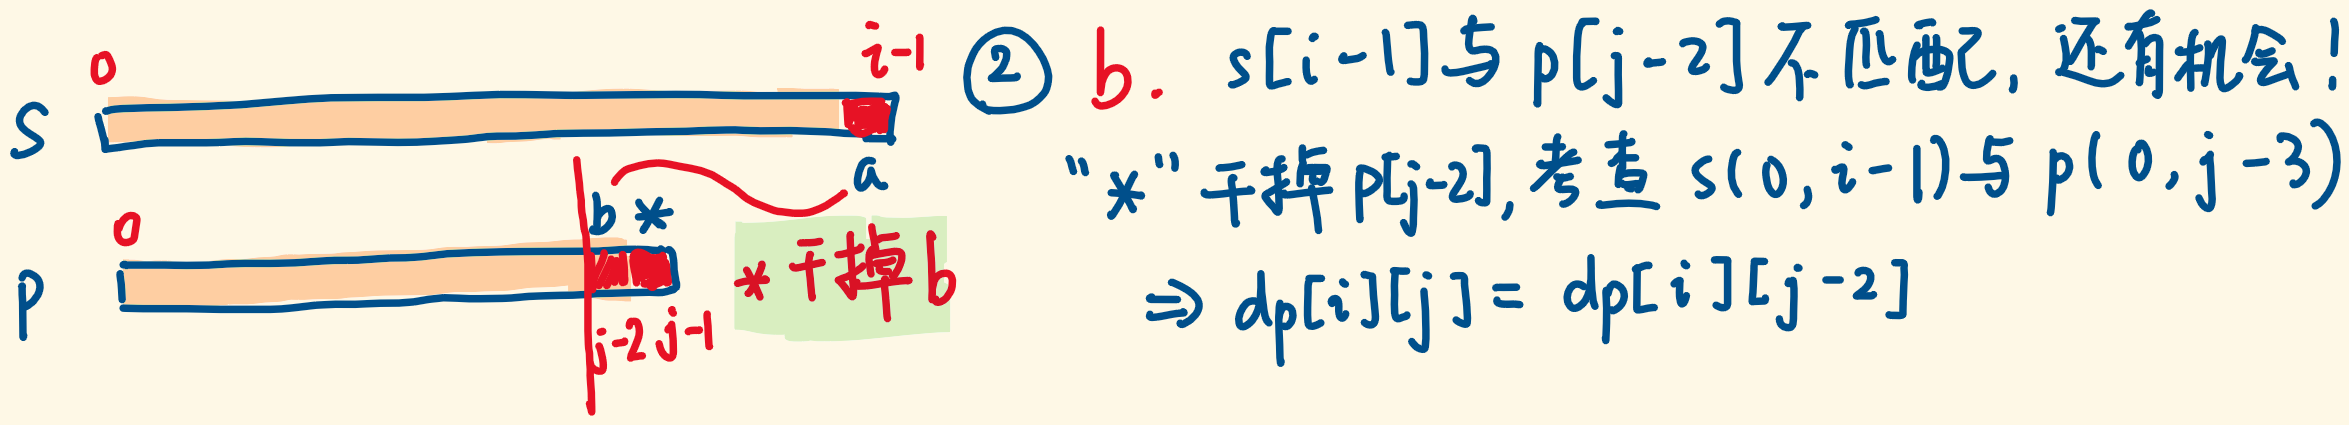
p[j-1] == “∗”,但 s[i-1] 和 p[j-2] 不匹配
s[i-1] 和 p[j−2] 不匹配,还有救,p[j−1] 星号可以干掉 p[j−2],继续考察 s(0 , i-1) 和 p(0 , j-3)。
注意:
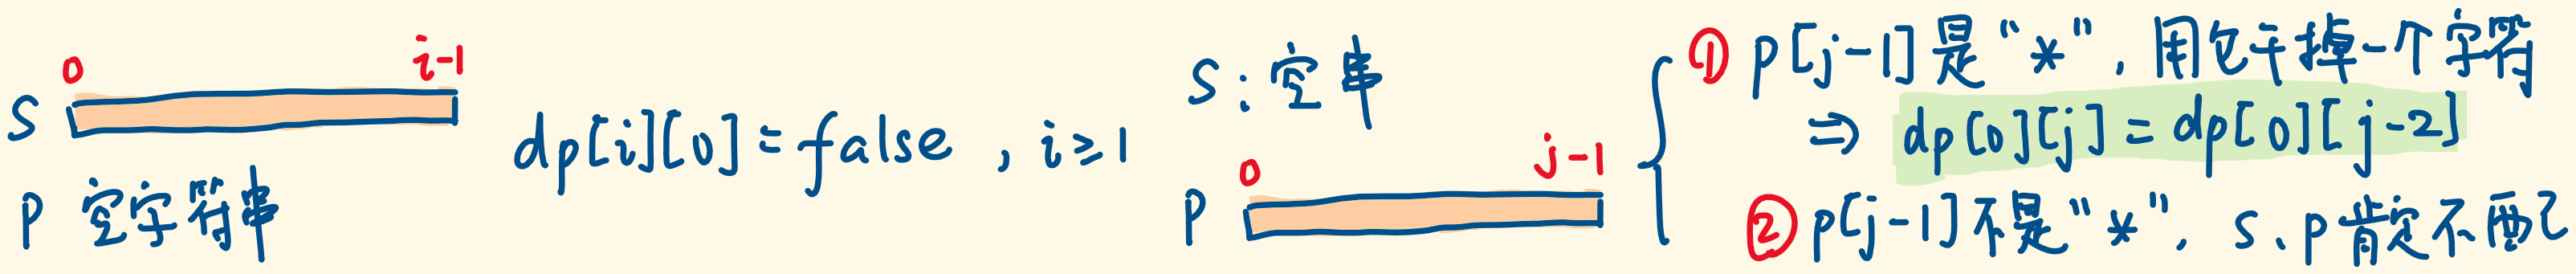
p为空串,s不为空串,肯定不匹配。
s为空串,但p不为空串,要想匹配,只可能是右端是星号,它干掉一个字符后,把 p 变为空串。
s、p都为空串,肯定匹配。
代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
class Solution { public boolean isMatch (String s, String p) { char [] cs = s.toCharArray(); char [] cp = p.toCharArray(); boolean [][] dp = new boolean [cs.length + 1 ][cp.length + 1 ]; dp[0 ][0 ] = true ; for (int j = 1 ; j <= cp.length; j++) { if (cp[j - 1 ] == '*' ) { dp[0 ][j] = dp[0 ][j - 2 ]; } } for (int i = 1 ; i <= cs.length; i++) { for (int j = 1 ; j <= cp.length; j++) { if (cs[i - 1 ] == cp[j - 1 ] || cp[j - 1 ] == '.' ) { dp[i][j] = dp[i - 1 ][j - 1 ]; } else if (cp[j - 1 ] == '*' ) { if (cs[i - 1 ] == cp[j - 2 ] || cp[j - 2 ] == '.' ) { dp[i][j] = dp[i][j - 2 ] || dp[i - 1 ][j]; } else { dp[i][j] = dp[i][j - 2 ]; } } } } return dp[cs.length][cp.length]; } }
29.两数相除(M) 给定两个整数,被除数 dividend 和除数 divisor。将两数相除,要求不使用乘法、除法和 mod 运算符 。
返回 被除数 dividend 除以 除数 divisor 得到的商 。
整数除法的结果应当截去(truncate)其小数部分,例如:truncate(8.345) = 8 以及 truncate(-2.7335) = -2
1 输入: dividend = 7, divisor = -3输出: -2解释: 7/-3 = truncate(-2.33333..) = -2
提示:
被除数和除数均为 32 位有符号整数。
指数递增
由于题目规定只能存储32位整数,所以只能使用int ,要考虑除法结果溢出。
对于溢出或容易出错的边界 情况:
当被除数 是32位有符号数的最小值-2的31次方 时:
如果除数为1,那么直接返回答案-2的31次方;
如果除数为-1,那么答案为2的31次方,产生了溢出。
当除数 为32位有符号整数的最小值-2的31次方 :
如果被除数同样为-2的31次方,那么直接返回答案1;
对于其余情况,直接返回0;
当被除数为0时,直接返回答案0;
对于除数和被除数的符号 ,需要考虑4种情况,为了方便,使 除数和被除数符号 符号相同,这样就只需考虑一种符号的情况,由于都取整数的话可能会溢出,因此将除数和被除数都取为负数 。
方法一:二分法
指数递增步长 方法二:指数递增步长 (类二分查找,快速加):
我们首先不断地将 Y 乘以 2(通过加法运算实现),并将这些结果放入数组中,其中数组的第 i 项 就等于 Y * 2的 i 次方 ;这一过程直到 Y 的两倍严格小于 X 为止。
对数组进行逆序遍历。当遍历到第 i 项时,如果大于等于X, 就将答案增加2的 i 次方,并且将X减去这一项的值。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
class Solution { public int divide (int dividend, int divisor) { if (dividend == Integer.MIN_VALUE) { if (divisor == 1 ) { return Integer.MIN_VALUE; } if (divisor == -1 ) { return Integer.MAX_VALUE; } } if (divisor == Integer.MIN_VALUE) { return dividend = = Integer.MIN_VALUE ? 1 : 0 ; } if (dividend == 0 ) { return 0 ; } boolean rev = false ; if (dividend > 0 ) { dividend = -dividend; rev = !rev; } if (divisor > 0 ) { divisor = -divisor; rev = !rev; } List<Integer> candidates = new ArrayList <Integer>(); candidates.add(divisor); int index = 0 ; while (candidates.get(index) >= dividend - candidates.get(index)) { candidates.add(candidates.get(index) + candidates.get(index)); ++index; } int ans = 0 ; for (int i = candidates.size() - 1 ; i >= 0 ; --i) { if (candidates.get(i) >= dividend) { ans += 1 << i; dividend -= candidates.get(i); } } return rev ? -ans : ans; } }
166.分数到小数(M) 给定两个整数,分别表示分数的分子 numerator 和分母 denominator ,以 字符串形式返回小数 。
如果小数部分为循环小数,则将循环的部分括在括号内 。
如果存在多个答案,只需返回任意一个 。
对于所有给定的输入,保证答案字符串的长度小于104。
1 示例:输入:numerator = 4 , denominator = 333 输出:"0.(012)"
模拟长除法 计算分子和分母相除的结果,可能有:整数,有限小数,无限循环小数;
如果分子可以被分母整除,则结果为整数
如果分子不能被分母整除,则为有限/无限循环小数,需用模拟长除法 的方式来计算:
先根据分子,分母的正负 决定结果的正负,并将分子,分母都转为正数;
先计算整数部分,并将整数部分和小数点拼接到结果中;
再计算小数部分:每次将余数乘以 10,然后计算小数的下一位数字,并得到新的余数。重复上述操作直到余数变成 0 或者找到循环节。
如果余数为0,则结果为有限小数
如果找到循环节,则在循环节开始和结束位置加上括号;
判断循环节:因为相同的余数,计算得到的小数的下一位数字一定相同,所以如果有余数在之前已经出现过,则认为找到循环节;(用哈希表存储每个余数第一次出现的下标)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
class Solution { public String fractionToDecimal (int numerator, int denominator) { long numeratorLong = (long ) numerator; long denominatorLong = (long ) denominator; if (numeratorLong % denominatorLong == 0 ) { return String.valueOf(numeratorLong / denominatorLong); } StringBuffer sb = new StringBuffer (); if (numeratorLong < 0 ^ denominatorLong < 0 ) { sb.append('-' ); } numeratorLong = Math.abs(numeratorLong); denominatorLong = Math.abs(denominatorLong); long integerPart = numeratorLong / denominatorLong; sb.append(integerPart); sb.append('.' ); StringBuffer fractionPart = new StringBuffer (); Map<Long, Integer> remainderIndexMap = new HashMap <Long, Integer>(); long remainder = numeratorLong % denominatorLong; int index = 0 ; while (remainder != 0 && !remainderIndexMap.containsKey(remainder)) { remainderIndexMap.put(remainder, index); remainder *= 10 ; fractionPart.append(remainder / denominatorLong); remainder %= denominator; index++; } if (remainder != 0 ) { int insertIndex = remainderIndexMap.get(remainder); fractionPart.insert(insertIndex, '(' ); fractionPart.append(')' ); } sb.append(fractionPart.toString()); return sb.toString(); } }
187.重复的DNA序列(M) 所有 DNA 都由一系列缩写为 ‘A’,’C’,’G’ 和 ‘T’ 的核苷酸组成,例如:”ACGAATTCCG”。在研究 DNA 时,识别 DNA 中的重复序列有时会对研究非常有帮助。
编写一个函数来找出所有目标子串,目标子串的长度为 10,且在 DNA 字符串 s 中出现次数超过一次。
1 输入:s = "AAAAACCCCCAAAAACCCCCCAAAAAGGGTTT" 输出:["AAAAACCCCC" ,"CCCCCAAAAA" ]
滑动窗口+哈希表 从左到右处理字符串 ss,使用滑动窗口得到每个以 s[i]s[i] 为结尾且长度为 1010 的子串,同时使用哈希表记录每个子串的出现次数,如果该子串出现次数超过一次,则加入答案。
时间复杂度:O(NL),其中 N 是字符串 s 的长度,L=10即目标子串的长度。
空间复杂度:O(NL)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Solution { public List<String> findRepeatedDnaSequences (String s) { List<String> list = new ArrayList <>(); Map<String, Integer> map = new HashMap <>(); int n = s.length(); for (int i = 0 ; i + 10 <= n; i++){ String cur = s.substring(i, i + 10 ); int cnt = map.getOrDefault(cur, 0 ); if (cnt == 1 ) list.add(cur); map.put(cur, cnt + 1 ); } return list; } }
位运算+滑动窗口+哈希表 因为只有4种字符,所以可以将每个字符用2个比特表示 ,即:
A:00 C:01 G:10 T:11
这样,长为10个字符的字符串就可以用20个比特表示,这里用 int整数(有32)的低20位 来表示它,
如果我们对每个长为 10 的子串都单独计算其整数表示,那么时间复杂度仍然和方法一一样为 O(NL)。为了优化时间复杂度,我们可以用一个大小固定为 10 的滑动窗口来计算子串的整数表示。
设当前滑动窗口对应的整数表示为 x,当我们要计算下一个子串时,就将滑动窗口向右移动一位,此时会有一个新的字符进入窗口,以及窗口最左边的字符离开窗口,这些操作对应的位运算,按计算顺序表示如下:
滑动窗口向右移动一位:x = x << 2,由于每个字符用 2 个比特表示,所以要左移 2 位;
一个新的字符 ch 进入窗口:x = x | bin[ch],这里 bin[ch] 为字符 ch 的对应二进制;
窗口最左边的字符离开窗口:x = x & ((1 << 20) - 1),由于我们只考虑 x 的低 20 位比特,需要将其余位置零,即与上 (1 << 20) - 1。
上面三步合并,就可以用O(1)的时间算出下一个子串的整数表示,即 x = ((x << 2) | bin[ch]) & ((1 << 20) - 1)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
class Solution { static final int L = 10 ; Map<Character, Integer> bin = new HashMap <Character, Integer>() { { put('A' , 0 ); put('C' , 1 ); put('G' , 2 ); put('T' , 3 ); } }; public List<String> findRepeatedDnaSequences (String s) { List<String> ans = new ArrayList <String>(); int n = s.length(); if (n <= L) { return ans; } int x = 0 ; for (int i = 0 ; i < L - 1 ; ++i) { x = (x << 2 ) | bin.get(s.charAt(i)); } Map<Integer, Integer> cnt = new HashMap <Integer, Integer>(); for (int i = 0 ; i <= n - L; ++i) { x = ((x << 2 ) | bin.get(s.charAt(i + L - 1 ))) & ((1 << (L * 2 )) - 1 ); cnt.put(x, cnt.getOrDefault(x, 0 ) + 1 ); if (cnt.get(x) == 2 ) { ans.add(s.substring(i, i + L)); } } return ans; } }
223.矩形面积(E) 给你 二维 平面上两个 由直线构成的 矩形 ,请你计算并返回两个矩形覆盖的总面积。
每个矩形由其 左下 顶点和 右上 顶点坐标表示:
第一个矩形由其左下顶点 (ax1, ay1) 和右上顶点 (ax2, ay2) 定义。左下顶点 (bx1, by1) 和右上顶点 (bx2, by2) 定义。
方法 :直接计算重叠面积
如果两个矩形重叠,则两个矩形的重叠部分也是矩形,重叠部分的面积可以根据重叠部分的边界计算。
两个矩形的水平边投影到 xx 轴上的线段分别为[ax 1,ax 2] 和 [bx 1,bx 2],竖直边投影到 yy 轴上的线段分别为[ay 1,ay 2] 和 [by 1,by 2]。如果两个矩形重叠,则重叠部分的水平边投影到 x 轴上的线段为 [max(ax1, bx1) , min(ax2, bx2)] , 竖直边投影到 y 轴上的线段为 [max(ay1, by1) , min(ay2, by2)] , 根据重叠部分的水平边投影到 x 轴上的线段长度和竖直边投影到 y 轴上的线段长度即可计算重叠部分的面积。只有当两条线段的长度都大于 0 时,重叠部分的面积才大于 0,否则重叠部分的面积为 0。
1
2
3
4
5
6
7
8
class Solution { public int computeArea (int ax1, int ay1, int ax2, int ay2, int bx1, int by1, int bx2, int by2) { int area1 = (ax2 - ax1) * (ay2 - ay1), area2 = (bx2 - bx1) * (by2 - by1); int overlapWidth = Math.min(ax2, bx2) - Math.max(ax1, bx1), overlapHeight = Math.min(ay2, by2) - Math.max(ay1, by1); int overlapArea = Math.max(overlapWidth, 0 ) * Math.max(overlapHeight, 0 ); return area1 + area2 - overlapArea; } }
229.求众数2(M) 给定一个大小为 n 的整数数组,找出其中所有出现超过 n/3 次的元素。
进阶:尝试设计时间复杂度为 O(n)、空间复杂度为 O(1)的算法解决此问题。
哈希表计数:
一个朴素的做法是使用「哈希表」进行计数,在计数完成后将所有出现次数超过 n / 3n /3 的元素加入答案。
时间和空间复杂度都为O(n)
摩尔投票法 摩尔投票法的核心思想为对拼消耗 。
最基本的摩尔投票问题,比如找出一组数字序列中出现次数大于总数 1/2 的数字(并且假设这个数字一定存在)。我们可以直接利用反证法证明这样的数字只可能有一个。摩尔投票算法的核心思想是基于这个事实:
每次 从序列里选择两个不相同的数字删除掉 (或称为「抵消」),最后剩下 一个数字或几个相同的数字,就是出现次数大于总数一半的那个元素 。
题目要求找出出现超过n/3次的元素,可以用反证法推出满足条件的元素最多只有2个。所以可以利用摩尔投票法的核心思想,每次选择三个互不相同的元素进行删除 (或称为「抵消」)。
摩尔投票法最后还需要计数阶段,来确定选出来的元素是否满足条件;
时间复杂度:O(n),空间复杂度:O(1),只使用了常数个元素来存储关键元素和统计次数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
class Solution { public List<Integer> majorityElement (int [] nums) { int element1 = 0 ; int element2 = 0 ; int vote1 = 0 ; int vote2 = 0 ; for (int num : nums) { if (vote1 > 0 && num == element1) { vote1++; } else if (vote2 > 0 && num == element2) { vote2++; } else if (vote1 == 0 ) { element1 = num; vote1++; } else if (vote2 == 0 ) { element2 = num; vote2++; } else { vote1--; vote2--; } } int cnt1 = 0 ; int cnt2 = 0 ; for (int num : nums) { if (vote1 > 0 && num == element1) { cnt1++; } if (vote2 > 0 && num == element2) { cnt2++; } } List<Integer> ans = new ArrayList <>(); if (vote1 > 0 && cnt1 > nums.length / 3 ) { ans.add(element1); } if (vote2 > 0 && cnt2 > nums.length / 3 ) { ans.add(element2); } return ans; } }
230.二叉搜索树中第k小的元素(M) 给定一个二叉搜索树的根节点 root ,和一个整数 k ,请你设计一个算法查找其中第 k 个最小元素(从 1 开始计数)。
1 输入:root = [5,3,6,2,4,null,null,1], k = 3输出:3
树中的节点数为 n 。
1 <= k <= n <= 10的4次方0 <= Node.val <= 10的4次方
进阶: 如果二叉搜索树经常被修改(插入/删除操作)并且你需要频繁地查找第 k 小的值,你将如何优化算法?
中序遍历 由于题目中的树为搜索树,即树中左子节点小于当前节点,右子节点大于当前节点,各子树本身也是二叉搜索树;因此中序遍历二叉搜索树得到的结果是排序的;
时间复杂度:O(H + k):H为树的高度
空间复杂度:O(H):栈中最多存储H个元素
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution { public int kthSmallest (TreeNode root, int k) { Deque<TreeNode> stack = new ArrayDeque <>(); while (root != null || !stack.isEmpty()) { while (root != null ) { stack.push(root); root = root.left; } root = stack.poll(); k--; if (k == 0 ){ break ; } root = root.right; } return root.val; } }
记录子树的节点数
如果要频繁地查找第k小的值,该如何优化?
中序遍历中,以为我们不知道子树的节点数量,不得不通过遍历子树来获得前k个元素;
因此,我们可以记录下每个节点为根结点的子树的结点数 ,并在查找第 k 小的值时,使用如下方法搜索:
令 node 等于根结点,开始搜索。
对当前结点 node 进行如下操作:
如果 node 的左子树的结点数 left 小于 k-1,则第 k 小的元素一定在node 的右子树中,令 node 等于其的右子结点,k 等于 k - left−1,并继续搜索;
如果 node 的左子树的结点数 left 等于 k-1,则第 k 小的元素即为 node ,结束搜索并返回 node 即可;
如果 node 的左子树的结点数 left 大于 k-1,则第 k 小的元素一定在 node 的左子树中,令 node 等于其左子结点,并继续搜索。
可以再每个节点中存在子树节点数,也可以用哈希表记录;
时间复杂度:预处理的时间为O(N):N为树中节点的总数(需要遍历所有节点来统计每个节点的为根的子树节点数);搜索的时间为O(H),H为树高;
空间复杂度 :O(N),哈希表存储每个节点的子树节点数信息
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
class Solution { public int kthSmallest (TreeNode root, int k) { MyBst bst = new MyBst (root); return bst.kthSmallest(k); } } class MyBst { TreeNode root; Map<TreeNode, Integer> nodeNum; public MyBst (TreeNode root) { this .root = root; this .nodeNum = new HashMap <TreeNode, Integer>(); countNodeNum(root); } public int kthSmallest (int k) { TreeNode node = root; while (node != null ) { int left = getNodeNum(node.left); if (left < k - 1 ) { node = node.right; k -= left + 1 ; } else if (left == k - 1 ) { break ; } else { node = node.left; } } return node.val; } private int countNodeNum (TreeNode node) { if (node == null ) { return 0 ; } nodeNum.put(node, 1 + countNodeNum(node.left) + countNodeNum(node.right)); return nodeNum.get(node); } private int getNodeNum (TreeNode node) { return nodeNum.getOrDefault(node, 0 ); } }
平衡二叉搜索树
如果二叉搜索树经常被修改(插入/删除操作)并且你需要频繁地查找第 k 小的值,你将如何优化算法?
平衡二叉搜索树中每个节点的左子树和右子树高度最多相差1;
其子树也是平衡二叉搜索树;
一棵存有n个节点的平衡二叉搜索树的高度为O(logn);
在方法二中,其搜索的时间复杂度为O(H),当树是平衡树时,时间复杂度可取到O(logN);
时间复杂度:预处理的时间复杂度为 O(N),其中 N 是树中结点的总数。插入、删除和搜索的时间复杂度均为 O(log N)。
空间复杂度:O(N),用于存储平衡二叉搜索树。
260.只出现一次的数字III (M) 给定一个整数数组 nums,其中恰好有两个元素只出现一次,其余所有元素均出现两次。 找出只出现一次的那两个元素。你可以按 任意顺序 返回答案。
进阶:你的算法应该具有线性时间复杂度。你能否仅使用常数空间复杂度来实现?
1
2
3
4
例子: 输入:nums = [1,2,1,3,2,5] 输出:[3,5] 解释:[5, 3] 也是有效的答案。
方法一:用哈希映射统计数组中每一个元素出现的次数。在统计完成后,对哈希映射进行遍历,将所有只出现了一次的数放入答案中。
时间复杂度:O(n);空间复杂度:O(n)
方法二:位运算
位运算 假设数组 nums 中只出现一次的元素分别是x1和x2,如果把nums 中的所有元素全部异或起来,得到结果 x,则x = x1异或x2 ,因为数组中出现两次的元素都会因为异或运算而被抵消掉(如:a异或b异或b=a)。
因为x1和x2不等,所以x不会等于0。此时,利用 x & -x 得到 x 的最低有效位lowbit ,即x二进制表示中最低位的1,设这个1在第i位;
这样,数组中的元素就可以分为两类:一类是二进制表示中第i位为1的,另一类是第i位为0的,而x1和x2不会在同一类里(因为只有x1和x2的第i位不同,异或得到的第i位才为1);然后将同一类的元素全部异或起来,那么其中一类最终会得到x1,另一类得到x2 (出现两次的元素都会被异或运算抵消,最后只留下x1或x2)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
class Solution { public int [] singleNumber(int [] nums) { int xorNum = 0 ; for (int num : nums) { xorNum ^= num; } int lowBit = (xorNum == Integer.MIN_VALUE ? xorNum : xorNum & (-xorNum)); int x1 = 0 , x2 = 0 ; for (int num : nums) { if ((lowBit & num) != 0 ) { x1 ^= num; } else { x2 ^= num; } } return new int []{x1, x2}; } }
335.交叉路径(D) 给定一个整数数组distance;
从X-Y平面上的原点(0,0)开始,每四个数字一组,分别向北,西,南,东移动。
判断你所经过的路径是否相交,如果相交,返回true,否则,返回false;
1
2
3
输入:distance = [2 ,1 ,1 ,2 ] 输出:true
归纳法(找规律) 首先,至少需要4条边才可能存在相交路径,如果distance长度小于4,可直接返回fasle;
对可能相交情况进行分情况讨论,设当前枚举到的边为 d[ i ] ,(画图理解!)
d[i] 与 d[i - 3] 发生相交:此时满足 d[i] >= d[i - 2],同时 d[i - 1] <= d[i - 3];
d[i] 与 d[i - 4] 发生相交:此时满足 d[i - 1] >= d[i - 3],同时 d[i] + d[i - 4] >= d[i - 2];
d[i] 与 d[i - 5] 发生相交:此时满足 d[i - 1] <= d[i - 3],同时 d[i - 2] > d[i - 4],同时 d[i] + d[i - 4] >= d[i - 2],同时 d[i - 1] + d[i - 5] >= d[i - 3]
综上,d[i] 不会与d[i - 1] 和 d[i - 2] 发生相交,而 d[i] 在与d[i - x] (x>5)发生相交前,必然先与d[i - y] (3<=y<5) 发生相交。
1
2
3
4
5
6
7
8
9
10
11
12
class Solution { public boolean isSelfCrossing (int [] d) { int n = d.length; if (n < 4 ) return false ; for (int i = 3 ; i < n; i++) { if (d[i] >= d[i - 2 ] && d[i - 1 ] <= d[i - 3 ]) return true ; if (i >= 4 && d[i - 1 ] == d[i - 3 ] && d[i] + d[i - 4 ] >= d[i - 2 ]) return true ; if (i >= 5 && d[i - 1 ] <= d[i - 3 ] && d[i - 2 ] > d[i - 4 ] && d[i] + d[i - 4 ] >= d[i - 2 ] && d[i - 1 ] + d[i - 5 ] >= d[i - 3 ]) return true ; } return false ; } }
352.将数据流变为多个不相交区间(D) 给你一个由非负整数 a1, a2, …, an 组成的数据流输入,请你将到目前为止看到的数字总结为不相交的区间列表。
(如:arr[1,2,3,7] ,则将其分为:[1,3],[7,7] )
实现 SummaryRanges 类:
SummaryRanges():使用一个空数据流初始化对象。
有序映射(TreeMap) 使用某一数据结构维护这些不相交的区间,在设计具体的数据结构之前,我们需要先明确 void addNum(int val) 这一操作会使得当前的区间集合发生的变化:
情况一:如果存在一个区间 [ l , r ],它完全包含 val,即 l ≤ val ≤ r,那么在加入 val 之后,区间集合不会有任何变化;
情况二:如果存在一个区间 [ l , r ],它的右边界 r「紧贴着」val,即 r + 1 = val,那么在加入 val 之后,该区间会从 [ l , r ] 变为 [ l , r+1 ];
情况三:如果存在一个区间 [ l , r ],它的左边界 l「紧贴着」val,即 l - 1 = val,那么在加入 val 之后,该区间会从 [ l , r ] 变为 [ l−1 , r ];
情况四:如果情况二和情况三同时满足,即存在一个区间 [ l0 , r0] 满足 r0 + 1 = val, 并且存在一个区间 [ l1, r1] 满足 l1 - 1 = val,那么在加入val后,这两个区间会合并成一个大区间;
情况五:在上述四种情况均不满足的情况下,val 会单独形成一个新的区间 [ val , val ]。
一种可以找到「最近」区间 的数据结构是有序映射 。有序映射中的键和值分别表示区间的左边界 l 和右边界 r。由于有序映射支持查询「最大的比某个元素小的键」以及「最小的比某个元素大的键」这两个操作,因此我们可以快速地定位区间 [ l0 , r0 ] 和[ l1 , r1];
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
class SummaryRanges { TreeMap<Integer, Integer> intervals; public SummaryRanges () { intervals = new TreeMap <Integer, Integer>(); } public void addNum (int val) { Map.Entry<Integer, Integer> interval1 = intervals.ceilingEntry(val + 1 ); Map.Entry<Integer, Integer> interval0 = intervals.floorEntry(val); if (interval0 != null && interval0.getKey() <= val && val <= interval0.getValue()) { return ; } else { boolean leftAside = interval0 != null && interval0.getValue() + 1 == val; boolean rightAside = interval1 != null && interval1.getKey() - 1 == val; if (leftAside && rightAside) { int left = interval0.getKey(), right = interval1.getValue(); intervals.remove(interval0.getKey()); intervals.remove(interval1.getKey()); intervals.put(left, right); } else if (leftAside) { intervals.put(interval0.getKey(), interval0.getValue() + 1 ); } else if (rightAside) { int right = interval1.getValue(); intervals.remove(interval1.getKey()); intervals.put(val, right); } else { intervals.put(val, val); } } } public int [][] getIntervals() { int size = intervals.size(); int [][] ans = new int [size][2 ]; int index = 0 ; for (Map.Entry<Integer, Integer> entry : intervals.entrySet()) { int left = entry.getKey(), right = entry.getValue(); ans[index][0 ] = left; ans[index][1 ] = right; ++index; } return ans; } }
405.数字转换为十六进制数(E) 给定一个整数,编写一个算法将这个数转换为十六进制数。对于负整数,我们通常使用 补码运算 方法。
注意:
十六进制中所有字母(a-f)都必须是小写。
十六进制字符串中不能包含多余的前导零。如果要转化的数为0,那么以单个字符’0’来表示;对于其他情况,十六进制字符串中的第一个字符将不会是0字符。
给定的数确保在32位有符号整数范围内。
不能使用任何由库提供的将数字直接转换或格式化为十六进制的方法。
模拟+进制转换
利用通用的进制转换思路来做,不断循环 num % k 和 num / k 的操作来构造出 k 进制每一位。
但需要处理「补码」问题:对于负数的 num,我们需要先在 num 基础上加上 2^32 的偏移量,再进行进制转换。
(将有符号整数 转化为 无符号整数,其二进制表示方式不变,十进制则相当于原数字加上2的n次方,n为二进制的位数,同样的,其十六进制表示方式也不变)
1 class Solution { public String toHex (int num) { if (num == 0 ) return "0" ; long temp = num; StringBuilder sb = new StringBuilder (); if (num < 0 ) temp = (long ) (Math.pow(2 , 32 ) + num); while (temp != 0 ) { long u = temp % 16 ; char c = (char ) (u + '0' ); if (u >= 10 ) c = (char ) (u - 10 + 'a' ); sb.append(c); temp /= 16 ; } return sb.reverse().toString(); }}
位运算 + 分组换算
将长度为 32 的二进制转换为 16 进制数,本质是对长度为 32 的二进制数进行分组,
由于我们是直接对长度为 32 的二进制进行分组转算(4 个为一组,共 8 组),而长度为 32 的二进制本身就是使用补码规则来表示的,因此我们无须额外处理「补码」问题。
具体的,我们将 num 与 15的二进制 进行 & 运算,然后对 num 进行无符号右移 4 位来实现每 4 位处理
1 class Solution { public String toHex (int num) { if (num == 0 ) return "0" ; StringBuilder sb = new StringBuilder (); while (num != 0 ) { int u = num & 15 ; char c = (char ) (u + '0' ); if (u >= 10 ) c = (char ) (u - 10 + 'a' ); sb.append(c); num >>>= 4 ; } return sb.reverse().toString(); }}
437.路径总和III(M) 给定一个二叉树的根节点 root ,和一个整数 targetSum ,求该二叉树里节点值之和等于 targetSum 的 路径 的数目 。
路径 不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
1 示例:输入:root =[10,5,-3,3,2,null,11,3,-2,null,1],targetSum = 8输出:3解释:和等于 8 的路径有 3 条,如图所示。
前缀和 前缀和,就是到达当前元素的路径上,之前所有元素的和。
如果前缀总和currSum,在节点A和节点B处相差target,则位于节点A和节点B之间的元素之和是target,也就是说A和B之间的路径符合题目要求
算法思路:
抵达当前节点(即B节点)后,将前缀和累加,然后查找在前缀和上,有没有前缀和currSum-target的节点(即A节点),存在即表示从A到B有一条路径之和满足条件的情况。结果加上满足前缀和currSum-target的节点的数量。然后递归进入左右子树。
左右子树遍历完成之后,回到当前层,需要把当前节点添加的前缀和去除。避免回溯之后影响上一层。因为思想是前缀和,不属于前缀的,我们就要去掉它。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution { public int pathSum (TreeNode root, int sum) { Map<Integer, Integer> prefixSumCount = new HashMap <>(); prefixSumCount.put(0 , 1 ); return recursionPathSum(root, prefixSumCount, sum, 0 ); } private int recursionPathSum (TreeNode node, Map<Integer, Integer> prefixSumCount, int target, int currSum) { if (node == null ) { return 0 ; } int res = 0 ; currSum += node.val; prefixSumCount.put(currSum, prefixSumCount.getOrDefault(currSum, 0 ) + 1 ); res += recursionPathSum(node.left, prefixSumCount, target, currSum); res += recursionPathSum(node.right, prefixSumCount, target, currSum); prefixSumCount.put(currSum, prefixSumCount.get(currSum) - 1 ); return res; } }
时间复杂度:O(N),每个节点只遍历一次
;空间复杂度:O(N),用了一个hashMap
476.数字的补数(E)
对整数的二进制表示取反(0 变 1 ,1 变 0)后,再转换为十进制表示,可以得到这个整数的补数。
例如,整数 5 的二进制表示是 “101” ,取反后得到 “010” ,再转回十进制表示得到补数 2 。(无视了前导零)
给你一个整数 num ,输出它的补数。
1 <= num < 2的31次方
模拟(lowbit)
如果 num 的二进制表示中最高位 1 的位置为 s 的话,那么实际上我们只需要对 num 的前 s - 1 位进行取反即是答案(第 s 位的取反结果始终为 0)。
因此我们可以先使用 lowbit 操作来得到 num 二进制表示中最高位 1 的位置为 1,其余位为 0 时所代表的数字 x。
然后 x - 1 即是二进制表示中前 s - 1 位均为 1,其余位为 0 的数字,将其与 num 的取反数执行「按位与」操作,即可达到「仅对 num 的前 s - 1 位进行取反」的效果。
1
2
3
4
5
6
7
class Solution { public int findComplement (int num) { int x = 0 ; for (int i = num; i != 0 ; i -= i & -i) x = i; return ~num & (x - 1 ); } }
也可以用这种:
找到二进制表示最高位的 1 :第 i (0≤i≤30) 位,后,
我们可以遍历 num 的第 0 ∼ i 个二进制位,将它们依次进行取反。也可以用更高效的方式,构造掩码 mask = 2
1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Solution { public int findComplement (int num) { int highbit = 0 ; for (int i = 1 ; i <= 30 ; ++i) { if (num >= 1 << i) { highbit = i; } else { break ; } } int mask = highbit == 30 ? 0x7fffffff : (1 << (highbit + 1 )) - 1 ; return num ^ mask; } }
483.密钥格式化(E) 有一个密钥字符串 S ,只包含字母,数字以及 ‘-‘(破折号)。其中, N 个 ‘-‘ 将字符串分成了 N+1 组。
给你一个数字 K,请你重新格式化字符串,使每个分组恰好包含 K 个字符。特别地,第一个分组包含的字符个数必须小于等于 K,但至少要包含 1 个字符。两个分组之间需要用 ‘-‘(破折号)隔开,并且将所有的小写字母转换为大写字母。
给定非空字符串 S 和数字 K,按照上面描述的规则进行格式化。
1 示例:输入:S = "5F3Z-2e-9-w" , K = 4 输出:"5F3Z-2E9W" 解释:字符串 S 被分成了两个部分,每部分 4 个字符;注意,两个额外的破折号需要删掉。
模拟
简单字符串模拟,从后往前处理,避免对首个分区的分情况讨论和取余操作。(注意答案字符串首部不要加上‘-’)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution { public String licenseKeyFormatting (String s, int k) { StringBuilder sb = new StringBuilder (); for (int i = s.length() - 1 , cnt = 0 ; i >= 0 ; i--) { if (s.charAt(i) == '-' ) continue ; if (cnt == k){ sb.append("-" ); cnt = 0 ; } sb.append(s.charAt(i)); cnt++; } return sb.reverse().toString().toUpperCase(); } }
583.两个字符串的删除操作(M) 给定两个单词 word1 和 word2 ,找到使得 word1 和 word2 相同所需的最小步数,每步可以删除任意一个字符串中的一个字符。
1
2
3
4
示例: 输入: "sea", "eat" 输出: 2 解释: 第一步将"sea"变为"ea",第二步将"eat"变为"ea"
最长公共子序列 该问题等价于求解量字符的「最长公共子序列」,若两者长度分别为 n 和 m,而最长公共子序列长度为 max,则 n - max + m - maxn 即为答案。
f[i] [j] 代表考虑 s1 的前 i 个字符、考虑 s2 的前 j 个字符
当有了「状态定义」之后,基本上「转移方程」就是呼之欲出:
s1[i]==s2[j] : f [i] [j] = f [i-1] [j-1] +1 s1[i] != s2[j] : f [i] [j]=max( f [i-1] [j], f [i] [j-1] )
不加哨兵空格:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution { public int minDistance (String s1, String s2) { char [] cs1 = s1.toCharArray(), cs2 = s2.toCharArray(); int n = s1.length(), m = s2.length(); int [][] f = new int [n + 1 ][m + 1 ]; for (int i = 1 ; i <= n; i++) { for (int j = 1 ; j <= m; j++) { if (cs1[i - 1 ] == cs2[j - 1 ]) f[i][j] = f[i - 1 ][j - 1 ] + 1 ; else f[i][j] = Math.max(f[i - 1 ][j], f[i][j - 1 ]); } } return n - f[n][m] + m - f[n][m]; } }
加哨兵空格:
可以往字符串头部追加一个空格,以减少边界判断(使下标从 1 开始,并很容易构造出可滚动的「有效值」)。但实现上,不用真的往字符串中最佳空格,只需在初始化动规值时假定存在首部空格,以及对最后的 LCS 长度进行减一操作即可。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution { public int minDistance (String s1, String s2) { char [] cs1 = s1.toCharArray(), cs2 = s2.toCharArray(); int n = s1.length(), m = s2.length(); int [][] f = new int [n + 1 ][m + 1 ]; for (int i = 0 ; i <= n; i++) f[i][0 ] = 1 ; for (int j = 0 ; j <= m; j++) f[0 ][j] = 1 ; for (int i = 1 ; i <= n; i++) { for (int j = 1 ; j <= m; j++) { f[i][j] = Math.max(f[i - 1 ][j], f[i][j - 1 ]); if (cs1[i - 1 ] == cs2[j - 1 ]) f[i][j] = Math.max(f[i][j], f[i - 1 ][j - 1 ] + 1 ); } } int max = f[n][m] - 1 ; return n - max + m - max; } }
动态规划 更加契合题意的状态定义是根据「最长公共子序列(LCS)」的原始状态定义进行微调:定义 f [i] [j] 代表考虑 s1 的前 i 个字符、考虑 s2 的前 j 个字符(最终字符串不一定包含 s1[i] 或 s2[j])时形成相同字符串的最小删除次数。
则转移方程 f [i] [j] 计算:
s1[i] == s2[j]:f [i] [j] = f [i - 1] [j - 1],代表可以不用必然删掉 s1[i] 和 s2[j] 形成相同字符串; s1[i] != s2[j]:f[i] [j] = min(f[i - 1] [j] + 1, f[i] [j - 1] + 1),代表至少一个删除 s1[i] 和 s2[j] 中的其中一个。
f [i] [j] 为上述方案中的最小值,最终答案为 f [n] [m]。
动态规划的边界:
当i 或 j = 0 时,其中一个字符串为空,空字符串和任何字符串要变成相同,只有将另一个字符串的字符全部删除,所以 dp[i] [0] = i 以及 dp[0] [j] = j
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution { public int minDistance (String s1, String s2) { int n = s1.length(), m = s2.length(); char [] c1 = s1.toCharArray(), c2 = s2.toCharArray(); int [][] dp = new int [n + 1 ][m + 1 ]; for (int i = 0 ; i <= n; i++) dp[i][0 ] = i; for (int j = 0 ; j <= m; j++) dp[0 ][j] = j; for (int i = 1 ; i <= n; i++){ for (int j = 1 ; j <= m; j++){ dp[i][j] = Math.min(dp[i][j - 1 ] + 1 , dp[i - 1 ][j] + 1 ); if (c1[i - 1 ] == c2[j - 1 ]) dp[i][j] = Math.min(dp[i][j], dp[i - 1 ][j - 1 ]); } } return dp[n][m]; } }
638.大礼包 在 商店中, 有 n 件在售的物品。每件物品都有对应的价格。然而,也有一些大礼包,每个大礼包以优惠的价格捆绑销售一组物品。
给你一个整数数组 price 表示物品价格,其中 price[i] 是第 i 件物品的价格needs 表示购物清单,其中 needs[i] 是需要购买第 i 件物品的数量
还有一个数组 special 表示大礼包,special[i] 的长度为 n + 1 ,其中 special[i][j] 表示第 i 个大礼包中内含第 j 件物品的数量special[i][n] (也就是数组中的最后一个整数)为第 i 个大礼包的价格
返回 确切 满足购物清单所需花费的最低价格,你可以充分利用大礼包的优惠活动。你不能购买超出购物清单指定数量的物品,即使那样会降低整体价格。任意大礼包可无限次购买。
输入:price = [2,3,4], special = [[1,1,0,4],[2,2,1,9]], needs = [1,2,1]
记忆化搜索 因为大礼包中可能包含多个物品,所以并不是所有状态都可以得到。因此,我们使用记忆化搜索而不是完全遍历的方法,来计算出满足每个购物清单 needs 所需花费的最低价格。
首先,我们过滤掉不需要计算的大礼包。
如果大礼包完全没有优惠(大礼包的价格大于等于原价购买大礼包内所有物品的价格),或者大礼包内不包含任何的物品,那么购买这些大礼包不可能使整体价格降低。因此,我们可以不考虑这些大礼包,并将它们过滤掉,以提高效率和方便编码。
然后,计算满足购物清单所需花费的最低价格:
用 dp[needs] 表示满足购物清单 needs 所需花费的最低价格。在进行状态转移时,我们考虑在满足购物清单 needs 时的最后一次购买;其中,将原价购买购物清单中的所有物品也视作一次购买。则有两种情况:
对此,要求出当前购物清单 cur_needs 所需花费的最低价格 min_price ,具体做法为:
将 min_price 初始化为原价购买购物清单cur_needs 中的所有物品的花费;
逐个遍历所有可以购买的大礼包,不妨设当前遍历的大礼包为 cur_special,其价格为special_price:
计算购买大礼包 cur_special 后新的购物清单 next_needs,并递归地计算满足购物清单 next_needs 所需花费的最低价格 next_price;
计算满足当前购物清单 cur_needs 所需花费的最低价格 cur_price = special_price + next_price;
如果 cur_price < min_price,则将 min_price 更新为 cur_price。
返回计算满足购物清单 cur_needs 所需花费的最低价格 min_price。
时间复杂度:O ( n × k × m^n^ ):k为大礼包数量,m为每种物品的需求量(等于最大需求量加1),n表示物品数量
空间复杂度:O ( n × m^n^ ):用于存储记忆化搜索中 m^n^个状态的计算结果,每个状态需要存储 n 个商品的需求量。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
class Solution { Map<List<Integer>, Integer> memo = new HashMap <List<Integer>, Integer>(); public int shoppingOffers (List<Integer> price, List<List<Integer>> special, List<Integer> needs) { int n = price.size(); List<List<Integer>> filterSpecial = new ArrayList <List<Integer>>(); for (List<Integer> sp : special) { int totalCount = 0 , totalPrice = 0 ; for (int i = 0 ; i < n; ++i) { totalCount += sp.get(i); totalPrice += sp.get(i) * price.get(i); } if (totalCount > 0 && totalPrice > sp.get(n)) { filterSpecial.add(sp); } } return dfs(price, needs, filterSpecial, n); } public int dfs (List<Integer> price, List<Integer> curNeeds, List<List<Integer>> filterSpecial, int n) { if (!memo.containsKey(curNeeds)) { int minPrice = 0 ; for (int i = 0 ; i < n; ++i) { minPrice += curNeeds.get(i) * price.get(i); } for (List<Integer> curSpecial : filterSpecial) { int specialPrice = curSpecial.get(n); List<Integer> nextNeeds = new ArrayList <Integer>(); for (int i = 0 ; i < n; ++i) { if (curSpecial.get(i) > curNeeds.get(i)) { break ; } nextNeeds.add(curNeeds.get(i) - curSpecial.get(i)); } if (nextNeeds.size() == n) { minPrice = Math.min(minPrice, dfs(price, nextNeeds, filterSpecial, n) + specialPrice); } } memo.put(curNeeds, minPrice); } return memo.get(curNeeds); } }
869.重新排序得到2的幂(M) ~~ ~~ 待理解!